


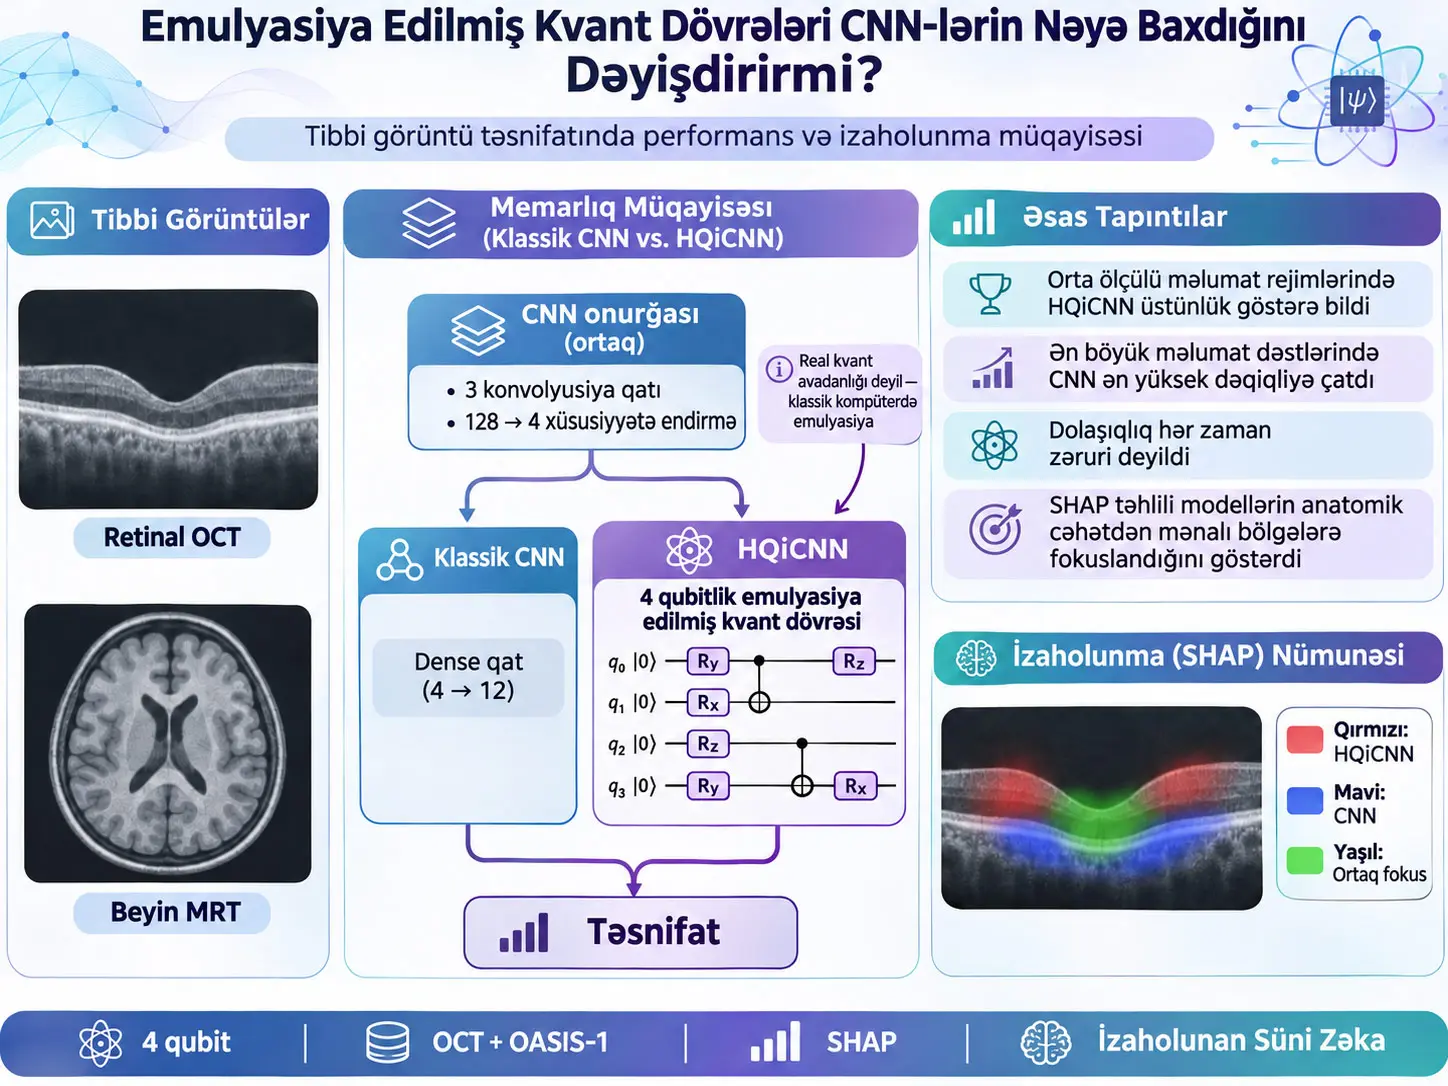
Hibrid Kvantdan İlhamlanan Konvolyusiya Neyron Şəbəkəsi (Hybrid Quantum-inspired Convolutional Neural Network, HQiCNN), klassik CNN görüntü-xüsusiyyət çıxarma əsasını saxlayaraq ara təsvir qatındakı klassik dense layer əvəzinə dörd qubitlik, klassik kompüterdə emulyasiya olunan parametrik kvant dövrəsindən istifadə edən görüntü təsnifatı modelidir. Tədqiqat HQiCNN-i eyni convolutional backbone-dan istifadə edən klassik CNN ilə retinal optik koherens tomoqrafiyası (OCT) və demensiya mərhələləndirilməsi üçün hazırlanmış beyin MRI görüntüləri üzərində müqayisə edir. Əsas tədqiqat sualı kiçik və klassik şəkildə emulyasiya edilə bilən bir kvant dövrəsinin real kvant avadanlığı tələb etmədən CNN-in öyrəndiyi ara təsviri və görüntünün hansı bölgələrinə əhəmiyyət verdiyini mənalı şəkildə dəyişdirib-dəyişdirməməsidir.
İki model mümkün qədər nəzarətli memarlıq müqayisəsi üçün eyni convolutional backbone-dan istifadə edir. Görüntü əvvəlcə üç qatlı convolutional block tərəfindən 128 ölçülü feature vector-a çevrilir; sonra linear reduction qatı bu vektoru 4 ölçüyə endirir. Klassik CNN qolunda bu dörd xüsusiyyət ReLU aktivləşdirməli \(4\rightarrow12\) dense layer-a daxil olur, HQiCNN qolunda isə dörd feature dörd qubitlik emulyasiya edilmiş kvant dövrəsinə angle encoding ilə ötürülür. Dövrədə \(R_Y\) input encoding, trainable \(R_X\) və \(R_Z\) rotations və seçimə bağlı CNOT entanglement mövcuddur. Dörd qubit üzərində \(X\), \(Y\) və \(Z\) Pauli observables oxunaraq ümumilikdə 12 classical output feature əldə edilir. Hər iki qolun 12 ölçülü çıxışı eyni tip classical output layer-a gedir.
Bu dövrə real quantum processor üzərində işlədilməmişdir. Kvant komponent PyTorch-un yerli riyazi əməliyyatları ilə klassik kompüterdə emulyasiya edildiyi üçün hardware noise, decoherence, finite-shot measurement uncertainty və fiziki qubit connectivity kimi real kvant kompüter məhdudiyyətləri benchmark-a daxil deyil. Emulyasiya edilmiş quruluş həmçinin quantum hardware-də lazım olacaq parameter-shift gradient estimation əvəzinə ordinary backpropagation istifadə edə bilir.
OCT üçün training size, learning rate, batch size, circuit entanglement və observable-set ölçüsü sistemli şəkildə dəyişdirilmişdir. Doqquz training size, üç learning rate, üç batch size, entangled/non-entangled circuit, üç observable set və 10 random seed ehtiva edən əsas OCT hyperparameter proqramı cəmi 640 execution kimi bildirilir. Maksimum training müddəti 100 epoch, early-stopping patience səkkiz epoch, learning-rate-scheduler patience üç epoch və reduction factor 0.3-dür.
Nəticələr vahid bir memarlığın hər vəziyyətdə üstün olmadığını göstərir. OCT-də klassik CNN ən böyük training set üçün tədqiqatın ən yüksək ümumi test accuracy dəyərinə, %93.7-yə çatmışdır. HQiCNN isə xüsusilə orta ölçülü training sets, təxminən 800–2000 nümunə ətrafındakı bir çox configuration-da klassik CNN-dən daha yüksək mean test accuracy yaratmışdır. Oxşar meyl OASIS dementia robustness test-ində də müşahidə olunmuş; daha kiçik training sizes-da HQiCNN üstün olduğu halda məlumat miqdarı artdıqca fərq daralmış və böyük training size-da CNN cüzi şəkildə önə keçmişdir.
Entanglement ümumilikdə məcburi üstünlük təmin etməmişdir. Non-entangled circuit orta hesabla əksər configuration-da oxşar və ya daha yaxşı performans göstərərkən yalnız müəyyən training sizes, xüsusilə 1000 və 1200 nümunə səviyyələrində entanglement daha dəqiq və daha sabit nəticələr yaratmışdır. Mənbə bu nəticəni vacib hesab edir; çünki separable circuits klassik emulyasiyada daha asan miqyaslanarkən entangled circuits-in simulation xərci qubit sayı ilə çox daha sürətli artır.
Explainability bölməsində tədqiqatçılar iki SHAP əsaslı alət təklif edirlər. \(|SHAP|IoU\), iki model üçün mütləq SHAP dəyərlərinin ən yüksək %10-na malik görüntü bölgələrinin üst-üstə düşməsini vizuallaşdırır. \(EMD_{pos}\) isə iki modelin müsbət SHAP paylanmaları arasındakı məkan fərqini Earth Mover's Distance/Wasserstein yanaşması ilə kəmiyyətləşdirir. OCT-də orta \(EMD_{pos}\), 1000 training sample üçün \(0.066\pm0.019\), 30000 sample üçün \(0.045\pm0.018\) tapılmışdır. Dəyərin məlumat artdıqca azalması iki modelin müsbət attribution bölgələrinin daha çox oxşadığını göstərir.
Lakin tədqiqat klinik diaqnostika sisteminin doğrulanması deyil. SHAP xəritələrinin retinal pigment epithelium və xəstəliklə əlaqəli anatomik bölgələrdə cəmlənməsi anatomik baxımdan mənalı işarə olsa da müəlliflər bu bölgələrin klinik olaraq doğrulanmış biomarker olmadığını açıq şəkildə bildirirlər. Həmçinin müstəqil xarici klinik validation, clinician reader study, tam 3D MRI analysis və training/inference computational-cost comparison aparılmamışdır.
HQiCNN Nədir və Bu Tədqiqatda Real Kvant Kompüterindən İstifadə Olunurmu?
HQiCNN, klassik CNN əsasının ara dense representation layer-ını dörd qubitlik emulyasiya edilmiş parametrik kvant dövrəsi ilə əvəz edən hybrid quantum-inspired təsnifat modelidir; bu tədqiqatda fiziki kvant prosessorundan istifadə edilməmiş, kvant dövrəsi PyTorch üzərində klassik kompüterdə riyazi şəkildə emulyasiya edilmişdir.
“Quantum-inspired” burada dəqiq olaraq nə deməkdir?
Bu tədqiqatda “quantum-inspired” ifadəsi sadəcə ümumi marketinq etiketi deyil. HQiCNN-in ara qatı real quantum-circuit riyaziyyatından istifadə edən dörd-qubitlik parameterized circuit quruluşuna malikdir:
- classical features qubit rotation angles formasında encode edilir,
- qubit states unitary rotation matrices ilə çevrilir,
- trainable \(R_X\) və \(R_Z\) rotations istifadə olunur,
- entangled configuration-da CNOT gates tətbiq edilir,
- son state-dən \(X\), \(Y\) və \(Z\) Pauli observables-ın expectation-value bənzəri classical outputs əldə edilir.
Lakin bütün bu əməliyyatlar physical qubits üzərində deyil, klassik kompüterdə tensor/matrix operations ilə hesablanır. Bu fərq çox vacibdir: mənbə “kvant kompüterindən istifadə edərək tibbi görüntü təsnifatı apardıq” demir.
Qubit nədir?
Qubit ikiölçülü kompleks Hilbert space daxilində təyin olunan kvant informasiya vahididir. Mənbə əsas qubit state-i:
\[ |\psi\rangle = \alpha|0\rangle+\beta|1\rangle = \begin{bmatrix} \alpha\\ \beta \end{bmatrix} \]
şəklində verir.
Normalization şərti:
\[ |\alpha|^2+|\beta|^2=1 \]
olmalıdır.
Burada:
- \(|0\rangle\) və \(|1\rangle\): computational basis states,
- \(\alpha\) və \(\beta\): complex probability amplitudes,
- \(|\alpha|^2\) və \(|\beta|^2\): ideal measurement zamanı müvafiq basis outcome-ların Born-rule probabilities dəyərləridir.
Superposition qubit-in ölçmədən əvvəl yalnız \(|0\rangle\) və ya yalnız \(|1\rangle\) olmaq məcburiyyətində olmaması və bu basis states-in normalized linear combination-ı kimi təmsil oluna bilməsi deməkdir.
Bu məqalədə qubit state fiziki cihazda hazırlanmayıb; eyni riyazi state vector klassik hesablama üzərində saxlanılır.
Hilbert space nədir?
Hilbert space quantum state vectors-ın təyin olunduğu kompleks inner-product vector space-dir. Tək qubit üçün əsas space ikiölçülüdür. Bir neçə qubit tensor product ilə birləşdirildikdə state-space dimension böyüyür. Dörd qubit üçün ümumi pure-state vector:
\[ 2^4=16 \]
complex amplitude ehtiva edir.
Bu rəqəm burada tədqiqatın yeni nəticəsi deyil; dörd-qubit state-space quruluşunun riyazi mənasını izah edən əsas kvant informasiyası şərhidir.
Quantum gate nədir?
Quantum gate quantum state üzərində acting edən unitary operator-dur. Unitary olma şərti:
\[ U^\dagger U=I \]
olduğuna görə state normu qorunur.
Tədqiqatın əsas circuit gates-i \(R_X\), \(R_Y\), \(R_Z\) və CNOT-dur.
Mənbədə verilən \(R_X\), \(R_Y\) və \(R_Z\) fırlanmaları
Mənbə Tənlik (1)-də:
\[ R_X(\theta) = \begin{bmatrix} \cos(\theta/2) & -i\sin(\theta/2)\\ -i\sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Y(\theta) = \begin{bmatrix} \cos(\theta/2) & -\sin(\theta/2)\\ \sin(\theta/2) & \cos(\theta/2) \end{bmatrix}, \]
\[ R_Z(\theta) = \begin{bmatrix} e^{-i\theta/2} & 0\\ 0 & e^{i\theta/2} \end{bmatrix}. \tag{1} \]
matrislərindən istifadə edir.
Bu matrices qubit state-i Bloch sphere üzərində müvafiq olaraq \(x\), \(y\) və \(z\) oxları ətrafında \(\theta\) bucağı qədər rotate edən unitary transformations-dır.
\(\theta\) ölçüsüz bucaq parametridir və radians ilə şərh olunur. Circuit daxilində input-dependent və ya trainable parameter-ın hansı gate-ə tətbiq edilməsindən asılı olaraq \(\theta\), encoded classical feature və ya optimization zamanı öyrənilən model parameter-ı ola bilər.
Pauli observables nədir?
Mənbə Tənlik (2)-də üç əsas Pauli matrix-i verir:
\[ X= \begin{bmatrix} 0&1\\ 1&0 \end{bmatrix}, \qquad Y= \begin{bmatrix} 0&-i\\ i&0 \end{bmatrix}, \qquad Z= \begin{bmatrix} 1&0\\ 0&-1 \end{bmatrix}. \tag{2} \]
Pauli matrices həm quantum gates/rotations-ın yaradılmasında, həm də observables kimi quantum state-dən classical information çıxarılmasında mərkəzi rol oynayır.
Bu tədqiqatın əsas HQiCNN configuration-ında hər dörd qubit üçün üç local observable:
\[ X,\ Y,\ Z \]
qiymətləndirildiyinə görə:
\[ 4\ \text{qubit}\times3\ \text{observable}=12 \]
classical feature yaradılır.
Entanglement nədir?
Entanglement çoxlu quantum system state-inin müstəqil subsystem states-in tensor product-ına ayrıla bilmədiyi quantum correlation formasıdır.
Məsələn, ümumi iki-qubit state:
\[ |\psi\rangle \neq |\psi_A\rangle\otimes|\psi_B\rangle \]
olarsa state entangled ola bilər.
HQiCNN-in entangled versiyasında qubits arasında linear CNOT layer tətbiq olunur. Non-entangled versiyada bu coupling çıxarılır.
Bu tədqiqatın mühüm nəticəsi entanglement-ın ümumi performans üçün zəruri olmadığını göstərməsidir. Bu nəticə “entanglement heç bir quantum machine-learning modelində faydasızdır” demək deyil; yalnız burada istifadə olunan dörd-qubit HQiCNN, datasets və measurement scheme üçün bildirilmişdir.
Parameterized Quantum Circuit nədir?
Parameterized Quantum Circuit (PQC), bəzi gate angles-ın trainable parameters olduğu quantum circuit quruluşudur. Classical machine-learning optimizer training loss-u azaltmaq üçün bu parameters-ı yeniləyir.
Mənbədə HQiCNN circuit:
- 4-dimensional classical vector-u qəbul edir,
- hər component-i bir qubit-ə \(R_Y\) angle encoding ilə yerləşdirir,
- trainable \(R_X\) və \(R_Z\) rotations tətbiq edir,
- entangled versiyada CNOT gates istifadə edir,
- Pauli observables ölçməsindən 12-dimensional classical representation çıxarır.
CNN ilə HQiCNN Arasındakı Müqayisə Necə Nəzarətdə Saxlanıldı?
İki model eyni convolutional feature extractor, eyni 128→4 linear reduction və eyni 12-ölçülü representation-dan classification output-a gedən son qatı paylaşır; əsas memarlıq dəyişəni klassik CNN-dəki \(4\rightarrow12\) ReLU dense layer-ın HQiCNN-də dörd-qubitlik emulyasiya edilmiş parametrik circuit ilə əvəz edilməsidir.
Ortaq convolutional backbone
Giriş medical image, üç convolutional layer-dan ibarət ortaq block-a daxil olur. Mənbə hər layer üçün:
- Conv2D,
- kernel size 3,
- Batch Normalization,
- Max Pooling,
- ReLU
komponentlərini göstərir.
Bu block-un sonunda görüntü:
\[ 128 \]
ölçülü feature vector-a çevrilir.
Linear reduction
Activation istifadə etməyən linear reduction layer:
\[ 128\rightarrow4 \]
çevrilməsini həyata keçirir.
Beləliklə hər iki model eyni dörd-dimensional latent representation-ı qəbul edir.
Klassik CNN qolu
Klassik branch:
\[ 4\rightarrow12 \]
dense layer və ReLU activation istifadə edir.
HQiCNN qolu
HQiCNN eyni dörd-dimensional vector-u dörd qubit-ə angle-encode edir və quantum-circuit representation-dan sonra:
\[ 4\ \text{qubit} \times 3\ \text{local Pauli observable} = 12 \]
output feature yaradır.
Son classification layer
Hər iki branch-in 12-dimensional representation-ı ortaq output layer-a gedir. Output dimension dataset-dəki label sayına bərabərdir:
- OCT: 4 sinif,
- OASIS robustness task: 3 sinif.
Input niyə \(2\pi\cdot\mathrm{sigmoid}(v)\) ilə çevrilir?
Parameterized rotation gates bucaqlı input istifadə edir. Mənbə dörd-dimensional vector:
\[ v \]
üçün üç preprocessing strategy müqayisə etmişdir.
Birinci seçim:
\[ \widetilde v = 2\pi\cdot\operatorname{sigmoid}(v). \]
Sigmoid:
\[ (0,1) \]
aralığına sıxdığı üçün \(2\pi\) ilə vurulduqda angle range:
\[ (0,2\pi) \]
olur.
İkinci seçim:
\[ \operatorname{remainder}(v,2\pi) \]
ilə periodic wrapping etməkdir.
Üçüncü seçim heç bir explicit transform tətbiq etmədən raw \(v\) dəyərlərindən istifadə etməkdir.
Mənbə scaled sigmoid transformation-ın bu üç seçim arasında consistently better performance verdiyini və qalan təcrübələrdə bu üsuldan istifadə edildiyini bildirir. Əsas mətndə bu preprocessing müqayisəsinin bütün sayısal dəyərləri ayrıca cədvəl şəklində verilməmişdir.
Parameter-shift rule niyə burada istifadə edilmir?
Fiziki və ya black-box quantum circuit-də trainable rotation parameter-ların gradient-i parameter-shift rule ilə hesablana bilər. Mənbənin izahına görə \(p\) trainable parameter üçün bu yanaşma:
\[ 2p \]
forward circuit evaluation tələb edir.
Buradakı circuit tamamilə differentiable PyTorch operations ilə emulyasiya edildiyinə görə automatic differentiation/backpropagation istifadə oluna bilir. Müəlliflər bütün gradients-ın tək backward pass daxilində birlikdə hesablana bildiyini və gradient-computation evaluation scaling-inin \(O(p)\) circuit passes tələbindən tək backward pass-ə endirildiyini vurğulayırlar.
Bu, quantum-hardware speedup nəticəsi deyil. Üstünlük classical emulation-ın differentiable software graph-ından istifadə edilməsidir.
Barren plateau nədir və bu tədqiqatda ölçülübmü?
Barren plateau parameterized quantum circuits-də cost-function gradient-ların circuit size/depth böyüdükcə çox kiçik hala gəlməsi və training-i çətinləşdirməsi mümkün olan optimallaşdırma problemidir.
Məqalə barren plateau-nu QML miqyaslana bilməsinin ümumi məhdudiyyətlərindən biri kimi təqdim edir; lakin tədqiqatın əsas təcrübə proqramı dörd-qubitlik emulyasiya edilmiş shallow circuit üzərindədir və barren-plateau scaling üçün ayrıca eksperimental ölçmə və ya exponent fitting aparmır.
Buna görə “bu tədqiqat barren plateau problemini həll etdi” nəticəsi çıxarıla bilməz.
OCT verilənlər dəsti
Retinal optical coherence tomography verilənlər dəsti cəmi:
\[ 84\,495 \]
JPEG image ehtiva edir və mənbədə standart training/test splits ilə dörd sinif göstərilir:
- NORMAL,
- CNV — choroidal neovascularization,
- DME — diabetic macular edema,
- DRUSEN.
Mənbə verilənlər dəstinin görüntülərinin 2013–2017 arasında bir neçə beynəlxalq clinical center-da Spectralis OCT cihazları ilə toplandığını və label quality üçün çoxmərhələli ophthalmologist review tətbiq edildiyini bildirir.
Bu məlumat orijinal OCT dataset-in xüsusiyyətidir; mövcud HQiCNN tədqiqatının yeni xəstələr topladığı mənasına gəlmir.
OASIS-1 MRI verilənlər dəsti
Robustness analysis üçün OASIS-1 structural MRI istifadə olunmuşdur. Mənbəyə görə dataset:
\[ 416 \]
subject ehtiva edir və yaş aralığı:
\[ 18-96 \]
ildir.
Preprocessing zənciri:
- 3D image files-ın NIfTI formatına çevrilməsi,
- standard anatomical orientation-a reorientation,
- bias-field correction,
- field-of-view cropping,
- skull stripping,
- MNI152 template-ə 2 mm resolution ilə 12-degree-of-freedom affine registration,
- trilinear interpolation,
- tissue segmentation,
- white-matter partial-volume mask yaradılması,
- white-matter mean intensity hesablanması,
- Shinohara normalization,
- registered 3D volume-dan axial 2D slices çıxarılması
şəklində izah olunur.
Bütün model inputs:
\[ 64\times64 \]
pixel resolution-a resize edilmiş və:
\[ [0,1] \]
aralığına normalize edilmişdir.
OASIS sinifləri niyə real CDR diaqnozu kimi oxunmamalıdır?
Mənbə OASIS-derived labels-ı üç qrupa çevirir:
- Non Demented,
- Very Mild Dementia,
- Mild/Moderate Dementia.
Müəlliflər bu labels-ın formal clinical CDR assessment olmadığını açıq şəkildə bildirirlər.
Yalnız severity descriptions üzərindən təxmini uyğunlaşdırma aparılmışdır:
- Non Demented ≈ CDR 0,
- Very Mild Dementia ≈ CDR 0.5,
- Mild/Moderate Dementia ≈ CDR ≥ 1.
Moderate Dementia sinfi 500-dən az sample ehtiva etdiyi üçün Mild Dementia ilə birləşdirilmişdir. Majority class da digər classes-ın ölçüsünə downsample edilərək üç-sinifli task balanslaşdırılmışdır.
Buna görə tədqiqat birbaşa formal CDR clinical scoring algorithm öyrətməmişdir.
EMDpos Nəyi Ölçür?
\(EMD_{pos}\), HQiCNN və klassik CNN üçün normallaşdırılmış müsbət SHAP pixel distributions-ı ikiölçülü Earth Mover's Distance ilə müqayisə edən izah edilə bilənlik metrikidir; dəyər azaldıqca iki modelin düzgün təsnifatı dəstəkləyən görüntü bölgələrinin məkan paylanması bir-birinə daha çox yaxınlaşır.
SHAP nədir?
SHAP model prediction-a input features-ın hansı istiqamətdə və hansı böyüklükdə töhfə verdiyini Shapley-value yanaşması ilə izah edən model-agnostic explainability framework-dür.
Image model-də feature pixel və ya pixel region kimi şərh edilə bilər. Müsbət SHAP value müvafiq pixel-in qiymətləndirilən output-u dəstəkləyən contribution göstərdiyini bildirir.
Bu izah feature attribution-dır; təkbaşına biological causality və ya clinical biomarker sübutu deyil.
\(|SHAP|IoU\) necə istifadə olunur?
Mənbə hər model üçün mütləq SHAP values-ın ən yüksək:
\[ 10\% \]
hissəsini seçərək iki region-of-interest mask:
\[ R_A,\ R_B \]
yaradır.
Mənbə Figure 6-da:
- qırmızı: yalnız HQiCNN-in güclü attribution verdiyi bölgələr,
- mavi: yalnız CNN-in güclü attribution verdiyi bölgələr,
- yaşıl: iki modelin ortaq gördüyü bölgələr
kimi təqdim edilir.
Mənbə \(|SHAP|IoU\) üçün ayrıca scalar Intersection-over-Union formulunu nömrələnmiş tənlik şəklində vermir; metod əsasən üst-%10 masks arasındakı spatial intersection-ı görünən etmək üçün istifadə olunur.
\(EMD_{pos}\) formulu
Əvvəlcə iki modelin positive SHAP values-ı normallaşdırılaraq iki-dimensional probability distributions əldə edilir.
Mənbə Tənlik (3):
\[ EMD_{pos} = \min_{\gamma\in\Pi(\omega_{HQiCNN}\mid\omega_{CNN})} \sum_{i,j} \gamma_{i,j} \left\| p_i-p_j \right\|_2. \tag{3} \]
Burada:
- \(\omega_{HQiCNN}\) və \(\omega_{CNN}\): normallaşdırılmış positive SHAP spatial distributions,
- \(\gamma_{i,j}\): pixel location \(i\)-dən location \(j\)-yə daşınan probability mass miqdarı,
- \(p_i,p_j\): normalized pixel coordinates,
- \(\|\cdot\|_2\): Euclidean distance,
- \(\Pi\): iki distributions-ın marginals-ını qoruyan admissible transport plans çoxluğunu təmsil edən mənbə göstərimidir.
Mənbə pixel coordinate-u:
\[ p= \left( \frac{y}{64}, \frac{x}{64} \right) \]
kimi normallaşdırır.
64×64 image:
\[ 64\times64=4096 \]
grid point ehtiva edir.
EMD-nin fiziki metr, millimetr və ya pixel vahidi yoxdur; coordinate normalization səbəbilə burada ölçüsüz spatial-distance metric kimi istifadə olunur.
\(EMD_{pos}\) aşağı və yuxarı həddi
Identical distributions üçün:
\[ EMD_{pos}=0. \]
Mənbə maksimum həndəsi ayrılığı image grid-in qarşılıqlı corners-ı üzərindən hesablayır:
\[ D = \sqrt{ \left(\frac{63}{64}\right)^2 + \left(\frac{63}{64}\right)^2 } = \frac{63}{64}\sqrt2 \approx1.3921. \tag{4} \]
Beləliklə:
\[ 0 \le EMD_{pos} \le \frac{63}{64}\sqrt2 \approx1.3921. \tag{5} \]
kimi verilir.
Aşağı dəyər iki modelin positive-SHAP spatial distribution-larının oxşar olduğunu; yüksək dəyər isə probability mass-ın daha uzağa daşınmalı olduğunu bildirir.
Tədqiqatın Metodu və Nəticələri
OCT hyperparameter təcrübə dizaynı
| Hyperparameter | Dəyərlər | Seçim sayı |
|---|---|---|
| Training size | 200, 400, 800, 1000, 1200, 1600, 2000, 12000, 30000 | 9 |
| Learning rate | 10−2, 10−3, 10−4 | 3 |
| Batch size | 8, 16, 32 | 3 |
| Quantum circuit | Entangled, Not Entangled | 2 |
| Observable set | O1, O2, O3 | 3 |
| Random seed | 10 randomly selected seeds | 10 |
Mənbə ümumi OCT hyperparameter executions sayını:
\[ 9\times3\times10 + 3\times10 + 2\times8\times10 + 3\times6\times10 = 640 \]
kimi verir.
Bu 640 rəqəmi Table 1-dəki OCT hyperparameter proqramına aiddir. OASIS robustness experiment bu cəmin içinə ayrıca açıq formula ilə əlavə edilməmişdir.
Training ayarları
| Ayar | Mənbədə verilən dəyər / metod |
|---|---|
| Framework | PyTorch |
| Quantum emulation | Native PyTorch functions |
| Loss | Cross-entropy |
| Output softmax | İstifadə olunmur; cross-entropy unnormalized logits üzərində işləyir |
| Gradient handling | GradScaler |
| Maksimum epoch | 100 |
| Early-stopping patience | 8 epoch |
| Learning-rate scheduler patience | 3 epoch |
| Learning-rate reduction factor | 0.3 |
| Random repetitions | 10 seed |
Table 2: learning rate və training size nəticələri
Aşağıdakı dəyərlər mənbə Table 2-də 10 random seed üzərində bildirilən mean test accuracy ± standard deviation dəyərləridir.
| Model | LR | 200 | 400 | 800 | 1000 | 1200 | 1600 | 2000 | 12000 | 30000 |
|---|---|---|---|---|---|---|---|---|---|---|
| CNN | 0.01 | 0.436 ± 0.104 | 0.495 ± 0.135 | 0.575 ± 0.049 | 0.670 ± 0.082 | 0.698 ± 0.098 | 0.749 ± 0.083 | 0.843 ± 0.020 | 0.929 ± 0.015 | 0.930 ± 0.010 |
| CNN | 0.001 | 0.467 ± 0.098 | 0.535 ± 0.125 | 0.633 ± 0.058 | 0.661 ± 0.074 | 0.734 ± 0.055 | 0.751 ± 0.076 | 0.774 ± 0.127 | 0.924 ± 0.010 | 0.937 ± 0.006 |
| CNN | 0.0001 | 0.311 ± 0.069 | 0.358 ± 0.078 | 0.550 ± 0.092 | 0.518 ± 0.132 | 0.628 ± 0.068 | 0.643 ± 0.049 | 0.672 ± 0.042 | 0.885 ± 0.011 | 0.919 ± 0.006 |
| HQiCNN | 0.01 | 0.325 ± 0.094 | 0.468 ± 0.105 | 0.551 ± 0.099 | 0.638 ± 0.092 | 0.714 ± 0.078 | 0.800 ± 0.032 | 0.818 ± 0.066 | 0.930 ± 0.009 | 0.929 ± 0.012 |
| HQiCNN | 0.001 | 0.448 ± 0.082 | 0.559 ± 0.076 | 0.688 ± 0.051 | 0.745 ± 0.074 | 0.769 ± 0.028 | 0.795 ± 0.055 | 0.828 ± 0.034 | 0.920 ± 0.008 | 0.931 ± 0.008 |
| HQiCNN | 0.0001 | 0.347 ± 0.089 | 0.414 ± 0.085 | 0.542 ± 0.080 | 0.582 ± 0.053 | 0.600 ± 0.051 | 0.653 ± 0.037 | 0.684 ± 0.058 | 0.897 ± 0.008 | 0.920 ± 0.008 |
Training size nəticəsi
Hər iki modeldə də ümumi meyl training data artdıqca test accuracy-nin yüksəlməsidir.
Mənbə xüsusilə təxminən:
\[ 12\,000 \]
sample-dan sonra gains-in daha yavaş hala gəldiyini və saturation/diminishing-returns davranışının başladığını bildirir.
HQiCNN-in ən nəzərəçarpan nisbi üstünlükləri small-to-intermediate data regime-in ortasında görünür. Buna qarşılıq ən böyük training set üçün klassik CNN:
\[ 0.937\pm0.006 \]
ilə tədqiqatdakı ən yüksək qlobal OCT accuracy-yə çatmışdır.
HQiCNN-in 30000 sample, learning rate 0.001 dəyəri:
\[ 0.931\pm0.008 \]
kimi bildirilir.
Beləliklə tədqiqat “HQiCNN hər məlumat ölçüsündə CNN-dən daha yaxşıdır” nəticəsini dəstəkləmir.
Learning rate nəticəsi
Mənbə:
\[ 10^{-3} \]
learning rate-in ümumilikdə accuracy və optimization stability arasında ən balanslı seçim olduğunu bildirir.
\(10^{-2}\) bəzi configurations-da yüksək performans yaratsa da seed/configuration variation daha böyükdür.
\[ 10^{-4} \]
isə əksər hallarda daha aşağı accuracy yaratmış və mənbə bunu optimization-ın allocated training budget daxilində həddindən artıq conservative qalması ilə əlaqələndirmişdir.
Bu nəticə yalnız burada istifadə olunan architectures, datasets və training budget üçün keçərlidir; bütün neural networks üçün universal optimum learning rate deyil.
Figure 3-ün interpolation xəbərdarlığı
Mənbə small/intermediate training-size bölgəsindəki HQiCNN–CNN mean-accuracy difference dəyərlərini heatmap ilə təqdim edir.
Heatmap-in girişləri discrete measured configurations-dır; mənbə caption-ı vizualı daha smooth etmək üçün interpolation istifadə edildiyini açıq şəkildə bildirir.
Buna görə Verianla interpolated color field-dan yeni dəqiq numeric values oxumamış, mənbə Table 2-dəki real discrete values-ı source-of-truth kimi qorumuşdur.
Batch size nəticəsi
Training size 1000 üçün batch sizes:
\[ 8,\ 16,\ 32 \]
müqayisə edilmişdir.
Mənbənin Figure 4(a) şərhi HQiCNN-in üç batch size-ın hamısında mean accuracy və stability baxımından klassik CNN-dən daha yaxşı olduğunu bildirir.
Figure 4(a)-da individual box-plot values ayrıca numeric table kimi verilmədiyinə görə Verianla bar/box positions-dan dəqiq yeni rəqəmlər yaratmır.
Entanglement nəticəsi
Entangled circuit CNOT layer ehtiva edir, non-entangled model isə eyni entangling gates olmadan işləyir.
Mənbənin nəticəsi:
- orta hesabla non-entangled configuration daha yaxşı nəticə verir,
- 1000 və 1200 training samples üçün entangled configuration daha accurate və stable görünür,
- ümumi güclü performans üçün entanglement zəruri deyil.
Mənbə həmçinin output observables-ın local olmasının entanglement tərəfindən yaradılan higher-order correlations-ın hamısını görünən etməyə biləcəyini mümkün izah kimi bildirir.
Bu sübut olunmuş mexanizm deyil; müəlliflərin nəticə şərhidir.
Niyə non-entangled dövrə miqyaslana bilmə baxımından vacibdir?
Mənbə separable circuit classical emulation complexity-sinin qubit sayı ilə linear miqyaslana bildiyini; entangled circuit simulation-ın isə ümumi halda exponential complexity yarada bildiyini bildirir.
Buna görə oxşar classification accuracy entanglement olmadan əldə edilə bilirsə daha böyük emulated circuit-lərə keçid computational baxımdan daha tətbiqolunan ola bilər.
Bu nəticə real quantum hardware üçün birbaşa “entanglement istifadə etməyin” tövsiyəsi deyil.
Observable sets
Mənbə üç nested observable set təyin edir.
Mənbə göstərimi ilə:
\[ O_1 = \{\Gamma_i\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i\in\{1,4\}. \]
\[ O_2 = O_1 \cup \{\Gamma_i\Gamma_j\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j\in\{1,4\}, \quad i\neq j. \]
\[ O_3 = O_1 \cup O_2 \cup \{\Gamma_i\Gamma_j\Gamma_k\}, \qquad \Gamma\in\{X,Y,Z\}, \qquad i,j,k\in\{1,4\}, \quad i\neq j\neq k. \]
Notasiya xəbərdarlığı: Mənbə mətni dörd-qubit circuit üzərində local, pairwise və triple observables təyin etdiyini açıq şəkildə deyərkən indeks çoxluqlarını literal olaraq \(\{1,4\}\) formasında çap edir. Bu göstərim yalnız iki indeks ehtiva etdiyi üçün kontekstlə tam uyğun görünmür. Verianla göstərimi \(\{1,\ldots,4\}\) formasına səssizcə dəyişdirməmişdir.
Observable-set nəticəsi
Small və intermediate training sizes-da \(O_1\), \(O_2\) və \(O_3\) arasında nəzərəçarpan performans fərqi görünmür.
Mənbə bunu low-data regime-də modelin feature-space expressivity-dən əvvəl training data miqdarı ilə məhdudlaşması kimi şərh edir.
Large-data regime-də, xüsusilə:
\[ 12\,000 \quad\text{ve}\quad 30\,000 \]
training samples üçün daha zəngin observable sets slightly higher accuracy yaradır.
Mənbə bu nəticəni hardware baxımından da müzakirə edir: non-commuting əlavə observables real hardware-də əlavə measurement budget tələb edir. Emulated setting-də isə bu physical shot overhead yoxdur.
Figure 4(c) mənbədaxili caption xətası
Figure 4(c)-nin qrafiki və ətraf mətni \(O_1,O_2,O_3\) observable-set comparison-ını göstərir.
Buna qarşılıq subfigure caption mənbədə yenidən:
“Accuracy comparison ... for different batch sizes”
mənasına gələn ifadədən istifadə edir.
Buna görə Verianla Figure 4(c)-ni observable-set experiment kimi, əsas mətnin izahı və graph legend ilə uyğun şəkildə təsvir edir; mənbə caption-dakı uyğunsuzluğu da görünən saxlayır.
OASIS robustness nəticəsi
OCT experiments-də müəyyən edilmiş yaxşı-performing hyperparameters OASIS dementia classification probleminə köçürülmüşdür.
Mənbə Figure 5 üç training size göstərir:
\[ 999,\ 3000,\ 12000. \]
999 rəqəmi üç classes arasında balanced dataset yaratmaq tələbi səbəbilə istifadə edilmişdir.
Figure 5-in mənbə şərhi:
- kiçik training size-da HQiCNN klassik CNN-dən daha yaxşıdır,
- training size artdıqca fərq daralır,
- ən böyük training size-da klassik CNN cüzi şəkildə önə keçir.
Figure 5-in raw box-plot observations-ı numeric table kimi dərc edilmədiyinə görə burada qrafikdən yeni dəqiq accuracy dəyərləri çıxarılmamışdır.
Bu experiment müəlliflərin öz ifadəsi ilə robustness check-dir; clinical conclusion yaratmaq üçün dizayn edilməmişdir.
SHAP explainability nəticələri
OCT explainability experiment üçün hər modeldə 10 seeds arasından accuracy-si modelin mean accuracy dəyərinə ən yaxın seed seçilmişdir.
Mənbə attribution maps-də iki modelin xüsusilə:
- retinal pigment epithelium (RPE),
- retinal layers,
- disease-associated elevations/deformations
ətrafındakı anatomik sahələrə fokuslandığını bildirir.
1000 training sample şəraitində HQiCNN attribution maps daha localized və anatomically coherent görünərkən classical CNN daha fragmented attribution distribution göstərir.
30000 sample-a çıxıldıqda iki modelin attribution overlap-i nəzərəçarpan şəkildə artır.
Bu müşahidələr attribution pattern səviyyəsindədir; klinik diaqnostika mexanizminin səbəb-nəticə doğrulaması deyil.
\(EMD_{pos}\) nəticələri
| Training size | EMDpos | Şərh |
|---|---|---|
| 1000 | 0.066 ± 0.019 | İki model arasında aşağı, lakin 30000-sample vəziyyətinə görə daha böyük spatial fərq |
| 30000 | 0.045 ± 0.018 | Daha yüksək SHAP-spatial agreement |
Hər iki dəyər də theoretical upper bound:
\[ 1.3921 \]
dəyərinə nisbətən xeyli aşağıdır.
Mənbə həmçinin same-image EMD distributions-ın müxtəlif görüntülər arasındakı cross-image reference distribution-dan daha aşağı olduğunu bildirir.
Bu nəticə iki modelin eyni görüntü üzərində oxşar anatomik regions-a positive attribution verməsi ilə uyğundur.
Lakin aşağı \(EMD_{pos}\):
- modelin klinik baxımdan doğru səbəbli izah verdiyi,
- tapılan bölgənin validated biomarker olduğu,
- modelin xəstəlik patofiziologiyasını öyrəndiyi
mənasına gəlmir.
Bu Tədqiqat “Kvant Üstünlüyü” Göstərirmi?
Xeyr; tədqiqat real kvant avadanlığına qarşı klassik kompüter üstünlüyü və ya hesablama mürəkkəbliyi mənasında quantum advantage göstərmir. HQiCNN-in ara qatı klassik kompüterdə emulyasiya edilmişdir və nəticələr yalnız müəyyən məlumat/optimizasiya rejimlərində bu kvantdan ilhamlanan təsvirin parameter-controlled klassik CNN-ə alternativ ola bildiyini göstərir.
Tədqiqatın nəticə bölməsinin ən mühüm cümlələrindən biri HQiCNN üstünlüyünün yalnız “quantum operations əlavə edilmiş olmasından” qaynaqlanmadığını bildirir.
Performans:
- training data miqdarı,
- learning rate və optimization dynamics,
- entanglement seçimi,
- observable set
ilə birlikdə dəyişir.
Buna görə “kvant layer hər vəziyyətdə daha yaxşı representation öyrənir” kimi ümumi nəticə mənbə tərəfindən dəstəklənmir.
Tədqiqatın dəstəklədiyi nəticələr
- Dörd-qubitlik emulyasiya edilmiş quantum circuit klassik CNN-in ara dense layer-ına alternativ representation layer kimi istifadə oluna bilər.
- HQiCNN orta ölçülü bəzi training-data regimes-də klassik CNN-dən daha yüksək test accuracy yaratmışdır.
- Klassik CNN ən böyük OCT training set-ində tədqiqatın ən yüksək ümumi accuracy dəyərinə çatmışdır.
- Learning rate ilə training size-ın qarşılıqlı təsiri iki memarlıq arasındakı fərqə nəzərəçarpan təsir edir.
- 10−3 learning rate tədqiqat şəraitində ən balanslı/stabil seçim kimi bildirilmişdir.
- Batch sizes 8, 16 və 32 altında 1000-sample OCT experiment-də HQiCNN-in üstünlüyü qorunmuşdur.
- Entanglement ümumilikdə güclü performans üçün zəruri deyil.
- Large-data regime-də daha zəngin observable sets kiçik, lakin ölçülə bilən yaxşılaşma təmin etmişdir.
- OASIS robustness test-ində small-data → HQiCNN üstünlüyü, large-data → CNN üstünlüyünə çevrilən oxşar meyl görünmüşdür.
- \(|SHAP|IoU\) və \(EMD_{pos}\) iki modelin attribution patterns-ını müqayisə etmək üçün istifadə oluna bilmişdir.
- 1000 sample-da HQiCNN SHAP maps daha localized görünərkən 30000 sample-da modellərin attribution distributions-ı daha çox oxşarlaşmışdır.
Tədqiqatın dəstəkləmədiyi nəticələr
- Real kvant kompüterinin CNN-dən daha yaxşı tibbi görüntü təsnifatı apardığı göstərilməmişdir.
- Quantum computational advantage və ya asymptotic quantum speedup göstərilməmişdir.
- HQiCNN-in bütün datasets və bütün training sizes üçün CNN-dən üstün olduğu göstərilməmişdir.
- Entanglement-ın təsnifat uğuru üçün zəruri olduğu göstərilməmişdir.
- SHAP regions klinik olaraq doğrulanmış biomarker deyil.
- OASIS labels formal CDR clinical assessments deyil.
- Model xəstəxana istifadəsində prospective şəkildə doğrulanmamışdır.
- Müstəqil multicenter external clinical validation aparılmamışdır.
- Clinician reader study aparılmamışdır.
- MRI classification full 3D volume üzərindən aparılmamışdır; 2D slices istifadə edilmişdir.
- Training time, inference speed, memory use və ümumi computational efficiency benchmark edilməmişdir.
- Real quantum-hardware noise, decoherence və finite-shot measurement error sınaqdan keçirilməmişdir.
Əsas məhdudiyyətlər
- Quantum circuit yalnız dörd qubit və shallow emulated quruluşdadır.
- Real quantum hardware istifadə edilməmişdir.
- Hardware connectivity constraint yoxdur.
- Finite-shot measurement uncertainty yoxdur.
- Decoherence və ya gate noise yoxdur.
- OASIS robustness task 2D slices-a endirilmişdir.
- Independent external clinical dataset validation çatışmır.
- Clinician reader study çatışmır.
- Computational-cost comparison aparılmamışdır.
- Code public repository kimi verilməmiş; corresponding authors-dan reasonable request əsasında təmin edilə biləcəyi bildirilmişdir.
- “Parameter-matched” ifadəsi istifadə olunsa da manuscript iki modelin ümumi trainable-parameter saylarını açıq numeric comparison cədvəlində bildirmir.
Mənbədaxili mühüm hesabat qeydləri
- Figure 3 caption-da “red areas” əvəzinə “read areas” yazı xətası var; heatmap-in qırmızı bölgələri HQiCNN-in daha yaxşı olduğu sahələrdir.
- Figure 3 discrete configurations-dan yaradılmış olsa da vizual smoothness üçün interpolation istifadə edir.
- Figure 4(c) observable-set müqayisəsi olduğu halda subfigure caption batch-size comparison kimi yazılmışdır.
- Observable indeksləri dörd-qubit kontekstində \(i,j,k\in\{1,4\}\) formasında çap edilmişdir; mənbə bunun literal set, yoxsa 1–4 indeks intervalının qısaldılmış/səhv yazımı olduğunu izah etmir.
- “Parameter-matched” ifadəsi mənbədə istifadə olunur, lakin total trainable-parameter counts ayrıca sayısal cədvəldə verilmir.
Mənbə və Metod Qeydi
Özgün başlıq: Do emulated quantum circuits change what CNNs look at? Performance and explainability comparison in medical image classification
Müəlliflər: Guillermo Rubiños Rodríguez; Martín Ottavianelli; Mateo Alonso; Gonzalo Blázquez Gil; Boris-Stephan Rauchmann; Pablo Díez-Valle; Sergio Altares-López.
Müəllif sırası: Mənbədəki sıra olduğu kimi qorunmuşdur.
Bərabər töhfə: Pablo Díez-Valle və Sergio Altares-López mənbədə bərabər töhfəli müəlliflər kimi işarələnmişdir.
Corresponding author: Sergio Altares-López.
Corresponding-author e-posta: slopez@med.lmu.de
Qurum 1: Instituto Tecnológico de Galicia, Cantón Grande 9, Planta 3, 15003 A Coruña, Spain.
Qurum 2: Centro Singular de Investigación en Tecnoloxías Intelixentes (CiTIUS), Universidade de Santiago de Compostela, Santiago de Compostela, 15782, Spain.
Qurum 3: Department of Neuroradiology, LMU University Hospital, Ludwig Maximilian University of Munich, Marchioninistraße 15, 81377 Munich, Germany.
Qurum 4: Department of Psychiatry and Psychotherapy, LMU University Hospital, LMU Munich, Nussbaumstraße 7, 80336 Munich, Germany.
Mənbə növü: Quantum machine learning / medical image classification sahəsində hesablama preprint-i.
Platforma: arXiv.
arXiv: arXiv:2607.21186v1 [quant-ph].
Göndərilmə tarixi: 23 iyul 2026.
DOI: 10.48550/arXiv.2607.21186.
Hakemlik statusu: Araşdırılan mənbə arXiv preprint versiyasıdır. Biblioqrafik doğrulama zamanı eyni tədqiqat üçün ayrıca və doğrulanmış yekun hakemli jurnal versiyası müəyyən edilməmişdir.
Lisenziya: arXiv qeyd metadata-sında arXiv non-exclusive distribution license göstərilir; Creative Commons lisenziyası olduğu fərz edilməmişdir.
Səhifə sayı: 17.
Şəkil sayı: 6.
Cədvəl sayı: 2.
Əsas tədqiqat növü: Mövcud medical-image datasets üzərində supervised machine-learning benchmark və explainability analysis.
Quantum tədqiqat növü: Real quantum hardware deyil; dörd-qubitlik parametrik circuit-in classical emulation-ı.
Quantum implementation: Native PyTorch operations; dedicated quantum-computing framework istifadə edilməmişdir.
Gradient metodu: Emulated circuit üçün automatic differentiation/backpropagation; physical-circuit parameter-shift measurement istifadə edilməmişdir.
Classical baseline: Ortaq convolutional backbone + \(4\rightarrow12\) ReLU dense layer.
HQiCNN branch: Ortaq convolutional backbone + 4-qubit emulated parameterized quantum circuit + 12 observable output.
Input preprocessing: 2π·sigmoid(v), remainder(v,2π) və no-transform müqayisə edilmiş; qalan tədqiqatda scaled sigmoid seçilmişdir.
Əsas OCT verilənlər dəsti: 84,495 JPEG retinal OCT image; NORMAL, CNV, DME və DRUSEN sinifləri.
Robustness verilənlər dəsti: OASIS-1-derived structural MRI; mənbə 416 subject, 18–96 yaş aralığı bildirir.
OASIS task sinifləri: Non Demented, Very Mild Dementia, Mild/Moderate Dementia.
CDR sərhədi: OASIS labels formal clinical CDR assessment deyil; mənbə yalnız approximately corresponding CDR stages şəklində əlaqə qurur.
Input resolution: 64 × 64 pixel.
Input normalization: [0,1].
OCT hyperparameter executions: 640.
Random seeds: 10.
Maximum epochs: 100.
Early stopping patience: 8 epoch.
LR scheduler patience: 3 epoch.
LR reduction factor: 0.3.
Loss: Cross-entropy.
OCT highest reported accuracy: CNN, learning rate 0.001, 30000 training samples: \(0.937\pm0.006\).
Explainability metodları: \(|SHAP|IoU\) və \(EMD_{pos}\).
EMDpos: 1000 samples üçün \(0.066\pm0.019\); 30000 samples üçün \(0.045\pm0.018\).
EMDpos theoretical range: \(0\le EMD_{pos}\le(63/64)\sqrt2\approx1.3921\).
External clinical validation: Yoxdur.
Clinician reader study: Yoxdur.
MRI dimensionality: Full 3D classification əvəzinə processed 2D axial slices istifadə edilmişdir.
Computational-cost analysis: Training time, inference efficiency və memory requirements sistemli şəkildə benchmark edilməmişdir.
Data availability: OCT data mənbə istinadındakı mövcud dataset-ə; OASIS1-derived images və preprocessing data mənbədə göstərilən dataset mənbələrinə əsaslanır.
Code availability: Corresponding authors-dan reasonable request əsasında təmin edilə biləcəyi bildirilmişdir; mənbə public code repository vermir.
Maliyyələşdirmə: PESL-Stiftung-Alzheimer 2026, Bayern, Germany, registered project 80765114 Pesl-Alzheimer-Stift; Principal Investigator Dr.-Ing. Sergio Altares-López. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Gonzalo Blázquez Gil və Pablo Díez-Valle həmçinin CDTI CERVERA Research Programme tərəfindən maliyyələşdirilən ARQADE (CER-20251019) dəstəyini qəbul edirlər.
Müəllif töhfələri: Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle və Sergio Altares-López experiments-ı dizayn etmiş və planlaşdırmışdır. Guillermo Rubiños Rodríguez və Martín Ottavianelli experiments-ı həyata keçirmişdir. Gonzalo Blázquez Gil, Sergio Altares-López və Boris-Stephan Rauchmann funding təmin etmişdir. Guillermo Rubiños Rodríguez, Martín Ottavianelli, Mateo Alonso, Pablo Díez-Valle və Sergio Altares-López results interpretation-a töhfə vermişdir. Guillermo Rubiños Rodríguez və Sergio Altares-López manuscript writing-də aparıcı rol oynamışdır. Bütün müəlliflər critical feedback vermiş və tədqiqat, analiz və manuscript-in formalaşmasına töhfə vermişdir.
Maraqların toqquşması: Müəlliflər competing financial interests olmadığını bəyan edirlər.
Ayrıca ethics statement: Yüklənmiş preprint-də ayrıca institutional-review/ethics-approval statement bölməsi görünmür. Tədqiqat yeni patient recruitment əvəzinə mövcud datasets üzərində computational analysis aparır; bunun xaricində etik təsdiq statusu mənbə adından fərziyyə ilə tamamlanmamışdır.
Təkrarlanma yoxlaması: Bu exact başlıq və arXiv:2607.21186 üçün əvvəlki Verianla emal qeydi olmadığından yeni məqalə kimi hazırlanmışdır.
Mənbədaxili hesabat qeydləri: Figure 4(c) caption observable-set graph-ını batch-size comparison kimi etiketləyir; observable-index notation-da \(\{1,4\}\) istifadəsi kontekst baxımından qeyri-müəyyəndir; Figure 3 interpolation istifadə edir; total model parameter counts ayrıca numeric table kimi verilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib