


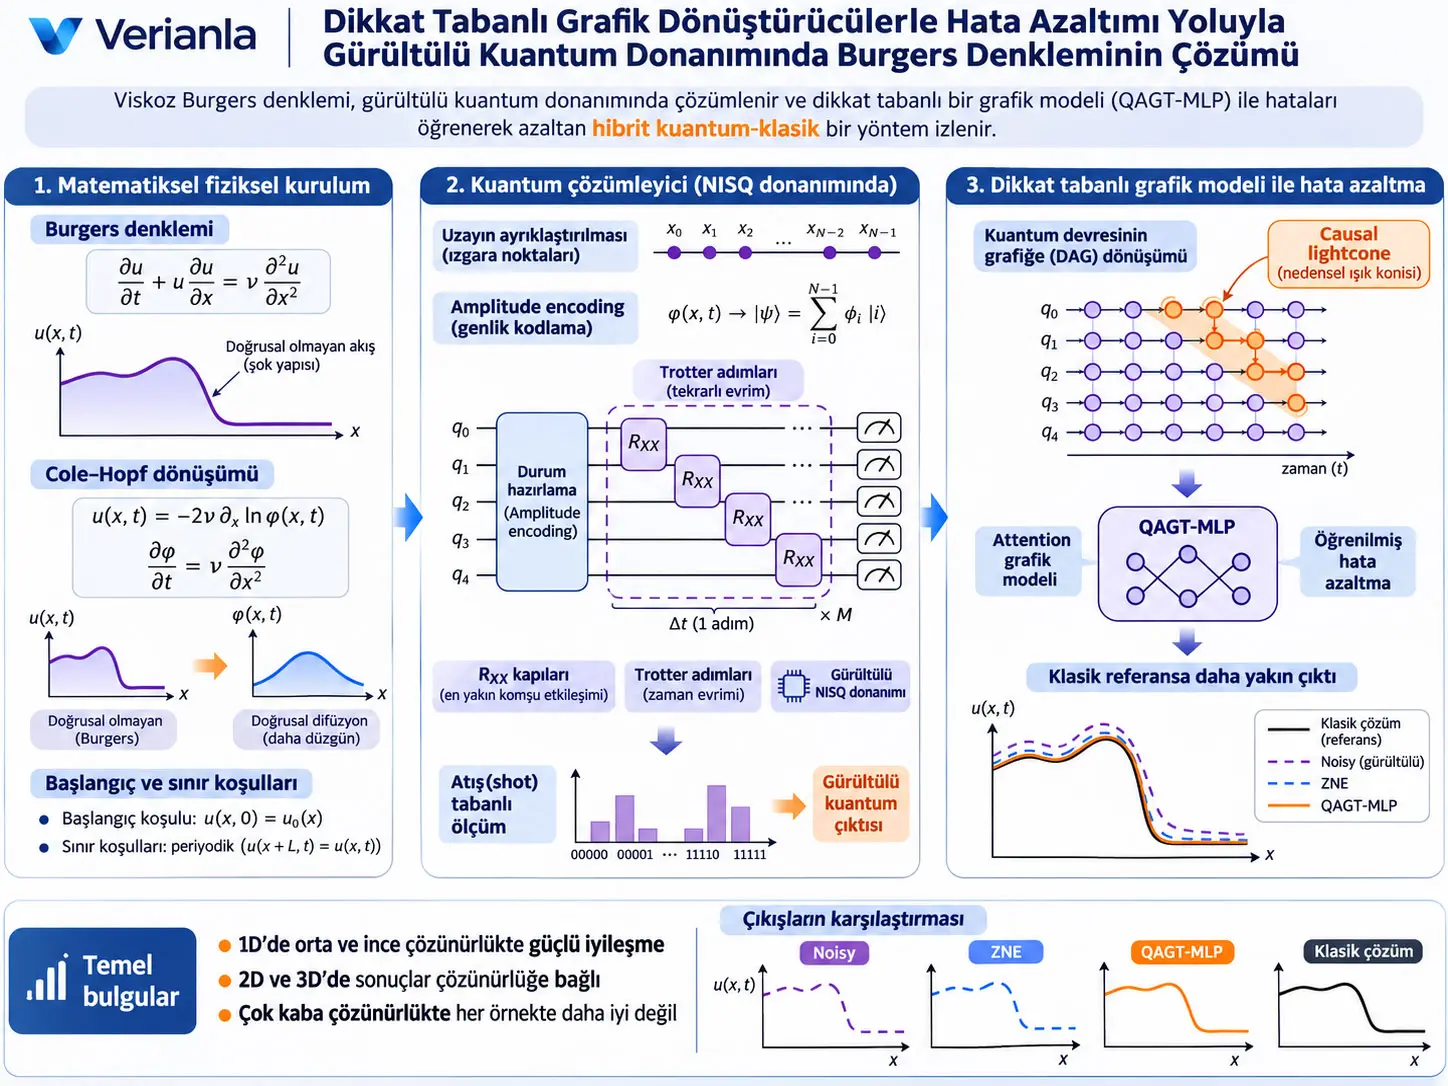
Bu çalışma, viskoz Burgers denklemini gürültülü ara ölçekli kuantum (Noisy Intermediate-Scale Quantum, NISQ) donanımında yaklaşık olarak çözmeye çalışan ve kuantum kaynaklı hataları klasik bir dikkat tabanlı grafik sinir ağıyla azaltan hibrit kuantum-klasik bir hesaplama çerçevesidir. Yöntemde doğrusal olmayan Burgers denklemi önce Cole–Hopf dönüşümü ile doğrusal bir difüzyon problemine dönüştürülür. Elde edilen ayrık Cole–Hopf alanı kuantum durumunun genliklarına kodlanır; zaman evrimi en yakın komşu iki-qubit \(R_{XX}\) kapılarından oluşan Trotterize devrelerle yaklaşık olarak gerçekleştirilir. Kuantum ölçümlerinden yeniden oluşturulan hız alanları daha sonra klasik yüksek doğruluklu Krylov çözümüyle karşılaştırılır. Son aşamada QAGT-MLP olarak adlandırılan attention tabanlı grafik modeli, kuantum devresinin yapısını, nedensel lightcone bilgisini, küresel devre özelliklerini ve gürültülü çıktıları kullanarak klasik referansa daha yakın bir düzeltilmiş alan üretmeyi öğrenir.
Çalışma yalnız kuantum simülatörü kullanmamaktadır. Gürültülü Qiskit Aer simülasyonlarının yanında gerçek IBM kuantum donanımı üzerinde de testler yapılmıştır. Kuantum sonuçları üç ana ölçütle değerlendirilir: klasik ve kuantum hız alanları arasındaki \(L_2\) hata, en dik hız gradyanının konumundan belirlenen şok konumu ve viskoz gradyanlardan hesaplanan dissipasyon oranı. Geleneksel bir kuantum hata azaltma yöntemi olan Zero-Noise Extrapolation (ZNE) de karşılaştırma tabanı olarak kullanılır.
Kaynağın 1D özet sonuçlarında QAGT-MLP'nin başarısı çözünürlüğe güçlü biçimde bağlıdır. Yüksek viskozite grubunda kaynak Tablo 1'e göre simülasyona karşı ortalama kazanç \(N=16\), \(N=32\) ve \(N=64\) için sırasıyla yaklaşık %39,6, %51,5 ve %62,6; gerçek donanım çıktısına karşı ise yaklaşık %40,2, %56,0 ve %71,0 olarak raporlanır. Küçük viskozite grubunda kazanımlar daha düşüktür fakat kaynak Tablo 2'de yine pozitiftir. Bununla birlikte bazı bireysel \(N=16\) örneklerinde model hatayı azaltmak yerine büyütmüştür. 2D 16×16 durumda MAE açısından −%5,86, 3D 4×4×4 durumda ise −%3,26 iyileşme raporlanması, yöntemin her çözünürlükte ve her problemde otomatik olarak üstün olmadığını açıkça göstermektedir.
Bu sonuçlar kuantum bilgisayarın klasik CFD'den daha hızlı olduğu anlamına gelmez. Çalışma bir hesaplama karmaşıklığı üstünlüğü, wall-clock hız üstünlüğü veya klasik çözücüye karşı “quantum advantage” göstermemektedir. Klasik Cole–Hopf/Krylov çözümü burada yüksek doğruluklu referans ve makine öğrenmesi hedefi olarak kullanılmaktadır. Çalışmanın gösterdiği temel sonuç, belirli NISQ Burgers problem sınıflarında kuantum gürültüsüyle bozulmuş çözümlerin devre yapısını da kullanan öğrenilmiş bir klasik düzelticiyle klasik referansa önemli ölçüde yaklaştırılabildiğidir.
Önce temel kavram: Burgers denklemi nedir?
Burgers denklemi, doğrusal olmayan taşınım ile viskoz difüzyonu aynı matematiksel model içinde birleştiren klasik bir kısmi diferansiyel denklemdir. Akışkanlar mekaniğindeki Navier–Stokes denklemlerinin bütün karmaşıklığını taşımaz; ancak doğrusal olmayan adveksiyon, keskin gradyan ve şok-benzeri yapı oluşumu gibi önemli davranışları içerdiği için sayısal yöntemlerin ve kuantum PDE çözücülerinin sınanmasında kullanışlıdır.
Çalışmanın 1D viskoz Burgers denklemi:
\[ \frac{\partial u}{\partial t} + u\frac{\partial u}{\partial x} = \nu\frac{\partial^2u}{\partial x^2}, \qquad \nu>0 \]
Formül neyi hesaplar? \(u(x,t)\) hız alanının uzay ve zaman içindeki değişimini tanımlar.
\(u(x,t)\): Kaynakta boyutsuz hız alanıdır.
\(x\): Uzaysal konumdur; ana 1D formülasyonda \(x\in[0,1]\).
\(t\): Zamandır.
\(\nu\): Pozitif viskozite parametresidir.
\(\partial u/\partial t\): Hızın zamana göre değişimini gösterir.
\(u\,\partial u/\partial x\): Doğrusal olmayan adveksiyon/taşınım terimidir. “Doğrusal olmayan” denmesinin temel nedeni, bilinmeyen \(u\)'nun kendi uzaysal türeviyle çarpılmasıdır.
\(\nu\,\partial^2u/\partial x^2\): Viskoz difüzyon terimidir. Uzaydaki keskin değişimleri yumuşatmaya eğilimlidir.
Fiziksel olarak adveksiyon terimi keskinleşmeyi, viskoz terim ise yumuşamayı temsil eder. Küçük \(\nu\) değerlerinde keskin gradyanların oluşması daha kolaydır; daha büyük \(\nu\) değerlerinde difüzyon etkisi güçlenir. Bu, kaynaktaki parametre taramasında küçük viskozite durumlarının daha zor problem rejimi oluşturmasının nedenidir.
Başlangıç ve sınır koşulları
Kaynak ana yöntem bölümünde iki uçta Dirichlet hız sınır koşullarını kullanır:
\[ u(0,t)=u_L,\qquad u(1,t)=u_R,\qquad t\ge0 \]
Başlangıç alanı:
\[ u(x,0)=u_0(x) \]
ve sayısal deneylerde tipik örnek olarak:
\[ u_0(x)=\sin(\pi x) \]
verilir. Parametre taramasında sol sınır \(u_L\) değiştirilirken sağ sınır \(u_R=0\) tutulur.
Kaynak içi tutarsızlık: Ana metin yukarıdaki \(+\sin(\pi x)\) başlangıç koşulunu ve iki uçta Dirichlet hız sınırlarını tarif eder. Kaynağın Ek Şekil 12 çiziminde ise başlangıç fonksiyonunun işareti ve bazı “open boundary” etiketleri ana metindeki tanımla tam olarak uyuşmamaktadır. Verianla aktarımında ana denklem sessizce değiştirilmemiştir ve şekil–metin farkı bir kaynak içi tutarsızlık olarak korunmuştur.
Cole–Hopf dönüşümü Burgers denklemini neden önemli ölçüde basitleştiriyor?
Cole–Hopf dönüşümü, Burgers denklemindeki doğrusal olmayan \(u\,u_x\) terimini doğrudan kuantum devresinde çözmeye çalışmak yerine yeni bir \(\phi(x,t)\) alanı tanımlayarak problemi doğrusal difüzyon denklemine dönüştürür; bu sayede çalışma kuantum tarafında doğrusal bir evrimi yaklaşık olarak temsil etmeye çalışabilir.
Cole–Hopf dönüşümü adım adım
Kaynak yeni bir skaler alan \(\phi(x,t)\) tanımlar:
\[ u(x,t) = -2\nu\frac{\partial}{\partial x}\ln\phi(x,t) = -2\nu\frac{\phi_x(x,t)}{\phi(x,t)} \]
Bu ifade ilk bakışta karmaşık görünse de temel fikir şudur: hız alanı \(u\), doğrudan kuantum durumuna kodlanmak yerine önce \(\phi\) adı verilen yardımcı alana dönüştürülür.
Dönüşüm Burgers denklemine yerleştirildiğinde \(\phi\) için doğrusal ısı/difüzyon denklemi elde edilir:
\[ \frac{\partial\phi}{\partial t} = \nu\frac{\partial^2\phi}{\partial x^2} \]
Böylece problem:
- önce: doğrusal olmayan Burgers denklemi,
- sonra: doğrusal difüzyon denklemi
şeklinde dönüştürülür.
Başlangıçtaki \(\phi\) alanı \(u_0(x)\)'ten şu ilişkiyle elde edilir:
\[ \phi_0(x) = \exp\left[ -\frac{1}{2\nu} \int_0^x u_0(y)\,dy \right] \]
Kaynak, genel bir çarpımsal normalizasyon sabitinin \(u\)'nun yeniden oluşturulmasını etkilemediğini belirtir. Bunun nedeni \(u\)'nun \(\phi_x/\phi\) oranından hesaplanmasıdır; \(\phi\) sabit bir katsayıyla çarpılırsa aynı katsayı pay ve paydada bulunur.
Uzay nasıl sayısallaştırılıyor?
Uzaysal alan \([0,1]\), \(N\) eşit aralıklı grid noktasına bölünür:
\[ x_j=j\Delta x, \qquad j=0,1,\ldots,N-1, \qquad \Delta x=\frac{1}{N-1} \]
Burada \(\Delta x\), komşu grid noktaları arasındaki uzaysal mesafedir.
İkinci türev standart ikinci mertebe merkezi fark ile yaklaşık hesaplanır:
\[ \frac{\partial^2\phi}{\partial x^2}(x_j,t) \approx \frac{ \phi_{j-1}(t)-2\phi_j(t)+\phi_{j+1}(t) }{\Delta x^2} \]
Bu ayrıklaştırma, sürekli PDE'yi sonlu boyutlu doğrusal ODE sistemine dönüştürür:
\[ \frac{d\boldsymbol{\phi}}{dt} = \nu L\boldsymbol{\phi} \]
\(L\), ayrık Laplasyen matrisidir. İç noktalar için temel katsayılar:
\[ L_{j,j}=-\frac{2}{\Delta x^2}, \qquad L_{j,j-1}=L_{j,j+1}=\frac{1}{\Delta x^2} \]
şeklindedir.
Sınırların \(\phi\) yerine \(u\) üzerinden uygulanması
Kaynak, Dirichlet sınır koşullarını doğrudan \(\phi\)'nin uç değerlerini evrimleştirerek değil, hız alanı \(u\) üzerinden uygular:
\[ u_0(t)=u_L, \qquad u_{N-1}(t)=u_R \]
ve ayrık Laplasyen matrisinin ilk ve son satırlarını sıfırlar:
\[ L_{0,j}=0, \qquad L_{N-1,j}=0 \]
Bu yaklaşımda iç \(\phi\) dinamiği ayrı ilerler; hız alanı yeniden oluşturulurken sınır hızları doğrudan atanır.
Başlangıç \(\phi\) vektörü nasıl hesaplanıyor?
Sürekli integral ayrık grid üzerinde trapez kuralıyla hesaplanır:
\[ I_j \approx \sum_{k=1}^{j} \frac{\Delta x}{2} \left[ u_0(x_k)+u_0(x_{k-1}) \right] \]
ardından:
\[ \phi_j(0) = \exp\left(-\frac{I_j}{2\nu}\right) \]
elde edilir. Vektör daha sonra kuantum durumuna hazırlanabilmesi için Öklid normu 1 olacak şekilde normalize edilir.
Klasik referans çözüm neden gerekli?
Ayrık sistemin formal çözümü:
\[ \boldsymbol{\phi}(t) = \exp(\nu tL)\boldsymbol{\phi}(0) \]
şeklindedir. Kaynak, bu matris üstelinin vektör üzerindeki etkisini QuTiP içindeki Krylov tabanlı bir propagator ile yaklaşıklar. Krylov altuzay yönteminde büyük ve seyrek bir matrisin tam üstelini açıkça oluşturmak yerine, üstel operatörün belirli bir başlangıç vektörü üzerindeki etkisi daha küçük bir altuzayda hesaplanır.
Zaman noktaları:
\[ t_n=n\Delta t, \qquad T=N_t\Delta t \]
olarak tanımlanır.
Klasik çözüm çalışmada yalnız “karşılaştırılacak başka bir yöntem” değildir. Aynı zamanda QAGT-MLP'nin supervised-learning hedefidir. Yani makine öğrenmesi modeli, gürültülü kuantum alanından klasik Krylov referans alanına giden dönüşümü öğrenmektedir.
Hız alanı \(\phi\)'den nasıl geri çıkarılıyor?
İç grid noktalarında Cole–Hopf ters dönüşümünün ayrık biçimi kullanılır:
\[ u_j(t_n) = -2\nu \frac{ \phi_{j+1}(t_n)-\phi_{j-1}(t_n) }{ 2\Delta x\, \max\big(\phi_j(t_n),\varepsilon\big) } \]
Kaynak örnek olarak:
\[ \varepsilon=10^{-10} \]
değerini verir. Bu küçük pozitif düzenleme sabiti, \(\phi_j\) çok küçüldüğünde paydanın sıfıra veya sayısal olarak tehlikeli derecede küçük değerlere yaklaşmasını engeller.
Çalışma doğruluğu hangi fiziksel ve sayısal ölçülerle izliyor?
1. Ayrık \(L_2\) hatası:
\[ E_{L_2}(t_n) = \left[ \sum_{j=0}^{N-1} \Delta x \left( u_j^{q}(t_n)-u_j^{ref}(t_n) \right)^2 \right]^{1/2} \]
Bu metrik kuantum veya düzeltilmiş çözüm ile klasik referans arasındaki toplam alan farkını ölçer. Hata büyüdükçe çözüm klasik referanstan uzaklaşır.
2. Şok konumu:
Önce ayrık hız gradyanı:
\[ \left(\frac{\partial u}{\partial x}\right)_{j+1/2} \approx \frac{u_{j+1}-u_j}{\Delta x} \]
hesaplanır. En büyük mutlak gradyanın bulunduğu konum:
\[ k^\star = \arg\max_{0\le j\le N-2} \left| \frac{u_{j+1}-u_j}{\Delta x} \right| \]
ve:
\[ x_{\mathrm{shock}}=x_{k^\star} \]
olarak tanımlanır.
3. Dissipasyon oranı:
\[ D(t_n) = \nu \sum_{j=0}^{N-2} \left[ \frac{u_{j+1}(t_n)-u_j(t_n)}{\Delta x} \right]^2 \Delta x \]
Bu büyüklük viskoz gradyanların toplam etkisini temsil eden ayrık bir dissipasyon göstergesidir. Yalnız noktasal hata değil, çözümün fiziksel gradyan yapısının da korunup korunmadığını değerlendirmeye yardımcı olur.
Kuantum hesaplamayı sıfırdan anlayalım: qubit nedir?
Klasik bit yalnız 0 veya 1 durumunda bulunur. Bir qubit ise ölçümden önce genel olarak:
\[ |\psi\rangle=\alpha|0\rangle+\beta|1\rangle \]
biçimindeki kuantum durumuyla tanımlanabilir ve normalize durumda:
\[ |\alpha|^2+|\beta|^2=1 \]
olmalıdır. \(\alpha\) ve \(\beta\) doğrudan klasik olasılıklar değil, kompleks olabilen olasılık genlikleridir. Ölçüm sonucunda 0 gözleme olasılığı \(|\alpha|^2\), 1 gözleme olasılığı \(|\beta|^2\)'dir.
Birden fazla qubit kullanıldığında durum uzayı üstel büyür. \(n\) qubit için \(2^n\) adet computational basis state vardır:
\[ |0\rangle,\ |1\rangle,\ldots,\ |2^n-1\rangle \]
Çalışmanın amplitude encoding yönteminin temel fikri bu geniş durum vektörünün genliklarını uzaysal grid değerlerini taşımak için kullanmaktır.
Amplitude encoding nasıl \(N\) grid noktasını az sayıda qubit ile temsil ediyor?
Çalışma, \(N\) adet ayrık Cole–Hopf değerini bir kuantum durumunun \(2^n\) genliğine yerleştirir; böylece gerekli qubit sayısı \(n=\lceil\log_2N\rceil\) olur, ancak bu kompakt temsil veriyi kuantum durumuna hazırlama, evrimden bilgi çıkarma ve ölçüm örnekleme maliyetlerini ortadan kaldırmaz.
Qubit sayısı
Kaynağın tanımı:
\[ n=\lceil\log_2N\rceil, \qquad D=2^n \]
Örneğin:
- \(N=8\) için \(n=3\) qubit,
- \(N=16\) için \(n=4\) qubit,
- \(N=32\) için \(n=5\) qubit,
- \(N=64\) için \(n=6\) qubit
yeterlidir.
Eğer \(N\), tam olarak \(2^n\) değilse kaynak vektörü \(D=2^n\) boyutuna sıfırlarla doldurur veya belirtilen yapıya göre gömer:
\[ \psi_k^{(0)} = \begin{cases} \tilde{\phi}_k,&0\le k\le N-1,\\ 0,&N\le k\le D-1. \end{cases} \]
Son normalize edilmiş kuantum durumu:
\[ |\psi(0)\rangle = \sum_{k=0}^{D-1} \psi_k^{(0)}|k\rangle \]
şeklindedir.
Amplitude encoding neden “bedava üstel hızlanma” değildir?
Bir \(2^n\)-boyutlu vektörün \(n\) qubit genliklarında temsil edilebilmesi güçlü bir matematiksel özelliktir. Ancak buradan tek başına “\(N\) klasik sayıyı \(\log_2N\) qubit ile kodladık, dolayısıyla hesap üstel hızlandı” sonucu çıkarılamaz.
Çünkü gerçek bir kuantum algoritmasında ayrıca:
- başlangıç vektörünün kuantum durumuna hazırlanması,
- gerekli kuantum işlemlerinin gerçekleştirilmesi,
- donanım gürültüsü,
- çok sayıda shot ile ölçüm yapılması,
- istenen klasik alanın ölçümlerden yeniden çıkarılması
gibi maliyetler vardır. Bu çalışma bu maliyetleri tamamen ortadan kaldıran veya klasik yönteme göre asimptotik hız üstünlüğü kanıtlayan bir sonuç sunmamaktadır.
Hamiltonian ne anlama geliyor?
Kuantum mekaniğinde Hamiltonian, sistemin zaman evrimini belirleyen operatördür. Kaynak, ayrık difüzyon dinamiğini taklit etmek amacıyla en yakın komşu qubit etkileşimlerinden oluşan:
\[ H = \sum_{i=0}^{n-2} \alpha X_iX_{i+1} \]
Hamiltonianını kullanır.
\(X_i\), \(i\). qubit üzerindeki Pauli-\(X\) operatörüdür. \(X_iX_{i+1}\), komşu iki qubit arasında bir etkileşim terimidir. \(\alpha\), karışım ölçeğini belirleyen katsayıdır.
\(R_{XX}\) kapısı ve Trotterizasyon kuantum zaman evrimini nasıl oluşturuyor?
\(R_{XX}\) iki qubit arasında \(X\otimes X\) etkileşimi üreten üniter bir rotasyondur; çalışma bu kapıları komşu qubit çiftleri boyunca tekrar ederek ve zamanı küçük Trotter adımlarına bölerek Cole–Hopf difüzyon dinamiğine benzetilen yaklaşık bir kuantum evrimi oluşturur.
\(R_{XX}\) kapısı
Kaynak:
\[ R_{XX}(\theta) = \exp\left( -i\frac{\theta}{2}X\otimes X \right) \]
tanımını kullanır.
Üniter olmak ne demektir? İdeal kapı, kuantum durumunun toplam olasılık normunu koruyan terslenebilir bir dönüşümdür.
\(\theta\): Rotasyon açısıdır ve kaynakta:
\[ \theta = \frac{2\nu\Delta t}{\Delta x^2} \]
olarak seçilir.
Bu bağıntı viskozite, zaman adımı ve uzaysal grid çözünürlüğünü kuantum kapısının rotasyon ölçeğine bağlar.
\(\nu\) arttığında \(\theta\) büyür. \(\Delta t\) arttığında \(\theta\) büyür. \(\Delta x\) küçüldüğünde, paydada \(\Delta x^2\) bulunduğu için \(\theta\) güçlü biçimde büyür. Bu matematiksel ilişki, ince gridlerin devre parametrelerini ve evrim yapısını etkileyebileceğini gösterir.
Trotter yaklaşımı
Hedef zaman \(t\), \(\Delta t\) büyüklüğündeki adımlara ayrılır:
\[ M = \max\left( 1,\left\lfloor\frac{t}{\Delta t}\right\rfloor \right) \]
ve toplam evrim:
\[ U(t) \approx \left[U(\Delta t)\right]^M \]
ile yaklaşık hesaplanır.
Bir Trotter adımı:
\[ U(\Delta t) = \prod_{i=0}^{n-2} R_{XX}^{(i,i+1)}(\theta) \]
şeklinde komşu qubit çiftlerine uygulanan \(R_{XX}\) kapılarından oluşur.
Trotterizasyon neden “yaklaşık”tır? Bir Hamiltonian farklı ve birbiriyle genel olarak commute etmeyen terimlerin toplamından oluşuyorsa, tüm üstel dönüşümü küçük ayrı üstellerin çarpımıyla değiştirmek sonlu zaman adımında Trotter hatası oluşturabilir. Adımlar küçüldükçe ideal matematiksel yakınsama iyileşebilir; fakat gerçek NISQ donanımında daha fazla adım aynı zamanda daha derin devre ve daha fazla gürültü anlamına gelebilir. Bu, NISQ algoritmalarının temel doğruluk–gürültü dengelerinden biridir.
Kritik kavramsal sınır: difüzyon ile üniter evrim aynı şey değildir
Kavramsal açıklama; çalışmanın yeni bulgusu değildir: Klasik difüzyon operatörü \(\exp(\nu tL)\) dissipatif bir evrimdir ve genel olarak üniter değildir. Buna karşılık ideal kuantum kapılarından oluşan \(R_{XX}\) devresi üniterdir. Kaynak, en yakın komşu Hamiltonian karışımının ayrık difüzyon davranışını “taklit etmesi” için bir ölçekleme seçildiğini belirtmektedir; ancak incelenen kaynak metninde \(n\)-qubit \(X_iX_{i+1}\) Hamiltonianı ile \(N\times N\) ayrık Laplasyen arasında tam bir operatör eşdeğerliğinin ayrıntılı matematiksel türetimi verilmemektedir.
Bu nedenle Verianla aktarımında \(R_{XX}\) devresi “difüzyon operatörüne matematiksel olarak tam eşittir” şeklinde sunulmamaktadır. Kaynağın kendi çerçevesine uygun biçimde, difüzyon dinamiğini yaklaşık olarak taklit etmek için kullanılan kuantum devre modeli olarak tanımlanmaktadır.
Qiskit ve IBM donanımı nasıl kullanılmış?
Çalışma devreleri Qiskit ve Qiskit Aer ile oluşturur. İki kuantum backend türü vardır:
- Gürültülü AerSimulator: gerçek IBM cihazından alınan gerçekçi gürültü modeliyle yapılandırılmıştır.
- Gerçek NISQ donanımı: kaynakta
ibm_torinobackend'i belirtilmiştir ve IBM Quantum Runtime üzerinden erişilmiştir.
Devreler çalıştırılmadan önce cihaz-topolojisine ve backend özelliklerine göre transpile edilir.
Her parametre/zaman koşulunda gürültülü simülasyon için kaynak tipik olarak:
\[ N_{\mathrm{shots}}=8192 \]
ölçüm kullanır.
Shot nedir?
Kuantum devresini bir kez çalıştırıp bütün qubitleri ölçmeye bir shot denir. Kuantum ölçümü olasılıksal olduğu için tek shot genellikle yeterli değildir. Aynı devre binlerce kez tekrar edilir ve hangi bit dizisinin kaç kere gözlendiği sayılır.
Örneğin dört qubit için bir ölçüm sonucu:
0101
gibi bir bit dizisi olabilir. Binlerce tekrar sonunda her bit dizisinin frekansı, o basis state'in ölçüm olasılığını yaklaşıklar.
Ölçüm sonuçlarından genlik nasıl yeniden kuruluyor?
Kaynak:
\[ \psi_k(t) = \sqrt{ \frac{\mathrm{counts}(b_k)} {N_{\mathrm{shots}}} } \]
ifadesini kullanır ve ardından yeniden normalize eder:
\[ \psi_k(t) \leftarrow \frac{\psi_k(t)} { \left( \sum_{j=0}^{N-1}|\psi_j(t)|^2 \right)^{1/2} } \]
Bu genlik vektörü daha sonra ayrık Cole–Hopf alanının rolünü üstlenir ve hız:
\[ u_j^{q}(t) = -2\nu \frac{ \psi_{j+1}(t)-\psi_{j-1}(t) }{ 2\Delta x\, \max(\psi_j(t),\varepsilon) } \]
ile yeniden oluşturulur.
Önemli kuantum ölçüm sınırı: counts bize ne verir, ne vermez?
Kavramsal açıklama; kaynak sonucuna ek bir deney değildir: Computational-basis ölçümü doğrudan kompleks genliği \(\psi_k\) değil, onun Born olasılığını \(|\psi_k|^2\) örnekler. Counts değerinin karekökünü almak genliğin büyüklüğüyle ilişkili pozitif bir değer üretir; genel bir kompleks kuantum durumunun fazını tek başına vermez.
Kaynağın denkleminde counts'tan karekök alınarak bir genlik vektörü oluşturulur. İncelenen PDF'de ayrıca faz tomografisi, faz geri kazanımı veya genel kompleks genliklerin işaret/faz bilgisinin nasıl çıkarıldığına ilişkin ayrı bir rekonstrüksiyon prosedürü açıklanmamaktadır. Bu nedenle Verianla, ölçüm adımını “kuantum durumunun tüm kompleks genlikleri eksiksiz yeniden ölçülüyor” şeklinde sunmamaktadır.
NISQ ne demektir?
Noisy Intermediate-Scale Quantum (NISQ), hata düzeltmeli büyük ölçekli fault-tolerant kuantum bilgisayarlarından önceki mevcut/erken kuantum donanım sınıfını ifade eder. Bu cihazlarda qubit sayısı ve coherence süresi sınırlıdır; tek-qubit ve özellikle iki-qubit kapılarında hata oluşur; readout hatası, decoherence, crosstalk ve zamanla değişen kalibrasyon gibi etkiler sonuçları bozabilir.
Bu nedenle ideal kuantum devresinin matematiksel çıktısı ile fiziksel cihazdan ölçülen çıktı aynı değildir.
Zero-Noise Extrapolation (ZNE) kuantum hatasını nasıl azaltmaya çalışıyor?
ZNE, aynı ideal işlemi farklı etkin gürültü seviyelerinde çalıştırıp elde edilen sonuçlardan gürültünün sıfır olduğu sınıra ekstrapolasyon yapmaya çalışır; hata düzeltme kodu kullanmaz ve bu çalışmada öğrenilmiş QAGT-MLP yöntemi için klasik bir karşılaştırma tabanı görevi görür.
Çalışmadaki ZNE uygulaması
Kaynak gürültüyü artırmak için entangling \(R_{XX}\) kapılarını tekrarlar. Ölçeklenmiş devre:
\[ U_{\mathrm{scaled}}(t;s) \approx \left[ \prod_{i=0}^{n-2} R_{XX}(\theta)^s \right]^M \]
biçiminde tanımlanır.
Çalışma iki gürültü ölçeği kullanır:
\[ s\in\{1,3\} \]
\(s=1\) nominal devredir; \(s=3\) aynı entangling kapıların daha fazla tekrarlandığı ve daha fazla donanım gürültüsü biriktiren devredir.
Birinci mertebe Richardson ekstrapolasyonu:
\[ u^{ZNE}(t) = \frac{3}{2}u^{(1)}(t) - \frac{1}{2}u^{(3)}(t) \]
ile sıfır-gürültüye yönelik tahmin üretir.
Kaynak ZNE sonucunu ayrıca fiziksel olarak kabul edilen aralığa kırpar:
\[ u_j^{ZNE} \leftarrow \min\left[ \max(u_j^{ZNE},u_{\min}), u_{\max} \right] \]
ve deneylerinde örnek sınırlar olarak:
\[ u_{\min}=-1,\qquad u_{\max}=2 \]
verir.
ZNE neden her zaman iyileştirme sağlamadı?
ZNE bias'ı azaltabilir; ancak daha gürültülü devreleri çalıştırıp bu sonuçları lineer kombinasyonla ekstrapole ettiği için örnekleme varyansını ve istikrarsızlığı artırabilir. Kaynak sonuçlarında bazı 2D ve özellikle 3D durumlarda ZNE'nin ham donanım sonucundan daha kötü hata verdiği açıkça gösterilmektedir.
Bu nedenle çalışmanın temel fikri, ZNE'yi tamamen ortadan kaldırmak değil, devrenin ve fiziksel alanın yapısını öğrenen problem-aware bir hata düzeltme katmanıyla daha güçlü bir düzeltme elde edip edemeyeceğini sınamaktır.
QAGT-MLP nedir?
QAGT-MLP, kuantum devresini yönlü döngüsüz grafik (Directed Acyclic Graph, DAG) olarak temsil eden, attention tabanlı grafik katmanlarından elde edilen yapısal özellikleri gürültülü kuantum çıktılarıyla birleştirip klasik referans alanını tahmin eden bir klasik makine öğrenmesi hata azaltma modelidir.
Bu model bir kuantum sinir ağı değildir. Eğitim ve çıkarımın hata düzeltme kısmı klasik makine öğrenmesi katmanıdır; girdilerinden biri kuantum devresi ve kuantum ölçüm çıktılarıdır.
Kuantum devresi neden bir grafiğe dönüştürülebilir?
Devrede her kuantum kapısı bir düğüm olarak düşünülebilir. Kapılar arasındaki kuantum bilgi akışı ve zaman/nedensellik ilişkisi ise kenarlar ile temsil edilebilir. Devre zaman yönünde ilerlediği için grafik doğal olarak yönlü ve döngüsüzdür.
Kaynağın belirttiği node özellikleri arasında:
- gate kimliği/türü,
- gate arity: kapının kaç qubit üzerinde çalıştığı,
- gate parametreleri,
- qubit indeks/kodlama bilgileri,
- işlemin devredeki zaman/moment konumu,
- yerel gürültü özellikleri,
- lightcone özellikleri,
- global devre özellikleri
bulunur.
Causal lightcone nedir?
Belirli bir qubit ölçümünü bütün devredeki her kapı etkileyemez. Yalnız nedensel olarak o ölçüme bilgi taşıyan kapılar etki edebilir. Çalışma bu altgrafı lightcone olarak kullanır.
Kaynağın tanımı:
\[ L_i = \left\{ g\in G: \exists\ \text{g'den }q_i\text{ ölçümüne nedensel yol} \right\} \]
Burada:
- \(G\): devredeki kapı düğümlerinin kümesi,
- \(g\): belirli bir gate düğümü,
- \(q_i\): ölçülen hedef qubit,
- \(L_i\): o ölçümü etkileyebilen gate'lerin lightcone kümesidir.
Bu maske üç temel işe yarar:
- Nedensel tutarlılık: İlgisiz gate'lerin tahmine karışmasını azaltır.
- Hesap verimliliği: Attention mekanizması bütün devre yerine gerekli alt yapıya odaklanabilir.
- Yorumlanabilirlik: Hangi gate dizilerinin belirli bir ölçüm hatasına katkıda bulunabileceğini izlemeye yardımcı olur.
Graph attention ne yapıyor?
Standart bir GNN, komşu düğümlerden gelen bilgileri toplar. Graph Attention Network (GAT) ise bütün komşuların katkısını eşit kabul etmek zorunda değildir. Öğrenilen attention ağırlıkları bazı komşuların belirli bir node temsili için daha önemli olmasını sağlar.
Bu çalışmada amaç, örneğin gürültülü bir ölçüm sonucunun düzeltilmesi için hangi kapılar, hangi qubit yolları ve hangi nedensel alt yapıların daha önemli olduğunu modelin öğrenebilmesidir.
QAGT-MLP'nin girdisi ve çıktısı
Kaynakta supervised-learning hedefi kavramsal olarak:
\[ \mathcal{R}: u^{noisy}(t) \ \text{veya}\ u^{ZNE}(t) \longmapsto u^{class}(t) \]
şeklinde ifade edilir.
Girdi yalnız gürültülü hız vektörü değildir. Circuit graph, gate özellikleri, lightcone, global circuit bilgileri ve quantum measurement sonucu birlikte kullanılır. Modelin son kısmındaki MLP, bu işlenmiş grafik temsilini ve ölçüm bilgilerini kullanarak noise-corrected çıktı üretir.
Eğitim yöntemi
Kaynak supervised learning kullanır. Girdi, devre grafiği ve ilgili gürültülü quantum measurement verileridir. Hedef, klasik simülasyon sonucudur.
Kayıp fonksiyonu:
Mean Squared Error (MSE), yani tahmin ile klasik ground truth arasındaki kare hataların ortalamasıdır.
Kaynak tek bir modelle bütün output boyutlarını çözmek yerine \(N=16\), \(N=32\) ve \(N=64\) için ayrı uzmanlaşmış modeller eğittiğini belirtir.
Eğitim eğrileri 100 epoch boyunca gösterilir. Kaynak, ilk yaklaşık 10–15 epoch'ta hızlı iyileşme ve yaklaşık 30. epoch sonrasında daha yavaş/kararlı gelişme gözlendiğini bildirir. \(N=32\) için yaklaşık 70. epoch civarında learning-rate step düşürmesi gösterilir; \(N=16\) ve \(N=64\) için sabit learning-rate davranışı belirtilir.
Ancak kaynak şu kritik eğitim ayrıntılarını açık değerlerle raporlamamaktadır:
- optimizer adı,
- başlangıç learning rate'in kesin sayısal değeri,
- batch size,
- GAT katmanlarının kesin sayısı,
- attention head sayısı,
- hidden embedding dimension,
- dropout oranı,
- weight decay,
- açık train/validation/test yüzde bölünmesi.
Bu eksik değerler Verianla tarafından tahmin edilmemiştir.
Çalışmanın Yöntemi ve Bulguları
Parametre taraması
| Parametre | Kaynak değerleri | Bilimsel rol |
|---|---|---|
| Viskozite \(\nu\) | 0,01; 0,05; 0,10; 0,15; 0,20 | Küçük değerlerde daha keskin gradyan, büyük değerlerde daha güçlü difüzyon |
| Zaman adımı \(\Delta t\) | 5×10⁻⁴; 10−3; 1,5×10⁻³; 2×10⁻³ | Klasik ve Trotter zaman ayrıklaştırmasını etkiler |
| Grid boyutu \(N\) | 8; 16; 32; 64 | Uzaysal çözünürlük; 3–6 qubit amplitude encoding |
| Sol sınır \(u_L\) | 1; 2; 4; 6 | Inflow sınır değeri |
| Sağ sınır \(u_R\) | 0 | Kaynak taramasında sabit tutulmuştur |
Bu tarama:
\[ 5\times4\times4\times4=320 \]
ayrı parametre kombinasyonu oluşturur.
Kaynak üç zaman kümesi kullanır:
\[ \mathcal{T}^{(0)} = \{0,\ 0.005,\ 0.010\} \]
\[ \mathcal{T}^{(1)} = \{0,\ 0.0025,\ 0.005,\ 0.0075,\ 0.010\} \]
\[ \mathcal{T}^{(2)} = \{0,\ 0.002,\ 0.004,\ 0.006,\ 0.008,\ 0.010\} \]
Toplam 14 zaman snapshot'ı üzerinden birkaç bin eşlenmiş klasik/kuantum örneği elde edildiği belirtilir.
Dataset içinde ne saklanıyor?
Kaynak her deney koşulu için:
- klasik referans alanını,
- noisy simulator alanını,
- ZNE-corrected alanı,
- varsa gerçek hardware alanını,
- ham counts veya quasi-distribution bilgisini,
- shock position ve dissipation gibi tanı metriklerini,
- circuit depth'i,
- iki-qubit gate sayısını,
- grid ve parametre meta verisini
yapılandırılmış JSON kayıtlarına koyduğunu belirtir.
Devreler ayrıca QPY ve desteklendiğinde QASM biçiminde dışa aktarılmaktadır. Bununla birlikte incelenen kaynakta bu dosyaların herkese açık bir repository indirme bağlantısı verilmemiştir.
1D yüksek viskozite özet sonuçları
| Çözünürlük | Örnek | Sim Noisy | ZNE | HW Raw | QAGT-MLP Sim | QAGT-MLP HW | Sim / HW kazancı |
|---|---|---|---|---|---|---|---|
| N=16 | 72 | 0,3498 | 0,3639 | 0,3780 | 0,2112 | 0,2260 | +%39,6 / +%40,2 |
| N=32 | 54 | 0,8954 | 0,6725 | 0,9902 | 0,4345 | 0,4353 | +%51,5 / +%56,0 |
| N=64 | 12 | 1,0520 | 0,7226 | 1,5157 | 0,3932 | 0,4398 | +%62,6 / +%71,0 |
Kaynak Tablo 1'in çevresindeki tartışma bu değerleri hata performansı bağlamında yorumlamaktadır. Ancak tablonun sütun başlığında ölçütün adı ayrıca “MAE” olarak yazılmadığından, Verianla tabloyu kaynağın verdiği biçimde “özet hata değerleri” olarak aktarmaktadır.
1D küçük viskozite özet sonuçları
| Çözünürlük | Örnek | Sim Noisy | ZNE | HW Raw | QAGT-MLP Sim | QAGT-MLP HW | Sim / HW kazancı |
|---|---|---|---|---|---|---|---|
| N=16 | 741 | 0,8373 | 1,1306 | 0,8305 | 0,6453 | 0,6447 | +%22,9 / +%22,4 |
| N=32 | 633 | 0,5618 | 0,6794 | 0,6051 | 0,3813 | 0,3804 | +%32,1 / +%37,1 |
| N=64 | 429 | 0,5899 | 0,6799 | 0,6819 | 0,3394 | 0,3370 | +%42,5 / +%50,6 |
Bu tablo küçük viskozite ve dolayısıyla daha keskin/çözülmesi zor yapıların bulunduğu rejimde QAGT-MLP'nin kazançlarının yüksek viskozite grubuna göre genel olarak daha düşük olduğunu gösterir. Aynı zamanda ZNE sütununun bazı durumlarda ham noisy değerinden daha yüksek olması, ZNE'nin otomatik olarak iyileştirme garantisi vermediğini gösterir.
Temsili 1D simülasyon örnekleri
Kaynak sonuç tartışmasında \(N=64\) için bir temsilî örnekte noisy simulation MAE'sinin yaklaşık 0,51'den QAGT-MLP sonrasında yaklaşık 0,07'ye düştüğü belirtilir.
\(N=32\) temsilî örneklerde yaklaşık 0,62 noisy MAE değerinin yaklaşık 0,13 veya altına indirildiği durumlar vardır.
\(N=16\) daha sorunludur. Bir örnekte yaklaşık 1,23'ten 0,17'ye büyük iyileşme sağlanırken, iki başka örnekte QAGT-MLP MAE'si yaklaşık 1,13 ve 1,16'ya yükselmiş; noisy giriş hata değerleri ise yaklaşık 0,43 ve 0,46 olarak verilmiştir.
Bu ikinci durumlarda model düzeltmek yerine sonucu kötüleştirmiştir.
Gerçek IBM donanımına genelleme
Önemli deneylerden biri, modelin yalnız noisy simulator verileri üzerinde eğitilip daha sonra gerçek IBM donanım çıktılarında denenmesidir.
\(N=64\) temsilî donanım örneklerinde ham MAE yaklaşık 0,56–1,05 aralığındayken QAGT-MLP sonrasında yaklaşık 0,07–0,32 aralığına indiği ve göreli iyileşmenin yaklaşık %69–87 olduğu belirtilir.
\(N=32\) örneklerinde ham donanım MAE'si yaklaşık 0,55–0,56, düzeltilmiş MAE yaklaşık 0,09–0,12 olarak raporlanır; kaynak bu örneklerde yaklaşık %80 iyileşme bildirir.
\(N=16\) yine karışıktır. İki örnekte yaklaşık 1,26 ve 1,30 ham MAE'nin yaklaşık 0,14'e düşmesi yaklaşık %89 iyileşme yaratırken başka bir örnekte ham yaklaşık 0,44 MAE, QAGT-MLP sonrasında yaklaşık 1,18'e yükselmiştir. Kaynak bu örnekte göreli sonucu −%167 olarak verir.
Bu başarısızlık özellikle önemlidir: model simulator → hardware distribution shift'ine rağmen birçok durumda iyi genellense de çok düşük çözünürlükte bazı alan yapıları yeterince temsil edilmediğinde öğrenilmiş düzeltici hatayı büyütebilir.
2D sonuçlar
Kaynak yöntemi iki boyutlu viskoz Burgers alanlarına da uygular ve Şekil 9'da 512×512 grid üzerindeki örnek zaman gelişimlerini gösterir. Classical reference, noisy quantum, ZNE ve QEM alanları karşılaştırılır. Görsellerde QEM alanlarının büyük ölçekli akış yapısını noisy ve ZNE'ye kıyasla daha iyi geri getirdiği bildirilir.
Bununla birlikte toplu 2D hata tablosu daha dengeli okunmalıdır:
| Grid | Örnek | Noisy MAE | Noisy MSE | Noisy RMSE | QAGT MAE | QAGT MSE | QAGT RMSE | ZNE MAE | ZNE MSE | ZNE RMSE | QAGT MAE iyileşmesi |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 16×16 | 66 | 0,543 | 0,700 | 0,796 | 0,574 | 0,404 | 0,635 | 0,747 | 0,960 | 0,947 | −%5,86 |
| 32×32 | 33 | 1,082 | 8,304 | 2,360 | 0,540 | 5,184 | 1,760 | 1,374 | 8,564 | 2,527 | +%50,06 |
16×16 durumda QAGT-MLP'nin MAE'si 0,543'ten 0,574'e çıkar; yani MAE açısından yaklaşık −%5,86'lık negatif “iyileşme” vardır. Buna karşılık MSE ve RMSE düşmektedir. Bu, bir modelin farklı hata metriklerinde farklı davranabileceğini gösterir.
32×32 durumda ise QAGT-MLP bütün üç hata metriğinde noisy ve ZNE'ye göre daha iyi sonuç verir ve MAE yaklaşık yarıya düşer.
2D korelasyon analizi
Kaynak 2D noktasal hızları klasik ideal değerlerle karşılaştıran KDE/scatter analizleri de sunar.
\(N=16\) için noisy ve ZNE korelasyonları yaklaşık:
\[ r\approx0.25,\qquad r\approx0.31 \]
iken QEM için:
\[ r\simeq0.98 \]
raporlanır.
\(N=32\) durumunda noisy ve ZNE korelasyonlarının yaklaşık 0,00–0,01 civarında olduğu, QEM'in ise yaklaşık:
\[ r\simeq0.61 \]
korelasyona ulaştığı belirtilir.
Burada korelasyonun yüksek olması tek başına her noktada küçük mutlak hata garantisi değildir; fakat tahmin edilen noktasal değerlerin klasik referansla birlikte değişme eğiliminin güçlendiğini gösterir.
3D sonuçlar
Kaynak gerçek kuantum donanımı gürültüsü üzerinden üç boyutlu Burgers alanlarını da değerlendirir. Görsel sonuçlar 4×4×4 grid üzerindeki vektör alanlarını farklı zamanlarda karşılaştırır.
Toplu 3D tablo:
| Grid | Örnek | Noisy MAE | Noisy MSE | Noisy RMSE | QAGT MAE | QAGT MSE | QAGT RMSE | QAGT MAE iyileşmesi |
|---|---|---|---|---|---|---|---|---|
| 4×4×4 | 21 | 0,531 | 6,310 | 1,744 | 0,549 | 5,601 | 1,634 | −%3,26 |
| 8×8×8 | 21 | 0,779 | 7,458 | 2,413 | 0,632 | 5,406 | 2,085 | +%18,92 |
4×4×4 gridde MAE hafifçe kötüleşirken MSE ve RMSE iyileşmektedir. 8×8×8 gridde ise MAE dahil bütün raporlanan metriklerde iyileşme görülür.
Dolayısıyla “3D'de model her zaman hatayı azaltıyor” denemez. Kaynağın kendi toplu tablosu çok kaba 4³ gridde MAE'nin kötüleştiğini göstermektedir.
Çözünürlük neden bu kadar önemli?
Makine öğrenmesi düzelticisi gürültülü input içindeki fiziksel yapıyı kullanarak klasik yapıyı tahmin etmeye çalışır. Eğer grid çok kaba ise gerçek şok konumu, tepe şekli ve gradyan yeterince örneklenmeyebilir. Bu durumda modelin düzeltmeye dayanak oluşturacağı fiziksel bilgi inputta bulunmayabilir.
Kaynak bu nedenle \(N=16\) hatalarını yalnız “quantum backend kötü” şeklinde yorumlamaz; benzer başarısız örneklerin simülasyonda da görülmesi çözünürlüğün temel sınırlayıcılardan biri olduğuna işaret eder.
Devre boyutu ve boyutsallık arttığında ne oluyor?
Kaynak Şekil 3, 1D, 2D ve 3D quantum CFD devrelerinde problem boyutu arttıkça:
- iki-qubit gate sayısının,
- toplam gate sayısının,
- entangling density'nin
arttığını gösterir.
Circuit depth ise disjoint iki-qubit işlemlerin paralel uygulanabilmesi nedeniyle toplam gate sayısı kadar hızlı büyümeyebilir. Buna rağmen iki-qubit kapılar NISQ donanımlarında önemli hata kaynakları olduğundan gate hacmindeki artış gürültü duyarlılığını yükseltir.
Kaynak grafiğinin ham sayısal noktaları tablo halinde verilmediği için Verianla burada eksenlerden yapay kesin değerler üretmemiştir.
Modelin açık başarısızlık modları
- Çok düşük uzaysal çözünürlükte fiziksel yapı eksik kalabilir.
- Öğrenilmiş düzeltme bazı örneklerde overshoot oluşturabilir.
- Şok çevresinde sistematik bias oluşabilir.
- Yanlış düzeltme şok konumunu kaydırabilir.
- Gradyan büyüklüğünü abartarak dissipasyonu fazla tahmin edebilir.
- 2D 16×16 ve 3D 4×4×4 toplu MAE sonuçları negatif iyileşme içermektedir.
- ZNE bazı rejimlerde raw hardware'dan daha kötü olabilir.
Çalışmanın desteklediği sonuçlar
- Gürültülü quantum Burgers çözümlerinin klasik referanstan sapmaları öğrenilmiş grafik tabanlı bir post-processing katmanıyla birçok durumda azaltılabilmektedir.
- Devrenin DAG yapısı ve causal lightcone bilgisi hata azaltma modeline girdi olarak kullanılabilmektedir.
- Yalnız gürültülü simülatör verisiyle eğitilmiş model, bazı \(N=32\) ve \(N=64\) 1D testlerinde gerçek IBM hardware çıktılarına device-specific yeniden eğitim olmadan genellenebilmiştir.
- 1D yüksek viskozite özetinde donanım tarafında raporlanan ortalama kazanç \(N=64\) için %71,0'a çıkmaktadır.
- 2D 32×32 durumda QAGT-MLP, noisy ve ZNE tabanlarına karşı belirgin MAE/MSE/RMSE iyileşmesi sağlamıştır.
- 3D 8×8×8 durumda QAGT-MLP, noisy hardware sonuçlarına karşı MAE, MSE ve RMSE'yi azaltmıştır.
- Çözünürlük, yöntemin güvenilirliği açısından kritik bir değişkendir.
Çalışmanın desteklemediği iddialar
- Quantum bilgisayarın klasik Krylov çözücüden daha hızlı olduğu gösterilmemiştir.
- Quantum advantage veya quantum supremacy gösterilmemiştir.
- Genel Navier–Stokes CFD problemlerinin kuantum bilgisayarda çözüldüğü gösterilmemiştir.
- QAGT-MLP'nin bütün quantum algoritmalarına genellendiği deneysel olarak kanıtlanmamıştır.
- QAGT-MLP bütün grid boyutlarında hatayı azaltmamaktadır.
- ZNE bütün örneklerde iyileşme sağlamamaktadır.
- Amplitude encoding'in state-preparation ve measurement maliyetleri ortadan kaldırdığı gösterilmemiştir.
- Computational-basis counts'tan genel kompleks quantum state'in fazının tam olarak geri kazanıldığı gösterilmemiştir.
- Çalışma fault-tolerant kuantum hesaplama sonucu değildir.
- Sonuçlar doğrudan gerçek endüstriyel 3D türbülans CFD performansı olarak yorumlanamaz.
Gelecek çalışma önerileri
Kaynak özellikle şu geliştirmeleri önerir:
- multi-resolution / multiscale öğrenme,
- physics-based loss fonksiyonları,
- uncertainty estimation,
- daha geniş CFD problem aileleri,
- daha ifade gücü yüksek quantum circuit ansatz'ları,
- daha büyük ve ölçeklenebilir graph mimarileri,
- quantum circuit ile error corrector'ın birlikte optimize edilmesi,
- differentiable surrogate veya reinforcement learning tabanlı ortak optimizasyon.
Bu öneriler çalışmada henüz doğrulanmış sonuçlar değildir; gelecekte araştırılması önerilen yönlerdir.
Kaynak ve Yöntem Notu
Özgün çalışma: Solving Burgers Equation on Noisy Quantum Hardware with Error Mitigation through Attention Graph Transformers
Yazarlar: Seyed Mohamad Ali Tousi, Adib Bazgir, Yuwen Zhang, G. N. DeSouza.
Yazar sırası: Kaynak PDF'deki sıra korunmuştur.
Kurum 1: Vision-Guided and Intelligent Robotics Lab (ViGIR), Department of Electrical Engineering and Computer Science, University of Missouri, Columbia, Missouri, USA.
Kurum 2: Department of Mechanical and Aerospace Engineering, University of Missouri, Columbia, Missouri, USA.
Sorumlu yazarlar: Kaynak işaretlemesine göre Yuwen Zhang ve G. N. DeSouza corresponding author olarak gösterilmektedir.
Kaynak türü: Araştırma preprint'i; hibrit kuantum-klasik PDE çözümü, gerçek NISQ donanım testi, gürültülü simülasyon ve klasik makine öğrenmesi hata azaltma çalışması.
Hakemlik durumu: PDF her sayfada “This preprint research paper has not been peer reviewed” uyarısını taşımaktadır. Dolayısıyla sonuçlar hakemli nihai yayın sonucu gibi sunulmamalıdır.
Platform: PDF, elektronik kopya için SSRN abstract 7649063 bağlantısını vermektedir.
Yayın durumu: Sayfa altbilgisinde “Preprint submitted to Elsevier” ifadesi bulunmaktadır. Kaynak PDF nihai dergi cildi, sayı ve makale numarası vermemektedir.
DOI: İncelenen PDF'de bu sürüm için DOI raporlanmamaktadır. DOI uydurulmamıştır.
Yayın tarihi: İncelenen PDF üzerinde güvenilir bir SSRN yayın/yükleme tarihi görünür biçimde verilmemektedir; bu nedenle kesin tarih eklenmemiştir.
Lisans: İncelenen PDF bu sürüm için açık bir yeniden kullanım lisansı belirtmemektedir. Bu nedenle kaynak figürleri piksel düzeyinde kopyalanmamış; yalnız bilimsel ilişkileri bağımsız Verianla SVG şemalarıyla yeniden ifade edilmiştir.
Ana yazılımlar ve platformlar: Qiskit, Qiskit Aer, IBM Quantum Runtime ve klasik referans için QuTiP Krylov tabanlı solver.
Gerçek quantum backend: Kaynak donanım deneylerinde ibm_torino backend'ini belirtmektedir.
Ölçüm: Gürültülü kuantum çalıştırmalarında tipik olarak 8192 shot kullanılmıştır.
Dataset: 1D ana tarama için 320 parametre kombinasyonu; üç zaman kümesinde toplam 14 zaman noktası/koşul ve birkaç bin eşlenmiş örnek üretildiği belirtilmektedir.
Veri ve devre dışa aktarımı: QPY, desteklendiğinde QASM ve yapılandırılmış JSON meta verileri kaydedilmiştir. Kaynakta bu dosyalar için açık bir kamu repository bağlantısı verilmemektedir.
Finansman: Ayrı bir Funding bölümü ve fon sağlayıcı/grant numarası kaynakta raporlanmamaktadır. CRediT bölümünde G. N. DeSouza için “Funding acquisition” rolü belirtilmiştir; bundan fon sağlayıcının kimliği çıkarılamaz.
Çıkar çatışması: İncelenen PDF'de ayrı bir conflict-of-interest beyanı görülmemektedir. “Çıkar çatışması yoktur” şeklinde varsayım yapılmamıştır.
CRediT katkıları: Seyed Mohamad Ali Tousi: Conceptualization, Methodology, Software, Investigation, Writing – original draft. Adib Bazgir: Conceptualization, Methodology, Software, Investigation, Writing – original draft. Yuwen Zhang: Conceptualization, Supervision, Resources, Writing – review & editing. G. N. DeSouza: Conceptualization, Supervision, Resources, Funding acquisition, Writing – review & editing.
Raporlanmayan eğitim ayrıntıları: Kaynakta optimizer adı, batch size, kesin learning-rate değerleri, GAT layer/head sayısı, hidden size, dropout ve açık veri bölme yüzdeleri net olarak verilmemektedir. Bu bilgiler Verianla tarafından tamamlanmamıştır.
Kaynak içi başlangıç/sınır koşulu tutarsızlığı: Ana yöntem bölümünde \(u_0(x)=\sin(\pi x)\) ve iki uçta Dirichlet hız sınırları verilirken Ek Şekil 12'nin görsel etiketleri bu tanımla tam uyuşmamaktadır. Ana yöntem denklemleri değiştirilmemiş ve fark açıkça belirtilmiştir.
Kuantum modelleme sınırı: Kaynak \(R_{XX}\) tabanlı en yakın komşu Hamiltonian evrimini ayrık difüzyon davranışını taklit etmek için kullanmaktadır. İncelenen metinde bu üniter kuantum evrimi ile klasik dissipatif Laplasyen semigrubu arasında tam operatör eşdeğerliğinin ayrıntılı türetimi verilmediğinden Verianla bunu tam matematiksel eşdeğerlik olarak sunmamıştır.
Ölçüm rekonstrüksiyonu sınırı: Kaynak computational-basis counts değerlerinden karekök alarak genlik vektörü oluşturmaktadır. PDF'de genel kompleks faz bilgisini yeniden kazanmak için ayrı tomography/phase-reconstruction prosedürü açıklanmamaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir