


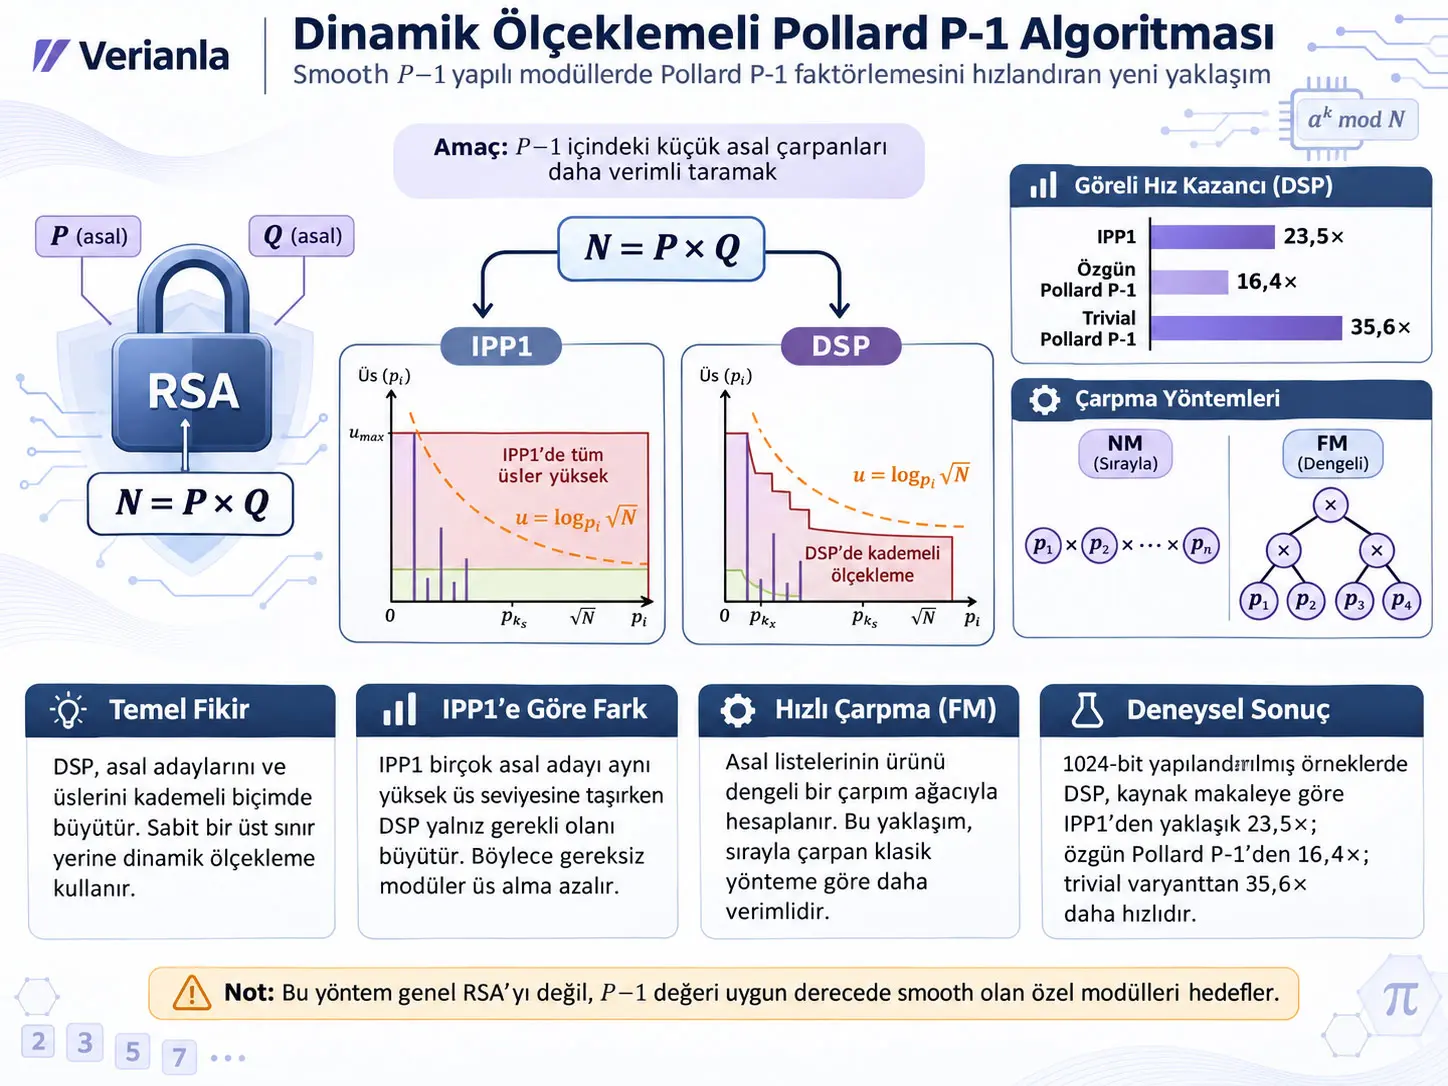
Dynamic Scaling Pollard’s P-1 Algorithm (DSP), Pollard P-1 özel amaçlı tamsayı çarpanlara ayırma yöntemini, asal adayları ve onların gerekli üslerini kademeli biçimde büyütecek şekilde yeniden düzenleyen bir algoritma varyantıdır. Çalışma, özellikle RSA modülü \(N=PQ\) içindeki bir asal çarpan \(P\) için \(P-1\)'in küçük asal çarpanlardan oluştuğu durumları hedefler. DSP'nin temel amacı, geleneksel Pollard P-1 ve IPP1 yöntemlerinde ortaya çıkan sabit smoothness-bound seçimi ve gereksiz yüksek üs hesaplamalarını azaltmaktır. Çalışma ayrıca büyük asal listelerinin ürününü daha düşük maliyetle hesaplamak için Fast Multiplication (FM) yöntemini geliştirir.
DSP'nin ayırt edici özelliği, asal adayları tek bir sabit aralığa toplamak yerine büyüklüklerine göre kademeli alt kümelere ayırması ve küçük asal çarpımlarından daha önce elde edilmiş ara ürünleri sonraki üslerde yeniden kullanmasıdır. Böylece bütün asal adayları IPP1'de olduğu gibi aynı \(u_{\max}\) seviyesine kadar yükseltmek yerine, küçük asallar daha yüksek üslere, büyük asallar ise matematiksel olarak ihtiyaç duyulan daha düşük üslere kadar taşınır. Bu yaklaşım özellikle \(P-1\)'in asal çarpanlarından birinin yüksek üs taşıdığı fakat diğerlerinin aynı yüksek üssü gerektirmediği durumda gereksiz modüler üs alma maliyetini azaltmayı amaçlar.
Yazarların teorik karşılaştırmasında, belirli koşullar altında en büyük ilgili asal \(p_{\sigma_s}\ge64\) olduğunda DSP'nin IPP1'den daha düşük maliyetli olmasını destekleyen olasılık en az 0,95 olarak türetilmiştir. Bu değer genel RSA anahtarlarının %95'inin DSP ile kırılabileceği anlamına gelmez; makaledeki belirli sayı-teorik maliyet eşitsizliğinin olasılığıdır.
Deneysel bölümde \(P-1\)'in Pollard P-1 ile çözülebilir olmasını sağlamak amacıyla birkaç rasgele 30-bit sayının ürünü kullanılarak 512-bit \(P\) asal sayıları oluşturulmuş, aynı bit uzunluğunda rasgele \(Q\) seçilerek 1024-bit \(N=PQ\) modülleri üretilmiştir. Tek iş parçacıklı Intel Core i5-9500 sistemindeki karşılaştırmada kaynak DSP'nin yaklaşık olarak IPP1'den 23,5 kat, özgün Pollard P-1'den 16,4 kat ve trivial varyanttan 35,6 kat daha hızlı çalıştığını bildirmektedir.
En önemli yorum sınırı: DSP genel amaçlı bir RSA kırma algoritması değildir. Pollard P-1 ailesi yalnız bir asal çarpanın \(P-1\) veya \(Q-1\) değerinde uygun smoothness zayıflığı bulunduğu özel durumlarda verimlidir. Çalışmanın 1024-bit deneyleri de bu zayıflığı özellikle taşıyacak biçimde oluşturulmuş test modülleridir.
Tamsayı çarpanlara ayırma problemi nedir?
RSA tipi bir modül:
biçiminde iki büyük ve farklı asal sayının çarpımıdır. \(N\) bilinirken \(P\) ve \(Q\)'yu geri kazanma problemi Integer Factorization Problem (IFP), yani tamsayı çarpanlara ayırma problemi olarak adlandırılır.
Modülün bit uzunluğu:
ile gösterilir. \(n_N\), \(N\)'yi ikili gösterimde yazmak için gereken bit sayısıdır. Kaynak analizinde \(P\) ve \(Q\)'nun yaklaşık olarak aynı bit uzunluğuna sahip olduğu varsayılır; dolayısıyla her biri yaklaşık \(n_N/2\) bit uzunluğundadır.
Euler totient fonksiyonu:
şeklindedir.
B-smooth sayı ne demektir?
Kaynak çalışmanın tanımına göre B-smooth sayı, bütün asal çarpanları \(B\)'den küçük veya \(B\)'ye eşit olan pozitif tamsayıdır.
Örneğin:
yalnız 2 ve 3 asal çarpanlarını içerdiği için 3-smooth bir sayıdır. Buradaki örnek yalnız tanımı öğretmek içindir; çalışmanın deney sonucu değildir.
Pollard P-1 algoritmasının hedeflediği zayıflık, \(P-1\)'in bu tür küçük asal çarpanlardan oluşmasıdır.
Pollard P-1 neden çalışabilir?
Fermat'ın Küçük Teoremi, \(P\) asal ve \(a\) sayısı \(P\) ile aralarında asal ise:
olduğunu söyler.
Eğer seçilen bir üs \(z\), \(P-1\)'in katıysa:
ve dolayısıyla:
olur.
Bu durumda:
hesabı, uygun koşullarda:
\[ 1
olan asal çarpan \(P\)'yi verebilir.
Dolayısıyla Pollard P-1'in asıl problemi \(P-1\)'in asal çarpanlarını içerecek kadar zengin fakat gereksiz derecede büyük olmayan bir \(z\) üssü oluşturmaktır.
Kaynağın temel notasyonu
\(P-1\) her zaman çift olduğundan kaynak önce tek kısmı:
olarak ayırır.
\(\gamma\), aday asal listesinin global üst sınırıdır. Aday küme:
şeklinde tanımlanır.
\(P_{\mathrm{div}}\) içindeki gerçek asal çarpanlar:
biçiminde yazılır.
- \(p_{\sigma_i}\): gerçekten \(P_{\mathrm{div}}\)'i bölen asal.
- \(u_{\sigma_i}\): o asalın gerçek üssü.
- \(\sigma_1<\sigma_2<\cdots<\sigma_s\): bu asalların global asal listesindeki sıraları.
- \(u_{\max}\): gerçek asal üsleri arasındaki maksimum değer.
Kaynak ayrıca en büyük asal-kuvvet bileşenini:
olarak tanımlar.
Bir \(p_i\) asalının mümkün olan maksimum üssü için kaynak:
üst sınırını kullanır. Bunun nedeni:
olduğundan herhangi bir asal kuvvetinin de bu büyüklüğü aşamamasıdır.
DSP asal adaylarını nasıl bölüyor?
Kaynak, aday asal kümesini büyüklüklerine göre \(k_0\) adet alt kümeye böler:
ve:
şeklindeki aralıkları kullanır.
Bu double-exponential sınırlar ilk bakışta alışılmadık görünebilir. Amaç, asalın büyüklüğü arttıkça o asalın \(P-1\) içinde taşıyabileceği maksimum üs sayısının hızla azalması gerçeğini algoritmik yapıya yansıtmaktır.
DSP Gerçekten Hiç Smoothness Bound Kullanmıyor mu?
Hayır; Algorithm 4'ün girdilerinden biri \(\gamma\) adlı global asal-listesi üst sınırıdır. DSP'nin avantajı, klasik Pollard P-1 veya IPP1'de olduğu gibi çalışmanın başarısı için dar bir \(B\) sınırını önceden doğru tahmin etmeye bağımlı olmamasıdır: \(\gamma\) teorik maksimuma ayarlanabilir ve algoritma asal/üs alanını dinamik olarak tarar; ön bilgi varsa daha küçük \(\gamma\) yalnız hızlandırma amacıyla kullanılabilir.
Asal-ürün bit uzunluğunun beklenen değeri
Kaynak, FM ve NM maliyetini analiz etmek için \(L(p,n_1,n_2)\) adında bir liste modeli kurar. Listedeki her:
elemanı bağımsız olarak \(p\) olasılığıyla seçilir.
Listedeki bütün sayıların çarpımının beklenen yapısal bit uzunluğu:
olarak verilir.
Bu formül bir süre ölçmez. Daha sonraki büyük-tamsayı çarpma ve modüler üs alma maliyetlerinin operand büyüklüğünü tahmin etmek için kullanılan matematiksel ara sonuçtur.
Temel işlem maliyet modelleri
Kaynak bütün DSP/IPP1 maliyet analizini dört temel işlem türüne ayırır.
1. Büyük tamsayı çarpımı:
Burada \(n\), operand bit uzunluğu; \(C_1\) implementation-dependent bir sabittir. Kaynak asimptotik analiz için büyük tamsayı çarpımını \(O(n\log n)\) olarak modellemektedir.
2. Modüler üs alma:
\(l\), exponent bit uzunluğu; \(n\), base/modulus bit büyüklüğü; \(w\), sliding-window genişliği olmak üzere:
şeklinde modellenir.
Kaynak, optimum pencere seçimini Lambert W fonksiyonunun asimptotik yaklaşımıyla çözüp:
yaklaşımını elde eder.
İncelenen exponent-boyut aralığında bu maliyet exponent bit uzunluğu \(l\) ile yaklaşık doğrusal davranmaktadır. DSP'nin ara asal ürünlerini yeniden kullanma fikrinin önemli matematiksel dayanaklarından biri budur.
3. Normal üs alma:
kaynakta basit binary exponentiation için kullanılan üst maliyet modelidir.
4. En büyük ortak bölen:
olarak modellenir. \(C_2\), GCD implementation'ına bağlı sabittir.
Özgün Pollard P-1 algoritması
Kaynak Pollard'ın özgün yaklaşımını iki aşamalı yapı olarak açıklar. \(1<B_1<B_2\) olmak üzere algoritmanın başarılı olabileceği iki temel durum:
- \(P-1\), \(B_1\)-smooth'dur.
- \(P-1=Ap\), burada \(A\) \(B_1\)-smooth ve \(B_1<p<B_2\) bir asaldır.
Birinci aşamada her asal için:
gibi yeterli üsler seçilerek:
oluşturulur.
Bishop'un trivial varyantı
Bishop'un kaynağın karşılaştırdığı basit varyantında başlangıçta rasgele:
seçilir ve:
işlemleri sıralı olarak uygulanır. Her adımda:
hesaplanır. Bu yaklaşım önceden smoothness bound seçmeyi gerektirmese de exponent'ı birer birer büyüttüğü için kaynakta pratik olmayan ölçüde pahalı kabul edilir.
IPP1 nasıl çalışıyor?
IPP1 önce belirli asal listenin bütün elemanlarını tek üründe birleştirir:
ve ardından:
işlemini tekrarlayarak bütün asalları aynı iteration sayısı boyunca birlikte yükseltir.
Bu yöntem asal üsleri birbirine yakınsa avantajlı olabilir. Ancak tek bir asalın gerçek üssü yüksek olduğunda bütün diğer asal adayları da aynı tekrar sayısına maruz kalır. DSP'nin hedeflediği temel gereksiz maliyet budur.
IPP1 teorik maliyet modeli
Kaynak Theorem 1'de \(p_t\ge p_{\sigma_s}\) koşulu altında:
üst maliyetini verir.
\(p_t=p_{\sigma_s}\) seçilirse:
elde edilir.
Birinci terim asal-listesi ürününün maliyetini; ikinci terim tekrarlanan GCD maliyetini; üçüncü terim tekrarlanan modular exponentiation'ın baskın maliyetini temsil eder.
DSP'nin ana algoritması
DSP'nin girdileri:
- \(N\): çarpanlarına ayrılacak iki-asallı modül.
- \(\gamma\): aday asal listesinin global üst sınırı.
çıktısı ise bulunan asal çarpan veya başarısızlığı gösteren \(\perp\)'dir.
Başlangıçta:
ve:
hesaplanır.
İlk GCD non-trivial bir çarpan vermiyorsa:
ile dynamic scaling başlatılır.
\(j<k_0\) için ilgili asal alt-kümesi:
oluşturulur.
Bu aralıktaki asalların ürünü:
olarak hesaplanır.
Dinamik exponent:
ve bir sonraki aşamanın accumulator'ü:
olur.
Her turda:
ve ardından:
hesaplanır.
Non-trivial \(d\) bulunursa algoritma çarpanı döndürür. Bulunamazsa bir sonraki asal/üs ölçeğine ilerler.
DSP'nin ikinci fazı neden farklı?
Kaynakta son asal alt-kümesi \(\mathcal{P}_{k_0}\) için özel bir gözlem yapılır. Bu aralıktaki asallar o kadar büyüktür ki \(P_{\mathrm{div}}\) içinde bunlardan aynı anda iki tanesinin bulunması büyüklük sınırıyla çelişecektir. Bu nedenle son alt-kümede bütün asalları yüksek üslere çıkaran pahalı bir işlem yerine Pollard'ın shift modular exponentiation yaklaşımı kullanılır.
Ardışık asal adaylar arasındaki yarı fark için:
hesaplanır ve:
önceden hesaplanır. Böylece ardışık asal adaylarına geçişte exponentiation baştan yapılmak yerine asal aralığındaki farklardan yararlanılır.
DSP'de ara ürün yeniden kullanımı neden işe yarıyor?
Kaynağın Example 1'i iki asal \(p_1,p_2\) için:
ifadesini iki farklı biçimde hesaplamayı karşılaştırır.
Birinci yöntemde:
bir kere hesaplanır ve:
sonra:
hesaplanır.
İkinci yöntemde exponent önce doğrudan:
olarak oluşturulur ve tek modüler üs alma yapılır.
Modüler exponentiation maliyeti exponent bit uzunluğuna yaklaşık doğrusal olduğu için iki yöntemin modular exponentiation maliyetleri birbirine yakın olabilir; ancak ikinci yöntem ayrıca büyük exponent'ın karesini üretmek zorundadır. Kaynağın çıkarımı, ara ürünün yeniden kullanılmasının exponent-oluşturma maliyetini azaltabildiğidir.
DSP teorik maliyet modeli
Kaynak Theorem 2'de ilgili durumda DSP maliyetini:
şeklinde verir.
Burada:
- \(p_{\sigma_s}\): \(P_{\mathrm{div}}\)'deki en büyük gerçek asal çarpan.
- \(p_{\sigma_x}^{u_{\sigma_x}}\): en büyük asal-kuvvet bileşeni.
- \(n_N\): modül bit uzunluğu.
- \(C_1\): büyük tamsayı çarpımı maliyet sabiti.
- \(C_2\): GCD maliyet sabiti.
- \(o(\cdot)\): baskın terimlerden daha yavaş büyüyen düşük mertebeli terimleri gösterir.
Bu teorem kaynakta başarıyla faktörlenebilir durum için kurulmuştur. Başarısızlık senaryosunun bütün maliyeti bu ifadeye dahil değildir.
DSP Neden IPP1'den Daha Az Gereksiz Üs Hesaplayabilir?
IPP1 seçilen asal listesindeki bütün asal adaylarını aynı \(u_{\max}\) tekrar sayısına kadar birlikte yükseltirken DSP asal büyüklüğü arttıkça mümkün üs sınırının düştüğü gerçeğini kullanarak farklı asal aralıklarını farklı hızlarda ölçekler; bu nedenle tek bir küçük asalın yüksek üs taşıması diğer bütün adayların aynı yüksek üssü gereksiz yere almasına yol açmaz.
%95 sonucu nasıl elde ediliyor?
Kaynak Theorem 1 ve Theorem 2 maliyetlerini karşılaştırırken DSP'nin daha düşük maliyetli olabileceği bir eşitsizlik elde eder. Ardından \(P-1\)'in largest-prime-factor dağılımı için Riesel'de tanımlanan \(\rho_1\) fonksiyonuna başvurur.
\(p_{\sigma_s}\ge64\) olduğunda:
ve kaynak kullandığı sonuçtan:
olduğunu aktarır. \(\rho_1\) monoton azalan olduğundan ilgili olay için:
sonucuna ulaşılır.
Bu nedenle makaledeki “%95'ten fazla” ifadesi bir teorik maliyet-karşılaştırma olasılığıdır. RSA anahtar kırma başarı oranı, güvenlik seviyesi veya deneysel 100 örnekten 95'inin kırıldığı anlamına gelmez.
DSP Genel Olarak RSA'yı Kıran Bir Algoritma mıdır?
Hayır; DSP Pollard P-1 ailesinin özel amaçlı bir faktörleme yöntemidir ve verimli olması için \(P-1\) veya \(Q-1\)'in küçük asal çarpanlardan oluşan uygun smooth yapıyı taşıması gerekir; çalışmanın 1024-bit test modülleri de bu yapının mevcut olmasını sağlamak amacıyla özel olarak üretilmiştir.
Fast Multiplication problemi nedir?
DSP ve IPP1 çok sayıda asal adayın ürününü hesaplamak zorundadır. Basit Normal Multiplication (NM) yönteminde:
listesi için ilk eleman sürekli büyüyen akümülatör olarak kullanılır:
Bu durumda her yeni çarpım bir öncekinden çok daha büyük bir tamsayıyla yapılır.
FM nasıl çalışıyor?
Fast Multiplication listede en küçük ile en büyük, ikinci küçük ile ikinci büyük elemanı eşleştirir:
ve:
yaparak listeyi her turda yaklaşık yarıya indirir.
Liste eleman sayısı tek ise başa çarpma etkisi olmayan 1 eklenir. İşlem tek bir ürün kalana kadar tekrarlanır.
Fast Multiplication Neden Normal Multiplication'dan Daha Ucuz Olabilir?
Normal Multiplication sürekli büyüyen tek bir akümülatörü yeni elemanlarla çarptığı için çok dengesiz operand boyutları üretirken FM büyük ve küçük elemanları simetrik biçimde eşleyip dengeli bir çarpım ağacı kurar; kaynağın büyük-tamsayı maliyet modelinde bu yapı asal-listesi ürününde yaklaşık \(4^n\) ölçekli NM maliyetini yaklaşık \(2^n n^2\) ölçekli FM maliyetine düşürmektedir.
Normal Multiplication karmaşıklığı
Theorem 3'te:
ifadesi verilir.
\(p=1\) ise:
olur.
Asal sayıların yaklaşık yoğunluğu Prime Number Theorem ile hesaba katıldığında, bütün \(n\)-bit sınırı altındaki asalların NM ile ürün maliyeti kaynakta:
biçiminde verilir.
Fast Multiplication karmaşıklığı
Theorem 4:
sonucunu verir.
\(p=1\) için:
olur.
Asal listesi için Corollary 2'de:
elde edilir.
\(n_1=0,n_2=n\) düşünüldüğünde temel ölçek:
olurken NM tarafı \(4^n\) ile büyür. Kaynak Şekil 4'te 21-26 bitlik maksimum asal çarpan boyutları için teorik eğrilerin gerçek ölçümlerle iyi uyuştuğunu göstermektedir. Ham ölçüm tablosu verilmediğinden Verianla grafikten kesin süre çıkarmamaktadır.
Çalışmanın Yöntemi ve Bulguları
Deney 1: Dört Pollard P-1 varyantının karşılaştırılması
Kaynak dört implementation'ı karşılaştırır:
- DSP + Fast Multiplication.
- IPP1 + Fast Multiplication.
- Özgün Pollard P-1.
- Bishop'un trivial Pollard P-1 varyantı.
Deney kod deposu kaynakta şu şekilde verilmiştir:
https://github.com/Summwer/expemeriment_of_pollardpm1
Kaynak bağlantı için 1 Ağustos 2026 erişim tarihi vermektedir.
1024-bit test modülleri nasıl üretildi?
Yazarlar önce \(P\)'yi, \(P-1\) değeri birkaç rasgele üretilmiş 30-bit sayının ürünü olacak biçimde oluşturmuştur. Böylece \(P-1\)'in en büyük asal çarpanı:
olmakta ve test örneklerinin Pollard P-1 ailesi tarafından çözülebilir olması amaçlanmaktadır.
Daha sonra \(P\) ile aynı bit uzunluğunda rasgele bir asal \(Q\) üretilir ve:
hesaplanır.
Kaynak metni bu yöntemle **10 adet 1024-bit \(N\)** üretildiğini söyler. Buna karşılık kaynak Şekil 7'nin görünür x ekseninde yalnız instance 1-8 yer almaktadır. Kaynak bu farklılığı açıklamamaktadır.
Deney donanımı
| Öğe | Kaynakta bildirilen değer |
|---|---|
| İşletim sistemi | Ubuntu 20.04.1 |
| Mimari | x86-64 |
| CPU | Intel Core i5-9500 @ 3.00 GHz |
| Kaynakta yazılan CPU bilgisi | 6 × Intel Core i5-9500 |
| RAM | 16 GB |
| Çalıştırma | Single thread |
| Modül | 1024-bit \(N=PQ\) |
| \(P,Q\) bit uzunluğu | Yaklaşık 512 bit |
Deney 1'in ana hız sonucu
| Karşılaştırılan yöntem | DSP'nin kaynakta bildirilen yaklaşık hız avantajı | Bağlam |
|---|---|---|
| IPP1 + FM | 23,5× | Özel olarak oluşturulmuş 1024-bit test modülleri |
| Özgün Pollard P-1 | 16,4× | Aynı test düzeni |
| Trivial Pollard P-1 | 35,6× | Aynı test düzeni |
Kaynak, yüksek asal-üslerinin bulunduğu instance 2, 3, 4, 5 ve 8'in bu davranışı görünür kıldığını belirtmektedir. Instance 2, 3, 4 ve 8'de IPP1'in özgün Pollard P-1'den bile daha yavaş olduğu, buna rağmen DSP'nin özgün algoritmadan daha hızlı kaldığı raporlanmıştır.
Yazarların yorumu, DSP'nin maliyetinin asal çarpanların sayısından veya asalın sıra indeksinden çok en büyük asal çarpanın büyüklüğüne duyarlı olduğudur. Bu, kaynağın kendi deneysel ve teorik yorumudur; başka dağılımlardaki bütün \(P-1\) yapıları için yeni bir evrensel sonuç olarak genişletilmemelidir.
Deney 2: Tek bir yüksek üs kontrollü olarak büyütülüyor
İkinci deneyde 512-bit \(P\) şu yapıda oluşturulur:
ve:
kullanılır.
Bu tasarımın amacı diğer koşulları kontrollü tutarken 3 asalının üssünü büyütmek ve IPP1 ile DSP arasındaki farkı sistematik biçimde gözlemlemektir.
Her \(P\) için rasgele 512-bit \(Q\) seçilir ve:
üretilir.
DSP için:
- Algorithm 4 gerçek implementation,
- Algorithm 6 DSPEst estimator,
- Theorem 2 teorik maliyet
karşılaştırılır.
IPP1 için ise:
- Algorithm 3 gerçek implementation,
- Algorithm 5 IPP1Est estimator,
- Theorem 1 teorik maliyet
karşılaştırılır.
Şekil 8'de teorik maliyet çizgileri, estimator noktaları ve gerçek deney noktaları aynı artış eğilimini yakından takip etmektedir. Bu sonuç, çalışmanın maliyet modellerinin test edilen bu yapılandırmalarda implementation davranışını iyi temsil ettiğini desteklemektedir. Kaynak ham nokta değerlerini tablo olarak vermediğinden yeni ara değer üretilmemektedir.
Teorik %95 karşılaştırmasının doğru yorumu
Kaynağın teorik sonucu:
- \(p_{\sigma_s}\ge64\) koşulunu,
- Riesel'in \(\rho_1\) fonksiyonunu,
- Theorem 1 ve Theorem 2 maliyet modellerini
birlikte kullanmaktadır.
Bu nedenle “DSP %95 başarı oranına sahiptir” demek yanlıştır. Kaynağın söylediği, belirli koşullar altında DSP'nin IPP1'den düşük teorik hesaplama maliyetine sahip olmasını destekleyen olayın olasılığının en az 0,95 olmasıdır.
Çalışmanın desteklediği sonuçlar
- DSP, Pollard P-1'in asal adayları ve gerekli üsleri aynı dinamik tarama düzeninde ele alan yeni bir varyantıdır.
- Daha önce hesaplanan asal ürünlerinin yeniden kullanılması, yüksek exponent oluşturma maliyetini azaltabilir.
- DSP, asal büyüklüğüne göre exponent tahsisini değiştirerek IPP1'in bütün adayları \(u_{\max}\)'a kadar taşımasından doğan gereksiz hesapları azaltır.
- Fast Multiplication dengeli bir çarpım ağacı kullanarak kaynak maliyet modelinde Normal Multiplication'dan daha iyi asimptotik davranış gösterir.
- Kaynak Şekil 4'te NM/FM teorik maliyet modelleri ile deneysel maliyetlerin iyi uyuştuğunu göstermektedir.
- Kaynağın teorik koşullarında \(p_{\sigma_s}\ge64\) olduğunda DSP'nin IPP1 maliyetinden daha düşük olması için kullanılan olasılık en az 0,95'tir.
- Kaynağın yapılandırılmış 1024-bit deneylerinde DSP, karşılaştırılan üç eski varyanttan daha hızlıdır.
- Kaynak yüksek asal-üslerinin bulunduğu durumda DSP avantajının daha görünür hâle geldiğini bildirmektedir.
- Kontrollü \(u_x\) deneyinde Theorem 1/2, estimator'lar ve implementation maliyetlerinin eğilimleri birbirine yakındır.
Çalışmanın desteklemediği sonuçlar
- DSP'nin genel 1024-bit RSA modüllerini verimli biçimde faktörlediği sonucu çıkarılamaz.
- 23,5×, 16,4× ve 35,6× hız oranları bütün RSA anahtarlarına genellenemez.
- %95 değeri genel RSA faktörleme başarı oranı değildir.
- DSP'nin Number Field Sieve gibi genel amaçlı faktörleme yöntemlerinden genel olarak hızlı olduğu test edilmemiştir.
- Çalışmanın deneyleri quantum factoring karşılaştırması değildir.
- Karmaşıklık teoremleri başarısız faktörleme senaryosunun tam maliyet analizini içermez.
- Çok çekirdekli veya GPU hızlandırmalı performans test edilmemiştir.
- Başka CPU, arbitrary-precision library veya implementation ortamında aynı hız oranlarının korunacağı kanıtlanmamıştır.
- Şekil 7'de görünmeyen instance 9 ve 10 için süre değerleri kaynaktan çıkarılamaz.
Temel yöntemsel ve yeniden üretilebilirlik sınırlılıkları
- Deney örnekleri Pollard P-1 ile çözülebilecek smooth yapı özellikle sağlanarak oluşturulmuştur.
- Karşılaştırma tek bir kişisel bilgisayarda ve single-thread çalıştırılmıştır.
- Kaynak metni ilk deney için 10 adet 1024-bit modül söylerken Şekil 7 yalnız sekiz instance göstermektedir.
- Şekil 7'nin bütün bar yükseklikleri tablo olarak verilmemiştir.
- Şekil 8'in ham deney, estimator ve teori değerleri tablo hâlinde yayımlanmamıştır.
- DSP/IPP1 teorik karmaşıklık bölümü açıkça solvable situation ile sınırlanmış ve failure scenario dışlanmıştır.
- Kaynakta deneylerde kullanılan arbitrary-precision arithmetic library'nin sürümü ayrıntılı olarak raporlanmamaktadır.
- Makale klasik sayı teorisi ve klasik hesaplama bağlamındadır; quantum factoring sonucu sunmamaktadır.
Çalışmanın kriptografik anlamı
Pollard P-1 algoritmaları RSA'nın temel integer-factorization problemindeki genel zorluğu ortadan kaldırmaz. Bunun yerine prime generation sırasında ortaya çıkabilecek belirli algebraic weakness'ları hedefler. Makalenin katkısı da bu özel zayıflık mevcut olduğunda faktörleme sürecinin daha az gereksiz hesapla yürütülmesine yöneliktir.
Bu nedenle araştırmanın doğru özeti “RSA artık kırıldı” değildir. Daha doğru ifade, smooth \(P-1\) veya \(Q-1\) yapısına sahip özel kompozitlerde Pollard P-1 faktörlemesini hızlandırmayı amaçlayan yeni bir traversal/exponent-scaling stratejisinin teorik ve deneysel olarak incelenmiş olmasıdır.
Kaynak ve Yöntem Notu
Özgün başlık: Dynamic Scaling Pollard’s P-1 Algorithm
Yazarlar: Wenwen Xia; Geng Wang; Dawu Gu.
Yazar sırası: Wenwen Xia birinci; Geng Wang ikinci; Dawu Gu üçüncü yazardır.
Sorumlu yazarlar: Geng Wang ve Dawu Gu.
Kurum: School of Cyber Science and Engineering, Shanghai Jiao Tong University, Shanghai 200240, China.
Eş katkı: Kaynakta eş birinci yazarlık veya eş katkı beyanı bulunmamaktadır.
Dergi: Cryptography.
Yayıncı: MDPI.
Cilt / sayı / makale: 10(4), Article 57.
Sayfa sayısı: 26.
DOI: 10.3390/cryptography10040057.
Academic Editor: Josef Pieprzyk.
Gönderim: 14 Haziran 2026.
Revizyon: 23 Temmuz 2026.
Kabul: 29 Temmuz 2026.
Yayın: 13 Ağustos 2026.
Version of Record notu: Resmî MDPI Version Notes kaydında ilk Version of Record PDF'si 13 Ağustos 2026'da, güncellenmiş PDF/HTML sürümü ise 17 Ağustos 2026'da yayımlanmıştır.
Kaynak türü: Hakemli araştırma makalesi; sayı teorisi, klasik kriptanaliz, algoritma tasarımı, asimptotik karmaşıklık analizi ve kontrollü bilgisayar deneyini birleştirir.
Hakemlik: Cryptography hakemli bir MDPI dergisidir. Derginin submission materyalleri single-anonymized peer review sürecini bildirmektedir.
Preprint durumu: İşlenen kaynak yayımlanmış Version of Record'dur; bu makalede ayrı bir preprint temel alınmamıştır.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Resmî bağlantı: https://doi.org/10.3390/cryptography10040057
Anahtar kelimeler: cryptanalysis; RSA; integer factorization; Pollard’s P-1.
Ana bilimsel katkı: Dynamic Scaling Pollard’s P-1 (DSP) ve Fast Multiplication (FM).
Karşılaştırılan algoritmalar: DSP; IPP1; özgün Pollard P-1; Bishop'un trivial Pollard P-1 varyantı.
Teorik modeller: Büyük tamsayı multiplication, sliding-window modular powering, binary normal powering ve GCD maliyetlerinin bileşiminden DSP/IPP1 cost estimator'ları oluşturulmuştur.
Temel DSP özelliği: Asal adayları double-exponential büyüklük aralıklarına ayırmak, daha küçük asalları daha yüksek üs seviyelerine kademeli olarak taşımak ve daha önce hesaplanmış asal ürünlerini yeniden kullanmak.
FM özelliği: Artan listedeki simetrik uç elemanları pairwise çarparak her turda listeyi yaklaşık yarıya indiren dengeli multiplication tree.
Birinci deney: \(P-1\)'in birkaç rasgele 30-bit sayının ürünü olacak biçimde üretildiği, 512-bit \(P\) ve yaklaşık aynı boyuttaki rasgele \(Q\)'dan 1024-bit \(N=PQ\) test modülleri.
İlk deney ortamı: Ubuntu 20.04.1; x86-64; Intel Core i5-9500 @ 3.00 GHz; 16 GB RAM; single thread.
İlk deney ana sonucu: Kaynak DSP'nin yaklaşık olarak IPP1'den 23,5×, özgün Pollard P-1'den 16,4× ve trivial varyanttan 35,6× hızlı olduğunu bildirir.
İlk deney kaynak içi uyuşmazlığı: Metin 10 adet 1024-bit test instance'ı bildirirken kaynak Şekil 7'nin görünür x ekseninde yalnız 1-8 instance'ları vardır. Kaynak bu farkı açıklamamaktadır.
İkinci deney: \(P=2\times3^{u_x}\times1073741789\times z+1\), \(u_x\in\{0,20,40,60,80,100\}\); rasgele 512-bit \(Q\); DSP ve IPP1 için teori-estimator-deney karşılaştırması.
Teorik %95 sonucu: \(p_{\sigma_s}\ge64\) koşulunda Riesel'in \(\rho_1\) fonksiyonuna dayalı türetimde DSP lehine kullanılan maliyet koşulu için en az 0,95 olasılık elde edilmektedir. Bu bir RSA kırma başarı oranı değildir.
Kod deposu: https://github.com/Summwer/expemeriment_of_pollardpm1 — kaynakta erişim tarihi 1 Ağustos 2026 olarak verilmiştir.
Finansman: National Cryptologic Science Fund of China, No. 2025NCSF02017.
Veri erişilebilirliği: Yazarlar sonuçları destekleyen ham verilerin talep üzerine sağlanacağını belirtmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir.
Yazar katkıları: Conceptualization, methodology, software, validation, formal analysis, investigation, data curation ve original draft: Wenwen Xia; resources: Dawu Gu; visualization: Wenwen Xia ve Geng Wang; supervision ve project administration: Geng Wang ve Dawu Gu; funding acquisition: Geng Wang ve Dawu Gu.
Etik kurul / bilgilendirilmiş onam: Kaynakta ayrı bir etik kurul veya informed-consent beyanı bulunmamaktadır; çalışma matematiksel algoritma ve sentetik/hesaplamalı faktörleme deneyidir.
Temel yöntemsel sınırlılıklar: Teorik cost analysis başarısızlık senaryosunu dışlar; deney modülleri Pollard P-1'e uygun smooth yapı sağlanarak üretilmiştir; karşılaştırma tek makine ve single-thread'dir; ilk deneyde metin-grafik instance sayısı uyuşmazlığı vardır; Şekil 7-8'in ham sayısal verileri tablo olarak verilmemiştir.
Genel yorum sınırı: Çalışma, uygun smooth \(P-1\) veya \(Q-1\) yapısına sahip modüllerde Pollard P-1 faktörlemesinin DSP ve FM ile hızlandırılabileceğini destekler; arbitrary RSA modulus, genel NFS karşılaştırması veya modern bütün RSA anahtarlarının pratik olarak kırılabildiği sonucunu desteklemez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir