


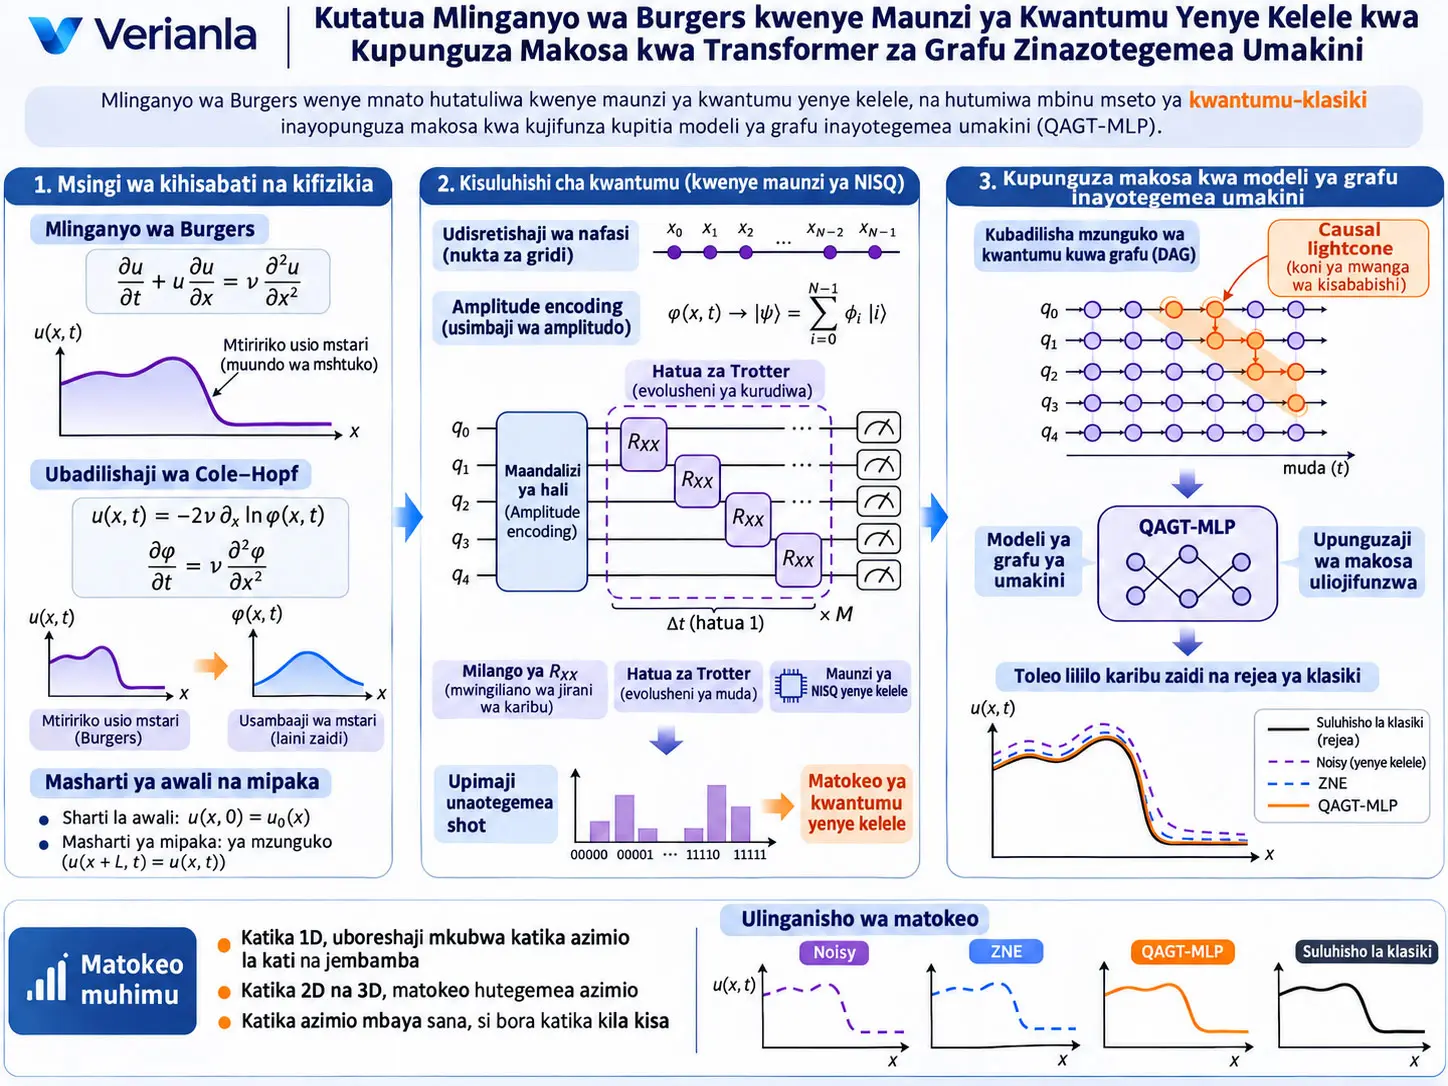
Utafiti huu ni mfumo wa ukokotoaji mseto wa kwantumu-klasiki unaojaribu kutatua kwa ukadiriaji mlinganyo wa Burgers wenye mnato kwenye maunzi ya kwantumu ya kiwango cha kati yenye kelele (Noisy Intermediate-Scale Quantum, NISQ), huku ukipunguza makosa yanayotokana na kwantumu kwa kutumia mtandao wa neva wa grafu wa klasiki unaotegemea umakini. Katika mbinu hii, mlinganyo wa Burgers usio wa mstari hubadilishwa kwanza kwa ubadilishaji wa Cole–Hopf kuwa tatizo la difusheni la mstari. Uga wa Cole–Hopf uliogawanywa unaopatikana husimbwa katika amplitudo za hali ya kwantumu; mageuzi ya wakati hukadiriwa kwa saketi zilizofanyiwa Trotterization zinazoundwa na geti za \(R_{XX}\) za qubit mbili zilizo jirani zaidi. Kisha nyuga za kasi zilizoundwa upya kutoka kwenye vipimo vya kwantumu hulinganishwa na suluhisho la klasiki la Krylov lenye usahihi wa juu. Katika hatua ya mwisho, modeli ya grafu inayotegemea attention inayoitwa QAGT-MLP hujifunza kutengeneza uga uliosahihishwa ulio karibu zaidi na rejea ya klasiki kwa kutumia muundo wa saketi ya kwantumu, taarifa ya causal lightcone, sifa za jumla za saketi na matokeo yenye kelele.
Utafiti hautumii simulator ya kwantumu pekee. Pamoja na uigaji wenye kelele wa Qiskit Aer, majaribio pia yamefanywa kwenye maunzi halisi ya kwantumu ya IBM. Matokeo ya kwantumu hutathminiwa kwa vipimo vitatu vikuu: kosa la \(L_2\) kati ya nyuga za kasi za klasiki na za kwantumu, nafasi ya mshtuko inayobainishwa kutokana na mahali pa gradienti kali zaidi ya kasi, na kiwango cha dissipation kinachokokotolewa kutoka kwenye gradienti za mnato. Mbinu ya jadi ya kupunguza makosa ya kwantumu, Zero-Noise Extrapolation (ZNE), pia hutumiwa kama msingi wa kulinganisha.
Katika matokeo ya muhtasari ya 1D ya chanzo, mafanikio ya QAGT-MLP yanategemea sana resolution. Katika kundi la mnato mkubwa, kwa mujibu wa Jedwali 1 la chanzo, wastani wa faida dhidi ya uigaji unaripotiwa kuwa takribani %39,6, %51,5 na %62,6 kwa \(N=16\), \(N=32\) na \(N=64\) mtawalia; dhidi ya matokeo ya maunzi halisi, takribani %40,2, %56,0 na %71,0. Katika kundi la mnato mdogo, faida ni ndogo zaidi lakini bado ni chanya katika Jedwali 2 la chanzo. Hata hivyo, katika baadhi ya mifano binafsi ya \(N=16\), modeli imeongeza kosa badala ya kulipunguza. Kuripotiwa kwa uboreshaji wa −%5,86 kwa kipimo cha MAE katika hali ya 2D 16×16 na −%3,26 katika hali ya 3D 4×4×4 kunaonyesha wazi kwamba mbinu hii si bora kiotomatiki katika kila resolution na kila tatizo.
Matokeo haya hayamaanishi kwamba kompyuta ya kwantumu ni ya haraka kuliko CFD ya klasiki. Utafiti hauonyeshi ubora wa kimahesabu wa complexity, ubora wa kasi ya wall-clock, wala “quantum advantage” dhidi ya kisuluhishi cha klasiki. Suluhisho la klasiki la Cole–Hopf/Krylov linatumika hapa kama rejea yenye usahihi wa juu na lengo la kujifunza kwa mashine. Matokeo ya msingi yanayoonyeshwa na utafiti ni kwamba, katika madarasa fulani ya matatizo ya NISQ Burgers, suluhisho zilizoharibiwa na kelele ya kwantumu zinaweza kusogezwa kwa kiasi kikubwa karibu na rejea ya klasiki kwa kutumia kisahihishi cha klasiki kilichofunzwa ambacho pia hutumia muundo wa saketi.
Kwanza dhana ya msingi: mlinganyo wa Burgers ni nini?
Mlinganyo wa Burgers ni mlinganyo klasiki wa diferensheli sehemu unaounganisha usafirishaji usio wa mstari na difusheni yenye mnato ndani ya modeli moja ya kihisabati. Haubebi ugumu wote wa milinganyo ya Navier–Stokes katika mekanika ya vimiminika; hata hivyo, kwa kuwa unajumuisha tabia muhimu kama advection isiyo ya mstari, gradienti kali na uundaji wa miundo inayofanana na mshtuko, ni muhimu kwa kujaribu mbinu za namba na visuluhishi vya PDE vya kwantumu.
Mlinganyo wa 1D wa Burgers wenye mnato katika utafiti:
\[ \frac{\partial u}{\partial t} + u\frac{\partial u}{\partial x} = \nu\frac{\partial^2u}{\partial x^2}, \qquad \nu>0 \]
Fomula inakokotoa nini? Inaeleza mabadiliko ya uga wa kasi \(u(x,t)\) katika nafasi na wakati.
\(u(x,t)\): Katika chanzo ni uga wa kasi usio na vipimo.
\(x\): Ni nafasi ya kijiometri; katika uundaji mkuu wa 1D, \(x\in[0,1]\).
\(t\): Ni wakati.
\(\nu\): Ni parameta chanya ya mnato.
\(\partial u/\partial t\): Inaonyesha mabadiliko ya kasi kwa wakati.
\(u\,\partial u/\partial x\): Ni sehemu ya advection/usafirishaji usio wa mstari. Sababu kuu ya kuitwa “isiyo wa mstari” ni kwamba \(u\) isiyojulikana inazidishwa na derivativi yake ya nafasi.
\(\nu\,\partial^2u/\partial x^2\): Ni sehemu ya difusheni yenye mnato. Ina mwelekeo wa kulainisha mabadiliko makali katika nafasi.
Kwa maana ya kifizikia, sehemu ya advection huwakilisha kukali zaidi, ilhali sehemu ya mnato huwakilisha kulainika. Kwa thamani ndogo za \(\nu\), gradienti kali hutokea kwa urahisi zaidi; kwa thamani kubwa za \(\nu\), athari ya difusheni huwa na nguvu zaidi. Hii ndiyo sababu hali za mnato mdogo huunda rejimu ngumu zaidi ya tatizo katika uchanganuzi wa vigezo wa chanzo.
Masharti ya awali na ya mipaka
Katika sehemu kuu ya mbinu, chanzo kinatumia masharti ya mipaka ya kasi ya Dirichlet katika ncha zote mbili:
\[ u(0,t)=u_L,\qquad u(1,t)=u_R,\qquad t\ge0 \]
Uga wa awali:
\[ u(x,0)=u_0(x) \]
na katika majaribio ya namba, mfano wa kawaida hutolewa kama:
\[ u_0(x)=\sin(\pi x) \]
Katika uchanganuzi wa vigezo, mpaka wa kushoto \(u_L\) hubadilishwa huku mpaka wa kulia \(u_R=0\) ukiwekwa bila kubadilika.
Kutolingana ndani ya chanzo: Matini kuu inaeleza sharti la awali la \(+\sin(\pi x)\) lililo hapo juu na masharti ya mipaka ya kasi ya Dirichlet katika ncha zote mbili. Hata hivyo, katika mchoro wa Kielelezo cha Ziada 12 cha chanzo, ishara ya fungsi ya awali na baadhi ya lebo za “open boundary” hazilingani kikamilifu na ufafanuzi katika matini kuu. Katika uwasilishaji wa Verianla, mlinganyo mkuu haujabadilishwa kimya kimya, na tofauti kati ya kielelezo na matini imehifadhiwa kama kutolingana ndani ya chanzo.
Kwa nini ubadilishaji wa Cole–Hopf hurahisisha kwa kiasi kikubwa mlinganyo wa Burgers?
Badala ya kujaribu kutatua moja kwa moja sehemu isiyo ya mstari \(u\,u_x\) ya mlinganyo wa Burgers katika saketi ya kwantumu, ubadilishaji wa Cole–Hopf hufafanua uga mpya \(\phi(x,t)\) na kubadilisha tatizo kuwa mlinganyo wa difusheni wa mstari; kwa njia hii, utafiti unaweza kujaribu kuwakilisha kwa ukadiriaji mageuzi ya mstari upande wa kwantumu.
Ubadilishaji wa Cole–Hopf hatua kwa hatua
Chanzo kinafafanua uga mpya wa skala \(\phi(x,t)\):
\[ u(x,t) = -2\nu\frac{\partial}{\partial x}\ln\phi(x,t) = -2\nu\frac{\phi_x(x,t)}{\phi(x,t)} \]
Ingawa usemi huu unaweza kuonekana mgumu kwa mara ya kwanza, wazo kuu ni hili: badala ya uga wa kasi \(u\) kusimbwa moja kwa moja katika hali ya kwantumu, kwanza hubadilishwa kuwa uga msaidizi unaoitwa \(\phi\).
Ubadilishaji unapowekwa katika mlinganyo wa Burgers, hupatikana mlinganyo wa mstari wa joto/difusheni kwa \(\phi\):
\[ \frac{\partial\phi}{\partial t} = \nu\frac{\partial^2\phi}{\partial x^2} \]
Hivyo tatizo hubadilishwa kutoka:
- kwanza: mlinganyo wa Burgers usio wa mstari,
- kisha: mlinganyo wa difusheni wa mstari
kwa muundo huo.
Uga wa awali wa \(\phi\) hupatikana kutoka \(u_0(x)\) kwa uhusiano ufuatao:
\[ \phi_0(x) = \exp\left[ -\frac{1}{2\nu} \int_0^x u_0(y)\,dy \right] \]
Chanzo kinaeleza kwamba konstanti ya jumla ya unormalishaji wa kuzidisha haiathiri uundaji upya wa \(u\). Sababu ni kwamba \(u\) hukokotolewa kutoka uwiano wa \(\phi_x/\phi\); ikiwa \(\phi\) itazidishwa kwa kizidishi cha kudumu, kizidishi hicho hicho kitaonekana katika nambari ya juu na ya chini ya sehemu.
Nafasi inagawanywaje kwa namba?
Eneo la nafasi \([0,1]\) hugawanywa katika \(N\) pointi za grid zilizo na nafasi sawa:
\[ x_j=j\Delta x, \qquad j=0,1,\ldots,N-1, \qquad \Delta x=\frac{1}{N-1} \]
Hapa \(\Delta x\) ni umbali wa nafasi kati ya pointi jirani za grid.
Derivativi ya pili hukadiriwa kwa tofauti ya kati ya kawaida ya mpangilio wa pili:
\[ \frac{\partial^2\phi}{\partial x^2}(x_j,t) \approx \frac{ \phi_{j-1}(t)-2\phi_j(t)+\phi_{j+1}(t) }{\Delta x^2} \]
Ugawanyaji huu hubadilisha PDE endelevu kuwa mfumo wa ODE wa mstari wenye vipimo vya mwisho:
\[ \frac{d\boldsymbol{\phi}}{dt} = \nu L\boldsymbol{\phi} \]
\(L\) ni matriki ya Laplacian iliyogawanywa. Kwa pointi za ndani, koefishenti kuu ni:
\[ L_{j,j}=-\frac{2}{\Delta x^2}, \qquad L_{j,j-1}=L_{j,j+1}=\frac{1}{\Delta x^2} \]
kama ilivyoonyeshwa.
Kutumia mipaka kupitia \(u\) badala ya \(\phi\)
Chanzo hutumia masharti ya mipaka ya Dirichlet kupitia uga wa kasi \(u\), badala ya kuendeleza moja kwa moja thamani za mwisho za \(\phi\):
\[ u_0(t)=u_L, \qquad u_{N-1}(t)=u_R \]
na huweka kuwa sifuri safu ya kwanza na ya mwisho ya matriki ya Laplacian iliyogawanywa:
\[ L_{0,j}=0, \qquad L_{N-1,j}=0 \]
Katika mbinu hii, mienendo ya ndani ya \(\phi\) huendelea kivyake; wakati uga wa kasi unapoundwa upya, kasi za mipakani hupewa moja kwa moja.
Vekta ya awali ya \(\phi\) inakokotolewaje?
Integrali endelevu hukokotolewa kwenye grid iliyogawanywa kwa kanuni ya trapezoid:
\[ I_j \approx \sum_{k=1}^{j} \frac{\Delta x}{2} \left[ u_0(x_k)+u_0(x_{k-1}) \right] \]
kisha:
\[ \phi_j(0) = \exp\left(-\frac{I_j}{2\nu}\right) \]
hupatikana. Vekta hiyo kisha hunormalishwa ili norma yake ya Euclidean iwe 1, hivyo iweze kuandaliwa kama hali ya kwantumu.
Kwa nini suluhisho la rejea ya klasiki linahitajika?
Suluhisho rasmi la mfumo uliogawanywa ni:
\[ \boldsymbol{\phi}(t) = \exp(\nu tL)\boldsymbol{\phi}(0) \]
Chanzo hukadiria athari ya eksponenti hii ya matriki kwenye vekta kwa kutumia propagator inayotegemea Krylov ndani ya QuTiP. Katika mbinu ya nafasi ndogo ya Krylov, badala ya kujenga wazi eksponenti kamili ya matriki kubwa na sparse, athari ya opereta ya eksponenti kwenye vekta fulani ya awali hukokotolewa katika nafasi ndogo zaidi.
Pointi za wakati:
\[ t_n=n\Delta t, \qquad T=N_t\Delta t \]
hufafanuliwa hivyo.
Suluhisho la klasiki katika utafiti si tu “mbinu nyingine ya kulinganisha”. Pia ni lengo la supervised-learning la QAGT-MLP. Yaani, modeli ya kujifunza kwa mashine hujifunza mabadiliko kutoka uga wa kwantumu wenye kelele hadi uga wa rejea ya klasiki ya Krylov.
Uga wa kasi unatolewaje tena kutoka \(\phi\)?
Katika pointi za ndani za grid, hutumiwa umbo lililogawanywa la ubadilishaji wa kinyume wa Cole–Hopf:
\[ u_j(t_n) = -2\nu \frac{ \phi_{j+1}(t_n)-\phi_{j-1}(t_n) }{ 2\Delta x\, \max\big(\phi_j(t_n),\varepsilon\big) } \]
Chanzo kinatoa kama mfano:
\[ \varepsilon=10^{-10} \]
Thamani hii ndogo chanya ya regularization huzuia denomineta kukaribia sifuri au thamani ndogo hatari kihesabu wakati \(\phi_j\) inapokuwa ndogo sana.
Utafiti hufuatilia usahihi kwa vipimo gani vya kifizikia na vya namba?
1. Kosa lililogawanywa la \(L_2\):
\[ E_{L_2}(t_n) = \left[ \sum_{j=0}^{N-1} \Delta x \left( u_j^{q}(t_n)-u_j^{ref}(t_n) \right)^2 \right]^{1/2} \]
Metrika hii hupima tofauti ya jumla ya uga kati ya suluhisho la kwantumu au lililosahihishwa na rejea ya klasiki. Kosa linapoongezeka, suluhisho huenda mbali zaidi na rejea ya klasiki.
2. Nafasi ya mshtuko:
Kwanza gradienti ya kasi iliyogawanywa:
\[ \left(\frac{\partial u}{\partial x}\right)_{j+1/2} \approx \frac{u_{j+1}-u_j}{\Delta x} \]
hukokotolewa. Nafasi yenye gradienti kubwa zaidi kwa thamani kamili ni:
\[ k^\star = \arg\max_{0\le j\le N-2} \left| \frac{u_{j+1}-u_j}{\Delta x} \right| \]
na:
\[ x_{\mathrm{shock}}=x_{k^\star} \]
hufafanuliwa hivyo.
3. Kiwango cha dissipation:
\[ D(t_n) = \nu \sum_{j=0}^{N-2} \left[ \frac{u_{j+1}(t_n)-u_j(t_n)}{\Delta x} \right]^2 \Delta x \]
Kiasi hiki ni kiashiria kilichogawanywa cha dissipation kinachowakilisha athari ya jumla ya gradienti za mnato. Husaidia kutathmini si tu kosa la pointi moja, bali pia kama muundo wa kifizikia wa gradienti za suluhisho umehifadhiwa.
Tuelewe ukokotoaji wa kwantumu kuanzia mwanzo: qubit ni nini?
Biti ya klasiki huwa katika hali ya 0 au 1 pekee. qubit moja, kwa upande mwingine, kabla ya kipimo inaweza kwa ujumla kufafanuliwa kwa hali ya kwantumu:
\[ |\psi\rangle=\alpha|0\rangle+\beta|1\rangle \]
na katika hali iliyonormalishwa lazima:
\[ |\alpha|^2+|\beta|^2=1 \]
iwe kweli. \(\alpha\) na \(\beta\) si uwezekano wa klasiki moja kwa moja, bali ni amplitudo za uwezekano ambazo zinaweza kuwa kompleks. Baada ya kipimo, uwezekano wa kuona 0 ni \(|\alpha|^2\), na uwezekano wa kuona 1 ni \(|\beta|^2\).
Qubit nyingi zinapotumiwa, nafasi ya hali hukua kwa eksponenti. Kwa \(n\) qubit kuna \(2^n\) computational basis state:
\[ |0\rangle,\ |1\rangle,\ldots,\ |2^n-1\rangle \]
Wazo kuu la mbinu ya amplitude encoding katika utafiti ni kutumia amplitudo za vekta hii kubwa ya hali kubeba thamani za grid za nafasi.
Amplitude encoding inawakilishaje pointi \(N\) za grid kwa kutumia qubit chache?
Utafiti huweka thamani \(N\) za Cole–Hopf zilizogawanywa katika amplitudo \(2^n\) za hali ya kwantumu; hivyo idadi ya qubit inayohitajika huwa \(n=\lceil\log_2N\rceil\), lakini uwakilishaji huu wa kompakt hauondoi gharama za kuandaa data katika hali ya kwantumu, kutoa taarifa kutoka kwenye mageuzi, na sampuli za kipimo.
Idadi ya Qubit
Ufafanuzi wa chanzo:
\[ n=\lceil\log_2N\rceil, \qquad D=2^n \]
Kwa mfano:
- kwa \(N=8\), \(n=3\) qubit,
- kwa \(N=16\), \(n=4\) qubit,
- kwa \(N=32\), \(n=5\) qubit,
- kwa \(N=64\), \(n=6\) qubit
zinatosha.
Ikiwa \(N\) si sawa kabisa na \(2^n\), chanzo hujaza vekta kwa sifuri hadi ukubwa wa \(D=2^n\) au huiingiza kulingana na muundo uliobainishwa:
\[ \psi_k^{(0)} = \begin{cases} \tilde{\phi}_k,&0\le k\le N-1,\\ 0,&N\le k\le D-1. \end{cases} \]
Hali ya mwisho ya kwantumu iliyonormalishwa ni:
\[ |\psi(0)\rangle = \sum_{k=0}^{D-1} \psi_k^{(0)}|k\rangle \]
.
Kwa nini amplitude encoding si “uongezaji kasi wa eksponenti bila gharama”?
Uwezo wa kuwakilisha vekta yenye vipimo \(2^n\) katika amplitudo za \(n\) qubit ni sifa yenye nguvu ya kihisabati. Hata hivyo, kutokana na hilo pekee haiwezekani kuhitimisha kwamba “tumesimba namba \(N\) za klasiki kwa \(\log_2N\) qubit, kwa hiyo ukokotoaji umeharakishwa kwa eksponenti”.
Kwa sababu katika algoritmi halisi ya kwantumu pia kuna gharama za:
- kuandaa vekta ya awali kuwa hali ya kwantumu,
- kutekeleza operesheni za kwantumu zinazohitajika,
- kelele ya maunzi,
- kufanya vipimo kwa shot nyingi,
- kutoa upya uga wa klasiki unaohitajika kutoka kwenye vipimo
. Utafiti huu hautoi matokeo yanayoondoa kabisa gharama hizi au kuthibitisha ubora wa kasi wa asimptoti dhidi ya mbinu ya klasiki.
Hamiltonian inamaanisha nini?
Katika mekanika ya kwantumu, Hamiltonian ni opereta inayobainisha mageuzi ya wakati ya mfumo. Chanzo hutumia Hamiltonian yenye mwingiliano wa qubit jirani zaidi ili kuiga mienendo ya difusheni iliyogawanywa:
\[ H = \sum_{i=0}^{n-2} \alpha X_iX_{i+1} \]
.
\(X_i\) ni opereta ya Pauli-\(X\) kwenye qubit ya \(i\). \(X_iX_{i+1}\) ni sehemu ya mwingiliano kati ya qubit mbili jirani. \(\alpha\) ni koefishenti inayobainisha kipimo cha uchanganyaji.
Geti ya \(R_{XX}\) na Trotterization huundaje mageuzi ya wakati ya kwantumu?
\(R_{XX}\) ni mzunguko wa unitary unaozalisha mwingiliano wa \(X\otimes X\) kati ya qubit mbili; utafiti hurudia geti hizi kwenye jozi za qubit jirani na kugawanya wakati katika hatua ndogo za Trotter ili kuunda mageuzi ya kwantumu ya ukadiriaji yanayofanana na mienendo ya difusheni ya Cole–Hopf.
Geti ya \(R_{XX}\)
Chanzo hutumia ufafanuzi:
\[ R_{XX}(\theta) = \exp\left( -i\frac{\theta}{2}X\otimes X \right) \]
.
Kuwa unitary kunamaanisha nini? Geti bora ni mabadiliko yanayoweza kugeuzwa ambayo huhifadhi norma ya jumla ya uwezekano wa hali ya kwantumu.
\(\theta\): Ni pembe ya mzunguko na katika chanzo huchaguliwa kama:
\[ \theta = \frac{2\nu\Delta t}{\Delta x^2} \]
.
Uhusiano huu unaunganisha mnato, hatua ya wakati na resolution ya grid ya nafasi na kipimo cha mzunguko wa geti ya kwantumu.
\(\nu\) inapoongezeka, \(\theta\) huongezeka. \(\Delta t\) inapoongezeka, \(\theta\) huongezeka. \(\Delta x\) inapopungua, kwa kuwa \(\Delta x^2\) iko kwenye denomineta, \(\theta\) huongezeka kwa nguvu. Uhusiano huu wa kihisabati unaonyesha kuwa grid nyembamba zinaweza kuathiri parameta za saketi na muundo wa mageuzi.
Mbinu ya Trotter
Wakati lengwa \(t\) hugawanywa katika hatua za ukubwa \(\Delta t\):
\[ M = \max\left( 1,\left\lfloor\frac{t}{\Delta t}\right\rfloor \right) \]
na mageuzi ya jumla hukadiriwa kwa:
\[ U(t) \approx \left[U(\Delta t)\right]^M \]
.
Hatua moja ya Trotter:
\[ U(\Delta t) = \prod_{i=0}^{n-2} R_{XX}^{(i,i+1)}(\theta) \]
huundwa na geti za \(R_{XX}\) zinazotumika kwa jozi za qubit jirani.
Kwa nini Trotterization ni “ya ukadiriaji”? Ikiwa Hamiltonian imeundwa na jumla ya sehemu tofauti ambazo kwa ujumla hazicommute, kubadilisha mabadiliko yote ya eksponenti kwa zao la eksponenti ndogo tofauti kunaweza kuzalisha kosa la Trotter katika hatua ya wakati yenye ukubwa usio sifuri. Hatua zinapopungua, ukaribiaji bora wa kihisabati unaweza kuboreka; lakini kwenye maunzi halisi ya NISQ, hatua nyingi zaidi pia zinaweza kumaanisha saketi yenye kina zaidi na kelele zaidi. Hii ni mojawapo ya mizani ya msingi ya usahihi–kelele katika algoritmi za NISQ.
Kikomo muhimu cha dhana: difusheni na mageuzi ya unitary si kitu kimoja
Maelezo ya dhana; si matokeo mapya ya utafiti: Opereta ya klasiki ya difusheni \(\exp(\nu tL)\) ni mageuzi ya dissipative na kwa ujumla si unitary. Kinyume chake, saketi ya \(R_{XX}\) iliyoundwa na geti bora za kwantumu ni unitary. Chanzo kinaeleza kuwa kipimo kilichaguliwa ili mchanganyiko wa Hamiltonian wa majirani wa karibu “uige” tabia ya difusheni iliyogawanywa; hata hivyo, katika matini ya chanzo iliyochunguzwa hakuna utoaji wa kina wa kihisabati wa usawa kamili wa kiopereta kati ya Hamiltonian ya \(n\)-qubit \(X_iX_{i+1}\) na Laplacian iliyogawanywa ya \(N\times N\).
Kwa hiyo, katika uwasilishaji wa Verianla, saketi ya \(R_{XX}\) haielezwi kama “sawa kabisa kihisabati na opereta ya difusheni”. Kwa mujibu wa mfumo wa chanzo chenyewe, inafafanuliwa kama modeli ya saketi ya kwantumu inayotumiwa kuiga kwa ukadiriaji mienendo ya difusheni.
Qiskit na maunzi ya IBM yametumiwaje?
Utafiti huunda saketi kwa Qiskit na Qiskit Aer. Kuna aina mbili za backend za kwantumu:
- AerSimulator yenye kelele: imesanidiwa kwa modeli halisi ya kelele iliyochukuliwa kutoka kifaa halisi cha IBM.
- Maunzi halisi ya NISQ: chanzo kinataja backend ya
ibm_torinona imefikiwa kupitia IBM Quantum Runtime.
Kabla ya kuendeshwa, saketi hufanyiwa transpile kulingana na topolojia ya kifaa na sifa za backend.
Kwa kila hali ya parameta/wakati, kwa uigaji wenye kelele chanzo kwa kawaida hutumia:
\[ N_{\mathrm{shots}}=8192 \]
vipimo.
Shot ni nini?
Kuendesha saketi ya kwantumu mara moja na kupima qubit zote huitwa shot moja. Kwa kuwa kipimo cha kwantumu ni cha uwezekano, shot moja kwa kawaida haitoshi. Saketi ile ile hurudiwa maelfu ya mara na huhesabiwa ni mfuatano gani wa bit umeonekana mara ngapi.
Kwa mfano, kwa qubit nne matokeo ya kipimo yanaweza kuwa:
0101
kama mfuatano wa bit. Baada ya maelfu ya marudio, marudio ya kila mfuatano wa bit hukadiria uwezekano wa kupima basis state hiyo.
Amplitudo huundwaje upya kutoka matokeo ya kipimo?
Chanzo hutumia:
\[ \psi_k(t) = \sqrt{ \frac{\mathrm{counts}(b_k)} {N_{\mathrm{shots}}} } \]
na kisha hunormalisha tena:
\[ \psi_k(t) \leftarrow \frac{\psi_k(t)} { \left( \sum_{j=0}^{N-1}|\psi_j(t)|^2 \right)^{1/2} } \]
Vekta hii ya amplitudo kisha huchukua nafasi ya uga wa Cole–Hopf uliogawanywa na kasi huundwa upya kwa:
\[ u_j^{q}(t) = -2\nu \frac{ \psi_{j+1}(t)-\psi_{j-1}(t) }{ 2\Delta x\, \max(\psi_j(t),\varepsilon) } \]
.
Kikomo muhimu cha kipimo cha kwantumu: counts hutupa nini, na haitupi nini?
Maelezo ya dhana; si jaribio la ziada kwa matokeo ya chanzo: Kipimo cha Computational-basis hakichukui moja kwa moja amplitudo kompleks \(\psi_k\), bali husampuli uwezekano wake wa Born \(|\psi_k|^2\). Kuchukua mzizi wa mraba wa thamani ya counts hutoa thamani chanya inayohusiana na ukubwa wa amplitudo; pekee yake haitoi awamu ya hali ya jumla ya kwantumu ya kompleks.
Katika mlinganyo wa chanzo, vekta ya amplitudo huundwa kwa kuchukua mzizi wa mraba kutoka counts. Katika PDF iliyochunguzwa, hakuna utaratibu tofauti wa rekonstruksi unaoelezwa kwa tomografia ya awamu, urejeshaji wa awamu, au namna ya kupata taarifa ya ishara/awamu ya amplitudo za jumla za kompleks. Kwa hiyo Verianla haiwasilishi hatua ya kipimo kama “amplitudo zote kompleks za hali ya kwantumu zinapimwa upya kikamilifu”.
NISQ inamaanisha nini?
Noisy Intermediate-Scale Quantum (NISQ) inarejelea darasa la sasa/la awali la maunzi ya kwantumu kabla ya kompyuta kubwa za kwantumu za fault-tolerant zenye usahihishaji wa makosa. Katika vifaa hivi idadi ya qubit na muda wa coherence ni mdogo; makosa hutokea katika geti za qubit moja na hasa qubit mbili; athari kama kosa la readout, decoherence, crosstalk na kalibresheni inayobadilika kwa wakati zinaweza kuharibu matokeo.
Kwa hiyo, matokeo ya kihisabati ya saketi bora ya kwantumu si sawa na matokeo yanayopimwa kutoka kwenye kifaa halisi.
Zero-Noise Extrapolation (ZNE) hujaribuje kupunguza kosa la kwantumu?
ZNE huendesha operesheni ile ile bora katika viwango tofauti vya kelele yenye athari na kujaribu kufanya extrapolation kutoka matokeo yaliyopatikana hadi kikomo ambacho kelele ni sifuri; haitumii msimbo wa kusahihisha makosa na katika utafiti huu hutumika kama msingi wa klasiki wa kulinganisha mbinu iliyofunzwa ya QAGT-MLP.
Matumizi ya ZNE katika utafiti
Chanzo hurudia geti za entangling \(R_{XX}\) ili kuongeza kelele. Saketi iliyopimwa upya hufafanuliwa kama:
\[ U_{\mathrm{scaled}}(t;s) \approx \left[ \prod_{i=0}^{n-2} R_{XX}(\theta)^s \right]^M \]
.
Utafiti hutumia vipimo viwili vya kelele:
\[ s\in\{1,3\} \]
\(s=1\) ni saketi ya nominal; \(s=3\) ni saketi ambayo geti zile zile za entangling hurudiwa zaidi na kukusanya kelele zaidi ya maunzi.
Extrapolation ya Richardson ya mpangilio wa kwanza:
\[ u^{ZNE}(t) = \frac{3}{2}u^{(1)}(t) - \frac{1}{2}u^{(3)}(t) \]
hutoa makadirio yanayolenga kelele sifuri.
Chanzo pia hukata matokeo ya ZNE kwenye masafa yanayokubalika kifizikia:
\[ u_j^{ZNE} \leftarrow \min\left[ \max(u_j^{ZNE},u_{\min}), u_{\max} \right] \]
na katika majaribio yake hutoa mipaka ya mfano:
\[ u_{\min}=-1,\qquad u_{\max}=2 \]
.
Kwa nini ZNE haikutoa uboreshaji kila wakati?
ZNE inaweza kupunguza bias; hata hivyo, kwa sababu huendesha saketi zenye kelele zaidi na kufanya extrapolation ya matokeo hayo kwa mchanganyiko wa mstari, inaweza kuongeza variance ya sampuli na kutokuwa thabiti. Matokeo ya chanzo yanaonyesha wazi kwamba katika baadhi ya hali za 2D na hasa 3D, ZNE ilitoa kosa baya zaidi kuliko matokeo ghafi ya maunzi.
Kwa hiyo wazo kuu la utafiti si kuondoa ZNE kabisa, bali kujaribu kama usahihishaji wenye nguvu zaidi unaweza kupatikana kwa safu ya problem-aware ya kusahihisha makosa inayojifunza muundo wa saketi na uga wa kifizikia.
QAGT-MLP ni nini?
QAGT-MLP ni modeli ya klasiki ya kujifunza kwa mashine ya kupunguza makosa inayowakilisha saketi ya kwantumu kama grafu iliyoelekezwa isiyo na mzunguko (Directed Acyclic Graph, DAG), inaunganisha sifa za kimuundo zinazopatikana kutoka tabaka za grafu zinazotegemea attention na matokeo ya kwantumu yenye kelele, kisha hukadiria uga wa rejea ya klasiki.
Modeli hii si mtandao wa neva wa kwantumu. Sehemu ya kusahihisha makosa katika mafunzo na inference ni safu ya klasiki ya kujifunza kwa mashine; mojawapo ya pembejeo zake ni saketi ya kwantumu na matokeo ya vipimo vya kwantumu.
Kwa nini saketi ya kwantumu inaweza kubadilishwa kuwa grafu?
Kila geti ya kwantumu katika saketi inaweza kufikiriwa kama nodi. Mtiririko wa taarifa ya kwantumu kati ya geti na uhusiano wa wakati/usababisho unaweza kuwakilishwa kwa kingo. Kwa sababu saketi husonga katika mwelekeo wa wakati, grafu huwa kwa asili imeelekezwa na haina mzunguko.
Miongoni mwa sifa za node zinazotajwa na chanzo ni:
- utambulisho/aina ya gate,
- gate arity: geti hufanya kazi kwenye qubit ngapi,
- parameta za gate,
- taarifa za faharasa/usimbaji wa qubit,
- nafasi ya wakati/moment ya operesheni ndani ya saketi,
- sifa za kelele za eneo husika,
- sifa za lightcone,
- sifa za jumla za saketi
.
Causal lightcone ni nini?
Si kila geti katika saketi nzima inaweza kuathiri kipimo cha qubit fulani. Ni geti zinazobeba taarifa kwa sababu hadi kwenye kipimo hicho pekee zinazoweza kuwa na athari. Utafiti hutumia subgrafu hii kama lightcone.
Ufafanuzi wa chanzo:
\[ L_i = \left\{ g\in G: \exists\ \text{g'den }q_i\text{ ölçümüne nedensel yol} \right\} \]
Hapa:
- \(G\): mkusanyiko wa nodi za geti katika saketi,
- \(g\): nodi fulani ya gate,
- \(q_i\): qubit lengwa inayopimwa,
- \(L_i\): mkusanyiko wa lightcone wa gate zinazoweza kuathiri kipimo hicho.
Maski hii hufanya kazi kuu tatu:
- Uthabiti wa kisababisho: Hupunguza kuingia kwa gate zisizohusika katika utabiri.
- Ufanisi wa ukokotoaji: Mekanizimu ya Attention inaweza kulenga muundo mdogo unaohitajika badala ya saketi nzima.
- Ufafanulikaji: Husaidia kufuatilia ni mfuatano gani wa gate unaweza kuchangia kosa fulani la kipimo.
Graph attention hufanya nini?
GNN ya kawaida hukusanya taarifa kutoka nodi jirani. Graph Attention Network (GAT) si lazima ichukulie mchango wa majirani wote kuwa sawa. Uzani wa attention uliojifunza hufanya baadhi ya majirani kuwa muhimu zaidi kwa uwakilishaji fulani wa node.
Katika utafiti huu lengo ni modeli iweze kujifunza, kwa mfano, ni geti gani, njia zipi za qubit na miundo midogo ipi ya kisababisho ni muhimu zaidi katika kusahihisha matokeo ya kipimo yenye kelele.
Pembejeo na matokeo ya QAGT-MLP
Katika chanzo, lengo la supervised-learning linaelezwa kimawazo kama:
\[ \mathcal{R}: u^{noisy}(t) \ \text{veya}\ u^{ZNE}(t) \longmapsto u^{class}(t) \]
.
Pembejeo si vekta ya kasi yenye kelele pekee. Circuit graph, sifa za gate, lightcone, taarifa za global circuit na matokeo ya quantum measurement hutumiwa pamoja. MLP katika sehemu ya mwisho ya modeli hutumia uwakilishaji huu wa grafu uliochakatwa na taarifa za kipimo kuzalisha matokeo ya noise-corrected.
Mbinu ya mafunzo
Chanzo hutumia supervised learning. Pembejeo ni grafu ya saketi na data husika ya quantum measurement yenye kelele. Lengo ni matokeo ya uigaji wa klasiki.
Fungsi ya hasara:
Mean Squared Error (MSE), yaani wastani wa makosa ya mraba kati ya utabiri na ground truth ya klasiki.
Chanzo kinaeleza kuwa badala ya kutatua vipimo vyote vya output kwa modeli moja, kilifunza modeli tofauti zilizobobea kwa \(N=16\), \(N=32\) na \(N=64\).
Mikondo ya mafunzo huonyeshwa kwa 100 epoch. Chanzo kinaripoti uboreshaji wa haraka katika takribani 10–15 epoch za kwanza na maendeleo ya polepole/yanayotulia baada ya takribani 30. epoch. Kwa \(N=32\), kupunguzwa kwa learning-rate step kunaonyeshwa karibu na 70. epoch; kwa \(N=16\) na \(N=64\), tabia ya learning-rate ya kudumu inaelezwa.
Hata hivyo, chanzo hakiripoti maelezo haya muhimu ya mafunzo kwa thamani wazi:
- jina la optimizer,
- thamani kamili ya namba ya learning rate ya awali,
- batch size,
- idadi kamili ya tabaka za GAT,
- idadi ya attention head,
- hidden embedding dimension,
- kiwango cha dropout,
- weight decay,
- mgawanyo wazi wa asilimia wa train/validation/test.
Thamani hizi zinazokosekana hazijakisiwa na Verianla.
Mbinu na Matokeo ya Utafiti
Uchunguzi wa vigezo
| Kigezo | Thamani za chanzo | Jukumu la kisayansi |
|---|---|---|
| Mnato \(\nu\) | 0,01; 0,05; 0,10; 0,15; 0,20 | Gradienti kali zaidi kwa thamani ndogo, difyusheni yenye nguvu zaidi kwa thamani kubwa |
| Hatua ya muda \(\Delta t\) | 5×10⁻⁴; 10−3; 1,5×10⁻³; 2×10⁻³ | Huathiri ugawanyaji wa muda wa klasiki na wa Trotter |
| Ukubwa wa grid \(N\) | 8; 16; 32; 64 | Azimio la anga; 3–6 qubit amplitude encoding |
| Mpaka wa kushoto \(u_L\) | 1; 2; 4; 6 | Thamani ya mpaka wa Inflow |
| Mpaka wa kulia \(u_R\) | 0 | Umedumishwa bila kubadilika katika uchunguzi wa chanzo |
Uchunguzi huu huunda:
\[ 5\times4\times4\times4=320 \]
michanganyiko tofauti ya vigezo.
Chanzo kinatumia seti tatu za muda:
\[ \mathcal{T}^{(0)} = \{0,\ 0.005,\ 0.010\} \]
\[ \mathcal{T}^{(1)} = \{0,\ 0.0025,\ 0.005,\ 0.0075,\ 0.010\} \]
\[ \mathcal{T}^{(2)} = \{0,\ 0.002,\ 0.004,\ 0.006,\ 0.008,\ 0.010\} \]
Inaelezwa kuwa jumla ya snapshot 14 za muda zilitumika kupata maelfu kadhaa ya sampuli zilizounganishwa za klasiki/kwantumu.
Ni nini huhifadhiwa katika dataset?
Chanzo kinaeleza kuwa kwa kila hali ya jaribio huhifadhi:
- uwanja wa marejeo wa klasiki,
- uwanja wa noisy simulator,
- uwanja wa ZNE-corrected,
- uwanja wa hardware halisi, iwapo upo,
- taarifa ghafi za counts au quasi-distribution,
- metriki za uchunguzi kama shock position na dissipation,
- circuit depth,
- idadi ya gate za two-qubit,
- metadata ya grid na vigezo
katika rekodi za JSON zilizopangwa kimuundo.
Mizunguko pia husafirishwa katika muundo wa QPY na, inapoungwa mkono, QASM. Hata hivyo, katika chanzo kilichochunguzwa hakuna kiungo cha repository ya umma cha kupakua faili hizi kilichotolewa.
Matokeo ya muhtasari wa 1D kwa mnato mkubwa
| Azimio | Sampuli | Sim Noisy | ZNE | HW Raw | QAGT-MLP Sim | QAGT-MLP HW | Faida ya Sim / HW |
|---|---|---|---|---|---|---|---|
| N=16 | 72 | 0,3498 | 0,3639 | 0,3780 | 0,2112 | 0,2260 | +%39,6 / +%40,2 |
| N=32 | 54 | 0,8954 | 0,6725 | 0,9902 | 0,4345 | 0,4353 | +%51,5 / +%56,0 |
| N=64 | 12 | 1,0520 | 0,7226 | 1,5157 | 0,3932 | 0,4398 | +%62,6 / +%71,0 |
Majadiliano yanayozunguka Jedwali la 1 katika chanzo yanafasiri thamani hizi katika muktadha wa utendaji wa makosa. Hata hivyo, kwa kuwa jina la kipimo halijaandikwa pia kama “MAE” katika kichwa cha safu ya jedwali, Verianla linawasilisha jedwali kama “thamani za muhtasari wa makosa” katika namna iliyotolewa na chanzo.
Matokeo ya muhtasari wa 1D kwa mnato mdogo
| Azimio | Sampuli | Sim Noisy | ZNE | HW Raw | QAGT-MLP Sim | QAGT-MLP HW | Faida ya Sim / HW |
|---|---|---|---|---|---|---|---|
| N=16 | 741 | 0,8373 | 1,1306 | 0,8305 | 0,6453 | 0,6447 | +%22,9 / +%22,4 |
| N=32 | 633 | 0,5618 | 0,6794 | 0,6051 | 0,3813 | 0,3804 | +%32,1 / +%37,1 |
| N=64 | 429 | 0,5899 | 0,6799 | 0,6819 | 0,3394 | 0,3370 | +%42,5 / +%50,6 |
Jedwali hili linaonyesha kuwa katika hali ya mnato mdogo, na hivyo miundo mikali zaidi/iliyo migumu zaidi kutatuliwa, faida za QAGT-MLP kwa ujumla ni ndogo kuliko katika kundi la mnato mkubwa. Wakati huohuo, ukweli kwamba katika baadhi ya hali thamani ya safu ya ZNE ni kubwa kuliko thamani ghafi ya noisy unaonyesha kuwa ZNE haitoi dhamana ya uboreshaji wa kiotomatiki.
Mifano wakilishi ya uigaji wa 1D
Katika majadiliano ya matokeo ya chanzo, inaelezwa kuwa kwa \(N=64\), katika mfano mmoja wakilishi noisy simulation MAE ilishuka kutoka takribani 0,51 hadi takribani 0,07 baada ya QAGT-MLP.
Katika mifano wakilishi ya \(N=32\), kuna hali ambapo thamani ya noisy MAE ya takribani 0,62 ilipunguzwa hadi takribani 0,13 au chini.
\(N=16\) ina matatizo zaidi. Katika mfano mmoja, uboreshaji mkubwa kutoka takribani 1,23 hadi 0,17 ulipatikana, lakini katika mifano mingine miwili QAGT-MLP MAE iliongezeka hadi takribani 1,13 na 1,16; thamani za makosa ya ingizo la noisy zilitolewa kama takribani 0,43 na 0,46.
Katika hali hizi za pili, badala ya kusahihisha, modeli ilifanya matokeo kuwa mabaya zaidi.
Ujumlishaji kwa maunzi halisi ya IBM
Moja ya majaribio muhimu ni kwamba modeli ilifunzwa kwa data za noisy simulator pekee na baadaye ikajaribiwa kwenye matokeo ya maunzi halisi ya IBM.
Katika mifano wakilishi ya maunzi ya \(N=64\), MAE ghafi ikiwa katika takribani 0,56–1,05, inaelezwa kuwa baada ya QAGT-MLP ilishuka hadi takribani 0,07–0,32 na uboreshaji wa uwiano ulikuwa takribani %69–87.
Katika mifano ya \(N=32\), MAE ghafi ya maunzi inaripotiwa kuwa takribani 0,55–0,56 na MAE iliyosahihishwa takribani 0,09–0,12; chanzo kinaripoti uboreshaji wa takribani %80 katika mifano hii.
\(N=16\) tena ina matokeo mchanganyiko. Katika mifano miwili, kushuka kwa MAE ghafi ya takribani 1,26 na 1,30 hadi takribani 0,14 kulileta uboreshaji wa takribani %89, ilhali katika mfano mwingine MAE ghafi ya takribani 0,44 iliongezeka hadi takribani 1,18 baada ya QAGT-MLP. Chanzo kinatoa matokeo ya uwiano ya −%167 katika mfano huu.
Kushindwa huku ni muhimu hasa: ingawa modeli hujumlisha vizuri katika hali nyingi licha ya simulator → hardware distribution shift, katika azimio la chini sana, baadhi ya miundo ya uwanja inapowakilishwa kwa kiwango kisichotosha, kisahihishaji kilichofunzwa kinaweza kuongeza kosa.
Matokeo ya 2D
Chanzo kinatumia mbinu hiyo pia kwa nyuga za Burgers zenye mnato za pande mbili na katika Kielelezo 9 kinaonyesha mifano ya mabadiliko ya muda kwenye grid ya 512×512. Nyuga za Classical reference, noisy quantum, ZNE na QEM zinalinganishwa. Katika vielelezo, inaripotiwa kuwa nyuga za QEM zinarejesha muundo wa mtiririko wa kiwango kikubwa vizuri zaidi kuliko noisy na ZNE.
Hata hivyo, jedwali la jumla la makosa ya 2D linapaswa kusomwa kwa uwiano zaidi:
| Grid | Sampuli | Noisy MAE | Noisy MSE | Noisy RMSE | QAGT MAE | QAGT MSE | QAGT RMSE | ZNE MAE | ZNE MSE | ZNE RMSE | Uboreshaji wa QAGT MAE |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 16×16 | 66 | 0,543 | 0,700 | 0,796 | 0,574 | 0,404 | 0,635 | 0,747 | 0,960 | 0,947 | −%5,86 |
| 32×32 | 33 | 1,082 | 8,304 | 2,360 | 0,540 | 5,184 | 1,760 | 1,374 | 8,564 | 2,527 | +%50,06 |
Katika hali ya 16×16, MAE ya QAGT-MLP huongezeka kutoka 0,543 hadi 0,574; yaani kuna “uboreshaji” hasi wa takribani −%5,86 kwa kipimo cha MAE. Kinyume chake, MSE na RMSE hupungua. Hii inaonyesha kuwa modeli inaweza kutenda kwa namna tofauti kwenye metriki tofauti za makosa.
Katika hali ya 32×32, QAGT-MLP hutoa matokeo bora kuliko noisy na ZNE katika metriki zote tatu za makosa na MAE hupungua kwa takribani nusu.
Uchambuzi wa uhusiano wa 2D
Chanzo pia kinawasilisha uchambuzi wa KDE/scatter unaolinganisha kasi za nukta za 2D na thamani bora za klasiki.
Kwa \(N=16\), uhusiano wa noisy na ZNE ni takribani:
\[ r\approx0.25,\qquad r\approx0.31 \]
ilhali kwa QEM:
\[ r\simeq0.98 \]
unaripotiwa.
Katika hali ya \(N=32\), inaelezwa kuwa uhusiano wa noisy na ZNE uko karibu na 0,00–0,01, huku QEM ikifikia uhusiano wa takribani:
\[ r\simeq0.61 \]
.
Hapa, uhusiano mkubwa peke yake hauhakikishi kosa dogo kabisa katika kila nukta; lakini unaonyesha kuwa mwelekeo wa thamani za nukta zilizotabiriwa kubadilika pamoja na marejeo ya klasiki umeimarika.
Matokeo ya 3D
Chanzo pia kinatathmini nyuga za Burgers zenye pande tatu kupitia kelele ya maunzi halisi ya kwantumu. Matokeo ya kuona yanalinganisha nyuga za vekta kwenye grid ya 4×4×4 katika nyakati tofauti.
Jedwali la jumla la 3D:
| Grid | Sampuli | Noisy MAE | Noisy MSE | Noisy RMSE | QAGT MAE | QAGT MSE | QAGT RMSE | Uboreshaji wa QAGT MAE |
|---|---|---|---|---|---|---|---|---|
| 4×4×4 | 21 | 0,531 | 6,310 | 1,744 | 0,549 | 5,601 | 1,634 | −%3,26 |
| 8×8×8 | 21 | 0,779 | 7,458 | 2,413 | 0,632 | 5,406 | 2,085 | +%18,92 |
Katika grid ya 4×4×4, MAE inakuwa mbaya kidogo huku MSE na RMSE zikiboreka. Katika grid ya 8×8×8, uboreshaji unaonekana katika metriki zote zilizoripotiwa, ikiwa ni pamoja na MAE.
Kwa hiyo, haiwezi kusemwa kwamba “katika 3D modeli hupunguza kosa kila wakati”. Jedwali la jumla la chanzo lenyewe linaonyesha kuwa MAE inakuwa mbaya katika grid ya 4³ yenye azimio la chini sana.
Kwa nini azimio ni muhimu kiasi hiki?
Kisahihishaji cha ujifunzaji wa mashine hujaribu kutabiri muundo wa klasiki kwa kutumia muundo wa kifizikia uliomo ndani ya input yenye kelele. Ikiwa grid ina azimio la chini sana, nafasi halisi ya shock, umbo la kilele na gradienti huenda zisichukuliwe sampuli vya kutosha. Katika hali hii, taarifa ya kifizikia ambayo modeli ingetumia kama msingi wa kusahihisha inaweza isiwepo katika input.
Kwa sababu hiyo, chanzo hakitafsiri makosa ya \(N=16\) kwa kusema tu “quantum backend ni mbaya”; kuonekana kwa mifano sawa ya kushindwa pia katika uigaji kunaashiria kuwa azimio ni mojawapo ya vikwazo vya msingi.
Nini hutokea ukubwa wa mzunguko na idadi ya vipimo vinapoongezeka?
Kielelezo 3 cha chanzo kinaonyesha kuwa katika mizunguko ya 1D, 2D na 3D quantum CFD, kadiri ukubwa wa tatizo unavyoongezeka:
- idadi ya gate za two-qubit,
- jumla ya gate,
- entangling density
huongezeka.
Circuit depth inaweza isiongezeke kwa kasi sawa na jumla ya gate kwa sababu operesheni za disjoint two-qubit zinaweza kutekelezwa kwa sambamba. Hata hivyo, kwa kuwa gate za two-qubit ni vyanzo muhimu vya makosa kwenye maunzi ya NISQ, kuongezeka kwa ujazo wa gate huongeza unyeti kwa kelele.
Kwa kuwa nukta ghafi za namba katika grafu ya chanzo hazijatolewa kwa mfumo wa jedwali, Verianla halijazalisha hapa thamani bandia zenye usahihi wa kupotosha kutoka kwenye mihimili.
Hali dhahiri za kushindwa kwa modeli
- Katika azimio la chini sana la anga, muundo wa kifizikia unaweza kubaki haujakamilika.
- Usahihishaji uliofunzwa unaweza kusababisha overshoot katika baadhi ya mifano.
- Bias ya kimfumo inaweza kutokea karibu na shock.
- Usahihishaji usio sahihi unaweza kuhamisha nafasi ya shock.
- Inaweza kukadiria dissipation kupita kiasi kwa kuzidisha ukubwa wa gradienti.
- Matokeo ya jumla ya MAE ya 2D 16×16 na 3D 4×4×4 yana uboreshaji hasi.
- ZNE inaweza kuwa mbaya kuliko raw hardware katika baadhi ya hali.
Matokeo yanayoungwa mkono na utafiti
- Mikengeuko ya suluhu za quantum Burgers zenye kelele kutoka kwenye marejeo ya klasiki inaweza kupunguzwa katika hali nyingi kwa safu ya post-processing inayotegemea grafu iliyofunzwa.
- Muundo wa DAG wa mzunguko na taarifa ya causal lightcone zinaweza kutumika kama ingizo kwa modeli ya kupunguza makosa.
- Modeli iliyofunzwa kwa data za noisy simulator pekee imeweza kujumlishwa katika baadhi ya vipimo vya 1D vya \(N=32\) na \(N=64\) hadi matokeo ya hardware halisi ya IBM bila mafunzo upya ya device-specific.
- Katika muhtasari wa 1D wa mnato mkubwa, faida ya wastani iliyoripotiwa upande wa maunzi hufikia %71,0 kwa \(N=64\).
- Katika hali ya 2D 32×32, QAGT-MLP ilitoa uboreshaji dhahiri wa MAE/MSE/RMSE dhidi ya misingi ya noisy na ZNE.
- Katika hali ya 3D 8×8×8, QAGT-MLP ilipunguza MAE, MSE na RMSE dhidi ya matokeo ya noisy hardware.
- Azimio ni kigezo muhimu kwa kuaminika kwa mbinu.
Madai yasiyoungwa mkono na utafiti
- Haijaonyeshwa kwamba kompyuta ya quantum ni ya haraka kuliko kisuluhishi cha klasiki cha Krylov.
- Quantum advantage au quantum supremacy haijaonyeshwa.
- Haijaonyeshwa kwamba matatizo ya jumla ya Navier–Stokes CFD yametatuliwa kwenye kompyuta ya kwantumu.
- Haijathibitishwa kwa majaribio kuwa QAGT-MLP inajumlishwa kwa algorithm zote za quantum.
- QAGT-MLP haipunguzi kosa katika ukubwa wote wa grid.
- ZNE haitoi uboreshaji katika mifano yote.
- Haijaonyeshwa kwamba Amplitude encoding huondoa gharama za state-preparation na measurement.
- Haijaonyeshwa kwamba kutoka Computational-basis counts, awamu ya quantum state tata ya jumla inaweza kurejeshwa kikamilifu.
- Utafiti si matokeo ya ukokotoaji wa kwantumu wa fault-tolerant.
- Matokeo hayawezi kufasiriwa moja kwa moja kama utendaji halisi wa viwandani wa 3D turbulent CFD.
Mapendekezo ya kazi za baadaye
Chanzo kinapendekeza hasa maboresho yafuatayo:
- ujifunzaji wa multi-resolution / multiscale,
- vitendaji vya physics-based loss,
- uncertainty estimation,
- familia pana zaidi za matatizo ya CFD,
- quantum circuit ansatz zenye uwezo mkubwa zaidi wa uwakilishi,
- miundo mikubwa zaidi na inayoweza kupanuka ya graph,
- kuboresha quantum circuit na error corrector kwa pamoja,
- uboreshaji wa pamoja unaotegemea differentiable surrogate au reinforcement learning.
Mapendekezo haya bado si matokeo yaliyothibitishwa katika utafiti; ni mwelekeo uliopendekezwa kwa utafiti wa baadaye.
Maelezo ya Chanzo na Mbinu
Utafiti asili: Solving Burgers Equation on Noisy Quantum Hardware with Error Mitigation through Attention Graph Transformers
Waandishi: Seyed Mohamad Ali Tousi, Adib Bazgir, Yuwen Zhang, G. N. DeSouza.
Mpangilio wa waandishi: Mpangilio katika PDF ya chanzo umehifadhiwa.
Taasisi 1: Vision-Guided and Intelligent Robotics Lab (ViGIR), Department of Electrical Engineering and Computer Science, University of Missouri, Columbia, Missouri, USA.
Taasisi 2: Department of Mechanical and Aerospace Engineering, University of Missouri, Columbia, Missouri, USA.
Waandishi wanaowajibika: Kulingana na alama za chanzo, Yuwen Zhang na G. N. DeSouza wameonyeshwa kama corresponding author.
Aina ya chanzo: Preprint ya utafiti; suluhisho mseto la kwantumu-klasiki la PDE, jaribio la maunzi halisi ya NISQ, uigaji wenye kelele na utafiti wa kupunguza makosa kwa ujifunzaji wa mashine wa klasiki.
Hali ya mapitio ya rika: PDF ina onyo “This preprint research paper has not been peer reviewed” katika kila ukurasa. Kwa hiyo, matokeo hayapaswi kuwasilishwa kama matokeo ya mwisho ya chapisho lililopitiwa na rika.
Jukwaa: PDF inatoa kiungo cha SSRN abstract 7649063 kwa nakala ya kielektroniki.
Hali ya uchapishaji: Katika kijachini cha ukurasa kuna kauli “Preprint submitted to Elsevier”. PDF ya chanzo haitoi juzuu ya mwisho ya jarida, toleo wala nambari ya makala.
DOI: Katika PDF iliyochunguzwa, DOI haijaripotiwa kwa toleo hili. DOI haijabuniwa.
Tarehe ya uchapishaji: Katika PDF iliyochunguzwa, tarehe ya kuaminika ya uchapishaji/upakiaji wa SSRN haijaonyeshwa kwa uwazi; kwa hiyo tarehe kamili haijaongezwa.
Leseni: PDF iliyochunguzwa haielezi leseni ya wazi ya matumizi upya kwa toleo hili. Kwa hiyo, vielelezo vya chanzo havijanakiliwa kwa kiwango cha pikseli; mahusiano ya kisayansi pekee yameelezwa upya kwa michoro huru ya Verianla SVG.
Programu na majukwaa makuu: Qiskit, Qiskit Aer, IBM Quantum Runtime na solver inayotegemea QuTiP Krylov kwa marejeo ya klasiki.
Quantum backend halisi: Chanzo kinataja backend ya ibm_torino katika majaribio ya maunzi.
Upimaji: Katika uendeshaji wa kwantumu wenye kelele, kwa kawaida 8192 shot zilitumika.
Dataset: Kwa uchunguzi mkuu wa 1D, michanganyiko 320 ya vigezo; katika seti tatu za muda, jumla ya nukta/hali 14 za muda na maelfu kadhaa ya sampuli zilizounganishwa zilitolewa.
Usafirishaji wa data na mizunguko: QPY, QASM inapoungwa mkono, na metadata za JSON zilizopangwa kimuundo zilihifadhiwa. Chanzo hakitoi kiungo cha wazi cha repository ya umma kwa faili hizi.
Ufadhili: Sehemu tofauti ya Funding na mfadhili/nambari ya grant hazijaripotiwa katika chanzo. Katika sehemu ya CRediT, jukumu la “Funding acquisition” limetajwa kwa G. N. DeSouza; utambulisho wa mfadhili hauwezi kutolewa kutokana na taarifa hii.
Mgongano wa maslahi: Katika PDF iliyochunguzwa hakuna tamko tofauti la conflict-of-interest linaloonekana. Hakujafanywa dhana kwamba “hakuna mgongano wa maslahi”.
Michango ya CRediT: Seyed Mohamad Ali Tousi: Conceptualization, Methodology, Software, Investigation, Writing – original draft. Adib Bazgir: Conceptualization, Methodology, Software, Investigation, Writing – original draft. Yuwen Zhang: Conceptualization, Supervision, Resources, Writing – review & editing. G. N. DeSouza: Conceptualization, Supervision, Resources, Funding acquisition, Writing – review & editing.
Maelezo ya mafunzo yasiyoripotiwa: Katika chanzo, jina la optimizer, batch size, thamani kamili za learning-rate, idadi ya GAT layer/head, hidden size, dropout na asilimia wazi za mgawanyo wa data hazijatolewa kwa uwazi. Taarifa hizi hazijakamilishwa na Verianla.
Kutokuwiana kwa hali ya awali/mpakani ndani ya chanzo: Katika sehemu kuu ya mbinu, \(u_0(x)=\sin(\pi x)\) na mipaka ya kasi ya Dirichlet katika ncha zote mbili hutolewa, lakini lebo za kuona katika Kielelezo cha Ziada 12 hazilingani kikamilifu na ufafanuzi huu. Milinganyo ya mbinu kuu haijabadilishwa na tofauti imeelezwa wazi.
Kikomo cha uundaji modeli wa kwantumu: Chanzo kinatumia evolusheni ya Hamiltonian ya majirani wa karibu inayotegemea \(R_{XX}\) kuiga tabia ya difyusheni iliyodiscretize. Kwa kuwa maandishi yaliyopitiwa hayatoi utokaji wa kina wa usawa kamili wa kiopereta kati ya evolusheni hii ya kwantumu ya unitary na semigroup ya Laplacian ya klasiki yenye dissipation, Verianla halijaiwasilisha kama usawa kamili wa kihisabati.
Kikomo cha urekebishaji upya wa vipimo: Chanzo huunda vekta ya amplitudo kwa kuchukua mzizi wa mraba wa thamani za computational-basis counts. Katika PDF, hakuna utaratibu tofauti wa tomography/phase-reconstruction unaoelezwa kwa kurejesha taarifa ya jumla ya awamu tata.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *