


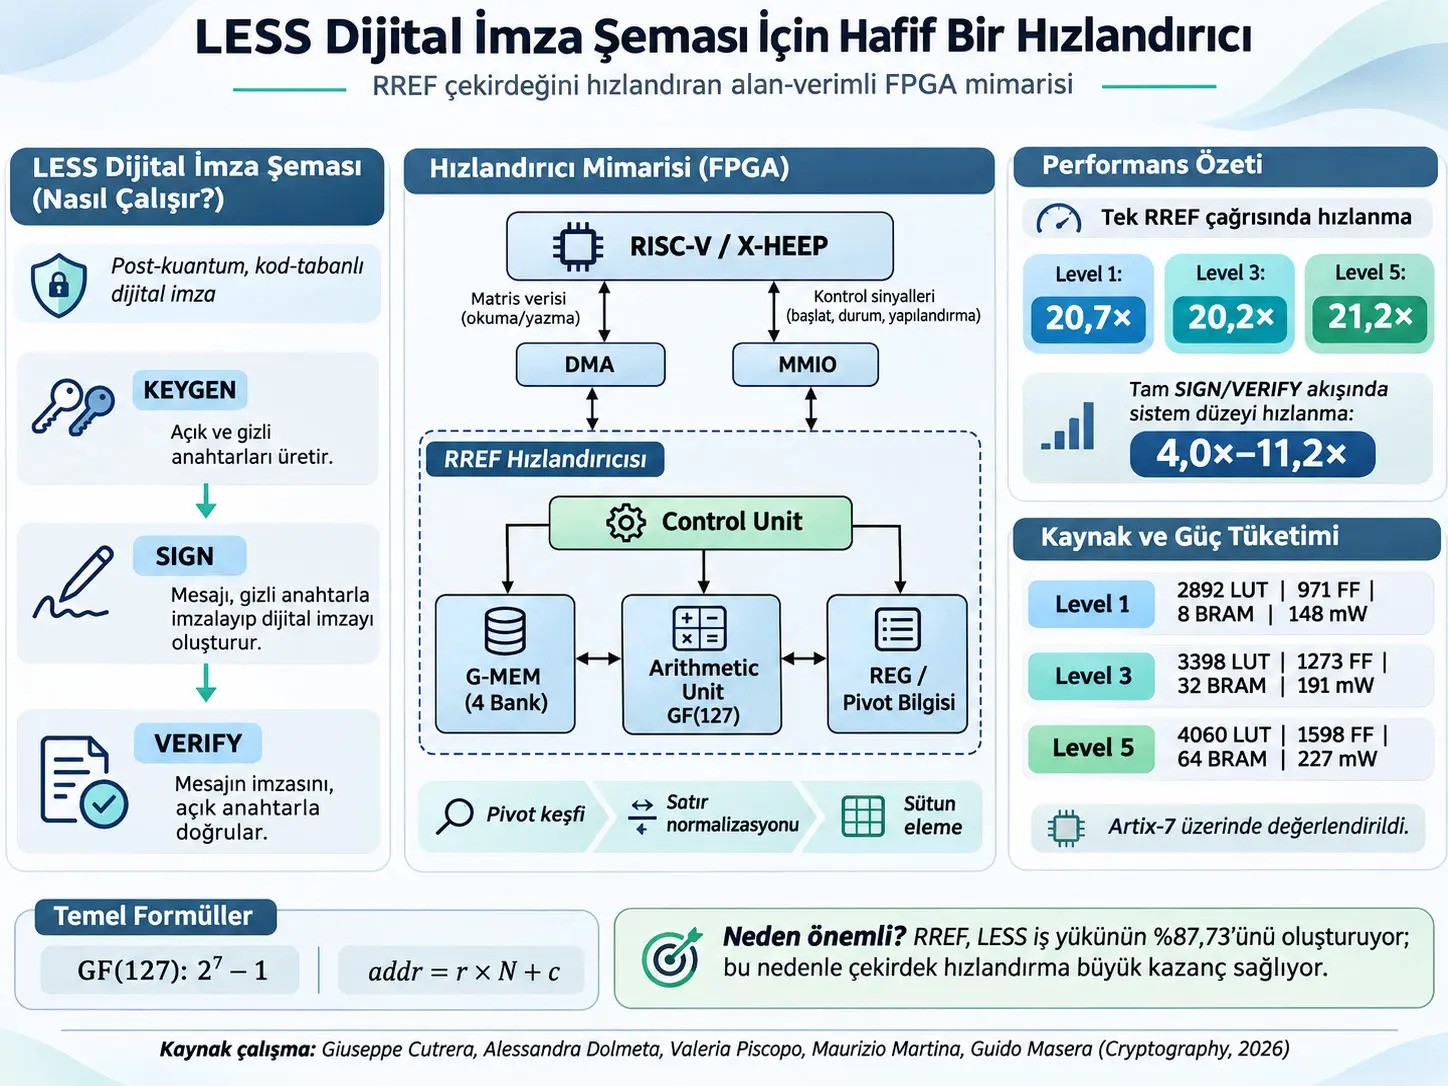
LESS (Linear Equivalence Signature Scheme), güvenliğini lineer kodlar arasındaki gizli eşdeğerliği bulmanın zorluğuna dayandıran kod-tabanlı bir post-kuantum dijital imza şemasıdır. Bu çalışma, LESS'in tamamını donanıma taşımak yerine, imzalama ve doğrulama akışında en yüksek hesaplama yükünü oluşturan indirgenmiş satır basamak biçimi (Reduced Row Echelon Form, RREF) çekirdeğini hızlandıran alan-odaklı bir FPGA mimarisi geliştirmektedir. Hızlandırıcı, RISC-V tabanlı X-HEEP gömülü sistemine gevşek bağlı bir bellek eşlemeli çevre birimi olarak entegre edilmiş; yoğun matris verileri DMA ile, kontrol ve pivot bilgileri ise MMIO kayıtları üzerinden taşınmıştır.
Kaynak profil sonuçlarında generator_RREF_pivot_reuse işlevi, LESS imzalama işleminin toplam çevrimlerinin %87,73'ünü tüketmektedir. Bu nedenle tasarımın ana hedefi, RREF işlemini küçük bir donanım ayak iziyle hızlandırmaktır. Xilinx Artix-7 xc7a100tftg256-2 üzerinde yapılan değerlendirmede tek bir RREF çağrısı için Level 1, Level 3 ve Level 5 yapılandırmalarında sırasıyla 20,7×, 20,2× ve 21,2× hızlanma raporlanmıştır. Tam SIGN ve VERIFY akışlarında ise hızlanma, donanıma taşınmayan hashing, kontrol ve veri hareketi nedeniyle daha düşüktür; kaynak Tablo 5'te SIGN için en yüksek 11,20×, VERIFY için en yüksek 9,91× değerleri yer almaktadır.
Mimari, matris elemanlarını dört paralel 8 bitlik BRAM bankasında saklayan 32 bitlik kelime erişimi, dört yollu sonlu alan aritmetiği, pivot bilgisi yeniden kullanımı, merkezi bir sonlu durum makinesi ve kesme tabanlı yazılım-donanım eşgüdümü üzerine kuruludur. GF(127) seçimi de donanım açısından önemlidir: 127 sayısı 27−1 biçiminde bir Mersenne asalı olduğundan, çarpım sonuçlarının mod 127 indirgenmesi pahalı genel amaçlı bölme devreleri yerine bit katlama mantığıyla yapılabilmektedir.
Çalışmanın güçlü yanı yalnız hız değil, alan maliyetidir. Kaynak Tablo 6'ya göre hızlandırıcı Level 1'de 2892 LUT, 971 FF ve 8 BRAM; Level 3'te 3398 LUT, 1273 FF, 32 BRAM ve 3 DSP; Level 5'te 4060 LUT, 1598 FF, 64 BRAM ve 8 DSP kullanmaktadır. Toplam güç tahminleri sırasıyla 148, 191 ve 227 mW'tır. Bununla birlikte makalenin kendi metninde birkaç sayısal tutarsızlık bulunmaktadır: Level 5 için bazı paragraflarda “3700'den az” veya “3649 LUT” denirken tablolarda 4060 LUT verilmiştir; sonuç bölümündeki 5,58 KeSlice ifadesi ise özet ve Tablo 8'deki yaklaşık 8,7 KeSlice değeriyle uyuşmamaktadır. Bu Verianla aktarımında tutarsızlıklar gizlenmemiş, tablo değerleri ve metin ifadeleri birbirinden ayrılmıştır.
Çalışma ayrıca fiziksel yan kanal güvenliğini kanıtlamamaktadır. 100 Known Answer Test (KAT) vektörü üzerinde çevrim sayısındaki değişimin tipik olarak 300 çevrimin altında kalması zamanlama açısından yüksek deterministik davranışa işaret etmektedir; ancak yazarlar güç analizi, elektromanyetik sızıntı ve hata enjeksiyonu direncinin ayrıca değerlendirilmesi gerektiğini açıkça belirtmektedir. Dolayısıyla bu araştırmanın gösterdiği şey, RREF çekirdeğinin küçük alanlı FPGA donanımıyla etkili biçimde hızlandırılabildiğidir; fiziksel saldırılara karşı tam güvenlik kanıtı değildir.
Dijital imza şeması hangi üç temel işlemi yapar?
Dijital imza sistemi üç ana algoritmadan oluşur. KEYGEN birbirine matematiksel olarak bağlı açık anahtar ve özel anahtarı üretir. SIGN, mesajı özel anahtarla ilişkilendirerek bir imza üretir. VERIFY ise mesaj, imza ve açık anahtarı birlikte değerlendirip imzanın kabul veya reddedilmesine karar verir. LESS de aynı genel üçlü yapıyı kullanır; çalışma özellikle SIGN ve VERIFY içinde tekrar tekrar çalışan lineer cebir çekirdeğine odaklanmaktadır.
Standartlaştırma bağlamı: Çalışma LESS'i NIST'in ilave post-kuantum dijital imza adaylarını değerlendirdiği “on-ramp” sürecinin kod-tabanlı şemalarından biri olarak ele alır. Makalenin kendisi, LESS'in sonraki değerlendirme aşamasına ilerlemediğini de açıkça belirtir. Bu nedenle burada anlatılan donanım tasarımı “NIST tarafından standartlaştırılmış LESS uygulaması” olarak değil, RREF ve matris ağırlıklı post-kuantum iş yükleri için alan-odaklı bir hızlandırma çalışması olarak okunmalıdır.
LESS'in matematiksel temeli: lineer kod eşdeğerliği
LESS'in temel matematiksel nesnesi, sonlu bir alan üzerindeki üreteç matrisidir. Kaynakta sonlu alan Fq ile, k satır ve n sütunlu üreteç matrisi ise G ile gösterilir. Bir mesaj vektörü m, G ile çarpıldığında kod sözcüğü üretir. Kaynakta bu satır uzayı şu biçimde tanımlanır:
\[\mathcal{C}(G)=\{mG:m\in\mathbb{F}_q^k\}\subseteq\mathbb{F}_q^n\]
Formül neyi anlatır? \(\mathcal{C}(G)\), G matrisinin satırlarının oluşturduğu lineer kodu ifade eder. \(m\), \(\mathbb{F}_q^k\) içindeki mesaj/katsayı vektörüdür; \(mG\) ise \(\mathbb{F}_q^n\) içinde bir kod sözcüğüdür. Burada fiziksel birim yoktur; bütün büyüklükler sonlu alan cebirinin ayrık elemanlarıdır.
İki üreteç matrisinin aynı veya eşdeğer kod yapısını temsil edebilmesi için satır bazını değiştiren terslenebilir bir S matrisi ile sütunları yeniden sıralayıp ölçekleyen monomial bir Q matrisi kullanılır. Kaynakta Lineer Eşdeğerlik Problemi şu denklemle verilir:
\[G'=SGQ \tag{1}\]
Bu denklemde \(S\in GL_k(\mathbb{F}_q)\), terslenebilir \(k\times k\) matristir. S'nin soldan çarpılması satır bazını değiştirir fakat kodun satır uzayını değiştirmez. \(Q\) ise her satır ve sütunda tam bir sıfır-dışı eleman taşıyan monomial matristir; kaynak bunu bir permütasyon matrisi ile terslenebilir diyagonal matrisin bileşimi olarak açıklar. Q'nun sağdan çarpılması koordinatları yeniden sıralar ve ölçekler.
LESS'in güvenlik varsayımı, uygun parametre ve dağılımlar altında G ve G′ verilmişken gizli monomial dönüşümü geri elde etmenin zor olmasına dayanır. Çalışma yeni bir kriptografik güvenlik kanıtı üretmemekte; mevcut LESS yapısının hesaplama açısından ağır olan matris işlemini donanımda hızlandırmaktadır.
RREF nedir?
İndirgenmiş satır basamak biçimi (RREF), bir matrisin temel satır işlemleriyle ulaştırıldığı kanonik biçimdir. Pivot olarak kullanılan her öncü eleman 1 yapılır; pivotun bulunduğu sütundaki diğer elemanlar sıfırlanır; pivot konumları satırlar aşağı indikçe sağa ilerler ve sıfır satırlar altta toplanır. Aynı satır uzayını tanımlayan iki matris aynı RREF'e ulaştığı için RREF, LESS içinde farklı baz temsillerini ortak bir kanonik temsile dönüştürmek açısından değerlidir.
LESS neden RREF hesaplamasında darboğaz yaşıyor?
LESS, eşdeğer kod temsillerini aynı kanonik biçime getirmek için RREF işlemini çok sayıda kez kullandığından, özellikle SIGN ve VERIFY aşamalarında yoğun sonlu alan satır işlemleri oluşur; kaynak profilinde generator_RREF_pivot_reuse işlevinin imzalama çevrimlerinin %87,73'ünü tüketmesi bu çekirdeği açık ara baskın hesaplama maliyeti haline getirmektedir.
RREF neden S matrisini ortadan kaldırıyor?
RREF'in kritik özelliği, aynı satır uzayını tanımlayan matrislerin aynı indirgenmiş satır basamak biçimine ulaşmasıdır. S matrisi yalnız satır bazını değiştirdiği için kaynak şu ilişkiyi kullanır:
\[\operatorname{RREF}(SGQ)=\operatorname{RREF}(GQ)\]
Bu eşitlikte S'nin etkisi kanonikleştirme sırasında kaybolur. Böylece doğrulama tarafında asıl izlenmesi gereken yapı Q'nun sütunlar üzerindeki monomial etkisine indirgenir. Sistematik biçim \([I\mid V]\) elde edildiğinde kaynak ayrıca pivot olmayan V sütunlarını ölçek altında leksikografik olarak normalize eder ve ardından leksikografik sıralama uygular. Amaç, aynı eşdeğerlik sınıfındaki farklı temsil biçimlerinin Fiat–Shamir özetine farklı girişler vermesini önlemektir.
LESS parametreleri neyi belirler?
Kaynak LESS'i kod parametreleri \((n,k,q)\) ve protokol parametreleri \((t,\omega,s)\) ile tanımlar. \(n\) kod uzunluğunu, \(k\) boyutu, \(q\) sonlu alanın mertebesini gösterir. \(t\), simüle edilen Σ-protokol turlarının sayısıdır. \(\omega\), t tur içindeki sıfır-dışı meydan okumaların sabit Hamming ağırlığıdır. \(s\) ise açık/gizli meydan okuma yuvalarının sayısıdır. Kaynağa göre t'nin artırılması soundness hatasını azaltır; sabit ağırlıklı meydan okuma yapısı transcript'i sıkıştırmaya yardımcı olur; daha büyük s açık anahtar boyutunu büyütebilirken imza boyutunu kısaltabilir.
| Küme | n | k | q | t | ω | s | Açık anahtar (KiB) | İmza (KiB) |
|---|---|---|---|---|---|---|---|---|
| LESS-1b | 252 | 126 | 127 | 247 | 30 | 2 | 13,7 | 8,4 |
| LESS-1i | 244 | 126 | 127 | 192 | 20 | 4 | 41,1 | 6,1 |
| LESS-1s | 198 | 99 | 127 | 68 | 17 | 8 | 95,9 | 5,2 |
| LESS-3b | 400 | 200 | 127 | 759 | 33 | 2 | 34,5 | 18,4 |
| LESS-3s | 400 | 200 | 127 | 895 | 26 | 3 | 68,9 | 14,1 |
| LESS-5b | 548 | 274 | 127 | 1352 | 40 | 2 | 64,6 | 32,5 |
| LESS-5s | 548 | 274 | 127 | 907 | 37 | 3 | 129,0 | 26,1 |
KEYGEN, SIGN ve VERIFY akışının LESS içindeki rolü
KEYGEN: Açık bir tohumdan temel G0 matrisi oluşturulur. Ek gizli tohumlardan monomial dönüşümlerin tersleri türetilir; bunlar G0 üzerine uygulanır, RREF'e dönüştürülür ve sıkıştırılmış biçimleri açık anahtarın parçaları haline gelir. Kimlik yuvası Q0=In örtük kabul edilir. Kaynak, anahtar üretimini tek seferlik kurulum işlemi olarak değerlendirdiği için bu aşamayı hızlandırıcıya taşımamış, ana işlemci üzerinde bırakmıştır.
SIGN: İmzalama sırasında t adet geçici monomial dönüşüm oluşturulur ve bunlardan kanonik commitment girdileri hazırlanır. Commitment'lar, mesaj ve salt birlikte hash edilerek d özeti elde edilir. Bu özet, sabit Hamming ağırlığı ω olan meydan okuma vektörünü belirler. Sıfır-dışı meydan okumalara karşılık gelen yalnız ω yanıt imzaya dahil edilir; diğer rastgelelik seed-tree yapısı üzerinden doğrulayıcı tarafından yeniden üretilebilir. Bu sıkıştırma, transcript boyutunu kontrol altında tutar.
VERIFY: Meydan okuma xi=0 ise doğrulayıcı ilgili seed-tree yaprağından geçici monomial dönüşümü yeniden üretir ve commitment girdisini hesaplar. xi≠0 ise sıkıştırılmış yanıt monomial dönüşüme açılır, açık matris yuvasına uygulanır, sonuç RREF'e getirilir ve pivot olmayan sütunlar kanonikleştirilir. Sonunda bütün yeniden oluşturulan commitment'lar mesaj ve salt ile hash edilir; elde edilen d′ değerinin imzadaki d ile eşleşmesi beklenir.
Kullanılan kriptografik terimler nasıl okunmalı?
CSPRNG (Cryptographically Secure Pseudorandom Number Generator), kriptografik kullanım için öngörülemez çıktı üretmesi beklenen sözde-rastgele sayı üreticisidir. Commitment, protokolün daha sonra doğrulanacak bir ara değerini bağlayıcı biçimde temsil eder. Σ-protokolü, bilginin kendisini açığa çıkarmadan belirli bir sırrın bilindiğini göstermeye yarayan meydan okuma-yanıt yapısındaki ispat ailesidir. Fiat–Shamir dönüşümü, etkileşimli meydan okumayı hash çıktısından türeterek protokolü imza kullanımına uygun etkileşimsiz biçime dönüştürür. Salt, aynı girdilerin farklı çalıştırmalarda aynı özet yapısına zorunlu olarak gitmesini engelleyen ek rastgele değerdir. Seed-tree ise çok sayıda rastgele tohumu tek tek taşımak yerine kök tohumdan türetilen dallı yapı üzerinden gerekli alt tohumların yeniden oluşturulmasına yardımcı olur. Bu açıklamalar yöntemi anlamak içindir; çalışmanın yeni bulguları değildir.
Profil neden yalnızca RREF çekirdeğini donanıma taşıyor?
| İşlev | Toplam çevrim payı | Temel görev |
|---|---|---|
generator_RREF_pivot_reuse | %87,73 | RREF matris indirgeme çekirdeği |
compute_canonical_form_type4 | %2,52 | Kanonik biçim hesabı |
compute_canonical_form_type5_popcnt | %2,08 | Kanonik biçim hesabı |
KeccakF1600_StatePermute | %1,50 | SHA-3/SHAKE permütasyonu |
| Diğerleri | %6,17 | Sıralama, bellek yönetimi, hashing |
Kaynak, standart sıralı RREF dönüşümünün \(G\in\mathbb{F}_q^{k\times n}\) için sonlu alan işlem sayısını asimptotik olarak \(\mathcal{O}(k^2n)\), matris ve izleme yapıları için deterministik bellek gereksinimini ise \(\mathcal{O}(kn)\) olarak verir. Bu ifade gerçek çevrim sayısı değildir; problem büyüdükçe hesap ve depolama gereksinimlerinin nasıl ölçeklendiğini gösteren asimptotik karmaşıklık sınıfıdır.
Hızlandırıcının üst düzey mimarisi
Donanım dört ana yapı etrafında kurulmuştur: merkezi Control Unit, matrisin tutulduğu G-MEM, sonlu alan işlemlerini yürüten Arithmetic Unit ve pivot/ara durum bilgisini taşıyan REG bloğu. Tasarım yüksek derecede açılmış dev bir paralel veri yolu yerine merkezi FSM ile yönetilen, dört elemanlık paralelliğe sahip daha serileştirilmiş bir veri yolu kullanır. Bu tercih mutlak tepe performansından bir miktar vazgeçip alan maliyetini düşürme stratejisidir.
RREF donanımında dört işlem evresi
- Ön işleme: Önceki çalıştırmalardan bilinen pivot sütunları taranır; gerekli satır değişimleri yapılarak sıfır-dışı elemanlar kanonik diyagonal konumlarına yaklaştırılır. Amaç, bilinen yapı bilgisini yeniden kullanarak gereksiz arama işini azaltmaktır.
- Pivot keşfi: Etkin diyagonal konumdan başlayarak ilgili sütunda aşağıya doğru sıfır-dışı eleman aranır. Pivot başka satırdaysa kelime-paralel satır takası uygulanır. Geçmiş pivot haritası geçerliyse bazı aramalar atlanabilir.
- Satır normalizasyonu: Pivot elemanın GF(127) içindeki çarpımsal tersi bulunur ve bütün pivot satırı bu değerle ölçeklenerek pivot tam 1 yapılır. 32 bitlik veri yolu sayesinde dört 8 bitlik alan elemanı aynı çevrimde işlenebilir.
- Sütun eleme: Normalize edilmiş pivot satırı referans alınır. Diğer satırlardaki pivot sütunu katsayısı kullanılarak sonlu alan çarp-çıkar işlemleri gerçekleştirilir ve pivot sütunundaki diğer elemanlar sıfırlanır.
Bu dört evre bütün gerekli sütunlar boyunca yürütüldüğünde RREF tamamlanır. Son matris ile güncellenmiş pivot haritaları ana sisteme geri aktarılır.
G-MEM neden dört bankaya ayrılmıştır?
Matris satır-major düzenle saklanır ve her GF(127) elemanı standart bellek yapılarıyla uyum için 8 bitlik bir bayt içinde tutulur. Kaynak bir \((r,c)\) elemanının bayt adresini şu basit doğrusal adresleme ile verir:
\[\text{addr}_{\text{byte}}=r\times N+c\]
Burada \(r\) satır indeksi, \(c\) sütun indeksi ve \(N\) satırdaki toplam sütun sayısıdır. Formül bir bellek adresi üretir; fiziksel ölçü birimi yoktur, sonuç bayt konumudur.
Fiziksel bellekte ardışık elemanlar Bank 0, Bank 1, Bank 2 ve Bank 3'e serpiştirilir. Böylece dört bankanın 8 bitlik çıkışları birleştirilerek tek çevrimde 32 bitlik kelime ve dolayısıyla dört alan elemanı okunabilir. Adres 4 bayt sınırına hizalı değilse g_addr >> 2 kelime indeksini, g_addr[1:0] ise bayt kaymasını belirler; bir döndürme ağı/barrel shifter veriyi doğru sıraya getirir. Yazma yolunda 4 bitlik g_wstrb sinyali yalnız değiştirilecek baytları etkinleştirir. Kaynak mimariyi hem okuma hem yazmada deterministik tek çevrim gecikmesi hedefiyle tanımlar.
GF(127) aritmetiği donanımı neden basitleştiriyor?
LESS parametrelerinde q=127 kullanılır. 127, \(2^7-1\) biçiminde bir Mersenne asalıdır. Bu nedenle:
\[2^7\equiv 1\pmod{127}\]
İki 7 bitlik alan elemanının çarpımından elde edilen ürün üst ve alt 7 bitlik parçalara ayrılabilir. Kaynak, indirgeme işlemini şu biçimde verir:
\[x\bmod 127=\big((x\gg 7)+(x\ \&\ 127)\big)\bmod 127\]
Değişkenler: \(x\), iki GF(127) elemanının çarpımından oluşan ara sonuçtur. \(x\gg7\), üst bitlerin 7 basamak sağa kaydırılmış halidir. \(x\ \&\ 127\), alt 7 bitin maskelenmiş halidir. Matematiksel rol: \(2^7\equiv1\) özelliği nedeniyle üst 7 bitin taşıdığı \(2^7\) ağırlıkları mod 127 altında alt tarafa katlanabilir. Donanım anlamı: genel amaçlı bölme devresine ihtiyaç azaltılır; toplama ve basit bit işlemleriyle modüler indirgeme yapılır. Kaynak elemanların bellekte 8 bit tutulduğunu, matematiksel olarak yalnız 7 bitin anlamlı olduğunu ve çarpım ara sonuçlarının taşmayı önlemek için 16 bit biçimde tutulduğunu belirtir.
Aritmetik birimi modüler toplama/çıkarma, dört paralel modüler çarpma yolu ve çarpımsal ters için 128 girişli bir lookup table/ROM içerir. Kaynağa göre bu ters alma yapısı, genişletilmiş Öklid algoritması gibi daha karmaşık çok adımlı bir devre yerine sabit gecikmeli erişim sağlar.
REG bloğu neden gereklidir?
REG yapısı iki N bitlik pivot vektörünü ve satır işlemleri için ara kayıtları içerir. was_pivot, ana işlemcinin daha önce bilinen pivot konumlarını hızlandırıcıya aktarmasını sağlar. is_pivot, yeni çalıştırmada keşfedilen pivotları kaydeder ve sonuçta ana sisteme geri gönderilir. Ayrıca satır takası ve eleme sırasında kullanılan kelime tamponları, pivot tersini saklayan ölçekleme kaydı, eleme katsayısını saklayan kayıtlar ve matris içinde konumu izleyen adres/indeks kayıtları bulunur.
X-HEEP entegrasyonu: kontrol ve veri yolları neden ayrılıyor?
Hızlandırıcı X-HEEP RISC-V sistemine gevşek bağlı, bellek eşlemeli bir çevre birimi olarak eklenmiştir. Küçük kontrol sinyalleri ve pivot haritaları MMIO kayıtlarından geçerken yoğun G matrisi doğrudan DMA ile hızlandırıcının yerel belleğine aktarılır. Böylece CPU büyük matris kopyalarını kendi yük/store akışıyla taşımak zorunda kalmaz.
Sürücü yazılımının dört evresi vardır: başlangıçta PLIC (Platform-Level Interrupt Controller) kesmeleri ve çalışma parametreleri yapılandırılır; ardından DMA G matrisini yükler ve pivot meta verisi 32 bitlik MMIO kelimeleriyle aktarılır; hızlandırma başlatıldığında CPU wfi komutuyla kesme bekleme durumuna geçebilir; tamamlanma kesmesinden sonra ters DMA aktarımıyla indirgenmiş matris geri alınır, pivot maskeleri okunur ve durum kayıtları kontrol edilerek üst düzey LESS protokolüne geri dönülür.
Çalışmanın Yöntemi ve Bulguları
Deney ve değerlendirme platformu
Donanım ölçümleri tek bir FPGA hedefi üzerinde yapılmıştır: Xilinx Artix-7 xc7a100tftg256-2. Hızlandırıcı sentezlenebilir RTL olarak tanımlanmış ve X-HEEP içinde gevşek bağlı MMIO çevre birimi şeklinde entegre edilmiştir. Tasarımın aritmetik yapısı üreticiye özgü özel aritmetik makrolara bağımlı değildir; ancak nicel zamanlama, yönlendirme, BRAM eşleme ve güç sonuçları seçilen FPGA'ya bağlı olduğundan kaynak bu sayısal sonuçları Artix-7 akışıyla sınırlar.
Yazılım tabanı aynı gömülü RISC-V akışında çalışan özgün RREF rutinidir. Derleme hedefi RV32IM, optimizasyon seviyesi -O2'dir. Çevrim sayıları platformun cycle counter'ı ile 100 Known Answer Test (KAT) vektörü üzerinde ölçülmüş ve ortalama alınmıştır. Dolayısıyla karşılaştırma, masaüstü sınıfı CPU'ya veya yüksek performanslı sunucu işlemcisine karşı değil, çalışmada kullanılan gömülü RISC-V yazılım tabanına karşıdır.
Tek RREF çağrısında performans
| Güvenlik seviyesi | Matris boyutu K×N | Yazılım çevrimi | Hızlandırılmış çevrim | Hızlanma |
|---|---|---|---|---|
| Level 1 | 126×252 | 86.814.359 | 4.186.854 | 20,7× |
| Level 3 | 200×400 | 310.933.265 | 15.366.401 | 20,2× |
| Level 5 | 274×548 | 792.047.471 | 37.432.087 | 21,2× |
Bu tablo yalnız RREF çekirdeğini izole eder. 20–21× değeri tüm dijital imza protokolünün aynı oranda hızlandığı anlamına gelmez. Bu ayrım makalenin yorumlanmasında merkezi önemdedir.
Donanıma aktarma maliyeti ve arayüz yükü
| Seviye | Hazırlık | Hesap | Geri okuma | Toplam | Arayüz yükü |
|---|---|---|---|---|---|
| Level 1 | 5.170 | 4.165.080 | 16.604 | 4.186.854 | %0,52 |
| Level 3 | 6.881 | 15.318.702 | 40.818 | 15.366.401 | %0,31 |
| Level 5 | 8.728 | 37.347.405 | 75.954 | 37.432.087 | %0,23 |
Hazırlık aşaması DMA kurulumu, matris yükleme, kesme yapılandırması ve pivot meta verisinin aktarımını; geri okuma ise matrisin geri alınması, pivot vektörlerinin okunması ve eşgüdümü içerir. Kaynakta ölçülen toplam ek yük bütün seviyelerde %1'in altındadır. Bu sonuç, bu özel platform ve veri yolu düzeninde DMA ve kesme tabanlı haberleşmenin RREF hesap süresini baskılayan yeni bir darboğaz oluşturmadığını gösterir.
21× RREF hızlanması neden tüm LESS imza akışında 21× hızlanma anlamına gelmiyor?
Donanım yalnız RREF çekirdeğini hızlandırdığı için hashing, protokol kontrolü, commitment işlemleri, kanonikleştirme ve veri hareketinin diğer bölümleri yazılımda kalır; bu nedenle Amdahl yasası benzeri bir sınır oluşur ve kaynak Tablo 5'te tam SIGN/VERIFY hızlanmaları çekirdek düzeyindeki yaklaşık 21× değerinden daha düşük kalır.
| Seviye | Parametre | SIGN (kCC) | VERIFY (kCC) | ||||
|---|---|---|---|---|---|---|---|
| Özgün | Hızlandırılmış | Hızlanma | Özgün | Hızlandırılmış | Hızlanma | ||
| 1 | 252_45 | 4.440.308 | 863.666 | 5,14× | 3.041.298 | 736.529 | 4,13× |
| 1 | 252_68 | 6.722.680 | 1.310.237 | 5,13× | 4.605.871 | 1.136.258 | 4,05× |
| 1 | 252_192 | 19.446.265 | 3.578.328 | 5,43× | 12.742.011 | 3.150.238 | 4,04× |
| 3 | 400_102 | 35.357.406 | 5.225.918 | 6,77× | 25.235.481 | 4.461.652 | 5,66× |
| 3 | 400_220 | 76.216.226 | 11.204.989 | 6,80× | 52.253.304 | 9.556.936 | 5,47× |
| 5 | 548_137 | 81.653.259 | 10.411.290 | 7,84× | 87.116.519 | 8.790.875 | 9,91× |
| 5 | 548_345 | 293.009.449 | 26.151.566 | 11,20× | 219.849.144 | 24.854.080 | 8,85× |
Kaynak notuna göre 1 kCC = 1000 clock cycle'dır ve bu tablodaki çevrim sayıları 100 KAT çalıştırmasının ortalamasını temsil eder.
Kaynak içi tutarsızlık: Tablo 5'te SIGN için 548_345 yapılandırmasında 11,20× hızlanma açıkça yer aldığı halde tablo öncesindeki metin sistem düzeyi hızlanmayı “4,0× ile 9,91× üzeri” aralığında tanımlar. Bu iki ifade tam olarak uyuşmamaktadır. Verianla burada tablo değerini değiştirmemekte ve metindeki üst sınırı da sessizce düzeltmemektedir.
KEYGEN için performans sonucu raporlanmamıştır. Kaynağa göre anahtar üretimi matematiksel olarak RREF kullansa da tek seferlik, genellikle çevrimdışı gerçekleştirilen bir kurulum aşamasıdır; önerilen hızlandırıcı özellikle SIGN ve VERIFY'daki tekrarlı generator_RREF_pivot_reuse yükünü hedeflediğinden KEYGEN hızlandırıcıyı kullanmaz.
Zamanlama deterministikliği ve güvenlik sınırı
Kaynak, FSM akışının gizli alan elemanlarına göre klasik yazılım dallanmaları yapmaması nedeniyle tasarımı constant-time davranış hedefiyle tanımlar. 100 farklı KAT vektöründe çevrim sayısı değişimi tipik olarak 300 çevrimin altında kalmıştır; milyonlarca çevrimlik işlemler yanında bu değişim küçüktür. Ancak yazarlar bunun güç analizi, elektromanyetik yayılım veya hata enjeksiyonuna direnç kanıtlamadığını özellikle belirtir.
Bu hızlandırıcı fiziksel yan kanal saldırılarına dayanıklı kabul edilebilir mi?
Hayır; çalışma çevrim sayısı açısından yüksek zamanlama deterministikliği gösterse de açık güç, elektromanyetik sızıntı veya hata enjeksiyonu karşı önlemi uygulamamakta ve bu saldırı sınıflarına direnç için ayrı leakage/fault değerlendirmesini gelecek çalışma olarak bırakmaktadır.
FPGA kaynak göstergeleri ne anlama geliyor?
FPGA, mantık yapısı yeniden yapılandırılabilen programlanabilir bir donanım platformudur. LUT (Lookup Table) temel kombinasyonel mantığı gerçekleştirir. FF (Flip-Flop) bit düzeyinde durum/kayıt saklar. BRAM (Block RAM) FPGA içindeki yerleşik bellek bloklarıdır. DSP blokları ise özellikle çarpma ve benzeri aritmetik işlemler için ayrılmış donanım kaynaklarıdır. Bir tasarımın “küçük” olması yalnız LUT sayısıyla değil, bu kaynakların birlikte ne kadar kullanıldığıyla değerlendirilmelidir.
Alan kullanımı
| Seviye | Parametre kümesi | LUT | FF | BRAM | DSP |
|---|---|---|---|---|---|
| Level 1 | 252_45/68/192 | 2892 | 971 | 8 | 0 |
| Level 3 | 400_102/220 | 3398 | 1273 | 32 | 3 |
| Level 5 | 548_137/345 | 4060 | 1598 | 64 | 8 |
Kaynak içi tutarsızlık: Tablo 6 Level 5 için 4060 LUT verir. Buna karşın hemen önceki alan değerlendirme metni “3700 LUT'tan az” ifadesini, sonraki karşılaştırma paragrafı ise 3649 LUT ifadesini kullanır. Aynı kaynak içindeki bu üç sayı birbiriyle uyumlu değildir. Bu aktarımda sayılar birleştirilmemiş; tablodaki 4060 LUT değeri tablo verisi olarak, diğer ifadeler ise kaynak metnindeki tutarsızlık olarak belirtilmiştir.
Güç tüketimi ve çalışma frekansı
| Seviye | Parametre kümesi | Statik güç (mW) | Dinamik güç (mW) | Toplam (mW) | Frekans (MHz) |
|---|---|---|---|---|---|
| Level 1 | 252_45/68/192 | 92 | 56 | 148 | 78,6 |
| Level 3 | 400_102/220 | 93 | 99 | 191 | 76,2 |
| Level 5 | 548_137/345 | 94 | 132 | 227 | 70,8 |
Güvenlik seviyesi yükseldikçe matris boyutu, BRAM ve DSP kullanımı arttığı için dinamik güç de yükselir. Kaynağın Artix-7 uygulamasında en yüksek toplam değer 227 mW'tır. Bu güç değerleri yerleştirme-yönlendirme sonrasındaki FPGA tahminleridir; farklı FPGA ailesi, gerilim, saat, yerleşim ve çalışma koşulları için aynı değerlerin geçerli olduğu varsayılamaz.
KeSlice metriği nasıl hesaplanıyor?
Kaynak farklı FPGA kaynaklarını tek alan göstergesinde birleştirmek için Equation (2) olarak şu metriği kullanır:
\[\mathrm{eSlice}=\max\left\{\frac{\mathrm{LUT}}{8}+128\times\mathrm{BRAM},\frac{\mathrm{FF}}{16}\right\} \tag{2}\]
Formül neyi hesaplar? LUT, BRAM ve flip-flop kullanımını eşdeğer slice ölçeğine dönüştürüp baskın olan kaynak maliyetini seçer. Değişkenler: LUT kullanılan lookup table sayısı, BRAM block RAM miktarı, FF flip-flop sayısıdır. Birim: eSlice eşdeğer slice sayısıdır; bin eSlice, KeSlice olarak ifade edilir. Matematiksel rol: ilk terim LUT ve BRAM maliyetini, ikinci terim FF maliyetini temsil eder; maksimum alınarak bunlardan daha baskın olan alan sınırlaması seçilir.
Örneğin kaynak Tablo 6'daki Level 5 değerleri kullanılırsa \(4060/8+64\times128=8699,5\) eSlice; \(1598/16\approx99,875\) eSlice olur. Maksimum değer yaklaşık 8,6995 KeSlice'tır ve bu, kaynak Tablo 8'deki 8,699 KeSlice ile uyumludur. Kaynak özetinde de aralık yaklaşık 1,38–8,7 KeSlice olarak verilmektedir.
Kaynak içi tutarsızlık: Sonuç bölümünde en yüksek güvenlik seviyesinin “en fazla 5,58 KeSlices” kullandığı yazılmıştır. Bu değer hem özetin 8,7 KeSlice üst sınırıyla hem Tablo 8'deki 8,699 KeSlice değeriyle hem de kaynak Equation (2) ile Tablo 6 sayılarından yapılan doğrudan hesapla uyuşmamaktadır. Bu nedenle 5,58 değeri doğrulanmış tek değer gibi sunulmamıştır.
Mevcut FPGA tasarımlarıyla alan karşılaştırması
| Referans / tasarım | LUT | FF | BRAM | DSP | KeSlice | Frekans (MHz) |
|---|---|---|---|---|---|---|
| [10] CROSS-RSDP-1-b | 27.308 | 11.820 | 57,5 | 0 | 19,0 | 111 |
| [24] DILITHIUM-L2/L3/L5 satırı | 29.998 | 10.366 | 11 | 10 | 8,908 | 96,9 |
| [22] LESS Level 1 grubu | 54.800 | 39.900 | 59,5 | 0 | 21,3 | 200 |
| [22] LESS Level 3 grubu | 76.700 | 57.900 | 102,5 | 0 | 32,3 | 167 |
| [22] LESS Level 5 grubu | 104.300 | 76.700 | 167,5 | 0 | 47,5 | 143 |
| Bu çalışma Level 1 | 2892 | 971 | 8 | 0 | 1,386 | 78,6 |
| Bu çalışma Level 3 | 3398 | 1273 | 32 | 3 | 4,521 | 76,2 |
| Bu çalışma Level 5 | 4060 | 1598 | 64 | 8 | 8,699 | 70,8 |
Bu karşılaştırma “en hızlı FPGA uygulaması” sıralaması olarak okunmamalıdır. Kaynak, özellikle [22] tasarımının LESS'in tamamını yüksek throughput için donanıma alan bir mimari olduğunu, bu çalışmanın ise yalnız baskın RREF çekirdeğini bir RISC-V yazılım-donanım akışı içinde hızlandırdığını belirtir. Uygulanan işlev kapsamları ve raporlanan gecikme metrikleri farklı olduğundan mutlak latency karşılaştırması yapılmamıştır. Tablo esas olarak önerilen tasarımın alan ekseninde hangi noktada durduğunu göstermek için kullanılmıştır.
Gelecek çalışma: yan kanal koruması ve ölçeklenebilirlik
Yazarların ilk gelecek çalışma yönü fiziksel saldırılardır. Mevcut mimaride açık masking veya fault karşı önlemi yoktur. Pivot keşfi, koşullu pivot yeniden kullanımı, satır değişimi, sütun eleme, bellek erişim örüntüsü ve LUT tabanlı ters alma gibi mikro işlemlerin güç ve elektromanyetik sızıntı açısından incelenmesi önerilmektedir. Kaynak, sonlu alan aritmetik yollarında çok-paylı masking yaklaşımını ve glitch'e dayanıklı hücre yapıları olarak Domain-Oriented Masking (DOM) ile Threshold Implementation (TI) tekniklerini olası gelecek yönleri arasında sayar.
İkinci yön, mimarinin başka matris-tabanlı problemlere taşınabilirliğidir. Dört bankalı bellek, adres hizalama/döndürme ağı ve pivot yeniden kullanımı Gaussian elimination yoğun başka iş yüklerine uyarlanabilir. Kaynak, QR-UOV gibi çok değişkenli lineer cebir yükü yüksek başka post-kuantum adaylarını örnek verir. Ancak bu bir doğrulanmış performans sonucu değildir. Daha büyük sonlu alanlar basit kombinasyonel aritmetik ve inversion ROM yerine daha karmaşık çok çevrimli veri yolları gerektirebilir; çok daha büyük matrislerde ise bellek bant genişliği yeni ana darboğaz haline gelebilir.
Çalışmanın desteklediği sonuçlar
- LESS yazılım profilinde RREF çekirdeği baskın hesaplama maliyetidir; imzalama çevrimlerinin %87,73'ü
generator_RREF_pivot_reuseişlevinde ölçülmüştür. - Önerilen dört yollu, BRAM-merkezli RREF hızlandırıcısı Artix-7 üzerinde tek RREF çağrısında yaklaşık 20–21× hızlanma sağlamıştır.
- DMA ve kesme tabanlı entegrasyonun ölçülen offload ek yükü üç güvenlik seviyesinde de %1'in altında kalmıştır.
- Tam SIGN ve VERIFY akışlarında sistem düzeyi hızlanma sağlanmıştır; ancak çekirdek hızlanmasından daha düşüktür çünkü protokolün diğer bölümleri donanıma taşınmamıştır.
- Kaynak tablolarına göre mimari Level 1'den Level 5'e 2892–4060 LUT, 8–64 BRAM ve 0–8 DSP aralığında kaynak kullanmıştır.
- Kaynak güç tablosunda toplam güç 148–227 mW aralığındadır.
- 100 KAT vektöründe çevrim sayısı değişiminin tipik olarak 300 çevrimin altında olması yüksek zamanlama deterministikliğini desteklemektedir.
Çalışmanın desteklemediği genellemeler
- 21× RREF hızlanması, bütün LESS protokolünün her parametre kümesinde 21× hızlandığı anlamına gelmez.
- Çalışma masaüstü CPU'lar, sunucu işlemcileri veya başka FPGA aileleri üzerinde aynı çevrim, güç ve frekans sonuçlarını garanti etmez.
- Zamanlama deterministikliği, güç analizi, elektromanyetik analiz veya hata enjeksiyonuna direnç kanıtı değildir.
- Önerilen mimarinin QR-UOV veya başka matris ağırlıklı şemalarda aynı performansı vereceği deneysel olarak gösterilmemiştir.
- Kaynak içindeki çelişkili 3649/4060 LUT ve 5,58/8,699 KeSlice değerleri tek bir kesin sayıya sessizce indirgenemez.
- LESS'in NIST'in ilave dijital imza sürecinde sonraki aşamaya geçmemiş olması, bu donanım çalışmasının doğrudan standartlaştırılmış bir imza uygulaması olduğu anlamına gelmez.
Kaynak ve Yöntem Notu
Özgün çalışma: A Lightweight Accelerator for the LESS Digital Signature Scheme
Yazarlar: Giuseppe Cutrera, Alessandra Dolmeta, Valeria Piscopo, Maurizio Martina, Guido Masera.
Yazar sırası: Kaynak PDF'deki sıra korunmuştur. Kaynakta eşit katkı/eş birinci yazar işareti bulunmamaktadır.
Sorumlu yazarlar: Alessandra Dolmeta ve Valeria Piscopo.
Kurum: Department of Electronics and Telecommunication (DET), Politecnico di Torino, 10129 Torino, Italy.
Dergi: Cryptography.
Yayıncı: MDPI, Basel, Switzerland.
Cilt / sayı / makale numarası: 2026, 10(4), 45.
DOI: 10.3390/cryptography10040045.
Gönderim: 17 Nisan 2026.
Revizyon: 23 Haziran 2026.
Kabul: 29 Haziran 2026.
Yayın: 3 Temmuz 2026.
Kaynak türü: Article; özgün donanım mimarisi, sistem entegrasyonu ve FPGA performans/kaynak değerlendirmesi sunan mühendislik araştırmasıdır.
Hakemlik durumu: Cryptography, MDPI tarafından yayımlanan hakemli bilimsel bir dergidir. Makalenin PDF'sinde Received, Revised, Accepted ve Published tarihleri ayrıca yer almaktadır.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0). Telif hakkı yazarlardadır; yayıncı lisans sahibi olarak MDPI'dir.
Resmî bağlantı: https://doi.org/10.3390/cryptography10040045
Finansman: Yazarlar araştırmanın dış finansman almadığını bildirmiştir.
Veri erişilebilirliği: Çalışmanın özgün katkılarının makale içinde bulunduğu, ek soruların sorumlu yazarlara yöneltilebileceği belirtilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Kavramsallaştırma, metodoloji, uygulama, doğrulama ve veri düzenleme G.C., A.D. ve V.P.; ilk taslak yazımı G.C., A.D. ve V.P.; gözden geçirme/düzenleme ile görselleştirme A.D., V.P., M.M. ve G.M.; danışmanlık M.M. ve G.M. tarafından yürütülmüştür.
Temel yöntemsel sınır: Nicel sonuçlar Xilinx Artix-7 xc7a100tftg256-2 hedefi ve gömülü RV32IM yazılım tabanı için raporlanmıştır. Başka FPGA ailesi, başka işlemci veya başka saat/yerleşim koşullarına doğrudan genellenmemelidir.
Güvenlik sınırı: Çalışma fiziksel yan kanal veya hata enjeksiyonu direncini değerlendirmemiştir. Zamanlama deterministikliği ayrı bir ölçümdür ve fiziksel sızıntı direnciyle eşanlamlı değildir.
Kaynak içi sayısal tutarsızlıklar: (1) Tablo 5 SIGN için 11,20× değerini içerirken yakın metin üst aralığı 9,91× civarında ifade etmektedir. (2) Tablo 6 ve Tablo 8 Level 5 için 4060 LUT verirken alan metni 3700'den az ve sonraki paragraf 3649 LUT ifadelerini kullanmaktadır. (3) Özet ve Tablo 8 Level 5 alanını yaklaşık 8,7/8,699 KeSlice gösterirken sonuç bölümünde 5,58 KeSlice yazmaktadır. Verianla bu farkları sessizce düzeltmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir