


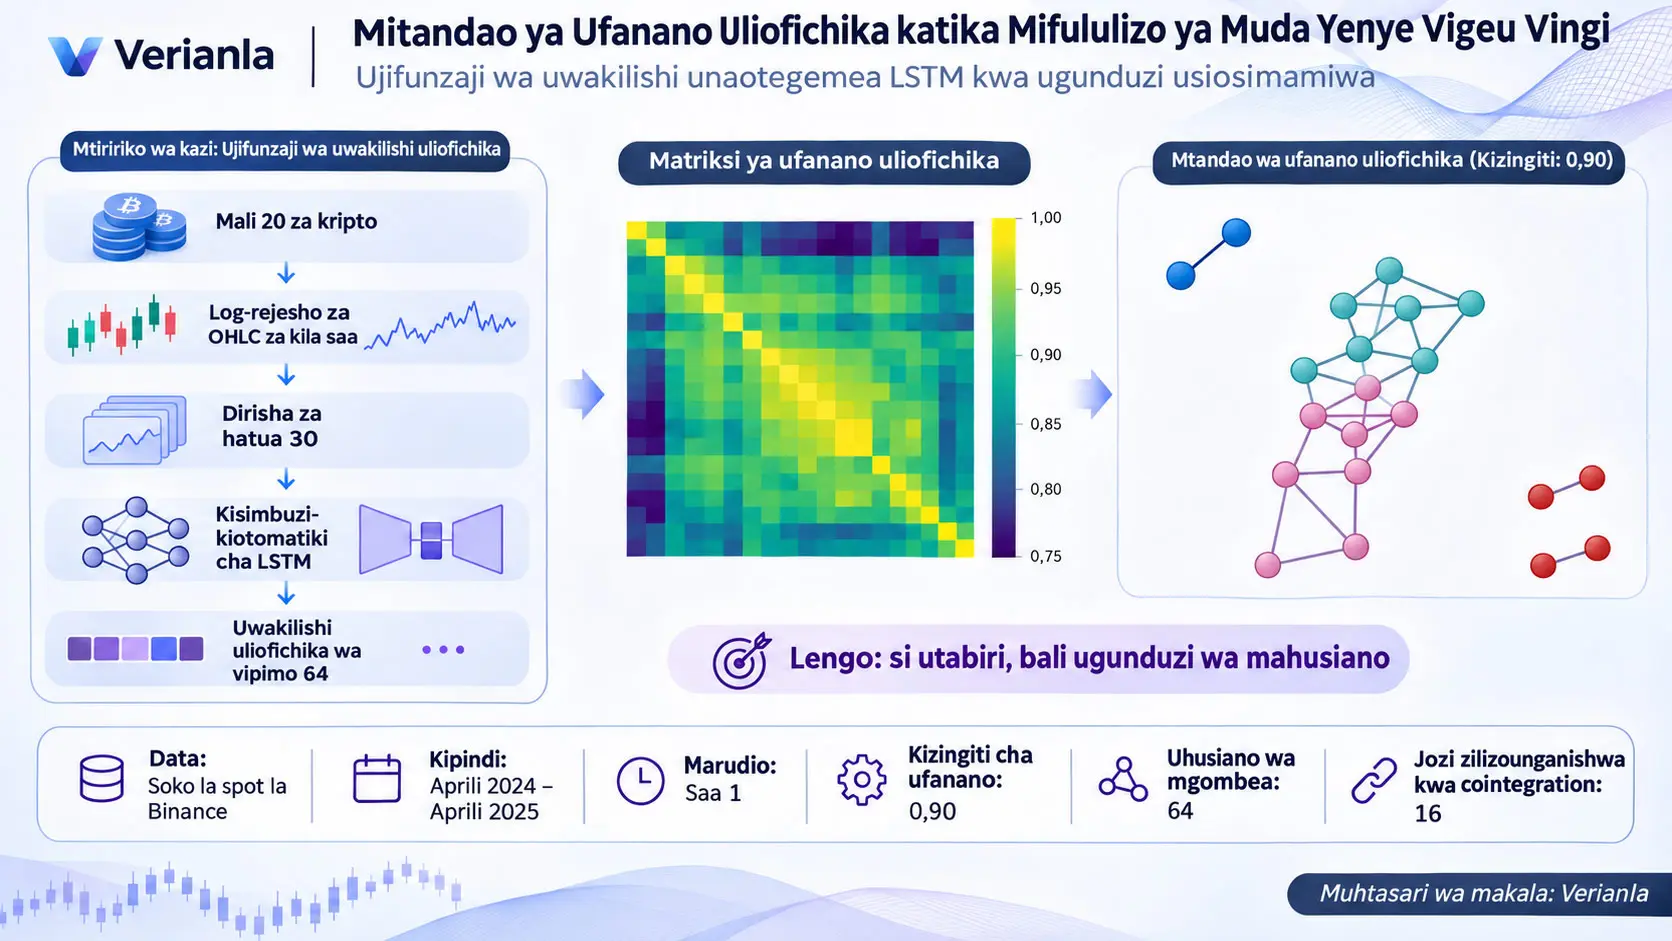
Mitandao ya Ufanano wa Kimuundo Uliofichika (Latent Structural Similarity Networks) ni mbinu ya ujifunzaji wa mashine usiosimamiwa inayolenga kugundua ufanano kati ya mali katika mifululizo ya muda yenye vigeu vingi, si kwa kuangalia tu kama zinapanda na kushuka kwa wakati mmoja, bali pia kwa mifumo changamani zaidi ya tabia zinazoonyesha kwa muda. Utafiti huu ulioandaliwa na Olusegun Owoeye unaonyesha kuwa, kwa kubadilisha mifululizo ya muda kuwa uwakilishi fiche wenye vipimo vichache, mahusiano ya kimuundo kati ya mali ambayo ni vigumu kuyaona moja kwa moja yanaweza kuchunguzwa kupitia mtandao wa ufanano.
Mbinu inayopendekezwa haikutengenezwa kutabiri bei inayofuata au kutekeleza miamala ya uwekezaji kiotomatiki. Lengo kuu la utafiti ni kugundua mahusiano yanayowezekana kati ya mali nyingi bila kutegemea kanuni za biashara au uboreshaji zilizobainishwa mapema. Kwa ajili hiyo, mifululizo ya muda hugawanywa katika madirisha yanayopishana,Long Short-Term Memory (LSTM) uwakilishi fiche hujifunzwa kwa kutumia autoencoder ya mfuatano-kwa-mfuatano inayotegemea LSTM, na mtandao wa mahusiano huundwa kwa kutegemea ufanano wa kosaini kati ya uwakilishi huo.
Mbinu hiyo ilitathminiwa kwa data ya soko la papo hapo la sarafu-fiche kutoka Binance. Utafiti ulitumia mifululizo ya bei dhidi ya USDT ya mali 20 za sarafu-fiche zilizochaguliwa kwa mtaji wa soko. Kipindi cha data kilihusisha takriban mwaka mmoja kutoka Aprili 2024 hadi Aprili 2025. Vipimo vilikuwa vya kila saa. Bei za ufunguzi, za juu zaidi, za chini zaidi na za kufunga (Open, High, Low, Close; OHLC) zilibadilishwa kuwa faida za kilogarithimu; madirisha yanayopishana yenye hatua 30 za muda yaliundwa, na autoencoder ya LSTM ya pamoja ilifunzwa kwa mali zote.
Katika sehemu ya encoder ya autoencoder, tabaka mbili za LSTM zenye kipimo fiche cha 256 zilitumika; uwakilishi uliopatikana ulibadilishwa kuwa vekta fiche yenye vipimo 64 kupitia tabaka mnene lenye kazi ya uanzishaji ya ReLU. Mafunzo yalitumia optimizer ya Adam, kosa la wastani wa miraba la uundaji upya, mini-batch ya sampuli 64 na epoch 20. Vekta fiche za madirisha mbalimbali ya kila mali zilifanyiwa wastani ili kupata uwakilishi mmoja wa kiwango cha mali; kisha ufanano wa kosaini kati ya jozi zote za mali ukahesabiwa.
Kizingiti cha ufanano wa kosaini cha 0,90 kilipotumika, mahusiano tarajiwa 64 yalipatikana kati ya mali 20. Mtandao uliotokea haukuwa na muundo sare ambamo mali zote zimeunganishwa kwa kiwango sawa; ulikuwa na vikundi vyenye miunganisho mingi, vijenzi vilivyounganishwa tofauti na jozi zilizotenganishwa. Matokeo haya yanaonyesha kuwa uwakilishi fiche uliojifunzwa ulihifadhi tofauti fulani za kimuundo badala ya kupunguza mali zote kuwa tabia moja ya jumla ya soko.
Jozi tarajiwa 64 zilizogunduliwa pia zilitathminiwa kwa kutumia jaribio la kawaida lauwiano wa muda mrefu wa Engle–Granger (cointegration test). Katika uchunguzi huu wa kiutambuzi uliofanyika baadaye kwa kiwango cha uhakika cha %95, jozi 16 zilikidhi kigezo cha cointegration. Idadi hii ni %25 ya jozi tarajiwa 64. Kushindwa kwa jozi 48 zilizobaki kupita jaribio hakumaanishi kwamba mahusiano hayo ni makosa kwa lazima; kwa sababu ufanano wa kimuundo uliofichika unaotafutwa na mbinu hii si dhana ileile ya kihisabati na uhusiano wa usawa wa muda mrefu wa mstari ulio wa kawaida.
Mchango mkuu wa utafiti ni kuanzisha tabaka la ugunduzi lililo huru na michakato ya utabiri na uamuzi ili kuchunguza mahusiano katika mifululizo ya muda yenye vigeu vingi. Mbinu hii inatoa mfumo wa njia unaoweza kurekebishwa kwa vipimo vya kibaolojia, sensa za viwandani, michakato ya kuharibika kwa nyenzo na mifumo ya uhandisi yenye vigeu vingi, pamoja na masoko ya fedha. Hata hivyo, majaribio tofauti hayakufanywa katika nyanja hizi nyingine.
Kikomo muhimu cha utafiti ni kwamba matokeo yaliripotiwa kwa masafa moja ya data na kizingiti kimoja kisichobadilika cha ufanano. Makala inaeleza itifaki ya kutathmini uthabiti wa muda, unyeti wa kizingiti na udumifu wa miunganisho katika makadirio ya kurudiwa; lakini haitoi matokeo ya kina ya majaribio ya namba kwa ukaguzi wote huo. Vilevile, mbinu haikulinganishwa na algoriti mbadala za ugunduzi, na mapato ya mkakati wowote wa uwekezaji hayakujaribiwa.
Umuhimu wa utafiti kwa Uturuki ni kwamba unatoa mbinu ya jumla ya kufanya uchunguzi wa awali katika mifululizo changamani ya muda ambamo hakuna data ya matokeo yenye lebo. Inaweza kurekebishwa ili kuchunguza tabia zinazofanana za sensa za mashine za viwandani, mifumo ya mabadiliko ya vifaa mbalimbali vya uzalishaji kwa muda au ukaribu wa kimuundo kati ya vikundi vya mali za kifedha. Hata hivyo, matumizi hayo si mifano iliyothibitishwa moja kwa moja katika utafiti, bali ni maeneo yanayowezekana ya utafiti yanayojadiliwa kutokana na muundo wa mbinu.
Ufanano wa Kimuundo Uliofichika Ni Nini, na Unatofautianaje na Korelesheni ya Kawaida?
Ufanano wa kimuundo uliofichika huzingatia si tu mabadiliko ya pamoja ya wakati mmoja katika thamani zilizoonekana za mali mbili au zaidi, bali pia kiasi ambacho mifumo ya tabia yenye vigeu vingi iliyojifunzwa kwa muda inafanana. Katika utafiti huu, ufanano huo hauhesabiwi moja kwa moja kwenye data ghafi; hutathminiwa kwa kulinganisha vekta fiche zilizojifunzwa na autoencoder ya LSTM.
Mfululizo wa muda ni nini?
Mfululizo wa muda (time series) ni mkusanyiko wa thamani za kigeu zinazoonekana katika nyakati tofauti, zikiwa katika mpangilio wa muda. Kwa mfano, bei za kufunga za kila saa za sarafu-fiche, vipimo vya joto vya mashine vya kila dakika au data za mtetemo za kila sekunde za mstari wa uzalishaji huunda mifululizo ya muda.
Katika data ya aina hii, mpangilio wa uchunguzi ni muhimu. Thamani zilezile zinapotokea katika mpangilio tofauti kwa nyakati tofauti, zinaweza kuwa na taarifa tofauti kuhusu tabia ya mfumo.
Mfululizo wa muda wenye vigeu vingi ni nini?
Mfululizo wa muda wenye vigeu vingi (Multivariate Time Series) ni upimaji wa pamoja kwa muda wa sifa zaidi ya moja za mali au mfumo uleule.
Katika soko la sarafu-fiche, kuangalia bei ya kufunga pekee ni mbinu ya kigeu kimoja, wakati kutathmini pamoja sifa zinazotokana na bei za ufunguzi, za juu zaidi, za chini zaidi na za kufunga ni mbinu yenye vigeu vingi.
Sehemu ya mbinu ya utafiti inadhania kuwa kuna mali \(N\) na kwamba kila mali inawakilishwa katika nukta \(T\) za muda kwa vekta za sifa zenye vipimo \(d\):
\[ X_i=\{x_{i,t}\}_{t=1}^{T} \]
\[ x_{i,t}\in\mathbb{R}^{d} \]
Hapa:
- \(X_i\): ni mfululizo wa muda wenye vigeu vingi wa mali ya \(i\).
- \(x_{i,t}\): ni vekta ya sifa ya mali ya \(i\) katika muda \(t\).
- \(N\): ni idadi ya mali zinazochunguzwa.
- \(T\): ni jumla ya idadi ya uchunguzi wa muda.
- \(d\): ni idadi ya sifa katika kila nukta ya muda.
- \(\mathbb{R}^{d}\): ni nafasi ya namba halisi yenye vipimo \(d\).
Uwakilishi huu hauhusu data ya bei pekee. Modeli hiyohiyo ya kihisabati inaweza pia kuwakilisha mifululizo ya muda inayojumuisha kwa pamoja vipimo tofauti vya mota ya viwandani kama joto, mkondo, mtetemo na shinikizo.
Korelesheni ya kawaida hupima nini?
Korelesheni ni uhusiano wa kitakwimu unaotumiwa kufupisha mwelekeo na kiwango cha mabadiliko ya pamoja ya vigeu viwili chini ya hali fulani. Korelesheni ya Pearson inayotumiwa sana huzingatia mabadiliko ya pamoja ya mstari.
Kwa mfano, kama faida za mali mbili mara nyingi zinasonga katika mwelekeo mmoja, korelesheni chanya ya mstari inaweza kuonekana. Lakini hii haimaanishi kwamba tabia zao changamani zaidi kwa muda zinafanana kabisa.
Hata kama mali mbili hazisongi katika mwelekeo mmoja katika nyakati zilezile, zinaweza kuonyesha mkusanyiko wa volatili, mwitikio uliochelewa, mizunguko fulani au miundo inayofanana ya mabadiliko katika vipindi tofauti.
Utafiti unatokana na wazo kwamba mabadiliko ya pamoja ya mstari ya wakati mmoja peke yake huenda yasitoshe kunasa mahusiano haya yote.
Nafasi fiche inamaanisha nini?
Nafasi fiche (latent space) ni nafasi ya kihisabati ambamo data yenye vipimo vingi iliyoonekana inawakilishwa upya na modeli ya ujifunzaji kupitia sifa chache zaidi.
Neno fiche hapa lina maana kwamba sifa hazionekani moja kwa moja kama safu za data ghafi. Modeli hujifunza kubadili mifumo ya data kuwa uwakilishi uliobanwa zaidi wakati wa mafunzo.
Kwa mfano, vekta yenye vipimo 64 inayozalishwa na modeli haimaanishi kwamba kipimo chake fulani kisichoelezwa katika chanzo kinawakilisha moja kwa moja “volatili” na kipimo kingine “mwelekeo wa bei”. Vipimo fiche ni vipengele vya uwakilishi wa kihisabati vilivyojifunzwa.
Kwa hiyo utafiti hautafsiri kila kipimo cha uwakilishi fiche kana kwamba ni kigeu cha kiuchumi. Mwandishi huzingatia hasa muundo wa mtandao wa mahusiano unaotokana na uwakilishi huu.
Ujifunzaji usiosimamiwa ni nini?
Ujifunzaji usiosimamiwa (unsupervised learning) ni njia ambayo modeli hujifunza mahusiano fulani kutoka katika muundo wa data bila kuhitaji darasa sahihi au lebo lengwa iliyoandaliwa mapema kwa kila sampuli.
Katika utafiti huu, autoencoder haifunzwe kwa kutabiri bei ya baadaye ya sarafu-fiche. Inajaribu kuunda upya dirisha la mfululizo wa muda ililopewa kama ingizo.
Hivyo lengo la ujifunzaji si usahihi wa uamuzi wa uwekezaji, bali kuhifadhi taarifa za mfululizo wa muda katika uwakilishi uliobanwa.
Autoencoder ni nini?
Autoencoder (autoencoder) ni mbinu ya mtandao neva yenye encoder na decoder.
Encoder hubadili data ya ingizo kuwa uwakilishi fiche wa vipimo vichache zaidi. Decoder hujaribu kuunda upya data ya awali kutokana na uwakilishi huo fiche.
Kigezo muhimu katika mafunzo ya mfumo huu ni kiwango ambacho data iliyoundwa upya inafanana na data ya awali.
Chanzo kinasema kwamba kosa la wastani wa miraba la uundaji upya (Mean Squared Error, MSE) hupunguzwa kadiri iwezekanavyo. Umbo la jumla la kihisabati la kipimo hiki cha kosa linaweza kuonyeshwa kwa madhumuni ya ufundishaji kama ifuatavyo:
\[ MSE=\frac{1}{m}\sum_{j=1}^{m}(x_j-\hat{x}_j)^2 \]
kinaweza kuonyeshwa hivi.
Hapa \(x_j\) inawakilisha thamani halisi ya ingizo, \(\hat{x}_j\) thamani iliyoundwa upya, na \(m\) idadi ya jumla ya thamani za skela zinazolinganishwa.
Kwa sababu tofauti kati ya kila uchunguzi na thamani yake iliyoundwa upya hupandishwa mraba, makosa makubwa hutoa mchango mkubwa zaidi. Modeli hujaribu kupunguza kosa hili wakati wa mafunzo.
Mlinganyo huu umetolewa ili kufundisha ufafanuzi wa kawaida wa MSE; chanzo hakina kazi tofauti ya upotevu iliyoandikwa kwa vipimo vyote vya tensor mahususi kwa modeli.
Kwa nini LSTM ilitumika?
Long Short-Term Memory (LSTM) ni usanifu wa mtandao neva unaojirudia uliotengenezwa ili kujifunza mahusiano ya muda ndani ya data yenye mpangilio.
Wakati mbinu za kawaida za mstari za kupunguza vipimo zinaweza kuwakilisha baadhi ya mahusiano ya muda kwa kiwango kidogo, LSTM inaweza kutumia taarifa kutoka hatua zilizotangulia za mfuatano wa data wakati wa kuchakata hatua zinazofuata.
Sababu ya kuchagua LSTM katika utafiti ni uwezekano kwamba ufanano unategemea si tu thamani za vigeu kwa wakati fulani bali pia mifumo ya tabia inayokua kwa muda.
Hata hivyo, matumizi ya LSTM hayathibitishi kwamba modeli imejifunza kwa uhakika mahusiano yote yasiyo ya mstari au kwamba inastahimili hali zote za soko. Sifa hizo hutegemea data ya mafunzo iliyotumiwa na masharti ya uthibitishaji huru.
Autoencoder ya mfuatano-kwa-mfuatano hufanya nini?
Sequence-to-Sequence Autoencoder hulenga kusimba mifululizo ya ingizo yenye urefu usiobadilika au iliyopangwa kwa muundo fulani na kuizalisha upya katika umbo la mfuatano.
Katika utafiti, kila dirisha la muda hupewa encoder kama mfuatano wenye vigeu vingi. Encoder hubadili mfuatano huo kuwa vekta fiche; decoder huunda upya sifa za dirisha hilohilo la muda.
Lengo la mtafiti ni kwamba nafasi fiche ya pamoja inayoonyesha uundaji upya mzuri iweze kutumiwa kuchunguza mahusiano mapana zaidi ya kimuundo kwa muda kati ya mali.
Kwa nini mbinu hii hujifunza uwakilishi badala ya kutumia korelesheni moja kwa moja?
Vipimo vya kawaida vya ufanano vinavyohesabiwa kutokana na mifululizo ghafi ya faida ni vya haraka na rahisi kuelewa. Hata hivyo, kufupisha tabia yenye vigeu vingi katika kila kipindi cha muda kwa faida moja tu kunaweza kupoteza baadhi ya taarifa.
Mbinu inayopendekezwa hujifunza kwanza mifumo katika mifululizo mifupi ya muda, kisha hufupisha madirisha hayo katika kiwango cha mali na hatimaye kulinganisha vekta fiche.
Hili halimaanishi kwamba korelesheni ya kawaida si halali kisayansi. Utafiti unatoa mfumo mpana zaidi wa ugunduzi, lakini haufanyi ulinganisho wa kina wa ubora wa namba dhidi ya korelesheni ya moja kwa moja.
Ufanano kati ya Mali 20 za Sarafu-Fiche Uligunduliwaje katika Utafiti?
Utafiti ulichakata faida za kilogarithimu zenye vigeu vingi zilizohesabiwa kutokana na bei za OHLC za kila saa za mali 20 za sarafu-fiche kwenye Binance, kwa kuzigawa katika madirisha ya hatua 30 na kutumia autoencoder ya pamoja ya LSTM. Uwakilishi uliojifunzwa wa madirisha ya kila mali ulifanyiwa wastani, kisha kizingiti cha 0,90 kikatumika kwa ufanano wa kosaini kati ya vekta fiche zenye vipimo 64 zilizopatikana ili kuunda mtandao wa mahusiano tarajiwa.
Wigo wa mkusanyiko wa data
| Kipengele | Thamani ya chanzo |
|---|---|
| Chanzo cha data | Binance |
| Soko | Soko la papo hapo la sarafu-fiche |
| Idadi ya mali | 20 |
| Kigezo cha uteuzi | Mali 20 kubwa zaidi za sarafu-fiche kwa mtaji wa soko katika kipindi cha utafiti |
| Sarafu ya kunukuu bei | USDT |
| Kipindi cha data | Aprili 2024 – Aprili 2025 |
| Masafa ya sampuli | Saa 1 |
| Sifa za bei | Open, High, Low, Close (OHLC) |
| Ubadilishaji wa ingizo | Faida za kilogarithimu |
| Urefu wa dirisha | Hatua 30 za muda |
| Encoder | LSTM ya tabaka mbili |
| Kipimo fiche cha LSTM | 256 |
| Kipimo cha uwakilishi fiche | 64 |
| Mini-batch | 64 |
| Muda wa mafunzo | Epoch 20 |
| Uboreshaji | Adam |
| Kigezo cha upotevu | Kosa la wastani wa miraba la uundaji upya |
| Kigezo cha ufanano | Ufanano wa kosaini |
| Kizingiti cha ufanano | 0,90 |
| Mahusiano tarajiwa yaliyogunduliwa | 64 |
| Yanayokidhi kigezo cha cointegration | 16 |
Chanzo kinaeleza kipindi cha data kwa kiwango cha mwezi. Saa kamili za mwanzo na mwisho, muhuri wa muda wa uchotaji data, idadi ya rekodi kamili za kihistoria kwa kila mali na kanuni zote za kati za uteuzi wa mali hazijaripotiwa kila moja kivyake. Kwa hiyo maelezo hayo hayakujazwa kwa dhana.
Data ya OHLC inamaanisha nini?
OHLC ina taarifa nne za bei kwa kipindi maalumu cha muda:
- Open: Bei ya ufunguzi ya kipindi cha saa.
- High: Bei ya juu zaidi iliyotazamwa katika kipindi hicho.
- Low: Bei ya chini zaidi iliyotazamwa katika kipindi hicho.
- Close: Bei ya kufunga ya kipindi hicho.
Taarifa hizi nne zinaweza kuonyesha tabia zaidi ya ndani ya kipindi kuliko bei ya kufunga peke yake. Kwa mfano, mishumaa miwili ya saa yenye bei sawa ya kufunga inaweza kuwa na bei tofauti za juu zaidi na chini zaidi.
Katika utafiti, mifululizo hii ya OHLC ilibadilishwa kuwa faida za kilogarithimu, na hakuna njia mpya za sifa zilizoongezwa.
Faida ya kilogarithimu ni nini?
Faida ya kilogarithimu ni kipimo cha mabadiliko ya bei kinachoelezwa kwa logariti asilia ya uwiano wa bei mbili chanya zinazofuatana.
Ufafanuzi wa kawaida, kwa madhumuni ya ufundishaji, ni:
\[ r_t=\ln\left(\frac{P_t}{P_{t-1}}\right) \]
ni kama ifuatavyo.
Hapa \(P_t\) inaonyesha bei katika nukta husika ya muda, \(P_{t-1}\) bei katika nukta iliyotangulia na \(\ln\) logariti asilia.
Faida za kilogarithimu huruhusu kuzingatia mabadiliko ya uwiano badala ya viwango halisi vya bei. Hili linaweza kusaidia kutathmini mali zenye viwango tofauti vya bei ndani ya mfumo uleule wa ujifunzaji.
Uwakilishi huu wa kihisabati ni ufafanuzi wa kawaida wa faida ya kilogarithimu. Ingawa chanzo kinasema kilitumia faida za kilogarithimu za OHLC, hakielezi kwa kila undani jinsi thamani zilizokosekana, bei sifuri na ulinganifu wa data vilivyoshughulikiwa katika kubadili njia nne za bei.
Kwa nini data zinagawanywa katika madirisha?
Tabia katika mifululizo ya muda ya fedha na viwanda inaweza kubadilika kwa muda. Kutazama kipindi chote kwa dhana moja ya usambazaji usiobadilika kunaweza kuficha sifa za kimuundo za eneo fulani zilizojitokeza katika vipindi maalumu.
Dirisha linalosogea (rolling window) ni uchunguzi wa mfululizo wa muda katika sehemu ndogo zinazofuatana na ambazo mara nyingi zinapishana.
Katika utafiti, urefu wa kila dirisha:
\[ L=30 \]
ulibainishwa hivyo. Kwa kuwa masafa ya data ni saa moja, hii inamaanisha kila dirisha lina mfuatano wa uchunguzi wa saa 30.
Kwa sababu chanzo hakitoi thamani ya namba iliyoelezwa kwa undani kwa hatua ya kusogeza dirisha (stride), haijabainishwa kwa dhana hasa dirisha moja lilisogezwa kwa uchunguzi mingapi.
Kila dirisha:
\[ X_i^{(\tau)}\in\mathbb{R}^{L\times d} \]
huonyeshwa hivi.
Hapa \(\tau\) inawakilisha faharasa ya dirisha, \(L\) urefu wa dirisha na \(d\) kipimo cha sifa.
Chanzo kinasema kwamba sifa zilinormalishwa katika kila dirisha kivyake. Hata hivyo, mlinganyo kamili wa normalizasheni iliyotumiwa na uchakataji wa thamani zinazotoka nje ya kawaida au data zilizokosekana haujafafanuliwa kwa kina. Kwa hiyo ubadilishaji maalumu wa z-score au min–max haujachukuliwa kama mbinu ya chanzo.
Lengo la normalizasheni kwa kila dirisha
Viwango vya bei na mizani ya volatili ya mali tofauti vinaweza kutofautiana. Normalizasheni inalenga kupunguza kuzingatia kwa modeli tofauti za ukubwa halisi pekee na kufanya miundo ya tabia kwa muda ilinganishwe kwa urahisi zaidi.
Hatua hii haibadili mali zote kuwa sifa moja ya kiuchumi. Inalenga tu kupunguza athari za mizani katika uwakilishi wa data uliotumiwa.
Maelezo ya usanifu wa autoencoder ya LSTM
Kwa mujibu wa chanzo, sehemu ya encoder ina tabaka mbili za LSTM zinazofuatana na kipimo fiche ni 256. Tokeo la mwisho la LSTM hubadilishwa kuwa vekta fiche yenye vipimo 64 kupitia tabaka mnene lenye kazi ya uanzishaji ya ReLU.
Katika sehemu ya decoder, vekta fiche hupitishwa tena katika projection, hurudiwa katika mhimili wa muda na kubadilishwa kuwa kipimo cha sifa za mfuatano wa ingizo kwa kutumia tabaka mbili za LSTM na tabaka la mstari linalosambazwa kwa muda.
Modeli ilitengenezwa kwenye TensorFlow/Keras na kufunzwa kwa epoch 20 kwa kutumia uboreshaji wa Adam.
Epoch ni jina la kupita mara moja kikamilifu katika data za mafunzo wakati wa ujifunzaji wa modeli.Mini-batch ni kundi la sampuli zinazotumiwa pamoja katika kila sasisho la parameta. Katika utafiti, ukubwa wa mini-batch ni 64.
Data za mafunzo zilichukuliwa kutoka bwawa la sampuli la pamoja lililoundwa kwa madirisha yanayosogea ya mali zote 20. Hivyo modeli moja inayotoa nafasi fiche ya pamoja ilifunzwa badala ya modeli tofauti kabisa kwa kila mali.
Matumizi ya modeli ya pamoja ni muhimu katika kulinganisha mali, kwa kuwa vekta fiche za mali tofauti huzalishwa ndani ya mfumo uleule wa uwakilishi.
Uwakilishi wa madirisha huunganishwaje?
Autoencoder huzalisha uwakilishi fiche kwa kila dirisha la kila mali. Hata hivyo, ili kufanya ulinganisho mmoja wa ufanano kati ya mali, inahitajika vekta ya pamoja inayowakilisha kila mali.
Kwa kusudi hili, chanzo hutumia wastani wa kihesabu wa vekta za madirisha:
\[ z_i=\frac{1}{K_i}\sum_{\tau=1}^{K_i}h_i^{(\tau)} \]
Hapa:
- \(z_i\): ni uwakilishi fiche uliounganishwa wa mali ya \(i\).
- \(K_i\): ni idadi ya madirisha yaliyoundwa kwa mali husika.
- \(h_i^{(\tau)}\): ni vekta fiche ya mali ya \(i\) iliyojifunzwa kutoka dirisha la \(\tau\).
- \(\tau\): ni faharasa ya dirisha.
Fomula inaonyesha kwamba uwakilishi wote wa madirisha ya mali hujumlishwa na kugawanywa kwa idadi ya madirisha. Matokeo ni vekta moja inayofupisha mifumo ya tabia iliyojifunzwa ya mali kwa muda.
Mbinu hii inalenga kupunguza kwa kufanya wastani athari za mabadiliko ya muda mfupi yanayoonekana katika dirisha fulani pekee.
Hata hivyo, kufanya wastani hakuhifadhi bila upotevu mabadiliko yote ya muda. Kwa mfano, tabia zinazotofautiana sana katika vipindi tofauti zinaweza kuunganishwa katika vekta moja. Hii pia ni sababu moja ya mwandishi kusisitiza umuhimu wa tathmini za uthabiti katika hatua za baadaye.
Ufanano wa kosaini huhesabiwaje?
Mlinganyo mkuu wa pili wa utafiti niufanano wa kosaini (cosine similarity) kati ya vekta fiche za mali mbili:
\[ s_{ij}=\frac{z_i^{\top}z_j}{\|z_i\|\|z_j\|} \]
Katika mlinganyo huu:
- \(s_{ij}\): ni ufanano wa kosaini kati ya mali za \(i\) na \(j\).
- \(z_i\): ni vekta fiche ya mali ya kwanza.
- \(z_j\): ni vekta fiche ya mali ya pili.
- \(z_i^{\top}z_j\): ni zao la skela la vekta hizo mbili.
- \(\|z_i\|\): ni norma ya Euclid ya vekta ya kwanza.
- \(\|z_j\|\): ni norma ya Euclid ya vekta ya pili.
Norma ya Euclid ni urefu wa kihisabati wa vekta. Ufanano wa kosaini husaidia kutathmini jinsi mielekeo ya vekta ilivyo karibu kuliko ukubwa wake.
Ikiwa vekta mbili zisizo sifuri zinaelekea upande mmoja, ufanano wa kosaini ni 1. Ikiwa zinaelekea kwa pembe ya kulia, ni 0; na ikiwa zinaelekea pande zinazokinzana, ni −1.
Thamani hii si kipimo kilekile na mgawo wa korelesheni ya Pearson kati ya faida za kifedha. Vitu vinavyolinganishwa katika chanzo si mifululizo ghafi ya faida bali vekta fiche zilizojifunzwa.
Fomula haijafafanuliwa moja kwa moja kwa vekta sifuri kwa sababu norma kwenye kigawanyo huwa sifuri. Chanzo hakiripoti kanuni maalumu ya ukokotoaji kwa hali hiyo.
Kwa nini ufanano wa kosaini ulichaguliwa?
Lengo la mwandishi ni kuchunguza ufanano wa mwelekeo wa uwakilishi fiche badala ya ukubwa wake halisi. Hata kama vekta fiche mbili zina ukubwa tofauti, ufanano wao wa kosaini unaweza kuwa mkubwa ikiwa zinaelekea upande mmoja.
Sifa hii inaweza kutoa kipimo cha kihisabati kinachofaa wakati wa kulinganisha mali zenye miundo tofauti ya bei na mizani.
Hata hivyo, ufanano mkubwa wa kosaini haumaanishi kwamba mali mbili za sarafu-fiche zitakuwa na faida sawa katika siku zijazo, kwamba kuna uhusiano wa kisababishi kati yao, au kwamba zinatokana na msingi uleule wa kiuchumi.
Matriksi ya ufanano ni nini?
Thamani za \(s_{ij}\) zilizohesabiwa kwa kila jozi ya mali zinaweza kupangwa katika matriksi. Hivyo safu na nguzo zina mali, na sehemu za makutano zina ufanano kati ya mali hizo.
Kwa mali 20, muundo huu ni matriksi ya ufanano iliyo linganifu yenye ukubwa wa 20×20.
Thamani za ulalo mkuu wa matriksi ni 1 kwa sababu ufanano wa kosaini wa vekta zisizo sifuri na zenyewe huwa na thamani hiyo.
Kielelezo 1 cha chanzo kinaonyesha matriksi hii kwa rangi. Inaonekana kuwa si seli zote zina rangi sawa na kwamba baadhi ya vikundi vya mali vina ufanano mkubwa zaidi.
Hii inaonyesha kwamba modeli haikupunguza mali zote za sarafu-fiche kuwa vekta ileile ya uwakilishi.
Hata hivyo, thamani zote 400 za namba zinazolingana na kila seli ya Kielelezo 1 hazijachapishwa katika jedwali tofauti. Kwa hiyo Verianla haitungi migawo sahihi ya ufanano kutokana na rangi zinazoonekana.
Mtandao wa ufanano huundwaje?
Matriksi ya ufanano yenyewe ina jozi zote za mali. Lengo la utafiti ni kutenganisha watarajiwa wenye nguvu zaidi kutoka katika eneo hili lenye mahusiano mengi.
Kwa sababu hiyo, grafu yenye uzani na isiyo na mwelekeo huundwa, ambamo mali huwakilishwa kama nodi (node) na mahusiano yanayofikia ufanano wa kutosha huwakilishwa kama kingo (edge).
Kizingiti kilichotumiwa katika utafiti:
\[ \tau=0.90 \]
kiliwekwa hivyo.
Jozi za mali zenye thamani za ufanano zinazofikia kizingiti hiki huhifadhiwa kwenye mtandao; jozi nyingine hazijumuishwi katika kingo za mtandao wa watarajiwa.
Kizingiti hiki kilichaguliwa kwa majaribio kwa kutegemea data, kwa lengo la kuepuka mitandao yenye msongamano mkubwa sana au iliyotawanyika kupita kiasi. Chanzo hakisemi kuwa thamani ya kizingiti iliamuliwa kupitia uboreshaji wa uwekezaji.
Katika mtandao, nodi, ukingo na kijenzi kilichounganishwa vinamaanisha nini?
Nodi (node): Inawakilisha mali moja ya sarafu-fiche katika utafiti huu.
Ukingo (edge): Unawakilisha uhusiano wa ufanano fiche kati ya mali mbili unaokidhi sharti la kizingiti.
Uzani (weight): Ni thamani ya ufanano wa kosaini inayohusishwa na ukingo.
Kijenzi kilichounganishwa (connected component): Ni kundi la nodi zinazoweza kufikiana kupitia njia ya kingo ndani ya kundi hilo.
Grafu ndogo yenye msongamano: Ni hali ya kuwa na miunganisho mingi kwa kiasi kati ya nodi za kundi.
Jozi iliyotengwa: Ni muundo wa nodi mbili zinazounganishwa lakini zimetenganishwa na vijenzi vikubwa vingine vya mtandao.
Kielelezo 2 cha chanzo kinaonyesha vikundi vyenye msongamano tofauti na jozi zilizotenganishwa. Kutounganika kwa mali zote katika mtandao mmoja wa jumla kunatafsiriwa kwamba uwakilishi uliojifunzwa uliunda muundo wa mahusiano wenye uwezo wa kutofautisha.
Kuna jozi ngapi zinazowezekana kati ya mali 20?
Ikizingatiwa kwamba kila mali kati ya 20 inaweza kulinganishwa na mali nyingine 19, idadi ya jumla ya jozi tofauti zinazowezekana, bila kuhesabu kila jozi mara mbili, ni:
\[ \binom{20}{2}=\frac{20(20-1)}{2}=190 \]
huhesabiwa hivyo.
Namba hii ni matokeo rahisi ya kombinatoriki yanayotokana na muundo wa mtandao usio na mwelekeo wa mali 20 wa chanzo; si ugunduzi mpya wa majaribio.
Katika utafiti, jozi 64 kati ya jozi tofauti 190 zinazowezekana zilikidhi sharti la kizingiti na kuhifadhiwa kwenye mtandao wa watarajiwa.
Hivyo mbinu ya ugunduzi inatoa muundo wa mahusiano uliowekewa mipaka ya watarajiwa 64 badala ya kupeleka moja kwa moja jozi zote za mali katika uchunguzi wa baadaye.
Kwa nini thamani ya kizingiti ni muhimu?
Kuweka kizingiti ni hatua inayoathiri moja kwa moja msongamano wa mtandao.
Kizingiti cha ufanano kilicho juu zaidi kwa kawaida husababisha miunganisho michache kubaki. Kizingiti cha chini zaidi kinaweza kufanya jozi zaidi za mali ziwe sehemu ya mtandao wa watarajiwa.
Hata hivyo, katika utafiti huu matokeo ya mtandao yaliyohesabiwa tofauti kwa vizingiti mbalimbali hayajaripotiwa. Kwa mfano, chanzo hakielezi kwamba vizingiti vya 0,85 au 0,95 vingezalisha kingo ngapi.
Chanzo kinapendekeza kutathmini mikakati mbadala ya kuweka vizingiti na uchunguzi wa vizingiti katika utafiti wa baadaye.
Kwa nini mtandao uliojifunzwa si ramani ya mahusiano ya hakika?
Kingo za mtandao zinaonyesha kuwepo kwa ufanano mkubwa wa mwelekeo kati ya uwakilishi fiche uliojifunzwa wa mali mbili.
Lakini sifa hiyo si uthibitisho wa hakika kwamba mali mbili zinaathiriana katika ulimwengu halisi, zina chanzo cha msingi kinachofanana, au zitasonga pamoja katika siku zijazo.
Mwandishi anauweka mtandao moja kwa moja kamagrafu ya nadharia tete za mahusiano (relational hypothesis graph). Dhana hii inaonyesha kwamba mtandao unapendekeza mahusiano tarajiwa kwa uchunguzi wa baadaye, si kusababisha kwa hakika au mahusiano yaliyothibitishwa ya usawa wa kiuchumi.
Kwa Nini Ni Jozi 16 Tu Kati ya Mahusiano Tarajiwa 64 Zilikidhi Jaribio la Cointegration?
Kwa sababu kipimo cha ufanano fiche cha utafiti na jaribio la cointegration la Engle–Granger hutathmini aina tofauti za mahusiano. Ufanano fiche hupima ukaribu wa mifumo ya muda yenye vigeu vingi iliyojifunzwa, huku cointegration ikichunguza kama kuna mchanganyiko wa mstari ulio tuli kitakwimu kati ya mifululizo chini ya dhana maalumu kuhusu uunganishaji na mahusiano ya mstari ya muda mrefu.
Cointegration ni nini?
Cointegration (cointegration) ni hali ambayo mchanganyiko ufaao wa mstari wa mifululizo fulani ya muda isiyo tuli kitakwimu unakuwa na muundo uliotulia kitakwimu.
Dhana hii hutumiwa hasa kuchunguza mahusiano ya usawa wa muda mrefu kati ya mifululizo ya muda.
Mifululizo miwili kusonga katika mwelekeo unaofanana kwa muda mfupi pekee haitoshi kwa cointegration. Vivyo hivyo, korelesheni ya mstari kuwa ndogo hakuondoi mahusiano yote ya muda mrefu yanayowezekana.
Jaribio la Engle–Granger hufanya nini?
Jaribio la cointegration la Engle–Granger ni mojawapo ya mbinu za kawaida za ekonometri za kuchunguza kama kuna uhusiano wa mstari wa muda mrefu kati ya mifululizo miwili ya muda chini ya hali zinazofaa za uunganishaji.
Katika mbinu ya kawaida yenye vigeu viwili, mfululizo mmoja huwekwa katika modeli kama kazi ya mstari ya mwingine na utulivu wa kisekta wa mabaki ya kosa la modeli huchunguzwa.
Kwa ufafanuzi wa kufundishia, inaweza kuandikwa:
\[ Y_t=\alpha+\beta X_t+\varepsilon_t \]
inaweza kuandikwa.
Hapa \(Y_t\) na \(X_t\) ni mifululizo ya muda, \(\alpha\) ni kiungo kisichobadilika, \(\beta\) ni mgawo wa uhusiano wa mstari na \(\varepsilon_t\) ni kiungo cha mabaki.
Iwapo masharti ya kinadharia yanayohusika yanatimizwa, mabaki kuwa tuli kitakwimu yanaweza kuashiria cointegration kati ya mifululizo.
Mlinganyo huu ni uwasilishaji wa kufundishia wa mbinu ya kawaida ya Engle–Granger. Makala ya chanzo haijaripoti thamani maalumu za \(\alpha\) na \(\beta\) zilizotumiwa kwa kila jozi ya mali.
Utulivu wa kitakwimu ni nini?
Utulivu wa kitakwimu (stationarity) ni dhana inayohusu kutobadilika kwa sifa fulani za kitakwimu za mfululizo wa muda kwa muda.
Katika muktadha wa utulivu dhaifu wa kitakwimu, kwa kawaida hutathminiwa kama wastani ni thabiti, variansi haibadiliki kwa muda na kovariansi hutegemea tu ucheleweshaji kati ya nukta za muda.
Viwango vya bei za kifedha mara nyingi huchunguzwa kama michakato isiyo tuli kitakwimu. Faida za kilogarithimu zinaweza kutoa uwakilishi ulio tuli zaidi chini ya baadhi ya masharti ya modeli.
Lakini kutumia faida hakumaanishi kwamba kila mali ya sarafu-fiche imethibitishwa kwa uhakika kuwa tuli kitakwimu katika kipindi chote kilichochunguzwa. Chanzo hakitoi majedwali tofauti ya majaribio ya utulivu kwa mali zote.
Cointegration ilitumikaje katika chanzo?
Katika utafiti, jaribio la Engle–Granger lilitumika baada ya mtandao fiche kuundwa.
Kwanza mahusiano tarajiwa 64 yalichaguliwa kwa kizingiti cha 0,90, kisha jozi hizi zikafanyiwa jaribio la cointegration katika kiwango cha uhakika cha %95.
Matokeo ya jaribio yalionyesha kuwa jozi tarajiwa 16 zilikidhi kigezo.
Matokeo haya:
\[ \frac{16}{64}\times100=\%25 \]
yanalingana na kiwango hicho.
Iliripotiwa kuwa jozi tarajiwa 48 zilizobaki hazikukidhi sharti la cointegration.
Chanzo hakijachapisha thamani za p, takwimu za jaribio au migawo ya regresha iliyotumika kwa kila jozi 64 kivyake. Kwa hivyo haiwezekani kuhesabu upya kutokana na PDF hii ni jozi zipi zilipita jaribio kwa thamani zipi za kitakwimu.
Je, jozi 48 ni ugunduzi ulioshindwa?
Hapana. Lengo la utafiti si kutengeneza kiainishaji kinachotambua jozi za cointegration kwa usahihi wa kiwango cha juu kabisa.
Mtandao fiche unajaribu kugundua muundo wa pamoja wa mifumo tofauti ya muda. Jaribio la cointegration, kwa upande mwingine, huchunguza uhusiano wa kawaida wa ekonometri wenye upeo mwembamba na masharti maalumu ya kihisabati.
Kwa hiyo kutokidhi jaribio hakumaanishi kwamba ufanano mkubwa haupo kati ya vekta fiche.
Pia jozi 16 kukidhi kigezo cha cointegration hakumaanishi kwamba jozi hizo ni fursa za uwekezaji zenye faida kiotomatiki.
Je, matokeo haya yanaunda mkakati wa uwekezaji?
Hapana. Utafiti haukutoa ishara za kununua au kuuza, haukubuni kanuni za kufungua au kufunga miamala, wala haukuhesabu faida ya mkakati.
Matokeo kama gharama za miamala, mtelezo (slippage), faida ya portifolio, uwiano wa Sharpe, kushuka kwa kiwango cha juu zaidi au faida halisi ya uwekezaji hayajaripotiwa.
Mwandishi anawasilisha mtandao wa mahusiano kama muundo wa ugunduzi wa awali unaoweza kutumiwa na tafiti za baadaye zinazolenga nyanja mahsusi.
Faida kuu ya mtandao wa mahusiano ni nini?
Katika mfumo wenye mali nyingi, uchunguzi wa kina wa jozi zote zinazowezekana moja baada ya nyingine unaweza kuleta mzigo mkubwa wa uchambuzi.
Mbinu inayopendekezwa hulinganisha kwanza mali zote katika nafasi fiche ya pamoja, kisha kutenganisha mahusiano yenye ufanano mkubwa.
Kwa njia hii, hupatikana orodha fupi ya watarajiwa kwa uchunguzi wa kina zaidi.
Hata hivyo, kuna tofauti muhimu hapa: hesabu ya awali ya ufanano inafanyika kwa jozi zote. Kwa hiyo mbinu haiondoi hesabu zote za awali za ufanano wa jozi. Upunguzaji wa wigo hufanyika katika hatua ya baadaye ya uchunguzi wa kina.
Uthabiti wa muda unaweza kutathminiwaje?
Utafiti unapendekeza itifaki ya kutathmini uthabiti ili kuchunguza iwapo miunganisho iliyogunduliwa hujitokeza tena katika vipindi tofauti vya muda.
Katika mbinu hii, kipindi cha data kinaweza kugawanywa katika vitalu tofauti vya muda na michakato ileile ya kujifunza na kuunda mtandao kurudiwa.
Baadaye kingo za pamoja kati ya mitandao zinaweza kulinganishwa.
Chanzo kinapendekeza, kwa mfano,ufanano wa Jaccard na korelesheni ya nafasi kati ya matriksi za ufanano.
Ufafanuzi wa kawaida wa ufanano wa Jaccard kwa seti mbili za kingo ni:
\[ J(A,B)=\frac{|A\cap B|}{|A\cup B|} \]
ni kama ifuatavyo.
Hapa \(A\) na \(B\) ni seti za kingo zilizopatikana katika vitalu tofauti vya muda. \(A\cap B\) ni kingo za pamoja, na \(A\cup B\) inawakilisha kingo zote tofauti zilizopo katika angalau mtandao mmoja.
Thamani ya Jaccard inapokuwa 1, seti hizo mbili zinafanana kabisa; inapokuwa 0, hakuna ukingo wa pamoja.
Fomula hii imetolewa ili kufundisha tathmini ya uthabiti inayopendekezwa katika makala. Chanzo hakijaripoti thamani maalumu ya Jaccard iliyohesabiwa kwa utafiti huu.
Seti ya miunganisho ya msingi ni nini?
Mwandishi anaeleza kwamba miunganisho inayoendelea kujitokeza katika makadirio mbalimbali ya kurudiwa inaweza kuchunguzwa kamakingo za msingi (core edges).
Kwa mfano, jozi fulani ya mali ikionyesha tena na tena ufanano mkubwa katika vitalu tofauti vya muda, inaweza kuashiria uhusiano tarajiwa ulio thabiti zaidi kuliko ufanano wa kipindi kimoja pekee.
Chanzo kinaeleza hili kama sehemu ya itifaki ya utafiti. Hata hivyo, hakuna jedwali kamili la udumifu linaloonyesha ni miunganisho ipi kati ya 64 ilijirudia katika vitalu vingapi vya muda.
Kwa nini unyeti wa kizingiti unapaswa kujaribiwa tofauti?
Mtandao ulioundwa kwa kizingiti cha 0,90 una muundo fulani. Kizingiti kinapobadilishwa, baadhi ya miunganisho inaweza kuondolewa au mipya kuongezwa.
Kwa hiyo sifa kama ukubwa wa kijenzi kikubwa zaidi kilichounganishwa, udumifu wa nodi zenye miunganisho mingi au kuendelea kuwepo kwa kingo zenye nguvu zinaweza kuchunguzwa katika vizingiti tofauti.
Lakini chanzo hakijachapisha matokeo ya kulinganisha yaliyopimwa katika vizingiti tofauti. Tathmini ya unyeti wa kizingiti inayowasilishwa na utafiti ni pendekezo la mbinu; haimaanishi kwamba majaribio ya vizingiti vingi yamekamilishwa.
Mbinu na Matokeo ya Utafiti
Muundo wa utafiti
Utafiti huu ni onyesho la majaribio la mbinu inayotathmini kama uwakilishi fiche unaopatikana kwa ujifunzaji usiosimamiwa unaweza kutumiwa kugundua mahusiano katika mifululizo ya muda yenye vigeu vingi.
Mfuatano wa hatua kuu za utafiti ni kama ifuatavyo:
- Data za OHLC za kila saa za mali 20 za sarafu-fiche zilizochaguliwa kutoka Binance zilichukuliwa.
- Mifululizo ya bei ilibadilishwa kuwa faida za kilogarithimu.
- Faida zenye vigeu vingi ziligawanywa katika madirisha yanayopishana ya hatua 30 za muda.
- Sifa zilinormalishwa kwa kujitegemea katika kila dirisha.
- Madirisha ya mali zote yalipewa autoencoder ya pamoja ya LSTM.
- Autoencoder ilifunzwa kupunguza kosa la wastani wa miraba la uundaji upya.
- Vekta fiche yenye vipimo 64 ilizalishwa kwa kila dirisha.
- Vekta za madirisha za kila mali zilifanyiwa wastani kuunda uwakilishi wa kiwango cha mali.
- Ufanano wa kosaini kati ya vekta fiche za mali 20 ulihesabiwa.
- Mtandao wa ufanano wenye uzani na usio na mwelekeo uliundwa kwa kizingiti cha 0,90.
- Mahusiano tarajiwa 64 ya mali yalipatikana kutoka mtandao.
- Jozi hizi 64 zilitathminiwa baadaye kwa jaribio la Engle–Granger; jozi 16 zilikidhi kigezo cha cointegration.
Matokeo ya kwanza ya jaribio: matriksi ya ufanano fiche
Kielelezo 1 cha chanzo kinaonyesha matriksi ya ufanano wa kosaini iliyohesabiwa kutokana na vekta fiche zilizounganishwa za mali 20 za sarafu-fiche.
Mgawanyo wa rangi za matriksi unaonyesha kwamba jozi zote za mali hazifanani kwa kiwango kilekile.
Baadhi ya vikundi vya mali vina ufanano fiche mkubwa huku baadhi ya jozi zikiwa na thamani ndogo zaidi. Mtafiti anatafsiri matokeo haya kuwa ishara kwamba modeli ya pamoja haikupunguza mali zote kuwa uwakilishi mmoja wa jumla wa soko.
Hata hivyo, kielelezo cha chanzo hakitoi jedwali kamili la namba za ufanano za 20×20. Kwa hiyo hakukuwa na jedwali tofauti la matokeo lililoundwa kwa kutoa thamani sahihi za seli kutoka kwenye picha.
Matokeo ya pili ya jaribio: mtandao wa ufanano wenye kingo chache
Kielelezo 2 cha chanzo kinaonyesha mtandao ulioundwa kwa kutumia kizingiti cha 0,90.
Mtandao huu una mali 20 na miunganisho tarajiwa 64.
Mtandao umegawanyika katika vijenzi kadhaa vilivyounganishwa. Kuna miunganisho mingi ndani ya baadhi ya vikundi, huku mali nyingine zikiwa na miunganisho michache au zikiwa katika jozi zilizotenganishwa.
Tofauti hii inaashiria kwamba muundo wa ufanano si sare katika mali zote.
Ingawa chanzo kinaeleza sifa za jumla za topolojia ya mtandao, hakijachapisha katika jedwali idadi kamili ya kingo za kila nodi, uzani wote wa kingo au orodha kamili ya miunganisho.
Kwa hiyo Verianla haitengenezi orodha za kingo za kukisia au miunganisho ya mali iliyobuniwa ili kuunda upya Kielelezo 2 cha chanzo.
Matokeo ya tatu ya jaribio: utambuzi wa kawaida wa cointegration
Baada ya kuchunguza jozi tarajiwa 64 kwa jaribio la Engle–Granger, iliripotiwa kwamba jozi 16 zilikidhi kigezo cha cointegration.
Ugunduzi huu unaonyesha kwamba mbinu ya ufanano fiche pia ilifichua baadhi ya jozi zinazolingana na ufafanuzi wa kawaida wa uhusiano wa mstari wa muda mrefu.
Hata hivyo, ukweli kwamba ni jozi 16 tu zilizokidhi kigezo haumaanishi kwamba ufanisi wa ugunduzi wa mbinu ni %25. Cointegration si lengo la mafunzo wala mkusanyiko wa lebo za ukweli wa mwisho katika utafiti huu.
Katika mbinu ya mwandishi, jaribio la kawaida ni zana ya kutafsiri mahusiano yaliyogunduliwa kutoka mtazamo tofauti wa kitakwimu.
Vipimo vya mafanikio ambavyo havikupimwa katika chanzo
Kwa sababu hakuna tatizo la uainishaji lililobainishwa katika utafiti, vipimo kama usahihi (accuracy), precision, recall au F1-score havijaripotiwa.
Kwa kuwa hakuna utabiri wa bei uliofanywa, RMSE, MAE za utabiri au kiwango cha mafanikio ya kutabiri mabadiliko ya bei za baadaye pia havijatolewa.
Vilevile, kwa kuwa hakuna ulinganisho wa namba uliofanywa katika data zilezile na mbinu mbadala za ugunduzi, haiwezekani kuhitimisha kwamba mbinu inayopendekezwa ni bora kuliko mbinu nyingine zote.
Uwezo wa kutafsiri mbinu
Utafiti hautoi uwezo wa kutafsiri kwa kugawa moja kwa moja maana ya kiuchumi kwa kila kipengele cha vekta yenye vipimo 64 iliyojifunzwa.
Uwezo wa kutafsiri unaonekana zaidi katika kiwango cha mtandao.
Inawezekana kuona ni nodi zipi mtandao unaunganisha, ni mali zipi zimo katika kijenzi kilekile, ni vikundi vidogo vipi vyenye miunganisho mingi na ni jozi zipi zinazoweza kuingizwa katika uchunguzi wa baadaye wa kitakwimu.
Kwa hiyo badala ya kueleza moja kwa moja nafasi fiche, mbinu hubadili muundo wa mahusiano unaotolewa na nafasi hiyo kuwa kitu kinachoweza kuchambuliwa.
Uwezekano wa kuhamisha mbinu kwenda nyanja nyingine
Mwandishi anabainisha kwamba mbinu inayopendekezwa haitegemei kanuni za kihisabati zinazohusu data za fedha pekee.
Mlolongo huohuo wa hatua za jumla umeundwa ili uweze kutumiwa katika mifululizo mbalimbali ya muda yenye vigeu vingi.
Kwa mfano, utafiti unaweza kufanywa ili kugundua mifumo yenye tabia za muda zinazofanana katika nyanja kama upimaji wa fenotipu za kibaolojia, uchambuzi wa kuharibika kwa nyenzo na ufuatiliaji wa mali za viwandani.
Hata hivyo, utafiti huu una onyesho la majaribio katika data za sarafu-fiche pekee. Hakujachapishwa matokeo tofauti ya ufanisi kwa data za kibaolojia, viwandani au nyenzo.
Maeneo yanayowezekana ya matumizi ya uhandisi nchini Uturuki
Katika mitambo ya viwandani nchini Uturuki, mifululizo ya muda inaweza kupatikana kutoka mashine kwa vipimo kama joto, mkondo, mtetemo, shinikizo na matumizi ya nishati.
Uchunguzi wa mbinu ya ufanano wa kimuundo uliofichika katika data hizi unaweza kusaidia kutambua vifaa au vikundi vya sensa vinavyoonyesha tabia zinazofanana kwa ajili ya uchunguzi wa awali.
Hata hivyo, katika urekebishaji wa aina hii, usafishaji wa data, ulinganifu wa muda wa sensa, masafa ya sampuli, urefu wa dirisha, normalizasheni, mafunzo ya modeli na vizingiti vya ufanano lazima vithibitishwe tofauti kwa mfumo husika wa viwandani.
Matumizi haya yanayowezekana si utekelezaji wa makala uliofanywa katika viwanda vya Uturuki.
Nguvu za utafiti
Jambo la kwanza muhimu katika utafiti ni kutumia ujifunzaji wa uwakilishi fiche bila lengo la moja kwa moja la utabiri au uainishaji.
Jambo la pili muhimu ni kuwakilisha madirisha ya muda yenye vigeu vingi kwa modeli moja ya pamoja ya ujifunzaji.
Jambo la tatu muhimu ni kwamba uwakilishi uliojifunzwa haukuachwa kuwa tu matokeo ya kupunguza vipimo, bali ulitumiwa kuunda mtandao kati ya mali.
Jambo la nne muhimu ni kwamba jaribio la kawaida la cointegration lilitathminiwa si kama lebo ya mwisho ya ukweli bali kama mtazamo tofauti wa utambuzi.
Sifa hizi zinaonyesha kwamba mchango mkuu wa utafiti si algoriti ya uwekezaji, bali usanifu wa tabaka la ugunduzi linaloweza kutumiwa katika nyanja tofauti.
Mipaka ya utafiti
Majaribio yalifanywa kwa masafa ya saa moja pekee. Haijaonyeshwa kwamba muundo huohuo wa mtandao utatokea katika data za dakika, siku au wiki.
Mtandao wa ufanano uliripotiwa kwa thamani moja tu ya kizingiti cha 0,90. Mbinu mbadala za kuweka vizingiti hazikulinganishwa.
Ingawa itifaki ya tathmini iliainishwa kwa uthabiti wa muda na unyeti wa kizingiti, matokeo ya kina ya namba ya uthabiti kwa vitalu tofauti vya muda na vizingiti mbalimbali hayajaripotiwa.
Mbinu haikulinganishwa na mbinu nyingine za ujifunzaji wa uwakilishi au ugunduzi kwa kutumia data zilezile.
Cointegration ya Engle–Granger ni zana moja tu ya kawaida ya uchunguzi wa kiutambuzi; si jaribio kamili linalothibitisha aina zote zinazowezekana za mahusiano ya kimuundo.
Utafiti hauna kazi maalumu ya uwekezaji au uamuzi wa kiutendaji. Kwa hiyo haijapimwa ni kwa kiwango gani mtandao uliogunduliwa ungeongeza mafanikio ya mfumo wowote wa kufanya maamuzi.
Chanzo hakina jedwali tofauti la data lenye vekta kamili za namba za mali zote, matriksi kamili ya ufanano ya 20×20 na uzani wa miunganisho yote 64.
Matokeo yanayoungwa mkono na utafiti
- Mifululizo ya muda yenye vigeu vingi iliweza kuwakilishwa katika nafasi fiche ya pamoja kwa autoencoder ya LSTM isiyosimamiwa.
- Ufanano fiche wa mali 20 za sarafu-fiche haukuwa katika kiwango sawa, bali ulionyesha muundo wenye tofauti.
- Mahusiano tarajiwa 64 yalipatikana kwa kizingiti cha kosaini cha 0,90.
- Mtandao ulionyesha topolojia yenye vikundi vidogo vyenye miunganisho mingi na vijenzi mbalimbali vilivyounganishwa.
- Jozi 16 kati ya watarajiwa 64 zilikidhi kigezo cha cointegration cha Engle–Granger.
- Ilijadiliwa kwamba cointegration ya kawaida na ufanano wa kimuundo uliofichika ni dhana tofauti.
- Mbinu iliwasilishwa kama tabaka la ugunduzi wa mahusiano bila utabiri au uboreshaji wa uwekezaji.
Madai ya jumla ambayo utafiti hauyaungi mkono
- Haijaonyeshwa kwamba modeli inatabiri kwa mafanikio bei za baadaye za sarafu-fiche.
- Haijathibitishwa kwamba mahusiano yote 64 yaliyogunduliwa yana uhusiano wa kisababishi wa kiuchumi.
- Haiwezekani kuhitimisha kwamba jozi 16 za cointegration ni fursa za uwekezaji wenye faida.
- Haiwezekani kusema kwamba jozi 48 ni ugunduzi usio sahihi moja kwa moja.
- Haijaonyeshwa kwamba mbinu ina mafanikio zaidi kuliko mbinu nyingine zote za ugunduzi.
- Haijathibitishwa kwamba matokeo yale yale yatapatikana katika masafa tofauti ya muda.
- Haijathibitishwa kwamba topolojia ileile itahifadhiwa kwa vizingiti vingine mbali na 0,90.
- Hakuna majaribio tofauti yaliyofanywa katika mikusanyiko ya data za kibaolojia au viwandani.
- Haiwezekani kusema kwamba utafiti umepata usababishi au usawa wa kiuchumi wa muda mrefu uliothibitishwa kwa mahusiano yote yaliyogunduliwa.
Hitimisho la jumla la utafiti
Utafiti wa Olusegun Owoeye unaonyesha kwamba si lazima mahusiano kati ya mifululizo ya muda yenye vigeu vingi yachunguzwe tu kwa vipimo visivyobadilika vya ufanano kwenye uchunguzi ghafi.
Kubadili madirisha ya muda yanayosogea kuwa uwakilishi fiche wa pamoja kwa autoencoder ya LSTM na kujenga mtandao wa mahusiano kutokana na uwakilishi huo kunatoa mbinu ya kuchunguza ufanano tarajiwa katika mikusanyiko changamani ya data.
Mahusiano tarajiwa 64 yaliyopatikana katika data za sarafu-fiche na ukweli kwamba 16 kati yake zilikidhi kigezo cha kawaida cha cointegration vinadokeza kwamba uwakilishi fiche unaweza pia kukusanya tabia tofauti za muda ambazo haziwezi kupunguzwa kuwa mahusiano ya mstari ya usawa wa muda mrefu pekee.
Hata hivyo, ugunduzi huu haumaanishi kwamba uthibitishaji wa nje wa mahusiano yote yaliyogunduliwa umekamilishwa au kwamba ufanisi wa utabiri na biashara wa mbinu umethibitishwa.
Mchango mkuu wa kisayansi wa utafiti ni kubadili uwakilishi wa mifululizo ya muda uliojifunzwa kuwa tabaka huru la ugunduzi wa mahusiano. Hivyo, mikusanyiko iliyopangwa ya mahusiano tarajiwa inaweza kuundwa kwa uchambuzi wa kina zaidi katika nyanja mbalimbali za utafiti.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Latent Structural Similarity Networks for Unsupervised Discovery in Multivariate Time Series.
Mwandishi: Olusegun Owoeye.
Mpangilio wa waandishi: Ni utafiti wa mwandishi mmoja.
Mchango sawa: Hautumiki kwa sababu ni utafiti wa mwandishi mmoja.
Mwandishi wa mawasiliano: PDF inatoa anwani ya barua pepe ya mwandishi mmoja; hakuna alama tofauti ya corresponding-author.
Taasisi: Independent Researcher; University of Cambridge (current affiliation).
Maelezo ya taasisi: Chanzo kinamtambulisha mtafiti kama mtafiti huru na kutaja University of Cambridge kuwa taasisi anayohusishwa nayo kwa sasa. Taarifa hiyo haijapanuliwa kumaanisha kwamba University of Cambridge iliendesha au kufadhili utafiti huu kama taasisi.
Kitambulisho cha arXiv: arXiv:2601.18803.
Toleo lililochunguzwa: arXiv:2601.18803v1.
Tarehe iliyoonyeshwa katika chanzo: 15 Januari 2026.
Dokezo kuhusu tarehe za kibiblia: Tarehe 28 Januari 2026 pia inaonekana katika rekodi za faharasa na masasisho za arXiv. Tarehe iliyo kwenye PDF haijachanganywa na tarehe ya kusasisha jukwaa.
DOI: 10.48550/arXiv.2601.18803.
Chanzo rasmi: https://arxiv.org/abs/2601.18803
Aina ya uchapishaji: Chapisho la awali la arXiv (preprint).
Hali ya mapitio ya kitaalamu: Rekodi ya arXiv yenyewe si ushahidi wa mapitio ya kitaalamu. Katika uchunguzi huu halikutambuliwa toleo tofauti lililothibitishwa la jarida au kongamano lenye mapitio ya kitaalamu.
Jarida / mchapishaji: Hakuna taarifa tofauti zilizothibitishwa za jarida lenye mapitio ya kitaalamu, juzuu au nambari ya toleo lililochunguzwa.
Leseni: Chanzo kinapatikana kwa ruhusa ya usambazaji ya arXiv. Ruhusa hii haijachukuliwa kuwa leseni ya jumla ya Creative Commons inayoruhusu watu wengine kutumia tena bila mipaka vielelezo na maandishi ya chanzo.
Nyanja ya kisayansi: Computer Science – Machine Learning (cs.LG).
Aina ya utafiti:Uundaji wa mbinu na onyesho la data halisi kuhusu ujifunzaji usiosimamiwa wa uwakilishi na ugunduzi wa mtandao wa mahusiano.
Chanzo cha data: Soko la papo hapo la sarafu-fiche la Binance.
Ulimwengu wa mali: Mali 20 za sarafu-fiche zilizobainishwa kwa mtaji wa soko.
Sarafu ya kunukuu bei: USDT.
Kipindi cha data: Aprili 2024 – Aprili 2025.
Masafa ya sampuli: Saa 1.
Sifa za ingizo: Uwakilishi wa faida za kilogarithimu za bei za Open, High, Low, Close.
Urefu wa dirisha: L = 30 hatua za muda.
Modeli: Sequence-to-Sequence LSTM Autoencoder.
Encoder: Tabaka mbili za LSTM zenye kipimo fiche cha 256 na tabaka mnene lenye uanzishaji wa ReLU linalozalisha uwakilishi fiche wenye vipimo 64.
Decoder: Projection ya vekta fiche, kurudiwa kwake kwa urefu wa mfuatano, tabaka mbili za LSTM na tabaka la kutoka la mstari linalosambazwa kwa muda.
Mazingira ya mafunzo: TensorFlow/Keras.
Uboreshaji: Adam.
Kazi ya upotevu: Mean Squared Reconstruction Error.
Mini-batch: 64.
Epoch: 20.
Uwakilishi fiche katika kiwango cha mali: Wastani wa uwakilishi wa madirisha ya kila mali.
Mbinu ya ufanano: Cosine Similarity.
Kizingiti: 0,90.
Muundo wa mtandao: Grafu ya ufanano yenye uzani na isiyo na mwelekeo.
Mahusiano tarajiwa yaliyogunduliwa: Kingo 64.
Utambuzi wa kitakwimu: Engle–Granger Cointegration Test.
Kiwango cha uhakika cha jaribio: 0,95.
Yanayokidhi kigezo cha cointegration: Jozi 16.
Mipaka ya tafsiri: Jaribio la cointegration si lengo la mafunzo ya utafiti, lebo ya mwisho ya usahihi au kipimo cha ufanisi wa uwekezaji. Ni tathmini ya utambuzi wa ekonometri iliyotumika baadaye pekee.
Kielelezo 1: Kinaonyesha matriksi ya ufanano wa kosaini kati ya uwakilishi fiche uliounganishwa wa mali 20.
Kielelezo 2: Kinaonyesha mtandao wa ufanano fiche ulioundwa kwa kizingiti cha 0,90. Mtandao una vijenzi vilivyounganishwa tofauti, vikundi vidogo vyenye msongamano na jozi zilizotenganishwa.
Uundaji upya wa vielelezo: Kwa kuwa matriksi ghafi ya 20×20 na uzani wote wa kingo 64 havijachapishwa katika chanzo, hakuna uundaji upya wa kubuni wa matokeo halisi uliofanywa. Verianla imeonyesha mahusiano ya hatua za mbinu na matokeo ya namba yaliyoripotiwa kwa michoro huru ya SVG.
Tathmini ya uthabiti: Itifaki ya mbinu imetolewa kwa kuunda upya mtandao katika vitalu vya muda, ufanano wa kingo wa Jaccard na unyeti wa kizingiti. Hakuna jedwali la kina la matokeo lililochapishwa kwa ukaguzi huu.
Ulinganisho wa mbinu mbadala: Chanzo hakikufanya ulinganisho wa moja kwa moja wa namba wa ufanisi na mifumo mingine ya ugunduzi kwa data zilezile.
Ufanisi wa utabiri na uwekezaji: Utafiti haukupima utabiri wa bei, uboreshaji wa uwekezaji, utekelezaji wa biashara au faida ya mkakati.
Upatikanaji wa data: Chanzo cha data na mbinu kuu ya uchakataji wa awali zimeelezwa. Hata hivyo, PDF haitaji kifurushi tofauti rasmi cha data kinachojumuisha data ghafi zote, historia ya uteuzi wa mali, vekta fiche na matriksi kamili ya ufanano.
Upatikanaji wa msimbo: PDF ya chanzo haina kiungo kinachoweza kuthibitishwa cha hazina ya msimbo wazi kinachotoa msimbo wote wa mafunzo na uundaji wa mtandao.
Ufadhili: Hakuna tamko tofauti la ufadhili lililotambuliwa katika PDF.
Mgongano wa maslahi: Hakuna tamko tofauti la mgongano wa maslahi lililotambuliwa katika PDF.
CRediT/mchango wa mwandishi: Hakuna matriksi tofauti ya kina ya michango katika utafiti wa mwandishi mmoja.
Uhusiano na utafiti wa awali: Mwandishi anaeleza kwamba baadhi ya vipengele vya mbinu vilitengenezwa kutoka mfumo mpana zaidi wa utafiti unaomilikiwa, na katika makala ya sasa vipengele vya maamuzi na uboreshaji maalumu wa nyanja vimeondolewa ili kuchunguza tabaka huru la ugunduzi.
Muktadha wa Uturuki: Utafiti hautoi jaribio tofauti kwa mali za kifedha, viwanda au mikusanyiko ya data za kibaolojia nchini Uturuki. Maeneo ya matumizi ya ndani yanahitaji uthibitishaji zaidi wa kisayansi.
Mipaka ya hitimisho la kisayansi: Mbinu iliunda mtandao uliopangwa wa ufanano tarajiwa kati ya mali 20 za sarafu-fiche kwa kutumia ujifunzaji usiosimamiwa wa uwakilishi fiche. Hata hivyo, mtandao si uthibitisho wa hakika wa mahusiano halisi ya kisababishi, mabadiliko ya bei za baadaye au ufanisi wa maamuzi uliothibitishwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *