


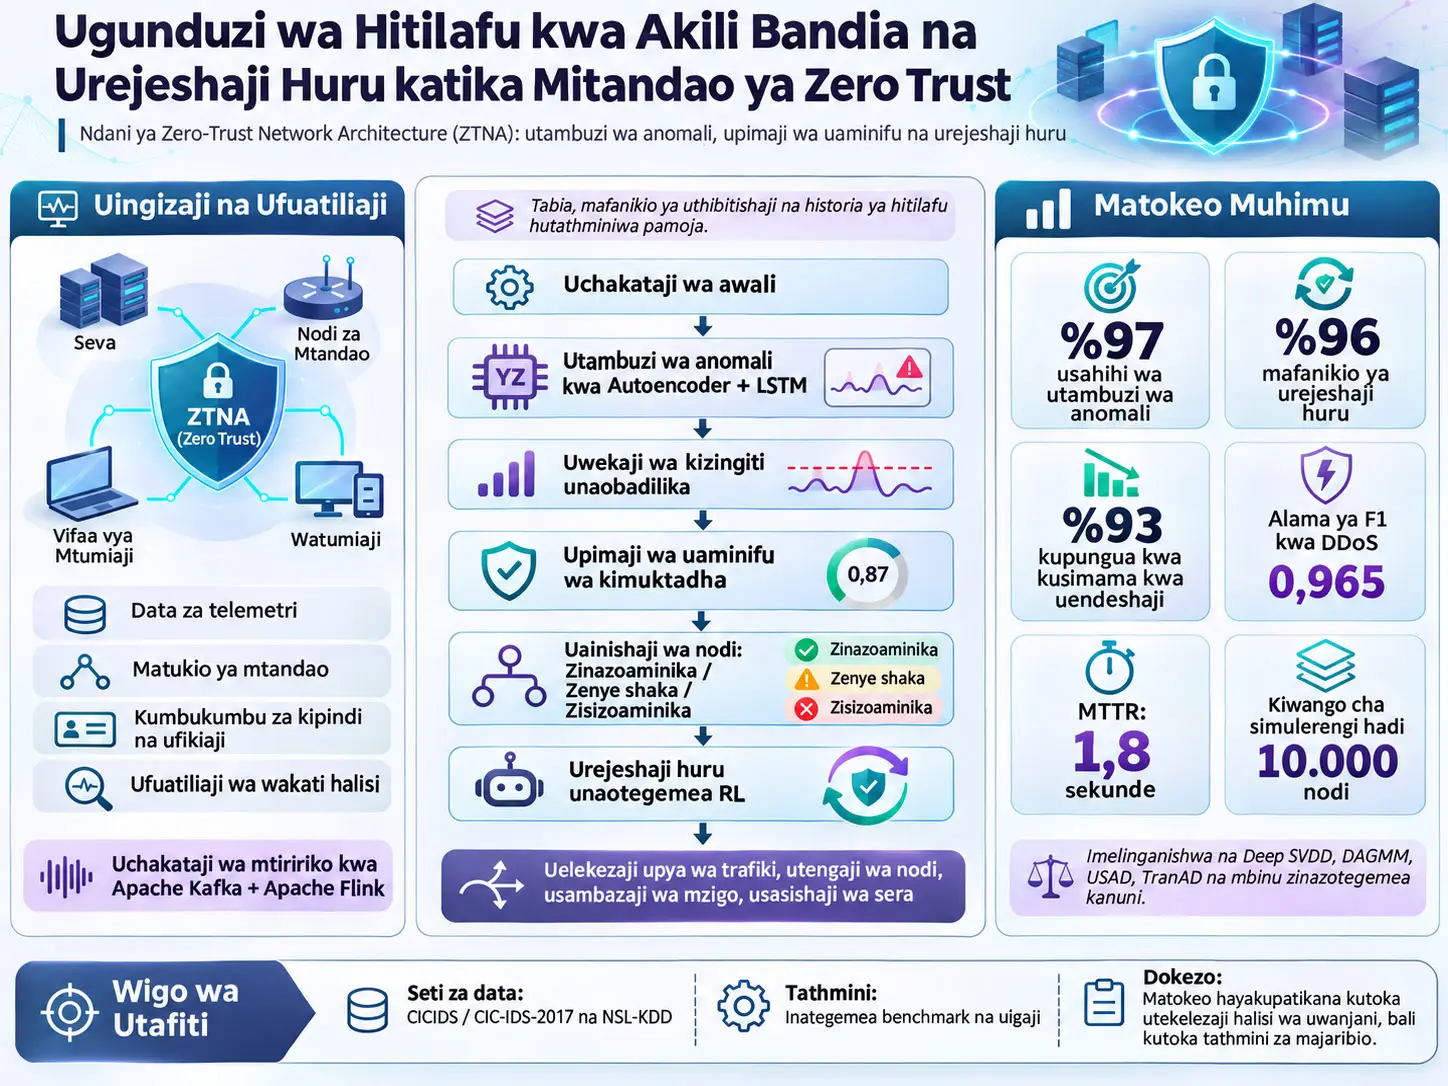
Mfumo uliopendekezwa wa Autoencoder-LSTM-RL-Trust ni usanifu jumuishi wa ugunduzi wa hitilafu na urejeshaji huru unaotegemea akili bandia, unaolenga kutambua anomali kutoka telemetri ya mtandao katika Usanifu wa Mtandao wa Zero Trust (Zero-Trust Network Architecture, ZTNA), kukokotoa kwa njia inayobadilika uaminifu wa kimuktadha wa nodi, na kurekebisha shughuli za urejeshaji kupitia nodi zinazoaminika kwa kutumia reinforcement learning. Mfumo huo unaunganisha uchanganuzi wa anomali unaotegemea Autoencoder na Long Short-Term Memory (LSTM), mekanizimu ya attention, uwekaji wa kizingiti unaobadilika, trust scoring inayotegemea tabia na fault-history, recovery orchestration inayotegemea reinforcement learning (RL), pamoja na dhana za telemetri ya mtiririko kupitia Apache Kafka na Apache Flink.
Katika utafiti chanzo, mfumo ulitathminiwa kwa kutumia data za benchmark za CICIDS/CIC-IDS-2017 na NSL-KDD, madarasa ya mashambulizi ya DDoS, Unauthorized Access na Data Exfiltration, pamoja na masimulizi ya mtandao kwa viwango tofauti. Matokeo ya jumla katika kiwango cha mfumo yamewasilishwa kama %97 anomaly-detection accuracy, %96 autonomous-recovery success na %93 downtime reduction. Kwa DDoS, F1-score 0,965 iliripotiwa; katika sehemu ya hitimisho DDoS Mean Time to Detect (MTTD) ilitajwa kuwa 1,6 s na Mean Time to Repair (MTTR) 1,8 s.
Thamani hizi si utendaji wa muda mrefu katika mazingira halisi ya mtandao wa shirika wa Zero-Trust. Waandishi wanaeleza wazi kwamba uthibitishaji wa sasa unatokana na benchmark na ni simulation-based, kwamba sehemu ya federated learning bado haijajaribiwa kwa majaribio chini ya deployment iliyosambazwa kwa kiwango kikubwa, na kwamba uthibitishaji katika mazingira ya live software-defined Zero-Trust telemetry utahitajika siku zijazo.
Majedwali tofauti ndani ya chanzo hayatumii kila mara thamani ileile ya namba kwa dhana zilezile. Kwa mfano, jedwali la ulinganisho la CICIDS linatoa accuracy 0,961 kwa proposed Autoencoder-LSTM, ilhali maandishi ya Discussion 5.1 yanaandika 0,950. Katika majedwali tofauti ya majaribio yanayohusu recovery, 2,3 s recovery latency, 1,8 s MTTR na 90 ms recovery time zimeripotiwa kando. Kwa hiyo Verianla haiunganishi thamani hizi kana kwamba ni namba moja.
Usanifu wa Mtandao wa Zero Trust Unamaanisha Nini Katika Utafiti Huu?
Usanifu wa Mtandao wa Zero Trust (Zero-Trust Network Architecture, ZTNA) ni mkabala wa usalama unaotathmini ufikiaji kwa uthibitishaji endelevu, muktadha, uthibitishaji wa utambulisho na udhibiti wa kina wa sera badala ya kumpa mtumiaji, kifaa au eneo la mtandao uaminifu wa kudumu na wa kudhaniwa; utafiti huu unalenga kuongeza katika ZTNA ugunduzi wa anomali, trust scoring inayobadilika na kazi za autonomous recovery ndani ya mzunguko mmoja uliofungwa.
Tatizo la utafiti
Hoja ya kuanzia ya utafiti chanzo ni kwamba mifumo mingi ya jadi ya usalama wa mtandao hutegemea vizingiti tuli, dhana za trust zilizofafanuliwa mapema au taratibu za recovery zinazohitaji kuingilia kati kwa binadamu. Katika mazingira yanayobadilika ya Zero-Trust, tabia za nodi, topolojia ya mtandao na aina za mashambulizi zinaweza kubadilika kadiri muda unavyopita; kwa hiyo sheria zisizobadilika zinaweza kuzalisha false positive na pia kuchelewa kuitikia mifumo mipya ya mashambulizi.
Watafiti wanalenga kuunganisha kazi tatu ndani ya mzunguko mmoja wa maamuzi:
- Kutambua mikengeuko kutoka kwa tabia ya kawaida kwa kutumia deep learning.
- Kusasisha daima uaminifu wa kila nodi kwa kuzingatia tabia na historia ya fault.
- Fault au attack inapogunduliwa, kupanga upya kiotomatiki muundo wa majukumu, trafiki, sera na huduma wa mtandao kupitia nodi zinazoaminika.
Michango mikuu ya utafiti
Chanzo kinafafanua michango mitano mikuu. Kwanza ni mbinu ya dual-model anomaly detection inayotumia Autoencoder pamoja na LSTM. Pili ni context-aware trust scoring inayotumia muktadha wa anomali unaotegemea Mahalanobis pamoja na vipimo vya kitabia kama node responsiveness, authentication frequency na fault history. Tatu ni autonomous recovery orchestration inayotegemea RL. Nne ni kuingizwa kwa federated learning katika usanifu kwa ajili ya privacy-preserving distributed adaptation. Tano ni tathmini za benchmark na masimulizi.
Hata hivyo, hali ya majaribio ya moduli ya federated learning ni tofauti na ya vipengele vingine. Chanzo kinaeleza wazi kwamba preliminary experiments kuu zililenga muundo wa kati wa hybrid Autoencoder-LSTM-RL; sehemu ya federated-learning katika utafiti huu ipo zaidi kama reference architecture kuliko kama jaribio lililosambazwa kwa kiwango kikubwa.
Ugunduzi wa Anomali wa Autoencoder-LSTM Unafanyaje Kazi?
Mlolongo uliopendekezwa wa ugunduzi wa anomali huchakata telemetri ya vipimo vingi kwa kuanza na ucentrishaji, upunguzaji wa vipimo na unormalishaji; Autoencoder inapojifunza kujenga upya tabia ya kawaida, LSTM huunda modeli ya utegemezi wa muda, reconstruction error na alama za kimuktadha hulinganishwa na kizingiti, na sampuli zisizo za kawaida hubadilishwa kuwa fault vector na kupelekwa kwa moduli za trust na recovery.
Upataji wa data na uhandisi wa vipengele
Chanzo kinafafanua Apache Kafka na Apache Flink kama vipengele vya data-ingestion vya usanifu kwa ajili ya mtiririko wa telemetri wa wakati halisi. Ingizo zinazoweza kutumiwa ni pamoja na event logs, matukio ya failed-login, miito ya API, user interaction patterns na telemetri ya mtandao.
Feature engineering imeundwa kutumia viwango vitatu vya temporal granularity: short-term, mid-term na long-term. Lengo ni kuwezesha LSTM kujifunza si tu mikengeuko inayotokea kwa wakati mmoja, bali pia mifumo ya tabia inayokua kadiri muda unavyopita.
Feature vector inaweza pia kutajirishwa kwa taarifa za nje za threat-intelligence. Mifano iliyotolewa na chanzo ni blacklisted IP addresses na taarifa kuhusu software vulnerability zinazojulikana. Kazi ya muktadha huu wa nje ni kuupa modeli muktadha wa ziada pale ambapo tabia ileile ghafi ya mtandao inaweza kuwa na maana tofauti kwa upande wa usalama.
Kazi ya Autoencoder
Autoencoder hujifunza uwakilishi uliobanwa zaidi wa tabia ya kawaida ya mtandao na hujaribu kujenga upya feature vector ya ingizo. Kwa kuwa sampuli za kawaida huwa karibu na mgawanyo wa mafunzo, reconstruction error inatarajiwa kuwa ndogo kwa kulinganisha. Tukio la mtandao lililopotoka kutoka kwa muundo wa kawaida linaweza kujengwa upya vibaya zaidi na modeli, hivyo reconstruction error inaweza kuongezeka.
Kazi ya LSTM
Mtandao wa Long Short-Term Memory hutumiwa kuunda modeli ya utegemezi wa muda katika telemetri inayofuatana. Anomali inaweza isiwe thamani moja tu ya juu au ya chini; kwa mfano, mfululizo wa matukio kama kuongezeka kwa latency kufuatiwa na kupungua kwa mafanikio ya authentication unaweza kupata maana unapochunguzwa kwa pamoja.
Attention-enhanced LSTM
Chanzo kinapendekeza matumizi ya tabaka za attention baada ya matokeo ya LSTM. Kazi inayokusudiwa ya mekanizimu ya attention hapa ni kutoa uzito mkubwa kwa hatua za muda ambazo zinaweza kuwa muhimu zaidi katika kueleza tabia ya anomaly.
Ensemble autoencoder
Inaelezwa kwamba badala ya Autoencoder moja kubwa, shallow autoencoder kadhaa zinaweza kutumiwa kwenye feature subsets tofauti. Lengo ni kupunguza hatari ya kufit kupita kiasi kwenye makundi ya noisy au redundant feature na kuongeza uwezo wa generalization.
Dynamic thresholding
Badala ya anomaly threshold isiyobadilika, matumizi ya quantile-based au statistically adaptive threshold yanapendekezwa. Kwa njia hii, tabia ya kawaida ya mtandao inapobadilika kadiri muda unavyopita, threshold pia inakusudiwa kuendana na concept drift.
Kikomo cha chanzo kuhusu Mahalanobis distance
Chanzo katika Section 3.2 kinasema anomaly score huhesabiwa kwa kutumia Mahalanobis distance na kwamba ingizo hutathminiwa dhidi ya muundo wa mean/covariance wa mgawanyo wa mafunzo. Hata hivyo, katika picha ya ukurasa ya PDF iliyochapishwa, baada ya sentensi “Mathematically, the anomaly score is computed using Mahalanobis distance:” hakuna mlinganyo unaoonekana. Verianla haikamilishi fomula hii inayokosekana kwa kujitegemea kwa kutumia mlinganyo wa kawaida wa Mahalanobis.
Mlinganyo 1–8: Ucentrishaji, covariance na upunguzaji wa vipimo
\[ \mu_i=\frac{1}{N}\sum_{j=1}^{N}x_{j,i}, \qquad i\in\{1,\ldots,d\} \tag{1} \]
Mlinganyo 1 hukokotoa wastani wa sampuli kwa kila feature. \(N\) ni idadi ya sampuli, \(d\) ni idadi ya feature, na \(x_{j,i}\) katika sampuli ya \(j\). ni thamani ya feature ya \(i\).
\[ \bar{x}_{j,i}=x_{j,i}-\mu_i, \qquad X=[\bar{x}_{j,i}] \tag{2} \]
Mlinganyo 2 ni mchakato wa mean-centering. Kila feature huwakilishwa kwa umbali wake kutoka kwenye wastani wake.
\[ S=\frac{1}{N-1}\sum_{j=1}^{N} \left(\bar{x}_{j}\bar{x}_{j}^{T}\right) \tag{3} \]
Mlinganyo 3 huunda covariance matrix kutoka kwa sampuli zilizocentrishwa. Covariance matrix huwakilisha jinsi feature zinavyobadilika kwa pamoja.
\[ X=U\Sigma V^{T}, \qquad V_k=V[:,1:k] \tag{4} \]
Chanzo kinatoa hatua hii chini ya kichwa cha PCA na hutumia uwasilishaji wa SVD katika umbo la matrix decomposition. \(V_k\) inawakilisha principal direction za kwanza \(k\).
\[ Fr_j=\sum_{i=1}^{k}x_{j,i}v_i \tag{5} \]
\[ Fr=[Fr_1,\ldots,Fr_N] \tag{6} \]
Mlinganyo 5–6 huonyesha kila sampuli kwenye principal direction zilizochaguliwa na kuunda reduced feature matrix.
\[ z_{j,i}= \frac{x_{j,i}-\mu_i} {\sqrt{\frac{1}{N}\sum_{k=1}^{N}(x_{k,i}-\mu_i)^2}} \tag{7} \]
\[ Z=[z_{j,i}], \qquad i\in\{1,\ldots,k\} \tag{8} \]
Mlinganyo 7–8 hu-scale thamani za principal component na kuunda matriki ya normalization \(Z\). Chanzo hakibainishi kitengo cha kifizikia; thamani baada ya unormalishaji ni thamani za feature zilizowekwa kwenye skeli.
Mlinganyo 9–17: LSTM, reconstruction error na anomaly score
\[ h_t=LSTM(x_t,h_{t-1}), \qquad x_t\in Z \tag{9} \]
\[ c_t=\sigma_f\odot c_{t-1}+\sigma_i\odot\tilde{c}_t \tag{10} \]
Mlinganyo 9–10 huonyesha jinsi mfululizo wa muda unavyobebwa ndani ya LSTM hidden state na cell-state. \(\odot\) ni uzidishaji wa kipengele kwa kipengele.
\[ \hat{x}_t=Decoder(h_t) \tag{11} \]
\[ E_t=\sum_{i=1}^{d}(x_{t,i}-\hat{x}_{t,i})^2 \tag{12} \]
\[ E_{total}=\sum_{t=1}^{T}E_t \tag{13} \]
Mlinganyo 11–13 hufafanua Autoencoder decoder kuzalisha reconstructed input na tofauti yake na ingizo halisi kukokotolewa kama squared reconstruction error.
\[ \mu_E=\frac{1}{T}\sum_{t=1}^{T}E_t \tag{14} \]
\[ \sigma_E= \sqrt{\frac{1}{T}\sum_{t=1}^{T}(E_t-\mu_E)^2} \tag{15} \]
\[ A_t=\frac{E_t-\mu_E}{\sigma_E} \tag{16} \]
Mlinganyo 14–16 hunormalisha reconstruction error kulingana na wastani wake na standard deviation. \(A_t\) ni standardize anomaly score katika muda \(t\).
\[ A_{i,t}= \sum_{j=1}^{w} \left( \frac{e_{i,t-j}}{\sigma_i} \right)^2 \alpha_j \tag{17} \]
Mlinganyo 17 ni usemi wa smoothed anomaly score unaounganisha kwa uzani vipengele vya error katika dirisha la nyuma la \(w\). \(\alpha_j\) hutumiwa katika chanzo kama mgawo wa uzani.
Mlinganyo 18–23: Feature correlation, ranking na uainishaji wa Softmax
\[ Cov(f_i,f_j)= \frac{1}{N}\sum_{t=1}^{N} (f_{t,i}-\mu_i)(f_{t,j}-\mu_j) \tag{18} \]
\[ C_{i,j}= \frac{\sum_{t=1}^{N}(f_{t,i}-\mu_i)(f_{t,j}-\mu_j)} {\sqrt{\sum_{t=1}^{N}(f_{t,i}-\mu_i)^2} \sqrt{\sum_{t=1}^{N}(f_{t,j}-\mu_j)^2}} \tag{19} \]
Mlinganyo 18 hukokotoa covariance, na Mlinganyo 19 hukokotoa muundo wa correlation.
\[ S_i=\sum_{j=1}^{d}|C_{i,j}| \tag{20} \]
\[ Rank(f_i)=sort(S_i) \tag{21} \]
Feature contribution hupangwa kulingana na jumla ya absolute correlation na feature nyingine.
\[ z_c=\sum_{i=1}^{k}w_{c,i}x_i+b_c \tag{22} \]
\[ P(y=c\mid x)= \frac{e^{z_c}} {\sum_{j=1}^{C}e^{z_j}} \tag{23} \]
Mlinganyo 22 hukokotoa logit ya darasa, na Mlinganyo 23 hukokotoa uwezekano wa Softmax. Matokeo ya Softmax huzalisha uwezekano wa madarasa ambao jumla yake ni 1.
Mlinganyo 24–28: Loss, backpropagation na Adam
\[ L= \sum_{t=1}^{T}\sum_{i=1}^{d} (x_{t,i}-\hat{x}_{t,i})^2 \tag{24} \]
\[ \frac{\partial L}{\partial w} = \sum_{t=1}^{T} \frac{\partial L}{\partial h_t} \frac{\partial h_t}{\partial w} \tag{25} \]
\[ \Delta w= -\eta \sum_{t=1}^{T}\nabla_w L \tag{26} \]
Mlinganyo 24 unaonyesha reconstruction loss, na Mlinganyo 25–26 unaonyesha mlolongo wa weight update unaotegemea gradient. \(\eta\) ni learning rate.
\[ m_t=\beta_1m_{t-1}+(1-\beta_1)\nabla_t \tag{27} \]
\[ v_t=\beta_2v_{t-1}+(1-\beta_2)\nabla_t^2 \tag{28} \]
Mlinganyo 27–28 huwakilisha makadirio ya moment ya kwanza na ya pili ya Adam optimizer. Chanzo kinatoa milinganyo hii lakini hakitoi kwa jedwali wazi la hyperparameter thamani za namba za \(\beta_1\), \(\beta_2\) na learning-rate zilizotumika ndani ya PDF.
Mlinganyo 29–35: Logging, fault vector na recovery trigger
\[ Log(t)=\sum_{i=1}^{k}x_{t,i}\delta_i \tag{29} \]
\[ \delta_i=\mathbf{1}\{A_t>\theta_A\} \tag{30} \]
\[ F_t=\{x_t\mid A_t>\theta_A\} \tag{31} \]
\[ ID= \sum_{i=1}^{k} hash(x_{t,i},t+i) \tag{32} \]
\[ S_t= \frac{A_t} {\sum_{i=1}^{T}A_i} \tag{33} \]
\[ R_t=\mathbf{1}\{S_t>\tau\}, \qquad Log(t)=\{x_t,A_t,S_t,R_t\} \tag{34} \]
\[ U_t=\sum_{j=1}^{M}\omega_j\psi_j(t) \tag{35} \]
Mlinganyo 29–35 ni mlolongo wa chanzo unaotumiwa kurekodi anomaly, kuingiza feature vector zinazozidi threshold katika fault vector, kukokotoa severity score na kuzalisha recovery trigger. \(\theta_A\) ni anomaly threshold, \(\tau\) ni recovery decision threshold, na \(\omega_j\) ni migawo ya uzani.
Alama ya Uaminifu Inayozingatia Muktadha Hukokotolewaje?
Moduli ya context-aware trust scoring huunganisha fault vector inayotoka kwa anomaly detector na response reliability, authentication success, fault history na inactivity ya kila nodi ili kusasisha thamani ya trust kila wakati; thamani hunormalishwa, mikengeuko kutoka wastani wa kimataifa hukokotolewa, na nodi huainishwa kama trusted, suspicious au untrusted.
Mlinganyo wa trust-update usioonekana katika chanzo
Section 3.3 inasema trust score husasishwa kwa mlinganyo wa time-decaying wenye tunable weight kwa previous trust, response reliability na fault history. Hata hivyo, katika picha ya PDF iliyochapishwa, mlinganyo huu hauonekani baada ya sentensi “the score is updated as:”. Kwa hiyo Verianla haikamilishi mlinganyo unaokosekana kwa kutumia fomula ya jumla ya trust-score.
Mlinganyo 36–45: Fault vector na ishara za tabia
\[ F_t=\{x_t\mid A_t>\theta_A\} \tag{36} \]
\[ N_f= \sum_{i=1}^{N} \mathbf{1}\{A_i(t)>\theta_A\}\,n_i \tag{37} \]
\[ T_i(0)= \frac{1}{K} \sum_{k=1}^{K}T^{init}_{i,k} \tag{38} \]
\[ R_i(0)= \sum_{j=1}^{M}\rho^{(0)}_{i,j} \tag{39} \]
\[ F_i(0)= \sum_{j=1}^{M}\phi^{(0)}_{i,j} \tag{40} \]
\[ \Delta S_i(t)= \sum_{j=1}^{T} \left( \gamma_1R_i(j)+ \gamma_2A_i(j)- \gamma_3F_i(j) \right) \tag{41} \]
Katika Mlinganyo 41, michango ya response na authentication huingia kwa uzani chanya kuelekea trust, huku historia ya fault ikiingia kwa uzani hasi katika alama ya tabia. \(\gamma_1,\gamma_2,\gamma_3\) ni tunable weight.
\[ R_i(t+1)= \sum_{j=1}^{t}\delta_{r_i,j} + R_i(0) \tag{42} \]
\[ A_i(t+1)= \sum_{j=1}^{t}\delta_{a_i,j} + A_i(0) \tag{43} \]
\[ F_i(t+1)= \sum_{j=1}^{t}\delta_{f_i,j} + F_i(0) \tag{44} \]
\[ \Delta S_i(t+1)= \sum_{j=1}^{t+1} \left( \gamma_1R_i(j)+ \gamma_2A_i(j)- \gamma_3F_i(j) \right) \tag{45} \]
Milinganyo hii hukusanya matukio ya response, authentication na fault kwa muda ili kuunda rolling behavior score.
Mlinganyo 46–57: Usasishaji wa trust, decay na node classification
\[ T_i(t+1)= \frac{1}{t+1} \sum_{j=0}^{t} \left( \alpha T_i(j)+ \beta\Delta S_i(j) \right) \tag{46} \]
\[ T_i^{cumulative} = \sum_{j=1}^{t+1}T_i(j) \tag{47} \]
\[ D_i(t)= \sum_{j=1}^{t} T_i(j)e^{-\lambda j} \tag{48} \]
Mlinganyo 48 hupunguza taarifa ya trust iliyo inactive au ya zamani kwa kutumia exponential decay. \(\lambda\) ni decay factor.
\[ T_i^{norm}= \frac{T_i(t)} {\sum_{j=1}^{m}T_j(t)} \tag{49} \]
\[ \bar{T}(t)= \frac{1}{m} \sum_{j=1}^{m}T_j(t) \tag{50} \]
\[ \Delta T_i= |T_i(t)-\bar{T}(t)| \tag{51} \]
Mlinganyo 49–51 hunormalisha thamani ya node trust ya kila nodi kulingana na mtandao mzima na kukokotoa mkengeuko kutoka global trust average.
\[ Trusted_i= \sum_{j=1}^{m} \mathbf{1}\{T_j^{nr}>\tau\}\delta_{ij} \tag{52} \]
\[ Untrusted_i= \sum_{j=1}^{m} \mathbf{1}\{T_j^{nr}<\tau\}\delta_{ij} \tag{53} \]
\[ Suspicious_i= \sum_{j=1}^{m} \mathbf{1}\{\Delta T_j>\epsilon\}\delta_{ij} \tag{54} \]
Chanzo kinatumia notation \(T^{norm}\) katika Mlinganyo 49, lakini \(T^{nr}\) katika milinganyo ya uainishaji. Verianla haibadilishi kimyakimya maumbo haya mawili kuwa ishara moja katika chanzo; ingawa muktadha unaashiria kwamba yote yanawakilisha thamani ya trust iliyokwishanormalishwa, notation ya chanzo haiko thabiti kikamilifu.
\[ T_{goa}(t)= \sum_{i=1}^{m} T_i(t)\delta_i^{(active)} \tag{55} \]
\[ S_{flagged}= \sum_{i=1}^{m} \mathbf{1}\{T_i^{nr}<\tau\}n_i \tag{56} \]
\[ TrustedList_t= \sum_{i=1}^{m} \mathbf{1}\{T_i^{nr}>\tau\}n_i \tag{57} \]
Hatua hii ya mwisho inalenga kupeleka kwenye moduli ya recovery nodi zilizothibitishwa tu ambazo zimevuka threshold.
Urejeshaji Huru na Reinforcement Learning Hufanya Nini Katika Usanifu Huu?
Moduli ya autonomous recovery huchagua miongoni mwa nodi zilizothibitishwa na moduli ya trust zile zenye ulinganifu mkubwa wa rasilimali na jukumu; hufanya shughuli kama kuelekeza upya trafiki, kutenga nodi, kugawa upya majukumu, load redistribution, policy update na service redeployment, na matokeo yakishindwa, hurekebisha upya sera ya recovery kwa feedback ya reinforcement learning.
Muundo wa state, action na reward wa RL agent
State hujumuisha fault context ya sasa na taarifa ya network topology. Action ni dynamic role assignment na shughuli za containment/reconfiguration. Reward ni tathmini ya composite inayounganisha matokeo kama downtime reduction, trust preservation na policy compliance.
Mlinganyo 58–66: Uteuzi wa node inayoaminika na compatibility
\[ T^{*}= \left\{ n_i\mid T_i^{*}= \frac{T_i}{\max(T)} > \tau_{trust} \right\} \tag{58} \]
\[ M^{trust}= \sum_{i\in T^{*}} T_i^{*}\omega_i \tag{59} \]
\[ R_i= \sum_{j=1}^{m} \kappa_{ij}\theta_j \tag{60} \]
\[ R_i^{nr}= \frac{R_i}{\max(R)} \tag{61} \]
\[ S_i= R_i^{nr} \left( 1+ \frac{1}{T} \sum_{t=1}^{T}\phi_{i,t} \right) \tag{62} \]
Katika mlolongo huu, \(R_i\) inawakilisha alama ya aina ya node recovery capability/role fitness, na \(\phi_{i,t}\) inawakilisha recent cooperative au participative metric.
\[ \Delta_i= \sqrt{ \sum_{j=1}^{m} (d_j-\kappa_{ij})^2 } \tag{63} \]
\[ \Gamma_i= \frac{S_i}{1+\Delta_i} \tag{64} \]
\[ R_{sre}=sort_{desc}(\Gamma_i) \tag{65} \]
\[ R_{top}= \{n_i\in R_{sre}\mid i=1,\ldots,k\} \tag{66} \]
Mlinganyo 63–66 hupima tofauti kati ya node capability na recovery requirement, huunda compatibility score na kuchagua node \(k\) zenye alama ya juu zaidi kwa ajili ya recovery.
Mlinganyo 67–73: Uzani wa jukumu, topology, load na recovery effectiveness
\[ Total= \sum_{j=1}^{k} \left(T'_j+R_j\right) \tag{67} \]
\[ \alpha'_i= \alpha_i \left( 1+ \frac{s_1+s_2+\cdots+s_T}{T} \right) \tag{68} \]
Chanzo kinafafanua \(s_T\) katika muktadha wa system strain/load katika wakati \(t\).
\[ P_{ij}= \sum_{l\in Path(i,j)} \left( \frac{b_l}{1+\lambda_l} \right) T_l \tag{69} \]
Mlinganyo 69 hupanga upya uzani wa communication path kwa kuzingatia uhusiano wa bandwidth, latency na trust.
\[ L_i= \alpha'_iL_{total} \tag{70} \]
\[ Policy_{new}= Policy_{old}+ \sum_{i=1}^{k}\alpha'_i \tag{71} \]
\[ \psi_t= \sum_{i=1}^{k} \left( \lambda_i^{(t)}- \delta_i^{(t)} \right)\omega_i \tag{72} \]
\[ E_{rec}= \frac{\psi_t} {\psi_t+ \sum_{i=1}^{k}\delta_i^{(t)}} \tag{73} \]
Mlinganyo 72–73 hufafanua improvement baada ya recovery na uwiano wa recovery effectiveness. Kwa kuwa chanzo kinaweza kutumia ishara \(\lambda\) kwa maana tofauti katika sehemu tofauti, majina ya alama lazima yasomwe kulingana na muktadha.
Mlinganyo 74–77: Q-learning, policy refinement na uthabiti
\[ Q(s,a)= Q(s,a)+ \alpha \left[ r+ \gamma \max_{a'} Q(s',a') - Q(s,a) \right] \tag{74} \]
Mlinganyo 74 hutumia mantiki ya kawaida ya temporal-difference Q-learning update katika recovery policy tuning. \(\alpha\) ni learning rate, na \(\gamma\) ni discount factor ya reward ya baadaye.
\[ \theta_{t+1}= \theta_t- \eta\nabla_{\theta}L(\theta_t) \tag{75} \]
\[ Stable \Longleftrightarrow \frac{1}{T} \sum_{t=1}^{T} |\delta_t| < \epsilon \tag{76} \]
\[ N_{sal}= \{n_i\mid L_i<\delta_{max} \land E_{rec}>\tau \} \tag{77} \]
Mlinganyo 75 unaonyesha strategy parameter update, Mlinganyo 76 stability criterion, na Mlinganyo 77 final resilient node set inayokidhi masharti ya load na recovery effectiveness. Orodha ya notation ya chanzo pia ina jina tofauti “\(N_{resilient}\)” kwa final set; Verianla haisahihishi kimyakimya tofauti hii ya notation.
Ugumu wa kinadharia wa ukokotoaji
| Kipengele | Ugumu wa chanzo | Jukumu la kisayansi |
|---|---|---|
| PCA / SVD | O(n log n) | Dimensionality reduction kwa telemetry yenye vipimo vingi |
| Shallow Autoencoder | O(n · d) | Compact representation na reconstruction-error anomaly detection |
| Maelezo ya Autoencoder training | O(n · d · e) | Gharama ya mafunzo yenye n sampuli, d feature na e epoch |
| LSTM | O(T · H²) | Uundaji wa modeli ya temporal dependency |
| Attention | O(T² · d) | Mahusiano ya attention kati ya hatua za muda |
| GNN | O(E · d²) | Trust propagation / topology-aware evaluation |
| Energy-Based Model | O(n · d²) | Energy-function anomaly scoring |
| Mahalanobis distance | O(d²) | Covariance-aware anomaly deviation |
| Dynamic thresholding | O(n) | Quantile au statistical adaptive threshold |
| RL / Policy Gradient | O(n · A · T) | Recovery-policy optimization |
| Trust score computation | O(n) | Kusasisha thamani za trust za nodi |
| Trust-aware graph traversal | O(V + E) | Traversal katika nodi na miunganisho ya mtandao |
| Kafka / Flink streaming ingestion | O(m) / record | Telemetri ya mtiririko chini ya m concurrent stream |
Ugumu huu ni tathmini za kinadharia za waandishi wa chanzo. Runtime halisi haiwezi kuamuliwa kwa Big-O notation pekee; inategemea hali kama hardware, implementation, batch size, feature dimension, sequence length na concurrency.
Mbinu na Matokeo ya Utafiti
Seti za data na wigo wa tathmini
Utafiti hutumia seti za data za benchmark za CICIDS/CIC-IDS-2017 na NSL-KDD kama mifano ya intrusion-detection telemetry. Waandishi wanakubali wazi kwamba seti hizi za data haziwakilishi usanifu kamili wa production Zero-Trust wenye micro-segmentation, continuous authentication au dynamic policy enforcement.
Kwa hiyo matokeo yanayotolewa kutoka kwenye seti hizi za data si uthibitisho wa tabia nzima ya uendeshaji ya ZTNA. Seti za data zilitumika kuunda modeli za hali za usalama kama abnormal behavior, unauthorized access na distributed attack; vipengele vya trust scoring na recovery viliongezwa juu yake.
Maelezo yanayokosekana kwa upande wa reproducibility
Chanzo kinasema makala iliyorekebishwa ina maelezo kama learning rate, optimizer, batch size, idadi ya epoch, hidden-layer size na dynamic threshold. Hata hivyo, katika PDF iliyochapishwa hakuna jedwali wazi la hyperparameter linalotoa kwa pamoja thamani zao za namba. Vivyo hivyo, ingawa inasemekana training/validation/test split zimeelezwa kwa kina, asilimia kamili za split hazionekani wazi katika maandishi ya PDF.
Kwa hiyo Verianla haibuni learning rate, batch size, epoch au uwiano wa split.
Confusion matrix ya madarasa mengi
| Darasa halisi \ Utabiri | DDoS | Unauthorized Access | Data Exfiltration |
|---|---|---|---|
| DDoS | 34 | 31 | 30 |
| Unauthorized Access | 41 | 30 | 24 |
| Data Exfiltration | 48 | 26 | 21 |
Matriki hii inaonyesha kwamba attack-type separation ni ngumu. Kati ya matukio ya DDoS, 34 yaliainishwa kwa usahihi huku 61 yakienda katika madarasa mengine mawili. Kwa Unauthorized Access kuna uainishaji sahihi 30; kwa Data Exfiltration kuna uainishaji sahihi 21 tu.
Waandishi hasa wanaeleza kwamba overlap ya kitabia kati ya Data Exfiltration na DDoS hufanya mipaka ya madarasa isiwe wazi.
Je, Usahihi wa %97 wa Ugunduzi wa Anomali Ni Matokeo Yale Yale na Confusion Matrix ya Madarasa Mengi?
Hapana. Chanzo kinatenganisha wazi kwamba thamani ya jumla ya %97 system-level detection accuracy inatokana na aggregate anomaly-detection/recovery evaluation ya mfumo jumuishi wenye adaptive threshold, contextual trust scoring, temporal attention na RL-based recovery optimization; ilhali confusion matrix ya madarasa mengi katika Figure 14 ni tathmini yenye wigo mdogo zaidi na ya hatua ya awali kwa attack-type separation.
Tofauti hii ni muhimu. Kupuuza makosa mengi ya off-diagonal katika Figure 14 na kusema kwamba “modeli hutenganisha DDoS, Unauthorized Access na Data Exfiltration kwa usahihi wa %97” hakulingani na chanzo.
Attack-specific Mean Time to Detect
Maandishi ya chanzo yanaripoti detection time katika madarasa matatu ya mashambulizi kwa mifumo ya kawaida/baseline katika viwango vya 2,3 s, 2,7 s na 2,9 s; kwa mbinu iliyopendekezwa, Unauthorized Access 1,9 s, Data Exfiltration 2,0 s na DDoS 1,6 s.
Katika sehemu ya hitimisho, MTTD = 1,6 s inarudiwa hasa kwa DDoS.
Matokeo ya Attack-specific F1
Kwa modeli iliyopendekezwa, chanzo kinaripoti DDoS F1 = 0,965, Unauthorized Access F1 = 0,945 na Data Exfiltration F1 = 0,920.
Katika ulinganisho wa DDoS, Deep SVDD imetolewa kama 0,872 na TranAD kama 0,928. Katika ulinganisho wa Unauthorized Access, chanzo kinaeleza takriban safu ya 0,892–0,878 kwa USAD/DAGMM. Kwa Data Exfiltration, thamani ya USAD 0,865 imeelezwa wazi.
Ulinganisho wa jumla wa precision, recall na F1
| Modeli | Precision | Recall | F1 |
|---|---|---|---|
| Rule-Based | 0,842 | 0,810 | 0,825 |
| LSTM-Only | 0,912 | 0,897 | 0,904 |
| Autoencoder-LSTM | Maandishi ya chanzo yanaripoti utendaji wa takriban 0,944 | Maandishi ya chanzo yanaripoti utendaji wa takriban 0,944 | Maandishi ya chanzo yanaripoti utendaji wa takriban 0,944 |
| Proposed Method | 0,962 | 0,955 | 0,958 |
Ulinganisho wa ROC/AUC
Katika maelezo ya Figure 13, chanzo kinafafanua thamani za AUC za mbinu za classical detection kwa DDoS, Unauthorized Access na Data Exfiltration kuwa chini ya 0,51, yaani karibu na random discrimination.
Katika maandishi ya chanzo, thamani zifuatazo za AUC zimetolewa kwa modeli za hali ya juu za anomaly-detection: Deep SVDD = 0,740; DAGMM = 0,780; USAD = 0,760; TranAD = 0,810.
Accuracy, specificity na sensitivity
Katika maelezo ya Figure 22, chanzo kinaripoti Accuracy = 0,960, Specificity = 0,958 na Sensitivity = 0,959 kwa mbinu iliyopendekezwa.
Accuracy inaonyesha usahihi wa utabiri wote; specificity ni uwezo wa kukataa kwa usahihi sampuli normal/non-anomalous; sensitivity ni uwiano wa kugundua sampuli halisi za anomaly.
Ablation ya false-positive rate na recovery latency
| Usanidi | False Positive Rate | Recovery Latency (s) |
|---|---|---|
| Full model | 0,032 | 2,3 |
| No trust module | 0,071 | 2,3 |
| No RL policy | 0,046 | 4,1 |
| No feature fusion | 0,065 | 3,2 |
| Only Autoencoder | 0,058 | 3,5 |
Moduli ya trust inapoondolewa, false-positive rate huongezeka kutoka 0,032 hadi 0,071. RL policy inapoondolewa, recovery latency huongezeka kutoka 2,3 s hadi 4,1 s. Ablation hizi zinaonyesha kwamba moduli hizo mbili huchangia kazi tofauti: trust scoring hasa inahusishwa na udhibiti wa tahadhari za uongo, huku RL ikihusishwa na kasi ya recovery.
Component-wise ablation iliyopanuliwa
| Usanidi | FPR | Recovery Latency (s) | Precision | Recall |
|---|---|---|---|---|
| Full model | 0,032 | 2,300 | 0,946 | 0,943 |
| No trust module | 0,071 | 2,300 | 0,901 | 0,871 |
| No RL policy | 0,046 | 4,100 | 0,917 | 0,896 |
| No fault vector filtering | 0,059 | 3,800 | 0,910 | 0,882 |
| No behavior scoring | 0,064 | 3,500 | 0,905 | 0,879 |
| Only Autoencoder | 0,057 | 3,700 | 0,912 | 0,890 |
| No feature fusion | 0,065 | 3,200 | 0,906 | 0,884 |
Ulinganisho wa mbinu kwenye CICIDS
| Modeli | Accuracy | Precision | Recall | F1 | Training Time (min) | Memory (MB) |
|---|---|---|---|---|---|---|
| Proposed Autoencoder-LSTM | 0,961 | 0,950 | 0,939 | 0,944 | 18 | 420 |
| CNN-GRU | 0,942 | 0,932 | 0,922 | 0,927 | 22 | 460 |
| BiLSTM-Attn | 0,933 | 0,921 | 0,916 | 0,918 | 20 | 440 |
| GCN-LSTM | 0,926 | 0,914 | 0,908 | 0,911 | 25 | 470 |
| SAE-SVM | 0,912 | 0,900 | 0,888 | 0,893 | 15 | 350 |
| Random Forest | 0,892 | 0,878 | 0,865 | 0,871 | 14 | 300 |
| Isolation Forest | 0,861 | 0,851 | 0,840 | 0,845 | 12 | 250 |
| Transformer-IDS | 0,939 | 0,928 | 0,914 | 0,920 | 21 | 455 |
| Hybrid-VAE-GRU | 0,953 | 0,940 | 0,928 | 0,934 | 19 | 430 |
| AE-RL | 0,949 | 0,937 | 0,923 | 0,930 | 17 | 415 |
| Rule-Based | 0,845 | 0,838 | 0,812 | 0,825 | 6 | 160 |
Katika jedwali hili proposed Autoencoder-LSTM accuracy ni 0,961. Kwa upande mwingine, maandishi ya Discussion 5.1 yanaandika accuracy 0,950 na precision 0,951 katika tathmini hiyohiyo ya CICIDS. Verianla haibadilishi kimyakimya jedwali ili lilingane na maandishi; inaweka kando ripoti mbili tofauti ndani ya chanzo.
Ablation ya usanifu wa hybrid
| Toleo la modeli | Accuracy | Precision | Recall | F1 | AUC |
|---|---|---|---|---|---|
| Full model — AE + LSTM + RL + Trust | 0,975 | 0,971 | 0,978 | 0,974 | 0,982 |
| Without trust module | 0,942 | 0,935 | 0,944 | 0,939 | 0,961 |
| Without RL policy | 0,951 | 0,942 | 0,955 | 0,948 | 0,968 |
| Without feature fusion | 0,948 | 0,938 | 0,952 | 0,945 | 0,965 |
| Only Autoencoder | 0,931 | 0,922 | 0,937 | 0,929 | 0,951 |
| AE + RL — No LSTM | 0,945 | 0,938 | 0,951 | 0,944 | 0,962 |
| AE + LSTM — No RL | 0,957 | 0,948 | 0,961 | 0,954 | 0,971 |
| AE + Transformer | 0,960 | 0,953 | 0,964 | 0,958 | 0,975 |
Full model hutoa thamani ya juu zaidi katika metrik zote za Table 6. Moduli ya trust inapoondolewa, F1 hushuka hadi 0,939; RL inapoondolewa, hushuka hadi 0,948.
Katika Discussion 5.3 kuna kauli “removal of the trust module resulted in a F1 score of 3.6”. Kwa kuwa F1-score katika utafiti huu imeripotiwa ndani ya safu ya 0–1 na Table 6 inaonyesha 0,939, maandishi hayo hayalingani na Table 6. Verianla haitumii thamani 3,6 kama matokeo ya kisayansi.
Ulinganisho wa utendaji wa fault-detection
| Mbinu | Detection Accuracy (%) | False Positive Rate (%) | Detection Latency (ms) | Scalability (%) | Model Complexity (1–10) | Resource Usage (MB) |
|---|---|---|---|---|---|---|
| Deep neural network-based anomaly detection | 95 | 3,5 | 54 | 88 | 7 | 200 |
| RL for policy-based recovery | 93 | 4,2 | 67 | 85 | 8 | 185 |
| Federated learning-based distributed fault analytics | 92 | 3,8 | 60 | 92 | 6 | 165 |
| GNN for topological fault mapping | 94 | 4,0 | 64 | 89 | 8 | 195 |
| LSTM-based log sequence anomaly detection | 94 | 3,6 | 55 | 87 | 7 | 170 |
| Proposed method | 97 | 2,4 | 48 | 95 | 6 | 160 |
Mstari wa proposed-method katika Table 7 unaripoti %97 detection accuracy, %2,4 false-positive rate, 48 ms detection latency, %95 scalability score na 160 MB resource usage.
Ulinganisho wa recovery na adaptivity
| Mbinu | Recovery Time (ms) | Success Rate (%) | Self-Adaptivity (%) | Downtime Reduction (%) | Policy Compliance (%) | Learning Efficiency (1–10) |
|---|---|---|---|---|---|---|
| Deep neural network-based anomaly detection | 130 | 91 | 87 | 84 | 90 | 7 |
| RL policy-based recovery | 98 | 94 | 90 | 89 | 93 | 9 |
| Federated learning distributed fault analytics | 105 | 90 | 86 | 86 | 89 | 8 |
| GNN topological fault mapping | 110 | 91 | 88 | 85 | 92 | 8 |
| LSTM log-sequence anomaly detection | 120 | 92 | 89 | 87 | 91 | 8 |
| Proposed method | 90 | 96 | 93 | 93 | 96 | 10 |
Table 8 inatoa 90 ms recovery time na %96 success rate kwa proposed method. Hata hivyo, Figure 20/Conclusion katika ulinganisho mwingine inaripoti 1,8 s MTTR na 0,99 recovery success. Kwa kuwa chanzo hakilinganishi itifaki za majaribio za vipimo hivi viwili vya recovery ndani ya jedwali moja la maelezo, Verianla haiunganishi kama familia moja ya thamani.
Ulinganisho wa MTTR
Katika maelezo ya Figure 20, chanzo kinaripoti kwa proposed method MTTR = 1,8 s na recovery success = 0,99; kwa Autoencoder-LSTM MTTR = 2,3 s na success takriban 0,97; kwa mbinu ya Rule-Based MTTR = 5,1 s na success takriban 0,82.
Kwa kuwa thamani hizi hazijatolewa chini ya jina lilelile la metri kama safu ya “Recovery Time (ms)” katika Table 8, hazijasawazishwa kwa kufanya ubadilishaji wa moja kwa moja wa vitengo.
Simuleringi ya memory-consumption
Chanzo kinalinganisha mizigo ya 5 fault na 20 fault katika mazingira ya 1.000-node na 10.000-node. Memory footprint iliyoripotiwa kwa proposed method ni takriban 160 MB, 200 MB, 780 MB na 910 MB mtawalia.
Imeelezwa wazi kwamba mfumo wa jadi ulitumia 180 MB katika mazingira madogo zaidi na 1040 MB katika mazingira makubwa zaidi ya 10.000-node/20-fault. Kwa hiyo, thamani ya 910 MB ya proposed method katika mazingira makubwa zaidi si “kuokoa 910 MB”, bali ni total memory usage.
Mgawanyo wa F1 na kutokuwa na uhakika
Chanzo kinaeleza kwamba Figure 17 ilitumia error bar za ±1 standard deviation (\(\pm1\sigma\)) kwa safu za attack-specific F1. Figure 19, kwa upande mwingine, inalinganisha mgawanyo wa F1-score wa modeli tofauti kwa boxplot na kuripoti median ya juu pamoja na mgawanyo mwembamba kiasi kwa proposed method.
Chanzo hakiripoti formal p-value, confidence interval au named hypothesis test katika sehemu hii. Kwa hiyo hakuna p-value ya nje ya chanzo iliyozalishwa kwa kauli “ina umuhimu wa kitakwimu”.
Matokeo yanayoungwa mkono na utafiti
- Katika tathmini ya benchmark na simuleringi, mfumo jumuishi uliopendekezwa uliripoti %97 system-level anomaly-detection accuracy.
- Chanzo kinaripoti %96 autonomous-recovery success na %93 downtime reduction.
- Kwa DDoS, proposed method F1-score 0,965 na MTTD 1,6 s ziliripotiwa.
- Thamani za jumla za proposed-method precision 0,962, recall 0,955 na F1 0,958 ziliripotiwa katika ulinganisho tofauti wa modeli.
- Table 6 inatoa accuracy 0,975, F1 0,974 na AUC 0,982 kwa full hybrid model.
- Kuondoa Trust module kuliathiri vibaya false-positive rate na ubora wa detection.
- Kuondoa RL policy kuliongeza recovery latency.
- Katika simuleringi za 10.000-node, matumizi ya kumbukumbu ya 780–910 MB yaliripotiwa kwa proposed method.
- Kafka na Flink ziliingizwa katika usanifu kama vipengele vya streaming architecture vyenye latency ndogo, si kama matokeo yaliyopimwa ya dai la real-time deployment.
Matokeo ambayo utafiti hauungi mkono
- %97 accuracy si mafanikio ya uwanjani katika mtandao halisi wa enterprise Zero-Trust.
- Figure 14 haionyeshi kwamba attack class tatu zinatenganishwa kwa usahihi wa %97.
- Utendaji wa moduli ya federated-learning katika edge deployment ya kiwango kikubwa haujathibitishwa katika utafiti huu.
- 90 ms recovery time, 1,8 s MTTR na 2,3 s recovery latency haziwezi kutafsiriwa kama metri moja na ileile.
- Thamani 910 MB haimaanishi kuokoa kumbukumbu ya 910 MB; ni reported proposed-method usage katika mazingira makubwa ya simuleringi.
- Kwa kuwa numeric learning rate, batch size, epoch count na exact data split ratios hazionekani wazi katika Source PDF, si vigezo vyote vya reproducibility vinavyopatikana.
- Milinganyo ya Mahalanobis au Section 3.3 trust-update isiyoonekana katika chanzo haijakamilishwa na Verianla.
- Matokeo ya benchmark hayatoi dhamana ya moja kwa moja kwa network topology nyingine, trafiki halisi ya watumiaji, hali tofauti za concept drift au mabadiliko ya mashambulizi ya muda mrefu.
Tofauti za kuripoti ndani ya chanzo
| Mada | Mahali katika chanzo A | Mahali katika chanzo B | Mkabala wa Verianla |
|---|---|---|---|
| CICIDS accuracy | Table 5: 0,961 | Discussion 5.1: 0,950 | Ripoti mbili huwekwa tofauti; hazilazimishwi kuunganishwa kuwa thamani moja. |
| Trust-module F1 | Table 6: 0,939 | Discussion 5.3: “3.6” | Thamani ya Table 6 huwasilishwa; kauli 3,6 huwekwa alama kama kutolingana ndani ya chanzo. |
| Recovery | Table 3–4: 2,3 s recovery latency | Figure 20/Conclusion: 1,8 s MTTR | Kwa kuwa majina ya metri ni tofauti, hazisawazishwi. |
| Recovery | Table 8: 90 ms recovery time, %96 success | Figure 20: 1,8 s MTTR, 0,99 success | Huhifadhiwa kama miktadha tofauti ya jaribio/kipimo. |
| Memory | Abstract: “910 MB memory usage optimization” | Figure 21 text: 910 MB proposed usage, 1040 MB traditional usage | 910 MB haitafsiriwi kama “akiba”. |
| Trust notation | Mlinganyo 49: T norm | Mlinganyo 52–57: T nr | Notation haisawazishwi kimyakimya. |
Mielekeo ya utafiti wa baadaye
Chanzo kinapendekeza siku zijazo enterprise-scale real-time Zero-Trust deployment, asynchronous federated optimization, decentralized adaptive policy learning, graph-aware trust propagation, lightweight edge-compatible architecture na uthibitishaji kwenye live software-defined Zero-Trust telemetry.
Maeneo haya ya utafiti wa baadaye si matokeo yaliyokwishafikiwa ya makala ya sasa. Hasa, ingawa federated learning imewasilishwa katika chanzo kama architecture-level integration, imeelezwa kwamba majaribio ya edge yaliyosambazwa kwa kiwango kikubwa yatafanywa baadaye.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Artificial Intelligence driven fault detection and autonomous recovery in zero trust network architectures
Waandishi na mpangilio: Sami Morsi; Rajit Nair; Hasan Alkahtani; Sultan Ahmad; Theyazn H. H. Aldhyani; Hikmat A. M. Abdeljaber.
Corresponding author: Sultan Ahmad.
Corresponding e-mail: s.alisher@psau.edu.sa
Affiliation 1: Applied College, King Faisal University, 31982 Al-Ahsa, Saudi Arabia.
Affiliation 2: VIT Bhopal University, Bhopal, India.
Affiliation 3: College of Computer Science and Information Technology, King Faisal University, P.O. Box 400, 31982 Al-Ahsa, Saudi Arabia.
Affiliation 4: Department of Computer Science, College of Computer Engineering and Sciences, Prince Sattam Bin Abdulaziz University, 11942 Alkharj, Saudi Arabia.
Affiliation 5: Department of Computer Science and Engineering, University Center for Research and Development (UCRD), Chandigarh University, Gharuan, Mohali, Punjab 140413, India.
Affiliation 6: Department of Extended-Reality and Games Development, Faculty of Information Technology, Applied Science Private University, 11831 Amman, Jordan.
Ulinganifu wa mwandishi-affiliation: Sami Morsi — 1; Rajit Nair — 2; Hasan Alkahtani — 3; Sultan Ahmad — 4 na 5; Theyazn H. H. Aldhyani — 1; Hikmat A. M. Abdeljaber — 6.
Mchango sawa: Chanzo hakitoi tamko tofauti la equal-contribution au equal-first-authorship.
Jarida: Discover Artificial Intelligence.
Mchapishaji/platform: Springer Nature / Springer.
Juzuu: Volume 6.
Namba ya makala: 871.
Mwaka wa uchapishaji: 2026.
Aina ya makala: Research.
DOI: 10.1007/s44163-026-01654-w.
Kiungo rasmi: https://doi.org/10.1007/s44163-026-01654-w
Received: 26 Februari 2026.
Accepted: 15 Juni 2026.
Published: Kulingana na rekodi rasmi ya makala ya Springer, 7 Julai 2026.
Version of record: Katika rekodi rasmi ya Springer, 21 Agosti 2026.
Maelezo ya mapitio: Chanzo ni makala ya Springer Research iliyochapishwa na tarehe za Received/Accepted zimeripotiwa. PDF ya chanzo haibainishi maelezo ya modeli ya mapitio iliyotumika kama single-blind/double-blind.
Leseni: Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International — CC BY-NC-ND 4.0.
Athari ya leseni kwa vielelezo: Kwa kuwa leseni hairuhusu kushiriki adapted material, Verianla HTML haizalishi upya vielelezo vya chanzo katika umbo lililobadilishwa/kurekebishwa. SVG za ndani ya makala zimeundwa kwa muundo huru kutokana na ukweli wa kisayansi ulioelezwa wazi katika maandishi pekee.
Eneo kuu: Zero-Trust Network Architecture, anomaly detection, autonomous recovery, deep learning, reinforcement learning na trust scoring.
Modeli kuu: Framework jumuishi inayotegemea Autoencoder-LSTM-RL-Trust.
Vipengele vya Streaming: Apache Kafka na Apache Flink.
Vipengele vya Anomaly: Autoencoder, LSTM, attention, ensemble shallow autoencoders, dynamic thresholding, muktadha wa Mahalanobis-distance na mkabala wa Energy-Based Model.
Vipengele vya Trust: Response reliability, authentication strength/frequency, fault history, decay, normalization, deviation na trusted/suspicious/untrusted node classification.
Vipengele vya Recovery: Trust-ranked node selection, compatibility scoring, traffic rerouting, node isolation, role reassignment, load redistribution, policy update, service redeployment na reinforcement-learning feedback.
Hali ya Federated learning: Imejumuishwa katika usanifu wa framework kwa privacy-preserving distributed adaptation; chanzo kinaeleza kwamba majaribio ya federated edge deployment kwa kiwango kikubwa yatafanywa siku zijazo.
Seti kuu za data: CIC-IDS-2017/CICIDS na NSL-KDD.
Upatikanaji wa data: Chanzo kinaeleza kwamba dataset zinapatikana kupitia public repository na kinatoa viungo vya Kaggle kwa CIC-IDS-2017 na NSL-KDD.
Attack classes: DDoS, Unauthorized Access na Data Exfiltration.
Matokeo ya jumla ya system-level: %97 anomaly detection accuracy; %96 autonomous recovery success; %93 downtime reduction.
Matokeo ya DDoS: F1-score 0,965; katika sehemu ya hitimisho MTTD 1,6 s.
MTTR: Katika muktadha wa Figure 20/Conclusion, 1,8 s.
Table 7 proposed result: %97 detection accuracy; %2,4 FPR; 48 ms detection latency; %95 scalability; complexity 6/10; 160 MB resource usage.
Table 8 proposed result: 90 ms recovery time; %96 success; %93 self-adaptivity; %93 downtime reduction; %96 policy compliance; 10/10 learning efficiency.
Memory simulation: Kwa proposed method, matumizi ya 160 MB, 200 MB, 780 MB na 910 MB yaliripotiwa mtawalia katika mazingira ya 1.000N-5F, 1.000N-20F, 10.000N-5F na 10.000N-20F.
Kikomo cha Confusion-matrix: Confusion matrix ya madarasa mengi ya attack-type si yenyewe %97 system-level detection accuracy ya jumla.
Kikomo cha Hyperparameter reproducibility: Ingawa chanzo kinasema maelezo ya hyperparameter yamejumuishwa, PDF iliyochapishwa haitoi learning rate, batch size, epoch, hidden-layer size na split ratios katika jedwali kamili la namba.
Tatizo la uwasilishaji wa fomula: Katika PDF Section 3.2, mlinganyo hauonekani mahali ambapo fomula ya Mahalanobis anomaly-score inatarajiwa; vivyo hivyo katika Section 3.3 mahali ambapo time-decaying trust-update formula inatarajiwa. Vipengele hivi vinavyokosekana havijakamilishwa na Verianla kwa makadirio.
Tofauti ya CICIDS ndani ya chanzo: Table 5 proposed accuracy 0,961; Discussion 5.1 accuracy 0,950.
Tofauti ya trust-ablation ndani ya chanzo: Table 6 without-trust F1 = 0,939; Discussion 5.3 inaandika “F1 score of 3.6”.
Tofauti ya metri za recovery ndani ya chanzo: Table 3–4 recovery latency 2,3 s; Figure 20/Conclusion MTTR 1,8 s; Table 8 recovery time 90 ms. Chanzo hakionyeshi kwamba hizi zinatokana na itifaki moja ya kipimo.
Ufadhili: Deanship of Scientific Research, Vice Presidency for Graduate Studies and Scientific Research, King Faisal University, Saudi Arabia; Grant No. KFU262842.
Maadili: Ethics approval and consent to participate — Not Applicable.
Consent for publication: Not Applicable.
Mgongano wa maslahi: Waandishi wanatamka kwamba hakuna competing interests.
Michango ya waandishi: Sultan Ahmad, Sami Morsi, Rajit Nair na Hasan Alkahtani — mapitio ya fasihi na methodology; Theyazn H. H. Aldhyani, Sultan Ahmad na Hikmat A. M. Abdeljaber — formal analysis, data collection na investigation; Hikmat A. M. Abdeljaber, Theyazn H. H. Aldhyani na Sultan Ahmad — initial drafting na statistical analysis; Sami Morsi, Rajit Nair na Hasan Alkahtani — supervision. Chanzo pia kinaeleza kwamba waandishi wote walichangia system na manuscript development na waliidhinisha final manuscript.
Kikomo kikuu cha kimetodolojia: Evaluation ya sasa inategemea benchmark na simulation; uthibitishaji wa live enterprise-scale Zero-Trust deployment haujafanywa.
Utafiti wa baadaye: Enterprise real-time ZTNA deployment, large-scale federated edge experimentation, federated adaptive optimization, graph-aware trust propagation, lightweight edge architectures na live software-defined Zero-Trust telemetry validation.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *