


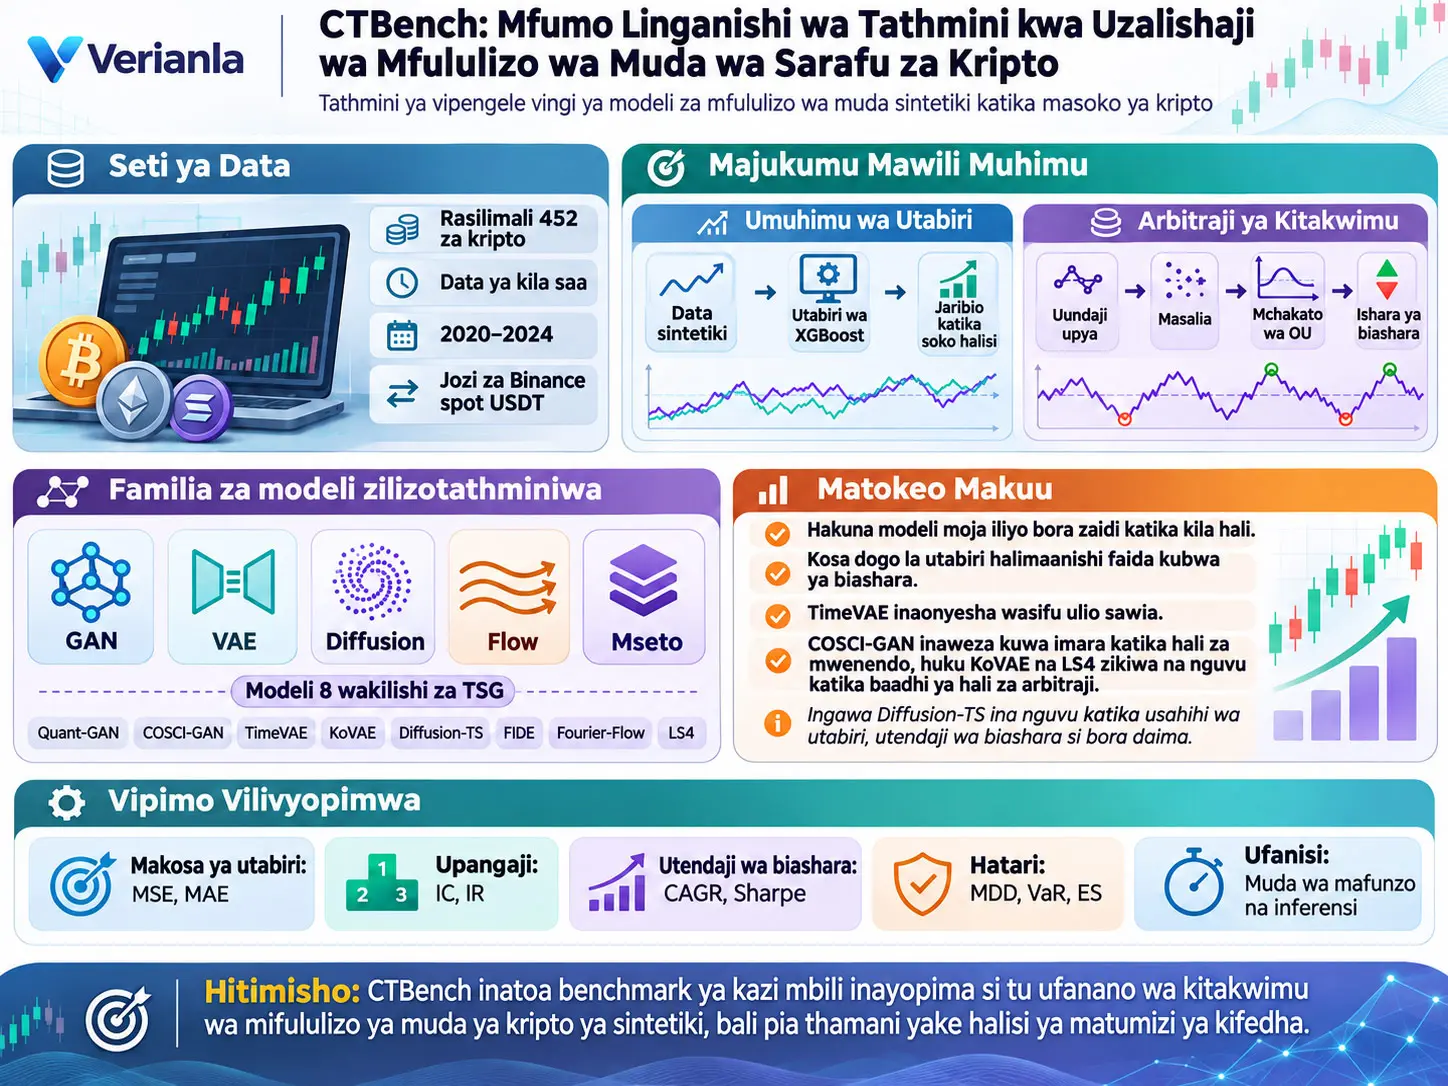
CTBench, ni mfumo wa benchmark unaotathmini modeli za uzalishaji wa mfululizo wa muda sintetiki (Time Series Generation, TSG) katika masoko ya sarafu za kripto si kwa kufanana kwa takwimu pekee, bali pia kwa mafanikio ya utabiri, ufaafu kwa biashara, hatari na gharama ya ukokotoaji. Utafiti uliopakiwa unatumia data za kila saa za mali 452 za kripto zilizofanyiwa biashara dhidi ya USDT katika soko la spot la Binance kati ya Januari 2020 na Desemba 2024, baada ya uchunguzi wenye data zinazokosekana kuchujwa. Modeli nane za TSG zimechaguliwa kutoka familia tano za modeli—GAN, VAE, diffusion, flow na usanifu mseto—na kutathminiwa katika majukumu mawili yanayokamilishana yanayoitwa Predictive Utility na Statistical Arbitrage.
Jukumu la Predictive Utility hupima kama data sintetiki zinahifadhi muundo wa muda na wa kati ya mali unaohitajika kutabiri marejesho ya saa inayofuata katika soko halisi. Modeli ya utabiri ya XGBoost hufunzwa kwa data sintetiki zilizotolewa na modeli ya TSG; kisha mtabiri huendeshwa kwenye data halisi za majaribio na ishara zinazopatikana hubadilishwa kuwa mikakati mbalimbali ya portfoliyo. Jukumu la Statistical Arbitrage hutumia modeli ya TSG kama kijenzi upya; mabaki kati ya marejesho halisi na yaliyoundwa upya humodeliwa kwa mchakato wa Ornstein–Uhlenbeck wa kurudi kwenye wastani ili kuzalisha ishara za kununua na kuuza.
Matokeo muhimu zaidi ya utafiti ni kwamba hakuna modeli moja ya TSG iliyo bora katika malengo yote. Ingawa Diffusion-TS hutoa matokeo yenye nguvu kwa upande wa kosa la utabiri, inaonekana kuwa hilo halibadiliki moja kwa moja kuwa faida ya biashara. TimeVAE hutoa wasifu ulio na uwiano zaidi kati ya usahihi wa takwimu na utendaji wa biashara, huku COSCI-GAN ikiweza kuzalisha ishara zenye nguvu za biashara hasa katika rejimu zenye mwelekeo na trend. Fourier-Flow huonyesha utendaji thabiti wa kiwango cha kati hadi juu katika vipimo vingi, ilhali katika jukumu la Statistical Arbitrage KoVAE na LS4 zinaweza kutoa marejesho ya juu katika baadhi ya vipindi, lakini wasifu wao wa hatari hutofautiana.
Kikomo muhimu cha matokeo ni hiki: utendaji wote wa biashara ni matokeo ya uigaji na backtest yaliyotengenezwa kwa data za kihistoria. Haya si dhamana ya marejesho yatakayopatikana kwa fedha halisi siku zijazo. Katika sehemu muhimu ya tathmini za msingi, ada ya biashara imechukuliwa kuwa sifuri; kwa jukumu la Statistical Arbitrage, pia limejaribiwa tukio la uhalisia zaidi lenye ada ya biashara ya %0.03.
CTBench ni Nini na Hupima Nini?
CTBench ni benchmark ya TSG inayolenga kripto, iliyoundwa kupima si tu kama mfululizo wa muda sintetiki wa sarafu za kripto unafanana kwa mwonekano au usambazaji na data halisi, bali pia kama data hizo sintetiki zinabeba taarifa inayoweza kutumika kiuchumi katika majukumu ya baadaye kama utabiri wa soko halisi na mikakati ya biashara.
Kwa nini kriptovalyuta inahitaji benchmark tofauti?
Motisha kuu ya utafiti ni kwamba benchmark nyingi zilizopo za uzalishaji wa mfululizo wa muda hulenga maeneo kama afya, trafiki, ishara za viwandani au masoko ya jadi ya fedha. Masoko ya kripto, kwa upande mwingine, huunda mazingira tofauti ya majaribio kwa sababu yanafunguliwa saa 24 kwa siku na siku 7 kwa wiki, yana tete kubwa, mabadiliko ya haraka ya rejimu na miundo isiyo sawa ya ukwasi kati ya mali.
Chanzo kinabainisha mapengo matatu makuu. Kwanza, benchmark zilizopo hazifunikii uga wa kriptovalyuta kwa upana wa kutosha. Pili, tathmini nyingi hubaki kwenye utabiri au uainishaji na hazipimi muundo unaoweza kufanyiwa biashara. Tatu, dhana kwamba kosa dogo la data sintetiki ni la manufaa kwa mkakati halisi wa kifedha haijajaribiwa moja kwa moja.
Moduli tano kuu za CTBench
Seti ya data za kripto inaundwaje?
Kwa mujibu wa sehemu ya mbinu, data zimeundwa kutoka data za kihistoria za kila saa za jozi za biashara za spot zilizoorodheshwa kwenye Binance. Kipindi kinaanzia Januari 2020 hadi Desemba 2024. Mali zenye uchunguzi unaokosekana zimechujwa na jozi zinazofanyiwa biashara dhidi ya USDT pekee zimehifadhiwa. Baada ya hatua hizi, mali 452 tofauti za kripto zilibaki.
Chanzo kinafafanua vekta ya msingi ya bei inayotumiwa kwa kila mali na kila nukta ya muda kama ifuatavyo:
\[ \mathbf{x}_{i,t} = [O_{i,t},H_{i,t},L_{i,t},C_{i,t}] \in\mathbb{R}^{4}. \]
Hapa \(O\) inaonyesha bei ya kufungua, \(H\) bei ya juu zaidi, \(L\) bei ya chini zaidi na \(C\) bei ya kufunga. Mali zote na nukta za muda zinapounganishwa, tensor ya data:
\[ \mathbf{D} = [\mathbf{x}_{i,t}] \in \mathbb{R}^{n\times(l+1)\times4} \]
inafafanuliwa hivyo. Ingawa maandishi ya chanzo yanatumia kauli “five standard fields” katika hatua hii, vekta ya kihisabati ina sehemu nne tu za OHLC. Verianla haijarekebisha kauli hiyo kwa kuongeza sehemu ya tano.
Log-marejesho ya kila saa yanahesabiwaje?
\[ r_{i,t} = \log\left( \frac{C_{i,t}}{C_{i,t-1}} \right). \]
\(C_{i,t}\) ni bei ya kufunga ya mali \(i\) katika saa \(t\). Log-marejesho ni logaritimu asilia ya uwiano wa bei mbili mfululizo za kufunga. Ubadilishaji huu husaidia kulinganisha mali za kripto zenye viwango tofauti vya bei kwa kipimo kimoja cha marejesho na kuruhusu modeli za mfululizo wa muda kuchakata mabadiliko badala ya kiwango cha bei moja kwa moja.
Marejesho ya kila saa ya mali zote:
\[ \mathbf{R} = [r_{i,t}] \in \mathbb{R}^{n\times l} \]
huunganishwa katika matriksi.
Mgawanyo wa rolling-window unafanywaje?
Kwa kutumia dirisha la mafunzo \(w\), hatua ya test \(s\), jumla ya saa \(l\) na idadi ya split \(k\):
\[ \mathcal{O} = \{w,w+s,\ldots,w+(k-1)s\}, \qquad k= \left\lfloor \frac{l-w}{s} \right\rfloor \]
inafafanuliwa. Katika kila nukta ya split ya \(\tau\), matriksi za mafunzo na test:
\[ \mathbf{R}_{train}^{(\tau)} = [\mathbf r_{\tau-w+1},\ldots,\mathbf r_{\tau}] \]
na
\[ \mathbf{R}_{test}^{(\tau)} = [\mathbf r_{\tau+1},\ldots,\mathbf r_{\tau+s}] \]
huundwa. Hivyo modeli hufunzwa kwenye dirisha la zamani bila kuona data za baadaye wakati wa mafunzo, kisha hutathminiwa katika kipindi kinachofuata.
Hali za uzalishaji na ujenzi upya
Modeli ya TSG \(\mathbf g^{(\tau)}\) hufunzwa upya kwa kila rolling split kwenye data za mafunzo. Katika hali ya uzalishaji, modeli huchukua sampuli za mfululizo sintetiki kutoka kelele ya Gaussian:
\[ \mathbf{R}_{gen} = \mathbf g^{(\tau)}(\mathbf z), \qquad \mathbf z\sim\mathcal{N}(0,\mathbf I). \]
Katika hali ya Reconstruction, modeli hujenga upya data zilizopo za mafunzo au test:
\[ \widehat{\mathbf R}_{train} = \mathbf g^{(\tau)} (\mathbf R_{train}^{(\tau)}), \qquad \widehat{\mathbf R}_{test} = \mathbf g^{(\tau)} (\mathbf R_{test}^{(\tau)}). \]
Hali hizi mbili zina kazi tofauti katika majukumu mawili makuu ya CTBench. Predictive Utility hupima ubora wa uzalishaji sintetiki, huku Statistical Arbitrage ikipima kama muundo wa mabaki unaobaki baada ya ujenzi upya unaweza kufanyiwa biashara.
Tatizo la uandishi wa ndani ya chanzo katika ufafanuzi wa portfoliyo
Chanzo huchapisha vekta ya uzani wa portfoliyo:
\[ \boldsymbol{\eta}_{t} = [\eta_{1,t},\ldots,\eta_{n,t}] \in\mathbb{R}^{n}, \qquad \eta_{i,t}=1 \]
kwa namna hiyo na kisha:
\[ V_t = V_{t-1} \times (\boldsymbol{\eta}_{t}\cdot\mathbf r_t) \]
hutumia kufafanua maendeleo ya portfoliyo,
\[ \Delta V_t = V_t-V_{t-1} \]
na kufafanua faida-hasara ya kila saa.
Dokezo la uaminifu kwa chanzo: Katika nadharia ya portfoliyo, jumla ya uzani na usasishaji wa mtaji mara nyingi vinaweza kuandikwa kwa namna tofauti; hata hivyo, katika PDF iliyopakiwa formula imechapishwa kwa namna iliyo hapo juu. Verianla haijabadilisha kimya kimya \(\eta_{i,t}=1\) kuwa \(\sum_i\eta_{i,t}=1\), wala formula ya \(V_t\) kuwa mlinganyo mwingine wa kawaida wa portfoliyo.
Utoaji wa vipengele
Utafiti hutumia mkondo uleule wa utoaji wa vipengele kwa marejesho halisi na sintetiki. Vipengele vinavyotumiwa vinajumuisha vipengele vya Alpha101 pamoja na viashiria vya jadi vya kiufundi kama Bollinger Bands, Relative Strength Index (RSI) na wastani unaosogea. Vipengele hivi vinalenga kusimba tabia za soko za muda mfupi kama momentum, kurudi kwenye wastani na tete.
Vipengele vya kifunksi:
\[ \boldsymbol{\Phi} = \{\boldsymbol{\phi}_{j}\}_{j=1}^{d} \]
vinafafanuliwa na mwisho wa ubadilishaji hutoa tensor ya vipengele yenye vipimo \(n\times l\times d\).
Ni nini kinachoonekana katika usambazaji wa data?
Chanzo kinaeleza kuwa usambazaji wa wastani wa log-marejesho ya kila saa wa mali 452 za kripto umejikusanya karibu na sifuri lakini una mkengeuko mdogo kuelekea kulia. Usambazaji wa tete ya kila saa una mkia mrefu wa kulia; yaani mali nyingi zina tete ya chini kiasi, huku kundi dogo likionyesha mabadiliko makubwa sana ya bei.
Katika sampuli za 2020–2024 zilizochunguzwa kwa makundi ya thamani ya soko, kipindi cha kupanda cha 2020–2021, marekebisho makali ya 2022 na vipindi vya baadaye vya kupona/kukomaa vinaonekana. Chanzo kinaeleza kuwa mali za kripto za thamani ya soko ya kati na ndogo zinaweza kuonyesha tete ya juu na kali zaidi kuliko sampuli za thamani kubwa ya soko.
Katika uchambuzi wa ndani ya saa, inaripotiwa kuwa marejesho ya wastani yanaongezeka karibu na UTC 05:00–07:00 na UTC 21:00–23:00; tete huwa dhahiri zaidi karibu na usiku wa manane na katika kipindi cha takriban UTC 12:00–17:00 ambapo saa za biashara za Marekani na Ulaya zinaingiliana. Uchunguzi huu ni wa kimaelezo; hakuna jaribio tofauti lililofanywa kuthibitisha kwamba soko fulani la kijiografia ndilo linalosababisha mienendo hii.
Tofauti kati ya Majukumu ya Predictive Utility na Statistical Arbitrage ni Nini?
Jukumu la Predictive Utility hupima kama data sintetiki zinahifadhi muundo unaoweza kutumiwa katika utabiri wa soko halisi, huku Statistical Arbitrage ikipima kama mabaki yanayotokana na kujenga upya mfululizo halisi kwa modeli ya TSG yanazalisha ishara za biashara zilizo thabiti na zinazorejea kwenye wastani.
Hatua ya mafunzo ya jukumu la Predictive Utility
Kwa kila split, data halisi za mafunzo:
\[ \mathbf{R}_{train}^{(\tau)} \in \mathbb{R}^{n\times w}, \qquad w=500\times24 \]
zinawekwa hivyo. Yaani dirisha la mafunzo lina data za kila saa za siku 500.
Modeli ya TSG hujifunza utegemezi wa muda na mahusiano kati ya mali kutoka data hizi na huzalisha marejesho sintetiki:
\[ \mathbf R_{gen} = \mathbf g(\mathbf z), \qquad \mathbf z\sim\mathcal N(0,\mathbf I). \]
Baada ya utoaji wa vipengele kutumika kwa marejesho sintetiki, modeli ya utabiri ya XGBoost hufunzwa kutabiri marejesho ya saa inayofuata:
\[ \widehat r_{i,t+1} = \mathbf f \left( \boldsymbol{\Phi}(\mathbf R_{gen})[i,t,:] \right). \]
Chanzo kimechagua XGBoost kama modeli ya utabiri ya pamoja yenye nguvu lakini isiyohitaji urekebishaji kupita kiasi wa hyperparameter. Lengo ni kwamba matokeo yaathiriwe kadiri iwezekanavyo na ubora wa data sintetiki, si uwezo wa modeli ya utabiri.
Hatua ya test ya Predictive Utility
Dirisha la test:
\[ s=30\times24 \]
saa. Mtabiri huzalisha marejesho ya saa inayofuata kutoka data halisi za test. Mali hupangwa kulingana na marejesho yaliyotabiriwa; chanzo kinaeleza kuwa katika jukumu hili huundwa portfoliyo isiyoegemea dola inayoshikilia long katika nusu ya juu ya mali zenye utabiri wa juu zaidi na short katika nusu ya chini ya mali zenye utabiri wa chini zaidi, na portfoliyo husawazishwa upya kila saa.
Wazo la msingi hapa ni kwamba ikiwa data sintetiki si tu zinafanana na data halisi bali pia zinahifadhi mahusiano yanayoweza kutabirika katika soko halisi, mtabiri aliyefunzwa kwa data sintetiki anapaswa kuzalisha ishara yenye maana katika soko halisi.
Hatua ya mafunzo ya Statistical Arbitrage
Katika jukumu hili, modeli ya TSG hujenga upya marejesho halisi. Baki la mafunzo:
\[ \rho_{i,t} = r_{i,t} - \widehat r_{i,t} \]
linafafanuliwa hivyo.
Mabaki ya kila mali hulinganishwa na mchakato wa Ornstein–Uhlenbeck (OU):
\[ d\rho_{i,t} = \theta_i (\mu_i-\rho_{i,t})dt + \sigma_i dW_t. \]
\(\theta_i>0\) huwakilisha kasi ya baki kurudi kwenye wastani wake wa muda mrefu \(\mu_i\); \(\mu_i\) ni thamani ya usawa wa muda mrefu; \(\sigma_i\) ni tete ya mchakato wa baki; na \(dW_t\) ni ongezeko la mchakato wa kawaida wa Wiener.
Modeli ya OU hapa haisemi kwamba bei yenyewe lazima irejee kwenye wastani. Katika chanzo, dhana ya kurudi kwenye wastani inatumika kwa mfululizo wa mabaki kati ya marejesho halisi na marejesho yaliyoundwa upya na modeli ya TSG.
Hatua ya test ya Statistical Arbitrage na s-score
Katika kipindi cha test, baki:
\[ \epsilon_{i,t} = r_{i,t} - \widehat r_{i,t} \]
huhesabiwa na \(s\)-score iliyosanifishwa:
\[ s_{i,t} = \frac{\epsilon_{i,t}-\mu_i} {\sigma_i/\sqrt{2\theta_i}} \]
hupatikana.
\(s_{i,t}\) huonyesha mkengeuko uliosanifishwa wa baki lililoonekana kutoka kiwango cha usawa kilichotabiriwa na mchakato wa OU. Chanzo hutumia kizingiti cha ishara:
\[ \gamma=2 \]
kama ifuatavyo.
- Ikiwa \(s_{i,t}>+2\), nafasi ya short hufunguliwa au kudumishwa.
- Ikiwa \(s_{i,t}<-2\), nafasi ya long hufunguliwa au kudumishwa.
- Katika hali nyingine hakuna nafasi inayochukuliwa.
Ishara ghafi ya nafasi:
\[ \eta_{i,t} = \operatorname{sgn}(-s_{i,t}) |s_{i,t}| \]
na uzani wa portfoliyo uliosanifishwa:
\[ \widetilde{\eta}_{i,t} = \frac{\eta_{i,t}} {\sum_j|\eta_{j,t}|} \]
hufafanuliwa hivyo. Portfoliyo husawazishwa upya kila saa.
Mikakati mitatu ya biashara
| Mkakati | Kifupisho | Mantiki ya biashara iliyotolewa katika chanzo |
|---|---|---|
| Cross-Sectional Momentum | CSM | Kwa mujibu wa marejesho ya saa moja yaliyotabiriwa, nafasi ya long katika mali za %10 za juu na short katika mali za %10 za chini. |
| Long-Only Top-Quantile | LOTQ | Nafasi ya long yenye uzani sawa katika mali zilizo katika %20 ya juu ya utabiri; mali nyingine zina uzani sifuri. |
| Proportional-Weighting | PW | Uzani wa portfoliyo hupewa kwa uwiano wa ukubwa wa marejesho yaliyotabiriwa. |
Metriksi za tathmini
Vipimo vya namba vya tathmini vinavyofafanuliwa wazi katika §3.4 ya chanzo ni 11. Vinajumuisha metriksi mbili za kosa, mbili za upangaji, mbili za utendaji wa biashara, tatu za hatari na mbili za muda wa ukokotoaji.
Mean Squared Error — MSE
\[ MSE = \frac{1}{k\,s\,n} \sum_{\tau\in\mathcal O} \sum_{t=1}^{s} \sum_{i=1}^{n} \left( r_{i,t+\tau} - \widehat r_{i,t+\tau} \right)^2. \]
MSE huchukua wastani wa mraba wa makosa ya utabiri; makosa makubwa hupata uzani zaidi kwa sababu ya kuwekwa mraba. Thamani ya chini inaonyesha usahihi bora wa utabiri.
Mean Absolute Error — MAE
\[ MAE = \frac{1}{k\,s\,n} \sum_{\tau\in\mathcal O} \sum_{t=1}^{s} \sum_{i=1}^{n} \left| r_{i,t+\tau} - \widehat r_{i,t+\tau} \right|. \]
MAE hupima kosa kamili la utabiri na, ikilinganishwa na MSE, hutoa uzani mdogo zaidi kwa makosa makubwa sana ya pekee.
Information Coefficient — IC
Uwiano wa Spearman kati ya mpangilio wa marejesho halisi na yaliyotabiriwa ya mali katika kila nukta ya muda:
\[ IC_{\tau,t} = \operatorname{SpearmanCorr} ( \mathbf r_{t+\tau}, \widehat{\mathbf r}_{t+\tau} ) \]
huhesabiwa na kisha huchukuliwa wastani juu ya nukta zote za split/muda:
\[ IC = \frac{1}{k\,s} \sum_{\tau\in\mathcal O} \sum_{t=1}^{s} IC_{\tau,t}. \]
IC chanya inaonyesha kuwa modeli inaweza kuhifadhi si tu thamani kamili za marejesho bali pia mpangilio wa mali kulingana na nyingine.
Information Ratio — IR
\[ IR = \frac{\operatorname{Mean}(IC_{\tau,t})} {\operatorname{Std}(IC_{\tau,t})}. \]
IR hupima si kiwango cha wastani cha IC pekee bali pia uthabiti wake kwa muda.
Compound Annual Growth Rate — CAGR
\[ CAGR = \left( \frac{V_s}{V_0} \right)^{8760/s} - 1. \]
Kwa kuwa chanzo kinatumia data za soko za kila saa, kinatumia saa \(8760=365\times24\) katika kipengele cha kuweka kwa mwaka. CAGR hupima ukuaji changamano uliowekwa kwa mwaka kati ya mtaji wa mwanzo \(V_0\) na thamani ya portfoliyo mwishoni mwa kipindi \(V_s\).
Sharpe Ratio — SR
\[ SR = \frac{ \mathbb E[\Delta V_t/V_{t-1}] }{ \operatorname{Std}(\Delta V_t/V_{t-1}) } \sqrt{8760}. \]
Uwiano wa Sharpe hupima marejesho ya wastani ya portfoliyo kwa kuhusianisha na tete ya marejesho na huwekwa kwa mwaka kutoka data za kila saa. Katika formula ya chanzo hakuna marekebisho tofauti ya kiwango kisicho na hatari yanayoonekana.
Maximum Drawdown — MDD
\[ MDD = \max_{u\le t} \left( \frac{V_u-V_t}{V_u} \right). \]
MDD hupima upungufu mkubwa zaidi wa jamaa baada ya thamani ya kilele ambayo portfoliyo ilikuwa imeifikia hapo awali.
Value at Risk — VaR
\[ VaR_{0.95} = - \operatorname{Percentile}_{5\%} \left( \frac{\Delta V_t}{V_{t-1}} \right). \]
Chanzo kinatumia VaR katika kiwango cha kujiamini cha %95. Kipimo hiki hufupisha ukubwa wa hasara kwenye mpaka wa chini wa %5 wa usambazaji wa marejesho.
Expected Shortfall — ES
\[ ES_{0.95} = - \mathbb E \left[ \frac{\Delta V_t}{V_{t-1}} \;\middle|\; \frac{\Delta V_t}{V_{t-1}} \le -VaR_{0.95} \right]. \]
ES hupima hasara ya wastani ya hali mbaya zaidi za mkia zinazopita hata kizingiti cha VaR. Hivyo huonyesha si tu mpaka wa hasara bali pia jinsi hasara zinavyoweza kuwa nzito kizingiti kinapovukwa.
Muda wa mafunzo na inferensi
Training Time, ni muda wa saa halisi uliotumika kufunza modeli ya TSG. Inference Time ni muda wa wastani wa kuzalisha au kujenga upya batch ya data yenye mali \(n\) na hatua \(s\) za muda.
Kwa nini chanzo wakati mwingine kinasema metriksi 11, 12 na 13?
Muhtasari na maelezo ya usanifu wa CTBench katika chanzo yanataja metriksi 13. §3.4, hata hivyo, inafafanua wazi metriksi 11 za namba zilizopewa namba E1–E11. Katika sehemu ya mipangilio ya majaribio hutumiwa kauli “twelve metrics detailed in §3.4”. Kielelezo 2 pia kinaonyesha matokeo mawili ya uoneshaji yanayoitwa Growth Curve na Ranking Plot chini ya kichwa “Visualization”. Kwa hiyo idadi ya metriksi katika chanzo si thabiti; Verianla haiziunganishi kuwa namba moja ya uhakika.
Modeli nane za TSG zilizojaribiwa
| Familia | Modeli | Mipangilio ya msingi iliyotolewa katika chanzo |
|---|---|---|
| GAN | Quant-GAN | latent_dim = 8; hidden_dim = 80; gradient penalty λgp = 10.0; critic steps = 5. |
| GAN | COSCI-GAN | latent_dim = 32; γ = 5; n_groups = 4; discriminator ya kati inayotegemea MLP. |
| VAE | TimeVAE | latent_dim = 8; tabaka zenye vitengo 50, 100 na 200. |
| VAE | KoVAE | WKL = 0.009; WPRED = 0.03. |
| Diffusion | Diffusion-TS | 1000 diffusion timestep; 3 encoder; 6 decoder; dmodel = 64. |
| Diffusion | FIDE | hatua 1000; hidden_dim = 64; tabaka 8; σ = 0.05. |
| Flow | Fourier-Flow | coupling inayotegemea DFT; hidden_size = 128; tabaka 3 za flow. |
| Mseto | LS4 | hidden_dim = 6; latent_dim = 8; batch size = 512. |
Quant-GAN na COSCI-GAN zinazotegemea GAN zimetumika katika jukumu la Predictive Utility pekee. Tanbihi ya chanzo inaeleza sababu kuwa modeli za GAN kwa asili hazitoi kazi ya reconstruction.
Mbinu na Matokeo ya Utafiti
Kwa nini Kosa Dogo la Utabiri Halimaanishi Faida Kubwa ya Biashara?
Katika matokeo ya CTBench, baadhi ya modeli zina nguvu katika metriksi za utabiri kama MSE na MAE lakini hazizalishi ishara ya biashara yenye faida; kwa sababu modeli zalishi inaweza kupunguza kosa la utabiri kwa kulainisha kupita kiasi mfululizo wa bei, huku pia ikidhoofisha variance, mienendo ya mikia au tofauti za upangaji kati ya mali ambazo mikakati ya biashara hutumia.
Mpangilio wa majaribio
Ili kuiga matumizi ya ulimwengu halisi, uthibitishaji wa walk-forward rolling-window umetumika. Mwishoni mwa kila mzunguko, mfumo ulisogezwa mbele kwa urefu wa kipindi cha test na modeli ikafunzwa upya.
| Kipengele | Thamani |
|---|---|
| Kipindi cha data | Januari 2020 – Desemba 2024 |
| Marudio ya data | Kila saa, 24/7 |
| Idadi ya mali | Mali 452 za kripto |
| Soko | Binance spot, jozi za USDT |
| Dirisha la mafunzo | Siku 500 × saa 24 |
| Dirisha la test la Predictive Utility | Siku 30 × saa 24 |
| Dirisha la test la Statistical Arbitrage | Siku 15 × saa 24 |
| Gharama ya msingi ya biashara | 0 |
| Tukio la ziada la gharama la Statistical Arbitrage | Ada ya biashara ya %0.03 |
| Usawazishaji upya wa biashara | Kila saa |
| Kizingiti cha ishara ya biashara | γ = 2 |
| Prosesa | Intel Xeon Platinum 8480C @ 3.80 GHz |
| Kumbukumbu | 64 GB RAM |
| GPU | NVIDIA H100 |
Matokeo ya Predictive Utility ya 2021
Kwa mujibu wa uchambuzi wa kila mwaka wa chanzo, Diffusion-TS inaongoza katika usahihi wa utabiri katika soko la kupanda la 2021. Hata hivyo, CAGR hasi na thamani za chini za Sharpe za modeli zinaonyesha kwamba kosa dogo la utabiri halikubadilika kuwa mafanikio ya biashara.
TimeVAE katika kipindi hicho inaonyesha wasifu ulio na uwiano zaidi kati ya usahihi wa utabiri na marejesho. COSCI-GAN, kwa upande mwingine, hutoa matokeo yenye nguvu hasa katika mikakati nyeti kwa trend kama LOTQ na PW; chanzo kinasema kwamba mwaka 2021 uwiano wa Sharpe kwa mikakati hii unaweza kuzidi 5.
2022: rejimu ya tete kubwa
Katika 2022 kuna kuzorota kidogo kwa usahihi wa utabiri wa modeli zote. TimeVAE imeweza kuhifadhi thamani chanya za Sharpe katika mikakati tofauti. Ingawa Diffusion-TS ina nguvu katika metriksi zinazotegemea kosa, imeathiriwa na vipindi virefu vya drawdown.
COSCI-GAN ilionyesha mchanganyiko wa CAGR ya juu na drawdown isiyo ya kina sana katika mkakati wa CSM, huku LS4 ikionyesha wasifu wa kihafidhina unaotoa udhibiti zaidi wa hatari.
2023: rejimu ya ukomavu
Mwaka 2023, makosa ya utabiri yanapokaribiana kati ya modeli, matokeo ya biashara hutofautiana kwa wazi. COSCI-GAN iliyo nyeti kwa trend inadhoofika, huku TimeVAE na Fourier-Flow zikihifadhi thamani za juu za Sharpe. Chanzo kinasisitiza kwamba Fourier-Flow ilifanya vizuri katika kipindi cha ukomavu kwa hatari ndogo ya mkia na marejesho yenye nguvu yaliyorekebishwa kwa hatari.
2024: ishara dhaifu na kurudi kwenye wastani
Mwaka 2024, usahihi wa utabiri na faida kwa ujumla zilipungua. TimeVAE ilihifadhi faida kwa kiwango kidogo, huku modeli nyingi zikishindwa kuzalisha marejesho thabiti. Chanzo kinaunganisha hali hii na kupungua kwa fursa za alpha katika mazingira yenye ishara dhaifu.
Upangaji wa modeli za Predictive Utility unaonyesha nini?
Uchambuzi wa ranking wa kila mwaka una ujumbe mitatu kuu. Diffusion-TS huendelea kuwa juu katika metriksi za utabiri lakini hubaki nyuma katika utendaji wa biashara. TimeVAE na COSCI-GAN huonyesha faida tofauti katika rejimu tofauti za soko. Fourier-Flow hupata nafasi za kati hadi juu na thabiti katika vipimo vingi, hivyo kutoa wasifu wa modeli ulio na uwiano zaidi kwa matumizi yanayodhibiti hatari.
Tafsiri ya uigaji wa dola 10.000
Chanzo kinaonyesha maendeleo ya portfoliyo zilizoigwa zenye thamani ya mwanzo ya dola 10.000 katika 2021–2024 chini ya ishara zinazotolewa na modeli mbalimbali za TSG. Grafu hizi si akaunti halisi za uwekezaji; ni matokeo ya backtest yaliyofanywa kwa data za kihistoria.
Chini ya CSM, COSCI-GAN na TimeVAE huonyesha ukuaji wa mara kwa mara, huku Diffusion-TS na FIDE zikishuka kwa muda. Chini ya LOTQ, COSCI-GAN inaongoza wazi; TimeVAE na Fourier-Flow huonyesha ukuaji wa wastani zaidi. Chini ya PW, COSCI-GAN bado ina nguvu; TimeVAE na Fourier-Flow huonyesha ukuaji changamano ulio laini zaidi, huku LS4 ikiwa na wasifu wa usawa na wa kihafidhina zaidi.
Matokeo ya Statistical Arbitrage
Katika jukumu la Statistical Arbitrage, mbinu ya kawaida inayotegemea PCA hutumiwa kama marejeo. Quant-GAN na COSCI-GAN hazipo katika jukumu hili; TimeVAE, KoVAE, Diffusion-TS, FIDE, Fourier-Flow na LS4 zenye uwezo wa reconstruction hutathminiwa.
Inaripotiwa kuwa faida ya modeli zote hupungua gharama za biashara zinapoongezwa. Mbinu zinazozalisha kiasi kikubwa cha biashara na turnover kubwa huathiriwa zaidi na gharama, huku modeli zinazozalisha ishara laini zaidi zikiweza kuhifadhi sehemu kubwa zaidi ya marejesho yao.
Katika mazingira yanayofanana na mgogoro ya 2022, KoVAE huzalisha CAGR ya juu zaidi lakini ina drawdown kubwa na wasifu wa Sharpe wa kiwango cha kati. Chanzo kinaunganisha hili na mabadiliko makubwa ya marejesho ambayo hata hivyo hurudi kwenye wastani.
Mwaka 2023 LS4 iliripotiwa kuwa modeli yenye nguvu zaidi kwa CAGR na Sharpe, na kiwango cha drawdown kilibaki kidogo kiasi. Gharama za biashara zinapojumuishwa, LS4 na KoVAE hubaki juu katika upangaji, ingawa marejesho yao ghafi hupungua.
TimeVAE na Diffusion-TS zinafafanuliwa kama modeli za daraja la pili zilizo na uwiano zaidi. FIDE, ingawa huzalisha CAGR na Sharpe karibu na sifuri au hasi katika miaka yote, mara nyingi hutoa VaR/ES ya chini zaidi na thamani ndogo za MDD. Tafsiri ya chanzo ni kwamba FIDE inaweza kujenga upya mfululizo wa mabaki kwa “usafi” kiasi cha kuondoa pia muundo unaoweza kufanyiwa biashara.
Fourier-Flow hubaki dhaifu kwa marejesho katika jukumu la Statistical Arbitrage na haiwezi kudhibiti drawdown kwa uthabiti. Chanzo kinapendekeza kwamba mbinu ya flow inayotegemea exact-likelihood, ingawa inaweza kulainisha kelele za masafa ya juu, haiwezi kila mara kutenga vipengele vya kurudi kwenye wastani vinavyoweza kufanyiwa biashara.
Mikondo ya mtaji yenye ada ya biashara ya %0.03
Katika mikondo ya mtaji ya Statistical Arbitrage ya chanzo, LS4 huonyesha ukuaji changamano unaoendelea kiasi chini ya gharama ya biashara ya %0.03, na ongezeko mbili kali za hatua katikati ya 2022 na mwanzoni mwa 2023 zinavutia. KoVAE pia huonyesha ukuaji mkubwa, lakini hufanya kazi kwa hatari kubwa zaidi.
TimeVAE hukua kwa uthabiti hadi 2022, hutengeneza tambarare katikati ya 2023 na kusogea kwa usawa au kushuka kidogo katika 2024. Ingawa Diffusion-TS huzalisha mkondo laini zaidi wenye drawdown ndogo, chanzo kinaieleza kuwa na marejesho ya mwisho ya chini miongoni mwa modeli zinazoweza kutumika.
Kuzorota kwa kiasi kikubwa kwa mkondo wa mtaji wa FIDE mapema kunasababisha tafsiri kwamba mabaki yaliyoregularizwa kupita kiasi yanaweza kuondoa ishara inayoweza kufanyiwa biashara. Fourier-Flow, kwa upande mwingine, huonyesha upotevu wa mtaji wa polepole lakini unaoendelea tangu katikati ya 2022.
Ufanisi wa ukokotoaji
Familia ya VAE inaibuka katika chanzo kama kundi lenye ufanisi mkubwa zaidi wa ukokotoaji. Mafunzo ya TimeVAE huchukua chini ya dakika moja na muda wa inferensi hubaki chini ya sekunde moja. Kwa hiyo inaonekana kuwa na faida kwa mafunzo ya mara kwa mara au majaribio yenye ucheleweshaji mdogo.
Modeli zinazotegemea GAN zina gharama ya ukokotoaji ya kiwango cha kati. Inaelezwa kuwa muda wa mafunzo wa Quant-GAN ulio juu kiasi haubadiliki kuwa uzalishaji wa kasi sawa.
Modeli za diffusion ndizo kundi lenye mahitaji makubwa zaidi ya ukokotoaji. Hasa, kutokana na muundo wa iterative denoising wa Diffusion-TS, muda wa mafunzo na inferensi ni mrefu zaidi. Chanzo kwa hiyo kinasema kuwa mbinu za diffusion zinaweza kufaa zaidi kwa matumizi ya offline au mazingira yenye rasilimali kubwa za ukokotoaji.
Mapendekezo ya chanzo ya uteuzi wa modeli
| Tukio | Modeli zinazopendekezwa | Sababu iliyotolewa katika chanzo |
|---|---|---|
| Masoko yanayofuata trend / yenye mwelekeo | COSCI-GAN, KoVAE | COSCI-GAN huimarisha ishara ya trend na usambazaji; KoVAE inaweza kutoa alpha kwa gharama ya drawdown kubwa zaidi. |
| Rejimu za kurudi kwenye wastani / za upande | TimeVAE, Fourier-Flow, Diffusion-TS | TimeVAE na Fourier-Flow hutoa uwiano; Diffusion-TS inaweza kuhifadhi upangaji wa mali. |
| Nyeti kwa ada ya biashara / turnover ndogo | TimeVAE, Diffusion-TS | Ishara laini zaidi za mabaki na Sharpe thabiti zaidi chini ya gharama za biashara. |
| Uvumilivu wa hatari / muundo wa portfoliyo | KoVAE, LS4, TimeVAE, Diffusion-TS, FIDE | KoVAE na LS4: marejesho ya juu zaidi pamoja na hatari zaidi; TimeVAE na Diffusion-TS: uwiano wa Sharpe/drawdown; FIDE: muundo wa kujihami. |
| Usambazaji na ufanisi wa ukokotoaji | TimeVAE, LS4 | Mafunzo upya ya haraka na ucheleweshaji mdogo wa inferensi; modeli za diffusion zinafaa zaidi kwa matumizi ya offline. |
Mabadilishano makuu kati ya familia nne za modeli
Chanzo kinafupisha matokeo katika namna nne pana za tabia. Modeli zinazotegemea VAE hutoa reconstruction thabiti lakini zinaweza kuchelewa kujibu rejimu zinazobadilika haraka sana. Modeli zinazotegemea GAN zinaweza kunasa trend alpha lakini zinaweza kutokuwa thabiti wakati wa tete kubwa. Modeli za diffusion zinaweza kuwakilisha vizuri tabia za mikia na makundi ya rejimu, lakini zinaweza kupoteza utendaji katika vipindi vya ishara dhaifu. Modeli zinazotegemea flow huweka kipaumbele kwa uundaji wa likelihood lakini manufaa ya biashara ya kifedha yanaweza kubaki machache; modeli mseto zina ufanisi wa ukokotoaji lakini zinaweza kuwa zisizo thabiti zaidi katika tabia ya hatari-marejesho.
Matokeo ambayo utafiti unaunga mkono na hauungi mkono
| Utafiti unaunga mkono | Utafiti hauungi mkono |
|---|---|
| Kwamba kuna mabadilishano makubwa kati ya usahihi wa utabiri wa modeli za TSG na manufaa ya biashara ya kifedha. | Kwamba modeli yenye MSE/MAE ndogo itatoa faida ya uhakika katika soko halisi. |
| Kwamba hakuna modeli iliyo bora katika rejimu zote za soko na metriksi zote. | Kwamba modeli moja ndiyo bora kwa masoko yote ya kripto kwa ujumla. |
| Kwamba modeli kama TimeVAE, COSCI-GAN, Fourier-Flow, KoVAE na LS4 zina faida tofauti katika rejimu tofauti. | Kwamba modeli hizi zitarudia utendaji uleule siku zijazo. |
| Kwamba gharama za biashara hupunguza kwa kiasi kikubwa utendaji wa Statistical Arbitrage. | Kwamba ada ya %0.03 ni gharama ya biashara ya jumla kwa masoko yote na wafanyabiashara wote. |
| Matokeo ya kipindi cha 2020–2024 kwa mali 452 za Binance USDT. | Ujumlishaji wa moja kwa moja kwa masoko yote ya kripto, masoko ya derivativi au rejimu za soko za baadaye. |
| Kwamba kutathmini data sintetiki kwa majukumu ya kifedha ya downstream hutoa taarifa ya ziada. | Kwamba utendaji wa backtest ni ushahidi wa mafanikio ya biashara ya moja kwa moja. |
Vikwazo vya kimbinu na maelezo ya uzalishikaji upya
Hesabu ya metriksi: Katika sehemu tofauti za chanzo kuna kauli za vipengele 11, 12 na 13 vya tathmini. Kutothabiti huku kumehifadhiwa.
Maelezo ya chanzo cha data: Katika sehemu ya michango data inaelezwa kwa kauli “major global exchanges”, ilhali mbinu ya §3.1 inaeleza wazi soko la spot la Binance. Katika maelezo ya empiri, §3.1 imechukuliwa kama msingi.
Idadi ya sehemu za OHLC: Chanzo kinasema “five standard fields” lakini kinafafanua sehemu nne kwa namna \([O,H,L,C]\).
Mlinganyo wa portfoliyo: Milinganyo ya uzani na \(V_t\) katika chanzo haijarekebishwa kulingana na formula ya kawaida ya fedha; imewasilishwa kama ilivyochapishwa katika chanzo.
Njia za taarifa za pembeni: Taarifa za side-channel kama order book, rekodi za blockchain na habari zimeachwa nje ya benchmark. Matokeo yanatathmini uwezo wa TSG unaotegemea bei/marejesho, kiasi na vipengele vya kifedha vilivyotokana pekee.
Gharama ya biashara: Katika Predictive Utility na benchmark za msingi, ada ya msingi ni sifuri. Kwa Statistical Arbitrage kuna tukio la ziada lenye ada ya %0.03. Spread, slippage, athari ya soko na gharama zote za uendeshaji zinazotegemea soko hazijamodeliwa kama mazingira kamili ya biashara ya moja kwa moja.
Kazi ya baadaye: Waandishi wanataja kuongeza token mpya, kupanua hadi data za masoko mengi, kuunganisha usanifu wa hali ya juu zaidi wa TSG, model ensemble, mbinu ya model switching inayohisi rejimu na tathmini/urekebishaji wa hyperparameter wa kiotomatiki kama kazi ya baadaye.
Maelezo ya Chanzo na Mbinu
Kichwa asili: CTBench: Cryptocurrency Time Series Generation Benchmark
Waandishi: Yihao Ang; Qiang Wang; Qiang Huang; Yifan Bao; Xinyu Xi; Anthony K. H. Tung; Chen Jin; Zhiyong Huang.
Toleo la chanzo lililopakiwa: arXiv:2508.02758v1, 3 Agosti 2025.
Hali ya uchapishaji ya PDF iliyopakiwa: Preprint. PDF ina vishikilia nafasi vya kiolezo kama “ACM Conference, XXX-XXX, 2020” na “doi:XX.XX/XXX.XX”; hizi si taarifa halisi za konferensi au DOI halisi.
Hali ya sasa ya uchapishaji: Utafiti huo huo baadaye ulichapishwa kama makala ya konferensi iliyopitiwa na wahakiki katika International Conference on Learning Representations 2026 (ICLR 2026). Maelezo makuu ya kisayansi yameandaliwa kutoka preprint ya v1 iliyopakiwa; toleo la sasa limetumiwa tu kuthibitisha utambulisho wa uchapishaji/uhakiki.
Taasisi za waandishi — toleo lililopakiwa: Yihao Ang, Qiang Wang, Yifan Bao, Xinyu Xi, Anthony K. H. Tung, Chen Jin na Zhiyong Huang — National University of Singapore. Qiang Huang — Harbin Institute of Technology (Shenzhen).
Mwandishi wa mawasiliano: Katika arXiv v1 iliyopakiwa hakuna alama tofauti ya corresponding author inayoonekana. Katika toleo la baadaye la ICLR 2026, Qiang Huang ameonyeshwa kama corresponding author.
DOI: PDF iliyopakiwa haitoi DOI halisi ya uchapishaji, inaonyesha DOI ya kishikilia nafasi pekee. Kwa hiyo maandishi ya kishikilia nafasi hayajatumika kama DOI.
Rekodi rasmi ya preprint: https://arxiv.org/abs/2508.02758
Toleo lililopitiwa na wahakiki: ICLR 2026 Conference Proceedings.
Aina ya chanzo: Faili lililopakiwa ni preprint; toleo la sasa lililopitiwa na wahakiki la utafiti huo huo ni makala ya konferensi.
Leseni / hali ya hakimiliki: PDF ya v1 iliyopakiwa ina maandishi yasiyokamilika ya kiolezo cha hakimiliki cha ACM na hakuna leseni wazi ya Creative Commons inayoonekana kwa matumizi tena. Kwa hiyo taswira ya kisayansi ndani ya makala imeundwa upya kama SVG huru kutokana na mahusiano ya mbinu yaliyoelezwa wazi, badala ya kuwa nakala ya pikseli ya kielelezo cha chanzo.
Data: Januari 2020–Desemba 2024 data za kila saa za Binance spot USDT; mali 452 za kripto baada ya uchunguzi wenye data zinazokosekana kuchujwa.
Mbinu kuu: Benchmark ya Time Series Generation; tathmini ya majukumu mawili ya Predictive Utility na Statistical Arbitrage.
Familia ya modeli: GAN, VAE, diffusion, flow na usanifu mseto.
Modeli zilizojaribiwa: Quant-GAN, COSCI-GAN, TimeVAE, KoVAE, Diffusion-TS, FIDE, Fourier-Flow na LS4.
Modeli ya utabiri: XGBoost katika jukumu la Predictive Utility.
Modeli ya Statistical Arbitrage: Mchakato wa Ornstein–Uhlenbeck juu ya mabaki ya TSG reconstruction; kizingiti cha ishara ya biashara γ = 2.
Vipimo vya tathmini: MSE, MAE, IC, IR, CAGR, Sharpe Ratio, MDD, VaR, ES, Training Time na Inference Time vinavyofafanuliwa wazi katika §3.4. Kwa kuwa sehemu nyingine za chanzo pia zinatoa jumla kama 12 na 13, kutothabiti kwa hesabu kumeachwa wazi.
Vifaa vya majaribio: Intel Xeon Platinum 8480C @ 3.80 GHz, 64 GB RAM na NVIDIA H100 GPU.
Ufadhili: Preprint iliyopakiwa haina funding statement tofauti.
Mgongano wa maslahi: Preprint iliyopakiwa haina conflicts of interest statement tofauti.
Kamati ya maadili / mshiriki binadamu: Kwa kuwa utafiti unatumia data za kihistoria za soko na benchmark ya modeli za ukokotoaji, hautegemei jaribio lenye washiriki binadamu; preprint iliyopakiwa haina sehemu tofauti ya kamati ya maadili.
Upatikanaji wa data/msimbo: Chanzo kinafafanua CTBench kama benchmark ya chanzo huria na rasilimali ya data; PDF ya v1 iliyopakiwa haina sehemu tofauti ya Data Availability Statement.
Michango ya waandishi: Preprint ya v1 iliyopakiwa haina CRediT wala sehemu tofauti ya michango ya waandishi.
Kikomo kikuu cha kisayansi: CAGR, Sharpe, drawdown na mikondo ya mtaji katika ripoti ni matokeo ya benchmark/backtest yaliyoundwa kwa data za kihistoria; si dhamana kwamba utendaji uleule utapatikana kwa mtaji halisi siku zijazo wala si ushahidi wa biashara ya moja kwa moja.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *