


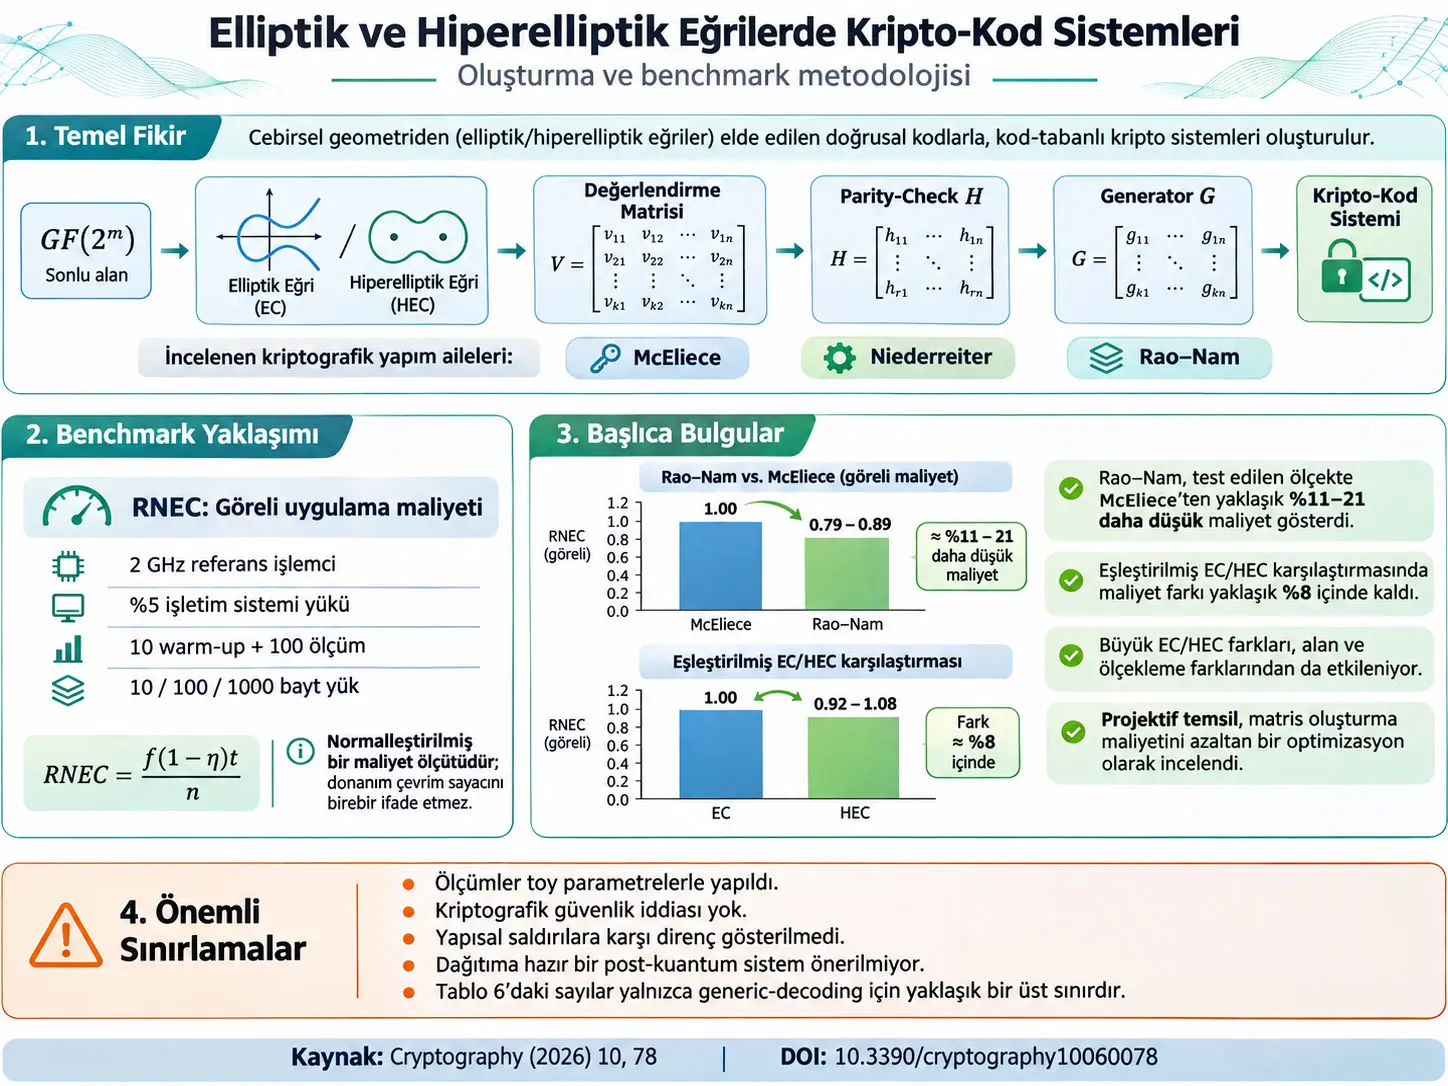
Kripto-kod sistemi (crypto-code construction, CCC), hata düzeltici kodların cebirsel yapısını kriptografik dönüşümle birleştiren bir sistemdir. Bu çalışma yeni bir McEliece, Niederreiter veya Rao–Nam primitive'i geliştirmemekte; elliptik eğrilerden (EC) ve genus-2 hiperelliptik eğrilerden (HEC) türetilmiş cebirsel-geometrik kodların nasıl kurulacağını, değerlendirme ve parity-check matrislerinin nasıl üretileceğini ve aynı kontrollü ölçüm protokolü altında McEliece ile Rao–Nam gerçekleştirimlerinin maliyetinin nasıl karşılaştırılacağını tanımlayan yeniden üretilebilir bir metodoloji sunmaktadır.
Çalışmanın deneysel benchmarkları kriptografik güvenlik için seçilmiş parametrelerle yapılmamıştır. Ölçülen üç temel kod yapılandırması hata ağırlığı \(t_e=1\) olan toy parametrelerdir ve yazarlar bunların hiçbir kriptografik güvenlik sağlamadığını açıkça belirtmektedir. Bu parametrelerin amacı, sistemlerin güvenliğini göstermek değil, aynı kod ailesi ve aynı ölçüm protokolü altında gerçekleştirim maliyetini karşılaştırmaktır.
Kontrollü şema karşılaştırmasının en sağlam sonucu, aynı eğri ailesi ve aynı kod kullanıldığında simetrik Rao–Nam gerçekleştirimlerinin benchmarkta McEliece'den daha ucuz olmasıdır. Kaynak Tablo 2'de McEliece/Rao–Nam RNEC oranı HEC dalında 1,176–1,251; EC dalında 1,118–1,258 aralığındadır. Yazarların yorumu, test edilen toy ölçekte Rao–Nam'ın yaklaşık %11–21 daha düşük uygulama maliyeti göstermesidir. Bu fark kriptografik ölçekte aynı oranın korunacağını kanıtlamaz.
Elliptik ve hiperelliptik eğrilerin doğrudan performans karşılaştırması ise başlangıç tasarımında kontrol altında değildir. EC dalı 10, 100 ve 1000 bayt yüklerde sırasıyla GF(4), GF(8) ve GF(64) üzerinde farklı kodlara geçerken HEC dalı aynı genus-2, \((7,4)\), GF(4) kodunu çoklu blok halinde tekrar kullanmaktadır. Bu nedenle 1000 baytta görülen büyük EC/HEC oranları eğri ailesinin saf etkisi değildir. Daha sonra bütün diğer değişkenler sabitlenerek yapılan matched comparison'da genus-1 ve genus-2 gerçekleştirimlerinin maliyetleri %8 içinde kalmıştır.
Güvenlik açısından çalışma daha da ihtiyatlıdır. Tablo 6'da generic information-set decoding için yaklaşık 77, 95 ve 260 bit gibi referans değerler hesaplanmasına rağmen yazarlar bunları gerçek güvenlik seviyesi olarak kabul etmemektedir. Cebirsel-geometrik kodların yapısına yönelik Schur-product ve filtration saldırılarının maliyeti belirlenmemiştir; dolayısıyla çalışmada deployment-ready herhangi bir post-kuantum parametre seti önerilmemektedir.
Çalışma enerji tüketimini doğrudan ölçmemiştir. Projektif koordinat kullanımı, küçük Galois alanlarında çalışma ve simetrik Rao–Nam yapısı hesaplama maliyetini azaltabilecek mühendislik seçenekleri olarak incelenmektedir; gerçek enerji tüketiminin cihaz ve platform bazında ayrıca ölçülmesi gerekmektedir.
Çalışmanın bilimsel problemi nedir?
McEliece ve Niederreiter gibi kod tabanlı açık anahtarlı kriptosistemlerin güçlü yönlerinden biri, güvenlik varsayımlarının hata düzeltici kodlarda genel decoding problemlerine dayanmasıdır. Bunun önemli mühendislik bedellerinden biri ise büyük public key'ler, büyük generator/parity-check matrisleri ve decoding maliyetidir. Kaynak özellikle mobil, gömülü ve sınırlı hesaplama kaynaklarına sahip sistemlerde bu maliyetin azaltılmasını araştırmaktadır.
Çalışma iki ana fikri birleştirir. Birincisi, kod yapısının elliptik veya hiperelliptik eğrilerin rasyonel noktalarından oluşturulmasıdır. İkincisi, aynı oluşturma ve benchmark metodolojisinin McEliece gibi asimetrik ve Rao–Nam gibi simetrik crypto-code construction'lara uygulanmasıdır.
Burada önemli bir ayrım vardır: elliptik veya hiperelliptik eğriler elliptic-curve discrete logarithm tabanlı bağımsız kriptosistem olarak kullanılmamaktadır. Eğriler, cebirsel-geometrik kodun rasyonel noktalarını, divisor yapısını, evaluation set'ini ve matrislerini oluşturmak için kullanılmaktadır. Asıl güvenlik varsayımı gizlenmiş yapılandırılmış kodun decoding güçlüğüdür.
Çalışmanın yeniliği nedir?
McEliece, Niederreiter ve Rao–Nam şemaları kaynak tarafından klasik ve önceden var olan yapılar olarak kabul edilmektedir. Elliptik ve hiperelliptik eğrilerin cebirsel-geometrik kodlarda kullanımı da tamamen yeni değildir. Makalenin özgün katkısı; belirli parametrelerden EC ve HEC için evaluation/parity-check matrislerini yeniden üretilebilir biçimde oluşturan prosedür, dört scheme-family kombinasyonuna değiştirilmeden uygulanan tek benchmark protokolü ve generic-decoding sınırının güvenlik kapsamı açıkça belirtilerek birlikte raporlanmasıdır.
Sonlu Galois alanı GF(\(2^m\)) nedir?
\(\mathrm{GF}(2^m)\), tam olarak \(2^m\) elemanı bulunan sonlu bir alandır. Kaynak bu alanı indirgenemez bir polinom ve \(1,x,x^2,\ldots,x^{m-1}\) canonical bazıyla tanımlar. Karakteristik 2 olduğu için toplama işlemleri bit düzeyinde XOR ile gerçekleştirilebilir; bu durum donanım ve yazılım gerçekleştiriminde büyük karakteristikli tamsayı aritmetiğine göre farklı maliyet özellikleri oluşturabilir.
Bu denklem, alan elemanının bit vektörünün bir tamsayı biçiminde serialize edilmesini gösterir. \(v_i\) her bit katsayısını, \(m\) alan derecesini temsil eder. Denklem bir güvenlik seviyesi hesaplamaz; yalnız finite-field elemanının bilgisayarda temsil edilmesine ilişkin kodlama ilişkisidir.
Elliptik eğri bu çalışmada nasıl tanımlanıyor?
Kaynak, \(\mathrm{GF}(q)\) üzerinde genus \(g=1\) olan düzgün elliptik eğriyi genel Weierstrass biçimiyle verir:
Burada \(a_1,a_2,a_3,a_4,a_6\), \(\mathrm{GF}(q)\) alanının elemanlarıdır. Bu affine gösterimdir.
Aynı eğrinin projektif biçimi:
Projektif koordinatlar \((X:Y:Z)\), affine düzleme ek olarak infinity point'i de tutarlı cebirsel yapı içinde ifade etmeye olanak verir.
Projektif Koordinatlar Bu Çalışmada Neden Kullanılıyor?
Projektif koordinatlar, kaynak çalışmada evaluation ve parity-check matrislerinin oluşturulması sırasında affine normalizasyonun gerektirdiği \(\mathrm{GF}(2^m)\) alan terslerini azaltmak veya ortadan kaldırmak için kullanılan hesaplama temsilidir; bu dönüşüm kodun güvenlik varsayımını güçlendiren yeni bir kriptografik problem değil, uygulama maliyetini düşürmeyi amaçlayan bir koordinat değişimidir.
Affine nokta \((x,y)\), projektif kapanışta \((X:Y:Z)\) biçiminde ifade edilir. Kaynak özellikle bu isomorphism'in Abel–Jacobi map ile karıştırılmaması gerektiğini belirtmektedir. Eğrinin Jacobian'ına yeni bir güvenlik varsayımı taşınmamaktadır.
Çalışmada affine noktalar için normalize edilmiş temsil \(Z=1\), infinity point için ise \((0:1:0)\) kullanılmaktadır. Bu sabit temsil, evaluation matrix içinde kullanılan monomial'ların aynı homogeneous degree'e sahip olmaması nedeniyle önemlidir.
Hiperelliptik eğri nasıl tanımlanıyor?
Karakteristik 2'de kullanılan genel hiperelliptik eğri biçimi:
Burada \(h(x)\in \mathrm{GF}(2^m)[x]\) ve \(\deg h\le g\); \(f(x)\) normalize edilmiş bir polinomdur ve \(\deg f=2g+1\) veya \(2g+2\) olabilir. \(g\), eğrinin genus değeridir.
Benchmarkta kullanılan HEC örneği genus \(g=2\), GF(4) üzerindedir. Kaynağın verdiği özel model:
Alan:
ve jeneratör için:
Kaynak bu özel parametrizasyonda yedi rasyonel nokta elde etmektedir:
Bu yedi nokta bütün genus-2 GF(4) eğrilerinin zorunlu özelliği değildir. Yedi nokta yalnız benchmarkta kullanılan özel eğri parametrizasyonuna aittir.
Hasse–Weil sınırı neyi belirliyor?
\(N\), eğri üzerinde bulunabilecek rasyonel nokta sayısının üst sınırını; \(q\), finite field büyüklüğünü; \(g\), genus'u temsil eder. Genus arttıkça aynı alan üzerinde kullanılabilecek nokta sayısı için üst sınır büyür.
Örneğin kaynak GF(4) için genus 2'de üst sınırı 13, genus 3'te 17 olarak verir. Bu artış daha uzun kod oluşturma olanağı sağlayabilir; fakat daha yüksek genus otomatik olarak daha iyi kod veya daha yüksek kriptografik güvenlik anlamına gelmez.
Genus arttığında ne değişiyor?
Kaynak dört etkiyi birlikte tartışmaktadır:
- Kod uzunluğu: Hasse–Weil üst sınırı genus ile büyür; aynı field üzerinde daha fazla rasyonel nokta mümkün olabilir.
- Minimum mesafe: genus büyümesi tasarlanan minimum mesafe garantisini azaltabilir.
- Aritmetik maliyet: Mumford representation en fazla \(2g\) field element gerektirir; Cantor reduction maliyeti genus arttıkça yükselir.
- Güvenlik: yüksek genus yapısal kod saldırılarını ortadan kaldırmaz; kaynak yüksek genus'un otomatik güvenlik artışı sağlamadığını açıkça belirtir.
Minimum mesafe–genus değiş tokuşu
Riemann–Roch boyutu:
ve Goppa mesafe alt sınırı:
birlikte kullanıldığında:
elde edilir. \(n-k+1\), Singleton bound tarafındaki referans terimdir. Kaynağın yorumu, kodun garanti edilen minimum mesafesinin Singleton bound'dan genus kadar aşağıda kalmasıdır. Bu nedenle genus ile daha fazla rasyonel nokta kazanılırken minimum mesafe garantisinden bedel ödenebilir.
Kaynak temel algebraic decoding için düzeltilebilir hata sayısını:
biçiminde verir. Bu da genus büyümesinin yalnız kod uzunluğunu değil decoding radius'u da etkilediğini göstermektedir.
Divisor nedir?
Divisor, eğri üzerindeki noktaların sonlu tamsayı katsayılı biçimsel toplamıdır:
Divisor, bir rational function'ın nerede sıfır veya kutup taşıdığını ve bunun multiplicity değerini kaydetmek için kullanılan cebirsel bir nesnedir.
Derecesi:
şeklinde tanımlanır.
Bir rational function \(f\)'nin principal divisor'u:
biçimindedir. \(v_P(f)\), \(P\) noktasındaki zero/pole valuation bilgisini taşır.
Jacobian bu çalışmada ne işe yarıyor?
Degree-zero divisor sınıfları:
ile temsil edilmektedir. Kaynak Jacobian'ı rasyonel noktaların, reduced divisor'ların ve kod tanımlayıcı divisor'un düzenli biçimde seçilebilmesini sağlayan construction and parameterization tool olarak kullanır.
Çalışmanın güvenliği hyperelliptic-curve discrete logarithm problemine dayanmaz. Secret, Jacobian üzerinde bir discrete logarithm değil, gizlenmiş code description'dır. Bu nedenle genus \(\ge3\) HEC discrete logarithm için bilinen index-calculus iyileştirmeleri ile burada kullanılan code-based hardness varsayımı birbirine karıştırılmamalıdır.
Riemann–Roch uzayı ve evaluation code
\(L(G)\), kutupları divisor \(G\) tarafından sınırlandırılan rational function'ların uzayıdır.
Evaluation divisor:
şeklinde kurulur. Destek kümelerinin kesişmemesi, \(L(G)\)'deki fonksiyonların evaluation noktalarında düzgün biçimde değerlendirilebilmesini sağlar.
Evaluation map:
ve buna karşılık gelen evaluation code:
biçimindedir.
Kaynağın constructive code tanımı
Çalışmada gerçek benchmark kodu doğrudan:
şeklinde tanımlanır ve \(G\), bu kernel'in bir bazını oluşturan satırlardan oluşturulur. Doğrulanan koşullar:
şeklindedir.
HEC genus-2 GF(4) benchmarkında ve matched genus-1 benchmarkında \(n=7\), \(k=4\), \(\operatorname{rank}(G)=4\), \(\operatorname{rank}(H)=3\) ve \(HG^T=0\) tam olarak doğrulanmıştır.
Ancak kaynak önemli bir sınır koyar: oluşturulan \(C=\ker(H)\) kodunun mutlaka daha önce tanımlanan belirli \(C_L(D,G)\) evaluation code ile birebir aynı olduğu veya seçilen satırların cebirsel-geometrik dual \(C_\Omega(D,G)\) kodunu gerçekleştirdiği iddia edilmemektedir. Bu correspondence çalışmada ispatlanmamıştır.
McEliece yapısında masking
Kaynak McEliece dalında secret masking matrislerini \(X\), \(P\) ve bazı değiştirilmiş yapılarda \(D\) ile tanımlar. Public generator matrix genel olarak masked code generator üzerinden oluşturulur.
Kaynakta codogram için verilen temel ilişki:
\(i\), \(k\)-sembollü information vector; \(G_X\), masked public generator matrix; \(e\), ağırlığı decoding kapasitesiyle sınırlanan gizli hata vektörüdür. Encryption, geçerli bir codeword üzerine kontrollü hata ekler.
Niederreiter yapısı
Niederreiter yapısında confidential information doğrudan error vector üzerinden syndrome olarak temsil edilir:
\(H_X\), masked parity-check matrix; \(e\), uzunluğu \(n\) ve ağırlığı \(t\)'yi aşmayan error vector'dür. McEliece codeword tabanlı ifade kullanırken Niederreiter syndrome tabanlı ifade kullanmaktadır.
Rao–Nam yapısı
Klasik Rao–Nam encryption:
biçimindedir. \(I\), plaintext information vector; \(G\), generator matrix; \(e\), random error vector'dür.
Değiştirilmiş yapı, ayrıca bir permutation matrix \(Z\) kullanır:
Kaynak bu yapının public-key matrix işlemlerinden kaçınabilmesi nedeniyle daha düşük işlem maliyetine sahip olabileceğini tartışmaktadır.
Bununla birlikte klasik Rao–Nam'ın güvenlik geçmişi problemsiz değildir. Kaynak unmodified Rao–Nam için chosen-plaintext attack hassasiyetini ve yapısal saldırı problemlerini açıkça belirtmektedir. Dolayısıyla benchmarktaki düşük maliyet, tek başına deployment güvenliği anlamına gelmez.
Flawed code ve MV2 mekanizması nedir?
Kaynak “flawed code” terimini kontrollü biçimde hasarlanmış/kayıplı bilgi temsilini tanımlamak için kullanmaktadır. MV2 yaklaşımında orijinal bilgi, birbirine bağımlı damage sequence ve damaged text parçalarına ayrılır; kaynak tek parçanın tek başına plaintext'i geri getirmek için yeterli olmadığını belirtmektedir.
Bu yapının amacı multi-channel cryptography ve uygulama maliyetinin ayarlanmasıdır. Ancak kaynakta kullanılan toy benchmarklar, bu mekanizmanın cryptographically secure deployment seviyesini kanıtlamamaktadır.
LDPC yaklaşımı
Çalışma McEliece için ikinci bir kod yaklaşımı olarak Low-Density Parity-Check (LDPC) kodlarını da inceler. Decoding, Belief Propagation / Sum–Product Algorithm ile gerçekleştirilir. Yazılım uygulaması log-likelihood ratio (LLR) mesajlarını variable node ve check node arasında iteratif olarak taşır.
Kaynak algoritmasında check-node güncellemesinde \(\tanh\) değerleri çarpılır ve inverse hyperbolic tangent uygulanmadan önce oran, sayısal kararlılık için yaklaşık \((-1+10^{-10},1-10^{-10})\) aralığında clip edilir. Varsayılan maksimum iterasyon 50'dir. Zero syndrome elde edildiğinde algoritma erken sonlanır.
Kaynak LDPC'nin AWGN tipi iletişim kanallarındaki iteratif decoding verimliliğini kabul etmekle birlikte graph-related veri yapılarının bellek gereksinimini ve QC-LDPC/QC-MDPC yapılarındaki structural cryptanalysis risklerini ayrıca tartışmaktadır.
Çalışmanın Yöntemi ve Bulguları
Deney ve yazılım ortamı
Yazarların computational experiments uygulaması Python 3.12.5 ve SageMath kullanılarak gerçekleştirilmiştir. Controlled performance evaluation için 2 GHz single-core reference processor ve %5 background operating-system load tanımlanmıştır.
| Parametre | Kaynak değeri | Bilimsel rol |
|---|---|---|
| Referans işlemci | 2 GHz, single core | RNEC normalizasyon referansı |
| Arka plan OS yükü | %5 | Normalize edilen kullanılabilir işlemci payı |
| Warm-up | 10 çalışma | Ölçüm istatistiğine alınmaz |
| Ölçüm | 100 tekrar / hücre | Mean, SD, CV, CI, median ve IQR üretir |
| Zamanlayıcı | perf_counter_ns | Wall-clock execution time |
| Error weight | \(t_e=1\) | Toy benchmark parametresi |
| Payload | 10, 100, 1000 byte | Üç workload noktası |
| Base PRNG seed | 2026 | Deterministik reproducibility |
Kaynak base seed 2026'yı görevler arasında deterministik olarak bölmektedir: candidate search için +101, key generation için +202, matrix generation için +303 ve encryption için +10.000.
Bir benchmark trial, yalnız encrypt–decrypt çiftini zamanlar. Key generation ve matrix construction ölçüm penceresinin dışındadır. Bu sınır RNEC sonuçlarının yorumunda önemlidir.
RNEC Neyi Ölçer ve Neyi Ölçmez?
Reference-Normalized Execution Cost (RNEC), çalışmada encrypt–decrypt işleminin wall-clock süresini 2 GHz referans frekansı ve %5 arka plan OS yükü üzerinden plaintext baytı başına normalize eden göreli bir maliyet metriğidir; hardware performance counter kullanılmadığı için gerçek CPU cycle count veya platformdan bağımsız “cycles per byte” ölçümü değildir.
Kaynak Denklem (32):
Burada:
- \(f=2\times10^9\ \mathrm{Hz}\): referans işlemci frekansı.
- \(\eta=0.05\): %5 background OS load.
- \(1-\eta=0.95\): ölçülen işlem için varsayılan kullanılabilir işlemci payı.
- \(t_{\mathrm{exec}}\): saniye cinsinden ölçülen wall-clock çalışma süresi.
- \(n_{\mathrm{bytes}}\): işlenen plaintext boyutu.
\(f\times t_{\mathrm{exec}}\) boyutsal olarak referans çevrim eşdeğeri üretir ve bunun byte sayısına bölünmesi normalize maliyet verir. Ancak bu değer gerçek performance-counter cycle ölçümü değildir. Cache davranışı, microarchitecture, dynamic frequency scaling, OS scheduling ve Python/SageMath runtime etkileri bu normalizasyonla ortadan kalkmaz.
Kaynak per-codeword/per-block ölçümü için ayrıca:
ifadesini kullanmaktadır. Bu ikinci dönüşüm farklı block payload'larının yarattığı amortization etkisini azaltmayı amaçlar; fakat EC ve HEC dallarının farklı ölçeklenme stratejilerini eşitlemez.
Benchmark yapılandırmaları neden simetrik değil?
EC dalında payload büyüdükçe intrinsic code ve field birlikte değiştirilmiştir:
| Payload | EC dalı | HEC dalı |
|---|---|---|
| 10 byte | EC(7,4), GF(4) | HEC(7,4), genus 2, GF(4) |
| 100 byte | EC(13,10), GF(8) | Aynı HEC(7,4)/GF(4), multiblock |
| 1000 byte | EC(55,52), GF(64) | Aynı HEC(7,4)/GF(4), multiblock |
Dolayısıyla eğri ailesi, field size, code dimension ve batching strategy aynı anda değişmektedir. İlk EC–HEC karşılaştırması bu nedenle bir curve-family experiment değildir.
Tablo 1 — RNEC per block
| Yapılandırma | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| Rao–Nam / EC | 19.693 ± 612 | 26.149 ± 581 | 165.963 ± 1.569 |
| McEliece / EC | 24.776 ± 85 | 32.271 ± 347 | 185.541 ± 7.755 |
| Rao–Nam / HEC, GF(4) sabit | 22.299 ± 1.264 | 19.861 ± 1.075 | 19.570 ± 354 |
| McEliece / HEC, GF(4) sabit | 26.220 ± 279 | 24.821 ± 567 | 24.476 ± 470 |
Kaynak bütün hücrelerde 100 retained repetition kullanmaktadır. Tablo 1'de coefficient of variation %0,3 ile %5,7 arasında raporlanır. 95% confidence interval'ın yarı genişliği hiçbir hücrede mean'in %1,2'sini geçmemektedir.
Kaynak ayrıca mean/median oranının on iki hücrenin hiçbirinde 1,011'i aşmadığını belirtir. Figure 13 histogramları da aynı retained per-run örneklerini gösterir. Bu durum görülen ortalamaların birkaç uç örnek tarafından sürüklenmediğine işaret eder; fakat RNEC'nin platform-normalization kaynaklı sistematik belirsizliğini ortadan kaldırmaz.
McEliece ve Rao–Nam karşılaştırması
| Eğri ailesi | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| HEC | 1,176 ± 0,013 | 1,250 ± 0,014 | 1,251 ± 0,006 |
| EC | 1,258 ± 0,008 | 1,234 ± 0,006 | 1,118 ± 0,009 |
Kaynağın yorumu, Rao–Nam'ın bu benchmarkta bütün payload noktalarında McEliece'den yaklaşık %11–21 daha ucuz olduğudur. HEC dalında tasarruf yaklaşık %15, %20 ve %20; EC dalında ise field GF(4)'ten GF(64)'e büyüdükçe yaklaşık %20,5'ten %10,6'ya düşmektedir.
Bu karşılaştırma curve-family comparison'dan daha güçlüdür; çünkü aynı aile içindeki McEliece ve Rao–Nam aynı code, field ve payload kullanmaktadır. Böylece değişen temel faktör kriptografik şemadır.
Ancak \(k=4\), \(t_e=1\) gibi toy parametreler nedeniyle aynı yüzde oranının cryptographic-scale code'larda korunacağı gösterilmemiştir.
İlk EC–HEC karşılaştırması
| Şema | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| McEliece | 0,945 ± 0,002 | 1,300 ± 0,006 | 7,580 ± 0,068 |
| Rao–Nam | 0,883 ± 0,011 | 1,317 ± 0,015 | 8,480 ± 0,034 |
Değer 1'in üzerindeyse HEC benchmark configuration daha ucuzdur; 1'in altındaysa EC configuration daha ucuzdur. Ancak 1000 byte'daki 7,580 ve 8,480 oranları “HEC eğrisi intrinsik olarak 7–9× daha hızlıdır” anlamına gelmez. Aynı anda field, code dimension ve batching yöntemi de değişmiştir.
Kaynak içi raporlama notu: çalışmanın sonundaki matched-comparison açıklaması Tablo 3'e atıf yaparken unmatched McEliece oranlarını 0,899; 1,257; 7,424 şeklinde vermektedir. Bu sayılar Tablo 3'teki 0,945; 1,300; 7,580 değerleriyle aynı değildir ve farkın nedeni kaynakta açıklanmamaktadır. Verianla temel nicel kaynak olarak görünür Tablo 3 değerlerini korumaktadır.
Hiperelliptik Eğriler Bu Benchmarkta Elliptik Eğrilerden Daha Hızlı mıdır?
Kaynak böyle genel bir sonuç çıkarmamaktadır; eşleştirilmemiş benchmarkta HEC yapılandırması büyük payloadlarda çok daha ucuz görünse de field, code dimension ve batching strategy birlikte değiştiği için bu fark eğri ailesine atfedilemez, tüm diğer parametreler GF(4), \((7,4)\), \(t_e=1\) altında sabitlendiğinde genus-1 EC ile genus-2 HEC maliyetleri ölçüm çözünürlüğünde yaklaşık %8 içinde kalmıştır.
Eşleştirilmiş EC–HEC karşılaştırması
Kaynak daha sonra confounding faktörlerini kaldırmak için iki dalı da GF(4), \(n=7\), \(k=4\), \(t_e=1\), aynı payload, aynı multiblock batching, aynı decoder path ve aynı measurement protocol ile tekrar çalıştırmıştır. Yalnız genus değişmiştir: EC için \(g=1\), HEC için \(g=2\).
| Yapılandırma | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| McEliece / EC, \(g=1\) | 25.422 ± 1.372 | 25.187 ± 1.041 | 26.032 ± 1.004 |
| McEliece / HEC, \(g=2\) | 27.300 ± 245 | 27.152 ± 1.605 | 25.300 ± 725 |
| Rao–Nam / EC, \(g=1\) | 20.751 ± 1.734 | 21.838 ± 4.513 | 21.144 ± 5.312 |
| Rao–Nam / HEC, \(g=2\) | 22.348 ± 217 | 20.295 ± 1.901 | 20.702 ± 2.129 |
| Şema | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| McEliece | 0,931 ± 0,010 | 0,928 ± 0,013 | 1,029 ± 0,010 |
| Rao–Nam | 0,929 ± 0,015 | 1,076 ± 0,048 | 1,021 ± 0,054 |
Bütün oranlar 1'in yaklaşık %8'i içinde kalmaktadır. Yazarlar bu nedenle ilk eşleştirilmemiş sonuçların hyperelliptic curve family için intrinsik büyük performans üstünlüğü olarak yorumlanmasını geri çekmektedir.
Bu matched comparison da toy parametrelerde yapılmıştır. Sonuç yalnız bu ölçekte genus değişiminin kendi başına belirgin maliyet farkı göstermediğini söyler; cryptographic-length kodlarda aynı sonucun korunacağını kanıtlamaz.
RNEC'nin iki makinedeki yeniden üretilebilirliği
Kaynak protokolü iki farklı makinede çalıştırmıştır. Absolute wall-clock maliyetler beklendiği gibi değişirken Tablo 2'deki scheme-level oranlar iki makine arasında absolute 0,031 içinde uyuşmuştur. Kaynak bunu RNEC'nin mutlak performans metriğinden çok relative comparison metriği olarak yorumlamaktadır.
Generic-decoding baseline nasıl hesaplanıyor?
Code-based construction için generic information-set decoding maliyetinin üst sınırı olarak kaynak klasik Prange iş faktörünü kullanır:
Bu ifade field operation sayısı cinsindedir.
Değişkenler:
- \(n\): kod uzunluğu.
- \(k\): kod boyutu/dimension.
- \(n-k\): parity/syndrome boyutuyla ilişkili fark.
- \(t\): hata ağırlığı.
- \(\binom{n}{t}\): \(n\) pozisyon arasından \(t\) hata konumu seçme kombinasyonu.
Kaynak modern ISD yöntemlerini yaklaşık olarak modellemek için:
kullanır. \(\alpha\) teorik evrensel sabit değildir. Tek bir Classic McEliece binary parameter set üzerinde yaklaşık 143-bit yayımlanmış estimate'e karşı 148-bit sonuç verecek şekilde kalibre edilmiştir.
Kuantum sütunu için kaynak:
şeklinde kaba placeholder kullanır. Makalenin kendisi bunun gerçek achievable quantum attack cost olmadığını ve hangi ISD subroutine'lerinin kuantumlaştırıldığına göre durumun değişeceğini açıkça belirtir.
Error vector candidate sayısı:
ile verilir. \(q\), alphabet/field büyüklüğüdür. Bu sayı brute-force aday uzayını ifade eder.
Tablo 6'daki 260 Bit Gerçek Bir Güvenlik Seviyesi midir?
Hayır. Kaynak 260-bit değerini GF(1024) üzerindeki \((1000,399)\), \(t=298\) referans parametre kümesi için tek bir binary kalibrasyona dayanan yaklaşık generic-decoding baseline olarak raporlamakta; q-ary ISD bağımlılıklarını ve cebirsel-geometrik kodlara yönelik structural attack maliyetini modellemediği için bu değerin gerçek veya deployment-ready güvenlik seviyesi olmadığını açıkça belirtmektedir.
| Parametre kümesi | Sınıf | \(\log_2|E_t|\) | \(WF_{\mathrm{ISD}}\) | \(WF_{\mathrm{quantum}}\) | Public key |
|---|---|---|---|---|---|
| HEC (7,4), \(g=2\), GF(4), \(t=1\) | Toy | 4,4 | 6 | 3 | — |
| EC (13,10), GF(8), \(t=1\) | Toy | 6,5 | 8 | 4 | — |
| EC (55,52), GF(64), \(t=1\) | Toy | 11,8 | 11 | 6 | — |
| AG (300,89), \(g=2\), GF(256), \(t=103\) | Reference | 1097,4 | 77 | 39 | 18 KiB |
| AG (300,149), \(g=2\), GF(256), \(t=73\) | Reference | 819,5 | 95 | 47 | 22 KiB |
| AG (1000,399), \(g=2\), GF(1024), \(t=298\) | Generic-decoding reference | 3853,2 | 260 | 130 | 293 KiB |
İlk üç benchmark yapılandırması \(t=1\) olduğundan çok küçük error space'e sahiptir ve kaynak bunları açıkça “no cryptographic security whatsoever” olarak tanımlar.
Son satırdaki 260-bit sayı generic decoding açısından büyük görünse de yalnız generic attack üst sınırıdır. Structured code attack daha ucuzsa gerçek güvenlik onu takip eder.
Yapısal saldırılar neden kritik?
Algebraic-geometric code rastgele lineer code değildir; rasyonel noktalar, function evaluation ve divisor yapısından gelen ek cebirsel izler taşır. Generic-decoding saldırısı bu yapıyı dikkate almaz.
Kaynak Sidelnikov–Shestakov, Faure–Minder ve Couvreur–Marquez-Corbella–Pellikaan çizgisindeki saldırıları tartışmaktadır. Özellikle public code'un component-wise Schur square yapısı structural distinguisher ve filtration attack için kullanılabilir.
ve component-wise product:
olarak tanımlanır.
Algebraic-geometric evaluation code için:
ilişkisi nedeniyle Schur-square dimension rastgele bir code'dan farklı büyüme gösterebilir ve bu fark yapısal saldırıya yol açabilir.
Toy Schur-square testi neden güvenlik kanıtı değildir?
Benchmarkta genus-1 ve genus-2 \((7,4)\) kodlarının Schur square dimension değeri 7 bulunmuştur. Aynı parametrelerde random code için:
olduğundan test random code ile aynı sonucu verir.
Ancak burada üst sınır zaten \(n=7\) tarafından doygunlaştırılmıştır. Bu nedenle testin ayırıcı gücü yoktur. Kaynak açıkça, cryptographic size'da structural distinguisher tarafından ayrılabilecek bir code'un bu toy ölçekte yine de testi geçebileceğini belirtmektedir.
Masking structural saldırıları ortadan kaldırıyor mu?
Kaynak hayır demektedir. Non-singular \(X\) ile çarpma code'un kendisini değiştirmez; monomial \(PD\) dönüşümü Schur-square dimension profile'ını saklayabilir. Shortening cebirsel-geometrik yapıyı korur ve bazı durumlarda code length'i düşürerek saldırgana yardımcı bile olabilir. Plaintext-derived symbol ekleyen extension mekanizmasının da structure-recovery hardness'ını artırdığı gösterilmemiştir.
Deployment öncesinde kaynak hangi güvenlik çalışmalarını zorunlu görüyor?
- Cryptographic-size parametrelerde Schur-square profiling.
- Filtration attack'ın doğrudan uygulanması ve nerede başarısız olduğunun raporlanması.
- Evaluation point, support ve multiplier recovery analizi.
- Best-known structural attack için parameter-dependent work factor.
- Generic-decoding değerlerinin yayımlanmış q-ary syndrome-decoding estimator ile bağımsız hesaplanması.
- Decoding rutinleri constant-time olmadığından açık side-channel leakage modelinin kurulması.
Bu altı çalışma cryptographically meaningful ölçekte tamamlanmadan kaynak herhangi bir parametre kümesini deployment-ready olarak önermemektedir.
Enerji tüketimi ölçüldü mü?
Hayır. Kaynak implementation cost, wall-clock benchmark ve bazı önceki çalışma cycle-count bilgilerini tartışmasına rağmen mevcut deneyde doğrudan enerji ölçümü gerçekleştirmemiştir. Enerji üzerindeki etkinin platforma bağlı olduğu açıkça belirtilmiştir.
Bu nedenle küçük field veya daha az işlem sayısından doğrudan joule, watt veya batarya ömrü sonucu üretilemez.
Tablo 4 neden diğer benchmark tablolarından farklıdır?
Kaynak Tablo 4'te HEC McEliece için character read, string comparison ve string concatenation call count/processor cycle profili vermektedir. Ancak Data Availability Statement, bu call-count ve cycle sayılarını mevcut reproducibility package'ın yeniden üretmediğini; bunların önceki Ref. [3]'ten aktarıldığını açıkça belirtmektedir. Bu nedenle Tablo 4 mevcut benchmark kampanyasının ham zaman örnekleriyle aynı provenance sınıfında değildir.
Çalışmanın desteklediği sonuçlar
- EC ve genus-2 HEC tabanlı code matrices için tekrarlanabilir construction procedure kurulabilmiştir.
- Benchmark kodlarında \(\operatorname{rank}(G)=k\), \(\operatorname{rank}(H)=n-k\) ve \(HG^T=0\) koşulları doğrulanmıştır.
- Projektif temsil, matrix-construction aşamasında field inversion ihtiyacını azaltan hesaplama optimizasyonudur.
- Kontrollü aynı-family karşılaştırmasında Rao–Nam benchmark maliyeti McEliece'den daha düşüktür.
- Measured Rao–Nam avantajı test edilen toy ölçekte yaklaşık %11–21 aralığındadır.
- İlk EC–HEC büyük performans farkı curve family'nin saf etkisi değildir.
- Matched toy comparison'da genus-1 ve genus-2 maliyetleri yaklaşık %8 içinde kalmaktadır.
- Generic-decoding baseline hesaplanmıştır ve structural security'den açıkça ayrılmıştır.
- Reproducibility package, kod, parametreler, matrisler, fixed seeds, raw timings ve work-factor script'lerini içerir.
Çalışmanın desteklemediği sonuçlar
- Benchmarkta kullanılan toy parametrelerin post-kuantum güvenli olduğu sonucu çıkarılamaz.
- 260-bit generic-decoding baseline gerçek 260-bit güvenlik garantisi değildir.
- Hiperelliptik eğrilerin elliptik eğrilerden intrinsik olarak 7–9× daha hızlı olduğu sonucu çıkarılamaz.
- Daha yüksek genus'un structural cryptanalysis'e daha dayanıklı olduğu gösterilmemiştir.
- Projektif koordinatların kodun cebirsel yapısını saldırgandan gizlediği gösterilmemiştir.
- Schur-square testinin toy örnekte random code ile aynı sonuç vermesi structural resistance kanıtı değildir.
- Mevcut çalışma deployment-ready McEliece, Niederreiter veya Rao–Nam parametre seti önermemektedir.
- Çalışma gerçek enerji tüketimini ölçmemiştir.
- RNEC gerçek hardware cycle counter ölçümü değildir.
- Mobil sistemlerde confidentiality/integrity hizmetinin bu parametrelerle production-ready olduğu gösterilmemiştir.
Yeniden üretilebilirlik
Kaynak, açık reproducibility package içinde EC ve HEC gerçekleştirimlerini, curve parameter generation kodunu, evaluation-matrix construction ve decoding rutinlerini; bütün benchmark curve equation ve irreducible polynomial bilgilerini; rational-point ve evaluation set'lerini; generator/parity-check matrislerini; fixed PRNG seeds'i; Algorithm 3 benchmark harness'ini; raw per-run timing samples'ı; Figure 13 üretim script'ini ve Table 6 work-factor estimation script'ini sağladığını bildirmektedir.
Yazılım sürümleri Python 3.12.5 ve SageMath 10.5 olarak raporlanmıştır.
Kaynak Tables 1–3, Table 6 ve Figure 13'ün package script'leri tarafından yeniden üretilebildiğini; absolute RNEC'nin hardware platforma bağlı kaldığını fakat configuration ratio'larının farklı platformlarda yeniden üretilebildiğini belirtmektedir.
Gelecek çalışma sınırı
Yazarların doğrudan devam çalışması, genus \(g=2,3,4\), farklı base fields ve farklı evaluation divisors içeren daha geniş family study'dir. Bu çalışma olmadan benchmarkta kullanılan tek genus-2 GF(4) örneğinin bütün hyperelliptic constructions için temsil edici olduğu söylenemez.
Ayrıca cryptographic-scale structural cryptanalysis, bağımsız q-ary syndrome-decoding estimation, constant-time implementation ve gerçek platform energy measurement gelecekteki doğrulama gereksinimleridir.
Kaynak ve Yöntem Notu
Özgün başlık: Construction and Benchmarking Methodology for Crypto-Code Systems on Elliptic and Hyperelliptic Curves
Yazarlar: Serhii Yevseiev; Stanislav Milevskyi; Serhii Pohasii; Olena Akhiiezer; Vladyslav Sokol.
Yazar sırası: Serhii Yevseiev birinci, Stanislav Milevskyi ikinci, Serhii Pohasii üçüncü, Olena Akhiiezer dördüncü, Vladyslav Sokol beşinci yazardır.
Sorumlu yazar: Serhii Yevseiev.
Kurum: Department of Cybersecurity, National Technical University “Kharkiv Polytechnic Institute”, 61002 Kharkiv, Ukraine.
Eş katkı: Kaynakta eş birinci yazarlık veya eş katkı beyanı bulunmamaktadır.
Dergi: Cryptography.
Yayıncı: MDPI, Basel, Switzerland.
Cilt / sayı / makale: 10(6), Article 78.
Sayfa sayısı: 44.
DOI: 10.3390/cryptography10060078.
Gönderim: 11 Ağustos 2026.
Revizyon: 5 Ekim 2026.
Kabul: 20 Ekim 2026.
Yayın: 27 Ekim 2026.
Kaynak türü: Hakemli araştırma makalesi; cebirsel-geometrik code construction, yazılım gerçekleştirmesi, controlled benchmark ve generic-decoding baseline analizini birleştirmektedir.
Hakemlik: Cryptography hakemli bir dergidir; resmî MDPI dergi materyalleri single-blind peer-review sürecini bildirmektedir.
Preprint durumu: Verianla için işlenen belge yayımlanmış dergi sürümüdür; kaynakta ayrı bir preprint sürümü işlenmemiştir.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Resmî yayın kaydı: MDPI Cryptography, DOI 10.3390/cryptography10060078.
Ana bilimsel alan: Post-kuantum kriptografi, kod tabanlı kriptografi, cebirsel-geometrik kodlar ve sonlu alan hesaplama.
Ana yöntem: EC ve HEC rasyonel noktalarından evaluation/parity-check matrices oluşturulması; \(C=\ker(H)\) üzerinden generator matrix türetilmesi; McEliece ve Rao–Nam gerçekleştirimlerinin aynı benchmark harness altında ölçülmesi.
Benchmark yazılımı: Python 3.12.5 ve SageMath 10.5.
Benchmark protokolü: 2 GHz single-core reference processor, %5 OS load, hücre başına 10 discarded warm-up ve 100 retained run, \(t_e=1\), 10/100/1000-byte payload ve perf_counter_ns wall-clock timer.
RNEC yorumu: Reference-normalized relative execution cost'tur; gerçek hardware cycle-count değildir.
Benchmark güvenlik sınıfı: Ölçülen parametreler toy parametrelerdir ve kaynak tarafından cryptographic security taşımadığı açıkça belirtilmiştir.
Generic-decoding analizi: Prange work factor ve tek binary calibration point üzerinden \(\alpha=0.85\) düzeltmesi kullanılmış illustrative baseline'dır; q-ary quantitative security estimate değildir.
Structural security: Cryptographic-scale Schur-product/filtration resistance gösterilmemiştir; hiçbir parametre deployment-ready olarak sunulmamaktadır.
Enerji ölçümü: Mevcut çalışmada doğrudan enerji tüketimi ölçülmemiştir.
Finansman: Araştırma dış finansman almamıştır.
Veri erişilebilirliği: Kaynak, complete reproducibility package'ın açık olarak sağlandığını; reference implementation, exact curve parameters, irreducible polynomials, rational-point/evaluation sets, generator ve parity-check matrices, fixed PRNG seeds, benchmark harness, raw timing samples, Figure 13 script'i ve Table 6 work-factor estimation script'ini içerdiğini bildirmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir.
Yazar katkıları: Kavramsallaştırma Serhii Yevseiev ve Stanislav Milevskyi; yöntem Serhii Yevseiev ve Stanislav Milevskyi; yazılım Serhii Pohasii ve Vladyslav Sokol; doğrulama Serhii Yevseiev, Stanislav Milevskyi ve Olena Akhiiezer; biçimsel analiz Serhii Yevseiev, Stanislav Milevskyi ve Olena Akhiiezer; araştırma Serhii Yevseiev ve Serhii Pohasii; kaynaklar Serhii Yevseiev ve Vladyslav Sokol; veri düzenleme Serhii Pohasii ve Olena Akhiiezer; ilk taslak Serhii Yevseiev; gözden geçirme/düzenleme Stanislav Milevskyi, Serhii Pohasii ve Olena Akhiiezer; görselleştirme Vladyslav Sokol; danışmanlık ve proje yönetimi Serhii Yevseiev olarak bildirilmiştir.
Temel yöntemsel sınırlılıklar: Toy güvenlik parametreleri; HEC tarafında yalnız tek genus-2 GF(4) eğri örneği; eşleştirilmemiş EC/HEC ölçekleme; RNEC'nin wall-clock tabanlı olması; gerçek cycle counter ve enerji ölçümünün bulunmaması; Table 6 generic-decoding değerlerinin kaba proxy olması; cryptographic-scale structural attack değerlendirmesinin tamamlanmamış olması; decoding rutinlerinin constant-time olmaması; Table 4 cycle/call-count verilerinin mevcut reproducibility package tarafından yeniden üretilmemesi.
Kaynak içi sayısal not: Tablo 3'te McEliece EC/HEC oranları 0,945; 1,300; 7,580 iken çalışmanın son matched-comparison metninde Tablo 3 için 0,899; 1,257; 7,424 değerleri yazılmaktadır. Kaynak farkın nedenini açıklamamaktadır; bu Verianla içeriğinde görünür Tablo 3 değerleri temel alınmış ve fark saklanmamıştır.
Yorum sınırı: Çalışmanın katkısı deployment-ready yeni post-kuantum primitive veya kanıtlanmış yeni security level değil; EC/HEC tabanlı crypto-code construction'ların oluşturulması ve implementasyon maliyetinin yeniden üretilebilir biçimde karşılaştırılmasına yönelik metodolojidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir