


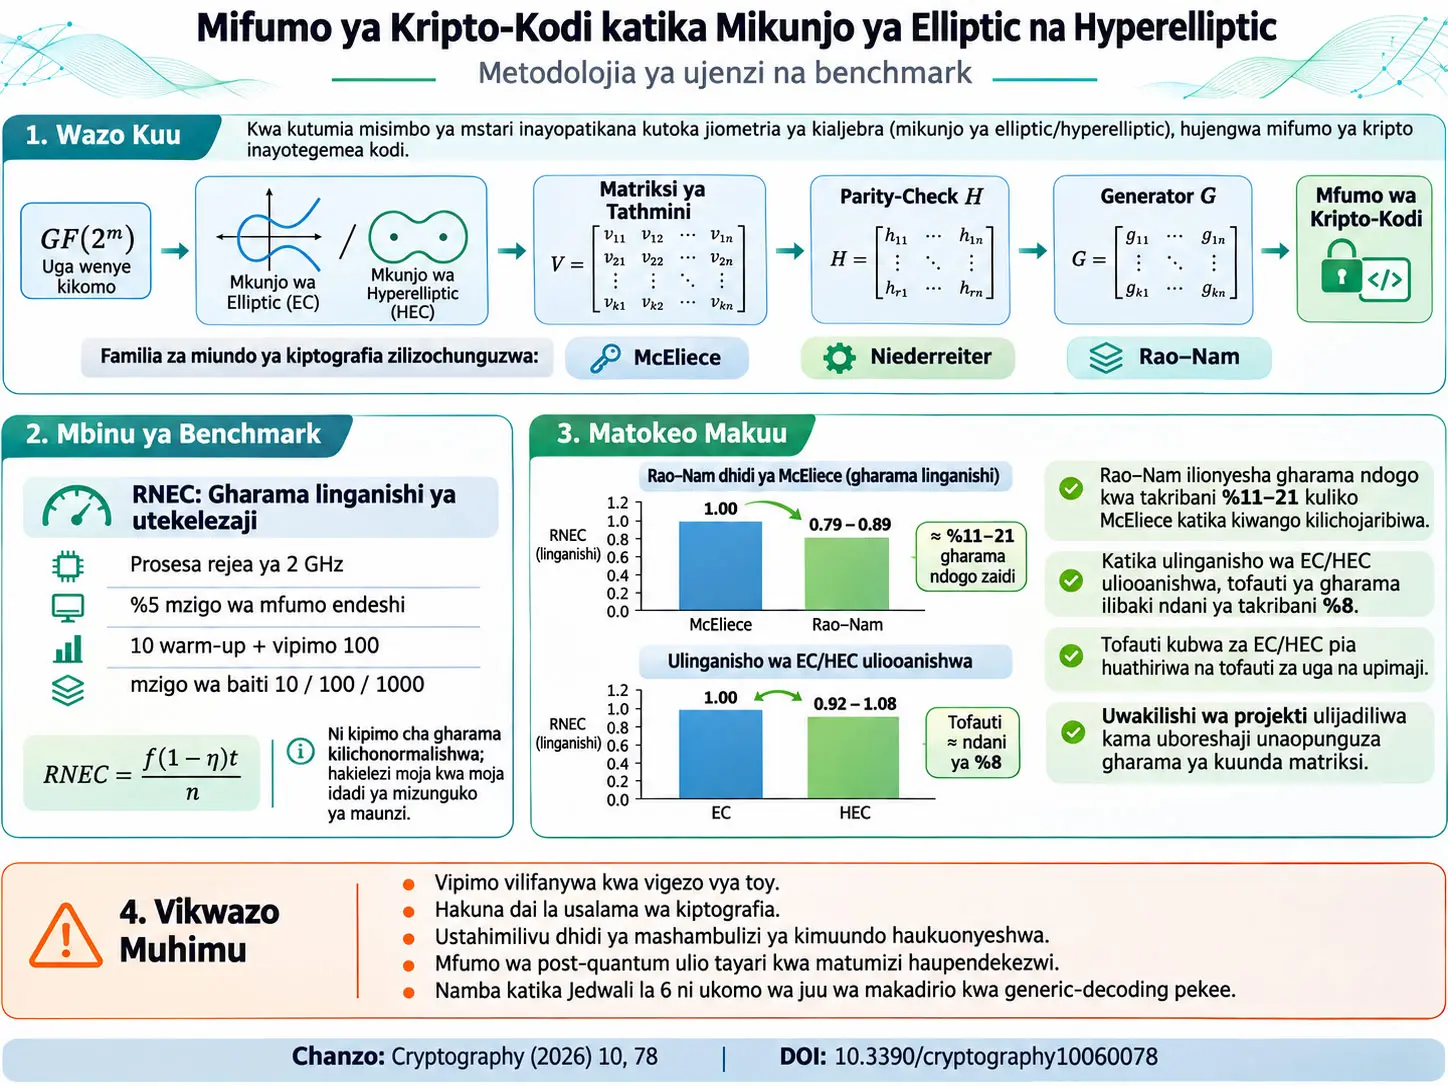
Mfumo wa kripto-kodi (crypto-code construction, CCC) ni mfumo unaounganisha muundo wa kialjebra wa misimbo ya kusahihisha makosa na mabadiliko ya kikriptografia. Utafiti huu hautengenezi primitive mpya ya McEliece, Niederreiter au Rao–Nam; badala yake unawasilisha metodolojia inayoweza kurudiwa inayofafanua jinsi ya kujenga misimbo ya kialjebra-kijiometri inayotokana na mikunjo ya elliptic (EC) na mikunjo ya hyperelliptic ya genus-2 (HEC), jinsi ya kuzalisha matriksi za evaluation na parity-check, na jinsi ya kulinganisha gharama ya utekelezaji wa McEliece na Rao–Nam chini ya itifaki ileile ya kipimo kinachodhibitiwa.
Benchmark za majaribio za utafiti hazikufanywa kwa kutumia vigezo vilivyochaguliwa kwa usalama wa kikriptografia. Mipangilio mitatu ya msingi ya kodi iliyopimwa ni toy parameters zenye uzito wa kosa \(t_e=1\), na waandishi wanasema wazi kwamba hazitoi usalama wowote wa kikriptografia. Lengo la vigezo hivi si kuonyesha usalama wa mifumo, bali kulinganisha gharama ya utekelezaji chini ya familia ileile ya kodi na itifaki ileile ya kipimo.
Matokeo thabiti zaidi ya ulinganisho wa mifumo unaodhibitiwa ni kwamba, familia ileile ya mkunjo na kodi ileile zinapotumiwa, utekelezaji wa Rao–Nam wa kisimetri huwa na gharama ndogo katika benchmark kuliko McEliece. Katika Jedwali 2 la chanzo, uwiano wa McEliece/Rao–Nam RNEC uko katika 1,176–1,251 kwenye tawi la HEC na 1,118–1,258 kwenye tawi la EC. Kwa tafsiri ya waandishi, katika kiwango cha toy kilichojaribiwa Rao–Nam inaonyesha takribani %11–21 ya gharama ndogo ya utekelezaji. Tofauti hii haithibitishi kwamba uwiano huo huo utadumu katika kiwango cha kikriptografia.
Ulinganisho wa moja kwa moja wa utendaji wa mikunjo ya elliptic na hyperelliptic haujadhibitiwa katika muundo wa awali. Tawi la EC linapohamia misimbo tofauti juu ya GF(4), GF(8) na GF(64) kwa mizigo ya 10, 100 na 1000 byte mtawalia, tawi la HEC linatumia tena kodi ileile ya genus-2, \((7,4)\), GF(4) katika hali ya multiblock. Kwa hiyo uwiano mkubwa wa EC/HEC unaoonekana katika 1000 byte si athari safi ya familia ya mkunjo. Baadaye, katika matched comparison ambako vigezo vingine vyote vilidumishwa, gharama za utekelezaji wa genus-1 na genus-2 zilibaki ndani ya %8.
Kwa upande wa usalama, utafiti ni wa tahadhari zaidi. Ingawa Jedwali 6 linakokotoa thamani za marejeo za takribani 77, 95 na 260 bit kwa generic information-set decoding, waandishi hawazichukulii kama viwango halisi vya usalama. Gharama ya mashambulizi ya Schur-product na filtration yanayolenga muundo wa misimbo ya kialjebra-kijiometri haijabainishwa; kwa hiyo hakuna seti ya vigezo vya post-quantum iliyo deployment-ready inayopendekezwa katika utafiti.
Utafiti haukupima matumizi ya nishati moja kwa moja. Matumizi ya kuratibu za projective, kufanya kazi katika nyuga ndogo za Galois na muundo wa Rao–Nam wa kisimetri vinachunguzwa kama chaguo za kihandisi zinazoweza kupunguza gharama ya hesabu; matumizi halisi ya nishati yanahitaji kupimwa kando kwa kila kifaa na jukwaa.
Tatizo la kisayansi la utafiti ni lipi?
Mojawapo ya nguvu za mifumo ya kriptografia ya ufunguo wa umma inayotegemea kodi, kama McEliece na Niederreiter, ni kwamba dhana zake za usalama zinategemea matatizo ya jumla ya decoding katika misimbo ya kusahihisha makosa. Moja ya gharama zake muhimu za kihandisi ni public key kubwa, matriksi kubwa za generator/parity-check na gharama ya decoding. Chanzo kinachunguza hasa kupunguza gharama hii katika mifumo ya simu, embedded na yenye rasilimali chache za kukokotoa.
Utafiti unaunganisha mawazo mawili makuu. Kwanza, muundo wa kodi unajengwa kutoka kwenye pointi za rational za mikunjo ya elliptic au hyperelliptic. Pili, metodolojia ileile ya ujenzi na benchmark inatumika kwa crypto-code construction za asymmetri kama McEliece na za simetri kama Rao–Nam.
Kuna tofauti muhimu hapa: mikunjo ya elliptic au hyperelliptic haitumiki kama cryptosystem huru inayotegemea elliptic-curve discrete logarithm. Mikunjo hutumiwa kuunda pointi za rational za kodi ya kialjebra-kijiometri, muundo wa divisor, evaluation set na matriksi. Dhana kuu ya usalama ni ugumu wa decoding wa kodi yenye muundo iliyofichwa.
Ubunifu wa utafiti ni upi?
Mitindo ya McEliece, Niederreiter na Rao–Nam inachukuliwa na chanzo kuwa miundo ya kawaida na iliyokuwepo kabla. Matumizi ya mikunjo ya elliptic na hyperelliptic katika misimbo ya kialjebra-kijiometri pia si mapya kabisa. Mchango wa asili wa makala ni utaratibu unaoweza kurudiwa wa kuzalisha matriksi za evaluation/parity-check kwa EC na HEC kutoka kwa vigezo maalumu, itifaki moja ya benchmark inayotumiwa bila kubadilishwa kwa michanganyiko minne ya scheme-family, na kuripoti pamoja mpaka wa generic-decoding huku wigo wake wa usalama ukibainishwa wazi.
Uga wenye kikomo wa Galois GF(\(2^m\)) ni nini?
\(\mathrm{GF}(2^m)\) ni uga wenye kikomo wenye vipengele \(2^m\) hasa. Chanzo kinafafanua uga huu kwa polynomial isiyopunguzika na msingi canonical wa \(1,x,x^2,\ldots,x^{m-1}\). Kwa kuwa characteristic ni 2, shughuli za kujumlisha zinaweza kufanywa kwa XOR katika kiwango cha bit; hali hii inaweza kuleta sifa tofauti za gharama katika utekelezaji wa maunzi na programu ikilinganishwa na hesabu ya integer yenye characteristic kubwa.
Mlinganyo huu unaonyesha serialize ya vector ya bit ya kipengele cha uga katika umbo la integer. \(v_i\) inawakilisha coefficient ya kila bit na \(m\) daraja la uga. Mlinganyo hauhesabu kiwango cha usalama; ni uhusiano wa coding wa uwakilishi wa kipengele cha finite-field katika kompyuta.
Mkunjo wa elliptic unafafanuliwaje katika utafiti huu?
Chanzo kinatoa mkunjo laini wa elliptic juu ya \(\mathrm{GF}(q)\) wenye genus \(g=1\) kwa umbo la jumla la Weierstrass:
Hapa \(a_1,a_2,a_3,a_4,a_6\) ni vipengele vya uga \(\mathrm{GF}(q)\). Huu ni uwakilishi wa affine.
Umbo la projective la mkunjo huohuo ni:
Kuratibu za projective \((X:Y:Z)\) huruhusu infinity point kuonyeshwa ndani ya muundo wa kialjebra unaolingana, pamoja na tambarare ya affine.
Kwa Nini Kuratibu za Projective Zinatumika Katika Utafiti Huu?
Kuratibu za projective ni uwakilishi wa kikokotozi unaotumiwa katika utafiti wa chanzo ili kupunguza au kuondoa inverses za uga \(\mathrm{GF}(2^m)\) zinazohitajika na affine normalization wakati wa kuunda matriksi za evaluation na parity-check; mabadiliko haya si tatizo jipya la kikriptografia linaloimarisha dhana ya usalama wa kodi, bali ni mabadiliko ya kuratibu yanayolenga kupunguza gharama ya utekelezaji.
Pointi ya affine \((x,y)\) inaonyeshwa katika projective closure kama \((X:Y:Z)\). Chanzo kinasisitiza hasa kwamba isomorphism hii haipaswi kuchanganywa na Abel–Jacobi map. Hakuna dhana mpya ya usalama inayohamishwa kwenye Jacobian ya mkunjo.
Katika utafiti, uwakilishi uliosawazishwa \(Z=1\) unatumiwa kwa pointi za affine, huku \((0:1:0)\) ikitumika kwa infinity point. Uwakilishi huu wa kudumu ni muhimu kwa sababu monomial zinazotumiwa katika evaluation matrix hazina homogeneous degree ileile.
Mkunjo wa hyperelliptic unafafanuliwaje?
Umbo la jumla la mkunjo wa hyperelliptic linalotumiwa katika characteristic 2 ni:
Hapa \(h(x)\in \mathrm{GF}(2^m)[x]\) na \(\deg h\le g\); \(f(x)\) ni polynomial iliyosawazishwa na \(\deg f=2g+1\) au \(2g+2\). \(g\) ni thamani ya genus ya mkunjo.
Mfano wa HEC unaotumiwa katika benchmark una genus \(g=2\) juu ya GF(4). Modeli maalumu iliyotolewa na chanzo ni:
Uga:
na kwa generator:
Chanzo kinapata pointi saba za rational katika parametarisho hili maalumu:
Pointi hizi saba si sifa ya lazima ya mikunjo yote ya genus-2 GF(4). Pointi saba zinahusu tu parametarisho maalumu la mkunjo lililotumiwa katika benchmark.
Mpaka wa Hasse–Weil unabainisha nini?
\(N\) inawakilisha mpaka wa juu wa idadi ya pointi za rational zinazoweza kuwepo kwenye mkunjo; \(q\) ukubwa wa finite field; \(g\) genus. Genus inapoongezeka, mpaka wa juu wa idadi ya pointi zinazoweza kutumika juu ya uga huohuo huongezeka.
Kwa mfano, chanzo kinatoa mpaka wa juu wa 13 kwa genus 2 na 17 kwa genus 3 kwenye GF(4). Ongezeko hili linaweza kuruhusu uundaji wa kodi ndefu zaidi; lakini genus kubwa zaidi haimaanishi kiotomatiki kodi bora au usalama mkubwa zaidi wa kikriptografia.
Nini hubadilika genus inapoongezeka?
Chanzo kinajadili athari nne kwa pamoja:
- Urefu wa kodi: mpaka wa juu wa Hasse–Weil huongezeka pamoja na genus; pointi zaidi za rational zinaweza kuwepo juu ya field ileile.
- Umbali wa chini: ongezeko la genus linaweza kupunguza dhamana ya umbali wa chini uliobuniwa.
- Gharama ya arithmetic: Mumford representation huhitaji hadi \(2g\) field element; gharama ya Cantor reduction huongezeka genus inapoongezeka.
- Usalama: genus kubwa haiondoi mashambulizi ya muundo wa kodi; chanzo kinasema wazi kwamba genus kubwa haitoi ongezeko la usalama kiotomatiki.
Mbadilishano wa umbali wa chini–genus
Dimension ya Riemann–Roch:
na mpaka wa chini wa umbali wa Goppa:
zinapotumiwa pamoja:
hupatikana. \(n-k+1\) ni neno la marejeo upande wa Singleton bound. Kwa tafsiri ya chanzo, umbali wa chini unaodhaminiwa wa kodi hubaki chini ya Singleton bound kwa kiasi cha genus. Kwa hiyo, wakati pointi zaidi za rational zinapatikana kwa kuongeza genus, gharama hulipwa katika dhamana ya umbali wa chini.
Chanzo kinatoa idadi ya makosa yanayoweza kurekebishwa kwa algebraic decoding ya msingi kama:
Hii inaonyesha kwamba ongezeko la genus haliathiri tu urefu wa kodi bali pia decoding radius.
Divisor ni nini?
Divisor ni jumla formal yenye idadi finite ya pointi za mkunjo zenye coefficients za integer:
Divisor ni kitu cha kialjebra kinachotumiwa kurekodi ni wapi rational function ina zero au pole na multiplicity yake.
Degree yake inafafanuliwa kama:
.
Principal divisor ya rational function \(f\) ni:
. \(v_P(f)\) hubeba taarifa ya zero/pole valuation kwenye pointi \(P\).
Jacobian inatumika kufanya nini katika utafiti huu?
Madarasa ya degree-zero divisor yanawakilishwa na:
. Chanzo kinatumia Jacobian kama construction and parameterization tool inayowezesha uteuzi wa mpangilio wa pointi za rational, reduced divisor na divisor inayofafanua kodi.
Usalama wa utafiti hautegemei hyperelliptic-curve discrete logarithm problem. Secret si discrete logarithm juu ya Jacobian, bali ni code description iliyofichwa. Kwa hiyo maboresho yanayojulikana ya index-calculus kwa HEC discrete logarithm yenye genus \(\ge3\) hayapaswi kuchanganywa na dhana ya code-based hardness inayotumiwa hapa.
Nafasi ya Riemann–Roch na evaluation code
\(L(G)\) ni nafasi ya rational function ambazo poles zake zimewekewa kikomo na divisor \(G\).
Evaluation divisor:
huundwa. Kutokukatana kwa support sets huruhusu functions katika \(L(G)\) kutathminiwa ipasavyo kwenye pointi za evaluation.
Evaluation map:
na evaluation code inayolingana:
.
Ufafanuzi wa constructive code wa chanzo
Katika utafiti, kodi halisi ya benchmark inafafanuliwa moja kwa moja kama:
na \(G\) huundwa kutoka kwa rows zinazounda basis ya kernel hii. Masharti yaliyothibitishwa ni:
.
Katika benchmark ya HEC genus-2 GF(4) na matched genus-1 benchmark, \(n=7\), \(k=4\), \(\operatorname{rank}(G)=4\), \(\operatorname{rank}(H)=3\) na \(HG^T=0\) zimethibitishwa kikamilifu.
Hata hivyo chanzo kinaweka kikomo muhimu: hakidai kwamba kodi iliyoundwa \(C=\ker(H)\) lazima iwe sawa kabisa na evaluation code maalumu ya \(C_L(D,G)\) iliyoelezwa awali, wala kwamba rows zilizochaguliwa zinatekeleza kodi ya dual ya kialjebra-kijiometri \(C_\Omega(D,G)\). Correspondence hii haijathibitishwa katika utafiti.
Masking katika muundo wa McEliece
Chanzo kinafafanua matriksi za secret masking katika tawi la McEliece kwa \(X\), \(P\) na katika baadhi ya miundo iliyobadilishwa kwa \(D\). Public generator matrix kwa ujumla huundwa kupitia masked code generator.
Uhusiano wa msingi uliotolewa katika chanzo kwa codogram ni:
\(i\) ni information vector yenye alama \(k\); \(G_X\) ni masked public generator matrix; \(e\) ni vector ya kosa ya siri ambayo uzito wake umewekewa kikomo na uwezo wa decoding. Encryption huongeza kosa linalodhibitiwa juu ya codeword halali.
Muundo wa Niederreiter
Katika muundo wa Niederreiter confidential information huwakilishwa moja kwa moja kama syndrome kupitia error vector:
\(H_X\) ni masked parity-check matrix; \(e\) ni error vector yenye urefu \(n\) na uzito usiozidi \(t\). McEliece hutumia uwakilishi unaotegemea codeword, huku Niederreiter ikitumia uwakilishi unaotegemea syndrome.
Muundo wa Rao–Nam
Rao–Nam encryption ya kawaida ni:
. \(I\) ni plaintext information vector; \(G\) ni generator matrix; \(e\) ni random error vector.
Muundo uliobadilishwa pia hutumia permutation matrix \(Z\):
Chanzo kinajadili kwamba muundo huu unaweza kuwa na gharama ya chini ya uendeshaji kwa sababu unaweza kuepuka shughuli za public-key matrix.
Hata hivyo, historia ya usalama ya Rao–Nam ya kawaida si bila matatizo. Chanzo kinataja wazi unyeti wa chosen-plaintext attack na matatizo ya mashambulizi ya kimuundo kwa unmodified Rao–Nam. Kwa hiyo gharama ndogo katika benchmark peke yake haimaanishi usalama wa deployment.
Flawed code na utaratibu wa MV2 ni nini?
Chanzo kinatumia neno “flawed code” kuelezea uwakilishi wa taarifa uliodhibitiwa ambao umeharibiwa/una upotevu. Katika mbinu ya MV2 taarifa ya asili hugawanywa katika sehemu zinazotegemeana za damage sequence na damaged text; chanzo kinasema kwamba sehemu moja peke yake haitoshi kurejesha plaintext.
Lengo la muundo huu ni multi-channel cryptography na kurekebisha gharama ya utekelezaji. Hata hivyo toy benchmark zinazotumiwa katika chanzo hazithibitishi kiwango cha cryptographically secure deployment cha utaratibu huu.
Mbinu ya LDPC
Utafiti pia unachunguza misimbo ya Low-Density Parity-Check (LDPC) kama mbinu ya pili ya kodi kwa McEliece. Decoding hufanywa kwa Belief Propagation / Sum–Product Algorithm. Utekelezaji wa programu hupitisha ujumbe wa log-likelihood ratio (LLR) kati ya variable node na check node kwa kurudia.
Katika algorithm ya chanzo, thamani za \(\tanh\) huzidishwa wakati wa sasisho la check-node na kabla ya kutumia inverse hyperbolic tangent, uwiano huwekwa clip takribani katika \((-1+10^{-10},1-10^{-10})\) kwa uthabiti wa namba. Idadi ya juu ya chaguo-msingi ya iterations ni 50. Algorithm hukoma mapema Zero syndrome inapopatikana.
Chanzo kinakubali ufanisi wa iterative decoding wa LDPC katika njia za mawasiliano za aina ya AWGN, lakini pia kinajadili mahitaji ya kumbukumbu ya miundo ya data ya graph-related na hatari za structural cryptanalysis katika miundo ya QC-LDPC/QC-MDPC.
Mbinu na Matokeo ya Utafiti
Mazingira ya majaribio na programu
Utekelezaji wa computational experiments wa waandishi ulifanywa kwa Python 3.12.5 na SageMath. Kwa Controlled performance evaluation, 2 GHz single-core reference processor na %5 background operating-system load zilifafanuliwa.
| Kigezo | Thamani ya chanzo | Jukumu la kisayansi |
|---|---|---|
| Prosesa ya marejeo | 2 GHz, single core | Marejeo ya normalizasheni ya RNEC |
| Mzigo wa OS wa nyuma | %5 | Sehemu inayopatikana ya prosesa inayowekwa kawaida |
| Warm-up | 10 runs | Haijumuishwi katika takwimu za kipimo |
| Kipimo | 100 marudio / seli | Huzalisha Mean, SD, CV, CI, median na IQR |
| Kipima muda | perf_counter_ns | Wall-clock execution time |
| Error weight | \(t_e=1\) | Toy benchmark parameter |
| Payload | 10, 100, 1000 byte | Pointi tatu za workload |
| Base PRNG seed | 2026 | Reproducibility ya kideterministi |
Chanzo hugawa base seed 2026 kwa njia ya kideterministi kati ya kazi: +101 kwa candidate search, +202 kwa key generation, +303 kwa matrix generation na +10.000 kwa encryption.
Benchmark trial moja hupima muda wa jozi ya encrypt–decrypt pekee. Key generation na matrix construction ziko nje ya dirisha la kipimo. Mpaka huu ni muhimu katika kutafsiri matokeo ya RNEC.
RNEC Hupima Nini na Haipimi Nini?
Reference-Normalized Execution Cost (RNEC) ni kipimo cha gharama ya kulinganisha ambacho katika utafiti kinaweka kawaida wall-clock duration ya operesheni ya encrypt–decrypt kwa kila byte ya plaintext kwa kutumia frequency ya marejeo ya 2 GHz na %5 background OS load; kwa kuwa hardware performance counter haitumiki, si kipimo halisi cha CPU cycle count wala “cycles per byte” huru kwa jukwaa.
Mlinganyo (32) wa chanzo:
Hapa:
- \(f=2\times10^9\ \mathrm{Hz}\): frequency ya prosesa ya marejeo.
- \(\eta=0.05\): %5 background OS load.
- \(1-\eta=0.95\): sehemu inayokadiriwa kupatikana ya prosesa kwa operesheni inayopimwa.
- \(t_{\mathrm{exec}}\): muda wa wall-clock uliopimwa kwa sekunde.
- \(n_{\mathrm{bytes}}\): ukubwa wa plaintext unaochakatwa.
\(f\times t_{\mathrm{exec}}\) huzalisha kwa vipimo sawa na idadi ya mizunguko ya marejeo na kugawanya kwa idadi ya byte hutoa gharama iliyowekwa kawaida. Hata hivyo thamani hii si kipimo halisi cha performance-counter cycle. Tabia ya cache, microarchitecture, dynamic frequency scaling, OS scheduling na athari za Python/SageMath runtime haziondolewi na normalizasheni hii.
Chanzo pia hutumia kwa kipimo cha per-codeword/per-block:
. Ubadilishaji huu wa pili unalenga kupunguza athari ya amortization inayosababishwa na block payload tofauti; lakini hausawazishi mikakati tofauti ya scaling ya matawi ya EC na HEC.
Kwa nini mipangilio ya benchmark si ya simetria?
Katika tawi la EC, intrinsic code na field zimebadilishwa pamoja payload inapoongezeka:
| Payload | Tawi la EC | Tawi la HEC |
|---|---|---|
| 10 byte | EC(7,4), GF(4) | HEC(7,4), genus 2, GF(4) |
| 100 byte | EC(13,10), GF(8) | HEC(7,4)/GF(4) ileile, multiblock |
| 1000 byte | EC(55,52), GF(64) | HEC(7,4)/GF(4) ileile, multiblock |
Kwa hiyo familia ya mkunjo, field size, code dimension na batching strategy hubadilika kwa wakati mmoja. Ulinganisho wa awali wa EC–HEC kwa sababu hii si curve-family experiment.
Jedwali 1 — RNEC per block
| Mpangilio | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| Rao–Nam / EC | 19.693 ± 612 | 26.149 ± 581 | 165.963 ± 1.569 |
| McEliece / EC | 24.776 ± 85 | 32.271 ± 347 | 185.541 ± 7.755 |
| Rao–Nam / HEC, GF(4) thabiti | 22.299 ± 1.264 | 19.861 ± 1.075 | 19.570 ± 354 |
| McEliece / HEC, GF(4) thabiti | 26.220 ± 279 | 24.821 ± 567 | 24.476 ± 470 |
Chanzo hutumia 100 retained repetition katika seli zote. Katika Jedwali 1 coefficient of variation imeripotiwa kuwa kati ya %0,3 na %5,7. Nusu-upana wa 95% confidence interval hauzidi %1,2 ya mean katika seli yoyote.
Chanzo pia kinasema kwamba uwiano wa mean/median hauzidi 1,011 katika seli yoyote kati ya kumi na mbili. Histogram za Figure 13 pia zinaonyesha sampuli zilezile za retained per-run. Hii inaashiria kwamba wastani unaoonekana haujasukumwa na sampuli chache zilizokithiri; lakini haiondoi kutokuwa na uhakika wa kimfumo wa RNEC unaotokana na platform-normalization.
Ulinganisho wa McEliece na Rao–Nam
| Familia ya mkunjo | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| HEC | 1,176 ± 0,013 | 1,250 ± 0,014 | 1,251 ± 0,006 |
| EC | 1,258 ± 0,008 | 1,234 ± 0,006 | 1,118 ± 0,009 |
Kwa tafsiri ya chanzo, Rao–Nam katika benchmark hii ni takribani %11–21 nafuu kuliko McEliece katika pointi zote za payload. Katika tawi la HEC, akiba ni takribani %15, %20 na %20; katika tawi la EC, inapungua kutoka takribani %20,5 hadi %10,6 field inapokua kutoka GF(4) hadi GF(64).
Ulinganisho huu ni wenye nguvu zaidi kuliko curve-family comparison; kwa sababu McEliece na Rao–Nam ndani ya familia ileile hutumia code, field na payload ileile. Hivyo sababu kuu inayobadilika ni mpango wa kikriptografia.
Hata hivyo, kutokana na toy parameters kama \(k=4\), \(t_e=1\), haijaonyeshwa kwamba uwiano uleule wa asilimia utadumu katika cryptographic-scale code.
Ulinganisho wa awali wa EC–HEC
| Mpango | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| McEliece | 0,945 ± 0,002 | 1,300 ± 0,006 | 7,580 ± 0,068 |
| Rao–Nam | 0,883 ± 0,011 | 1,317 ± 0,015 | 8,480 ± 0,034 |
Thamani ikiwa juu ya 1, HEC benchmark configuration ni nafuu zaidi; ikiwa chini ya 1, EC configuration ni nafuu zaidi. Lakini uwiano wa 7,580 na 8,480 katika 1000 byte haumaanishi kwamba “mkunjo wa HEC intrinsically ni 7–9× wa kasi zaidi”. Wakati huo huo field, code dimension na njia ya batching pia zilibadilika.
Dokezo la kuripoti ndani ya chanzo: maelezo ya matched-comparison mwishoni mwa utafiti yanapotaja Jedwali 3 yanatoa uwiano wa unmatched McEliece kama 0,899; 1,257; 7,424. Nambari hizi si sawa na 0,945; 1,300; 7,580 za Jedwali 3 na sababu ya tofauti haijaelezwa katika chanzo. Verianla inadumisha thamani zinazoonekana za Jedwali 3 kama chanzo kikuu cha kiasi.
Je, Mikunjo ya Hyperelliptic ni ya Kasi Zaidi Kuliko Mikunjo ya Elliptic Katika Benchmark Hii?
Chanzo hakitoi hitimisho la jumla kama hilo; ingawa katika benchmark isiyolinganishwa HEC configuration inaonekana kuwa nafuu sana kwa payload kubwa, field, code dimension na batching strategy hubadilika pamoja na kwa hiyo tofauti hiyo haiwezi kuhusishwa na familia ya mkunjo; vigezo vingine vyote vilipowekwa thabiti chini ya GF(4), \((7,4)\), \(t_e=1\), gharama za genus-1 EC na genus-2 HEC zilibaki ndani ya takribani %8 katika resolution ya kipimo.
Ulinganisho uliolinganishwa wa EC–HEC
Chanzo kisha kiliendesha tena matawi yote mawili kwa GF(4), \(n=7\), \(k=4\), \(t_e=1\), payload ileile, multiblock batching ileile, decoder path ileile na measurement protocol ileile ili kuondoa confounding factors. Genus pekee ndiyo iliyobadilika: \(g=1\) kwa EC na \(g=2\) kwa HEC.
| Mpangilio | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| McEliece / EC, \(g=1\) | 25.422 ± 1.372 | 25.187 ± 1.041 | 26.032 ± 1.004 |
| McEliece / HEC, \(g=2\) | 27.300 ± 245 | 27.152 ± 1.605 | 25.300 ± 725 |
| Rao–Nam / EC, \(g=1\) | 20.751 ± 1.734 | 21.838 ± 4.513 | 21.144 ± 5.312 |
| Rao–Nam / HEC, \(g=2\) | 22.348 ± 217 | 20.295 ± 1.901 | 20.702 ± 2.129 |
| Mpango | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| McEliece | 0,931 ± 0,010 | 0,928 ± 0,013 | 1,029 ± 0,010 |
| Rao–Nam | 0,929 ± 0,015 | 1,076 ± 0,048 | 1,021 ± 0,054 |
Uwiano wote unabaki ndani ya takribani %8 ya 1. Kwa hiyo waandishi wanaondoa tafsiri ya matokeo ya awali yasiyolinganishwa kama faida kubwa ya intrinsically ya utendaji kwa hyperelliptic curve family.
Matched comparison hii pia ilifanywa kwa toy parameters. Matokeo yanasema tu kwamba katika kiwango hiki mabadiliko ya genus peke yake hayakuonyesha tofauti dhahiri ya gharama; hayathibitishi kwamba matokeo hayo yatadumu katika misimbo ya cryptographic-length.
Uzalishaji upya wa RNEC katika mashine mbili
Chanzo kiliendesha itifaki kwenye mashine mbili tofauti. Absolute wall-clock costs zilibadilika kama ilivyotarajiwa, huku scheme-level ratios za Jedwali 2 zikilingana ndani ya absolute 0,031 kati ya mashine hizo mbili. Chanzo kinatafsiri hili kwamba RNEC ni zaidi relative comparison metric kuliko kipimo cha absolute performance.
Generic-decoding baseline inakokotolewaje?
Kwa code-based construction, chanzo kinatumia classic Prange work factor kama mpaka wa juu wa gharama ya generic information-set decoding:
Usemi huu uko katika idadi ya field operation.
Vigezo:
- \(n\): urefu wa kodi.
- \(k\): ukubwa/dimension ya kodi.
- \(n-k\): tofauti inayohusiana na ukubwa wa parity/syndrome.
- \(t\): uzito wa kosa.
- \(\binom{n}{t}\): mchanganyiko unaotokana na nafasi \(n\) kwa kuchagua nafasi \(t\) za kosa.
Chanzo hutumia kwa kukadiria mbinu za kisasa za ISD:
. \(\alpha\) si constant ya kinadharia ya ulimwengu wote. Imekalibrishwa kwenye Classic McEliece binary parameter set moja ili kutoa matokeo ya 148-bit dhidi ya estimate iliyochapishwa ya takribani 143-bit.
Kwa safu ya quantum, chanzo hutumia:
kama placeholder ya takriban. Makala yenyewe inasema wazi kwamba hii si achievable quantum attack cost ya kweli na hali hubadilika kulingana na ni ISD subroutine zipi zinazoquantize.
Idadi ya error vector candidate hutolewa na:
. \(q\) ni ukubwa wa alphabet/field. Idadi hii inawakilisha nafasi ya wagombea ya brute-force.
Je, 260 Bit Katika Jedwali 6 ni Kiwango Halisi cha Usalama?
Hapana. Chanzo kinaripoti thamani ya 260-bit kama generic-decoding baseline ya takriban kwa seti ya vigezo vya marejeo \((1000,399)\), \(t=298\) juu ya GF(1024), inayotegemea calibration moja ya binary; kwa kuwa haimodeli utegemezi wa q-ary ISD wala gharama ya structural attack dhidi ya misimbo ya kialjebra-kijiometri, kinasema wazi kwamba thamani hii si kiwango halisi wala deployment-ready cha usalama.
| Seti ya vigezo | Darasa | \(\log_2|E_t|\) | \(WF_{\mathrm{ISD}}\) | \(WF_{\mathrm{quantum}}\) | Public key |
|---|---|---|---|---|---|
| HEC (7,4), \(g=2\), GF(4), \(t=1\) | Toy | 4,4 | 6 | 3 | — |
| EC (13,10), GF(8), \(t=1\) | Toy | 6,5 | 8 | 4 | — |
| EC (55,52), GF(64), \(t=1\) | Toy | 11,8 | 11 | 6 | — |
| AG (300,89), \(g=2\), GF(256), \(t=103\) | Reference | 1097,4 | 77 | 39 | 18 KiB |
| AG (300,149), \(g=2\), GF(256), \(t=73\) | Reference | 819,5 | 95 | 47 | 22 KiB |
| AG (1000,399), \(g=2\), GF(1024), \(t=298\) | Generic-decoding reference | 3853,2 | 260 | 130 | 293 KiB |
Mipangilio mitatu ya kwanza ya benchmark ina error space ndogo sana kwa sababu \(t=1\), na chanzo inaielezea wazi kuwa “no cryptographic security whatsoever”.
Ingawa nambari ya 260-bit katika mstari wa mwisho inaonekana kubwa kwa generic decoding, ni mpaka wa juu wa generic attack pekee. Ikiwa Structured code attack ni nafuu zaidi, usalama halisi utafuata hiyo.
Kwa nini mashambulizi ya kimuundo ni muhimu?
Algebraic-geometric code si random linear code; hubeba alama za ziada za kialjebra zinazotokana na pointi za rational, function evaluation na muundo wa divisor. Generic-decoding attack haizingatii muundo huu.
Chanzo kinajadili mashambulizi katika mstari wa Sidelnikov–Shestakov, Faure–Minder na Couvreur–Marquez-Corbella–Pellikaan. Hasa muundo wa component-wise Schur square wa public code unaweza kutumiwa kwa structural distinguisher na filtration attack.
na component-wise product hufafanuliwa kama:
.
Kwa algebraic-geometric evaluation code:
kwa sababu ya uhusiano huu Schur-square dimension inaweza kukua tofauti na random code na tofauti hiyo inaweza kusababisha shambulio la kimuundo.
Kwa nini toy Schur-square test si uthibitisho wa usalama?
Katika benchmark, Schur square dimension ya misimbo ya genus-1 na genus-2 \((7,4)\) ilipatikana kuwa 7. Kwa random code yenye vigezo vilevile:
hivyo test hutoa matokeo yale yale.
Lakini hapa mpaka wa juu tayari umesaturate kwa \(n=7\). Kwa hiyo test haina nguvu ya kutofautisha. Chanzo kinasema wazi kwamba code inayoweza kutofautishwa na structural distinguisher katika cryptographic size inaweza bado kupita test katika kiwango hiki cha toy.
Je, masking huondoa mashambulizi ya kimuundo?
Chanzo kinasema hapana. Kuzidisha kwa non-singular \(X\) hakubadilishi code yenyewe; mabadiliko ya monomial \(PD\) yanaweza kuhifadhi Schur-square dimension profile. Shortening huhifadhi muundo wa kialjebra-kijiometri na katika baadhi ya hali inaweza hata kumsaidia mshambuliaji kwa kupunguza code length. Haijaonyeshwa pia kwamba extension mechanism inayoongeza plaintext-derived symbol huongeza structure-recovery hardness.
Chanzo kinaona kazi zipi za usalama kuwa lazima kabla ya deployment?
- Schur-square profiling kwa cryptographic-size parameters.
- Kutumia Filtration attack moja kwa moja na kuripoti mahali inaposhindwa.
- Uchambuzi wa evaluation point, support na multiplier recovery.
- Parameter-dependent work factor kwa best-known structural attack.
- Kukokotoa kwa uhuru generic-decoding values kwa q-ary syndrome-decoding estimator iliyochapishwa.
- Kujenga mfano wazi wa side-channel leakage kwa sababu decoding routines si constant-time.
Kabla kazi hizi sita kukamilishwa katika kiwango cha cryptographically meaningful, chanzo hakipendekezi seti yoyote ya vigezo kama deployment-ready.
Je, matumizi ya nishati yalipimwa?
Hapana. Ingawa chanzo kinajadili implementation cost, wall-clock benchmark na taarifa za cycle-count kutoka kwa baadhi ya kazi za awali, hakuna kipimo cha moja kwa moja cha nishati kilichofanywa katika jaribio la sasa. Imeelezwa wazi kuwa athari ya nishati inategemea jukwaa.
Kwa hiyo haiwezekani kutoa matokeo ya moja kwa moja ya joule, watt au muda wa betri kutokana tu na field ndogo au idadi ndogo ya shughuli.
Kwa nini Jedwali 4 ni tofauti na majedwali mengine ya benchmark?
Chanzo kinatoa katika Jedwali 4 profile ya character read, string comparison na string concatenation call count/processor cycle kwa HEC McEliece. Lakini Data Availability Statement inasema wazi kwamba call-count na cycle hizi hazizalishwi upya na reproducibility package ya sasa; zimehamishwa kutoka Ref. [3] ya awali. Kwa hiyo Jedwali 4 haliko katika provenance class ileile na sampuli ghafi za muda za kampeni ya benchmark ya sasa.
Matokeo yanayoungwa mkono na utafiti
- Construction procedure inayorudiwa imeweza kuanzishwa kwa code matrices zinazotegemea EC na genus-2 HEC.
- Katika benchmark codes, masharti \(\operatorname{rank}(G)=k\), \(\operatorname{rank}(H)=n-k\) na \(HG^T=0\) yamethibitishwa.
- Uwakilishi wa projective ni optimization ya kikokotozi inayopunguza hitaji la field inversion katika hatua ya matrix-construction.
- Katika ulinganisho unaodhibitiwa wa same-family, gharama ya benchmark ya Rao–Nam ni ndogo kuliko McEliece.
- Faida iliyopimwa ya Rao–Nam iko takribani katika %11–21 katika kiwango cha toy kilichojaribiwa.
- Tofauti kubwa ya awali ya utendaji wa EC–HEC si athari safi ya curve family.
- Katika matched toy comparison gharama za genus-1 na genus-2 hubaki ndani ya takribani %8.
- Generic-decoding baseline imekokotolewa na kutenganishwa wazi na structural security.
- Reproducibility package ina code, parameters, matrices, fixed seeds, raw timings na work-factor scripts.
Matokeo yasiyoungwa mkono na utafiti
- Haiwezi kuhitimishwa kwamba toy parameters zinazotumiwa katika benchmark ni salama baada ya quantum.
- 260-bit generic-decoding baseline si dhamana halisi ya usalama wa 260-bit.
- Haiwezi kuhitimishwa kwamba mikunjo ya hyperelliptic intrinsically ni 7–9× ya kasi zaidi kuliko mikunjo ya elliptic.
- Haijaonyeshwa kwamba genus ya juu ni sugu zaidi kwa structural cryptanalysis.
- Haijaonyeshwa kwamba kuratibu za projective huficha muundo wa kialjebra wa kodi dhidi ya mshambuliaji.
- Matokeo sawa ya Schur-square test na random code katika mfano wa toy si uthibitisho wa structural resistance.
- Utafiti wa sasa haupendekezi seti ya vigezo vya deployment-ready kwa McEliece, Niederreiter au Rao–Nam.
- Utafiti haukupima matumizi halisi ya nishati.
- RNEC si kipimo halisi cha hardware cycle counter.
- Haijaonyeshwa kwamba huduma ya confidentiality/integrity katika mifumo ya simu ni production-ready kwa vigezo hivi.
Uzalishaji upya
Chanzo kinaripoti kwamba reproducibility package ya wazi ina utekelezaji wa EC na HEC, code ya curve parameter generation, routines za evaluation-matrix construction na decoding; taarifa zote za benchmark curve equation na irreducible polynomial; rational-point na evaluation sets; matriksi za generator/parity-check; fixed PRNG seeds; Algorithm 3 benchmark harness; raw per-run timing samples; Figure 13 generation script na Table 6 work-factor estimation script.
Matoleo ya programu yameripotiwa kuwa Python 3.12.5 na SageMath 10.5.
Chanzo kinasema kwamba Tables 1–3, Table 6 na Figure 13 zinaweza kuzalishwa upya na package scripts; absolute RNEC inabaki kutegemea hardware platform, lakini configuration ratios zinaweza kuzalishwa upya kwenye majukwaa tofauti.
Mpaka wa kazi ya baadaye
Kazi ya moja kwa moja inayofuata ya waandishi ni family study pana zaidi yenye genus \(g=2,3,4\), base fields tofauti na evaluation divisors tofauti. Bila utafiti huu haiwezi kusemwa kwamba mfano mmoja wa genus-2 GF(4) uliotumiwa katika benchmark unawakilisha hyperelliptic constructions zote.
Zaidi ya hayo, cryptographic-scale structural cryptanalysis, q-ary syndrome-decoding estimation ya kujitegemea, constant-time implementation na real platform energy measurement ni mahitaji ya uthibitishaji wa baadaye.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Construction and Benchmarking Methodology for Crypto-Code Systems on Elliptic and Hyperelliptic Curves
Waandishi: Serhii Yevseiev; Stanislav Milevskyi; Serhii Pohasii; Olena Akhiiezer; Vladyslav Sokol.
Mpangilio wa waandishi: Serhii Yevseiev ni mwandishi wa kwanza, Stanislav Milevskyi wa pili, Serhii Pohasii wa tatu, Olena Akhiiezer wa nne, na Vladyslav Sokol wa tano.
Mwandishi wa mawasiliano: Serhii Yevseiev.
Taasisi: Department of Cybersecurity, National Technical University “Kharkiv Polytechnic Institute”, 61002 Kharkiv, Ukraine.
Mchango sawa: Hakuna taarifa ya uandishi wa kwanza wa pamoja au mchango sawa katika chanzo.
Jarida: Cryptography.
Mchapishaji: MDPI, Basel, Switzerland.
Juzuu / toleo / makala: 10(6), Article 78.
Idadi ya kurasa: 44.
DOI: 10.3390/cryptography10060078.
Kuwasilishwa: 11 Agosti 2026.
Marekebisho: 5 Oktoba 2026.
Kukubaliwa: 20 Oktoba 2026.
Kuchapishwa: 27 Oktoba 2026.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wenzao; inaunganisha algebraic-geometric code construction, utekelezaji wa programu, controlled benchmark na uchambuzi wa generic-decoding baseline.
Mapitio ya wenzao: Cryptography ni jarida linalopitiwa na wenzao; nyenzo rasmi za jarida za MDPI zinaeleza mchakato wa single-blind peer-review.
Hali ya preprint: Hati iliyochakatwa kwa Verianla ni toleo la jarida lililochapishwa; hakuna toleo tofauti la preprint lililochakatwa katika chanzo.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Rekodi rasmi ya uchapishaji: MDPI Cryptography, DOI 10.3390/cryptography10060078.
Eneo kuu la kisayansi: Kriptografia ya baada ya quantum, kriptografia inayotegemea kodi, misimbo ya kialjebra-kijiometri na ukokotoaji katika nyuga finite.
Mbinu kuu: Kuunda evaluation/parity-check matrices kutoka pointi za rational za EC na HEC; kutoa generator matrix kupitia \(C=\ker(H)\); kupima utekelezaji wa McEliece na Rao–Nam chini ya benchmark harness ileile.
Programu ya benchmark: Python 3.12.5 na SageMath 10.5.
Itifaki ya benchmark: 2 GHz single-core reference processor, %5 OS load, 10 discarded warm-up na 100 retained run kwa kila seli, \(t_e=1\), 10/100/1000-byte payload na perf_counter_ns wall-clock timer.
Tafsiri ya RNEC: Ni Reference-normalized relative execution cost; si hardware cycle-count halisi.
Darasa la usalama la benchmark: Vigezo vilivyopimwa ni toy parameters na chanzo kinasema wazi kwamba havina cryptographic security.
Uchambuzi wa generic-decoding: Ni illustrative baseline inayotumia Prange work factor na marekebisho ya \(\alpha=0.85\) kupitia binary calibration point moja; si q-ary quantitative security estimate.
Structural security: Cryptographic-scale Schur-product/filtration resistance haijaonyeshwa; hakuna kigezo kinachowasilishwa kama deployment-ready.
Kipimo cha nishati: Matumizi ya nishati hayakupimwa moja kwa moja katika utafiti huu.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Chanzo kinasema complete reproducibility package imetolewa wazi na inajumuisha reference implementation, exact curve parameters, irreducible polynomials, rational-point/evaluation sets, generator na parity-check matrices, fixed PRNG seeds, benchmark harness, raw timing samples, Figure 13 script na Table 6 work-factor estimation script.
Mgongano wa maslahi: Waandishi wanatangaza kwamba hakuna mgongano wa maslahi.
Michango ya waandishi: Uundaji wa dhana Serhii Yevseiev na Stanislav Milevskyi; mbinu Serhii Yevseiev na Stanislav Milevskyi; programu Serhii Pohasii na Vladyslav Sokol; uthibitishaji Serhii Yevseiev, Stanislav Milevskyi na Olena Akhiiezer; uchambuzi rasmi Serhii Yevseiev, Stanislav Milevskyi na Olena Akhiiezer; uchunguzi Serhii Yevseiev na Serhii Pohasii; rasilimali Serhii Yevseiev na Vladyslav Sokol; uratibu wa data Serhii Pohasii na Olena Akhiiezer; rasimu ya kwanza Serhii Yevseiev; mapitio/uhariri Stanislav Milevskyi, Serhii Pohasii na Olena Akhiiezer; uoneshaji Vladyslav Sokol; usimamizi na usimamizi wa mradi Serhii Yevseiev.
Vikwazo vikuu vya kimetodolojia: Toy security parameters; upande wa HEC una mfano mmoja tu wa mkunjo wa genus-2 GF(4); EC/HEC scaling isiyolinganishwa; RNEC kutegemea wall-clock; kutokuwepo kwa cycle counter halisi na kipimo cha nishati; Table 6 generic-decoding values kuwa proxy ya takriban; cryptographic-scale structural attack assessment kutokamilika; decoding routines kutokuwa constant-time; data za Table 4 cycle/call-count kutozalishwa upya na reproducibility package ya sasa.
Dokezo la namba ndani ya chanzo: Katika Jedwali 3 uwiano wa McEliece EC/HEC ni 0,945; 1,300; 7,580, wakati maandishi ya matched-comparison mwishoni mwa utafiti yanaandika 0,899; 1,257; 7,424 kwa Jedwali 3. Chanzo hakielezi sababu ya tofauti; katika maudhui haya ya Verianla, thamani zinazoonekana za Jedwali 3 zimetumika kama msingi na tofauti haijafichwa.
Mpaka wa tafsiri: Mchango wa utafiti si primitive mpya ya post-quantum iliyo deployment-ready wala security level mpya iliyothibitishwa; ni metodolojia ya kuunda crypto-code construction zinazotegemea EC/HEC na kulinganisha gharama za utekelezaji kwa njia inayoweza kurudiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *