


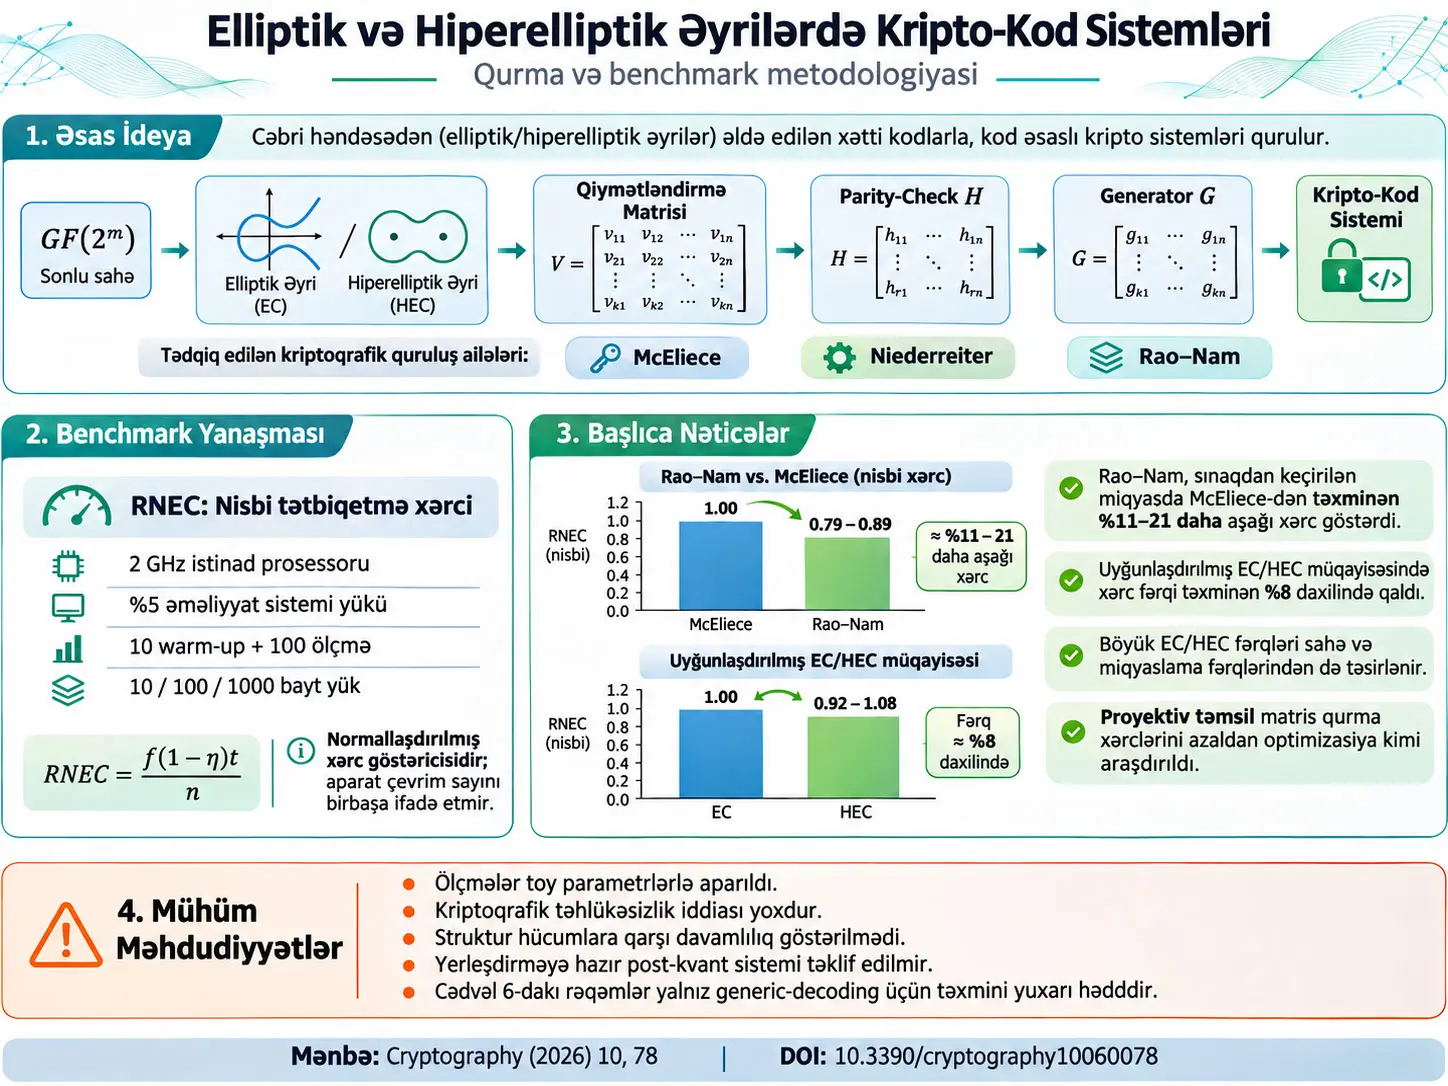
Kripto-kod sistemi (crypto-code construction, CCC), səhv düzəldən kodların cəbri quruluşunu kriptoqrafik çevrilmə ilə birləşdirən sistemdir. Bu tədqiqat yeni McEliece, Niederreiter və ya Rao–Nam primitivi hazırlamır; elliptik əyrilərdən (EC) və genus-2 hiperelliptik əyrilərdən (HEC) törədilmiş cəbri-həndəsi kodların necə qurulacağını, evaluation və parity-check matrislərinin necə yaradılacağını və eyni nəzarətli ölçmə protokolu altında McEliece ilə Rao–Nam reallaşdırmalarının xərcinin necə müqayisə ediləcəyini müəyyən edən təkrar istehsal edilə bilən metodologiya təqdim edir.
Tədqiqatın eksperimental benchmarkları kriptoqrafik təhlükəsizlik üçün seçilmiş parametrlərlə aparılmamışdır. Ölçülən üç əsas kod konfiqurasiyası səhv çəkisi \(t_e=1\) olan toy parametrlərdir və müəlliflər bunların heç bir kriptoqrafik təhlükəsizlik təmin etmədiyini açıq şəkildə bildirirlər. Bu parametrlərin məqsədi sistemlərin təhlükəsizliyini göstərmək deyil, eyni kod ailəsi və eyni ölçmə protokolu altında reallaşdırma xərcini müqayisə etməkdir.
Nəzarətli sxem müqayisəsinin ən etibarlı nəticəsi eyni əyri ailəsi və eyni kod istifadə edildikdə simmetrik Rao–Nam reallaşdırmalarının benchmarkda McEliece-dən daha ucuz olmasıdır. Mənbə Cədvəl 2-də McEliece/Rao–Nam RNEC nisbəti HEC qolunda 1,176–1,251; EC qolunda 1,118–1,258 intervalındadır. Müəlliflərin şərhinə görə sınaqdan keçirilən toy miqyasda Rao–Nam təxminən %11–21 daha aşağı tətbiq xərci göstərir. Bu fərq kriptoqrafik miqyasda eyni nisbətin qorunacağını sübut etmir.
Elliptik və hiperelliptik əyrilərin birbaşa performans müqayisəsi isə ilkin dizaynda nəzarət altında deyil. EC qolu 10, 100 və 1000 bayt yükdə müvafiq olaraq GF(4), GF(8) və GF(64) üzərində müxtəlif kodlara keçərkən HEC qolu eyni genus-2, \((7,4)\), GF(4) kodunu çoxbloklu şəkildə təkrar istifadə edir. Buna görə 1000 baytda görünən böyük EC/HEC nisbətləri əyri ailəsinin xalis təsiri deyil. Daha sonra bütün digər dəyişənlər sabit saxlanılaraq aparılan matched comparison-da genus-1 və genus-2 reallaşdırmalarının xərcləri %8 daxilində qalmışdır.
Təhlükəsizlik baxımından tədqiqat daha da ehtiyatlıdır. Cədvəl 6-da generic information-set decoding üçün təxminən 77, 95 və 260 bit kimi istinad dəyərləri hesablansa da, müəlliflər bunları real təhlükəsizlik səviyyəsi kimi qəbul etmirlər. Cəbri-həndəsi kodların quruluşuna yönəlmiş Schur-product və filtration hücumlarının xərci müəyyən edilməmişdir; buna görə tədqiqatda deployment-ready hər hansı post-kvant parametr dəsti təklif olunmur.
Tədqiqat enerji sərfiyyatını birbaşa ölçməmişdir. Proyektiv koordinatların istifadəsi, kiçik Galois sahələrində işləmə və simmetrik Rao–Nam quruluşu hesablama xərcini azalda biləcək mühəndislik seçimləri kimi araşdırılır; faktiki enerji sərfiyyatı cihaz və platforma əsasında ayrıca ölçülməlidir.
Tədqiqatın elmi problemi nədir?
McEliece və Niederreiter kimi kod əsaslı açıq açarlı kriptosistemlərin güclü tərəflərindən biri təhlükəsizlik fərziyyələrinin səhv düzəldən kodlardakı ümumi decoding problemlərinə əsaslanmasıdır. Bunun mühüm mühəndislik xərclərindən biri isə böyük public key-lər, böyük generator/parity-check matrisləri və decoding xərcidir. Mənbə xüsusilə mobil, daxili sistemlərdə və məhdud hesablama resurslarına malik sistemlərdə bu xərcin azaldılmasını araşdırır.
Tədqiqat iki əsas fikri birləşdirir. Birincisi, kod quruluşunun elliptik və ya hiperelliptik əyrilərin rasional nöqtələrindən yaradılmasıdır. İkincisi, eyni qurma və benchmark metodologiyasının McEliece kimi asimmetrik və Rao–Nam kimi simmetrik crypto-code construction-lara tətbiq edilməsidir.
Burada mühüm fərq vardır: elliptik və ya hiperelliptik əyrilər elliptic-curve discrete logarithm əsaslı müstəqil kriptosistem kimi istifadə edilmir. Əyrilər cəbri-həndəsi kodun rasional nöqtələrini, divisor quruluşunu, evaluation set-ini və matrislərini yaratmaq üçün istifadə olunur. Əsas təhlükəsizlik fərziyyəsi gizlədilmiş strukturlaşdırılmış kodun decoding çətinliyidir.
Tədqiqatın yeniliyi nədir?
McEliece, Niederreiter və Rao–Nam sxemləri mənbə tərəfindən klassik və əvvəlcədən mövcud strukturlar kimi qəbul olunur. Elliptik və hiperelliptik əyrilərin cəbri-həndəsi kodlarda istifadəsi də tamamilə yeni deyil. Məqalənin orijinal töhfəsi müəyyən parametrlərdən EC və HEC üçün evaluation/parity-check matrislərini təkrar istehsal edilə bilən şəkildə yaradan prosedurun, dörd scheme-family kombinasiyasına dəyişdirilmədən tətbiq olunan vahid benchmark protokolunun və generic-decoding sərhədinin təhlükəsizlik əhatəsi açıq şəkildə göstərilməklə birlikdə hesabatlandırılmasıdır.
Sonlu Galois sahəsi GF(\(2^m\)) nədir?
\(\mathrm{GF}(2^m)\), dəqiq olaraq \(2^m\) elementi olan sonlu sahədir. Mənbə bu sahəni parçalanmayan polinom və \(1,x,x^2,\ldots,x^{m-1}\) kanonik bazası ilə müəyyən edir. Xarakteristika 2 olduğu üçün toplama əməliyyatları bit səviyyəsində XOR ilə həyata keçirilə bilər; bu vəziyyət aparat və proqram reallaşdırmasında böyük xarakteristikalı tam ədəd arifmetikasına nisbətən fərqli xərc xüsusiyyətləri yarada bilər.
Bu tənlik sahə elementinin bit vektorunun tam ədəd şəklində serialize edilməsini göstərir. \(v_i\) hər bit əmsalını, \(m\) sahə dərəcəsini ifadə edir. Tənlik təhlükəsizlik səviyyəsini hesablamır; yalnız finite-field elementinin kompüterdə təmsilinə aid kodlaşdırma əlaqəsidir.
Elliptik əyri bu tədqiqatda necə müəyyən edilir?
Mənbə \(\mathrm{GF}(q)\) üzərində genus \(g=1\) olan hamar elliptik əyrini ümumi Weierstrass forması ilə verir:
Burada \(a_1,a_2,a_3,a_4,a_6\), \(\mathrm{GF}(q)\) sahəsinin elementləridir. Bu affine təsviridir.
Eyni əyrinin proyektiv forması:
Proyektiv koordinatlar \((X:Y:Z)\), affine müstəviyə əlavə olaraq infinity point-i də ardıcıl cəbri struktur daxilində ifadə etməyə imkan verir.
Proyektiv Koordinatlar Bu Tədqiqatda Niyə İstifadə Olunur?
Proyektiv koordinatlar mənbə tədqiqatda evaluation və parity-check matrislərinin yaradılması zamanı affine normallaşdırmanın tələb etdiyi \(\mathrm{GF}(2^m)\) sahə tərslərini azaltmaq və ya aradan qaldırmaq üçün istifadə olunan hesablama təmsilidir; bu çevrilmə kodun təhlükəsizlik fərziyyəsini gücləndirən yeni kriptoqrafik problem deyil, tətbiq xərcini azaltmağı hədəfləyən koordinat dəyişməsidir.
Affine nöqtə \((x,y)\), proyektiv qapanışda \((X:Y:Z)\) şəklində ifadə olunur. Mənbə xüsusilə bu isomorphism-in Abel–Jacobi map ilə qarışdırılmamalı olduğunu bildirir. Əyrinin Jacobian-ına yeni təhlükəsizlik fərziyyəsi daşınmır.
Tədqiqatda affine nöqtələr üçün normallaşdırılmış təsvir \(Z=1\), infinity point üçün isə \((0:1:0)\) istifadə olunur. Bu sabit təsvir evaluation matrix-də istifadə olunan monomial-ların eyni homogeneous degree-ə malik olmaması səbəbindən vacibdir.
Hiperelliptik əyri necə müəyyən edilir?
Xarakteristika 2-də istifadə olunan ümumi hiperelliptik əyri forması:
Burada \(h(x)\in \mathrm{GF}(2^m)[x]\) və \(\deg h\le g\); \(f(x)\) normallaşdırılmış polinomdur və \(\deg f=2g+1\) və ya \(2g+2\) ola bilər. \(g\), əyrinin genus dəyəridir.
Benchmarkda istifadə olunan HEC nümunəsi genus \(g=2\), GF(4) üzərindədir. Mənbənin verdiyi xüsusi model:
Sahə:
və generator üçün:
Mənbə bu xüsusi parametrizasiyada yeddi rasional nöqtə əldə edir:
Bu yeddi nöqtə bütün genus-2 GF(4) əyrilərinin məcburi xüsusiyyəti deyil. Yeddi nöqtə yalnız benchmarkda istifadə olunan xüsusi əyri parametrizasiyasına aiddir.
Hasse–Weil sərhədi nəyi müəyyən edir?
\(N\), əyri üzərində ola biləcək rasional nöqtələrin sayının yuxarı sərhədini; \(q\), finite field ölçüsünü; \(g\), genus-u ifadə edir. Genus artdıqca eyni sahə üzərində istifadə edilə biləcək nöqtələrin sayı üçün yuxarı sərhəd böyüyür.
Məsələn mənbə GF(4) üçün genus 2-də yuxarı sərhədi 13, genus 3-də 17 olaraq verir. Bu artım daha uzun kod qurmağa imkan verə bilər; lakin daha yüksək genus avtomatik olaraq daha yaxşı kod və ya daha yüksək kriptoqrafik təhlükəsizlik demək deyil.
Genus artdıqda nə dəyişir?
Mənbə dörd təsiri birlikdə müzakirə edir:
- Kod uzunluğu: Hasse–Weil yuxarı sərhədi genus ilə böyüyür; eyni field üzərində daha çox rasional nöqtə mümkün ola bilər.
- Minimum məsafə: genus artımı layihələndirilmiş minimum məsafə zəmanətini azalda bilər.
- Arifmetik xərc: Mumford representation ən çox \(2g\) field element tələb edir; Cantor reduction xərci genus artdıqca yüksəlir.
- Təhlükəsizlik: yüksək genus struktur kod hücumlarını aradan qaldırmır; mənbə yüksək genus-un avtomatik təhlükəsizlik artımı vermədiyini açıq bildirir.
Minimum məsafə–genus kompromisi
Riemann–Roch ölçüsü:
və Goppa məsafə aşağı sərhədi:
birlikdə istifadə edildikdə:
alınır. \(n-k+1\), Singleton bound tərəfdəki istinad terminidir. Mənbənin şərhinə görə kodun zəmanət verilən minimum məsafəsi Singleton bound-dan genus qədər aşağıda qalır. Buna görə genus ilə daha çox rasional nöqtə qazanılarkən minimum məsafə zəmanətindən xərc ödənə bilər.
Mənbə əsas algebraic decoding üçün düzəldilə bilən səhv sayını:
şəklində verir. Bu da genus artımının yalnız kod uzunluğunu deyil decoding radius-u da təsirləndirdiyini göstərir.
Divisor nədir?
Divisor əyri üzərindəki nöqtələrin sonlu tam ədəd əmsallı formal cəmidir:
Divisor rational function-ın harada sıfır və ya qütb daşıdığını və bunun multiplicity dəyərini qeyd etmək üçün istifadə olunan cəbri obyektdir.
Dərəcəsi:
şəklində müəyyən edilir.
Bir rational function \(f\)-nin principal divisor-u:
şəklindədir. \(v_P(f)\), \(P\) nöqtəsindəki zero/pole valuation məlumatını daşıyır.
Jacobian bu tədqiqatda nə işə yarayır?
Degree-zero divisor sinifləri:
ilə təmsil olunur. Mənbə Jacobian-ı rasional nöqtələrin, reduced divisor-ların və kodu müəyyən edən divisor-un sistemli şəkildə seçilməsini təmin edən construction and parameterization tool kimi istifadə edir.
Tədqiqatın təhlükəsizliyi hyperelliptic-curve discrete logarithm probleminə əsaslanmır. Secret, Jacobian üzərində discrete logarithm deyil, gizlədilmiş code description-dır. Buna görə genus \(\ge3\) HEC discrete logarithm üçün məlum index-calculus təkmilləşdirmələri ilə burada istifadə olunan code-based hardness fərziyyəsi qarışdırılmamalıdır.
Riemann–Roch fəzası və evaluation code
\(L(G)\), qütbləri divisor \(G\) tərəfindən məhdudlaşdırılan rational function-ların fəzasıdır.
Evaluation divisor:
şəklində qurulur. Dəstək çoxluqlarının kəsişməməsi \(L(G)\)-dəki funksiyaların evaluation nöqtələrində düzgün qiymətləndirilməsinə imkan verir.
Evaluation map:
və ona uyğun evaluation code:
şəklindədir.
Mənbənin constructive code tərifi
Tədqiqatda faktiki benchmark kodu birbaşa:
şəklində müəyyən edilir və \(G\), bu kernel-in bazasını təşkil edən sətirlərdən yaradılır. Yoxlanılan şərtlər:
şəklindədir.
HEC genus-2 GF(4) benchmarkında və matched genus-1 benchmarkında \(n=7\), \(k=4\), \(\operatorname{rank}(G)=4\), \(\operatorname{rank}(H)=3\) və \(HG^T=0\) dəqiq şəkildə doğrulanmışdır.
Lakin mənbə mühüm məhdudiyyət qoyur: yaradılan \(C=\ker(H)\) kodunun mütləq əvvəl müəyyən edilən konkret \(C_L(D,G)\) evaluation code ilə tam eyni olduğu və ya seçilmiş sətirlərin cəbri-həndəsi dual \(C_\Omega(D,G)\) kodunu reallaşdırdığı iddia edilmir. Bu correspondence tədqiqatda sübut edilməmişdir.
McEliece quruluşunda masking
Mənbə McEliece qolunda secret masking matrislərini \(X\), \(P\) və bəzi dəyişdirilmiş strukturlarda \(D\) ilə müəyyən edir. Public generator matrix ümumilikdə masked code generator üzərindən yaradılır.
Mənbədə codogram üçün verilən əsas əlaqə:
\(i\), \(k\)-simvollu information vector; \(G_X\), masked public generator matrix; \(e\), çəkisi decoding qabiliyyəti ilə məhdudlaşdırılan gizli səhv vektorudur. Encryption, etibarlı codeword üzərinə nəzarətli səhv əlavə edir.
Niederreiter quruluşu
Niederreiter quruluşunda confidential information birbaşa error vector üzərindən syndrome kimi təmsil olunur:
\(H_X\), masked parity-check matrix; \(e\), uzunluğu \(n\) və çəkisi \(t\)-ni aşmayan error vector-dür. McEliece codeword əsaslı ifadə istifadə edərkən Niederreiter syndrome əsaslı ifadədən istifadə edir.
Rao–Nam quruluşu
Klassik Rao–Nam encryption:
şəklindədir. \(I\), plaintext information vector; \(G\), generator matrix; \(e\), random error vector-dür.
Dəyişdirilmiş quruluş əlavə olaraq permutation matrix \(Z\) istifadə edir:
Mənbə bu quruluşun public-key matrix əməliyyatlarından yayınması səbəbindən daha aşağı əməliyyat xərcinə malik ola biləcəyini müzakirə edir.
Bununla birlikdə klassik Rao–Nam-ın təhlükəsizlik tarixi problemsiz deyil. Mənbə unmodified Rao–Nam üçün chosen-plaintext attack həssaslığını və struktur hücum problemlərini açıq şəkildə bildirir. Buna görə benchmarkdakı aşağı xərc təkbaşına deployment təhlükəsizliyi demək deyil.
Flawed code və MV2 mexanizmi nədir?
Mənbə “flawed code” terminini nəzarətli şəkildə zədələnmiş/itkili məlumat təmsilini müəyyən etmək üçün istifadə edir. MV2 yanaşmasında orijinal məlumat bir-birindən asılı damage sequence və damaged text hissələrinə ayrılır; mənbə tək hissənin təkbaşına plaintext-i geri qaytarmaq üçün kifayət etmədiyini bildirir.
Bu quruluşun məqsədi multi-channel cryptography və tətbiq xərcinin tənzimlənməsidir. Lakin mənbədə istifadə olunan toy benchmarklar bu mexanizmin cryptographically secure deployment səviyyəsini sübut etmir.
LDPC yanaşması
Tədqiqat McEliece üçün ikinci kod yanaşması kimi Low-Density Parity-Check (LDPC) kodlarını da araşdırır. Decoding, Belief Propagation / Sum–Product Algorithm ilə həyata keçirilir. Proqram tətbiqi log-likelihood ratio (LLR) mesajlarını variable node və check node arasında iterativ şəkildə ötürür.
Mənbə alqoritmində check-node yeniləməsində \(\tanh\) dəyərləri vurulur və inverse hyperbolic tangent tətbiq edilməzdən əvvəl nisbət ədədi sabitlik üçün təxminən \((-1+10^{-10},1-10^{-10})\) intervalında clip edilir. Standart maksimum iterasiya 50-dir. Zero syndrome əldə olunduqda alqoritm erkən dayanır.
Mənbə LDPC-nin AWGN tipli kommunikasiya kanallarında iterativ decoding səmərəliliyini qəbul etsə də, graph-related məlumat strukturlarının yaddaş tələblərini və QC-LDPC/QC-MDPC strukturlarındakı structural cryptanalysis risklərini ayrıca müzakirə edir.
Tədqiqatın Metodu və Nəticələri
Təcrübə və proqram mühiti
Müəlliflərin computational experiments tətbiqi Python 3.12.5 və SageMath istifadə edilməklə həyata keçirilmişdir. Controlled performance evaluation üçün 2 GHz single-core reference processor və %5 background operating-system load müəyyən edilmişdir.
| Parametr | Mənbə dəyəri | Elmi rol |
|---|---|---|
| İstinad prosessoru | 2 GHz, single core | RNEC normallaşdırma istinadı |
| Arxa fon OS yükü | %5 | Normallaşdırılan mövcud prosessor payı |
| Warm-up | 10 işləmə | Ölçmə statistikasına daxil edilmir |
| Ölçmə | 100 təkrar / hüceyrə | Mean, SD, CV, CI, median və IQR yaradır |
| Taymer | perf_counter_ns | Wall-clock execution time |
| Error weight | \(t_e=1\) | Toy benchmark parametri |
| Payload | 10, 100, 1000 byte | Üç workload nöqtəsi |
| Base PRNG seed | 2026 | Deterministik reproducibility |
Mənbə base seed 2026-nı tapşırıqlar arasında deterministik şəkildə bölür: candidate search üçün +101, key generation üçün +202, matrix generation üçün +303 və encryption üçün +10.000.
Bir benchmark trial yalnız encrypt–decrypt cütünü zamanlayır. Key generation və matrix construction ölçmə pəncərəsinin xaricindədir. Bu sərhəd RNEC nəticələrinin şərhində vacibdir.
RNEC Nəyi Ölçür və Nəyi Ölçmür?
Reference-Normalized Execution Cost (RNEC), tədqiqatda encrypt–decrypt əməliyyatının wall-clock müddətini 2 GHz istinad tezliyi və %5 arxa fon OS yükü əsasında plaintext baytı başına normallaşdıran nisbi xərc metrikasıdır; hardware performance counter istifadə edilmədiyi üçün real CPU cycle count və ya platformadan asılı olmayan “cycles per byte” ölçümü deyil.
Mənbə Tənlik (32):
Burada:
- \(f=2\times10^9\ \mathrm{Hz}\): istinad prosessor tezliyi.
- \(\eta=0.05\): %5 background OS load.
- \(1-\eta=0.95\): ölçülən əməliyyat üçün qəbul edilən mövcud prosessor payı.
- \(t_{\mathrm{exec}}\): saniyə ilə ölçülən wall-clock işləmə müddəti.
- \(n_{\mathrm{bytes}}\): emal olunan plaintext ölçüsü.
\(f\times t_{\mathrm{exec}}\) ölçü baxımından istinad dövrü ekvivalenti yaradır və bunun byte sayına bölünməsi normallaşdırılmış xərc verir. Lakin bu dəyər real performance-counter cycle ölçümü deyil. Cache davranışı, microarchitecture, dynamic frequency scaling, OS scheduling və Python/SageMath runtime təsirləri bu normallaşdırma ilə aradan qalxmır.
Mənbə per-codeword/per-block ölçümü üçün əlavə olaraq:
ifadəsindən istifadə edir. Bu ikinci çevrilmə müxtəlif block payload-larının yaratdığı amortization təsirini azaltmağı hədəfləyir; lakin EC və HEC qollarının müxtəlif miqyaslanma strategiyalarını bərabərləşdirmir.
Benchmark konfiqurasiyaları niyə simmetrik deyil?
EC qolunda payload böyüdükcə intrinsic code və field birlikdə dəyişdirilmişdir:
| Payload | EC qolu | HEC qolu |
|---|---|---|
| 10 byte | EC(7,4), GF(4) | HEC(7,4), genus 2, GF(4) |
| 100 byte | EC(13,10), GF(8) | Eyni HEC(7,4)/GF(4), multiblock |
| 1000 byte | EC(55,52), GF(64) | Eyni HEC(7,4)/GF(4), multiblock |
Beləliklə əyri ailəsi, field size, code dimension və batching strategy eyni anda dəyişir. İlk EC–HEC müqayisəsi buna görə curve-family experiment deyil.
Cədvəl 1 — RNEC per block
| Konfiqurasiya | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| Rao–Nam / EC | 19.693 ± 612 | 26.149 ± 581 | 165.963 ± 1.569 |
| McEliece / EC | 24.776 ± 85 | 32.271 ± 347 | 185.541 ± 7.755 |
| Rao–Nam / HEC, GF(4) sabit | 22.299 ± 1.264 | 19.861 ± 1.075 | 19.570 ± 354 |
| McEliece / HEC, GF(4) sabit | 26.220 ± 279 | 24.821 ± 567 | 24.476 ± 470 |
Mənbə bütün hüceyrələrdə 100 retained repetition istifadə edir. Cədvəl 1-də coefficient of variation %0,3 ilə %5,7 arasında bildirilir. 95% confidence interval-ın yarı eni heç bir hüceyrədə mean-in %1,2-sini keçmir.
Mənbə əlavə olaraq mean/median nisbətinin on iki hüceyrənin heç birində 1,011-i aşmadığını bildirir. Figure 13 histogramları da eyni retained per-run nümunələrini göstərir. Bu vəziyyət görünən orta qiymətlərin bir neçə ekstremal nümunə tərəfindən sürüklənmədiyinə işarə edir; lakin RNEC-nin platform-normalization mənşəli sistematik qeyri-müəyyənliyini aradan qaldırmır.
McEliece və Rao–Nam müqayisəsi
| Əyri ailəsi | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| HEC | 1,176 ± 0,013 | 1,250 ± 0,014 | 1,251 ± 0,006 |
| EC | 1,258 ± 0,008 | 1,234 ± 0,006 | 1,118 ± 0,009 |
Mənbənin şərhinə görə Rao–Nam bu benchmarkda bütün payload nöqtələrində McEliece-dən təxminən %11–21 daha ucuzdur. HEC qolunda qənaət təxminən %15, %20 və %20; EC qolunda isə field GF(4)-dən GF(64)-ə böyüdükcə təxminən %20,5-dən %10,6-ya düşür.
Bu müqayisə curve-family comparison-dan daha güclüdür; çünki eyni ailə daxilində McEliece və Rao–Nam eyni code, field və payload istifadə edir. Beləliklə dəyişən əsas amil kriptoqrafik sxemdir.
Lakin \(k=4\), \(t_e=1\) kimi toy parametrlərə görə eyni faiz nisbətinin cryptographic-scale code-larda qorunacağı göstərilməmişdir.
İlk EC–HEC müqayisəsi
| Sxem | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| McEliece | 0,945 ± 0,002 | 1,300 ± 0,006 | 7,580 ± 0,068 |
| Rao–Nam | 0,883 ± 0,011 | 1,317 ± 0,015 | 8,480 ± 0,034 |
Dəyər 1-dən yuxarıdırsa HEC benchmark configuration daha ucuzdur; 1-dən aşağıdırsa EC configuration daha ucuzdur. Lakin 1000 byte-dakı 7,580 və 8,480 nisbətləri “HEC əyrisi intrinsik olaraq 7–9× daha sürətlidir” demək deyil. Eyni zamanda field, code dimension və batching üsulu da dəyişmişdir.
Mənbədaxili hesabat qeydi: tədqiqatın sonundakı matched-comparison izahı Cədvəl 3-ə istinad edərkən unmatched McEliece nisbətlərini 0,899; 1,257; 7,424 şəklində verir. Bu rəqəmlər Cədvəl 3-dəki 0,945; 1,300; 7,580 dəyərləri ilə eyni deyil və fərqin səbəbi mənbədə izah olunmur. Verianla əsas kəmiyyət mənbəyi kimi görünən Cədvəl 3 dəyərlərini saxlayır.
Hiperelliptik Əyrilər Bu Benchmarkda Elliptik Əyrilərdən Daha Sürətlidirmi?
Mənbə belə ümumi nəticə çıxarmır; uyğunlaşdırılmamış benchmarkda HEC konfiqurasiyası böyük payload-larda xeyli daha ucuz görünsə də field, code dimension və batching strategy birlikdə dəyişdiyi üçün bu fərq əyri ailəsinə aid edilə bilməz, bütün digər parametrlər GF(4), \((7,4)\), \(t_e=1\) altında sabit saxlanıldıqda genus-1 EC ilə genus-2 HEC xərcləri ölçmə həssaslığı daxilində təxminən %8 daxilində qalmışdır.
Uyğunlaşdırılmış EC–HEC müqayisəsi
Mənbə daha sonra confounding amilləri aradan qaldırmaq üçün hər iki qolu GF(4), \(n=7\), \(k=4\), \(t_e=1\), eyni payload, eyni multiblock batching, eyni decoder path və eyni measurement protocol ilə yenidən işlətmişdir. Yalnız genus dəyişmişdir: EC üçün \(g=1\), HEC üçün \(g=2\).
| Konfiqurasiya | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| McEliece / EC, \(g=1\) | 25.422 ± 1.372 | 25.187 ± 1.041 | 26.032 ± 1.004 |
| McEliece / HEC, \(g=2\) | 27.300 ± 245 | 27.152 ± 1.605 | 25.300 ± 725 |
| Rao–Nam / EC, \(g=1\) | 20.751 ± 1.734 | 21.838 ± 4.513 | 21.144 ± 5.312 |
| Rao–Nam / HEC, \(g=2\) | 22.348 ± 217 | 20.295 ± 1.901 | 20.702 ± 2.129 |
| Sxem | 10 byte | 100 byte | 1000 byte |
|---|---|---|---|
| McEliece | 0,931 ± 0,010 | 0,928 ± 0,013 | 1,029 ± 0,010 |
| Rao–Nam | 0,929 ± 0,015 | 1,076 ± 0,048 | 1,021 ± 0,054 |
Bütün nisbətlər 1-in təxminən %8-i daxilində qalır. Müəlliflər buna görə ilk uyğunlaşdırılmamış nəticələrin hyperelliptic curve family üçün intrinsik böyük performans üstünlüyü kimi şərh edilməsini geri götürürlər.
Bu matched comparison da toy parametrlərlə aparılmışdır. Nəticə yalnız bu miqyasda genus dəyişməsinin öz-özlüyündə nəzərəçarpan xərc fərqi göstərmədiyini bildirir; cryptographic-length kodlarda eyni nəticənin qorunacağını sübut etmir.
RNEC-nin iki maşında təkrar istehsal edilə bilməsi
Mənbə protokolu iki fərqli maşında işə salmışdır. Absolute wall-clock xərcləri gözlənildiyi kimi dəyişərkən Cədvəl 2-dəki scheme-level nisbətlər iki maşın arasında absolute 0,031 daxilində uyğun gəlmişdir. Mənbə bunu RNEC-nin mütləq performans metrikasından daha çox relative comparison metrikası olması kimi şərh edir.
Generic-decoding baseline necə hesablanır?
Code-based construction üçün generic information-set decoding xərcinin yuxarı sərhədi kimi mənbə klassik Prange iş faktorundan istifadə edir:
Bu ifadə field operation sayı ilə verilir.
Dəyişənlər:
- \(n\): kod uzunluğu.
- \(k\): kod ölçüsü/dimension.
- \(n-k\): parity/syndrome ölçüsü ilə əlaqəli fərq.
- \(t\): səhv çəkisi.
- \(\binom{n}{t}\): \(n\) mövqe arasından \(t\) səhv mövqeyi seçmə kombinasiyası.
Mənbə müasir ISD üsullarını təxmini modelləşdirmək üçün:
istifadə edir. \(\alpha\) nəzəri universal sabit deyil. Tək Classic McEliece binary parameter set üzərində təxminən 143-bit yayımlanmış estimate-ə qarşı 148-bit nəticə verəcək şəkildə kalibrlənmişdir.
Kvant sütunu üçün mənbə:
şəklində kobud placeholder istifadə edir. Məqalənin özü bunun real achievable quantum attack cost olmadığını və hansı ISD subroutine-lərinin kvantlaşdırıldığına görə vəziyyətin dəyişəcəyini açıq şəkildə bildirir.
Error vector candidate sayı:
ilə verilir. \(q\), alphabet/field ölçüsüdür. Bu say brute-force namizəd fəzasını ifadə edir.
Cədvəl 6-dakı 260 Bit Həqiqi Təhlükəsizlik Səviyyəsidirmi?
Xeyr. Mənbə 260-bit dəyərini GF(1024) üzərindəki \((1000,399)\), \(t=298\) istinad parametr dəsti üçün tək binary kalibrləməyə əsaslanan təxmini generic-decoding baseline kimi bildirir; q-ary ISD asılılıqlarını və cəbri-həndəsi kodlara yönəlmiş structural attack xərcini modelləşdirmədiyi üçün bu dəyərin real və ya deployment-ready təhlükəsizlik səviyyəsi olmadığını açıq şəkildə bildirir.
| Parametr dəsti | Sinif | \(\log_2|E_t|\) | \(WF_{\mathrm{ISD}}\) | \(WF_{\mathrm{quantum}}\) | Public key |
|---|---|---|---|---|---|
| HEC (7,4), \(g=2\), GF(4), \(t=1\) | Toy | 4,4 | 6 | 3 | — |
| EC (13,10), GF(8), \(t=1\) | Toy | 6,5 | 8 | 4 | — |
| EC (55,52), GF(64), \(t=1\) | Toy | 11,8 | 11 | 6 | — |
| AG (300,89), \(g=2\), GF(256), \(t=103\) | Reference | 1097,4 | 77 | 39 | 18 KiB |
| AG (300,149), \(g=2\), GF(256), \(t=73\) | Reference | 819,5 | 95 | 47 | 22 KiB |
| AG (1000,399), \(g=2\), GF(1024), \(t=298\) | Generic-decoding reference | 3853,2 | 260 | 130 | 293 KiB |
İlk üç benchmark konfiqurasiyası \(t=1\) olduğu üçün çox kiçik error space-ə malikdir və mənbə bunları açıq şəkildə “no cryptographic security whatsoever” kimi müəyyən edir.
Son sətirdəki 260-bit say generic decoding baxımından böyük görünsə də yalnız generic attack yuxarı sərhədidir. Structured code attack daha ucuzdursa real təhlükəsizlik onu izləyir.
Struktur hücumlar niyə kritikdir?
Algebraic-geometric code təsadüfi lineer code deyil; rasional nöqtələr, function evaluation və divisor quruluşundan gələn əlavə cəbri izlər daşıyır. Generic-decoding hücumu bu quruluşu nəzərə almır.
Mənbə Sidelnikov–Shestakov, Faure–Minder və Couvreur–Marquez-Corbella–Pellikaan xəttindəki hücumları müzakirə edir. Xüsusilə public code-un component-wise Schur square quruluşu structural distinguisher və filtration attack üçün istifadə oluna bilər.
və component-wise product:
kimi müəyyən edilir.
Algebraic-geometric evaluation code üçün:
əlaqəsinə görə Schur-square dimension təsadüfi bir code-dan fərqli artım göstərə bilər və bu fərq struktur hücuma səbəb ola bilər.
Toy Schur-square testi niyə təhlükəsizlik sübutu deyil?
Benchmarkda genus-1 və genus-2 \((7,4)\) kodlarının Schur square dimension dəyəri 7 tapılmışdır. Eyni parametrlərdə random code üçün:
olduğuna görə test random code ilə eyni nəticəni verir.
Lakin burada yuxarı sərhəd artıq \(n=7\) tərəfindən doydurulmuşdur. Buna görə testin ayırdetmə gücü yoxdur. Mənbə açıq şəkildə cryptographic size-da structural distinguisher tərəfindən fərqləndirilə biləcək code-un bu toy miqyasda yenə də testi keçə biləcəyini bildirir.
Masking struktur hücumları aradan qaldırırmı?
Mənbə xeyr deyir. Non-singular \(X\) ilə vurma code-un özünü dəyişmir; monomial \(PD\) çevrilməsi Schur-square dimension profile-ını saxlaya bilər. Shortening cəbri-həndəsi quruluşu qoruyur və bəzi hallarda code length-i azaldaraq hücumçuya hətta kömək edə bilər. Plaintext-derived symbol əlavə edən extension mexanizminin də structure-recovery hardness-ı artırdığı göstərilməmişdir.
Deployment-dan əvvəl mənbə hansı təhlükəsizlik işlərini zəruri sayır?
- Cryptographic-size parametrlərdə Schur-square profiling.
- Filtration attack-ın birbaşa tətbiqi və harada uğursuz olduğunun bildirilməsi.
- Evaluation point, support və multiplier recovery təhlili.
- Best-known structural attack üçün parameter-dependent work factor.
- Generic-decoding dəyərlərinin yayımlanmış q-ary syndrome-decoding estimator ilə müstəqil hesablanması.
- Decoding rutinləri constant-time olmadığı üçün açıq side-channel leakage modelinin qurulması.
Bu altı iş cryptographically meaningful miqyasda tamamlanmadan mənbə heç bir parametr dəstini deployment-ready kimi tövsiyə etmir.
Enerji sərfiyyatı ölçülübmü?
Xeyr. Mənbə implementation cost, wall-clock benchmark və bəzi əvvəlki işlərin cycle-count məlumatlarını müzakirə etsə də, mövcud təcrübədə birbaşa enerji ölçümü aparmamışdır. Enerji üzərində təsirin platformadan asılı olduğu açıq şəkildə bildirilmişdir.
Buna görə kiçik field və ya daha az əməliyyat sayından birbaşa joule, watt və ya batareya ömrü nəticəsi çıxarıla bilməz.
Cədvəl 4 niyə digər benchmark cədvəllərindən fərqlidir?
Mənbə Cədvəl 4-də HEC McEliece üçün character read, string comparison və string concatenation call count/processor cycle profilini verir. Lakin Data Availability Statement bu call-count və cycle rəqəmlərini mövcud reproducibility package-ın yenidən istehsal etmədiyini; bunların əvvəlki Ref. [3]-dən götürüldüyünü açıq şəkildə bildirir. Buna görə Cədvəl 4 mövcud benchmark kampaniyasının xam zaman nümunələri ilə eyni provenance sinfində deyil.
Tədqiqatın dəstəklədiyi nəticələr
- EC və genus-2 HEC əsaslı code matrices üçün təkrarlana bilən construction procedure qurmaq mümkün olmuşdur.
- Benchmark kodlarında \(\operatorname{rank}(G)=k\), \(\operatorname{rank}(H)=n-k\) və \(HG^T=0\) şərtləri doğrulanmışdır.
- Proyektiv təmsil matrix-construction mərhələsində field inversion ehtiyacını azaldan hesablama optimallaşdırmasıdır.
- Nəzarətli eyni-family müqayisəsində Rao–Nam benchmark xərci McEliece-dən aşağıdır.
- Ölçülən Rao–Nam üstünlüyü sınaqdan keçirilən toy miqyasda təxminən %11–21 intervalındadır.
- İlk EC–HEC böyük performans fərqi curve family-nin xalis təsiri deyil.
- Matched toy comparison-da genus-1 və genus-2 xərcləri təxminən %8 daxilində qalır.
- Generic-decoding baseline hesablanmış və structural security-dən açıq şəkildə ayrılmışdır.
- Reproducibility package kodu, parametrləri, matrisləri, fixed seeds-i, raw timings-i və work-factor script-lərini ehtiva edir.
Tədqiqatın dəstəkləmədiyi nəticələr
- Benchmarkda istifadə olunan toy parametrlərin post-kvant təhlükəsiz olduğu nəticəsi çıxarıla bilməz.
- 260-bit generic-decoding baseline real 260-bit təhlükəsizlik zəmanəti deyil.
- Hiperelliptik əyrilərin elliptik əyrilərdən intrinsik olaraq 7–9× daha sürətli olduğu nəticəsi çıxarıla bilməz.
- Daha yüksək genus-un structural cryptanalysis-ə daha davamlı olduğu göstərilməmişdir.
- Proyektiv koordinatların kodun cəbri quruluşunu hücumçudan gizlətdiyi göstərilməmişdir.
- Schur-square testinin toy nümunədə random code ilə eyni nəticə verməsi structural resistance sübutu deyil.
- Mövcud tədqiqat deployment-ready McEliece, Niederreiter və ya Rao–Nam parametr dəsti təklif etmir.
- Tədqiqat real enerji sərfiyyatını ölçməmişdir.
- RNEC real hardware cycle counter ölçümü deyil.
- Mobil sistemlərdə confidentiality/integrity xidmətinin bu parametrlərlə production-ready olduğu göstərilməmişdir.
Təkrar istehsal edilə bilmə
Mənbə açıq reproducibility package daxilində EC və HEC reallaşdırmalarını, curve parameter generation kodunu, evaluation-matrix construction və decoding rutinlərini; bütün benchmark curve equation və irreducible polynomial məlumatlarını; rational-point və evaluation set-lərini; generator/parity-check matrislərini; fixed PRNG seeds-i; Algorithm 3 benchmark harness-ini; raw per-run timing samples-ı; Figure 13 yaratma script-ini və Table 6 work-factor estimation script-ini təqdim etdiyini bildirir.
Proqram versiyaları Python 3.12.5 və SageMath 10.5 kimi bildirilmişdir.
Mənbə Tables 1–3, Table 6 və Figure 13-ün package script-ləri tərəfindən yenidən istehsal edilə bildiyini; absolute RNEC-nin hardware platformadan asılı qaldığını, lakin configuration ratio-larının müxtəlif platformalarda yenidən istehsal oluna bildiyini bildirir.
Gələcək iş sərhədi
Müəlliflərin birbaşa davam işi genus \(g=2,3,4\), müxtəlif base fields və müxtəlif evaluation divisors ehtiva edən daha geniş family study-dir. Bu tədqiqat olmadan benchmarkda istifadə olunan tək genus-2 GF(4) nümunəsinin bütün hyperelliptic constructions üçün təmsilçi olduğu deyilə bilməz.
Bundan əlavə cryptographic-scale structural cryptanalysis, müstəqil q-ary syndrome-decoding estimation, constant-time implementation və real platform energy measurement gələcək doğrulama tələbləridir.
Mənbə və Metod Qeydi
Orijinal başlıq: Construction and Benchmarking Methodology for Crypto-Code Systems on Elliptic and Hyperelliptic Curves
Müəlliflər: Serhii Yevseiev; Stanislav Milevskyi; Serhii Pohasii; Olena Akhiiezer; Vladyslav Sokol.
Müəllif sırası: Serhii Yevseiev birinci, Stanislav Milevskyi ikinci, Serhii Pohasii üçüncü, Olena Akhiiezer dördüncü, Vladyslav Sokol beşinci müəllifdir.
Məsul müəllif: Serhii Yevseiev.
Qurum: Department of Cybersecurity, National Technical University “Kharkiv Polytechnic Institute”, 61002 Kharkiv, Ukraine.
Bərabər töhfə: Mənbədə bərabər birinci müəlliflik və ya bərabər töhfə bəyanatı yoxdur.
Jurnal: Cryptography.
Nəşriyyat: MDPI, Basel, Switzerland.
Cild / nömrə / məqalə: 10(6), Article 78.
Səhifə sayı: 44.
DOI: 10.3390/cryptography10060078.
Göndərilmə: 11 Avqust 2026.
Reviziya: 5 Oktyabr 2026.
Qəbul: 20 Oktyabr 2026.
Nəşr: 27 Oktyabr 2026.
Mənbə növü: Hakemli tədqiqat məqaləsi; cəbri-həndəsi code construction, proqram reallaşdırması, controlled benchmark və generic-decoding baseline təhlilini birləşdirir.
Hakemlik: Cryptography hakemli jurnaldır; rəsmi MDPI jurnal materiallarında single-blind peer-review prosesi bildirilir.
Preprint statusu: Verianla üçün işlənən sənəd nəşr olunmuş jurnal versiyasıdır; mənbədə ayrıca preprint versiyası işlənməmişdir.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Rəsmi nəşr qeydi: MDPI Cryptography, DOI 10.3390/cryptography10060078.
Əsas elmi sahə: Post-kvant kriptoqrafiya, kod əsaslı kriptoqrafiya, cəbri-həndəsi kodlar və sonlu sahə hesablaması.
Əsas metod: EC və HEC rasional nöqtələrindən evaluation/parity-check matrices yaradılması; \(C=\ker(H)\) üzərindən generator matrix törədilməsi; McEliece və Rao–Nam reallaşdırmalarının eyni benchmark harness altında ölçülməsi.
Benchmark proqramı: Python 3.12.5 və SageMath 10.5.
Benchmark protokolu: 2 GHz single-core reference processor, %5 OS load, hüceyrə başına 10 discarded warm-up və 100 retained run, \(t_e=1\), 10/100/1000-byte payload və perf_counter_ns wall-clock timer.
RNEC şərhi: Reference-normalized relative execution cost-dur; real hardware cycle-count deyil.
Benchmark təhlükəsizlik sinfi: Ölçülən parametrlər toy parametrlərdir və mənbə tərəfindən cryptographic security daşımadığı açıq şəkildə bildirilmişdir.
Generic-decoding təhlili: Prange work factor və tək binary calibration point üzərindən \(\alpha=0.85\) düzəlişi istifadə olunan illustrative baseline-dır; q-ary quantitative security estimate deyil.
Structural security: Cryptographic-scale Schur-product/filtration resistance göstərilməmişdir; heç bir parametr deployment-ready kimi təqdim edilmir.
Enerji ölçümü: Mövcud tədqiqatda birbaşa enerji sərfiyyatı ölçülməmişdir.
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almamışdır.
Məlumat əlçatanlığı: Mənbə complete reproducibility package-ın açıq təqdim edildiyini; reference implementation, exact curve parameters, irreducible polynomials, rational-point/evaluation sets, generator və parity-check matrices, fixed PRNG seeds, benchmark harness, raw timing samples, Figure 13 script-i və Table 6 work-factor estimation script-ini ehtiva etdiyini bildirir.
Maraqların toqquşması: Müəlliflər maraqların toqquşması olmadığını bəyan edirlər.
Müəllif töhfələri: Konseptuallaşdırma Serhii Yevseiev və Stanislav Milevskyi; metod Serhii Yevseiev və Stanislav Milevskyi; proqram təminatı Serhii Pohasii və Vladyslav Sokol; doğrulama Serhii Yevseiev, Stanislav Milevskyi və Olena Akhiiezer; formal təhlil Serhii Yevseiev, Stanislav Milevskyi və Olena Akhiiezer; tədqiqat Serhii Yevseiev və Serhii Pohasii; resurslar Serhii Yevseiev və Vladyslav Sokol; məlumatların idarə olunması Serhii Pohasii və Olena Akhiiezer; ilkin layihə Serhii Yevseiev; nəzərdən keçirmə/redaktə Stanislav Milevskyi, Serhii Pohasii və Olena Akhiiezer; vizuallaşdırma Vladyslav Sokol; rəhbərlik və layihə idarəetməsi Serhii Yevseiev kimi bildirilmişdir.
Əsas metodoloji məhdudiyyətlər: Toy təhlükəsizlik parametrləri; HEC tərəfində yalnız bir genus-2 GF(4) əyri nümunəsi; uyğunlaşdırılmamış EC/HEC miqyaslanması; RNEC-nin wall-clock əsaslı olması; real cycle counter və enerji ölçümünün olmaması; Table 6 generic-decoding dəyərlərinin kobud proxy olması; cryptographic-scale structural attack qiymətləndirilməsinin tamamlanmaması; decoding rutinlərinin constant-time olmaması; Table 4 cycle/call-count məlumatlarının mövcud reproducibility package tərəfindən yenidən istehsal edilməməsi.
Mənbədaxili say qeydi: Cədvəl 3-də McEliece EC/HEC nisbətləri 0,945; 1,300; 7,580 olduğu halda tədqiqatın son matched-comparison mətnində Cədvəl 3 üçün 0,899; 1,257; 7,424 dəyərləri yazılmışdır. Mənbə fərqin səbəbini izah etmir; bu Verianla məzmununda görünən Cədvəl 3 dəyərləri əsas götürülmüş və fərq gizlədilməmişdir.
Şərh sərhədi: Tədqiqatın töhfəsi deployment-ready yeni post-kvant primitive və ya sübut edilmiş yeni security level deyil; EC/HEC əsaslı crypto-code construction-ların yaradılması və reallaşdırma xərcinin təkrar istehsal edilə bilən şəkildə müqayisə olunmasına yönəlmiş metodologiyadır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib