

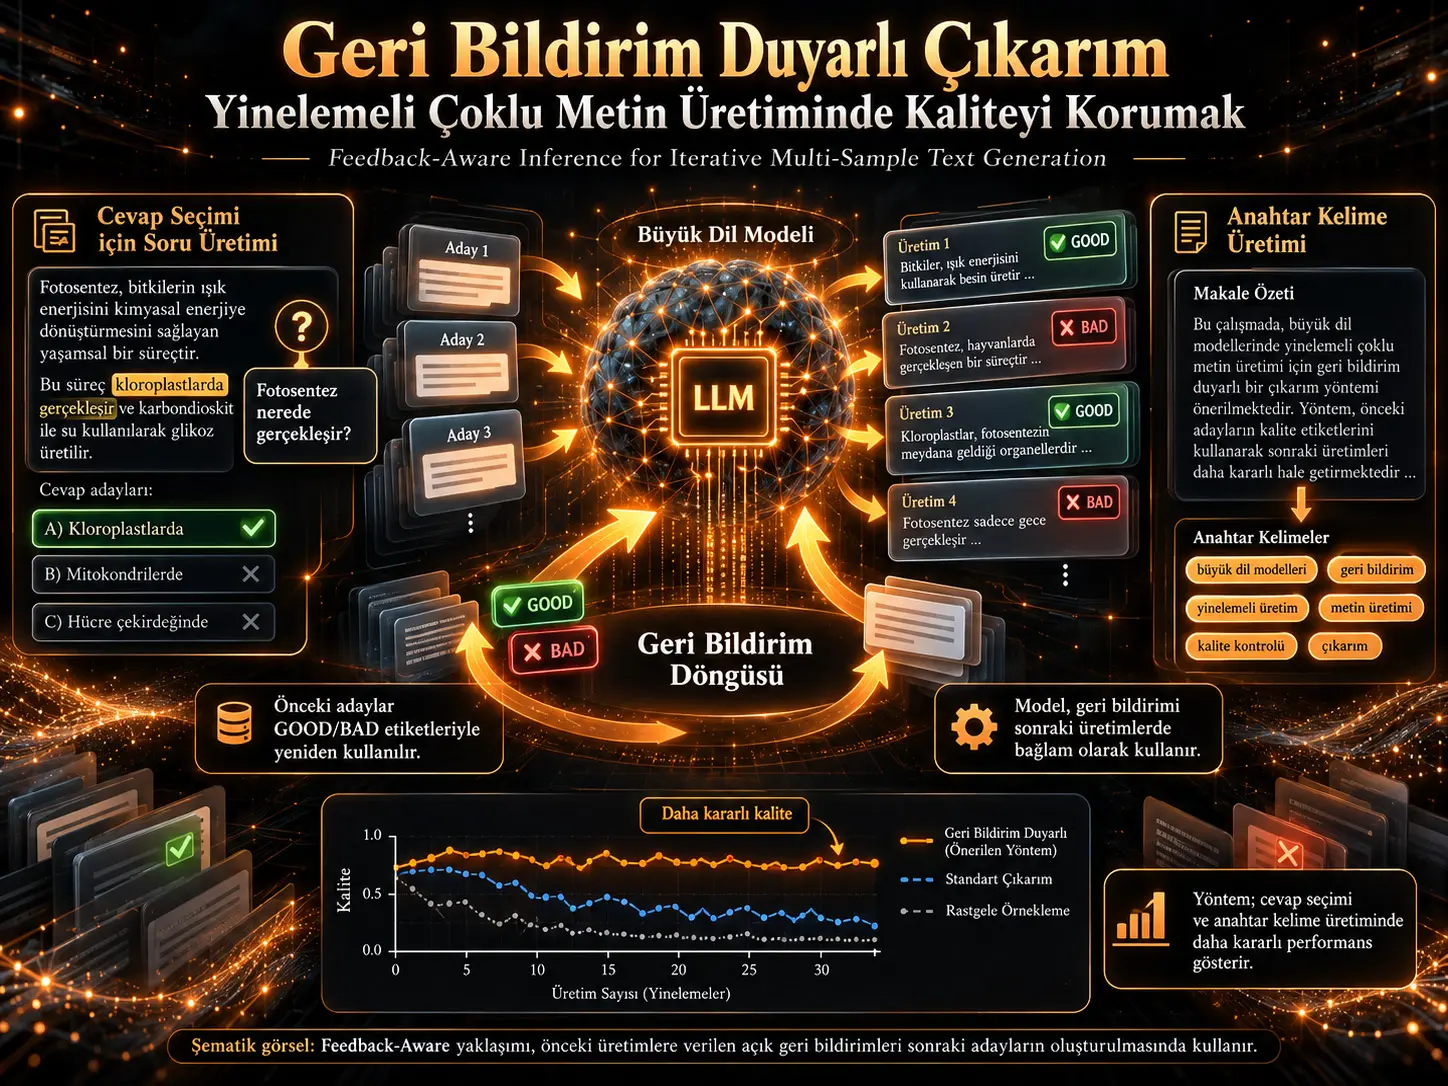
Geri Bildirim Duyarlı Çıkarım (Feedback-Aware Inference, FA), bir dil modelinin aynı bağlam için birden fazla metin adayı üretirken önceki adaylara verilen açık kalite etiketlerini yeni üretimlerin bağlamına ekleyerek yinelemeli iyileştirme yapmasını sağlayan bir çıkarım çerçevesidir. Çalışmada temel model olarak Llama-3 8B kullanılmış, modeller LoRA ile fine-tune edilmiş ve yöntem iki farklı çoklu-üretim görevinde sınanmıştır: soru üretimi için cevap parçası seçimi ve bilimsel metinlerden anahtar kelime üretimi. Feedback-Aware yaklaşımı, özellikle üretilen örnek sayısı arttıkça kaliteyi Single Sequence Generation, All Sequences Generation, All Sequences Generation with Resulting Content ve çalışmada kullanılan GPT-4o baseline'ına göre daha kararlı korumuştur. Bu sonuçlar yalnız incelenen iki görev, tek 8B taban model ve kullanılan etiketleme sistemleri için gösterilmiştir; yöntemin bütün üretken görevlerde, bütün model ölçeklerinde veya bütün feedback türlerinde aynı üstünlüğü göstereceği henüz kanıtlanmamıştır.
Yöntemin ayırt edici özelliği, feedback'i yeni bir parametre güncellemesi olarak değil, sonraki çıkarım adımının prompt geçmişine eklenen yapılandırılmış bir sinyal olarak kullanmasıdır. Model önceki üretimleri ve bunların GOOD veya BAD etiketlerini görür; ardından bir sonraki adayın GOOD olması hedefiyle yeni üretim yapar. Karmaşık görevlerde ayrıca Resulting Content Generator (RCG) adlı isteğe bağlı bir modül kullanılabilir. RCG, üretilen adayın ortaya çıkardığı ek içeriği oluşturur; örneğin cevap parçası seçme görevinde seçilen cevaptan bir soru üretir ve etiketleme sistemi hem cevabı hem bu soruyu birlikte değerlendirebilir.
Deneylerde kullanılan feedback kaynağı görevden göreve değişmektedir. Soru üretimi için cevap seçmede kalite otomatik QGen ve QAns modellerinin oluşturduğu bir değerlendirme hattıyla belirlenmektedir. Anahtar kelime üretiminde ise makale yazarlarının KP20K veri setinde seçtiği anahtar kelimeler GOOD örnekleri olarak kullanılır; karşıt BAD örnekleri benzer fakat ilgili özet için anotasyonda bulunmayan anahtar kelimelerden oluşturulur. Böylece çalışma hem otomatik proxy değerlendirmesinden hem insan kürasyonundan türeyen geri bildirimle aynı çıkarım mimarisinin kullanılabileceğini göstermeyi amaçlamaktadır.
İstatistiksel karşılaştırmalar, yöntemin avantajının özellikle çok sayıda aday üretildiğinde güçlendiğini göstermektedir. Soru-cevap görevinde FA ile SSG arasındaki fark küçük K değerlerinde anlamlı değilken K=20 ve K=25'te belirginleşmiştir. KP20K anahtar kelime görevinde FA'nın SSG ve çalışmadaki GPT-4o baseline'ına göre farkı bütün raporlanan K değerlerinde anlamlıdır; ASG ile fark ise K=1 ve K=3'te anlamlı değilken K=5 ve K=10'da anlamlı hale gelmiştir. Bu desen, yöntemin temel değerinin “ilk örneği mutlaka en iyi üretmekten” çok, örnek sayısı büyürken kalite ve çeşitliliği daha uzun süre korumak olduğunu göstermektedir.
Geri Bildirim Duyarlı Çıkarım Nedir?
Geri Bildirim Duyarlı Çıkarım, önceki üretimlerin GOOD/BAD gibi ayrık kalite etiketlerini ve gerekiyorsa bu üretimlerden türetilen ek içeriği prompt geçmişine ekleyerek sonraki metin adayını yönlendiren, eğitimden sonra yinelemeli çıkarım sırasında çalışan bir çoklu-örnek üretim çerçevesidir.
Tek seferlik üretimin sorunu
Birçok doğal dil işleme görevinin tek bir doğru cevabı yoktur. Bir metinden soru üretilecekse farklı bölümler anlamlı soru-cevap çiftlerine dönüştürülebilir; bir bilimsel özet için de birden fazla geçerli anahtar kelime seçilebilir. Tek bir dizinin üretilmesi, bu çözüm alanının yalnız küçük bir bölümünü kapsar.
Bir modelden aynı bağlam için çok sayıda bağımsız örnek istemek çeşitliliği artırabilir; ancak model daha önce ne ürettiğini veya hangi örneklerin kötü kabul edildiğini hesaba katmıyorsa yeni örneklerin kalitesi giderek düşebilir, tekrarlar oluşabilir ve aday havuzunun daha az yararlı bölgelerine kayılabilir.
Feedback-Aware yaklaşımının hedeflediği problem tam olarak budur: önceki üretimleri çıkarım bağlamının bir parçası haline getirerek modelin hem kabul edilmiş hem reddedilmiş adaylardan sonraki üretim sırasında yararlanmasını sağlamak.
Feedback-Aware yaklaşımı RLHF ve DPO'dan nasıl ayrılıyor?
RLHF ve DPO gibi tercih optimizasyon yöntemleri model parametrelerini eğitim aşamasında insan veya tercih sinyallerine göre uyarlamaya odaklanır. Feedback-Aware Inference ise görev sırasında ortaya çıkan geri bildirimi doğrudan çıkarım bağlamına taşır.
Bu ayrım, Feedback-Aware modelinin hiç eğitilmediği anlamına gelmez. Model önce GOOD/BAD geçmişini nasıl yorumlayacağını öğrenebilmesi için bu yapıya benzeyen promptlarla fine-tune edilir. Fark, her yeni feedback geldiğinde yeniden parametre optimizasyonu yapılmasının gerekmemesidir; yeni feedback bir sonraki prompt'a eklenir.
Yöntem ayrıca büyük sohbet modellerinin serbest biçimli doğal dil eleştirileriyle gerçekleştirdiği self-refinement yaklaşımından da ayrılır. Buradaki feedback uzun eleştiri metinleri olmak zorunda değildir; deneylerde en temel biçimiyle ikili GOOD/BAD etiketidir.
Çerçevenin üç uygulanabilirlik koşulu
Kaynak, Feedback-Aware Inference için üç sınır koşulu tanımlamaktadır. Görevde öğrenilebilir ayrık bir feedback sinyali bulunmalıdır; bu etiketi üretebilecek insan veya otomatik bir Labeling System bulunmalıdır; ayrıca görev tek bir çıktıdan çok birden fazla farklı iyi adayın üretilmesinden yararlanmalıdır.
Şekil 1: eğitim ve çıkarım neden iki ayrı aşamadır?
Kaynak çalışmanın 5. sayfasındaki Şekil 1 iki veri akışını birbirinden ayırır. Eğitim tarafında veri bağlamlarından aday diziler oluşturulur, Labeling System bunlara kalite etiketi atar ve etiketli örnekler Feedback-Aware Model'i fine-tune etmek için kullanılır.
Çıkarım tarafında başlangıç prompt'u yalnız görev açıklaması ve bağlamdan oluşur. Model bir aday üretir. Aday Labeling System tarafından değerlendirilir. Etiket ve aday, gerekiyorsa RCG'nin ürettiği ek içerikle birlikte geçmişe eklenir. Sonraki üretim bu genişlemiş bağlamı görür. Böylece çıkarım tek yönlü bir “prompt → cevap” eşlemesi olmaktan çıkıp üretim → değerlendirme → geçmişi güncelleme → yeni üretim döngüsüne dönüşür.
Labeling System nedir?
Labeling System (LS), üretilen bir dizi \(g\) için kalite etiketi döndüren görev-özel değerlendirme bileşenidir:
\[ LS(g)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
GOOD ve BAD etiketinin bilimsel anlamı sabit değildir. Dilbilgisel doğruluk, bağlama uygunluk, soru üretilebilirliği, konu temsil gücü veya başka görev-özel ölçütler kullanılabilir. Feedback-Aware çerçevesinin genel mekanizması belirli bir kalite metriğine bağlı değildir; ancak gerçek performansı kullanılan Labeling System'in kalitesine bağlıdır.
Resulting Content Generator ne işe yarıyor?
Bazı görevlerde yalnız üretilen adayın kendisine bakmak kaliteyi belirlemek için yeterli değildir. Bu durumda Resulting Content Generator (RCG), adayın yol açacağı ek çıktıyı üretir ve LS kararını iki girdiye göre verebilir:
\[ LS\left(g,RCG(g)\right)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
Çalışmanın cevap seçimi görevinde \(g\) seçilmiş cevap parçasıdır; RCG rolünü QGen üstlenir ve bu parçadan soru oluşturur. Böylece sistem “bu metin parçası yüzeysel olarak makul görünüyor mu?” yerine “bu parçadan bağlama dayalı ve cevaplanabilir bir soru üretilebiliyor mu?” sorusuna yaklaşır.
GOOD/BAD Etiketleri Modeli Çıkarım Sırasında Nasıl Yönlendiriyor?
GOOD/BAD etiketleri, önceki adaylarla birlikte prompt geçmişinde tutulur; Feedback-Aware Model yeni üretim yaparken hangi tür örneklerin kabul veya reddedildiğini bağlam içinde görür ve sonraki adayını bu geçmişe koşullandırır, ancak çıkarım sırasında model ağırlıkları yeniden güncellenmez.
Eğitim veri yapısı
Başlangıç veri seti bağlamlardan oluşur:
\[ D_{\mathrm{initial}}=[C_1,C_2,\ldots,C_n]. \]
Her \(C_i\) bağlamı için birden fazla aday dizi:
\[ [g_{i,1},g_{i,2},\ldots,g_{i,m}] \]
ve bunlara karşılık gelen kalite etiketleri:
\[ [LS(g_{i,1}),LS(g_{i,2}),\ldots,LS(g_{i,m})] \]
oluşturulur. Aynı bağlam için hem GOOD hem BAD örneklerin bulunması, modelin yalnız olumlu örnek biçimini ezberlemesinden ziyade iki kalite sınıfının prompt içindeki anlamını öğrenebilmesi için önemlidir.
Prompt geçmişinin yapısı
Kaynağın 7. sayfasındaki Şekil 2'de genel şablon; görev açıklaması, bağlam ve sıralı geçmişten oluşmaktadır. Her geçmiş satırı bir kalite etiketi ve daha önce üretilmiş diziyi içerir; görev gerektiriyorsa resulting content de aynı satıra eklenir.
Eğitim sırasında kayıp bütün prompt üzerinde hesaplanmaz. Model yalnız şablonun sonundaki hedef GOOD dizinin tokenlarını tahmin etmek üzere optimize edilir. Önceki GOOD/BAD örnekler ve resulting content ise koşullandırma bağlamı işlevi görür.
Çıkarım döngüsünün mantığı
Kaynak Algorithm 1'in işlevsel akışı şu şekilde özetlenebilir: başlangıç prompt'u oluşturulur; model bir GOOD aday üretmeye çalışır; aday ve varsa resulting content LS tarafından değerlendirilir; adayın GOOD olup olmadığı kaydedilir; ardından etiket, aday ve ek içerik prompt geçmişine eklenerek yeni tur başlatılır.
Durdurma koşulu çerçevenin sabit parçası değildir. Kaynak; hedef sayıda kabul edilmiş örneğe ulaşmayı, art arda belirli sayıda BAD sonuç görülmesini veya geçerli aday havuzunun tükenmesini olası durdurma kuralları olarak verir.
Feedback-Aware yöntemi best-of-N'den neden farklıdır?
Best-of-N yaklaşımında sabit bir koşullu dağılımdan çok sayıda bağımsız örnek üretilip en yüksek puanlı örnek seçilir. Feedback-Aware yaklaşımında ise \(t+1\). üretimin dağılımı, \(t\). ve önceki üretimlerin prompt'a geri eklenmesi nedeniyle değişebilir. Dolayısıyla önceki aday yalnız seçme aşamasında değil sonraki üretimin koşullandırılmasında rol oynar.
Çalışmanın Yöntemi ve Bulguları
Karşılaştırılan yöntemler
| Yöntem | Temel çalışma biçimi | Önceki üretim farkındalığı |
|---|---|---|
| Feedback-Aware (FA) | Önceki adayları GOOD/BAD etiketleriyle prompt'a ekleyerek yinelemeli üretim | Evet; açık kalite etiketiyle |
| Single Sequence Generation (SSG) | Bağlamdan tek GOOD aday üretmeye yönelik fine-tuning; çıkarımda çoklu örnekleme | Hayır |
| All Sequences Generation (ASG) | Bir bağlamın GOOD dizilerini birlikte üretmeye yönelik fine-tuning | Üretilen liste yapısı var; GOOD/BAD feedback etiketi yok |
| ASG-RC | ASG yapısına önceki resulting content bilgisini ekler | İçerik geçmişi var; GOOD/BAD etiketi yok |
| GPT-4o | Görev ve tek eğitim örneği içeren one-shot prompt ile liste üretimi | Çalışmadaki kurulumda yinelemeli feedback döngüsü yok |
Model ve eğitim ayarları
FA, SSG, ASG ve ASG-RC modellerinin tabanı Llama-3 8B'dir. Fine-tuning LoRA ile attention katmanlarının projection matrisleri üzerinde yapılmıştır. Bütün ana deneylerin fine-tuning ve inference işlemleri tek bir NVIDIA A100 80 GB GPU üzerinde gerçekleştirilmiştir.
| Aşama | Parametre | Değer |
|---|---|---|
| Eğitim | Taban model | Llama-3 8B |
| Eğitim | Fine-tuning | LoRA; attention projection matrisleri |
| Eğitim | Optimizer | AdamW-8bit |
| Eğitim | Learning rate | \(1\times10^{-5}\) |
| Eğitim | Batch size | 64; gradient accumulation ile |
| Eğitim | Precision | FP16 |
| QGen/QAns | Precision | BF16 |
| Çıkarım | Decoding | Nucleus sampling |
| Çıkarım | Top-k | 20 |
| Çıkarım | Top-p | 0,8 |
| Tümü | Random seed | 42 |
| GPT-4o | Ayarlar | Varsayılan ayarlar |
FA, ASG ve ASG-RC'nin yinelemeli üretiminde her turda 10 örnek oluşturulup en yüksek log-likelihood değerine sahip aday seçilmiştir. SSG için 100 örnek üretilmiş, tekrarlar çıkarılmış ve en üst 25 aday korunmuştur.
Görev 1: Soru üretimi için cevap parçası seçimi
Bu görevde model, verilen bir metinden soru üretmeye elverişli birden fazla cevap parçası seçer. Kalite değerlendirmesi için iki yardımcı model kullanılır:
| Model | Görevi |
|---|---|
| QGen | Bağlam ve seçilmiş cevap parçasından soru üretmek |
| QAns | Üretilen soruyu bağlamdan cevaplamaya çalışmak |
QGen ve QAns, SQuAD, HotpotQA ve NarrativeQA üzerinde ayrı ayrı supervised fine-tuning ile hazırlanmış; FairytaleQA model eğitimine dahil edilmeden genel test olarak kullanılmıştır.
| Veri seti | QGen | QAns |
|---|---|---|
| SQuAD | 0,58 | 0,75 |
| HotpotQA | 0,50 | 0,50 |
| NarrativeQA | 0,54 | 0,60 |
| FairytaleQA | 0,51 | 0,45 |
Bir cevap parçası ne zaman GOOD kabul ediliyor?
Seçilen cevap \(a\) için önce:
\[ q=QGen(ctx,a) \]
ile bir soru üretilir. Ardından QAns modelinin bağlam ve soru verildiğinde \(a\) cevabını üretme olasılığının kaynakta ampirik olarak seçilen %3 eşiğini geçmesi gerekir:
\[ P(QAns(ctx,q)=a)\geq0.03. \]
Bu eşik, eğitim veri setindeki doğru cevap olasılıklarının dağılımına dayanarak seçilmiştir.
İkinci koşul, sorunun gerçekten bağlama bağımlı olmasını amaçlar. Modelin cevabı bağlam olmadan üretme olasılığı, bağlam verildiğindeki olasılığından büyük olmamalıdır:
\[ \frac{P(QAns("",q)=a)} {P(QAns(ctx,q)=a)} \leq1. \]
Cevap dizisinin toplam olasılığı token log-olasılıklarının toplamının üstel dönüşümüyle hesaplanır:
\[ P(QAns(ctx,q)=a) = e^{ \sum_i \log P(a_i\mid ctx,q,a_{0:i-1}) }. \]
Bu ölçütler, seçilen cevabın yalnız metinde görünen rastgele bir kelime değil, bağlama dayanarak anlamlı bir soru-cevap çifti oluşturabilen içerik olmasını hedefler.
Cevap seçimi veri setleri
| Veri seti | Eğitim | Doğrulama | Test |
|---|---|---|---|
| TASA | 10.000 | 1.000 | 1.000 |
| FairytaleQA | 8.548 | 1.025 | 1.007 |
TASA'nın kaynak havuzu 60.000'den fazla pasaj içerir. Çalışmada dil ve sanat, sağlık, bilim, endüstriyel sanatlar, ekonomi, işletme ve sosyal bilimler gibi alanlardan örnekleme yapılmıştır. FairytaleQA ise çocuklara uygun anlatılardan uzmanlar tarafından hazırlanmış soru-cevap verilerini içerir.
Eğitim için olası cevap parçaları her cümlenin constituency parse ağacındaki düğümlerden çıkarılmıştır. Her aday için QGen soru üretmiş ve aday daha sonra LS tarafından GOOD veya BAD olarak etiketlenmiştir.
Görev 2: Anahtar kelime üretimi
Anahtar kelime üretimi KP20K veri setinde değerlendirilmiştir. KP20K yaklaşık 500.000 bilimsel makale özeti ve yazarların seçtiği anahtar kelimeleri içerir. Çalışma bu havuzdan 50.000 eğitim, 2.000 doğrulama ve 2.000 test örneği seçmiştir.
Yazarların ilgili özet için belirlediği anahtar kelimeler GOOD kabul edilmiştir. Veri setinde doğrudan BAD anotasyonu bulunmadığından negatif örnekler yapay olarak oluşturulmuştur. Başka makalelere ait fakat hedef özetle embedding uzayında yüksek benzerlik taşıyan, buna karşın hedef özetin GOOD listesinde bulunmayan anahtar kelimeler seçilmiştir.
Benzerlik hesaplamasında sentence-transformers/all-mpnet-base-v2 encoder modeli kullanılmıştır. Her özet için GOOD anahtar kelime sayısı kadar BAD örnek seçilerek daha zor ve karşılaştırmalı negatifler oluşturulmaya çalışılmıştır.
Değerlendirme metrikleri
Cevap seçimi için Precision@K kullanılır:
\[ P@K= \frac{\text{ilk }K\text{ aday içindeki GOOD sayısı}}{K}. \]
Buradaki \(K\), algoritmanın ayarlanabilir hiperparametresi değil değerlendirme ufkudur. Cevap seçimi için sonuçlar \(K=25\)'e kadar raporlanmıştır.
Anahtar kelime üretiminde F1@K kullanılmış ve değerlendirme \(K=10\)'a kadar sürdürülmüştür. Kaynak, KP20K'de GOOD anahtar kelime sayısının 95. yüzdelik değerinin 10 olduğunu belirterek bu sınırı gerekçelendirmektedir.
Yöntemin Avantajı Neden K Büyüdükçe Daha Belirginleşiyor?
Feedback-Aware yöntemin avantajı K büyüdükçe belirginleşir çünkü model önceki GOOD ve BAD üretimleri görerek tekrarları ve düşük kaliteli adayları daha iyi kaçınabilirken SSG gibi yöntemler her yeni üretimde geçmiş adaylardan habersizdir; bu nedenle ilk örnekte rekabetçi olan yöntemler uzun aday listelerinde daha hızlı kalite kaybedebilir.
Şekil 4'ün bilimsel mesajı
Kaynak Şekil 4a'da cevap seçimi Precision@K eğrileri K arttıkça genel olarak aşağı yönlüdür. Bunun nedeni geçerli cevap havuzunun giderek tüketilmesidir. SSG başlangıçta güçlüdür fakat daha hızlı düşer. ASG önceki liste içeriğini görmenin avantajını taşısa da Feedback-Aware yaklaşımın gerisinde kalır. ASG-RC, cevap seçimi görevindeki en güçlü baselinelardan biridir; resulting content olan sorular modele ek bağlam sağlar fakat GOOD/BAD kalite sinyali bulunmadığı için FA kadar kararlı değildir.
Şekil 4b'de anahtar kelime F1@K eğrileri önce yükselir, yaklaşık orta K değerlerinde tepeye ulaşır ve daha sonra düşer. Kaynağın yorumu bu şeklin model davranışındaki bozulmadan tek başına kaynaklanmadığıdır. Küçük K'de yeterli gerçek anahtar kelime henüz üretilmediği için recall sınırlayıcıdır; K gerçek anahtar kelime havuzunu aştığında ek üretimler BAD sınıfından gelmeye başlar ve precision kaybı F1'i aşağı çeker.
FairytaleQA başlığı altında raporlanan istatistiksel sonuçlar
| K | Baseline | Mean Δ | Holm-düzeltilmiş p | Kaynak anlamlılık |
|---|---|---|---|---|
| 1 | SSG | +0,0005 | \(9.70\times10^{-1}\) | Anlamlı değil |
| 1 | ASG | +0,0812 | \(8.39\times10^{-8}\) | *** |
| 1 | ASG-RC | +0,0244 | \(1.62\times10^{-1}\) | Anlamlı değil |
| 1 | GPT-4o | +0,1340 | \(1.49\times10^{-17}\) | *** |
| 10 | SSG | −0,0001 | \(9.44\times10^{-1}\) | Anlamlı değil |
| 10 | ASG | +0,0496 | \(1.19\times10^{-34}\) | *** |
| 10 | ASG-RC | +0,0125 | \(1.74\times10^{-3}\) | ** |
| 10 | GPT-4o | +0,2520 | \(1.44\times10^{-192}\) | *** |
| 20 | SSG | +0,0517 | \(5.85\times10^{-71}\) | *** |
| 20 | ASG | +0,0633 | \(1.52\times10^{-96}\) | *** |
| 20 | ASG-RC | +0,0376 | \(4.52\times10^{-43}\) | *** |
| 20 | GPT-4o | +0,2841 | \(2.76\times10^{-271}\) | *** |
| 25 | SSG | +0,1104 | \(1.04\times10^{-227}\) | *** |
| 25 | ASG | +0,0632 | \(2.55\times10^{-105}\) | *** |
| 25 | ASG-RC | +0,0529 | \(4.20\times10^{-88}\) | *** |
| 25 | GPT-4o | +0,2828 | \(3.18\times10^{-292}\) | *** |
İstatistiksel testin ana mesajı, SSG'nin K=1 ve K=10'da FA ile pratik olarak aynı düzeyde olabilmesine rağmen K=20 ve K=25'te belirgin biçimde geride kalmasıdır. Bu sonuç “FA ilk üretilen örnekte her zaman daha iyidir” iddiasını desteklemez; “çoklu üretim uzadıkça FA kaliteyi daha iyi korur” iddiasını destekler.
KP20K anahtar kelime üretimindeki istatistiksel sonuçlar
| K | Baseline | Mean Δ | Holm-düzeltilmiş p | Kaynak anlamlılık |
|---|---|---|---|---|
| 1 | SSG | +0,0651 | \(2.76\times10^{-6}\) | *** |
| 1 | ASG | −0,0160 | \(2.59\times10^{-1}\) | Anlamlı değil |
| 1 | GPT-4o | +0,1431 | \(1.41\times10^{-20}\) | *** |
| 3 | SSG | +0,0607 | \(2.90\times10^{-22}\) | *** |
| 3 | ASG | +0,0118 | \(9.45\times10^{-2}\) | Anlamlı değil |
| 3 | GPT-4o | +0,1612 | \(1.12\times10^{-86}\) | *** |
| 5 | SSG | +0,0435 | \(6.47\times10^{-24}\) | *** |
| 5 | ASG | +0,0218 | \(1.33\times10^{-5}\) | *** |
| 5 | GPT-4o | +0,1309 | \(1.99\times10^{-107}\) | *** |
| 10 | SSG | +0,0351 | \(6.94\times10^{-46}\) | *** |
| 10 | ASG | +0,0262 | \(4.69\times10^{-16}\) | *** |
| 10 | GPT-4o | +0,0764 | \(7.48\times10^{-104}\) | *** |
Burada ASG, K=1'de FA'dan sayısal olarak biraz daha yüksek F1 üretmiştir; Mean Δ'nın −0,0160 olması bunu gösterir ve fark istatistiksel olarak anlamlı değildir. K=3'te FA lehine küçük fark da anlamlı değildir. FA'nın ASG'ye göre istatistiksel avantajı K=5 ve K=10'da ortaya çıkmaktadır.
İstatistiksel yöntem
Birincil prosedür, aynı bağlamdaki yöntem sonuçlarını eşleştiren iki yönlü Wilcoxon signed-rank testidir. Kaynak, Precision@K ve F1@K'nin [0,1] aralığında sınırlı ve özellikle küçük K'de ayrık/non-normal özellik göstermesi nedeniyle bu testi tercih etmiştir.
Her K içinde çoklu karşılaştırmalar için Holm–Bonferroni düzeltmesiyle aile düzeyi hata oranı \(\alpha=0.05\) olarak kontrol edilmiştir. Ayrıca paired t-test ve ortalama fark üzerinde 10.000 yeniden örneklemeli paired bootstrap uygulanmış; kaynak bütün K değerlerinde ana Wilcoxon sonucuyla aynı istatistiksel yoruma ulaşıldığını bildirmiştir.
Nitel örnekler ne gösteriyor?
Kaynak Tablo 5, cevap seçimi görevinde Feedback-Aware modelinin ilk beş üretimde “happy”, “vivid”, “lion” ve “personification” gibi farklı semantik yönlere ait dört GOOD cevap üretebildiği; yalnız beşinci adayın BAD olduğu bir örnek sunar. Aynı bağlamda bazı baselinelar daha hızlı biçimde düşük kaliteli veya birbirine yakın adaylara yönelmektedir.
Tablo 6'daki anahtar kelime örneğinde FA sırasıyla “productivity”, “knowledge workers”, “performance indicators”, “experts” ve “management” üretmektedir; bunlardan üçüncüsü kaynak etiketlerine göre BAD, diğer dördü GOOD'dur. Baselinelarda sonraki üretimlerde alakasız veya tekrar niteliğinde adayların daha sık görüldüğü örneklenmektedir.
Kaynak nitel tablolarda REPEATED etiketini semantik olarak daha önce üretilen adayla eşdeğer bir üretimi görünür kılmak için kullanmıştır. Bu etiket nicel değerlendirmede yeni bir kalite sınıfı değildir; tam tekrarlar metrik hesaplamasından önce çıkarılmaktadır.
ORPO alignment deneyi
GOOD ve BAD örneklerin bulunması, araştırmacıları preference alignment yöntemi ORPO'yu ayrıca sınamaya yöneltmiştir. ORPO, seçilmiş ve reddedilmiş cevaplar arasında odds-ratio tabanlı bir ceza kullanır. Deneyde:
\[ \beta=0.3 \]
olarak ayarlanmıştır ve diğer eğitim koşulları supervised fine-tuning düzeniyle aynı tutulmuştur.
Kaynak Figure 5'e göre Feedback-Aware modelinin ORPO sürümü ile standart SFT sürümü benzer davranış göstermektedir. SSG'de ORPO cevap seçiminin ilk örneklerinde yarar sağlayabilse de K büyüdükçe precision daha sert düşmektedir. Anahtar kelime görevinde SSG-ORPO daha başlangıçtan düşük performans göstermiştir.
Yazarların yorumu, ikili tercih optimizasyonunun aday uzayını GOOD/BAD ekseninde daha sert kutuplaştırabilmesi ve bunun çeşitlilik gerektiren çoklu örnek üretiminde dezavantaj yaratabilmesidir. Bu deney, ORPO'nun genel olarak kötü bir alignment yöntemi olduğunu göstermez; yalnız incelenen çoklu üretim görevlerindeki davranışı gösterir.
Hata kipleri
Kaynak üç temel hata mekanizması vurgular. İlk olarak Labeling System zayıf veya sistematik biçimde yanlıysa, yanlış etiketler bir sonraki prompt'a eklendiği için hata düzelmek yerine yinelemeler boyunca pekişebilir.
İkinci olarak her üretim ve etiketi prompt geçmişine eklendiği için bağlam uzunluğu iterasyon sayısıyla büyür. Bu durum context saturation riskini ve çıkarım maliyetini artırır.
Üçüncü olarak belirli bir bağlam için gerçekten iyi aday sayısı sınırlıysa model bir noktadan sonra GOOD havuzunu tüketir. Bu nedenle en iyi yöntemde bile yüksek K değerlerinde metrik düşüşü görülmesi tamamen ortadan kaldırılamaz.
Çalışmanın yöntemsel sınırlılıkları
Hiperparametre araması hesaplama maliyeti nedeniyle bilinçli olarak sınırlı tutulmuştur. Karşılaştırma adaleti için ana model ve baselinelarda ortak eğitim/decoding ayarları kullanılmış olsa da her yöntemin kendi optimum ayarı araştırılmamıştır.
Framework eğitim için negatif örneklere ihtiyaç duyar. KP20K gibi yalnız pozitif anotasyona sahip veri setlerinde BAD örneklerin ayrıca oluşturulması gerekir; negatifler fazla kolay seçilirse model GOOD/BAD ayrımını yüzeysel biçimde öğrenebilir.
Performans Labeling System kalitesine bağımlıdır. Çalışmadaki FairytaleQA gözlemi orta düzeyde etiketleme kusuruna belirli bir dayanıklılık olduğuna işaret etse de kontrollü biçimde artan gürültü seviyeleriyle sistematik robustness deneyi yapılmamıştır.
Yinelemeli süreç tek geçişli modellere göre ek çıkarım maliyeti getirir: daha fazla generation çağrısı, Labeling System çağrıları ve iterasyonla doğrusal büyüyen prompt geçmişi vardır. Makale wall-clock latency, throughput ve GPU bellek profillerini üretim ortamı için ayrıntılı benchmark olarak sunmamıştır.
Deneysel feedback yalnız binary GOOD/BAD biçimindedir. Framework daha zengin etiket yapısını kavramsal olarak desteklese de dereceli veya çok boyutlu feedback deneysel olarak test edilmemiştir.
Son olarak bütün ana fine-tuning deneyleri tek bir 8B taban model üzerinde yapılmıştır. Sonuçların çok daha küçük, çok daha büyük veya farklı mimari ailelerine doğrudan genellenebilirliği henüz gösterilmemiştir.
Çalışmanın desteklediği sonuçlar
Çalışma, uygun biçimde fine-tune edilmiş 8B ölçekli bir açık kaynak modelin açık GOOD/BAD feedback geçmişini çıkarım prompt'unda kullanarak iki incelenen çoklu metin üretimi görevinde kaliteyi iterasyonlar boyunca güçlü baselinelardan daha kararlı koruyabildiğini desteklemektedir.
İstatistiksel sonuçlar özellikle yüksek K rejiminde Feedback-Aware yaklaşım lehine farkların büyüdüğünü desteklemektedir. Bu sonuç, eğitim teknolojilerinde çok sayıda soru adayı, geniş değerlendirme madde havuzları veya sonradan filtrelenecek anahtar kelime adayları gibi oversampling senaryolarıyla uyumludur.
Çalışma ayrıca feedback kaynağının tek bir mekanizmaya bağlı olmadığını gösteren iki örnek sunmaktadır: cevap seçimi için otomatik proxy modeller ve anahtar kelime üretimi için insan tarafından küratörlenmiş anotasyonlar.
Çalışmanın desteklemediği sonuçlar
Çalışma Feedback-Aware yönteminin bütün NLP görevlerinde bütün büyük modellerden üstün olduğunu göstermez. Yalnız iki görev ve tek ana 8B model ailesi değerlendirilmiştir.
GPT-4o baseline'ının düşük performansı GPT-4o'nun genel model kapasitesinin Llama-3 8B'den düşük olduğunu göstermez. Deneyde GPT-4o one-shot prompting ile kullanılırken diğer ana modeller görev-özel fine-tuning görmüştür; dolayısıyla sonuç yalnız bu deney protokolüne aittir.
Çalışma feedback'in her zaman hataları düzelttiğini de göstermez. Hatalı veya yanlı LS sinyali aynı feedback döngüsü içinde hatanın sonraki üretimlere taşınmasına yol açabilir.
“Daha küçük modeller büyük proprietary LLM'lerin bütün iterative reasoning yeteneklerini aynı düzeyde sağlayabilir” sonucu da kaynak tarafından kanıtlanmamıştır. Gösterilen şey, incelenen iki çoklu-üretim görevinde yapılandırılmış feedback mekanizmasının 8B modelde yararlı olmasıdır.
Kaynak içindeki raporlama belirsizlikleri
TASA test bölümü 1000 ve FairytaleQA test bölümü 1007 örnek olarak verilmesine rağmen istatistiksel Tablo 3 “FairytaleQA, n=2007” biçiminde etiketlenmiştir. 2007 sayısı iki test bölümünün toplamına eşittir; ancak kaynak bunun birleşik analiz olduğunu açıkça söylemediğinden burada yalnız tutarsızlık görünür tutulmuştur.
KP20K'de 2000 test örneğinin seçildiği belirtilirken Tablo 4 istatistiksel karşılaştırmayı n=1998 bağlam üzerinde raporlar. İki örneğin neden analize girmediği kaynakta açıklanmamıştır.
Keyword Generation bölümünün KP20K kullandığı açıkça belirtilmesine karşın Tablo 6'daki örnek bağlamın sonunda “FairytaleQA dataset entry [15]” kaynak ifadesi bulunur. Verianla bu kaynağı sessizce KP20K olarak değiştirmemektedir.
Gelecek çalışma yönleri
Yazarlar framework'ün daha geniş üretken görev yelpazesinde, farklı model ölçeklerinde ve farklı mimarilerde sınanmasını önermektedir. Özellikle sentetik olarak bozulmuş Labeling System'lerle kontrollü feedback-noise deneyleri, modelin yanlış geri bildirime dayanıklılığını doğrudan ölçebilir.
Üretim ortamına yönelik wall-clock latency, throughput ve GPU bellek ölçümleri de gelecekteki önemli ihtiyaçlardan biridir; çünkü yinelemeli feedback döngüsünün kalite avantajı ek inference maliyetiyle birlikte değerlendirilmelidir.
Binary GOOD/BAD etiketinin ötesinde dereceli puanlar veya farklı kalite boyutlarını ayrı ayrı ifade eden çok boyutlu feedback yapıları da araştırılabilir.
Kaynak son olarak matematiksel problem çözme, mantıksal çıkarım veya bilimsel açıklama gibi çok aşamalı reasoning görevlerinde ara adımlara feedback uygulanmasını olası genişleme alanı olarak önermektedir. Bu kullanım çalışmada deneysel olarak doğrulanmış değildir.
Kaynak ve Yöntem Notu
Özgün çalışma: Feedback-Aware Inference for Iterative Multi-Sample Text Generation
Yazarlar: Andreea Dutulescu; Stefan Ruseti; Mihai Dascalu; Danielle S. McNamara.
Sorumlu yazar: Stefan Ruseti.
Kurumlar: Computer Science and Engineering Department, National University of Science and Technology POLITEHNICA Bucharest, Romanya; Academy of Romanian Scientists, Romanya; Learning Engineering Institute, Arizona State University, ABD.
Dergi: AI.
Yayınevi: MDPI.
Kaynak türü: Hakemli özgün araştırma makalesi; doğal dil işleme, dil modeli fine-tuning ve yinelemeli çıkarım deneyleri.
Yayın bilgisi: AI 2026, cilt 7, sayı 5, makale 171.
DOI: 10.3390/ai7050171
Gönderim: 1 Nisan 2026.
Revizyon: 8 Mayıs 2026.
Kabul: 12 Mayıs 2026.
Yayın: 15 Mayıs 2026.
Lisans: Creative Commons Attribution (CC BY), açık erişim.
Finansman: Araştırma Romanian Hub for Artificial Intelligence—HRIA projesi, Smart Growth, Digitization and Financial Instruments Program 2021–2027 kapsamında MySMIS no. 351416; U.S. Department of Education Institute of Education Sciences tarafından Arizona State University'ye verilen R305T240035 numaralı hibe ve Academy of Romanian Scientists AOSR-TEAMS-IV Edition 2025–2026 “Digital Transformation in Science” hibesiyle desteklenmiştir.
Kurumsal etik kurul: Uygulanabilir değil.
Bilgilendirilmiş onam: Uygulanabilir değil.
Veri, kod ve model erişimi: Yazarlar çalışmanın veri, kod ve fine-tune edilmiş modellerini açık bir GitHub deposunda yayımladıklarını bildirmektedir.
Üretken AI kullanım beyanı: Yazarlar makalenin hazırlanmasında üretken yapay zekânın yalnız yazım denetimi ve dilbilgisi amaçlarıyla kullanıldığını; çıktının kendileri tarafından incelenip düzenlendiğini ve içeriğin sorumluluğunu üstlendiklerini belirtmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir. Finansman sağlayıcıların çalışma tasarımı, veri toplama/analiz/yorumlama, makale yazımı veya yayın kararında rolü olmadığı bildirilmiştir.
Yazar katkıları: Kavramsallaştırma Andreea Dutulescu, Stefan Ruseti ve Mihai Dascalu; metodoloji Andreea Dutulescu ve Stefan Ruseti; yazılım, formal analiz, araştırma, kaynaklar, veri kürasyonu, ilk taslak ve görselleştirme Andreea Dutulescu; doğrulama Andreea Dutulescu, Stefan Ruseti ve Mihai Dascalu; gözden geçirme ve düzenleme dört yazarın tamamı; denetim Stefan Ruseti, Mihai Dascalu ve Danielle S. McNamara; proje yönetimi Mihai Dascalu; finansman edinimi Stefan Ruseti, Mihai Dascalu ve Danielle S. McNamara tarafından yürütülmüştür.
Temel yöntemsel sınırlılıklar: Yalnız iki görev değerlendirilmiştir; tek 8B taban model kullanılmıştır; hiperparametre araması sınırlıdır; negatif örnek gereksinimi vardır; etiketleme sisteminin hataları feedback döngüsünde yayılabilir; inference maliyeti tek geçişli yöntemlerden yüksektir; binary feedback dışındaki yapılar test edilmemiştir; üretim ortamı latency/throughput/GPU bellek benchmarkları sunulmamıştır.
Kaynak içi raporlama notu: FairytaleQA test sayısı ile Tablo 3'teki n=2007 etiketi, KP20K test sayısı ile Tablo 4'teki n=1998 değeri ve Tablo 6'daki FairytaleQA kaynak etiketi arasında açıklanmamış tutarsızlıklar bulunmaktadır. Bu noktalar Verianla tarafından sessizce düzeltilmemiştir.
Verianla yöntem notu: Bu içerik kaynak makalenin cümle cümle çevirisi veya paragraf-paragraf yakın yeniden yazımı değildir. Araştırma problemi, Feedback-Aware training/inference yapısı, GOOD/BAD feedback sistemi, QGen/QAns değerlendirme mantığı, veri setleri, model ayarları, P@K ve F1@K sonuçları, istatistiksel testler, nitel analiz, ORPO deneyi, sınırlılıklar ve gelecek çalışma önerileri korunarak bağımsız bir Türkçe bilimsel öğrenme yapısı oluşturulmuştur.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir