

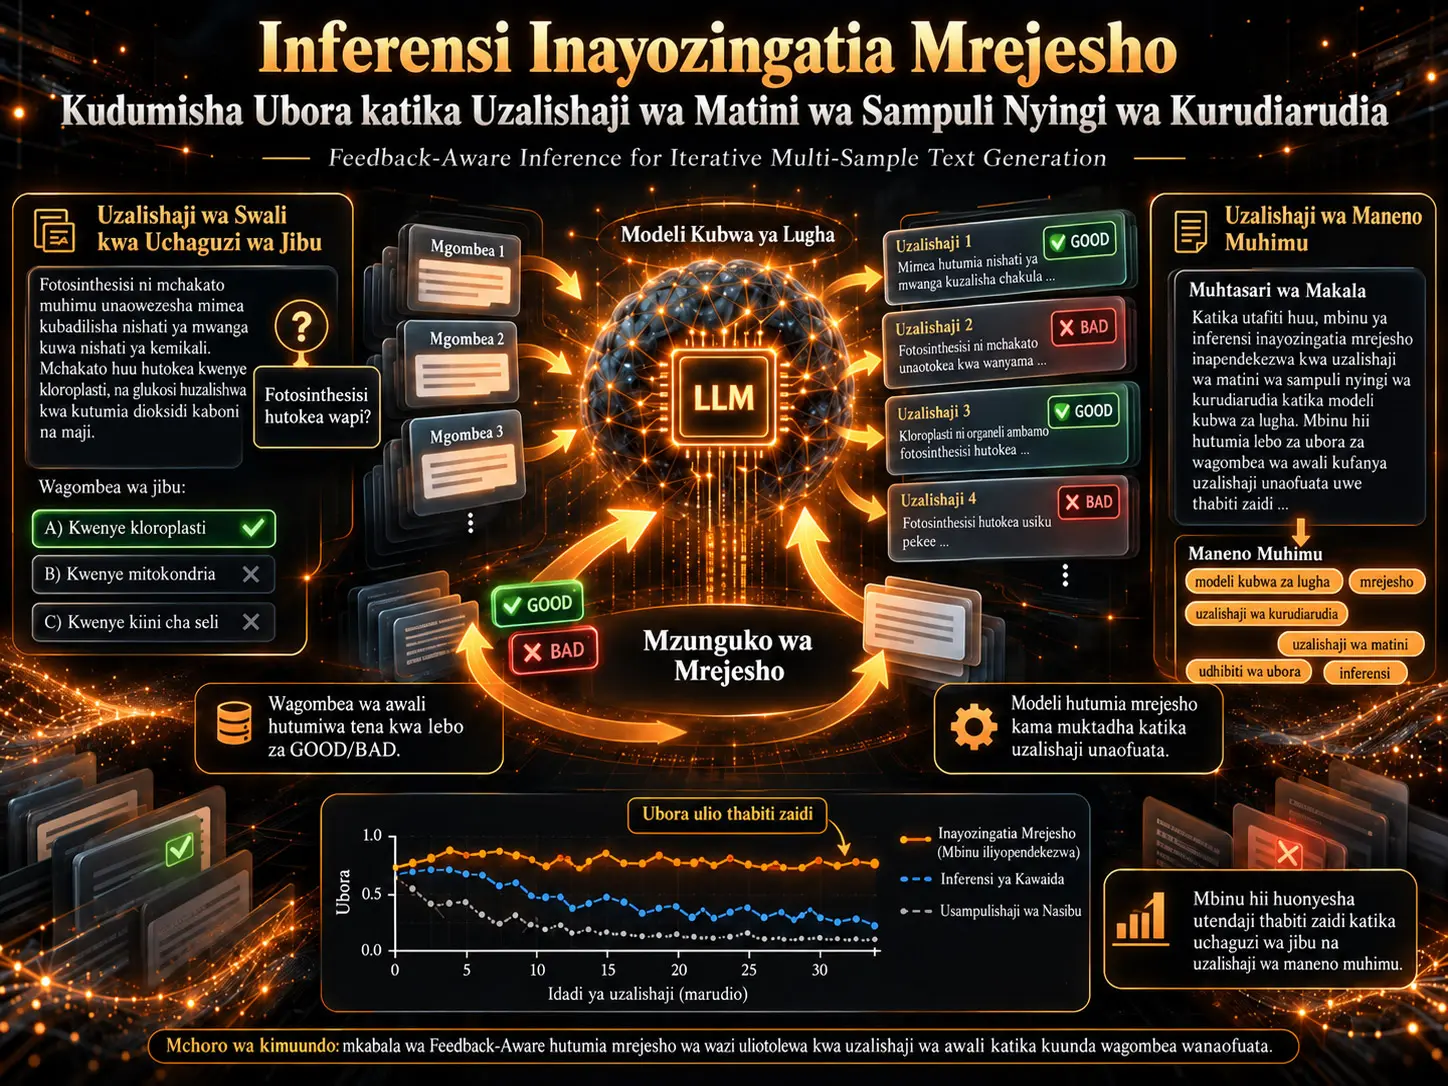
Inferensi Inayozingatia Mrejesho (Feedback-Aware Inference, FA), ni mfumo wa inferensi unaowezesha modeli ya lugha kufanya uboreshaji wa kurudiarudia kwa kuongeza kwenye muktadha wa uzalishaji mpya lebo za wazi za ubora zilizotolewa kwa wagombea wa awali wakati modeli inazalisha wagombea kadhaa wa matini kwa muktadha uleule. Katika utafiti, Llama-3 8B ilitumika kama modeli msingi, modeli zilifanyiwa fine-tuning kwa LoRA, na mbinu ilijaribiwa katika kazi mbili tofauti za uzalishaji wa sampuli nyingi: kuchagua kipande cha jibu kwa ajili ya uzalishaji wa swali na kuzalisha maneno muhimu kutoka matini za kisayansi. Mbinu ya Feedback-Aware ilidumisha ubora kwa uthabiti zaidi kuliko Single Sequence Generation, All Sequences Generation, All Sequences Generation with Resulting Content na baseline ya GPT-4o iliyotumika katika utafiti, hasa idadi ya sampuli zilizozalishwa ilipoongezeka. Matokeo haya yameonyeshwa tu kwa kazi mbili zilizochunguzwa, modeli msingi moja ya 8B na mifumo ya uwekaji lebo iliyotumika; bado haijathibitishwa kwamba mbinu itaonyesha ubora huohuo katika kazi zote za uzalishaji, mizani yote ya modeli au aina zote za mrejesho.
Sifa bainifu ya mbinu ni kutumia mrejesho si kama sasisho jipya la vigezo, bali kama ishara iliyopangiliwa inayoongezwa kwenye historia ya prompt ya hatua inayofuata ya inferensi. Modeli huona uzalishaji wa awali na lebo zake za GOOD au BAD; kisha huzalisha mgombea mpya kwa lengo la mgombea anayefuata kuwa GOOD. Katika kazi changamano, moduli ya hiari iitwayo Resulting Content Generator (RCG) pia inaweza kutumika. RCG huzalisha maudhui ya ziada yanayotokana na mgombea aliyezalishwa; kwa mfano, katika kazi ya kuchagua kipande cha jibu, huzalisha swali kutokana na jibu lililochaguliwa, na mfumo wa uwekaji lebo unaweza kutathmini jibu na swali hilo kwa pamoja.
Chanzo cha mrejesho kinachotumiwa katika majaribio hubadilika kulingana na kazi. Katika kuchagua jibu kwa ajili ya uzalishaji wa swali, ubora huamuliwa kupitia mnyororo wa tathmini unaoundwa na modeli otomatiki za QGen na QAns. Katika uzalishaji wa maneno muhimu, maneno muhimu yaliyochaguliwa na waandishi wa makala katika mkusanyiko wa data wa KP20K hutumiwa kama sampuli za GOOD; sampuli kinzani za BAD huundwa kutokana na maneno muhimu yanayofanana lakini ambayo hayapo katika anoteshini ya muhtasari husika. Kwa njia hii, utafiti unalenga kuonyesha kwamba usanifu uleule wa inferensi unaweza kutumiwa kwa mrejesho unaotokana na tathmini otomatiki ya proxy na pia na uratibu wa kibinadamu.
Ulinganisho wa kitakwimu unaonyesha kwamba faida ya mbinu huongezeka hasa wakati idadi kubwa ya wagombea inazalishwa. Katika kazi ya swali-jibu, tofauti kati ya FA na SSG si ya maana katika thamani ndogo za K, lakini huwa wazi katika K=20 na K=25. Katika kazi ya maneno muhimu ya KP20K, tofauti ya FA dhidi ya SSG na baseline ya GPT-4o ya utafiti ni ya maana katika thamani zote za K zilizoripotiwa; tofauti dhidi ya ASG si ya maana katika K=1 na K=3, lakini huwa ya maana katika K=5 na K=10. Muundo huu unaonyesha kwamba thamani kuu ya mbinu si sana “kuzalisha sampuli ya kwanza iwe bora kwa lazima”, bali kudumisha ubora na utofauti kwa muda mrefu zaidi kadiri idadi ya sampuli inavyoongezeka.
Inferensi Inayozingatia Mrejesho ni Nini?
Inferensi inayozingatia mrejesho ni mfumo wa uzalishaji wa sampuli nyingi unaofanya kazi wakati wa inferensi ya kurudiarudia baada ya mafunzo, ambao huongoza mgombea wa matini anayefuata kwa kuongeza kwenye historia ya prompt lebo bainifu za ubora za uzalishaji wa awali, kama GOOD/BAD, na inapohitajika maudhui ya ziada yanayotokana na uzalishaji huo.
Tatizo la uzalishaji wa mara moja
Kazi nyingi za uchakataji wa lugha asilia hazina jibu moja tu sahihi. Ikiwa swali litazalishwa kutoka kwenye matini, sehemu tofauti zinaweza kugeuzwa kuwa jozi za swali-jibu zenye maana; kwa muhtasari wa kisayansi pia maneno muhimu kadhaa halali yanaweza kuchaguliwa. Kuzalisha mfuatano mmoja tu hufunika sehemu ndogo ya nafasi hii ya suluhisho.
Kuiomba modeli sampuli nyingi huru kwa muktadha uleule kunaweza kuongeza utofauti; hata hivyo, ikiwa modeli haizingatii ilichozalisha hapo awali au ni sampuli zipi zilizokubaliwa kuwa mbaya, ubora wa sampuli mpya unaweza kushuka hatua kwa hatua, marudio yanaweza kutokea na uzalishaji unaweza kuelekea maeneo yasiyo na manufaa sana ya hazina ya wagombea.
Hili ndilo hasa tatizo linalolengwa na mbinu ya Feedback-Aware: kufanya uzalishaji wa awali kuwa sehemu ya muktadha wa inferensi ili modeli iweze kutumia wagombea waliokubaliwa na waliokataliwa wakati wa uzalishaji unaofuata.
Mbinu ya Feedback-Aware inatofautianaje na RLHF na DPO?
Mbinu za uboreshaji wa upendeleo kama RLHF na DPO hulenga kurekebisha vigezo vya modeli kulingana na ishara za binadamu au za upendeleo katika hatua ya mafunzo. Feedback-Aware Inference, kwa upande mwingine, huleta mrejesho unaotokea wakati wa kazi moja kwa moja kwenye muktadha wa inferensi.
Tofauti hii haimaanishi kwamba modeli ya Feedback-Aware haijafunzwa kabisa. Modeli hufanyiwa fine-tuning kwa prompt zinazofanana na muundo huu ili iweze kujifunza jinsi ya kutafsiri historia ya GOOD/BAD. Tofauti ni kwamba kila mrejesho mpya unapowasili hakuna haja ya kufanya upya uboreshaji wa vigezo; mrejesho mpya huongezwa kwenye prompt inayofuata.
Mbinu pia hutofautiana na njia ya self-refinement inayotekelezwa na modeli kubwa za mazungumzo kwa ukosoaji wa lugha asilia wa muundo huru. Mrejesho hapa si lazima uwe matini ndefu ya ukosoaji; katika majaribio, umbo lake la msingi zaidi ni lebo ya jozi GOOD/BAD.
Masharti matatu ya utekelezekaji wa mfumo
Chanzo kinafafanua masharti matatu ya mpaka kwa Feedback-Aware Inference. Kazi lazima iwe na ishara bainifu ya mrejesho inayoweza kujifunzwa; lazima kuwe na binadamu au Labeling System otomatiki inayoweza kuzalisha lebo hiyo; na kazi lazima inufaike na uzalishaji wa wagombea kadhaa tofauti na wazuri badala ya matokeo moja pekee.
Kielelezo 1: kwa nini mafunzo na inferensi ni hatua mbili tofauti?
Kielelezo 1 kwenye ukurasa wa 5 wa utafiti chanzo hutenganisha mitiririko miwili ya data. Upande wa mafunzo, mifuatano ya wagombea huzalishwa kutoka kwenye miktadha ya data, Labeling System huwapa lebo za ubora, na sampuli zenye lebo hutumiwa kufanya fine-tuning ya Feedback-Aware Model.
Upande wa inferensi, prompt ya mwanzo huwa na maelezo ya kazi na muktadha pekee. Modeli huzalisha mgombea. Mgombea hutathminiwa na Labeling System. Lebo na mgombea huongezwa kwenye historia, pamoja na maudhui ya ziada yaliyotolewa na RCG ikiwa yanahitajika. Uzalishaji unaofuata huona muktadha huu uliopanuliwa. Kwa hiyo inferensi huacha kuwa ulinganishaji wa upande mmoja wa “prompt → jibu” na kuwa mzunguko wa uzalishaji → tathmini → kusasisha historia → uzalishaji mpya.
Labeling System ni nini?
Labeling System (LS) ni sehemu ya tathmini mahususi kwa kazi ambayo hurudisha lebo ya ubora kwa mfuatano uliotengenezwa \(g\):
\[ LS(g)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
Maana ya kisayansi ya lebo GOOD na BAD si ya kudumu. Usahihi wa kisarufi, kufaa kwa muktadha, uwezekano wa kuzalisha swali, nguvu ya kuwakilisha mada au vigezo vingine mahususi kwa kazi vinaweza kutumika. Utaratibu wa jumla wa mfumo wa Feedback-Aware haujafungamana na kipimo maalum cha ubora; hata hivyo, utendaji wake halisi unategemea ubora wa Labeling System inayotumika.
Resulting Content Generator hufanya nini?
Katika baadhi ya kazi, kuangalia mgombea aliyezalishwa peke yake hakutoshi kubaini ubora. Katika hali hii, Resulting Content Generator (RCG) huzalisha matokeo ya ziada yatakayosababishwa na mgombea, na LS inaweza kufanya uamuzi kwa kuzingatia ingizo mbili:
\[ LS\left(g,RCG(g)\right)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
Katika kazi ya kuchagua jibu ya utafiti, \(g\) ni kipande cha jibu kilichochaguliwa; QGen huchukua jukumu la RCG na huzalisha swali kutoka kwenye kipande hiki. Kwa njia hii, mfumo unasogea kutoka swali la “je, kipande hiki cha matini kinaonekana kuwa cha kuridhisha kijuujuu?” kwenda swali la “je, swali linalotegemea muktadha na linaloweza kujibiwa linaweza kuzalishwa kutoka kwenye kipande hiki?”
Lebo za GOOD/BAD Huongozaje Modeli Wakati wa Inferensi?
Lebo za GOOD/BAD huhifadhiwa katika historia ya prompt pamoja na wagombea wa awali; wakati Feedback-Aware Model inazalisha jibu jipya, huona ndani ya muktadha ni aina gani za sampuli zilizokubaliwa au kukataliwa na hushurutisha mgombea anayefuata kwa historia hii, lakini uzito wa modeli hausasishwi upya wakati wa inferensi.
Muundo wa data ya mafunzo
Mkusanyiko wa data wa awali hujumuisha miktadha:
\[ D_{\mathrm{initial}}=[C_1,C_2,\ldots,C_n]. \]
Kwa kila muktadha wa \(C_i\), mifuatano kadhaa ya wagombea:
\[ [g_{i,1},g_{i,2},\ldots,g_{i,m}] \]
na lebo zao za ubora zinazolingana:
\[ [LS(g_{i,1}),LS(g_{i,2}),\ldots,LS(g_{i,m})] \]
huzalishwa. Kuwa na sampuli za GOOD na BAD kwa muktadha uleule ni muhimu ili modeli ijifunze maana ya madaraja mawili ya ubora ndani ya prompt, badala ya kukariri tu umbo la sampuli chanya.
Muundo wa historia ya prompt
Katika Kielelezo 2 cha ukurasa wa 7 wa chanzo, kiolezo cha jumla kinajumuisha maelezo ya kazi, muktadha na historia iliyopangwa. Kila mstari wa historia una lebo ya ubora na mfuatano uliotengenezwa hapo awali; ikiwa kazi inahitaji, resulting content pia huongezwa kwenye mstari huohuo.
Wakati wa mafunzo, loss haihesabiwi juu ya prompt nzima. Modeli huboreshwa ili kutabiri token za mfuatano lengwa wa GOOD mwishoni mwa kiolezo pekee. Sampuli za awali za GOOD/BAD na resulting content hutumika kama muktadha wa kushurutisha.
Mantiki ya mzunguko wa inferensi
Mtiririko wa kiutendaji wa Algorithm 1 katika chanzo unaweza kufupishwa hivi: prompt ya mwanzo huundwa; modeli hujaribu kuzalisha mgombea wa GOOD; mgombea na resulting content ikiwa ipo hutathminiwa na LS; huandikwa ikiwa mgombea ni GOOD au la; kisha lebo, mgombea na maudhui ya ziada huongezwa kwenye historia ya prompt na mzunguko mpya huanza.
Sharti la kusitisha si sehemu ya kudumu ya mfumo. Chanzo kinataja kufikia idadi lengwa ya sampuli zilizokubaliwa, kuona idadi fulani ya matokeo ya BAD mfululizo, au kumalizika kwa hazina ya wagombea halali kama sheria zinazowezekana za kusitisha.
Kwa nini mbinu ya Feedback-Aware ni tofauti na best-of-N?
Katika mbinu ya Best-of-N, sampuli nyingi huru huzalishwa kutoka kwenye usambazaji wa masharti usiobadilika na sampuli yenye alama ya juu zaidi huchaguliwa. Katika Feedback-Aware, usambazaji wa uzalishaji wa \(t+1\) unaweza kubadilika kwa sababu uzalishaji wa \(t\) na uzalishaji wa awali huongezwa tena kwenye prompt. Kwa hiyo mgombea wa awali huwa na nafasi si katika hatua ya uteuzi tu bali pia katika kushurutisha uzalishaji unaofuata.
Mbinu na Matokeo ya Utafiti
Mbinu zilizolinganishwa
| Mbinu | Namna kuu ya kufanya kazi | Ufahamu wa uzalishaji wa awali |
|---|---|---|
| Feedback-Aware (FA) | Uzalishaji wa kurudiarudia kwa kuongeza wagombea wa awali kwenye prompt wakiwa na lebo za GOOD/BAD | Ndiyo; kwa lebo ya wazi ya ubora |
| Single Sequence Generation (SSG) | Fine-tuning inayolenga kuzalisha mgombea mmoja wa GOOD kutoka kwenye muktadha; sampling ya sampuli nyingi wakati wa inferensi | Hapana |
| All Sequences Generation (ASG) | Fine-tuning inayolenga kuzalisha kwa pamoja mifuatano ya GOOD ya muktadha mmoja | Kuna muundo wa orodha iliyozalishwa; hakuna lebo ya feedback ya GOOD/BAD |
| ASG-RC | Huongeza taarifa ya resulting content ya awali kwenye muundo wa ASG | Kuna historia ya maudhui; hakuna lebo ya GOOD/BAD |
| GPT-4o | Uzalishaji wa orodha kwa one-shot prompt yenye kazi na sampuli moja ya mafunzo | Katika usanidi wa utafiti hakuna mzunguko wa feedback wa kurudiarudia |
Mipangilio ya modeli na mafunzo
Msingi wa modeli za FA, SSG, ASG na ASG-RC ni Llama-3 8B. Fine-tuning ilifanywa kwa LoRA juu ya matriksi za projection za tabaka za attention. Michakato yote ya fine-tuning na inference ya majaribio makuu ilifanywa kwenye NVIDIA A100 80 GB GPU moja.
| Hatua | Kigezo | Thamani |
|---|---|---|
| Mafunzo | Modeli msingi | Llama-3 8B |
| Mafunzo | Fine-tuning | LoRA; matriksi za attention projection |
| Mafunzo | Optimizer | AdamW-8bit |
| Mafunzo | Learning rate | \(1\times10^{-5}\) |
| Mafunzo | Batch size | 64; kwa gradient accumulation |
| Mafunzo | Precision | FP16 |
| QGen/QAns | Precision | BF16 |
| Inferensi | Decoding | Nucleus sampling |
| Inferensi | Top-k | 20 |
| Inferensi | Top-p | 0,8 |
| Zote | Random seed | 42 |
| GPT-4o | Mipangilio | Mipangilio chaguomsingi |
Katika uzalishaji wa kurudiarudia wa FA, ASG na ASG-RC, sampuli 10 zilitengenezwa katika kila mzunguko na mgombea mwenye thamani ya juu zaidi ya log-likelihood alichaguliwa. Kwa SSG, sampuli 100 zilitengenezwa, marudio yaliondolewa na wagombea 25 wa juu walihifadhiwa.
Kazi 1: kuchagua kipande cha jibu kwa ajili ya uzalishaji wa swali
Katika kazi hii, modeli huchagua vipande kadhaa vya jibu kutoka kwenye matini iliyopewa ambavyo vinafaa kwa kuzalisha swali. Modeli mbili saidizi hutumiwa kutathmini ubora:
| Modeli | Kazi yake |
|---|---|
| QGen | Kuzalisha swali kutoka kwenye muktadha na kipande cha jibu kilichochaguliwa |
| QAns | Kujaribu kujibu swali lililozalishwa kwa kutumia muktadha |
QGen na QAns ziliandaliwa kwa supervised fine-tuning tofauti kwenye SQuAD, HotpotQA na NarrativeQA; FairytaleQA ilitumika kama jaribio la jumla bila kuingizwa katika mafunzo ya modeli.
| Mkusanyiko wa data | QGen | QAns |
|---|---|---|
| SQuAD | 0,58 | 0,75 |
| HotpotQA | 0,50 | 0,50 |
| NarrativeQA | 0,54 | 0,60 |
| FairytaleQA | 0,51 | 0,45 |
Kipande cha jibu hukubaliwa kuwa GOOD lini?
Kwa jibu lililochaguliwa \(a\), kwanza:
\[ q=QGen(ctx,a) \]
swali huzalishwa. Kisha uwezekano wa modeli ya QAns kuzalisha jibu \(a\) inapopewa muktadha na swali lazima uzidi kizingiti cha %3 kilichochaguliwa kwa njia ya majaribio katika chanzo:
\[ P(QAns(ctx,q)=a)\geq0.03. \]
Kizingiti hiki kilichaguliwa kwa kuzingatia usambazaji wa uwezekano wa majibu sahihi katika mkusanyiko wa data wa mafunzo.
Sharti la pili linalenga kuhakikisha kwamba swali linategemea muktadha kweli. Uwezekano wa modeli kuzalisha jibu bila muktadha haupaswi kuwa mkubwa kuliko uwezekano wake inapopewa muktadha:
\[ \frac{P(QAns("",q)=a)} {P(QAns(ctx,q)=a)} \leq1. \]
Uwezekano wa jumla wa mfuatano wa jibu huhesabiwa kwa ugeuzaji wa kieksponenti wa jumla ya log-uwezekano za token:
\[ P(QAns(ctx,q)=a) = e^{ \sum_i \log P(a_i\mid ctx,q,a_{0:i-1}) }. \]
Vigezo hivi vinalenga kuhakikisha kwamba jibu lililochaguliwa si neno la nasibu linaloonekana tu katika matini, bali ni maudhui yanayoweza kuunda jozi ya swali-jibu yenye maana kwa kutegemea muktadha.
Mikusanyiko ya data ya uteuzi wa jibu
| Mkusanyiko wa data | Mafunzo | Uthibitishaji | Jaribio |
|---|---|---|---|
| TASA | 10.000 | 1.000 | 1.000 |
| FairytaleQA | 8.548 | 1.025 | 1.007 |
Hazina ya chanzo ya TASA ina zaidi ya vifungu 60.000. Katika utafiti, sampuli zilichukuliwa kutoka nyanja kama lugha na sanaa, afya, sayansi, sanaa za viwandani, uchumi, biashara na sayansi za kijamii. FairytaleQA ina data ya swali-jibu iliyoandaliwa na wataalamu kutoka simulizi zinazowafaa watoto.
Kwa mafunzo, vipande vinavyowezekana vya jibu vilitolewa kutoka kwenye vifundo vya constituency parse tree ya kila sentensi. QGen ilizalisha swali kwa kila mgombea na mgombea kisha akapewa lebo GOOD au BAD na LS.
Kazi 2: uzalishaji wa maneno muhimu
Uzalishaji wa maneno muhimu ulitathminiwa katika mkusanyiko wa data wa KP20K. KP20K ina takriban mihtasari 500.000 ya makala za kisayansi na maneno muhimu yaliyochaguliwa na waandishi. Utafiti ulichagua kutoka kwenye hazina hii sampuli 50.000 za mafunzo, 2.000 za uthibitishaji na 2.000 za jaribio.
Maneno muhimu yaliyotajwa na waandishi kwa muhtasari husika yalikubaliwa kuwa GOOD. Kwa kuwa mkusanyiko wa data hauna anoteshini ya moja kwa moja ya BAD, sampuli hasi ziliundwa kwa njia bandia. Maneno muhimu ya makala nyingine yaliyo na ufanano mkubwa na muhtasari lengwa katika nafasi ya embedding, lakini ambayo hayapo katika orodha ya GOOD ya muhtasari lengwa, yalichaguliwa.
Katika kukokotoa ufanano, sentence-transformers/all-mpnet-base-v2 modeli ya encoder ilitumika. Kwa kila muhtasari, sampuli za BAD zilichaguliwa kwa idadi sawa na maneno muhimu ya GOOD ili kujaribu kuunda sampuli hasi ngumu zaidi na za kulinganisha.
Vipimo vya tathmini
Precision@K hutumiwa kwa uteuzi wa jibu:
\[ P@K= \frac{\text{ilk }K\text{ aday içindeki GOOD sayısı}}{K}. \]
\(K\) hapa si hyperparameter inayoweza kurekebishwa ya algorithm, bali ni upeo wa tathmini. Matokeo ya uteuzi wa jibu yaliripotiwa hadi \(K=25\).
Katika uzalishaji wa maneno muhimu, F1@K ilitumika na tathmini iliendelea hadi \(K=10\). Chanzo kinahalalisha mpaka huu kwa kueleza kwamba thamani ya percentile ya 95 ya idadi ya maneno muhimu ya GOOD katika KP20K ni 10.
Kwa Nini Faida ya Mbinu Huwa Wazi Zaidi Kadiri K Inavyoongezeka?
Faida ya mbinu ya Feedback-Aware huwa wazi zaidi kadiri K inavyoongezeka kwa sababu modeli, kwa kuona uzalishaji wa awali wa GOOD na BAD, inaweza kuepuka marudio na wagombea wa ubora wa chini kwa ufanisi zaidi, huku mbinu kama SSG zikiwa hazijui wagombea wa awali katika kila uzalishaji mpya; kwa hiyo mbinu zinazoshindana vizuri katika sampuli ya kwanza zinaweza kupoteza ubora haraka zaidi katika orodha ndefu za wagombea.
Ujumbe wa kisayansi wa Kielelezo 4
Katika Kielelezo 4a cha chanzo, mikunjo ya Precision@K ya uteuzi wa jibu kwa ujumla huelekea chini kadiri K inavyoongezeka. Sababu ni kwamba hazina ya majibu halali huisha hatua kwa hatua. SSG huwa imara mwanzoni lakini hushuka haraka zaidi. ASG ina faida ya kuona maudhui ya orodha ya awali, lakini hubaki nyuma ya Feedback-Aware. ASG-RC ni mojawapo ya baseline imara zaidi katika kazi ya uteuzi wa jibu; maswali ambayo ni resulting content huipa modeli muktadha wa ziada, lakini kwa sababu hakuna ishara ya ubora ya GOOD/BAD, si thabiti kama FA.
Katika Kielelezo 4b, mikunjo ya F1@K ya maneno muhimu hupanda kwanza, hufikia kilele takriban katika thamani za kati za K, kisha hushuka. Tafsiri ya chanzo ni kwamba umbo hili halitokani peke yake na kuzorota kwa tabia ya modeli. Katika K ndogo, recall ndiyo kikwazo kwa sababu bado maneno muhimu halisi ya kutosha hayajazalishwa; K inapozidi hazina ya maneno muhimu halisi, uzalishaji wa ziada huanza kutoka daraja la BAD na upotevu wa precision hushusha F1.
Matokeo ya kitakwimu yaliyoripotiwa chini ya kichwa FairytaleQA
| K | Baseline | Mean Δ | p iliyorekebishwa kwa Holm | Umuhimu katika chanzo |
|---|---|---|---|---|
| 1 | SSG | +0,0005 | \(9.70\times10^{-1}\) | Si ya maana |
| 1 | ASG | +0,0812 | \(8.39\times10^{-8}\) | *** |
| 1 | ASG-RC | +0,0244 | \(1.62\times10^{-1}\) | Si ya maana |
| 1 | GPT-4o | +0,1340 | \(1.49\times10^{-17}\) | *** |
| 10 | SSG | −0,0001 | \(9.44\times10^{-1}\) | Si ya maana |
| 10 | ASG | +0,0496 | \(1.19\times10^{-34}\) | *** |
| 10 | ASG-RC | +0,0125 | \(1.74\times10^{-3}\) | ** |
| 10 | GPT-4o | +0,2520 | \(1.44\times10^{-192}\) | *** |
| 20 | SSG | +0,0517 | \(5.85\times10^{-71}\) | *** |
| 20 | ASG | +0,0633 | \(1.52\times10^{-96}\) | *** |
| 20 | ASG-RC | +0,0376 | \(4.52\times10^{-43}\) | *** |
| 20 | GPT-4o | +0,2841 | \(2.76\times10^{-271}\) | *** |
| 25 | SSG | +0,1104 | \(1.04\times10^{-227}\) | *** |
| 25 | ASG | +0,0632 | \(2.55\times10^{-105}\) | *** |
| 25 | ASG-RC | +0,0529 | \(4.20\times10^{-88}\) | *** |
| 25 | GPT-4o | +0,2828 | \(3.18\times10^{-292}\) | *** |
Ujumbe mkuu wa jaribio la kitakwimu ni kwamba ingawa SSG inaweza kuwa karibu katika kiwango kilekile na FA katika K=1 na K=10, hubaki nyuma kwa wazi katika K=20 na K=25. Matokeo haya hayaungi mkono dai kwamba “FA huwa bora kila wakati katika sampuli ya kwanza inayozalishwa”; yanaunga mkono dai kwamba “kadiri uzalishaji wa sampuli nyingi unavyoendelea, FA hudumisha ubora vizuri zaidi”.
Matokeo ya kitakwimu katika uzalishaji wa maneno muhimu wa KP20K
| K | Baseline | Mean Δ | p iliyorekebishwa kwa Holm | Umuhimu katika chanzo |
|---|---|---|---|---|
| 1 | SSG | +0,0651 | \(2.76\times10^{-6}\) | *** |
| 1 | ASG | −0,0160 | \(2.59\times10^{-1}\) | Si ya maana |
| 1 | GPT-4o | +0,1431 | \(1.41\times10^{-20}\) | *** |
| 3 | SSG | +0,0607 | \(2.90\times10^{-22}\) | *** |
| 3 | ASG | +0,0118 | \(9.45\times10^{-2}\) | Si ya maana |
| 3 | GPT-4o | +0,1612 | \(1.12\times10^{-86}\) | *** |
| 5 | SSG | +0,0435 | \(6.47\times10^{-24}\) | *** |
| 5 | ASG | +0,0218 | \(1.33\times10^{-5}\) | *** |
| 5 | GPT-4o | +0,1309 | \(1.99\times10^{-107}\) | *** |
| 10 | SSG | +0,0351 | \(6.94\times10^{-46}\) | *** |
| 10 | ASG | +0,0262 | \(4.69\times10^{-16}\) | *** |
| 10 | GPT-4o | +0,0764 | \(7.48\times10^{-104}\) | *** |
Hapa ASG ilizalisha F1 iliyo juu kidogo kwa namba kuliko FA katika K=1; Mean Δ ya −0,0160 inaonyesha hili na tofauti si ya maana kitakwimu. Katika K=3, tofauti ndogo kwa upande wa FA pia si ya maana. Faida ya kitakwimu ya FA dhidi ya ASG hujitokeza katika K=5 na K=10.
Mbinu ya kitakwimu
Utaratibu mkuu ni jaribio la pande mbili la Wilcoxon signed-rank linalooanisha matokeo ya mbinu katika muktadha uleule. Chanzo kilichagua jaribio hili kwa sababu Precision@K na F1@K zimefungwa katika masafa ya [0,1] na zinaonyesha sifa za discrete/non-normal hasa katika K ndogo.
Kwa ulinganisho mwingi ndani ya kila K, kiwango cha makosa ya familia kilidhibitiwa kuwa \(\alpha=0.05\) kwa marekebisho ya Holm–Bonferroni. Pia paired t-test na paired bootstrap yenye sampuli-rudia 10.000 juu ya tofauti ya wastani zilitumika; chanzo kinaripoti kwamba kwa thamani zote za K tafsiri ileile ya kitakwimu ilipatikana kama katika matokeo makuu ya Wilcoxon.
Mifano ya ubora inaonyesha nini?
Jedwali 5 la chanzo linatoa mfano ambapo, katika kazi ya uteuzi wa jibu, modeli ya Feedback-Aware iliweza kuzalisha majibu manne ya GOOD ya mielekeo tofauti ya kisemantiki kama “happy”, “vivid”, “lion” na “personification” katika uzalishaji wake mitano ya kwanza, huku mgombea wa tano pekee akiwa BAD. Katika muktadha uleule, baadhi ya baseline huelekea kwa haraka zaidi kwenye wagombea wa ubora wa chini au wanaofanana.
Katika mfano wa maneno muhimu wa Jedwali 6, FA huzalisha kwa mfululizo “productivity”, “knowledge workers”, “performance indicators”, “experts” na “management”; wa tatu kati ya haya ni BAD kulingana na lebo za chanzo, na mengine manne ni GOOD. Baseline zinaonyesha mara nyingi zaidi wagombea wasiohusika au wa kurudia katika uzalishaji unaofuata.
Katika majedwali ya ubora, chanzo kimetumia lebo REPEATED kuonyesha uzalishaji ambao kisemantiki ni sawa na mgombea aliyeshazalishwa. Lebo hii si daraja jipya la ubora katika tathmini ya kiasi; marudio halisi huondolewa kabla ya kukokotoa vipimo.
Jaribio la ORPO alignment
Kuwepo kwa sampuli za GOOD na BAD kulisababisha watafiti kujaribu pia ORPO, mbinu ya preference alignment. ORPO hutumia adhabu inayotegemea odds-ratio kati ya majibu yaliyochaguliwa na yaliyokataliwa. Katika jaribio:
\[ \beta=0.3 \]
iliwekwa na masharti mengine ya mafunzo yakahifadhiwa sawa na mpangilio wa supervised fine-tuning.
Kwa mujibu wa Figure 5 katika chanzo, toleo la ORPO la modeli ya Feedback-Aware na toleo la kawaida la SFT huonyesha tabia zinazofanana. Katika SSG, ORPO inaweza kutoa faida katika sampuli za mwanzo za uteuzi wa jibu, lakini precision hushuka kwa kasi zaidi kadiri K inavyoongezeka. Katika kazi ya maneno muhimu, SSG-ORPO ilionyesha utendaji wa chini tangu mwanzo.
Tafsiri ya waandishi ni kwamba uboreshaji wa upendeleo wa jozi unaweza kuifanya nafasi ya wagombea kuwa na mgawanyiko mkali zaidi katika mhimili wa GOOD/BAD, na hii inaweza kuwa hasara katika uzalishaji wa sampuli nyingi unaohitaji utofauti. Jaribio hili halionyeshi kwamba ORPO kwa ujumla ni mbinu mbaya ya alignment; linaonyesha tu tabia yake katika kazi za uzalishaji wa sampuli nyingi zilizochunguzwa.
Hali za hitilafu
Chanzo kinasisitiza taratibu tatu kuu za hitilafu. Kwanza, ikiwa Labeling System ni dhaifu au ina upendeleo wa kimfumo, lebo zisizo sahihi zinaweza kuimarisha hitilafu katika marudio badala ya kuirekebisha kwa sababu huongezwa kwenye prompt inayofuata.
Pili, kwa sababu kila uzalishaji na lebo huongezwa kwenye historia ya prompt, urefu wa muktadha huongezeka pamoja na idadi ya iteresheni. Hali hii huongeza hatari ya context saturation na gharama ya inferensi.
Tatu, ikiwa idadi ya wagombea walio wazuri kweli kwa muktadha fulani ni ndogo, modeli hatimaye humaliza hazina ya GOOD. Kwa hiyo hata katika mbinu bora zaidi, kushuka kwa vipimo katika thamani kubwa za K hakuwezi kuondolewa kabisa.
Mapungufu ya kimetodolojia ya utafiti
Utafutaji wa hyperparameter ulipunguzwa kwa makusudi kutokana na gharama ya ukokotoaji. Ingawa mipangilio ya pamoja ya mafunzo/decoding ilitumiwa katika modeli kuu na baseline kwa ajili ya haki ya ulinganisho, mpangilio bora wa kila mbinu haukutafitiwa.
Framework inahitaji sampuli hasi kwa ajili ya mafunzo. Katika mikusanyiko ya data kama KP20K yenye anoteshini chanya pekee, sampuli za BAD lazima ziundwe kando; ikiwa sampuli hasi zitachaguliwa kuwa rahisi mno, modeli inaweza kujifunza tofauti ya GOOD/BAD kijuujuu.
Utendaji unategemea ubora wa Labeling System. Ingawa uchunguzi wa FairytaleQA katika utafiti unaashiria ustahimilivu fulani kwa kasoro za kiwango cha kati za uwekaji lebo, hakuna jaribio la kimfumo la robustness lililofanywa kwa viwango vya kelele vinavyoongezwa kwa udhibiti.
Mchakato wa kurudiarudia huleta gharama ya ziada ya inferensi ikilinganishwa na modeli za njia moja: kuna miito zaidi ya generation, miito ya Labeling System na historia ya prompt inayokua kwa mstari pamoja na iteresheni. Makala haikutoa wall-clock latency, throughput na wasifu wa kumbukumbu ya GPU kama benchmark ya kina kwa mazingira ya uzalishaji.
Mrejesho wa majaribio uko katika umbo la binary GOOD/BAD pekee. Ingawa Framework inaunga mkono kidhana miundo tajiri zaidi ya lebo, mrejesho wa viwango au wa vipimo vingi haujajaribiwa kimajaribio.
Mwisho, majaribio yote makuu ya fine-tuning yalifanywa kwenye modeli msingi moja ya 8B. Bado haijaonyeshwa kwamba matokeo yanaweza kujumlishwa moja kwa moja kwa modeli ndogo zaidi sana, kubwa zaidi sana au familia tofauti za usanifu.
Hitimisho zinazoungwa mkono na utafiti
Utafiti unaunga mkono kwamba modeli ya chanzo huria ya kiwango cha 8B iliyofanyiwa fine-tuning ipasavyo inaweza kutumia historia ya wazi ya feedback ya GOOD/BAD katika prompt ya inferensi na kudumisha ubora kwa uthabiti zaidi kuliko baseline imara katika iteresheni za kazi mbili zilizochunguzwa za uzalishaji wa matini nyingi.
Matokeo ya kitakwimu yanaunga mkono kwamba tofauti huongezeka kwa upande wa mbinu ya Feedback-Aware hasa katika hali ya K kubwa. Matokeo haya yanaendana na hali za oversampling katika teknolojia za elimu, kama idadi kubwa ya wagombea wa maswali, hazina pana za vipengee vya tathmini au wagombea wa maneno muhimu watakaochujwa baadaye.
Utafiti pia unatoa mifano miwili inayoonyesha kwamba chanzo cha feedback hakitegemei utaratibu mmoja pekee: modeli otomatiki za proxy kwa uteuzi wa jibu na anoteshini zilizoratibiwa na binadamu kwa uzalishaji wa maneno muhimu.
Hitimisho ambazo utafiti hauungi mkono
Utafiti hauonyeshi kwamba mbinu ya Feedback-Aware ni bora kuliko modeli zote kubwa katika kazi zote za NLP. Kazi mbili tu na familia moja kuu ya modeli ya 8B ndizo zilizotathminiwa.
Utendaji wa chini wa baseline ya GPT-4o hauonyeshi kwamba uwezo wa jumla wa modeli ya GPT-4o ni mdogo kuliko wa Llama-3 8B. Katika jaribio, GPT-4o ilitumika kwa one-shot prompting huku modeli nyingine kuu zikipokea fine-tuning mahususi kwa kazi; kwa hiyo matokeo yanahusu itifaki hii ya jaribio pekee.
Utafiti pia hauonyeshi kwamba feedback husahihisha hitilafu kila wakati. Ishara ya LS iliyo potofu au yenye upendeleo inaweza kusababisha hitilafu kuhamishwa kwenda kwenye uzalishaji unaofuata ndani ya mzunguko huohuo wa feedback.
Hitimisho kwamba “modeli ndogo zinaweza kutoa uwezo wote wa iterative reasoning wa proprietary LLM kubwa katika kiwango kilekile” pia halijathibitishwa na chanzo. Kilichoonyeshwa ni kwamba utaratibu uliopangiliwa wa feedback ni wenye manufaa katika modeli ya 8B kwa kazi mbili za uzalishaji wa sampuli nyingi zilizochunguzwa.
Kutokuwa na uhakika katika uripoti wa chanzo
Ingawa sehemu ya jaribio ya TASA imetolewa kama sampuli 1000 na sehemu ya jaribio ya FairytaleQA kama sampuli 1007, Jedwali la kitakwimu 3 limewekewa lebo “FairytaleQA, n=2007”. Namba 2007 ni jumla ya sehemu mbili za jaribio; lakini kwa kuwa chanzo hakisemi wazi kwamba huu ni uchanganuzi wa pamoja, hapa kutokulingana pekee kumeachwa kuonekana.
Ingawa imeelezwa kwamba sampuli 2000 za jaribio zilichaguliwa katika KP20K, Jedwali 4 linaripoti ulinganisho wa kitakwimu juu ya miktadha n=1998. Chanzo hakielezi kwa nini sampuli mbili hazikuingia katika uchanganuzi.
Licha ya kuelezwa wazi kwamba sehemu ya Keyword Generation inatumia KP20K, mwisho wa muktadha wa mfano katika Jedwali 6 una kauli ya chanzo “FairytaleQA dataset entry [15]”. Verianla haibadilishi chanzo hiki kimya kimya kuwa KP20K.
Mwelekeo wa kazi za baadaye
Waandishi wanapendekeza Framework ijaribiwe katika anuwai pana zaidi ya kazi za uzalishaji, mizani tofauti ya modeli na usanifu tofauti. Hasa, majaribio yaliyodhibitiwa ya feedback-noise kwa kutumia Labeling System zilizoharibiwa kwa njia sintetiki yanaweza kupima moja kwa moja ustahimilivu wa modeli kwa mrejesho usio sahihi.
Vipimo vya wall-clock latency, throughput na kumbukumbu ya GPU kwa mazingira ya uzalishaji pia ni miongoni mwa mahitaji muhimu ya baadaye; kwa sababu faida ya ubora ya mzunguko wa feedback wa kurudiarudia lazima itathminiwe pamoja na gharama ya ziada ya inference.
Zaidi ya lebo ya binary GOOD/BAD, alama za ngazi au miundo ya feedback ya vipimo vingi inayoeleza vipengele tofauti vya ubora kando pia inaweza kuchunguzwa.
Mwisho, chanzo kinapendekeza utumiaji wa feedback kwenye hatua za kati katika kazi za reasoning za hatua nyingi, kama kutatua matatizo ya hisabati, inferensi ya kimantiki au maelezo ya kisayansi, kuwa eneo linalowezekana la upanuzi. Matumizi haya hayajathibitishwa kimajaribio katika utafiti.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Feedback-Aware Inference for Iterative Multi-Sample Text Generation
Waandishi: Andreea Dutulescu; Stefan Ruseti; Mihai Dascalu; Danielle S. McNamara.
Mwandishi anayewajibika: Stefan Ruseti.
Taasisi: Computer Science and Engineering Department, National University of Science and Technology POLITEHNICA Bucharest, Romania; Academy of Romanian Scientists, Romania; Learning Engineering Institute, Arizona State University, Marekani.
Jarida: AI.
Mchapishaji: MDPI.
Aina ya chanzo: Makala asilia ya utafiti iliyopitiwa na rika; uchakataji wa lugha asilia, fine-tuning ya modeli ya lugha na majaribio ya inferensi ya kurudiarudia.
Taarifa ya uchapishaji: AI 2026, juzuu 7, toleo 5, makala 171.
DOI: 10.3390/ai7050171
Iliwasilishwa: 1 Aprili 2026.
Marekebisho: 8 Mei 2026.
Ilikubaliwa: 12 Mei 2026.
Ilichapishwa: 15 Mei 2026.
Leseni: Creative Commons Attribution (CC BY), ufikiaji huria.
Ufadhili: Utafiti uliungwa mkono na mradi wa Romanian Hub for Artificial Intelligence—HRIA chini ya Smart Growth, Digitization and Financial Instruments Program 2021–2027, MySMIS no. 351416; ruzuku namba R305T240035 iliyotolewa kwa Arizona State University na U.S. Department of Education Institute of Education Sciences; na ruzuku ya Academy of Romanian Scientists AOSR-TEAMS-IV Edition 2025–2026 “Digital Transformation in Science”.
Kamati ya maadili ya taasisi: Haitumiki.
Ridhaa yenye taarifa: Haitumiki.
Ufikiaji wa data, msimbo na modeli: Waandishi wanaripoti kwamba wamechapisha data, msimbo na modeli zilizofanyiwa fine-tuning za utafiti katika hazina huria ya GitHub.
Tamko la matumizi ya akili bandia zalishi: Waandishi wanaeleza kwamba katika kuandaa makala, akili bandia zalishi ilitumika tu kwa ukaguzi wa tahajia na sarufi; matokeo yalikaguliwa na kuhaririwa nao, na wanawajibika kwa maudhui.
Mgongano wa maslahi: Waandishi wanatangaza kwamba hakuna mgongano wa maslahi. Imeripotiwa kuwa wafadhili hawakuwa na nafasi katika muundo wa utafiti, ukusanyaji/uchanganuzi/ufafanuzi wa data, uandishi wa makala au uamuzi wa kuchapisha.
Michango ya waandishi: Uundaji wa dhana Andreea Dutulescu, Stefan Ruseti na Mihai Dascalu; metodolojia Andreea Dutulescu na Stefan Ruseti; programu, uchanganuzi rasmi, utafiti, rasilimali, uratibu wa data, rasimu ya kwanza na uwasilishaji wa kuona Andreea Dutulescu; uthibitishaji Andreea Dutulescu, Stefan Ruseti na Mihai Dascalu; mapitio na uhariri waandishi wote wanne; usimamizi Stefan Ruseti, Mihai Dascalu na Danielle S. McNamara; usimamizi wa mradi Mihai Dascalu; upatikanaji wa ufadhili Stefan Ruseti, Mihai Dascalu na Danielle S. McNamara.
Mapungufu makuu ya kimetodolojia: Kazi mbili tu zilitathminiwa; modeli msingi moja ya 8B ilitumika; utafutaji wa hyperparameter ulikuwa mdogo; kuna hitaji la sampuli hasi; hitilafu za mfumo wa uwekaji lebo zinaweza kuenea katika mzunguko wa feedback; gharama ya inference ni kubwa kuliko mbinu za njia moja; miundo nje ya binary feedback haikujaribiwa; benchmark za latency/throughput/kumbukumbu ya GPU za mazingira ya uzalishaji hazikutolewa.
Dokezo la uripoti ndani ya chanzo: Kuna kutokulingana kusikoelezwa kati ya idadi ya jaribio ya FairytaleQA na lebo n=2007 katika Jedwali 3, idadi ya jaribio ya KP20K na thamani n=1998 katika Jedwali 4, pamoja na lebo ya chanzo FairytaleQA katika Jedwali 6. Vipengele hivi havikusahihishwa kimya kimya na Verianla.
Dokezo la mbinu ya Verianla: Maudhui haya si tafsiri ya sentensi kwa sentensi wala uandishi upya wa karibu wa aya kwa aya wa makala chanzo. Muundo huru wa kujifunza kisayansi kwa Kiswahili umeundwa kwa kuhifadhi tatizo la utafiti, muundo wa Feedback-Aware training/inference, mfumo wa feedback wa GOOD/BAD, mantiki ya tathmini ya QGen/QAns, mikusanyiko ya data, mipangilio ya modeli, matokeo ya P@K na F1@K, majaribio ya kitakwimu, uchanganuzi wa ubora, jaribio la ORPO, mapungufu na mapendekezo ya kazi za baadaye.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *