

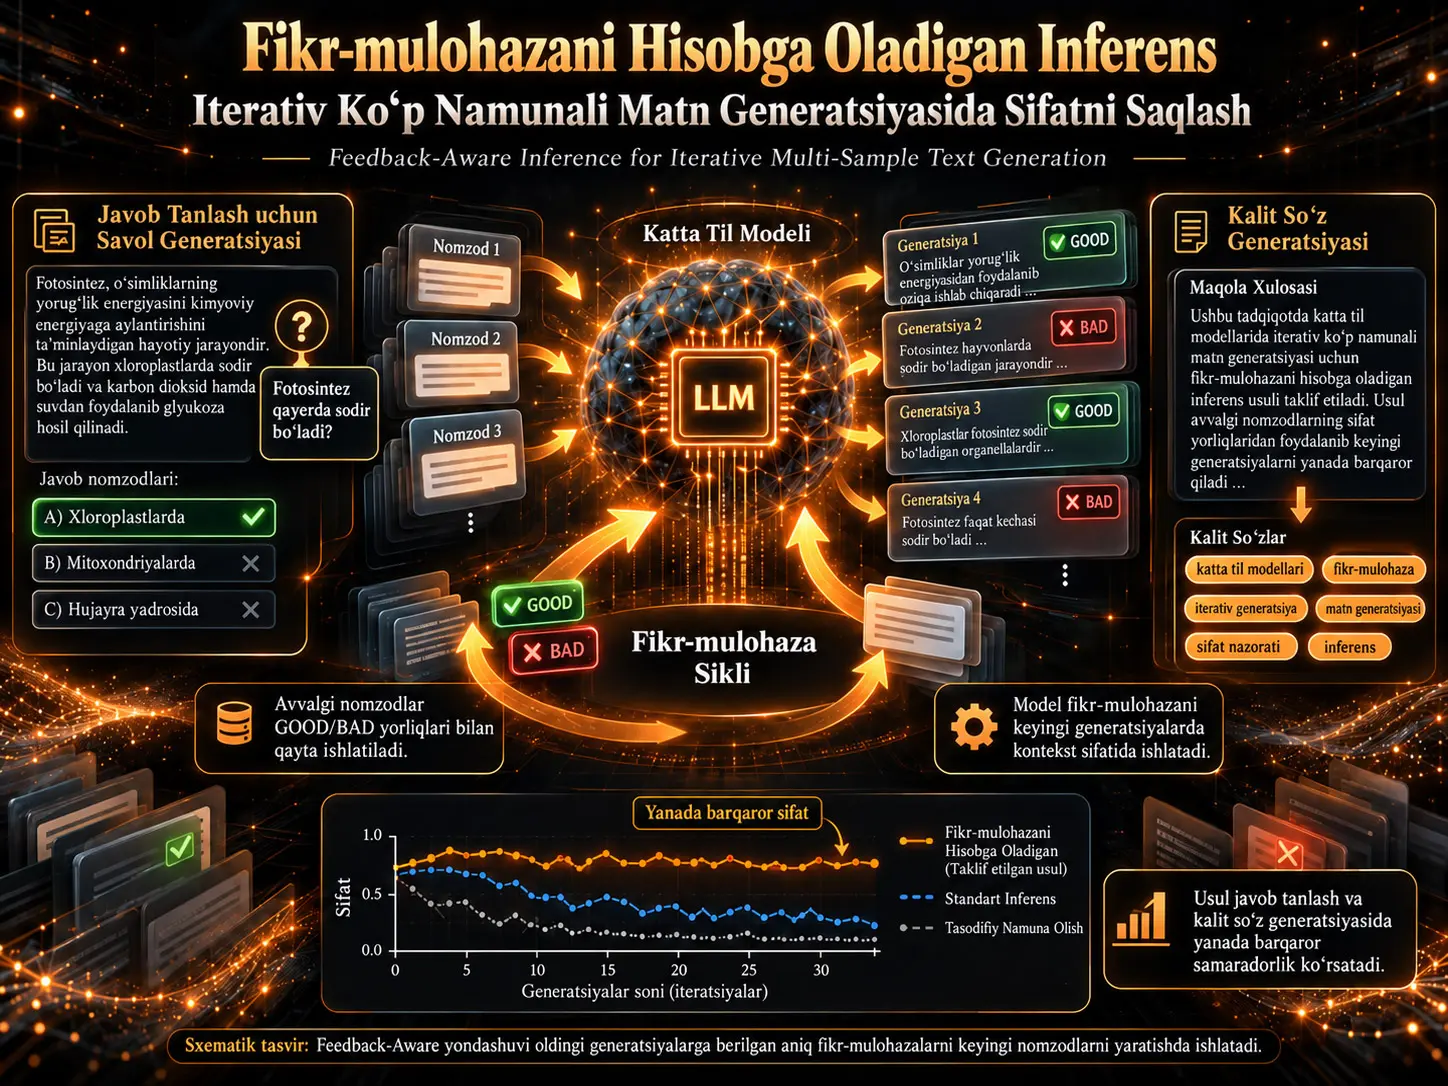
Fikr-mulohazani Hisobga Oladigan Inferens (Feedback-Aware Inference, FA), til modeli ayni kontekst uchun bir nechta matn nomzodini yaratishda avvalgi nomzodlarga berilgan aniq sifat yorliqlarini yangi generatsiyalar kontekstiga qoʻshib, iterativ yaxshilanishni amalga oshirishiga imkon beradigan inferens doirasidir. Tadqiqotda bazaviy model sifatida Llama-3 8B ishlatilgan, modellar LoRA yordamida fine-tune qilingan va usul ikki xil koʻp-generatsiyali vazifada sinovdan oʻtkazilgan: savol generatsiyasi uchun javob parchasini tanlash va ilmiy matnlardan kalit soʻzlar generatsiyasi. Feedback-Aware yondashuvi, ayniqsa yaratilgan namunalar soni ortgani sari, sifatni Single Sequence Generation, All Sequences Generation, All Sequences Generation with Resulting Content hamda tadqiqotda qoʻllangan GPT-4o baselineʼiga nisbatan barqarorroq saqlagan. Bu natijalar faqat oʻrganilgan ikki vazifa, bitta 8B bazaviy model va qoʻllangan yorliqlash tizimlari uchun koʻrsatilgan; usul barcha generativ vazifalarda, barcha model miqyoslarida yoki barcha feedback turlarida xuddi shu ustunlikni koʻrsatishi hali isbotlanmagan.
Usulning ajralib turuvchi xususiyati feedbackʼni yangi parametr yangilanishi sifatida emas, balki keyingi inferens bosqichining prompt tarixiga qoʻshiladigan tuzilmali signal sifatida ishlatishidir. Model avvalgi generatsiyalarni va ularning GOOD yoki BAD yorliqlarini koʻradi; soʻng keyingi nomzod GOOD boʻlishini maqsad qilib yangi generatsiya yaratadi. Murakkab vazifalarda Resulting Content Generator (RCG) deb ataladigan ixtiyoriy modul ham qoʻllanishi mumkin. RCG yaratilgan nomzod yuzaga keltiradigan qoʻshimcha kontentni hosil qiladi; masalan, javob parchasini tanlash vazifasida tanlangan javobdan savol yaratadi va yorliqlash tizimi ham javobni, ham ushbu savolni birgalikda baholashi mumkin.
Tajribalarda ishlatiladigan feedback manbai vazifaga qarab oʻzgaradi. Savol generatsiyasi uchun javob tanlashda sifat avtomatik QGen va QAns modellari yaratgan baholash konveyeri orqali aniqlanadi. Kalit soʻz generatsiyasida esa maqola mualliflari KP20K maʼlumotlar toʻplamida tanlagan kalit soʻzlar GOOD namunalari sifatida ishlatiladi; qarama-qarshi BAD namunalari oʻxshash, ammo tegishli annotatsiyada mazkur annotatsiya uchun mavjud boʻlmagan kalit soʻzlardan yaratiladi. Shu tariqa tadqiqot bir xil inferens arxitekturasidan ham avtomatik proxy baholashdan, ham inson kuratsiyasidan olingan feedback bilan foydalanish mumkinligini koʻrsatishni maqsad qiladi.
Statistik taqqoslashlar usulning afzalligi ayniqsa koʻp sonli nomzod yaratilganda kuchayishini koʻrsatadi. Savol-javob vazifasida FA bilan SSG oʻrtasidagi farq kichik K qiymatlarida ahamiyatli emas, K=20 va K=25 da esa aniqroq namoyon boʻladi. KP20K kalit soʻz vazifasida FAʼning SSG va tadqiqotdagi GPT-4o baselineʼiga nisbatan farqi hisobot berilgan barcha K qiymatlarida ahamiyatlidir; ASG bilan farq esa K=1 va K=3 da ahamiyatli emas, K=5 va K=10 da ahamiyatli boʻladi. Bu naqsh usulning asosiy qiymati “birinchi namunani albatta eng yaxshi yaratish”dan koʻra, namunalar soni ortayotganda sifat va xilma-xillikni uzoqroq saqlab qolish ekanini koʻrsatadi.
Fikr-mulohazani Hisobga Oladigan Inferens Nima?
Fikr-mulohazani hisobga oladigan inferens avvalgi generatsiyalarning GOOD/BAD kabi diskret sifat yorliqlarini va kerak boʻlsa shu generatsiyalardan hosil qilingan qoʻshimcha kontentni prompt tarixiga qoʻshib keyingi matn nomzodini yoʻnaltiradigan, treningdan keyingi iterativ inferens paytida ishlaydigan koʻp namunali generatsiya doirasidir.
Bir martalik generatsiya muammosi
Koʻplab tabiiy tilni qayta ishlash vazifalarida bitta toʻgʻri javob mavjud emas. Matndan savol yaratilsa, turli qismlar mazmunli savol-javob juftliklariga aylantirilishi mumkin; ilmiy annotatsiya uchun ham bir nechta yaroqli kalit soʻz tanlanishi mumkin. Bitta ketma-ketlikni yaratish ushbu yechim makonining faqat kichik qismini qamrab oladi.
Modeldan ayni kontekst uchun koʻp sonli mustaqil namunalarni soʻrash xilma-xillikni oshirishi mumkin; biroq model avval nima yaratganini yoki qaysi namunalar yomon deb qabul qilinganini hisobga olmasa, yangi namunalarning sifati asta-sekin pasayishi, takrorlar paydo boʻlishi va nomzodlar havzasining kamroq foydali hududlariga siljishi mumkin.
Feedback-Aware yondashuvi nishonga oladigan muammo aynan shu: avvalgi generatsiyalarni inferens kontekstining bir qismiga aylantirish orqali modelga keyingi generatsiyada ham qabul qilingan, ham rad etilgan nomzodlardan foydalanish imkonini berish.
Feedback-Aware yondashuvi RLHF va DPOdan qanday farq qiladi?
RLHF va DPO kabi afzallikni optimallashtirish usullari model parametrlarini trening bosqichida inson yoki afzallik signallariga moslashtirishga qaratiladi. Feedback-Aware Inference esa vazifa davomida yuzaga kelgan feedbackʼni bevosita inferens kontekstiga olib kiradi.
Bu farq Feedback-Aware modeli umuman oʻqitilmagan degani emas. Model GOOD/BAD tarixini qanday talqin qilishni oʻrganishi uchun shu tuzilishga oʻxshash promptlar bilan fine-tune qilinadi. Farqi shundaki, har bir yangi feedback kelganda parametrlarni qayta optimallashtirish talab qilinmaydi; yangi feedback keyingi promptʼga qoʻshiladi.
Usul yirik suhbat modellarining erkin shakldagi tabiiy til tanqidlari bilan amalga oshiradigan self-refinement yondashuvidan ham farq qiladi. Bu yerdagi feedback uzun tanqid matni boʻlishi shart emas; tajribalarda uning eng asosiy shakli ikkilik GOOD/BAD yorligʻidir.
Dairaning uchta qoʻllanish sharti
Manba Feedback-Aware Inference uchun uchta chegaraviy shartni belgilaydi. Vazifada oʻrganish mumkin boʻlgan diskret feedback signali boʻlishi kerak; ushbu yorliqni ishlab chiqara oladigan inson yoki avtomatik Labeling System boʻlishi kerak; shuningdek, vazifa bitta chiqishdan koʻra bir nechta turli yaxshi nomzodlar yaratilishidan foyda olishi kerak.
1-rasm: trening va inferens nega ikki alohida bosqich?
Manba tadqiqotning 5-sahifasidagi 1-rasm ikki maʼlumot oqimini bir-biridan ajratadi. Trening tomonida maʼlumot kontekstlaridan nomzod ketma-ketliklar yaratiladi, Labeling System ularga sifat yorligʻi beradi va yorliqlangan namunalar Feedback-Aware Modelʼni fine-tune qilish uchun ishlatiladi.
Inferens tomonida boshlangʻich prompt faqat vazifa tavsifi va kontekstdan iborat boʻladi. Model bitta nomzod yaratadi. Nomzod Labeling System tomonidan baholanadi. Yorliq va nomzod, kerak boʻlsa RCG yaratgan qoʻshimcha kontent bilan birga tarixga qoʻshiladi. Keyingi generatsiya ushbu kengaytirilgan kontekstni koʻradi. Shunday qilib, inferens bir yoʻnalishli “prompt → javob” mosligidan chiqib, generatsiya → baholash → tarixni yangilash → yangi generatsiya sikliga aylanadi.
Labeling System nima?
Labeling System (LS) yaratilgan \(g\) ketma-ketligi uchun sifat yorligʻini qaytaradigan vazifaga xos baholash komponentidir:
\[ LS(g)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
GOOD va BAD yorliqlarining ilmiy maʼnosi qatʼiy emas. Grammatik toʻgʻrilik, kontekstga muvofiqlik, savol yaratish mumkinligi, mavzuni ifodalash kuchi yoki boshqa vazifaga xos mezonlardan foydalanish mumkin. Feedback-Aware doirasining umumiy mexanizmi muayyan sifat metrikasiga bogʻliq emas; biroq uning amaldagi samaradorligi qoʻllanayotgan Labeling System sifatiga bogʻliq.
Resulting Content Generator nima qiladi?
Baʼzi vazifalarda sifatni aniqlash uchun faqat yaratilgan nomzodning oʻziga qarash yetarli emas. Bunday holatda Resulting Content Generator (RCG) nomzod yuzaga keltiradigan qoʻshimcha chiqishni yaratadi va LS qarorni ikki kirishga asoslanib berishi mumkin:
\[ LS\left(g,RCG(g)\right)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
Tadqiqotning javob tanlash vazifasida \(g\) tanlangan javob parchasidir; RCG rolini QGen bajaradi va shu parchadan savol yaratadi. Shunda tizim “bu matn parchasi yuzaki jihatdan maqbul koʻrinadimi?” degan savol oʻrniga “bu parchadan kontekstga asoslangan va javob berish mumkin boʻlgan savol yaratish mumkinmi?” degan savolga yaqinlashadi.
GOOD/BAD Yorliqlari Modelni Inferens Paytida Qanday Yoʻnaltiradi?
GOOD/BAD yorliqlari avvalgi nomzodlar bilan birga prompt tarixida saqlanadi; Feedback-Aware Model yangi generatsiya paytida qaysi turdagi namunalar qabul qilingan yoki rad etilganini kontekst ichida koʻradi va keyingi nomzodini shu tarixga shartlaydi, ammo inferens vaqtida model ogʻirliklari qayta yangilanmaydi.
Trening maʼlumotlari tuzilishi
Boshlangʻich maʼlumotlar toʻplami kontekstlardan iborat:
\[ D_{\mathrm{initial}}=[C_1,C_2,\ldots,C_n]. \]
Har bir \(C_i\) konteksti uchun bir nechta nomzod ketma-ketlik:
\[ [g_{i,1},g_{i,2},\ldots,g_{i,m}] \]
va ularga mos sifat yorliqlari:
\[ [LS(g_{i,1}),LS(g_{i,2}),\ldots,LS(g_{i,m})] \]
yaratiladi. Ayni kontekst uchun ham GOOD, ham BAD namunalar boʻlishi modelning faqat ijobiy namuna shaklini yodlab olishidan koʻra, prompt ichida ikki sifat sinfining maʼnosini oʻrganishi uchun muhimdir.
Prompt tarixi tuzilishi
Manbaning 7-sahifasidagi 2-rasmda umumiy shablon vazifa tavsifi, kontekst va ketma-ket tarixdan iborat. Har bir tarix qatori sifat yorligʻi va avval yaratilgan ketma-ketlikni oʻz ichiga oladi; vazifa talab qilsa resulting content ham ayni qatorga qoʻshiladi.
Trening paytida loss butun prompt boʻyicha hisoblanmaydi. Model faqat shablon oxiridagi maqsad GOOD ketma-ketligining tokenlarini bashorat qilish uchun optimallashtiriladi. Avvalgi GOOD/BAD namunalar va resulting content esa shartlovchi kontekst vazifasini bajaradi.
Inferens siklining mantiqi
Manba Algorithm 1 ning funksional oqimini quyidagicha umumlashtirish mumkin: boshlangʻich prompt yaratiladi; model GOOD nomzod yaratishga urinadi; nomzod va mavjud boʻlsa resulting content LS tomonidan baholanadi; nomzodning GOOD ekani yoki emasligi qayd etiladi; soʻng yorliq, nomzod va qoʻshimcha kontent prompt tarixiga qoʻshilib yangi sikl boshlanadi.
Toʻxtatish sharti doiraning qatʼiy qismi emas. Manba maqsad qilingan miqdordagi qabul qilingan namunalarga erishish, ketma-ket maʼlum sondagi BAD natijalarni koʻrish yoki yaroqli nomzodlar havzasining tugashini mumkin boʻlgan toʻxtatish qoidalari sifatida keltiradi.
Feedback-Aware usuli best-of-N dan nega farq qiladi?
Best-of-N yondashuvida qatʼiy shartli taqsimotdan koʻp sonli mustaqil namunalar yaratiladi va eng yuqori balli namuna tanlanadi. Feedback-Aware yondashuvida esa \(t+1\)-generatsiya taqsimoti \(t\)- va undan avvalgi generatsiyalarning promptʼga qayta qoʻshilishi sababli oʻzgarishi mumkin. Shuning uchun avvalgi nomzod faqat tanlash bosqichida emas, balki keyingi generatsiyani shartlashda ham rol oʻynaydi.
Tadqiqot Usuli va Natijalari
Taqqoslangan usullar
| Usul | Asosiy ishlash shakli | Avvalgi generatsiyalardan xabardorlik |
|---|---|---|
| Feedback-Aware (FA) | Avvalgi nomzodlarni GOOD/BAD yorliqlari bilan promptʼga qoʻshib iterativ generatsiya qilish | Ha; aniq sifat yorligʻi bilan |
| Single Sequence Generation (SSG) | Kontekstdan bitta GOOD nomzod yaratishga qaratilgan fine-tuning; inferensda koʻp namunali sampling | Yoʻq |
| All Sequences Generation (ASG) | Bitta kontekstning GOOD ketma-ketliklarini birgalikda yaratishga qaratilgan fine-tuning | Yaratilgan roʻyxat tuzilishi bor; GOOD/BAD feedback yorligʻi yoʻq |
| ASG-RC | ASG tuzilishiga avvalgi resulting content maʼlumotini qoʻshadi | Kontent tarixi bor; GOOD/BAD yorligʻi yoʻq |
| GPT-4o | Vazifa va bitta trening namunasini oʻz ichiga olgan one-shot prompt bilan roʻyxat generatsiyasi | Tadqiqotdagi sozlamada iterativ feedback sikli yoʻq |
Model va trening sozlamalari
FA, SSG, ASG va ASG-RC modellarining bazasi Llama-3 8B dir. Fine-tuning LoRA yordamida attention qatlamlarining projection matritsalarida bajarilgan. Barcha asosiy tajribalarning fine-tuning va inference jarayonlari bitta NVIDIA A100 80 GB GPU da amalga oshirilgan.
| Bosqich | Parametr | Qiymat |
|---|---|---|
| Trening | Bazaviy model | Llama-3 8B |
| Trening | Fine-tuning | LoRA; attention projection matritsalari |
| Trening | Optimizer | AdamW-8bit |
| Trening | Learning rate | \(1\times10^{-5}\) |
| Trening | Batch size | 64; gradient accumulation bilan |
| Trening | Precision | FP16 |
| QGen/QAns | Precision | BF16 |
| Inferens | Decoding | Nucleus sampling |
| Inferens | Top-k | 20 |
| Inferens | Top-p | 0,8 |
| Barchasi | Random seed | 42 |
| GPT-4o | Sozlamalar | Standart sozlamalar |
FA, ASG va ASG-RC ning iterativ generatsiyasida har bir siklda 10 namuna yaratilib, eng yuqori log-likelihood qiymatiga ega nomzod tanlangan. SSG uchun 100 namuna yaratilgan, takrorlar olib tashlangan va eng yuqori 25 nomzod saqlangan.
Vazifa 1: Savol generatsiyasi uchun javob parchasini tanlash
Bu vazifada model berilgan matndan savol yaratishga yaroqli bir nechta javob parchasini tanlaydi. Sifatni baholash uchun ikki yordamchi model ishlatiladi:
| Model | Vazifasi |
|---|---|
| QGen | Kontekst va tanlangan javob parchasidan savol yaratish |
| QAns | Yaratilgan savolga kontekstdan javob berishga urinish |
QGen va QAns SQuAD, HotpotQA va NarrativeQA ustida alohida supervised fine-tuning yordamida tayyorlangan; FairytaleQA model treningiga kiritilmasdan umumiy test sifatida ishlatilgan.
| Maʼlumotlar toʻplami | QGen | QAns |
|---|---|---|
| SQuAD | 0,58 | 0,75 |
| HotpotQA | 0,50 | 0,50 |
| NarrativeQA | 0,54 | 0,60 |
| FairytaleQA | 0,51 | 0,45 |
Javob parchasi qachon GOOD deb qabul qilinadi?
Tanlangan \(a\) javobi uchun avval:
\[ q=QGen(ctx,a) \]
yordamida savol yaratiladi. Soʻng QAns modelining kontekst va savol berilganda \(a\) javobini yaratish ehtimoli manbada empirik ravishda tanlangan %3 chegaradan oshishi kerak:
\[ P(QAns(ctx,q)=a)\geq0.03. \]
Bu chegara trening maʼlumotlar toʻplamidagi toʻgʻri javob ehtimollari taqsimotiga asoslanib tanlangan.
Ikkinchi shart savolning haqiqatan ham kontekstga bogʻliq boʻlishini koʻzlaydi. Modelning javobni kontekstsiz yaratish ehtimoli kontekst berilgandagi ehtimolidan katta boʻlmasligi kerak:
\[ \frac{P(QAns("",q)=a)} {P(QAns(ctx,q)=a)} \leq1. \]
Javob ketma-ketligining umumiy ehtimoli token log-ehtimollari yigʻindisining eksponensial oʻzgartirilishi orqali hisoblanadi:
\[ P(QAns(ctx,q)=a) = e^{ \sum_i \log P(a_i\mid ctx,q,a_{0:i-1}) }. \]
Bu mezonlar tanlangan javob shunchaki matnda uchraydigan tasodifiy soʻz emas, balki kontekstga tayangan holda mazmunli savol-javob juftligini hosil qila oladigan kontent boʻlishini maqsad qiladi.
Javob tanlash maʼlumotlar toʻplamlari
| Maʼlumotlar toʻplami | Trening | Validatsiya | Test |
|---|---|---|---|
| TASA | 10.000 | 1.000 | 1.000 |
| FairytaleQA | 8.548 | 1.025 | 1.007 |
TASA manba havzasi 60.000 dan ortiq parcha matnni oʻz ichiga oladi. Tadqiqotda til va sanʼat, sogʻliq, fan, sanoat sanʼati, iqtisod, biznes va ijtimoiy fanlar kabi sohalardan namunalar olingan. FairytaleQA esa bolalarga mos hikoyalardan mutaxassislar tayyorlagan savol-javob maʼlumotlarini oʻz ichiga oladi.
Trening uchun ehtimoliy javob parchalari har bir gapning constituency parse daraxtidagi tugunlardan ajratib olingan. Har bir nomzod uchun QGen savol yaratgan va nomzod keyin LS tomonidan GOOD yoki BAD deb yorliqlangan.
Vazifa 2: Kalit soʻzlar generatsiyasi
Kalit soʻz generatsiyasi KP20K maʼlumotlar toʻplamida baholangan. KP20K taxminan 500.000 ta ilmiy maqola annotatsiyasi va mualliflar tanlagan kalit soʻzlarni oʻz ichiga oladi. Tadqiqot ushbu havzadan 50.000 ta trening, 2.000 ta validatsiya va 2.000 ta test namunasini tanlagan.
Mualliflar tegishli annotatsiya uchun belgilagan kalit soʻzlar GOOD deb qabul qilingan. Maʼlumotlar toʻplamida bevosita BAD annotatsiyasi boʻlmagani uchun salbiy namunalar sunʼiy ravishda yaratilgan. Boshqa maqolalarga tegishli, ammo maqsad annotatsiya bilan embedding makonida yuqori oʻxshashlikka ega, shu bilan birga maqsad annotatsiyaning GOOD roʻyxatida boʻlmagan kalit soʻzlar tanlangan.
Oʻxshashlikni hisoblashda sentence-transformers/all-mpnet-base-v2 encoder modeli ishlatilgan. Har bir annotatsiya uchun GOOD kalit soʻzlar sonicha BAD namuna tanlanib, murakkabroq va taqqoslama salbiy namunalarni yaratishga harakat qilingan.
Baholash metrikalari
Javob tanlash uchun Precision@K ishlatiladi:
\[ P@K= \frac{\text{ilk }K\text{ aday içindeki GOOD sayısı}}{K}. \]
Bu yerdagi \(K\) algoritmning sozlanadigan giperparametri emas, baholash ufqidir. Javob tanlash natijalari \(K=25\) gacha hisobot qilingan.
Kalit soʻz generatsiyasida F1@K ishlatilgan va baholash \(K=10\) gacha davom ettirilgan. Manba KP20K dagi GOOD kalit soʻzlar sonining 95-percentil qiymati 10 ekanini koʻrsatib, ushbu chegarani asoslaydi.
Nega K Kattalashgani Sari Usulning Afzalligi Aniqroq Koʻrinadi?
Feedback-Aware usulining afzalligi K kattalashgani sari aniqroq namoyon boʻladi, chunki model avvalgi GOOD va BAD generatsiyalarni koʻrib takrorlar hamda past sifatli nomzodlardan yaxshiroq qochishi mumkin, SSG kabi usullar esa har bir yangi generatsiyada avvalgi nomzodlardan bexabar; shu sababli birinchi namunada raqobatbardosh boʻlgan usullar uzun nomzodlar roʻyxatida sifatni tezroq yoʻqotishi mumkin.
4-rasmning ilmiy mazmuni
Manbaning 4a-rasmida javob tanlash Precision@K egri chiziqlari K oshgani sari umuman pasayuvchi yoʻnalishga ega. Buning sababi yaroqli javoblar havzasining asta-sekin tugashidir. SSG boshida kuchli, ammo tezroq pasayadi. ASG avvalgi roʻyxat kontentini koʻrish afzalligiga ega boʻlsa-da, Feedback-Aware yondashuvidan ortda qoladi. ASG-RC javob tanlash vazifasidagi eng kuchli baselineʼlardan biridir; resulting content boʻlgan savollar modelga qoʻshimcha kontekst beradi, ammo GOOD/BAD sifat signali yoʻqligi sababli FA kabi barqaror emas.
4b-rasmda kalit soʻz F1@K egri chiziqlari avval koʻtariladi, taxminan oʻrta K qiymatlarida choʻqqiga chiqadi va keyin pasayadi. Manbaning talqiniga koʻra bu shakl faqat model xatti-harakatining yomonlashishidan kelib chiqmaydi. K kichik boʻlganda hali yetarlicha haqiqiy kalit soʻz yaratilmagani uchun recall cheklovchi omil boʻladi; K haqiqiy kalit soʻzlar havzasidan oshganda qoʻshimcha generatsiyalar BAD sinfidan kela boshlaydi va precision yoʻqotilishi F1 ni pastga tortadi.
FairytaleQA sarlavhasi ostida berilgan statistik natijalar
| K | Baseline | Mean Δ | Holm-tuzatilgan p | Manbadagi ahamiyatlilik |
|---|---|---|---|---|
| 1 | SSG | +0,0005 | \(9.70\times10^{-1}\) | Ahamiyatli emas |
| 1 | ASG | +0,0812 | \(8.39\times10^{-8}\) | *** |
| 1 | ASG-RC | +0,0244 | \(1.62\times10^{-1}\) | Ahamiyatli emas |
| 1 | GPT-4o | +0,1340 | \(1.49\times10^{-17}\) | *** |
| 10 | SSG | −0,0001 | \(9.44\times10^{-1}\) | Ahamiyatli emas |
| 10 | ASG | +0,0496 | \(1.19\times10^{-34}\) | *** |
| 10 | ASG-RC | +0,0125 | \(1.74\times10^{-3}\) | ** |
| 10 | GPT-4o | +0,2520 | \(1.44\times10^{-192}\) | *** |
| 20 | SSG | +0,0517 | \(5.85\times10^{-71}\) | *** |
| 20 | ASG | +0,0633 | \(1.52\times10^{-96}\) | *** |
| 20 | ASG-RC | +0,0376 | \(4.52\times10^{-43}\) | *** |
| 20 | GPT-4o | +0,2841 | \(2.76\times10^{-271}\) | *** |
| 25 | SSG | +0,1104 | \(1.04\times10^{-227}\) | *** |
| 25 | ASG | +0,0632 | \(2.55\times10^{-105}\) | *** |
| 25 | ASG-RC | +0,0529 | \(4.20\times10^{-88}\) | *** |
| 25 | GPT-4o | +0,2828 | \(3.18\times10^{-292}\) | *** |
Statistik testning asosiy xabari shuki, SSG K=1 va K=10 da FA bilan amalda bir xil darajada boʻlishi mumkin boʻlsa-da, K=20 va K=25 da aniq ortda qoladi. Bu natija “FA birinchi yaratilgan namunada har doim yaxshiroq” degan daʼvoni qoʻllab-quvvatlamaydi; “koʻp generatsiya uzaygani sari FA sifatni yaxshiroq saqlaydi” degan daʼvoni qoʻllab-quvvatlaydi.
KP20K kalit soʻz generatsiyasidagi statistik natijalar
| K | Baseline | Mean Δ | Holm-tuzatilgan p | Manbadagi ahamiyatlilik |
|---|---|---|---|---|
| 1 | SSG | +0,0651 | \(2.76\times10^{-6}\) | *** |
| 1 | ASG | −0,0160 | \(2.59\times10^{-1}\) | Ahamiyatli emas |
| 1 | GPT-4o | +0,1431 | \(1.41\times10^{-20}\) | *** |
| 3 | SSG | +0,0607 | \(2.90\times10^{-22}\) | *** |
| 3 | ASG | +0,0118 | \(9.45\times10^{-2}\) | Ahamiyatli emas |
| 3 | GPT-4o | +0,1612 | \(1.12\times10^{-86}\) | *** |
| 5 | SSG | +0,0435 | \(6.47\times10^{-24}\) | *** |
| 5 | ASG | +0,0218 | \(1.33\times10^{-5}\) | *** |
| 5 | GPT-4o | +0,1309 | \(1.99\times10^{-107}\) | *** |
| 10 | SSG | +0,0351 | \(6.94\times10^{-46}\) | *** |
| 10 | ASG | +0,0262 | \(4.69\times10^{-16}\) | *** |
| 10 | GPT-4o | +0,0764 | \(7.48\times10^{-104}\) | *** |
Bu yerda ASG K=1 da FA dan son jihatdan biroz yuqori F1 yaratgan; Mean Δ ning −0,0160 boʻlishi buni koʻrsatadi va farq statistik jihatdan ahamiyatli emas. K=3 da FA foydasiga boʻlgan kichik farq ham ahamiyatli emas. FA ning ASG ga nisbatan statistik afzalligi K=5 va K=10 da yuzaga chiqadi.
Statistik usul
Asosiy protsedura ayni kontekstdagi usul natijalarini juftlaydigan ikki tomonlama Wilcoxon signed-rank testidir. Manba Precision@K va F1@K [0,1] oraligʻida cheklangan va ayniqsa kichik K da diskret/non-normal xususiyat koʻrsatgani uchun ushbu testni tanlagan.
Har bir K doirasidagi koʻp taqqoslashlar uchun Holm–Bonferroni tuzatishi bilan oilaviy xatolik darajasi \(\alpha=0.05\) sifatida nazorat qilingan. Bundan tashqari paired t-test va oʻrtacha farq uchun 10.000 qayta namunalashli paired bootstrap qoʻllangan; manba barcha K qiymatlarida asosiy Wilcoxon natijasi bilan bir xil statistik talqinga erishilganini bildirgan.
Sifatli misollar nimani koʻrsatadi?
Manbadagi 5-jadval javob tanlash vazifasida Feedback-Aware modeli dastlabki besh generatsiyada “happy”, “vivid”, “lion” va “personification” kabi turli semantik yoʻnalishlarga mansub toʻrtta GOOD javob yarata olgani, faqat beshinchi nomzod BAD boʻlgan misolni beradi. Ayni kontekstda ayrim baselineʼlar tezroq past sifatli yoki bir-biriga yaqin nomzodlarga yoʻnaladi.
6-jadvaldagi kalit soʻz misolida FA ketma-ket “productivity”, “knowledge workers”, “performance indicators”, “experts” va “management” ni yaratadi; ulardan uchinchisi manba yorliqlariga koʻra BAD, qolgan toʻrttasi GOOD. Baselineʼlarda keyingi generatsiyalarda aloqasiz yoki takroriy xarakterdagi nomzodlar tez-tez paydo boʻlishi misol qilingan.
Manba sifatli jadvallarda REPEATED yorligʻidan semantik jihatdan avval yaratilgan nomzodga teng generatsiyani koʻrinadigan qilish uchun foydalangan. Bu yorliq miqdoriy baholashda yangi sifat sinfi emas; aynan takrorlar metrikani hisoblashdan oldin olib tashlanadi.
ORPO alignment tajribasi
GOOD va BAD namunalarning mavjudligi tadqiqotchilarni preference alignment usuli ORPO ni alohida sinashga undagan. ORPO tanlangan va rad etilgan javoblar oʻrtasida odds-ratio asosidagi jazoni qoʻllaydi. Tajribada:
\[ \beta=0.3 \]
deb sozlangan va boshqa trening shartlari supervised fine-tuning tartibi bilan bir xil saqlangan.
Manbadagi Figure 5 ga koʻra Feedback-Aware modelining ORPO versiyasi va standart SFT versiyasi oʻxshash xatti-harakat koʻrsatadi. SSG da ORPO javob tanlashning ilk namunalarida foyda berishi mumkin boʻlsa-da, K oshgani sari precision keskinroq pasayadi. Kalit soʻz vazifasida SSG-ORPO boshidanoq pastroq samaradorlik koʻrsatgan.
Mualliflar talqiniga koʻra, ikkilik afzallik optimallashtirishi nomzodlar makonini GOOD/BAD oʻqi boʻylab keskinroq qutblashtirishi va bu xilma-xillik talab qiladigan koʻp namunali generatsiyada kamchilik tugʻdirishi mumkin. Bu tajriba ORPO umuman yomon alignment usuli ekanini koʻrsatmaydi; faqat oʻrganilgan koʻp-generatsiyali vazifalardagi xatti-harakatini koʻrsatadi.
Xato rejimlari
Manba uchta asosiy xato mexanizmini taʼkidlaydi. Birinchidan, Labeling System zaif yoki tizimli ravishda tarafkash boʻlsa, notoʻgʻri yorliqlar keyingi promptʼga qoʻshilgani sabab xato tuzalish oʻrniga iteratsiyalar davomida kuchayishi mumkin.
Ikkinchidan, har bir generatsiya va yorliq prompt tarixiga qoʻshilgani uchun kontekst uzunligi iteratsiyalar soni bilan ortadi. Bu holat context saturation xavfi va inferens xarajatini oshiradi.
Uchinchidan, muayyan kontekst uchun haqiqatan yaxshi nomzodlar soni cheklangan boʻlsa, model maʼlum nuqtadan keyin GOOD havzasini tugatadi. Shu sababli eng yaxshi usulda ham yuqori K qiymatlarida metrika pasayishini butunlay bartaraf etib boʻlmaydi.
Tadqiqotning metodologik cheklovlari
Giperparametr qidiruvi hisoblash xarajati sabab ataylab cheklangan. Taqqoslash adolati uchun asosiy model va baselineʼlarda umumiy trening/decoding sozlamalari ishlatilgan boʻlsa-da, har bir usulning oʻz optimal sozlamasi oʻrganilmagan.
Framework trening uchun salbiy namunalarga muhtoj. KP20K kabi faqat ijobiy annotatsiyaga ega maʼlumotlar toʻplamlarida BAD namunalarni alohida yaratish kerak; salbiylar juda oson tanlansa, model GOOD/BAD farqini yuzaki oʻrganishi mumkin.
Samaradorlik Labeling System sifatiga bogʻliq. Tadqiqotdagi FairytaleQA kuzatuvi oʻrtacha darajadagi yorliqlash nuqsoniga muayyan chidamlilik borligiga ishora qilsa-da, nazorat qilinib oshiriladigan shovqin darajalari bilan tizimli robustness tajribasi oʻtkazilmagan.
Iterativ jarayon bir oʻtishli modellarga qaraganda qoʻshimcha inferens xarajatini keltiradi: koʻproq generation chaqiruvlari, Labeling System chaqiruvlari va iteratsiya bilan chiziqli oʻsadigan prompt tarixi mavjud. Maqola ishlab chiqarish muhiti uchun wall-clock latency, throughput va GPU xotira profillarini batafsil benchmark sifatida taqdim etmagan.
Eksperimental feedback faqat binary GOOD/BAD shaklidadir. Framework boyroq yorliq tuzilishini konseptual jihatdan qoʻllab-quvvatlasa-da, darajali yoki koʻp oʻlchovli feedback tajribada sinab koʻrilmagan.
Nihoyat, barcha asosiy fine-tuning tajribalari bitta 8B bazaviy modelda oʻtkazilgan. Natijalarni ancha kichik, ancha katta yoki boshqa arxitektura oilalariga bevosita umumlashtirish mumkinligi hali koʻrsatilmagan.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
Tadqiqot tegishli tarzda fine-tune qilingan 8B miqyosli ochiq manbali model ochiq GOOD/BAD feedback tarixidan inferens promptʼida foydalanib, oʻrganilgan ikki koʻp matn generatsiyasi vazifasida sifatni iteratsiyalar davomida kuchli baselineʼlarga qaraganda barqarorroq saqlay olishini qoʻllab-quvvatlaydi.
Statistik natijalar ayniqsa yuqori K rejimida farqlar Feedback-Aware yondashuvi foydasiga kattalashishini qoʻllab-quvvatlaydi. Bu natija taʼlim texnologiyalarida koʻp sonli savol nomzodlari, keng baholash elementlari havzalari yoki keyinroq filtrlanadigan kalit soʻz nomzodlari kabi oversampling ssenariylariga mos keladi.
Tadqiqot shuningdek feedback manbai bitta mexanizmga bogʻliq emasligini koʻrsatadigan ikki misol beradi: javob tanlash uchun avtomatik proxy modellar va kalit soʻz generatsiyasi uchun inson tomonidan kuratsiya qilingan annotatsiyalar.
Tadqiqot qoʻllab-quvvatlamaydigan xulosalar
Tadqiqot Feedback-Aware usuli barcha NLP vazifalarida barcha yirik modellardan ustun ekanini koʻrsatmaydi. Faqat ikki vazifa va bitta asosiy 8B model oilasi baholangan.
GPT-4o baselineʼining past samaradorligi GPT-4o ning umumiy model qobiliyati Llama-3 8B dan pastligini koʻrsatmaydi. Tajribada GPT-4o one-shot prompting bilan ishlatilgan, boshqa asosiy modellar esa vazifaga xos fine-tuning olgan; shuning uchun natija faqat ushbu tajriba protokoliga tegishli.
Tadqiqot feedback har doim xatolarni tuzatishini ham koʻrsatmaydi. Notoʻgʻri yoki tarafkash LS signali ayni feedback sikli ichida xatoning keyingi generatsiyalarga oʻtishiga olib kelishi mumkin.
“Kichikroq modellar yirik proprietary LLM larning barcha iterative reasoning qobiliyatlarini bir xil darajada taʼminlay oladi” degan xulosa ham manba tomonidan isbotlanmagan. Koʻrsatilgan narsa — oʻrganilgan ikki koʻp-generatsiyali vazifada tuzilmali feedback mexanizmi 8B modelda foydali ekanidir.
Manbadagi hisobot noaniqliklari
TASA test qismi 1000 va FairytaleQA test qismi 1007 namuna deb berilganiga qaramay, statistik 3-jadval “FairytaleQA, n=2007” shaklida yorliqlangan. 2007 soni ikki test qismining yigʻindisiga teng; ammo manba bu birlashtirilgan tahlil ekanini ochiq aytmagani uchun bu yerda faqat nomuvofiqlik koʻrinadigan holda saqlangan.
KP20K da 2000 test namunasi tanlangani aytilgan boʻlsa-da, 4-jadval statistik taqqoslashni n=1998 kontekstda hisobot qiladi. Ikki namuna nega tahlilga kiritilmagani manbada izohlanmagan.
Keyword Generation boʻlimida KP20K ishlatilgani aniq koʻrsatilganiga qaramay, 6-jadvaldagi misol konteksti oxirida “FairytaleQA dataset entry [15]” degan manba ifodasi mavjud. Verianla bu manbani jim tarzda KP20K ga oʻzgartirmaydi.
Kelajakdagi tadqiqot yoʻnalishlari
Mualliflar framework kengroq generativ vazifalar toʻplamida, turli model miqyoslarida va turli arxitekturalarda sinovdan oʻtkazilishini taklif qiladilar. Ayniqsa, sintetik ravishda buzilgan Labeling System lar bilan nazoratli feedback-noise tajribalari modelning notoʻgʻri feedback ga chidamliligini bevosita oʻlchashi mumkin.
Ishlab chiqarish muhitiga oid wall-clock latency, throughput va GPU xotira oʻlchovlari ham kelajakdagi muhim ehtiyojlardan biridir; chunki iterativ feedback siklining sifat afzalligi qoʻshimcha inference xarajati bilan birgalikda baholanishi kerak.
Binary GOOD/BAD yorligʻidan tashqari darajali ballar yoki turli sifat oʻlchamlarini alohida ifodalovchi koʻp oʻlchovli feedback tuzilmalari ham tadqiq qilinishi mumkin.
Manba nihoyat matematik masala yechish, mantiqiy inferens yoki ilmiy izoh kabi koʻp bosqichli reasoning vazifalarida oraliq qadamlarga feedback qoʻllashni ehtimoliy kengayish sohasi sifatida taklif qiladi. Bu qoʻllanish tadqiqotda tajriba orqali tasdiqlanmagan.
Manba va Usul Haqida Izoh
Asl tadqiqot: Feedback-Aware Inference for Iterative Multi-Sample Text Generation
Mualliflar: Andreea Dutulescu; Stefan Ruseti; Mihai Dascalu; Danielle S. McNamara.
Masʼul muallif: Stefan Ruseti.
Tashkilotlar: Computer Science and Engineering Department, National University of Science and Technology POLITEHNICA Bucharest, Ruminiya; Academy of Romanian Scientists, Ruminiya; Learning Engineering Institute, Arizona State University, AQSh.
Jurnal: AI.
Nashriyot: MDPI.
Manba turi: Taqrizdan oʻtgan original tadqiqot maqolasi; tabiiy tilni qayta ishlash, til modeli fine-tuning va iterativ inferens tajribalari.
Nashr maʼlumoti: AI 2026, jild 7, son 5, maqola 171.
DOI: 10.3390/ai7050171
Yuborilgan: 1 aprel 2026.
Tahrir: 8 may 2026.
Qabul: 12 may 2026.
Nashr: 15 may 2026.
Litsenziya: Creative Commons Attribution (CC BY), ochiq kirish.
Moliyalashtirish: Tadqiqot Romanian Hub for Artificial Intelligence—HRIA loyihasi, Smart Growth, Digitization and Financial Instruments Program 2021–2027 doirasida MySMIS no. 351416; U.S. Department of Education Institute of Education Sciences tomonidan Arizona State University ga berilgan R305T240035 raqamli grant va Academy of Romanian Scientists AOSR-TEAMS-IV Edition 2025–2026 “Digital Transformation in Science” granti bilan qoʻllab-quvvatlangan.
Institutsional etika kengashi: Qoʻllanilmaydi.
Xabardor rozilik: Qoʻllanilmaydi.
Maʼlumot, kod va modelga kirish: Mualliflar tadqiqot maʼlumotlari, kodi va fine-tune qilingan modellarini ochiq GitHub repozitoriyasida eʼlon qilganini bildiradilar.
Generativ AI dan foydalanish bayonoti: Mualliflar maqolani tayyorlashda generativ sunʼiy intellekt faqat imlo tekshiruvi va grammatika maqsadlarida ishlatilganini; chiqishlar oʻzlari tomonidan koʻrib chiqilib tahrirlanganini va kontent uchun javobgarlikni oʻz zimmalariga olganini bildiradilar.
Manfaatlar toʻqnashuvi: Mualliflar manfaatlar toʻqnashuvi yoʻqligini bayon qiladilar. Moliyalashtiruvchilar tadqiqot dizayni, maʼlumot yigʻish/tahlil/talqin, maqola yozish yoki nashr qarorida rol oʻynamagani bildirilgan.
Muallif hissalari: Konseptuallashtirish Andreea Dutulescu, Stefan Ruseti va Mihai Dascalu; metodologiya Andreea Dutulescu va Stefan Ruseti; dasturiy taʼminot, formal tahlil, tadqiqot, resurslar, maʼlumotlar kuratsiyasi, dastlabki qoralama va vizuallashtirish Andreea Dutulescu; validatsiya Andreea Dutulescu, Stefan Ruseti va Mihai Dascalu; koʻrib chiqish va tahrirlash barcha toʻrt muallif; nazorat Stefan Ruseti, Mihai Dascalu va Danielle S. McNamara; loyiha boshqaruvi Mihai Dascalu; moliyalashtirishni jalb qilish Stefan Ruseti, Mihai Dascalu va Danielle S. McNamara tomonidan amalga oshirilgan.
Asosiy metodologik cheklovlar: Faqat ikki vazifa baholangan; bitta 8B bazaviy model ishlatilgan; giperparametr qidiruvi cheklangan; salbiy namunalar talabi mavjud; yorliqlash tizimidagi xatolar feedback siklida tarqalishi mumkin; inference xarajati bir oʻtishli usullardan yuqori; binary feedback dan boshqa tuzilmalar sinovdan oʻtkazilmagan; ishlab chiqarish muhiti latency/throughput/GPU xotira benchmarklari berilmagan.
Manba ichidagi hisobot izohi: FairytaleQA test soni bilan 3-jadvaldagi n=2007 yorligʻi, KP20K test soni bilan 4-jadvaldagi n=1998 qiymati va 6-jadvaldagi FairytaleQA manba yorligʻi oʻrtasida izohlanmagan nomuvofiqliklar mavjud. Bu nuqtalar Verianla tomonidan jim tarzda tuzatilmagan.
Verianla usul izohi: Ushbu kontent manba maqolaning gapma-gap tarjimasi yoki paragrafma-paragraf yaqin qayta yozuvi emas. Tadqiqot muammosi, Feedback-Aware training/inference tuzilishi, GOOD/BAD feedback tizimi, QGen/QAns baholash mantiqi, maʼlumotlar toʻplamlari, model sozlamalari, P@K va F1@K natijalari, statistik testlar, sifat tahlili, ORPO tajribasi, cheklovlar va kelajakdagi tadqiqot takliflari saqlangan holda mustaqil oʻzbekcha ilmiy oʻquv tuzilmasi yaratilgan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan