

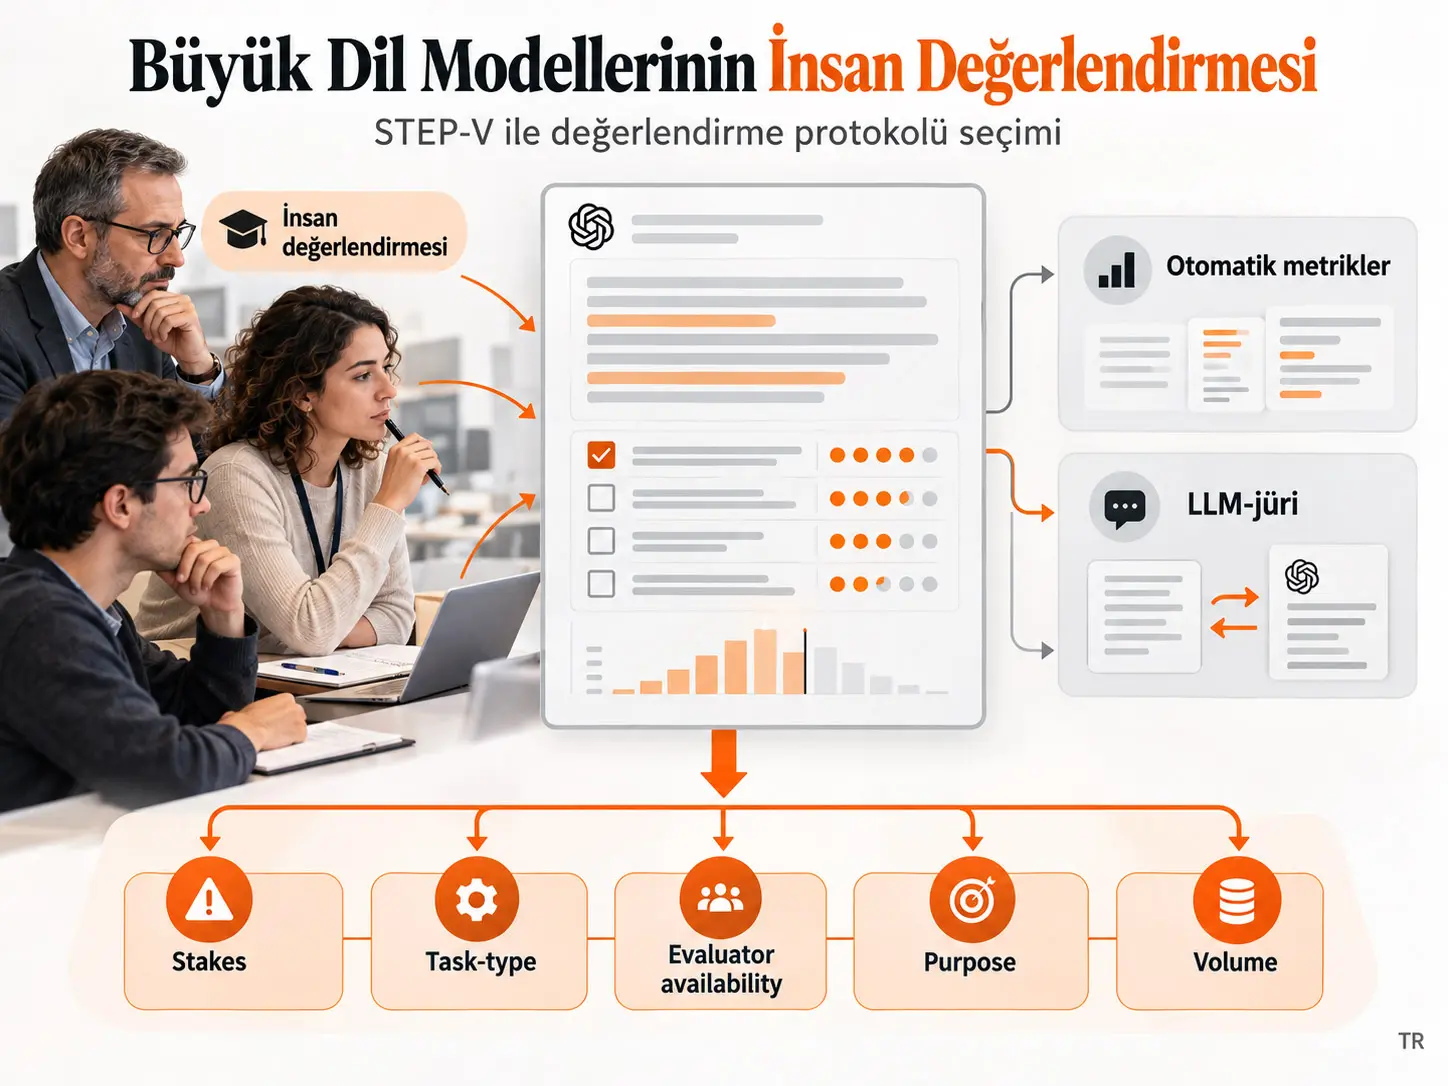
İnsan merkezli LLM değerlendirmesi, büyük dil modeli çıktılarının yalnız otomatik metriklerle değil; belirli bir görevi, kalite ölçütünü ve kullanım bağlamını değerlendirmeye uygun insan yargılarıyla ölçülmesini sağlayan bir değerlendirme yaklaşımıdır. Bu derleme, insan değerlendirmesini kusursuz bir “doğru cevap kaynağı” olarak değil, kendi güvenirliği, geçerliği, önyargıları, bilişsel sınırlılıkları ve belirsizliği bulunan bir ölçüm altyapısı olarak ele almaktadır. Makale yeni bir LLM deneyinin sonuçlarını sunmamakta; değerlendirme metodolojisi, psikometri, bilişsel bilim, insan faktörleri ve alan-özel LLM uygulamalarındaki araştırmaları sentezleyerek değerlendirme protokolünün nasıl seçilmesi gerektiğine ilişkin kavramsal bir çerçeve geliştirmektedir.
Yazar dört temel soruna dikkat çekmektedir: insan etiketlerinin kusursuz altın standart olarak ele alınması, değerlendirici yorgunluğu ve aşırı bilişsel yük, insanlarla LLM tabanlı jüri modellerinde görülen ortak veya farklı önyargı yapıları ve değerlendirme sonuçlarında belirsizlik ile dağılım bilgilerinin çoğu zaman ihmal edilmesi. Bu sorunları sistematik biçimde ele almak için STEP-V çerçevesi önerilmektedir. STEP-V; Stakes, Task-type, Evaluator availability, Purpose ve Volume boyutlarından oluşur ve gerçek kullanım koşullarında insan, otomatik metrik ve LLM-as-judge bileşimlerinin nasıl seçilebileceğine ilişkin karar desteği sağlar.
Makalenin ikinci özgün katkısı, insan değerlendiriciler ile LLM-as-judge sistemlerini aynı hata çerçevesinde inceleyen ortak bir hata modu taksonomisidir. Sıra etkileri, uzun cevap tercihi, otorite etkisi, aşırı güven, yorgunluk, öznellik, bilgi eksikliği, kültürel önyargı ve yanlış bilgiye güven gibi sorunların bazıları hem insanlar hem de LLM değerlendiricilerinde farklı biçimlerde görülebilir. Bu nedenle insan ve yapay değerlendiricileri bir araya getiren hibrit sistemlerin kendiliğinden daha güvenilir olduğu varsayılamaz; iki taraf aynı tür hataya eğilimliyse hata azalmak yerine güçlenebilir.
Çalışmanın temel yorum sınırı şudur: STEP-V ve ortak hata modu taksonomisi henüz prospektif deneylerle doğrulanmış nicel performans modelleri değildir. Yazar bunları değerlendirme tasarımını yapılandırmak için kavramsal çerçeveler olarak sunmakta ve gerçek değerlendirme kalitesini artırıp artırmadıklarının gelecekte ampirik olarak sınanması gerektiğini açıkça belirtmektedir.
LLM Değerlendirmesinde İnsan Yargısı Neden Hâlâ Gereklidir?
İnsan yargısı özellikle açık uçlu, bağlama bağımlı, uzmanlık gerektiren veya sosyal ve normatif ölçütler içeren görevlerde gereklidir; çünkü sözcük benzerliği veya otomatik puanlar bir yanıtın klinik olarak güvenli, hukuken savunulabilir, pedagojik olarak yararlı, toplumsal açıdan uygun veya gerçek kullanıcı için faydalı olup olmadığını tek başına güvenilir biçimde ölçemez.
Erken doğal dil işleme sistemlerinde görevler daha dar, doğru çıktı uzayı daha sınırlı ve referans cevaplarla karşılaştırma daha uygulanabilirdi. Güncel LLM'ler ise tıbbi danışmanlıktan hukuki analize, öğretimden planlamaya ve yaratıcı yazıya kadar çok açık uçlu çıktılar üretmektedir. Böyle durumlarda aynı soruya birden fazla iyi yanıt bulunabilir ve yüzeysel olarak benzer iki yanıt güvenlik veya doğruluk açısından tamamen farklı olabilir.
Bu nedenle makale değerlendirmeyi yalnız “model doğru cevap verdi mi?” sorusuna indirgemez. Asıl ölçüm problemi şunları birlikte kapsar: neyin ölçüldüğü, kimin değerlendirdiği, hangi protokolün kullanıldığı, değerlendirme ölçeğinin nasıl tanımlandığı, değerlendiricinin ne kadar uzman olduğu, ne kadar yorulduğu ve sonuçların hangi istatistiksel varsayımlarla birleştirildiği.
İnsan değerlendirmesinin kendisi de bir ölçüm sistemidir
Bir insan değerlendirmesi geçerli veya geçersiz; güvenilir veya güvenilmez; iyi kalibre edilmiş veya kötü kalibre edilmiş olabilir. Bu nedenle insan etiketini otomatik olarak “ground truth” kabul etmek metodolojik olarak yetersizdir.
Makalenin psikometrik yaklaşımı burada önem kazanır. Bir ölçümün güvenirliği, farklı değerlendiriciler, maddeler veya zamanlar arasında ne kadar tutarlı olduğunu; geçerliği ise gerçekten ölçmek istediği yapıyı ölçüp ölçmediğini ifade eder. Bir değerlendirme yüksek tutarlılığa sahip olup yine de yanlış şeyi ölçebilir.
Örneğin değerlendiricilerin sistematik olarak daha uzun yanıtları tercih etmesi çok tutarlı bir sonuç doğurabilir; ancak hedef ölçüt doğruluksa cevap uzunluğu gerçek kalite göstergesi olmayabilir. Benzer biçimde son kullanıcı memnuniyeti “algılanan yararlılık” için geçerli bir ölçüt olabilirken olgusal doğruluğun geçerli ölçüsü olmak zorunda değildir.
Üç katmanlı LLM değerlendirme taksonomisi
| Katman | Değerlendirici / araç | Temel avantaj | Temel sınır |
|---|---|---|---|
| Katman 1 | Otomatik referanslı veya referanssız metrikler | Düşük maliyet, yüksek tekrarlanabilirlik ve hızlı iterasyon | Açık uçlu görevlerde doğruluk, akıl yürütme kalitesi, yararlılık veya etik uygunluk gibi yapıları eksik ölçebilir |
| Katman 2 | LLM-as-judge sistemleri | İnsanlardan daha yüksek ölçeklenebilirlik ve klasik metriklerden daha fazla bağlamsal duyarlılık | Geçerlik görev, dil, ölçülen özellik ve hedef insan grubuna bağlıdır; varsayılan olarak geçerli kabul edilemez |
| Katman 3 | Doğrudan insan değerlendirmesi | Bağlam, uzmanlık, sosyal uygunluk, güvenlik ve çoklu geçerli cevapları değerlendirebilme | Maliyet, ölçeklenebilirlik, yorgunluk, heterojenlik ve bilişsel önyargılar |
Katman 1: Otomatik metrikler
BLEU, ROUGE ve METEOR gibi klasik metrikler üretilen metni referans cevaplarla yüzeysel veya yapısal benzerlik açısından karşılaştırır. BERTScore gibi daha yeni anlamsal metrikler gömme uzayında anlamsal benzerliği değerlendirmeye çalışır. Perplexity veya bazı retrieval-augmented generation bağlamlarındaki faithfulness metrikleri gibi referanssız araçlar da tek bir altın cevap gerektirmeden kalite sinyali üretmeyi amaçlar.
Bu araçların önemi küçümsenmemelidir; hızlı, ucuz ve yeniden üretilebilir değerlendirme sağlarlar. Ancak makalenin vurgusu, bunların yalnız ölçebildikleri yapı kadar anlamlı olduğudur. Bir metin referans cevaba benzediği hâlde gerçek dünya açısından yanlış veya güvensiz olabilir; başka bir metin referansa az benzediği hâlde doğru ve yararlı olabilir.
Katman 2: LLM-as-judge
LLM-as-judge, bir dil modelinin başka bir model çıktısını puanlamak, sıralamak veya iki yanıt arasında tercih yapmak için değerlendirici olarak kullanılmasıdır. Makale bu yaklaşımın özellikle açık kriterli, rubrik tabanlı veya ikili karşılaştırma görevlerinde yararlı olabileceğini; ancak görev türü, ölçülen özellik, dil ve karşılaştırıldığı insan değerlendiricilerin uzmanlık düzeyine göre performansın önemli ölçüde değişebildiğini vurgulamaktadır.
Bundan çıkarılan temel sonuç, LLM-as-judge sisteminin tak-çalıştır biçiminde evrensel bir değerlendirici olmadığıdır. Bir jüri modelinin geçerliği yereldir: hedef göreve, hedef yapıya ve hedef insan değerlendirici topluluğuna karşı kalibre ve test edilmelidir.
Katman 3: Doğrudan insan değerlendirmesi
Doğrudan insan değerlendirmesi ikna edicilik, uygunluk, pedagojik değer, potansiyel zarar, alan-özel yeterlilik ve bağlamsal uyum gibi formalize edilmesi zor özelliklerde yüksek esneklik sunar.
Ancak “insan değerlendirmesi” tek bir yöntem değildir. Bir hekimin klinik yanıtı değerlendirmesi, bir hukuk uzmanının hukuki analizi incelemesi, bir son kullanıcının memnuniyet bildirmesi ve bir crowdworker'ın iki chatbot cevabını karşılaştırması farklı ölçüm eylemleridir. Bunları eşdeğer kabul etmek değerlendirme geçerliğini zayıflatabilir.
Bir LLM Çıktısını Kimin Değerlendirmesi Gerektiğine Nasıl Karar Verilir?
Değerlendirici seçimi, ölçülecek yapının ne kadar uzmanlık bilgisi, yaşanmış deneyim veya bağlamsal aşinalık gerektirdiğine göre yapılmalıdır. Yüksek riskli ve uzmanlık gerektiren görevlerde alan uzmanları daha güçlü yapı geçerliği sağlayabilirken, kullanıcı memnuniyeti veya günlük kullanılabilirlik gibi yapılar için gerçek son kullanıcılar daha geçerli değerlendiriciler olabilir.
| Değerlendirici | Uzman görevlerde geçerlik | Güvenirlik | Maliyet | Ölçeklenebilirlik | En uygun kullanım |
|---|---|---|---|---|---|
| Alan uzmanları | Çok yüksek | Orta | Çok yüksek | Düşük | Tıp, hukuk, askerî alan, finans gibi yüksek riskli ve uzmanlık gerektiren görevler |
| Eğitimli anotatörler | Orta | Orta | Orta | Orta | Rubrik ve kalibrasyonla genel amaçlı kalite değerlendirmesi |
| Crowdworker'lar | Düşük–orta | Düşük–orta | Düşük | Çok yüksek | Akıcılık, alaka, temel anlaşılabilirlik ve düşük riskli büyük ölçekli anotasyon |
| Son kullanıcılar | Yüksek ekolojik geçerlik | Düşük | Düşük | Orta | Memnuniyet, kullanılabilirlik ve gerçek kullanım bağlamındaki yararlılık |
Makale özellikle uzmanlar arasında görüş ayrılığı olabileceğini hatırlatmaktadır. Uzmanların aynı sonuca ulaşmaması otomatik olarak değerlendirme başarısızlığı değildir; karmaşık bir klinik, hukuki veya sosyal yapının gerçekten belirsiz olmasının işareti olabilir.
Ne değerlendiriliyor?
Değerlendirmenin ilk tasarım adımlarından biri hedef yapının açık biçimde tanımlanmasıdır. “Kalite” gibi tek ve belirsiz bir sözcük yerine doğruluk, yararlılık, tercih, güven, okunabilirlik, güvenlik, bağlamsal uygunluk veya başka bir ölçülebilir yapı belirlenmelidir.
Olgusal doğruluk, alıntı doğruluğu ve biçim kurallarına uygunluk çoğu zaman dışarıdan doğrulanabilir. Yaratıcılık, kibarlık veya etkileşim çekiciliği ise insan yorumuna ve sosyal normlara daha fazla bağlıdır. Klinik uygunluk, hukuki sağlamlık veya düzenleyici uyum gibi ölçütlerde genel değerlendiricilerin yeterli uzmanlığı bulunmayabilir.
Değerlendirme hangi protokolle yapılabilir?
- Likert tipi puanlama: Yanıta örneğin 1–5 arasında puan verilir. İnce derecelendirme sağlar ancak ölçek yorumlama ve anchoring etkilerine duyarlıdır.
- İkili karar: Kabul edilebilir / kabul edilemez veya doğru / yanlış gibi iki sınıftan biri seçilir. Keskin ayrımlarda anlaşmayı artırabilir ancak nüansı kaybedebilir.
- İkili karşılaştırma: İki çıktı yan yana değerlendirilir ve belirli bir ölçüte göre hangisinin daha iyi olduğu seçilir. Mutlak puan vermekte zorlanan değerlendiriciler için yararlı olabilir.
- Rubrik tabanlı değerlendirme: Çıktı birden fazla açık alt boyutta, önceden tanımlanmış ölçütler veya anchor örnekleriyle puanlanır. Belirsiz bütüncül yargıyı daha gözlenebilir parçalara ayırabilir.
Protokol yalnız puan biçimini belirlemez; ortaya çıkacak verinin istatistiksel yapısını, bilişsel yükü ve muhtemel hata kaynaklarını da belirler. Çok fazla eşzamanlı ölçüt, uzun değerlendirme oturumları veya yetersiz tanımlanmış ölçek etiketleri güvenilirliği azaltabilir.
İnsanlar Arasında Görüş Ayrılığı Her Zaman Hata mıdır?
Hayır. Açık uçlu, öznel veya kültürel açıdan değişken görevlerde görüş ayrılığı gerçek ve anlamlı perspektif farklılıklarını temsil edebilir; buna karşılık ilaç kontrendikasyonu veya yanlış hukuki atıf gibi dışarıdan doğrulanabilen yüksek riskli konularda yüksek anlaşmazlık daha sıkı uzman incelemesi gerektiren bir uyarı sinyali olarak değerlendirilmelidir.
Güvenirlik ölçümü
Makale Cohen's kappa, Krippendorff's alpha ve intraclass correlation coefficient gibi değerlendiriciler arası güvenirlik ölçülerinin mevcut olduğunu; ancak LLM değerlendirme çalışmalarında bunların yeterince raporlanmadığını veya bağlamsız verildiğini belirtmektedir.
Tek bir ortalama puan yüksek anlaşmazlığı gizleyebilir. Bu nedenle düşük anlaşma doğrudan “anotatör gürültüsü” olarak atılmamalıdır; belirsiz kriter, karışık bir yapı veya değerlendirici üzerinde aşırı bilişsel yük olduğuna işaret edebilir.
Dağılımsal değerlendirme
Öznel görevlerde yalnız ortalama görüşe bakmak yerine değerlendirme dağılımlarını korumak mümkündür. Makale Kullback–Leibler divergence ve Earth Mover's Distance gibi dağılımsal uzaklık ölçülerinin, model yargılarının yalnız insan ortalamasına değil insan görüşlerinin yayılımına ne kadar benzediğini incelemek için kullanılabileceğini tartışmaktadır.
Buradaki amaç bütün anlaşmazlığı ortadan kaldırmak değildir. Farklı insan gruplarının farklı ama geçerli perspektifleri bulunabilir. Buna karşın büyük alt grup ayrışmaları veya yüksek riskli maddelerde belirsizlik, hedefli denetim ve uzman adjudication ihtiyacını gösterebilir.
Kusurlu altın standart problemi
İnsan etiketi birçok LLM değerlendirmesinde son ve tartışılmaz referans gibi ele alınır. Makale psikometri ve tanısal istatistik literatürüne dayanarak bunun her zaman geçerli olmadığını vurgular. İnsan değerlendiriciler de hata yapabilir, farklı şiddette puanlayabilir veya yapıyı farklı yorumlayabilir.
Bu nedenle basit puan ortalamalarının ötesine geçmek için many-facet Rasch modelleri, hiyerarşik ordinal modeller, Bradley–Terry tipi ikili karşılaştırma modelleri ve gerektiğinde kusurlu-altın-standart veya latent-class modelleri gibi ölçüm yaklaşımları tartışılmaktadır. Makale bu modelleri kendi verisine uygulamamaktadır; bunları daha savunulabilir LLM değerlendirme tasarımı için metodolojik seçenekler olarak sunmaktadır.
Çalışmanın Yöntemi ve Bulguları
Derlemenin bilimsel yaklaşımı
Çalışma yeni bir LLM veri seti üzerinde deney yapan ampirik araştırma değildir. Yazar; LLM değerlendirme metodolojisi, insan değerlendirmesi, psikometri, bilişsel bilim, anotasyon araştırmaları, LLM-as-judge çalışmaları ve sağlık, hukuk, finans, askerî alan, eğitim ve güvenlik gibi uygulama alanlarındaki literatürü bir araya getirerek ortak bir değerlendirme tasarım mantığı oluşturmaktadır.
Kaynak sistematik tarama sorgusu, PRISMA seçme akışı, meta-analiz veya nicel çalışma-kalite puanlaması bildirmemektedir. Bu nedenle elde edilen “bulgular”, yeni deneysel etkilerden çok literatür senteziyle geliştirilen kavramsal sonuçlar, yöntem önerileri ve tasarım ilkeleridir.
İnsan ve LLM değerlendiricilerinin ortak hata modu taksonomisi
| Hata modu | İnsandaki görünümü | LLM-as-judge görünümü | Önerilen tasarım karşılığı |
|---|---|---|---|
| Sıra etkileri | İlk/son öğeye ağırlık verme, anchoring | Pozisyon önyargısı | Sıralamayı rastgeleleştir ve sunumu körle |
| Uzunluk önyargısı | Daha uzun cevabı daha iyi görme | İçerik yerine uzunluğu tercih etme | Uzunluğu kontrol et veya özlülüğü ayrı değerlendir |
| Otorite önyargısı | Prestijli kaynak veya tona gereğinden fazla güvenme | Otoriter görünen çıktıyı kayırma | Mümkünse kaynak/kimlik ipuçlarını kaldır |
| Sosyal uyum | Önceki değerlendiricilere doğru sürüklenme | Önceden verilen sinyalleri pekiştirme | Değerlendiricileri bağımsız tut ve puan sızıntısını önle |
| Aşırı güven | Puanlarda gereğinden yüksek kesinlik | Kararda gereğinden yüksek kesinlik | Gerekçe veya güven düzeyi raporlaması iste |
| Yorgunluk ve aşırı yük | Oturum içinde ve oturumlar arasında dikkatin azalması | Uzun bağlam, karmaşık görev veya tekrarlı çıkarım altında performans düşüşü | Oturum uzunluğunu sınırla ve sıra boyunca drift denetimi yap |
| Öznellik başarısızlığı | Yaratıcı veya kültürel yargılarda düşük değerlendiriciler arası anlaşma | Öznel görevlerde insanlarla zayıf uyum | Birden fazla değerlendirici kullan, anlaşmazlığı koru ve gürültü içindeki sinyali incele |
| Bilgi boşlukları | Uzmanlık gerektiren hatayı fark edememe | Zayıf alan-özel muhakeme | Değerlendirici uzmanlığını göreve eşleştir |
| Kültürel önyargı | Demografik veya kültürel arka planın puanı şekillendirmesi | Eğitim verisinden taşınan önyargılar | Değerlendirici havuzunu çeşitlendir ve alt grup etkilerini test et |
| Halüsinasyona güven | Kendinden emin yanlış bilgiyi tespit edememe | Uydurulmuş içeriği geçerli olarak puanlama | Olgusal boyutlarda harici doğrulama kullan |
Bu tablo makalenin önemli mesajlarından birini açık eder: insan ve LLM hataları bağımsız olmak zorunda değildir. İki taraf aynı yönde uzunluk, otorite veya kültürel önyargı gösteriyorsa bunları birleştirmek “iki farklı kontrol katmanı” oluşturmak yerine aynı sapmayı güçlendirebilir.
STEP-V Çerçevesi Bir Değerlendirme Protokolünü Nasıl Seçiyor?
STEP-V, değerlendirme tasarımını beş bağlamsal değişkene göre yapılandırır: hatalı değerlendirmenin sonuçlarının ciddiyeti, görevin kapalı/açık uçlu yapısı, uygun değerlendiricilerin erişilebilirliği, değerlendirmenin amacı ve değerlendirilecek çıktı hacmi. Çerçeve tek bir evrensel protokol önermez; bağlam değiştikçe insan, LLM ve otomatik yöntemlerin rollerinin de değişmesi gerektiğini savunur.
| Boyut | Anlamı | Tasarım üzerindeki temel etkisi |
|---|---|---|
| S — Stakes | Yanlış değerlendirmenin gerçek dünyadaki sonuçlarının ciddiyeti | Risk yükseldikçe uzmanlık, muhafazakâr eşikler ve belirsizlik yönetimi önem kazanır |
| T — Task-type | Görevin kapalı ve doğrulanabilir mi, yoksa açık uçlu ve öznel mi olduğu | Doğrulanabilir görevler otomasyona daha uygun olabilir; açık uçlu görevler daha fazla insan yargısı gerektirir |
| E — Evaluator availability | Uzman, anotatör, crowdworker, son kullanıcı veya LLM değerlendiricilerin erişilebilirliği | Kıt uzman zamanı örnekleme ve escalation stratejisini değiştirir |
| P — Purpose | Erken geliştirme, dağıtım öncesi doğrulama veya üretim sonrası sürekli izleme | Aynı sistem yaşam döngüsünün farklı aşamalarında farklı değerlendirme protokolleri gerektirebilir |
| V — Volume | Değerlendirilecek çıktı sayısı ve sıklığı | Hacim yükseldikçe otomasyon, istatistiksel örnekleme ve seçici insan incelemesi gerekir |
Stakes: hata ne kadar ciddi?
Düşük riskli uygulamalar, yanlış değerlendirmenin büyük gerçek dünya zararına yol açmasının beklenmediği yaratıcı yazı, pazarlama sloganı veya chatbot ton ayarı gibi görevleri kapsar. Bu bağlamlarda otomatik metrikler, tercih testleri veya daha hafif insan değerlendirmeleri yeterli olabilir.
Orta riskli uygulamalar, hata nedeniyle anlamlı fakat genellikle kritik olmayan sonuçların oluşabileceği işletme içi belge özetleme, genel eğitim açıklamaları veya insan tarafından gözden geçirilen yazılım kod önerileri gibi görevlerdir. Hibrit değerlendirme daha anlamlı hâle gelir.
Yüksek riskli uygulamalar, tıbbi tavsiye, klinik karar desteği, hukuki analiz, finansal öneri veya askerî planlama gibi yanlış değerlendirmenin zarar, hukuki sorumluluk veya güvenlik riski doğurabileceği alanlardır. Makale bu bağlamlarda alan uzmanlarını, çok boyutlu rubrikleri, muhafazakâr karar eşiklerini ve belirsizlik/anlaşmazlık yönetimini önceliklendirir; otomatik yöntemleri destekleyici role yerleştirir.
Task-type: görev doğrulanabilir mi?
Kapalı uçlu görevlerde açık doğru cevap veya dış doğrulama kuralı bulunabilir. Yapılandırılmış bilgi çıkarımı, bilinen etikete sahip sınıflandırma veya birim testlerini geçmesi gereken kod gibi görevlerde otomatik kontrol güçlü bir rol oynayabilir.
Açık uçlu görevlerde ise birden fazla makul yanıt bulunabilir. Karmaşık belge özeti, tıbbi danışmanlık dili, hukuki muhakeme veya stratejik öneri gibi görevlerde yararlılık, açıklık ve bağlamsal uygunluk gibi yapılar tam olarak dışarıdan gözlenemeyebilir.
Evaluator availability: doğru değerlendirici gerçekten erişilebilir mi?
Tıp, hukuk veya askerî planlama gibi alanlarda en uygun uzmanlar pahalı ve zaman açısından kıt olabilir. Bu nedenle değerlendirme tasarımı yalnız ideal değerlendiricinin kim olduğunu değil, gerçekten ne kadar uzman zamanının mevcut olduğunu da hesaba katmalıdır.
Makale, uzmanların sınırlı olduğu durumlarda sabit bir anotasyon kotası yerine hedeflenen belirsizliğe göre örneklem büyüklüğü planlamayı; uzman emeğini riskli, sınırda veya yüksek anlaşmazlıklı maddelere yönlendirmeyi önermektedir.
Purpose: değerlendirme hangi yaşam döngüsü aşamasında?
Erken geliştirme hızlı model karşılaştırması ve bariz hata modlarının bulunmasına odaklanır. Otomatik metrikler, küçük insan tercih testleri veya LLM-as-judge sistemleri hızlı yön gösterici sinyal sağlayabilir.
Dağıtım öncesi doğrulama daha yüksek kanıt eşiği gerektirir. Sistem hedeflenen performans, güvenlik ve güvenirlik sınırlarını karşılıyor mu sorusuna yapılandırılmış insan değerlendirmesi, alan kriterleri ve güvenirlik raporlamasıyla cevap verilmesi gerekir.
Üretim izleme sistem kullanıma girdikten sonra performans kayması, yeni hata modları ve kullanıcı etkileşimlerindeki değişimi izler. Yüksek hacimde otomatik izleme ve anomali tespiti yapılabilir; seçilen yüksek riskli veya şüpheli örnekler insan incelemesine yönlendirilebilir.
Volume: milyonlarca çıktı nasıl değerlendirilir?
Düşük hacimli bir uzman test setinde her çıktı ayrıntılı rubriklerle birden fazla uzman tarafından incelenebilir. Orta hacimde örnekleme ile kısmi otomasyon bir araya getirilebilir. Milyonlarca chatbot etkileşiminin bulunduğu yüksek hacimli üretim ortamında ise her çıktıyı doğrudan insanla değerlendirmek mümkün değildir; otomatik tarama ve istatistiksel örnekleme ile yalnız riskli veya sıra dışı örneklerin insana yönlendirilmesi gerekir.
Kaynak Şekil 1'in bilimsel mesajı
Makalenin sayfa 10'undaki STEP-V şekli düşük, orta ve yüksek riskli kullanım düzeylerini üç ayrı karar panelinde göstermektedir. Her panel “temel hedef”, “kim değerlendirmeli?”, “kabul edilebilir yöntemler” ve “ne zaman uzman incelemesine yükseltilmeli?” sorularını geliştirme, dağıtım doğrulaması ve izleme bağlamında birlikte ele alır.
Şeklin ana mesajı, risk arttıkça insan uzmanlığının değerlendirme zincirinin merkezine taşınmasıdır. Düşük riskli ve yüksek hacimli işlerde otomasyon daha fazla kullanılabilirken, yüksek riskli alanlarda otomatik değerlendirme insan uzmanının yerine geçmek yerine ön eleme veya destek görevinde kalmalıdır.
Yüksek Riskli Uygulamalarda LLM-as-Judge İnsan Uzmanının Yerini Alabilir mi?
Makalenin önerisine göre genel durumda hayır. Yüksek riskli uygulamalarda LLM-as-judge sistemleri ancak hedef görevde nitelikli uzmanlarla karşılaştırıldığında olağanüstü güçlü ve görev-özel kanıt sunabiliyorsa daha geniş rol alabilir; varsayılan yaklaşım uzmanı birincil hakem, LLM'yi ise ön tarama, alt ölçüt kontrolü veya inceleme önceliklendirme aracı olarak kullanmaktır.
Expert-Guided Auto-Evaluation
Uzman azlığı ile yüksek değerlendirme hacmi arasındaki boşluğu azaltmak için makale Expert-Guided Auto-Evaluation yaklaşımını tartışmaktadır. Burada uzmanın rolü her çıktıyı tek tek etiketlemekten kısmen uzaklaşarak ölçüm aracını tasarlamaya kayar.
Uzman; görev-özel rubrikleri, kritik alt kriterleri ve değerlendirme/eleştiri istemlerini oluşturur. LLM tabanlı jüri sistemi bu yapılandırılmış ölçümü daha geniş çıktı hacmi üzerinde uygular. Ancak LLM değerlendirmesinin uzman standartlarıyla kalibre edilmesi gerekir.
50–100 uzman etiketi önerisi ne anlama geliyor?
Makale, tam uzman denetiminin maliyet nedeniyle mümkün olmadığı bazı yüksek riskli durumlarda yaklaşık 50–100 uzman tarafından doğrulanmış örneğin daha büyük ve daha ucuz crowd-sourced veya LLM-jüri veri setini kalibre etmek için kullanılabileceğini örnek bir strateji olarak tartışmaktadır.
Bu sayı evrensel bir örneklem büyüklüğü kuralı değildir. Metnin devamı, örneklem planının sabit bir kota yerine karar için kabul edilebilir belirsizlik düzeyinden başlatılması gerektiğini açıkça belirtmektedir.
Üç uygulama örneği
| Uygulama | Risk / görev yapısı | Önerilen değerlendirme yaklaşımı |
|---|---|---|
| Tıbbi danışman asistanı | Yüksek risk, büyük ölçüde açık uçlu, uzman kıtlığı | Uzman liderliğinde rubrik değerlendirmesi; otomatik araçlar ön tarama/triage; belirsiz veya riskli durumları uzmana yükseltme |
| Tüketici yazı asistanı | Düşük–orta risk, açık uçlu, yüksek değerlendirici erişimi | İkili tercih, kullanıcı puanları ve LLM-as-judge; güvenlik/politika boyutlarında periyodik uzman denetimi |
| Kurumsal retrieval tabanlı politika/uyum aracı | Orta–yüksek risk, kısmen doğrulanabilir, yüksek hacim | Olgusal uyum ve citation doğruluğu için otomatik kontroller + insana kalibre edilmiş LLM-as-judge + örneklenmiş insan denetimi |
STEP-V hangi durumlarda başarısız olabilir?
Yazar STEP-V'yi değerlendirme hatasına karşı garanti olarak sunmamaktadır. Çerçevenin özellikle dört durumda problemi çözemeyeceği belirtilmektedir: ölçülecek yapı kötü tanımlanmışsa, mevcut değerlendiricilerin tamamı aynı sistematik önyargıyı taşıyorsa, yüksek riskli görevde asgari uzman gözetimi yoksa veya anlamlı değerlendirici anlaşmazlığı tek bir konsensüs puanına yanlış biçimde indirgeniyorsa.
Bu durumda sorun protokol seçiminin ötesindedir. STEP-V karar alanını düzenleyebilir ancak geçersiz bir yapı tanımını, yetersiz değerlendirici havuzunu veya belirsizliği gizleyen bir ölçüm sistemini kendiliğinden düzeltemez.
Metodolojik öneriler
Makale insan merkezli LLM değerlendirmesi için hedef ölçütlerin açık operasyonel tanımlarla başlamasını önerir. Tanımlar, temsil edici örnekler ve sınır durumlarının nasıl ele alınacağı önceden belirtilmelidir.
Değerlendirici seçimi hedef yapıyla gerekçelendirilmelidir. Sıra etkisi ve diğer bilinen önyargıları azaltmak için körleme, randomizasyon, kalibrasyon ve iş yükü yönetimi kullanılmalıdır. Çalışmalar yalnız ortalama puan değil, güvenirlik istatistiği ve belirsizlik bilgisi de raporlamalıdır.
Otomatik metrikler ve LLM tabanlı jüri modelleri hedef görev üzerinde insan yargılarıyla kalibre edilmeden varsayılan olarak geçerli kabul edilmemelidir. Risk düzeyi yükseldikçe LLM-as-judge sistemini kullanabilmek için gereken kanıt standardı da yükselmelidir.
Psikometrik model seçimi
| Veri / protokol | Önerilen model ailesi | Amaç |
|---|---|---|
| Likert veya ordinal rubrik puanları | Hiyerarşik ordinal modeller | Latent kaliteyi rater şiddeti, madde zorluğu ve belirsizlikle birlikte modellemek |
| Çok değerlendiricili yapılandırılmış değerlendirme | Many-facet Rasch modelleri | Model performansını değerlendirici sertliği ve madde zorluğundan ayırmak |
| İkili karşılaştırma | Bradley–Terry veya ilişkili Thurstone modelleri | Göreli kaliteyi ikili tercih verilerinden tahmin etmek |
| Hiçbir değerlendiricinin hatasız kabul edilemediği ortam | Latent-class / imperfect-gold-standard modelleri | Basit çoğunluk oylaması yerine değerlendirici hatasını açık biçimde modellemek |
Minimum raporlama standardı
Yazar, değerlendirme çalışmalarında en azından değerlendirici işe alımı, eğitim, görev talimatları, ölçek biçimi, değerlendirme oturumu süresi, adjudication kuralları, güvenirlik istatistikleri ve belirsizlik raporlamasının görünür olması gerektiğini savunmaktadır.
Örnek rubrikler, kalibrasyon istemleri, denetim checklist'leri ve analiz şablonlarının paylaşılması da yeniden üretilebilirliği güçlendirebilir. Kaynağın Supplementary Materials paketinde bu amaçlarla hazırlanmış beş ek dosya bulunmaktadır.
Çalışmanın desteklediği ve desteklemediği sonuçlar
| Çalışmanın desteklediği | Çalışmanın desteklemediği |
|---|---|
| İnsan değerlendirmesinin kendi güvenirlik, geçerlik ve önyargı sorunları olan bir ölçüm sistemi olarak tasarlanması gerektiği. | İnsan değerlendirmesinin her durumda LLM-as-judge'dan daha doğru olduğunun deneysel olarak kanıtlandığı. |
| LLM-as-judge geçerliğinin görev, yapı ve değerlendirici topluluğuna bağlı olduğu. | Belirli bir jüri modelinin bütün görevlerde kullanılması gerektiği. |
| İnsan–LLM hibrit değerlendirme bazı durumlarda ölçek ve bağlamsal kaliteyi birleştirebilir. | Hibrit sistemlerin otomatik olarak önyargıyı azalttığı. |
| Anlaşmazlık öznel veya kültürel görevlerde anlamlı perspektif farkı taşıyabilir. | Bütün anlaşmazlıkların kabul edilmesi gerektiği; güvenlik-kritik maddelerde adjudication gereksiz olduğu. |
| STEP-V değerlendirme yöntemi seçimini sistematikleştiren bir tasarım desteğidir. | STEP-V'nin deneysel olarak doğrulanmış, hata oranı bilinen veya tek doğru protokolü otomatik hesaplayan bir model olduğu. |
| Yüksek riskte uzman gözetimi ve belirsizlik yönetimi önceliklendirilmelidir. | Kalibre edilmemiş LLM-as-judge sistemlerinin tıp, hukuk, finans veya askerî kullanımda uzmanların yerine geçebileceği. |
Sınırlılıklar ve gelecek araştırma
Makalenin en önemli sınırlılığı, hem STEP-V hem de ortak hata modu taksonomisinin kavramsal olmasıdır. Yazar bu yapıların gerçek değerlendirme tasarımını iyileştirip iyileştirmediğinin, önyargı ve anlaşmazlığı ne ölçüde öngördüğünün ve hibrit sistem performansına ilişkin varsayımların prospektif araştırmalarla sınanması gerektiğini belirtmektedir.
LLM değerlendirme alanının çok hızlı değişmesi, derlemelerin kısa sürede eskime riskini de artırmaktadır. Gelecek çalışmaların değerlendiricilerin zaman içinde LLM'lere alışması, kültürler arası ölçüm değişmezliği, değerlendirici etkilerinin psikometrik modellenmesi, anlaşmazlık-aware pipeline'lar, örneklem ve güç planlaması ve sınırlı uzman zamanının belirsizliğe göre tahsis edilmesi üzerinde yoğunlaşması önerilmektedir.
Makale ayrıca STEP-V'nin ileride yarı nicel bir karar aracına dönüştürülebileceğini tartışmaktadır. Beş boyuta ordinal seviyeler atanması ve bunların geçerlik riski, değerlendiriciler arası güvenirlik riski, ortak önyargı büyütmesi, maliyet ve escalation yükü gibi çıktılarla ilişkilendirilmesi mümkündür. Ancak kaynak bu nicel eşlemeyi henüz gerçekleştirmemektedir; mevcut STEP-V'nin nicel performans tahminleyicisi olarak kullanılması çalışma tarafından desteklenmez.
Kaynak ve Yöntem Notu
| Özgün başlık | Human Evaluation of Large Language Models: A Review and Protocol Selection Framework |
|---|---|
| Yazar | Tad T. Brunyé |
| Kurum 1 | Center for Applied Brain and Cognitive Sciences, Tufts University, Medford, Massachusetts, USA |
| Kurum 2 | U.S. Army DEVCOM Soldier Center, Natick, Massachusetts, USA |
| DOI | 10.3390/ai7050174 |
| Dergi | AI |
| Yayıncı | MDPI, Basel, Switzerland |
| ISSN | 2673-2688 |
| Cilt / sayı | 7 / 5 |
| Makale numarası | 174 |
| Kaynak türü | Review |
| Alınma tarihi | 7 Nisan 2026 |
| Revizyon | 30 Nisan 2026 |
| Kabul | 14 Mayıs 2026 |
| Yayın | 19 Mayıs 2026 |
| Hakemlik | Hakemli dergi yayını |
| Lisans | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Finansman | U.S. Army DEVCOM Soldier Center, Augmented Decisions via Intelligent Systems Recommendations (ADVISR) programı, BC1/3D |
| Institutional Review Board | Uygulanamaz |
| Bilgilendirilmiş onam | Uygulanamaz |
| Veri erişilebilirliği | Uygulanamaz |
| Çıkar çatışması | Yazar çıkar çatışması olmadığını bildirmiştir. |
| Supplementary Materials | File S1–S5 mevcut |
Supplementary Materials içeriği: File S1 Illustrative Scoring Rubrics; File S2 Example Calibration Prompts; File S3 Example Reporting Template; File S4 Example Audit Checklist; File S5 STEP-V Illustrative Configurations.
Finansman ve kurumsal görüş sınırı: Çalışma U.S. Army DEVCOM Soldier Center bünyesindeki ADVISR programı tarafından desteklenmiştir. Makalede görüş ve iddiaların yazarın kişisel görüşleri olduğu ve United States Army veya ilgili devlet kurumlarının resmî politika veya görüşünü temsil etmediği açıkça belirtilmektedir.
Yazar katkıları: Kaynak tek yazarlıdır ve ayrı bir CRediT katkı tablosu raporlamamaktadır. Kaynakta bulunmayan katkı rolleri Verianla tarafından türetilmemiştir.
Derleme yöntemi sınırı: Makale geniş bir literatür sentezi yapmaktadır ancak sistematik arama dizgesi, PRISMA akışı, çalışma seçimi sayıları veya meta-analitik sentez raporlamamaktadır. Bu nedenle “sistematik derleme” olarak sınıflandırılmamıştır.
STEP-V doğrulama sınırı: STEP-V ve hata modu taksonomisi kavramsal çerçevelerdir. Kaynak bunların gelecekte prospektif olarak sınanması gerektiğini belirtmektedir; çerçevelere ait doğruluk oranı, duyarlılık, özgüllük, güven aralığı veya deneysel başarı puanı raporlanmamaktadır.
Görsel kaynak notu: Sayfa 10'daki özgün STEP-V şekli düşük, orta ve yüksek risk uygulamalarında değerlendirici seçimi, geliştirme/doğrulama/izleme yöntemleri ve escalation mantığını gösteren bir karar yardımcısıdır. Verianla için yeniden çizilecekse piksel kopyası yerine aynı bilimsel ilişkileri koruyan özgün karar akışı kullanılmalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir