

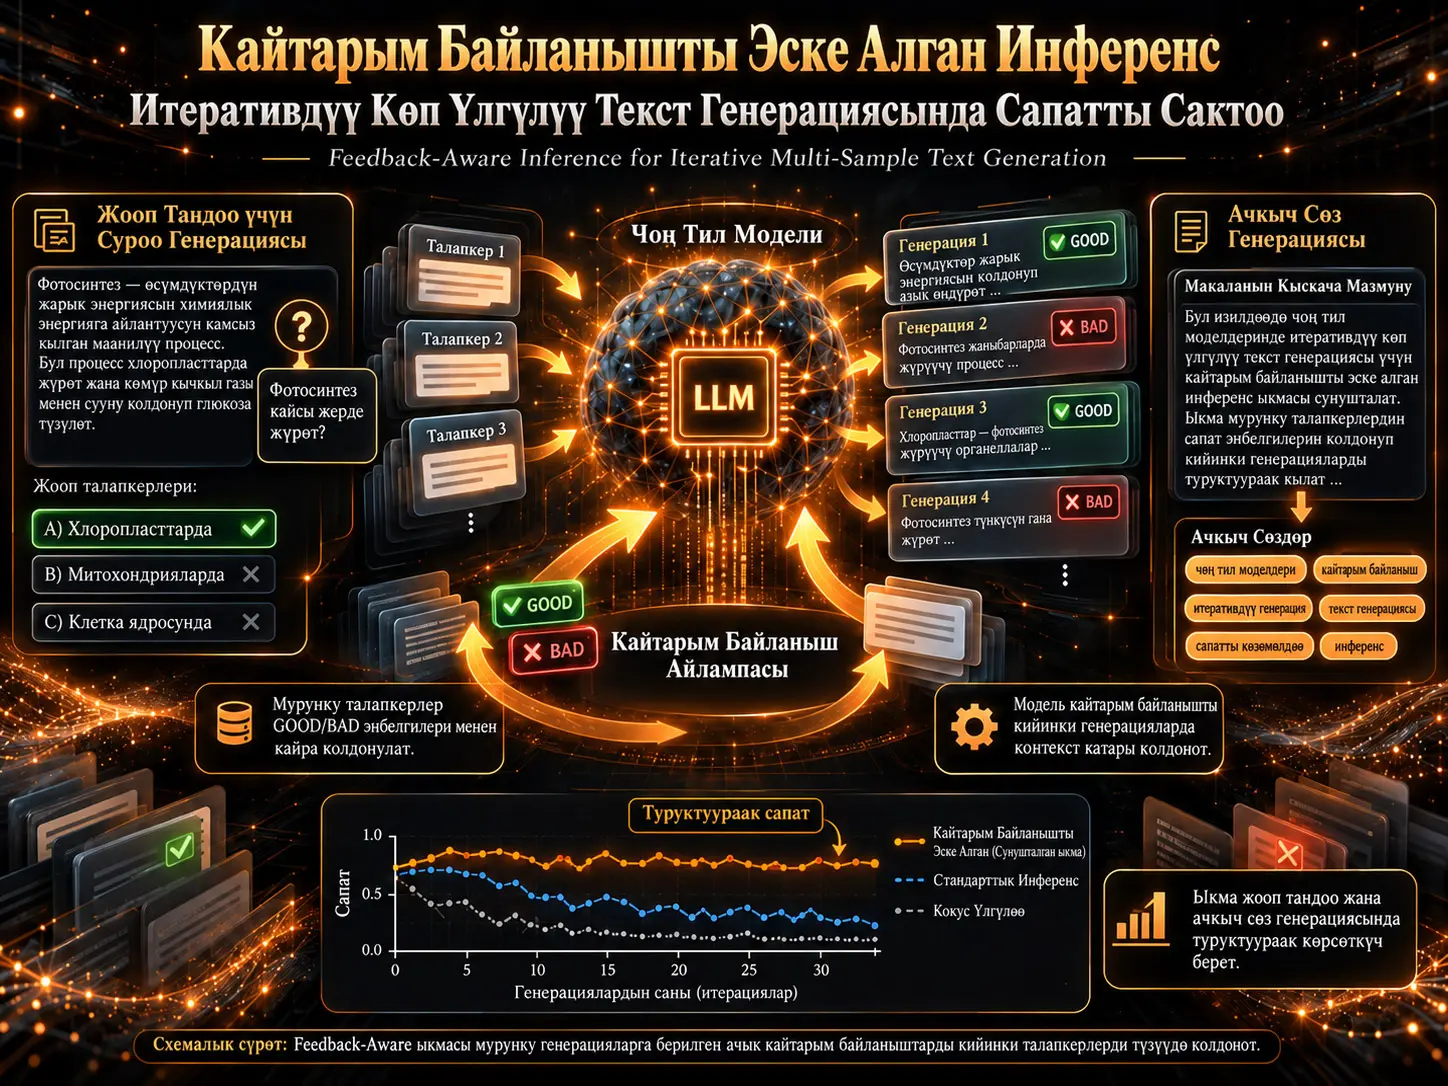
Кайтарым Байланышты Эске Алган Инференс (Feedback-Aware Inference, FA), тил модели бир эле контекст үчүн бир нече тексттик талапкерди түзүп жатканда мурунку талапкерлерге берилген ачык сапат энбелгилерин жаңы генерациялардын контекстине кошуу аркылуу итеративдүү жакшыртууну жүргүзүүгө мүмкүндүк берген инференс алкагы. Изилдөөдө базалык модель катары Llama-3 8B колдонулуп, моделдер LoRA менен fine-tune кылынган жана ыкма эки башка көп-генерациялык тапшырмада сыналган: суроо түзүү үчүн жооп бөлүгүн тандоо жана илимий тексттерден ачкыч сөздөрдү генерациялоо. Feedback-Aware ыкмасы, өзгөчө түзүлгөн үлгүлөрдүн саны көбөйгөн сайын, сапатты Single Sequence Generation, All Sequences Generation, All Sequences Generation with Resulting Content жана изилдөөдө колдонулган GPT-4o baseline'ына салыштырмалуу туруктуураак сактаган. Бул натыйжалар изилденген эки тапшырма, бир гана 8B базалык модель жана колдонулган энбелгилөө системалары үчүн гана көрсөтүлгөн; ыкма бардык генеративдүү тапшырмаларда, бардык модель масштабдарында же бардык feedback түрлөрүндө ушундай эле артыкчылыкты көрсөтөрү азырынча далилденген эмес.
Ыкманын айырмалоочу өзгөчөлүгү feedback'ти жаңы параметр жаңыртуусу катары эмес, кийинки инференс кадамынын prompt тарыхына кошулган структураланган сигнал катары колдонушунда. Модель мурунку генерацияларды жана алардын GOOD же BAD энбелгилерин көрөт; андан соң кийинки талапкер GOOD болушун көздөп жаңы генерация түзөт. Татаал тапшырмаларда Resulting Content Generator (RCG) деп аталган кошумча, милдеттүү эмес модуль колдонулушу мүмкүн. RCG түзүлгөн талапкер пайда кылган кошумча мазмунду жаратат; мисалы, жооп бөлүгүн тандоо тапшырмасында тандалган жооптон суроо түзөт жана энбелгилөө системасы жоопту да, ошол суроону да бирге баалай алат.
Эксперименттерде колдонулган feedback булагы тапшырмага жараша өзгөрөт. Суроо түзүү үчүн жооп тандоодо сапат автоматтык QGen жана QAns моделдери түзгөн баалоо түтүгү аркылуу аныкталат. Ачкыч сөз генерациясында болсо макаланын авторлору KP20K маалыматтар топтомунда тандаган ачкыч сөздөр GOOD үлгүлөрү катары колдонулат; каршы BAD үлгүлөрү окшош, бирок тиешелүү аннотацияда жок ачкыч сөздөрдөн түзүлөт. Ошентип, изилдөө бир эле инференс архитектурасын автоматтык proxy баалоодон да, адамдык курациядан алынган feedback менен да колдонууга болорун көрсөтүүнү көздөйт.
Статистикалык салыштыруулар ыкманын артыкчылыгы өзгөчө көп сандагы талапкерлер түзүлгөндө күчөй турганын көрсөтөт. Суроо-жооп тапшырмасында FA менен SSG ортосундагы айырма кичине K маанилеринде маанилүү эмес, ал эми K=20 жана K=25 болгондо айкын болот. KP20K ачкыч сөз тапшырмасында FAнын SSG жана изилдөөдөгү GPT-4o baseline'ына салыштырмалуу айырмасы отчет берилген бардык K маанилеринде маанилүү; ASG менен айырма K=1 жана K=3'тө маанилүү эмес, ал эми K=5 жана K=10'до маанилүү болуп калат. Бул көрүнүш ыкманын негизги баалуулугу “биринчи үлгүнү сөзсүз эң жакшы түзүүдө” эмес, үлгүлөрдүн саны көбөйгөн сайын сапат менен ар түрдүүлүктү узагыраак сактоодо экенин көрсөтөт.
Кайтарым Байланышты Эске Алган Инференс Деген Эмне?
Кайтарым байланышты эске алган инференс мурунку генерациялардын GOOD/BAD сыяктуу дискреттүү сапат энбелгилерин жана зарыл болсо ошол генерациялардан алынган кошумча мазмунду prompt тарыхына кошуу аркылуу кийинки тексттик талапкерди багыттаган, окутуудан кийинки итеративдүү инференс учурунда иштеген көп үлгүлүү генерация алкагы.
Бир жолку генерациянын көйгөйү
Көптөгөн табигый тилди иштетүү тапшырмаларында бир гана туура жооп болбойт. Тексттен суроо түзүлсө, ар башка бөлүктөр маанилүү суроо-жооп жуптарына айландырылышы мүмкүн; илимий аннотация үчүн да бир нече жарактуу ачкыч сөз тандалышы мүмкүн. Бир гана ырааттуулукту түзүү бул чечим мейкиндигинин аз гана бөлүгүн камтыйт.
Моделден бир эле контекст үчүн көп сандагы көз карандысыз үлгүлөрдү суроо ар түрдүүлүктү көбөйтүшү мүмкүн; бирок модель буга чейин эмне түзгөнүн же кайсы үлгүлөр начар деп кабыл алынганын эске албаса, жаңы үлгүлөрдүн сапаты бара-бара төмөндөп, кайталоолор пайда болуп жана талапкерлер бассейнинин азыраак пайдалуу аймактарына жылышы мүмкүн.
Feedback-Aware ыкмасы көздөгөн маселе дал ушунда: мурунку генерацияларды инференс контекстинин бир бөлүгүнө айлантып, моделге кийинки генерация учурунда кабыл алынган да, четке кагылган да талапкерлерден пайдаланууга мүмкүнчүлүк берүү.
Feedback-Aware ыкмасы RLHF жана DPOдон кандай айырмаланат?
RLHF жана DPO сыяктуу артыкчылык оптималдаштыруу ыкмалары окутуу баскычында модель параметрлерин адамдын же артыкчылык сигналдарына ылайыкташтырууга багытталат. Feedback-Aware Inference болсо тапшырма учурунда пайда болгон feedback'ти түздөн-түз инференс контекстине алып келет.
Бул айырма Feedback-Aware модели таптакыр окутулган эмес дегенди билдирбейт. Модель GOOD/BAD тарыхын кантип чечмелөөнү үйрөнүшү үчүн ушул түзүлүшкө окшош prompt'тар менен fine-tune кылынат. Айырмасы — ар бир жаңы feedback келген сайын параметрлерди кайра оптималдаштыруу талап кылынбайт; жаңы feedback кийинки prompt'ка кошулат.
Ыкма чоң чат моделдеринин эркин формадагы табигый тил сын-пикирлери менен жүргүзгөн self-refinement ыкмасынан да айырмаланат. Бул жердеги feedback узун сын-пикир тексти болушу шарт эмес; эксперименттерде анын эң негизги формасы экилик GOOD/BAD энбелгиси.
Алкактын колдонулушунун үч шарты
Булак Feedback-Aware Inference үчүн үч чектик шартты аныктайт. Тапшырмада үйрөнүүгө боло турган дискреттүү feedback сигналы болушу керек; бул энбелгини чыгара алган адам же автоматтык Labeling System болушу керек; мындан тышкары тапшырма бир эле чыгуудан көрө бир нече ар башка жакшы талапкердин түзүлүшүнөн пайда көрүшү керек.
1-сүрөт: окутуу жана инференс эмне үчүн эки өзүнчө баскыч?
Булак изилдөөнүн 5-бетиндеги 1-сүрөттө эки маалымат агымын бири-биринен ажыратат. Окутуу жагында маалымат контексттеринен талапкер ырааттуулуктар түзүлөт, Labeling System аларга сапат энбелгисин берет жана энбелгиленген үлгүлөр Feedback-Aware Model'ди fine-tune кылуу үчүн колдонулат.
Инференс жагында баштапкы prompt тапшырманын сүрөттөлүшүнөн жана контексттен гана турат. Модель бир талапкер түзөт. Талапкер Labeling System тарабынан бааланат. Энбелги жана талапкер, зарыл болсо RCG түзгөн кошумча мазмун менен бирге тарыхка кошулат. Кийинки генерация бул кеңейтилген контекстти көрөт. Ошентип, инференс бир багыттуу “prompt → жооп” дал келүүсүнөн чыгып, генерация → баалоо → тарыхты жаңыртуу → жаңы генерация циклине айланат.
Labeling System деген эмне?
Labeling System (LS) түзүлгөн \(g\) ырааттуулугу үчүн сапат энбелгисин кайтарган тапшырмага мүнөздүү баалоо компоненти:
\[ LS(g)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
GOOD жана BAD энбелгилеринин илимий мааниси туруктуу эмес. Грамматикалык тууралык, контекстке ылайыктуулук, суроо түзүүгө жарамдуулук, теманы чагылдыруу күчү же башка тапшырмага мүнөздүү критерийлер колдонулушу мүмкүн. Feedback-Aware алкагынын жалпы механизми белгилүү бир сапат метрикасына байланган эмес; бирок анын чыныгы көрсөткүчү колдонулган Labeling System'дин сапатына көз каранды.
Resulting Content Generator эмне кылат?
Айрым тапшырмаларда сапатты аныктоо үчүн түзүлгөн талапкердин өзүн гана кароо жетишсиз. Мындай учурда Resulting Content Generator (RCG) талапкер пайда кылган кошумча чыгууну түзөт жана LS чечимди эки киргизүүгө негиздеп бере алат:
\[ LS\left(g,RCG(g)\right)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
Изилдөөнүн жооп тандоо тапшырмасында \(g\) — тандалган жооп бөлүгү; RCG ролун QGen аткарып, ушул бөлүктөн суроо түзөт. Ошентип, система “бул текст бөлүгү үстүртөн караганда акылга сыярлык көрүнүп жатабы?” деген суроонун ордуна “бул бөлүктөн контекстке негизделген жана жооп берүүгө боло турган суроо түзүлө алабы?” деген суроого жакындайт.
GOOD/BAD Энбелгилери Моделди Инференс Учурунда Кантип Багыттайт?
GOOD/BAD энбелгилери мурунку талапкерлер менен бирге prompt тарыхында сакталат; Feedback-Aware Model жаңы генерация түзүп жатканда кайсы түрдөгү үлгүлөр кабыл алынганын же четке кагылганын контекст ичинде көрүп, кийинки талапкерин ушул тарыхка шарттайт, бирок инференс учурунда модель салмактары кайра жаңыртылбайт.
Окутуу маалыматтарынын түзүлүшү
Баштапкы маалыматтар топтому контексттерден турат:
\[ D_{\mathrm{initial}}=[C_1,C_2,\ldots,C_n]. \]
Ар бир \(C_i\) контексти үчүн бир нече талапкер ырааттуулук:
\[ [g_{i,1},g_{i,2},\ldots,g_{i,m}] \]
жана аларга туура келген сапат энбелгилери:
\[ [LS(g_{i,1}),LS(g_{i,2}),\ldots,LS(g_{i,m})] \]
түзүлөт. Бир эле контекст үчүн GOOD да, BAD да үлгүлөрдүн болушу модель оң үлгүнүн формасын гана жаттап албастан, prompt ичиндеги эки сапат классынын маанисин үйрөнүшү үчүн маанилүү.
Prompt тарыхынын түзүлүшү
Булактын 7-бетиндеги 2-сүрөттө жалпы шаблон тапшырманын сүрөттөлүшүнөн, контексттен жана иреттүү тарыхтан турат. Ар бир тарых сабы сапат энбелгисин жана буга чейин түзүлгөн ырааттуулукту камтыйт; тапшырма талап кылса resulting content да ошол эле сапка кошулат.
Окутуу учурунда жоготуу бүт prompt боюнча эсептелбейт. Модель шаблондун аягындагы максаттуу GOOD ырааттуулуктун token'дерин божомолдоо үчүн гана оптималдаштырылат. Мурунку GOOD/BAD үлгүлөрү жана resulting content болсо шарттоочу контекст милдетин аткарат.
Инференс циклинин логикасы
Булактагы Algorithm 1'дин функционалдык агымын мындайча жыйынтыктоого болот: баштапкы prompt түзүлөт; модель GOOD талапкер түзүүгө аракет кылат; талапкер жана бар болсо resulting content LS тарабынан бааланат; талапкердин GOOD экени же эместиги катталат; андан соң энбелги, талапкер жана кошумча мазмун prompt тарыхына кошулуп жаңы цикл башталат.
Токтотуу шарты алкактын туруктуу бөлүгү эмес. Булак максаттуу сандагы кабыл алынган үлгүлөргө жетүүнү, катары менен белгилүү сандагы BAD натыйжалардын көрүнүшүн же жарактуу талапкерлер бассейнинин түгөнүшүн мүмкүн болгон токтотуу эрежелери катары берет.
Feedback-Aware ыкмасы best-of-Nден эмне үчүн айырмаланат?
Best-of-N ыкмасында туруктуу шарттуу бөлүштүрүүдөн көп сандагы көз карандысыз үлгүлөр түзүлүп, эң жогорку балл алган үлгү тандалат. Feedback-Aware ыкмасында болсо \(t+1\)-генерациянын бөлүштүрүлүшү \(t\)- жана мурунку генерациялардын prompt'ка кайра кошулушунан улам өзгөрүшү мүмкүн. Демек, мурунку талапкер тандоо баскычында гана эмес, кийинки генерацияны шарттоодо да роль ойнойт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Салыштырылган ыкмалар
| Ыкма | Негизги иштөө формасы | Мурунку генерациялардан кабардар болуу |
|---|---|---|
| Feedback-Aware (FA) | Мурунку талапкерлерди GOOD/BAD энбелгилери менен prompt'ка кошуп итеративдүү генерациялоо | Ооба; ачык сапат энбелгиси менен |
| Single Sequence Generation (SSG) | Контексттен бир GOOD талапкер түзүүгө багытталган fine-tuning; инференсте көп үлгүлүү sampling | Жок |
| All Sequences Generation (ASG) | Бир контексттин GOOD ырааттуулуктарын чогуу түзүүгө багытталган fine-tuning | Түзүлгөн тизме түзүмү бар; GOOD/BAD feedback энбелгиси жок |
| ASG-RC | ASG түзүмүнө мурунку resulting content маалыматын кошот | Мазмун тарыхы бар; GOOD/BAD энбелгиси жок |
| GPT-4o | Тапшырма жана бир окутуу үлгүсү бар one-shot prompt менен тизме генерациялоо | Изилдөөдөгү жөндөөдө итеративдүү feedback цикли жок |
Модель жана окутуу жөндөөлөрү
FA, SSG, ASG жана ASG-RC моделдеринин базасы Llama-3 8B. Fine-tuning LoRA аркылуу attention катмарларынын projection матрицаларында жүргүзүлгөн. Бардык негизги эксперименттердин fine-tuning жана inference процесстери бир NVIDIA A100 80 GB GPUда аткарылган.
| Баскыч | Параметр | Маани |
|---|---|---|
| Окутуу | Базалык модель | Llama-3 8B |
| Окутуу | Fine-tuning | LoRA; attention projection матрицалары |
| Окутуу | Optimizer | AdamW-8bit |
| Окутуу | Learning rate | \(1\times10^{-5}\) |
| Окутуу | Batch size | 64; gradient accumulation менен |
| Окутуу | Precision | FP16 |
| QGen/QAns | Precision | BF16 |
| Инференс | Decoding | Nucleus sampling |
| Инференс | Top-k | 20 |
| Инференс | Top-p | 0,8 |
| Баары | Random seed | 42 |
| GPT-4o | Жөндөөлөр | Демейки жөндөөлөр |
FA, ASG жана ASG-RCнин итеративдүү генерациясында ар бир циклде 10 үлгү түзүлүп, эң жогорку log-likelihood маанисине ээ талапкер тандалган. SSG үчүн 100 үлгү түзүлүп, кайталоолор алынып салынган жана эң жогорку 25 талапкер сакталган.
Тапшырма 1: Суроо түзүү үчүн жооп бөлүгүн тандоо
Бул тапшырмада модель берилген тексттен суроо түзүүгө ылайыктуу бир нече жооп бөлүгүн тандайт. Сапатты баалоо үчүн эки көмөкчү модель колдонулат:
| Модель | Милдети |
|---|---|
| QGen | Контексттен жана тандалган жооп бөлүгүнөн суроо түзүү |
| QAns | Түзүлгөн суроого контексттен жооп берүүгө аракет кылуу |
QGen жана QAns SQuAD, HotpotQA жана NarrativeQA үстүндө өз-өзүнчө supervised fine-tuning менен даярдалган; FairytaleQA модель окутуусуна кошулбастан жалпы тест катары колдонулган.
| Маалыматтар топтому | QGen | QAns |
|---|---|---|
| SQuAD | 0,58 | 0,75 |
| HotpotQA | 0,50 | 0,50 |
| NarrativeQA | 0,54 | 0,60 |
| FairytaleQA | 0,51 | 0,45 |
Жооп бөлүгү качан GOOD деп кабыл алынат?
Тандалган \(a\) жообу үчүн адегенде:
\[ q=QGen(ctx,a) \]
аркылуу суроо түзүлөт. Андан кийин QAns моделинин контекст жана суроо берилгенде \(a\) жообун түзүү ыктымалдыгы булакта эмпирикалык түрдө тандалган %3 чектен ашышы керек:
\[ P(QAns(ctx,q)=a)\geq0.03. \]
Бул чек окутуу маалыматтар топтомундагы туура жооп ыктымалдыктарынын бөлүштүрүлүшүнө таянып тандалган.
Экинчи шарт суроонун чындап эле контекстке көз каранды болушун көздөйт. Моделдин жоопту контекстсиз түзүү ыктымалдыгы, контекст берилгендеги ыктымалдыгынан чоң болбошу керек:
\[ \frac{P(QAns("",q)=a)} {P(QAns(ctx,q)=a)} \leq1. \]
Жооп ырааттуулугунун жалпы ыктымалдыгы token log-ыктымалдыктарынын суммасынын экспоненциалдык өзгөртүлүшү менен эсептелет:
\[ P(QAns(ctx,q)=a) = e^{ \sum_i \log P(a_i\mid ctx,q,a_{0:i-1}) }. \]
Бул критерийлер тандалган жооп текстте жөн гана кездешкен туш келди сөз эмес, контекстке таянып маанилүү суроо-жооп жубун түзө алган мазмун болушун көздөйт.
Жооп тандоо маалыматтар топтомдору
| Маалыматтар топтому | Окутуу | Валидация | Тест |
|---|---|---|---|
| TASA | 10.000 | 1.000 | 1.000 |
| FairytaleQA | 8.548 | 1.025 | 1.007 |
TASAнын баштапкы бассейни 60.000'ден ашык үзүндүнү камтыйт. Изилдөөдө тил жана искусство, саламаттык, илим, өнөр жай искусствосу, экономика, бизнес жана коомдук илимдер сыяктуу тармактардан үлгүлөр алынган. FairytaleQA болсо балдарга ылайыктуу баяндардан адистер даярдаган суроо-жооп маалыматтарын камтыйт.
Окутуу үчүн мүмкүн болгон жооп бөлүктөрү ар бир сүйлөмдүн constituency parse дарагындагы түйүндөрдөн алынган. Ар бир талапкер үчүн QGen суроо түзүп, талапкер кийин LS тарабынан GOOD же BAD деп энбелгиленген.
Тапшырма 2: Ачкыч сөз генерациясы
Ачкыч сөз генерациясы KP20K маалыматтар топтомунда бааланган. KP20K болжол менен 500.000 илимий макаланын аннотациясын жана авторлор тандаган ачкыч сөздөрдү камтыйт. Изилдөө бул бассейнден 50.000 окутуу, 2.000 валидация жана 2.000 тест үлгүсүн тандаган.
Авторлор тиешелүү аннотация үчүн белгилеген ачкыч сөздөр GOOD деп кабыл алынган. Маалыматтар топтомунда түз BAD аннотациясы жок болгондуктан терс үлгүлөр жасалма түрдө түзүлгөн. Башка макалаларга таандык, бирок максаттуу аннотация менен embedding мейкиндигинде жогорку окшоштукка ээ, ошол эле учурда максаттуу аннотациянын GOOD тизмесинде жок ачкыч сөздөр тандалган.
Окшоштукту эсептөөдө sentence-transformers/all-mpnet-base-v2 encoder модели колдонулган. Ар бир аннотация үчүн GOOD ачкыч сөздөрдүн санына барабар BAD үлгүлөр тандалып, кыйыныраак жана салыштырма терс үлгүлөрдү түзүүгө аракет жасалган.
Баалоо метрикалары
Жооп тандоо үчүн Precision@K колдонулат:
\[ P@K= \frac{\text{ilk }K\text{ aday içindeki GOOD sayısı}}{K}. \]
Бул жердеги \(K\) алгоритмдин жөндөлүүчү гиперпараметри эмес, баалоо горизонту. Жооп тандоо үчүн натыйжалар \(K=25\)ке чейин отчеттолгон.
Ачкыч сөз генерациясында F1@K колдонулуп, баалоо \(K=10\)го чейин улантылган. Булак KP20Kдеги GOOD ачкыч сөздөрдүн санынын 95-процентилдик мааниси 10 экенин көрсөтүп, бул чекти негиздейт.
K Чоңойгон Сайын Ыкманын Артыкчылыгы Эмне Үчүн Айкыныраак Болот?
Feedback-Aware ыкмасынын артыкчылыгы K чоңойгон сайын айкыныраак болот, анткени модель мурунку GOOD жана BAD генерацияларды көрүп, кайталоолордон жана сапаты төмөн талапкерлерден жакшыраак кача алат, ал эми SSG сыяктуу ыкмалар ар бир жаңы генерацияда мурунку талапкерлерден кабарсыз; ошондуктан биринчи үлгүдө атаандаштыкка жөндөмдүү болгон ыкмалар узун талапкерлер тизмесинде сапатты тезирээк жоготушу мүмкүн.
4-сүрөттүн илимий мааниси
Булактын 4a-сүрөтүндө жооп тандоонун Precision@K ийри сызыктары K өскөн сайын жалпысынан төмөн багытта кетет. Мунун себеби жарактуу жооптор бассейнинин бара-бара түгөнүшү. SSG башында күчтүү, бирок тезирээк төмөндөйт. ASG мурунку тизменин мазмунун көрүү артыкчылыгына ээ болгону менен Feedback-Aware ыкмасынан артта калат. ASG-RC жооп тандоо тапшырмасындагы эң күчтүү baseline'дардын бири; resulting content болгон суроолор моделге кошумча контекст берет, бирок GOOD/BAD сапат сигналы жок болгондуктан FAдай туруктуу эмес.
4b-сүрөттө ачкыч сөздөрдүн F1@K ийри сызыктары адегенде жогорулап, болжол менен орто K маанилеринде чокусуна жетип, андан кийин төмөндөйт. Булактын түшүндүрмөсү боюнча бул форма моделдин жүрүм-турумунун начарлашынан гана келип чыкпайт. Кичине Kде жетиштүү чыныгы ачкыч сөздөр али түзүлбөгөндүктөн recall чектөөчү болот; K чыныгы ачкыч сөздөр бассейнин ашканда кошумча генерациялар BAD класстан келе баштайт жана precision жоготуусу F1'ди төмөн түшүрөт.
FairytaleQA аталышы астында отчеттолгон статистикалык натыйжалар
| K | Baseline | Mean Δ | Holm-түзөтүлгөн p | Булактагы маанилүүлүк |
|---|---|---|---|---|
| 1 | SSG | +0,0005 | \(9.70\times10^{-1}\) | Маанилүү эмес |
| 1 | ASG | +0,0812 | \(8.39\times10^{-8}\) | *** |
| 1 | ASG-RC | +0,0244 | \(1.62\times10^{-1}\) | Маанилүү эмес |
| 1 | GPT-4o | +0,1340 | \(1.49\times10^{-17}\) | *** |
| 10 | SSG | −0,0001 | \(9.44\times10^{-1}\) | Маанилүү эмес |
| 10 | ASG | +0,0496 | \(1.19\times10^{-34}\) | *** |
| 10 | ASG-RC | +0,0125 | \(1.74\times10^{-3}\) | ** |
| 10 | GPT-4o | +0,2520 | \(1.44\times10^{-192}\) | *** |
| 20 | SSG | +0,0517 | \(5.85\times10^{-71}\) | *** |
| 20 | ASG | +0,0633 | \(1.52\times10^{-96}\) | *** |
| 20 | ASG-RC | +0,0376 | \(4.52\times10^{-43}\) | *** |
| 20 | GPT-4o | +0,2841 | \(2.76\times10^{-271}\) | *** |
| 25 | SSG | +0,1104 | \(1.04\times10^{-227}\) | *** |
| 25 | ASG | +0,0632 | \(2.55\times10^{-105}\) | *** |
| 25 | ASG-RC | +0,0529 | \(4.20\times10^{-88}\) | *** |
| 25 | GPT-4o | +0,2828 | \(3.18\times10^{-292}\) | *** |
Статистикалык тесттин негизги билдирүүсү — SSG K=1 жана K=10'до FA менен иш жүзүндө бирдей деңгээлде боло алганы менен, K=20 жана K=25'те айкын артта калат. Бул натыйжа “FA биринчи түзүлгөн үлгүдө дайыма жакшыраак” деген дооматты колдобойт; “көп генерация узарган сайын FA сапатты жакшыраак сактайт” деген дооматты колдойт.
KP20K ачкыч сөз генерациясындагы статистикалык натыйжалар
| K | Baseline | Mean Δ | Holm-түзөтүлгөн p | Булактагы маанилүүлүк |
|---|---|---|---|---|
| 1 | SSG | +0,0651 | \(2.76\times10^{-6}\) | *** |
| 1 | ASG | −0,0160 | \(2.59\times10^{-1}\) | Маанилүү эмес |
| 1 | GPT-4o | +0,1431 | \(1.41\times10^{-20}\) | *** |
| 3 | SSG | +0,0607 | \(2.90\times10^{-22}\) | *** |
| 3 | ASG | +0,0118 | \(9.45\times10^{-2}\) | Маанилүү эмес |
| 3 | GPT-4o | +0,1612 | \(1.12\times10^{-86}\) | *** |
| 5 | SSG | +0,0435 | \(6.47\times10^{-24}\) | *** |
| 5 | ASG | +0,0218 | \(1.33\times10^{-5}\) | *** |
| 5 | GPT-4o | +0,1309 | \(1.99\times10^{-107}\) | *** |
| 10 | SSG | +0,0351 | \(6.94\times10^{-46}\) | *** |
| 10 | ASG | +0,0262 | \(4.69\times10^{-16}\) | *** |
| 10 | GPT-4o | +0,0764 | \(7.48\times10^{-104}\) | *** |
Бул жерде ASG K=1'де FAга караганда сан жагынан бир аз жогору F1 берген; Mean Δнын −0,0160 болушу муну көрсөтөт жана айырма статистикалык жактан маанилүү эмес. K=3'тө FAнын пайдасына болгон кичине айырма да маанилүү эмес. FAнын ASGге салыштырмалуу статистикалык артыкчылыгы K=5 жана K=10'до пайда болот.
Статистикалык ыкма
Негизги процедура бир эле контексттеги ыкма натыйжаларын жупташтырган эки тараптуу Wilcoxon signed-rank тести. Булак Precision@K жана F1@K [0,1] аралыгында чектелген жана өзгөчө кичине Kде дискреттүү/non-normal мүнөз көрсөткөнү үчүн ушул тестти тандаган.
Ар бир K ичинде көп салыштыруулар үчүн Holm–Bonferroni түзөтүүсү менен үй-бүлөлүк ката деңгээли \(\alpha=0.05\) катары көзөмөлдөнгөн. Мындан тышкары paired t-test жана орточо айырма боюнча 10.000 кайра тандоодон турган paired bootstrap колдонулган; булак бардык K маанилеринде негизги Wilcoxon натыйжасы менен бирдей статистикалык чечмелөөгө жеткенин билдирген.
Сапаттык мисалдар эмнени көрсөтөт?
Булактагы 5-таблица жооп тандоо тапшырмасында Feedback-Aware модели биринчи беш генерацияда “happy”, “vivid”, “lion” жана “personification” сыяктуу ар башка семантикалык багыттарга тиешелүү төрт GOOD жооп түзө алганын, бешинчи талапкер гана BAD болгон мисалды берет. Ошол эле контекстте айрым baseline'дар сапаты төмөн же бири-бирине окшош талапкерлерге тезирээк өтөт.
6-таблицадагы ачкыч сөз мисалында FA ирети менен “productivity”, “knowledge workers”, “performance indicators”, “experts” жана “management” түзөт; алардын үчүнчүсү булак энбелгилери боюнча BAD, калган төртөө GOOD. Baseline'дарда кийинки генерацияларда тиешеси жок же кайталоочу талапкерлер көбүрөөк кездешери мисал менен көрсөтүлөт.
Булак сапаттык таблицаларда REPEATED энбелгисин семантикалык жактан мурда түзүлгөн талапкерге эквиваленттүү генерацияны көрүнүктүү кылуу үчүн колдонгон. Бул энбелги сандык баалоодо жаңы сапат классы эмес; так кайталоолор метрика эсептелерден мурун алынып салынат.
ORPO alignment эксперименти
GOOD жана BAD үлгүлөрдүн болушу изилдөөчүлөрдү preference alignment ыкмасы ORPOну өзүнчө сынап көрүүгө түрткөн. ORPO тандалган жана четке кагылган жооптордун ортосунда odds-ratio негизиндеги жаза колдонот. Экспериментте:
\[ \beta=0.3 \]
деп жөндөлүп, башка окутуу шарттары supervised fine-tuning тартиби менен бирдей сакталган.
Булактагы Figure 5'ке ылайык Feedback-Aware моделинин ORPO версиясы менен стандарттуу SFT версиясы окшош жүрүм-турум көрсөтөт. SSGде ORPO жооп тандоонун алгачкы үлгүлөрүндө пайда бере алганы менен K чоңойгон сайын precision кескин төмөндөйт. Ачкыч сөз тапшырмасында SSG-ORPO башынан эле төмөн көрсөткүч берген.
Авторлордун түшүндүрмөсү боюнча экилик артыкчылык оптималдаштыруу талапкерлер мейкиндигин GOOD/BAD огу боюнча катуураак поляризациялап, бул ар түрдүүлүк талап кылган көп үлгүлүү генерацияда кемчилик жаратышы мүмкүн. Бул эксперимент ORPO жалпы эле начар alignment ыкмасы экенин көрсөтпөйт; изилденген көп-генерациялык тапшырмалардагы жүрүм-турумун гана көрсөтөт.
Ката режимдери
Булак үч негизги ката механизмин баса белгилейт. Биринчиден, Labeling System алсыз же системалуу түрдө бир жактуу болсо, туура эмес энбелгилер кийинки prompt'ка кошулгандыктан ката оңдолбой, тескерисинче итерациялар бою күчөшү мүмкүн.
Экинчиден, ар бир генерация жана энбелги prompt тарыхына кошулгандыктан контексттин узундугу итерациялардын саны менен өсөт. Бул context saturation тобокелдигин жана инференс чыгымын жогорулатат.
Үчүнчүдөн, белгилүү бир контекст үчүн чындап жакшы талапкерлердин саны чектелүү болсо, модель бир учурда GOOD бассейнин түгөтөт. Ошондуктан эң жакшы ыкмада да жогорку K маанилеринде метриканын төмөндөшүн толук жок кылуу мүмкүн эмес.
Изилдөөнүн методологиялык чектөөлөрү
Гиперпараметр издөө эсептөө чыгымынан улам атайын чектелген. Салыштыруунун адилеттүүлүгү үчүн негизги модель жана baseline'дарда жалпы окутуу/decoding жөндөөлөрү колдонулганы менен, ар бир ыкманын өзүнүн оптималдуу жөндөөсү изилденген эмес.
Framework окутуу үчүн терс үлгүлөрдү талап кылат. KP20K сыяктуу оң аннотациялары гана бар маалыматтар топтомдорунда BAD үлгүлөрдү өзүнчө түзүү керек; эгер терс үлгүлөр өтө жеңил тандалса, модель GOOD/BAD айырмасын үстүртөн үйрөнүшү мүмкүн.
Көрсөткүч Labeling Systemдин сапатына көз каранды. Изилдөөдөгү FairytaleQA байкоосу орточо деңгээлдеги энбелгилөө катасына белгилүү туруктуулук бар экенин көрсөткөнү менен, көзөмөлдөнүп көбөйтүлгөн ызы-чуу деңгээлдери менен системалуу robustness эксперименти жүргүзүлгөн эмес.
Итеративдүү процесс бир өтмө моделдерге салыштырмалуу кошумча инференс чыгымын жаратат: көбүрөөк generation чакыруусу, Labeling System чакыруусу жана итерация менен сызыктуу өсүүчү prompt тарыхы бар. Макала өндүрүш чөйрөсү үчүн wall-clock latency, throughput жана GPU эс тутум профилдерин деталдуу benchmark катары берген эмес.
Эксперименттик feedback binary GOOD/BAD формасында гана. Framework байыраак энбелги түзүмүн концептуалдык жактан колдогону менен, даражалуу же көп өлчөмдүү feedback экспериментте сыналган эмес.
Акырында, бардык негизги fine-tuning эксперименттери бир гана 8B базалык модель үстүндө жүргүзүлгөн. Натыйжаларды кыйла кичине, кыйла чоң же башка архитектуралык үй-бүлөлөргө түздөн-түз жалпылоого болору азырынча көрсөтүлгөн эмес.
Изилдөө колдогон жыйынтыктар
Изилдөө туура fine-tune кылынган 8B масштабындагы ачык булактуу модель ачык GOOD/BAD feedback тарыхын инференс prompt'унда колдонуп, изилденген эки көп текст генерациясы тапшырмасында сапатты итерациялар бою күчтүү baseline'дарга караганда туруктуураак сактай аларын колдойт.
Статистикалык натыйжалар өзгөчө жогорку K режиминде айырмалар Feedback-Aware ыкмасынын пайдасына чоңоёрун колдойт. Бул натыйжа билим берүү технологияларындагы көп сандагы суроо талапкерлер, кеңири баалоо пункттарынын бассейндери же кийин чыпкалана турган ачкыч сөз талапкерлер сыяктуу oversampling сценарийлерине шайкеш келет.
Изилдөө ошондой эле feedback булагы бир гана механизмге байланбаганын көрсөткөн эки мисал берет: жооп тандоо үчүн автоматтык proxy моделдер жана ачкыч сөз генерациясы үчүн адам тарабынан курацияланган аннотациялар.
Изилдөө колдобогон жыйынтыктар
Изилдөө Feedback-Aware ыкмасы бардык NLP тапшырмаларында бардык чоң моделдерден жогору экенин көрсөтпөйт. Эки гана тапшырма жана бир негизги 8B модель үй-бүлөсү бааланган.
GPT-4o baseline'ынын төмөн көрсөткүчү GPT-4oнун жалпы модель мүмкүнчүлүгү Llama-3 8Bден төмөн экенин көрсөтпөйт. Экспериментте GPT-4o one-shot prompting менен колдонулган, башка негизги моделдер болсо тапшырмага мүнөздүү fine-tuning алган; демек натыйжа ушул эксперимент протоколуна гана тиешелүү.
Изилдөө feedback ар дайым каталарды оңдой турганын да көрсөтпөйт. Туура эмес же бир жактуу LS сигналы ошол эле feedback цикли ичинде катаны кийинки генерацияларга өткөрүп жибериши мүмкүн.
“Кичирээк моделдер чоң proprietary LLMдердин бардык iterative reasoning мүмкүнчүлүктөрүн бирдей деңгээлде камсыздай алат” деген жыйынтык да булак тарабынан далилденген эмес. Көрсөтүлгөн нерсе — изилденген эки көп-генерациялык тапшырмада структураланган feedback механизми 8B моделде пайдалуу болгон.
Булактагы отчет берүү белгисиздиктери
TASA тест бөлүгү 1000 жана FairytaleQA тест бөлүгү 1007 үлгү деп берилгенине карабастан, статистикалык 3-таблица “FairytaleQA, n=2007” деп энбелгиленген. 2007 саны эки тест бөлүгүнүн суммасына барабар; бирок булак бул бириктирилген анализ экенин ачык айтпагандыктан, бул жерде дал келбестик гана көрүнүктүү түрдө сакталган.
KP20Kде 2000 тест үлгүсү тандалганы айтылганы менен, 4-таблица статистикалык салыштырууну n=1998 контекст үстүндө отчеттойт. Эки үлгүнүн эмне үчүн анализге кирбей калганы булакта түшүндүрүлгөн эмес.
Keyword Generation бөлүмү KP20K колдонгону ачык көрсөтүлгөнүнө карабастан, 6-таблицадагы мисал контекстинин аягында “FairytaleQA dataset entry [15]” деген булак сөз айкашы бар. Verianla бул булакты унчукпай KP20K деп өзгөртпөйт.
Келечектеги изилдөө багыттары
Авторлор framework'ти кеңири генеративдүү тапшырмаларда, ар башка модель масштабдарында жана ар башка архитектураларда сыноону сунушташат. Айрыкча синтетикалык түрдө бузулган Labeling Systemдер менен көзөмөлдөнгөн feedback-noise эксперименттери моделдин туура эмес feedbackке туруктуулугун түздөн-түз өлчөй алат.
Өндүрүш чөйрөсүнө багытталган wall-clock latency, throughput жана GPU эс тутум өлчөөлөрү да келечектеги маанилүү муктаждыктардын бири; анткени итеративдүү feedback циклинин сапат артыкчылыгы кошумча inference чыгымы менен бирге бааланууга тийиш.
Binary GOOD/BAD энбелгисинен тышкары даражалуу баллдар же ар башка сапат өлчөмдөрүн өз-өзүнчө билдирген көп өлчөмдүү feedback түзүмдөрү да изилдениши мүмкүн.
Булак акырында математикалык маселе чыгаруу, логикалык инференс же илимий түшүндүрмө сыяктуу көп баскычтуу reasoning тапшырмаларында аралык кадамдарга feedback колдонуу мүмкүн болгон кеңейтүү багыты экенин сунуштайт. Бул колдонуу изилдөөдө эксперименттик түрдө ырасталган эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Оригиналдуу изилдөө: Feedback-Aware Inference for Iterative Multi-Sample Text Generation
Авторлор: Andreea Dutulescu; Stefan Ruseti; Mihai Dascalu; Danielle S. McNamara.
Жооптуу автор: Stefan Ruseti.
Мекемелер: Computer Science and Engineering Department, National University of Science and Technology POLITEHNICA Bucharest, Румыния; Academy of Romanian Scientists, Румыния; Learning Engineering Institute, Arizona State University, АКШ.
Журнал: AI.
Басмакана: MDPI.
Булак түрү: Рецензияланган оригиналдуу изилдөө макаласы; табигый тилди иштетүү, тил моделин fine-tuning кылуу жана итеративдүү инференс эксперименттери.
Жарыялоо маалыматы: AI 2026, том 7, сан 5, макала 171.
DOI: 10.3390/ai7050171
Жөнөтүлгөн: 1 апрель 2026.
Ревизия: 8 май 2026.
Кабыл алынган: 12 май 2026.
Жарыяланган: 15 май 2026.
Лицензия: Creative Commons Attribution (CC BY), ачык жеткиликтүүлүк.
Каржылоо: Изилдөө Romanian Hub for Artificial Intelligence—HRIA долбоору, Smart Growth, Digitization and Financial Instruments Program 2021–2027 алкагында MySMIS no. 351416; U.S. Department of Education Institute of Education Sciences тарабынан Arizona State Universityге берилген R305T240035 номерлүү грант жана Academy of Romanian Scientists AOSR-TEAMS-IV Edition 2025–2026 “Digital Transformation in Science” гранты менен колдоого алынган.
Институционалдык этика комитети: Колдонулбайт.
Маалымдалган макулдук: Колдонулбайт.
Маалыматтарга, кодго жана моделге жетүү: Авторлор изилдөөнүн маалыматтарын, кодун жана fine-tune кылынган моделдерин ачык GitHub репозиторийинде жарыялаганын билдиришет.
Генеративдүү AI колдонуу жөнүндө билдирүү: Авторлор макаланы даярдоодо генеративдүү жасалма интеллект орфографияны текшерүү жана грамматика максатында гана колдонулганын; чыгарылган натыйжа өздөрү тарабынан каралып, редакцияланганын жана мазмун үчүн жоопкерчиликти өздөрүнө алышарын билдиришет.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришет. Каржылоочулардын изилдөө дизайнында, маалымат чогултуу/анализ/чечмелөөдө, макаланы жазууда же жарыялоо чечиминде ролу болбогону айтылган.
Авторлордун салымы: Концептуалдаштыруу Andreea Dutulescu, Stefan Ruseti жана Mihai Dascalu; методология Andreea Dutulescu жана Stefan Ruseti; программалык камсыздоо, формалдуу анализ, изилдөө, ресурстар, маалыматтарды курациялоо, алгачкы долбоор жана визуалдаштыруу Andreea Dutulescu; валидация Andreea Dutulescu, Stefan Ruseti жана Mihai Dascalu; карап чыгуу жана редакциялоо төрт автордун баары; көзөмөл Stefan Ruseti, Mihai Dascalu жана Danielle S. McNamara; долбоорду башкаруу Mihai Dascalu; каржылоону алуу Stefan Ruseti, Mihai Dascalu жана Danielle S. McNamara тарабынан жүргүзүлгөн.
Негизги методологиялык чектөөлөр: Эки гана тапшырма бааланган; бир 8B базалык модель колдонулган; гиперпараметр издөө чектелген; терс үлгүлөргө талап бар; энбелгилөө системасынын каталары feedback циклинде жайылышы мүмкүн; inference чыгымы бир өтмө ыкмалардан жогору; binary feedbackтен башка түзүмдөр сыналган эмес; өндүрүш чөйрөсүнүн latency/throughput/GPU эс тутум benchmark'тары берилген эмес.
Булак ичиндеги отчет эскертүүсү: FairytaleQA тест саны менен 3-таблицадагы n=2007 энбелгиси, KP20K тест саны менен 4-таблицадагы n=1998 мааниси жана 6-таблицадагы FairytaleQA булак энбелгиси ортосунда түшүндүрүлбөгөн дал келбестиктер бар. Бул пункттар Verianla тарабынан унчукпай оңдолгон эмес.
Verianla ыкма эскертүүсү: Бул мазмун булак макаланын сүйлөм-сүйлөм котормосу же абзац-абзац жакын кайра жазылышы эмес. Изилдөө маселеси, Feedback-Aware training/inference түзүмү, GOOD/BAD feedback системасы, QGen/QAns баалоо логикасы, маалыматтар топтомдору, модель жөндөөлөрү, P@K жана F1@K натыйжалары, статистикалык тесттер, сапаттык анализ, ORPO эксперименти, чектөөлөр жана келечектеги изилдөө сунуштары сакталып, өз алдынча кыргыз тилиндеги илимий окуу түзүмү түзүлгөн.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген