

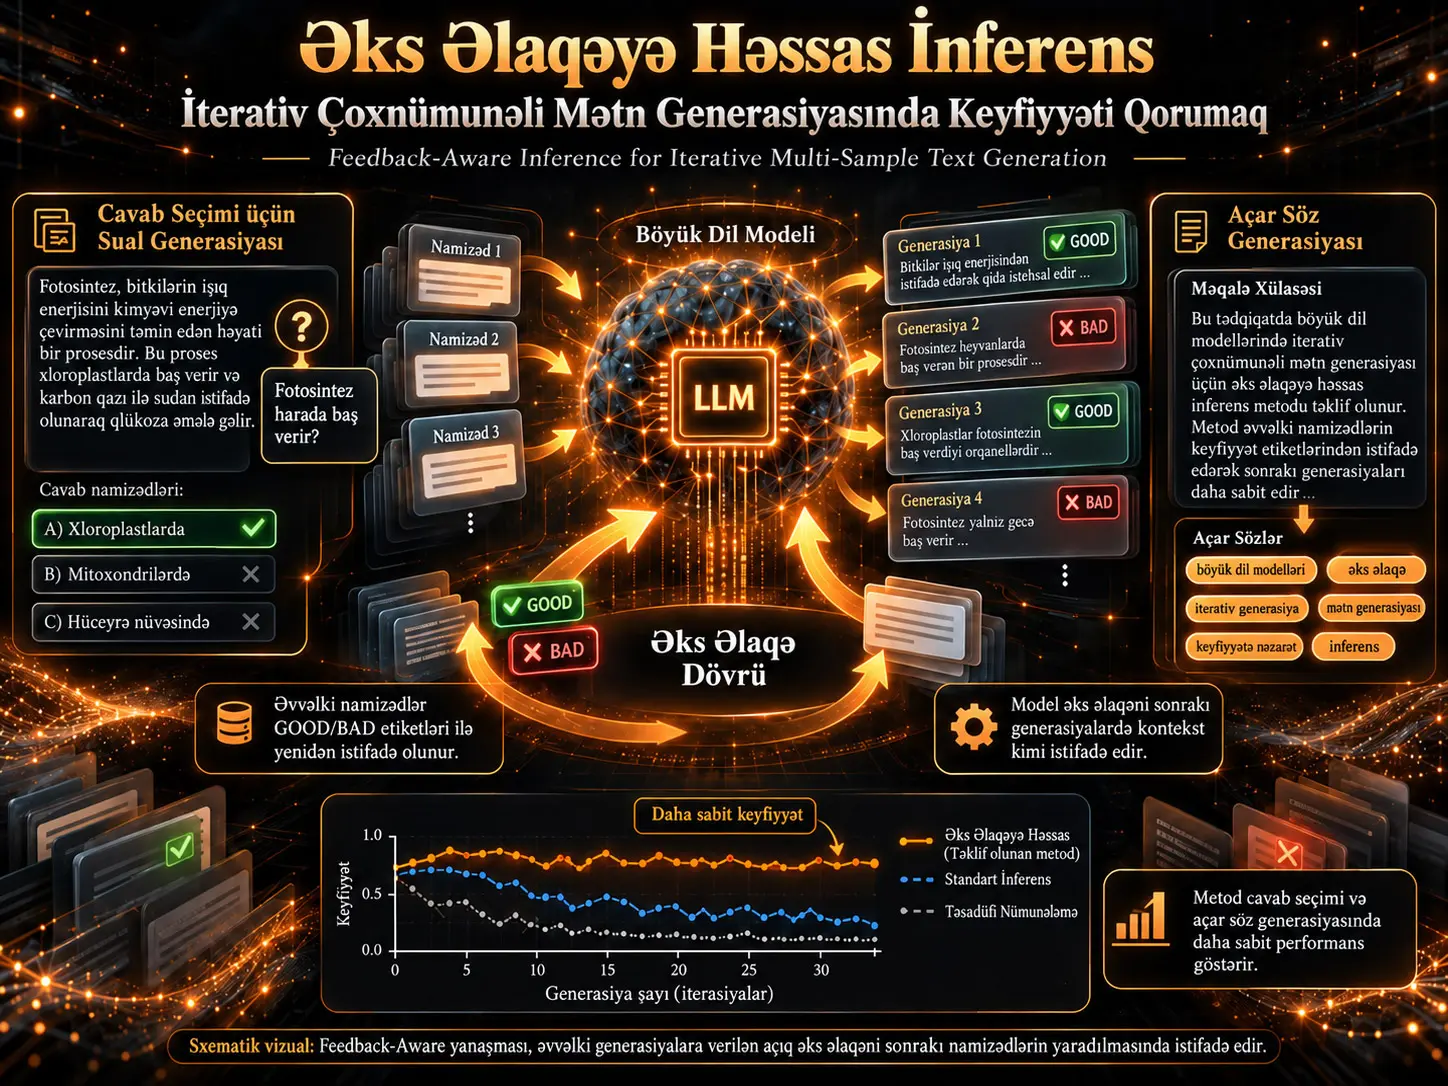
Əks Əlaqəyə Həssas İnferens (Feedback-Aware Inference, FA), dil modelinin eyni kontekst üçün bir neçə mətn namizədi yaradarkən əvvəlki namizədlərə verilmiş açıq keyfiyyət etiketlərini yeni generasiyaların kontekstinə əlavə etməklə iterativ təkmilləşdirmə aparmasına imkan verən inferens çərçivəsidir. Tədqiqatda baza model kimi Llama-3 8B istifadə edilmiş, modellər LoRA ilə fine-tune edilmiş və üsul iki müxtəlif çoxlu-generasiya tapşırığında sınaqdan keçirilmişdir: sual generasiyası üçün cavab fraqmentinin seçilməsi və elmi mətnlərdən açar sözlərin generasiyası. Feedback-Aware yanaşması, xüsusən yaradılan nümunələrin sayı artdıqca, keyfiyyəti Single Sequence Generation, All Sequences Generation, All Sequences Generation with Resulting Content və tədqiqatda istifadə olunan GPT-4o baseline-ı ilə müqayisədə daha sabit qorumuşdur. Bu nəticələr yalnız araşdırılan iki tapşırıq, tək 8B baza model və istifadə olunan etiketləmə sistemləri üçün göstərilmişdir; üsulun bütün generativ tapşırıqlarda, bütün model miqyaslarında və ya bütün feedback növlərində eyni üstünlüyü göstərəcəyi hələ sübut edilməmişdir.
Üsulun fərqləndirici xüsusiyyəti feedback-i yeni parametr yeniləməsi kimi deyil, növbəti inferens addımının prompt tarixçəsinə əlavə edilən strukturlaşdırılmış siqnal kimi istifadə etməsidir. Model əvvəlki generasiyaları və onların GOOD və ya BAD etiketlərini görür; sonra növbəti namizədin GOOD olması məqsədilə yeni generasiya yaradır. Mürəkkəb tapşırıqlarda əlavə olaraq Resulting Content Generator (RCG) adlı ixtiyari modul istifadə edilə bilər. RCG yaradılan namizədin ortaya çıxardığı əlavə məzmunu yaradır; məsələn, cavab fraqmentinin seçilməsi tapşırığında seçilmiş cavabdan sual yaradır və etiketləmə sistemi həm cavabı, həm də həmin sualı birlikdə qiymətləndirə bilər.
Eksperimentlərdə istifadə olunan feedback mənbəyi tapşırıqdan tapşırığa dəyişir. Sual generasiyası üçün cavab seçilməsində keyfiyyət avtomatik QGen və QAns modellərinin yaratdığı qiymətləndirmə xətti ilə müəyyən edilir. Açar söz generasiyasında isə məqalə müəlliflərinin KP20K verilənlər dəstində seçdiyi açar sözlər GOOD nümunələri kimi istifadə olunur; qarşı BAD nümunələri oxşar, lakin müvafiq xülasə üçün annotasiyada olmayan açar sözlərdən yaradılır. Beləliklə, tədqiqat eyni inferens arxitekturasının həm avtomatik proxy qiymətləndirməsindən, həm də insan kurasiyasından törəyən feedback-lə istifadə edilə biləcəyini göstərməyi hədəfləyir.
Statistik müqayisələr üsulun üstünlüyünün xüsusən çox sayda namizəd yaradıldıqda gücləndiyini göstərir. Sual-cavab tapşırığında FA ilə SSG arasındakı fərq kiçik K qiymətlərində əhəmiyyətli deyil, K=20 və K=25-də isə aydınlaşır. KP20K açar söz tapşırığında FA-nın SSG və tədqiqatdakı GPT-4o baseline-ı ilə müqayisədə fərqi hesabat verilən bütün K qiymətlərində əhəmiyyətlidir; ASG ilə fərq isə K=1 və K=3-də əhəmiyyətli deyil, K=5 və K=10-da əhəmiyyətli olur. Bu nümunə üsulun əsas dəyərinin “ilk nümunəni mütləq ən yaxşı yaratmaqdan” daha çox, nümunələrin sayı artarkən keyfiyyət və müxtəlifliyi daha uzun müddət qorumaq olduğunu göstərir.
Əks Əlaqəyə Həssas İnferens Nədir?
Əks Əlaqəyə Həssas İnferens əvvəlki generasiyaların GOOD/BAD kimi diskret keyfiyyət etiketlərini və lazım gəldikdə həmin generasiyalardan törəyən əlavə məzmunu prompt tarixçəsinə əlavə etməklə növbəti mətn namizədini yönləndirən, təlimdən sonra iterativ inferens zamanı işləyən çoxnümunəli generasiya çərçivəsidir.
Birdəfəlik generasiyanın problemi
Bir çox təbii dil emalı tapşırığının tək bir doğru cavabı yoxdur. Mətndən sual yaradılacaqsa, müxtəlif hissələr mənalı sual-cavab cütlərinə çevrilə bilər; elmi xülasə üçün də bir neçə etibarlı açar söz seçilə bilər. Tək bir ardıcıllığın yaradılması bu həll məkanının yalnız kiçik bir hissəsini əhatə edir.
Modeldən eyni kontekst üçün çox sayda müstəqil nümunə istəmək müxtəlifliyi artıra bilər; lakin model daha əvvəl nə yaratdığını və ya hansı nümunələrin pis qəbul edildiyini nəzərə almırsa, yeni nümunələrin keyfiyyəti tədricən düşə, təkrarlar yarana və namizəd hovuzunun daha az faydalı sahələrinə sürüşə bilər.
Feedback-Aware yanaşmasının hədəflədiyi problem məhz budur: əvvəlki generasiyaları inferens kontekstinin bir hissəsinə çevirərək modelin növbəti generasiya zamanı həm qəbul edilmiş, həm də rədd edilmiş namizədlərdən yararlanmasını təmin etmək.
Feedback-Aware yanaşması RLHF və DPO-dan necə fərqlənir?
RLHF və DPO kimi üstünlük optimallaşdırma üsulları model parametrlərini təlim mərhələsində insan və ya üstünlük siqnallarına uyğunlaşdırmağa yönəlir. Feedback-Aware Inference isə tapşırıq zamanı ortaya çıxan feedback-i birbaşa inferens kontekstinə daşıyır.
Bu fərq Feedback-Aware modelinin ümumiyyətlə təlim almadığı demək deyil. Model GOOD/BAD tarixçəsini necə şərh etməyi öyrənə bilsin deyə bu quruluşa bənzər promptlarla fine-tune edilir. Fərq ondadır ki, hər yeni feedback gəldikdə parametrlərin yenidən optimallaşdırılması tələb olunmur; yeni feedback növbəti prompt-a əlavə edilir.
Üsul həmçinin böyük dialoq modellərinin sərbəst formalı təbii dil tənqidləri ilə həyata keçirdiyi self-refinement yanaşmasından fərqlənir. Buradakı feedback uzun tənqid mətnləri olmaq məcburiyyətində deyil; eksperimentlərdə onun ən əsas forması ikili GOOD/BAD etiketidir.
Çərçivənin üç tətbiqolunma şərti
Mənbə Feedback-Aware Inference üçün üç sərhəd şərti müəyyən edir. Tapşırıqda öyrənilə bilən diskret feedback siqnalı olmalıdır; bu etiketi yarada biləcək insan və ya avtomatik Labeling System mövcud olmalıdır; həmçinin tapşırıq tək bir çıxışdan çox bir neçə fərqli yaxşı namizədin yaradılmasından faydalanmalıdır.
Şəkil 1: təlim və inferens niyə iki ayrı mərhələdir?
Mənbə tədqiqatın 5. səhifəsindəki Şəkil 1 iki verilən axınını bir-birindən ayırır. Təlim tərəfində verilən kontekstlərindən namizəd ardıcıllıqlar yaradılır, Labeling System onlara keyfiyyət etiketi verir və etiketlənmiş nümunələr Feedback-Aware Model-i fine-tune etmək üçün istifadə olunur.
İnferens tərəfində başlanğıc prompt-u yalnız tapşırığın təsvirindən və kontekstdən ibarətdir. Model bir namizəd yaradır. Namizəd Labeling System tərəfindən qiymətləndirilir. Etiket və namizəd, lazım gəldikdə RCG-nin yaratdığı əlavə məzmunla birlikdə tarixçəyə əlavə edilir. Növbəti generasiya bu genişlənmiş konteksti görür. Beləliklə, inferens birtərəfli “prompt → cavab” uyğunluğundan çıxaraq generasiya → qiymətləndirmə → tarixçəni yeniləmə → yeni generasiya dövrünə çevrilir.
Labeling System nədir?
Labeling System (LS) yaradılmış bir \(g\) ardıcıllığı üçün keyfiyyət etiketi qaytaran tapşırıq-xüsusi qiymətləndirmə komponentidir:
\[ LS(g)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
GOOD və BAD etiketlərinin elmi mənası sabit deyil. Qrammatik düzgünlük, kontekstə uyğunluq, sual yaratma imkanı, mövzunu təmsil etmə gücü və ya başqa tapşırıq-xüsusi meyarlar istifadə edilə bilər. Feedback-Aware çərçivəsinin ümumi mexanizmi müəyyən bir keyfiyyət metrikindən asılı deyil; lakin real performansı istifadə olunan Labeling System-in keyfiyyətindən asılıdır.
Resulting Content Generator nə iş görür?
Bəzi tapşırıqlarda yalnız yaradılmış namizədin özünə baxmaq keyfiyyəti müəyyən etmək üçün kifayət deyil. Bu halda Resulting Content Generator (RCG) namizədin doğuracağı əlavə çıxışı yaradır və LS qərarını iki girişə əsasən verə bilər:
\[ LS\left(g,RCG(g)\right)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
Tədqiqatın cavab seçimi tapşırığında \(g\) seçilmiş cavab fraqmentidir; RCG rolunu QGen yerinə yetirir və bu fraqmentdən sual yaradır. Beləliklə, sistem “bu mətn fraqmenti səthi baxımdan ağlabatan görünürmü?” sualından daha çox “bu fraqmentdən kontekstə əsaslanan və cavablandırıla bilən sual yaratmaq mümkündürmü?” sualına yaxınlaşır.
GOOD/BAD Etiketləri Modeli İnferens Zamanı Necə Yönləndirir?
GOOD/BAD etiketləri əvvəlki namizədlərlə birlikdə prompt tarixçəsində saxlanılır; Feedback-Aware Model yeni generasiya yaradarkən hansı növ nümunələrin qəbul və ya rədd edildiyini kontekst daxilində görür və növbəti namizədini bu tarixçəyə şərtləndirir, lakin inferens zamanı model çəkiləri yenidən yenilənmir.
Təlim verilənlərinin quruluşu
Başlanğıc verilənlər dəsti kontekstlərdən ibarətdir:
\[ D_{\mathrm{initial}}=[C_1,C_2,\ldots,C_n]. \]
Hər \(C_i\) konteksti üçün bir neçə namizəd ardıcıllıq:
\[ [g_{i,1},g_{i,2},\ldots,g_{i,m}] \]
və bunlara uyğun keyfiyyət etiketləri:
\[ [LS(g_{i,1}),LS(g_{i,2}),\ldots,LS(g_{i,m})] \]
yaradılır. Eyni kontekst üçün həm GOOD, həm də BAD nümunələrin olması modelin yalnız müsbət nümunə formasını əzbərləməsi əvəzinə prompt daxilində iki keyfiyyət sinfinin mənasını öyrənə bilməsi üçün vacibdir.
Prompt tarixçəsinin quruluşu
Mənbənin 7. səhifəsindəki Şəkil 2-də ümumi şablon tapşırıq təsviri, kontekst və ardıcıl tarixçədən ibarətdir. Hər tarixçə sətri bir keyfiyyət etiketi və daha əvvəl yaradılmış ardıcıllığı ehtiva edir; tapşırıq tələb edərsə resulting content də eyni sətrə əlavə olunur.
Təlim zamanı itki bütün prompt üzrə hesablanmır. Model yalnız şablonun sonundakı hədəf GOOD ardıcıllığının tokenlərini proqnozlaşdırmaq üçün optimallaşdırılır. Əvvəlki GOOD/BAD nümunələri və resulting content isə şərtləndirici kontekst funksiyasını daşıyır.
İnferens dövrünün məntiqi
Mənbə Algorithm 1-in funksional axını belə xülasə edilə bilər: başlanğıc prompt-u yaradılır; model GOOD namizəd yaratmağa çalışır; namizəd və varsa resulting content LS tərəfindən qiymətləndirilir; namizədin GOOD olub-olmadığı qeydə alınır; sonra etiket, namizəd və əlavə məzmun prompt tarixçəsinə əlavə edilərək yeni dövrə başlanır.
Dayandırma şərti çərçivənin sabit hissəsi deyil. Mənbə hədəf sayda qəbul edilmiş nümunəyə çatmağı, ardıcıl müəyyən sayda BAD nəticənin görülməsini və ya etibarlı namizəd hovuzunun tükənməsini mümkün dayandırma qaydaları kimi göstərir.
Feedback-Aware üsulu best-of-N-dən niyə fərqlənir?
Best-of-N yanaşmasında sabit şərti paylanmadan çox sayda müstəqil nümunə yaradılır və ən yüksək ballı nümunə seçilir. Feedback-Aware yanaşmasında isə \(t+1\). generasiyanın paylanması, \(t\). və əvvəlki generasiyaların prompt-a geri əlavə edilməsi səbəbindən dəyişə bilər. Buna görə əvvəlki namizəd yalnız seçim mərhələsində deyil, növbəti generasiyanın şərtləndirilməsində də rol oynayır.
Tədqiqatın Metodu və Nəticələri
Müqayisə edilən üsullar
| Üsul | Əsas iş prinsipi | Əvvəlki generasiyalardan xəbərdarlıq |
|---|---|---|
| Feedback-Aware (FA) | Əvvəlki namizədləri GOOD/BAD etiketləri ilə prompt-a əlavə edərək iterativ generasiya | Bəli; açıq keyfiyyət etiketi ilə |
| Single Sequence Generation (SSG) | Kontekstdən tək GOOD namizəd yaratmağa yönəlmiş fine-tuning; inferensdə çoxlu nümunələmə | Xeyr |
| All Sequences Generation (ASG) | Bir kontekstin GOOD ardıcıllıqlarını birlikdə yaratmağa yönəlmiş fine-tuning | Yaradılmış siyahı quruluşu var; GOOD/BAD feedback etiketi yoxdur |
| ASG-RC | ASG quruluşuna əvvəlki resulting content məlumatını əlavə edir | Məzmun tarixçəsi var; GOOD/BAD etiketi yoxdur |
| GPT-4o | Tapşırıq və tək təlim nümunəsi olan one-shot prompt ilə siyahı generasiyası | Tədqiqatdakı quruluşda iterativ feedback dövrü yoxdur |
Model və təlim parametrləri
FA, SSG, ASG və ASG-RC modellərinin bazası Llama-3 8B-dir. Fine-tuning LoRA ilə attention qatlarının projection matrisləri üzərində aparılmışdır. Bütün əsas eksperimentlərin fine-tuning və inference əməliyyatları tək bir NVIDIA A100 80 GB GPU üzərində həyata keçirilmişdir.
| Mərhələ | Parametr | Dəyər |
|---|---|---|
| Təlim | Baza model | Llama-3 8B |
| Təlim | Fine-tuning | LoRA; attention projection matrisləri |
| Təlim | Optimizer | AdamW-8bit |
| Təlim | Learning rate | \(1\times10^{-5}\) |
| Təlim | Batch size | 64; gradient accumulation ilə |
| Təlim | Precision | FP16 |
| QGen/QAns | Precision | BF16 |
| İnferens | Decoding | Nucleus sampling |
| İnferens | Top-k | 20 |
| İnferens | Top-p | 0,8 |
| Hamısı | Random seed | 42 |
| GPT-4o | Parametrlər | Defolt parametrlər |
FA, ASG və ASG-RC-nin iterativ generasiyasında hər dövrdə 10 nümunə yaradılmış və ən yüksək log-likelihood dəyərinə malik namizəd seçilmişdir. SSG üçün 100 nümunə yaradılmış, təkrarlar çıxarılmış və ən üst 25 namizəd saxlanılmışdır.
Tapşırıq 1: Sual generasiyası üçün cavab fraqmentinin seçilməsi
Bu tapşırıqda model verilmiş mətndən sual yaratmağa yararlı bir neçə cavab fraqmenti seçir. Keyfiyyət qiymətləndirilməsi üçün iki köməkçi model istifadə olunur:
| Model | Tapşırığı |
|---|---|
| QGen | Kontekst və seçilmiş cavab fraqmentindən sual yaratmaq |
| QAns | Yaradılmış sualı kontekstdən cavablandırmağa çalışmaq |
QGen və QAns SQuAD, HotpotQA və NarrativeQA üzərində ayrı-ayrılıqda supervised fine-tuning ilə hazırlanmış; FairytaleQA model təliminə daxil edilmədən ümumi test kimi istifadə olunmuşdur.
| Verilənlər dəsti | QGen | QAns |
|---|---|---|
| SQuAD | 0,58 | 0,75 |
| HotpotQA | 0,50 | 0,50 |
| NarrativeQA | 0,54 | 0,60 |
| FairytaleQA | 0,51 | 0,45 |
Cavab fraqmenti nə vaxt GOOD qəbul edilir?
Seçilmiş \(a\) cavabı üçün əvvəlcə:
\[ q=QGen(ctx,a) \]
ilə sual yaradılır. Sonra QAns modelinin kontekst və sual verildikdə \(a\) cavabını yaratma ehtimalının mənbədə empirik olaraq seçilmiş %3 həddini keçməsi tələb olunur:
\[ P(QAns(ctx,q)=a)\geq0.03. \]
Bu hədd təlim verilənlər dəstində düzgün cavab ehtimallarının paylanmasına əsasən seçilmişdir.
İkinci şərt sualın həqiqətən kontekstdən asılı olmasını təmin etməyi hədəfləyir. Modelin cavabı kontekstsiz yaratma ehtimalı, kontekst verildikdə olan ehtimalından böyük olmamalıdır:
\[ \frac{P(QAns("",q)=a)} {P(QAns(ctx,q)=a)} \leq1. \]
Cavab ardıcıllığının ümumi ehtimalı token log-ehtimallarının cəminin eksponensial çevrilməsi ilə hesablanır:
\[ P(QAns(ctx,q)=a) = e^{ \sum_i \log P(a_i\mid ctx,q,a_{0:i-1}) }. \]
Bu meyarlar seçilmiş cavabın sadəcə mətndə görünən təsadüfi söz deyil, kontekstə əsaslanaraq mənalı sual-cavab cütü yarada bilən məzmun olmasını hədəfləyir.
Cavab seçimi verilənlər dəstləri
| Verilənlər dəsti | Təlim | Validasiya | Test |
|---|---|---|---|
| TASA | 10.000 | 1.000 | 1.000 |
| FairytaleQA | 8.548 | 1.025 | 1.007 |
TASA-nın mənbə hovuzu 60.000-dən çox keçid ehtiva edir. Tədqiqatda dil və incəsənət, səhiyyə, elm, sənaye sənətləri, iqtisadiyyat, biznes və sosial elmlər kimi sahələrdən nümunələr götürülmüşdür. FairytaleQA isə uşaqlara uyğun hekayələrdən mütəxəssislər tərəfindən hazırlanmış sual-cavab məlumatlarını ehtiva edir.
Təlim üçün mümkün cavab fraqmentləri hər cümlənin constituency parse ağacındakı düyünlərdən çıxarılmışdır. Hər namizəd üçün QGen sual yaratmış və namizəd daha sonra LS tərəfindən GOOD və ya BAD kimi etiketlənmişdir.
Tapşırıq 2: Açar söz generasiyası
Açar söz generasiyası KP20K verilənlər dəstində qiymətləndirilmişdir. KP20K təxminən 500.000 elmi məqalə xülasəsi və müəlliflərin seçdiyi açar sözləri ehtiva edir. Tədqiqat bu hovuzdan 50.000 təlim, 2.000 validasiya və 2.000 test nümunəsi seçmişdir.
Müəlliflərin müvafiq xülasə üçün müəyyən etdiyi açar sözlər GOOD qəbul edilmişdir. Verilənlər dəstində birbaşa BAD annotasiyası olmadığından mənfi nümunələr süni şəkildə yaradılmışdır. Başqa məqalələrə aid, lakin hədəf xülasə ilə embedding məkanında yüksək oxşarlıq göstərən, bununla belə hədəf xülasənin GOOD siyahısında olmayan açar sözlər seçilmişdir.
Oxşarlığın hesablanmasında sentence-transformers/all-mpnet-base-v2 encoder modeli istifadə edilmişdir. Hər xülasə üçün GOOD açar sözlərin sayı qədər BAD nümunə seçilərək daha çətin və müqayisəli mənfi nümunələr yaratmağa çalışılmışdır.
Qiymətləndirmə metrikləri
Cavab seçimi üçün Precision@K istifadə olunur:
\[ P@K= \frac{\text{ilk }K\text{ aday içindeki GOOD sayısı}}{K}. \]
Buradakı \(K\) alqoritmin tənzimlənən hiperparametri deyil, qiymətləndirmə üfüqüdür. Cavab seçimi üçün nəticələr \(K=25\)-ə qədər hesabat verilmişdir.
Açar söz generasiyasında F1@K istifadə edilmiş və qiymətləndirmə \(K=10\)-a qədər davam etdirilmişdir. Mənbə KP20K-də GOOD açar söz sayının 95. persentil dəyərinin 10 olduğunu bildirərək bu sərhədi əsaslandırır.
Üsulun Üstünlüyü K Böyüdükcə Niyə Daha Aydın Olur?
Feedback-Aware üsulunun üstünlüyü K böyüdükcə aydınlaşır, çünki model əvvəlki GOOD və BAD generasiyaları görərək təkrarlardan və aşağı keyfiyyətli namizədlərdən daha yaxşı yayınır, SSG kimi üsullar isə hər yeni generasiyada əvvəlki namizədlərdən xəbərsizdir; buna görə ilk nümunədə rəqabətqabiliyyətli olan üsullar uzun namizəd siyahılarında keyfiyyəti daha sürətlə itirə bilər.
Şəkil 4-ün elmi mesajı
Mənbənin Şəkil 4a-sında cavab seçimi Precision@K əyriləri K artdıqca ümumiyyətlə aşağı istiqamətlidir. Bunun səbəbi etibarlı cavab hovuzunun tədricən tükənməsidir. SSG başlanğıcda güclüdür, lakin daha sürətlə azalır. ASG əvvəlki siyahı məzmununu görməyin üstünlüyünü daşısa da Feedback-Aware yanaşmasından geri qalır. ASG-RC cavab seçimi tapşırığındakı ən güclü baseline-lardan biridir; resulting content olan suallar modelə əlavə kontekst verir, lakin GOOD/BAD keyfiyyət siqnalı olmadığı üçün FA qədər sabit deyil.
Şəkil 4b-də açar söz F1@K əyriləri əvvəl yüksəlir, təxminən orta K qiymətlərində zirvəyə çatır və sonra azalır. Mənbənin şərhinə görə bu forma təkcə model davranışının pisləşməsindən qaynaqlanmır. Kiçik K-də kifayət qədər həqiqi açar söz hələ yaradılmadığı üçün recall məhdudlaşdırıcıdır; K həqiqi açar söz hovuzunu aşdıqda əlavə generasiyalar BAD sinfindən gəlməyə başlayır və precision itkisi F1-i aşağı çəkir.
FairytaleQA başlığı altında hesabat verilən statistik nəticələr
| K | Baseline | Mean Δ | Holm-düzəlişli p | Mənbə əhəmiyyətliliyi |
|---|---|---|---|---|
| 1 | SSG | +0,0005 | \(9.70\times10^{-1}\) | Əhəmiyyətli deyil |
| 1 | ASG | +0,0812 | \(8.39\times10^{-8}\) | *** |
| 1 | ASG-RC | +0,0244 | \(1.62\times10^{-1}\) | Əhəmiyyətli deyil |
| 1 | GPT-4o | +0,1340 | \(1.49\times10^{-17}\) | *** |
| 10 | SSG | −0,0001 | \(9.44\times10^{-1}\) | Əhəmiyyətli deyil |
| 10 | ASG | +0,0496 | \(1.19\times10^{-34}\) | *** |
| 10 | ASG-RC | +0,0125 | \(1.74\times10^{-3}\) | ** |
| 10 | GPT-4o | +0,2520 | \(1.44\times10^{-192}\) | *** |
| 20 | SSG | +0,0517 | \(5.85\times10^{-71}\) | *** |
| 20 | ASG | +0,0633 | \(1.52\times10^{-96}\) | *** |
| 20 | ASG-RC | +0,0376 | \(4.52\times10^{-43}\) | *** |
| 20 | GPT-4o | +0,2841 | \(2.76\times10^{-271}\) | *** |
| 25 | SSG | +0,1104 | \(1.04\times10^{-227}\) | *** |
| 25 | ASG | +0,0632 | \(2.55\times10^{-105}\) | *** |
| 25 | ASG-RC | +0,0529 | \(4.20\times10^{-88}\) | *** |
| 25 | GPT-4o | +0,2828 | \(3.18\times10^{-292}\) | *** |
Statistik testin əsas mesajı odur ki, SSG K=1 və K=10-da FA ilə praktik olaraq eyni səviyyədə ola bildiyi halda K=20 və K=25-də aydın şəkildə geri qalır. Bu nəticə “FA ilk yaradılan nümunədə həmişə daha yaxşıdır” iddiasını dəstəkləmir; “çoxlu generasiya uzandıqca FA keyfiyyəti daha yaxşı qoruyur” iddiasını dəstəkləyir.
KP20K açar söz generasiyasındakı statistik nəticələr
| K | Baseline | Mean Δ | Holm-düzəlişli p | Mənbə əhəmiyyətliliyi |
|---|---|---|---|---|
| 1 | SSG | +0,0651 | \(2.76\times10^{-6}\) | *** |
| 1 | ASG | −0,0160 | \(2.59\times10^{-1}\) | Əhəmiyyətli deyil |
| 1 | GPT-4o | +0,1431 | \(1.41\times10^{-20}\) | *** |
| 3 | SSG | +0,0607 | \(2.90\times10^{-22}\) | *** |
| 3 | ASG | +0,0118 | \(9.45\times10^{-2}\) | Əhəmiyyətli deyil |
| 3 | GPT-4o | +0,1612 | \(1.12\times10^{-86}\) | *** |
| 5 | SSG | +0,0435 | \(6.47\times10^{-24}\) | *** |
| 5 | ASG | +0,0218 | \(1.33\times10^{-5}\) | *** |
| 5 | GPT-4o | +0,1309 | \(1.99\times10^{-107}\) | *** |
| 10 | SSG | +0,0351 | \(6.94\times10^{-46}\) | *** |
| 10 | ASG | +0,0262 | \(4.69\times10^{-16}\) | *** |
| 10 | GPT-4o | +0,0764 | \(7.48\times10^{-104}\) | *** |
Burada ASG K=1-də FA-dan ədədi olaraq bir qədər yüksək F1 yaratmışdır; Mean Δ-nın −0,0160 olması bunu göstərir və fərq statistik baxımdan əhəmiyyətli deyil. K=3-də FA lehinə olan kiçik fərq də əhəmiyyətli deyil. FA-nın ASG-yə qarşı statistik üstünlüyü K=5 və K=10-da ortaya çıxır.
Statistik üsul
Əsas prosedur eyni kontekstdəki üsul nəticələrini cütləşdirən iki tərəfli Wilcoxon signed-rank testidir. Mənbə Precision@K və F1@K-nin [0,1] intervalında məhdud olması və xüsusən kiçik K-də diskret/non-normal xüsusiyyət göstərməsi səbəbindən bu testi seçmişdir.
Hər K daxilində çoxsaylı müqayisələr üçün Holm–Bonferroni düzəlişi ilə ailə səviyyəli xəta dərəcəsi \(\alpha=0.05\) kimi nəzarətdə saxlanılmışdır. Bundan əlavə paired t-test və orta fərq üzərində 10.000 təkrar nümunələməli paired bootstrap tətbiq edilmiş; mənbə bütün K qiymətlərində əsas Wilcoxon nəticəsi ilə eyni statistik şərhə çatıldığını bildirmişdir.
Keyfiyyət nümunələri nə göstərir?
Mənbə Cədvəl 5-də cavab seçimi tapşırığında Feedback-Aware modelinin ilk beş generasiyada “happy”, “vivid”, “lion” və “personification” kimi müxtəlif semantik istiqamətlərə aid dörd GOOD cavab yarada bildiyi, yalnız beşinci namizədin BAD olduğu nümunə təqdim edir. Eyni kontekstdə bəzi baseline-lar daha sürətlə aşağı keyfiyyətli və ya bir-birinə yaxın namizədlərə yönəlir.
Cədvəl 6-dakı açar söz nümunəsində FA ardıcıllıqla “productivity”, “knowledge workers”, “performance indicators”, “experts” və “management” yaradır; bunlardan üçüncüsü mənbə etiketlərinə görə BAD, digər dördü GOOD-dur. Baseline-larda sonrakı generasiyalarda əlaqəsiz və ya təkrar xarakterli namizədlərin daha tez-tez görüldüyü nümunələrlə göstərilir.
Mənbə keyfiyyət cədvəllərində REPEATED etiketini semantik baxımdan daha əvvəl yaradılmış namizədlə ekvivalent generasiyanı görünən etmək üçün istifadə etmişdir. Bu etiket kəmiyyət qiymətləndirilməsində yeni keyfiyyət sinfi deyil; tam təkrarlar metrik hesablanmasından əvvəl çıxarılır.
ORPO alignment eksperimenti
GOOD və BAD nümunələrin mövcudluğu tədqiqatçıları preference alignment üsulu ORPO-nu ayrıca sınaqdan keçirməyə yönəltmişdir. ORPO seçilmiş və rədd edilmiş cavablar arasında odds-ratio əsaslı cəza istifadə edir. Eksperimentdə:
\[ \beta=0.3 \]
olaraq təyin edilmiş və digər təlim şərtləri supervised fine-tuning quruluşu ilə eyni saxlanılmışdır.
Mənbənin Figure 5-inə görə Feedback-Aware modelinin ORPO versiyası ilə standart SFT versiyası oxşar davranış göstərir. SSG-də ORPO cavab seçiminin ilk nümunələrində fayda verə bilsə də K böyüdükcə precision daha kəskin azalır. Açar söz tapşırığında SSG-ORPO başlanğıcdan etibarən daha aşağı performans göstərmişdir.
Müəlliflərin şərhinə görə ikili üstünlük optimallaşdırması namizəd məkanını GOOD/BAD oxu boyunca daha sərt qütbləşdirə bilər və bu, müxtəliflik tələb edən çoxnümunəli generasiyada mənfi təsir yarada bilər. Bu eksperiment ORPO-nun ümumiyyətlə pis alignment üsulu olduğunu göstərmir; yalnız araşdırılan çoxlu-generasiya tapşırıqlarındakı davranışını göstərir.
Xəta rejimləri
Mənbə üç əsas xəta mexanizmini vurğulayır. Birincisi, Labeling System zəif və ya sistematik şəkildə qərəzlidirsə, yanlış etiketlər növbəti prompt-a əlavə edildiyi üçün xəta düzəlmək əvəzinə iterasiyalar boyunca güclənə bilər.
İkincisi, hər generasiya və etiket prompt tarixçəsinə əlavə edildiyi üçün kontekst uzunluğu iterasiya sayı ilə böyüyür. Bu vəziyyət context saturation riskini və inferens xərcini artırır.
Üçüncüsü, müəyyən kontekst üçün həqiqətən yaxşı namizədlərin sayı məhduddursa, model müəyyən nöqtədən sonra GOOD hovuzunu tükədir. Buna görə ən yaxşı üsulda belə yüksək K qiymətlərində metrik azalmasının görünməsi tamamilə aradan qaldırıla bilməz.
Tədqiqatın metodoloji məhdudiyyətləri
Hiperparametr axtarışı hesablama xərci səbəbindən şüurlu şəkildə məhdud saxlanılmışdır. Müqayisənin ədalətli olması üçün əsas model və baseline-larda ortaq təlim/decoding parametrləri istifadə olunsa da hər üsulun öz optimal parametri araşdırılmamışdır.
Framework təlim üçün mənfi nümunələrə ehtiyac duyur. KP20K kimi yalnız müsbət annotasiyaya malik verilənlər dəstlərində BAD nümunələr ayrıca yaradılmalıdır; mənfi nümunələr həddindən artıq asan seçilərsə model GOOD/BAD fərqini səthi şəkildə öyrənə bilər.
Performans Labeling System-in keyfiyyətindən asılıdır. Tədqiqatdakı FairytaleQA müşahidəsi orta səviyyəli etiketləmə qüsuruna müəyyən dözümlülük olduğuna işarə etsə də idarə olunan şəkildə artan səs-küy səviyyələri ilə sistematik robustness eksperimenti aparılmamışdır.
İterativ proses təkkeçidli modellərlə müqayisədə əlavə inferens xərci yaradır: daha çox generation çağırışı, Labeling System çağırışları və iterasiya ilə xətti böyüyən prompt tarixçəsi mövcuddur. Məqalə istehsal mühiti üçün wall-clock latency, throughput və GPU yaddaş profillərini ətraflı benchmark kimi təqdim etməmişdir.
Eksperimental feedback yalnız binary GOOD/BAD formasındadır. Framework daha zəngin etiket strukturunu konseptual olaraq dəstəkləsə də dərəcələnmiş və ya çoxölçülü feedback eksperimental olaraq sınaqdan keçirilməmişdir.
Nəhayət, bütün əsas fine-tuning eksperimentləri tək bir 8B baza model üzərində aparılmışdır. Nəticələrin çox daha kiçik, çox daha böyük və ya fərqli arxitektura ailələrinə birbaşa ümumiləşdirilə bilməsi hələ göstərilməmişdir.
Tədqiqatın dəstəklədiyi nəticələr
Tədqiqat uyğun şəkildə fine-tune edilmiş 8B miqyaslı açıq mənbə modelinin açıq GOOD/BAD feedback tarixçəsini inferens prompt-unda istifadə edərək araşdırılan iki çoxlu mətn generasiyası tapşırığında keyfiyyəti iterasiyalar boyunca güclü baseline-lardan daha sabit qoruya bildiyini dəstəkləyir.
Statistik nəticələr xüsusən yüksək K rejimində fərqlərin Feedback-Aware yanaşmasının lehinə böyüdüyünü dəstəkləyir. Bu nəticə təhsil texnologiyalarında çox sayda sual namizədi, geniş qiymətləndirmə elementləri hovuzları və ya sonradan filtrlənəcək açar söz namizədləri kimi oversampling ssenariləri ilə uyğundur.
Tədqiqat həmçinin feedback mənbəyinin tək bir mexanizmdən asılı olmadığını göstərən iki nümunə təqdim edir: cavab seçimi üçün avtomatik proxy modellər və açar söz generasiyası üçün insan tərəfindən kurasiya edilmiş annotasiyalar.
Tədqiqatın dəstəkləmədiyi nəticələr
Tədqiqat Feedback-Aware üsulunun bütün NLP tapşırıqlarında bütün böyük modellərdən üstün olduğunu göstərmir. Yalnız iki tapşırıq və tək əsas 8B model ailəsi qiymətləndirilmişdir.
GPT-4o baseline-ının aşağı performansı GPT-4o-nun ümumi model qabiliyyətinin Llama-3 8B-dən aşağı olduğunu göstərmir. Eksperimentdə GPT-4o one-shot prompting ilə istifadə olunarkən digər əsas modellər tapşırıq-xüsusi fine-tuning keçmişdir; buna görə nəticə yalnız bu eksperiment protokoluna aiddir.
Tədqiqat feedback-in həmişə xətaları düzəltdiyini də göstərmir. Səhv və ya qərəzli LS siqnalı eyni feedback dövrü daxilində xətanın növbəti generasiyalara daşınmasına səbəb ola bilər.
“Daha kiçik modellər böyük proprietary LLM-lərin bütün iterative reasoning imkanlarını eyni səviyyədə təmin edə bilər” nəticəsi də mənbə tərəfindən sübut edilməmişdir. Göstərilən odur ki, araşdırılan iki çoxlu-generasiya tapşırığında strukturlaşdırılmış feedback mexanizmi 8B modeldə faydalıdır.
Mənbədəki hesabat qeyri-müəyyənlikləri
TASA test bölməsi 1000, FairytaleQA test bölməsi isə 1007 nümunə kimi verilsə də statistik Cədvəl 3 “FairytaleQA, n=2007” kimi etiketlənmişdir. 2007 sayı iki test bölməsinin cəminə bərabərdir; lakin mənbə bunun birləşdirilmiş analiz olduğunu açıq demədiyinə görə burada yalnız uyğunsuzluq görünən saxlanılmışdır.
KP20K-də 2000 test nümunəsinin seçildiyi bildirildiyi halda Cədvəl 4 statistik müqayisəni n=1998 kontekst üzərində hesabat verir. İki nümunənin niyə analizə daxil olmadığı mənbədə izah edilməmişdir.
Keyword Generation bölməsinin KP20K istifadə etdiyi açıq göstərilsə də Cədvəl 6-dakı nümunə kontekstinin sonunda “FairytaleQA dataset entry [15]” mənbə ifadəsi mövcuddur. Verianla bu mənbəni səssiz şəkildə KP20K olaraq dəyişdirmir.
Gələcək tədqiqat istiqamətləri
Müəlliflər framework-ün daha geniş generativ tapşırıq diapazonunda, fərqli model miqyaslarında və fərqli arxitekturalarda sınaqdan keçirilməsini təklif edirlər. Xüsusən sintetik şəkildə korlanmış Labeling System-lərlə idarə olunan feedback-noise eksperimentləri modelin yanlış feedback-ə dözümlülüyünü birbaşa ölçə bilər.
İstehsal mühitinə yönəlik wall-clock latency, throughput və GPU yaddaş ölçmələri də gələcək üçün vacib ehtiyaclardandır; çünki iterativ feedback dövrünün keyfiyyət üstünlüyü əlavə inference xərci ilə birlikdə qiymətləndirilməlidir.
Binary GOOD/BAD etiketindən əlavə dərəcələnmiş ballar və ya müxtəlif keyfiyyət ölçülərini ayrıca ifadə edən çoxölçülü feedback strukturları da araşdırıla bilər.
Mənbə sonda riyazi problem həlli, məntiqi inferens və ya elmi izah kimi çoxmərhələli reasoning tapşırıqlarında aralıq addımlara feedback tətbiq edilməsini mümkün genişlənmə sahəsi kimi təklif edir. Bu istifadə tədqiqatda eksperimental olaraq təsdiqlənməmişdir.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Feedback-Aware Inference for Iterative Multi-Sample Text Generation
Müəlliflər: Andreea Dutulescu; Stefan Ruseti; Mihai Dascalu; Danielle S. McNamara.
Məsul müəllif: Stefan Ruseti.
Qurumlar: Computer Science and Engineering Department, National University of Science and Technology POLITEHNICA Bucharest, Rumıniya; Academy of Romanian Scientists, Rumıniya; Learning Engineering Institute, Arizona State University, ABŞ.
Jurnal: AI.
Nəşriyyat: MDPI.
Mənbə növü: Resenziyalı orijinal tədqiqat məqaləsi; təbii dil emalı, dil modelinin fine-tuning-i və iterativ inferens eksperimentləri.
Nəşr məlumatı: AI 2026, cild 7, say 5, məqalə 171.
DOI: 10.3390/ai7050171
Təqdim edilmə: 1 aprel 2026.
Reviziya: 8 may 2026.
Qəbul: 12 may 2026.
Nəşr: 15 may 2026.
Lisenziya: Creative Commons Attribution (CC BY), açıq giriş.
Maliyyələşdirmə: Tədqiqat Romanian Hub for Artificial Intelligence—HRIA layihəsi, Smart Growth, Digitization and Financial Instruments Program 2021–2027 çərçivəsində MySMIS no. 351416; U.S. Department of Education Institute of Education Sciences tərəfindən Arizona State University-yə verilmiş R305T240035 nömrəli qrant və Academy of Romanian Scientists AOSR-TEAMS-IV Edition 2025–2026 “Digital Transformation in Science” qrantı ilə dəstəklənmişdir.
İnstitusional etika komitəsi: Tətbiq edilmir.
Məlumatlandırılmış razılıq: Tətbiq edilmir.
Verilənlərə, koda və modelə çıxış: Müəlliflər tədqiqatın verilənlərini, kodunu və fine-tune edilmiş modellərini açıq GitHub deposunda dərc etdiklərini bildirirlər.
Generativ AI istifadə bəyanatı: Müəlliflər məqalənin hazırlanmasında generativ süni intellektdən yalnız yazı yoxlaması və qrammatika məqsədləri üçün istifadə edildiyini; çıxışın özləri tərəfindən nəzərdən keçirilib redaktə edildiyini və məzmunun məsuliyyətini üzərlərinə götürdüklərini bildirirlər.
Maraqların toqquşması: Müəlliflər maraqların toqquşması olmadığını bəyan edirlər. Maliyyələşdirən tərəflərin tədqiqat dizaynında, verilənlərin toplanması/analizi/şərhində, məqalənin yazılmasında və ya nəşr qərarında rolu olmadığı bildirilmişdir.
Müəllif töhfələri: Konseptuallaşdırma Andreea Dutulescu, Stefan Ruseti və Mihai Dascalu; metodologiya Andreea Dutulescu və Stefan Ruseti; proqram təminatı, formal analiz, araşdırma, resurslar, verilənlərin kurasiyası, ilkin qaralama və vizuallaşdırma Andreea Dutulescu; validasiya Andreea Dutulescu, Stefan Ruseti və Mihai Dascalu; nəzərdən keçirmə və redaktə bütün dörd müəllif; nəzarət Stefan Ruseti, Mihai Dascalu və Danielle S. McNamara; layihə idarəetməsi Mihai Dascalu; maliyyələşdirmənin əldə edilməsi Stefan Ruseti, Mihai Dascalu və Danielle S. McNamara tərəfindən həyata keçirilmişdir.
Əsas metodoloji məhdudiyyətlər: Yalnız iki tapşırıq qiymətləndirilmişdir; tək 8B baza model istifadə edilmişdir; hiperparametr axtarışı məhduddur; mənfi nümunə tələbi var; etiketləmə sisteminin xətaları feedback dövründə yayıla bilər; inference xərci təkkeçidli üsullardan yüksəkdir; binary feedback-dən başqa strukturlar sınaqdan keçirilməmişdir; istehsal mühiti latency/throughput/GPU yaddaş benchmark-ları təqdim edilməmişdir.
Mənbədaxili hesabat qeydi: FairytaleQA test sayı ilə Cədvəl 3-dəki n=2007 etiketi, KP20K test sayı ilə Cədvəl 4-dəki n=1998 dəyəri və Cədvəl 6-dakı FairytaleQA mənbə etiketi arasında izah olunmamış uyğunsuzluqlar var. Bu məqamlar Verianla tərəfindən səssizcə düzəldilməmişdir.
Verianla metod qeydi: Bu məzmun mənbə məqalənin cümlə-cümlə tərcüməsi və ya paraqraf-paraqraf yaxın yenidən yazımı deyil. Tədqiqat problemi, Feedback-Aware training/inference quruluşu, GOOD/BAD feedback sistemi, QGen/QAns qiymətləndirmə məntiqi, verilənlər dəstləri, model parametrləri, P@K və F1@K nəticələri, statistik testlər, keyfiyyət təhlili, ORPO eksperimenti, məhdudiyyətlər və gələcək tədqiqat təklifləri qorunaraq müstəqil Azərbaycan dilində elmi öyrənmə strukturu yaradılmışdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib