

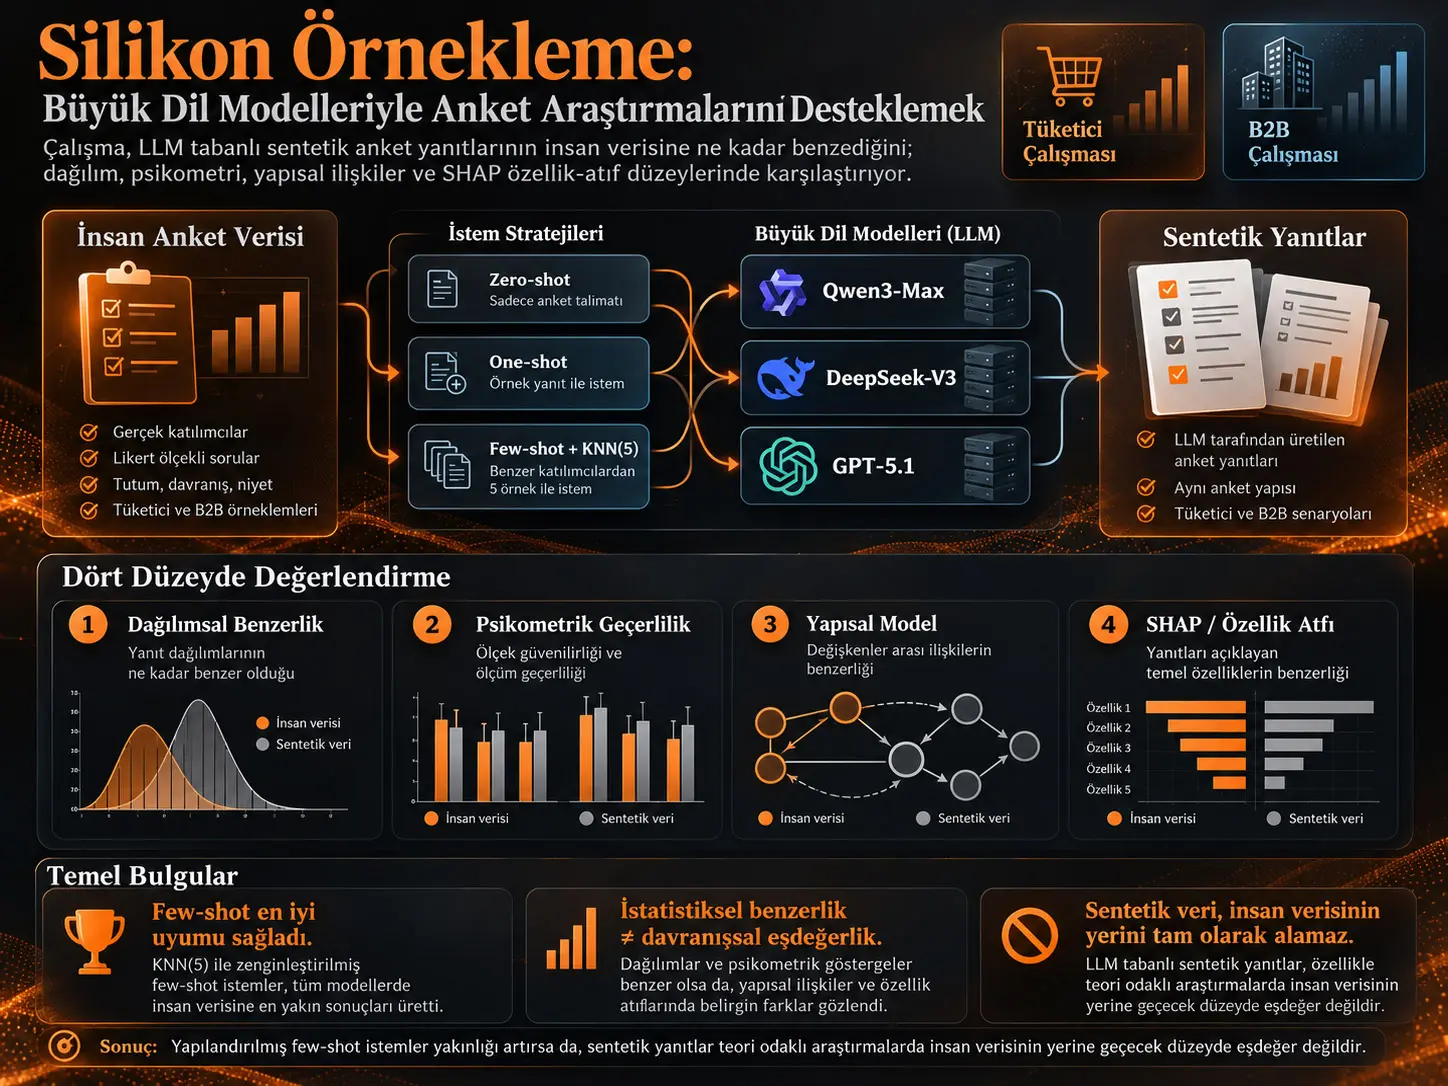
Silikon örnekleme (silicon sampling), büyük dil modellerinin kontrollü istemler altında sentetik anket yanıtları üretmesi ve bu yanıtların insanlardan toplanmış ampirik verilerle karşılaştırmalı olarak kullanılması yaklaşımıdır. Bu çalışma, silikon örneklemenin yalnız “insana benzeyen cevaplar üretip üretmediğini” değil; dağılımsal benzerliği, psikometrik ölçüm kalitesini, yapısal ilişkileri ve öngörücü özellik-atıf düzenlerini ne ölçüde koruduğunu araştırmaktadır. Üç büyük dil modeliyle toplam 6.048 sentetik yanıt üretilmiş ve bunlar iki gerçek insan veri setindeki toplam 672 yanıtla karşılaştırılmıştır: lüks tüketim bağlamında 369 tüketici ve B2B yeşil pazarlama bağlamında 303 firma. Çalışmanın ana sonucu, few-shot biçimindeki yapılandırılmış istemlerin insan verisine yakınlığı belirgin biçimde artırdığı; ancak daha iyi istatistiksel uyumun insan yanıtlarıyla tam psikolojik veya davranışsal eşdeğerlik anlamına gelmediğidir.
Çalışma bu ayrımı dört aşamalı bir geçerlilik hiyerarşisiyle gösterir. İlk düzey yanıt dağılımlarını, ikinci düzey ölçeklerin güvenilirlik ve geçerliliğini, üçüncü düzey teorik yapısal ilişkilerin korunmasını, dördüncü düzey ise Gradient Boosting modellerinden elde edilen SHAP özellik-atıf örüntülerini karşılaştırır. Sonuçlar derinleştikçe uyumun daha koşullu hâle geldiğini gösterir. Tüketici bağlamında LLM yanıtları genel olarak insan yanıtlarından daha yüksek puanlara yönelirken, örgütsel B2B bağlamında özellikle DeepSeek ve GPT yapılandırmalarında azaltılmış yanıtlar ve varyans sıkışması öne çıkmıştır.
Bu nedenle çalışma, silikon örneklemeyi insan katılımcıların yerine geçecek bağımsız bir ampirik kanıt kaynağı olarak değil; anket ön testi, kıyaslama, sağlamlık kontrolü, örneklem duyarlılığı ve senaryo incelemesi gibi sınırları açıkça belirlenmiş görevlerde kullanılabilecek yardımcı bir metodolojik araç olarak konumlandırmaktadır. Özellikle teori sınaması, aracılık, düzenleyicilik veya davranış mekanizması yorumu gerektiğinde insan verisi temel ampirik referans olmaya devam etmektedir.
Silikon Örnekleme Nedir?
Silikon örnekleme, büyük dil modellerinden belirli demografik, bağlamsal veya rol temelli koşullar altında anket biçiminde sentetik yanıtlar elde edilmesi ve bu yanıtların insan verisinin yerine otomatik olarak geçirilmeden, gerçek insan referans verileriyle sistematik biçimde kıyaslanması yaklaşımıdır.
Anket araştırmasının temel zorluklarından biri, insan davranışını doğrudan gözlenemeyen yapılar üzerinden ölçmeye çalışmasıdır. Marka imajı, sosyal etki, yaşam doyumu, çevresel strateji veya marka konumlandırması gibi değişkenler fiziksel bir sensörle doğrudan okunmaz; çok maddeli ölçeklerden çıkarılan gizil yapılardır. Bu nedenle bir veri setinin yalnız ortalama değerlerinin “gerçekçi” görünmesi, onun teori sınaması için yeterli olduğu anlamına gelmez.
Büyük dil modelleri bağlama duyarlı ve biçimsel olarak tutarlı yanıtlar üretebildiği için anket araştırmasında yeni bir metodolojik olanak ortaya çıkmaktadır. Ancak LLM yanıtlarının insan katılımcılar gibi kararlı psikolojik özelliklere sahip olduğu varsayılamaz. Model çıktısı istemin yapısına, verilen örneklere, bağlamsal bilgiye ve modelin kendi öğrenilmiş temsil uzayına bağlıdır. Bu nedenle çalışma, sentetik yanıtların geçerliliğini doğrudan varsaymak yerine insan verisine karşı kademeli olarak sınamaktadır.
Araştırmanın temel sorusu
Araştırmanın merkezi problemi, “LLM çıktıları insan yanıtlarına benziyor mu?” sorusundan daha derindir. Asıl soru, sentetik yanıtların araştırmanın gerektirdiği metodolojik özellikleri hangi derinliğe kadar koruyabildiğidir. Bir veri setinin ortalamaları insan verisine yaklaşabilir; buna karşılık aynı veri seti ölçeklerin kovaryans yapısını, teorik yol ilişkilerini veya bir sonucun hangi değişkenlerden etkilendiğine ilişkin özellik-atıf düzenini farklı biçimde kurabilir.
Neden Yalnız İstatistiksel Benzerlik Yeterli Değildir?
İstatistiksel benzerlik yalnız en yüzeysel geçerlilik düzeyini gösterir; teoriye dayalı anket araştırması için ölçek güvenilirliğinin, gizil faktör yapısının, yapısal ilişkilerin ve sonuçları açıklayan özellik-atıf düzenlerinin de insan referans verisiyle uyumlu olup olmadığı ayrıca sınanmalıdır.
Dört düzeyli hiyerarşik geçerlilik
| Düzey | Temel soru | Kullanılan başlıca araçlar | Ne ölçülüyor? |
|---|---|---|---|
| 1 — Dağılımsal karşılık | Sentetik yanıt dağılımları insan yanıtlarına ne kadar yaklaşıyor? | MANOVA, madde düzeyinde ANOVA, Welch t-testi, standart sapma oranları | Ortalama kaymaları, dağılım ve yönlü şişme/sıkışma |
| 2 — Psikometrik bütünlük | Ölçeklerin ölçüm kalitesi korunuyor mu? | Cronbach α, bileşik güvenilirlik (CR), AVE, CFA | İç tutarlılık, yakınsak geçerlilik ve gizil faktör yapısı |
| 3 — Yapısal modelin korunması | Teorik değişkenler arasındaki yollar korunuyor mu? | SEM, standartlaştırılmış yol katsayıları ve uyum indeksleri | Yön, istatistiksel anlamlılık, etki büyüklüğü ve model uyumu |
| 4 — Özellik-atıf tutarlılığı | Sonucu tahmin ederken hangi değişkenler öne çıkıyor? | Gradient Boosting + SHAP | Öngörücü değişkenlerin göreli önem örüntüleri |
Dördüncü düzey özellikle dikkatle yorumlanmalıdır. SHAP değerleri burada Gradient Boosting tahmin modellerindeki özellik katkılarını açıklamaktadır. Dolayısıyla bu sonuçlar doğrudan “LLM böyle düşünüyor” veya “insan zihni şu mekanizmayı kullanıyor” anlamına gelmez. Çalışmanın kendi metodolojik sınırı da budur: SHAP, veri setlerinin ürettiği öngörücü atıf örüntülerini karşılaştırır; gerçek bilişsel süreçleri doğrudan gözlemez.
İstem tasarımı neden metodolojik bir değişkendir?
Çalışmada model seçiminin yanında istem mimarisi de bağımsız bir metodolojik değişken olarak ele alınmıştır. Zero-shot koşulunda örnek verilmez. One-shot koşulunda bir biçim örneği sunulur. Few-shot + KNN koşulunda ise incelenen profile özellik uzayında yakın olan beş gerçek gözlem bulunarak modelin bağlamına örnek olarak eklenir. Böylece modelin yanıtları doğrudan toplu istatistikler verilmeden yerel insan veri örüntülerine bağlanmaya çalışılır.
En yakın insan örneklerinin belirlenmesinde kaynak çalışma Öklid uzaklığını kullanır:
\[ d(p_i,p_j)=\sqrt{\sum_f \left(p_i^f-p_j^f\right)^2} \]
Bu denklem iki profil arasındaki özellik-uzayı uzaklığını hesaplar. \(p_i\) sentetik yanıt üretilecek profili, \(p_j\) aday insan gözlemini, \(f\) ise karşılaştırmada kullanılan özelliği temsil eder. Her özellikteki farkın karesi alınır, özellikler boyunca toplanır ve toplamın karekökü hesaplanır. En küçük uzaklığa sahip beş gözlem, few-shot bağlam çapasını oluşturur. Denklem fiziksel bir büyüklük hesaplamadığı için metre, saniye veya başka bir fiziksel birime sahip değildir; sonuç kullanılan özellik gösteriminin uzayındaki geometrik uzaklıktır.
İnsan referans verileri → profil ve bağlam çıkarımı → zero-shot / one-shot / few-shot + KNN(5) → Qwen3-Max / DeepSeek-V3 / GPT-5.1 → sentetik anket yanıtları → dört düzeyli insan–LLM karşılaştırması.
İki farklı araştırma bağlamı neden kullanıldı?
Birinci çalışma bireysel tüketici tutumlarının baskın olduğu lüks tüketim bağlamını kullanır. İnsan referans örneklemi Çin alt örneklemindeki 369 geçerli yanıttan oluşur. Sosyal etki, gösterişçi tüketim, marka imajı, lüks tüketim eğilimi, satın alma dürtüsü, lüks harcama ve yaşam doyumu gibi yapılar değerlendirilir.
İkinci çalışma 303 firmadan oluşan bir B2B veri setini kullanır. Burada yeşil pazarlama stratejisi, şirket çevre stratejisi, yeşil marka konumlandırması, yeşil marka rekabetçiliği ve yeni yeşil ürün başarısı arasındaki ilişkiler ele alınır. Bu model doğrudan etkilerin yanında aracılık ve düzenleyicilik ilişkileri de içerdiği için ilk çalışmadan daha yüksek yapısal karmaşıklık taşımaktadır.
Çalışmanın Yöntemi ve Bulguları
Üç model değerlendirilmiştir: Qwen3-Max (qwen3-max), DeepSeek-V3 (deepseek-v3) ve GPT-5.1 (gpt-5.1-all). Üretim sıcaklığı 0,7, max_tokens 2000 olarak belirlenmiş; top_p API varsayılanında bırakılmış ve seed belirtilmemiştir. Her sentetik vaka yalnız bir kez üretilmiş, aynı vaka için tekrarlı üretimlerin ortalaması alınmamıştır.
İki insan veri setindeki toplam 672 gözlemin üç model ve üç temel istem koşulunda yeniden üretilmesi 6.048 sentetik yanıt oluşturmuştur. Bu tasarımın önemli avantajı, model ve istem koşullarının aynı insan referans çerçevesi üzerinde karşılaştırılabilmesidir. Önemli sınırlılığı ise her sentetik vakanın yalnız bir kez oluşturulması nedeniyle üretim rastlantısallığının ve tekrarlar arası kararlılığın doğrudan ölçülememesidir.
Few-Shot Prompting İnsan Verisiyle Eşdeğerlik Sağlıyor mu?
Hayır. Few-shot + KNN koşulu iki çalışmada da genel olarak insan referansına en yakın sentetik verileri üretmiştir; ancak dağılımsal sapmalar, model uyum kayıpları, bazı yol katsayılarının değişmesi ve SHAP özellik-atıf düzenlerindeki farklılıklar nedeniyle çalışma bunu insan verisiyle tam eşdeğerlik olarak yorumlamamaktadır.
Çalışma 1 — Tüketici bağlamında dağılımsal sonuçlar
Tüketici deneyinde zero-shot yanıtlar insan verisinden en fazla uzaklaşan koşullardır. Few-shot, üç modelde de farkı önemli ölçüde azaltır. Bununla birlikte sentetik yanıtların belirgin bir yukarı yönlü sapması devam eder. Few-shot koşulunda Qwen için ortalama fark +0,50, DeepSeek için +0,49 ve GPT için +0,67 ölçek puanıdır. İstatistiksel olarak anlamlı farklılık gösteren maddelerin neredeyse tamamında LLM ortalamaları insan ortalamalarından yüksektir.
| Model | Wilks λ | Ortalama η² | İnsan verisine göre ortalama fark | Ana yön |
|---|---|---|---|---|
| Qwen3-Max | 0,245 | 0,064 | +0,50 | Sentetik yanıtlar daha yüksek |
| DeepSeek-V3 | 0,251 | 0,063 | +0,49 | Sentetik yanıtlar daha yüksek |
| GPT-5.1 | 0,321 | 0,088 | +0,67 | Sentetik yanıtlar daha yüksek |
Bu sonuç, yapılandırılmış istemin önemli olduğunu fakat sentetik örneklemin yanlılıktan otomatik olarak arınmadığını gösterir. Few-shot koşulu farkın büyüklüğünü azaltmakta, fakat tüketici örneklemindeki sistematik yüksek puan verme eğilimini ortadan kaldırmamaktadır.
Çalışma 1 — Psikometrik bütünlük
Few-shot veri setlerinde Cronbach α, bileşik güvenilirlik ve AVE değerleri genel olarak kabul edilebilir sınırlar içinde kalmıştır. En belirgin zayıflamalardan biri marka imajı yapısında görülür; ancak AVE yine de Qwen için 0,577, DeepSeek için 0,571 ve GPT için 0,631 olarak raporlanmıştır.
CFA uyumunda insan verisi daha güçlüdür. İnsan referansında CFI 0,944, TLI 0,935 ve RMSEA 0,064 iken; Qwen few-shot verisinde 0,913 / 0,900 / 0,072, DeepSeek’te 0,909 / 0,895 / 0,073 ve GPT’de 0,899 / 0,884 / 0,085 değerleri elde edilmiştir. Ölçek yapısı tamamen çökmemekte, fakat insan ölçüm modelinin düzeyinde de yeniden üretilmemektedir.
Çalışma 1 — Yapısal model
SEM sonuçları aynı dereceli modeli gösterir. İnsan modelinde CFI 0,947, TLI 0,941 ve RMSEA 0,061’dir. Few-shot Qwen modeli 0,901 / 0,889 / 0,076; DeepSeek 0,897 / 0,885 / 0,077; GPT ise 0,889 / 0,877 / 0,088 değerlerini vermiştir.
Altı temel yapısal yolun büyük bölümü yön ve anlamlılık açısından korunmuştur. Ancak marka imajından lüks tüketim eğilimine giden BI → LCT yolu insan verisinde \(β=0,184\) iken Qwen’de \(β=-0,149\) ve DeepSeek’te \(β=-0,168\) olarak yön değiştirmiş; GPT’de \(β=0,146\) ile insan yönü korunmuştur. Diğer bazı yolların yönü korunsa bile katsayı büyüklükleri insan referansından önemli ölçüde uzaklaşmıştır. Bu nedenle model topolojisinin korunması, etki büyüklüklerinin aynı olduğu anlamına gelmemektedir.
Çalışma 1 — SHAP neden kritik bir uyarı verdi?
İnsan referansında satın alma dürtüsünü tahmin eden Gradient Boosting modelinde en güçlü özellik yaşam doyumudur (LS; önem 0,367). Yaş değişkeninin insan verisindeki önemi 0,137’dir. Sentetik veri setlerinin ortalamasında ise yaşın SHAP önemi 0,303’e yükselirken LS’nin ortalama önemi 0,036’ya düşmektedir. Kaynak ayrıca yaşın 12 LLM/istem yapılandırmasının 10’unda en önemli özellik hâline geldiğini bildirir.
Bu, sentetik yanıtların bazı yüzeysel ve yapısal özellikleri korurken sonucun hangi değişkenler etrafında örgütlendiğini değiştirebildiğini göstermektedir. Buradaki sonuç “LLM gerçekten karar verirken yaşı kullanıyor” biçiminde okunmamalıdır; SHAP farklı veri setlerinden eğitilmiş Gradient Boosting modellerinin özellik-atıf düzenlerini karşılaştırmaktadır.
Çalışma 2 — B2B bağlamında dağılım yönü değişiyor
B2B çalışmasında few-shot yine genel olarak en iyi yaklaşımı verir, ancak sapmanın yönü tüketici çalışmasındaki gibi tekdüze değildir. GPT-5.1 few-shot koşulu Wilks λ=0,266 ve ortalama η²=0,034 ile en güçlü dağılımsal uyumlardan birini sunar; ortalama fark -0,048’dir. DeepSeek few-shot farkı -0,160 iken Qwen few-shot +0,159’dur.
| Model | Wilks λ | Ortalama η² | İnsan verisine göre ortalama fark |
|---|---|---|---|
| Qwen3-Max | 0,192 | 0,056 | +0,159 |
| DeepSeek-V3 | 0,211 | 0,050 | -0,160 |
| GPT-5.1 | 0,266 | 0,034 | -0,048 |
Çalışmanın önemli çapraz-bağlam bulgusu burada ortaya çıkar: sentetik veri hatası sabit bir “LLM her zaman yüksek puan verir” davranışı değildir. Tüketici bağlamında belirgin şişme görülürken, örgütsel ve stratejik B2B sorularında özellikle DeepSeek ve GPT yanıtları insan referansına göre aşağı doğru kayabilmekte ve varyans daha sıkışmış olabilmektedir.
Çalışma 2 — Ölçüm yapısı daha kırılgan
B2B ölçeklerinde iç tutarlılık genel olarak güçlü kalırken bazı yakınsak geçerlilik değerleri zayıflamıştır. Kaynak Tablo 8’e göre Green Marketing Strategy için insan AVE değeri 0,599’dur; Qwen’de 0,447 ve DeepSeek’te 0,395’e düşerken GPT’de 0,584’tür. Qwen ve DeepSeek değerlerinin 0,50’nin altında kalması, özellikle daha soyut stratejik yapılarda gizil temsilin güvenilirlik katsayılarından daha kırılgan olabileceğini göstermektedir.
CFA’da insan referansı CFI 0,992, TLI 0,991 ve RMSEA 0,017 ile çok güçlü uyum gösterir. GPT verisi 0,897 / 0,889 / 0,068 ile üç model arasında insana en yakın sonuçları verir. Qwen 0,845 / 0,833 / 0,077; DeepSeek ise 0,792 / 0,775 / 0,087 değerlerindedir. Böylece B2B bağlamındaki gizil ölçüm yapısının tüketici bağlamına göre daha zor yeniden üretildiği görülmektedir.
Çalışma 2 — Doğrudan, aracılı ve düzenleyici yollar
Kaynak Tablo 11, bütün yolların eşit ölçüde korunmadığını açıkça gösterir. Örneğin GMS → GBP yolu insan verisinde \(β=0,396\) iken Qwen’de 0,746, DeepSeek’te 1,267 ve GPT’de 0,651’dir; yön ve anlamlılık korunurken büyüklükler belirgin biçimde değişmektedir.
Buna karşılık CES → GBP yolu insan verisinde \(β=0,209\) iken Qwen’de -0,104 ve DeepSeek’te -0,323 ile yön değiştirmiş; GPT’de 0,286 olarak korunmuştur. GBP → NGPS ilişkisi insan verisinde \(β=0,543\) iken Qwen’de 0,187 ve DeepSeek’te 0,180 olarak yönünü korumasına rağmen kaynak tablodaki anlamlılık koruma ölçütünü geçmemiş; GPT’de 0,492 ile hem yön hem anlamlılık korunmuştur.
Düzenleyici etki de önemli bir sınır durumudur. İnsan verisindeki GMS × CES → GBP etkileşimi \(β=-0,445\)’tir. Qwen (-0,154) ve DeepSeek (-0,169) aynı yönü ve anlamlılığı korurken GPT’de katsayı +0,034’e dönmüş ve korunmamıştır. Dolayısıyla sentetik veri, ana yapısal mimariyi kısmen yeniden üretse bile özellikle daha yüksek dereceli ilişkilerde eşdeğerlik garanti edilmemektedir.
Çalışma 2 — Özellik-atıf düzeni
İnsan B2B referansında Green Brand Positioning sonucunu tahmin eden en önemli değişken New Green Product Success’tır (NGPS; SHAP önemi 0,363). LLM veri setlerinde NGPS’nin ortalama önemi 0,025’e ve ortalama sırası 5,0’a geriler. Buna karşılık Green Brand Competitiveness (GBC) insan verisinde 0,124 iken sentetik veri ortalamasında 0,158’e çıkar ve ortalama sıra 1,3 olur.
Bu sonuç tüketici deneyindeki “demografik ikame” örüntüsünden farklıdır. B2B bağlamında sentetik veri, sonucu insan verisindeki performans-odaklı değişkenlerden ziyade ara stratejik yapılara daha fazla bağlamaktadır. Böylece çalışmanın ana iddiası güçlenir: LLM sapması yalnız modelden değil, temsil edilmesi gereken araştırma bağlamının niteliğinden de etkilenmektedir.
Çalışmanın desteklediği sonuçlar
Kaynak çalışma, yapılandırılmış few-shot istemlerin insan referansına yakınlığı genel olarak artırdığını; psikometrik güvenilirliğin birçok durumda korunabildiğini; bazı yapısal ilişkilerin yön ve anlamlılığının yeniden üretilebildiğini; ancak dağılımsal yanlılık, katsayı büyüklüğü bozulması, karmaşık yapısal ilişkilerde kararsızlık ve özellik-atıf örüntülerinde sistematik farklılıkların devam ettiğini desteklemektedir.
Çalışmanın desteklemediği sonuçlar
Çalışma, LLM üretimli yanıtların insan katılımcıların yerine güvenle geçirilebileceğini kanıtlamaz. Few-shot prompting insan eşdeğerliğini garanti etmez. SHAP sonuçları insan veya LLM bilişini doğrudan ölçmez. İki araştırma bağlamındaki sonuçlar bütün toplumlara, bütün anket türlerine, bütün kültürlere veya bütün LLM sürümlerine genellenemez. Çalışma ayrıca sentetik yanıtların tekrarlı üretimlerde ne kadar kararlı olduğunu sınamamıştır.
Pratik anlam
Bu sonuçlar silikon örneklemenin en güvenli kullanım alanlarının anket tasarımı sırasında ön test, madde tutarlılığı kontrolü, alternatif örneklem kompozisyonlarına duyarlılık, metodolojik stres testi, kıyaslama ve senaryo keşfi olduğunu düşündürmektedir. Sentetik veri bu görevlerde araştırmacının hangi koşullarda sonuçların değişebileceğini incelemesine yardım edebilir. Fakat gerçek popülasyon davranışı hakkında ampirik kanıt gerektiğinde insan verisinin yerini almamalıdır.
Kaynak ve Yöntem Notu
Özgün başlık: Silicon Sampling: Supporting Survey Research with Large Language Models
Yazarlar: Haozhe Ma; Yunchu Yang; Arnaldo Coelho; Penousal Machado; Yapeng Wang.
Kurumlar: CEBER – Centre for Business and Economics Research, Faculty of Economics, University of Coimbra; Faculty of Applied Sciences, Macao Polytechnic University; CISUC/LASI – Centre for Informatics and Systems of the University of Coimbra, Department of Informatics Engineering.
Corresponding author: PDF’de corresponding-author işareti Yunchu Yang üzerinde gösterilmektedir.
DOI: 10.2139/ssrn.7362005.
Platform ve yayın statüsü: SSRN preprint kaydı. Yüklenen PDF açık biçimde çalışmanın henüz hakem değerlendirmesinden geçmediğini belirtmektedir. PDF alt bilgisinde “Preprint submitted to Elsevier” ifadesi bulunur; sağlanan belgede hakemli bir dergi sürümü tanımlanmamaktadır.
Gönderim tarihi: Resmî SSRN kaydında 28 Ağustos 2026.
Lisans: Yüklenen PDF ve doğrulanabilen bibliyografik kayıtta yeniden kullanım için açık bir Creative Commons lisansı belirlenmemiştir. Bu nedenle Verianla içeriğinde kaynak figürleri veya özgün tablo tasarımları yeniden kullanılmamış; bilimsel olgular bağımsız anlatım ve yeni tablo yapılarıyla sunulmuştur.
Temel araştırma tasarımı: İki önceden doğrulanmış insan anket veri setinin Qwen3-Max, DeepSeek-V3 ve GPT-5.1 tarafından zero-shot, one-shot ve few-shot + KNN bağlamlarında sentetik olarak yeniden üretilmesi; sentetik ve insan veri setlerinin dağılımsal, psikometrik, yapısal ve SHAP özellik-atıf düzeylerinde karşılaştırılması.
Üretim ayarları: Temperature 0,7; max_tokens 2000; top_p API varsayılanı; seed belirtilmemiştir. Her sentetik vaka bir kez oluşturulmuştur.
İnsan örneklemleri: Tüketici çalışması N=369; B2B çalışması N=303; toplam N=672.
Sentetik veri: Toplam 6.048 LLM üretimli yanıt.
CRediT katkıları: Haozhe Ma — kavramsallaştırma, araştırma, veri kürasyonu ve ilk taslak; Yunchu Yang — metodoloji, biçimsel analiz, görselleştirme ve inceleme/düzenleme; Arnaldo Coelho — ilk taslak, danışmanlık ve inceleme/düzenleme; Penousal Machado — danışmanlık ve inceleme/düzenleme; Yapeng Wang — kaynaklar ve danışmanlık.
Finansman, çıkar çatışması ve veri erişilebilirliği: Sağlanan PDF’de bunlar için ayrı ve açık beyanlar tespit edilmemiştir; bu alanlar hakkında ek bilgi varsayılmamıştır.
Kaynak içindeki raporlama tutarsızlıkları
Yöntem tasarımı üç temel istem rejimini zero-shot, one-shot ve few-shot + KNN olarak tanımlamasına rağmen Study 1 anlatısında bir yerde “statistical-summary prompting” ifadesi yer almaktadır. Bu terim ana deney tasarımı ve ilgili tablolarla açık biçimde eşleştirilmediğinden Verianla anlatımında üç açıkça tanımlanmış rejim esas alınmıştır.
B2B psikometrik sonuçlarının anlatı kısmı Green Marketing Strategy için insan AVE değerini 0,566 olarak yazarken, kaynak Tablo 8 aynı değeri 0,599 olarak vermektedir. Verianla nicel aktarımında doğrudan tablo değeri 0,599 kullanılmış ve tutarsızlık saklanmamıştır.
B2B yapısal sonuçların anlatısındaki bazı genel ifadeler de kaynak Tablo 11’in yol-bazlı koruma işaretleriyle tam örtüşmemektedir. Bu nedenle yön ve anlamlılık değerlendirmelerinde Tablo 11’in tek tek raporladığı katsayılar ve koruma işaretleri esas alınmıştır.
Temel sınırlılıklar
Araştırma yalnız iki anket bağlamını incelemektedir. B2B çalışması Çin kurumsal ortamına dayandığı için sonuçların başka kurumsal veya kültürel bağlamlarda aynı şekilde ortaya çıkacağı bilinmemektedir. Kullanılan model ve istem yapılandırmaları sınırlıdır; retrieval-augmented generation, fine-tuning veya insan–LLM hibrit örnekleme gibi yaklaşımlar doğrudan sınanmamıştır.
Her sentetik vaka yalnız bir kez oluşturulduğundan aynı istem ve profilin tekrarlı üretimlerinde dağılımsal, psikometrik veya yapısal sonuçların ne ölçüde değişeceği bilinmemektedir. Ayrıca mekanizma düzeyi değerlendirme Gradient Boosting + SHAP çerçevesine bağlıdır. Farklı tahmin algoritmaları veya açıklanabilirlik yöntemleri farklı özellik-atıf yapıları üretebilir.
Bu nedenle çalışmanın en güçlü sonucu, “sentetik katılımcılar insanlarla aynıdır” değildir. Daha savunulabilir sonuç, silikon örneklemenin geçerliliğinin kullanılan istem, model, araştırma bağlamı ve yapılmak istenen bilimsel çıkarımın derinliğine bağlı olduğudur.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir