

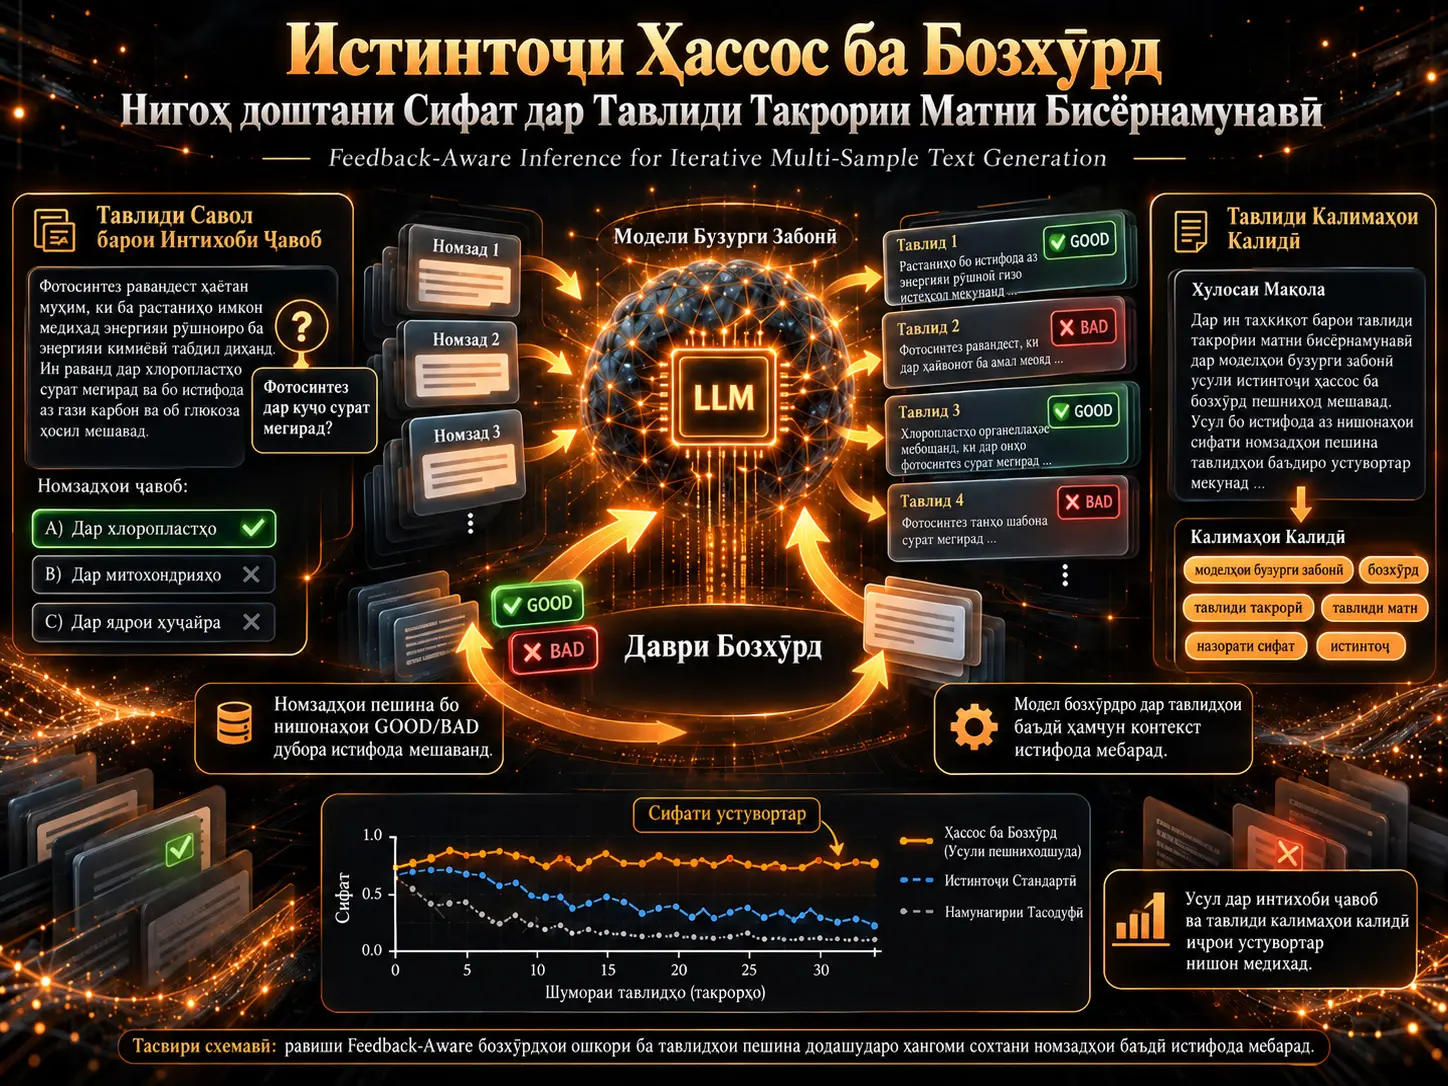
Истинтоҷи Ҳассос ба Бозхӯрд (Feedback-Aware Inference, FA), чаҳорчӯбаи истинтоҷест, ки ба модели забонӣ имкон медиҳад ҳангоми тавлиди чанд номзади матнӣ барои як контекст, нишонаҳои возеҳи сифатро, ки ба номзадҳои қаблӣ дода шудаанд, ба контексти тавлидҳои нав илова карда, такмили такрориро анҷом диҳад. Дар таҳқиқот Llama-3 8B ҳамчун модели асосӣ истифода шуда, моделҳо бо LoRA fine-tune карда шудаанд ва усул дар ду вазифаи гуногуни тавлиди бисёрнамунавӣ санҷида шудааст: интихоби порчаи ҷавоб барои тавлиди савол ва тавлиди калимаҳои калидӣ аз матнҳои илмӣ. Равиши Feedback-Aware, махсусан бо зиёд шудани шумораи намунаҳои тавлидшуда, сифатро нисбат ба Single Sequence Generation, All Sequences Generation, All Sequences Generation with Resulting Content ва baseline-и GPT-4o-и истифодашуда дар таҳқиқот устувортар нигоҳ доштааст. Ин натиҷаҳо танҳо барои ду вазифаи омӯхташуда, як модели асосии 8B ва системаҳои нишонагузории истифодашуда нишон дода шудаанд; ҳанӯз исбот нашудааст, ки усул дар ҳамаи вазифаҳои тавлидӣ, ҳамаи миқёсҳои модел ё ҳамаи намудҳои бозхӯрд ҳамин бартариро нишон медиҳад.
Хусусияти фарқкунандаи усул дар он аст, ки бозхӯрд на ҳамчун навсозии нави параметр, балки ҳамчун сигнали сохторёфтае истифода мешавад, ки ба таърихи prompt-и қадами навбатии истинтоҷ илова мегардад. Модел тавлидҳои қаблӣ ва нишонаҳои GOOD ё BAD-и онҳоро мебинад; сипас бо ҳадафи GOOD будани номзади навбатӣ тавлиди нав анҷом медиҳад. Дар вазифаҳои мураккаб инчунин модули ихтиёрии Resulting Content Generator (RCG) истифода шуда метавонад. RCG муҳтавои иловагиеро, ки номзади тавлидшуда ба вуҷуд меорад, месозад; масалан, дар вазифаи интихоби порчаи ҷавоб аз ҷавоби интихобшуда савол месозад ва системаи нишонагузорӣ метавонад ҳам ҷавоб ва ҳам ин саволро якҷоя арзёбӣ кунад.
Манбаи бозхӯрди истифодашуда дар таҷрибаҳо вобаста ба вазифа тағйир меёбад. Дар интихоби ҷавоб барои тавлиди савол сифат тавассути занҷири арзёбие муайян мешавад, ки моделҳои худкори QGen ва QAns месозанд. Дар тавлиди калимаҳои калидӣ бошад, калимаҳои калидие, ки муаллифони мақола дар маҷмӯи додаҳои KP20K интихоб кардаанд, ҳамчун намунаҳои GOOD истифода мешаванд; намунаҳои муқобили BAD аз калимаҳои калидии монанд, вале дар аннотатсияи хулосаи дахлдор мавҷуднабуда сохта мешаванд. Ҳамин тавр, таҳқиқот мехоҳад нишон диҳад, ки як меъмории истинтоҷ метавонад ҳам бо бозхӯрди ҳосилшуда аз арзёбии худкори proxy ва ҳам аз курасияи инсонӣ истифода шавад.
Муқоисаҳои оморӣ нишон медиҳанд, ки бартарии усул махсусан ҳангоми тавлиди шумораи зиёди номзадҳо қавитар мешавад. Дар вазифаи саволу ҷавоб фарқи байни FA ва SSG дар қиматҳои хурди K аҳамиятнок нест, аммо дар K=20 ва K=25 равшан мешавад. Дар вазифаи калимаҳои калидии KP20K фарқи FA нисбат ба SSG ва baseline-и GPT-4o-и таҳқиқот дар ҳамаи қиматҳои K-и гузоришшуда аҳамиятнок аст; фарқ бо ASG дар K=1 ва K=3 аҳамиятнок нест, вале дар K=5 ва K=10 аҳамиятнок мешавад. Ин намуна нишон медиҳад, ки арзиши асосии усул бештар дар нигоҳ доштани сифат ва гуногунӣ бо афзоиши шумораи намунаҳо барои муддати дарозтар аст, на дар “ҳатман беҳтарин сохтани намунаи аввал”.
Истинтоҷи Ҳассос ба Бозхӯрд Чист?
Истинтоҷи ҳассос ба бозхӯрд чаҳорчӯбаи тавлиди бисёрнамунавиест, ки нишонаҳои дискретии сифати тавлидҳои қаблӣ, ба мисли GOOD/BAD, ва дар ҳолати зарурӣ муҳтавои иловагии аз ин тавлидҳо ҳосилшударо ба таърихи prompt илова карда, номзади матнии навбатиро роҳнамоӣ мекунад ва дар вақти истинтоҷи такрорӣ пас аз омӯзиш кор мекунад.
Мушкилоти тавлиди якдафъаина
Бисёр вазифаҳои коркарди забони табиӣ як ҷавоби ягонаи дуруст надоранд. Агар аз матн савол сохта шавад, қисмҳои гуногун метавонанд ба ҷуфтҳои пурмаънои саволу ҷавоб табдил ёбанд; барои хулосаи илмӣ низ чанд калимаи калидии дуруст интихоб шуда метавонад. Тавлиди як пайдарпаӣ танҳо қисми хурди ин фазои ҳалҳоро фаро мегирад.
Дархости шумораи зиёди намунаҳои мустақил аз модел барои як контекст метавонад гуногуниро зиёд кунад; аммо агар модел он чизеро, ки пештар тавлид кардааст, ё кадом намунаҳо бад қабул шудаанд, ба ҳисоб нагирад, сифати намунаҳои нав метавонад тадриҷан коҳиш ёбад, такрорҳо пайдо шаванд ва раванд ба минтақаҳои камтар муфиди ҳавзи номзадҳо гузарад.
Мушкиле, ки равиши Feedback-Aware ҳадаф мегирад, маҳз ҳамин аст: табдил додани тавлидҳои қаблӣ ба қисми контексти истинтоҷ, то модел ҳангоми тавлиди навбатӣ ҳам аз номзадҳои қабулшуда ва ҳам аз номзадҳои радшуда истифода барад.
Равиши Feedback-Aware аз RLHF ва DPO чӣ фарқ дорад?
Усулҳои оптимизатсияи афзалият, ба мисли RLHF ва DPO, ба мутобиқ кардани параметрҳои модел бо сигналҳои инсонӣ ё афзалиятӣ дар марҳилаи омӯзиш тамаркуз мекунанд. Feedback-Aware Inference бошад, бозхӯрдеро, ки ҳангоми иҷрои вазифа пайдо мешавад, мустақиман ба контексти истинтоҷ интиқол медиҳад.
Ин фарқ маънои онро надорад, ки модели Feedback-Aware умуман омӯзонида намешавад. Барои он ки модел тарзи тафсири таърихи GOOD/BAD-ро омӯзад, он бо prompt-ҳои монанд ба ҳамин сохтор fine-tune карда мешавад. Фарқ дар он аст, ки бо омадани ҳар бозхӯрди нав оптимизатсияи дубораи параметрҳо талаб намешавад; бозхӯрди нав ба prompt-и навбатӣ илова мегардад.
Усул инчунин аз равиши self-refinement-и моделҳои калони гуфтугӯӣ, ки бо танқидҳои озодшакли забони табиӣ анҷом дода мешавад, фарқ мекунад. Бозхӯрд дар ин ҷо ҳатман матни дарози танқидӣ нест; дар таҷрибаҳо шакли асосии он нишонаи дуӣ GOOD/BAD аст.
Се шарти татбиқпазирии чаҳорчӯба
Манбаъ барои Feedback-Aware Inference се шарти ҳудудиро муайян мекунад. Дар вазифа бояд сигнали дискретии бозхӯрде мавҷуд бошад, ки омӯхта шавад; бояд инсон ё Labeling System-и худкоре бошад, ки ин нишонаро тавлид карда тавонад; инчунин вазифа бояд аз тавлиди якчанд номзади хуби гуногун бештар аз як баромади ягона манфиат гирад.
Расми 1: чаро омӯзиш ва истинтоҷ ду марҳилаи ҷудогонаанд?
Расми 1 дар саҳифаи 5-и таҳқиқоти манбаъ ду ҷараёни додаҳоро аз ҳам ҷудо мекунад. Дар тарафи омӯзиш аз контекстҳои додаҳо пайдарпаии номзадҳо сохта мешавад, Labeling System ба онҳо нишонаи сифат медиҳад ва намунаҳои нишонагузоришуда барои fine-tune кардани Feedback-Aware Model истифода мешаванд.
Дар тарафи истинтоҷ prompt-и оғозӣ танҳо аз тавсифи вазифа ва контекст иборат аст. Модел як номзад месозад. Номзад аз ҷониби Labeling System арзёбӣ мешавад. Нишона ва номзад, дар ҳолати зарурӣ ҳамроҳ бо муҳтавои иловагии RCG, ба таърих илова мешаванд. Тавлиди навбатӣ ин контексти васеъшударо мебинад. Ҳамин тавр, истинтоҷ аз як мувофиқати яксамтаи “prompt → ҷавоб” берун рафта, ба даври тавлид → арзёбӣ → навсозии таърих → тавлиди нав табдил меёбад.
Labeling System чист?
Labeling System (LS) ҷузъи арзёбии махсуси вазифа аст, ки барои пайдарпаии тавлидшудаи \(g\) нишонаи сифат бармегардонад:
\[ LS(g)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
Маънои илмии нишонаҳои GOOD ва BAD собит нест. Дурустии грамматикӣ, мувофиқати контекстӣ, имконпазирии тавлиди савол, қудрати намояндагии мавзуъ ё меъёрҳои дигари махсуси вазифа истифода шуда метавонанд. Механизми умумии чаҳорчӯбаи Feedback-Aware ба як метрикаи мушаххаси сифат вобаста нест; аммо иҷрои воқеии он ба сифати Labeling System-и истифодашуда вобаста аст.
Resulting Content Generator чӣ кор мекунад?
Дар баъзе вазифаҳо танҳо ба худи номзади тавлидшуда нигоҳ кардан барои муайян кардани сифат кофӣ нест. Дар ин ҳолат Resulting Content Generator (RCG) баромади иловагиеро, ки номзад ба вуҷуд меорад, тавлид мекунад ва LS метавонад қарорро бар асоси ду вуруд қабул кунад:
\[ LS\left(g,RCG(g)\right)\in\{\mathrm{GOOD},\mathrm{BAD}\}. \]
Дар вазифаи интихоби ҷавоби таҳқиқот \(g\) порчаи ҷавоби интихобшуда аст; нақши RCG-ро QGen иҷро карда, аз ин порча савол месозад. Ҳамин тавр, система ба ҷойи саволи “оё ин порчаи матн аз назари сатҳӣ қобили қабул менамояд?” ба саволи “оё аз ин порча саволи ба контекст асосёфта ва ҷавобпазир сохтан мумкин аст?” наздик мешавад.
Нишонаҳои GOOD/BAD Моделро Ҳангоми Истинтоҷ Чӣ Гуна Роҳнамоӣ Мекунанд?
Нишонаҳои GOOD/BAD ҳамроҳ бо номзадҳои қаблӣ дар таърихи prompt нигоҳ дошта мешаванд; Feedback-Aware Model ҳангоми тавлиди нав мебинад, ки кадом намудҳои намунаҳо дар дохили контекст қабул ё рад шудаанд ва номзади навбатиро ба ин таърих шартӣ мекунад, аммо ҳангоми истинтоҷ вазнҳои модел дубора нав карда намешаванд.
Сохтори додаҳои омӯзишӣ
Маҷмӯи додаҳои оғозӣ аз контекстҳо иборат аст:
\[ D_{\mathrm{initial}}=[C_1,C_2,\ldots,C_n]. \]
Барои ҳар контексти \(C_i\) чанд пайдарпаии номзад:
\[ [g_{i,1},g_{i,2},\ldots,g_{i,m}] \]
ва нишонаҳои сифати мувофиқ ба онҳо:
\[ [LS(g_{i,1}),LS(g_{i,2}),\ldots,LS(g_{i,m})] \]
сохта мешаванд. Мавҷуд будани ҳам намунаҳои GOOD ва ҳам BAD барои як контекст муҳим аст, то модел ба ҷойи танҳо азбар кардани шакли намунаҳои мусбат, маънои ду синфи сифатро дар дохили prompt омӯзад.
Сохтори таърихи prompt
Дар Расми 2-и саҳифаи 7-и манбаъ қолаби умумӣ аз тавсифи вазифа, контекст ва таърихи пайдарпай иборат аст. Ҳар сатри таърих як нишонаи сифат ва пайдарпаии қаблан тавлидшударо дар бар мегирад; агар вазифа талаб кунад resulting content низ ба ҳамон сатр илова мешавад.
Ҳангоми омӯзиш loss барои тамоми prompt ҳисоб карда намешавад. Модел танҳо барои пешгӯии token-ҳои пайдарпаии ҳадафии GOOD дар охири қолаб оптимизатсия мешавад. Намунаҳои қаблии GOOD/BAD ва resulting content бошад, нақши контексти шартиро иҷро мекунанд.
Мантиқи даври истинтоҷ
Ҷараёни функсионалии Algorithm 1-и манбаъро чунин ҷамъбаст кардан мумкин аст: prompt-и оғозӣ сохта мешавад; модел кӯшиш мекунад номзади GOOD созад; номзад ва, агар бошад, resulting content аз ҷониби LS арзёбӣ мешаванд; GOOD будан ё набудани номзад сабт мешавад; сипас нишона, номзад ва муҳтавои иловагӣ ба таърихи prompt илова шуда, даври нав оғоз мегардад.
Шарти қатъ қисми собити чаҳорчӯба нест. Манбаъ расидан ба шумораи ҳадафии намунаҳои қабулшуда, дидани шумораи муайяни натиҷаҳои пайдарпайи BAD ё тамом шудани ҳавзи номзадҳои эътиборнокро ҳамчун қоидаҳои эҳтимолии қатъ пешниҳод мекунад.
Чаро усули Feedback-Aware аз best-of-N фарқ мекунад?
Дар равиши Best-of-N аз як тақсимоти шартии собит шумораи зиёди намунаҳои мустақил тавлид шуда, намунаи дорои холҳои баландтарин интихоб мегардад. Дар равиши Feedback-Aware тақсимоти тавлиди \(t+1\) метавонад аз сабаби дубора ба prompt илова шудани тавлиди \(t\) ва тавлидҳои қаблӣ тағйир ёбад. Аз ин рӯ, номзади қаблӣ на танҳо дар марҳилаи интихоб, балки дар шартӣ кардани тавлиди навбатӣ низ нақш дорад.
Усул ва Натиҷаҳои Таҳқиқот
Усулҳои муқоисашуда
| Усул | Шакли асосии кор | Огоҳӣ аз тавлидҳои қаблӣ |
|---|---|---|
| Feedback-Aware (FA) | Тавлиди такрорӣ бо илова кардани номзадҳои қаблӣ ба prompt бо нишонаҳои GOOD/BAD | Бале; бо нишонаи возеҳи сифат |
| Single Sequence Generation (SSG) | Fine-tuning барои тавлиди як номзади GOOD аз контекст; намунагирии бисёркарата дар истинтоҷ | Не |
| All Sequences Generation (ASG) | Fine-tuning барои якҷоя тавлид кардани пайдарпаии GOOD-и як контекст | Сохтори рӯйхати тавлидшуда мавҷуд аст; нишонаи feedback-и GOOD/BAD нест |
| ASG-RC | Ба сохтори ASG маълумоти resulting content-и қаблиро илова мекунад | Таърихи муҳтаво ҳаст; нишонаи GOOD/BAD нест |
| GPT-4o | Тавлиди рӯйхат бо one-shot prompt, ки вазифа ва як намунаи омӯзиширо дар бар мегирад | Дар танзими таҳқиқот даври такрории feedback вуҷуд надорад |
Модел ва танзимоти омӯзиш
Асоси моделҳои FA, SSG, ASG ва ASG-RC Llama-3 8B аст. Fine-tuning бо LoRA дар матритсаҳои projection-и қабатҳои attention анҷом дода шудааст. Ҳамаи равандҳои fine-tuning ва inference-и таҷрибаҳои асосӣ дар як NVIDIA A100 80 GB GPU иҷро шудаанд.
| Марҳила | Параметр | Қимат |
|---|---|---|
| Омӯзиш | Модели асосӣ | Llama-3 8B |
| Омӯзиш | Fine-tuning | LoRA; матритсаҳои attention projection |
| Омӯзиш | Optimizer | AdamW-8bit |
| Омӯзиш | Learning rate | \(1\times10^{-5}\) |
| Омӯзиш | Batch size | 64; бо gradient accumulation |
| Омӯзиш | Precision | FP16 |
| QGen/QAns | Precision | BF16 |
| Истинтоҷ | Decoding | Nucleus sampling |
| Истинтоҷ | Top-k | 20 |
| Истинтоҷ | Top-p | 0,8 |
| Ҳама | Random seed | 42 |
| GPT-4o | Танзимот | Танзимоти пешфарз |
Дар тавлиди такрории FA, ASG ва ASG-RC дар ҳар давр 10 намуна сохта шуда, номзади дорои баландтарин қимати log-likelihood интихоб шудааст. Барои SSG 100 намуна тавлид шуда, такрорҳо хориҷ ва 25 номзади боло нигоҳ дошта шудаанд.
Вазифаи 1: интихоби порчаи ҷавоб барои тавлиди савол
Дар ин вазифа модел аз матни додашуда чанд порчаи ҷавоберо интихоб мекунад, ки барои тавлиди савол мувофиқанд. Барои арзёбии сифат ду модели ёрирасон истифода мешаванд:
| Модел | Вазифа |
|---|---|
| QGen | Тавлиди савол аз контекст ва порчаи ҷавоби интихобшуда |
| QAns | Кӯшиши ҷавоб додан ба саволи тавлидшуда аз рӯйи контекст |
QGen ва QAns дар SQuAD, HotpotQA ва NarrativeQA алоҳида бо supervised fine-tuning омода шудаанд; FairytaleQA бе ворид шудан ба омӯзиши модел ҳамчун санҷиши умумӣ истифода шудааст.
| Маҷмӯи додаҳо | QGen | QAns |
|---|---|---|
| SQuAD | 0,58 | 0,75 |
| HotpotQA | 0,50 | 0,50 |
| NarrativeQA | 0,54 | 0,60 |
| FairytaleQA | 0,51 | 0,45 |
Порчаи ҷавоб кай GOOD ҳисобида мешавад?
Барои ҷавоби интихобшудаи \(a\) аввал:
\[ q=QGen(ctx,a) \]
савол тавлид мешавад. Сипас эҳтимоли он ки модели QAns ҳангоми дода шудани контекст ва савол ҷавоби \(a\)-ро тавлид кунад, бояд аз ҳадди %3-и дар манбаъ ба таври эмпирикӣ интихобшуда гузарад:
\[ P(QAns(ctx,q)=a)\geq0.03. \]
Ин ҳад бар асоси тақсимоти эҳтимолҳои ҷавоби дуруст дар маҷмӯи додаҳои омӯзишӣ интихоб шудааст.
Шарти дуюм ҳадаф дорад, ки савол воқеан ба контекст вобаста бошад. Эҳтимоли тавлиди ҷавоб аз ҷониби модел бе контекст набояд аз эҳтимоли он ҳангоми дода шудани контекст калонтар бошад:
\[ \frac{P(QAns("",q)=a)} {P(QAns(ctx,q)=a)} \leq1. \]
Эҳтимоли умумии пайдарпаии ҷавоб бо табдили экспоненсиалии ҷамъбасти log-эҳтимолҳои token ҳисоб карда мешавад:
\[ P(QAns(ctx,q)=a) = e^{ \sum_i \log P(a_i\mid ctx,q,a_{0:i-1}) }. \]
Ин меъёрҳо ҳадаф доранд, ки ҷавоби интихобшуда на танҳо калимаи тасодуфии дар матн дидашаванда, балки муҳтавое бошад, ки бар асоси контекст ҷуфти пурмаънои саволу ҷавоб сохта тавонад.
Маҷмӯи додаҳои интихоби ҷавоб
| Маҷмӯи додаҳо | Омӯзиш | Валидатсия | Санҷиш |
|---|---|---|---|
| TASA | 10.000 | 1.000 | 1.000 |
| FairytaleQA | 8.548 | 1.025 | 1.007 |
Ҳавзи манбаи TASA зиёда аз 60.000 порчаи матнро дар бар мегирад. Дар таҳқиқот аз соҳаҳое мисли забон ва санъат, тандурустӣ, илм, санъатҳои саноатӣ, иқтисод, тиҷорат ва илмҳои иҷтимоӣ намуна гирифта шудааст. FairytaleQA бошад, додаҳои саволу ҷавобро дар бар мегирад, ки мутахассисон аз ривоятҳои муносиб барои кӯдакон омода кардаанд.
Барои омӯзиш порчаҳои эҳтимолии ҷавоб аз гиреҳҳои дарахти constituency parse-и ҳар ҷумла гирифта шудаанд. Барои ҳар номзад QGen савол тавлид карда, номзад сипас аз ҷониби LS ҳамчун GOOD ё BAD нишонагузорӣ шудааст.
Вазифаи 2: тавлиди калимаҳои калидӣ
Тавлиди калимаҳои калидӣ дар маҷмӯи додаҳои KP20K арзёбӣ шудааст. KP20K тақрибан 500.000 хулосаи мақолаи илмӣ ва калимаҳои калидии интихобкардаи муаллифонро дар бар мегирад. Таҳқиқот аз ин ҳавз 50.000 намунаи омӯзишӣ, 2.000 валидатсионӣ ва 2.000 санҷиширо интихоб кардааст.
Калимаҳои калидие, ки муаллифон барои хулосаи дахлдор муайян кардаанд, GOOD ҳисоб шудаанд. Азбаски дар маҷмӯи додаҳо аннотатсияи мустақими BAD вуҷуд надошт, намунаҳои манфӣ ба таври сунъӣ сохта шудаанд. Калимаҳои калидие интихоб шудаанд, ки ба мақолаҳои дигар тааллуқ доранд, вале дар фазои embedding бо хулосаи ҳадаф монандии баланд доранд ва ҳамзамон дар рӯйхати GOOD-и хулосаи ҳадаф нестанд.
Барои ҳисоб кардани монандӣ sentence-transformers/all-mpnet-base-v2 модели encoder истифода шудааст. Барои ҳар хулоса ба миқдори калимаҳои калидии GOOD намунаҳои BAD интихоб шуда, кӯшиш шудааст намунаҳои манфии душвортар ва муқоисавӣ сохта шаванд.
Метрикаҳои арзёбӣ
Барои интихоби ҷавоб Precision@K истифода мешавад:
\[ P@K= \frac{\text{ilk }K\text{ aday içindeki GOOD sayısı}}{K}. \]
\(K\) дар ин ҷо гиперпараметри танзимшавандаи алгоритм нест, балки уфуқи арзёбӣ аст. Натиҷаҳои интихоби ҷавоб то \(K=25\) гузориш шудаанд.
Дар тавлиди калимаҳои калидӣ F1@K истифода шуда, арзёбӣ то \(K=10\) идома ёфтааст. Манбаъ ин ҳадро бо зикри он асоснок мекунад, ки қимати 95-персентилии шумораи калимаҳои калидии GOOD дар KP20K ба 10 баробар аст.
Чаро Бартарии Усул Бо Афзоиши K Равшантар Мешавад?
Бартарии усули Feedback-Aware бо афзоиши K равшантар мешавад, зеро модел бо дидани тавлидҳои қаблии GOOD ва BAD метавонад аз такрорҳо ва номзадҳои пастсифат беҳтар канорагирӣ кунад, дар ҳоле ки усулҳое мисли SSG дар ҳар тавлиди нав аз номзадҳои қаблӣ бехабаранд; аз ин рӯ усулҳое, ки дар намунаи аввал рақобатпазиранд, метавонанд дар рӯйхатҳои дарози номзадҳо сифатро зудтар аз даст диҳанд.
Паёми илмии Расми 4
Дар Расми 4a-и манбаъ каҷҳои Precision@K-и интихоби ҷавоб бо афзоиши K дар маҷмуъ ба поён майл мекунанд. Сабаб дар он аст, ки ҳавзи ҷавобҳои эътиборнок тадриҷан тамом мешавад. SSG дар оғоз қавӣ аст, вале зудтар коҳиш меёбад. ASG бартарии дидани муҳтавои рӯйхати қаблиро дорад, аммо аз равиши Feedback-Aware ақиб мемонад. ASG-RC яке аз baseline-ҳои қавитарин дар вазифаи интихоби ҷавоб аст; саволҳое, ки resulting content мебошанд, ба модел контексти иловагӣ медиҳанд, аммо азбаски сигнали сифати GOOD/BAD вуҷуд надорад, он мисли FA устувор нест.
Дар Расми 4b каҷҳои F1@K-и калимаҳои калидӣ аввал боло мераванд, тақрибан дар қиматҳои миёнаи K ба авҷ мерасанд ва баъд коҳиш меёбанд. Тавзеҳи манбаъ ин аст, ки ин шакл танҳо аз бад шудани рафтори модел ба вуҷуд намеояд. Дар K-и хурд, азбаски ҳанӯз калимаҳои калидии воқеии кофӣ тавлид нашудаанд, recall маҳдудкунанда аст; вақте K аз ҳавзи калимаҳои калидии воқеӣ мегузарад, тавлидҳои иловагӣ аз синфи BAD меоянд ва талафи precision F1-ро поён мебарад.
Натиҷаҳои омории гузоришшуда зери унвони FairytaleQA
| K | Baseline | Mean Δ | p-и бо Holm ислоҳшуда | Аҳамиятнокии манбаъ |
|---|---|---|---|---|
| 1 | SSG | +0,0005 | \(9.70\times10^{-1}\) | Аҳамиятнок нест |
| 1 | ASG | +0,0812 | \(8.39\times10^{-8}\) | *** |
| 1 | ASG-RC | +0,0244 | \(1.62\times10^{-1}\) | Аҳамиятнок нест |
| 1 | GPT-4o | +0,1340 | \(1.49\times10^{-17}\) | *** |
| 10 | SSG | −0,0001 | \(9.44\times10^{-1}\) | Аҳамиятнок нест |
| 10 | ASG | +0,0496 | \(1.19\times10^{-34}\) | *** |
| 10 | ASG-RC | +0,0125 | \(1.74\times10^{-3}\) | ** |
| 10 | GPT-4o | +0,2520 | \(1.44\times10^{-192}\) | *** |
| 20 | SSG | +0,0517 | \(5.85\times10^{-71}\) | *** |
| 20 | ASG | +0,0633 | \(1.52\times10^{-96}\) | *** |
| 20 | ASG-RC | +0,0376 | \(4.52\times10^{-43}\) | *** |
| 20 | GPT-4o | +0,2841 | \(2.76\times10^{-271}\) | *** |
| 25 | SSG | +0,1104 | \(1.04\times10^{-227}\) | *** |
| 25 | ASG | +0,0632 | \(2.55\times10^{-105}\) | *** |
| 25 | ASG-RC | +0,0529 | \(4.20\times10^{-88}\) | *** |
| 25 | GPT-4o | +0,2828 | \(3.18\times10^{-292}\) | *** |
Паёми асосии санҷиши оморӣ ин аст, ки ҳарчанд SSG дар K=1 ва K=10 амалан метавонад дар сатҳи FA бошад, дар K=20 ва K=25 ба таври равшан ақиб мемонад. Ин натиҷа даъвои “FA дар намунаи аввал ҳамеша беҳтар аст”-ро дастгирӣ намекунад; даъвои “бо дароз шудани тавлиди бисёрнамунавӣ FA сифатро беҳтар нигоҳ медорад”-ро дастгирӣ мекунад.
Натиҷаҳои оморӣ дар тавлиди калимаҳои калидии KP20K
| K | Baseline | Mean Δ | p-и бо Holm ислоҳшуда | Аҳамиятнокии манбаъ |
|---|---|---|---|---|
| 1 | SSG | +0,0651 | \(2.76\times10^{-6}\) | *** |
| 1 | ASG | −0,0160 | \(2.59\times10^{-1}\) | Аҳамиятнок нест |
| 1 | GPT-4o | +0,1431 | \(1.41\times10^{-20}\) | *** |
| 3 | SSG | +0,0607 | \(2.90\times10^{-22}\) | *** |
| 3 | ASG | +0,0118 | \(9.45\times10^{-2}\) | Аҳамиятнок нест |
| 3 | GPT-4o | +0,1612 | \(1.12\times10^{-86}\) | *** |
| 5 | SSG | +0,0435 | \(6.47\times10^{-24}\) | *** |
| 5 | ASG | +0,0218 | \(1.33\times10^{-5}\) | *** |
| 5 | GPT-4o | +0,1309 | \(1.99\times10^{-107}\) | *** |
| 10 | SSG | +0,0351 | \(6.94\times10^{-46}\) | *** |
| 10 | ASG | +0,0262 | \(4.69\times10^{-16}\) | *** |
| 10 | GPT-4o | +0,0764 | \(7.48\times10^{-104}\) | *** |
Дар ин ҷо ASG дар K=1 аз ҷиҳати рақамӣ F1-и каме баландтар аз FA тавлид кардааст; Mean Δ-и −0,0160 инро нишон медиҳад ва фарқ аз ҷиҳати оморӣ аҳамиятнок нест. Дар K=3 фарқи хурд ба фоидаи FA низ аҳамиятнок нест. Бартарии омории FA нисбат ба ASG дар K=5 ва K=10 зоҳир мешавад.
Усули оморӣ
Тартиби асосӣ санҷиши дуҷонибаи Wilcoxon signed-rank мебошад, ки натиҷаҳои усулҳоро дар ҳамон контекст ҷуфт мекунад. Манбаъ ин санҷишро интихоб кардааст, зеро Precision@K ва F1@K дар фосилаи [0,1] маҳдуданд ва махсусан дар K-и хурд хусусияти дискретӣ/non-normal нишон медиҳанд.
Барои муқоисаҳои сершумор дар дохили ҳар K, сатҳи хатои оилавӣ бо ислоҳи Holm–Bonferroni дар \(\alpha=0.05\) назорат шудааст. Илова бар ин, paired t-test ва paired bootstrap бо 10.000 бознамунагирӣ барои фарқи миёна татбиқ шудаанд; манбаъ гузориш медиҳад, ки дар ҳамаи қиматҳои K ҳамон тафсири омории натиҷаи асосии Wilcoxon ба даст омадааст.
Намунаҳои сифатӣ чиро нишон медиҳанд?
Ҷадвали 5-и манбаъ мисолеро пешниҳод мекунад, ки дар он модели Feedback-Aware дар панҷ тавлиди аввал чор ҷавоби GOOD-и марбут ба самтҳои гуногуни семантикӣ, ба мисли “happy”, “vivid”, “lion” ва “personification”, тавлид карда тавонистааст ва танҳо номзади панҷум BAD будааст. Дар ҳамон контекст баъзе baseline-ҳо зудтар ба номзадҳои пастсифат ё ба ҳам монанд мегузаранд.
Дар мисоли калимаҳои калидии Ҷадвали 6, FA пай дар пай “productivity”, “knowledge workers”, “performance indicators”, “experts” ва “management”-ро тавлид мекунад; саввуми онҳо мувофиқи нишонаҳои манбаъ BAD ва чортои дигар GOOD мебошанд. Дар baseline-ҳо нишон дода мешавад, ки дар тавлидҳои баъдӣ номзадҳои номарбут ё такрорӣ бештар пайдо мешаванд.
Манбаъ дар ҷадвалҳои сифатӣ нишонаи REPEATED -ро барои намоён кардани тавлиде истифода кардааст, ки аз ҷиҳати семантикӣ бо номзади қаблан тавлидшуда баробар аст. Ин нишона дар арзёбии миқдорӣ синфи нави сифат нест; такрорҳои дақиқ пеш аз ҳисоб кардани метрика хориҷ карда мешаванд.
Таҷрибаи ORPO alignment
Мавҷуд будани намунаҳои GOOD ва BAD муҳаққиқонро водор кардааст, ки усули preference alignment-и ORPO-ро низ ҷудогона санҷанд. ORPO байни ҷавобҳои интихобшуда ва радшуда ҷазои бар асоси odds-ratio-ро истифода мебарад. Дар таҷриба:
\[ \beta=0.3 \]
танзим шуда, шартҳои дигари омӯзиш бо тартиби supervised fine-tuning яксон нигоҳ дошта шудаанд.
Мувофиқи Figure 5-и манбаъ, версияи ORPO-и модели Feedback-Aware ва версияи стандартии SFT рафтори монанд нишон медиҳанд. Дар SSG, ORPO метавонад дар намунаҳои аввали интихоби ҷавоб фоида расонад, вале бо афзоиши K precision тезтар коҳиш меёбад. Дар вазифаи калимаҳои калидӣ SSG-ORPO аз оғоз иҷрои пасттар нишон додааст.
Тафсири муаллифон ин аст, ки оптимизатсияи афзалияти дуӣ метавонад фазои номзадҳоро дар меҳвари GOOD/BAD сахттар қутбӣ кунад ва ин дар тавлиди бисёрнамунавӣ, ки гуногунӣ мехоҳад, нуқсон эҷод кунад. Ин таҷриба нишон намедиҳад, ки ORPO умуман усули бади alignment аст; танҳо рафтори онро дар вазифаҳои бисёртавлидии омӯхташуда нишон медиҳад.
Ҳолатҳои хато
Манбаъ се механизми асосии хатогиро таъкид мекунад. Аввал, агар Labeling System заиф ё ба таври систематикӣ ғаразнок бошад, азбаски нишонаҳои нодуруст ба prompt-и навбатӣ илова мешаванд, хато метавонад ба ҷойи ислоҳ шудан дар тӯли итератсияҳо тақвият ёбад.
Дуюм, азбаски ҳар тавлид ва нишона ба таърихи prompt илова мешавад, дарозии контекст бо шумораи итератсияҳо меафзояд. Ин ҳолат хатари context saturation ва арзиши истинтоҷро зиёд мекунад.
Сеюм, агар барои контексти муайян шумораи номзадҳои воқеан хуб маҳдуд бошад, модел дар як нуқта ҳавзи GOOD-ро тамом мекунад. Аз ин рӯ, ҳатто дар беҳтарин усул ҳам коҳиши метрика дар қиматҳои баланди K пурра бартараф карда намешавад.
Маҳдудиятҳои методологии таҳқиқот
Ҷустуҷӯи гиперпараметрҳо бинобар арзиши ҳисоббарорӣ қасдан маҳдуд нигоҳ дошта шудааст. Гарчанде барои адолати муқоиса дар модели асосӣ ва baseline-ҳо танзимоти умумии омӯзиш/decoding истифода шудаанд, танзими оптималии ҳар усул ҷудогона таҳқиқ нашудааст.
Framework барои омӯзиш ба намунаҳои манфӣ ниёз дорад. Дар маҷмӯи додаҳо, ба мисли KP20K, ки танҳо аннотатсияи мусбат доранд, намунаҳои BAD бояд алоҳида сохта шаванд; агар намунаҳои манфӣ аз ҳад осон интихоб шаванд, модел метавонад фарқи GOOD/BAD-ро сатҳӣ омӯзад.
Иҷроиш ба сифати Labeling System вобаста аст. Гарчанде мушоҳидаи FairytaleQA дар таҳқиқот ба мавҷуд будани як андоза устуворӣ ба нуқсони миёнаи нишонагузорӣ ишора мекунад, таҷрибаи систематикии robustness бо сатҳҳои назоратшаванда ва афзояндаи садо анҷом дода нашудааст.
Раванди такрорӣ нисбат ба моделҳои якгузар арзиши иловагии истинтоҷ меорад: шумораи бештари даъватҳои generation, даъватҳои Labeling System ва таърихи prompt, ки бо итератсия хаттӣ меафзояд. Мақола wall-clock latency, throughput ва профилҳои хотираи GPU-ро барои муҳити истеҳсолӣ ҳамчун benchmark-и муфассал пешниҳод накардааст.
Бозхӯрди таҷрибавӣ танҳо дар шакли binary GOOD/BAD аст. Гарчанде Framework аз ҷиҳати консептуалӣ сохтори бойтари нишонаҳоро дастгирӣ мекунад, бозхӯрди дараҷабандишуда ё бисёрченака ба таври таҷрибавӣ санҷида нашудааст.
Ниҳоят, ҳамаи таҷрибаҳои асосии fine-tuning танҳо дар як модели асосии 8B анҷом дода шудаанд. Ҳанӯз нишон дода нашудааст, ки натиҷаҳоро мустақиман ба моделҳои хеле хурдтар, хеле калонтар ё оилаҳои дигари меъморӣ умумӣ кардан мумкин аст.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
Таҳқиқот дастгирӣ мекунад, ки модели кушодаасоси миқёси 8B, ки ба таври муносиб fine-tune шудааст, бо истифода аз таърихи возеҳи feedback-и GOOD/BAD дар prompt-и истинтоҷ метавонад сифатро дар ду вазифаи омӯхташудаи тавлиди бисёрматнӣ дар тӯли итератсияҳо нисбат ба baseline-ҳои қавӣ устувортар нигоҳ дорад.
Натиҷаҳои оморӣ дастгирӣ мекунанд, ки махсусан дар режими K-и баланд фарқҳо ба фоидаи равиши Feedback-Aware калон мешаванд. Ин натиҷа бо сенарияҳои oversampling дар технологияҳои таълимӣ, ба мисли шумораи зиёди номзадҳои савол, ҳавзҳои васеи бандҳои арзёбӣ ё номзадҳои калимаҳои калидие, ки баъдтар филтр мешаванд, мувофиқ аст.
Таҳқиқот инчунин ду мисол меорад, ки нишон медиҳанд манбаи feedback ба як механизм вобаста нест: моделҳои худкори proxy барои интихоби ҷавоб ва аннотатсияҳои аз ҷониби инсон курацияшуда барои тавлиди калимаҳои калидӣ.
Натиҷаҳое, ки таҳқиқот дастгирӣ намекунад
Таҳқиқот нишон намедиҳад, ки усули Feedback-Aware дар ҳамаи вазифаҳои NLP аз ҳамаи моделҳои калон бартарӣ дорад. Танҳо ду вазифа ва як оилаи асосии модели 8B арзёбӣ шудаанд.
Иҷрои пасти baseline-и GPT-4o нишон намедиҳад, ки қобилияти умумии модели GPT-4o аз Llama-3 8B пасттар аст. Дар таҷриба GPT-4o бо one-shot prompting истифода шудааст, дар ҳоле ки дигар моделҳои асосӣ fine-tuning-и махсуси вазифаро гузаштаанд; бинобар ин натиҷа танҳо ба ҳамин протоколи таҷриба дахл дорад.
Таҳқиқот инчунин нишон намедиҳад, ки feedback ҳамеша хатоҳоро ислоҳ мекунад. Сигнали нодуруст ё ғаразноки LS метавонад дар дохили ҳамон даври feedback хаторо ба тавлидҳои баъдӣ интиқол диҳад.
Хулосаи “моделҳои хурдтар метавонанд ҳамаи қобилиятҳои iterative reasoning-и proprietary LLM-ҳои калонро дар як сатҳ таъмин кунанд” низ аз ҷониби манбаъ исбот нашудааст. Он чизе, ки нишон дода шудааст, ин аст, ки дар ду вазифаи омӯхташудаи бисёртавлидӣ механизми сохторёфтаи feedback дар модели 8B муфид аст.
Номуайяниҳои гузориш дар манбаъ
Гарчанде қисми санҷиши TASA ҳамчун 1000 ва қисми санҷиши FairytaleQA ҳамчун 1007 намуна дода шудааст, Ҷадвали омории 3 бо “FairytaleQA, n=2007” нишонагузорӣ шудааст. Шумораи 2007 ба ҷамъбасти ду қисми санҷиш баробар аст; аммо азбаски манбаъ возеҳ намегӯяд, ки ин таҳлили якҷоя аст, дар ин ҷо танҳо номувофиқатӣ намоён нигоҳ дошта шудааст.
Дар ҳоле ки гуфта шудааст дар KP20K 2000 намунаи санҷишӣ интихоб шудааст, Ҷадвали 4 муқоисаи омориро дар n=1998 контекст гузориш мекунад. Сабаби ба таҳлил ворид нашудани ду намуна дар манбаъ шарҳ дода нашудааст.
Бо вуҷуди он ки равшан гуфта шудааст бахши Keyword Generation аз KP20K истифода мекунад, дар охири контексти намунавии Ҷадвали 6 ибораи манбаи “FairytaleQA dataset entry [15]” мавҷуд аст. Verianla ин манбаъро хомӯшона ба KP20K иваз намекунад.
Самтҳои таҳқиқоти оянда
Муаллифон пешниҳод мекунанд, ки Framework дар доираи васеътари вазифаҳои тавлидӣ, миқёсҳои гуногуни модел ва меъмориҳои гуногун санҷида шавад. Хусусан, таҷрибаҳои назоратшавандаи feedback-noise бо Labeling System-ҳои ба таври синтетикӣ вайроншуда метавонанд устувории моделро ба бозхӯрди нодуруст мустақиман чен кунанд.
Андозагириҳои wall-clock latency, throughput ва хотираи GPU барои муҳити истеҳсолӣ низ аз ниёзҳои муҳими оянда мебошанд; зеро бартарии сифати даври такрории feedback бояд ҳамроҳ бо арзиши иловагии inference арзёбӣ шавад.
Ғайр аз нишонаи binary GOOD/BAD, холҳои дараҷабандишуда ё сохторҳои бисёрченакаи feedback, ки андозаҳои гуногуни сифатро ҷудогона ифода мекунанд, низ метавонанд таҳқиқ шаванд.
Манбаъ дар анҷом татбиқи feedback ба қадамҳои миёнарав дар вазифаҳои бисёрмарҳилагии reasoning, ба мисли ҳалли масъалаҳои математикӣ, истинтоҷи мантиқӣ ё шарҳи илмиро ҳамчун самти эҳтимолии густариш пешниҳод мекунад. Ин истифода дар таҳқиқот ба таври таҷрибавӣ тасдиқ нашудааст.
Ёддошт оид ба Манбаъ ва Усул
Таҳқиқоти аслӣ: Feedback-Aware Inference for Iterative Multi-Sample Text Generation
Муаллифон: Andreea Dutulescu; Stefan Ruseti; Mihai Dascalu; Danielle S. McNamara.
Муаллифи масъул: Stefan Ruseti.
Муассисаҳо: Computer Science and Engineering Department, National University of Science and Technology POLITEHNICA Bucharest, Руминия; Academy of Romanian Scientists, Руминия; Learning Engineering Institute, Arizona State University, ИМА.
Маҷалла: AI.
Ношир: MDPI.
Навъи манбаъ: Мақолаи аслии таҳқиқотии тақризшуда; коркарди забони табиӣ, fine-tuning-и модели забонӣ ва таҷрибаҳои истинтоҷи такрорӣ.
Маълумоти нашр: AI 2026, ҷилд 7, шумора 5, мақола 171.
DOI: 10.3390/ai7050171
Ирсол: 1 апрели 2026.
Бознигарӣ: 8 майи 2026.
Қабул: 12 майи 2026.
Нашр: 15 майи 2026.
Иҷозатнома: Creative Commons Attribution (CC BY), дастрасии кушода.
Маблағгузорӣ: Таҳқиқот аз ҷониби лоиҳаи Romanian Hub for Artificial Intelligence—HRIA дар доираи Smart Growth, Digitization and Financial Instruments Program 2021–2027 бо MySMIS no. 351416; гранти R305T240035, ки U.S. Department of Education Institute of Education Sciences ба Arizona State University додааст; ва гранти Academy of Romanian Scientists AOSR-TEAMS-IV Edition 2025–2026 “Digital Transformation in Science” дастгирӣ шудааст.
Кумитаи институтсионалии ахлоқ: Татбиқ намешавад.
Ризоияти огоҳона: Татбиқ намешавад.
Дастрасӣ ба додаҳо, код ва модел: Муаллифон гузориш медиҳанд, ки додаҳо, код ва моделҳои fine-tune-шудаи таҳқиқотро дар як анбори кушодаи GitHub нашр кардаанд.
Изҳороти истифодаи AI-и тавлидӣ: Муаллифон изҳор мекунанд, ки ҳангоми омода кардани мақола зеҳни сунъии тавлидӣ танҳо барои санҷиши имло ва грамматика истифода шудааст; баромадро худи онҳо баррасӣ ва таҳрир карда, масъулияти муҳтаворо ба уҳда гирифтаанд.
Бархӯрди манфиатҳо: Муаллифон изҳор мекунанд, ки бархӯрди манфиатҳо вуҷуд надорад. Гузориш шудааст, ки маблағгузорон дар тарҳи таҳқиқот, ҷамъоварӣ/таҳлил/тафсири додаҳо, навиштани мақола ё қарори нашр нақш надоштаанд.
Саҳми муаллифон: Консептуализатсия Andreea Dutulescu, Stefan Ruseti ва Mihai Dascalu; методология Andreea Dutulescu ва Stefan Ruseti; нармафзор, таҳлили формалӣ, таҳқиқот, захираҳо, курасияи додаҳо, тарҳи аввал ва визуализатсия Andreea Dutulescu; валидатсия Andreea Dutulescu, Stefan Ruseti ва Mihai Dascalu; баррасӣ ва таҳрир ҳамаи чор муаллиф; назорат Stefan Ruseti, Mihai Dascalu ва Danielle S. McNamara; идоракунии лоиҳа Mihai Dascalu; ҷалби маблағгузорӣ аз ҷониби Stefan Ruseti, Mihai Dascalu ва Danielle S. McNamara анҷом дода шудааст.
Маҳдудиятҳои асосии методологӣ: Танҳо ду вазифа арзёбӣ шудаанд; як модели асосии 8B истифода шудааст; ҷустуҷӯи гиперпараметрҳо маҳдуд аст; ниёз ба намунаҳои манфӣ вуҷуд дорад; хатоҳои системаи нишонагузорӣ метавонанд дар даври feedback паҳн шаванд; арзиши inference аз усулҳои якгузар баландтар аст; сохторҳои ғайр аз binary feedback санҷида нашудаанд; benchmark-ҳои latency/throughput/хотираи GPU барои муҳити истеҳсолӣ пешниҳод нашудаанд.
Ёддошти гузориш дар дохили манбаъ: Байни шумораи санҷишии FairytaleQA ва нишонаи n=2007 дар Ҷадвали 3, шумораи санҷишии KP20K ва қимати n=1998 дар Ҷадвали 4, инчунин нишонаи манбаи FairytaleQA дар Ҷадвали 6 номувофиқатиҳои шарҳнашуда мавҷуданд. Ин нуқтаҳо аз ҷониби Verianla хомӯшона ислоҳ нашудаанд.
Ёддошти усули Verianla: Ин муҳтаво тарҷумаи ҷумла ба ҷумла ё бознависии наздики параграф ба параграфи мақолаи манбаъ нест. Бо нигоҳ доштани масъалаи таҳқиқот, сохтори Feedback-Aware training/inference, системаи feedback-и GOOD/BAD, мантиқи арзёбии QGen/QAns, маҷмӯи додаҳо, танзимоти модел, натиҷаҳои P@K ва F1@K, санҷишҳои оморӣ, таҳлили сифатӣ, таҷрибаи ORPO, маҳдудиятҳо ва пешниҳодҳои таҳқиқоти оянда, як сохтори мустақили омӯзиши илмӣ ба забони тоҷикӣ сохта шудааст.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд