


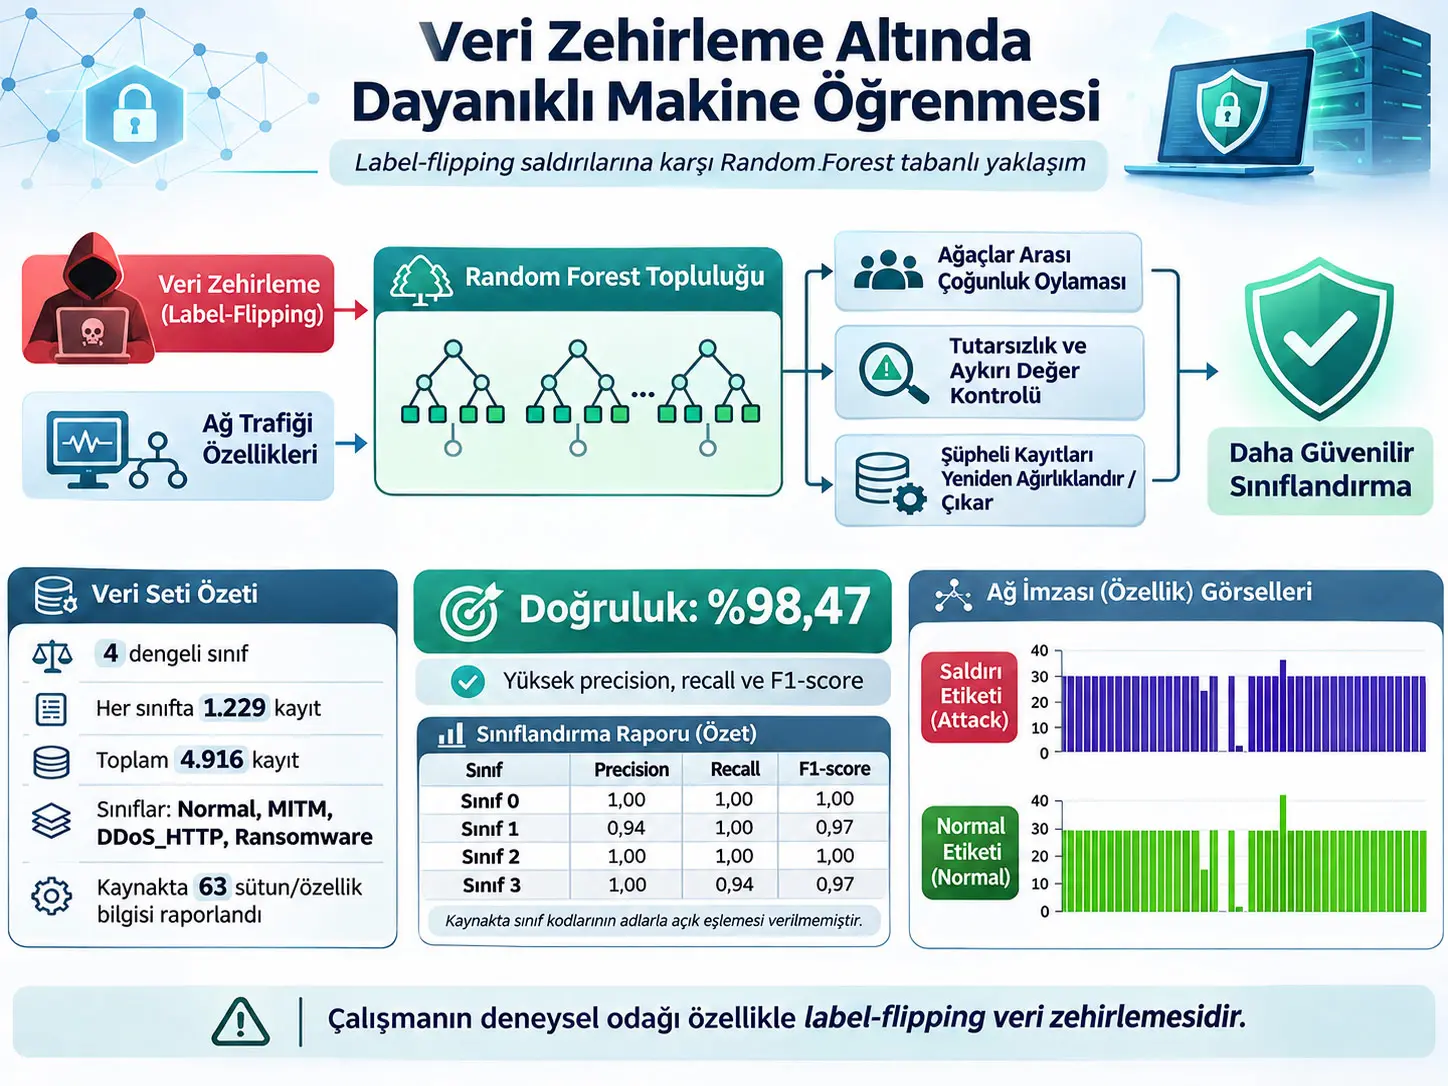
Random Forest tabanlı dayanıklı makine öğrenmesi çerçevesi, eğitim verisindeki etiketlerin kötü niyetli biçimde değiştirilmesiyle oluşturulan label-flipping veri zehirleme saldırılarına karşı ağ trafiği sınıflandırmasının güvenilirliğini korumayı amaçlayan bir topluluk öğrenmesi yaklaşımıdır. Çalışma, normal ağ trafiği ile MITM, DDoS_HTTP ve Ransomware sınıflarını içeren dengeli bir veri yapısı üzerinde Random Forest kullanmış; kaynak ekran çıktısında dört sınıfın her biri 1.229 kayıt, toplam temizlenmiş veri ise 4.916 satır ve 63 sütun olarak gösterilmiştir. Model için ana sonuç %98,47 doğruluktur. Bununla birlikte makale, zehirlenen etiket oranını, hangi etiketlerin hangi sınıfa çevrildiğini, eğitim/test ayrımını, ağaç sayısını veya diğer Random Forest hiperparametrelerini raporlamadığı için %98,47 değeri yalnız raporlanan deney koşulları içinde yorumlanmalıdır.
Çalışmanın ana saldırı modeli label-flipping saldırısıdır: saldırgan özellik değerlerini değiştirmeden eğitim örneklerinin sınıf etiketlerini değiştirerek modelin yanlış karar sınırları öğrenmesini sağlamaya çalışır. Kaynak, Random Forest'ın bootstrap örnekleme, rastgele özellik seçimi ve çok sayıda karar ağacının çoğunluk oylaması sayesinde tek tek zehirlenmiş kayıtların bütün topluluğu aynı ölçüde etkilemesini azaltabileceğini savunmaktadır. Ayrıca özellik-etiket tutarsızlıkları, ağaçlar arası yüksek anlaşmazlık, özellik önemi, aykırı değer tespiti ve tutarlılık kontrolleri kullanılarak şüpheli kayıtların işaretlenmesi; ardından bu kayıtların yeniden ağırlıklandırılması veya çıkarılması ve modelin yeniden eğitilmesi önerilmektedir.
Kaynak başlığında “Model Attacks” ifadesi bulunmasına ve mimaride ayrı bir “model attack and adversarial perturbation layer” tanımlanmasına rağmen, raporlanan deneysel performans esas olarak label-flipping veri zehirleme senaryosuna dayanmaktadır. Kaynakta ayrı bir backdoor, inference-time adversarial perturbation veya başka bir model saldırısı için bağımsız saldırı yoğunluğu, test protokolü ve performans tablosu verilmemektedir. Bu nedenle çalışmanın %98,47 sonucunu bütün model saldırılarına karşı genel dayanıklılık kanıtı olarak yorumlamak doğru değildir.
Şekil 4'teki sınıflandırma raporu dört sayısal sınıf için destek değerini 1.229 olarak göstermektedir. Sınıf 0 için precision/recall/F1 1,00/1,00/1,00; sınıf 1 için 0,94/1,00/0,97; sınıf 2 için 1,00/1,00/1,00; sınıf 3 için 1,00/0,94/0,97 olarak görüntülenmektedir. Ancak PDF bu sayısal sınıf kodlarını MITM, Normal, DDoS_HTTP ve Ransomware adlarıyla açık bir eşleme tablosunda vermediği için hangi adlandırılmış sınıfın 0,94 precision veya 0,94 recall değerine sahip olduğu güvenilir biçimde söylenemez.
Veri zehirleme neden makine öğrenmesi için farklı bir güvenlik problemidir?
Makine öğrenmesi modeli yalnız algoritmadan ibaret değildir; modelin öğrendiği karar yapısı eğitim verisine bağlıdır. Veri zehirleme saldırısında saldırgan, model eğitilirken kullanılan veriyi manipüle ederek modelin daha sonra yanlış kararlar vermesini hedefler. Bu nedenle saldırı, yalnız bir test girdisini kandırmaya değil, modelin öğrenme sürecinin kendisini bozmaya yönelir.
Kaynak çalışmanın odaklandığı durumda saldırgan, ağ paketlerinden veya ağ kayıtlarından çıkarılmış özellikleri değiştirmek yerine sınıf etiketlerini değiştirir. Böyle bir kayıt dışarıdan bakıldığında normal bir ağ kaydı gibi görünebilir; fakat kaydın “hangi sınıfa ait olduğu” bilgisinin değiştirilmiş olması, modelin özelliklerle sınıf arasındaki yanlış ilişkiyi öğrenmesine neden olabilir.
Label-Flipping Saldırısı Nedir?
Label-flipping saldırısı, eğitim örneklerinin özellik değerlerini büyük ölçüde korurken doğru sınıf etiketlerini kasıtlı olarak başka sınıf etiketleriyle değiştiren bir veri zehirleme saldırısıdır; bu çalışmada amaç, ağ trafiğine ait özellikler ile verilen sınıf etiketi arasındaki ilişkiyi bozarak sınıflandırıcının yanlış kararlar öğrenmesini sağlamaktır.
Özellik aynı kalırken etiket değişirse neden tespit zorlaşır?
Bir aykırı değer saldırısında kötü niyetli örnek fiziksel veya istatistiksel olarak normal dağılımdan uzak olabilir. Label-flipping saldırısında ise özellik vektörü olağan bir trafik kaydına benzeyebilir. Sorun, özelliklerin değil etiketin güvenilmez olmasıdır. Bu nedenle yalnız “alışılmadık değer var mı?” kontrolü yeterli olmayabilir; özellik-etiket ilişkisi, ağaçlar arası karar farklılıkları ve tekrar eğitildiğinde ortaya çıkan tutarlılık da önem kazanır.
Veri zehirleme ile model saldırısı aynı şey değildir
Kaynak giriş bölümünde veri zehirlemeyi eğitim verisinin bozulmasıyla, model saldırılarını ise eğitim veya çıkarım aşamasındaki zafiyetlerin kullanılmasıyla ilişkilendirmektedir. Model saldırıları backdoor davranışları veya yanlış sınıflandırmayı tetikleyen adversarial manipülasyonlar gibi daha geniş bir alanı kapsayabilir. Ancak bu makalenin deneysel bölümü bu saldırı ailesinin tamamını karşılaştırmalı olarak test etmez; sayısal değerlendirme label-flipping senaryosunda yoğunlaşır.
Çalışmanın veri yapısı
Makalenin abstract bölümünde her sınıfta 1.229 kayıt bulunduğu ve ağdan 63 özellik çıkarıldığı belirtilmektedir. Sayfa 4'teki Şekil 3 ekran çıktısı ise dört dengeli sınıfı açıkça göstermektedir: MITM, Normal, DDoS_HTTP ve Ransomware. Aynı ekran çıktısında temizlenmiş veri seti “4916 rows × 63 columns” olarak görünür.
| Sınıf | Kaynakta görülen kayıt sayısı | Statü |
|---|---|---|
| MITM | 1.229 | Şekil 3 konsol çıktısında açıkça listelenmiştir. |
| Normal | 1.229 | Şekil 3 konsol çıktısında açıkça listelenmiştir. |
| DDoS_HTTP | 1.229 | Şekil 3 konsol çıktısında açıkça listelenmiştir. |
| Ransomware | 1.229 | Şekil 3 konsol çıktısında açıkça listelenmiştir. |
| Toplam | 4.916 | 1.229 × 4; Şekil 3'teki toplam satır sayısıyla aynıdır. |
Burada önemli bir raporlama ayrıntısı vardır. Abstract “63 features” ifadesini kullanırken Şekil 3, veri çerçevesini 63 sütun olarak göstermekte ve görünür sütunlar arasında Attack_label ile Attack_type da bulunmaktadır. PDF, hedef/etiket sütunları çıkarıldıktan sonra gerçekten 63 bağımsız predictor kullanılıp kullanılmadığını açık biçimde ayırmamaktadır. Bu nedenle Verianla “kesin olarak 63 predictor özellik kullanıldı” sonucunu kaynak adına üretmemektedir.
Kaynakta görülen ağ özellikleri neyi temsil ediyor?
Kaynak doğrudan bütün 63 alanın tam veri sözlüğünü vermemektedir. Metin frame.time, ip.src_host ve ip.dst_host gibi alanları örnekler. Sayfa 5'teki saldırı ve normal örnek imza grafiklerinin x eksenlerinde ARP, ICMP, HTTP, TCP, UDP, DNS, MQTT ve Modbus/TCP ile ilişkili çeşitli alan adları da görünmektedir. Bunlar trafik akışının zamanını, kaynak/hedef adreslerini, protokol davranışlarını, portları, sıra/uzunluk bilgilerini veya uygulama katmanı mesaj özelliklerini temsil edebilir.
Ancak Şekil 5 ve Şekil 6'nın y ekseninde ölçü birimi ve her çubuğun nasıl normalize edildiği açıklanmamaktadır. Bu nedenle bu iki grafik “hangi protokol özelliğinin bilimsel olarak şu kadar daha önemli olduğu” şeklinde nicel feature-importance grafikleri olarak yorumlanmamalıdır. Kaynak bunları attack ve normal etiketli örnek ağ imzalarının görsel çıktısı olarak kullanmaktadır.
Modelin ana savunma çekirdeği: Random Forest
Random Forest, birden fazla karar ağacını farklı bootstrap veri örnekleri ve rastgele özellik alt kümeleri üzerinde eğiterek bu ağaçların tahminlerini bir topluluk kararı halinde birleştiren ensemble yöntemidir. Kaynağın savunma mantığı, zehirlenmiş bir kaydın bütün ağaçları aynı biçimde etkilememesi ve tek bir ağacın hatasının çoğunluk oylaması içinde baskılanabilmesidir.
Makale, temiz/orijinal veri setini matematiksel olarak D, zehirlenmiş örnekleri Dp ve bunların oluşturduğu bozulmuş eğitim kümesini D′ ile göstermektedir:
\[ D' = D \cup D_p \]
Bu ifade neyi anlatır? Kaynak, temiz veri ile zehirlenmiş veya yanlış etiketlenmiş örneklerin birlikte eğitim kümesini oluşturduğu kavramsal durumu küme birleşimiyle göstermektedir. Bu denklem saldırının tam üretim algoritmasını vermez; kaç kaydın zehirlendiği, hangi sınıftan hangi sınıfa çevrildiği veya zehir oranının ne olduğu PDF'de belirtilmemektedir.
Random Forest Label-Flipping Saldırılarına Karşı Neden Direnç Sağlayabilir?
Random Forest, her karar ağacını bootstrap ile seçilmiş farklı örnekler ve farklı özellik alt kümeleri üzerinde eğittiği için zehirlenmiş kayıtların etkisini bütün ağaçlara aynı biçimde yaymayabilir; son kararın çok sayıda ağacın çoğunluk oyuyla verilmesi de tekil ağaç hatalarının etkisini azaltabilir, ancak bu mekanizma Random Forest'ı veri zehirlemeye karşı otomatik veya koşulsuz olarak bağışık yapmaz.
Bootstrap örnekleme ne işe yarar?
Bootstrap örneklemede her karar ağacı eğitim kümesinden tekrar seçime izin veren örnekleme yoluyla farklı bir alt veri kümesi görür. Kaynağın yorumuna göre bu yapı, zehirli kayıtların yalnız bazı ağaçları etkilemesini ve tüm topluluğun aynı bozulmaya maruz kalmamasını sağlayabilir. Ancak gerçek etki zehir oranına, sınıf yapısına ve ağaç sayısına bağlıdır; makale bu parametreleri ayrıntılı deney serisiyle raporlamamaktadır.
Rastgele özellik seçimi ne işe yarar?
Karar ağacındaki her bölünmede özelliklerin yalnız bir alt kümesinin değerlendirilmesi, ağaçlar arasında çeşitlilik oluşturur. Böylece bütün ağaçların aynı özellik ilişkisine aşırı bağımlı hale gelmesi azaltılabilir. Kaynak bunu, zehirlenmiş örneklerdeki belirli özellik-etiket tutarsızlıklarının karar sınırlarını sürekli aynı yönde etkilemesini sınırlayan bir mekanizma olarak sunmaktadır.
Çoğunluk oylaması nasıl hesaplanır?
Kaynak Random Forest'ın nihai sınıf kararını şu denklemle vermektedir:
\[ \hat{y} = \operatorname*{arg\,max}_{c} \sum_{t=1}^{T} \mathbb{I}\bigl(h_t(x)=c\bigr) \]
Formül neyi hesaplar? Her ağacın hangi sınıfa oy verdiğini sayar ve en fazla oyu alan sınıfı nihai tahmin olarak seçer.
- \(\hat{y}\): Random Forest'ın nihai tahmin ettiği sınıf.
- \(c\): Aday sınıf etiketi.
- \(T\): Topluluktaki karar ağacı sayısı.
- \(h_t(x)\): \(t\). karar ağacının \(x\) örneği için ürettiği sınıf.
- \(\mathbb{I}(\cdot)\): Koşul doğruysa 1, yanlışsa 0 olan gösterge fonksiyonu.
- \(\sum\): Belirli sınıf için toplam oy sayısı.
- \(\operatorname*{arg\,max}\): En yüksek oy sayısını veren sınıfı seçen işlem.
Denklemin birimi yoktur; sınıf oylarının sayımı üzerinden karar verir. Örneğin bir sınıf en fazla sayıda ağaç tarafından seçilmişse, nihai Random Forest çıktısı o sınıf olur. Kaynak, kullanılan gerçek ağaç sayısı \(T\)'yi raporlamamaktadır.
Ağaç anlaşmazlığı neden şüphe sinyali olarak kullanılıyor?
Kaynak sistemde, aynı örnek için karar ağaçları arasında yüksek tahmin anlaşmazlığı bulunması şüpheli durum olarak değerlendirilir. Mantık, özelliklerle atanmış etiket arasında olağandışı bir ilişki olduğunda farklı bootstrap örnekleri ve özellik alt kümeleri kullanan ağaçların daha az tutarlı karar verebilmesidir. Bununla birlikte makale “yüksek anlaşmazlık” için sayısal bir eşik raporlamamaktadır.
Özellik önemi, aykırı değer ve tutarlılık kontrolleri
Kaynak, Random Forest çıktısını tek başına kullanmak yerine feature importance analizi, outlier detection ve consistency checks ile zehirlenmiş kayıtları izole etmeyi amaçlamaktadır. Şüpheli olarak işaretlenen kayıtların yeniden ağırlıklandırılabileceği veya veri setinden çıkarılabileceği, ardından modelin yeniden eğitileceği belirtilmektedir.
Ancak PDF şu ayrıntıları vermemektedir: kullanılan aykırı değer algoritmasının adı, feature-importance türü, tutarlılık skorunun matematiksel tanımı, eşik değerleri, yeniden ağırlıklandırma katsayısı ve hangi koşulda kayıt silindiği. Bu nedenle bu bileşenleri kaynağın tarif ettiğinden daha ayrıntılı bir algoritmaya dönüştürmek doğru olmaz.
Kaynak mimarinin sekiz işlevsel bileşeni
| Bileşen | Kaynakta verilen işlev | Yorum sınırı |
|---|---|---|
| Data Poisoning Input Layer | Yanlış değiştirilmiş veya yanlış etiketlenmiş eğitim örneklerini temsil eder. | Zehir oranı ve label-flip matrisi raporlanmamıştır. |
| Model Attack / Adversarial Perturbation Layer | Eğitim veya çıkarım sırasında modeli yanıltmayı amaçlayan adversarial manipülasyonları temsil eder. | Ayrı sayısal saldırı deneyi verilmemiştir. |
| Robust Random Forest Core | Rastgele veri/özellik alt kümeleri üzerinde çok sayıda karar ağacı eğitir. | Ağaç sayısı ve hiperparametreler raporlanmamıştır. |
| Individual Decision Trees | Farklı veri bölümlerinden bağımsız karar kuralları öğrenir. | Tek tek ağaç performansı raporlanmamıştır. |
| Ensemble Voting | Ağaç oylarını çoğunluk kararıyla birleştirir. | Oy güven eşiği veya tie-break kuralı açıklanmamıştır. |
| Secure Prediction Output | Ensemble consensus üzerinden nihai tahmin üretir. | “Secure” terimi saha güvenlik garantisi anlamına gelmez. |
| Anomaly Detection and Alert | Label-flipping veya adversarial davranışla ilişkili olağandışı tahmin örüntülerini işaretler. | Alarm eşiği ve ayrı detection metriği raporlanmamıştır. |
| Reliable System Output | Tahmin ve anomali göstergesini birlikte sunmayı amaçlar. | Uzun dönem production reliability testi bulunmamaktadır. |
“Gerçek zamanlı” NetIDS çıktısı nasıl yorumlanmalı?
Makale Şekil 5'te bir Network Intrusion Detection System (NetIDS) ekranının mevcut ağ durumunu “Attack” ve saldırı tipini “DDoS_HTTP” olarak etiketlediğini anlatmaktadır. Bu, çalışan bir prototip çıktısının örneğidir. Ancak kaynak throughput, paket/saniye kapasitesi, end-to-end latency, CPU/RAM kullanımı veya gecikme dağılımı gibi gerçek zaman performans ölçülerini raporlamamaktadır. Bu nedenle “gerçek zamanlı gösterim” ile “yüksek hacimli production ağında doğrulanmış gerçek zaman performansı” aynı şey değildir.
Bu Çalışmada “Model Attacks” Ayrı Bir Deney Olarak Test Edildi mi?
Kaynak mimaride model saldırıları ve adversarial perturbasyonlar için ayrı bir katman tanımlasa da, yayımlanan sayısal değerlendirme label-flipping veri zehirleme senaryosuna odaklanmaktadır; backdoor, evasion veya başka bir model saldırısı için bağımsız saldırı yoğunluğu, kontrol grubu, metrik tablosu ya da ayrı karşılaştırmalı sonuç raporlanmamıştır.
Literatür boşluğu nasıl kuruluyor?
Kaynak, önceki çalışmaların önemli bölümünün modelleri temiz ve ideal veri altında değerlendirdiğini, farklı saldırı yoğunlukları ve saldırı türleri karşısında model ailelerinin sistematik karşılaştırılmasında boşluk bulunduğunu savunmaktadır. Ayrıca ilgili literatürde anomaly detector poisoning, RONI yaklaşımı, clean-label poisoning, generative poisoning ve DNN veri zehirleme çalışmaları tartışılmaktadır.
Bununla birlikte mevcut makalenin kendi deneysel tasarımı, girişte tanımlanan bütün geniş boşluğu kapatan kapsamlı bir çok-model ve çok-saldırı benchmark'ı değildir. Uygulanan ana model Random Forest, ana deneysel saldırı ise label-flipping'dir.
Çalışmanın Yöntemi ve Bulguları
Araştırma tasarımının kaynakta görünen sırası
- Model önce temiz veri üzerinde eğitilmiştir.
- Label-flipping saldırıları simüle edilerek eğitim etiketleri kasıtlı biçimde değiştirilmiştir.
- Ağ trafiğinden istatistiksel, yapısal ve davranışsal özellikler çıkarılmıştır.
- Random Forest, clean/poisoned veya doğru/yanlış etiket ilişkilerindeki örüntüleri ayırt etmek amacıyla kullanılmıştır.
- Ağaç tahminleri çoğunluk oylamasıyla birleştirilmiştir.
- Ağaçlar arası anlaşmazlık, özellik önemi, outlier detection ve consistency checks kullanılarak şüpheli örnekler işaretlenmiştir.
- Şüpheli örneklerin yeniden ağırlıklandırılması veya çıkarılması ve modelin yeniden eğitilmesi öngörülmüştür.
- Son performans classification report ve %98,47 accuracy ile raporlanmıştır.
Deney veri setinin sayısal özeti
| Öğe | Kaynakta raporlanan bilgi | Açıklık durumu |
|---|---|---|
| Toplam kayıt | 4.916 | Şekil 3 ekran çıktısında görünür. |
| Sınıf sayısı | 4 | MITM, Normal, DDoS_HTTP, Ransomware olarak görünür. |
| Sınıf başına kayıt | 1.229 | Abstract, Results ve Şekil 3 ile uyumludur. |
| Veri dengesi | Dengeli | Her sınıf aynı support değerine sahiptir. |
| Özellik/sütun sayısı | Abstract: 63 özellik; Şekil 3: 63 sütun | Etiket sütunlarının 63 içinde olup olmadığı açık ayrılmamıştır. |
| Yazılım dili | Python | Kaynak açıkça belirtir. |
| Model | Random Forest | Ana savunma/sınıflandırma modeli. |
| Ana saldırı | Label-flipping | Deneysel değerlendirmenin merkezi. |
| Accuracy | %98,47 | Kaynağın ana raporlanan sonucu. |
Classification report ne gösteriyor?
| Sayısal sınıf | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| 0 | 1,00 | 1,00 | 1,00 | 1.229 |
| 1 | 0,94 | 1,00 | 0,97 | 1.229 |
| 2 | 1,00 | 1,00 | 1,00 | 1.229 |
| 3 | 1,00 | 0,94 | 0,97 | 1.229 |
| Macro average | 0,99 | 0,98 | 0,98 | 4.916 |
| Weighted average | 0,99 | 0,98 | 0,98 | 4.916 |
Şekil 4'ün classification report satırı accuracy değerini iki ondalıklı gösterimde 0,98 olarak yuvarlarken aynı konsol çıktısının altında “Accuracy: 98.47%” bilgisi verilmektedir. Verianla ana sonucu kaynakta açıkça verilen %98,47 olarak korur.
Sayısal sınıf 0–3'ün MITM, Normal, DDoS_HTTP ve Ransomware sınıflarına karşılıkları classification report içinde adlandırılmamaktadır. Şekil 3 yalnız dört sınıf adının her birinde 1.229 kayıt bulunduğunu gösterir. Bu nedenle “MITM precision 0,94'tür” veya “Ransomware recall 0,94'tür” gibi bir eşleme yapmak kaynakta olmayan bilgi üretmek olur.
Precision, recall ve F1-score neyi ölçer?
Aşağıdaki formüller makalenin özgün denklemleri değildir; kaynakta raporlanan performans metriklerinin standart anlamını öğretmek için verilmiştir.
\[ Precision = \frac{TP}{TP+FP} \]
Precision, modelin belirli bir sınıf olarak tahmin ettiği örneklerin ne kadarının gerçekten o sınıfa ait olduğunu ölçer.
\[ Recall = \frac{TP}{TP+FN} \]
Recall, gerçekten belirli bir sınıfa ait örneklerin ne kadarının model tarafından yakalandığını ölçer.
\[ F1 = 2\frac{Precision\times Recall}{Precision+Recall} \]
F1-score, precision ve recall arasında harmonik ortalama oluşturur. Kaynakta her sınıf aynı support değerine sahip olduğu için macro average ile weighted average değerlerinin birbirine çok yakın olması beklenen bir durumdur; raporlanan tabloda her iki ortalama da precision için 0,99, recall ve F1 için 0,98 olarak görünmektedir.
%98,47 Doğruluk Sonucu Nasıl Yorumlanmalıdır?
%98,47 accuracy, kaynağın raporladığı veri düzeni ve Random Forest uygulaması altında sınıflandırma tahminlerinin büyük bölümünün doğru olduğunu gösterir; ancak zehirlenmiş örnek tespit oranının ayrı olarak %98,47 olduğu, bütün label-flipping yoğunluklarında aynı performansın korunacağı veya gerçek production ağında aynı sonucun elde edileceği bu çalışma tarafından ayrıca gösterilmemiştir.
98,47% hangi göreve ait?
Makalenin anlatımı %98,47 değerini label-flipping saldırılarına karşı dayanıklılık başarısı olarak yorumlamaktadır. Bununla birlikte Şekil 4'teki görünür classification report dört sınıf kodu için performans verir ve her sınıfta 1.229 support bulunur. Kaynak, “poisoned sample” ve “clean sample” olmak üzere ayrı ikili detection sınıflarına ait confusion matrix veya poisoned-sample detection rate sunmamaktadır.
Bu nedenle %98,47'yi en güvenli biçimde “çalışmanın label-flipping bağlamında raporladığı dört sınıflı sınıflandırma accuracy'si” olarak okumak gerekir. Etiket zehirlenmiş kayıtların bizzat tespit edilme duyarlılığı için ayrı bir sayı kaynakta yoktur.
Eğitim/test ayrımı neden önemli bir eksik?
Makale train/test split oranını, cross-validation düzenini veya bağımsız hold-out test setini açıklamamaktadır. Şekil 3'te temizlenmiş veri seti 4.916 satır olarak görünürken Şekil 4 classification report'taki support toplamı da 4.916'dır. Bu gözlem, performansın hangi veri alt kümesinde hesaplandığını yeniden üretilebilir biçimde doğrulamayı zorlaştırmaktadır.
Bu durumdan otomatik olarak “model eğitim verisi üzerinde test edilmiştir” sonucu çıkarılamaz; kaynak deney kodunu ve veri bölme adımlarını yeterli ayrıntıyla göstermediği için doğru ifade, bağımsız test ayrımının PDF'den doğrulanamadığıdır.
Hiperparametreler raporlanıyor mu?
Hayır. Kaynak Random Forest'taki karar ağacı sayısını, maksimum derinliği, minimum leaf boyutunu, max_features ayarını, bootstrap parametrelerini, random seed'i veya class_weight ayarını vermemektedir. Aynı biçimde feature-importance hesaplama türü, outlier detector ve yeniden ağırlıklandırma parametreleri de raporlanmamıştır.
Label-flipping saldırısının yoğunluğu raporlanıyor mu?
Hayır. Kaynak etiketlerin kasıtlı biçimde değiştirildiğini ve modelin önce clean data üzerinde eğitildikten sonra label-flipping simülasyonuna tabi tutulduğunu belirtir; fakat toplam kayıtların yüzde kaçının çevrildiği, hangi sınıftan hangi sınıfa çevrildiği ve saldırının rastgele mi hedefli mi uygulandığı açık biçimde raporlanmamaktadır.
Dört sınıfın dengeli olması ne anlama gelir?
Her sınıfın 1.229 kayıt taşıması, değerlendirmede büyük bir sınıfın küçük sınıfları sayısal olarak bastırmasını engeller. Bununla birlikte dengeli veri seti gerçek üretim ağındaki saldırı sıklıklarını temsil etmek zorunda değildir. Kaynak gerçek dünya prevalansına göre yeniden ağırlıklandırılmış saha testi sunmamaktadır.
Kaynağın Şekil 5 ve Şekil 6 sonuçları
Sayfa 5'teki Şekil 5 “Attack label”, Şekil 6 ise “Normal label” için seçilmiş IP network signature bar grafiklerini göstermektedir. İki grafikte protokol ve ağ alanlarının örnek düzeyindeki farklı değerleri görselleştirilmiştir. Kaynak bu grafiklerin y eksenine fiziksel birim veya normalizasyon tanımı vermediği için bar yüksekliklerinden kesin bilimsel eşik veya feature importance skoru çıkarılmamıştır.
Kaynakta açıkça raporlanan ana bulgular
- Random Forest tabanlı çerçeve için ana accuracy %98,47 olarak raporlanmıştır.
- Dört sayısal sınıfın her birinde support 1.229'dur.
- Sınıf 0 ve 2 için görünür precision, recall ve F1-score değerleri 1,00'dır.
- Sınıf 1 için precision 0,94, recall 1,00, F1-score 0,97'dir.
- Sınıf 3 için precision 1,00, recall 0,94, F1-score 0,97'dir.
- Macro ve weighted average precision 0,99; recall 0,98; F1-score 0,98 olarak görünmektedir.
- Kaynak, Random Forest ensemble yapısının label-flipping etkisini azaltabildiğini yorumlamaktadır.
- Kaynak, feature-label discrepancy, tree disagreement, outlier detection, consistency check ve feature importance bileşenlerini zehirli örnekleri işaretlemek için birlikte tarif etmektedir.
Çalışmanın desteklemediği sonuçlar
- %98,47 değerinin bütün data poisoning türlerinde geçerli olduğu gösterilmemiştir.
- Backdoor veya başka model saldırıları için %98,47 başarı gösterilmemiştir.
- Poisoned-sample detection rate ayrı bir metrik olarak raporlanmamıştır.
- Gerçek üretim ağında latency, throughput veya uzun dönem performans doğrulaması yapılmamıştır.
- Modelin farklı poison oranlarında nasıl davrandığı gösterilmemiştir.
- Random Forest başka modellerle aynı veri üzerinde kontrollü benchmark'a tabi tutulmamıştır.
- Belirli named class ile 0–3 sayısal class kodlarının eşlemesi açıkça verilmemiştir.
- 63 sütunun tamamının predictor feature olduğu doğrulanamamaktadır.
- Bağımsız hold-out test seti veya cross-validation prosedürü PDF'den doğrulanamamaktadır.
Yeniden üretilebilirlik açısından eksik raporlanan bilgiler
| Bilgi | Durum | Neden önemli? |
|---|---|---|
| Veri setinin özgün kaynağı / indirme adresi | Raporlanmıyor | Bağımsız yeniden üretimi zorlaştırır. |
| Train/validation/test split | Raporlanmıyor | Genelleme performansının nasıl ölçüldüğü doğrulanamaz. |
| Cross-validation | Raporlanmıyor | Tek bölmeye bağlılık değerlendirilemez. |
| Poisoning oranı | Raporlanmıyor | Dayanıklılığın saldırı şiddetine göre değişimi bilinmez. |
| Label-flip eşleme kuralı | Raporlanmıyor | Hangi sınıfların hangi sınıflara çevrildiği bilinmez. |
| Random Forest ağaç sayısı | Raporlanmıyor | Ensemble kapasitesi yeniden kurulamaz. |
| Diğer Random Forest hiperparametreleri | Raporlanmıyor | Model davranışı ve overfitting riski değerlendirilemez. |
| Random seed | Raporlanmıyor | Deney tekrarlanabilirliği azalır. |
| Outlier detection algoritması/eşiği | Raporlanmıyor | Şüpheli kayıt tespiti yeniden üretilemez. |
| Reweighting/removal kuralı | Raporlanmıyor | Veri temizleme adımı nicel olarak belirsiz kalır. |
| Poison detection confusion matrix | Raporlanmıyor | “Zehirli kaydı tespit etme” başarısı ayrı ölçülemez. |
| Donanım ve çalışma süresi | Raporlanmıyor | Gerçek zaman performansı değerlendirilemez. |
Çalışmanın bilimsel değeri nerede?
Kaynağın en açık katkısı, label-flipping tehdidini ağ saldırı sınıflandırması bağlamında ele alarak Random Forest ensemble yapısını, feature-label consistency kontrolünü ve şüpheli kayıt temizliğini aynı savunma akışında bir araya getirmesidir. Çalışma ayrıca dört dengeli sınıfta yüksek bir sınıflandırma performansı raporlamaktadır.
Buna karşılık makalenin kısa olması ve deney ayrıntılarının sınırlı raporlanması, sonucu yeniden üretme ve farklı poisoning yoğunluklarına genelleme konusunda açık sorular bırakmaktadır. Bu sınırlılıkları görünür tutmak, çalışmanın sonucunu küçültmek değil; %98,47 değerinin hangi bilgiyle desteklendiğini ve hangi ek bilgilerin PDF'de bulunmadığını doğru ayırmaktır.
Kaynak ve Yöntem Notu
Özgün başlık: Robust Machine Learning under Data Poisoning and Model Attacks
Yazarlar ve sıra: Promise Enyindah; Chigoziri Bobby Marcus.
Corresponding author: Promise Enyindah.
Corresponding author e-posta: promise.enyindah@uniport.edu.ng
ORCID: PDF'nin gömülü ORCID bağlantıları yazar sırasıyla Promise Enyindah için 0000-0001-6246-7077 ve Chigoziri Bobby Marcus için 0000-0003-4773-0222 adreslerine işaret etmektedir.
Kurum: Department of Computer Science, University of Port Harcourt, Choba, Nigeria.
Eşit katkı: Kaynakta eşit katkı veya eş birinci yazarlık beyanı tespit edilmemiştir.
Dergi: European Journal of Electrical Engineering and Computer Science (EJECE).
Yayınevi / platform: European Open Science.
ISSN: 2736-5751.
Cilt / sayı: Volume 10, Issue 1.
Sayfalar: 31–36.
DOI: 10.24018/ejece.2026.10.1.70077.
Resmî yayın kaydı: European Open Science EJECE, article ID 70077; DOI kaydı yukarıdaki DOI ile eşleşmektedir.
Kaynak türü: Research Article.
Hakemlik durumu: Derginin resmî “About the Journal” sayfası EJECE'yi peer-reviewed uluslararası dergi olarak tanımlamakta ve double-blind peer review kullandığını belirtmektedir.
Submitted: 12 Ocak 2026.
Published: 10 Şubat 2026.
Issue ayı için bibliyografik not: Makale PDF'sinin masthead'i “February 2026” yazmaktadır. RePEc/EconPapers indeks kaydı aynı Volume 10 Issue 1'i January 2026 olarak listelemektedir. Verianla makale düzeyindeki açık tarih olarak PDF'de verilen 10 Şubat 2026 tarihini esas almaktadır ve iki kayıt arasındaki issue-month farkını gizlememektedir.
Lisans: Makale PDF'sinin kendi telif satırı Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International (CC BY-NC-SA 4.0) belirtmektedir.
Lisans tutarlılığı notu: Derginin güncel web politikalarında lisans ifadeleri kendi aralarında ve bu PDF ile tam uyumlu değildir: submission copyright sayfasında CC BY-SA 4.0, Open Access Policy sayfasında ise CC BY-NC 4.0 yazmaktadır. Bu nedenle Verianla bu çalışma için makale PDF'sindeki article-level lisans beyanını provenance bilgisi olarak kaydetmekte; kaynak şekillerin görsel tasarımını kopyalamak yerine yalnız bilimsel ilişkilerden bağımsız şema oluşturmaktadır.
Preprint durumu: İncelenen PDF yayımlanmış dergi makalesidir. Kaynakta bu çalışma için ayrı bir preprint kimliği belirtilmemektedir.
Ana deneysel saldırı: Label-flipping data poisoning.
Başlıktaki “model attacks” kapsamı: Mimaride adversarial/model attack katmanı tanımlanmaktadır; ancak ayrı model-attack benchmark'ı veya bağımsız sayısal sonuç raporlanmamaktadır.
Veri: Şekil 3'te dört dengeli sınıf; her sınıfta 1.229 kayıt ve toplam 4.916 satır görünmektedir. Sınıflar MITM, Normal, DDoS_HTTP ve Ransomware olarak listelenmiştir.
Özellik sayısı: Abstract 63 feature belirtmektedir; Şekil 3 temizlenmiş veri çerçevesini 63 sütun olarak göstermektedir. Attack_label ve Attack_type sütunlarının da görünür olması nedeniyle predictor sayısının hedef sütunları hariç ayrıca 63 olup olmadığı açık değildir.
Model: Random Forest classifier.
Ensemble mekanizması: Bootstrap örnekler üzerinde karar ağaçları, random feature selection ve majority voting.
Ek savunma mekanizmaları: Feature importance analysis, outlier detection, consistency checks, tree disagreement monitoring, şüpheli örnekleri reweight/remove etme ve retraining.
Ana sonuç: %98,47 accuracy.
Classification report: Dört sayısal sınıfın her birinde support 1.229; class 0: 1,00/1,00/1,00; class 1: 0,94/1,00/0,97; class 2: 1,00/1,00/1,00; class 3: 1,00/0,94/0,97 precision/recall/F1. Class kodlarının adlandırılmış sınıflara açık eşlemesi raporlanmamıştır.
Train/test doğrulaması: Kaynak train/test split, validation split veya cross-validation prosedürünü açık biçimde raporlamamaktadır.
Hiperparametreler: Ağaç sayısı dahil Random Forest hiperparametreleri raporlanmamaktadır.
Poisoning parametreleri: Zehir oranı, değiştirilen kayıt sayısı ve label-flip sınıf eşleme matrisi raporlanmamaktadır.
İstatistiksel belirsizlik: Confidence interval, standard deviation, repeated-run variance, p-değeri veya başka inferansiyel belirsizlik analizi raporlanmamaktadır.
Finansman: İncelenen PDF'de ayrı bir funding statement tespit edilmemiştir; finansman olmadığı varsayılmamıştır.
Veri erişilebilirliği: İncelenen PDF'de ayrı bir Data Availability Statement veya veri deposu bağlantısı tespit edilmemiştir.
Yazar katkıları: Ayrı bir author contributions / CRediT beyanı tespit edilmemiştir.
Etik kurul: Ayrı bir ethics approval veya informed consent beyanı tespit edilmemiştir; çalışma insan/hayvan araştırması olarak raporlanmamaktadır.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir