


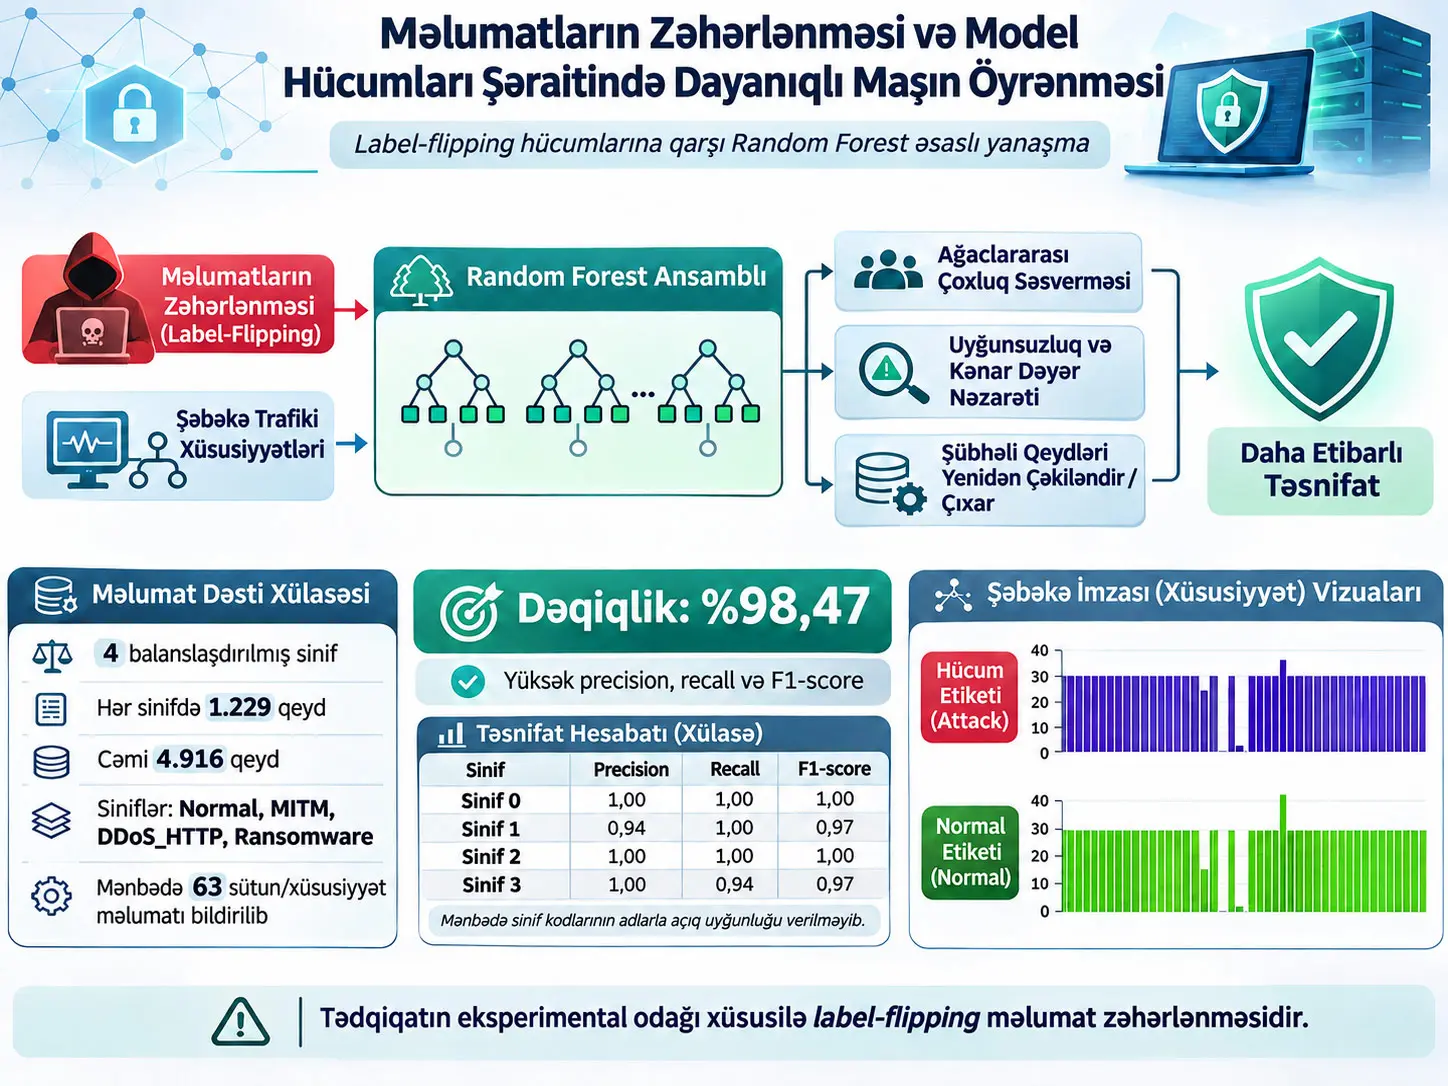
Random Forest əsaslı dayanıqlı maşın öyrənməsi çərçivəsi, təlim məlumatlarındakı etiketlərin qəsdən zərərli şəkildə dəyişdirilməsi ilə yaradılan label-flipping məlumat zəhərləmə hücumlarına qarşı şəbəkə trafikinin təsnifat etibarlılığını qorumağı hədəfləyən ensemble öyrənmə yanaşmasıdır. Tədqiqat normal şəbəkə trafiki ilə MITM, DDoS_HTTP və Ransomware siniflərini əhatə edən balanslaşdırılmış məlumat strukturu üzərində Random Forest-dan istifadə etmiş; mənbənin ekran çıxışında dörd sinfin hər birində 1.229 qeyd, ümumi təmizlənmiş məlumatda isə 4.916 sətir və 63 sütun göstərilmişdir. Model üçün əsas nəticə %98,47 dəqiqlikdir. Bununla belə, məqalə zəhərlənmiş etiketlərin nisbətini, hansı etiketlərin hansı sinfə çevrildiyini, təlim/test bölünməsini, ağac sayını və ya digər Random Forest hiperparametrlərini bildirmədiyinə görə %98,47 dəyəri yalnız bildirilən eksperimental şərtlər daxilində şərh edilməlidir.
Tədqiqatın əsas hücum modeli label-flipping hücumudur: hücumçu xüsusiyyət dəyərlərini dəyişdirmədən təlim nümunələrinin sinif etiketlərini dəyişdirərək modelin yanlış qərar sərhədlərini öyrənməsinə nail olmağa çalışır. Mənbə Random Forest-ın bootstrap nümunələmə, təsadüfi xüsusiyyət seçimi və çoxsaylı qərar ağaclarının çoxluq səsverməsi sayəsində ayrı-ayrı zəhərlənmiş qeydlərin bütün ensemble-a eyni dərəcədə təsir göstərməsini azalda biləcəyini irəli sürür. Bundan əlavə, xüsusiyyət-etiket uyğunsuzluqları, ağaclar arasında yüksək fikir ayrılığı, xüsusiyyət əhəmiyyəti, kənar dəyər aşkarlanması və tutarlılıq yoxlamaları istifadə edilərək şübhəli qeydlərin işarələnməsi; daha sonra bu qeydlərin yenidən çəkiləndirilməsi və ya çıxarılması və modelin yenidən təlim edilməsi təklif olunur.
Mənbənin başlığında “Model Attacks” ifadəsi olmasına və arxitekturda ayrıca “model attack and adversarial perturbation layer” müəyyən edilməsinə baxmayaraq, bildirilən eksperimental performans əsasən label-flipping məlumat zəhərləmə ssenarisinə əsaslanır. Mənbədə ayrıca backdoor, inference-time adversarial perturbation və ya başqa model hücumu üçün müstəqil hücum intensivliyi, test protokolu və performans cədvəli verilmir. Buna görə tədqiqatın %98,47 nəticəsini bütün model hücumlarına qarşı ümumi dayanıqlılıq sübutu kimi şərh etmək doğru deyil.
Şəkil 4-dəki təsnifat hesabatı dörd ədədi sinif üçün support dəyərini 1.229 kimi göstərir. Sinif 0 üçün precision/recall/F1 1,00/1,00/1,00; sinif 1 üçün 0,94/1,00/0,97; sinif 2 üçün 1,00/1,00/1,00; sinif 3 üçün 1,00/0,94/0,97 kimi göstərilir. Lakin PDF bu ədədi sinif kodlarını MITM, Normal, DDoS_HTTP və Ransomware adları ilə açıq uyğunlaşdırma cədvəlində vermədiyinə görə hansı adlandırılmış sinfin 0,94 precision və ya 0,94 recall dəyərinə malik olduğunu etibarlı şəkildə demək mümkün deyil.
Məlumat zəhərlənməsi maşın öyrənməsi üçün niyə fərqli təhlükəsizlik problemidir?
Maşın öyrənməsi modeli yalnız alqoritmdən ibarət deyil; modelin öyrəndiyi qərar strukturu təlim məlumatlarından asılıdır. Məlumat zəhərləmə hücumunda hücumçu model təlim edilərkən istifadə olunan məlumatları manipulyasiya edərək modelin sonradan yanlış qərarlar verməsini hədəfləyir. Buna görə hücum yalnız test girişini aldatmağa deyil, modelin öyrənmə prosesinin özünü pozmağa yönəlir.
Mənbə tədqiqatın diqqət yetirdiyi vəziyyətdə hücumçu şəbəkə paketlərindən və ya şəbəkə qeydlərindən çıxarılan xüsusiyyətləri dəyişdirmək əvəzinə sinif etiketlərini dəyişdirir. Belə qeyd kənardan baxıldıqda normal şəbəkə qeydi kimi görünə bilər; lakin qeydin “hansı sinfə aid olduğu” məlumatının dəyişdirilməsi modelin xüsusiyyətlərlə sinif arasında yanlış əlaqəni öyrənməsinə səbəb ola bilər.
Label-Flipping Hücumu Nədir?
Label-flipping hücumu, təlim nümunələrinin xüsusiyyət dəyərlərini böyük ölçüdə qoruyaraq düzgün sinif etiketlərini qəsdən başqa sinif etiketləri ilə dəyişdirən məlumat zəhərləmə hücumudur; bu tədqiqatda məqsəd şəbəkə trafikinə aid xüsusiyyətlərlə verilən sinif etiketi arasındakı əlaqəni pozaraq təsnifatçının yanlış qərarlar öyrənməsinə nail olmaqdır.
Xüsusiyyət eyni qaldığı halda etiket dəyişirsə aşkarlama niyə çətinləşir?
Kənar dəyər hücumunda zərərli nümunə fiziki və ya statistik olaraq normal paylanmadan uzaq ola bilər. Label-flipping hücumunda isə xüsusiyyət vektoru adi trafik qeydinə bənzəyə bilər. Problem xüsusiyyətlərin deyil, etiketin etibarsız olmasıdır. Buna görə yalnız “qeyri-adi dəyər varmı?” yoxlaması kifayət etməyə bilər; xüsusiyyət-etiket əlaqəsi, ağaclar arasındakı qərar fərqləri və yenidən təlim edildikdə ortaya çıxan tutarlılıq da əhəmiyyət qazanır.
Məlumat zəhərlənməsi ilə model hücumu eyni şey deyil
Mənbə giriş bölməsində məlumat zəhərlənməsini təlim məlumatlarının pozulması ilə, model hücumlarını isə təlim və ya inference mərhələsindəki zəifliklərdən istifadə ilə əlaqələndirir. Model hücumları backdoor davranışları və ya yanlış təsnifatı tetikleyen adversarial manipulyasiyalar kimi daha geniş sahəni əhatə edə bilər. Lakin bu məqalənin eksperimental bölməsi bu hücum ailəsinin hamısını müqayisəli şəkildə sınaqdan keçirmir; ədədi qiymətləndirmə label-flipping ssenarisində cəmlənir.
Tədqiqatın məlumat strukturu
Məqalənin abstract bölməsində hər sinifdə 1.229 qeyd olduğu və şəbəkədən 63 xüsusiyyət çıxarıldığı bildirilir. Səhifə 4-dəki Şəkil 3 ekran çıxışı isə dörd balanslaşdırılmış sinfi açıq şəkildə göstərir: MITM, Normal, DDoS_HTTP və Ransomware. Eyni ekran çıxışında təmizlənmiş məlumat dəsti “4916 rows × 63 columns” kimi görünür.
| Sinif | Mənbədə görünən qeyd sayı | Status |
|---|---|---|
| MITM | 1.229 | Şəkil 3 konsol çıxışında açıq şəkildə siyahılanmışdır. |
| Normal | 1.229 | Şəkil 3 konsol çıxışında açıq şəkildə siyahılanmışdır. |
| DDoS_HTTP | 1.229 | Şəkil 3 konsol çıxışında açıq şəkildə siyahılanmışdır. |
| Ransomware | 1.229 | Şəkil 3 konsol çıxışında açıq şəkildə siyahılanmışdır. |
| Cəmi | 4.916 | 1.229 × 4; Şəkil 3-dəki ümumi sətir sayı ilə eynidir. |
Burada mühüm hesabat detalı vardır. Abstract “63 features” ifadəsindən istifadə etdiyi halda Şəkil 3 məlumat çərçivəsini 63 sütun kimi göstərir və görünən sütunlar arasında Attack_label ilə Attack_type da vardır. PDF hədəf/etiket sütunları çıxarıldıqdan sonra həqiqətən 63 müstəqil predictor istifadə edilib-edilmədiyini açıq şəkildə ayırmır. Buna görə Verianla mənbə adından “dəqiq olaraq 63 predictor xüsusiyyət istifadə olunub” nəticəsini yaratmır.
Mənbədə görünən şəbəkə xüsusiyyətləri nəyi təmsil edir?
Mənbə bütün 63 sahənin tam məlumat lüğətini birbaşa təqdim etmir. Mətn frame.time, ip.src_host və ip.dst_host kimi sahələri nümunə göstərir. Səhifə 5-dəki hücum və normal nümunə imza qrafiklərinin x oxlarında ARP, ICMP, HTTP, TCP, UDP, DNS, MQTT və Modbus/TCP ilə əlaqəli müxtəlif sahə adları da görünür. Bunlar trafik axınının zamanını, mənbə/hədəf ünvanlarını, protokol davranışlarını, portları, sıra/uzunluq məlumatlarını və ya tətbiq qatı mesaj xüsusiyyətlərini təmsil edə bilər.
Lakin Şəkil 5 və Şəkil 6-nın y oxunda ölçü vahidi və hər sütunun necə normallaşdırıldığı izah edilmir. Buna görə bu iki qrafik “hansı protokol xüsusiyyətinin elmi baxımdan nə qədər daha vacib olduğu” formasında kəmiyyət feature-importance qrafikləri kimi şərh edilməməlidir. Mənbə bunlardan attack və normal etiketli nümunə şəbəkə imzalarının vizual çıxışı kimi istifadə edir.
Modelin əsas müdafiə nüvəsi: Random Forest
Random Forest, bir neçə qərar ağacını fərqli bootstrap məlumat nümunələri və təsadüfi xüsusiyyət alt çoxluqları üzərində təlim edərək bu ağacların proqnozlarını ensemble qərarı kimi birləşdirən üsuldur. Mənbənin müdafiə məntiqi ondan ibarətdir ki, zəhərlənmiş bir qeyd bütün ağaclara eyni şəkildə təsir etməsin və tək bir ağacın xətası çoxluq səsverməsi daxilində zəiflədilə bilsin.
Məqalə təmiz/orijinal məlumat dəstini riyazi olaraq D, zəhərlənmiş nümunələri Dp və bunların yaratdığı pozulmuş təlim çoxluğunu D′ ilə göstərir:
\[ D' = D \cup D_p \]
Bu ifadə nəyi bildirir? Mənbə təmiz məlumatlarla zəhərlənmiş və ya yanlış etiketlənmiş nümunələrin birlikdə təlim çoxluğunu yaratdığı konseptual vəziyyəti çoxluqların birləşməsi ilə göstərir. Bu tənlik hücumun tam generasiya alqoritmini vermir; neçə qeydin zəhərləndiyi, hansı sinifdən hansı sinfə çevrildiyi və ya zəhərləmə nisbətinin nə olduğu PDF-də göstərilmir.
Random Forest Label-Flipping Hücumlarına Qarşı Niyə Dayanıqlılıq Göstərə Bilər?
Random Forest hər qərar ağacını bootstrap ilə seçilmiş fərqli nümunələr və fərqli xüsusiyyət alt çoxluqları üzərində təlim etdiyinə görə zəhərlənmiş qeydlərin təsirini bütün ağaclara eyni şəkildə yaymaya bilər; yekun qərarın çoxsaylı ağacların çoxluq səsi ilə verilməsi də ayrı-ayrı ağac xətalarının təsirini azalda bilər, lakin bu mexanizm Random Forest-ı məlumat zəhərlənməsinə qarşı avtomatik və ya şərtsiz immun etmir.
Bootstrap nümunələmə nə iş görür?
Bootstrap nümunələmədə hər qərar ağacı təlim çoxluğundan təkrar seçməyə icazə verən nümunələmə yolu ilə fərqli alt məlumat dəsti görür. Mənbənin şərhinə görə bu struktur zəhərli qeydlərin yalnız bəzi ağaclara təsir etməsini və bütün ensemble-ın eyni pozulmaya məruz qalmamasını təmin edə bilər. Lakin real təsir zəhərləmə nisbətindən, sinif strukturundan və ağac sayından asılıdır; məqalə bu parametrləri ətraflı eksperiment seriyası ilə bildirmir.
Təsadüfi xüsusiyyət seçimi nə iş görür?
Qərar ağacındakı hər bölünmədə xüsusiyyətlərin yalnız bir alt çoxluğunun qiymətləndirilməsi ağaclar arasında müxtəliflik yaradır. Beləliklə, bütün ağacların eyni xüsusiyyət əlaqəsindən həddindən artıq asılı vəziyyətə gəlməsi azaldıla bilər. Mənbə bunu zəhərlənmiş nümunələrdəki müəyyən xüsusiyyət-etiket uyğunsuzluqlarının qərar sərhədlərinə davamlı olaraq eyni istiqamətdə təsirini məhdudlaşdıran mexanizm kimi təqdim edir.
Çoxluq səsverməsi necə hesablanır?
Mənbə Random Forest-ın yekun sinif qərarını aşağıdakı tənliklə verir:
\[ \hat{y} = \operatorname*{arg\,max}_{c} \sum_{t=1}^{T} \mathbb{I}\bigl(h_t(x)=c\bigr) \]
Düstur nəyi hesablayır? Hər ağacın hansı sinfə səs verdiyini sayır və ən çox səs alan sinfi yekun proqnoz kimi seçir.
- \(\hat{y}\): Random Forest-ın yekun proqnozlaşdırdığı sinif.
- \(c\): Namizəd sinif etiketi.
- \(T\): Ensemble-dakı qərar ağaclarının sayı.
- \(h_t(x)\): \(t\). qərar ağacının \(x\) nümunəsi üçün yaratdığı sinif.
- \(\mathbb{I}(\cdot)\): Şərt doğrudursa 1, yanlışdırsa 0 olan göstərici funksiyası.
- \(\sum\): Müəyyən sinif üçün ümumi səs sayı.
- \(\operatorname*{arg\,max}\): Ən yüksək səs sayını verən sinfi seçən əməliyyat.
Tənliyin vahidi yoxdur; qərarı sinif səslərinin sayılması əsasında verir. Məsələn, bir sinif ən çox sayda ağac tərəfindən seçilibsə, yekun Random Forest çıxışı həmin sinif olur. Mənbə istifadə olunan real ağac sayı \(T\)-ni bildirmir.
Ağaclararası fikir ayrılığı niyə şübhə siqnalı kimi istifadə olunur?
Mənbə sistemində eyni nümunə üçün qərar ağacları arasında yüksək proqnoz fikir ayrılığının olması şübhəli vəziyyət kimi qiymətləndirilir. Məntiq budur ki, xüsusiyyətlə təyin edilmiş etiket arasında qeyri-adi əlaqə olduqda fərqli bootstrap nümunələri və xüsusiyyət alt çoxluqları istifadə edən ağaclar daha az tutarlı qərarlar verə bilər. Bununla belə, məqalə “yüksək fikir ayrılığı” üçün ədədi hədd bildirmir.
Xüsusiyyət əhəmiyyəti, kənar dəyər və tutarlılıq yoxlamaları
Mənbə Random Forest çıxışını tək istifadə etmək əvəzinə feature importance təhlili, outlier detection və consistency checks vasitəsilə zəhərlənmiş qeydləri izolyasiya etməyi hədəfləyir. Şübhəli kimi işarələnmiş qeydlərin yenidən çəkiləndirilə və ya məlumat dəstindən çıxarıla biləcəyi, sonra modelin yenidən təlim ediləcəyi bildirilir.
Lakin PDF aşağıdakı detalları vermir: istifadə olunan kənar dəyər alqoritminin adı, feature-importance növü, tutarlılıq balının riyazi tərifi, hədd dəyərləri, yenidən çəkiləndirmə əmsalı və qeydin hansı şərtdə silindiyi. Buna görə bu komponentləri mənbənin təsvir etdiyindən daha detallı alqoritmə çevirmək düzgün olmaz.
Mənbə arxitekturasının səkkiz funksional komponenti
| Komponent | Mənbədə verilən funksiya | Şərh həddi |
|---|---|---|
| Data Poisoning Input Layer | Yanlış dəyişdirilmiş və ya yanlış etiketlənmiş təlim nümunələrini təmsil edir. | Zəhərləmə nisbəti və label-flip matrisi bildirilməmişdir. |
| Model Attack / Adversarial Perturbation Layer | Təlim və ya inference zamanı modeli çaşdırmağı hədəfləyən adversarial manipulyasiyaları təmsil edir. | Ayrı ədədi hücum eksperimenti verilməmişdir. |
| Robust Random Forest Core | Təsadüfi məlumat/xüsusiyyət alt çoxluqları üzərində çoxsaylı qərar ağaclarını təlim edir. | Ağac sayı və hiperparametrlər bildirilməmişdir. |
| Individual Decision Trees | Fərqli məlumat bölmələrindən müstəqil qərar qaydaları öyrənir. | Ayrı-ayrı ağac performansı bildirilməmişdir. |
| Ensemble Voting | Ağac səslərini çoxluq qərarı ilə birləşdirir. | Səs etibar həddi və ya tie-break qaydası izah edilməmişdir. |
| Secure Prediction Output | Ensemble consensus əsasında yekun proqnoz yaradır. | “Secure” termini saha təhlükəsizlik zəmanəti demək deyil. |
| Anomaly Detection and Alert | Label-flipping və ya adversarial davranışla əlaqəli qeyri-adi proqnoz nümunələrini işarələyir. | Alarm həddi və ayrıca detection metriği bildirilməmişdir. |
| Reliable System Output | Proqnoz və anomaliya göstəricisini birlikdə təqdim etməyi hədəfləyir. | Uzunmüddətli production reliability testi yoxdur. |
“Real vaxtlı” NetIDS çıxışı necə şərh edilməlidir?
Məqalə Şəkil 5-də bir Network Intrusion Detection System (NetIDS) ekranının mövcud şəbəkə vəziyyətini “Attack”, hücum tipini isə “DDoS_HTTP” kimi etiketlədiyini izah edir. Bu, işləyən prototip çıxışının nümunəsidir. Lakin mənbə throughput, paket/saniyə tutumu, end-to-end latency, CPU/RAM istifadəsi və ya gecikmə paylanması kimi real vaxt performans ölçülərini bildirmir. Buna görə “real vaxtlı göstərim” ilə “yüksək həcmli production şəbəkəsində doğrulanmış real vaxt performansı” eyni şey deyil.
Bu Tədqiqatda “Model Attacks” Ayrı Eksperiment Kimi Sınaqdan Keçirilibmi?
Mənbə arxitekturda model hücumları və adversarial perturbation-lar üçün ayrıca qat müəyyən etsə də, yayımlanmış ədədi qiymətləndirmə label-flipping məlumat zəhərləmə ssenarisinə yönəlib; backdoor, evasion və ya başqa model hücumu üçün müstəqil hücum intensivliyi, nəzarət qrupu, metrik cədvəli və ya ayrıca müqayisəli nəticə bildirilməmişdir.
Ədəbiyyat boşluğu necə qurulur?
Mənbə əvvəlki tədqiqatların əhəmiyyətli hissəsinin modelləri təmiz və ideal məlumat altında qiymətləndirdiyini, müxtəlif hücum intensivlikləri və hücum növləri qarşısında model ailələrinin sistematik müqayisəsində boşluq olduğunu irəli sürür. Bundan əlavə, əlaqəli ədəbiyyatda anomaly detector poisoning, RONI yanaşması, clean-label poisoning, generative poisoning və DNN məlumat zəhərləmə tədqiqatları müzakirə olunur.
Bununla belə, mövcud məqalənin öz eksperimental dizaynı girişdə müəyyən edilən bütün geniş boşluğu bağlayan hərtərəfli çox-model və çox-hücum benchmark-ı deyil. Tətbiq olunan əsas model Random Forest, əsas eksperimental hücum isə label-flipping-dir.
Tədqiqatın Metodu və Nəticələri
Tədqiqat dizaynının mənbədə görünən ardıcıllığı
- Model əvvəlcə təmiz məlumat üzərində təlim edilmişdir.
- Label-flipping hücumları simulyasiya edilərək təlim etiketləri qəsdən dəyişdirilmişdir.
- Şəbəkə trafikindən statistik, struktur və davranış xüsusiyyətləri çıxarılmışdır.
- Random Forest clean/poisoned və ya düzgün/yanlış etiket əlaqələrindəki nümunələri ayırmaq məqsədilə istifadə edilmişdir.
- Ağac proqnozları çoxluq səsverməsi ilə birləşdirilmişdir.
- Ağaclararası fikir ayrılığı, xüsusiyyət əhəmiyyəti, outlier detection və consistency checks istifadə edilərək şübhəli nümunələr işarələnmişdir.
- Şübhəli nümunələrin yenidən çəkiləndirilməsi və ya çıxarılması və modelin yenidən təlim edilməsi nəzərdə tutulmuşdur.
- Yekun performans classification report və %98,47 accuracy ilə bildirilmişdir.
Eksperimental məlumat dəstinin ədədi xülasəsi
| Element | Mənbədə bildirilən məlumat | Aydınlıq vəziyyəti |
|---|---|---|
| Ümumi qeyd | 4.916 | Şəkil 3 ekran çıxışında görünür. |
| Sinif sayı | 4 | MITM, Normal, DDoS_HTTP, Ransomware kimi görünür. |
| Sinif başına qeyd | 1.229 | Abstract, Results və Şəkil 3 ilə uyğundur. |
| Məlumat balansı | Balanslaşdırılmış | Hər sinif eyni support dəyərinə malikdir. |
| Xüsusiyyət/sütun sayı | Abstract: 63 xüsusiyyət; Şəkil 3: 63 sütun | Etiket sütunlarının 63-ün daxilində olub-olmadığı açıq şəkildə ayrılmayıb. |
| Proqramlaşdırma dili | Python | Mənbə bunu açıq şəkildə bildirir. |
| Model | Random Forest | Əsas müdafiə/təsnifat modeli. |
| Əsas hücum | Label-flipping | Eksperimental qiymətləndirmənin mərkəzi. |
| Accuracy | %98,47 | Mənbənin əsas bildirilən nəticəsi. |
Classification report nə göstərir?
| Ədədi sinif | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| 0 | 1,00 | 1,00 | 1,00 | 1.229 |
| 1 | 0,94 | 1,00 | 0,97 | 1.229 |
| 2 | 1,00 | 1,00 | 1,00 | 1.229 |
| 3 | 1,00 | 0,94 | 0,97 | 1.229 |
| Macro average | 0,99 | 0,98 | 0,98 | 4.916 |
| Weighted average | 0,99 | 0,98 | 0,98 | 4.916 |
Şəkil 4-dəki classification report sətri accuracy dəyərini iki onluq göstərimdə 0,98 kimi yuvarlaqlaşdırdığı halda, eyni konsol çıxışının altında “Accuracy: 98.47%” məlumatı verilir. Verianla əsas nəticəni mənbədə açıq şəkildə verilən %98,47 kimi qoruyur.
Ədədi sinif 0–3-ün MITM, Normal, DDoS_HTTP və Ransomware siniflərinə uyğunluqları classification report daxilində adlandırılmır. Şəkil 3 yalnız dörd sinif adının hər birində 1.229 qeyd olduğunu göstərir. Buna görə “MITM precision 0,94-dür” və ya “Ransomware recall 0,94-dür” kimi uyğunlaşdırma aparmaq mənbədə olmayan məlumat yaratmaq olardı.
Precision, recall və F1-score nəyi ölçür?
Aşağıdakı düsturlar məqalənin özgün tənlikləri deyil; mənbədə bildirilən performans metriklərinin standart mənasını öyrətmək üçün verilmişdir.
\[ Precision = \frac{TP}{TP+FP} \]
Precision modelin müəyyən sinif kimi proqnozlaşdırdığı nümunələrin nə qədərinin həqiqətən həmin sinfə aid olduğunu ölçür.
\[ Recall = \frac{TP}{TP+FN} \]
Recall həqiqətən müəyyən sinfə aid olan nümunələrin nə qədərinin model tərəfindən tutulduğunu ölçür.
\[ F1 = 2\frac{Precision\times Recall}{Precision+Recall} \]
F1-score precision və recall arasında harmonik orta yaradır. Mənbədə hər sinif eyni support dəyərinə malik olduğuna görə macro average ilə weighted average dəyərlərinin bir-birinə çox yaxın olması gözlənilən haldır; bildirilən cədvəldə hər iki orta precision üçün 0,99, recall və F1 üçün 0,98 kimi görünür.
%98,47 Dəqiqlik Nəticəsi Necə Şərh Edilməlidir?
%98,47 accuracy, mənbənin bildirdiyi məlumat düzəni və Random Forest tətbiqi altında təsnifat proqnozlarının böyük hissəsinin düzgün olduğunu göstərir; lakin zəhərlənmiş nümunələrin aşkarlanma nisbətinin ayrıca %98,47 olduğu, bütün label-flipping intensivliklərində eyni performansın qorunacağı və ya real production şəbəkəsində eyni nəticənin əldə ediləcəyi bu tədqiqat tərəfindən ayrıca göstərilməyib.
98,47% hansı tapşırığa aiddir?
Məqalənin izahı %98,47 dəyərini label-flipping hücumlarına qarşı dayanıqlılıq uğuru kimi şərh edir. Bununla belə, Şəkil 4-də görünən classification report dörd sinif kodu üzrə performans verir və hər sinifdə 1.229 support vardır. Mənbə “poisoned sample” və “clean sample” olmaqla ayrıca ikili detection siniflərinə aid confusion matrix və ya poisoned-sample detection rate təqdim etmir.
Buna görə %98,47-ni ən təhlükəsiz şəkildə “tədqiqatın label-flipping kontekstində bildirdiyi dörd sinifli təsnifat accuracy-si” kimi oxumaq lazımdır. Etiketi zəhərlənmiş qeydlərin özlərinin aşkarlanma həssaslığı üçün mənbədə ayrıca rəqəm yoxdur.
Təlim/test bölünməsi niyə mühüm çatışmazlıqdır?
Məqalə train/test split nisbətini, cross-validation düzənini və ya müstəqil hold-out test dəstini izah etmir. Şəkil 3-də təmizlənmiş məlumat dəsti 4.916 sətir kimi göründüyü halda Şəkil 4-dəki classification report-un support cəmi də 4.916-dır. Bu müşahidə performansın məlumatların hansı alt çoxluğunda hesablandığını təkrar istehsal oluna bilən şəkildə doğrulamağı çətinləşdirir.
Bu vəziyyətdən avtomatik olaraq “model təlim məlumatı üzərində test edilib” nəticəsi çıxarıla bilməz; mənbə eksperiment kodunu və məlumat bölünməsi addımlarını kifayət qədər təfərrüatla göstərmədiyinə görə düzgün ifadə müstəqil test bölünməsinin PDF-dən doğrulana bilməməsidir.
Hiperparametrlər bildirilirmi?
Xeyr. Mənbə Random Forest-dakı qərar ağaclarının sayını, maksimum dərinliyi, minimum leaf ölçüsünü, max_features parametrini, bootstrap parametrlərini, random seed-i və ya class_weight parametrini vermir. Eyni şəkildə feature-importance hesablama növü, outlier detector və yenidən çəkiləndirmə parametrləri də bildirilməyib.
Label-flipping hücumunun intensivliyi bildirilirmi?
Xeyr. Mənbə etiketlərin qəsdən dəyişdirildiyini və modelin əvvəlcə clean data üzərində təlim edildikdən sonra label-flipping simulyasiyasına məruz qaldığını bildirir; lakin ümumi qeydlərin neçə faizinin dəyişdirildiyi, hansı sinifdən hansı sinfə çevrildiyi və hücumun təsadüfi yoxsa hədəfli tətbiq edildiyi açıq şəkildə bildirilmir.
Dörd sinfin balanslaşdırılmış olması nə deməkdir?
Hər sinfin 1.229 qeyd daşıması qiymətləndirmədə böyük sinfin kiçik sinifləri say baxımından sıxışdırmasının qarşısını alır. Bununla belə, balanslaşdırılmış məlumat dəsti real istehsal şəbəkəsindəki hücum tezliklərini təmsil etmək məcburiyyətində deyil. Mənbə real dünya prevalensiyasına görə yenidən çəkiləndirilmiş saha testi təqdim etmir.
Mənbənin Şəkil 5 və Şəkil 6 nəticələri
Səhifə 5-dəki Şəkil 5 “Attack label”, Şəkil 6 isə “Normal label” üçün seçilmiş IP network signature sütun qrafiklərini göstərir. Hər iki qrafikdə protokol və şəbəkə sahələrinin nümunə səviyyəsində fərqli dəyərləri vizuallaşdırılmışdır. Mənbə bu qrafiklərin y oxuna fiziki vahid və ya normallaşdırma tərifi vermədiyinə görə sütun hündürlüklərindən dəqiq elmi hədd və ya feature importance balı çıxarılmayıb.
Mənbədə açıq şəkildə bildirilən əsas nəticələr
- Random Forest əsaslı çərçivə üçün əsas accuracy %98,47 kimi bildirilmişdir.
- Dörd ədədi sinfin hər birində support 1.229-dur.
- Sinif 0 və 2 üçün görünən precision, recall və F1-score dəyərləri 1,00-dır.
- Sinif 1 üçün precision 0,94, recall 1,00, F1-score 0,97-dir.
- Sinif 3 üçün precision 1,00, recall 0,94, F1-score 0,97-dir.
- Macro və weighted average precision 0,99; recall 0,98; F1-score 0,98 kimi görünür.
- Mənbə Random Forest ensemble strukturunun label-flipping təsirini azalda bildiyini şərh edir.
- Mənbə feature-label discrepancy, tree disagreement, outlier detection, consistency check və feature importance komponentlərini zəhərli nümunələri işarələmək üçün birlikdə təsvir edir.
Tədqiqatın dəstəkləmədiyi nəticələr
- %98,47 dəyərinin bütün data poisoning növlərində keçərli olduğu göstərilməyib.
- Backdoor və ya başqa model hücumları üçün %98,47 uğur göstərilməyib.
- Poisoned-sample detection rate ayrıca metrik kimi bildirilməyib.
- Real istehsal şəbəkəsində latency, throughput və ya uzunmüddətli performans doğrulaması aparılmayıb.
- Modelin fərqli poison nisbətlərində necə davrandığı göstərilməyib.
- Random Forest başqa modellərlə eyni məlumat üzərində nəzarətli benchmark-a məruz qalmayıb.
- Müəyyən named class ilə 0–3 ədədi class kodlarının uyğunluğu açıq şəkildə verilməyib.
- 63 sütunun hamısının predictor feature olduğu doğrulana bilmir.
- Müstəqil hold-out test dəsti və ya cross-validation proseduru PDF-dən doğrulana bilmir.
Təkrar istehsal oluna bilmə baxımından natamam bildirilən məlumatlar
| Məlumat | Vəziyyət | Niyə vacibdir? |
|---|---|---|
| Məlumat dəstinin özgün mənbəyi / yükləmə ünvanı | Bildirilmir | Müstəqil təkrar istehsalı çətinləşdirir. |
| Train/validation/test split | Bildirilmir | Ümumiləşdirmə performansının necə ölçüldüyü doğrulana bilmir. |
| Cross-validation | Bildirilmir | Tək bölünmədən asılılıq qiymətləndirilə bilmir. |
| Poisoning nisbəti | Bildirilmir | Dayanıqlılığın hücum şiddətinə görə necə dəyişdiyi məlum deyil. |
| Label-flip uyğunlaşdırma qaydası | Bildirilmir | Hansı siniflərin hansı siniflərə çevrildiyi məlum deyil. |
| Random Forest ağac sayı | Bildirilmir | Ensemble tutumu yenidən qurula bilmir. |
| Digər Random Forest hiperparametrləri | Bildirilmir | Model davranışı və overfitting riski qiymətləndirilə bilmir. |
| Random seed | Bildirilmir | Eksperimentin təkrarlana bilməsi azalır. |
| Outlier detection alqoritmi/həddi | Bildirilmir | Şübhəli qeyd aşkarlanması təkrar istehsal oluna bilmir. |
| Reweighting/removal qaydası | Bildirilmir | Məlumat təmizləmə addımı kəmiyyət baxımından qeyri-müəyyən qalır. |
| Poison detection confusion matrix | Bildirilmir | “Zəhərli qeydi aşkarlama” uğuru ayrıca ölçülə bilmir. |
| Avadanlıq və işləmə müddəti | Bildirilmir | Real vaxt performansı qiymətləndirilə bilmir. |
Tədqiqatın elmi dəyəri nədədir?
Mənbənin ən aydın töhfəsi label-flipping təhdidini şəbəkə hücumu təsnifatı kontekstində nəzərdən keçirərək Random Forest ensemble strukturunu, feature-label consistency yoxlamasını və şübhəli qeyd təmizliyini eyni müdafiə axınında birləşdirməsidir. Tədqiqat həmçinin dörd balanslaşdırılmış sinifdə yüksək təsnifat performansı bildirir.
Bunun əksinə, məqalənin qısa olması və eksperiment detallarının məhdud bildirilməsi nəticənin təkrar istehsalı və fərqli poisoning intensivliklərinə ümumiləşdirilməsi ilə bağlı açıq suallar saxlayır. Bu məhdudiyyətləri görünən saxlamaq tədqiqatın nəticəsini kiçiltmək deyil; %98,47 dəyərinin hansı məlumatla dəstəkləndiyini və hansı əlavə məlumatların PDF-də olmadığını düzgün ayırmaqdır.
Mənbə və Metod Qeydi
Özgün başlıq: Robust Machine Learning under Data Poisoning and Model Attacks
Müəlliflər və sıra: Promise Enyindah; Chigoziri Bobby Marcus.
Corresponding author: Promise Enyindah.
Corresponding author e-poçt: promise.enyindah@uniport.edu.ng
ORCID: PDF-də yerləşdirilmiş ORCID bağlantıları müəllif sırasına uyğun olaraq Promise Enyindah üçün 0000-0001-6246-7077 və Chigoziri Bobby Marcus üçün 0000-0003-4773-0222 ünvanlarına yönəlir.
Qurum: Department of Computer Science, University of Port Harcourt, Choba, Nigeria.
Bərabər töhfə: Mənbədə bərabər töhfə və ya bərabər birinci müəlliflik bəyanı aşkar edilməmişdir.
Jurnal: European Journal of Electrical Engineering and Computer Science (EJECE).
Nəşriyyat / platforma: European Open Science.
ISSN: 2736-5751.
Cild / say: Volume 10, Issue 1.
Səhifələr: 31–36.
DOI: 10.24018/ejece.2026.10.1.70077.
Rəsmi nəşr qeydi: European Open Science EJECE, article ID 70077; DOI qeydi yuxarıdakı DOI ilə uyğun gəlir.
Mənbə növü: Research Article.
Hakimlik vəziyyəti: Jurnalın rəsmi “About the Journal” səhifəsi EJECE-ni peer-reviewed beynəlxalq jurnal kimi müəyyən edir və double-blind peer review istifadə etdiyini bildirir.
Submitted: 12 yanvar 2026.
Published: 10 fevral 2026.
Buraxılış ayı üçün biblioqrafik qeyd: Məqalə PDF-sinin masthead hissəsində “February 2026” yazılıb. RePEc/EconPapers indeks qeydi eyni Volume 10 Issue 1-i January 2026 kimi siyahıya alır. Verianla məqalə səviyyəsində açıq tarix kimi PDF-də verilmiş 10 fevral 2026 tarixini əsas götürür və iki qeyd arasındakı issue-month fərqini gizlətmir.
Lisenziya: Məqalə PDF-sinin öz müəllif hüquqları sətri Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International (CC BY-NC-SA 4.0) göstərir.
Lisenziya uyğunluğu qeydi: Jurnalın cari veb siyasətlərində lisenziya ifadələri həm bir-biri ilə, həm də bu PDF ilə tam uyğun deyil: submission copyright səhifəsində CC BY-SA 4.0, Open Access Policy səhifəsində isə CC BY-NC 4.0 yazılır. Buna görə Verianla bu tədqiqat üçün məqalə PDF-sindəki article-level lisenziya bəyanını provenance məlumatı kimi qeydə alır; mənbə şəkillərin vizual dizaynını kopyalamaq əvəzinə yalnız elmi əlaqələrdən müstəqil sxem yaradır.
Preprint vəziyyəti: İncelənən PDF yayımlanmış jurnal məqaləsidir. Mənbədə bu tədqiqat üçün ayrıca preprint identifikatoru göstərilmir.
Əsas eksperimental hücum: Label-flipping data poisoning.
Başlıqdakı “model attacks” əhatəsi: Arxitekturda adversarial/model attack qatı müəyyən edilir; lakin ayrıca model-attack benchmark-ı və ya müstəqil ədədi nəticə bildirilmir.
Məlumat: Şəkil 3-də dörd balanslaşdırılmış sinif; hər sinifdə 1.229 qeyd və ümumilikdə 4.916 sətir görünür. Siniflər MITM, Normal, DDoS_HTTP və Ransomware kimi siyahılanıb.
Xüsusiyyət sayı: Abstract 63 feature göstərir; Şəkil 3 təmizlənmiş məlumat çərçivəsini 63 sütun kimi göstərir. Attack_label və Attack_type sütunlarının da görünməsi səbəbindən predictor sayının hədəf sütunlarından əlavə ayrıca 63 olub-olmadığı aydın deyil.
Model: Random Forest classifier.
Ensemble mexanizmi: Bootstrap nümunələr üzərində qərar ağacları, random feature selection və majority voting.
Əlavə müdafiə mexanizmləri: Feature importance analysis, outlier detection, consistency checks, tree disagreement monitoring, şübhəli nümunələrin reweight/remove edilməsi və retraining.
Əsas nəticə: %98,47 accuracy.
Classification report: Dörd ədədi sinfin hər birində support 1.229; class 0: 1,00/1,00/1,00; class 1: 0,94/1,00/0,97; class 2: 1,00/1,00/1,00; class 3: 1,00/0,94/0,97 precision/recall/F1. Class kodlarının adlandırılmış siniflərlə açıq uyğunluğu bildirilməyib.
Train/test doğrulaması: Mənbə train/test split, validation split və ya cross-validation prosedurunu açıq şəkildə bildirmir.
Hiperparametrlər: Ağac sayı daxil olmaqla Random Forest hiperparametrləri bildirilmir.
Poisoning parametrləri: Zəhərləmə nisbəti, dəyişdirilmiş qeyd sayı və label-flip sinif uyğunlaşdırma matrisi bildirilmir.
Statistik qeyri-müəyyənlik: Confidence interval, standard deviation, repeated-run variance, p-dəyəri və ya başqa inferensial qeyri-müəyyənlik təhlili bildirilmir.
Maliyyələşdirmə: İncelənən PDF-də ayrıca funding statement aşkar edilməmişdir; maliyyələşdirmənin olmadığı fərz edilməmişdir.
Məlumat əlçatanlığı: İncelənən PDF-də ayrıca Data Availability Statement və ya məlumat deposu bağlantısı aşkar edilməmişdir.
Müəllif töhfələri: Ayrıca author contributions / CRediT bəyanı aşkar edilməmişdir.
Etika komitəsi: Ayrıca ethics approval və ya informed consent bəyanı aşkar edilməmişdir; tədqiqat insan/heyvan araşdırması kimi bildirilməyib.
Maraqların toqquşması: Müəlliflər maraqların toqquşmasının olmadığını bəyan edirlər.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib