


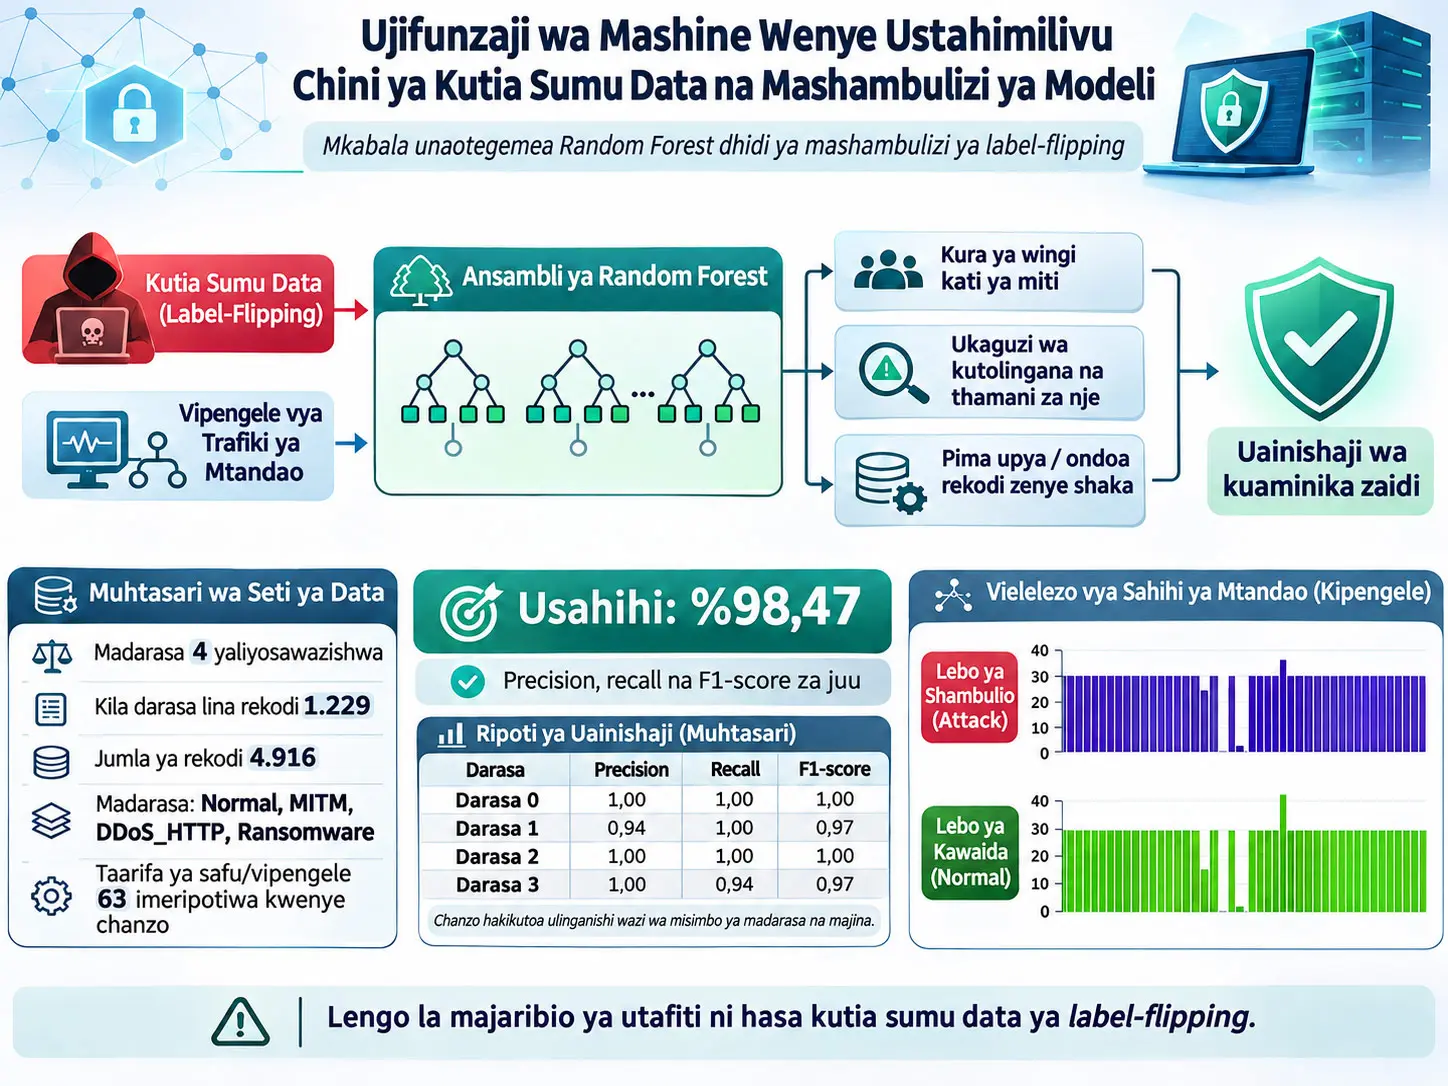
Mfumo wa ujifunzaji wa mashine wenye ustahimilivu unaotegemea Random Forest ni mkabala wa ujifunzaji wa mkusanyiko unaolenga kudumisha uaminifu wa uainishaji wa trafiki ya mtandao dhidi ya mashambulizi ya kutia sumu data ya label-flipping, yanayotengenezwa kwa kubadilisha kwa nia ovu lebo katika data ya mafunzo. Utafiti ulitumia Random Forest kwenye muundo wa data uliosawazishwa unaojumuisha trafiki ya kawaida ya mtandao pamoja na madarasa ya MITM, DDoS_HTTP na Ransomware; katika matokeo ya skrini ya chanzo kila moja ya madarasa manne lina rekodi 1.229, huku data yote iliyosafishwa ikionyeshwa kuwa na mistari 4.916 na safu 63. Matokeo makuu ya modeli ni usahihi wa %98,47. Hata hivyo, kwa kuwa makala hairipoti uwiano wa lebo zilizotiwa sumu, ni lebo zipi zilizobadilishwa kuwa madarasa gani, mgawanyo wa mafunzo/test, idadi ya miti au hyperparameters nyingine za Random Forest, thamani ya %98,47 inapaswa kufasiriwa ndani ya hali za majaribio zilizoripotiwa pekee.
Modeli kuu ya shambulizi katika utafiti ni shambulizi la label-flipping: mshambuliaji hubadilisha lebo za darasa za sampuli za mafunzo bila kubadilisha thamani za vipengele, akijaribu kufanya modeli ijifunze mipaka isiyo sahihi ya maamuzi. Chanzo kinahoji kuwa Random Forest inaweza kupunguza kiwango ambacho rekodi moja moja zilizotiwa sumu zinaathiri mkusanyiko mzima kwa kiwango sawa, kutokana na bootstrap sampling, uteuzi wa vipengele kwa nasibu na upigaji kura wa wengi wa miti mingi ya maamuzi. Pia inapendekezwa kuweka alama kwenye rekodi zinazotiliwa shaka kwa kutumia kutolingana kwa kipengele-lebo, kutokubaliana kwa kiwango kikubwa kati ya miti, umuhimu wa vipengele, outlier detection na consistency checks; kisha rekodi hizo ziwekewe uzito upya au ziondolewe na modeli ifundishwe tena.
Ingawa kichwa cha chanzo kina neno “Model Attacks” na usanifu unaeleza “model attack and adversarial perturbation layer” tofauti, utendaji wa majaribio ulioripotiwa unategemea hasa mazingira ya kutia sumu data ya label-flipping. Chanzo hakitoi kiwango huru cha shambulizi, itifaki ya test na jedwali la utendaji kwa backdoor, inference-time adversarial perturbation au shambulizi jingine la modeli. Kwa hiyo, si sahihi kufasiri matokeo ya %98,47 ya utafiti kama ushahidi wa ustahimilivu wa jumla dhidi ya mashambulizi yote ya modeli.
Ripoti ya uainishaji katika Kielelezo 4 inaonyesha thamani ya support ya 1.229 kwa madarasa manne ya nambari. Kwa darasa 0, precision/recall/F1 ni 1,00/1,00/1,00; kwa darasa 1 ni 0,94/1,00/0,97; kwa darasa 2 ni 1,00/1,00/1,00; na kwa darasa 3 ni 1,00/0,94/0,97. Hata hivyo, kwa kuwa PDF haitoi jedwali la wazi la kulinganisha misimbo hii ya nambari na majina MITM, Normal, DDoS_HTTP na Ransomware, haiwezekani kusema kwa uaminifu ni darasa gani lenye jina linalokuwa na precision 0,94 au recall 0,94.
Kwa nini kutia sumu data ni tatizo tofauti la usalama kwa ujifunzaji wa mashine?
Modeli ya ujifunzaji wa mashine si algoriti pekee; muundo wa maamuzi ambao modeli hujifunza unategemea data ya mafunzo. Katika shambulizi la kutia sumu data, mshambuliaji hubadilisha data inayotumiwa wakati wa kufundisha modeli kwa lengo la kuifanya baadaye itoe maamuzi yasiyo sahihi. Kwa hiyo, shambulizi hili halilengi tu kudanganya ingizo moja la test, bali kuvuruga mchakato wenyewe wa ujifunzaji wa modeli.
Katika hali inayolengwa na utafiti wa chanzo, mshambuliaji hubadilisha lebo za darasa badala ya kubadilisha vipengele vilivyotolewa kutoka kwenye pakiti za mtandao au rekodi za mtandao. Rekodi kama hiyo inaweza kuonekana kwa nje kama rekodi ya kawaida ya mtandao; lakini kubadilishwa kwa taarifa ya “rekodi hii ni ya darasa gani” kunaweza kuifanya modeli ijifunze uhusiano usio sahihi kati ya vipengele na darasa.
Shambulizi la Label-Flipping ni Nini?
Shambulizi la label-flipping ni shambulizi la kutia sumu data ambalo kwa kiasi kikubwa huhifadhi thamani za vipengele vya sampuli za mafunzo huku likibadilisha kwa makusudi lebo sahihi za darasa kuwa lebo za madarasa mengine; katika utafiti huu lengo ni kuvuruga uhusiano kati ya vipengele vya trafiki ya mtandao na lebo ya darasa iliyotolewa ili kufanya kiainishaji kijifunze maamuzi yasiyo sahihi.
Kwa nini kugundua huwa vigumu zaidi ikiwa kipengele kinabaki kilekile lakini lebo inabadilika?
Katika shambulizi la outlier, sampuli ovu inaweza kuwa mbali kimwili au kitakwimu na usambazaji wa kawaida. Katika shambulizi la label-flipping, vekta ya vipengele inaweza kufanana na rekodi ya kawaida ya trafiki. Tatizo si vipengele bali kutokuaminika kwa lebo. Kwa hiyo, ukaguzi wa “je, kuna thamani isiyo ya kawaida?” pekee huenda usitoshe; uhusiano wa kipengele-lebo, tofauti za maamuzi kati ya miti na uthabiti unaojitokeza baada ya kufundisha tena pia huwa muhimu.
Kutia sumu data na shambulizi la modeli si kitu kilekile
Katika utangulizi, chanzo kinahusisha kutia sumu data na kuharibika kwa data ya mafunzo, huku mashambulizi ya modeli yakihusishwa na kutumia udhaifu wakati wa mafunzo au inference. Mashambulizi ya modeli yanaweza kujumuisha eneo pana zaidi kama tabia za backdoor au manipulations za adversarial zinazochochea uainishaji usio sahihi. Hata hivyo, sehemu ya majaribio ya makala hii haijaribu kwa kulinganisha familia hii yote ya mashambulizi; tathmini ya nambari inajikita katika mazingira ya label-flipping.
Muundo wa data wa utafiti
Sehemu ya abstract ya makala inasema kuwa kila darasa lina rekodi 1.229 na vipengele 63 vilitolewa kutoka kwenye mtandao. Matokeo ya skrini ya Kielelezo 3 kwenye ukurasa wa 4 yanaonyesha wazi madarasa manne yaliyosawazishwa: MITM, Normal, DDoS_HTTP na Ransomware. Katika matokeo hayo hayo ya skrini, seti ya data iliyosafishwa inaonekana kama “4916 rows × 63 columns”.
| Darasa | Idadi ya rekodi inayoonekana kwenye chanzo | Hali |
|---|---|---|
| MITM | 1.229 | Imeorodheshwa wazi katika matokeo ya console ya Kielelezo 3. |
| Normal | 1.229 | Imeorodheshwa wazi katika matokeo ya console ya Kielelezo 3. |
| DDoS_HTTP | 1.229 | Imeorodheshwa wazi katika matokeo ya console ya Kielelezo 3. |
| Ransomware | 1.229 | Imeorodheshwa wazi katika matokeo ya console ya Kielelezo 3. |
| Jumla | 4.916 | 1.229 × 4; ni sawa na jumla ya mistari katika Kielelezo 3. |
Hapa kuna maelezo muhimu ya kuripoti. Ingawa Abstract inatumia kauli “63 features”, Kielelezo 3 kinaonyesha data frame yenye safu 63, na kati ya safu zinazoonekana kuna Attack_label na Attack_type. PDF haitenganishi wazi kama, baada ya kuondoa safu za lengo/lebo, predictor huru 63 zilitumika kweli. Kwa hiyo, Verianla haitengenezi kwa niaba ya chanzo hitimisho la “predictor feature 63 zilitumika kwa uhakika”.
Vipengele vya mtandao vinavyoonekana kwenye chanzo vinawakilisha nini?
Chanzo hakitoi moja kwa moja kamusi kamili ya data ya sehemu zote 63. Maandishi yanatoa mifano ya sehemu kama frame.time, ip.src_host na ip.dst_host. Kwenye mhimili wa x wa grafu za saini za sampuli za attack na normal katika ukurasa wa 5, majina mbalimbali ya sehemu yanayohusiana na ARP, ICMP, HTTP, TCP, UDP, DNS, MQTT na Modbus/TCP pia yanaonekana. Hizi zinaweza kuwakilisha muda wa mtiririko wa trafiki, anwani za chanzo/lengo, tabia za itifaki, porti, taarifa za mpangilio/urefu au vipengele vya ujumbe vya tabaka la programu.
Hata hivyo, kitengo cha kipimo kwenye mhimili wa y wa Kielelezo 5 na Kielelezo 6, pamoja na jinsi kila nguzo ilivyonormalishwa, hakijaelezwa. Kwa hiyo grafu hizi mbili hazipaswi kufasiriwa kama grafu za kiasi za feature-importance kwa maana ya “ni kipengele gani cha itifaki kilicho muhimu zaidi kisayansi kwa kiwango fulani”. Chanzo huzitumia kama matokeo ya kuona ya saini za mtandao za sampuli zilizopewa lebo ya attack na normal.
Kiini kikuu cha ulinzi cha modeli: Random Forest
Random Forest ni mbinu ya ensemble inayofundisha miti mingi ya maamuzi kwenye sampuli tofauti za data za bootstrap na vikundi vidogo vya vipengele vilivyochaguliwa kwa nasibu, kisha kuunganisha utabiri wa miti hiyo kuwa uamuzi wa mkusanyiko. Mantiki ya ulinzi ya chanzo ni kwamba rekodi moja iliyotiwa sumu isiathiri miti yote kwa namna ileile na kwamba kosa la mti mmoja liweze kupunguzwa ndani ya upigaji kura wa wengi.
Makala inaonyesha seti ya data safi/asilia kwa D, sampuli zilizotiwa sumu kwa Dp na seti ya mafunzo iliyoharibika inayoundwa nazo kwa D′:
\[ D' = D \cup D_p \]
Usemi huu unaeleza nini? Chanzo kinaonyesha kwa muungano wa seti hali ya kidhana ambapo data safi na sampuli zilizotiwa sumu au kuwekewa lebo isiyo sahihi kwa pamoja huunda seti ya mafunzo. Mlinganyo huu hautoi algoriti kamili ya kutengeneza shambulizi; PDF haisemi ni rekodi ngapi zilizotiwa sumu, zilibadilishwa kutoka darasa gani kwenda darasa gani, au uwiano wa sumu ulikuwa kiasi gani.
Kwa Nini Random Forest Inaweza Kutoa Ustahimilivu Dhidi ya Mashambulizi ya Label-Flipping?
Kwa sababu Random Forest hufundisha kila mti wa maamuzi kwenye sampuli tofauti zilizochaguliwa kwa bootstrap na vikundi vidogo tofauti vya vipengele, athari za rekodi zilizotiwa sumu huenda zisisambae kwa namna ileile kwenye miti yote; pia uamuzi wa mwisho kutolewa kwa kura ya wengi ya miti mingi unaweza kupunguza athari ya makosa ya mti mmoja mmoja, lakini utaratibu huu hauifanyi Random Forest kuwa na kinga ya moja kwa moja au isiyo na masharti dhidi ya kutia sumu data.
Bootstrap sampling hufanya nini?
Katika bootstrap sampling, kila mti wa maamuzi huona seti ndogo tofauti ya data kupitia sampuli kutoka kwenye seti ya mafunzo kwa kuruhusu uteuzi wa kurudiwa. Kulingana na tafsiri ya chanzo, muundo huu unaweza kufanya rekodi zenye sumu ziathiri baadhi tu ya miti na kuzuia mkusanyiko mzima kukumbwa na uharibifu uleule. Hata hivyo, athari halisi hutegemea uwiano wa sumu, muundo wa madarasa na idadi ya miti; makala hairipoti vigezo hivi kwa mfululizo wa kina wa majaribio.
Uteuzi wa vipengele kwa nasibu hufanya nini?
Kutathmini tu kikundi kidogo cha vipengele katika kila mgawanyiko wa mti wa maamuzi huunda utofauti kati ya miti. Hivyo, utegemezi mkubwa wa miti yote kwa uhusiano uleule wa vipengele unaweza kupunguzwa. Chanzo kinawasilisha hili kama utaratibu unaozuia kutolingana fulani kwa kipengele-lebo katika sampuli zilizotiwa sumu kuathiri mipaka ya maamuzi daima katika mwelekeo uleule.
Upigaji kura wa wengi huhesabiwaje?
Chanzo kinatoa uamuzi wa mwisho wa darasa wa Random Forest kwa mlinganyo ufuatao:
\[ \hat{y} = \operatorname*{arg\,max}_{c} \sum_{t=1}^{T} \mathbb{I}\bigl(h_t(x)=c\bigr) \]
Formula inahesabu nini? Inahesabu kila mti ulipiga kura kwa darasa gani na kuchagua darasa lililopata kura nyingi zaidi kama utabiri wa mwisho.
- \(\hat{y}\): Darasa la mwisho linalotabiriwa na Random Forest.
- \(c\): Lebo ya darasa linalogombea.
- \(T\): Idadi ya miti ya maamuzi katika mkusanyiko.
- \(h_t(x)\): Darasa linalotolewa na mti wa maamuzi wa \(t\) kwa sampuli \(x\).
- \(\mathbb{I}(\cdot)\): Kazi ya kiashiria yenye thamani 1 ikiwa sharti ni kweli na 0 ikiwa si kweli.
- \(\sum\): Jumla ya kura kwa darasa fulani.
- \(\operatorname*{arg\,max}\): Operesheni inayochagua darasa lenye idadi kubwa zaidi ya kura.
Mlinganyo hauna kitengo; hutoa uamuzi kwa kuhesabu kura za madarasa. Kwa mfano, ikiwa darasa moja limechaguliwa na idadi kubwa zaidi ya miti, matokeo ya mwisho ya Random Forest huwa darasa hilo. Chanzo hakiripoti idadi halisi ya miti \(T\) iliyotumika.
Kwa nini kutokubaliana kati ya miti hutumiwa kama ishara ya shaka?
Katika mfumo wa chanzo, kutokubaliana kwa kiwango kikubwa kati ya utabiri wa miti ya maamuzi kwa sampuli ileile huchukuliwa kuwa hali ya kutia shaka. Mantiki ni kwamba pale ambapo kuna uhusiano usio wa kawaida kati ya vipengele na lebo iliyowekwa, miti inayotumia sampuli tofauti za bootstrap na vikundi vidogo vya vipengele inaweza kutoa maamuzi yenye uthabiti mdogo. Hata hivyo, makala hairipoti kizingiti cha nambari cha “kutokubaliana kwa kiwango kikubwa”.
Umuhimu wa vipengele, outlier na ukaguzi wa uthabiti
Badala ya kutumia matokeo ya Random Forest pekee, chanzo kinalenga kutenga rekodi zilizotiwa sumu kwa kutumia feature importance analysis, outlier detection na consistency checks. Inaelezwa kuwa rekodi zilizowekwa alama kuwa za kutia shaka zinaweza kuwekewa uzito upya au kuondolewa kwenye seti ya data, kisha modeli ikafundishwa tena.
Hata hivyo, PDF haitoi maelezo yafuatayo: jina la algoriti ya outlier iliyotumika, aina ya feature-importance, ufafanuzi wa kihisabati wa alama ya uthabiti, viwango vya kizingiti, mgawo wa kuweka uzito upya na sharti ambalo rekodi huondolewa. Kwa hiyo, si sahihi kubadilisha vipengele hivi kuwa algoriti yenye maelezo zaidi kuliko chanzo kinavyoeleza.
Vipengele vinane vya utendaji vya usanifu wa chanzo
| Kipengele | Kazi iliyotolewa kwenye chanzo | Mpaka wa tafsiri |
|---|---|---|
| Data Poisoning Input Layer | Huwakilisha sampuli za mafunzo zilizobadilishwa vibaya au kuwekewa lebo isiyo sahihi. | Uwiano wa sumu na matriki ya label-flip havijaripotiwa. |
| Model Attack / Adversarial Perturbation Layer | Huwakilisha manipulations za adversarial zinazolenga kupotosha modeli wakati wa mafunzo au inference. | Jaribio tofauti la nambari la shambulizi halijatolewa. |
| Robust Random Forest Core | Hufundisha miti mingi ya maamuzi kwenye vikundi vidogo vya data/vipengele vilivyochaguliwa kwa nasibu. | Idadi ya miti na hyperparameters hazijaripotiwa. |
| Individual Decision Trees | Hujifunza sheria huru za maamuzi kutoka sehemu tofauti za data. | Utendaji wa kila mti haujaripotiwa. |
| Ensemble Voting | Huunganisha kura za miti kwa uamuzi wa wengi. | Kizingiti cha kuamini kura au sheria ya tie-break haijaelezwa. |
| Secure Prediction Output | Hutoa utabiri wa mwisho kupitia Ensemble consensus. | Neno “Secure” halimaanishi dhamana ya usalama katika mazingira halisi. |
| Anomaly Detection and Alert | Huashiria mifumo isiyo ya kawaida ya utabiri inayohusiana na label-flipping au tabia ya adversarial. | Kizingiti cha tahadhari na metrika tofauti ya detection havijaripotiwa. |
| Reliable System Output | Hulenga kuwasilisha utabiri na kiashiria cha anomalia kwa pamoja. | Hakuna jaribio la muda mrefu la production reliability. |
Matokeo ya NetIDS ya “muda halisi” yanapaswa kufasiriwaje?
Makala inaeleza kuwa katika Kielelezo 5 skrini ya Network Intrusion Detection System (NetIDS) imeweka hali ya sasa ya mtandao kama “Attack” na aina ya shambulizi kama “DDoS_HTTP”. Huu ni mfano wa matokeo ya prototipu inayofanya kazi. Hata hivyo, chanzo hakiripoti vipimo vya utendaji wa muda halisi kama throughput, uwezo wa pakiti/sekunde, end-to-end latency, matumizi ya CPU/RAM au usambazaji wa ucheleweshaji. Kwa hiyo, “onyesho la muda halisi” na “utendaji wa muda halisi uliothibitishwa kwenye mtandao wa production wenye mzigo mkubwa” si kitu kilekile.
Je, “Model Attacks” Zilijaribiwa Kama Jaribio Tofauti Katika Utafiti Huu?
Ingawa chanzo kinafafanua tabaka tofauti kwa mashambulizi ya modeli na adversarial perturbations katika usanifu, tathmini ya nambari iliyochapishwa inajikita kwenye mazingira ya kutia sumu data ya label-flipping; hakuna kiwango huru cha shambulizi, kundi la udhibiti, jedwali la metrika au matokeo tofauti ya kulinganisha yaliyotolewa kwa backdoor, evasion au shambulizi jingine la modeli.
Pengo la fasihi linawekwaje?
Chanzo kinahoji kuwa sehemu kubwa ya tafiti zilizotangulia zilitathmini modeli chini ya data safi na bora, na kwamba kuna pengo katika kulinganisha kwa utaratibu familia za modeli dhidi ya viwango na aina tofauti za mashambulizi. Pia katika fasihi husika zinajadiliwa anomaly detector poisoning, mbinu ya RONI, clean-label poisoning, generative poisoning na tafiti za kutia sumu data za DNN.
Hata hivyo, muundo wa majaribio wa makala hii yenyewe si benchmark pana ya modeli nyingi na mashambulizi mengi inayofunga pengo lote pana lililofafanuliwa katika utangulizi. Modeli kuu iliyotumika ni Random Forest na shambulizi kuu la majaribio ni label-flipping.
Mbinu na Matokeo ya Utafiti
Mfuatano wa muundo wa utafiti unaoonekana kwenye chanzo
- Modeli ilifundishwa kwanza kwenye data safi.
- Mashambulizi ya Label-flipping yalisimuliwa na lebo za mafunzo zikabadilishwa kwa makusudi.
- Vipengele vya kitakwimu, kimuundo na kitabia vilitolewa kutoka kwenye trafiki ya mtandao.
- Random Forest ilitumika kutofautisha mifumo katika mahusiano ya clean/poisoned au lebo sahihi/isiyo sahihi.
- Utabiri wa miti uliunganishwa kwa upigaji kura wa wengi.
- Sampuli zinazotiliwa shaka ziliwekwa alama kwa kutumia kutokubaliana kati ya miti, umuhimu wa vipengele, outlier detection na consistency checks.
- Kuweka uzito upya au kuondoa sampuli zinazotiliwa shaka na kufundisha modeli tena kulipangwa.
- Utendaji wa mwisho uliripotiwa kwa classification report na %98,47 accuracy.
Muhtasari wa nambari wa seti ya data ya majaribio
| Kipengee | Taarifa iliyoripotiwa kwenye chanzo | Hali ya uwazi |
|---|---|---|
| Jumla ya rekodi | 4.916 | Inaonekana katika matokeo ya skrini ya Kielelezo 3. |
| Idadi ya madarasa | 4 | Inaonekana kama MITM, Normal, DDoS_HTTP, Ransomware. |
| Rekodi kwa kila darasa | 1.229 | Inaendana na Abstract, Results na Kielelezo 3. |
| Usawazishaji wa data | Imesawazishwa | Kila darasa lina thamani sawa ya support. |
| Idadi ya vipengele/safu | Abstract: vipengele 63; Kielelezo 3: safu 63 | Haijatenganishwa wazi kama safu za lebo zimo ndani ya 63. |
| Lugha ya programu | Python | Chanzo kinaeleza wazi. |
| Modeli | Random Forest | Modeli kuu ya ulinzi/uainishaji. |
| Shambulizi kuu | Label-flipping | Kiini cha tathmini ya majaribio. |
| Accuracy | %98,47 | Matokeo makuu yaliyoripotiwa na chanzo. |
Classification report inaonyesha nini?
| Darasa la nambari | Precision | Recall | F1-score | Support |
|---|---|---|---|---|
| 0 | 1,00 | 1,00 | 1,00 | 1.229 |
| 1 | 0,94 | 1,00 | 0,97 | 1.229 |
| 2 | 1,00 | 1,00 | 1,00 | 1.229 |
| 3 | 1,00 | 0,94 | 0,97 | 1.229 |
| Macro average | 0,99 | 0,98 | 0,98 | 4.916 |
| Weighted average | 0,99 | 0,98 | 0,98 | 4.916 |
Ingawa mstari wa classification report katika Kielelezo 4 unazungusha thamani ya accuracy kuwa 0,98 katika onyesho la desimali mbili, chini ya matokeo hayo hayo ya console kuna taarifa “Accuracy: 98.47%”. Verianla huhifadhi matokeo makuu kama %98,47 yaliyotolewa wazi kwenye chanzo.
Ulinganifu wa madarasa ya nambari 0–3 na madarasa MITM, Normal, DDoS_HTTP na Ransomware haujatajwa kwa majina ndani ya classification report. Kielelezo 3 kinaonyesha tu kuwa kila moja ya majina manne ya madarasa lina rekodi 1.229. Kwa hiyo, kufanya ulinganifu kama “MITM precision ni 0,94” au “Ransomware recall ni 0,94” kungekuwa kutengeneza taarifa isiyopo kwenye chanzo.
Precision, recall na F1-score hupima nini?
Formula zifuatazo si milinganyo ya asili ya makala; zimetolewa kufundisha maana ya kawaida ya metrika za utendaji zilizoripotiwa kwenye chanzo.
\[ Precision = \frac{TP}{TP+FP} \]
Precision hupima ni sampuli ngapi kati ya zile ambazo modeli ilitabiri kuwa za darasa fulani ambazo kwa kweli ni za darasa hilo.
\[ Recall = \frac{TP}{TP+FN} \]
Recall hupima ni sampuli ngapi kati ya zile ambazo kwa kweli ni za darasa fulani ambazo modeli ilizigundua.
\[ F1 = 2\frac{Precision\times Recall}{Precision+Recall} \]
F1-score huunda wastani wa harmonic kati ya precision na recall. Kwa kuwa kila darasa lina thamani sawa ya support katika chanzo, inatarajiwa kuwa thamani za macro average na weighted average ziwe karibu sana; katika jedwali lililoripotiwa wastani zote mbili zinaonekana kuwa 0,99 kwa precision na 0,98 kwa recall na F1.
Matokeo ya Usahihi wa %98,47 Yanapaswa Kufasiriwaje?
Accuracy ya %98,47 inaonyesha kuwa, chini ya mpangilio wa data na matumizi ya Random Forest yaliyoripotiwa na chanzo, sehemu kubwa ya utabiri wa uainishaji ilikuwa sahihi; hata hivyo, utafiti huu haujaonyesha tofauti kwamba kiwango cha kugundua sampuli zilizotiwa sumu ni %98,47, kwamba utendaji huo huo utadumishwa katika viwango vyote vya label-flipping, au kwamba matokeo yale yale yatapatikana kwenye mtandao halisi wa production.
98,47% ni ya kazi gani?
Maelezo ya makala yanafasiri thamani ya %98,47 kama mafanikio ya ustahimilivu dhidi ya mashambulizi ya label-flipping. Hata hivyo, classification report inayoonekana katika Kielelezo 4 inatoa utendaji kwa misimbo minne ya madarasa na kila darasa lina support 1.229. Chanzo hakitoi confusion matrix au poisoned-sample detection rate kwa madarasa mawili tofauti ya detection yanayoitwa “poisoned sample” na “clean sample”.
Kwa hiyo, njia salama zaidi ni kuisoma %98,47 kama “accuracy ya uainishaji wa madarasa manne iliyoripotiwa na utafiti katika muktadha wa label-flipping”. Hakuna nambari tofauti kwenye chanzo kwa unyeti wa kugundua rekodi zenye lebo zilizotiwa sumu zenyewe.
Kwa nini mgawanyo wa mafunzo/test ni upungufu muhimu?
Makala haielezi uwiano wa train/test split, mpangilio wa cross-validation au seti huru ya hold-out test. Kielelezo 3 kinaonyesha seti ya data iliyosafishwa yenye mistari 4.916, huku jumla ya support katika classification report ya Kielelezo 4 pia ikiwa 4.916. Uchunguzi huu hufanya iwe vigumu kuthibitisha kwa namna inayoweza kurudiwa ni kwenye sehemu gani ya data utendaji ulihesabiwa.
Haiwezekani kutoa moja kwa moja hitimisho kwamba “modeli ilijaribiwa kwenye data ya mafunzo” kutokana na hali hii; kwa kuwa chanzo hakionyeshi msimbo wa majaribio na hatua za kugawa data kwa maelezo ya kutosha, kauli sahihi ni kwamba mgawanyo huru wa test hauwezi kuthibitishwa kutoka kwenye PDF.
Je, hyperparameters zimeripotiwa?
Hapana. Chanzo hakitoi idadi ya miti ya maamuzi katika Random Forest, kina cha juu, ukubwa wa chini wa leaf, mpangilio wa max_features, vigezo vya bootstrap, random seed au mpangilio wa class_weight. Vivyo hivyo, aina ya hesabu ya feature-importance, outlier detector na vigezo vya kuweka uzito upya havijaripotiwa.
Je, kiwango cha shambulizi la label-flipping kimeripotiwa?
Hapana. Chanzo kinasema kuwa lebo zilibadilishwa kwa makusudi na kwamba modeli ilifundishwa kwanza kwenye clean data kabla ya kuwekwa kwenye simulasia ya label-flipping; lakini hakiripoti wazi ni asilimia gani ya rekodi zote ilibadilishwa, zilibadilishwa kutoka darasa gani kwenda darasa gani, na kama shambulizi lilitumika kwa nasibu au kwa kulenga.
Kuwa na madarasa manne yaliyosawazishwa kunamaanisha nini?
Kila darasa kuwa na rekodi 1.229 huzuia darasa kubwa kuzidi madarasa madogo kwa idadi wakati wa tathmini. Hata hivyo, seti ya data iliyosawazishwa si lazima iwakilishe marudio ya mashambulizi katika mtandao halisi wa uzalishaji. Chanzo hakitoi jaribio la mazingira halisi lililowekewa uzito upya kulingana na prevalence ya ulimwengu halisi.
Matokeo ya Kielelezo 5 na Kielelezo 6 cha chanzo
Kielelezo 5 kwenye ukurasa wa 5 kinaonyesha grafu za nguzo za IP network signature zilizochaguliwa kwa “Attack label”, huku Kielelezo 6 kikizionyesha kwa “Normal label”. Grafu zote mbili zinaonyesha thamani tofauti za kiwango cha sampuli za sehemu za itifaki na mtandao. Kwa kuwa chanzo hakitoi kitengo cha kimwili au ufafanuzi wa normalisation kwenye mhimili wa y wa grafu hizi, hakuna kizingiti sahihi cha kisayansi au alama ya feature importance iliyotolewa kutokana na urefu wa nguzo.
Matokeo makuu yaliyoripotiwa wazi kwenye chanzo
- Accuracy kuu ya %98,47 imeripotiwa kwa mfumo unaotegemea Random Forest.
- Kila moja ya madarasa manne ya nambari lina support 1.229.
- Thamani zinazoonekana za precision, recall na F1-score kwa madarasa 0 na 2 ni 1,00.
- Kwa darasa 1, precision ni 0,94, recall 1,00, F1-score 0,97.
- Kwa darasa 3, precision ni 1,00, recall 0,94, F1-score 0,97.
- Macro na weighted average precision zinaonekana 0,99; recall 0,98; F1-score 0,98.
- Chanzo kinafasiri kuwa muundo wa ensemble wa Random Forest unaweza kupunguza athari ya label-flipping.
- Chanzo kinaeleza pamoja vipengele vya feature-label discrepancy, tree disagreement, outlier detection, consistency check na feature importance kwa ajili ya kuweka alama kwenye sampuli zenye sumu.
Hitimisho ambazo utafiti hauungi mkono
- Haijaonyeshwa kuwa thamani ya %98,47 inatumika kwa aina zote za data poisoning.
- Hakuna mafanikio ya %98,47 yaliyoonyeshwa kwa backdoor au mashambulizi mengine ya modeli.
- Poisoned-sample detection rate haijaripotiwa kama metrika tofauti.
- Hakuna uthibitishaji wa latency, throughput au utendaji wa muda mrefu uliofanywa kwenye mtandao halisi wa uzalishaji.
- Haijaonyeshwa jinsi modeli inavyotenda katika viwango tofauti vya poison.
- Random Forest haijawekwa kwenye benchmark iliyodhibitiwa dhidi ya modeli nyingine kwenye data ileile.
- Ulinganifu wa named class maalumu na misimbo ya nambari ya class 0–3 haujatolewa wazi.
- Haiwezi kuthibitishwa kuwa safu zote 63 ni predictor feature.
- Seti huru ya hold-out test au utaratibu wa cross-validation hauwezi kuthibitishwa kutoka kwenye PDF.
Taarifa zilizoripotiwa pungufu kwa upande wa uwezo wa kurudia utafiti
| Taarifa | Hali | Kwa nini ni muhimu? |
|---|---|---|
| Chanzo asilia cha seti ya data / anwani ya kupakua | Haijaripotiwa | Hufanya urudiaji huru kuwa mgumu. |
| Train/validation/test split | Haijaripotiwa | Haiwezi kuthibitishwa jinsi utendaji wa jumla ulivyopimwa. |
| Cross-validation | Haijaripotiwa | Utegemezi wa mgawanyo mmoja hauwezi kutathminiwa. |
| Uwiano wa Poisoning | Haijaripotiwa | Mabadiliko ya ustahimilivu kulingana na ukali wa shambulizi hayajulikani. |
| Sheria ya kulinganisha Label-flip | Haijaripotiwa | Haijulikani ni madarasa gani yalibadilishwa kuwa madarasa gani. |
| Idadi ya miti ya Random Forest | Haijaripotiwa | Uwezo wa ensemble hauwezi kujengwa upya. |
| Hyperparameters nyingine za Random Forest | Haijaripotiwa | Tabia ya modeli na hatari ya overfitting haziwezi kutathminiwa. |
| Random seed | Haijaripotiwa | Uwezo wa kurudia jaribio hupungua. |
| Algoriti/kizingiti cha Outlier detection | Haijaripotiwa | Ugunduzi wa rekodi zinazotiliwa shaka hauwezi kurudiwa. |
| Sheria ya Reweighting/removal | Haijaripotiwa | Hatua ya kusafisha data hubaki na utata wa kiasi. |
| Poison detection confusion matrix | Haijaripotiwa | Mafanikio ya “kugundua rekodi yenye sumu” hayawezi kupimwa tofauti. |
| Vifaa na muda wa utekelezaji | Haijaripotiwa | Utendaji wa muda halisi hauwezi kutathminiwa. |
Thamani ya kisayansi ya utafiti iko wapi?
Mchango ulio wazi zaidi wa chanzo ni kushughulikia tishio la label-flipping katika muktadha wa uainishaji wa mashambulizi ya mtandao kwa kuleta pamoja muundo wa ensemble wa Random Forest, ukaguzi wa feature-label consistency na usafishaji wa rekodi zinazotiliwa shaka katika mtiririko mmoja wa ulinzi. Utafiti pia unaripoti utendaji wa juu wa uainishaji katika madarasa manne yaliyosawazishwa.
Kwa upande mwingine, ufupi wa makala na kuripotiwa kwa maelezo machache ya majaribio huacha maswali wazi kuhusu kurudia matokeo na kuyaeneza kwa viwango tofauti vya poisoning. Kuweka mipaka hii wazi si kupunguza matokeo ya utafiti; ni kutenganisha kwa usahihi ni taarifa gani zinaunga mkono thamani ya %98,47 na ni taarifa zipi za ziada hazipo kwenye PDF.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Robust Machine Learning under Data Poisoning and Model Attacks
Waandishi na mpangilio: Promise Enyindah; Chigoziri Bobby Marcus.
Corresponding author: Promise Enyindah.
Corresponding author e-mail: promise.enyindah@uniport.edu.ng
ORCID: Viungo vya ORCID vilivyopachikwa kwenye PDF vinaelekeza, kwa mpangilio wa waandishi, kwenye 0000-0001-6246-7077 kwa Promise Enyindah na 0000-0003-4773-0222 kwa Chigoziri Bobby Marcus.
Taasisi: Department of Computer Science, University of Port Harcourt, Choba, Nigeria.
Mchango sawa: Hakuna tamko la mchango sawa au uandishi mwenza wa kwanza lililotambuliwa kwenye chanzo.
Jarida: European Journal of Electrical Engineering and Computer Science (EJECE).
Mchapishaji / jukwaa: European Open Science.
ISSN: 2736-5751.
Juzuu / toleo: Volume 10, Issue 1.
Kurasa: 31–36.
DOI: 10.24018/ejece.2026.10.1.70077.
Rekodi rasmi ya uchapishaji: European Open Science EJECE, article ID 70077; rekodi ya DOI inalingana na DOI iliyo hapo juu.
Aina ya chanzo: Research Article.
Hali ya mapitio ya rika: Ukurasa rasmi wa “About the Journal” wa jarida unaeleza EJECE kuwa jarida la kimataifa la peer-reviewed na unasema linatumia double-blind peer review.
Submitted: 12 Januari 2026.
Published: 10 Februari 2026.
Dokezo la kibibliografia kuhusu mwezi wa toleo: Masthead ya PDF ya makala inaandika “February 2026”. Rekodi ya faharasa ya RePEc/EconPapers inaorodhesha Volume 10 Issue 1 hiyo hiyo kama January 2026. Verianla inachukua tarehe ya 10 Februari 2026 iliyotolewa kwenye PDF kama tarehe ya wazi ya kiwango cha makala na haifichi tofauti ya issue-month kati ya rekodi hizo mbili.
Leseni: Mstari wa hakimiliki wa PDF ya makala yenyewe unaonyesha Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International (CC BY-NC-SA 4.0).
Dokezo la ulinganifu wa leseni: Kauli za leseni katika sera za sasa za wavuti za jarida hazilingani kikamilifu kati yao wala na PDF hii: ukurasa wa submission copyright unasema CC BY-SA 4.0, huku ukurasa wa Open Access Policy ukisema CC BY-NC 4.0. Kwa hiyo, Verianla inarekodi tamko la article-level la leseni katika PDF ya makala kama taarifa ya provenance kwa utafiti huu; badala ya kunakili muundo wa kuona wa vielelezo vya chanzo, inatengeneza mchoro huru kutokana na mahusiano ya kisayansi pekee.
Hali ya preprint: PDF iliyokaguliwa ni makala ya jarida iliyochapishwa. Chanzo hakionyeshi utambulisho tofauti wa preprint kwa utafiti huu.
Shambulizi kuu la majaribio: Label-flipping data poisoning.
Upeo wa “model attacks” kwenye kichwa: Usanifu unafafanua tabaka la adversarial/model attack; hata hivyo, hakuna benchmark tofauti ya model-attack wala matokeo huru ya nambari yaliyoripotiwa.
Data: Kielelezo 3 kinaonyesha madarasa manne yaliyosawazishwa; kila darasa lina rekodi 1.229 na jumla ya mistari 4.916. Madarasa yameorodheshwa kama MITM, Normal, DDoS_HTTP na Ransomware.
Idadi ya vipengele: Abstract inataja feature 63; Kielelezo 3 kinaonyesha data frame iliyosafishwa yenye safu 63. Kwa kuwa safu za Attack_label na Attack_type pia zinaonekana, haiko wazi kama idadi ya predictor ni 63 tofauti baada ya kuondoa safu lengwa.
Modeli: Random Forest classifier.
Utaratibu wa Ensemble: Miti ya maamuzi kwenye sampuli za Bootstrap, random feature selection na majority voting.
Mbinu za ziada za ulinzi: Feature importance analysis, outlier detection, consistency checks, tree disagreement monitoring, reweight/remove ya sampuli zinazotiliwa shaka na retraining.
Matokeo makuu: %98,47 accuracy.
Classification report: Kila moja ya madarasa manne ya nambari lina support 1.229; class 0: 1,00/1,00/1,00; class 1: 0,94/1,00/0,97; class 2: 1,00/1,00/1,00; class 3: 1,00/0,94/0,97 precision/recall/F1. Ulinganifu wazi wa code za class na madarasa yenye majina haujaripotiwa.
Uthibitishaji wa Train/test: Chanzo hakiripoti wazi train/test split, validation split au utaratibu wa cross-validation.
Hyperparameters: Hyperparameters za Random Forest, pamoja na idadi ya miti, hazijaripotiwa.
Vigezo vya Poisoning: Uwiano wa sumu, idadi ya rekodi zilizobadilishwa na matriki ya kulinganisha madarasa ya label-flip havijaripotiwa.
Kutokuwa na uhakika wa kitakwimu: Confidence interval, standard deviation, repeated-run variance, p-value au uchanganuzi mwingine wa inferential wa kutokuwa na uhakika haujaripotiwa.
Ufadhili: Hakuna funding statement tofauti iliyotambuliwa katika PDF iliyokaguliwa; haikukadiriwa kuwa hakuna ufadhili.
Upatikanaji wa data: Hakuna Data Availability Statement tofauti au kiungo cha hazina ya data kilichotambuliwa katika PDF iliyokaguliwa.
Michango ya waandishi: Hakuna tamko tofauti la author contributions / CRediT lililotambuliwa.
Kamati ya maadili: Hakuna tamko tofauti la ethics approval au informed consent lililotambuliwa; utafiti haujaripotiwa kama utafiti wa binadamu/wanyama.
Mgongano wa maslahi: Waandishi wanatangaza kuwa hakuna mgongano wa maslahi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *