


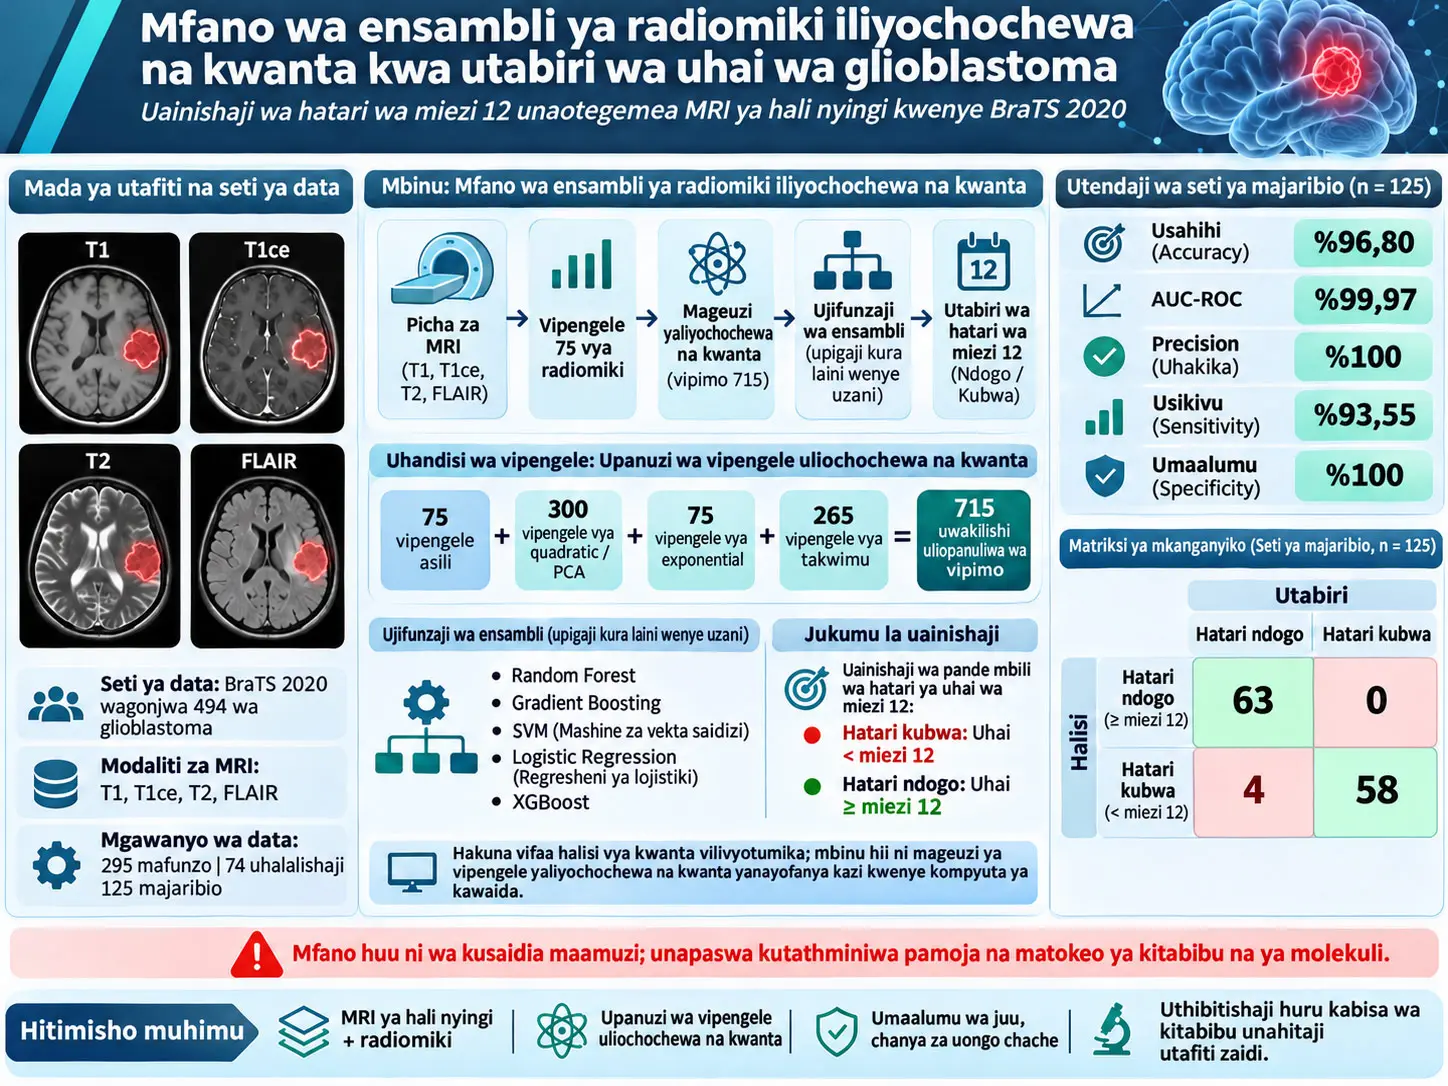
Radiomiki iliyoongozwa na dhana za kwanta ni mbinu ya ujifunzaji wa mashine inayopanua vipengele vya kawaida vya nambari vya radiomiki vilivyotolewa kutoka kwenye picha za kitabibu kwa kutumia mabadiliko yasiyo ya mstari ya vipengele yaliyoongozwa na kompyuta ya kwanta, bila kutumia maunzi halisi ya kwanta. Utafiti huu hubadilisha vipengele 75 vya radiomiki vilivyotolewa kutoka kwenye picha za sumaku-nyuklia za modi nyingi za wagonjwa wa glioblastoma kuwa nafasi iliyopanuliwa ya vipengele yenye vipimo 715, kisha huunganisha uwakilishi huo na kisainishaji cha ensemble ili kuainisha wagonjwa kuwa wa hatari kubwa au hatari ndogo kwa kutumia kizingiti cha kuishi cha miezi 12.
Utafiti ulitumia wagonjwa 494 wa glioblastoma kutoka mkusanyiko wa data wa Brain Tumor Segmentation 2020 (BraTS 2020). Kwa kila mgonjwa, mfuatano wa MRI wa T1, T1 yenye kontrasti (T1ce), T2 na FLAIR ulitathminiwa. Mkusanyiko wa data uligawanywa katika wagonjwa 295 kwa mafunzo (%60), wagonjwa 74 kwa uthibitishaji (%15) na wagonjwa 125 kwa majaribio (%25). Kigezo kikuu cha mwisho cha utafiti ni overall survival ya miezi 12: wagonjwa waliokuwa na uhai wa chini ya miezi 12 waliainishwa kuwa wa hatari kubwa, na waliokuwa na uhai wa miezi 12 au zaidi waliainishwa kuwa wa hatari ndogo.
Katika chanzo, badiliko linaloitwa Quantum Feature Transform (QFT) limetolewa kama:
\[ \Phi(x)=[x;Q(x);E(x);S(x)] \]
Vekta ya kuanzia ni:
\[ x\in\mathbb{R}^{75} \]
na baada ya badiliko:
\[ \Phi(x)\in\mathbb{R}^{715} \]
uwakilishi wa ukubwa huo hupatikana. Hapa \(x\) inawakilisha vipengele asilia vya radiomiki, \(Q(x)\) inawakilisha quadratic interactions za jozi za vipengele, \(E(x)\) inawakilisha Gaussian exponential encoding, na \(S(x)\) inawakilisha sehemu ya statistical aggregates.
Mbinu hii haikuendeshwa kwenye quantum computer halisi. Waandishi wanaeleza wazi kwamba njia hiyo ni quantum-inspired na inaweza kutekelezwa kwenye kompyuta za kawaida kwa kutumia NumPy na scikit-learn. Imeripotiwa kwamba ubadilishaji wa vipengele vya mgonjwa mmoja huchukua takribani dakika 2–3 kwenye CPU ya kawaida.
Utendaji ulioripotiwa na chanzo katika seti ya majaribio:
- Accuracy: %96,80,
- 95% confidence interval: %94,92–%98,68,
- AUC-ROC: %99,97,
- Precision: %100,
- Sensitivity: %93,55,
- Specificity: %100,
- F1-score: %96,67.
Katika kundi la majaribio la wagonjwa 125, wagonjwa wote 63 wa hatari ndogo waliainishwa kwa usahihi, wagonjwa 58 kati ya 62 wa hatari kubwa waliainishwa kwa usahihi, na wagonjwa 4 wa hatari kubwa walitabiriwa kimakosa kuwa wa hatari ndogo. Kwa hiyo, utafiti unaripoti false-positive sifuri lakini una false-negative nne.
Ingawa matokeo haya yanaonyesha uwezo mkubwa wa kutenganisha makundi, mpaka wa tafsiri ya kliniki ni muhimu. Katika sehemu ya Discussion ya utafiti wenyewe, inaelezwa kwamba modeli haipaswi kutumika kama mtoa uamuzi wa kliniki wa moja kwa moja, na kwamba matokeo yanapaswa kutathminiwa pamoja na taarifa nyingine za kliniki na molekuli. Aidha, licha ya matumizi ya neno “external validation”, kundi la mwisho la majaribio la wagonjwa 125 limetokana na mgawanyo wa ndani wa mkusanyiko huo huo wa BraTS 2020; hakuna validation ya prospective au ya hali halisi iliyofanywa katika cohort huru kabisa ya hospitali isiyo ya BraTS.
Je, neno “kwanta” katika makala hii linamaanisha kuwa kompyuta halisi ya kwanta ilitumika?
Hapana. Katika utafiti huu hakuna prosesa ya kwanta, qubit, quantum gate au quantum circuit halisi iliyotumika; njia ambayo waandishi wanaiita “Quantum Feature Transform” imeongozwa na wazo la uwakilishi wa vipimo vingi na usio wa mstari katika kompyuta ya kwanta, lakini ni njia ya uhandisi wa vipengele inayokokotolewa kabisa kwenye kompyuta ya kawaida.
Tofauti hii ni ya msingi kwa uelewa sahihi wa makala.
Katika matumizi halisi ya quantum machine learning, baadhi ya hesabu zinaweza kufanywa kwenye qubit kwa kutumia quantum gates. Katika utafiti huu, badiliko lilifanywa kwa kutumia:
- operesheni za vekta kwa NumPy,
- Principal Component Analysis (PCA) kwa scikit-learn,
- visainishaji vya kawaida vya machine-learning.
Badiliko lilitekelezwa kwa kutumia zana hizi.
Kwa hiyo, kile ambacho utafiti unaonyesha:
“Kompyuta ya kwanta ilitabiri kuishi kwa glioblastoma kwa usahihi wa %96,80.”
sio hivyo.
Kauli inayolingana na chanzo ni:
“Modeli ya ensemble inayofanya kazi kwenye data za radiomiki zilizopanuliwa kwa badiliko la kawaida la vipengele lililoongozwa na dhana za kwanta ilipata accuracy ya %96,80 katika mgawanyo wa majaribio wa BraTS 2020 wa utafiti.”
Radiomiki ni nini?
Radiomiki ni mbinu ya uchanganuzi wa picha kwa kompyuta inayobadilisha vipengele vya kuonekana vya uvimbe, kama umbo, mgawanyo wa nguvu ya ishara na utofauti wa tishu katika picha za kitabibu kama MRI, CT au PET, kuwa vigezo vya nambari.
Radiolojia anapotazama picha ya MRI anaweza kutathmini kwa macho:
- ukubwa wa uvimbe,
- umbo,
- kutokuwa sawa kwa mipaka,
- kuongezeka kwa kontrasti,
- maeneo ya nekrosisi,
- uvimbe wa tishu.
anaweza kuyatathmini kwa macho.
Radiomiki hujaribu kubadilisha vipengele vinavyofanana kuwa vigezo vya kihesabu.
Kwa mfano:
- tumor volume → ujazo,
- sphericity → kiwango ambacho uvimbe unakaribia umbo la duara,
- surface area → eneo la uso,
- entropy → kipimo cha kutokuwa na mpangilio katika mgawanyo wa nguvu ya voxel,
- vipengele vya GLCM → mahusiano ya anga ya nguvu za voxel zilizo jirani
vinaweza kuwa data za kuingiza katika modeli ya ujifunzaji wa mashine.
Kwa nini glioblastoma ni tatizo gumu la utabiri?
Glioblastoma ni mojawapo ya saratani za msingi za ubongo zenye ukali mkubwa zaidi kwa watu wazima. Chanzo kinaeleza kwamba katika hali za sasa za matibabu median survival ni takribani miezi 12–15. Hata hivyo, wagonjwa wote hawafuati mwenendo mmoja wa kliniki.
Kunaweza kuwa na utofauti mkubwa kati ya wagonjwa katika:
- ujazo wa uvimbe,
- mahali ulipo,
- kiwango cha uvamizi wa tishu,
- contrast enhancement,
- biolojia ya molekuli,
- mwitikio wa matibabu.
Kuhusiana na vipengele hivi, kunaweza kuwa na heterogeneity muhimu.
Kwa hiyo, si wastani wa kuishi pekee bali pia uainishaji wa hatari wa kila mtu una umuhimu wa kliniki.
Modeli inajaribu kujibu swali gani la kliniki?
Tatizo la uainishaji la utafiti:
\[ \text{Survival}<12\ \text{ay} \Rightarrow \text{yüksek risk} \]
na:
\[ \text{Survival}\geq12\ \text{ay} \Rightarrow \text{düşük risk} \]
limefafanuliwa kwa namna hii.
Kwa hiyo, modeli haitabiri exact survival time. Kwa mfano, haitoi continuous survival prediction ya aina ya “mgonjwa ataishi miezi 17,3”.
Modeli hufanya binary risk classification tu kuzunguka kizingiti cha miezi 12.
Mkusanyiko wa data wa BraTS 2020 ulitumikaje katika utafiti?
Utafiti ulitumia picha za BraTS 2020 za vituo vingi kutoka kwa wagonjwa 494 wa glioblastoma; wagonjwa waligawanywa katika hatua ya vipengele ghafi kuwa wagonjwa 295 wa mafunzo, 74 wa validation na 125 wa test, kwa lengo la kuzuia mipangilio ya modeli kuvuja taarifa kutoka kundi la test.
| Kipengele | Thamani ya chanzo |
|---|---|
| Jumla ya wagonjwa | 494 |
| Aina ya uvimbe | Glioblastoma, imeelezwa katika chanzo kama WHO Grade IV |
| Taasisia zilizochangia | 19, za mataifa mbalimbali |
| Mfuatano wa MRI | T1, T1ce, T2, FLAIR |
| Azimio la picha | 1 mm³ isotropic |
| Mafunzo | 295 wagonjwa (%60) |
| Validation | 74 wagonjwa (%15) |
| Test | 125 wagonjwa (%25) |
| Kigezo kikuu cha mwisho | Kizingiti cha kuishi cha miezi 12 |
| Segmentation | Segmentation ya mkono ya mtaalamu, maeneo madogo matatu |
Kwa nini mfuatano minne ya MRI hutumiwa pamoja?
T1, T1ce, T2 na FLAIR si picha nne zinazorudia taarifa hiyo hiyo ya kibaiolojia. Zinasisitiza sifa tofauti za tishu.
| Mfuatano wa MRI | Jukumu kuu katika utafiti |
|---|---|
| T1 | Muundo wa anatomia |
| T1ce | Uvimbe hai unaoongeza kontrasti na kuvurugika kwa blood-brain barrier |
| T2 | Vasogenic edema na infiltrative disease |
| FLAIR | Hukandamiza ishara ya Cerebrospinal-fluid ili kufanya mipaka ya uvimbe na edema ionekane zaidi |
Mbinu kuu ya utafiti ni kuunganisha complementary information kutoka kwenye modali zote nne katika feature representation moja ya radiomiki.
Segmentation inajumuisha maeneo gani?
Katika chanzo, wataalamu walifafanua tumor sub-region tatu kuu:
- enhancing tumor,
- peritumoral edema,
- necrotic core.
Figure 2 ya chanzo inaonyesha maeneo haya kwa rangi tofauti. Kwa sababu picha hizi za radiolojia ni ushahidi wa kuona kutoka kwa data halisi za wagonjwa, Verianla haikutengeneza picha bandia ya MRI.
Ukinzani wa MRI-modality ndani ya chanzo
Maelezo makuu ya mbinu na Table 3 ya makala yanaonyesha mfuatano minne wa MRI:
T1, T1ce, T2 na FLAIR
ndivyo inavyotolewa.
Hata hivyo, katika aya ya inclusion-criteria, maelezo ya “full multimodal MRI data” yanataja T1 post-contrast, T2-weighted, FLAIR na diffusion-weighted imaging.
Diffusion-weighted imaging haitumiki tena katika pipeline kuu ya QFT yenye modali nne. Chanzo hakielezi sababu ya tofauti hii. Kwa hiyo, si sahihi kuichukulia diffusion-weighted imaging kama njia ya tano iliyothibitishwa ya kuingiza data katika modeli.
Vipengele 75 vya radiomiki vilitengenezwa vipi?
Katika orodha kuu ya vipengele ya chanzo, vigezo 75 vimegawanywa katika familia tano: shape, first-order statistics, GLCM, GLRLM na GLSZM; vikundi hivi vinalenga kuwakilisha kimaandishi na kitarakimu jiometri ya uvimbe, mgawanyo wa nguvu za voxel na utofauti wa tishu.
| Familia ya kipengele | Idadi | Maana kuu |
|---|---|---|
| Jumla | 75 | Vekta ya kuingiza QFT |
| Shape | 14 | Vipengele vya jiometri kama ujazo, eneo la uso, sphericity, compactness na kipenyo cha juu cha 3B |
| First-order | 18 | Takwimu za nguvu kama Mean, median, variance, skewness, kurtosis, energy, entropy |
| GLCM | 22 | Ushirikiano wa anga wa nguvu za voxel zilizo jirani |
| GLRLM | 16 | Vipengele vinavyopima miundo ya mfululizo ya voxel run zenye thamani sawa ya nguvu |
| GLSZM | 5 | Vipengele vinavyopima muundo wa voxel zones zilizounganishwa zenye nguvu zinazofanana |
GLCM ni nini?
Gray Level Co-occurrence Matrix (GLCM) ni texture representation inayohesabu ni mara ngapi thamani za nguvu za voxel mbili katika uhusiano maalum wa anga huonekana pamoja.
Vipengele vinavyotegemea GLCM vinajaribu kupima si wastani wa mwangaza wa uvimbe tu bali pia spatial heterogeneity ndani ya picha.
GLRLM ni nini?
Gray Level Run Length Matrix (GLRLM) huchanganua urefu wa makundi mfululizo ya voxel yenye kiwango sawa au kinachofanana cha kijivu katika mwelekeo fulani.
Kwa hiyo inaweza kutoa taarifa kuhusu kama muundo wa tishu katika picha ni wa kufanana zaidi au wa vipande zaidi.
GLSZM ni nini?
Gray Level Size Zone Matrix (GLSZM) hutathmini ukubwa wa maeneo yaliyounganishwa ya voxel yenye kiwango sawa cha kijivu.
Wakati GLRLM huchunguza miundo ya run iliyo na mwelekeo, GLSZM huzingatia connected zones.
Ukinzani wa ndani wa chanzo kuhusu idadi ya vipengele
Chanzo kwanza kinafafanua vipengele 75 kama:
\[ 14+18+22+16+5=75 \]
limefafanuliwa kwa namna hiyo.
Hata hivyo, aya chache baadaye 75-dimensional vector inaelezwa kama:
“63 texture/first-order features across modalities + 12 shape features”
limeelezwa kwa namna hiyo.
Maelezo haya hayalingani na idadi ya awali ya 14 shape.
Chanzo hakielezi ikiwa tofauti hii inatokana na feature-selection, modality aggregation au njia tofauti ya kuhesabu. Kwa hiyo, Verianla haitatui tofauti hii kwa dhana yake mwenyewe.
Picha zilichakatwa vipi kabla ya modeli?
Chanzo kinaripoti kwamba z-score normalization, N4 bias-field correction na intensity discretization zilitumika ndani ya tumor ROI ili kupunguza tofauti za scanner na acquisition; baadaye feature vectors za modali nne za MRI ziliunganishwa.
Z-score normalization
Z-score normalization kwa kawaida hutumika kuleta wastani wa kipengele karibu na sifuri na standard deviation karibu na moja.
Muundo wa dhana ni:
\[ z=\frac{x-\mu}{\sigma} \]
ni kama ifuatavyo.
Huu si ugunduzi mpya wa utafiti, bali ni maelezo ya kihisabati ya hatua ya preprocessing iliyoelezwa katika chanzo kama “mean = 0, standard deviation = 1”.
Hapa:
- \(x\): thamani asilia,
- \(\mu\): wastani wa mgawanyo husika,
- \(\sigma\): standard deviation,
- \(z\): thamani iliyofanyiwa normalization.
N4 bias-field correction
Katika MRI, coil sensitivity na athari nyingine za acquisition zinaweza kusababisha intensity inhomogeneity inayobadilika polepole kwenye picha. N4 bias correction hutumiwa kupunguza intensity variation hii ya masafa ya chini.
Intensity discretization
Chanzo kinaripoti:
- kwa T1/T1ce fixed bin width: 25 HU,
- kwa T2/FLAIR fixed bin width: 5 HU.
hivyo ndivyo chanzo kinavyoripoti.
Jambo la kuzingatia kwa uaminifu kwa chanzo ni kwamba thamani za MRI intensity hazina, kifizikia, skeli sanifu ya HU kama Hounsfield Unit katika CT. Hata hivyo, makala inaandika kitengo hiki kama “HU”. Verianla haikibadilishi kimya kimya kuwa kitengo kingine; inaonyesha kwamba chanzo kimeripoti hivyo.
Quantum Feature Transform inawezaje kupanua vipengele 75 hadi vipimo 715?
QFT huhifadhi vekta asilia ya vipengele 75 na kuunganisha feature-feature quadratic products, badiliko la Gaussian exponential la kila kipengele na vipengele vya ziada vinavyoelezwa katika chanzo kama statistical aggregates, hivyo kutengeneza feature representation ya kawaida yenye vipimo 715.
Mlinganyo mkuu wa chanzo ni:
\[ \Phi(x)=[x;Q(x);E(x);S(x)] \]
ni kama ifuatavyo.
Hapa:
- \(x\): vipengele 75 vya asili vya radiomiki,
- \(Q(x)\): quadratic interaction representation,
- \(E(x)\): exponential encoding,
- \(S(x)\): statistical aggregates.
Mgawanyo wa vipimo uliotolewa na chanzo:
| Sehemu | Kipimo | Kazi |
|---|---|---|
| Jumla | 715 | \(\Phi(x)\) |
| \(x\) | 75 | Kuhifadhi vipengele asilia bila kuvibadilisha |
| \(Q(x)\) | 300 | Uwakilishi uliobanwa kwa PCA wa pairwise quadratic interactions |
| \(E(x)\) | 75 | Badiliko la Gaussian exponential |
| \(S(x)\) | 265 | Representation ya ziada iliyoelezwa katika chanzo kama statistical aggregates |
Jumla:
\[ 75+300+75+265=715. \]
Quadratic encoding hufanya nini?
Jozi tofauti za vipengele 75 huzidishwa kama:
\[ x_i x_j \]
ili kuunda interactions za daraja la pili.
Idadi ya jozi tofauti kati ya vipengele 75, bila kipengele kuunganishwa na chenyewe, ni:
\[ \binom{75}{2} = \frac{75\times74}{2} = 2775. \]
Chanzo pia kinaripoti 2.775 unique feature pair.
Quadratic terms hizi zinaweza kusaidia kuiga mahusiano nonlinear ambapo vipengele viwili vina prognostic information dhaifu vikiwa peke yake lakini yenye nguvu vinapounganishwa.
Hata hivyo, kutumia moja kwa moja vigezo vipya 2.775 katika mkusanyiko wenye training patient 295 kunaweza kuunda dimensionality kubwa kupita kiasi.
Kwa hiyo PCA ilitumika.
Kwa nini PCA ilitumika?
Principal Component Analysis hubadilisha correlated high-dimensional variables kuwa idadi ndogo ya orthogonal component zinazohifadhi sehemu kubwa ya variance.
Chanzo kilihifadhi:
\[ 300 \]
principal component kutoka quadratic feature space.
Imeelezwa kwamba vipengele hivi 300 vinaeleza:
\[ 95\% \]
ya cumulative variance katika quadratic feature space.
PCA ilifit kwenye training data pekee. Kutokuruhusu validation au test data kuathiri vigezo vya PCA ni muhimu kwa kupunguza hatari ya data leakage.
Exponential encoding ni nini?
Kwa kila kipengele, chanzo kinatumia:
\[ E_i(x) = \exp\left( -\frac{x_i^2}{2\sigma^2} \right) \]
fomula hii inatumika.
Hapa:
- \(x_i\): feature husika iliyofanyiwa normalization,
- \(\sigma\): Gaussian bandwidth,
- \(E_i(x)\): exponential-encoded feature.
Katika chanzo, thamani bora imetolewa kama:
\[ \sigma=1.5 \]
imeelezwa hivyo.
Thamani hii ilichaguliwa kwa nested cross-validation ndani ya training-set ili kuongeza validation AUC-ROC.
Funksheni ina thamani ya juu zaidi karibu na \(x_i=0\). Kadiri \(|x_i|\) inavyoongezeka, thamani ya exponential hupungua kwa namna isiyo ya mstari.
Kwa hiyo, badiliko linaunda uhusiano usio wa mstari kati ya feature magnitude na output.
Ni nini kilicho katika sehemu ya Statistical aggregate?
Chanzo kinasema kwamba kwa \(S(x)\) zilikokotolewa feature-family statistics kama mean, standard deviation, skewness na kurtosis, na jumla ya vipimo 265 ilitengwa.
Hata hivyo, hakionyeshi kwa undani jinsi idadi ya 265 ilivyopatikana kwa kuzingatia tu four statistics × feature families zilizotajwa.
Kwa hiyo Verianla:
- inahifadhi thamani 265 kama ilivyoripotiwa katika chanzo,
- lakini haibuni mgawanyo wa vipengele vidogo ambao haupo katika chanzo.
Kwa nini badiliko hili linaitwa “quantum-inspired”?
Waandishi wanaeleza badiliko kama “quantum-like representation” inayowakilisha feature interactions ndani ya higher-order na nonlinear channel space.
Hata hivyo, kwa kuwa operesheni za kihisabati ni:
- pairwise multiplication,
- PCA,
- Gaussian exponential functions,
- classical statistics
ongezeko la utendaji haliwezi kutafsiriwa kama ushahidi wa quantum computational advantage halisi.
Kile ambacho utafiti unaonyesha ni kwamba quantum-inspired feature engineering pipeline hii maalum inahusishwa na classification performance katika mkusanyiko huu wa data.
Modeli ya ensemble iliundwaje?
Kulingana na Methods Section 2.3, base learner tano — Random Forest, Gradient Boosting, Support Vector Machine, Logistic Regression na XGBoost — zilifunzwa kwenye feature space ya vipimo 715, na uwezekano wa modeli uliunganishwa kwa soft voting kwa kutumia uzito ulioboreshwa.
Random Forest
| Hiperparameta | Thamani |
|---|---|
| Idadi ya miti | 500 |
| Maximum depth | 15 |
| Minimum samples per leaf | 5 |
| Kigezo cha Split | Gini impurity |
Gradient Boosting
| Hiperparameta | Thamani |
|---|---|
| Iterations | 300 |
| Learning rate | 0,01 |
| Maximum depth | 6 |
| Mbinu ya ziada | early stopping inayotegemea Validation loss |
Support Vector Machine
| Hiperparameta | Thamani |
|---|---|
| Kernel | RBF |
| C | 10 |
| Gamma | 0,001 |
| Uboreshaji | Grid search |
Logistic Regression
| Hiperparameta | Thamani |
|---|---|
| Penalty | L2 |
| Penalty strength \(\alpha\) | 0,01 |
| Solver | SAGA |
XGBoost
| Hiperparameta | Thamani |
|---|---|
| Boosting rounds | 400 |
| Learning rate | 0,05 |
| Maximum depth | 7 |
| Subsample | 0,8 |
Uzito wa ensemble
| Modeli | Uzito |
|---|---|
| Random Forest | 0,25 |
| Gradient Boosting | 0,22 |
| XGBoost | 0,21 |
| SVM | 0,18 |
| Logistic Regression | 0,14 |
Jumla ya uzito:
\[ 0.25+0.22+0.21+0.18+0.14=1.00. \]
Soft voting hufanyaje kazi?
Kila modeli, kwa uwezekano wa hatari kubwa wa mgonjwa:
\[ P_m(\mathrm{high}\mid x) \]
hutoa thamani.
Ensemble probability kwa dhana:
\[ P_{\mathrm{ens}} = \sum_{m=1}^{M} w_mP_m \]
inaweza kuonyeshwa kwa namna hii.
Hapa:
- \(M\): idadi ya modeli,
- \(w_m\): ensemble weight ya modeli husika,
- \(P_m\): predicted probability ya modeli husika.
Chanzo kinaeleza kwamba non-negative weights zilibadilishwa kwenye validation set ili jumla yake iwe 1.
Ukinzani wa ndani wa chanzo kuhusu usanifu wa modeli
Hapa kuna tatizo kubwa la uthabiti wa chanzo:
- Section 2.3 inafafanua Random Forest, Gradient Boosting, SVM, Logistic Regression na XGBoost, yaani modeli 5.
- Ensemble weights za Section 2.3 pia zinatoa uzito kwa modeli hizo tano.
- Hata hivyo, Figure 4 inaonyesha XGBoost, Random Forest, Extra Trees na Gradient Boosting chini ya maandishi “4 models”.
- Katika Figure 6 zinaonekana Extra Trees, Gradient Boosting, Random Forest, XGBoost na calibrated SVM.
- Logistic Regression haipo katika Figure 6.
Chanzo hakielezi ikiwa orodha hizi tofauti za modeli zinahusu hatua tofauti za majaribio au ni ukinzani kati ya picha na maandishi.
Kwa hiyo, Verianla inaeleza usanifu mkuu wa modeli kwa kufuata maelezo explicit ya Methods Section 2.3; haiongezi Extra Trees kama mwanachama wa sita au mbadala aliyethibitishwa wa final ensemble.
Kizingiti cha uamuzi kilichaguliwaje?
Kulingana na maandishi ya Methods, thresholds za uamuzi kutoka 0,30 hadi 0,70 zilichunguzwa kwa hatua za 0,01 kwenye validation set, na threshold ya 0,48 ilichaguliwa kwa kuongeza accuracy huku specificity ikibaki juu ya %95; kisha threshold hii ilitumiwa bila kubadilishwa kwenye test set.
Safu iliyochunguzwa:
\[ 0.30,0.31,\ldots,0.70 \]
ni kama ifuatavyo.
Katika maandishi ya chanzo, threshold iliyochaguliwa imeripotiwa kama:
\[ t=0.48 \]
inaripotiwa hivyo.
Hata hivyo, katika picha ya pipeline ya Figure 4 ya PDF:
“Optimal threshold: 0.85”
imeandikwa.
Thamani hizi mbili haziwezi kuwa sahihi kwa wakati mmoja, na chanzo hakielezi sababu ya mgongano huo.
Kwa hiyo Verianla:
- hutumia thamani 0,48 ya Section 2.4 katika maelezo makuu ya mbinu,
- haipuuzi thamani 0,85 ya Figure 4,
- haikadirii nje ya chanzo ni thamani ipi ilitumika kweli katika utekelezaji wa final.
Accuracy, sensitivity, specificity na AUC-ROC zinamaanisha nini?
Vipimo hivi hupima aina tofauti za makosa ya modeli; hasa katika uainishaji wa hatari ya glioblastoma, sensitivity huonyesha uwezo wa kutambua wagonjwa wa hatari kubwa, huku specificity ikionyesha uwezo wa kutowatambua kimakosa wagonjwa wa kweli wa hatari ndogo kama wa hatari kubwa.
True Positive na False Negative
Katika ufafanuzi wa madarasa wa utafiti huu, darasa “positive” linaweza kuzingatiwa kuwa la hatari kubwa.
Kwa hiyo:
- True Positive (TP): kweli ni hatari kubwa na modeli pia imesema hatari kubwa,
- False Negative (FN): kweli ni hatari kubwa lakini modeli imesema hatari ndogo.
Katika test set:
\[ TP=58 \]
na:
\[ FN=4. \]
True Negative na False Positive
- True Negative (TN): kweli ni hatari ndogo na modeli pia imesema hatari ndogo,
- False Positive (FP): kweli ni hatari ndogo lakini modeli imesema hatari kubwa.
Katika test set:
\[ TN=63 \]
na:
\[ FP=0. \]
Accuracy
\[ \mathrm{Accuracy} = \frac{TP+TN}{TP+TN+FP+FN}. \]
Katika test set hii:
\[ \frac{58+63}{125} = \frac{121}{125} = 0.968 = 96.80\%. \]
Sensitivity
\[ \mathrm{Sensitivity} = \frac{TP}{TP+FN}. \]
Katika utafiti huu:
\[ \frac{58}{58+4} = \frac{58}{62} \approx93.55\%. \]
Hivyo wagonjwa 58 kati ya 62 wa kweli wa hatari kubwa walitambuliwa kwa usahihi.
Specificity
\[ \mathrm{Specificity} = \frac{TN}{TN+FP}. \]
Hapa:
\[ \frac{63}{63+0} = 100\%. \]
Ndiyo maana chanzo kinaripoti specificity ya %100.
Precision
\[ \mathrm{Precision} = \frac{TP}{TP+FP}. \]
Hapa:
\[ \frac{58}{58+0} = 100\%. \]
False-negative rate
\[ \mathrm{FNR} = \frac{FN}{TP+FN} = \frac{4}{62} \approx6.45\%. \]
Kliniki, kosa hili ni muhimu hasa kwa sababu kumtathmini mgonjwa wa hatari kubwa kuwa wa hatari ndogo kunaweza kuleta hatari ya undertreatment.
AUC-ROC
ROC curve huonyesha uhusiano kati ya sensitivity na false-positive rate wakati classification threshold inabadilishwa.
AUC-ROC ni eneo chini ya curve hiyo.
Chanzo kinaripoti kwa test:
\[ \mathrm{AUC}=99.97\% \]
chanzo kinaripoti hivyo.
Thamani hii inaonyesha kwamba modeli inaweza kupanga kwa nguvu makundi ya hatari kubwa na hatari ndogo katika test set.
Hata hivyo, AUC ya juu pekee si dhamana ya prospective clinical utility, treatment benefit au calibration.
Ukalibishaji wa uwezekano wa modeli ulitathminiwaje?
Utafiti haukutathmini classification accuracy pekee; katika validation set pia ulitumia reliability diagrams na Brier score kuchunguza jinsi predicted probabilities zinavyolingana na matokeo yaliyoonekana.
Katika chanzo, validation-set Brier score:
\[ 0.12 \]
imetolewa hivyo.
Kwa binary classification, Brier score kwa dhana:
\[ \mathrm{Brier} = \frac{1}{N} \sum_{i=1}^{N} (p_i-y_i)^2 \]
ni kama ifuatavyo.
Hapa:
- \(p_i\): predicted probability ya modeli,
- \(y_i\): binary outcome halisi,
- \(N\): idadi ya sampuli.
Brier score ya chini inaashiria probabilistic calibration bora; hata hivyo, katika tafsiri ya moja kwa moja ya Brier score, prevalence ya darasa na modeli inayolinganishwa ni muhimu.
Mbinu na Matokeo ya Utafiti
Mgawanyo wa train, validation na test unajaribuje kuzuia kuvuja kwa taarifa?
Kulingana na chanzo, PCA, exponential bandwidth, model hyperparameters na vigezo vilivyojifunza kuhusu feature transformation viliamuliwa kwenye training set pekee; validation set ilitumika kwa calibration ya threshold na ensemble weight, huku test set ya wagonjwa 125 ikihifadhiwa hadi tathmini ya mwisho.
Mgawanyo:
\[ 494=295+74+125. \]
Uwiano wa Training:
\[ \frac{295}{494}\approx59.7\%. \]
Validation:
\[ \frac{74}{494}\approx15.0\%. \]
Test:
\[ \frac{125}{494}\approx25.3\%. \]
Chanzo kinaripoti hizi kwa makadirio yaliyozungushwa kama 60/15/25%.
Nested 5-fold cross-validation
Base-model hyperparameter optimization ilifanywa kwenye training set kwa nested 5-fold cross-validation.
Pia, tathmini ya model robustness ilifanywa kwenye muunganiko wa training + validation:
\[ n=370 \]
kwa stratified 5-fold cross-validation.
Matokeo ya ensemble cross-validation
Katika chanzo, kwa mbinu ya quantum-radiomics mean cross-validation accuracy ni:
\[ 97.32\%\pm1.24\% \]
na range:
\[ 95.89\%-98.65\% \]
imetolewa hivyo.
Fold tano:
| Fold | Accuracy |
|---|---|
| 1 | 98,65% |
| 2 | 97,30% |
| 3 | 96,76% |
| 4 | 95,89% |
| 5 | 98,24% |
Coefficient of variation iliyotolewa na chanzo:
\[ 1.27\% \]
imeripotiwa.
Cross-validation AUC
Wastani:
\[ 99.12\%\pm0.58\% \]
range:
\[ 98.23\%-99.76\%. \]
Figure 6 inaonyesha nini?
Figure 6 ya chanzo haionyeshi wastani wa 97,32% wa quantum ensemble uliotajwa hapo juu, bali inaonyesha individual base-model cross-validation accuracies:
| Modeli | Accuracy |
|---|---|
| Extra Trees | 95,25% |
| Gradient Boosting | 94,92% |
| Random Forest | 94,83% |
| XGBoost | 95,08% |
| Calibrated SVM | 93,5% |
Katika Figure 6 mean ni:
\[ 94.72\% \]
standard deviation:
\[ 0.62\% \]
na range:
\[ 1.75\% \]
zimeonyeshwa.
Thamani hizi si kundi lile lile la metriki na matokeo ya ensemble cross-validation ya 97,32%.
Utendaji wa validation na test
| Metriki | Validation n=74 | Test n=125 | 95% CI kwa Test |
|---|---|---|---|
| Accuracy | 98,65% | 96,80% | 94,92–98,68% |
| AUC-ROC | 99,78% | 99,97% | 99,89–100,0% |
| Precision | 100,00% | 100,00% | 100,0–100,0% |
| Sensitivity | 97,30% | 93,55% | 86,31–100,0% |
| F1-score | 98,63% | 96,67% | 93,94–99,40% |
| Specificity | 100,00% | 100,00% | 100,0–100,0% |
| False-positive rate | 0,00% | 0,00% | 0,0–0,0% |
| False-negative rate | 2,70% | 6,45% | 0,0–13,69% |
Validation confusion matrix
Katika validation set:
- wagonjwa 37 wa kweli wa hatari ndogo → 37 wameainishwa kwa usahihi kuwa hatari ndogo,
- 0 false positive,
- wagonjwa 36 wa kweli wa hatari kubwa → 36 wameainishwa kwa usahihi kuwa hatari kubwa,
- 1 false negative.
hali hiyo imebainika.
Test confusion matrix
Katika test set:
- 63 true negative,
- 0 false positive,
- 58 true positive,
- 4 false negative.
hali hiyo imebainika.
Threshold sensitivity
Chanzo kinaripoti kwamba threshold ilipobadilishwa kati ya 0,30–0,70, hasa katika:
\[ 0.40-0.55 \]
range:
- accuracy ilibaki juu ya %92,
- specificity ilibaki juu ya %95.
chanzo kinaripoti kwamba zilibaki hivyo.
Uchambuzi huu ulifanywa ili kuunga mkono kwamba utendaji wa modeli haukuwa matokeo ya bahati yaliyotokea kwenye threshold moja pekee.
Matokeo ya subgroup
| Kikundi kidogo | Accuracy | Thamani ya p ya kulinganisha |
|---|---|---|
| Ujazo wa uvimbe <40 cm³ | 95,8% | p=0,43 |
| Ujazo wa uvimbe ≥40 cm³ | 97,4% | |
| Frontal lobe | 96,2% | p=0,52 |
| Maeneo mengine | 97,1% | |
| Umri <60 | 96,5% | p=0,68 |
| Umri mkubwa zaidi | 97,0% |
Thamani hizi za p zimetolewa katika chanzo ili kuunga mkono kwamba hakuna performance difference muhimu iliyobainika kati ya vikundi vidogo.
Hata hivyo, kwa kuwa test set ina jumla ya wagonjwa 125, haipaswi kuhitimishwa kwamba uchanganuzi wa vikundi vidogo unahakikisha utendaji sawa katika idadi kubwa zaidi ya watu wa kidemografia au kliniki.
Vipimo vya McNemar na DeLong
Chanzo katika ulinganisho wa quantum ensemble na baseline kinaripoti:
\[ p<0.001 \]
kwa kipimo cha McNemar na:
\[ p<0.001 \]
kwa kipimo cha DeLong.
Kipimo cha McNemar hutathmini tofauti kati ya paired classification errors, huku kipimo cha DeLong kinaweza kutumika kulinganisha thamani za ROC AUC.
Hapa, matokeo ya vipimo hivi hayamaanishi “ubora umethibitishwa kwa sababu ya quantum mechanics”. Vipimo vinatathmini tu tofauti ya utendaji wa takwimu kati ya prediction outputs zinazolinganishwa.
Je, utafiti wa ablation unaweza kutenganisha kweli mchango wa quantum-inspired feature transform?
Katika utafiti wa ablation, modeli zilifunzwa upya kwa kutumia vipengele 75 asilia vya radiomiki bila quantum expansion na kwa mgawanyo uleule wa data, na kupungua kwa utendaji kulionekana; hata hivyo, chanzo kina ukinzani wa ndani katika ufafanuzi wa “best baseline” kwa upande wa accuracy.
Chanzo:
| Modeli | Accuracy | AUC-ROC |
|---|---|---|
| XGBoost | 81,36% | 0,695 |
| Random Forest | 83,05% | 0,631 |
| SVM | 72,88% | 0,681 |
| Logistic Regression | 81,36% | 0,647 |
Quantum-enhanced ensemble:
\[ 96.80\%\ \mathrm{accuracy} \]
na:
\[ 99.97\%\ \mathrm{AUC} \]
imeripotiwa.
Tatizo la “best baseline” katika chanzo
Maandishi yanaita XGBoost:
“best baseline model”
na kutoa accuracy 81,36% na AUC 0,695.
Hata hivyo, katika aya hiyo hiyo Random Forest ina accuracy:
\[ 83.05\% \]
imepewa hivyo.
Kwa hiyo:
- Kwa AUC, XGBoost ina thamani ya juu zaidi kati ya modeli zilizotolewa.
- Kwa Accuracy, thamani ya juu zaidi iliyoripotiwa ni %83,05 ya Random Forest.
Chanzo kinakokotoa “takribani 15 percentage-point accuracy improvement” kutoka 81,36% → 96,80%:
\[ 96.80-81.36=15.44 \]
percentage point.
Lakini ikiwa baseline accuracy ya juu zaidi iliyoripotiwa, 83,05%, itatumika:
\[ 96.80-83.05=13.75 \]
percentage point.
Hesabu hii ya pili si matokeo mapya ya majaribio ya Verianla; ni tofauti ya kihesabu tu kati ya thamani mbili za accuracy zilizotolewa pamoja katika chanzo, na imetolewa kuonyesha kwa nini istilahi “best baseline” ndani ya chanzo haina uwazi kamili.
Uchambuzi wa makosa ya modeli ulionyesha nini?
Wagonjwa 23 waliotambuliwa vibaya mara tatu au zaidi katika fold tano za cross-validation walibainishwa; chanzo kilihusisha sehemu kubwa ya kesi hizi ngumu na kuishi karibu na mpaka wa uamuzi wa miezi 12, muonekano usio wa kawaida wa picha au taarifa zisizokamilika za matibabu.
Chanzo kinaripoti:
- 23 consistently misclassified patient → %6,2 ya mkusanyiko mzima wa data,
- wagonjwa 15 → borderline outcome ndani ya ±1 mwezi wa kizingiti cha miezi 12,
- wagonjwa 5 → atypical imaging kama minimal contrast enhancement licha ya aggressive disease,
- wagonjwa 3 → incomplete treatment information.
hivyo ndivyo chanzo kinavyoripoti.
Uchambuzi huu unaashiria kwamba makosa ya modeli si ya nasibu kabisa; hata hivyo, uhusiano huu si causal proof.
Uthabiti wa Feature-importance
Kwa feature-importance ranking kati ya cross-validation folds, correlation coefficient iliripotiwa kuwa:
\[ r=0.92 \]
imeripotiwa hivyo.
Chanzo kinasisitiza miongoni mwa vigezo vilivyoonekana muhimu katika fold zote:
- tumor volume,
- sphericity,
- surface area.
chanzo kinasisitiza shape features kama hizo.
Katika Discussion, pia inaelezwa kwamba vipengele kama tumor-volume, shape irregularity na enhancement heterogeneity vina biological plausibility.
Dai la “external validation” la chanzo linapaswa kutafsiriwaje?
Utafiti unaonyesha cross-domain methodological transfer kwa kuhamisha mbinu ya awali ya brain-metastasis quantum-radiomics kwenda aina tofauti ya uvimbe, GBM; hata hivyo, kwa sababu wagonjwa wote wa train, validation na test wa modeli ya GBM katika makala hii walitoka BraTS 2020, hakuna external validation halisi iliyofanywa katika cohort huru ya taasisi isiyo ya BraTS.
Tofauti hii ni muhimu.
Waandishi wanaliita kundi la wagonjwa 125 “external test set”.
Lakini katika utafiti huo huo:
\[ 494\ \mathrm{BraTS\ hastası} \rightarrow 295+74+125 \]
mgawanyo mmoja wa BraTS cohort ulifanywa.
Kwa hiyo, wagonjwa wa test ni huru dhidi ya training patients; lakini chanzo cha data ni ekosistimu ile ile ya benchmark.
Discussion inaweka kikomo hiki wazi na kusema kwamba validation kwenye:
non-BraTS datasets from institutions independent of research groups
haijafanywa.
Waandishi wanaeleza kwamba external validation halisi inahitaji:
- vituo vya hospitali tofauti na wachangiaji wa BraTS,
- protokali tofauti za upigaji picha,
- patient cohorts mpya,
- prospective validation.
zinaelezwa kuwa zinahitajika.
Dai la cross-domain linategemea nini?
Kazi ya awali ya waandishi ilikuwa metodolojia ya quantum-radiomics iliyotengenezwa kwa brain metastasis survival prediction.
Katika utafiti huu, uwezo wa kuhamisha dhana hiyo hiyo ya msingi ya transform kwenda glioblastoma radiomics umetafsiriwa kama “cross-domain”.
Hata hivyo, makala ya sasa haitoi tena quantitative results za cohort ya awali ya brain-metastasis kwa ulinganisho wa side-by-side.
Chanzo chenyewe pia kinakubali kwamba cross-domain claim inategemea:
methodological transfer
na kwamba side-by-side performance reporting ya cohort mbili inapaswa kufanywa katika tafiti zijazo.
Ulinganisho na mbinu zilizochapishwa unaaminika kwa kiwango gani?
Chanzo kinalinganisha test accuracy yake ya %96,80 na utendaji wa chini uliochapishwa katika tafiti za radiomiki za kawaida na deep-learning; hata hivyo, kwa sababu endpoint, ukubwa wa mkusanyiko wa data, preprocessing, train/test split na validation rigor vinatofautiana, ulinganisho huu si jaribio la moja kwa moja la head-to-head.
| Utafiti | Mbinu | Cohort | Test accuracy | Specificity |
|---|---|---|---|---|
| Kickingereder | Radiomics + Random Forest | 170 | 73,0% | 69% |
| Lao | 3D CNN | 181 | 76,0% | 72% |
| Nie | Multi-channel CNN | 163 | 79,0% | 78% |
| Isensee | nnU-Net + Radiomics | 285 | 82,0% | 85% |
| Feng | Multi-task CNN | 209 | 88,0% | 89% |
| Utafiti huu | Quantum Radiomics + Ensemble | 494 | 96,80% | 100% |
Chanzo chenyewe kinaonya kuwa tahadhari inahitajika wakati wa numerical comparison ya moja kwa moja.
Kwa sababu tafiti zinatofautiana katika:
- 12-month survival versus median survival endpoint,
- patient number,
- image preprocessing,
- train/test splitting,
- cross-validation versus held-out testing,
- model complexity.
vipengele hivyo vinatofautiana.
Kwa hiyo, hitimisho kwamba “njia hii ni bora kwa uhakika wa kisayansi kuliko njia zote nyingine” halijathibitishwa na jedwali hili pekee.
Kwa nini false-negative nne ni muhimu kliniki?
False-negative nne zinaonyesha kwamba wagonjwa wanne waliokuwa kweli wa hatari kubwa waliwekwa na modeli kama wa hatari ndogo; aina hii ya kosa inaweza kuwa na matokeo makubwa ikiwa uamuzi wa kliniki kama kupunguza nguvu ya matibabu utawekwa kiotomatiki. Kwa hiyo, modeli inapaswa kuzingatiwa katika kiwango cha decision-support pekee.
Katika test set ya chanzo:
\[ 4/62=6.45\% \]
ya wagonjwa wa hatari kubwa waliwekwa kimakosa katika darasa la hatari ndogo.
Waandishi katika Section 3.1 wanasema wazi kuwa hili ni “significant clinical concern”.
Kwa hiyo, kuonyesha %100 specificity peke yake kunaweza kupotosha.
%100 specificity:
“Wagonjwa wa hatari ndogo hawakutambulishwa kimakosa kuwa wa hatari kubwa.”
inamaanisha hivyo.
Haimaanishi:
“Wagonjwa wote wa hatari kubwa walipatikana.”
Kwa sababu sensitivity ni %93,55.
Ukinzani wa false-negative katika Discussion
Katika Discussion ya chanzo, wakati wa kueleza false-negative nne kwa kauli kama “all but one case borderline survival”, kwa kesi moja kuna:
survival = 16 months
kauli hii imetumika.
Hata hivyo, katika ufafanuzi wa binary endpoint wa utafiti wenyewe:
\[ \mathrm{high\ risk}<12\ \mathrm{months} \]
kwa hiyo mgonjwa aliyeishi kweli miezi 16 hawezi kuwa false-negative kama high-risk true class.
Chanzo hakielezi ukinzani huu wa kimantiki.
Kwa hiyo Verianla haitumii kauli ya miezi 16 kama ushahidi wa uchanganuzi wa kliniki wa false-negative.
Matokeo yanayoungwa mkono na utafiti
- Binary survival-risk classification ya miezi 12 ilifanywa kwa vipengele vya radiomiki vya MRI vya modi nyingi kutoka wagonjwa 494 wa GBM katika BraTS 2020.
- Quantum-inspired transformation iliyotumika katika chanzo hufanya kazi kwenye kompyuta ya kawaida.
- Vipengele 75 vya radiomiki vilipanuliwa katika mbinu ya chanzo kuwa representation ya vipimo 715.
- Pairwise quadratic interaction space ina 2.775 feature pair na hupunguzwa hadi 300 PCA component.
- 300 component huhifadhi %95 ya quadratic variance.
- Gaussian exponential bandwidth ilichaguliwa kuwa \(\sigma=1.5\).
- Methods Section 2.3 inafafanua weighted soft-voting ensemble yenye learner tano za kawaida za machine-learning.
- Accuracy ya %96,80 iliripotiwa kwenye test n=125.
- Test AUC-ROC ya %99,97 iliripotiwa.
- Specificity ni %100 na sensitivity ni %93,55.
- Kuna false-negative nne na false-positive sifuri.
- Five-fold cross-validation ensemble accuracy ni %97,32 ± %1,24.
- Utafiti wa ablation unaripoti performance ya chini bila quantum-inspired feature expansion.
- Utafiti ulifanywa kwenye multi-institutional BraTS data.
Matokeo ambayo utafiti hauungi mkono
- Utafiti hauonyeshi kwamba quantum computer halisi ilitabiri kuishi kwa glioblastoma.
- Quantum supremacy au quantum computational advantage haijaonyeshwa.
- Modeli haijajaribiwa katika prospective clinical trial.
- Haijathibitishwa kwamba modeli inaweza kuendesha treatment decisions kiotomatiki kwa usalama.
- Hakuna validation iliyofanywa katika cohort huru ya hospitali isiyo ya BraTS.
- Modeli haitabiri continuous survival time; hutumia binary endpoint ya miezi 12.
- %100 specificity haimaanishi wagonjwa wote wa hatari kubwa walitambuliwa kwa usahihi.
- Ulinganisho na mbinu za deep-learning zilizochapishwa si head-to-head retraining kwenye cohort ile ile.
- Performance sawa haijaonyeshwa kwa saratani nyingine, CT, PET au ultrasound.
- Haiwezi kuchukuliwa kwamba modeli ina performance sawa kwa rare GBM subtypes au underrepresented demographic groups.
- Clinical cost-effectiveness haijathibitishwa kwa formal health-economic study.
- Haijaonyeshwa kwamba hitaji la Manual/expert tumor segmentation limetatuliwa kikamilifu kiotomatiki katika mazingira halisi ya kliniki.
Vikwazo vikuu vya utafiti
Hoja zilizotajwa na chanzo zinazoweka mipaka katika tafsiri ya matokeo:
- BraTS 2020 ni curated na preprocessed benchmark dataset.
- Reliable automatic segmentation inahitajika kwa Clinical deployment.
- Binary cutoff ya miezi 12 hupoteza continuous survival information.
- Uwezo wa kujumlisha kwa rare GBM subtypes na underrepresented demographic groups ni mdogo.
- Non-BraTS independent institutional validation haijafanywa.
- Prospective validation haijafanywa.
- Brain metastasis → GBM cross-domain claim haina side-by-side quantitative comparison.
Mapendekezo ya kazi za baadaye
Chanzo kinapendekeza katika siku zijazo:
- Cox proportional-hazards regression,
- accelerated failure-time models,
- independent institutional datasets,
- prospective newly diagnosed cohorts,
- clinical/treatment variables integration,
- genomic na molecular markers integration,
- longitudinal treatment-response monitoring.
Hizi ni miongoni mwa mwelekeo wa uthibitishaji na maendeleo uliopendekezwa.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Quantum Radiomics Ensemble Model for Glioblastoma Survival Prediction and External Validation on BraTS 2020
Waandishi: Damiana Teliti; Olsi Shehu; Bekir Karlik; Jasmin Kevrić.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa.
Corresponding author: Damiana Teliti.
Taasisi 1: Department of Information Technology, Faculty of Engineering, Natural and Medical Sciences, International Burch University, Sarajevo, Bosnia and Herzegovina.
Taasisi 2: Department of Electrical and Electronics Engineering, Faculty of Engineering and Architecture, Istanbul Esenyurt University, Istanbul, Türkiye.
Taasisi 3: Department of Electrical and Electronics Engineering, Faculty of Engineering, Natural and Medical Sciences, International Burch University, Sarajevo, Bosnia and Herzegovina.
Jarida: The Open Neuroimaging Journal.
Mchapishaji: Bentham Open / Bentham Science.
Aina ya chanzo: Research Article.
Hali ya mapitio: The Open Neuroimaging Journal ni jarida la peer-reviewed; utafiti ni makala iliyochapishwa ya utafiti.
Juzuu: 19.
E-location ID: e18744400478846.
DOI: 10.2174/0118744400478846260616061026.
Received: 14 Januari 2026.
Revised: 6 Aprili 2026.
Accepted: 8 Aprili 2026.
Published: 2 Julai 2026.
Kiungo rasmi: https://doi.org/10.2174/0118744400478846260616061026
Leseni: Creative Commons Attribution 4.0 International, CC BY 4.0.
Maneno muhimu: Quantum machine learning; Radiomics; Glioblastoma; Multi-modal MRI; Ensemble learning; Neuroimaging.
Muundo wa utafiti: retrospective secondary analysis na machine-learning classification kwenye publicly available de-identified BraTS 2020 data.
Sampuli: wagonjwa 494 wa glioblastoma.
Mgawanyo wa data: 295 train / 74 validation / 125 test.
Endpoint kuu ya kliniki: 12-month overall survival threshold.
Mbinu kuu: feature extraction inayotegemea PyRadiomics → quantum-inspired feature transformation → weighted ensemble classification → validation-threshold calibration → held-out test evaluation.
Quantum hardware: Haikutumika. Badiliko lilitekelezwa kwenye CPU ya kawaida kwa NumPy na scikit-learn.
Toleo la PyRadiomics: v3.0.
Usanifishaji wa radiomiki: Ufafanuzi wa IBSI ulitumika kama msingi.
Idadi ya vipengele: Mwanzo 75; baada ya QFT 715.
Idadi ya Quadratic pair: 2.775.
Quadratic PCA component: 300.
PCA cumulative variance: %95.
Exponential encoding bandwidth: \(\sigma=1.5\).
Muda wa kukokotoa QFT: Kulingana na chanzo, takribani dakika 2–3/mgonjwa kwenye CPU ya kawaida.
Methods Section 2.3 ensemble: Random Forest, Gradient Boosting, Support Vector Machine, Logistic Regression, XGBoost.
Uzito wa ensemble: Random Forest 0,25; Gradient Boosting 0,22; XGBoost 0,21; SVM 0,18; Logistic Regression 0,14.
Chanzo cha Threshold: Maandishi ya Section 2.4 yanaripoti 0,48.
Ukinzani wa Threshold: Katika Figure 4 ya chanzo imeandikwa “Optimal threshold: 0.85”. Chanzo hakielezi ukinzani huu wa 0,48/0,85. Verianla imetumia 0,48 ya maandishi ya mbinu katika maelezo makuu na haijaficha thamani ya Figure 4.
Ukinzani wa orodha ya modeli: Section 2.3 inafafanua learner tano: RF, Gradient Boosting, SVM, Logistic Regression na XGBoost. Figure 4 inaonyesha modeli nne: XGBoost, Random Forest, Extra Trees na Gradient Boosting. Figure 6 inaonyesha Extra Trees, Gradient Boosting, Random Forest, XGBoost na calibrated SVM. Chanzo hakielezi tofauti hiyo.
Ukinzani wa Feature-count: Section 2.2 kwanza inatoa 14 shape + 18 first-order + 22 GLCM + 16 GLRLM + 5 GLSZM = 75; baadaye inaeleza 75-vector kama 63 texture/first-order + 12 shape. Chanzo hakielezi tofauti hiyo.
Ukinzani wa MRI-modality: Pipeline kuu hutumia T1, T1ce, T2 na FLAIR. Aya ya Inclusion-criteria pia inataja diffusion-weighted imaging. Chanzo hakionyeshi baadaye kwamba DWI ilitumika katika ingizo la QFT.
Ukinzani wa Ablation: Chanzo kinaita XGBoost “best baseline model” ikiwa na 81,36% accuracy na 0,695 AUC; katika aya hiyo hiyo Random Forest inaripotiwa kuwa na 83,05% accuracy. Kwa hiyo, neno “best” halilingani kikamilifu na maandishi kwa upande wa accuracy.
Ukinzani wa False-negative Discussion: Darasa la High-risk limefafanuliwa kama survival <12 miezi, lakini katika maelezo ya false-negative ya Discussion kuna survival ya miezi 16. Kwa kuwa thamani hii haionekani kuendana na ufafanuzi wake wa binary class, Verianla haikuitumia kama ushahidi wa hitimisho la kliniki.
Mpaka wa External-validation: Kundi la test la wagonjwa 125 lilitenganishwa na training na validation katika kiwango cha mgonjwa; hata hivyo, wagonjwa wote 494 walitoka BraTS 2020. Discussion ya chanzo yenyewe inaeleza wazi kwamba validation kwenye non-BraTS independent institution dataset haijafanywa.
Mpaka wa matumizi ya kliniki: Modeli haijathibitishwa katika prospective clinical trial na haijajaribiwa kama treatment decision algorithm. Waandishi katika Section 3.1 wanapendekeza matokeo yaangaliwe kama probabilistic decision support.
Maadili: Utafiti ni retrospective secondary analysis wa publicly available, fully de-identified BraTS 2020 data. International Burch University Ethics Committee iliamua kwamba formal ethics approval haikuhitajika; approval reference number haikutolewa.
Human/animal rights: Hakukuwa na jaribio jipya kwa binadamu au wanyama. Tafiti asilia za upigaji picha zilifanywa chini ya viwango vya maadili vya contributing institutions husika.
Consent: Consent ilipatikana katika contributing institutions husika kwa upigaji picha wa awali na data sharing; consent ya ziada haikuhitajika kwa de-identified secondary analysis hii.
Upatikanaji wa data: Mkusanyiko wa data wa BraTS 2020 unapatikana wazi kupitia CBICA/University of Pennsylvania BraTS repository. Trained ensemble model na analysis code zinaweza kuombwa kutoka kwa corresponding author kwa reasonable request.
Ufadhili: None.
Mgongano wa maslahi: Waandishi wameripoti kwamba hakuna mgongano wa kifedha au mwingine wa maslahi.
Acknowledgements: Declared none.
Michango ya waandishi: Chanzo hakitoi mgawanyo wa kina wa majukumu ya CRediT. Imeripotiwa kwamba waandishi wote walisoma na kuidhinisha final manuscript, walishiriki katika uandishi na marekebisho, na walikubali kuwajibika kwa usahihi wa utafiti.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *