


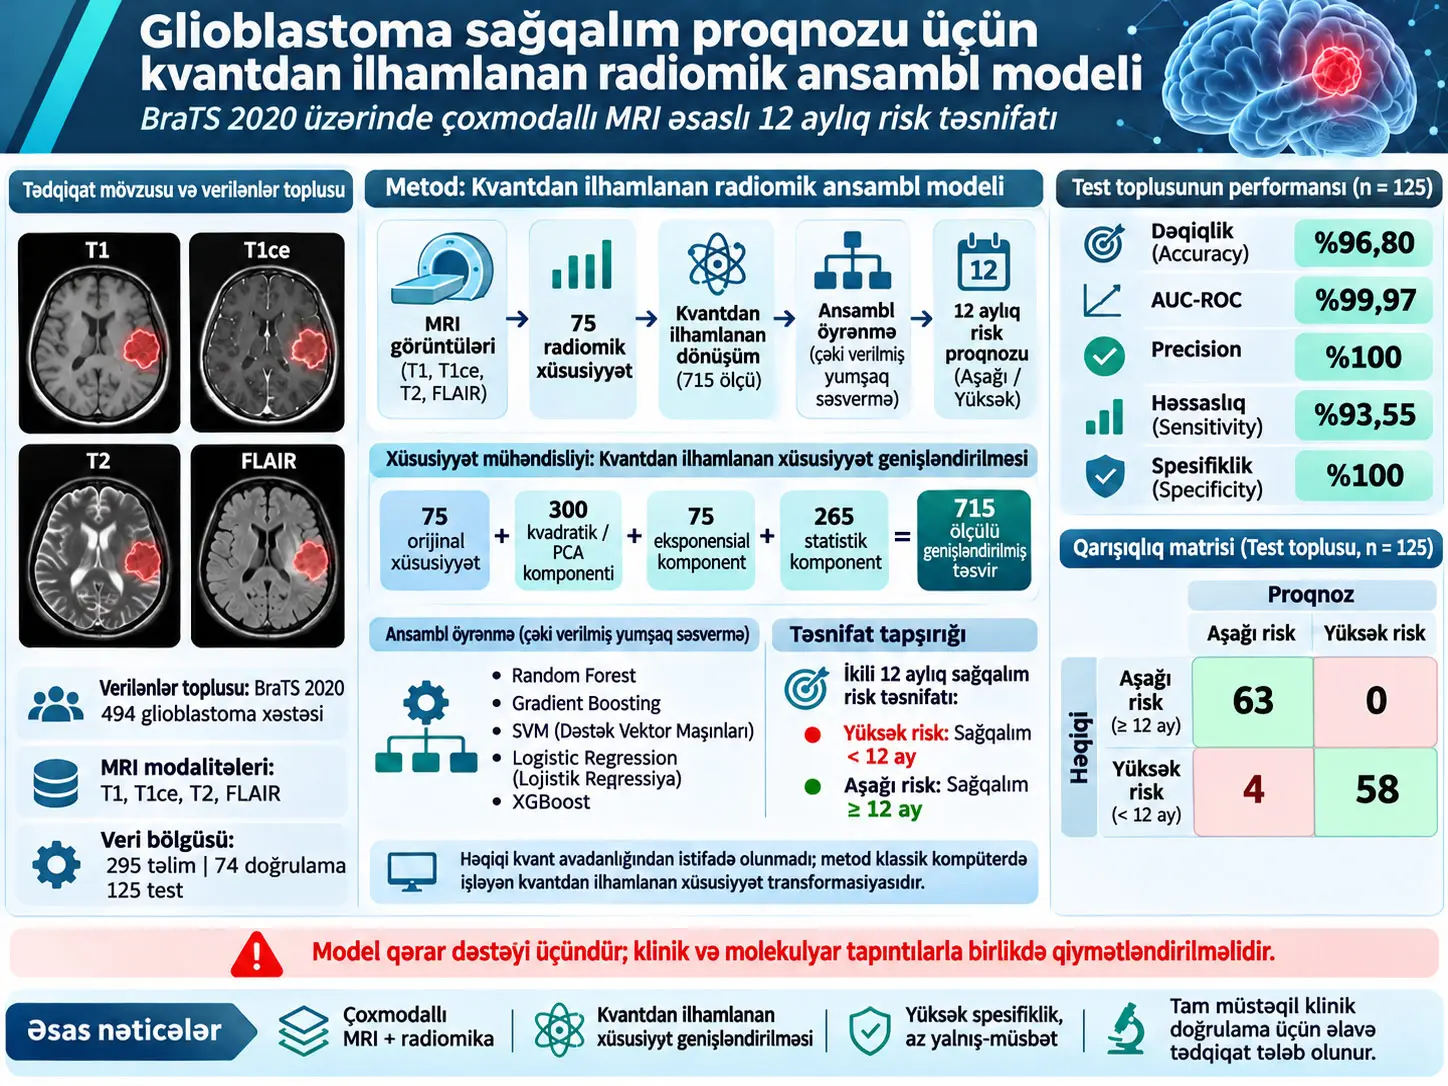
Kvantdan ilhamlanan radiomika tibbi görüntülərdən çıxarılan klassik ədədi radiomik xüsusiyyətləri real kvant avadanlığından istifadə etmədən, kvant hesablamasından ilhamlanan qeyri-xətti xüsusiyyət çevrilmələri ilə genişləndirən maşın öyrənməsi yanaşmasıdır. Bu tədqiqat glioblastoma xəstələrinin çoxmodal maqnit-rezonans görüntülərindən çıxarılan 75 radiomik xüsusiyyəti 715 ölçülü genişləndirilmiş xüsusiyyət fəzasına çevirir və bu təsviri ensemble təsnifatçısı ilə birləşdirərək 12 aylıq sağqalım həddinə görə yüksək risk və aşağı risk təsnifatı aparır.
Tədqiqat Brain Tumor Segmentation 2020 (BraTS 2020) verilənlər dəstindəki 494 glioblastoma xəstəsindən istifadə etmişdir. Hər xəstə üçün T1, kontrastlı T1 (T1ce), T2 və FLAIR MRI ardıcıllıqları qiymətləndirilmişdir. Verilənlər dəsti 295 xəstə təlim (%60), 74 xəstə doğrulama (%15) və 125 xəstə test (%25) olmaqla bölünmüşdür. Tədqiqatın əsas sonlanım nöqtəsi 12 aylıq overall survival-dır: sağqalımı 12 aydan az olan xəstələr yüksək riskli, 12 ay və ya daha çox olanlar isə aşağı riskli kimi təsnif edilmişdir.
Mənbədə Quantum Feature Transform (QFT) adlandırılan çevrilmə:
\[ \Phi(x)=[x;Q(x);E(x);S(x)] \]
şəklində verilir. Başlanğıc vektoru:
\[ x\in\mathbb{R}^{75} \]
olub çevrilmədən sonra:
\[ \Phi(x)\in\mathbb{R}^{715} \]
ölçülü təsvir əldə edilir. Burada \(x\) ilkin radiomik xüsusiyyətləri, \(Q(x)\) xüsusiyyət cütlərinin quadratic interactions-ını, \(E(x)\) Gaussian exponential encoding-i və \(S(x)\) statistical aggregates komponentini təmsil edir.
Bu yanaşma real quantum computer üzərində işlədilməmişdir. Müəlliflər metodun quantum-inspired olduğunu və standart klassik kompüterlərdə NumPy və scikit-learn istifadə edilərək tətbiq oluna bildiyini açıq şəkildə qeyd edirlər. Bir xəstənin xüsusiyyət çevrilməsinin standart CPU üzərində təxminən 2–3 dəqiqə çəkdiyi bildirilmişdir.
Test dəstində mənbə tərəfindən bildirilən performans:
- Accuracy: %96,80,
- 95% confidence interval: %94,92–%98,68,
- AUC-ROC: %99,97,
- Precision: %100,
- Sensitivity: %93,55,
- Specificity: %100,
- F1-score: %96,67.
125 xəstədən ibarət test qrupunda 63 aşağı riskli xəstənin hamısı düzgün təsnif edilmiş, 62 yüksək riskli xəstənin 58-i düzgün təsnif edilmiş və 4 yüksək riskli xəstə səhvən aşağı riskli kimi proqnozlaşdırılmışdır. Beləliklə, tədqiqat sıfır false-positive bildirərkən dörd false-negative ehtiva edir.
Bu nəticələr yüksək ayırdetmə performansına işarə etsə də, klinik şərh sərhədi mühümdür. Tədqiqatın öz Discussion bölməsində modelin mütləq klinik qərarverici kimi istifadə edilməməli, nəticələrin digər klinik və molekulyar məlumatlarla birlikdə qiymətləndirilməli olduğu göstərilir. Həmçinin “external validation” ifadəsinə baxmayaraq, 125 xəstədən ibarət yekun test qrupu BraTS 2020 verilənlər dəstinin öz daxili bölgüsündən gəlir; tam müstəqil non-BraTS xəstəxana kohortunda prospective və ya real həyat doğrulaması aparılmamışdır.
Bu məqalədəki “kvant” ifadəsi real kvant kompüterindən istifadə edildiyi anlamına gəlirmi?
Xeyr. Tədqiqatda kvant prosessoru, qubit, quantum gate və ya real quantum circuit işlədilməmişdir; müəlliflərin “Quantum Feature Transform” adlandırdığı metod kvant hesablamasındakı yüksək ölçülü və qeyri-xətti təsvir ideyasından ilhamlanır, lakin bütövlükdə klassik kompüterdə hesablanan xüsusiyyət mühəndisliyi metodudur.
Bu fərq məqalənin düzgün başa düşülməsi üçün əsas əhəmiyyət daşıyır.
Real quantum machine learning tətbiqində bəzi hesablamalar qubit-lər üzərində quantum gates istifadə edilərək həyata keçirilə bilər. Bu tədqiqatda isə çevrilmə:
- NumPy ilə vektor əməliyyatları,
- scikit-learn ilə Principal Component Analysis (PCA),
- klassik machine-learning təsnifatçıları
istifadə edilməklə həyata keçirilmişdir.
Buna görə tədqiqatın göstərdiyi:
“Kvant kompüteri glioblastoma sağqalımını %96,80 dəqiqliklə proqnozlaşdırdı.”
deyildir.
Mənbəyə sadiq ifadə:
“Kvantdan ilhamlanan klassik xüsusiyyət çevrilməsi ilə genişləndirilmiş radiomik məlumatlar üzərində işləyən ensemble model tədqiqatın BraTS 2020 test bölgüsündə %96,80 accuracy əldə etdi.”
Radiomika nədir?
Radiomika MRI, CT və ya PET kimi tibbi görüntülərdə şişin forması, intensivlik paylanması və toxuma heterogenliyi kimi vizual xüsusiyyətləri ədədi dəyişənlərə çevirən hesablama əsaslı görüntü analizi yanaşmasıdır.
Radioloq MRI görüntüsünə baxdıqda şişin:
- ölçüsünü,
- formasını,
- sərhəd nizamsızlığını,
- kontrastlanmasını,
- nekrotik sahələrini,
- ödemi
vizual olaraq qiymətləndirə bilər.
Radiomika isə oxşar xüsusiyyətləri riyazi dəyişənlərə çevirməyə çalışır.
Məsələn:
- tumor volume → həcm,
- sphericity → şişin sferik formaya nə qədər yaxın olması,
- surface area → səth sahəsi,
- entropy → voxel intensivlik paylanmasındakı nizamsızlığın ölçüsü,
- GLCM xüsusiyyətləri → qonşu voxel intensivliklərinin məkan əlaqələri
kimi kəmiyyətlər maşın öyrənməsi modeli üçün giriş məlumatı ola bilər.
Glioblastoma niyə çətin proqnoz problemidir?
Glioblastoma böyüklərdə ən aqressiv ilkin beyin malignitələrindən biridir. Mənbə mövcud müalicə şəraitində median survival-ın təxminən 12–15 ay olduğunu bildirir. Lakin bütün xəstələr eyni klinik gedişi göstərmir.
Xəstələr arasında:
- şiş həcmi,
- lokalizasiya,
- infiltrasiya səviyyəsi,
- kontrast enhancement,
- molekulyar biologiya,
- müalicəyə cavab
baxımından mühüm heterogenlik ola bilər.
Buna görə yalnız orta sağqalım deyil, fərdi risk təsnifatı da klinik baxımdan əhəmiyyətlidir.
Model hansı klinik suala cavab verməyə çalışır?
Tədqiqatın təsnifat problemi:
\[ \text{Survival}<12\ \text{ay} \Rightarrow \text{yüksek risk} \]
və:
\[ \text{Survival}\geq12\ \text{ay} \Rightarrow \text{düşük risk} \]
şəklində müəyyən edilmişdir.
Buna görə model exact survival time proqnozu vermir. Məsələn, “xəstə 17,3 ay yaşayacaq” formasında continuous survival prediction yaratmır.
Model yalnız 12 aylıq hədd ətrafında binary risk classification aparır.
BraTS 2020 verilənlər dəsti tədqiqatda necə istifadə edildi?
Tədqiqatda 494 glioblastoma xəstəsinin çoxmərkəzli BraTS 2020 görüntülərindən istifadə edilmiş; xəstələr ilkin xüsusiyyət mərhələsində 295 təlim, 74 doğrulama və 125 test xəstəsi olaraq bölünmüş və model sazlamalarının test qrupuna məlumat sızdırmaması hədəflənmişdir.
| Xüsusiyyət | Mənbə dəyəri |
|---|---|
| Ümumi xəstə | 494 |
| Şiş tipi | Glioblastoma, mənbədə WHO Grade IV kimi göstərilmişdir |
| Töhfə verən qurum | 19, çoxmillətli |
| MRI ardıcıllıqları | T1, T1ce, T2, FLAIR |
| Görüntü rezolyusiyası | 1 mm³ isotropic |
| Təlim | 295 xəstə (%60) |
| Doğrulama | 74 xəstə (%15) |
| Test | 125 xəstə (%25) |
| Əsas sonlanım | 12 aylıq sağqalım həddi |
| Seqmentasiya | Mütəxəssis manual seqmentasiya, üç alt bölgə |
Dörd MRI ardıcıllığı niyə birlikdə istifadə olunur?
T1, T1ce, T2 və FLAIR eyni bioloji məlumatı təkrarlayan dörd görüntü deyil. Onlar müxtəlif toxuma xüsusiyyətlərini vurğulayır.
| MRI ardıcıllığı | Tədqiqatdakı əsas rol |
|---|---|
| T1 | Anatomik quruluş |
| T1ce | Kontrastlanan aktiv şiş və blood-brain barrier pozulması |
| T2 | Vasogenic edema və infiltrative disease |
| FLAIR | Cerebrospinal-fluid siqnalını basdıraraq şiş və ödem sərhədlərinin daha görünən olması |
Tədqiqatın əsas yanaşması bu dörd modalitenin hamısındakı complementary information-ı vahid radiomik feature representation daxilində birləşdirməkdir.
Seqmentasiya hansı bölgələri əhatə edir?
Mənbədə mütəxəssislər tərəfindən üç əsas tumor sub-region müəyyən edilmişdir:
- enhancing tumor,
- peritumoral edema,
- necrotic core.
Mənbə Figure 2 bu bölgələri müxtəlif rənglərlə göstərir. Bu radioloji görüntülər real xəstələrə aid mənbə məlumatının vizual sübutu olduğuna görə Verianla tərəfindən süni MRI görüntüsü yaradılmamışdır.
Mənbədəki MRI-modality uyğunsuzluğu
Məqalənin əsas metod təsviri və Table 3 dörd MRI ardıcıllığını:
T1, T1ce, T2 və FLAIR
kimi verir.
Lakin inclusion-criteria paraqrafında “full multimodal MRI data” izahında T1 post-contrast, T2-weighted, FLAIR və diffusion-weighted imaging ifadəsi də yer alır.
Diffusion-weighted imaging tədqiqatın əsas dörd-modallı QFT pipeline-ında yenidən istifadə edilmir. Mənbə bu fərqin səbəbini izah etmir. Buna görə diffusion-weighted imaging-i modelin təsdiqlənmiş beşinci giriş kanalı kimi qəbul etmək düzgün deyil.
75 radiomik xüsusiyyət necə yaradıldı?
Mənbənin əsas xüsusiyyət siyahısında 75 dəyişən beş ailəyə bölünür: shape, first-order statistics, GLCM, GLRLM və GLSZM; bu qruplar şiş geometriyasını, voxel intensivlik paylanmalarını və toxuma heterogenliyini ədədi şəkildə təmsil etməyi hədəfləyir.
| Xüsusiyyət ailəsi | Say | Əsas məna |
|---|---|---|
| Cəmi | 75 | QFT giriş vektoru |
| Shape | 14 | Həcm, səth sahəsi, sphericity, compactness, maksimum 3B diametr kimi geometrik xüsusiyyətlər |
| First-order | 18 | Mean, median, variance, skewness, kurtosis, energy, entropy kimi intensivlik statistikaları |
| GLCM | 22 | Qonşu voxel intensivliklərinin məkan birgəliyi |
| GLRLM | 16 | Eyni intensivlik dəyərlərinin ardıcıl voxel run strukturlarını ölçən xüsusiyyətlər |
| GLSZM | 5 | Oxşar intensivlikdə bağlı voxel zones strukturunu ölçən xüsusiyyətlər |
GLCM nədir?
Gray Level Co-occurrence Matrix (GLCM) müəyyən məkan əlaqəsində iki voxel-in intensivlik dəyərlərinin birlikdə nə qədər tez-tez göründüyünü sayan texture representation-dır.
GLCM əsaslı xüsusiyyətlər yalnız şişin orta parlaqlığını deyil, görüntü daxilində spatial heterogeneity-ni ölçməyə çalışır.
GLRLM nədir?
Gray Level Run Length Matrix (GLRLM) müəyyən istiqamətdə eyni və ya oxşar boz-səviyyəli ardıcıl voxel qruplarının uzunluqlarını analiz edir.
Buna görə görüntünün daha homogen və ya daha parçalanmış toxuma quruluşuna malik olması haqqında məlumat yarada bilər.
GLSZM nədir?
Gray Level Size Zone Matrix (GLSZM) eyni boz səviyyədə olan bağlı voxel bölgələrinin ölçülərini qiymətləndirir.
GLRLM istiqamətli run strukturlarını araşdırarkən, GLSZM connected zones üzərində fokuslanır.
Xüsusiyyət sayındakı mənbədaxili uyğunsuzluq
Mənbə əvvəlcə 75 xüsusiyyəti:
\[ 14+18+22+16+5=75 \]
şəklində müəyyən edir.
Lakin bir neçə paraqraf sonra 75-dimensional vector:
“63 texture/first-order features across modalities + 12 shape features”
şəklində ifadə edilir.
Bu izah əvvəlki 14 shape sayı ilə uyğun gəlmir.
Mənbə bu fərqin feature-selection, modality aggregation və ya fərqli sayım metodundan qaynaqlandığını açıqlamır. Buna görə Verianla bu fərqi öz fərziyyəsi ilə həll etmir.
Görüntülər modeldən əvvəl necə əvvəlcədən işlənmişdir?
Mənbə scanner və acquisition fərqlərini azaltmaq üçün tumor ROI daxilində z-score normalization, N4 bias-field correction və intensity discretization tətbiq olunduğunu; dörd MRI modalitesinin feature vectors-larının daha sonra birləşdirildiyini bildirir.
Z-score normalization
Z-score normalization ümumiyyətlə bir xüsusiyyətin ortalamasını sıfıra, standard deviation-ını isə birə yaxınlaşdırmaq üçün istifadə olunur.
Konseptual forma:
\[ z=\frac{x-\mu}{\sigma} \]
şəklindədir.
Bu tənlik tədqiqatın yeni tapıntısı deyil, mənbədə “mean = 0, standard deviation = 1” kimi göstərilən preprocessing addımının riyazi izahıdır.
Burada:
- \(x\): ilkin dəyər,
- \(\mu\): müvafiq paylanmanın ortalaması,
- \(\sigma\): standard deviation,
- \(z\): normallaşdırılmış dəyərdir.
N4 bias-field correction
MRI-da coil sensitivity və digər acquisition təsirləri görüntü boyunca yavaş dəyişən intensity inhomogeneity yarada bilər. N4 bias correction bu aşağı tezlikli intensity variation-ı azaltmaq üçün istifadə olunur.
Intensity discretization
Mənbə:
- T1/T1ce üçün fixed bin width: 25 HU,
- T2/FLAIR üçün fixed bin width: 5 HU
bildirir.
Burada mənbəyə sadiqlik baxımından diqqət edilməli məqam budur: MRI intensity dəyərləri fiziki olaraq CT-dəki Hounsfield Unit kimi standart HU şkalasına malik deyil. Lakin məqalə bu vahidi “HU” kimi yazır. Verianla bunu səssizcə başqa vahidlə əvəz etmir; mənbədə məhz belə bildirildiyini qeyd edir.
Quantum Feature Transform 75 xüsusiyyəti 715 ölçüyə necə çıxarır?
QFT ilkin 75 xüsusiyyət vektorunu saxlayaraq feature-feature quadratic products, hər xüsusiyyətin Gaussian exponential çevrilməsi və mənbədə statistical aggregates kimi müəyyən edilən əlavə xüsusiyyətləri birləşdirib 715 ölçülü klassik feature representation yaradır.
Mənbənin əsas tənliyi:
\[ \Phi(x)=[x;Q(x);E(x);S(x)] \]
şəklindədir.
Burada:
- \(x\): 75 ilkin radiomik xüsusiyyət,
- \(Q(x)\): quadratic interaction representation,
- \(E(x)\): exponential encoding,
- \(S(x)\): statistical aggregates.
Mənbə tərəfindən verilən ölçü bölgüsü:
| Komponent | Ölçü | Funksiya |
|---|---|---|
| Cəmi | 715 | \(\Phi(x)\) |
| \(x\) | 75 | İlkin xüsusiyyətlərin dəyişdirilmədən saxlanması |
| \(Q(x)\) | 300 | Pairwise quadratic interactions-ın PCA ilə sıxılmış təsviri |
| \(E(x)\) | 75 | Gaussian exponential çevrilmə |
| \(S(x)\) | 265 | Mənbədə statistical aggregates kimi müəyyən edilən əlavə representation |
Cəm:
\[ 75+300+75+265=715. \]
Quadratic encoding nə edir?
75 xüsusiyyətin müxtəlif cütləri:
\[ x_i x_j \]
şəklində vurularaq ikinci dərəcəli interactions yaradılır.
75 fərqli xüsusiyyətin özü ilə deyil, bir-birindən fərqli cütlərinin sayı:
\[ \binom{75}{2} = \frac{75\times74}{2} = 2775. \]
Mənbə də 2.775 unique feature pair bildirir.
Bu quadratic terms, məsələn, iki xüsusiyyətin ayrıca zəif, birlikdə isə güclü prognostic information daşıdığı nonlinear əlaqələri modelləşdirməyə kömək edə bilər.
Lakin 2.775 yeni dəyişəni birbaşa istifadə etmək 295 training patient olan verilənlər dəstində həddindən artıq yüksək dimensionality yarada bilər.
Buna görə PCA tətbiq edilmişdir.
PCA niyə istifadə edildi?
Principal Component Analysis correlated high-dimensional variables-ı variance-nın böyük hissəsini saxlayan daha az sayda orthogonal component-ə çevirir.
Mənbə quadratic feature space-dən:
\[ 300 \]
principal component saxlamışdır.
Bu 300 komponentin quadratic feature space-də cumulative variance-ın:
\[ 95\% \]
hissəsini izah etdiyi göstərilir.
PCA yalnız training data üzərində fit edilmişdir. Validation və ya test məlumatlarının PCA parametrlərinə təsir etməməsi data leakage riskini azaltmaq baxımından mühümdür.
Exponential encoding nədir?
Hər xüsusiyyət üçün mənbədə:
\[ E_i(x) = \exp\left( -\frac{x_i^2}{2\sigma^2} \right) \]
forması istifadə olunur.
Burada:
- \(x_i\): normallaşdırılmış müvafiq feature,
- \(\sigma\): Gaussian bandwidth,
- \(E_i(x)\): exponential-encoded feature-dır.
Mənbədə optimal:
\[ \sigma=1.5 \]
kimi verilmişdir.
Bu dəyər training-set daxilində nested cross-validation ilə validation AUC-ROC-u maksimumlaşdıracaq şəkildə seçilmişdir.
Funksiya \(x_i=0\) yaxınlığında ən yüksək dəyərə malikdir. \(|x_i|\) böyüdükcə exponential dəyər qeyri-xətti şəkildə azalır.
Beləliklə, çevrilmə feature magnitude ilə output arasında xətti olmayan əlaqə yaradır.
Statistical aggregate komponentində nə var?
Mənbə \(S(x)\) üçün mean, standard deviation, skewness və kurtosis kimi feature-family statistics hesablandığını və ümumilikdə 265 ölçü ayrıldığını bildirir.
Lakin yalnız dörd statistics × göstərilən feature families hesabı ilə 265 sayının necə əldə olunduğunu təfərrüatı ilə göstərmir.
Buna görə Verianla:
- 265 dəyərini mənbədə bildirildiyi kimi saxlayır,
- lakin mənbədə olmayan alt-komponent bölgüsünü uydurmur.
Bu çevrilmə niyə “quantum-inspired” adlandırılır?
Müəlliflər çevrilməni feature interactions-ı higher-order və nonlinear channel space daxilində təmsil edən “quantum-like representation” kimi təsvir edirlər.
Lakin riyazi əməliyyatlar:
- pairwise multiplication,
- PCA,
- Gaussian exponential functions,
- classical statistics
olduğuna görə performans artımını real quantum computational advantage sübutu kimi şərh etmək mümkün deyil.
Tədqiqatın göstərdiyi budur ki, bu konkret quantum-inspired feature engineering pipeline bu verilənlər dəstindəki classification performance ilə əlaqəlidir.
Ensemble model necə qurulmuşdur?
Methods Section 2.3-ə görə 715 ölçülü feature space üzərində Random Forest, Gradient Boosting, Support Vector Machine, Logistic Regression və XGBoost olmaqla beş base learner öyrədilmiş və model ehtimalları optimallaşdırılmış çəkilərlə soft voting üsulu ilə birləşdirilmişdir.
Random Forest
| Hiperparametr | Dəyər |
|---|---|
| Ağac sayı | 500 |
| Maximum depth | 15 |
| Minimum samples per leaf | 5 |
| Split kriteriyası | Gini impurity |
Gradient Boosting
| Hiperparametr | Dəyər |
|---|---|
| Iterations | 300 |
| Learning rate | 0,01 |
| Maximum depth | 6 |
| Əlavə üsul | Validation loss əsaslı early stopping |
Support Vector Machine
| Hiperparametr | Dəyər |
|---|---|
| Kernel | RBF |
| C | 10 |
| Gamma | 0,001 |
| Optimallaşdırma | Grid search |
Logistic Regression
| Hiperparametr | Dəyər |
|---|---|
| Penalty | L2 |
| Penalty strength \(\alpha\) | 0,01 |
| Solver | SAGA |
XGBoost
| Hiperparametr | Dəyər |
|---|---|
| Boosting rounds | 400 |
| Learning rate | 0,05 |
| Maximum depth | 7 |
| Subsample | 0,8 |
Ensemble çəkiləri
| Model | Çəki |
|---|---|
| Random Forest | 0,25 |
| Gradient Boosting | 0,22 |
| XGBoost | 0,21 |
| SVM | 0,18 |
| Logistic Regression | 0,14 |
Çəkilərin cəmi:
\[ 0.25+0.22+0.21+0.18+0.14=1.00. \]
Soft voting necə işləyir?
Hər model bir xəstənin yüksək-risk ehtimalı üçün:
\[ P_m(\mathrm{high}\mid x) \]
yaradır.
Ensemble probability konseptual olaraq:
\[ P_{\mathrm{ens}} = \sum_{m=1}^{M} w_mP_m \]
şəklində ifadə edilə bilər.
Burada:
- \(M\): model sayı,
- \(w_m\): müvafiq modelin ensemble weight-i,
- \(P_m\): müvafiq modelin predicted probability-sidir.
Mənbədə non-negative weights-in cəmi 1 olacaq şəkildə validation set üzərində optimallaşdırıldığı göstərilir.
Model arxitekturası ilə bağlı mənbədaxili uyğunsuzluq
Burada ciddi mənbə-tutarlılığı problemi vardır:
- Section 2.3: Random Forest, Gradient Boosting, SVM, Logistic Regression və XGBoost olmaqla 5 model müəyyən edir.
- Section 2.3 ensemble weights də eyni beş modelə çəki verir.
- Figure 4 görüntüsü isə “4 models” ifadəsi altında XGBoost, Random Forest, Extra Trees və Gradient Boosting göstərir.
- Figure 6-da Extra Trees, Gradient Boosting, Random Forest, XGBoost və calibrated SVM görünür.
- Figure 6-da Logistic Regression yoxdur.
Mənbə bu fərqli model siyahılarının ayrıca eksperimental mərhələlərə aid olub-olmadığını və ya şəkil/mətn uyğunsuzluğu olub-olmadığını izah etmir.
Buna görə Verianla əsas model arxitekturasını Methods Section 2.3-ün explicit təsvirinə görə təqdim edir; Extra Trees-i final ensemble-ın təsdiqlənmiş altıncı və ya alternativ üzvü kimi əlavə etmir.
Qərar həddi necə seçildi?
Methods mətninə görə validation set üzərində 0,30 ilə 0,70 arasında 0,01 addımlarla qərar hədləri skan edilmiş və accuracy-ni maksimumlaşdırarkən specificity-ni %95-dən yuxarı saxlayan hədd 0,48 kimi seçilmiş; daha sonra bu hədd test setində dəyişdirilmədən istifadə olunmuşdur.
Skan edilən aralıq:
\[ 0.30,0.31,\ldots,0.70 \]
şəklindədir.
Mənbə mətnində seçilmiş threshold:
\[ t=0.48 \]
kimi bildirilir.
Lakin PDF-nin Figure 4 pipeline görüntüsündə:
“Optimal threshold: 0.85”
yazılır.
Bu iki dəyər eyni anda doğru ola bilməz və mənbə ziddiyyətin səbəbini açıqlamır.
Buna görə Verianla:
- əsas metod mətnində Section 2.4-dəki 0,48 dəyərindən istifadə edir,
- Figure 4-dəki 0,85 dəyərini görməzdən gəlmir,
- final tətbiqdə hansı dəyərin həqiqətən istifadə olunduğunu mənbədən kənar təxmin etmir.
Accuracy, sensitivity, specificity və AUC-ROC nə deməkdir?
Bu metriklər modelin müxtəlif xəta növlərini ölçür; xüsusilə glioblastoma risk təsnifatında sensitivity yüksək-risk xəstələri tutmaq qabiliyyətini, specificity isə həqiqətən aşağı-risk olan xəstələri yüksək-risk kimi səhv işarələməmək qabiliyyətini göstərir.
True Positive və False Negative
Bu tədqiqatın sinif tərifində “positive” sinfi yüksək-risk kimi qəbul edilə bilər.
Buna görə:
- True Positive (TP): həqiqətən yüksək-risk və model də yüksək-risk dedi,
- False Negative (FN): həqiqətən yüksək-risk, lakin model aşağı-risk dedi.
Test setində:
\[ TP=58 \]
və:
\[ FN=4. \]
True Negative və False Positive
- True Negative (TN): həqiqətən aşağı-risk və model də aşağı-risk dedi,
- False Positive (FP): həqiqətən aşağı-risk, lakin model yüksək-risk dedi.
Test setində:
\[ TN=63 \]
və:
\[ FP=0. \]
Accuracy
\[ \mathrm{Accuracy} = \frac{TP+TN}{TP+TN+FP+FN}. \]
Bu test setində:
\[ \frac{58+63}{125} = \frac{121}{125} = 0.968 = 96.80\%. \]
Sensitivity
\[ \mathrm{Sensitivity} = \frac{TP}{TP+FN}. \]
Bu tədqiqatda:
\[ \frac{58}{58+4} = \frac{58}{62} \approx93.55\%. \]
Yəni 62 real yüksək-risk xəstənin 58-i düzgün tapılmışdır.
Specificity
\[ \mathrm{Specificity} = \frac{TN}{TN+FP}. \]
Burada:
\[ \frac{63}{63+0} = 100\%. \]
Buna görə mənbə %100 specificity bildirir.
Precision
\[ \mathrm{Precision} = \frac{TP}{TP+FP}. \]
Burada:
\[ \frac{58}{58+0} = 100\%. \]
False-negative rate
\[ \mathrm{FNR} = \frac{FN}{TP+FN} = \frac{4}{62} \approx6.45\%. \]
Klinik baxımdan bu xəta xüsusilə vacibdir; çünki yüksək-risk xəstənin aşağı-risk kimi qiymətləndirilməsi undertreatment riski yarada bilər.
AUC-ROC
ROC curve classification threshold dəyişdirilərkən sensitivity ilə false-positive rate arasındakı əlaqəni göstərir.
AUC-ROC isə bu əyrinin altında qalan sahəni ifadə edir.
Mənbə test üçün:
\[ \mathrm{AUC}=99.97\% \]
bildirir.
Bu dəyər modelin test setində yüksək-risk və aşağı-risk qruplarını çox güclü şəkildə sıraladığını göstərir.
Lakin yüksək AUC təkbaşına prospective clinical utility, treatment benefit və ya calibration zəmanəti deyil.
Modelin ehtimal kalibrasiyası necə qiymətləndirilib?
Tədqiqat yalnız classification accuracy-ni qiymətləndirməmiş; validation setində reliability diagrams və Brier score istifadə edərək predicted probabilities-nin müşahidə olunan nəticələrlə nə qədər uyğun gəldiyini də araşdırmışdır.
Mənbədə validation-set Brier score:
\[ 0.12 \]
kimi verilmişdir.
Binary classification üçün Brier score konseptual olaraq:
\[ \mathrm{Brier} = \frac{1}{N} \sum_{i=1}^{N} (p_i-y_i)^2 \]
şəklindədir.
Burada:
- \(p_i\): modelin predicted probability-si,
- \(y_i\): real binary outcome,
- \(N\): nümunə sayıdır.
Aşağı Brier score daha yaxşı probabilistic calibration deməkdir; lakin Brier score-un mütləq şərhində sinif prevalence və müqayisə edilən model vacibdir.
Tədqiqatın Metodu və Nəticələri
Train, validation və test bölgüsü məlumat sızmasını necə önləməyə çalışır?
Mənbəyə görə PCA, exponential bandwidth, model hyperparameters və feature transformation-a aid öyrənilən parametrlər yalnız training set üzərində müəyyən edilmiş; validation set threshold və ensemble weight kalibrasiyası üçün istifadə edilmiş, 125 xəstədən ibarət test seti isə final qiymətləndirməyə qədər ayrılmış saxlanmışdır.
Bölgü:
\[ 494=295+74+125. \]
Training nisbəti:
\[ \frac{295}{494}\approx59.7\%. \]
Validation:
\[ \frac{74}{494}\approx15.0\%. \]
Test:
\[ \frac{125}{494}\approx25.3\%. \]
Mənbə bunları yuvarlaqlaşdırılmış olaraq 60/15/25% şəklində bildirir.
Nested 5-fold cross-validation
Base-model hyperparameter optimization training set üzərində nested 5-fold cross-validation ilə həyata keçirilmişdir.
Həmçinin model robustness qiymətləndirilməsi training + validation birləşməsi:
\[ n=370 \]
üzərində stratified 5-fold cross-validation ilə aparılmışdır.
Ensemble cross-validation nəticəsi
Mənbədə quantum-radiomics yanaşması üçün mean cross-validation accuracy:
\[ 97.32\%\pm1.24\% \]
və range:
\[ 95.89\%-98.65\% \]
kimi verilmişdir.
Beş fold:
| Fold | Accuracy |
|---|---|
| 1 | 98,65% |
| 2 | 97,30% |
| 3 | 96,76% |
| 4 | 95,89% |
| 5 | 98,24% |
Mənbənin verdiyi coefficient of variation:
\[ 1.27\% \]
kimi bildirilmişdir.
Cross-validation AUC
Orta:
\[ 99.12\%\pm0.58\% \]
range:
\[ 98.23\%-99.76\%. \]
Figure 6 nə göstərir?
Mənbə Figure 6 quantum ensemble-ın yuxarıdakı 97,32% ortalamasını deyil, ayrıca individual base-model cross-validation accuracies dəyərlərini göstərir:
| Model | Accuracy |
|---|---|
| Extra Trees | 95,25% |
| Gradient Boosting | 94,92% |
| Random Forest | 94,83% |
| XGBoost | 95,08% |
| Calibrated SVM | 93,5% |
Figure 6 üzərində mean:
\[ 94.72\% \]
standard deviation:
\[ 0.62\% \]
və range:
\[ 1.75\% \]
kimi göstərilmişdir.
Bu dəyərlər ensemble cross-validation nəticəsi olan 97,32% ilə eyni metrik qrupu deyil.
Validation və test performansı
| Metrik | Validation n=74 | Test n=125 | Test üçün 95% CI |
|---|---|---|---|
| Accuracy | 98,65% | 96,80% | 94,92–98,68% |
| AUC-ROC | 99,78% | 99,97% | 99,89–100,0% |
| Precision | 100,00% | 100,00% | 100,0–100,0% |
| Sensitivity | 97,30% | 93,55% | 86,31–100,0% |
| F1-score | 98,63% | 96,67% | 93,94–99,40% |
| Specificity | 100,00% | 100,00% | 100,0–100,0% |
| False-positive rate | 0,00% | 0,00% | 0,0–0,0% |
| False-negative rate | 2,70% | 6,45% | 0,0–13,69% |
Validation confusion matrix
Validation setində:
- 37 real aşağı-risk → 37 düzgün aşağı-risk,
- 0 false positive,
- 36 real yüksək-risk → 36 düzgün yüksək-risk,
- 1 false negative
vardır.
Test confusion matrix
Test setində:
- 63 true negative,
- 0 false positive,
- 58 true positive,
- 4 false negative
vardır.
Threshold sensitivity
Mənbə threshold 0,30–0,70 arasında dəyişdirildikdə xüsusilə:
\[ 0.40-0.55 \]
aralığında:
- accuracy-nin %92-dən yuxarı,
- specificity-nin %95-dən yuxarı
qaldığını bildirir.
Bu analiz model performansının yalnız bir hədd nöqtəsində yaranan təsadüfi nəticə olmadığını dəstəkləmək məqsədilə aparılmışdır.
Subgroup nəticələri
| Alt qrup | Accuracy | Müqayisə p dəyəri |
|---|---|---|
| Şiş həcmi <40 cm³ | 95,8% | p=0,43 |
| Şiş həcmi ≥40 cm³ | 97,4% | |
| Frontal lobe | 96,2% | p=0,52 |
| Digər lokalizasiyalar | 97,1% | |
| Yaş <60 | 96,5% | p=0,68 |
| Daha yuxarı yaş | 97,0% |
Bu p dəyərləri mənbədə alt qruplar arasında əhəmiyyətli performance difference müşahidə olunmadığını dəstəkləmək üçün təqdim edilmişdir.
Lakin test seti cəmi 125 xəstə olduğuna görə alt-qrup analizlərinin daha böyük demoqrafik və ya klinik populyasiyalarda bərabər performansa zəmanət verdiyi nəticəsi çıxarılmamalıdır.
McNemar və DeLong testləri
Mənbə quantum ensemble ilə baseline müqayisəsində:
\[ p<0.001 \]
McNemar testi və:
\[ p<0.001 \]
DeLong testi bildirir.
McNemar testi paired classification errors arasındakı fərqi qiymətləndirərkən, DeLong testi ROC AUC dəyərlərinin müqayisəsində istifadə oluna bilər.
Burada bu testlərin nəticəsi “quantum mechanics səbəbindən üstünlük sübut edildi” demək deyil. Testlər yalnız müqayisə edilən prediction outputs arasındakı statistik performans fərqini qiymətləndirir.
Ablasiya tədqiqatı quantum-inspired feature transform-un töhfəsini həqiqətən ayıra bilirmi?
Ablasiya tədqiqatında eyni məlumat bölgüsü istifadə edilərək 75 ilkin radiomik xüsusiyyət üzərində quantum expansion olmadan modellər yenidən öyrədilmiş və performans azalması müşahidə edilmişdir; lakin mənbə “ən yaxşı baseline” tərifində accuracy baxımından daxili uyğunsuzluq ehtiva edir.
Mənbə:
| Model | Accuracy | AUC-ROC |
|---|---|---|
| XGBoost | 81,36% | 0,695 |
| Random Forest | 83,05% | 0,631 |
| SVM | 72,88% | 0,681 |
| Logistic Regression | 81,36% | 0,647 |
Quantum-enhanced ensemble:
\[ 96.80\%\ \mathrm{accuracy} \]
və:
\[ 99.97\%\ \mathrm{AUC} \]
bildirir.
Mənbədəki “best baseline” problemi
Mətn XGBoost-u:
“best baseline model”
kimi xarakterizə edib accuracy 81,36% və AUC 0,695 verir.
Lakin eyni paraqrafda Random Forest accuracy:
\[ 83.05\% \]
kimi göstərilmişdir.
Buna görə:
- AUC baxımından XGBoost verilən modellər arasında ən yüksək dəyərə malikdir.
- Accuracy baxımından isə verilən rəqəmlərin ən yüksəyi Random Forest-ın %83,05 dəyəridir.
Mənbə “təxminən 15 percentage-point accuracy improvement” hesabını 81,36% → 96,80% üzərindən aparır:
\[ 96.80-81.36=15.44 \]
percentage point.
Lakin ən yüksək bildirilən baseline accuracy olan 83,05% əsas götürülsə:
\[ 96.80-83.05=13.75 \]
percentage point olur.
Bu ikinci hesab Verianla-nın yeni eksperimental nəticəsi deyil; yalnız mənbədə yan-yana verilən iki accuracy dəyərinin arifmetik fərqidir və mənbədaxili “best baseline” terminologiyasının niyə qeyri-müəyyən olduğunu göstərmək üçün verilir.
Modelin xəta analizi nə göstərdi?
Beş cross-validation fold-da üç və ya daha çox dəfə səhv təsnif edilən 23 xəstə müəyyən edilmiş; mənbə bu çətin halların mühüm hissəsini 12 aylıq qərar sərhədinə yaxın sağqalım, atipik görüntüləmə görünüşü və ya natamam müalicə məlumatı ilə əlaqələndirmişdir.
Mənbə:
- 23 consistently misclassified patient → ümumi verilənlər dəstinin %6,2-si,
- 15 xəstə → 12 aylıq həddən ±1 ay uzaqlıqda borderline outcome,
- 5 xəstə → aggressive disease olmasına baxmayaraq minimal contrast enhancement kimi atypical imaging,
- 3 xəstə → incomplete treatment information
bildirir.
Bu analiz model xətalarının tamamilə təsadüfi olmadığını düşündürür; lakin bu əlaqə causal proof deyil.
Feature-importance stabilliyi
Cross-validation folds arasında feature-importance ranking üçün correlation coefficient:
\[ r=0.92 \]
kimi bildirilmişdir.
Mənbə bütün fold-larda mühüm görünən dəyişənlər arasında:
- tumor volume,
- sphericity,
- surface area
kimi shape features-i vurğulayır.
Discussion bölməsində həmçinin tumor-volume, shape irregularity və enhancement heterogeneity kimi xüsusiyyətlərin bioloji plausibility daşıdığı qeyd edilir.
Mənbənin “external validation” iddiası necə şərh edilməlidir?
Tədqiqat əvvəlki brain-metastasis quantum-radiomics yanaşmasını fərqli şiş növü olan GBM-yə köçürərək cross-domain metodoloji transfer göstərir; lakin bu məqalədəki GBM modelinin train, validation və test xəstələrinin hamısı BraTS 2020-dən gəldiyinə görə müstəqil non-BraTS qurum kohortunda real xarici doğrulama aparılmamışdır.
Bu fərq mühümdür.
Müəlliflər 125 xəstədən ibarət qrupu “external test set” adlandırırlar.
Lakin eyni tədqiqatda:
\[ 494\ \mathrm{BraTS\ hastası} \rightarrow 295+74+125 \]
şəklində vahid BraTS cohort split-i aparılmışdır.
Beləliklə, test xəstələri training patients-dan müstəqildir; lakin məlumat mənbəyi eyni benchmark ekosistemidir.
Discussion bölməsi bunu açıq şəkildə məhdudlaşdırır və:
non-BraTS datasets from institutions independent of research groups
üzərində doğrulamanın aparılmadığını bildirir.
Müəlliflər real external validation üçün:
- BraTS töhfəvericilərindən fərqli xəstəxana mərkəzləri,
- fərqli görüntüləmə protokolları,
- yeni patient cohorts,
- prospective validation
lazım olduğunu ifadə edirlər.
Cross-domain iddiası nəyə əsaslanır?
Müəlliflərin əvvəlki işi brain metastasis survival prediction üzrə hazırlanmış quantum-radiomics metodologiyasıdır.
Bu tədqiqatda eyni əsas transform konseptinin glioblastoma radiomics-ə köçürülə bilməsi “cross-domain” kimi şərh edilir.
Lakin mövcud məqalə əvvəlki brain-metastasis cohort-un quantitative results-ını yanaşı yenidən təqdim etmir.
Mənbənin özü də cross-domain claim-in:
methodological transfer
üzərinə qurulduğunu və iki cohort-un side-by-side performance reporting-inin gələcək tədqiqatlarda aparılmalı olduğunu qəbul edir.
Nəşr olunmuş metodlarla müqayisələr nə dərəcədə etibarlıdır?
Mənbə öz %96,80 test accuracy-sini ənənəvi radiomika və deep-learning tədqiqatlarında daha aşağı bildirilmiş performanslarla müqayisə edir; lakin endpoint, verilənlər dəsti ölçüsü, preprocessing, train/test bölgüsü və validation rigor fərqli olduğuna görə bu müqayisələr birbaşa head-to-head eksperiment deyil.
| Tədqiqat | Metod | Cohort | Test accuracy | Specificity |
|---|---|---|---|---|
| Kickingereder | Radiomics + Random Forest | 170 | 73,0% | 69% |
| Lao | 3D CNN | 181 | 76,0% | 72% |
| Nie | Multi-channel CNN | 163 | 79,0% | 78% |
| Isensee | nnU-Net + Radiomics | 285 | 82,0% | 85% |
| Feng | Multi-task CNN | 209 | 88,0% | 89% |
| Bu tədqiqat | Quantum Radiomics + Ensemble | 494 | 96,80% | 100% |
Mənbənin özü birbaşa numerical comparison aparılarkən ehtiyatlı olmağı tələb edir.
Çünki tədqiqatlar arasında:
- 12-month survival versus median survival endpoint,
- patient number,
- image preprocessing,
- train/test splitting,
- cross-validation versus held-out testing,
- model complexity
fərqlidir.
Buna görə “bu metod bütün digər metodlardan elmi baxımdan qəti şəkildə üstündür” nəticəsi təkcə bu cədvəllə sübut edilmiş deyil.
Dörd false-negative klinik baxımdan niyə vacibdir?
Dörd false-negative həqiqətən yüksək-risk olan dörd xəstənin model tərəfindən aşağı-risk kimi işarələndiyini göstərir; bu xəta növü müalicə intensivliyini azaltmaq kimi klinik qərar avtomatlaşdırılarsa ciddi nəticə yarada biləcəyinə görə model yalnız decision-support səviyyəsində nəzərdən keçirilməlidir.
Mənbənin test setində:
\[ 4/62=6.45\% \]
yüksək-risk xəstəsi səhvən aşağı-risk sinfinə verilmişdir.
Müəlliflər Section 3.1-də bunun “significant clinical concern” olduğunu açıq şəkildə bildirirlər.
Buna görə %100 specificity ifadəsini təkbaşına önə çıxarmaq yanıltıcı ola bilər.
%100 specificity:
“Aşağı-risk xəstələr yüksək-risk kimi səhv işarələnmədi.”
deməkdir.
Bu demək deyil:
“Bütün yüksək-risk xəstələr tapıldı.”
Çünki sensitivity %93,55-dir.
Discussion bölməsindəki false-negative uyğunsuzluğu
Mənbənin Discussion bölməsində dörd false-negative üçün “all but one case borderline survival” kimi izah verildiyi halda bir halda:
survival = 16 months
ifadəsi istifadə edilir.
Lakin tədqiqatın öz binary endpoint tərifində:
\[ \mathrm{high\ risk}<12\ \mathrm{months} \]
olduğuna görə real olaraq 16 ay yaşayan xəstə yüksək-risk true class kimi false-negative ola bilməz.
Mənbə bu məntiqi uyğunsuzluğu izah etmir.
Buna görə Verianla bu 16 aylıq ifadəni false-negative klinik analizinin sübutu kimi istifadə etmir.
Tədqiqatın dəstəklədiyi nəticələr
- BraTS 2020-dəki 494 GBM xəstəsinin çoxmodal MRI radiomik xüsusiyyətləri ilə 12 aylıq binary survival-risk classification aparılmışdır.
- Mənbədə istifadə olunan quantum-inspired transformation klassik kompüterdə işləyir.
- 75 radiomik xüsusiyyət mənbə metodunda 715 ölçülü representation-a genişləndirilmişdir.
- Pairwise quadratic interaction space 2.775 feature pair ehtiva edir və 300 PCA component-ə endirilir.
- 300 component quadratic variance-nın %95-ni saxlayır.
- Gaussian exponential bandwidth \(\sigma=1.5\) kimi seçilmişdir.
- Methods Section 2.3 beş klassik machine-learning learner ehtiva edən weighted soft-voting ensemble müəyyən edir.
- Test n=125 üzərində accuracy %96,80 bildirilmişdir.
- Test AUC-ROC %99,97 bildirilmişdir.
- Specificity %100 və sensitivity %93,55-dir.
- Dörd false-negative və sıfır false-positive vardır.
- Five-fold cross-validation ensemble accuracy %97,32 ± %1,24-dür.
- Ablation tədqiqatı quantum-inspired feature expansion olmadan daha aşağı performance bildirir.
- Tədqiqat multi-institutional BraTS data üzərində aparılmışdır.
Tədqiqatın dəstəkləmədiyi nəticələr
- Tədqiqat real quantum computer-ın glioblastoma sağqalımını proqnozlaşdırdığını göstərmir.
- Quantum supremacy və ya quantum computational advantage göstərilməmişdir.
- Model prospective clinical trial-da sınaqdan keçirilməmişdir.
- Modelin treatment decisions-i təhlükəsiz şəkildə avtomatlaşdıra biləcəyi sübut edilməmişdir.
- Müstəqil non-BraTS xəstəxana cohort-unda doğrulama aparılmamışdır.
- Model continuous survival time proqnozu vermir; 12 aylıq binary endpoint istifadə edir.
- %100 specificity bütün yüksək-risk xəstələrin düzgün tanındığı demək deyil.
- Nəşr olunmuş deep-learning metodları ilə müqayisələr eyni cohort üzərində head-to-head retraining deyil.
- Fərqli xərçənglər, CT, PET və ya ultrasound üçün eyni performance göstərilməmişdir.
- Model rare GBM subtypes və ya underrepresented demographic groups üçün bərabər performans göstərmiş sayılmır.
- Clinical cost-effectiveness formal health-economic study ilə sübut edilməmişdir.
- Manual/expert tumor segmentation tələbinin real klinikada tam avtomatik həll edildiyi göstərilməmişdir.
Tədqiqatın əsas məhdudiyyətləri
Mənbə tərəfindən göstərilən və nəticələrin şərhini məhdudlaşdıran məqamlar:
- BraTS 2020 curated və preprocessed benchmark dataset-dir.
- Clinical deployment üçün reliable automatic segmentation tələb olunur.
- 12 aylıq binary cutoff continuous survival information-ı itirir.
- Rare GBM subtypes və underrepresented demographic groups üçün ümumiləşdirilə bilmə məhduddur.
- Non-BraTS independent institutional validation aparılmamışdır.
- Prospective validation aparılmamışdır.
- Brain metastasis → GBM cross-domain claim side-by-side quantitative comparison ehtiva etmir.
Gələcək tədqiqat təklifləri
Mənbə gələcəkdə:
- Cox proportional-hazards regression,
- accelerated failure-time models,
- independent institutional datasets,
- prospective newly diagnosed cohorts,
- clinical/treatment variables integration,
- genomic və molecular markers integration,
- longitudinal treatment-response monitoring
kimi doğrulama və inkişaf istiqamətləri təklif edir.
Mənbə və Metod Qeydi
Orijinal başlıq: Quantum Radiomics Ensemble Model for Glioblastoma Survival Prediction and External Validation on BraTS 2020
Müəlliflər: Damiana Teliti; Olsi Shehu; Bekir Karlik; Jasmin Kevrić.
Müəllif sırası: Mənbədəki sıra qorunmuşdur.
Corresponding author: Damiana Teliti.
Qurum 1: Department of Information Technology, Faculty of Engineering, Natural and Medical Sciences, International Burch University, Sarajevo, Bosnia and Herzegovina.
Qurum 2: Department of Electrical and Electronics Engineering, Faculty of Engineering and Architecture, Istanbul Esenyurt University, Istanbul, Türkiye.
Qurum 3: Department of Electrical and Electronics Engineering, Faculty of Engineering, Natural and Medical Sciences, International Burch University, Sarajevo, Bosnia and Herzegovina.
Jurnal: The Open Neuroimaging Journal.
Nəşriyyat: Bentham Open / Bentham Science.
Mənbə növü: Research Article.
Rəy statusu: The Open Neuroimaging Journal rəyli jurnaldır; tədqiqat nəşr olunmuş tədqiqat məqaləsidir.
Cild: 19.
E-location ID: e18744400478846.
DOI: 10.2174/0118744400478846260616061026.
Received: 14 Yanvar 2026.
Revised: 6 Aprel 2026.
Accepted: 8 Aprel 2026.
Published: 2 İyul 2026.
Rəsmi keçid: https://doi.org/10.2174/0118744400478846260616061026
Lisenziya: Creative Commons Attribution 4.0 International, CC BY 4.0.
Açar sözlər: Quantum machine learning; Radiomics; Glioblastoma; Multi-modal MRI; Ensemble learning; Neuroimaging.
Tədqiqat dizaynı: Publicly available de-identified BraTS 2020 data üzərində retrospective secondary analysis və machine-learning classification.
Nümunə: 494 glioblastoma xəstəsi.
Məlumat bölgüsü: 295 train / 74 validation / 125 test.
Əsas klinik endpoint: 12-month overall survival threshold.
Əsas metod: PyRadiomics əsaslı feature extraction → quantum-inspired feature transformation → weighted ensemble classification → validation-threshold calibration → held-out test evaluation.
Quantum hardware: İstifadə edilməmişdir. Çevrilmə klassik CPU-da NumPy və scikit-learn ilə tətbiq edilmişdir.
PyRadiomics versiyası: v3.0.
Radiomik standartlaşdırma: IBSI tərifləri əsas götürülmüşdür.
Xüsusiyyət sayı: Başlanğıc 75; QFT-dən sonra 715.
Quadratic pair sayı: 2.775.
Quadratic PCA component: 300.
PCA cumulative variance: %95.
Exponential encoding bandwidth: \(\sigma=1.5\).
QFT hesablama müddəti: Mənbəyə görə standart CPU üzərində təxminən 2–3 dəqiqə/xəstə.
Methods Section 2.3 ensemble: Random Forest, Gradient Boosting, Support Vector Machine, Logistic Regression, XGBoost.
Ensemble çəkiləri: Random Forest 0,25; Gradient Boosting 0,22; XGBoost 0,21; SVM 0,18; Logistic Regression 0,14.
Threshold mənbəyi: Section 2.4 mətni 0,48 bildirir.
Threshold uyğunsuzluğu: Mənbə Figure 4 görüntüsündə “Optimal threshold: 0.85” yazılır. Mənbə bu 0,48/0,85 ziddiyyətini izah etmir. Verianla metod mətnindəki 0,48-i əsas izahda istifadə etmiş, Figure 4 dəyərini gizlətməmişdir.
Model siyahısı uyğunsuzluğu: Section 2.3 beş learner kimi RF, Gradient Boosting, SVM, Logistic Regression və XGBoost müəyyən edir. Figure 4 dörd model kimi XGBoost, Random Forest, Extra Trees və Gradient Boosting göstərir. Figure 6 isə Extra Trees, Gradient Boosting, Random Forest, XGBoost və calibrated SVM təqdim edir. Mənbə fərqi izah etmir.
Feature-count uyğunsuzluğu: Section 2.2 əvvəl 14 shape + 18 first-order + 22 GLCM + 16 GLRLM + 5 GLSZM = 75 verir; daha sonra 75-vector-ı 63 texture/first-order + 12 shape kimi təsvir edir. Mənbə fərqi izah etmir.
MRI-modality uyğunsuzluğu: Əsas pipeline T1, T1ce, T2 və FLAIR istifadə edir. Inclusion-criteria paraqrafı isə diffusion-weighted imaging-i də sadalayır. Mənbə DWI-nin QFT girişində istifadə olunduğunu daha sonra göstərmir.
Ablation uyğunsuzluğu: Mənbə XGBoost-u “best baseline model” kimi 81,36% accuracy və 0,695 AUC ilə adlandırır; eyni paraqrafda Random Forest 83,05% accuracy bildirir. Buna görə “best” ifadəsi accuracy baxımından mətnlə tam uyğun deyil.
False-negative Discussion uyğunsuzluğu: High-risk sinfi survival <12 ay kimi müəyyən edilsə də, Discussion bölməsində false-negative izahında 16 aylıq survival ifadəsi var. Bu dəyər öz binary class tərifi ilə uyğun görünmədiyinə görə Verianla bunu klinik nəticənin sübutu kimi istifadə etməmişdir.
External-validation sərhədi: 125 xəstədən ibarət test qrupu training və validation-dan xəstə səviyyəsində ayrılmışdır; lakin 494 xəstənin hamısı BraTS 2020-dən gəlir. Mənbənin öz Discussion bölməsi non-BraTS müstəqil institution dataset doğrulamasının aparılmadığını açıq şəkildə bildirir.
Klinik istifadə sərhədi: Model prospective clinical trial-da doğrulanmamış və treatment decision algorithm kimi sınaqdan keçirilməmişdir. Müəlliflər Section 3.1-də çıxışın probabilistic decision support kimi görülməsini təklif edirlər.
Etika: Tədqiqat publicly available, fully de-identified BraTS 2020 məlumatının retrospective secondary analysis-idir. International Burch University Ethics Committee formal ethics approval tələb olunmadığına qərar vermiş; approval reference number göstərilməmişdir.
Human/animal rights: Yeni insan və ya heyvan təcrübəsi aparılmamışdır. Orijinal görüntüləmə tədqiqatları müvafiq contributing institutions-ın etik standartları çərçivəsində həyata keçirilmişdir.
Consent: Orijinal görüntüləmə və data sharing üçün müvafiq contributing institutions-da consent alınmışdır; bu de-identified secondary analysis üçün əlavə consent tələb olunmamışdır.
Məlumat əlçatanlığı: BraTS 2020 verilənlər dəsti CBICA/University of Pennsylvania BraTS repository vasitəsilə açıq əlçatandır. Trained ensemble model və analysis code corresponding author-dan reasonable request əsasında istənilə bilər.
Maliyyələşdirmə: None.
Maraqlar toqquşması: Müəlliflər maliyyə və ya digər maraqlar toqquşması olmadığını bildirmişlər.
Acknowledgements: Declared none.
Müəllif töhfələri: Mənbə ətraflı CRediT rol bölgüsü vermir. Bütün müəlliflərin final manuscript-i oxuyub təsdiqlədiyi, yazı və reviziyada iştirak etdiyi və tədqiqatın doğruluğuna dair məsuliyyət qəbul etdiyi bildirilmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib