


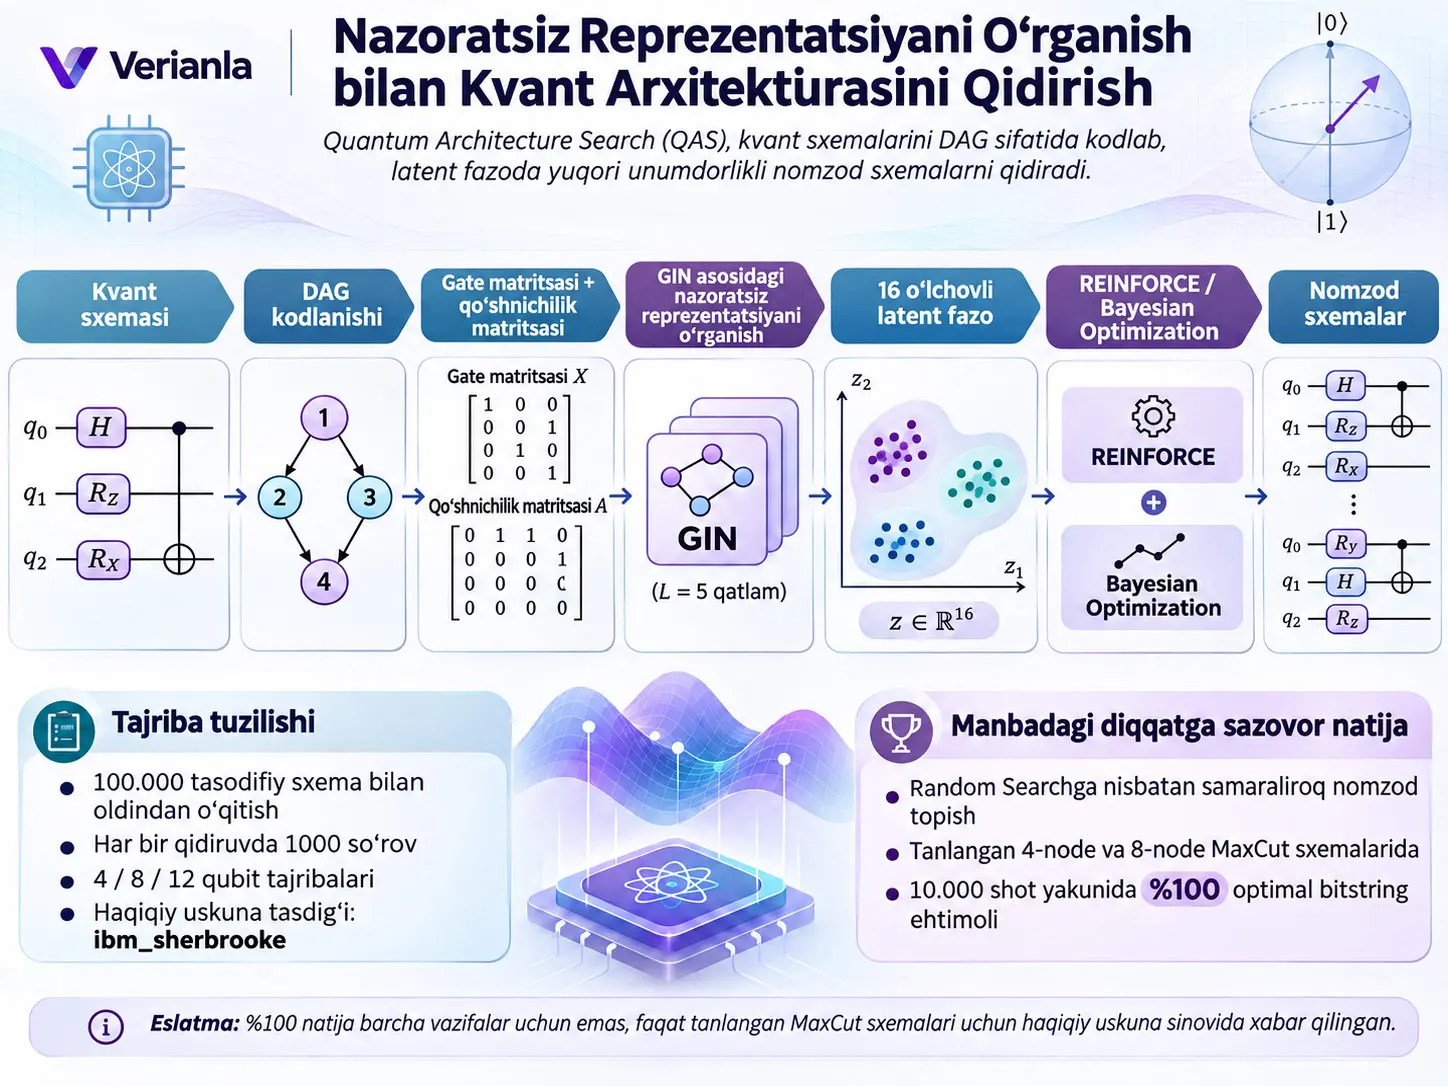
Nazoratsiz reprezentatsiyani o‘rganish bilan Kvant Arxitekturasini Qidirish (Quantum Architecture Search, QAS) — parametrik kvant sxemalarining tuzilishini unumdorlik yorlig‘idan foydalanmasdan past o‘lchamli va uzluksiz latent fazoda ifodalaydigan, so‘ng bu latent fazoni REINFORCE yoki Bayesian Optimization yordamida o‘rganib, yuqori unumdorlikka ega nomzod sxemalarni topishni maqsad qilgan predictor-free kvant sxemasi dizayn doirasidir. Tadqiqotda kvant sxemasi avval yo‘naltirilgan siklsiz graf (Directed Acyclic Graph, DAG) sifatida kodlanadi, gate turlari va qubit rollari alohida xususiyatlar bilan ifodalanadi, Graph Isomorphism Network (GIN) asosidagi variational graph autoencoder tasodifiy yaratilgan 100.000 sxemaning faqat tuzilmaviy ma’lumotidan foydalanib 16 o‘lchamli latent reprezentatsiyani o‘rganadi va keyin qidiruv algoritmlari shu fazoda nomzod arxitekturalarni tanlaydi.
Tadqiqotning asosiy yangiligi kvant sxemasi tuzilishining reprezentatsiyasini unumdorlikka yo‘naltirilgan qidiruv jarayonidan ajratishidadir. Predictor-based QAS usullari ko‘p sonli sxemalarni oldindan baholashni va shu natijalar bilan alohida unumdorlik bashoratchisini o‘qitishni talab qilishi mumkin. Bu tadqiqotda dastlabki o‘qitish bosqichida sxema unumdorligi, VQA energiyasi yoki fidelity yorlig‘i ishlatilmaydi. Biroq “predictor-free” iborasi “baholashsiz” degani emas: qidiruv paytida REINFORCE yoki Bayesian Optimization taklif qilgan nomzod sxemalar reward hisoblash uchun vazifaning o‘zida haqiqatan baholanadi.
Asosiy qidiruv tajribalari quantum state preparation, MaxCut va manbada “quantum chemistry” sarlavhasi ostida berilgan energiyani-minimallashtirish vazifalarida 4 va 8 qubit darajasida o‘tkazilgan. Har bir tajribada qidiruv fazosi 100.000 sxemadan iborat bo‘lgan, har bir run faqat 1000 search query ishlatgan va asosiy unumdorlik taqqoslashlari 50 ta mustaqil random seed bo‘yicha bajarilgan. REINFORCE va Bayesian Optimization, ayniqsa 4-qubit tajribalarida, Random Searchga nisbatan ko‘proq yuqori unumdorlikli nomzod sxema topgan; biroq usul barcha masshtab va barcha metrikalarda raqib reprezentatsiyadan mutlaq ustun emas. Masalan, 12-qubit encoding taqqoslashlarining ayrimlari mavjud GSQAS encoding foydasiga natija beradi.
Haqiqiy kvant apparatida tekshirish faqat tanlangan MaxCut misollarida amalga oshirilgan. 4-node va 8-node MaxCut uchun qidiruv natijasida topilgan eng yaxshi sxemalarning parametrlari shovqinsiz simulatorda o‘qitilgan, keyin ayni parametrlar qayta optimallashtirilmasdan IBMning ibm_sherbrooke NISQ qurilmasida ishga tushirilgan. Manba har bir muammo uchun 10.000 shot yakunida %100,0 optimal bitstring ehtimolini xabar qiladi. Bu natija tanlangan ikki MaxCut sxemasining ko‘chirilishini tasdiqlaydi; barcha QAS vazifalari, barcha sxemalar yoki barcha NISQ shovqin sharoitlari %100 muvaffaqiyat bilan yechilganini ko‘rsatmaydi.
Tadqiqot shuningdek muhim masshtablanuvchanlik chegarasini ko‘rsatadi. 4-qubit latent reprezentatsiyalar ixcham va unumdorlik jihatidan tartibliroq klasterlansa, 12-qubit fazoda 100.000 sxemalik namuna mumkin bo‘lgan arxitekturalarning ancha kichik qismini qamragani sabab yuqori unumdorlikli sxemalarning latent tashkiloti zaiflashadi. Demak, usul qidiruv xarajatini kamaytirish va katta yorliqli ma’lumotlar to‘plamiga ehtiyojni yo‘qotish bo‘yicha afzallik bersa-da, kattaroq kvant sxemalariga masshtablash muammosi hal qilingan emas.
Kvant Arxitekturasini Qidirish (QAS) Nima?
Kvant Arxitekturasini Qidirish (Quantum Architecture Search, QAS) — muayyan kvant hisoblash vazifasi uchun qaysi gate-lar qaysi qubit-larda va qanday ulanish/ketma-ketlik tuzilishida ishlatilishini avtomatik yoki yarim avtomatik o‘rganadigan sxema-arxitekturasini optimallashtirish yondashuvidir; bu tadqiqotda QAS sxemalarning diskret kombinator fazosini bevosita skanerlash o‘rniga avval o‘rganilgan uzluksiz latent reprezentatsiya fazosini qidiradi.
Nega kvant sxemasi arxitekturasi muhim?
Variational Quantum Algorithm (VQA) — parametrik kvant sxemasini klassik optimizer bilan birga ishlatadigan gibrid kvant-klassik algoritmlar oilasi. Parametrik kvant sxemasi, Parameterized Quantum Circuit (PQC), muayyan gate burchaklari yoki boshqa gate parametrlari o‘rgatiladigan kvant sxemasidir.
VQA ichida faqat gate parametrlarining qiymati emas, sxemaning arxitekturasi ham muhim. Ikki sxema bir xil qubit soniga ega bo‘lsa ham, gate turlari, gate ketma-ketligi, ikki-qubit ulanishlari va circuit depth farq qilganda expressibility, entangling capability, optimallashtirish xatti-harakati va shovqinga sezgirlik o‘zgarishi mumkin.
Shuning uchun ikkita alohida optimallashtirish muammosi mavjud:
- Parametrlarni optimallashtirish: Tanlangan sxemaning \(R_x\), \(R_y\), \(R_z\), \(U3\) kabi parametrik gate burchaklarini sozlash.
- Arxitekturani optimallashtirish: Qaysi gate-lar, qaysi tartibda va qaysi qubit ulanishlari bilan ishlatilishini tanlash.
QAS ikkinchi muammoni nishonga oladi. Biroq arxitektura fazosi diskret va kombinator bo‘lgani uchun mumkin bo‘lgan sxemalar soni qubit va gate soni bilan juda tez o‘sishi mumkin.
NISQ nima degani?
Noisy Intermediate-Scale Quantum (NISQ) — fault-tolerant quantum error correction butun hisoblash davomida to‘liq qo‘llanib bo‘lmaydigan, biroq muayyan sondagi fizik qubit va gate bilan haqiqiy kvant hisoblari bajarilishi mumkin bo‘lgan shovqinli oraliq bosqich kvant qurilmalarini ta’riflaydi.
Bu tadqiqot motivatsiyasida NISQ muhim; chunki uzunroq, keraksiz gate-larni o‘z ichiga olgan yoki yomon tuzilgan parametrik sxemalar ideal simulatorda ishlasa ham, haqiqiy qurilmada decoherence va gate noise sabab unumdorlikni yo‘qotishi mumkin. Shu sababli QASning maqsadi faqat matematik jihatdan ifoda kuchi yuqori emas, vazifa uchun samarali sxema tuzilmalarini ham topishdir.
Barren plateau nima?
Barren plateau — ayrim variational quantum circuit-larda optimallashtirish landscapeining katta hududlarida gradient qiymatlari juda kichik bo‘lib qoladigan muammo. Gradient deyarli nol bo‘lganda klassik optimizer qaysi parametr yo‘nalishida harakatlanish kerakligini aniqlashda qiynalishi mumkin.
Manba barren plateauni QAS motivatsiyalaridan biri sifatida beradi; biroq taklif qilingan usul barren plateau muammosini matematik jihatdan yo‘q qiladi deb da’vo qilmaydi. Tadqiqot bevosita o‘lchaydigan narsa sxema arxitekturasini qidirish unumdorligidir.
Kvant Sxemasi Nega Yo‘naltirilgan Siklsiz Graf (DAG) Sifatida Kodlanadi?
Tadqiqot kvant sxemasidagi har bir gateni graf tuguni, ayni qubitda vaqt ketma-ketligiga ko‘ra bir-birini kuzatuvchi gate bog‘liqliklarini yo‘naltirilgan qirralar sifatida ifodalaydi; START va END tugunlari ham qo‘shilib, sxema yo‘naltirilgan siklsiz grafga aylantiriladi va shu tariqa GIN asosidagi graph representation learning sxemaning gate turini, qubit joylashuvini va ulanish topologiyasini birgalikda qayta ishlay oladi.
DAG nima?
Directed Acyclic Graph (DAG) — qirralari yo‘naltirilgan, biroq boshlang‘ich nuqtaga qaytadigan directed cycle-ni o‘z ichiga olmaydigan graf. Kvant sxemasida gate-larning vaqt ketma-ketligi tabiiy ravishda oldinga yo‘nalgan dependency munosabatini hosil qilgani uchun DAG ifodasi mos keladi.
Manbada \(m\) gate turi, \(h\) gate va \(g\) qubitni o‘z ichiga olgan sxema:
grafi bilan ifodalanadi. START va ENDni ham hisobga olgandagi tugunlar soni:
bo‘ladi.
Bu graf uchun bir-birini to‘ldiruvchi ikki matritsa yaratiladi:
- Adjacency matrix \(A\): \(n\times n\) o‘lchamli tuzilmaviy ulanish matritsasi.
- Gate matrix \(X\): \(n\times(m+2+g)\) o‘lchamli gate va qubit-rol xususiyatlar matritsasi.
\(A_{ij}=1\), node \(i\)dan node \(j\)ga directed edge borligini; \(A_{ij}=0\) esa bunday ulanish yo‘qligini bildiradi.
Eski encoding yondashuvida qaysi ma’lumot yo‘qolardi?
Manba taqqoslagan avvalgi EGSQAS encoding ikki-qubit gate ichidagi control va target qubit rollarini yetarlicha ajratmagan. Masalan, CNOT gate-da control qubit bilan target qubit fizik jihatdan bir xil rolga ega emas; bu farq yo‘qolganda ikki xil sxema tuzilmaviy jihatdan bir-biriga ortiqcha o‘xshash ifodalanishi mumkin.
Taklif qilingan encoding bu muammoni ikki yo‘l bilan hal qiladi:
- Ikki-qubit gate uchun control qubit tegishli qatorda −1, target qubit +1 bilan kodlanadi.
- Adjacency matrix ichidagi edge weight amalda qatnashayotgan qubit soni bilan bog‘lanadi; masalan, ikki-qubit gate uchun weight 2 ishlatiladi.
Shunday qilib, model faqat “qaysi gate bor?” ma’lumotini emas, gatening qubit tizimidagi operatsion rolini ham ko‘radi.
Nazoratsiz Reprezentatsiyani O‘rganish Bu Tadqiqotda Nimani O‘rganadi?
Nazoratsiz dastlabki o‘qitish sxemaning MaxCut, state preparation yoki energiyani-minimallashtirish vazifasida qanchalik yaxshi natija berishini o‘rganmaydi; faqat \(A\) adjacency matrix va \(X\) gate/qubit feature matrixdan sxemalarning tuzilmaviy xususiyatlarini siqilgan latent o‘zgaruvchilarga aylantirishni va shu tuzilmaviy ma’lumotdan sxema grafini qayta qurishni o‘rganadi.
Variational posterior: Tenglama (1)
\(Z\), latent representation to‘plamidir. \(z_i\), latent o‘zgaruvchi; \(\mu_i\), ushbu o‘zgaruvchining Gaussian posterior mean-i; \(\sigma_i\), standard deviation parametridir. \(\operatorname{diag}(\sigma_i^2)\), diagonal covariance farazini ifodalaydi.
Bu tenglama kvant state wavefunction tenglamasi emas. \(Z\), klassik machine-learning modeli o‘rganadigan latent o‘zgaruvchidir.
Reparameterization trick
Model latent o‘zgaruvchini:
ko‘rinishida namunalaydi. Bu yozuv tasodifiy namunalash amalini \(\mu_i\) va \(\sigma_i\) orqali differentiable o‘qitish oqimiga bog‘lash uchun ishlatiladi.
GIN message passing: Tenglama (2)
\(M^{(s)}\), GINning \(s\). message-passing layeridagi node embedding matritsasidir. Boshlanishi:
\(\hat A\) manbada:
deb ta’riflanadi. Asl circuit graph directed bo‘lsa-da, GIN message passing paytida adjacency symmetrize qilinadi; shu tariqa bog‘langan gate-lar o‘rtasida ikki yo‘nalishli feature aggregation bajarilishi mumkin.
\((1+\epsilon^{(s)})M^{(s-1)}\) hadi nodening o‘z avvalgi reprezentatsiyasini saqlaydigan o‘rgatiladigan self-loop hissasidir. \(\hat A M^{(s-1)}\) qo‘shni gate ma’lumotlarini jamlaydi. \(\operatorname{MLP}^{(s)}\) esa jamlangan ma’lumotni nonlinear embeddingga aylantiradi.
Tadqiqotdagi barcha asosiy tajribalarda:
- GIN layer soni \(L=5\),
- hidden dimension = 128,
- latent dimension = 16
ishlatilgan.
Fusion layer nima qiladi?
Model faqat oxirgi GIN layer chiqishiga tayanish o‘rniga turli GIN qatlamlaridan kelgan reprezentatsiyalarni birlashtiradigan fusion layerdan foydalanadi. Maqsad faqat chuqur qatlamdagi abstrakt reprezentatsiyani emas, balki oldingi qatlamlardagi lokal gate/connectivity ma’lumotini ham latent representationga olib o‘tishdir.
Decoder qaysi ma’lumotlarni qayta tiklaydi?
Decoder latent \(Z\)dan adjacency matrix \(A\)ni ham, gate matrix:
tuzilishini ham qayta tiklashga urinadi. \(X^t\) gate type one-hot ma’lumotini, \(X^q\) esa gatening qaysi qubit-larda ishlashini kodlaydigan pozitsiya ma’lumotini tashiydi.
Tenglama (3): Adjacency reconstruction
Bu factorization reconstructed graph ichidagi edge ma’lumotlarini latent node juftlaridan hosil qilish modelidir.
Tenglama (4)
Manba bu ifodani \(\operatorname{ReLU}_j\) notatsiyasi bilan beradi va \(\operatorname{ReLU}_j\) uchun alohida batafsil matematik ta’rif bermaydi. Shu sababli ifoda jim ravishda boshqa activation yoki probability functionga o‘zgartirilmagan. \(F_1\), manbada trainable linear function sifatida ko‘rsatiladi.
Tenglama (5)–(7): Gate matrix reconstruction
Softmax gate type kategoriyasini, \(\tanh\) esa qubit-position encodingning uzluksiz chiqishini hosil qilish uchun ishlatiladi. Manba Tenglama (6) va (7)da ikkala chiqish uchun ham \(F_2\) belgisidan foydalanadi va keyin \(F_1\) bilan \(F_2\) trainable linear functions ekanini aytadi. Verianla bu notatsiyani taxmin bilan \(F_3\) kabi boshqa belgiga o‘zgartirmagan.
ELBO: Tenglama (8)
Evidence Lower Bound (ELBO) — variational autoencoder o‘qitish maqsadi. Birinchi had latent representationdan asl circuit structure qanchalik yaxshi qayta hosil qilinishini mukofotlaydi. Ikkinchi had posterior \(q(Z\mid X,A)\) bilan prior \(p(Z)\) o‘rtasidagi Kullback–Leibler divergenceni jazolaydi.
Manba priorni:
deb tanlaydi. Bu regularization latent fazoning tarqoq va uzilgan lookup table o‘rniga tartibliroq probabilistic representationga aylanishini rag‘batlantiradi.
Pretraining minibatch gradient descent bilan va batch size 32 ishlatib bajarilgan.
Dastlabki o‘qitish giperparametrlari
| Parametr | Qiymat | Ma’nosi |
|---|---|---|
| Qubit soni | 4 / 8 / 12 | Tajriba/reprezentatsiya masshtablari |
| Gate soni | 10 / 20 / 30 | Mos ravishda 4 / 8 / 12 qubit circuit generator sozlamasi |
| Maximum circuit depth | 5 | Hosil qilingan sxema chuqurligining yuqori chegarasi |
| Circuit soni | 100.000 | Randomly generated search / representation space |
| Batch size | 32 | Pretraining minibatch o‘lchami |
| Pretraining epoch | 16 | Autoencoder dastlabki o‘qitish epoch soni |
| Dropout | 0,1 | Decoder implicit regularization |
| Input normalization | True | Input normalization qo‘llanadi |
| Input dimension | 2 + #gates + #qubits | Gate/qubit xususiyat o‘lchami |
| Hidden dimension | 128 | GIN hidden representation |
| Latent dimension | 16 | O‘rganilgan uzluksiz latent fazo |
| GIN layer | 5 | Message-passing depth |
| MLP layer | 2 | GIN ichidagi MLP chuqurligi |
Operation pool
Random circuit generator quyidagi gate hovuzidan foydalanadi:
Bu hovuzning tanlovi muhim. Search algorithm faqat generator hosil qila oladigan sxemalarni topishi mumkin. Operation poolda ayrim gate familylar bo‘lmasa, QAS keyinchalik bu yetishmaydigan arxitekturalarni “ixtiro” qila olmaydi. Shu sababli tadqiqot natijalari belgilangan circuit search space kontekstida baholanishi kerak.
Pretraining unumdorlik metrikalari nimani o‘lchaydi?
Manba beshta alohida metric ishlatadi:
- Accuracyops: gate type reconstruction aniqligi.
- Accuracyqubit: gatening qaysi qubit-larda ishlashini qayta tiklash aniqligi.
- Accuracyadj: adjacency matrix reconstruction aniqligi.
- Falposmean: reconstructed adjacency matrixdagi mean false-positive miqdori.
- KLD: latent representationning continuity/smoothness bahosida ishlatiladigan KL-divergence metrikasi.
| Qubit | Encoding | Accuracy ops | Accuracy qubit | Accuracy adj | Falpos mean | KLD |
|---|---|---|---|---|---|---|
| 4 | GSQAS | 99,99 | 99,99 | 99,91 | 100,00 | 0,061 |
| 4 | Taklif qilingan | 100 | 99,97 | 98,89 | 23,41 | 0,045 |
| 8 | GSQAS | 86,69 | 99,98 | 99,82 | 100,00 | 0,038 |
| 8 | Taklif qilingan | 100 | 98,65 | 97,34 | 7,35 | 0,029 |
| 12 | GSQAS | 86,69 | 99,94 | 99,70 | 100,00 | 0,028 |
| 12 | Taklif qilingan | 98,67 | 99,14 | 97,79 | 4,75 | 0,022 |
Bu jadvalni “taklif qilingan encoding barcha reconstruction metriclarda yaxshiroq” deb o‘qish to‘g‘ri emas. Taklif qilingan usul gate-type accuracy, false-positive metrikasi va KLD bo‘yicha aniq afzallik ko‘rsatsa-da, Accuracyqubit va ayniqsa Accuracyadj qiymatlari ayrim holatlarda GSQASdan past. Manbaning bahosi umumiy representation quality va downstream search behavior orqali amalga oshiriladi.
Manba Table 1 captionida “four metrics” iborasini ishlatgan bo‘lsa-da, ko‘rinadigan jadvalda Accuracyops, Accuracyqubit, Accuracyadj, Falposmean va KLD bo‘lib beshta metric ustuni mavjud. Verianla manba ichidagi bu ifoda farqini yashirmaydi.
PCA va t-SNE tasvirlari nimani ko‘rsatadi?
Manba Figure 2, 16-o‘lchamli latent representationni ikki o‘lchamga tushirish uchun Principal Component Analysis (PCA) va t-distributed Stochastic Neighbor Embedding (t-SNE)dan foydalanadi.
Bu tasvirlardagi ranglar circuitlar erishgan energy yoki fidelity qiymatlarini ko‘rsatadi; biroq bu performance qiymatlari autoencoderning unsupervised pretraining targeti emas. Ular faqat o‘qitishdan keyin latent spacening unumdorlik jihatidan qanday tashkil topganini tahlil qilish uchun ustiga joylashtirilgan.
4-qubit holatda yuqori unumdorlikli arxitekturalar tartibliroq hududlarda klasterlanadi. 12-qubit holatda esa 100.000 circuit mumkin bo‘lgan arxitektura fazosining kichikroq qismini ifodalagani sabab bu tartib zaifroq. Manba buni kattaroq qidiruv fazolarida representation-learning coverage chegarasi sifatida talqin qiladi.
Predictor-Free Qidiruv Nima Degani?
Predictor-free qidiruv candidate circuit unumdorligini oldindan bashorat qiladigan alohida supervised predictor o‘qitmaslikni anglatadi; pretrained structural encoder qat’iy saqlanadi, REINFORCE yoki Bayesian Optimization latent fazodan nomzod tanlaydi va nomzod sxemaning haqiqiy vazifa evaluationi faqat reward hosil qilish uchun ishlatiladi.
REINFORCE
Manba PPO va A2C bilan dastlabki sinovlar o‘tkazganini, biroq architecture search uchun REINFORCE usulini tanlaganini bildiradi.
REINFORCE — policy-gradient turidagi mustahkamlovchi o‘rganish algoritmidir. Bu tadqiqotda:
- state space pretrained architecture embeddingsdan iborat;
- policy network bitta hujayrali LSTMdan foydalanadi;
- action, joriy state distributiondan namunalangan latent vector tanloviga mos keladi;
- candidate circuit vazifada baholanadi;
- olingan fidelity yoki energiya nisbati reward sifatida policy updatega kiradi.
Energiya vazifalari uchun reward: Tenglama (9)
Manba MaxCut va energiyani-minimallashtirish vazifalarida \(E_{\mathrm{ground}}<0\) bo‘ladigan conventiondan foydalanadi. Bu convention ostida nomzod energiya ground-state energyga yetganda:
bo‘ladi. \(E_{\mathrm{candidate}}=0\) uchun reward 0.
Dastlabki optimallashtirish yoki numerical noise paytida \(E_{\mathrm{candidate}}>0\) bo‘lsa, nisbat manfiy chiqishi mumkin. Manba bu holatda rewardni 0 ga clip qiladi.
Quantum state preparation uchun energy ratio ishlatilmaydi; reward to‘g‘ridan-to‘g‘ri fidelity.
Adaptive baseline
REINFORCE varianceni kamaytirish maqsadida manba:
adaptive baselinedan foydalanadi. \(R_{\mathrm{avg}}\), avvalgi reward average; \(\alpha\in[0,1]\) smoothing coefficient. Manba asosiy usul matnida \(\alpha\)ning aniq numerical qiymatini bermaydi; shu sababli qiymat taxmin qilinmagan.
Har bir run 1000 architecture searchni o‘z ichiga oladi.
Bayesian Optimization
Ikkinchi search strategy — Deep Networks for Global Optimization (DNGO) asosidagi Bayesian Optimization.
Manba BO regression modelida 128 hidden unitni o‘z ichiga olgan bitta hidden-layer feed-forward basis functiondan foydalanadi. Acquisition function sifatida Expected Improvement (EI) tanlanadi.
BO dastlab 16 sample bilan ishlaydi. Har bir epochda EI taklif qilgan top-k architecture embeddinglar batchga qo‘shiladi va model yangilangan batchda 100 epoch qayta o‘qitiladi.
Bu yerdagi “100 epoch” autoencoder pretraining uchun berilgan 16 epoch bilan bir xil o‘qitish emas. Biri architecture representation pretraining, ikkinchisi BO search modelining iteration ichidagi qayta o‘qitilishidir.
Tadqiqot Usuli va Natijalari
100.000 Sxemalik Fazoda 1000 Qidiruv Nimani Anglatadi?
Har bir asosiy QAS runda usul oldindan hosil qilingan 100.000 sxemalik search spacening faqat 1000 nomzodini, ya’ni taxminan bir foizini vazifada so‘raydi; shu sababli tajribaning maqsadi barcha sxemalarni exhaustive tarzda skanerlash emas, latent representation yuqori unumdorlikli hududlarni Random Searchga qaraganda zichroq namunalay oladimi-yo‘qmi sinashdir.
Asosiy tajriba vazifalari
Tadqiqot uchta qo‘llanma oilasidan foydalanadi:
- quantum state preparation,
- MaxCut,
- energy minimization / manba terminologiyasi bilan quantum chemistry guruhi.
Asosiy Figure 3 va Figure 4 tajribalari 4 va 8 qubit darajasida o‘tkazilgan. Representation-learning va encoding baholashlarining ayrim qismlarida 12-qubit circuits ham ishlatiladi.
Quantum state preparation
Quantum state preparation vazifasining maqsadi target quantum stateni imkon qadar yuqori fidelity bilan qayta hosil qilishdir.
Manba target stateni unga mos random circuitni hosil qilish orqali yaratadi va QAS usulini shu state uchun yuqori fidelity beradigan candidate circuitlarni qidirishda ishlatadi.
Fidelity 0 bilan 1 oralig‘ida reward sifatida bevosita ishlatilishi mumkin bo‘lgani uchun alohida energy normalization qilinmaydi.
MaxCut
MaxCut — weighted undirected graph verticesini ikki guruhga ajratib, ikki guruh orasidagi edge weight yig‘indisini maksimal qilish muammosi.
Tadqiqot graphdan Hamiltonian hosil qiladi va VQE asosidagi energiya bahosidan foydalanadi.
Appendix A.2da manba:
- 4-qubit / 4-node misol uchun ground-state energy = −10 Ha,
- 8-qubit / 8-node misol uchun ground-state energy = −52 Ha
ifodasidan foydalanadi. “Ha” birligi manbada shu tarzda yozilgani sabab saqlangan; Verianla bu notatsiyani jim ravishda boshqa birlikka aylantirmaydi.
Quantum chemistry va TFIM farqi
Appendix A.2da molekulyar misollar:
- 4-qubit H₂: taxminan optimal ground-state energy = −1,136 Ha,
- 12-qubit LiH: taxminan optimal ground-state energy = −7,88 Ha
deb beriladi.
Biroq 8-qubit misol molekula emas. Manba \(n=8\) transverse-field Ising model (TFIM) ishlatilganini aniq bildiradi.
Manba Tenglama (10) — o‘zgartirilmasdan
\(\sigma_z^i\), \(i\). qubitdagi Pauli-Z operatorini; \(\sigma_x^i\), Pauli-X operatorini ifodalaydi. Birinchi had neighboring spin couplingni, ikkinchi had transverse-field hissasini bildiradi.
Manba ichidagi muhim nomuvofiqlik: Matn model \(n=8\) ekanini va yig‘indi \(i=0\)dan 7gacha ekanini aytgani holda qo‘shni indeksda \((i+1)\bmod 6\) deb yozadi. Bu ifoda source PDFda aynan shunday. Verianla buning typographical error ekanini manbadan tashqari taxmin qilib \(\bmod 8\)ga o‘zgartirmagan.
Manba ushbu Hamiltonian uchun taxminiy optimal energyni −10 Ha sifatida ishlatadi.
Qidiruv natijalari qanday taqqoslandi?
Figure 3da har bir plot 50 ta mustaqil running average rewardini ko‘rsatadi va har bir run 1000 queryni o‘z ichiga oladi. Shaded bands standard deviationni ko‘rsatadi.
Mualliflarning kuzatuviga ko‘ra, REINFORCE va Bayesian Optimization latent representation ichida search davom etgan sari average rewardni ayniqsa dastlabki bosqichda oshiradi, Random Search esa o‘xshash improvement ko‘rsatmaydi. RL va BOning variancei Random Searchdan biroz yuqori bo‘lsa-da, average reward darajalari yuqoriroq.
Candidate thresholdlar
| Vazifa | 4-qubit threshold | 8-qubit threshold |
|---|---|---|
| State preparation | 0,95 | 0,75 |
| MaxCut | 0,95 | 0,925 |
| Energy / quantum-chemistry guruhi | 0,95 | 0,95 |
Shu sababli 4-qubit va 8-qubit candidate countlarni faqat soniga qarab to‘g‘ridan-to‘g‘ri taqqoslash to‘g‘ri emas; task complexity bilan birga threshold qiymatlari ham farq qiladi.
4-qubit qidiruv samaradorligi
| Usul | Task | Jami baholash | Topilgan nomzod \(N_{\mathrm{QAS}}\) | \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|---|---|
| GNN predictor + RL | Fidelity | 2000 | 36 | 0,0180 |
| GNN predictor + RL | MaxCut | 2000 | 783 | 0,3915 |
| GNN predictor + RL | QC-H₂ | 2000 | 278 | 0,1390 |
| GSQAS predictor + RL | Fidelity | 2000 | 37 | 0,0185 |
| GSQAS predictor + RL | MaxCut | 2000 | 785 | 0,3925 |
| GSQAS predictor + RL | QC-H₂ | 2000 | 658 | 0,3290 |
| Random Search | Fidelity | 1000 | 15 | 0,0150 |
| Random Search | MaxCut | 1000 | 568 | 0,5680 |
| Random Search | QC-H₂ | 1000 | 371 | 0,3710 |
| Taklif qilingan QAS — REINFORCE | Fidelity | 1000 | 69 | 0,0690 |
| Taklif qilingan QAS — REINFORCE | MaxCut | 1000 | 898 | 0,8980 |
| Taklif qilingan QAS — REINFORCE | QC-H₂ | 1000 | 817 | 0,8170 |
| Taklif qilingan QAS — BO | Fidelity | 1000 | 63 | 0,0630 |
| Taklif qilingan QAS — BO | MaxCut | 1000 | 820 | 0,8200 |
| Taklif qilingan QAS — BO | QC-H₂ | 1000 | 739 | 0,7390 |
Predictor-based usullarning \(N_{\mathrm{eval}}=2000\) qiymati performance predictorni qurish uchun kerak bo‘lgan labeled-circuit baholashlari bilan search paytida qilingan baholashlar yig‘indisini o‘z ichiga oladi. Taklif qilingan predictor-free usulda alohida 1000 labeled pretraining circuit evaluation yo‘q; structural pretraining performance label talab qilmaydi va \(N_{\mathrm{eval}}=1000\) search evaluation ishlatiladi.
Bu jadval usul ayniqsa MaxCut va H₂ energiya vazifasida yuqori-performing regionsni zichroq namunalay olishini ko‘rsatadi. Biroq task-specific thresholdlar va search-space composition natijalarning kontekstidir; qiymatlar universal QAS efficiency constantlari emas.
Encoding o‘zgarganda natija doim yaxshilanadimi?
| Tajriba | GSQAS encoding \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) | Taklif qilingan encoding \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|
| GSQAS — 4 | 0,3125 | 0,3290 |
| GSQAS — 12 | 0,1415 | 0,1380 |
| QAS-RL — 4 | 0,7600 | 0,8170 |
| QAS-RL — 8 | 0,1600 | 0,1670 |
| QAS-RL — 12 | 0,4220 | 0,3920 |
Bu natija muhim talqin chegarasini yaratadi. Yangi encoding 4 va 8-qubit misollarning ko‘pchiligida afzallik bersa-da, 12-qubitdagi ikki taqqoslashda GSQAS encodingdan ortda qoladi. Manba ham 12-qubit search space 100.000 circuit bilan yetarlicha ifodalanmasligini ehtimoliy sabab sifatida muhokama qiladi.
Latent dimension va GIN depth ablatsiyasi
| Latent \(d_z\) | GIN depth \(L\) | VAE loss | Average reward RL | Average reward BO |
|---|---|---|---|---|
| 8 | 5 | 0,11 | 0,95 ± 0,001 | 0,89 ± 0,030 |
| 16 | 5 | 0,09 | 0,98 ± 0,006 | 0,93 ± 0,013 |
| 32 | 5 | 0,14 | 0,975 ± 0,009 | 0,92 ± 0,017 |
| 16 | 3 | 0,10 | 0,95 ± 0,013 | 0,93 ± 0,021 |
| 16 | 7 | 0,09 | 0,97 ± 0,010 | 0,92 ± 0,022 |
Ablation natijalari 10 random seed bo‘yicha mean ± standard deviation sifatida berilgan. VAE reconstruction objective hyperparameterlarga sezgir bo‘lsa-da, downstream QAS reward cheklanganroq o‘zgaradi. Manbaning default tanlovi \(d_z=16\), \(L=5\).
IBM ibm_sherbrooke Ustidagi %100 Natija Nimani Anglatadi?
Manbaning %100 natijasi QAS bilan tanlangan faqat ikki MaxCut sxemasi — 4-node va 8-node problem — simulatorda o‘qitilgan parametrlari o‘zgartirilmasdan ibm_sherbrooke ustida 10.000 tadan shot bilan ishga tushirilganda barcha o‘lchovlarda optimal bitstring qayd etilganini anglatadi; bu state-preparation yoki chemistry/TFIM vazifalari haqiqiy apparatda ayni muvaffaqiyatga erishganini yoki usul umumiy quantum advantage berganini ko‘rsatmaydi.
Haqiqiy apparat test protokoli
- QAS yordamida 4-node va 8-node MaxCut uchun eng yaxshi-performing circuit tanlandi.
- Bu sxemalarning trainable parametrlari noise-free simulator ustida optimallashtirildi.
- Ayni parameter set haqiqiy ibm_sherbrooke qurilmasiga ko‘chirildi.
- Manba hech qanday hardware-specific parameter re-tuning qilinmaganini bildiradi.
- Har bir sharoit 10.000 measurement shot bilan ishga tushirildi.
| Metrik | 4-node simulator | 4-node haqiqiy qurilma | 8-node simulator | 8-node haqiqiy qurilma |
|---|---|---|---|---|
| Optimal bitstring ehtimoli | %100,0 | %100,0 | %100,0 | %100,0 |
| Average cut value | 4 | 4 | 12 | 12 |
| Shot | 10.000 | 10.000 | 10.000 | 10.000 |
| Noise model | Noise-free | Physical NISQ | Noise-free | Physical NISQ |
| Device | Simulator | ibm_sherbrooke | Simulator | ibm_sherbrooke |
Manba alohida confidence interval xabar qilmaydi. Shu sababli Verianla “haqiqiy muvaffaqiyat ehtimoli aniq 1,000000” kabi statistik umumlashtirish qilmaydi; faqat manba Table 4da 10.000 repeated shot uchun kuzatilgan va %100,0 deb xabar qilingan natijani yetkazadi.
Bu natija quantum advantagemi?
Yo‘q. Tadqiqot savoli classical computerni quantum computerga nisbatan tezlik yoki complexity jihatidan yengish emas. Qidiruv frameworki asosan klassik machine learning va shovqinsiz quantum simulationdan foydalanadi; haqiqiy hardware tajribasi esa tanlangan candidate circuitlarning ko‘chiriluvchanligini tekshiradi.
Demak, tadqiqot qo‘llab-quvvatlaydigan ifoda “topilgan ikki MaxCut circuit haqiqiy NISQ qurilmasiga parametr re-tuningsiz muvaffaqiyatli ko‘chirildi”dir. “QAS classical computingdan oshib ketdi” yoki “quantum advantage ko‘rsatildi” degan natija manba tomonidan sinovdan o‘tkazilmagan.
Tadqiqotning kuchli tomonlari
- Architecture representation learning bilan task-specific search bir-biridan ajratilgan.
- Pretraining performance labels yoki VQA evaluations talab qilmaydi.
- Control/target roli va multi-qubit edge importance avvalgi encodingga qaraganda aniqroq ifodalanadi.
- Ayni pretrained representation turli downstream tasks uchun ishlatilishi mumkin.
- REINFORCE va BO ayni latent space ustida qo‘llanishi mumkin.
- Search unumdorligi faqat bitta qo‘llanmada emas, state preparation, MaxCut va energy-based vazifalarda baholangan.
- Asosiy search curves 50 independent run bo‘yicha baholangan.
- Latent dimension va GIN depth uchun alohida ablation qilingan.
- Eng yaxshi MaxCut circuitlar haqiqiy IBM hardware ustida to‘g‘ridan-to‘g‘ri sinovdan o‘tkazilgan.
Tadqiqotning cheklovlari
Search-space coverage: 100.000 circuit 4-qubit muammosida boy namunalashni ta’minlashi mumkin bo‘lsa-da, 12-qubit barcha possible architecture spacening juda kichik qismini qamrashi mumkin. Manba 12-qubit latent representationdagi zaifroq clusteringni shu cheklov bilan bog‘laydi.
Operation-pool bog‘liqligi: Model faqat boshlang‘ich circuit generator ruxsat bergan gate seti va structural constraints ichida qidiruv olib boradi.
Hardware validation qamrovi: Haqiqiy hardware faqat 4-node va 8-node MaxCut best circuits uchun ishlatilgan; state preparation va energiya vazifalari uchun ayni real-device validation xabar qilinmagan.
Tanlangan sxema tekshiruvi: Hardware test butun candidate distributionni emas, search tanlagan eng yaxshi sxemalarni sinaydi.
Noise-model umumlashtirish: Search asosiy tajribalari noise-free simulator ustida bajarilgan. QAS objective bevosita hardware noise-aware search sifatida optimallashtirilmagan.
Scalability: 12-qubit natijalari representation coverage va downstream search unumdorligida pasayish bo‘lishi mumkinligini ko‘rsatadi. Shu sababli usul kattaroq sxemalarda avtomatik tarzda ayni efficiencyni kafolatlamaydi.
Predictor-free ≠ evaluation-free: Alohida predictor va labeled pretraining kerak bo‘lmasa-da reward uchun candidate VQA evaluation talab qilinadi; qimmat vazifa baholashi butunlay yo‘qolmaydi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
Manba circuit structureni nazoratsiz tarzda o‘rganilgan latent representationga aylantirish QAS uchun foydali bo‘lishi mumkinligini hamda REINFORCE/BO shu latent space ichida Random Searchga qaraganda samaraliroq yuqori-performing candidate discovery bera olishini qo‘llab-quvvatlaydi.
Taklif qilingan encoding control-target role va interaction weight kabi circuit-specific ma’lumotlarni aniqroq ifodalaydi hamda ko‘plab metric va downstream search conditionlarda afzallik beradi.
4-qubit misollarda latent representation performance structure bilan tartibli tarzda klasterlana olishi ko‘rsatiladi; performance label bu representationning training targeti emas.
Tanlangan 4-node va 8-node MaxCut circuits simulator-trained parameters bilan ibm_sherbrooke ustida qayta tuningsiz manbada xabar qilingan optimal outputni saqlashi ko‘rsatiladi.
Tadqiqot qo‘llab-quvvatlamaydigan natijalar
Tadqiqot barcha kvant circuit architecture search muammolarida yangi encoding eng yaxshi ekanini isbotlamaydi. 12-qubit taqqoslashlarida ayrim natijalar eski encoding foydasiga.
Tadqiqot predictor-free yondashuv quantum circuit evaluation ehtiyojini butunlay yo‘q qilganini ko‘rsatmaydi.
Tadqiqot topilgan barcha sxemalar haqiqiy hardware noisega chidamli ekanini ko‘rsatmaydi.
Tadqiqot state preparation, H₂, LiH yoki TFIM vazifalarini ibm_sherbrooke ustida ayni hardware test protokoli bilan tasdiqlamaydi.
Tadqiqot fault-tolerant quantum computing ko‘rsatmaydi; ishlatilgan haqiqiy qurilma NISQ qurilmasidir.
Tadqiqot quantum computational advantage yoki classical speedupni isbotlamaydi.
Tadqiqot 100.000 sxemalik namuna 12-qubit yoki undan katta circuit spacesni to‘liq ifodalaydi deb ko‘rsatmaydi.
Manba va Usul Haqida Izoh
Asl sarlavha: Quantum Architecture Search with Unsupervised Representation Learning
Mualliflar: Yize Sun, Zixin Wu, Volker Tresp, Yunpu Ma.
Teng hissa: Yize Sun va Zixin Wu.
Aloqa muallifi: Yunpu Ma.
Manbada berilgan aloqa e-pochtasi: cognitive.yunpu@gmail.com
Muassasa 1: Ludwig-Maximilians-University Munich, Munich, Germany.
Muassasa 2: Siemens AG, Munich, Germany.
Muassasa 3: MCML — Munich Center for Machine Learning, Munich, Germany.
Manba turi: Taqrizlangan journal article.
Jurnal: Quantum.
Jild: 10.
Maqola/sahifa raqami: 1994.
Nashr sanasi: 3 fevral 2026.
Qabul sanasi: 23 yanvar 2026.
DOI: 10.22331/q-2026-02-03-1994.
Eprint: arXiv:2401.11576v6 [quant-ph], 25 yanvar 2026.
Nashriyot: Verein zur Förderung des Open Access Publizierens in den Quantenwissenschaften.
Muharrir: Jiangwei Shang.
Litsenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Ilmiy tadqiqot turi: Kvant mashinaviy o‘rganish / quantum architecture search usul tadqiqoti; graph representation learning, reinforcement learning, Bayesian optimization, shovqinsiz quantum simulation va cheklangan haqiqiy NISQ hardware evaluationni o‘z ichiga oladi.
Search space: Random generator bilan 100.000 circuit.
Operation pool: X, Y, Z, H, Rx, Ry, Rz, U3, CNOT, CZ, CY.
Circuit generator: 4 / 8 / 12 qubit; mos ravishda 10 / 20 / 30 gate; maximum depth 5.
Representation model: GIN-based variational graph autoencoder.
GIN layer: 5.
Latent dimension: 16.
Hidden dimension: 128.
Pretraining: 16 epoch; batch size 32; dropout 0,1; structure-only \(A,X\) input; performance label ishlatilmaydi.
Search algorithms: REINFORCE va DNGO asosidagi Bayesian Optimization.
Search budget: Har bir asosiy run uchun 1000 query.
Asosiy unumdorlik takrorlari: Figure 3 va Figure 4 uchun 50 independent run / random seed.
Ablation takrorlari: Table 6 uchun 10 random seed.
Haqiqiy kvant qurilmasi: IBM ibm_sherbrooke.
Haqiqiy hardware test qamrovi: Faqat tanlangan 4-node va 8-node MaxCut circuits.
Hardware shot soni: Har bir sharoit uchun 10.000.
Hardware parameter transfer: Parametrlar noise-free simulator ustida o‘qitilgan va haqiqiy qurilmaga re-tuning qilinmasdan ko‘chirilgan.
Hardware natijasi: Manba Table 4, 4-node va 8-node MaxCut uchun ham simulator, ham haqiqiy qurilmada %100,0 optimal-bitstring probability xabar qiladi; alohida confidence interval berilmagan.
Manba ichidagi Tenglama (10) izohi: Matn \(n=8\) TFIMni ta’riflagan holda qo‘shni indeksni \((i+1)\bmod6\) deb yozadi. Verianla formulani o‘zgartirmagan va bu nomuvofiqlikni ko‘rinadigan qoldirgan.
Manba ichidagi qo‘llanma nomi izohi: 8-qubit tajriba “quantum chemistry” tajriba guruhi ichida muhokama qilinsa-da, Appendix A.2da ishlatilgan fizik model molekula emas, TFIMdir. H₂ 4-qubit, LiH esa 12-qubit molecular misollardir.
Manba ichidagi metric-caption izohi: Table 1 caption “four metrics” desa, jadvalda beshta metric ustuni mavjud.
Moliyalashtirish: German Federal Ministry of Education and Research tomonidan Quantum Reinforcement Learning for Industrial Applications (QLindA), loyiha no. 13N15644; shuningdek Federal Ministry for Economic Affairs and Climate Action tomonidan Quantum-Classical Hybrid Optimization Algorithms for Logistics and Production Line Management (QCHALLenge), loyiha no. 01MQ22008B.
AI foydalanish bayonoti: Manbaning acknowledgments bo‘limi manuscriptning ayrim qismlari drafting va language refinement maqsadida OpenAI ChatGPT-4 yordami bilan yaratilganini va mazmun uchun javobgarlik mualliflarda ekanini bildiradi.
Ma’lumotlarning mavjudligi: Taqdim etilgan 20 sahifalik maqolada alohida “Data Availability” bo‘limi aniqlanmagan. Manbada bo‘lmagan repository yoki dataset manzili qo‘shilmagan.
Code availability: Taqdim etilgan PDFda alohida “Code Availability” bayonoti aniqlanmagan.
Manfaatlar to‘qnashuvi: Taqdim etilgan PDFda alohida competing-interest/conflict-of-interest bayonoti aniqlanmagan; shu sababli “manfaatlar to‘qnashuvi yo‘q” degan manbadan tashqari faraz qilinmagan.
Mualliflar hissasi: Taqdim etilgan PDFda alohida CRediT author-contribution bo‘limi aniqlanmagan; faqat Yize Sun va Zixin Wu teng hissa qo‘shgani aniq ko‘rsatilgan.
Asosiy talqin chegarasi: Tadqiqot efficient architecture search va selected-circuit hardware transfer bo‘yicha dalil beradi; fault tolerance, umumiy hardware robustness yoki quantum advantage ko‘rsatmaydi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan