


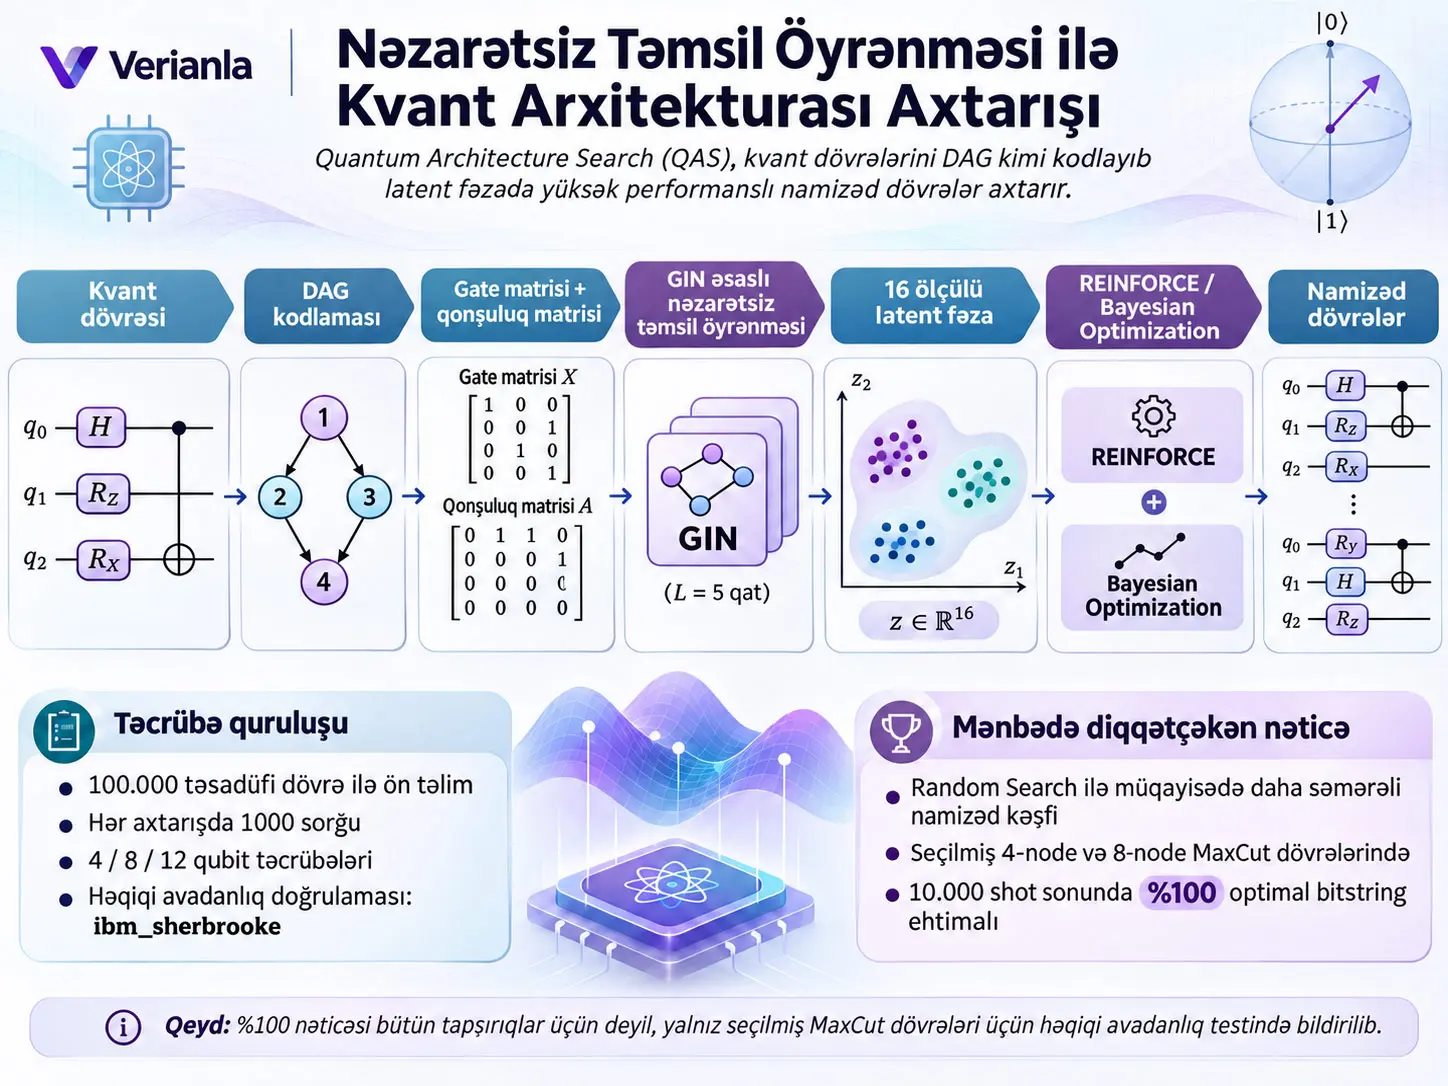
Nəzarətsiz təmsil öyrənməli Kvant Arxitektura Axtarışı (Quantum Architecture Search, QAS), parametrik kvant dövrələrinin strukturunu performans etiketi istifadə etmədən aşağıölçülü və fasiləsiz latent fəzada təmsil edən, daha sonra bu latent fəzanı REINFORCE və ya Bayesian Optimization ilə araşdıraraq yüksək performanslı namizəd dövrələr tapmağı hədəfləyən predictor-free kvant dövrəsi dizayn çərçivəsidir. Tədqiqatda kvant dövrəsi əvvəlcə yönlü dövrəsiz qraf (Directed Acyclic Graph, DAG) kimi kodlanır, gate növləri və qubit rolları ayrıca xüsusiyyətlərlə təmsil olunur, Graph Isomorphism Network (GIN) əsaslı variational graph autoencoder təsadüfi yaradılmış 100.000 dövrənin yalnız struktur məlumatından istifadə edərək 16 ölçülü latent təmsil öyrənir və sonra axtarış alqoritmləri bu fəzada namizəd arxitekturaları seçir.
Tədqiqatın əsas yeniliyi kvant dövrəsi strukturunun təmsilini performansa yönəlmiş axtarış prosesindən ayırmasıdır. Predictor-based QAS üsulları çoxlu sayda dövrənin əvvəlcədən qiymətləndirilməsini və həmin nəticələrlə ayrıca performans proqnozlaşdırıcısının öyrədilməsini tələb edə bilər. Bu tədqiqatda ilkin öyrətmə mərhələsində dövrə performansı, VQA enerjisi və ya fidelity etiketi istifadə olunmur. Lakin “predictor-free” ifadəsi “qiymətləndirməsiz” demək deyil: axtarış zamanı REINFORCE və ya Bayesian Optimization tərəfindən təklif olunan namizəd dövrələr reward hesablamaq üçün tapşırıq üzərində həqiqətən qiymətləndirilir.
Əsas axtarış təcrübələri quantum state preparation, MaxCut və mənbədə “quantum chemistry” başlığı altında təqdim olunan enerji-minimallaşdırma tapşırıqlarında 4 və 8 qubit səviyyəsində aparılmışdır. Hər təcrübədə axtarış fəzası 100.000 dövrədən ibarət olmuş, hər run yalnız 1000 search query istifadə etmiş və əsas performans müqayisələri 50 müstəqil random seed üzərində həyata keçirilmişdir. REINFORCE və Bayesian Optimization, xüsusilə 4-qubit təcrübələrdə Random Search ilə müqayisədə daha çox yüksək performanslı namizəd dövrə tapmışdır; lakin üsul bütün miqyaslarda və bütün metriklərdə rəqib təmsildən mütləq şəkildə üstün deyil. Məsələn, 12-qubit encoding müqayisələrinin bəziləri mövcud GSQAS encoding lehinə nəticələnir.
Həqiqi kvant avadanlığında doğrulama yalnız seçilmiş MaxCut nümunələri üzərində aparılmışdır. 4-node və 8-node MaxCut üçün axtarış nəticəsində tapılmış ən yaxşı dövrələrin parametrləri səs-küysüz simulatorda öyrədilmiş, sonra eyni parametrlər yenidən optimallaşdırma aparılmadan IBM-in ibm_sherbrooke NISQ cihazında işlədilmişdir. Mənbə hər problem üçün 10.000 shot sonunda %100,0 optimal bitstring ehtimalı bildirir. Bu nəticə seçilmiş iki MaxCut dövrəsinin ötürülməsini doğrulayır; bütün QAS tapşırıqlarının, bütün dövrələrin və ya bütün NISQ səs-küy şərtlərinin %100 uğurla həll edildiyini göstərmir.
Tədqiqat həmçinin mühüm miqyaslana bilmə sərhədi göstərir. 4-qubit latent təmsillər kompakt və performans baxımından daha nizamlı qruplaşdığı halda, 12-qubit fəzada 100.000 dövrəlik nümunə mümkün arxitekturaların çox daha kiçik hissəsini əhatə etdiyinə görə yüksək performanslı dövrələrin latent təşkili daha zəif olur. Buna görə üsul axtarış xərcini azaltmaq və böyük etiketli verilənlər dəsti tələbini aradan qaldırmaq baxımından üstünlük versə də, daha böyük kvant dövrələrinə miqyaslanma problemi həll olunmuş deyil.
Kvant Arxitektura Axtarışı (QAS) Nədir?
Kvant Arxitektura Axtarışı (Quantum Architecture Search, QAS), müəyyən kvant hesablama tapşırığı üçün hansı gate-lərin, hansı qubit-lər üzərində və hansı əlaqə/ardıcıllıq quruluşu ilə istifadə olunacağını avtomatik və ya yarı-avtomatik araşdıran dövrə-arxitekturası optimallaşdırma yanaşmasıdır; bu tədqiqatda QAS dövrələrin diskret kombinator fəzasını birbaşa skan etmək əvəzinə əvvəlcə öyrənilmiş fasiləsiz latent təmsil fəzasını araşdırır.
Kvant dövrəsi arxitekturası niyə vacibdir?
Variational Quantum Algorithm (VQA), parametrik kvant dövrəsini klassik optimizer ilə birlikdə istifadə edən hibrid kvant-klassik alqoritmlər ailəsidir. Parametrik kvant dövrəsi, Parameterized Quantum Circuit (PQC), müəyyən gate bucaqları və ya başqa gate parametrləri öyrədilə bilən kvant dövrəsidir.
VQA daxilində yalnız gate parametrlərinin qiyməti deyil, dövrənin arxitekturası da vacibdir. İki dövrə eyni qubit sayına malik olsa belə, gate növləri, gate ardıcıllığı, iki-qubit əlaqələri və circuit depth fərqli olduqda expressibility, entangling capability, optimallaşdırma davranışı və səs-küyə həssaslıq dəyişə bilər.
Buna görə iki ayrı optimallaşdırma problemi vardır:
- Parametr optimallaşdırması: Seçilmiş dövrənin \(R_x\), \(R_y\), \(R_z\), \(U3\) kimi parametrik gate bucaqlarını tənzimləmək.
- Arxitektura optimallaşdırması: Hansı gate-lərin, hansı ardıcıllıqla və hansı qubit əlaqələri ilə istifadə olunacağını seçmək.
QAS ikinci problemi hədəfləyir. Lakin arxitektura fəzası diskret və kombinator olduğuna görə mümkün dövrələrin sayı qubit və gate sayı ilə çox sürətlə arta bilər.
NISQ nə deməkdir?
Noisy Intermediate-Scale Quantum (NISQ), fault-tolerant quantum error correction-ın bütün hesablama boyu tam tətbiq edilə bilmədiyi, lakin müəyyən sayda fiziki qubit və gate ilə həqiqi kvant hesablamalarının aparıla bildiyi səs-küylü keçid dövrü kvant cihazlarını təsvir edir.
Bu tədqiqatın motivasiyasında NISQ vacibdir; çünki daha uzun, lazımsız gate-lər ehtiva edən və ya zəif strukturlaşdırılmış parametrik dövrələr ideal simulatorda işləsə belə, həqiqi cihazda decoherence və gate noise səbəbindən performans itirə bilər. Buna görə QAS-ın məqsədi yalnız riyazi baxımdan yüksək ifadə gücünə malik deyil, tapşırıq üçün effektiv dövrə strukturları da tapmaqdır.
Barren plateau nədir?
Barren plateau, müəyyən variational quantum circuit-lərdə optimallaşdırma landscape-inin böyük bölgələrində gradient qiymətlərinin çox kiçik olması problemidir. Gradient demək olar ki, sıfır olduqda klassik optimizer hansı parametr istiqamətində irəliləməli olduğunu müəyyən etməkdə çətinlik çəkə bilər.
Mənbə barren plateau-nu QAS motivasiyalarından biri kimi verir; lakin təklif olunan üsulun barren plateau problemini riyazi olaraq aradan qaldırdığını iddia etmir. Tədqiqatın birbaşa ölçdüyü şey dövrə arxitekturası axtarış performansıdır.
Kvant Dövrəsi Niyə Yönlü Dövrəsiz Qraf (DAG) Kimi Kodlanır?
Tədqiqat kvant dövrəsindəki hər gate-i qraf düyünü, eyni qubit üzərində zaman ardıcıllığına görə bir-birini izləyən gate asılılıqlarını isə yönlü kənarlar kimi təmsil edir; START və END düyünləri də əlavə edilərək dövrə yönlü dövrəsiz qraf formasına çevrilir və beləliklə GIN əsaslı graph representation learning dövrənin gate növünü, qubit mövqeyini və əlaqə topologiyasını birlikdə emal edə bilir.
DAG nədir?
Directed Acyclic Graph (DAG), kənarları yönlü olan, lakin başlanğıc nöqtəsinə geri qayıdan directed cycle ehtiva etməyən qrafdır. Kvant dövrəsində gate-lərin zaman ardıcıllığı təbii olaraq irəli istiqamətli dependency əlaqəsi yaratdığı üçün DAG təsviri uyğundur.
Mənbədə \(m\) gate növü, \(h\) gate və \(g\) qubit ehtiva edən bir dövrə:
qrafı ilə təmsil olunur. START və END daxil olmaqla düyün sayı:
olur.
Bu qraf üçün iki bir-birini tamamlayan matris yaradılır:
- Adjacency matrix \(A\): \(n\times n\) ölçülü struktur əlaqə matrisi.
- Gate matrix \(X\): \(n\times(m+2+g)\) ölçülü gate və qubit-rol xüsusiyyət matrisi.
\(A_{ij}=1\), node \(i\)-dən node \(j\)-yə directed edge olduğunu; \(A_{ij}=0\) isə belə əlaqə olmadığını göstərir.
Əvvəlki encoding yanaşmasında hansı məlumat itirdi?
Mənbənin müqayisə etdiyi əvvəlki EGSQAS encoding, iki-qubit gate daxilində control və target qubit rollarını kifayət qədər fərqləndirmirdi. Məsələn, CNOT gate-də control qubit ilə target qubit fiziki baxımdan eyni rola malik deyil; bu fərq itdiyi zaman iki fərqli dövrə struktur baxımından bir-birinə həddindən artıq oxşar təmsil oluna bilər.
Təklif olunan encoding bu problemi iki yolla həll edir:
- İki-qubit gate üçün control qubit müvafiq sətirdə −1, target qubit +1 ilə kodlanır.
- Adjacency matrix daxilindəki edge weight əməliyyatda iştirak edən qubit sayı ilə əlaqələndirilir; məsələn, iki-qubit gate üçün weight 2 istifadə olunur.
Beləliklə, model yalnız “hansı gate var?” məlumatını deyil, gate-in qubit sistemi daxilindəki əməliyyat rolunu da görür.
Nəzarətsiz Təmsil Öyrənmə Bu Tədqiqatda Nə Öyrənir?
Nəzarətsiz ilkin öyrətmə bir dövrənin MaxCut, state preparation və ya enerji-minimallaşdırma tapşırığında nə qədər yaxşı nəticə verdiyini öyrənmir; yalnız \(A\) adjacency matrix və \(X\) gate/qubit feature matrix-dən dövrələrin struktur xüsusiyyətlərini sıxılmış latent dəyişənlərə çevirməyi və bu struktur məlumatından dövrə qrafını yenidən qurmağı öyrənir.
Variational posterior: Tənlik (1)
\(Z\), latent representation çoxluğudur. \(z_i\), latent dəyişəndir; \(\mu_i\), bu dəyişənin Gaussian posterior mean-i; \(\sigma_i\), standard deviation parametridir. \(\operatorname{diag}(\sigma_i^2)\), diagonal covariance fərziyyəsini ifadə edir.
Bu tənlik kvant state wavefunction tənliyi deyil. \(Z\), klassik machine-learning modelinin öyrəndiyi latent dəyişəndir.
Reparameterization trick
Model latent dəyişəni:
şəklində nümunələyir. Bu yazılış təsadüfi nümunələmə əməliyyatını \(\mu_i\) və \(\sigma_i\) üzərindən differentiable öyrətmə axınına bağlamaq üçün istifadə olunur.
GIN message passing: Tənlik (2)
\(M^{(s)}\), GIN-in \(s\). message-passing layer-indəki node embedding matrisidir. Başlanğıc:
\(\hat A\) mənbədə:
kimi təyin olunur. Orijinal circuit graph directed olsa da GIN message passing zamanı adjacency symmetrize edilir; beləliklə, əlaqəli gate-lər arasında ikiistiqamətli feature aggregation aparıla bilər.
\((1+\epsilon^{(s)})M^{(s-1)}\) termini node-un öz əvvəlki təmsilini qoruyan öyrənilə bilən self-loop töhfəsidir. \(\hat A M^{(s-1)}\) qonşu gate məlumatını toplayır. \(\operatorname{MLP}^{(s)}\) isə toplanmış məlumatı nonlinear embedding-ə çevirir.
Tədqiqatda bütün əsas təcrübələrdə:
- GIN layer sayı \(L=5\),
- hidden dimension = 128,
- latent dimension = 16
istifadə edilmişdir.
Fusion layer nə edir?
Model yalnız son GIN layer çıxışına güvənmək əvəzinə müxtəlif GIN qatlarından gələn təmsilləri birləşdirən fusion layer istifadə edir. Məqsəd yalnız dərin qatda olan abstrakt təmsili deyil, daha erkən qatlardakı yerli gate/connectivity məlumatını da latent representation-a daşımaqdır.
Decoder hansı məlumatları yenidən qurur?
Decoder latent \(Z\)-dən həm adjacency matrix \(A\)-nı, həm də gate matrix:
strukturunu yenidən qurmağa çalışır. \(X^t\) gate type one-hot məlumatını, \(X^q\) isə gate-in hansı qubit-lər üzərində işlədiyini kodlayan mövqe məlumatını daşıyır.
Tənlik (3): Adjacency reconstruction
Bu factorization reconstructed graph daxilindəki edge məlumatını latent node cütlərindən yaratma modelidir.
Tənlik (4)
Mənbə bu ifadəni \(\operatorname{ReLU}_j\) notasiya ilə verir və \(\operatorname{ReLU}_j\) üçün ayrıca müstəqil ətraflı riyazi tərif təqdim etmir. Buna görə göstərim səssizcə başqa activation və ya probability function-a çevrilməmişdir. \(F_1\), mənbədə trainable linear function kimi göstərilir.
Tənlik (5)–(7): Gate matrix reconstruction
Softmax gate type kateqoriyasını, \(\tanh\) isə qubit-position encoding-in fasiləsiz çıxışını yaratmaq üçün istifadə olunur. Mənbə Tənlik (6) və (7)-də hər iki çıxış üçün də \(F_2\) simvolundan istifadə edir və sonra \(F_1\) ilə \(F_2\)-nin trainable linear functions olduğunu bildirir. Verianla bu notasiya əsasında fərziyyə ilə \(F_3\) kimi fərqli simvol yaratmamışdır.
ELBO: Tənlik (8)
Evidence Lower Bound (ELBO), variational autoencoder öyrətmə hədəfidir. Birinci termin latent representation-dan orijinal circuit structure-ın nə qədər yaxşı yenidən yaradıldığını mükafatlandırır. İkinci termin posterior \(q(Z\mid X,A)\) ilə prior \(p(Z)\) arasındakı Kullback–Leibler divergence-ı cəzalandırır.
Mənbə prior-u:
kimi seçir. Bu regularization latent fəzanın pərakəndə və kəsik lookup table əvəzinə daha nizamlı probabilistic representation halına gəlməsini təşviq edir.
Pretraining minibatch gradient descent ilə və batch size 32 istifadə edilərək aparılmışdır.
İlkin öyrətmə hiperparametrləri
| Parametr | Qiymət | Mənası |
|---|---|---|
| Qubit sayı | 4 / 8 / 12 | Təcrübə/təmsil miqyasları |
| Gate sayı | 10 / 20 / 30 | Müvafiq olaraq 4 / 8 / 12 qubit circuit generator parametri |
| Maximum circuit depth | 5 | Yaradılmış dövrə dərinliyinin yuxarı sərhədi |
| Circuit sayı | 100.000 | Randomly generated search / representation space |
| Batch size | 32 | Pretraining minibatch ölçüsü |
| Pretraining epoch | 16 | Autoencoder ilkin öyrətmə epoch sayı |
| Dropout | 0,1 | Decoder implicit regularization |
| Input normalization | True | Input normalization tətbiq olunur |
| Input dimension | 2 + #gates + #qubits | Gate/qubit xüsusiyyət ölçüsü |
| Hidden dimension | 128 | GIN hidden representation |
| Latent dimension | 16 | Öyrənilmiş fasiləsiz latent fəza |
| GIN layer | 5 | Message-passing depth |
| MLP layer | 2 | GIN daxilindəki MLP dərinliyi |
Operation pool
Random circuit generator aşağıdakı gate hovuzundan istifadə edir:
Bu hovuzun seçimi vacibdir. Search algorithm yalnız generator-un yarada bildiyi dövrələri tapa bilər. Operation pool daxilində müəyyən gate family-ləri yoxdursa, QAS sonradan bu çatışmayan arxitekturaları “ixtira” edə bilməz. Buna görə tədqiqatın nəticələri müəyyən edilmiş circuit search space kontekstində qiymətləndirilməlidir.
Pretraining performans metrikləri nəyi ölçür?
Mənbə beş ayrı metric istifadə edir:
- Accuracyops: gate type reconstruction dəqiqliyi.
- Accuracyqubit: gate-in hansı qubit-lər üzərində işlədiyinin yenidən qurulma dəqiqliyi.
- Accuracyadj: adjacency matrix reconstruction dəqiqliyi.
- Falposmean: reconstructed adjacency matrix-dəki mean false-positive miqdarı.
- KLD: latent representation-ın continuity/smoothness qiymətləndirilməsində istifadə olunan KL-divergence metriyi.
| Qubit | Encoding | Accuracy ops | Accuracy qubit | Accuracy adj | Falpos mean | KLD |
|---|---|---|---|---|---|---|
| 4 | GSQAS | 99,99 | 99,99 | 99,91 | 100,00 | 0,061 |
| 4 | Təklif olunan | 100 | 99,97 | 98,89 | 23,41 | 0,045 |
| 8 | GSQAS | 86,69 | 99,98 | 99,82 | 100,00 | 0,038 |
| 8 | Təklif olunan | 100 | 98,65 | 97,34 | 7,35 | 0,029 |
| 12 | GSQAS | 86,69 | 99,94 | 99,70 | 100,00 | 0,028 |
| 12 | Təklif olunan | 98,67 | 99,14 | 97,79 | 4,75 | 0,022 |
Bu cədvəli “təklif olunan encoding bütün reconstruction metric-lərində daha yaxşıdır” şəklində oxumaq düzgün deyil. Təklif olunan üsul gate-type accuracy, false-positive metriyi və KLD baxımından aydın üstünlüklər göstərsə də, Accuracyqubit və xüsusilə Accuracyadj qiymətləri bəzi hallarda GSQAS-dan daha aşağıdır. Mənbənin qiymətləndirməsi ümumi representation quality və downstream search behavior üzərindən aparılır.
Mənbə Table 1 caption-da “four metrics” ifadəsindən istifadə etsə də, görünən cədvəldə Accuracyops, Accuracyqubit, Accuracyadj, Falposmean və KLD olmaqla beş metric sütunu vardır. Verianla mənbədaxili bu ifadə fərqini gizlətmir.
PCA və t-SNE vizualları nəyi göstərir?
Mənbə Figure 2, 16-ölçülü latent representation-ı iki ölçüyə endirmək üçün Principal Component Analysis (PCA) və t-distributed Stochastic Neighbor Embedding (t-SNE) istifadə edir.
Bu vizuallardakı rənglər circuit-lərin əldə etdiyi energy və ya fidelity qiymətlərini göstərir; lakin bu performance qiymətləri autoencoder-ın unsupervised pretraining target-ı deyil. Yalnız təlimdən sonra latent space-in performans baxımından necə təşkil olunduğunu təhlil etmək üçün üzərinə əlavə edilmişdir.
4-qubit halda yüksək performanslı arxitekturalar daha nizamlı bölgələrdə qruplaşır. 12-qubit halda isə 100.000 circuit mümkün arxitektura fəzasının daha kiçik hissəsini təmsil etdiyinə görə bu nizam daha zəifdir. Mənbə bunu daha böyük axtarış fəzalarında representation-learning coverage sərhədi kimi şərh edir.
Predictor-Free Axtarış Nə Deməkdir?
Predictor-free axtarış candidate circuit performansını əvvəlcədən proqnozlaşdıran ayrıca supervised predictor öyrətməmək deməkdir; pretrained structural encoder sabitlənir, REINFORCE və ya Bayesian Optimization latent fəzadan namizəd seçir və namizəd dövrənin həqiqi tapşırıq evaluation-ı yalnız reward yaratmaq üçün istifadə olunur.
REINFORCE
Mənbə PPO və A2C ilə ilkin sınaqlar apardığını, lakin architecture search üçün REINFORCE üsulunu seçdiyini bildirir.
REINFORCE policy-gradient növlü reinforcement-learning alqoritmidir. Bu tədqiqatda:
- state space, pretrained architecture embeddings-dən ibarətdir;
- policy network birhüceyrəli LSTM istifadə edir;
- action, mövcud state distribution-dan nümunələnən latent vector seçiminə uyğun gəlir;
- candidate circuit tapşırıq üzərində qiymətləndirilir;
- əldə edilən fidelity və ya enerji nisbəti reward kimi policy update-ə daxil olur.
Enerji tapşırıqları üçün reward: Tənlik (9)
Mənbə MaxCut və enerji-minimallaşdırma tapşırıqlarında \(E_{\mathrm{ground}}<0\) olacaq convention istifadə edir. Bu convention daxilində namizəd enerji ground-state energy-yə çatdıqda:
olur. \(E_{\mathrm{candidate}}=0\) üçün reward 0-dır.
Erkən optimallaşdırma və ya numerical noise zamanı \(E_{\mathrm{candidate}}>0\) olarsa nisbət mənfi çıxa bilər. Mənbə bu halda reward-u 0-a clip edir.
Quantum state preparation üçün energy ratio istifadə edilmir; reward birbaşa fidelity-dir.
Adaptive baseline
REINFORCE variance-ını azaltmaq məqsədilə mənbə:
adaptive baseline istifadə edir. \(R_{\mathrm{avg}}\), əvvəlki reward average; \(\alpha\in[0,1]\) smoothing coefficient-dir. Mənbə əsas metod mətnində \(\alpha\)-nın spesifik numerical qiymətini vermir; buna görə qiymət təxmin edilməmişdir.
Hər run 1000 architecture search ehtiva edir.
Bayesian Optimization
İkinci search strategy, Deep Networks for Global Optimization (DNGO) əsaslı Bayesian Optimization-dır.
Mənbə BO regression modelində 128 hidden unit ehtiva edən tək hidden-layer feed-forward basis function istifadə edir. Acquisition function kimi Expected Improvement (EI) seçilir.
BO başlanğıcda 16 sample ilə işləyir. Hər epoch-da EI tərəfindən təklif olunan top-k architecture embedding-ləri batch-ə əlavə edilir və model yenilənmiş batch üzərində 100 epoch yenidən öyrədilir.
Buradakı “100 epoch”, autoencoder pretraining üçün verilən 16 epoch ilə eyni təlim deyil. Biri architecture representation pretraining, digəri BO search modelinin iteration daxilində yenidən öyrədilməsidir.
Tədqiqatın Metodu və Nəticələri
100.000 Dövrəlik Fəzada 1000 Axtarış Nə İfadə Edir?
Hər əsas QAS run-da üsul əvvəlcədən yaradılmış 100.000 dövrəlik search space-in yalnız 1000 namizədini, yəni təxminən yüzdə birini tapşırıq üzərində sorğulayır; buna görə təcrübənin məqsədi bütün dövrələri exhaustive şəkildə skan etmək deyil, latent representation-ın yüksək performanslı bölgələri Random Search ilə müqayisədə daha sıx nümunələyib-nümunələmədiyini yoxlamaqdır.
Əsas təcrübə tapşırıqları
Tədqiqat üç tətbiq ailəsindən istifadə edir:
- quantum state preparation,
- MaxCut,
- energy minimization / mənbə terminologiyası ilə quantum chemistry qrupu.
Əsas Figure 3 və Figure 4 təcrübələri 4 və 8 qubit səviyyəsində aparılmışdır. Representation-learning və encoding qiymətləndirmələrinin bəzi hissələrində 12-qubit circuits də istifadə olunur.
Quantum state preparation
Quantum state preparation tapşırığının məqsədi target quantum state-i mümkün qədər yüksək fidelity ilə yenidən yaratmaqdır.
Mənbə target state-i ona uyğun random circuit yaradaraq qurur və QAS üsulunu bu state üçün yüksək fidelity təmin edən candidate circuit-ləri axtarmaq üçün istifadə edir.
Fidelity 0 ilə 1 arasında reward kimi birbaşa istifadə edilə bildiyinə görə ayrıca energy normalization aparılmır.
MaxCut
MaxCut weighted undirected graph vertices-ını iki qrupa ayırarkən iki qrup arasındakı edge weight cəmini maksimumlaşdırma problemidir.
Tədqiqat graph-dan Hamiltonian törədir və VQE əsaslı enerji qiymətləndirməsindən istifadə edir.
Appendix A.2-də mənbə:
- 4-qubit / 4-node nümunə üçün ground-state energy = −10 Ha,
- 8-qubit / 8-node nümunə üçün ground-state energy = −52 Ha
ifadəsindən istifadə edir. “Ha” vahidi mənbədə bu şəkildə yazıldığı üçün qorunmuşdur; Verianla bu notasiyanı səssizcə başqa vahidə çevirmir.
Quantum chemistry və TFIM fərqi
Appendix A.2-də molekulyar nümunələr:
- 4-qubit H₂: təxminən optimal ground-state energy = −1,136 Ha,
- 12-qubit LiH: təxminən optimal ground-state energy = −7,88 Ha
kimi verilir.
Lakin 8-qubit nümunə molekul deyil. Mənbə \(n=8\) transverse-field Ising model (TFIM) istifadə etdiyini açıq şəkildə bildirir.
Mənbə Tənlik (10) — dəyişdirilmədən
\(\sigma_z^i\), \(i\). qubit üzərindəki Pauli-Z operatorunu; \(\sigma_x^i\), Pauli-X operatorunu təmsil edir. Birinci termin neighboring spin coupling-i, ikinci termin transverse-field töhfəsini ifadə edir.
Mənbədaxili mühüm uyğunsuzluq: Mətn modelin \(n=8\) olduğunu və cəmin \(i=0\) ilə 7 arasında olduğunu bildirdiyi halda qonşu indeksdə \((i+1)\bmod 6\) yazır. Bu ifadə source PDF-də məhz belədir. Verianla bunun typographical error olub-olmadığını mənbədən kənar fərziyyə ilə \(\bmod 8\)-ə çevirməmişdir.
Mənbə bu Hamiltonian üçün təxminən optimal energy-ni −10 Ha kimi istifadə edir.
Axtarış nəticələri necə müqayisə edildi?
Figure 3-də hər plot 50 müstəqil run-ın average reward-unu göstərir və hər run 1000 query ehtiva edir. Shaded bands standard deviation-ı göstərir.
Müəlliflərin müşahidəsinə görə REINFORCE və Bayesian Optimization latent representation daxilində search irəlilədikcə average reward-u xüsusilə erkən mərhələdə yüksəldir, Random Search isə oxşar improvement göstərmir. RL və BO-nun variance-ı Random Search-dən bir qədər yüksək olsa da average reward səviyyələri daha yüksəkdir.
Candidate threshold-ları
| Tapşırıq | 4-qubit threshold | 8-qubit threshold |
|---|---|---|
| State preparation | 0,95 | 0,75 |
| MaxCut | 0,95 | 0,925 |
| Energy / quantum-chemistry qrupu | 0,95 | 0,95 |
Buna görə 4-qubit və 8-qubit candidate count-larını yalnız saylara baxaraq birbaşa müqayisə etmək düzgün deyil; task complexity ilə yanaşı threshold qiymətləri də fərqlidir.
4-qubit axtarış səmərəliliyi
| Üsul | Task | Ümumi qiymətləndirmə | Tapılan namizəd \(N_{\mathrm{QAS}}\) | \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|---|---|
| GNN predictor + RL | Fidelity | 2000 | 36 | 0,0180 |
| GNN predictor + RL | MaxCut | 2000 | 783 | 0,3915 |
| GNN predictor + RL | QC-H₂ | 2000 | 278 | 0,1390 |
| GSQAS predictor + RL | Fidelity | 2000 | 37 | 0,0185 |
| GSQAS predictor + RL | MaxCut | 2000 | 785 | 0,3925 |
| GSQAS predictor + RL | QC-H₂ | 2000 | 658 | 0,3290 |
| Random Search | Fidelity | 1000 | 15 | 0,0150 |
| Random Search | MaxCut | 1000 | 568 | 0,5680 |
| Random Search | QC-H₂ | 1000 | 371 | 0,3710 |
| Təklif olunan QAS — REINFORCE | Fidelity | 1000 | 69 | 0,0690 |
| Təklif olunan QAS — REINFORCE | MaxCut | 1000 | 898 | 0,8980 |
| Təklif olunan QAS — REINFORCE | QC-H₂ | 1000 | 817 | 0,8170 |
| Təklif olunan QAS — BO | Fidelity | 1000 | 63 | 0,0630 |
| Təklif olunan QAS — BO | MaxCut | 1000 | 820 | 0,8200 |
| Təklif olunan QAS — BO | QC-H₂ | 1000 | 739 | 0,7390 |
Predictor-based üsulların \(N_{\mathrm{eval}}=2000\) qiyməti performans predictor-unu qurmaq üçün lazım olan labeled-circuit qiymətləndirmələri ilə search zamanı aparılan qiymətləndirmələrin cəmini ehtiva edir. Təklif olunan predictor-free üsulda ayrıca 1000 labeled pretraining circuit evaluation yoxdur; structural pretraining performance label tələb etmir və \(N_{\mathrm{eval}}=1000\) search evaluation istifadə olunur.
Bu cədvəl üsulun xüsusilə MaxCut və H₂ enerji tapşırığında yüksək-performing regions-ı daha sıx nümunələyə bildiyini göstərir. Lakin task-specific threshold-lar və search-space composition nəticələrin kontekstidir; qiymətlər universal QAS efficiency constant-ları deyil.
Encoding dəyişdikdə nəticə həmişə yaxşılaşırmı?
| Təcrübə | GSQAS encoding \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) | Təklif olunan encoding \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|
| GSQAS — 4 | 0,3125 | 0,3290 |
| GSQAS — 12 | 0,1415 | 0,1380 |
| QAS-RL — 4 | 0,7600 | 0,8170 |
| QAS-RL — 8 | 0,1600 | 0,1670 |
| QAS-RL — 12 | 0,4220 | 0,3920 |
Bu nəticə mühüm şərh sərhədi yaradır. Yeni encoding 4 və 8-qubit nümunələrin çoxunda üstünlük versə də, 12-qubit iki müqayisədə GSQAS encoding-dən geri qalır. Mənbə də 12-qubit search space-in 100.000 circuit ilə kifayət qədər təmsil olunmamasını mümkün səbəb kimi müzakirə edir.
Latent dimension və GIN depth ablasyonu
| Latent \(d_z\) | GIN depth \(L\) | VAE loss | Average reward RL | Average reward BO |
|---|---|---|---|---|
| 8 | 5 | 0,11 | 0,95 ± 0,001 | 0,89 ± 0,030 |
| 16 | 5 | 0,09 | 0,98 ± 0,006 | 0,93 ± 0,013 |
| 32 | 5 | 0,14 | 0,975 ± 0,009 | 0,92 ± 0,017 |
| 16 | 3 | 0,10 | 0,95 ± 0,013 | 0,93 ± 0,021 |
| 16 | 7 | 0,09 | 0,97 ± 0,010 | 0,92 ± 0,022 |
Ablation nəticələri 10 random seed üzrə mean ± standard deviation kimi verilmişdir. VAE reconstruction objective hyperparameter-lara həssas olsa da downstream QAS reward daha məhdud dəyişir. Mənbənin default seçimi \(d_z=16\), \(L=5\)-dir.
IBM ibm_sherbrooke Üzərindəki %100 Nəticə Nə Deməkdir?
Mənbənin %100 nəticəsi QAS ilə seçilmiş yalnız iki MaxCut dövrəsinin — 4-node və 8-node problem — simulatorda öyrədilmiş parametrləri dəyişdirilmədən ibm_sherbrooke üzərində 10.000 shot olmaqla işlədildikdə bütün ölçmələrdə optimal bitstring bildirilməsini ifadə edir; bu nəticə state-preparation və ya chemistry/TFIM tapşırıqlarının həqiqi avadanlıqda eyni uğura çatdığını və ya üsulun ümumi quantum advantage təmin etdiyini göstərmir.
Həqiqi avadanlıq test protokolu
- QAS ilə 4-node və 8-node MaxCut üçün ən yaxşı-performing circuit seçildi.
- Bu dövrələrin trainable parametrləri noise-free simulator üzərində optimallaşdırıldı.
- Eyni parameter set həqiqi ibm_sherbrooke cihazına ötürüldü.
- Mənbə heç bir hardware-specific parameter re-tuning aparılmadığını bildirir.
- Hər şərt 10.000 measurement shot ilə işlədildi.
| Metrik | 4-node simulator | 4-node həqiqi cihaz | 8-node simulator | 8-node həqiqi cihaz |
|---|---|---|---|---|
| Optimal bitstring ehtimalı | %100,0 | %100,0 | %100,0 | %100,0 |
| Average cut value | 4 | 4 | 12 | 12 |
| Shot | 10.000 | 10.000 | 10.000 | 10.000 |
| Noise model | Noise-free | Physical NISQ | Noise-free | Physical NISQ |
| Device | Simulator | ibm_sherbrooke | Simulator | ibm_sherbrooke |
Mənbə ayrıca confidence interval bildirmir. Buna görə Verianla “həqiqi uğur ehtimalı dəqiq olaraq 1,000000-dır” kimi statistik ümumiləşdirmə etmir; yalnız mənbə Table 4-də 10.000 repeated shot üçün müşahidə olunan və %100,0 kimi bildirilən nəticəni çatdırır.
Bu nəticə quantum advantage-dırmı?
Xeyr. Tədqiqatın araşdırma sualı classical computer-ı quantum computer-a qarşı sürət və ya complexity baxımından məğlub etmək deyil. Axtarış framework-ü əsasən klassik machine learning və səs-küysüz quantum simulation istifadə edir; həqiqi hardware təcrübəsi isə seçilmiş candidate circuit-lərin ötürülə bilməsini yoxlayır.
Beləliklə, tədqiqatın dəstəklədiyi ifadə “tapılan iki MaxCut circuit həqiqi NISQ cihazına parametr re-tuning olmadan uğurla ötürülmüşdür”dür. “QAS classical computing-i üstələmişdir” və ya “quantum advantage göstərilmişdir” nəticəsi mənbə tərəfindən yoxlanılmamışdır.
Tədqiqatın güclü tərəfləri
- Architecture representation learning ilə task-specific search bir-birindən ayrılmışdır.
- Pretraining performance labels və ya VQA evaluations tələb etmir.
- Control/target rolu və multi-qubit edge importance əvvəlki encoding ilə müqayisədə daha açıq təmsil olunur.
- Eyni pretrained representation müxtəlif downstream tasks üçün istifadə oluna bilər.
- REINFORCE və BO eyni latent space üzərində tətbiq oluna bilir.
- Search performansı yalnız bir tətbiqdə deyil, state preparation, MaxCut və energy-based tapşırıqlarda qiymətləndirilmişdir.
- Əsas search curves 50 independent run üzərindən qiymətləndirilmişdir.
- Latent dimension və GIN depth üçün ayrıca ablation aparılmışdır.
- Ən yaxşı MaxCut circuit-lər həqiqi IBM hardware üzərində birbaşa sınaqdan keçirilmişdir.
Tədqiqatın məhdudiyyətləri
Search-space coverage: 100.000 circuit 4-qubit problemdə zəngin nümunələmə təmin edə bilsə də, 12-qubit bütün possible architecture space-in çox kiçik hissəsini əhatə edə bilər. Mənbə 12-qubit latent representation-dakı daha zəif clustering-i bu məhdudiyyətlə əlaqələndirir.
Operation-pool asılılığı: Model yalnız başlanğıc circuit generator-un icazə verdiyi gate seti və structural constraints daxilində axtarış aparır.
Hardware validation əhatəsi: Həqiqi hardware yalnız 4-node və 8-node MaxCut best circuits üçün istifadə olunmuşdur; state preparation və enerji tapşırıqları üçün eyni real-device validation bildirilməmişdir.
Seçilmiş dövrə doğrulaması: Hardware test bütün candidate distribution-u deyil, search tərəfindən seçilmiş ən yaxşı dövrələri sınayır.
Noise-model ümumiləşdirilməsi: Search əsas təcrübələri noise-free simulator üzərində aparılmışdır. QAS objective birbaşa hardware noise-aware search kimi optimallaşdırılmamışdır.
Scalability: 12-qubit nəticələri representation coverage və downstream search performansında geriləmə ola biləcəyini göstərir. Buna görə üsul daha böyük dövrələrdə avtomatik olaraq eyni efficiency-ni təmin etmir.
Predictor-free ≠ evaluation-free: Ayrı predictor və labeled pretraining tələb olunmasa da reward üçün candidate VQA evaluation lazımdır; bahalı tapşırıq qiymətləndirilməsi tamamilə aradan qalxmır.
Tədqiqatın dəstəklədiyi nəticələr
Mənbə circuit structure-ı nəzarətsiz şəkildə öyrənilmiş latent representation-a çevirməyin QAS üçün faydalı ola biləcəyini və REINFORCE/BO-nun bu latent space daxilində Random Search-dən daha səmərəli yüksək-performing candidate discovery təmin edə bildiyini dəstəkləyir.
Təklif olunan encoding control-target role və interaction weight kimi circuit-specific məlumatları daha açıq təmsil edir və bir çox metric ilə downstream search condition-da üstünlük verir.
4-qubit nümunələrdə latent representation-ın performance structure ilə nizamlı şəkildə qruplaşa bildiyi göstərilir; performance label bu representation-ın training target-ı deyil.
Seçilmiş 4-node və 8-node MaxCut circuits-in simulator-trained parameters ilə ibm_sherbrooke üzərində yenidən tuning aparılmadan mənbədə bildirilən optimal output-u qoruduğu göstərilir.
Tədqiqatın dəstəkləmədiyi nəticələr
Tədqiqat bütün kvant circuit architecture search problemlərində yeni encoding-in ən yaxşı olduğunu sübut etmir. 12-qubit müqayisələrində bəzi nəticələr köhnə encoding lehinədir.
Tədqiqat predictor-free yanaşmanın quantum circuit evaluation ehtiyacını tamamilə aradan qaldırdığını göstərmir.
Tədqiqat tapılan bütün dövrələrin həqiqi hardware noise-a davamlı olduğunu göstərmir.
Tədqiqat state preparation, H₂, LiH və ya TFIM tapşırıqlarını ibm_sherbrooke üzərində eyni hardware test protokolu ilə doğrulamır.
Tədqiqat fault-tolerant quantum computing nümayiş etdirmir; istifadə olunan həqiqi cihaz NISQ cihazıdır.
Tədqiqat quantum computational advantage və ya classical speedup sübut etmir.
Tədqiqat 100.000 dövrəlik nümunənin 12-qubit və ya daha böyük circuit spaces-i tam təmsil etdiyini göstərmir.
Mənbə və Metod Qeydi
Orijinal başlıq: Quantum Architecture Search with Unsupervised Representation Learning
Müəlliflər: Yize Sun, Zixin Wu, Volker Tresp, Yunpu Ma.
Bərabər töhfə: Yize Sun və Zixin Wu.
Əlaqə müəllifi: Yunpu Ma.
Mənbədə verilən əlaqə e-poçtu: cognitive.yunpu@gmail.com
Qurum 1: Ludwig-Maximilians-University Munich, Munich, Germany.
Qurum 2: Siemens AG, Munich, Germany.
Qurum 3: MCML — Munich Center for Machine Learning, Munich, Germany.
Mənbə növü: Resenziyalı journal article.
Jurnal: Quantum.
Cild: 10.
Məqalə/səhifə nömrəsi: 1994.
Nəşr tarixi: 3 fevral 2026.
Qəbul tarixi: 23 yanvar 2026.
DOI: 10.22331/q-2026-02-03-1994.
Eprint: arXiv:2401.11576v6 [quant-ph], 25 yanvar 2026.
Nəşriyyat: Verein zur Förderung des Open Access Publizierens in den Quantenwissenschaften.
Redaktor: Jiangwei Shang.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Elmi tədqiqat növü: Kvant maşın öyrənməsi / quantum architecture search metod tədqiqatı; graph representation learning, reinforcement learning, Bayesian optimization, səs-küysüz quantum simulation və məhdud həqiqi NISQ hardware evaluation ehtiva edir.
Search space: Random generator ilə 100.000 circuit.
Operation pool: X, Y, Z, H, Rx, Ry, Rz, U3, CNOT, CZ, CY.
Circuit generator: 4 / 8 / 12 qubit; müvafiq olaraq 10 / 20 / 30 gate; maximum depth 5.
Representation model: GIN-based variational graph autoencoder.
GIN layer: 5.
Latent dimension: 16.
Hidden dimension: 128.
Pretraining: 16 epoch; batch size 32; dropout 0,1; structure-only \(A,X\) input; performance label istifadə olunmur.
Search algorithms: REINFORCE və DNGO əsaslı Bayesian Optimization.
Search budget: Hər əsas run üçün 1000 query.
Əsas performans təkrarları: Figure 3 və Figure 4 üçün 50 independent run / random seed.
Ablation təkrarları: Table 6 üçün 10 random seed.
Həqiqi kvant cihazı: IBM ibm_sherbrooke.
Həqiqi hardware test əhatəsi: Yalnız seçilmiş 4-node və 8-node MaxCut circuits.
Hardware shot sayı: Hər şərt üçün 10.000.
Hardware parameter transfer: Parametrlər noise-free simulator üzərində öyrədilmiş və həqiqi cihaza re-tuning aparılmadan ötürülmüşdür.
Hardware nəticəsi: Mənbə Table 4, 4-node və 8-node MaxCut üçün həm simulator, həm də həqiqi cihazda %100,0 optimal-bitstring probability bildirir; ayrıca confidence interval verilməmişdir.
Mənbədaxili Tənlik (10) qeydi: Mətn \(n=8\) TFIM təsvir etdiyi halda qonşu indeksi \((i+1)\bmod6\) kimi yazır. Verianla formulu dəyişdirməmiş və bu uyğunsuzluğu görünən saxlamışdır.
Mənbədaxili tətbiq adı qeydi: 8-qubit təcrübə “quantum chemistry” təcrübə qrupu daxilində müzakirə olunsa da Appendix A.2-də istifadə olunan fiziki model molekul deyil, TFIM-dir. H₂ 4-qubit, LiH isə 12-qubit molecular nümunələrdir.
Mənbədaxili metric-caption qeydi: Table 1 caption “four metrics” dediyi halda cədvəldə beş metric sütunu vardır.
Maliyyələşdirmə: German Federal Ministry of Education and Research tərəfindən Quantum Reinforcement Learning for Industrial Applications (QLindA), layihə no. 13N15644; həmçinin Federal Ministry for Economic Affairs and Climate Action tərəfindən Quantum-Classical Hybrid Optimization Algorithms for Logistics and Production Line Management (QCHALLenge), layihə no. 01MQ22008B.
AI istifadə bəyanatı: Mənbənin acknowledgments bölməsi manuscript-in bəzi hissələrinin drafting və language refinement məqsədilə OpenAI ChatGPT-4 dəstəyi ilə hazırlandığını və məzmunun məsuliyyətini müəlliflərin daşıdığını bildirir.
Verilənlərin əlçatanlığı: Təqdim edilmiş 20 səhifəlik məqalədə ayrıca “Data Availability” bölməsi müəyyən edilməmişdir. Mənbədə olmayan repository və ya dataset ünvanı əlavə edilməmişdir.
Code availability: Təqdim edilmiş PDF-də ayrıca “Code Availability” bəyanatı müəyyən edilməmişdir.
Maraqların toqquşması: Təqdim edilmiş PDF-də ayrıca competing-interest/conflict-of-interest bəyanatı müəyyən edilməmişdir; buna görə “maraqların toqquşması yoxdur” şəklində mənbədənkənar fərziyyə irəli sürülməmişdir.
Müəllif töhfələri: Təqdim edilmiş PDF-də ayrıca CRediT author-contribution bölməsi müəyyən edilməmişdir; yalnız Yize Sun və Zixin Wu-nun bərabər töhfə verdiyi açıq şəkildə bildirilmişdir.
Əsas şərh sərhədi: Tədqiqat efficient architecture search və selected-circuit hardware transfer barədə dəlil təqdim edir; fault tolerance, ümumi hardware robustness və ya quantum advantage göstərmir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib