


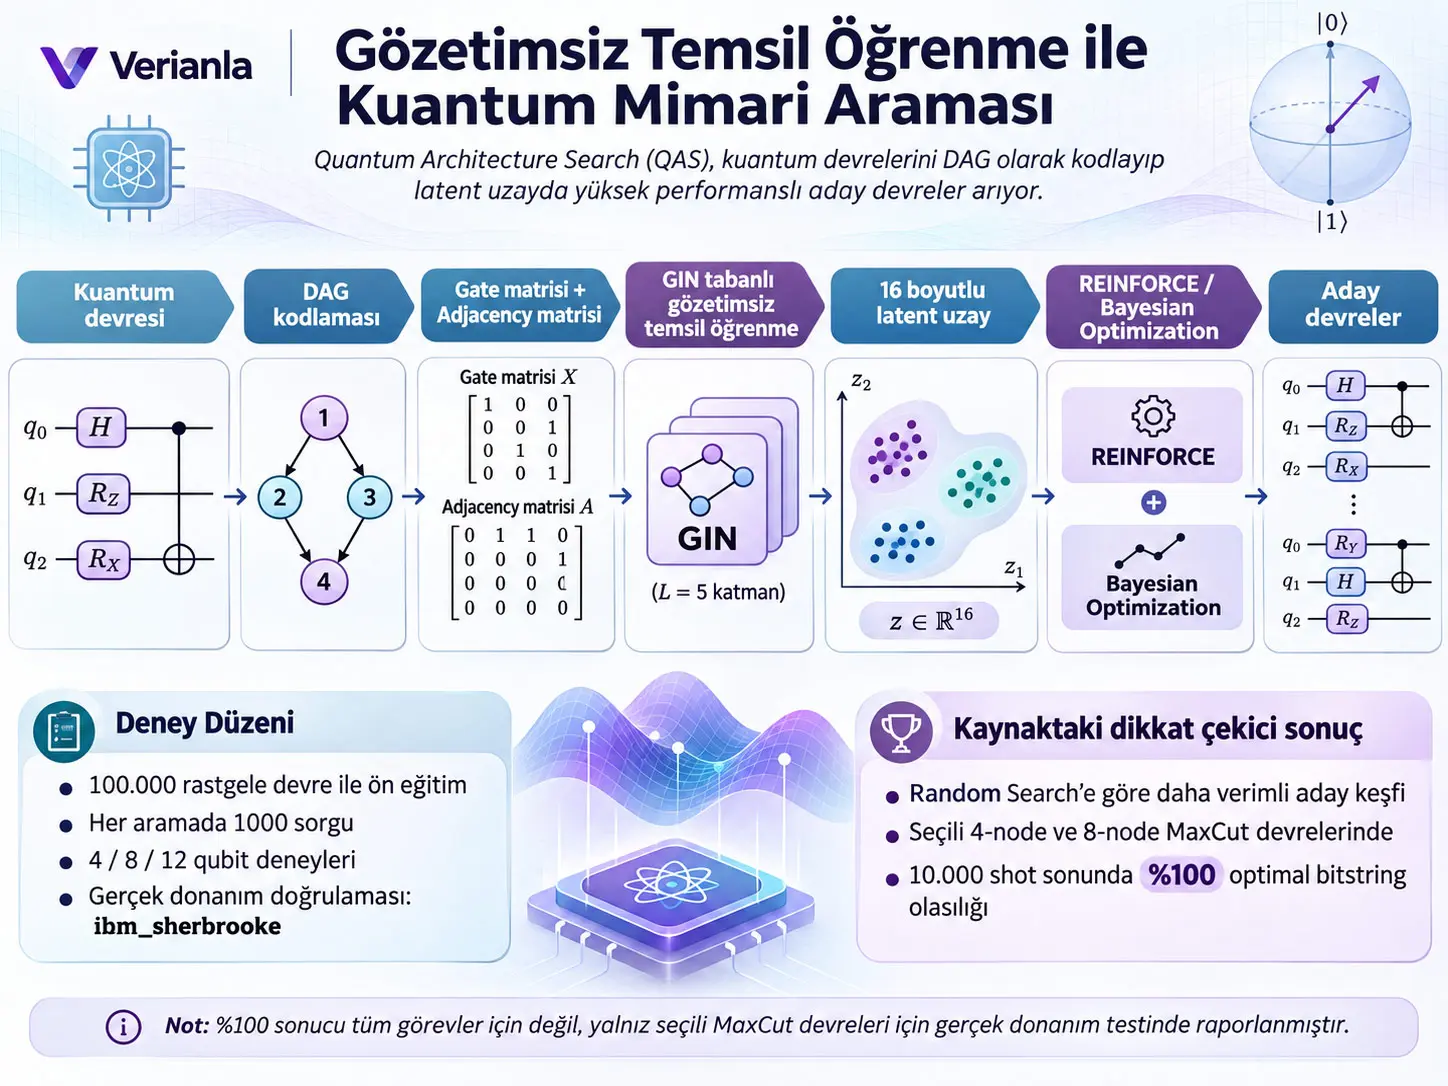
Gözetimsiz temsil öğrenmeli Kuantum Mimari Araması (Quantum Architecture Search, QAS), parametrik kuantum devrelerinin yapısını performans etiketi kullanmadan düşük boyutlu ve sürekli bir latent uzayda temsil eden, ardından bu latent uzayı REINFORCE veya Bayesian Optimization ile araştırarak yüksek performanslı aday devreler bulmayı amaçlayan predictor-free bir kuantum devre tasarım çerçevesidir. Çalışmada kuantum devresi önce yönlü çevrimsiz graf (Directed Acyclic Graph, DAG) olarak kodlanmakta, gate türleri ve qubit rolleri ayrı özelliklerle temsil edilmekte, Graph Isomorphism Network (GIN) tabanlı bir variational graph autoencoder 100.000 rastgele üretilmiş devrenin yalnız yapısal bilgisini kullanarak 16 boyutlu latent temsil öğrenmekte ve daha sonra arama algoritmaları bu uzayda aday mimarileri seçmektedir.
Çalışmanın temel yeniliği, kuantum devre yapısının temsilini performans odaklı arama işleminden ayırmasıdır. Predictor-based QAS yöntemleri çok sayıda devrenin önceden değerlendirilmesini ve bu sonuçlarla ayrı bir performans tahmincisinin eğitilmesini gerektirebilir. Bu çalışmada ön eğitim aşamasında devre performansı, VQA enerjisi veya fidelity etiketi kullanılmaz. Ancak “predictor-free” ifadesi “değerlendirmesiz” anlamına gelmez: arama sırasında REINFORCE veya Bayesian Optimization tarafından önerilen aday devreler reward hesaplamak için görev üzerinde gerçekten değerlendirilir.
Ana arama deneyleri quantum state preparation, MaxCut ve kaynakta “quantum chemistry” başlığı altında sunulan enerji-minimizasyon görevlerinde 4 ve 8 qubit düzeyinde yapılmıştır. Her deneyde arama uzayı 100.000 devreden oluşmuş, her run yalnız 1000 search query kullanmış ve ana performans karşılaştırmaları 50 bağımsız random seed üzerinden gerçekleştirilmiştir. REINFORCE ve Bayesian Optimization, özellikle 4-qubit deneylerde Random Search'e göre daha fazla yüksek performanslı aday devre bulmuş; ancak yöntem bütün ölçek ve bütün metriklerde rakip temsilden mutlak olarak üstün değildir. Örneğin 12-qubit encoding karşılaştırmalarının bazıları mevcut GSQAS encoding lehine sonuç vermektedir.
Gerçek kuantum donanımı doğrulaması yalnız seçilmiş MaxCut örnekleri üzerinde yapılmıştır. 4-node ve 8-node MaxCut için arama sonucunda bulunan en iyi devrelerin parametreleri gürültüsüz simülatörde eğitilmiş, daha sonra aynı parametreler yeniden optimizasyon yapılmadan IBM'in ibm_sherbrooke NISQ cihazında çalıştırılmıştır. Kaynak her problem için 10.000 shot sonunda %100,0 optimal bitstring olasılığı raporlamaktadır. Bu sonuç iki seçilmiş MaxCut devresinin aktarımını doğrular; bütün QAS görevlerinin, bütün devrelerin veya bütün NISQ gürültü koşullarının %100 başarıyla çözüldüğünü göstermez.
Çalışma ayrıca önemli bir ölçeklenebilirlik sınırı göstermektedir. 4-qubit latent temsiller kompakt ve performans açısından daha düzenli kümelenirken, 12-qubit uzayda 100.000 devrelik örneklem olası mimarilerin çok daha küçük bir bölümünü kapsadığı için yüksek performanslı devrelerin latent organizasyonu daha zayıf hâle gelmektedir. Dolayısıyla yöntem, arama maliyetini azaltma ve büyük etiketli veri seti gereksinimini kaldırma yönünde avantaj sağlasa da daha büyük kuantum devrelerine ölçekleme problemi çözülmüş değildir.
Kuantum Mimari Araması (QAS) Nedir?
Kuantum Mimari Araması (Quantum Architecture Search, QAS), belirli bir kuantum hesaplama görevi için hangi gate'lerin, hangi qubit'ler üzerinde ve hangi bağlantı/sıralama yapısıyla kullanılacağını otomatik veya yarı otomatik olarak araştıran bir devre-mimarisi optimizasyon yaklaşımıdır; bu çalışmada QAS, doğrudan devrelerin ayrık kombinatoryal uzayını taramak yerine önce öğrenilmiş sürekli latent temsil uzayını araştırır.
Neden kuantum devre mimarisi önemlidir?
Variational Quantum Algorithm (VQA), parametrik kuantum devresini klasik bir optimizer ile birlikte kullanan hibrit kuantum-klasik algoritma ailesidir. Parametrik kuantum devresi, Parameterized Quantum Circuit (PQC), belirli gate açıları veya başka gate parametreleri eğitilebilir olan kuantum devresidir.
VQA içinde yalnız gate parametrelerinin değeri değil, devrenin mimarisi de önemlidir. İki devre aynı qubit sayısına sahip olsa bile gate türleri, gate sırası, iki-qubit bağlantıları ve circuit depth farklı olduğunda expressibility, entangling capability, optimizasyon davranışı ve gürültüye duyarlılık değişebilir.
Bu nedenle iki ayrı optimizasyon problemi vardır:
- Parametre optimizasyonu: Seçilmiş devrenin \(R_x\), \(R_y\), \(R_z\), \(U3\) gibi parametrik gate açılarını ayarlamak.
- Mimari optimizasyon: Hangi gate'lerin, hangi sırada ve hangi qubit bağlantılarıyla kullanılacağını seçmek.
QAS ikinci problemi hedefler. Ancak mimari uzay ayrık ve kombinatoryal olduğu için olası devre sayısı qubit ve gate sayısıyla çok hızlı büyüyebilir.
NISQ ne demektir?
Noisy Intermediate-Scale Quantum (NISQ), fault-tolerant quantum error correction'ın bütün hesap boyunca tam olarak uygulanamadığı, fakat belirli sayıda fiziksel qubit ve gate ile gerçek kuantum hesaplarının yapılabildiği gürültülü ara dönem kuantum cihazlarını tanımlar.
Bu çalışmanın motivasyonunda NISQ önemlidir; çünkü daha uzun, gereksiz gate içeren veya kötü yapılandırılmış parametrik devreler ideal simülatörde çalışsa bile gerçek cihazda decoherence ve gate noise nedeniyle performans kaybedebilir. QAS'ın amacı bu nedenle yalnız matematiksel olarak ifade gücü yüksek değil, görev için etkili devre yapıları da bulmaktır.
Barren plateau nedir?
Barren plateau, belirli variational quantum circuit'lerde optimizasyon landscape'inin büyük bölgelerinde gradient değerlerinin çok küçük hâle gelmesi problemidir. Gradient neredeyse sıfır olduğunda klasik optimizer hangi parametre yönünde ilerlemesi gerektiğini belirlemekte zorlanabilir.
Kaynak barren plateau'yu QAS motivasyonlarından biri olarak verir; fakat önerilen yöntemin barren plateau problemini matematiksel olarak ortadan kaldırdığını iddia etmez. Çalışmanın doğrudan ölçtüğü şey devre mimarisi arama performansıdır.
Kuantum Devresi Neden Yönlü Çevrimsiz Grafik (DAG) Olarak Kodlanıyor?
Çalışma kuantum devresindeki her gate'i bir graf düğümü, aynı qubit üzerinde zaman sırasına göre birbirini izleyen gate bağımlılıklarını yönlü kenarlar olarak temsil eder; START ve END düğümleri de eklenerek devre yönlü çevrimsiz graf biçimine dönüştürülür ve böylece GIN tabanlı graph representation learning devrenin gate türünü, qubit konumunu ve bağlantı topolojisini birlikte işleyebilir.
DAG nedir?
Directed Acyclic Graph (DAG), kenarları yönlü olan fakat başlangıç noktasına geri dönen directed cycle içermeyen graftır. Kuantum devresinde gate'lerin zaman sıralaması doğal olarak ileri yönlü bir dependency ilişkisi oluşturduğu için DAG gösterimi uygundur.
Kaynakta \(m\) gate türü, \(h\) gate ve \(g\) qubit içeren bir devre:
grafıyla temsil edilir. START ve END dahil düğüm sayısı:
olur.
Bu graf için iki tamamlayıcı matris oluşturulur:
- Adjacency matrix \(A\): \(n\times n\) boyutlu yapısal bağlantı matrisi.
- Gate matrix \(X\): \(n\times(m+2+g)\) boyutlu gate ve qubit-rol özellik matrisi.
\(A_{ij}=1\), node \(i\)'den node \(j\)'ye directed edge bulunduğunu; \(A_{ij}=0\) böyle bir bağlantı bulunmadığını belirtir.
Eski encoding yaklaşımında hangi bilgi kayboluyordu?
Kaynağın karşılaştırdığı önceki EGSQAS encoding, iki-qubit gate içindeki control ve target qubit rollerini yeterince ayırmıyordu. Örneğin CNOT gate'inde control qubit ile target qubit fiziksel olarak aynı role sahip değildir; bu ayrım kaybolduğunda iki farklı devre yapısal olarak birbirine fazla benzer temsil edilebilir.
Önerilen encoding bu sorunu iki şekilde ele alır:
- İki-qubit gate için control qubit ilgili satırda −1, target qubit +1 ile kodlanır.
- Adjacency matrix içindeki edge weight, operasyona katılan qubit sayısıyla ilişkilendirilir; örneğin iki-qubit gate için weight 2 kullanılır.
Böylece model yalnız “hangi gate var?” bilgisini değil, gate'in qubit sistemi içindeki operasyonel rolünü de görür.
Gözetimsiz Temsil Öğrenme Bu Çalışmada Ne Öğreniyor?
Gözetimsiz ön eğitim, bir devrenin MaxCut, state preparation veya enerji-minimizasyon görevinde ne kadar iyi sonuç verdiğini öğrenmez; yalnız \(A\) adjacency matrix ile \(X\) gate/qubit feature matrix'ten devrelerin yapısal özelliklerini sıkıştırılmış latent değişkenlere dönüştürmeyi ve bu yapısal bilgiden devre grafını yeniden kurmayı öğrenir.
Variational posterior: Denklem (1)
\(Z\), latent representation kümesidir. \(z_i\), bir latent değişken; \(\mu_i\), bu değişkenin Gaussian posterior mean'i; \(\sigma_i\), standard deviation parametresidir. \(\operatorname{diag}(\sigma_i^2)\), diagonal covariance varsayımını ifade eder.
Bu denklem bir kuantum state wavefunction denklemi değildir. \(Z\), klasik machine-learning modelinin öğrendiği latent değişkendir.
Reparameterization trick
Model latent değişkeni:
biçiminde örnekler. Bu yazım rastgele örnekleme işlemini \(\mu_i\) ve \(\sigma_i\) üzerinden differentiable eğitim akışına bağlamak için kullanılır.
GIN message passing: Denklem (2)
\(M^{(s)}\), GIN'in \(s\). message-passing layer'ındaki node embedding matrisidir. Başlangıç:
\(\hat A\) kaynakta:
olarak tanımlanır. Orijinal circuit graph directed olsa da GIN message passing sırasında adjacency symmetrize edilir; böylece bağlantılı gate'ler arasında iki yönlü feature aggregation yapılabilir.
\((1+\epsilon^{(s)})M^{(s-1)}\) terimi node'un kendi önceki temsilini koruyan öğrenilebilir self-loop katkısıdır. \(\hat A M^{(s-1)}\) komşu gate bilgilerini toplar. \(\operatorname{MLP}^{(s)}\) ise toplanan bilgiyi nonlinear embedding'e dönüştürür.
Çalışmada bütün temel deneylerde:
- GIN layer sayısı \(L=5\),
- hidden dimension = 128,
- latent dimension = 16
kullanılmıştır.
Fusion layer ne işe yarıyor?
Model yalnız son GIN layer çıktısına güvenmek yerine farklı GIN katmanlarından gelen temsilleri birleştiren fusion layer kullanır. Amaç yalnız derin katmandaki soyut temsilin değil, daha erken katmanlardaki yerel gate/connectivity bilgisinin de latent representation'a taşınmasıdır.
Decoder hangi bilgileri yeniden oluşturuyor?
Decoder latent \(Z\)'den hem adjacency matrix \(A\)'yı hem de gate matrix:
yapısını yeniden oluşturmaya çalışır. \(X^t\) gate type one-hot bilgisini, \(X^q\) gate'in hangi qubit'ler üzerinde çalıştığını kodlayan pozisyon bilgisini taşır.
Denklem (3): Adjacency reconstruction
Bu factorization, reconstructed graph içindeki edge bilgilerini latent node çiftlerinden üretme modelidir.
Denklem (4)
Kaynak bu ifadeyi \(\operatorname{ReLU}_j\) notasyonuyla vermektedir ve \(\operatorname{ReLU}_j\) için ayrıca bağımsız ayrıntılı matematiksel tanım sağlamamaktadır. Bu nedenle gösterim sessizce başka bir activation veya probability function'a dönüştürülmemiştir. \(F_1\), kaynakta trainable linear function olarak belirtilir.
Denklem (5)–(7): Gate matrix reconstruction
Softmax gate type kategorisini, \(\tanh\) ise qubit-position encoding'in sürekli çıktısını üretmek için kullanılır. Kaynak Denklem (6) ve (7)'de iki çıktı için de \(F_2\) sembolünü kullanır ve ardından \(F_1\) ile \(F_2\)'nin trainable linear functions olduğunu söyler. Verianla bu notasyonu varsayımla \(F_3\) gibi farklı bir sembole çevirmemiştir.
ELBO: Denklem (8)
Evidence Lower Bound (ELBO), variational autoencoder eğitim hedefidir. İlk terim latent representation'dan orijinal circuit structure'ın ne kadar iyi yeniden üretildiğini ödüllendirir. İkinci terim posterior \(q(Z\mid X,A)\) ile prior \(p(Z)\) arasındaki Kullback–Leibler divergence'ı cezalandırır.
Kaynak prior'ı:
olarak seçer. Bu regularization latent uzayın dağınık ve kesintili bir lookup table yerine daha düzenli bir probabilistic representation hâline gelmesini teşvik eder.
Pretraining minibatch gradient descent ile ve batch size 32 kullanılarak yapılmıştır.
Ön eğitim hiperparametreleri
| Parametre | Değer | Anlamı |
|---|---|---|
| Qubit sayısı | 4 / 8 / 12 | Deney/temsil ölçekleri |
| Gate sayısı | 10 / 20 / 30 | Sırasıyla 4 / 8 / 12 qubit circuit generator ayarı |
| Maximum circuit depth | 5 | Üretilen devre derinliği üst sınırı |
| Circuit sayısı | 100.000 | Randomly generated search / representation space |
| Batch size | 32 | Pretraining minibatch boyutu |
| Pretraining epoch | 16 | Autoencoder ön eğitim epoch sayısı |
| Dropout | 0,1 | Decoder implicit regularization |
| Input normalization | True | Input normalization uygulanıyor |
| Input dimension | 2 + #gates + #qubits | Gate/qubit özellik boyutu |
| Hidden dimension | 128 | GIN hidden representation |
| Latent dimension | 16 | Öğrenilen sürekli latent uzay |
| GIN layer | 5 | Message-passing depth |
| MLP layer | 2 | GIN içindeki MLP derinliği |
Operation pool
Random circuit generator aşağıdaki gate havuzunu kullanır:
Bu havuzun seçimi önemlidir. Search algorithm yalnız generator'ın oluşturabildiği devreleri bulabilir. Operation pool'da belirli gate family'leri yoksa QAS sonradan bu eksik mimarileri “icat” edemez. Bu nedenle çalışmanın sonuçları tanımlanmış circuit search space bağlamında değerlendirilmelidir.
Pretraining performans metrikleri neyi ölçüyor?
Kaynak beş ayrı metric kullanır:
- Accuracyops: gate type reconstruction doğruluğu.
- Accuracyqubit: gate'in hangi qubit'ler üzerinde çalıştığını yeniden oluşturma doğruluğu.
- Accuracyadj: adjacency matrix reconstruction doğruluğu.
- Falposmean: reconstructed adjacency matrix'teki mean false-positive miktarı.
- KLD: latent representation'ın continuity/smoothness değerlendirmesinde kullanılan KL-divergence metriği.
| Qubit | Encoding | Accuracy ops | Accuracy qubit | Accuracy adj | Falpos mean | KLD |
|---|---|---|---|---|---|---|
| 4 | GSQAS | 99,99 | 99,99 | 99,91 | 100,00 | 0,061 |
| 4 | Önerilen | 100 | 99,97 | 98,89 | 23,41 | 0,045 |
| 8 | GSQAS | 86,69 | 99,98 | 99,82 | 100,00 | 0,038 |
| 8 | Önerilen | 100 | 98,65 | 97,34 | 7,35 | 0,029 |
| 12 | GSQAS | 86,69 | 99,94 | 99,70 | 100,00 | 0,028 |
| 12 | Önerilen | 98,67 | 99,14 | 97,79 | 4,75 | 0,022 |
Bu tabloyu “önerilen encoding bütün reconstruction metric'lerinde daha iyi” biçiminde okumak doğru değildir. Önerilen yöntem gate-type accuracy, false-positive metriği ve KLD açısından belirgin avantajlar gösterirken Accuracyqubit ve özellikle Accuracyadj değerleri bazı durumlarda GSQAS'tan daha düşüktür. Kaynağın değerlendirmesi genel representation quality ve downstream search behavior üzerinden yapılmaktadır.
Kaynak Table 1 caption'ında “four metrics” ifadesini kullanmasına rağmen görünür tabloda Accuracyops, Accuracyqubit, Accuracyadj, Falposmean ve KLD olmak üzere beş metric sütunu bulunmaktadır. Verianla bu kaynak içi ifade farkını gizlememektedir.
PCA ve t-SNE görselleri neyi gösteriyor?
Kaynak Figure 2, 16-boyutlu latent representation'ı iki boyuta indirgemek için Principal Component Analysis (PCA) ve t-distributed Stochastic Neighbor Embedding (t-SNE) kullanır.
Bu görsellerdeki renkler circuit'lerin elde ettiği energy veya fidelity değerlerini gösterir; fakat bu performance değerleri autoencoder'ın unsupervised pretraining target'ı değildir. Yalnız eğitimden sonra latent space'in performans açısından nasıl organize olduğunu analiz etmek için üstüne bindirilmiştir.
4-qubit durumda yüksek performanslı mimariler daha düzenli bölgelerde kümelenmektedir. 12-qubit durumda ise 100.000 circuit olası mimari uzayın daha küçük bir bölümünü temsil ettiği için bu düzen daha zayıftır. Kaynak bunu daha büyük arama uzaylarında representation-learning coverage sınırı olarak yorumlar.
Predictor-Free Arama Ne Demektir?
Predictor-free arama, candidate circuit performansını önceden tahmin eden ayrı bir supervised predictor eğitmemek anlamına gelir; pretrained structural encoder sabitlenir, REINFORCE veya Bayesian Optimization latent uzaydan aday seçer ve aday devrenin gerçek görev evaluation'ı yalnız reward üretmek için kullanılır.
REINFORCE
Kaynak PPO ve A2C ile başlangıç denemeleri yaptığını, fakat architecture search için REINFORCE yöntemini seçtiğini belirtir.
REINFORCE, policy-gradient türü reinforcement-learning algoritmasıdır. Bu çalışmada:
- state space, pretrained architecture embeddings'ten oluşur;
- policy network tek hücreli LSTM kullanır;
- action, mevcut state distribution'dan örneklenen latent vector seçimine karşılık gelir;
- candidate circuit görev üzerinde değerlendirilir;
- elde edilen fidelity veya enerji oranı reward olarak policy update'e girer.
Enerji görevleri için reward: Denklem (9)
Kaynak MaxCut ve enerji-minimizasyon görevlerinde \(E_{\mathrm{ground}}<0\) olacak convention kullanır. Bu convention altında aday enerji ground-state energy'ye ulaştığında:
olur. \(E_{\mathrm{candidate}}=0\) için reward 0'dır.
Erken optimizasyon veya numerical noise sırasında \(E_{\mathrm{candidate}}>0\) olursa oran negatif çıkabilir. Kaynak bu durumda reward'u 0'a clip eder.
Quantum state preparation için energy ratio kullanılmaz; reward doğrudan fidelity'dir.
Adaptive baseline
REINFORCE variance'ını azaltmak amacıyla kaynak:
adaptive baseline kullanır. \(R_{\mathrm{avg}}\), önceki reward average; \(\alpha\in[0,1]\) smoothing coefficient'tir. Kaynak ana yöntem metninde \(\alpha\)'nın spesifik numerical değerini vermemektedir; bu nedenle değer tahmin edilmemiştir.
Her run 1000 architecture search içerir.
Bayesian Optimization
İkinci search strategy, Deep Networks for Global Optimization (DNGO) tabanlı Bayesian Optimization'dır.
Kaynak BO regression modelinde 128 hidden unit içeren tek hidden-layer feed-forward basis function kullanır. Acquisition function olarak Expected Improvement (EI) seçilir.
BO başlangıçta 16 sample ile çalışır. Her epoch'ta EI tarafından önerilen top-k architecture embedding'leri batch'e eklenir ve model güncellenmiş batch üzerinde 100 epoch yeniden eğitilir.
Buradaki “100 epoch”, autoencoder pretraining için verilen 16 epoch ile aynı eğitim değildir. Biri architecture representation pretraining, diğeri BO search modelinin iteration içi yeniden eğitimidir.
Çalışmanın Yöntemi ve Bulguları
100.000 Devrelik Uzayda 1000 Arama Ne İfade Ediyor?
Her ana QAS run'ında yöntem 100.000 devrelik önceden oluşturulmuş search space'in yalnız 1000 adayını, yani yaklaşık yüzde birini görev üzerinde sorgular; bu nedenle deneyin amacı bütün devreleri exhaustive biçimde taramak değil, latent representation'ın yüksek performanslı bölgeleri Random Search'e göre daha yoğun örnekleyip örnekleyemediğini test etmektir.
Ana deney görevleri
Çalışma üç uygulama ailesi kullanır:
- quantum state preparation,
- MaxCut,
- energy minimization / kaynak terminolojisiyle quantum chemistry grubu.
Ana Figure 3 ve Figure 4 deneyleri 4 ve 8 qubit düzeyinde yapılmıştır. Representation-learning ve encoding değerlendirmelerinin bazı bölümlerinde 12-qubit circuits de kullanılır.
Quantum state preparation
Quantum state preparation görevinin amacı bir target quantum state'i mümkün olduğunca yüksek fidelity ile yeniden oluşturmaktır.
Kaynak target state'i karşılık gelen random circuit'i üreterek oluşturur ve QAS yöntemini bu state'e yüksek fidelity sağlayan candidate circuit'leri aramak için kullanır.
Fidelity 0 ile 1 arasında reward olarak doğrudan kullanılabildiği için ayrıca energy normalization yapılmaz.
MaxCut
MaxCut, weighted undirected graph vertices'ını iki gruba ayırırken iki grup arasındaki edge weight toplamını maksimum yapma problemidir.
Çalışma graph'tan bir Hamiltonian türetir ve VQE tabanlı enerji değerlendirmesi kullanır.
Appendix A.2'de kaynak:
- 4-qubit / 4-node örnek için ground-state energy = −10 Ha,
- 8-qubit / 8-node örnek için ground-state energy = −52 Ha
ifadesini kullanır. “Ha” birimi kaynakta bu şekilde yazıldığı için korunmuştur; Verianla bu notasyonu başka bir birime sessizce dönüştürmemektedir.
Quantum chemistry ve TFIM ayrımı
Appendix A.2'de moleküler örnekler:
- 4-qubit H₂: yaklaşık optimal ground-state energy = −1,136 Ha,
- 12-qubit LiH: yaklaşık optimal ground-state energy = −7,88 Ha
olarak verilir.
Ancak 8-qubit örnek molekül değildir. Kaynak \(n=8\) transverse-field Ising model (TFIM) kullandığını açıkça belirtir.
Kaynak Denklem (10) — değiştirilmeden
\(\sigma_z^i\), \(i\). qubit üzerindeki Pauli-Z operator'ını; \(\sigma_x^i\), Pauli-X operator'ını temsil eder. İlk terim neighboring spin coupling'i, ikinci terim transverse-field katkısını ifade eder.
Kaynak içi önemli tutarsızlık: Metin modelin \(n=8\) olduğunu ve toplamın \(i=0\) ile 7 arasında olduğunu söylerken komşu indeksinde \((i+1)\bmod 6\) yazmaktadır. Bu ifade source PDF'de aynen böyledir. Verianla bunun typographical error olup olmadığını kaynak dışında tahmin ederek \(\bmod 8\)'e çevirmemiştir.
Kaynak bu Hamiltonian için yaklaşık optimal energy'yi −10 Ha olarak kullanmaktadır.
Arama sonuçları nasıl karşılaştırıldı?
Figure 3'te her plot 50 bağımsız run'ın average reward'unu gösterir ve her run 1000 query içerir. Shaded bands standard deviation'ı gösterir.
Yazarların gözlemine göre REINFORCE ve Bayesian Optimization, latent representation içinde search ilerledikçe average reward'u özellikle erken aşamada yükseltirken Random Search benzer improvement göstermemektedir. RL ve BO'nun variance'ı Random Search'ten biraz daha yüksek olsa da average reward seviyeleri daha yüksektir.
Candidate threshold'ları
| Görev | 4-qubit threshold | 8-qubit threshold |
|---|---|---|
| State preparation | 0,95 | 0,75 |
| MaxCut | 0,95 | 0,925 |
| Energy / quantum-chemistry grubu | 0,95 | 0,95 |
Bu nedenle 4-qubit ve 8-qubit candidate count'larını yalnız sayıya bakarak doğrudan karşılaştırmak doğru değildir; task complexity yanında threshold değerleri de farklıdır.
4-qubit arama verimliliği
| Yöntem | Task | Toplam değerlendirme | Bulunan aday \(N_{\mathrm{QAS}}\) | \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|---|---|
| GNN predictor + RL | Fidelity | 2000 | 36 | 0,0180 |
| GNN predictor + RL | MaxCut | 2000 | 783 | 0,3915 |
| GNN predictor + RL | QC-H₂ | 2000 | 278 | 0,1390 |
| GSQAS predictor + RL | Fidelity | 2000 | 37 | 0,0185 |
| GSQAS predictor + RL | MaxCut | 2000 | 785 | 0,3925 |
| GSQAS predictor + RL | QC-H₂ | 2000 | 658 | 0,3290 |
| Random Search | Fidelity | 1000 | 15 | 0,0150 |
| Random Search | MaxCut | 1000 | 568 | 0,5680 |
| Random Search | QC-H₂ | 1000 | 371 | 0,3710 |
| Önerilen QAS — REINFORCE | Fidelity | 1000 | 69 | 0,0690 |
| Önerilen QAS — REINFORCE | MaxCut | 1000 | 898 | 0,8980 |
| Önerilen QAS — REINFORCE | QC-H₂ | 1000 | 817 | 0,8170 |
| Önerilen QAS — BO | Fidelity | 1000 | 63 | 0,0630 |
| Önerilen QAS — BO | MaxCut | 1000 | 820 | 0,8200 |
| Önerilen QAS — BO | QC-H₂ | 1000 | 739 | 0,7390 |
Predictor-based yöntemlerin \(N_{\mathrm{eval}}=2000\) değeri, performans predictor'ını kurmak için gerekli labeled-circuit değerlendirmeleri ile search sırasında yapılan değerlendirmelerin toplamını içerir. Önerilen predictor-free yöntemde ayrı 1000 labeled pretraining circuit evaluation yoktur; structural pretraining performance label istemez ve \(N_{\mathrm{eval}}=1000\) search evaluation kullanılır.
Bu tablo yöntemin özellikle MaxCut ve H₂ enerji görevinde yüksek-performing regions'ı daha yoğun örnekleyebildiğini gösterir. Fakat task-specific threshold'lar ve search-space composition sonuçların bağlamıdır; değerler evrensel QAS efficiency constant'ları değildir.
Encoding değiştiğinde sonuç her zaman iyileşiyor mu?
| Deney | GSQAS encoding \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) | Önerilen encoding \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|
| GSQAS — 4 | 0,3125 | 0,3290 |
| GSQAS — 12 | 0,1415 | 0,1380 |
| QAS-RL — 4 | 0,7600 | 0,8170 |
| QAS-RL — 8 | 0,1600 | 0,1670 |
| QAS-RL — 12 | 0,4220 | 0,3920 |
Bu sonuç önemli bir yorum sınırı oluşturur. Yeni encoding 4 ve 8-qubit örneklerin çoğunda avantaj sağlarken 12-qubit iki karşılaştırmada GSQAS encoding'in gerisindedir. Kaynak da 12-qubit search space'in 100.000 circuit ile yeterince temsil edilememesini olası neden olarak tartışır.
Latent dimension ve GIN depth ablasyonu
| Latent \(d_z\) | GIN depth \(L\) | VAE loss | Average reward RL | Average reward BO |
|---|---|---|---|---|
| 8 | 5 | 0,11 | 0,95 ± 0,001 | 0,89 ± 0,030 |
| 16 | 5 | 0,09 | 0,98 ± 0,006 | 0,93 ± 0,013 |
| 32 | 5 | 0,14 | 0,975 ± 0,009 | 0,92 ± 0,017 |
| 16 | 3 | 0,10 | 0,95 ± 0,013 | 0,93 ± 0,021 |
| 16 | 7 | 0,09 | 0,97 ± 0,010 | 0,92 ± 0,022 |
Ablation sonuçları 10 random seed üzerinden mean ± standard deviation olarak verilmiştir. VAE reconstruction objective hyperparameter'lara duyarlı olsa da downstream QAS reward daha sınırlı değişmektedir. Kaynağın default tercihi \(d_z=16\), \(L=5\)'tir.
IBM ibm_sherbrooke Üzerindeki %100 Sonuç Ne Anlama Geliyor?
Kaynağın %100 sonucu, QAS ile seçilmiş yalnız iki MaxCut devresinin — 4-node ve 8-node problem — simülatörde eğitilen parametreleri değiştirilmeden ibm_sherbrooke üzerinde 10.000'er shot çalıştırıldığında bütün ölçümlerde optimal bitstring raporlanmasını ifade eder; bu sonuç state-preparation veya chemistry/TFIM görevlerinin gerçek donanımda aynı başarıya ulaştığını ya da yöntemin genel quantum advantage sağladığını göstermez.
Gerçek donanım test protokolü
- QAS ile 4-node ve 8-node MaxCut için en iyi-performing circuit seçildi.
- Bu devrelerin trainable parametreleri noise-free simulator üzerinde optimize edildi.
- Aynı parameter set gerçek ibm_sherbrooke cihazına aktarıldı.
- Kaynak herhangi bir hardware-specific parameter re-tuning yapılmadığını belirtmektedir.
- Her koşul 10.000 measurement shot ile çalıştırıldı.
| Metrik | 4-node simülatör | 4-node gerçek cihaz | 8-node simülatör | 8-node gerçek cihaz |
|---|---|---|---|---|
| Optimal bitstring olasılığı | %100,0 | %100,0 | %100,0 | %100,0 |
| Average cut value | 4 | 4 | 12 | 12 |
| Shot | 10.000 | 10.000 | 10.000 | 10.000 |
| Noise model | Noise-free | Physical NISQ | Noise-free | Physical NISQ |
| Device | Simulator | ibm_sherbrooke | Simulator | ibm_sherbrooke |
Kaynak ayrı bir confidence interval raporlamamaktadır. Bu nedenle Verianla “gerçek başarı olasılığı kesin olarak 1,000000'dır” gibi istatistiksel genelleme yapmaz; yalnız kaynak Table 4'te 10.000 repeated shot için gözlenen ve %100,0 olarak raporlanan sonucu aktarır.
Bu sonuç quantum advantage mı?
Hayır. Çalışmanın araştırma sorusu classical computer'ı quantum computer'a karşı hız veya complexity açısından yenmek değildir. Arama framework'ü büyük ölçüde klasik machine learning ve gürültüsüz quantum simulation kullanır; gerçek hardware deneyi ise seçilmiş candidate circuit'lerin transfer edilebilirliğini test eder.
Dolayısıyla çalışmanın desteklediği ifade “bulunan iki MaxCut circuit gerçek NISQ cihazına parametre re-tuning olmadan başarıyla aktarılmıştır”dır. “QAS classical computing'i aşmıştır” veya “quantum advantage gösterilmiştir” sonucu kaynak tarafından test edilmemiştir.
Çalışmanın güçlü yönleri
- Architecture representation learning ile task-specific search birbirinden ayrılmıştır.
- Pretraining performance labels veya VQA evaluations gerektirmez.
- Control/target rolü ve multi-qubit edge importance önceki encoding'e göre daha açık temsil edilir.
- Aynı pretrained representation farklı downstream tasks için kullanılabilir.
- REINFORCE ve BO aynı latent space üzerinde uygulanabilmektedir.
- Search performansı yalnız tek bir uygulamada değil state preparation, MaxCut ve energy-based görevlerde değerlendirilmiştir.
- Ana search curves 50 independent run üzerinden değerlendirilmiştir.
- Latent dimension ve GIN depth için ayrıca ablation yapılmıştır.
- En iyi MaxCut circuit'ler gerçek IBM hardware üzerinde doğrudan test edilmiştir.
Çalışmanın sınırlılıkları
Search-space coverage: 100.000 circuit, 4-qubit problemde zengin bir örnekleme sağlayabilse de 12-qubit bütün possible architecture space'in çok küçük bölümünü kapsayabilir. Kaynak 12-qubit latent representation'daki daha zayıf clustering'i bu sınırlılıkla ilişkilendirir.
Operation-pool bağımlılığı: Model yalnız başlangıç circuit generator'ın izin verdiği gate seti ve structural constraints içinde arama yapar.
Hardware validation kapsamı: Gerçek hardware yalnız 4-node ve 8-node MaxCut best circuits için kullanılmıştır; state preparation ve enerji görevleri için aynı gerçek-device validation raporlanmamıştır.
Seçilmiş devre doğrulaması: Hardware test bütün candidate distribution'ı değil search tarafından seçilen en iyi devreleri test eder.
Noise-model genellemesi: Search ana deneyleri noise-free simulator üzerinde yapılmıştır. QAS objective doğrudan hardware noise-aware search olarak optimize edilmemiştir.
Scalability: 12-qubit sonuçları representation coverage ve downstream search performansında gerileme olabileceğini göstermektedir. Bu nedenle yöntem daha büyük devrelerde otomatik olarak aynı efficiency'yi garanti etmez.
Predictor-free ≠ evaluation-free: Ayrı predictor ve labeled pretraining gerekmese de reward için candidate VQA evaluation gerekir; pahalı görev değerlendirmesi tamamen ortadan kalkmaz.
Çalışmanın desteklediği sonuçlar
Kaynak, circuit structure'ı gözetimsiz biçimde öğrenilmiş latent representation'a dönüştürmenin QAS için kullanışlı olabileceğini ve REINFORCE/BO'nun bu latent space içinde Random Search'ten daha verimli yüksek-performing candidate discovery sağlayabildiğini desteklemektedir.
Önerilen encoding control-target role ve interaction weight gibi circuit-specific bilgileri daha açık temsil eder ve birçok metric ile downstream search condition'ında avantaj sağlar.
4-qubit örneklerde latent representation'ın performance structure ile düzenli biçimde kümelenebildiği gösterilmektedir; performance label bu representation'ın training target'ı değildir.
Seçilmiş 4-node ve 8-node MaxCut circuits'in simulator-trained parameters ile ibm_sherbrooke üzerinde yeniden tuning olmadan kaynakta raporlanan optimal output'u koruduğu gösterilmektedir.
Çalışmanın desteklemediği sonuçlar
Çalışma bütün kuantum circuit architecture search problemlerinde yeni encoding'in en iyi olduğunu kanıtlamaz. 12-qubit karşılaştırmalarında bazı sonuçlar eski encoding lehinedir.
Çalışma predictor-free yaklaşımın quantum circuit evaluation ihtiyacını tamamen ortadan kaldırdığını göstermez.
Çalışma bütün bulunan devrelerin gerçek hardware noise'a dayanıklı olduğunu göstermez.
Çalışma state preparation, H₂, LiH veya TFIM görevlerini ibm_sherbrooke üzerinde aynı hardware test protokolüyle doğrulamaz.
Çalışma fault-tolerant quantum computing göstermez; kullanılan gerçek cihaz NISQ cihazıdır.
Çalışma quantum computational advantage veya classical speedup kanıtlamaz.
Çalışma 100.000 devrelik örneklemin 12-qubit veya daha büyük circuit spaces'i tam temsil ettiğini göstermez.
Kaynak ve Yöntem Notu
Özgün başlık: Quantum Architecture Search with Unsupervised Representation Learning
Yazarlar: Yize Sun, Zixin Wu, Volker Tresp, Yunpu Ma.
Eş katkı: Yize Sun ve Zixin Wu.
İletişim yazarı: Yunpu Ma.
Kaynakta verilen iletişim e-postası: cognitive.yunpu@gmail.com
Kurum 1: Ludwig-Maximilians-University Munich, Munich, Germany.
Kurum 2: Siemens AG, Munich, Germany.
Kurum 3: MCML — Munich Center for Machine Learning, Munich, Germany.
Kaynak türü: Hakemli journal article.
Dergi: Quantum.
Cilt: 10.
Makale/sayfa numarası: 1994.
Yayın tarihi: 3 Şubat 2026.
Kabul tarihi: 23 Ocak 2026.
DOI: 10.22331/q-2026-02-03-1994.
Eprint: arXiv:2401.11576v6 [quant-ph], 25 Ocak 2026.
Yayınevi: Verein zur Förderung des Open Access Publizierens in den Quantenwissenschaften.
Editör: Jiangwei Shang.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Bilimsel çalışma türü: Kuantum makine öğrenmesi / quantum architecture search yöntem çalışması; graph representation learning, reinforcement learning, Bayesian optimization, gürültüsüz quantum simulation ve sınırlı gerçek NISQ hardware evaluation içerir.
Search space: Random generator ile 100.000 circuit.
Operation pool: X, Y, Z, H, Rx, Ry, Rz, U3, CNOT, CZ, CY.
Circuit generator: 4 / 8 / 12 qubit; sırasıyla 10 / 20 / 30 gate; maximum depth 5.
Representation model: GIN-based variational graph autoencoder.
GIN layer: 5.
Latent dimension: 16.
Hidden dimension: 128.
Pretraining: 16 epoch; batch size 32; dropout 0,1; structure-only \(A,X\) input; performance label kullanılmıyor.
Search algorithms: REINFORCE ve DNGO tabanlı Bayesian Optimization.
Search budget: Ana run başına 1000 query.
Ana performans tekrarları: Figure 3 ve Figure 4 için 50 independent run / random seed.
Ablation tekrarları: Table 6 için 10 random seed.
Gerçek kuantum cihazı: IBM ibm_sherbrooke.
Gerçek hardware test kapsamı: Yalnız seçilmiş 4-node ve 8-node MaxCut circuits.
Hardware shot sayısı: Her koşul için 10.000.
Hardware parameter transfer: Parametreler noise-free simulator üzerinde eğitilmiş ve gerçek cihaza re-tuning yapılmadan aktarılmıştır.
Hardware sonucu: Kaynak Table 4, 4-node ve 8-node MaxCut için hem simulator hem gerçek cihazda %100,0 optimal-bitstring probability raporlamaktadır; ayrı confidence interval verilmemiştir.
Kaynak içi Denklem (10) notu: Metin \(n=8\) TFIM tanımlarken komşu indeksi \((i+1)\bmod6\) olarak yazmaktadır. Verianla formülü değiştirmemiş ve bu uyumsuzluğu görünür bırakmıştır.
Kaynak içi uygulama adı notu: 8-qubit deney “quantum chemistry” deney grubu içinde tartışılsa da Appendix A.2'de kullanılan fiziksel model molekül değil TFIM'dir. H₂ 4-qubit, LiH ise 12-qubit molecular örneklerdir.
Kaynak içi metric-caption notu: Table 1 caption'ı “four metrics” derken tabloda beş metric sütunu bulunmaktadır.
Finansman: German Federal Ministry of Education and Research tarafından Quantum Reinforcement Learning for Industrial Applications (QLindA), proje no. 13N15644; ayrıca Federal Ministry for Economic Affairs and Climate Action tarafından Quantum-Classical Hybrid Optimization Algorithms for Logistics and Production Line Management (QCHALLenge), proje no. 01MQ22008B.
AI kullanım beyanı: Kaynak acknowledgments bölümü manuscript'in bazı bölümlerinin drafting ve language refinement amacıyla OpenAI ChatGPT-4 desteğiyle oluşturulduğunu ve içeriğin sorumluluğunu yazarların üstlendiğini belirtmektedir.
Veri erişilebilirliği: Sağlanan 20 sayfalık makalede bağımsız bir “Data Availability” bölümü belirlenmemiştir. Kaynakta bulunmayan repository veya dataset adresi eklenmemiştir.
Code availability: Sağlanan PDF'de bağımsız “Code Availability” beyanı belirlenmemiştir.
Çıkar çatışması: Sağlanan PDF'de ayrı bir competing-interest/conflict-of-interest beyanı belirlenmemiştir; bu nedenle “çıkar çatışması yoktur” şeklinde kaynak dışı varsayım yapılmamıştır.
Yazar katkıları: Sağlanan PDF'de ayrı CRediT author-contribution bölümü belirlenmemiştir; yalnız Yize Sun ve Zixin Wu'nun eş katkıda bulunduğu açıkça belirtilmiştir.
Temel yorum sınırı: Çalışma efficient architecture search ve selected-circuit hardware transfer konusunda kanıt sağlar; fault tolerance, genel hardware robustness veya quantum advantage göstermez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir