


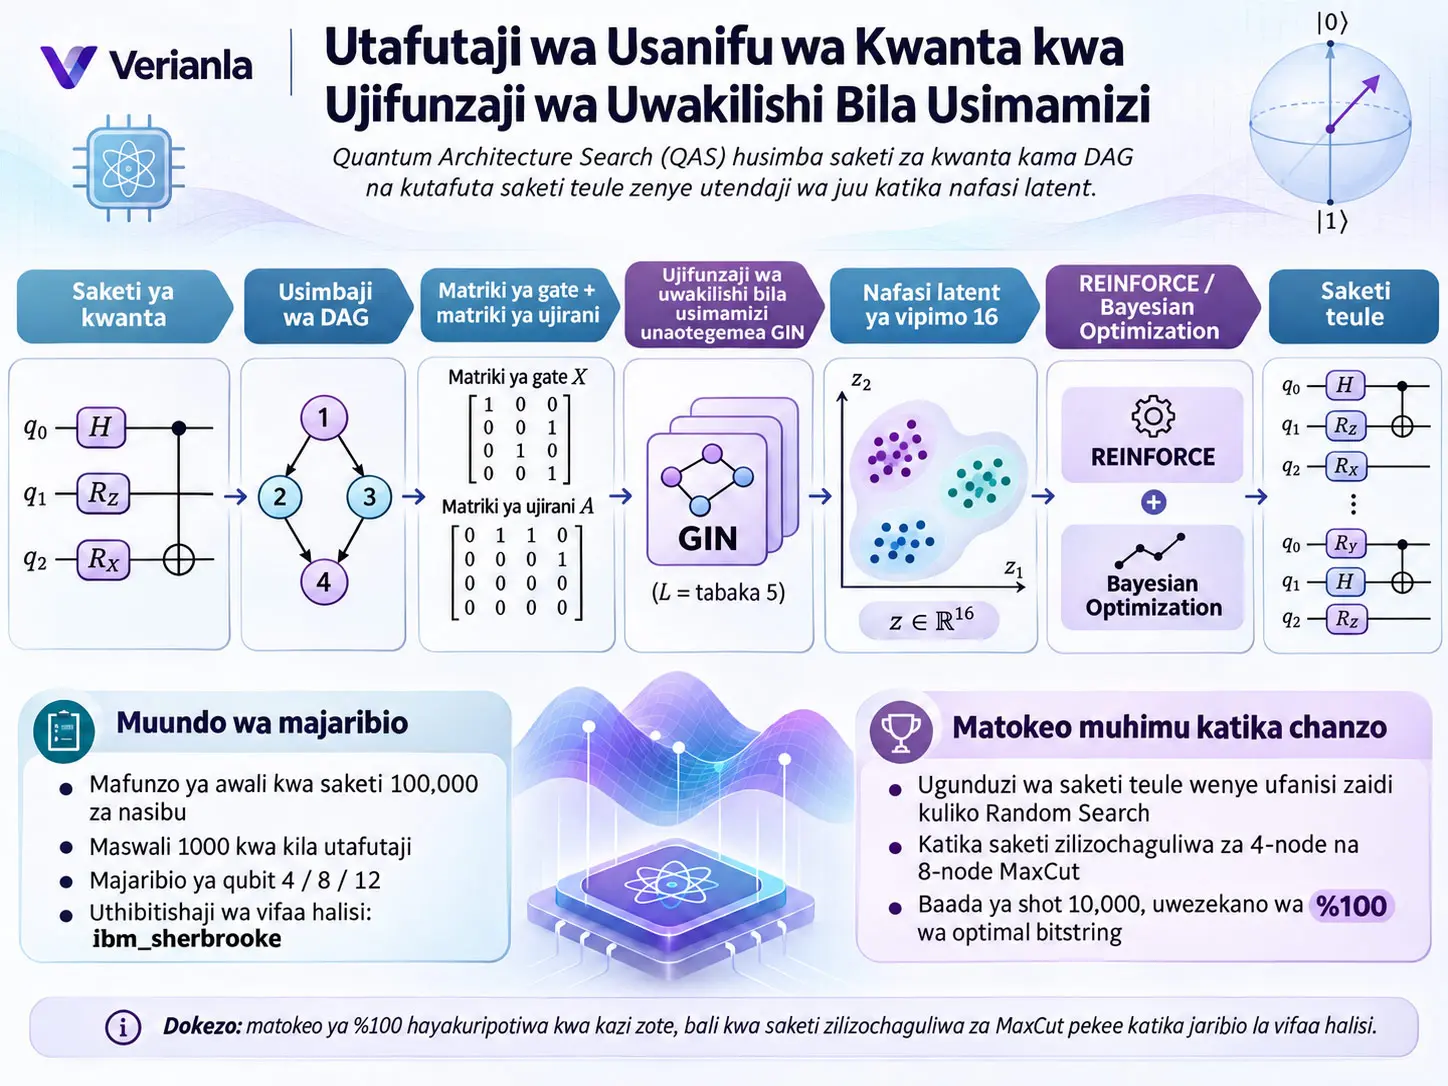
Utafutaji wa Usanifu wa Kwanta kwa Ujifunzaji wa Uwakilishi Bila Usimamizi (Quantum Architecture Search, QAS) ni mfumo wa predictor-free wa kubuni saketi za kwanta unaowakilisha muundo wa saketi za kwanta zenye vigezo katika nafasi latent yenye vipimo vichache na endelevu bila kutumia lebo ya utendaji, kisha kuchunguza nafasi hiyo latent kwa REINFORCE au Bayesian Optimization ili kutafuta saketi teule zenye utendaji wa juu. Katika utafiti, saketi ya kwanta kwanza husimbwa kama grafu elekezi isiyo na mzunguko (Directed Acyclic Graph, DAG), aina za gate na majukumu ya qubit huwakilishwa kwa vipengele tofauti, variational graph autoencoder inayotegemea Graph Isomorphism Network (GIN) hujifunza uwakilishi latent wa vipimo 16 kwa kutumia taarifa za kimuundo pekee za saketi 100.000 zilizozalishwa kwa nasibu, na baadaye algoriti za utafutaji huchagua usanifu teule katika nafasi hiyo.
Ubunifu mkuu wa utafiti ni kutenganisha uwakilishi wa muundo wa saketi ya kwanta na mchakato wa utafutaji unaolenga utendaji. Mbinu za Predictor-based QAS zinaweza kuhitaji kutathmini saketi nyingi mapema na kufundisha predictor tofauti ya utendaji kwa kutumia matokeo hayo. Katika utafiti huu, utendaji wa saketi, nishati ya VQA au lebo ya fidelity haitumiki katika hatua ya mafunzo ya awali. Hata hivyo, “predictor-free” haimaanishi “bila tathmini”: wakati wa utafutaji, saketi teule zinazopendekezwa na REINFORCE au Bayesian Optimization hutathminiwa kwa kweli kwenye kazi ili kukokotoa reward.
Majaribio makuu ya utafutaji yalifanywa katika quantum state preparation, MaxCut na kazi za kupunguza nishati zilizowasilishwa kwenye chanzo chini ya kichwa “quantum chemistry”, katika viwango vya 4 na 8 qubit. Katika kila jaribio, nafasi ya utafutaji ilikuwa na saketi 100.000, kila run ilitumia search query 1000 pekee, na ulinganisho mkuu wa utendaji ulifanywa kwa random seed 50 huru. REINFORCE na Bayesian Optimization, hasa katika majaribio ya 4-qubit, zilipata saketi teule nyingi zaidi zenye utendaji wa juu kuliko Random Search; lakini mbinu hiyo si bora kwa namna ya moja kwa moja kuliko uwakilishi mshindani katika kila kipimo na kila metric. Kwa mfano, baadhi ya ulinganisho wa 12-qubit encoding una matokeo yanayoipendelea GSQAS encoding iliyopo.
Uthibitishaji kwenye hardware halisi ya kwanta ulifanywa tu kwa mifano teule ya MaxCut. Kwa 4-node na 8-node MaxCut, vigezo vya saketi bora zaidi zilizopatikana katika utafutaji vilifundishwa kwenye simulator isiyo na kelele, kisha vigezo hivyo hivyo vikaendeshwa kwenye kifaa cha NISQ cha IBM ibm_sherbrooke bila kufanya uboreshaji upya. Chanzo kinaripoti uwezekano wa %100,0 wa optimal bitstring baada ya shot 10.000 kwa kila tatizo. Matokeo haya yanathibitisha uhamishaji wa saketi mbili teule za MaxCut; hayaonyeshi kwamba kazi zote za QAS, saketi zote au hali zote za kelele za NISQ zimetatuliwa kwa mafanikio ya %100.
Utafiti pia unaonyesha kikomo muhimu cha uwezo wa kupanuka. Ingawa uwakilishi latent wa 4-qubit ni kompakt na hujikusanya kwa mpangilio zaidi kwa mujibu wa utendaji, katika nafasi ya 12-qubit sampuli ya saketi 100.000 hufunika sehemu ndogo zaidi ya usanifu unaowezekana, hivyo mpangilio latent wa saketi zenye utendaji wa juu huwa dhaifu zaidi. Kwa hiyo, ingawa mbinu hutoa faida kwa kupunguza gharama ya utafutaji na kuondoa hitaji la seti kubwa ya data yenye lebo, tatizo la kupanua mbinu hadi saketi kubwa zaidi za kwanta halijatatuliwa.
Utafutaji wa Usanifu wa Kwanta (QAS) ni Nini?
Utafutaji wa Usanifu wa Kwanta (Quantum Architecture Search, QAS) ni mbinu ya kuboresha usanifu wa saketi inayochunguza kiotomatiki au nusu-kiotomatiki ni gate zipi zitumike, kwenye qubit zipi, na kwa muundo gani wa muunganisho/mpangilio kwa kazi maalumu ya ukokotoaji wa kwanta; katika utafiti huu, badala ya kuchanganua moja kwa moja nafasi disikriti ya mchanganyiko wa saketi, QAS kwanza huchunguza nafasi endelevu ya uwakilishi latent iliyojifunzwa.
Kwa nini usanifu wa saketi ya kwanta ni muhimu?
Variational Quantum Algorithm (VQA) ni familia ya algoriti mseto za kwanta-klasiki zinazotumia saketi ya kwanta yenye vigezo pamoja na optimizer ya klasiki. Saketi ya kwanta yenye vigezo, Parameterized Quantum Circuit (PQC), ni saketi ya kwanta ambayo pembe fulani za gate au vigezo vingine vya gate vinaweza kufundishwa.
Katika VQA, si thamani za vigezo vya gate pekee zilizo muhimu, bali pia usanifu wa saketi. Hata kama saketi mbili zina idadi sawa ya qubit, tofauti katika aina za gate, mpangilio wa gate, miunganisho ya qubit mbili na circuit depth zinaweza kubadilisha expressibility, entangling capability, tabia ya uboreshaji na unyeti kwa kelele.
Kwa hiyo kuna matatizo mawili tofauti ya uboreshaji:
- Uboreshaji wa vigezo: Kurekebisha pembe za gate zenye vigezo kama \(R_x\), \(R_y\), \(R_z\), \(U3\) za saketi iliyochaguliwa.
- Uboreshaji wa usanifu: Kuchagua gate zipi zitumike, kwa mpangilio gani na kwa miunganisho ipi ya qubit.
QAS inalenga tatizo la pili. Hata hivyo, kwa kuwa nafasi ya usanifu ni disikriti na ya mchanganyiko, idadi ya saketi zinazowezekana inaweza kukua kwa kasi sana kadiri idadi ya qubit na gate inavyoongezeka.
NISQ ina maana gani?
Noisy Intermediate-Scale Quantum (NISQ) inaelezea vifaa vya kwanta vya kipindi cha kati vyenye kelele, ambapo fault-tolerant quantum error correction haiwezi kutekelezwa kikamilifu katika hesabu nzima, lakini hesabu halisi za kwanta zinaweza kufanywa kwa idadi fulani ya qubit na gate za kimwili.
NISQ ni muhimu katika motisha ya utafiti huu; kwa sababu saketi zenye vigezo ambazo ni ndefu zaidi, zina gate zisizo za lazima au zimeundwa vibaya zinaweza kufanya kazi kwenye simulator bora lakini zikapoteza utendaji kwenye kifaa halisi kutokana na decoherence na gate noise. Kwa hiyo lengo la QAS si kutafuta tu miundo ya saketi yenye nguvu kubwa ya kujieleza kihisabati, bali pia miundo ya saketi inayofaa kwa kazi.
Barren plateau ni nini?
Barren plateau ni tatizo ambalo katika baadhi ya variational quantum circuit thamani za gradient huwa ndogo sana katika maeneo makubwa ya optimization landscape. Gradient inapokaribia sifuri, optimizer ya klasiki inaweza kupata ugumu wa kuamua mwelekeo wa kigezo unaopaswa kufuatwa.
Chanzo kinataja barren plateau kama mojawapo ya motisha za QAS; lakini hakidai kwamba mbinu iliyopendekezwa huondoa tatizo la barren plateau kihisabati. Kitu kinachopimwa moja kwa moja na utafiti ni utendaji wa utafutaji wa usanifu wa saketi.
Kwa Nini Saketi ya Kwanta Inasimbwa kama Grafu Elekezi Isiyo na Mzunguko (DAG)?
Utafiti unawakilisha kila gate katika saketi ya kwanta kama nodi ya grafu, na utegemezi wa gate zinazofuatana kwa mpangilio wa wakati kwenye qubit ileile kama kingo elekezi; nodi za START na END pia huongezwa na saketi hubadilishwa kuwa grafu elekezi isiyo na mzunguko, hivyo graph representation learning inayotegemea GIN inaweza kuchakata pamoja aina ya gate, nafasi ya qubit na topolojia ya muunganisho wa saketi.
DAG ni nini?
Directed Acyclic Graph (DAG) ni grafu yenye kingo elekezi lakini isiyo na directed cycle inayorudi kwenye sehemu ya kuanzia. Kwa kuwa mpangilio wa wakati wa gate katika saketi ya kwanta kwa kawaida huunda uhusiano wa dependency unaoelekea mbele, uwakilishi wa DAG unafaa.
Katika chanzo, saketi yenye aina \(m\) za gate, gate \(h\) na qubit \(g\) inawakilishwa na grafu:
Idadi ya nodi ikiwa ni pamoja na START na END ni:
.
Kwa grafu hii, matritsi mbili zinazokamilishana huundwa:
- Adjacency matrix \(A\): matritsi ya muunganisho wa kimuundo yenye vipimo \(n\times n\).
- Gate matrix \(X\): matritsi ya vipengele vya gate na jukumu la qubit yenye vipimo \(n\times(m+2+g)\).
\(A_{ij}=1\) inaonyesha kwamba kuna directed edge kutoka node \(i\) hadi node \(j\); \(A_{ij}=0\) inaonyesha hakuna muunganisho huo.
Ni taarifa gani iliyokuwa inapotea katika mbinu ya zamani ya encoding?
EGSQAS encoding ya awali inayolinganishwa na chanzo haikutofautisha vya kutosha majukumu ya control na target qubit ndani ya gate ya qubit mbili. Kwa mfano, katika CNOT gate, control qubit na target qubit hazina jukumu lilelile kimwili; tofauti hii inapopotea, saketi mbili tofauti zinaweza kuwakilishwa kama zinazofanana sana kimuundo.
Encoding iliyopendekezwa hushughulikia tatizo hili kwa njia mbili:
- Kwa gate ya qubit mbili, control qubit husimbwa kwa −1 kwenye safu husika na target qubit kwa +1.
- Edge weight katika adjacency matrix huhusishwa na idadi ya qubit zinazoshiriki operesheni; kwa mfano weight 2 hutumiwa kwa gate ya qubit mbili.
Hivyo modeli haioni tu taarifa ya “gate gani ipo?”, bali pia jukumu la kiutendaji la gate ndani ya mfumo wa qubit.
Ujifunzaji wa Uwakilishi Bila Usimamizi Unajifunza Nini katika Utafiti Huu?
Mafunzo ya awali bila usimamizi hayajifunzi jinsi saketi inavyofanya vizuri katika MaxCut, state preparation au kazi ya kupunguza nishati; yanajifunza tu kubadilisha vipengele vya kimuundo vya saketi kutoka \(A\) adjacency matrix na \(X\) gate/qubit feature matrix kuwa vigezo latent vilivyobanwa, na kujenga upya grafu ya saketi kutoka taarifa hiyo ya kimuundo.
Variational posterior: Mlinganyo (1)
\(Z\) ni mkusanyiko wa latent representation. \(z_i\) ni kigezo latent; \(\mu_i\) ni Gaussian posterior mean ya kigezo hicho; \(\sigma_i\) ni parameter ya standard deviation. \(\operatorname{diag}(\sigma_i^2)\) inaonyesha dhana ya diagonal covariance.
Mlinganyo huu si mlinganyo wa quantum state wavefunction. \(Z\) ni kigezo latent kinachojifunzwa na modeli ya klasiki ya machine-learning.
Reparameterization trick
Modeli huchukua sampuli ya kigezo latent kwa:
Namna hii ya kuandika hutumiwa kuunganisha mchakato wa sampuli nasibu na mtiririko wa mafunzo unaoweza kutofautishwa kupitia \(\mu_i\) na \(\sigma_i\).
GIN message passing: Mlinganyo (2)
\(M^{(s)}\) ni matritsi ya node embedding katika \(s\). message-passing layer ya GIN. Mwanzo:
\(\hat A\) hufafanuliwa katika chanzo kama:
Ingawa circuit graph ya awali ni directed, adjacency husymmetrize wakati wa GIN message passing; hivyo feature aggregation ya pande mbili inaweza kufanywa kati ya gate zilizounganishwa.
Hadi \((1+\epsilon^{(s)})M^{(s-1)}\) ni mchango wa self-loop unaoweza kujifunzwa unaohifadhi uwakilishi wa awali wa node yenyewe. \(\hat A M^{(s-1)}\) hukusanya taarifa za gate jirani. \(\operatorname{MLP}^{(s)}\) hubadilisha taarifa iliyokusanywa kuwa nonlinear embedding.
Katika majaribio yote ya msingi ya utafiti:
- idadi ya GIN layer \(L=5\),
- hidden dimension = 128,
- latent dimension = 16
zimetumika.
Fusion layer hufanya kazi gani?
Badala ya kutegemea tu matokeo ya GIN layer ya mwisho, modeli hutumia fusion layer inayounganisha uwakilishi kutoka tabaka tofauti za GIN. Lengo ni kuhamisha kwenye latent representation si uwakilishi dhahania wa tabaka la kina pekee, bali pia taarifa ya ndani ya gate/connectivity kutoka tabaka za awali.
Decoder hujenga upya taarifa zipi?
Decoder hujaribu kujenga upya kutoka latent \(Z\) adjacency matrix \(A\) pamoja na muundo wa gate matrix:
\(X^t\) hubeba taarifa ya gate type one-hot, na \(X^q\) hubeba taarifa ya nafasi inayosimba qubit zipi gate inafanya kazi juu yake.
Mlinganyo (3): Adjacency reconstruction
Factorization hii ni modeli ya kuzalisha taarifa za edge katika reconstructed graph kutoka jozi za latent node.
Mlinganyo (4)
Chanzo kinatoa usemi huu kwa notasheni ya \(\operatorname{ReLU}_j\) na hakitoi ufafanuzi huru wa kina wa kihisabati wa \(\operatorname{ReLU}_j\). Kwa hiyo, notasheni haijabadilishwa kimya kimya kuwa activation au probability function nyingine. \(F_1\) inaelezwa katika chanzo kama trainable linear function.
Mlinganyo (5)–(7): Gate matrix reconstruction
Softmax hutumiwa kuzalisha kategoria ya gate type, na \(\tanh\) hutumiwa kutoa matokeo endelevu ya qubit-position encoding. Chanzo hutumia alama \(F_2\) kwa matokeo yote mawili katika Mlinganyo (6) na (7), kisha husema kwamba \(F_1\) na \(F_2\) ni trainable linear functions. Verianla haijabadilisha notasheni hii kwa dhana kuwa alama nyingine kama \(F_3\).
ELBO: Mlinganyo (8)
Evidence Lower Bound (ELBO) ni lengo la mafunzo la variational autoencoder. Hadi ya kwanza hutunuku jinsi circuit structure ya awali inavyoweza kujengwa upya vizuri kutoka latent representation. Hadi ya pili huadhibu Kullback–Leibler divergence kati ya posterior \(q(Z\mid X,A)\) na prior \(p(Z)\).
Chanzo huchagua prior kama:
Regularization hii huhimiza nafasi latent kuwa probabilistic representation iliyo na mpangilio zaidi badala ya lookup table iliyotawanyika na kukatika.
Pretraining imefanywa kwa minibatch gradient descent kwa kutumia batch size 32.
Hyperparameter za mafunzo ya awali
| Parameter | Thamani | Maana |
|---|---|---|
| Idadi ya Qubit | 4 / 8 / 12 | Viwango vya jaribio/uwakilishi |
| Idadi ya Gate | 10 / 20 / 30 | Mpangilio wa circuit generator kwa 4 / 8 / 12 qubit mtawalia |
| Maximum circuit depth | 5 | Kikomo cha juu cha kina cha saketi inayozalishwa |
| Idadi ya Circuit | 100.000 | Randomly generated search / representation space |
| Batch size | 32 | Ukubwa wa pretraining minibatch |
| Pretraining epoch | 16 | Idadi ya epoch za mafunzo ya awali ya autoencoder |
| Dropout | 0,1 | Decoder implicit regularization |
| Input normalization | True | Input normalization inatumika |
| Input dimension | 2 + #gates + #qubits | Kipimo cha vipengele vya Gate/qubit |
| Hidden dimension | 128 | GIN hidden representation |
| Latent dimension | 16 | Nafasi latent endelevu iliyojifunzwa |
| GIN layer | 5 | Message-passing depth |
| MLP layer | 2 | Kina cha MLP ndani ya GIN |
Operation pool
Random circuit generator hutumia mkusanyiko ufuatao wa gate:
Uchaguzi wa mkusanyiko huu ni muhimu. Search algorithm inaweza kupata tu saketi ambazo generator inaweza kuzalisha. Ikiwa familia fulani za gate hazipo katika Operation pool, QAS haiwezi baadaye “kubuni” usanifu huo uliokosekana. Kwa hiyo matokeo ya utafiti yanapaswa kutathminiwa katika muktadha wa circuit search space iliyofafanuliwa.
Metriki za utendaji wa Pretraining hupima nini?
Chanzo hutumia metric tano tofauti:
- Accuracyops: usahihi wa gate type reconstruction.
- Accuracyqubit: usahihi wa kujenga upya qubit ambazo gate inafanya kazi juu yake.
- Accuracyadj: usahihi wa adjacency matrix reconstruction.
- Falposmean: kiasi cha mean false-positive katika reconstructed adjacency matrix.
- KLD: metric ya KL-divergence inayotumiwa katika tathmini ya continuity/smoothness ya latent representation.
| Qubit | Encoding | Accuracy ops | Accuracy qubit | Accuracy adj | Falpos mean | KLD |
|---|---|---|---|---|---|---|
| 4 | GSQAS | 99,99 | 99,99 | 99,91 | 100,00 | 0,061 |
| 4 | Iliyopendekezwa | 100 | 99,97 | 98,89 | 23,41 | 0,045 |
| 8 | GSQAS | 86,69 | 99,98 | 99,82 | 100,00 | 0,038 |
| 8 | Iliyopendekezwa | 100 | 98,65 | 97,34 | 7,35 | 0,029 |
| 12 | GSQAS | 86,69 | 99,94 | 99,70 | 100,00 | 0,028 |
| 12 | Iliyopendekezwa | 98,67 | 99,14 | 97,79 | 4,75 | 0,022 |
Si sahihi kusoma jedwali hili kama “encoding iliyopendekezwa ni bora katika reconstruction metric zote”. Ingawa mbinu iliyopendekezwa inaonyesha faida dhahiri katika gate-type accuracy, metric ya false-positive na KLD, thamani za Accuracyqubit na hasa Accuracyadj ni za chini kuliko GSQAS katika baadhi ya hali. Tathmini ya chanzo inafanywa kwa kuzingatia representation quality kwa ujumla na downstream search behavior.
Ingawa chanzo hutumia kauli “four metrics” katika caption ya Table 1, jedwali linaloonekana lina safu tano za metric: Accuracyops, Accuracyqubit, Accuracyadj, Falposmean na KLD. Verianla haifichi tofauti hii ya ndani ya chanzo.
Picha za PCA na t-SNE zinaonyesha nini?
Chanzo hutumia Principal Component Analysis (PCA) na t-distributed Stochastic Neighbor Embedding (t-SNE) katika Figure 2 ili kupunguza latent representation ya vipimo 16 kuwa vipimo viwili.
Rangi katika picha hizi zinaonyesha thamani za energy au fidelity zilizopatikana na circuit; lakini performance hizo si target ya unsupervised pretraining ya autoencoder. Zimewekwa juu ya uwakilishi tu baada ya mafunzo ili kuchambua jinsi latent space ilivyopangwa kwa mujibu wa utendaji.
Katika hali ya 4-qubit, usanifu wenye utendaji wa juu hujikusanya katika maeneo yenye mpangilio zaidi. Katika hali ya 12-qubit, mpangilio huu ni dhaifu zaidi kwa sababu circuit 100.000 zinawakilisha sehemu ndogo zaidi ya nafasi ya usanifu inayowezekana. Chanzo kinatafsiri hili kama kikomo cha representation-learning coverage katika nafasi kubwa zaidi za utafutaji.
Utafutaji Predictor-Free Una Maana Gani?
Utafutaji predictor-free unamaanisha kutofundisha supervised predictor tofauti inayotabiri mapema utendaji wa candidate circuit; pretrained structural encoder hufungwa, REINFORCE au Bayesian Optimization huchagua teule kutoka nafasi latent, na evaluation halisi ya kazi ya saketi teule hutumiwa tu kuzalisha reward.
REINFORCE
Chanzo kinasema kilifanya majaribio ya awali kwa PPO na A2C, lakini kilichagua mbinu ya REINFORCE kwa architecture search.
REINFORCE ni algoriti ya reinforcement-learning ya aina ya policy-gradient. Katika utafiti huu:
- state space huundwa na pretrained architecture embeddings;
- policy network hutumia LSTM yenye seli moja;
- action inalingana na uteuzi wa latent vector uliochukuliwa sampuli kutoka state distribution iliyopo;
- candidate circuit hutathminiwa kwenye kazi husika;
- fidelity au uwiano wa energy unaopatikana huingia kwenye policy update kama reward.
Reward kwa kazi za energy: Mlinganyo (9)
Chanzo hutumia convention ambayo \(E_{\mathrm{ground}}<0\) katika kazi za MaxCut na energy-minimization. Chini ya convention hii, candidate energy inapofikia ground-state energy:
huwa hivyo. Kwa \(E_{\mathrm{candidate}}=0\), reward ni 0.
Wakati wa optimization ya awali au numerical noise, ikiwa \(E_{\mathrm{candidate}}>0\), uwiano unaweza kuwa hasi. Chanzo katika hali hii hu-clip reward hadi 0.
Kwa quantum state preparation, energy ratio haitumiki; reward ni fidelity moja kwa moja.
Adaptive baseline
Ili kupunguza variance ya REINFORCE, chanzo hutumia:
adaptive baseline. \(R_{\mathrm{avg}}\) ni reward average ya awali; \(\alpha\in[0,1]\) ni smoothing coefficient. Chanzo hakitoi thamani mahususi ya numerical ya \(\alpha\) katika matini kuu ya mbinu; kwa hiyo thamani hiyo haijakadiriwa.
Kila run ina architecture search 1000.
Bayesian Optimization
Search strategy ya pili ni Bayesian Optimization inayotegemea Deep Networks for Global Optimization (DNGO).
Chanzo hutumia feed-forward basis function yenye hidden-layer moja iliyo na hidden unit 128 katika BO regression model. Expected Improvement (EI) huchaguliwa kama acquisition function.
BO huanza na sample 16. Katika kila epoch, top-k architecture embeddings zilizopendekezwa na EI huongezwa kwenye batch na model hufundishwa upya kwa epoch 100 juu ya batch iliyosasishwa.
“100 epoch” hapa si mafunzo yale yale na epoch 16 zilizotolewa kwa autoencoder pretraining. Moja ni architecture representation pretraining, na nyingine ni mafunzo ya upya ndani ya iteration ya BO search model.
Mbinu na Matokeo ya Utafiti
Utafutaji 1000 katika Nafasi ya Saketi 100.000 Una Maana Gani?
Katika kila QAS run kuu, mbinu huuliza kwenye kazi husika candidate 1000 tu kati ya search space iliyoundwa awali yenye circuit 100.000, yaani takribani asilimia moja; kwa hiyo lengo la jaribio si kuchanganua circuit zote kwa exhaustive search, bali kupima kama latent representation inaweza kuchukua sampuli kwa msongamano mkubwa zaidi katika maeneo yenye utendaji wa juu kuliko Random Search.
Kazi kuu za majaribio
Utafiti hutumia familia tatu za matumizi:
- quantum state preparation,
- MaxCut,
- energy minimization / kundi la quantum chemistry kwa istilahi ya chanzo.
Majaribio makuu ya Figure 3 na Figure 4 yalifanywa katika viwango vya 4 na 8 qubit. Katika baadhi ya sehemu za tathmini za representation-learning na encoding, 12-qubit circuits pia hutumiwa.
Quantum state preparation
Lengo la kazi ya quantum state preparation ni kuunda upya target quantum state kwa fidelity ya juu iwezekanavyo.
Chanzo huunda target state kwa kuzalisha random circuit inayolingana nayo, na hutumia mbinu ya QAS kutafuta candidate circuits zinazotoa fidelity ya juu kwa state hiyo.
Kwa kuwa fidelity inaweza kutumiwa moja kwa moja kama reward kati ya 0 na 1, energy normalization ya ziada haifanywi.
MaxCut
MaxCut ni tatizo la kugawa vertices za weighted undirected graph katika makundi mawili huku jumla ya edge weight kati ya makundi hayo mawili ikifanywa kuwa ya juu zaidi.
Utafiti hutoa Hamiltonian kutoka graph na hutumia tathmini ya energy inayotegemea VQE.
Katika Appendix A.2 chanzo hutumia:
- ground-state energy = −10 Ha kwa mfano wa 4-qubit / 4-node,
- ground-state energy = −52 Ha kwa mfano wa 8-qubit / 8-node
kama ilivyoandikwa. Kitengo “Ha” kimehifadhiwa kwa sababu chanzo kinakitoa kwa namna hiyo; Verianla hakibadilishi kimya kimya notation hii kuwa kitengo kingine.
Tofauti kati ya quantum chemistry na TFIM
Katika Appendix A.2, mifano ya molekuli imetolewa kama:
- 4-qubit H₂: takribani optimal ground-state energy = −1,136 Ha,
- 12-qubit LiH: takribani optimal ground-state energy = −7,88 Ha
.
Hata hivyo, mfano wa 8-qubit si molekuli. Chanzo kinaeleza wazi kwamba kinatumia \(n=8\) transverse-field Ising model (TFIM).
Mlinganyo (10) wa chanzo — bila kubadilishwa
\(\sigma_z^i\) huwakilisha Pauli-Z operator kwenye qubit ya \(i\); \(\sigma_x^i\) huwakilisha Pauli-X operator. Term ya kwanza inaonyesha neighboring spin coupling, na term ya pili inaonyesha mchango wa transverse-field.
Ukinzani muhimu ndani ya chanzo: Matini inasema model ni \(n=8\) na jumla inaanzia \(i=0\) hadi 7, lakini kwenye index ya jirani imeandikwa \((i+1)\bmod 6\). Usemi huu uko hivyo hivyo katika source PDF. Verianla haijakisia nje ya chanzo kama hii ni typographical error na kuibadilisha kuwa \(\bmod 8\).
Chanzo hutumia takribani optimal energy = −10 Ha kwa Hamiltonian hii.
Matokeo ya utafutaji yalilinganishwaje?
Katika Figure 3, kila plot huonyesha average reward ya run 50 huru, na kila run ina query 1000. Shaded bands huonyesha standard deviation.
Kulingana na uchunguzi wa waandishi, REINFORCE na Bayesian Optimization huongeza average reward hasa katika hatua za awali search inapoendelea ndani ya latent representation, wakati Random Search haionyeshi improvement inayofanana. Ingawa variance ya RL na BO ni juu kidogo kuliko Random Search, viwango vya average reward ni vya juu zaidi.
Candidate threshold
| Kazi | 4-qubit threshold | 8-qubit threshold |
|---|---|---|
| State preparation | 0,95 | 0,75 |
| MaxCut | 0,95 | 0,925 |
| Energy / kundi la quantum-chemistry | 0,95 | 0,95 |
Kwa hiyo si sahihi kulinganisha moja kwa moja candidate count za 4-qubit na 8-qubit kwa kuangalia idadi pekee; pamoja na task complexity, thamani za threshold pia ni tofauti.
Ufanisi wa utafutaji wa 4-qubit
| Mbinu | Task | Jumla ya tathmini | Candidate zilizopatikana \(N_{\mathrm{QAS}}\) | \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|---|---|
| GNN predictor + RL | Fidelity | 2000 | 36 | 0,0180 |
| GNN predictor + RL | MaxCut | 2000 | 783 | 0,3915 |
| GNN predictor + RL | QC-H₂ | 2000 | 278 | 0,1390 |
| GSQAS predictor + RL | Fidelity | 2000 | 37 | 0,0185 |
| GSQAS predictor + RL | MaxCut | 2000 | 785 | 0,3925 |
| GSQAS predictor + RL | QC-H₂ | 2000 | 658 | 0,3290 |
| Random Search | Fidelity | 1000 | 15 | 0,0150 |
| Random Search | MaxCut | 1000 | 568 | 0,5680 |
| Random Search | QC-H₂ | 1000 | 371 | 0,3710 |
| QAS iliyopendekezwa — REINFORCE | Fidelity | 1000 | 69 | 0,0690 |
| QAS iliyopendekezwa — REINFORCE | MaxCut | 1000 | 898 | 0,8980 |
| QAS iliyopendekezwa — REINFORCE | QC-H₂ | 1000 | 817 | 0,8170 |
| QAS iliyopendekezwa — BO | Fidelity | 1000 | 63 | 0,0630 |
| QAS iliyopendekezwa — BO | MaxCut | 1000 | 820 | 0,8200 |
| QAS iliyopendekezwa — BO | QC-H₂ | 1000 | 739 | 0,7390 |
Thamani ya \(N_{\mathrm{eval}}=2000\) katika mbinu za predictor-based inajumuisha jumla ya tathmini za labeled-circuit zinazohitajika kujenga performance predictor na tathmini zinazofanywa wakati wa search. Katika mbinu iliyopendekezwa ya predictor-free, hakuna tathmini tofauti za 1000 labeled pretraining circuit; structural pretraining haihitaji performance label na hutumia \(N_{\mathrm{eval}}=1000\) search evaluation.
Jedwali hili linaonyesha kwamba mbinu inaweza kuchukua sampuli kwa msongamano mkubwa zaidi katika high-performing regions, hasa katika kazi za MaxCut na H₂ energy. Hata hivyo, task-specific threshold na search-space composition ndio muktadha wa matokeo; thamani hizi si QAS efficiency constants za ulimwengu wote.
Je, matokeo huboreka kila mara encoding inapobadilishwa?
| Jaribio | GSQAS encoding \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) | Encoding iliyopendekezwa \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|
| GSQAS — 4 | 0,3125 | 0,3290 |
| GSQAS — 12 | 0,1415 | 0,1380 |
| QAS-RL — 4 | 0,7600 | 0,8170 |
| QAS-RL — 8 | 0,1600 | 0,1670 |
| QAS-RL — 12 | 0,4220 | 0,3920 |
Matokeo haya yanaweka mpaka muhimu wa tafsiri. Ingawa encoding mpya ina faida katika mifano mingi ya 4 na 8-qubit, iko nyuma ya GSQAS encoding katika ulinganisho miwili wa 12-qubit. Chanzo pia kinajadili kutowakilishwa vya kutosha kwa 12-qubit search space kwa circuit 100.000 kama sababu inayowezekana.
Ablation ya latent dimension na GIN depth
| Latent \(d_z\) | GIN depth \(L\) | VAE loss | Average reward RL | Average reward BO |
|---|---|---|---|---|
| 8 | 5 | 0,11 | 0,95 ± 0,001 | 0,89 ± 0,030 |
| 16 | 5 | 0,09 | 0,98 ± 0,006 | 0,93 ± 0,013 |
| 32 | 5 | 0,14 | 0,975 ± 0,009 | 0,92 ± 0,017 |
| 16 | 3 | 0,10 | 0,95 ± 0,013 | 0,93 ± 0,021 |
| 16 | 7 | 0,09 | 0,97 ± 0,010 | 0,92 ± 0,022 |
Matokeo ya ablation yametolewa kama mean ± standard deviation juu ya random seed 10. Ingawa VAE reconstruction objective ni nyeti kwa hyperparameter, downstream QAS reward hubadilika kwa kiwango kidogo zaidi. Chaguo la default la chanzo ni \(d_z=16\), \(L=5\).
Matokeo ya %100 kwenye IBM ibm_sherbrooke Yana Maana Gani?
Matokeo ya %100 ya chanzo yanamaanisha kwamba circuit mbili tu za MaxCut zilizochaguliwa na QAS — tatizo la 4-node na 8-node — zilipoendeshwa kwenye ibm_sherbrooke kwa shot 10.000 kila moja bila kubadilisha parameter zilizofundishwa kwenye simulator, optimal bitstring iliripotiwa katika vipimo vyote; matokeo haya hayaonyeshi kwamba kazi za state-preparation au chemistry/TFIM zilifikia mafanikio sawa kwenye hardware halisi, wala kwamba mbinu hutoa quantum advantage ya jumla.
Itifaki ya majaribio ya hardware halisi
- Best-performing circuit ilichaguliwa kwa QAS kwa 4-node na 8-node MaxCut.
- Trainable parameters za circuit hizi zili-optimize kwenye noise-free simulator.
- Parameter set hiyo hiyo ilihamishwa kwenda kifaa halisi cha ibm_sherbrooke.
- Chanzo kinaeleza kwamba hakuna hardware-specific parameter re-tuning iliyofanywa.
- Kila hali iliendeshwa kwa measurement shot 10.000.
| Metriki | Simulator ya 4-node | Kifaa halisi cha 4-node | Simulator ya 8-node | Kifaa halisi cha 8-node |
|---|---|---|---|---|
| Uwezekano wa optimal bitstring | %100,0 | %100,0 | %100,0 | %100,0 |
| Average cut value | 4 | 4 | 12 | 12 |
| Shot | 10.000 | 10.000 | 10.000 | 10.000 |
| Noise model | Noise-free | Physical NISQ | Noise-free | Physical NISQ |
| Device | Simulator | ibm_sherbrooke | Simulator | ibm_sherbrooke |
Chanzo hakiripoti confidence interval tofauti. Kwa hiyo Verianla haifanyi generalization ya kitakwimu kama “uwezekano halisi wa mafanikio ni 1,000000 kwa uhakika”; inaeleza tu matokeo yaliyoonekana kwa repeated shot 10.000 na kuripotiwa kama %100,0 katika Table 4 ya chanzo.
Je, matokeo haya ni quantum advantage?
Hapana. Swali la utafiti si kuishinda classical computer dhidi ya quantum computer kwa speed au complexity. Search framework hutumia kwa kiasi kikubwa classical machine learning na noise-free quantum simulation; jaribio la hardware halisi linajaribu transferability ya candidate circuits zilizochaguliwa.
Kwa hiyo kauli inayoungwa mkono na utafiti ni kwamba “circuit mbili za MaxCut zilizopatikana zimehamishwa kwa mafanikio kwenda kifaa halisi cha NISQ bila parameter re-tuning”. Hitimisho la “QAS imezidi classical computing” au “quantum advantage imeonyeshwa” halijajaribiwa na chanzo.
Nguvu za utafiti
- Architecture representation learning na task-specific search zimetenganishwa.
- Pretraining haihitaji performance labels au VQA evaluations.
- Control/target role na multi-qubit edge importance zinawakilishwa wazi zaidi kuliko encoding ya awali.
- Pretrained representation hiyo hiyo inaweza kutumiwa kwa downstream tasks tofauti.
- REINFORCE na BO zinaweza kutumika kwenye latent space hiyo hiyo.
- Search performance imetathminiwa si katika matumizi moja tu bali pia katika state preparation, MaxCut na kazi za energy-based.
- Search curves kuu zimetathminiwa juu ya independent run 50.
- Ablation tofauti imefanywa kwa latent dimension na GIN depth.
- Best MaxCut circuits zimejaribiwa moja kwa moja kwenye hardware halisi ya IBM.
Vikwazo vya utafiti
Search-space coverage: Ingawa circuit 100.000 zinaweza kutoa sampuli tajiri katika tatizo la 4-qubit, zinaweza kufunika sehemu ndogo sana ya possible architecture space yote ya 12-qubit. Chanzo kinahusisha clustering dhaifu zaidi katika 12-qubit latent representation na kikomo hiki.
Utegemezi wa operation-pool: Model hutafuta tu ndani ya gate set na structural constraints zinazoruhusiwa na circuit generator ya mwanzo.
Wigo wa hardware validation: Hardware halisi imetumiwa tu kwa best circuits za 4-node na 8-node MaxCut; real-device validation hiyo hiyo haijaripotiwa kwa state preparation na kazi za energy.
Uthibitishaji wa circuit zilizochaguliwa: Hardware test haijaribu candidate distribution yote, bali circuit bora zilizochaguliwa na search.
Generalization ya noise-model: Majaribio makuu ya search yalifanywa kwenye noise-free simulator. QAS objective haiku-optimize moja kwa moja kama hardware noise-aware search.
Scalability: Matokeo ya 12-qubit yanaonyesha kwamba kunaweza kuwa na kuzorota katika representation coverage na downstream search performance. Kwa hiyo mbinu haitoi dhamana kiotomatiki ya efficiency ile ile kwa circuit kubwa zaidi.
Predictor-free ≠ evaluation-free: Ingawa predictor tofauti na labeled pretraining hazihitajiki, candidate VQA evaluation bado inahitajika kwa reward; tathmini ghali ya kazi haiondolewi kabisa.
Matokeo yanayoungwa mkono na utafiti
Chanzo kinaunga mkono kwamba kubadilisha circuit structure kuwa latent representation iliyojifunzwa bila usimamizi kunaweza kuwa na manufaa kwa QAS, na kwamba REINFORCE/BO zinaweza kutoa high-performing candidate discovery yenye ufanisi zaidi kuliko Random Search ndani ya latent space hii.
Encoding iliyopendekezwa huwakilisha kwa uwazi zaidi taarifa mahususi za circuit kama control-target role na interaction weight, na hutoa faida katika metric nyingi na downstream search condition.
Katika mifano ya 4-qubit, latent representation imeonyeshwa kuwa inaweza kujikusanya kwa mpangilio kulingana na performance structure; performance label si training target ya representation hii.
Imeonyeshwa kwamba 4-node na 8-node MaxCut circuits zilizochaguliwa zilihifadhi optimal output iliyoripotiwa na chanzo kwenye ibm_sherbrooke kwa simulator-trained parameters bila tuning upya.
Matokeo ambayo utafiti hauungi mkono
Utafiti hauthibitishi kwamba encoding mpya ndiyo bora katika matatizo yote ya quantum circuit architecture search. Katika baadhi ya ulinganisho wa 12-qubit, matokeo yanaunga mkono encoding ya zamani.
Utafiti hauonyeshi kwamba mbinu ya predictor-free huondoa kabisa hitaji la quantum circuit evaluation.
Utafiti hauonyeshi kwamba circuit zote zilizopatikana zinastahimili hardware noise halisi.
Utafiti hauhakiki kazi za state preparation, H₂, LiH au TFIM kwenye ibm_sherbrooke kwa itifaki ile ile ya hardware test.
Utafiti hauonyeshi fault-tolerant quantum computing; kifaa halisi kilichotumika ni kifaa cha NISQ.
Utafiti hauthibitishi quantum computational advantage au classical speedup.
Utafiti hauonyeshi kwamba sampuli ya circuit 100.000 inawakilisha kikamilifu 12-qubit au circuit spaces kubwa zaidi.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Quantum Architecture Search with Unsupervised Representation Learning
Waandishi: Yize Sun, Zixin Wu, Volker Tresp, Yunpu Ma.
Mchango sawa: Yize Sun na Zixin Wu.
Mwandishi wa mawasiliano: Yunpu Ma.
Barua pepe ya mawasiliano iliyotolewa kwenye chanzo: cognitive.yunpu@gmail.com
Taasisi 1: Ludwig-Maximilians-University Munich, Munich, Germany.
Taasisi 2: Siemens AG, Munich, Germany.
Taasisi 3: MCML — Munich Center for Machine Learning, Munich, Germany.
Aina ya chanzo: Makala ya journal iliyopitiwa na rika.
Jarida: Quantum.
Juzuu: 10.
Nambari ya makala/ukurasa: 1994.
Tarehe ya kuchapishwa: 3 Februari 2026.
Tarehe ya kukubaliwa: 23 Januari 2026.
DOI: 10.22331/q-2026-02-03-1994.
Eprint: arXiv:2401.11576v6 [quant-ph], 25 Januari 2026.
Mchapishaji: Verein zur Förderung des Open Access Publizierens in den Quantenwissenschaften.
Mhariri: Jiangwei Shang.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Aina ya utafiti wa kisayansi: Utafiti wa mbinu katika ujifunzaji wa mashine wa kwanta / quantum architecture search; unajumuisha graph representation learning, reinforcement learning, Bayesian optimization, noise-free quantum simulation na hardware evaluation halisi ya NISQ iliyo na wigo mdogo.
Search space: Circuit 100.000 kwa random generator.
Operation pool: X, Y, Z, H, Rx, Ry, Rz, U3, CNOT, CZ, CY.
Circuit generator: 4 / 8 / 12 qubit; gate 10 / 20 / 30 mtawalia; maximum depth 5.
Representation model: GIN-based variational graph autoencoder.
GIN layer: 5.
Latent dimension: 16.
Hidden dimension: 128.
Pretraining: Epoch 16; batch size 32; dropout 0,1; structure-only \(A,X\) input; performance label haitumiki.
Search algorithms: REINFORCE na Bayesian Optimization inayotegemea DNGO.
Search budget: Query 1000 kwa kila run kuu.
Marudio makuu ya utendaji: Independent run / random seed 50 kwa Figure 3 na Figure 4.
Marudio ya ablation: Random seed 10 kwa Table 6.
Kifaa halisi cha kwanta: IBM ibm_sherbrooke.
Wigo wa test ya hardware halisi: Circuit zilizochaguliwa tu za 4-node na 8-node MaxCut.
Idadi ya hardware shot: 10.000 kwa kila hali.
Hardware parameter transfer: Parameter zilifundishwa kwenye noise-free simulator na kuhamishwa kwenda kifaa halisi bila re-tuning.
Matokeo ya hardware: Table 4 ya chanzo inaripoti %100,0 optimal-bitstring probability kwa 4-node na 8-node MaxCut kwenye simulator na kifaa halisi; confidence interval tofauti haijatolewa.
Dokezo la Mlinganyo (10) ndani ya chanzo: Wakati matini inaeleza TFIM ya \(n=8\), inaandika index ya jirani kama \((i+1)\bmod6\). Verianla haijabadilisha formula na imeacha ukinzani huu uonekane.
Dokezo la jina la matumizi ndani ya chanzo: Ingawa jaribio la 8-qubit linajadiliwa ndani ya kundi la majaribio la “quantum chemistry”, model ya kimwili iliyotumiwa katika Appendix A.2 si molekuli bali TFIM. H₂ ni mfano wa molecular wa 4-qubit, na LiH ni wa 12-qubit.
Dokezo la metric-caption ndani ya chanzo: Caption ya Table 1 inasema “four metrics”, ilhali jedwali lina safu tano za metric.
Ufadhili: Quantum Reinforcement Learning for Industrial Applications (QLindA), nambari ya mradi 13N15644, na German Federal Ministry of Education and Research; pia Quantum-Classical Hybrid Optimization Algorithms for Logistics and Production Line Management (QCHALLenge), nambari ya mradi 01MQ22008B, na Federal Ministry for Economic Affairs and Climate Action.
Taarifa ya matumizi ya AI: Sehemu ya acknowledgments ya chanzo inaeleza kwamba baadhi ya sehemu za manuscript ziliundwa kwa msaada wa OpenAI ChatGPT-4 kwa madhumuni ya drafting na language refinement, na kwamba waandishi wanawajibika kwa maudhui.
Upatikanaji wa data: Katika makala ya kurasa 20 iliyotolewa, sehemu huru ya “Data Availability” haijatambuliwa. Anwani ya repository au dataset ambayo haipo kwenye chanzo haijaongezwa.
Code availability: Katika PDF iliyotolewa, taarifa huru ya “Code Availability” haijatambuliwa.
Mgongano wa maslahi: Katika PDF iliyotolewa, taarifa tofauti ya competing-interest/conflict-of-interest haijatambuliwa; kwa hiyo dhana ya nje ya chanzo kwamba “hakuna mgongano wa maslahi” haijawekwa.
Michango ya waandishi: Katika PDF iliyotolewa, sehemu tofauti ya CRediT author-contribution haijatambuliwa; imeelezwa wazi tu kwamba Yize Sun na Zixin Wu walichangia kwa usawa.
Mpaka mkuu wa tafsiri: Utafiti unatoa ushahidi kuhusu efficient architecture search na selected-circuit hardware transfer; hauonyeshi fault tolerance, general hardware robustness au quantum advantage.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *