


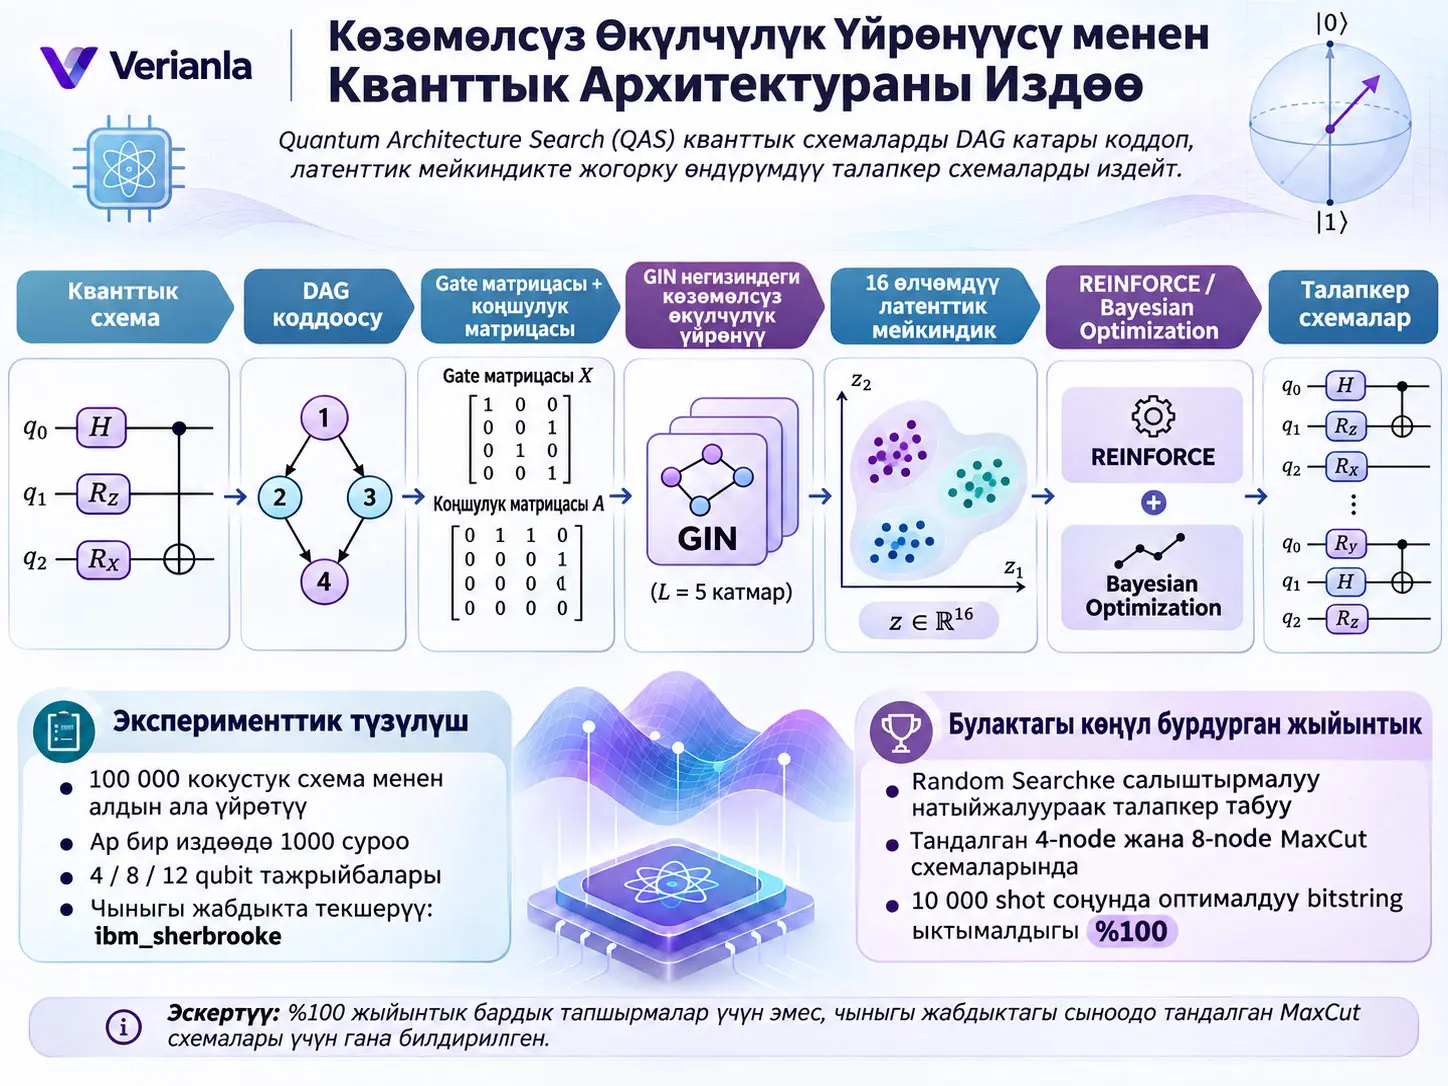
Көзөмөлсүз өкүлчүлүк үйрөнүүсү менен Кванттык Архитектураны Издөө (Quantum Architecture Search, QAS) — параметрдик кванттык схемалардын түзүлүшүн өндүрүмдүүлүк энбелгисин колдонбостон төмөн өлчөмдүү жана үзгүлтүксүз латенттик мейкиндикте көрсөткөн, андан кийин бул латенттик мейкиндикти REINFORCE же Bayesian Optimization аркылуу изилдеп, жогорку өндүрүмдүү талапкер схемаларды табууну көздөгөн predictor-free кванттык схема долбоорлоо алкагы. Изилдөөдө кванттык схема адегенде багытталган циклсиз граф (Directed Acyclic Graph, DAG) катары коддолот, gate түрлөрү жана qubit ролдору өзүнчө белгилер менен көрсөтүлөт, Graph Isomorphism Network (GIN) негизиндеги variational graph autoencoder кокус түзүлгөн 100.000 схеманын түзүмдүк маалыматын гана колдонуп 16 өлчөмдүү латенттик өкүлчүлүктү үйрөнөт, андан кийин издөө алгоритмдери ушул мейкиндиктен талапкер архитектураларды тандайт.
Изилдөөнүн негизги жаңылыгы кванттык схема түзүлүшүнүн өкүлчүлүгүн өндүрүмдүүлүккө багытталган издөө процессинен ажыратуусунда. Predictor-based QAS ыкмалары көп сандагы схемаларды алдын ала баалоону жана ошол жыйынтыктар менен өзүнчө өндүрүмдүүлүк болжолдоочусун үйрөтүүнү талап кылышы мүмкүн. Бул изилдөөдө алдын ала окутуу баскычында схема өндүрүмдүүлүгү, VQA энергиясы же fidelity энбелгиси колдонулбайт. Бирок “predictor-free” деген сөз “баалоосуз” дегенди билдирбейт: издөө учурунда REINFORCE же Bayesian Optimization сунуштаган талапкер схемалар reward эсептөө үчүн тапшырманын өзүндө чындап бааланат.
Негизги издөө эксперименттери quantum state preparation, MaxCut жана булакта “quantum chemistry” деген аталыш менен берилген энергияны-минималдаштыруу тапшырмаларында 4 жана 8 qubit деңгээлинде жүргүзүлгөн. Ар бир экспериментте издөө мейкиндиги 100.000 схемадан турган, ар бир run болгону 1000 search query колдонгон жана негизги өндүрүмдүүлүк салыштыруулары 50 көз карандысыз random seed боюнча аткарылган. REINFORCE жана Bayesian Optimization, айрыкча 4-qubit эксперименттеринде, Random Searchке караганда көбүрөөк жогорку өндүрүмдүү талапкер схема тапкан; бирок ыкма бардык масштабдарда жана бардык метрикаларда атаандаш өкүлчүлүктөн абсолюттук түрдө артык эмес. Мисалы, 12-qubit encoding салыштырууларынын айрымдары азыркы GSQAS encoding пайдасына жыйынтыкталат.
Чыныгы кванттык жабдыкта текшерүү тандалган MaxCut мисалдарында гана жүргүзүлгөн. 4-node жана 8-node MaxCut үчүн издөөдөн табылган эң мыкты схемалардын параметрлери ызы-чуусуз симулятордо үйрөтүлүп, андан кийин ошол эле параметрлер кайра оптималдаштырылбастан IBMдин ibm_sherbrooke NISQ түзмөгүндө иштетилген. Булак ар бир маселе үчүн 10.000 shot соңунда %100,0 optimal bitstring ыктымалдыгын билдирет. Бул жыйынтык тандалган эки MaxCut схемасынын өткөрүлүшүн ырастайт; бардык QAS тапшырмалары, бардык схемалар же бардык NISQ ызы-чуу шарттары %100 ийгилик менен чечилди дегенди билдирбейт.
Изилдөө ошондой эле маанилүү масштабдалуу чегин көрсөтөт. 4-qubit латенттик өкүлчүлүктөр компакттуу жана өндүрүмдүүлүк боюнча тартиптүүрөөк топтолсо, 12-qubit мейкиндикте 100.000 схемалык үлгү мүмкүн болгон архитектуралардын кыйла аз бөлүгүн камтыгандыктан жогорку өндүрүмдүү схемалардын латенттик уюшулушу алсырайт. Демек, ыкма издөө чыгымын азайтуу жана чоң энбелгилүү маалымат топтомуна болгон муктаждыкты жоюу жагынан артыкчылык бергени менен, чоңураак кванттык схемаларга масштабдоо маселеси чечилген эмес.
Кванттык Архитектураны Издөө (QAS) Деген Эмне?
Кванттык Архитектураны Издөө (Quantum Architecture Search, QAS) — белгилүү бир кванттык эсептөө тапшырмасы үчүн кайсы gate-тер кайсы qubit-терде жана кандай байланыш/ырааттуулук түзүлүшүндө колдонуларын автоматтык же жарым-жартылай автоматтык изилдеген схема-архитектураны оптималдаштыруу ыкмасы; бул изилдөөдө QAS схемалардын дискреттик комбинатордук мейкиндигин түздөн-түз издөөнүн ордуна адегенде үйрөнүлгөн үзгүлтүксүз латенттик өкүлчүлүк мейкиндигин изилдейт.
Кванттык схема архитектурасы эмне үчүн маанилүү?
Variational Quantum Algorithm (VQA) — параметрдик кванттык схеманы классикалык optimizer менен бирге колдонгон гибриддик кванттык-классикалык алгоритмдердин үй-бүлөсү. Параметрдик кванттык схема, Parameterized Quantum Circuit (PQC), белгилүү gate бурчтары же башка gate параметрлери үйрөтүлө турган кванттык схема.
VQA ичинде gate параметрлеринин мааниси гана эмес, схеманын архитектурасы да маанилүү. Эки схема бирдей qubit санына ээ болсо да, gate түрлөрү, gate ырааты, эки-qubit байланыштары жана circuit depth айырмаланса, expressibility, entangling capability, оптималдаштыруу жүрүм-туруму жана ызы-чууга сезгичтик өзгөрүшү мүмкүн.
Ошондуктан эки өзүнчө оптималдаштыруу маселеси бар:
- Параметр оптималдаштыруу: Тандалган схеманын \(R_x\), \(R_y\), \(R_z\), \(U3\) сыяктуу параметрдик gate бурчтарын жөндөө.
- Архитектура оптималдаштыруу: Кайсы gate-тер, кандай ыраатта жана кайсы qubit байланыштары менен колдонуларын тандоо.
QAS экинчи маселени көздөйт. Бирок архитектура мейкиндиги дискреттик жана комбинатордук болгондуктан, мүмкүн болгон схемалардын саны qubit жана gate саны менен өтө тез өсүшү мүмкүн.
NISQ деген эмне?
Noisy Intermediate-Scale Quantum (NISQ) — fault-tolerant quantum error correction бүт эсептөө бою толук колдонулбай турган, бирок белгилүү сандагы физикалык qubit жана gate менен чыныгы кванттык эсептөөлөр аткарыла турган ызы-чуулуу орто этаптагы кванттык түзмөктөрдү сүрөттөйт.
Бул изилдөөнүн мотивациясында NISQ маанилүү; анткени узунураак, керексиз gate-терди камтыган же начар түзүмдөлгөн параметрдик схемалар идеалдуу симулятордо иштесе да, чыныгы түзмөктө decoherence жана gate noise айынан өндүрүмдүүлүгүн жоготушу мүмкүн. Ошондуктан QASтын максаты математикалык жактан жогорку туюнтуу жөндөмүнө ээ гана эмес, тапшырма үчүн натыйжалуу схема түзүлүштөрүн да табуу.
Barren plateau деген эмне?
Barren plateau — айрым variational quantum circuit-терде оптималдаштыруу landscapeинин чоң аймактарында gradient маанилери өтө кичине болуп калуучу көйгөй. Gradient дээрлик нөл болгондо классикалык optimizer кайсы параметр багытында жылыш керектигин аныктоодо кыйналышы мүмкүн.
Булак barren plateauну QAS мотивацияларынын бири катары берет; бирок сунушталган ыкма barren plateau көйгөйүн математикалык түрдө жок кылат деп ырастабайт. Изилдөө түз өлчөгөн нерсе — схема архитектурасын издөө өндүрүмдүүлүгү.
Кванттык Схема Эмне Үчүн Багытталган Циклсиз Граф (DAG) Катары Коддолот?
Изилдөө кванттык схемадагы ар бир gateти граф түйүнү, ошол эле qubitте убакыт ырааты боюнча бири-бирин ээрчиген gate көз карандылыктарын багытталган кырлар катары көрсөтөт; START жана END түйүндөрү да кошулуп, схема багытталган циклсиз графка айландырылат жана ушинтип GIN негизиндеги graph representation learning схеманын gate түрүн, qubit ордун жана байланыш топологиясын бирге иштете алат.
DAG деген эмне?
Directed Acyclic Graph (DAG) — кырлары багытталган, бирок баштапкы чекитке кайра кайта турган directed cycle камтыбаган граф. Кванттык схемада gateтердин убакыт ырааты табигый түрдө алдыга багытталган dependency мамилесин түзгөндүктөн DAG көрсөтмөсү ылайыктуу.
Булакта \(m\) gate түрү, \(h\) gate жана \(g\) qubit камтыган схема:
графы менен көрсөтүлөт. START жана END кошкондогу түйүндөрдүн саны:
болот.
Бул граф үчүн бири-бирин толуктаган эки матрица түзүлөт:
- Adjacency matrix \(A\): \(n\times n\) өлчөмүндөгү түзүмдүк байланыш матрицасы.
- Gate matrix \(X\): \(n\times(m+2+g)\) өлчөмүндөгү gate жана qubit-рол өзгөчөлүк матрицасы.
\(A_{ij}=1\), node \(i\)ден node \(j\)ге directed edge бар экенин; \(A_{ij}=0\) мындай байланыш жок экенин көрсөтөт.
Мурунку encoding ыкмасында кайсы маалымат жоголчу?
Булак салыштырган мурдагы EGSQAS encoding эки-qubit gate ичиндеги control жана target qubit ролдорун жетиштүү айырмалабаган. Мисалы, CNOT gateинде control qubit менен target qubit физикалык жактан бирдей роль аткарбайт; бул айырма жоголгондо эки башка схема түзүмдүк жактан бири-бирине өтө окшош көрсөтүлүшү мүмкүн.
Сунушталган encoding бул көйгөйдү эки жол менен чечет:
- Эки-qubit gate үчүн control qubit тиешелүү сапта −1, target qubit +1 менен коддолот.
- Adjacency matrix ичиндеги edge weight операцияга катышкан qubit саны менен байланыштуу болот; мисалы, эки-qubit gate үчүн weight 2 колдонулат.
Ошентип, модель “кайсы gate бар?” деген маалыматты гана эмес, gateтин qubit системасындагы операциялык ролун да көрөт.
Көзөмөлсүз Өкүлчүлүк Үйрөнүү Бул Изилдөөдө Эмнени Үйрөнөт?
Көзөмөлсүз алдын ала окутуу схеманын MaxCut, state preparation же энергияны-минималдаштыруу тапшырмасында канчалык жакшы жыйынтык берерин үйрөнбөйт; ал болгону \(A\) adjacency matrix жана \(X\) gate/qubit feature matrixтен схемалардын түзүмдүк өзгөчөлүктөрүн кысылган латенттик өзгөрмөлөргө айландырууну жана ушул түзүмдүк маалыматтан схема графын кайра курууну үйрөнөт.
Variational posterior: Теңдеме (1)
\(Z\) — latent representation жыйындысы. \(z_i\) — латенттик өзгөрмө; \(\mu_i\) — бул өзгөрмөнүн Gaussian posterior meanи; \(\sigma_i\) — standard deviation параметри. \(\operatorname{diag}(\sigma_i^2)\) diagonal covariance божомолун билдирет.
Бул теңдеме кванттык state wavefunction теңдемеси эмес. \(Z\) — классикалык machine-learning модели үйрөнгөн латенттик өзгөрмө.
Reparameterization trick
Модель латенттик өзгөрмөнү:
түрүндө үлгүлөйт. Бул жазылыш кокус үлгүлөө операциясын \(\mu_i\) жана \(\sigma_i\) аркылуу differentiable окутуу агымына байланыш үчүн колдонулат.
GIN message passing: Теңдеме (2)
\(M^{(s)}\) — GINдин \(s\). message-passing layerындагы node embedding матрицасы. Баштапкы абал:
\(\hat A\) булакта:
деп аныкталат. Баштапкы circuit graph directed болгону менен GIN message passing учурунда adjacency symmetrize кылынат; мунун аркасында байланышкан gateтердин ортосунда эки багыттуу feature aggregation жүргүзүлүшү мүмкүн.
\((1+\epsilon^{(s)})M^{(s-1)}\) мүчөсү nodeдун өзүнүн мурунку өкүлчүлүгүн сактаган үйрөнүлүүчү self-loop салымы. \(\hat A M^{(s-1)}\) коңшу gate маалыматтарын топтойт. \(\operatorname{MLP}^{(s)}\) болсо топтолгон маалыматты nonlinear embeddingге айлантат.
Изилдөөдө бардык негизги эксперименттерде:
- GIN layer саны \(L=5\),
- hidden dimension = 128,
- latent dimension = 16
колдонулган.
Fusion layer эмне кылат?
Модель акыркы GIN layer чыгышына гана таянбастан, ар башка GIN катмарларынан келген өкүлчүлүктөрдү бириктирген fusion layer колдонот. Максат терең катмардагы абстракттуу өкүлчүлүктү гана эмес, эртерээк катмарлардагы жергиликтүү gate/connectivity маалыматын да latent representationга өткөрүү.
Decoder кайсы маалыматтарды кайра түзөт?
Decoder латенттик \(Z\)ден adjacency matrix \(A\)ны да, gate matrix:
түзүлүшүн да кайра түзүүгө аракет кылат. \(X^t\) gate type one-hot маалыматын, \(X^q\) gate кайсы qubitтерде иштей турганын коддогон позиция маалыматын алып жүрөт.
Теңдеме (3): Adjacency reconstruction
Бул factorization reconstructed graph ичиндеги edge маалыматын латенттик node жуптарынан түзүү модели.
Теңдеме (4)
Булак бул туюнтманы \(\operatorname{ReLU}_j\) нотациясы менен берет жана \(\operatorname{ReLU}_j\) үчүн өзүнчө кеңири математикалык аныктама бербейт. Ошондуктан көрсөтүү унчукпай башка activation же probability functionга алмаштырылган эмес. \(F_1\) булакта trainable linear function катары көрсөтүлөт.
Теңдеме (5)–(7): Gate matrix reconstruction
Softmax gate type категориясын, \(\tanh\) болсо qubit-position encodingдин үзгүлтүксүз чыгышын түзүү үчүн колдонулат. Булак Теңдеме (6) жана (7)де эки чыгыш үчүн тең \(F_2\) белгисин колдонот жана андан соң \(F_1\) менен \(F_2\) trainable linear functions экенин айтат. Verianla бул нотацияны божомол менен \(F_3\) сыяктуу башка белгиге өзгөрткөн эмес.
ELBO: Теңдеме (8)
Evidence Lower Bound (ELBO) — variational autoencoder окутуу максаты. Биринчи мүчө латенттик representationдан баштапкы circuit structure канчалык жакшы кайра түзүлөрүн сыйлайт. Экинчи мүчө posterior \(q(Z\mid X,A)\) менен prior \(p(Z)\) ортосундагы Kullback–Leibler divergenceты жазалайт.
Булак priorду:
деп тандайт. Бул regularization латенттик мейкиндиктин чачыранды жана үзүл-кесил lookup table ордуна тартиптүүрөөк probabilistic representation болушуна түрткү берет.
Pretraining minibatch gradient descent менен жана batch size 32 колдонулуп жүргүзүлгөн.
Алдын ала окутуу гиперпараметрлери
| Параметр | Маани | Мааниси |
|---|---|---|
| Qubit саны | 4 / 8 / 12 | Эксперимент/өкүлчүлүк масштабдары |
| Gate саны | 10 / 20 / 30 | Тиешелүүлүгүнө жараша 4 / 8 / 12 qubit circuit generator жөндөөсү |
| Maximum circuit depth | 5 | Түзүлгөн схема тереңдигинин жогорку чеги |
| Circuit саны | 100.000 | Randomly generated search / representation space |
| Batch size | 32 | Pretraining minibatch өлчөмү |
| Pretraining epoch | 16 | Autoencoder алдын ала окутуу epoch саны |
| Dropout | 0,1 | Decoder implicit regularization |
| Input normalization | True | Input normalization колдонулат |
| Input dimension | 2 + #gates + #qubits | Gate/qubit өзгөчөлүк өлчөмү |
| Hidden dimension | 128 | GIN hidden representation |
| Latent dimension | 16 | Үйрөнүлгөн үзгүлтүксүз латенттик мейкиндик |
| GIN layer | 5 | Message-passing depth |
| MLP layer | 2 | GIN ичиндеги MLP тереңдиги |
Operation pool
Random circuit generator төмөнкү gate топтомун колдонот:
Бул топтомдун тандалышы маанилүү. Search algorithm generator түзө алган схемаларды гана таба алат. Operation poolдо белгилүү gate familyлер жок болсо, QAS кийинчерээк ошол жетишпеген архитектураларды “ойлоп таба” албайт. Ошондуктан изилдөөнүн жыйынтыктары аныкталган circuit search space контекстинде бааланышы керек.
Pretraining өндүрүмдүүлүк метрикалары эмнени өлчөйт?
Булак беш өзүнчө metric колдонот:
- Accuracyops: gate type reconstruction тактыгы.
- Accuracyqubit: gate кайсы qubitтерде иштей турганын кайра түзүү тактыгы.
- Accuracyadj: adjacency matrix reconstruction тактыгы.
- Falposmean: reconstructed adjacency matrixтеги mean false-positive көлөмү.
- KLD: latent representationдын continuity/smoothness баалоосунда колдонулган KL-divergence метрикасы.
| Qubit | Encoding | Accuracy ops | Accuracy qubit | Accuracy adj | Falpos mean | KLD |
|---|---|---|---|---|---|---|
| 4 | GSQAS | 99,99 | 99,99 | 99,91 | 100,00 | 0,061 |
| 4 | Сунушталган | 100 | 99,97 | 98,89 | 23,41 | 0,045 |
| 8 | GSQAS | 86,69 | 99,98 | 99,82 | 100,00 | 0,038 |
| 8 | Сунушталган | 100 | 98,65 | 97,34 | 7,35 | 0,029 |
| 12 | GSQAS | 86,69 | 99,94 | 99,70 | 100,00 | 0,028 |
| 12 | Сунушталган | 98,67 | 99,14 | 97,79 | 4,75 | 0,022 |
Бул таблицаны “сунушталган encoding бардык reconstruction metricтеринде жакшы” деп окуу туура эмес. Сунушталган ыкма gate-type accuracy, false-positive метрикасы жана KLD боюнча ачык артыкчылыктарды көрсөтсө да, Accuracyqubit жана өзгөчө Accuracyadj маанилери айрым учурларда GSQASтан төмөн. Булактын баалоосу жалпы representation quality жана downstream search behavior аркылуу жүргүзүлөт.
Булак Table 1 captionында “four metrics” деп жазганы менен, көрүнгөн таблицада Accuracyops, Accuracyqubit, Accuracyadj, Falposmean жана KLD болуп беш metric мамычасы бар. Verianla булак ичиндеги бул айырманы жашырбайт.
PCA жана t-SNE визуалдары эмнени көрсөтөт?
Булак Figure 2де 16-өлчөмдүү latent representationды эки өлчөмгө түшүрүү үчүн Principal Component Analysis (PCA) жана t-distributed Stochastic Neighbor Embedding (t-SNE) колдонот.
Бул визуалдардагы түстөр circuitтер алган energy же fidelity маанилерин көрсөтөт; бирок бул performance маанилери autoencoderдын unsupervised pretraining targetы эмес. Алар окутуудан кийин latent space өндүрүмдүүлүк боюнча кантип уюшулганын талдоо үчүн гана үстүнө түшүрүлгөн.
4-qubit учурда жогорку өндүрүмдүү архитектуралар тартиптүүрөөк аймактарда топтолот. 12-qubit учурда болсо 100.000 circuit мүмкүн болгон архитектура мейкиндигинин кичирээк бөлүгүн көрсөткөндүктөн, бул тартип алсызыраак. Булак муну чоңураак издөө мейкиндиктериндеги representation-learning coverage чеги катары чечмелейт.
Predictor-Free Издөө Деген Эмне?
Predictor-free издөө candidate circuit өндүрүмдүүлүгүн алдын ала божомолдогон өзүнчө supervised predictor үйрөтпөө дегенди билдирет; pretrained structural encoder туруктуу кармалат, REINFORCE же Bayesian Optimization латенттик мейкиндиктен талапкер тандайт жана талапкер схеманын чыныгы тапшырма evaluationы reward чыгаруу үчүн гана колдонулат.
REINFORCE
Булак PPO жана A2C менен баштапкы сыноолорду жүргүзгөнүн, бирок architecture search үчүн REINFORCE ыкмасын тандаганын билдирет.
REINFORCE — policy-gradient түрүндөгү бекемдөөчү үйрөнүү алгоритми. Бул изилдөөдө:
- state space pretrained architecture embeddingsтен турат;
- policy network бир уячалуу LSTM колдонот;
- action учурдагы state distributionдан үлгү алынган latent vector тандоосуна туура келет;
- candidate circuit тапшырмада бааланат;
- алынган fidelity же энергия катышы reward катары policy updateке кирет.
Энергия тапшырмалары үчүн reward: Теңдеме (9)
Булак MaxCut жана энергияны-минималдаштыруу тапшырмаларында \(E_{\mathrm{ground}}<0\) боло турган convention колдонот. Бул conventionда талапкер энергия ground-state energyге жеткенде:
болот. \(E_{\mathrm{candidate}}=0\) үчүн reward 0.
Эрте оптималдаштыруу же numerical noise маалында \(E_{\mathrm{candidate}}>0\) болсо катыш терс чыгышы мүмкүн. Булак мындай учурда rewardду 0гө clip кылат.
Quantum state preparation үчүн energy ratio колдонулбайт; reward түздөн-түз fidelity.
Adaptive baseline
REINFORCE varianceсын азайтуу үчүн булак:
adaptive baseline колдонот. \(R_{\mathrm{avg}}\) — мурдагы reward average; \(\alpha\in[0,1]\) — smoothing coefficient. Булак негизги ыкма текстинде \(\alpha\)нын так numerical маанисин бербейт; ошондуктан маани божомолдонгон эмес.
Ар бир run 1000 architecture search камтыйт.
Bayesian Optimization
Экинчи search strategy — Deep Networks for Global Optimization (DNGO) негизиндеги Bayesian Optimization.
Булак BO regression моделинде 128 hidden unit камтыган бир hidden-layer feed-forward basis function колдонот. Acquisition function катары Expected Improvement (EI) тандалат.
BO башында 16 sample менен иштейт. Ар бир epochта EI сунуштаган top-k architecture embeddingтер batchке кошулат жана модель жаңыртылган batch үстүндө 100 epoch кайра үйрөтүлөт.
Бул жердеги “100 epoch” autoencoder pretraining үчүн берилген 16 epoch менен бирдей окутуу эмес. Бири architecture representation pretraining, экинчиси BO search моделинин iteration ичиндеги кайра үйрөтүлүшү.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
100.000 Схемалык Мейкиндикте 1000 Издөө Эмнени Билдирет?
Ар бир негизги QAS runда ыкма алдын ала түзүлгөн 100.000 схемалык search spaceтин болгону 1000 талапкерин, башкача айтканда болжол менен бир пайызын тапшырмада сурайт; ошондуктан эксперименттин максаты бардык схемаларды exhaustive түрдө сканерлөө эмес, latent representation жогорку өндүрүмдүү аймактарды Random Searchке караганда тыгызыраак үлгүлөй алабы-жокпу текшерүү.
Негизги эксперимент тапшырмалары
Изилдөө үч колдонмо үй-бүлөсүн колдонот:
- quantum state preparation,
- MaxCut,
- energy minimization / булак терминологиясы менен quantum chemistry тобу.
Негизги Figure 3 жана Figure 4 эксперименттери 4 жана 8 qubit деңгээлинде жүргүзүлгөн. Representation-learning жана encoding баалоолорунун айрым бөлүктөрүндө 12-qubit circuits да колдонулат.
Quantum state preparation
Quantum state preparation тапшырмасынын максаты target quantum stateти мүмкүн болушунча жогорку fidelity менен кайра түзүү.
Булак target stateти ага туура келген random circuitти түзүү аркылуу даярдайт жана QAS ыкмасын ушул stateке жогорку fidelity берген candidate circuitтерди издөө үчүн колдонот.
Fidelity 0 менен 1дин ортосунда reward катары түз колдонулушу мүмкүн болгондуктан, өзүнчө energy normalization жасалбайт.
MaxCut
MaxCut — weighted undirected graph verticesин эки топко бөлүп, эки топтун ортосундагы edge weight суммасын максималдаштыруу маселеси.
Изилдөө graphтан Hamiltonian чыгарат жана VQE негизиндеги энергия баалоосун колдонот.
Appendix A.2де булак:
- 4-qubit / 4-node мисал үчүн ground-state energy = −10 Ha,
- 8-qubit / 8-node мисал үчүн ground-state energy = −52 Ha
деген туюнтманы колдонот. “Ha” бирдиги булакта ушундай жазылгандыктан сакталган; Verianla бул нотацияны унчукпай башка бирдикке айлантпайт.
Quantum chemistry жана TFIM айырмасы
Appendix A.2де молекулалык мисалдар:
- 4-qubit H₂: болжол менен оптималдуу ground-state energy = −1,136 Ha,
- 12-qubit LiH: болжол менен оптималдуу ground-state energy = −7,88 Ha
деп берилет.
Бирок 8-qubit мисал молекула эмес. Булак \(n=8\) transverse-field Ising model (TFIM) колдонулганын ачык айтат.
Булактагы Теңдеме (10) — өзгөртүүсүз
\(\sigma_z^i\) \(i\). qubitтеги Pauli-Z операторун; \(\sigma_x^i\) Pauli-X операторун көрсөтөт. Биринчи мүчө neighboring spin couplingди, экинчи мүчө transverse-field салымын билдирет.
Булак ичиндеги маанилүү шайкешсиздик: Текст модель \(n=8\) экенин жана сумма \(i=0\)дон 7ге чейин экенин айтат, бирок кошуна индексте \((i+1)\bmod 6\) деп жазылган. Бул туюнтма source PDFте так ушундай. Verianla бул typographical error болушу мүмкүн деп булактан тышкары божомол кылып, аны \(\bmod 8\)ге өзгөрткөн эмес.
Булак бул Hamiltonian үчүн болжолдуу оптималдуу energyни −10 Ha катары колдонот.
Издөө жыйынтыктары кантип салыштырылды?
Figure 3тө ар бир plot 50 көз карандысыз runдын average rewardун көрсөтөт жана ар бир run 1000 query камтыйт. Shaded bands standard deviationды көрсөтөт.
Авторлордун байкоосуна ылайык REINFORCE жана Bayesian Optimization latent representation ичинде search илгерилеген сайын average rewardду айрыкча алгачкы этапта жогорулатат, ал эми Random Search окшош improvement көрсөтпөйт. RL жана BOнун varianceы Random Searchтен бир аз жогору болсо да, average reward деңгээлдери жогору.
Candidate thresholdтар
| Тапшырма | 4-qubit threshold | 8-qubit threshold |
|---|---|---|
| State preparation | 0,95 | 0,75 |
| MaxCut | 0,95 | 0,925 |
| Energy / quantum-chemistry тобу | 0,95 | 0,95 |
Ошондуктан 4-qubit жана 8-qubit candidate countтарды санга гана карап түз салыштыруу туура эмес; task complexity менен катар threshold маанилери да айырмаланат.
4-qubit издөө натыйжалуулугу
| Ыкма | Task | Жалпы баалоо | Табылган талапкер \(N_{\mathrm{QAS}}\) | \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|---|---|
| GNN predictor + RL | Fidelity | 2000 | 36 | 0,0180 |
| GNN predictor + RL | MaxCut | 2000 | 783 | 0,3915 |
| GNN predictor + RL | QC-H₂ | 2000 | 278 | 0,1390 |
| GSQAS predictor + RL | Fidelity | 2000 | 37 | 0,0185 |
| GSQAS predictor + RL | MaxCut | 2000 | 785 | 0,3925 |
| GSQAS predictor + RL | QC-H₂ | 2000 | 658 | 0,3290 |
| Random Search | Fidelity | 1000 | 15 | 0,0150 |
| Random Search | MaxCut | 1000 | 568 | 0,5680 |
| Random Search | QC-H₂ | 1000 | 371 | 0,3710 |
| Сунушталган QAS — REINFORCE | Fidelity | 1000 | 69 | 0,0690 |
| Сунушталган QAS — REINFORCE | MaxCut | 1000 | 898 | 0,8980 |
| Сунушталган QAS — REINFORCE | QC-H₂ | 1000 | 817 | 0,8170 |
| Сунушталган QAS — BO | Fidelity | 1000 | 63 | 0,0630 |
| Сунушталган QAS — BO | MaxCut | 1000 | 820 | 0,8200 |
| Сунушталган QAS — BO | QC-H₂ | 1000 | 739 | 0,7390 |
Predictor-based ыкмалардын \(N_{\mathrm{eval}}=2000\) мааниси performance predictorду түзүү үчүн керектүү labeled-circuit баалоолору менен search учурундагы баалоолордун суммасын камтыйт. Сунушталган predictor-free ыкмада өзүнчө 1000 labeled pretraining circuit evaluation жок; structural pretraining performance label талап кылбайт жана \(N_{\mathrm{eval}}=1000\) search evaluation колдонулат.
Бул таблица ыкма айрыкча MaxCut жана H₂ энергия тапшырмасында жогорку-performing regionsды тыгызыраак үлгүлөй аларын көрсөтөт. Бирок task-specific thresholdтар жана search-space composition жыйынтыктардын контексти; маанилер универсалдуу QAS efficiency constantтар эмес.
Encoding өзгөргөндө жыйынтык дайыма жакшырабы?
| Эксперимент | GSQAS encoding \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) | Сунушталган encoding \(N_{\mathrm{QAS}}/N_{\mathrm{eval}}\) |
|---|---|---|
| GSQAS — 4 | 0,3125 | 0,3290 |
| GSQAS — 12 | 0,1415 | 0,1380 |
| QAS-RL — 4 | 0,7600 | 0,8170 |
| QAS-RL — 8 | 0,1600 | 0,1670 |
| QAS-RL — 12 | 0,4220 | 0,3920 |
Бул жыйынтык маанилүү чечмелөө чегин түзөт. Жаңы encoding 4 жана 8-qubit мисалдардын көбүндө артыкчылык бергени менен, 12-qubit эки салыштырууда GSQAS encodingден артта калат. Булак да 12-qubit search space 100.000 circuit менен жетиштүү көрсөтүлбөшүн мүмкүн болгон себеп катары талкуулайт.
Latent dimension жана GIN depth абляциясы
| Latent \(d_z\) | GIN depth \(L\) | VAE loss | Average reward RL | Average reward BO |
|---|---|---|---|---|
| 8 | 5 | 0,11 | 0,95 ± 0,001 | 0,89 ± 0,030 |
| 16 | 5 | 0,09 | 0,98 ± 0,006 | 0,93 ± 0,013 |
| 32 | 5 | 0,14 | 0,975 ± 0,009 | 0,92 ± 0,017 |
| 16 | 3 | 0,10 | 0,95 ± 0,013 | 0,93 ± 0,021 |
| 16 | 7 | 0,09 | 0,97 ± 0,010 | 0,92 ± 0,022 |
Ablation жыйынтыктары 10 random seed боюнча mean ± standard deviation түрүндө берилген. VAE reconstruction objective hyperparameterлерге сезгич болгону менен downstream QAS reward кыйла чектелүү өзгөрөт. Булактын default тандоосу \(d_z=16\), \(L=5\).
IBM ibm_sherbrooke Үстүндөгү %100 Жыйынтык Эмнени Билдирет?
Булактын %100 жыйынтыгы QAS менен тандалган эки гана MaxCut схемасы — 4-node жана 8-node problem — симулятордо үйрөтүлгөн параметрлери өзгөртүлбөстөн ibm_sherbrooke үстүндө ар бири 10.000 shot менен иштетилгенде бардык өлчөөлөрдө optimal bitstring билдирилгенин түшүндүрөт; бул state-preparation же chemistry/TFIM тапшырмалары чыныгы жабдыкта ушундай эле ийгиликке жетти же ыкма жалпы quantum advantage берди дегенди билдирбейт.
Чыныгы жабдык тест протоколу
- QAS менен 4-node жана 8-node MaxCut үчүн эң жакшы-performing circuit тандалды.
- Бул схемалардын trainable параметрлери noise-free simulator үстүндө оптималдаштырылды.
- Ошол эле parameter set чыныгы ibm_sherbrooke түзмөгүнө өткөрүлдү.
- Булак эч кандай hardware-specific parameter re-tuning жасалбаганын белгилейт.
- Ар бир шарт 10.000 measurement shot менен иштетилди.
| Метрика | 4-node симулятор | 4-node чыныгы түзмөк | 8-node симулятор | 8-node чыныгы түзмөк |
|---|---|---|---|---|
| Optimal bitstring ыктымалдыгы | %100,0 | %100,0 | %100,0 | %100,0 |
| Average cut value | 4 | 4 | 12 | 12 |
| Shot | 10.000 | 10.000 | 10.000 | 10.000 |
| Noise model | Noise-free | Physical NISQ | Noise-free | Physical NISQ |
| Device | Simulator | ibm_sherbrooke | Simulator | ibm_sherbrooke |
Булак өзүнчө confidence interval билдирбейт. Ошондуктан Verianla “чыныгы ийгилик ыктымалдыгы так 1,000000” деген статистикалык жалпылоону жасабайт; болгону булак Table 4тө 10.000 repeated shot үчүн байкалган жана %100,0 деп билдирилген жыйынтыкты берет.
Бул жыйынтык quantum advantageбы?
Жок. Изилдөөнүн суроосу classical computerди quantum computerге салыштырмалуу ылдамдык же complexity жагынан жеңүү эмес. Издөө frameworkү негизинен классикалык machine learning жана ызы-чуусуз quantum simulation колдонот; чыныгы hardware эксперименти болсо тандалган candidate circuitтердин өткөрүлө алышын текшерет.
Демек, изилдөө колдогон билдирүү “табылган эки MaxCut circuit чыныгы NISQ түзмөгүнө параметр re-tuningсиз ийгиликтүү өткөрүлгөн” деген. “QAS classical computingди ашып өттү” же “quantum advantage көрсөтүлдү” деген жыйынтык булак тарабынан текшерилген эмес.
Изилдөөнүн күчтүү жактары
- Architecture representation learning менен task-specific search бири-биринен ажыратылган.
- Pretraining performance labels же VQA evaluations талап кылбайт.
- Control/target ролу жана multi-qubit edge importance мурунку encodingге караганда ачыгыраак көрсөтүлөт.
- Ошол эле pretrained representation ар башка downstream tasks үчүн колдонулушу мүмкүн.
- REINFORCE жана BO бир эле latent space үстүндө колдонулушу мүмкүн.
- Search өндүрүмдүүлүгү бир эле колдонмодо эмес, state preparation, MaxCut жана energy-based тапшырмаларда бааланган.
- Негизги search curves 50 independent run боюнча бааланган.
- Latent dimension жана GIN depth үчүн өзүнчө ablation жүргүзүлгөн.
- Эң жакшы MaxCut circuitтер чыныгы IBM hardware үстүндө түз сыналган.
Изилдөөнүн чектөөлөрү
Search-space coverage: 100.000 circuit 4-qubit маселеде бай үлгүлөөнү камсыздай алса да, 12-qubit бардык possible architecture spaceтин өтө аз бөлүгүн гана камтышы мүмкүн. Булак 12-qubit latent representationдагы алсызыраак clusteringди ушул чектөө менен байланыштырат.
Operation-pool көз карандылыгы: Модель баштапкы circuit generator уруксат берген gate set жана structural constraints ичинде гана издөө жүргүзөт.
Hardware validation камтуусу: Чыныгы hardware 4-node жана 8-node MaxCut best circuits үчүн гана колдонулган; state preparation жана энергия тапшырмалары үчүн ушундай real-device validation билдирилген эмес.
Тандалган схема текшерүүсү: Hardware test бүт candidate distributionды эмес, search тандаган эң жакшы схемаларды сынайт.
Noise-model жалпылоосу: Search негизги эксперименттери noise-free simulatorдо жүргүзүлгөн. QAS objective түздөн-түз hardware noise-aware search катары оптималдаштырылган эмес.
Scalability: 12-qubit жыйынтыктары representation coverage жана downstream search өндүрүмдүүлүгү төмөндөшү мүмкүн экенин көрсөтөт. Ошондуктан ыкма чоңураак схемаларда автоматтык түрдө ошол эле efficiencyни кепилдебейт.
Predictor-free ≠ evaluation-free: Өзүнчө predictor жана labeled pretraining керек болбосо да reward үчүн candidate VQA evaluation талап кылынат; кымбат тапшырма баалоосу толугу менен жоголбойт.
Изилдөө колдогон жыйынтыктар
Булак circuit structureды көзөмөлсүз түрдө үйрөнүлгөн latent representationга айландыруу QAS үчүн пайдалуу болушу мүмкүн экенин жана REINFORCE/BO ушул latent space ичинде Random Searchке караганда натыйжалуураак жогорку-performing candidate discovery камсыздай аларын колдойт.
Сунушталган encoding control-target role жана interaction weight сыяктуу circuit-specific маалыматтарды ачыгыраак көрсөтөт жана көп metric менен downstream search conditionда артыкчылык берет.
4-qubit мисалдарда latent representation performance structure менен тартиптүү түрдө топтоло алары көрсөтүлөт; performance label бул representationдын training targetы эмес.
Тандалган 4-node жана 8-node MaxCut circuits simulator-trained parameters менен ibm_sherbrooke үстүндө кайра tuningсиз булакта билдирилген optimal outputту сактаганы көрсөтүлөт.
Изилдөө колдобогон жыйынтыктар
Изилдөө бардык кванттык circuit architecture search маселелеринде жаңы encoding эң жакшы экенин далилдебейт. 12-qubit салыштырууларында айрым жыйынтыктар эски encoding пайдасына.
Изилдөө predictor-free ыкма quantum circuit evaluation зарылдыгын толугу менен жойгонун көрсөтпөйт.
Изилдөө табылган бардык схемалар чыныгы hardware noiseга туруктуу экенин көрсөтпөйт.
Изилдөө state preparation, H₂, LiH же TFIM тапшырмаларын ibm_sherbrooke үстүндө ошол эле hardware test протоколу менен ырастабайт.
Изилдөө fault-tolerant quantum computing көрсөткөн эмес; колдонулган чыныгы түзмөк NISQ түзмөгү.
Изилдөө quantum computational advantage же classical speedup далилдебейт.
Изилдөө 100.000 схемалык үлгү 12-qubit же андан чоң circuit spacesти толук көрсөтөт деп далилдебейт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: Quantum Architecture Search with Unsupervised Representation Learning
Авторлор: Yize Sun, Zixin Wu, Volker Tresp, Yunpu Ma.
Тең салым: Yize Sun жана Zixin Wu.
Байланыш автору: Yunpu Ma.
Булакта берилген байланыш e-mail: cognitive.yunpu@gmail.com
Мекеме 1: Ludwig-Maximilians-University Munich, Munich, Germany.
Мекеме 2: Siemens AG, Munich, Germany.
Мекеме 3: MCML — Munich Center for Machine Learning, Munich, Germany.
Булак түрү: Рецензияланган journal article.
Журнал: Quantum.
Том: 10.
Макала/бет номери: 1994.
Жарыяланган күнү: 3 февраль 2026.
Кабыл алынган күнү: 23 январь 2026.
DOI: 10.22331/q-2026-02-03-1994.
Eprint: arXiv:2401.11576v6 [quant-ph], 25 январь 2026.
Басма: Verein zur Förderung des Open Access Publizierens in den Quantenwissenschaften.
Редактор: Jiangwei Shang.
Лицензия: Creative Commons Attribution 4.0 International (CC BY 4.0).
Илимий изилдөө түрү: Кванттык машиналык үйрөнүү / quantum architecture search ыкма изилдөөсү; graph representation learning, reinforcement learning, Bayesian optimization, ызы-чуусуз quantum simulation жана чектелген чыныгы NISQ hardware evaluation камтыйт.
Search space: Random generator менен 100.000 circuit.
Operation pool: X, Y, Z, H, Rx, Ry, Rz, U3, CNOT, CZ, CY.
Circuit generator: 4 / 8 / 12 qubit; тиешелүүлүгүнө жараша 10 / 20 / 30 gate; maximum depth 5.
Representation model: GIN-based variational graph autoencoder.
GIN layer: 5.
Latent dimension: 16.
Hidden dimension: 128.
Pretraining: 16 epoch; batch size 32; dropout 0,1; structure-only \(A,X\) input; performance label колдонулбайт.
Search algorithms: REINFORCE жана DNGO негизиндеги Bayesian Optimization.
Search budget: Ар бир негизги run үчүн 1000 query.
Негизги өндүрүмдүүлүк кайталоолору: Figure 3 жана Figure 4 үчүн 50 independent run / random seed.
Ablation кайталоолору: Table 6 үчүн 10 random seed.
Чыныгы кванттык түзмөк: IBM ibm_sherbrooke.
Чыныгы hardware test камтуусу: Тандалган 4-node жана 8-node MaxCut circuits гана.
Hardware shot саны: Ар бир шарт үчүн 10.000.
Hardware parameter transfer: Параметрлер noise-free simulatorдо үйрөтүлүп, чыныгы түзмөккө re-tuning жасалбастан өткөрүлгөн.
Hardware жыйынтыгы: Булак Table 4, 4-node жана 8-node MaxCut үчүн simulatorдо да, чыныгы түзмөктө да %100,0 optimal-bitstring probability билдирет; өзүнчө confidence interval берилген эмес.
Булак ичиндеги Теңдеме (10) эскертүүсү: Текст \(n=8\) TFIMди аныктап жатып, кошуна индексти \((i+1)\bmod6\) деп жазат. Verianla формуланы өзгөртпөй, бул шайкешсиздикти көрүнүктүү калтырган.
Булак ичиндеги колдонмо аталышы жөнүндө эскертүү: 8-qubit эксперимент “quantum chemistry” эксперименттер тобунда талкууланганы менен Appendix A.2де колдонулган физикалык модель молекула эмес, TFIM. H₂ — 4-qubit, LiH болсо 12-qubit molecular мисалдар.
Булак ичиндеги metric-caption эскертүүсү: Table 1 caption “four metrics” десе, таблицада беш metric мамычасы бар.
Каржылоо: German Federal Ministry of Education and Research тарабынан Quantum Reinforcement Learning for Industrial Applications (QLindA), долбоор no. 13N15644; ошондой эле Federal Ministry for Economic Affairs and Climate Action тарабынан Quantum-Classical Hybrid Optimization Algorithms for Logistics and Production Line Management (QCHALLenge), долбоор no. 01MQ22008B.
AI колдонуу билдирүүсү: Булактын acknowledgments бөлүмү manuscriptтин айрым бөлүктөрү drafting жана language refinement максатында OpenAI ChatGPT-4 колдоосу менен түзүлгөнүн жана мазмун үчүн жоопкерчиликти авторлор өзүнө аларын билдирет.
Маалыматтардын жеткиликтүүлүгү: Берилген 20 беттик макалада өзүнчө “Data Availability” бөлүмү аныкталган эмес. Булакта жок repository же dataset дареги кошулган эмес.
Code availability: Берилген PDFте өзүнчө “Code Availability” билдирүүсү аныкталган эмес.
Кызыкчылыктардын кагылышы: Берилген PDFте өзүнчө competing-interest/conflict-of-interest билдирүүсү аныкталган эмес; ошондуктан “кызыкчылыктардын кагылышы жок” деген булактан тышкары божомол жасалган эмес.
Автордук салымдар: Берилген PDFте өзүнчө CRediT author-contribution бөлүмү аныкталган эмес; Yize Sun жана Zixin Wu тең салым кошкону гана ачык көрсөтүлгөн.
Негизги чечмелөө чеги: Изилдөө efficient architecture search жана selected-circuit hardware transfer боюнча далил берет; fault tolerance, жалпы hardware robustness же quantum advantage көрсөтпөйт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген