


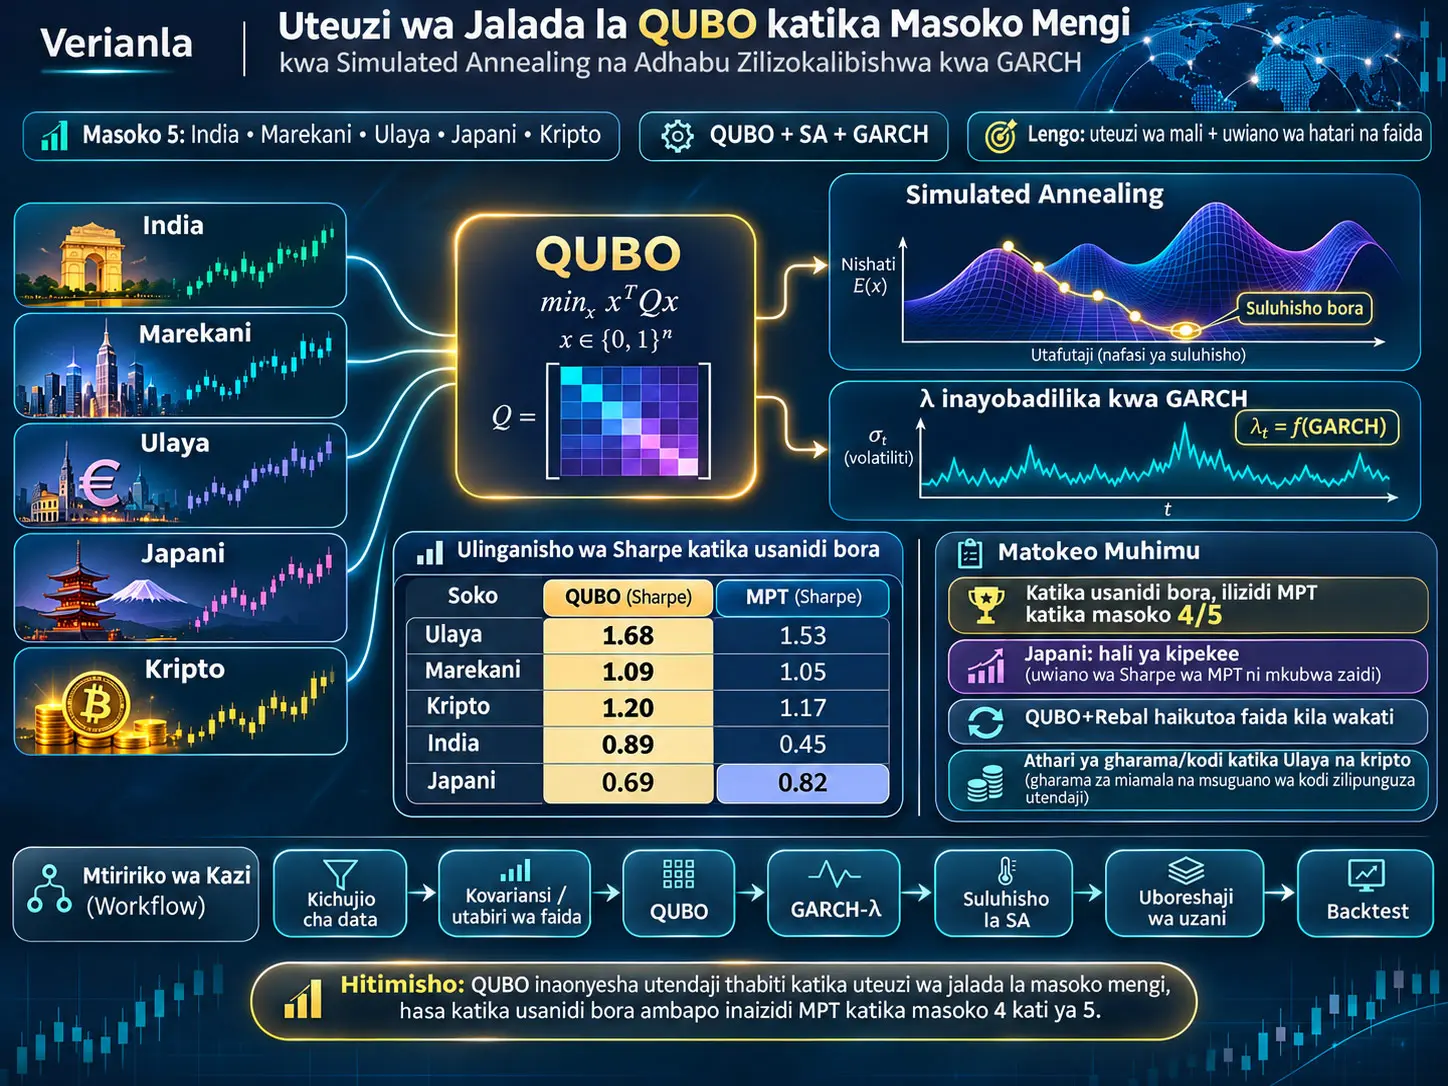
Uteuzi wa jalada la QUBO katika utafiti huu, ni mbinu ya kuunda jalada inayowakilisha kwa vigeu vya kibinari ni mali zipi katika ulimwengu wa uwekezaji zitaingizwa kwenye jalada na kubadilisha tatizo hili la uteuzi wa kimchanganyiko kuwa katika umbo la Quadratic Unconstrained Binary Optimisation (QUBO; Uboreshaji wa Kibinari wa Kikwadrati Usio na Vizuizi). Utafiti hutatua uteuzi wa mali unaotegemea QUBO kwa kutumia cardinality-preserving Simulated Annealing (SA; simulated annealing), kisha huamua uzani wa jalada wa mali zilizochaguliwa kwa uboreshaji wa kawaida wa wastani-variansi. Mfumo umetathminiwa katika masoko ya India, Marekani, Ulaya, Japani na kripto na kulinganishwa na mbinu ya kawaida ya Markowitz Mean-Variance Portfolio (MPT).
Katika safu ya kitakwimu ya mbinu hiyo, Ledoit-Wolf shrinkage na marekebisho ya heteroskedastisiti ya Forbes-Rigobon hutumiwa pamoja kwa makadirio ya kovariansi; ikiwa kiasi cha data hakitoshi ikilinganishwa na idadi ya mali, modeli ya faktori ya PCA hutumika. Marejesho yanayotarajiwa hupunguzwa kuelekea wastani wa jumla kwa James-Stein shrinkage. Katika modeli ya QUBO inayofanya uteuzi wa mali, hatari, marejesho yanayotarajiwa, sharti la kuchagua mali \(B\) haswa, na kuepuka jozi za mali zenye uwiano mkubwa huwekwa katika kazi moja ya nishati.
Moja ya vipengele asilia vya utafiti ni kuongeza au kupunguza kwa nguvu adhabu ya cardinality \(\lambda\) kulingana na tete ya soko kwa kutumia GARCH(1,1). Tete yenye masharti inapoongezeka, adhabu hulegezwa; katika hali tulivu zaidi huimarishwa. Waandishi pia hutumia swap-SA inayobadilisha mali moja iliyochaguliwa na mali moja isiyochaguliwa katika kila hatua ili kuzuia SA ya kawaida kutohifadhi idadi ya chaguo wakati wa utafutaji. Kwa hivyo, sharti la \(\sum_i x_i=B\) huhifadhiwa katika utafutaji wote.
Data ina mfululizo wa bei na kiasi cha biashara na inafunika kipindi cha Januari 2022–Januari 2026. Kulingana na sehemu ya vikwazo ya chanzo, tathmini halisi ya utendaji wa out-of-sample inategemea dirisha moja tu la backtest la siku 252 katika mwaka 2025. Katika grid ya majaribio, masoko matano, ukubwa tano wa ulimwengu, uwiano mitatu ya cardinality, vigawo vitatu vya kuepuka hatari na urefu mitatu wa lookback vimeunganishwa; baada ya kuondoa mchanganyiko unaojirudia na wenye thamani sawa, hadi usanidi 225 wa QUBO kwa kila soko umetathminiwa.
Grid yote ya vigezo inapowastanishwa kwa pamoja, QUBO huzidi MPT katika wastani wa uwiano wa Sharpe nchini India na Ulaya, huku MPT ikitoa matokeo ya juu kidogo Marekani, Japani na kripto. Hata hivyo, usanidi mmoja bora zaidi uliochaguliwa kwa mantiki ya uthibitishaji kwa kila soko unapolinganishwa, QUBO huzidi uwiano bora wa Sharpe wa MPT nchini India, Marekani, Ulaya na kripto; nchini Japani, MPT hutoa Sharpe ya juu zaidi. Kwa hiyo, matokeo ya utafiti si kwamba “QUBO ni bora kuliko MPT katika hali zote”; ubora hutegemea soko, usanidi na namna ya tathmini inayotumika.
Jaribio la Walk-forward QUBO+Rebal pia limetoa matokeo muhimu ya kinyume. Ulaya kulikuwa na miamala minne ya kusawazisha upya iliyotekelezwa, na katika soko la kripto kulikuwa na tisa; gharama za miamala na kodi za faida ya mtaji zilizotekelezwa zilipozingatiwa, katika masoko haya mawili gharama ya uboreshaji upya wa nguvu ilizidi faida ya utendaji. Hitimisho la waandishi ni kwamba uwezo wa kuboresha upya haumaani moja kwa moja kuwa jalada litakuwa bora zaidi.
Kikomo muhimu zaidi cha tafsiri katika utafiti ni kwamba matokeo yanategemea dirisha moja la out-of-sample la siku 252 na hakuna p-value, confidence interval au jaribio la umuhimu wa kitakwimu la vipindi vingi lililoripotiwa kwa tofauti za Sharpe/marejesho kati ya mikakati. Kwa hiyo tofauti za nambari zinapaswa kusomwa kama ulinganisho wenye nguvu wa backtest; hazipaswi kutafsiriwa kama ushahidi wa ubora wa hakika kwa muda mrefu au katika rejimu tofauti za soko.
Uteuzi wa jalada na upangaji wa uzani wa jalada si tatizo moja
Katika uboreshaji wa jalada kuna maamuzi mawili tofauti. Uamuzi wa kwanza ni mali zipi zitaingia kwenye jalada. Uamuzi wa pili ni ni uzani gani utapewa mali zilizochaguliwa. Mbinu ya kawaida ya Markowitz ina nguvu sana katika tatizo la pili; lakini jalada linapohitajika kuwa na mali \(B\) haswa, swali “nichague mali zipi \(B\)?” huwa tatizo la kimchanganyiko.
Utafiti hufafanua ulimwengu wa mali wagombea katika soko kama \(U^{(m)}\), idadi ya wagombea waliotolewa sampuli kama \(u\), idadi ya mali zitakazochaguliwa kama \(B\), na binary selection vector kama:
\[ x\in\{0,1\}^{u} \]
Kwa kila \(x_i\):
- \(x_i=1\): mali imechaguliwa,
- \(x_i=0\): mali haijachaguliwa.
Cardinality lengwa:
\[ B=\lfloor r\,u\rfloor, \qquad r\in\{0.2,0.3,0.4\}. \]
Hapa \(r\) ni cardinality ratio inayoamua ni sehemu gani ya mali wagombea itaingizwa kwenye jalada. Kwa mfano, ikiwa \(u=50\) na \(r=0.2\), lengo la kinadharia ni mali \(B=10\).
QUBO Inatatua Nini katika Uteuzi wa Jalada?
Katika utafiti huu, kabla ya kuamua moja kwa moja uzani wa jalada, QUBO huunganisha marejesho yanayotarajiwa, hatari, cardinality na adhabu za uwiano katika kazi moja ya nishati ya kibinari na kutatua tatizo dogo la kimchanganyiko la ni mali zipi \(B\) zichaguliwe kutoka katika ulimwengu wa wagombea; uzani huhesabiwa baada ya uteuzi kwa uboreshaji tofauti wa wastani-variansi.
Kwa nini masoko matano tofauti yanachunguzwa pamoja?
Watafiti hutumia masoko matano yasiyofanana ili kuzuia mbinu ionekane kuwa nzuri katika darasa moja tu la mali:
- India — ulimwengu wa NIFTY 50,
- Marekani — ulimwengu wa S&P 500,
- Ulaya — ulimwengu wa EURO STOXX 50,
- Japani — ulimwengu wa Nikkei 225,
- Kripto — ulimwengu wa mali za kidijitali na benchmark ya BTC.
Data za bei na kiasi kwa jumla ya ticker 250 zinapatikana kupitia yfinance. Seti ya ticker hutumia utaratibu wa disk cache wenye ufunguo wa MD5 ili data ileile iweze kutumiwa tena katika majaribio mradi tarehe ya kuanza au ya mwisho haijabadilika. Ticker zenye data katika chini ya %80 ya mistari yake huondolewa mapema.
Kwa nini uundaji wa ulimwengu hauanzi moja kwa moja na mali zote?
Ulimwengu wa wagombea utakaoingia QUBO huandaliwa katika hatua nne. Lengo ni kupunguza mali zisizo na ukwasi au zenye tete isiyo ya kawaida na kuunda bwawa lenye mseto badala ya bwawa la wagombea linaloundwa na mali zinazofanana sana.
1. Kichujio cha ukwasi
Mali huhifadhiwa ikiwa ina kiasi chanya katika angalau %95 ya siku za biashara:
\[ \mathrm{retain}_i \Longleftrightarrow \sum_t \mathbf{1}[V_{t,i}>0] \geq 0.95\,T. \tag{1} \]
\(V_{t,i}\) ni kiasi cha biashara cha mali \(i\) siku ya \(t\); \(T\) ni jumla ya siku zilizochunguzwa. Kichujio hiki kinalenga kupunguza mali zenye kusimama kwa biashara kwa muda mrefu au stale price data.
2. Wastani wa mauzo ya kila siku — ADTV
Miongoni mwa mali zilizopita kichujio cha ukwasi, zile zenye thamani kubwa zaidi ya Average Daily Turnover inayohesabiwa kwa bei × kiasi huhifadhiwa. Ili bwawa la wagombea liwe pana kuliko ulimwengu lengwa, chanzo hutumia:
\[ k_{\mathrm{pool}}=2 \]
kizidishi cha bwawa na, inapowezekana, hulenga kupeleka takriban wagombea \(2u\) wenye ukwasi kwenye vichujio vinavyofuata.
3. Kikomo cha juu cha tete
Tete iliyowekwa kwa mwaka:
\[ \hat{\sigma}_i = \mathrm{std}(r_{\tau,i})\sqrt{252} \leq \sigma_{\max}^{(m)}. \tag{2} \]
hukaguliwa kwa hili. Mkengeuko sanifu wa marejesho ya kila siku hupimwa kwa \(\sqrt{252}\) ili kupata makadirio ya tete ya mwaka.
| Soko | \(\sigma_{\max}\) |
|---|---|
| India | 0,75 |
| Marekani | 0,60 |
| Ulaya | 0,60 |
| Japani | 0,70 |
| Kripto | 5,00 |
Kuweka kikomo cha juu zaidi kwa kripto kunalenga kutokiondoa kabisa tete kubwa zaidi ya marejesho ya mali za kidijitali katika hatua ya ulimwengu wa wagombea.
4. Uwekaji wa makundi kwa ngazi
Mali hulinganishwa kwa umbali ufuatao wa uwiano:
\[ d_{ij}=1-|\hat{\rho}_{ij}|. \]
\(|\hat{\rho}_{ij}|\) inapokaribia 1, mali mbili husogea kwa nguvu pamoja na umbali hupungua. Uwiano unapokaribia sifuri, umbali hukaribia 1. Baada ya Average-linkage agglomerative clustering, lengo ni kuchagua mali yenye ADTV ya juu zaidi kutoka kila kundi.
Kutolingana kwa uundaji wa ulimwengu ndani ya chanzo
Jedwali 2 la chanzo linaonyesha kwamba kwa \(u=50\) na lookback ya siku 252, baada ya kichujio cha tete zilibaki takriban mali 42 nchini India, 47 Marekani, 45 Ulaya na 44 Japani; lakini baada ya clustering kila soko tena lina mali 50 kamili. Mbinu ya chanzo haielezi kwa utaratibu gani mali zilizopungua baada ya kichujio cha tete zilirudishwa.
Jambo hili ni muhimu kwa sababu haiwezekani moja kwa moja kugawa mali 42 katika makundi 50 tofauti na kuchagua mwakilishi tofauti kutoka kila kundi. Verianla haisahihishi jedwali hili kwa kusema “labda pool ilikuwa kubwa zaidi”; kuna pengo la maelezo kati ya maandishi ya chanzo na Jedwali 2 linaloathiri uwezekano wa kurudia matokeo.
Kwa nini Ledoit-Wolf shrinkage inatumika?
Matriksi ya kovariansi ya sampuli inaweza kuwa isiyokuwa thabiti hasa idadi ya mali \(n\) inapokaribia idadi ya uchunguzi \(T\). Chanzo hutumia kwanza Ledoit-Wolf shrinkage ikiwa \(T/n\geq5\):
\[ \hat{\Sigma}_{LW} = (1-\alpha)\hat{\Sigma}_{sample} + \alpha\,\mu_{target}I. \tag{3} \]
\(\hat{\Sigma}_{sample}\) ni matriksi ya kovariansi ya sampuli ya moja kwa moja, \(I\) ni matriksi ya utambulisho, \(\mu_{target}\) ni kipimo lengwa cha shrinkage na \(\alpha\) ni analytical shrinkage intensity.
Kadiri \(\alpha\) inavyoongezeka, makadirio husogea kutoka kovariansi ya sampuli ya moja kwa moja kuelekea matriksi lengwa iliyoratibiwa zaidi. Lengo ni kupunguza variansi ya makadirio na kutotulia kwa nambari kwa gharama ya kuongeza bias.
Marekebisho ya Forbes-Rigobon yanafanya nini?
Chanzo huanzia kwenye dhana kwamba uwiano uliopimwa katika vipindi vya tete kubwa unaweza kupotoshwa na heteroskedastisiti, hivyo hugawanya data katika rejimu za variansi kubwa \(H\) na variansi ndogo \(L\) kwenye mediani ya rolling volatility. Uwiano wa variansi kupitia first principal component \(f_1\):
\[ \delta = \frac{ \mathrm{Var}_{H}[f_1] - \mathrm{Var}_{L}[f_1] }{ \mathrm{Var}_{L}[f_1] } \]
huhesabiwa na uwiano wa tete kubwa:
\[ \rho^{FR}_{ij} = \frac{ \rho^{H}_{ij} }{ \sqrt{ 1+\delta \left( 1-(\rho^{H}_{ij})^2 \right) } }. \tag{4} \]
husahihishwa kwa namna hiyo.
Baada ya marekebisho, matriksi ya uwiano hufanywa positive semi-definite kwa eigenvalue clipping. Ikiwa:
\[ \frac{T}{n}<5 \]
chanzo hutumia modeli ya PCA covariance yenye faktori \(K\) inayoeleza angalau %80 ya variansi ya jumla kama fallback badala ya mnyororo wa Ledoit-Wolf + Forbes-Rigobon.
Kwa nini James-Stein shrinkage inatumika kwa marejesho yanayotarajiwa?
Wastani wa marejesho ya sampuli unaweza kuendana kupita kiasi na kipindi kilichopita. Kwa hiyo utafiti hupunguza wastani wa marejesho wa kila mali kuelekea grand mean ya mali zote:
\[ \mu_i^{JS} = (1-\kappa)\mu_i^{sample} + \kappa\bar{\mu}, \qquad \kappa = \min\left(1,\frac{n}{T}\right). \tag{5} \]
Kadiri \(n/T\) inavyoongezeka, yaani idadi ya mali inapoongezeka ikilinganishwa na idadi ya uchunguzi, \(\kappa\) huongezeka na noisy sample mean za mali moja moja huaminiwa kwa kiwango kidogo zaidi.
Kazi lengwa ya QUBO
Tatizo la QUBO kwa mali wagombea huandikwa kama:
\[ \min_{x\in\{0,1\}^{n}} x^\top Qx \tag{6} \]
Hapa lengo ni kupata vektori ya uteuzi wa kibinari inayotoa nishati ndogo zaidi ya QUBO.
Baada ya chanzo kunormalisha marejesho yanayotarajiwa na kovariansi kwa thamani zao za juu, vipengele vya diagonal huwekwa kama:
\[ Q_{ii} = q\tilde{\Sigma}_{ii} - \tilde{\mu}_i + \lambda(1-2B) \tag{7} \]
na kwa \(i<j\), vipengele vya off-diagonal huwekwa kama:
\[ Q_{ij} = 2q\tilde{\Sigma}_{ij} + 2\lambda + 2\lambda\delta_{div} \left( |\rho_{ij}|-0.3 \right)_{+}. \tag{8} \]
.
Hapa:
- \(q\in\{0.3,0.5,0.7\}\): kigezo cha risk-aversion,
- \(\tilde{\Sigma}\): kovariansi iliyorekebishwa kwa kipimo,
- \(\tilde{\mu}\): marejesho yanayotarajiwa yaliyorekebishwa kwa kipimo,
- \(\lambda\): cardinality penalty,
- \(B\): idadi lengwa ya mali zitakazochaguliwa,
- \(\rho_{ij}\): uwiano wa jozi ya mali,
- \(\delta_{div}=0.3\): uzani wa diversification penalty.
\((z)_+\) ni opereta ya sehemu chanya; ikiwa \(z\leq0\), huchukuliwa 0, na ikiwa \(z>0\), huchukuliwa \(z\). Kwa hiyo adhabu ya ziada ya mseto huanza kutumika tu kwa:
\[ |\rho_{ij}|>0.3 \]
jozi za mali zenye hali hiyo.
Kwa nini \(\lambda\) Iliyokalibishwa kwa GARCH Inatumika?
Badala ya kurekebisha kwa mkono adhabu ya cardinality kwa kila soko, chanzo huunganisha kipimo cha adhabu na ukubwa wa QUBO objective na hukizidisha kwa nguvu kwa tete yenye masharti ya GARCH(1,1); hivyo katika kipindi cha tete kubwa adhabu hulegezwa na katika rejimu tulivu huimarishwa, lakini hakuna utafiti tofauti wa ablation uliotenganisha moja kwa moja ubora wa muundo huu dhidi ya \(\lambda\) tuli.
Fomula ya msingi ya \(\lambda\)
\[ \lambda = \gamma_{target} \frac{ \|Q_{obj}\|_{\infty} }{ 2B-1 } \phi_{GARCH}, \qquad \gamma_{target}=3.0. \tag{9} \]
\(\|Q_{obj}\|_{\infty}\) ni infinity norm inayowakilisha kipimo cha objective cha QUBO nje ya adhabu. Kupima kwa \(2B-1\) kunalenga kuzuia adhabu isiwe kubwa au ndogo kupita kiasi ikilinganishwa na objective cardinality inapobadilika.
Kigezo cha marekebisho ya GARCH:
\[ \phi_{GARCH} = \mathrm{clip} \left( \frac{ \bar{\sigma}_{LW} }{ \bar{\sigma}_{GARCH} }, \frac{1}{3}, 2 \right). \tag{10} \]
huhesabiwa kwa njia hiyo.
Hapa \(\bar{\sigma}_{LW}\) huwakilisha kipimo cha tete kinachotegemea Ledoit-Wolf, na \(\bar{\sigma}_{GARCH}\) huwakilisha kipimo cha tete yenye masharti ya GARCH(1,1).
Tete yenye masharti ikiongezeka, \(\bar{\sigma}_{GARCH}\) huongezeka, uwiano hupungua na:
\[ \phi_{GARCH}<1 \]
inaweza kutokea; hivyo adhabu ya cardinality hulegea. Katika rejimu tulivu zaidi:
\[ \phi_{GARCH}>1 \]
inaweza kutokea na adhabu huongezeka. Operesheni ya clip huweka kigezo kati ya \(1/3\) na 2. Ikiwa GARCH fitting itashindwa:
\[ \phi_{GARCH}=1 \]
hutumika na kipimo hurudi kwenye adhabu tuli.
Vipimo vitatu vya uchunguzi kwa \(\lambda\)
- Ratio Test: uwiano wa \(\lambda(2B-1)/\|Q_{obj}\|_{\infty}\) unatarajiwa kuwa kati ya 2–5. Chanzo hutafsiri chini ya 2 kama adhabu ya cardinality isiyotosha, na juu ya 5 kama adhabu kupita kiasi inayoweza kuficha return signal.
- Sensitivity Test: angalau %40 asset overlap hutafutwa kati ya suluhisho za \(\lambda\) na \(10\lambda\).
- Energy Gap Test: Nishati ya QUBO ya suluhisho bora lenye mali \(B\) lazima iwe chini kabisa ya suluhisho bora lenye mali \(B+1\).
Katika chanzo, Ratio Test hupita katika zaidi ya %90 ya usanidi. Sensitivity Test hushindwa mara nyingi zaidi hasa katika hali za lookback fupi ya siku 126 katika soko la kripto. GARCH fitting inapofanikiwa, \(\phi_{GARCH}\) imeonekana takriban katika eneo la 0,8–1,6 na imeripotiwa kwamba hii inaweza kuleta mabadiliko ya takriban mara mbili katika \(\lambda\).
Kwa nini Simulated Annealing inatumika?
QUBO cardinality-constrained asset selection ni tatizo la uboreshaji wa kimchanganyiko. Utafiti hautumii physical quantum annealer; uboreshaji wote unafanywa kwenye vifaa vya kawaida kwa simulated annealing.
Katika hatua ya kwanza neal.SimulatedAnnealingSampler hutumika:
- \(N_{reads}=1000\),
- \(N_{sweeps}=3000\),
- \(n_{seeds}=5\) random seed huru.
Suluhisho lenye nishati ndogo zaidi ya QUBO huhifadhiwa.
Swap-SA huhifadhi cardinality vipi?
Ikiwa SA ya kawaida itabadilisha bit moja, idadi ya mali zilizochaguliwa inaweza kuondoka kwenye \(B\). Badala yake, katika hatua moja Swap-SA:
- huondoa mali moja kutoka seti iliyochaguliwa,
- huongeza mali moja kutoka seti isiyochaguliwa,
- hivyo haibadilishi jumla ya idadi ya mali zilizochaguliwa.
Uwezekano wa kukubali ubadilishaji:
\[ P_{\mathrm{accept}} = \min \left( 1, e^{-\Delta E/T} \right). \]
Nishati ikipungua, kwa kuwa \(\Delta E\leq0\), ubadilishaji hukubaliwa. Nishati ikiongezeka, hasa joto \(T\) likiwa juu, hatua zinazozidisha hali zinaweza pia kukubaliwa kwa uwezekano fulani ili kuwezesha kutoka kwenye minimum ya ndani.
Joto hupungua kwa kijiometria:
\[ T_r = T_0 \left( \frac{T_{end}}{T_0} \right)^{r/(N_{reads}-1)}, \]
\[ T_0=0.5\|Q\|_{\infty}, \qquad T_{end}=10^{-4}T_0. \tag{11} \]
Kutokana na muundo wa swap, katika utafutaji wote:
\[ \sum_i x_i=B \]
huhifadhiwa.
Muundo wa warm-start na majority-vote
Mtiririko wa suluhisho una hatua nne:
- neal SA huendeshwa na \(x^\ast_{neal}\) yenye nishati ya chini zaidi huhifadhiwa.
- Swap-SA huendeshwa kutoka mwanzo tofauti na \(x^\ast_{swap}\) hupatikana.
- Kati ya suluhisho mbili, ile yenye nishati ya chini ya QUBO huhifadhiwa.
- Ikiwa cardinality bado ni tofauti, informed enforcement hutumika kulingana na alama ya diagonal \(Q\).
Zaidi ya hayo, minyororo mitano huru ya swap-SA huendeshwa. Ikiwa wastani wa uteuzi wa mali katika suluhisho tano ni angalau 0,5, mali hiyo huhesabiwa kuwa imechaguliwa katika consensus portfolio.
Chanzo kinaripoti kwamba katika masoko manne yasiyo kripto, mkengeuko sanifu wa QUBO energy kati ya seed ni chini ya %5 ya nishati ya wastani na asset consistency huzidi 0,85 nchini India, Marekani, Ulaya na Japani. Katika soko la kripto, variansi ya suluhisho ni kubwa zaidi pamoja na kutotulia kwa rejimu.
Uzani wa mali zilizochaguliwa huamuliwaje?
Baada ya QUBO kufanya uteuzi wa mali pekee, tatizo la kawaida la mean-variance hutatuliwa kwenye selected set \(S\):
\[ \min_w \quad w^\top\Sigma_S w - q(\mu_S-r_f)\cdot w \]
kwa vizuizi vifuatavyo:
\[ \sum_i w_i=1, \qquad w_{\mathrm{floor}} \leq w_i \leq w_{\max}^{(m)}. \tag{12} \]
Chanzo hutoa kikomo cha chini cha uzani kama:
\[ w_{\mathrm{floor}} = \min \left( \frac{1}{5|S|}, \frac{0.9}{|S|} \right) \]
. Lengo ni kupunguza kujikusanya kupita kiasi katika mali moja au suluhisho chache za pembezoni.
Mpangilio wa solver:
CLARABEL → SCS → ECOS
. Ikiwa zote zitashindwa, minimum-variance fallback hutumika; ikiwa nayo itashindwa, equal-weight portfolio hutumika.
Mabadiliko ya thamani ya backtest
Chanzo husasisha thamani ya jalada kwa:
\[ V_t = V_{t-1} \left( w^\top R_t \right) \tag{13} \]
. Kwa kuwa \(R_t\) imefafanuliwa kama gross daily return vector, \(w^\top R_t\) ni kizidishi cha ukuaji wa jalada cha siku hiyo.
Vipimo vya utendaji
Out-of-sample Sharpe:
\[ \mathrm{Sharpe} = \frac{ \bar r_p^{excess} }{ \sigma_p } \sqrt{252}. \]
Uwiano wa wastani wa excess return wa kila siku baada ya kuondoa risk-free rate kwa tete ya kila siku huwekwa kwa mwaka.
Marejesho yaliyowekwa kwa mwaka:
\[ R_{ann} = (1+R_{total})^{252/T_{OOS}}-1. \]
Chanzo huripoti kipimo hiki kama NaN ikiwa \(T_{OOS}<60\).
Tete ya out-of-sample:
\[ \sigma_{OOS} = \mathrm{std}(r_p)\sqrt{252}. \]
Maximum drawdown:
\[ \mathrm{MaxDD} = \min_t \left( \frac{ V_t }{ \max_{s\leq t}V_s } -1 \right). \]
Kadiri thamani inavyokuwa hasi zaidi, ndivyo jalada lilivyoshuka kwa kina zaidi kutoka kilele chake cha awali.
Diversification ratio:
\[ DR = \frac{ w^\top\sigma }{ \sqrt{w^\top\Sigma w} }, \qquad \sigma_i=\sqrt{\Sigma_{ii}}. \]
Chanzo pia huripoti risk-free-rate-adjusted annualised return.
Vigezo kwa kila soko
| Kigezo | India | Marekani | Ulaya | Japani | Kripto |
|---|---|---|---|---|---|
| Risk-free rate (%) | 6,5 | 5,25 | 3,5 | 0,1 | 0,0 |
| Transaction cost (bp/side) | 60 | 20 | 30 | 20 | 40 |
| Rebalance period (siku) | 63 | 63 | 42 | 42 | 21 |
| Uzani wa juu wa mali moja (%) | 40 | 35 | 35 | 40 | 25 |
| Tete ya juu ya mwaka | 0,75 | 0,60 | 0,60 | 0,70 | 5,00 |
| Maximum pairwise correlation | 0,65 | 0,80 | 0,80 | 0,85 | 0,75 |
| FR rolling window (siku) | 21 | 14 | 14 | 21 | 7 |
| Benchmark | NIFTY 50 | S&P 500 | STOXX 50 | Nikkei 225 | BTC |
Ukaguzi wa lookahead na mkusanyiko
Chanzo hutumia ukaguzi mitatu ya uchunguzi:
- Lookahead Bias Check: ulimwengu ulioundwa kwa kipindi chote hulinganishwa na ulimwengu ulioundwa kwa kutumia pre-test data pekee; overlap ikiwa chini ya %90, run huwekewa alama
SUSPECT. - Benchmark Parity Check: equal-weight portfolio katika sampled universe hulinganishwa na marejesho ya benchmark ya eneo hilo.
- Concentration Audit: Herfindahl effective-N, maximum weight na top-3 weight concentration hurekodiwa.
Chanzo hutoa ufafanuzi wa ukaguzi huu; hata hivyo, hakiripoti kwa muhtasari ni run ngapi ziliwekewa alama SUSPECT. Kwa hiyo haiwezekani kuhitimisha kwamba “lookahead bias imeondolewa kabisa”.
Mbinu na Matokeo ya Utafiti
Grid ya majaribio
| Kipimo | Thamani |
|---|---|
| Masoko | India, Marekani, Ulaya, Japani, Kripto |
| Ukubwa wa ulimwengu \(u\) | 10, 20, 30, 40, 50 |
| Cardinality ratio \(r\) | 0,2; 0,3; 0,4 |
| Risk aversion \(q\) | 0,3; 0,5; 0,7 |
| Lookback | siku 126, 252, 504 |
| Diversification penalty \(\delta_{div}\) | 0,3 — thabiti |
Baada ya kuondoa duplicate combinations ambapo thamani tofauti za \(r\) huzungushwa hadi thamani ileile ya \(B\), hadi usanidi 225 wa QUBO kwa kila soko na run za MPT zinazolingana zilitathminiwa.
QUBO na MPT katika wastani wa grid yote
| Soko | QUBO | MPT | Juu zaidi katika wastani wa grid |
|---|---|---|---|
| India | 0,2059 | 0,1944 | QUBO |
| Marekani | 1,0462 | 1,0679 | MPT |
| Ulaya | 0,3431 | 0,3176 | QUBO |
| Japani | 0,7688 | 0,8097 | MPT |
| Kripto | 0,1815 | 0,2229 | MPT |
Jedwali hili linaonyesha wazi kwamba QUBO si bora kwa wastani katika masoko yote matano. QUBO ilitoa grid-mean Sharpe ya juu nchini India na Ulaya, huku MPT ikiwa juu zaidi Marekani, Japani na kripto.
Marejesho yaliyowekwa kwa mwaka na maximum drawdown
| Soko | Marejesho ya mwaka ya QUBO | Marejesho ya mwaka ya MPT | QUBO Max DD | MPT Max DD |
|---|---|---|---|---|
| India | 0,0979 | 0,0949 | -0,1617 | -0,1663 |
| Marekani | 0,3488 | 0,3685 | -0,2318 | -0,2410 |
| Ulaya | 0,0948 | 0,0918 | -0,2398 | -0,2462 |
| Japani | 0,2108 | 0,2354 | -0,2189 | -0,2322 |
| Kripto | -0,0122 | 0,0049 | -0,3574 | -0,3491 |
Maximum drawdown ya wastani ni ndogo zaidi kwa QUBO kuliko MPT nchini India, Marekani, Ulaya na Japani. Katika soko la kripto, thamani ya wastani ya drawdown ya QUBO ni mbaya zaidi.
Je, QUBO ni Bora Kuliko Markowitz MPT ya Kawaida?
Chanzo hakionyeshi ubora usio na masharti: katika wastani wa grid yote ya vigezo, QUBO hutoa Sharpe ya juu zaidi nchini India na Ulaya pekee, huku MPT ikiwa mbele Marekani, Japani na kripto; lakini usanidi bora wa kila soko unapolinganishwa, QUBO hushinda MPT katika masoko manne kati ya matano, isipokuwa Japani.
Ulinganisho wa Sharpe wa usanidi bora zaidi
| Soko | QUBO bora zaidi | MPT bora zaidi | QUBO+Rebal | drift-rebalance iliyotekelezwa |
|---|---|---|---|---|
| Ulaya | 1,68 | 1,53 | -0,35 | 4 |
| Marekani | 1,09 | 1,05 | 0,99 | 0 |
| Kripto | 1,20 | 1,17 | 0,55 | 9 |
| India | 0,89 | 0,45 | 0,99 | 0 |
| Japani | 0,69 | 0,82 | 0,67 | 0 |
Katika jedwali hili kuna mantiki mbili tofauti za uteuzi: usanidi bora wa grid wa static QUBO na usanidi bora wa walk-forward grid wa QUBO+Rebal huchaguliwa kila mmoja kivyake. Kwa hiyo, kwa mfano, ingawa nchini India imeandikwa 0×RB, kuripotiwa 0,99 kwa QUBO+Rebal na 0,89 kwa static QUBO best tofauti si mkanganyiko wa moja kwa moja wa kihesabu. Kulingana na maelezo ya mbinu ya chanzo, 0×RB humaanisha kwamba katika usanidi husika wa QUBO+Rebal hakukuwa na shughuli ya drift-triggered na uzani wa usanidi huo ulibaki sawa na underlying static QUBO yake; uteuzi wa “best” katika mistari miwili unaweza kutoka katika grid configurations tofauti.
Matokeo ya Ulaya
Ulaya, thamani bora ya static QUBO Sharpe ni 1,68 na MPT ni 1,53. Chanzo kinaripoti kuwa jalada hizo mbili zilisogea karibu hadi kushuka kwa soko kwa takriban %22 karibu na Aprili 2025; baada ya hapo QUBO ilipata nafuu haraka zaidi.
QUBO+Rebal ilitoa Sharpe ya -0,35 baada ya kusawazisha upya mara nne na katika chanzo ilibaki chini ya mikakati ya static na benchmark tulivu.
Matokeo ya Marekani
Marekani, thamani bora za QUBO na MPT ziko karibu sana:
\[ 1.09 \quad \text{vs.} \quad 1.05. \]
QUBO+Rebal imeripotiwa na Sharpe 0,99 na kwa kuwa ni 0×RB, hakuna drift-triggered rebalance iliyotokea.
Matokeo ya kripto
Katika kripto, static QUBO Sharpe bora ni 1,20 na MPT ni 1,17. Chanzo kinaripoti kwamba mikakati yote miwili ya static ilipanda kutoka thamani ya kuanzia ya takriban milioni 1,6 hadi kilele cha zaidi ya milioni 4,6 na kisha ikashuka kwa kasi hadi takriban milioni 3; drawdown zilifikia takriban -%40.
QUBO+Rebal ilifanya rebalance tisa na Sharpe ikashuka hadi 0,55. Ingawa lahaja ya rebalance ilibaki katika eneo la drawdown lisilo na kina sana la takriban -%25 hadi -%35, chanzo kinasema gharama za miamala na kodi ziliondoa faida ya marejesho.
Matokeo ya India
India hutoa tofauti kubwa zaidi ya QUBO–MPT katika ulinganisho wa usanidi bora wa static katika utafiti:
\[ \mathrm{Sharpe}_{QUBO}=0.89, \qquad \mathrm{Sharpe}_{MPT}=0.45. \]
Chanzo kinaripoti kuwa QUBO ilianza kutengana taratibu na MPT baada ya Aprili 2025 na katika vipindi fulani ilionyesha drawdown isiyo na kina sana.
Matokeo ya Japani
Japani ndiyo soko pekee ambapo MPT inazidi QUBO katika uwiano wa Sharpe wa usanidi bora:
\[ 0.82 \quad \text{vs.} \quad 0.69. \]
Hata hivyo, chanzo kinasisitiza kuwa marejesho ya juu ya MPT katika rally ya Agosti–Novemba 2025 yaliambatana na vipindi viwili tofauti vya drawdown vya takriban -%30 hadi -%39, na QUBO ilidumisha wasifu wa drawdown usio na kina sana. Kwa hiyo waandishi hawatafsiri matokeo ya Japani kwa nambari moja ya Sharpe pekee.
Mandhari ya risk-return
Chanzo kinaonyesha mchanganyiko wote wa soko, ukubwa wa ulimwengu, cardinality ratio, risk-aversion na lookback kwenye risk-return scatter moja. Kuingiliana kwa kiasi kikubwa kwa mawingu ya pointi ya QUBO na MPT kunaendana na ukaribu wa jumla wa mbinu hizi mbili katika matokeo ya grid-mean Sharpe.
Kwa kila soko, masoko ya hisa yaliyoendelea yana msongamano zaidi katika maeneo ya tete ndogo, huku kripto ikitawala mkia wa tete kubwa. Chanzo kinahusisha hili na volatility cap ya juu zaidi inayotumika kwa mali za kidijitali na kutotulia kwa rejimu.
Kwa kuwa coordinates mbichi za scatter hazikutolewa kama jedwali ndani ya PDF, Verianla haitengenezi wingu jipya la pointi.
Ni nini hasa kilipatikana kuhusu ukubwa wa ulimwengu?
Chanzo kinaandika kuwa ulimwengu wa \(u=10\) una variansi kubwa zaidi katika usambazaji wa Sharpe kutokana na mseto mdogo; \(u=30\)–50 inaweza kuwa thabiti zaidi lakini wakati mwingine kutoa wastani wa Sharpe wa chini.
Kwa upande mwingine, chanzo kinasema kwamba faida ya QUBO dhidi ya MPT katika \(u=20\)–30 inatarajiwa kuwa kubwa zaidi na kinaeleza wazi kwamba hili linapaswa kuthibitishwa matokeo ya per-universe-size yatakapowekwa kwenye jedwali. Kwa hiyo, matokeo ya \(u=20\)–30 hayapaswi kuwasilishwa kama ugunduzi mkuu uliothibitishwa.
Dirisha la lookback
Chanzo kinaripoti kwamba lookback ya siku 252 ilitoa utendaji wa out-of-sample ulio thabiti zaidi katika masoko. Dirisha la siku 504 linasemekana kuwa dhaifu zaidi hasa katika kripto mbele ya mabadiliko ya haraka ya rejimu kutokana na stale covariance estimates.
Imeandikwa kwamba dirisha la siku 126 linatarajiwa kutoa variansi kubwa zaidi ya Sharpe na hasa kushindwa zaidi kwa \(\lambda\) sensitivity-test katika kripto na India. Kwa kuwa chanzo kinatoa kauli hii ya mwisho kwa lugha ya matarajio, Verianla huhifadhi hadhi hiyo hiyo.
Je, ubora wa GARCH-\(\lambda\) dhidi ya \(\lambda\) tuli ulipimwa moja kwa moja?
Hapana. Ingawa waandishi wanajadili kwamba GARCH scaling ni muhimu hasa katika soko la kripto ambako rejimu za tete hubadilika haraka, wanaeleza wazi kwamba controlled ablation ya moja kwa moja dhidi ya static unscaled \(\lambda\) ingeweza kutenga faida hii kwa usahihi zaidi na kwamba hili linapaswa kufanywa baadaye.
Mchango wa Forbes-Rigobon
Katika sehemu ya mjadala, waandishi wanasema kwamba bila marekebisho ya FR, uwiano wa Ledoit-Wolf huwa na mwelekeo wa kukadiriwa kupita kiasi katika vipindi vya variansi kubwa na hali hii inaweza kusababisha portfolio zilizo makini kupita kiasi. Uboreshaji unaoonekana zaidi unatafsiriwa kuwa katika muundo wa uwiano uliokadiriwa wa India na Japani.
Hata hivyo, kwa kuwa chanzo hakitoi jedwali tofauti la utendaji wa FR-off / FR-on, Verianla haitengenezi ukubwa halisi wa athari yake kwenye Sharpe.
Kwa nini QUBO+Rebal haikuwa uboreshaji wa moja kwa moja?
Katika lahaja ya walk-forward, katika kila rebalance point:
- ulimwengu huchukuliwa sampuli upya,
- \(\hat{\mu}\) na \(\hat{\Sigma}\) hukadiriwa upya,
- GARCH-\(\lambda\) huhesabiwa upya,
- QUBO hutatuliwa upya,
- uzani wa jalada huboreshwa upya.
Zaidi ya hayo, drift-triggered rebalance ya mapema inaweza kufanywa ikiwa mkengeuko kutoka uzani lengwa unazidi %5 katika masoko ya hisa na %8 katika kripto. Ili kupunguza miamala midogo isiyo ya lazima, no-trade band ni %2 katika masoko ya hisa na %3 katika kripto.
Katika kila rebalance iliyotekelezwa, transaction cost ya kila soko pamoja na short/long-term capital-gains tax huzingatiwa.
Katika chanzo, Ulaya na kripto ndiyo masoko mawili ambako drift trigger ilianza kufanya kazi kwa kweli. Katika masoko haya mawili, gharama za miamala na kodi zilikuwa kubwa kuliko faida ya uboreshaji upya na QUBO+Rebal ilibaki nyuma ya mikakati ya static.
Kikomo cha umuhimu wa kitakwimu
Chanzo hakitoi jaribio la kawaida la hypothesis, p-value, confidence interval au effect-size analysis kwa tofauti za utendaji wa jalada kati ya QUBO na MPT. Kwa uthabiti wa QUBO solver, energy standard deviation na asset consistency kati ya seed huripotiwa; lakini hizi si sawa na umuhimu wa kitakwimu wa tofauti ya marejesho ya jalada.
Kwa hiyo, kwa mfano, tofauti ya grid-mean Sharpe ya 0,2059 dhidi ya 0,1944 nchini India au 1,0462 dhidi ya 1,0679 Marekani haijaonyeshwa na chanzo kuwa “muhimu kitakwimu”.
Matokeo yanayoungwa mkono na utafiti
- Cardinality-preserving swap-SA ni mbinu inayotekelezeka ya suluhisho la QUBO inayohifadhi sharti la mali \(B\) haswa katika utafutaji wote.
- Utaratibu wa \(\lambda\) unaotegemea GARCH umebadilisha kiotomatiki ukubwa wa adhabu katika rejimu tofauti za tete.
- Ratio Test imeonekana kufanikiwa katika zaidi ya %90 ya usanidi kulingana na chanzo.
- Katika masoko manne yasiyo kripto, suluhisho za swap-SA majority-vote zimeonyesha asset consistency ya juu.
- Katika wastani wa grid, QUBO na MPT kwa ujumla ziko karibu; hakuna mbinu inayotawala wastani wa Sharpe katika masoko yote matano.
- Katika ulinganisho wa usanidi bora, QUBO imezidi uwiano wa Sharpe wa MPT katika masoko manne kati ya matano.
- Japani, MPT Sharpe bora ni ya juu zaidi; QUBO imeonyesha wasifu wa drawdown usio na kina sana.
- Drift-triggered QUBO+Rebal haikuweza kufidia gharama za miamala na kodi Ulaya na kripto.
Matokeo yasiyoungwa mkono na utafiti
- Haijaonyeshwa kwamba QUBO ni bora kuliko MPT katika masoko yote au vipindi vyote.
- Haijapimwa kwa ablation ya moja kwa moja ni kwa kiasi gani GARCH-\(\lambda\) huongeza uwiano wa Sharpe ikilinganishwa na \(\lambda\) tuli.
- Bado haijathibitishwa kwa matokeo yaliyowekwa kwenye jedwali kwamba QUBO hutoa faida kubwa zaidi kwa uhakika katika ulimwengu wa \(u=20\)–30.
- Backtest moja ya siku 252 si dhamana ya utendaji wa uwekezaji wa muda mrefu.
- Chanzo hakikutumia physical quantum annealer; suluhisho linategemea CPU simulated annealing ya kawaida.
- Kuwa na QUBO energy ya chini hakumaanishi kwamba out-of-sample Sharpe halisi lazima iwe ya juu.
- Haijaonyeshwa kwamba kufanya rebalance mara nyingi zaidi lazima kuboreshe utendaji.
- Matokeo ya chanzo si ushauri wa uwekezaji wala dhamana ya marejesho ya baadaye.
Vikwazo vikuu
Dirisha moja la out-of-sample: Kwa mujibu wa sehemu ya vikwazo ya waandishi, jaribio linajumuisha dirisha moja la backtest la siku 252 kwa mwaka 2025. Non-overlapping rolling tests za miaka mingi hazikufanywa.
Unyeti wa rejimu: Usambazaji wa financial return si stationary. Hasa katika kripto, lookback fupi inaweza kuwa na kelele na lookback ndefu inaweza kubeba rejimu za zamani.
QUBO na weight allocation zina hatua mbili: Kwa kuwa uteuzi wa mali na upangaji wa uzani hutatuliwa kando, joint optimisation haifanywi. Waandishi wanapendekeza kuvijumuisha vyote viwili katika QUBO moja katika siku zijazo.
Diversification penalty ni heuristic: Kizingiti cha uwiano 0,3 na \(\delta_{div}=0.3\) vimewekwa kwa heuristic na chanzo; havijaboreshwa kwa cross-validation.
Hakuna ablation ya Static-\(\lambda\): Hakuna jaribio la moja kwa moja lenye udhibiti lililofanywa kutenganisha kikamilifu mchango wa kipekee wa GARCH scaling na vipengele vingine.
Statistical inference ni ndogo: p-value na confidence interval hazijaripotiwa kwa tofauti za utendaji wa mikakati.
Tatizo la kurudia la Universe Table 2: Katika baadhi ya masoko ambayo baada ya kichujio cha tete yana mali chini ya \(u=50\), chanzo hakielezi jinsi idadi ilivyorejea hadi mali 50 baada ya clustering.
Matoleo ya programu hayajafungwa kikamilifu: Ingawa Python 3.12 imetajwa wazi, kwa dimod, neal, cvxpy, scikit-learn, arch na yfinance sehemu ya toleo ina neno “Latest” pekee. Hali hii inaweza kuleta kutokuwa na uhakika kwa environment reproduction ya kufanana kabisa baadaye.
Mizani: Utafiti unalenga majaribio makuu karibu na \(n\leq50\). Waandishi wanapendekeza tensor-network QUBO solver au physical quantum annealer kwa \(n>100\) kama kazi ya baadaye.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Multi-Market QUBO Portfolio Selection with Simulated Annealing and GARCH-Calibrated Penalties
Waandishi: Vivek Lakshman; Yashh Gokullgandhi; Vaishnavi Singh; Sudhir Ranjan Jain; Ashwini Dalvi; Irfan Siddavatam.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa bila kubadilishwa.
Taasisi: Waandishi wote sita wameorodheshwa katika PDF kwa affiliasheni ya K J Somaiya School of Engineering.
Mchango sawa: Hakuna alama ya mchango sawa au mwandishi mwenza wa kwanza iliyotambuliwa katika PDF.
Corresponding author: Hakuna corresponding author aliyewekewa alama tofauti katika PDF; anwani za barua pepe za waandishi wote zimetolewa kando kwenye ukurasa wa kwanza.
Aina ya chanzo: Preprint. Kwenye kichwa cha juu cha PDF imeandikwa wazi “A PREPRINT”.
Tarehe ya uchapishaji ndani ya PDF: Haijaonyeshwa. Kwenye sehemu ya tarehe ya ukurasa wa kwanza kuna “date” pekee; kwa hiyo tarehe kamili ya uchapishaji haijatolewa kutoka maandishi ya chanzo.
Metadata ya faili: Metadata ya faili ya PDF ina tarehe ya kutengenezwa 3 Septemba 2026; tarehe hii ya kiufundi ya faili haijakubaliwa kama tarehe ya bibliografia ya uchapishaji.
Zenodo DOI: Jina la faili iliyopakiwa lina kitambulisho 10.5281/zenodo.22809089. Kwa kuwa metadata rasmi ya Zenodo record haikupatikana kwa uhuru kupitia web wakati kazi hii ikiandaliwa, tarehe ya rekodi, resource type na sehemu za leseni za DOI hazikuchukuliwa kuwa zimethibitishwa kando.
Jarida / mkutano: Hakuna jina la jarida au mkutano uliopitiwa na wataalamu lililotolewa ndani ya PDF.
Hali ya mapitio: Kwa kuwa chanzo kinajieleza kuwa preprint, hakijawasilishwa kama chapisho lililopitiwa na wataalamu.
Leseni: Hakuna leseni ya wazi ya Creative Commons au leseni nyingine ya matumizi tena iliyotambuliwa katika maandishi ya PDF yaliyopakiwa. Leseni haijabuniwa.
Ufadhili: Hakuna funding statement tofauti iliyotambuliwa katika PDF.
Mgongano wa maslahi: Hakuna conflict-of-interest statement tofauti iliyotambuliwa katika PDF.
CRediT / michango ya waandishi: Hakuna CRediT contribution statement tofauti iliyotambuliwa.
Chanzo cha data: Data za bei na kiasi cha biashara kwa masoko matano zilipakuliwa kupitia yfinance. Benchmark ni NIFTY 50, S&P 500, EURO STOXX 50, Nikkei 225 na BTC.
Kipindi cha data: Januari 2022–Januari 2026.
Tathmini ya out-of-sample: Kulingana na sehemu ya vikwazo ya chanzo, dirisha moja la OOS backtest la siku 252 katika mwaka 2025.
Masoko: India, Marekani, Ulaya, Japani na kripto.
Jumla ya ticker: 250.
Uboreshaji mkuu: Cardinality-constrained QUBO asset selection + simulated annealing; baada ya uteuzi, mean-variance weight optimisation.
Kovariansi: Ledoit-Wolf shrinkage + marekebisho ya heteroskedastisiti ya Forbes-Rigobon; wakati \(T/n<5\), modeli ya faktori ya PCA inayoeleza angalau %80 ya variansi hutumika kama fallback.
Marejesho yanayotarajiwa: James-Stein shrinkage.
Cardinality penalty: Objective-anchored na GARCH(1,1)-scaled \(\lambda\), \(\gamma_{target}=3.0\).
Diversification penalty: \(\delta_{div}=0.3\); huanza kutumika kwa jozi zenye \(|\rho_{ij}|>0.3\).
SA ya kawaida: 1.000 reads × 3.000 sweeps × 5 random seed.
Swap-SA: Katika kila hatua, mali moja iliyochaguliwa hubadilishwa na mali moja isiyochaguliwa; cardinality hubaki thabiti katika utafutaji wote.
Consensus: Majority vote kwenye seed tano huru za swap-SA.
Weight solver: CLARABEL → SCS → ECOS; kisha minimum-variance na equal-weight fallback.
Grid ya vigezo: \(u\in\{10,20,30,40,50\}\); \(r\in\{0.2,0.3,0.4\}\); \(q\in\{0.3,0.5,0.7\}\); lookback \(\in\{126,252,504\}\) siku.
Idadi ya usanidi: Baada ya kuondoa duplicate cardinality combinations, hadi usanidi 225 wa QUBO kwa kila soko na matching MPT run.
Vipimo vya utendaji: OOS Sharpe ratio, annualised return, OOS volatility, maximum drawdown, diversification ratio na risk-free-rate-adjusted annualised return.
Programu: Python 3.12; dimod; neal; cvxpy; scikit-learn; arch; yfinance; pandas/numpy. Kwa vifurushi vingi chanzo huandika “Latest” badala ya exact version.
Kutolingana muhimu ndani ya chanzo: Jedwali 2 linaonyesha kwamba katika hali ya \(u=50\), baada ya kichujio cha tete baadhi ya masoko yana mali chini ya 50, lakini baada ya clustering mali 50 hupatikana tena; haijaelezwa katika maandishi ya mbinu jinsi mali zilizokosekana zilivyojazwa.
Matarajio yasiyothibitishwa ndani ya chanzo: Kauli kwamba faida ya QUBO itakuwa kubwa zaidi katika eneo la \(u=20\)–30 imetolewa katika chanzo kama “expected” na imeelezwa kwamba inapaswa kuthibitishwa kwa kuwekwa kwenye jedwali tofauti; haijawasilishwa kama matokeo ya uhakika yaliyopimwa.
Kikomo cha ablation ya GARCH: Hakuna ulinganisho uliofanywa unaotenga moja kwa moja GARCH-scaled \(\lambda\) dhidi ya static \(\lambda\), na waandishi wameacha hili kama future work.
Matokeo muhimu zaidi: Katika wastani wa grid yote, QUBO na MPT ziko karibu na hakuna mbinu iliyo bora katika masoko yote. Katika ulinganisho wa usanidi bora, QUBO huzidi MPT katika masoko manne kati ya matano; Japani ndiyo isipokuwa.
Matokeo muhimu zaidi ya vitendo ya kinyume: Uboreshaji upya wa walk-forward haukuweza kufidia gharama za miamala na kodi zilizotekelezwa Ulaya na kripto; uwezo wa kusawazisha upya haukuleta ongezeko la utendaji kiotomatiki.
Kikomo muhimu zaidi cha kimetodolojia: Kwa kuwa matokeo yanategemea dirisha moja la out-of-sample la siku 252 na inferential significance analysis haijaripotiwa kwa tofauti za utendaji wa mikakati, haiwezekani kutoa hitimisho la ubora wa muda mrefu au kati ya rejimu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *