


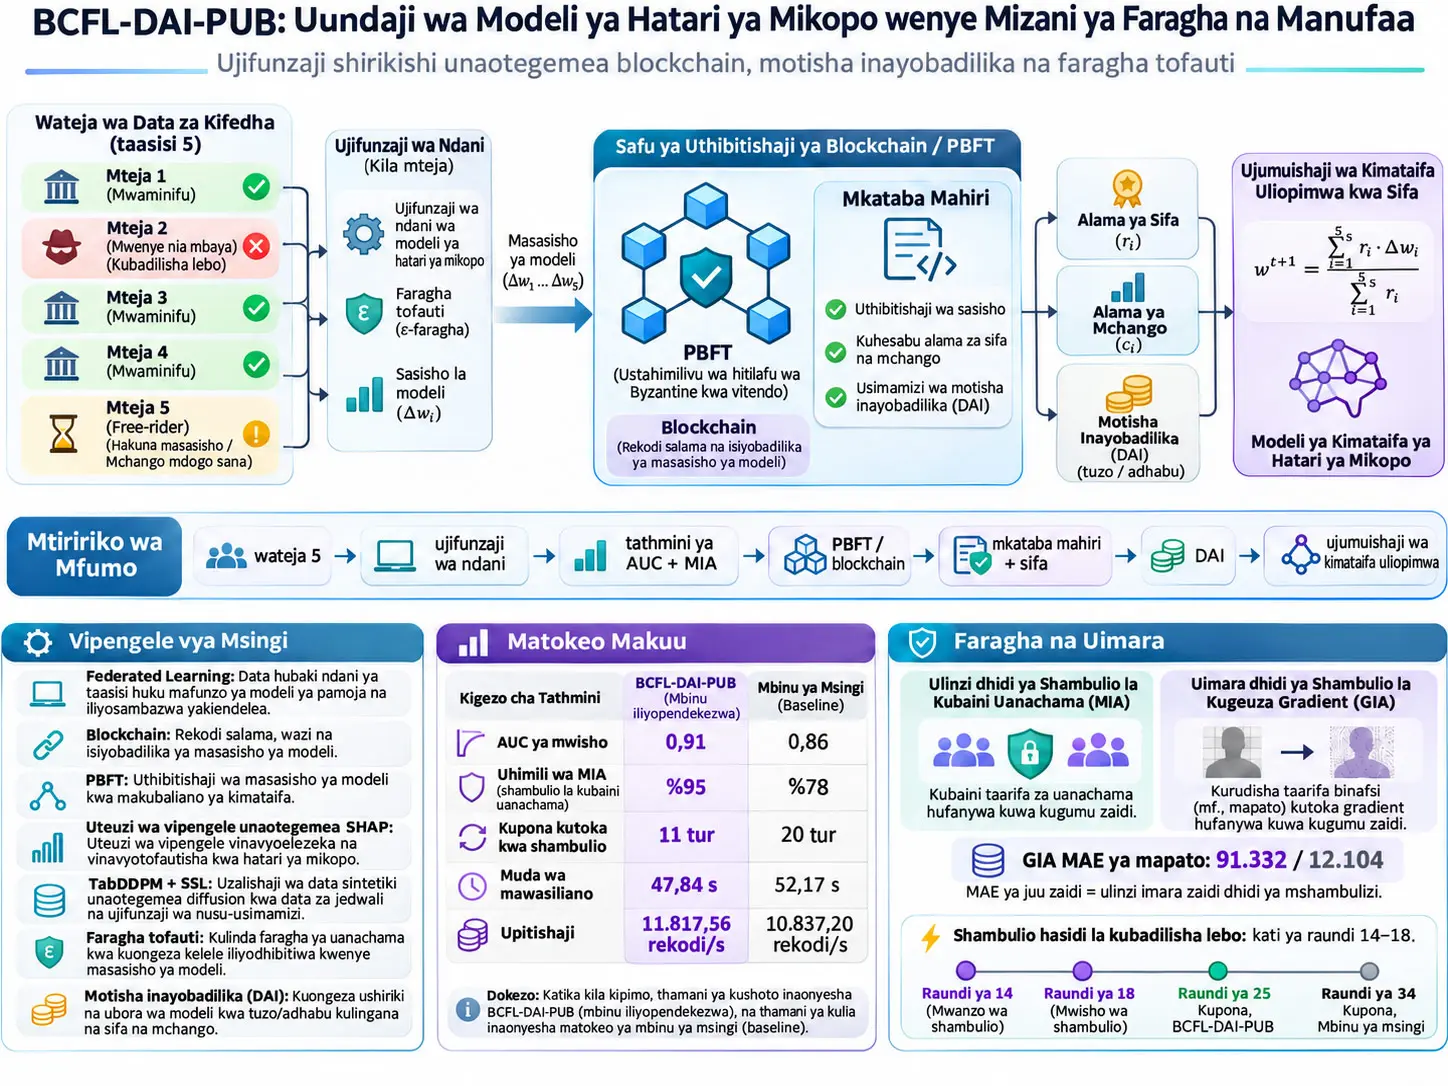
BCFL-DAI-PUB, ni mfumo wa blockchain-federated learning unaounganisha usimamizi wa blockchain, Federated Learning (FL), faragha tofauti katika kiwango cha optimizer, Tabular Denoising Diffusion Probabilistic Model (TabDDPM), tathmini ya modeli kati ya wenzao na utaratibu wa Dynamic Adaptive Incentive (DAI) kwa ajili ya uundaji wa modeli ya hatari ya mikopo. Mfumo huu unalenga kutathmini si utility ya modeli pekee bali pia mchango wa faragha wa wateja, kufanya uchaguzi wa nguvu kati ya correction inayotegemea SCAFFOLD, marekebisho ya privacy-budget na motisha ya kifedha; na kupunguza athari za wateja malicious na free-rider kwenye global model kupitia reputation-weighted aggregation.
Utafiti unatumia mkusanyiko wa data wa Home Credit Default Risk kwenye Kaggle. Mkusanyiko wa awali una rekodi 307.511 na vipengele 122; kutokuwiana kwa madarasa kati ya rekodi 24.825 za default ya mkopo zenye TARGET=1 na rekodi 282.686 za malipo yaliyofanikiwa zenye TARGET=0 kunarekebishwa kwa minority-class oversampling, na kuunda jumla ya rekodi 565.372 zilizosawazishwa. Data hizi zilizosawazishwa ziligawanywa kwa namna za near-IID na non-IID kati ya federated client watano walioigwa. Katika hali ya non-IID ambayo utafiti unaona kuwa ya uhalisia zaidi, kuna honest client watatu, label-flipping malicious client mmoja na free-rider mmoja.
Katika tathmini ya non-IID 10-fold cross-validation, BCFL-DAI-PUB iliripoti AUC 0,91501 ± 0,00007, Precision 0,83732 ± 0,00116, Recall 0,74946 ± 0,00018 na F1 Score 0,79096 ± 0,00008. Kwa baseline ya BCFL-PS-HER iliyolinganishwa, AUC ni 0,86071 ± 0,00123. Katika hali mchanganyiko ya honest + malicious + free-rider, modeli iliyopendekezwa ilifikia takriban 0,91 AUC katika raundi za mwisho, huku baseline ikifikia takriban 0,86 AUC.
Shambulio la label-flipping lilipoanzishwa katika raundi ya 14 na kusitishwa katika raundi ya 18, BCFL-DAI-PUB ilirejea kwenye kiwango chake cha AUC kabla ya shambulio katika raundi ya 25; muda wa recovery tangu kuanza kwa shambulio ulikuwa raundi 11. BCFL-PS-HER ilipona katika raundi ya 34 na ilihitaji raundi 20. Chanzo kinaripoti tofauti hii kama muda wa recovery wa baseline kuwa takriban mara 1,82 mrefu zaidi.
Katika tathmini za faragha, final Membership Inference Attack (MIA) Advantage ya BCFL-DAI-PUB ni takriban 0,05, huku ya baseline ikiwa takriban 0,22. Kwa upande mwingine, resistance zilizohesabiwa kwa ufafanuzi \(R_{MIA}=1-Adv_{MIA}\) ni %95 na %78 mtawalia. Katika jaribio la Gradient Inversion Attack (GIA), MAE ya vipengele vyote kwa mbinu iliyopendekezwa iliripotiwa kuwa 42.105 ± 2.310, na MAE ya kipengele cha income kuwa 91.332 ± 9.104; thamani za baseline zilikuwa 4.821 ± 387 na 12.104 ± 1.208 mtawalia. MAE hii kubwa ina maana kwamba uundaji upya wa mshambuliaji ni mbaya zaidi; haimaanishi kwamba hitilafu ya utabiri wa modeli imeongezeka.
Kikomo muhimu zaidi cha tafsiri ni kwamba matokeo haya hayatoki kwenye mtandao wa production blockchain-federated learning uliojengwa kati ya benki au taasisi halisi za fedha. Wateja waliigwa kutoka kwenye mkusanyiko mmoja wa data ya mikopo wa umma, na tabia malicious/free-rider zilifafanuliwa katika mazingira yanayodhibitiwa. Kwa hiyo, 0,91 AUC, %95 MIA resistance au recovery ya raundi 11 havihakikishi kiotomatiki utendaji huohuo katika taasisi halisi za fedha.
BCFL-DAI-PUB ni Nini?
BCFL-DAI-PUB ni mfumo wa uundaji wa modeli ya hatari ya mikopo unaolenga kubadilisha federated-learning aggregator ya kati kwa uratibu wa blockchain na smart-contract, kutathmini kwa pande zote sasisho za modeli za wateja kwa utility na privacy, na kurekebisha kwa nguvu motisha na athari ya kila mteja kwenye global-model kupitia utaratibu wa Dynamic Adaptive Incentive.
Tatizo ambalo utafiti unajaribu kutatua
Matumizi ya data kutoka taasisi nyingi za fedha katika modeli za hatari ya mikopo yanaweza kuruhusu modeli kuona borrower profiles zilizo tofauti zaidi. Hata hivyo, rekodi halisi za kifedha zinaposhirikiwa moja kwa moja kati ya taasisi, hujitokeza masuala ya faragha ya data, uzingatiaji wa kanuni na uaminifu. Federated Learning hupunguza tatizo hili kwa kuweka data ghafi ndani ya taasisi; lakini katika usanifu wa kawaida wa FL, aggregator ya kati inaweza kuleta tatizo la uaminifu na single-point-of-failure.
Blockchain-Federated Learning inalenga kufanya uratibu wa model-update uthibitishwe kupitia distributed ledger na smart contract. Lakini tatizo la pili linalosisitizwa na utafiti wa chanzo ni kwamba kuondoa aggregator ya kati pekee hakuhakikishi ushiriki wa uaminifu na endelevu wa wateja. Wateja wanaweza kuepuka gharama za hesabu, kutuma model update ya zamani, kufanya free-riding au kutengeneza kwa makusudi malicious model update.
Tatizo la tatu ni privacy–utility trade-off. Mbinu kali zaidi za privacy zinaweza kupunguza ishara ya kujifunza ya modeli; kulegeza privacy budget kwa ajili ya utility kubwa kunaweza kuongeza hatari ya inference attack. Kwa hiyo chanzo hufanya si predictive utility tu bali pia privacy contribution kuwa sehemu ya uamuzi wa motisha.
Pengo katika fasihi
Kwa mujibu wa mapitio ya fasihi ya chanzo, tafiti za federated-learning kwa hatari ya mikopo, ujumuishaji wa blockchain, mifumo ya incentive na mbinu za privacy-preserving zimeendelezwa kila moja kivyake; lakini tafiti zinazoshughulikia predictive utility, privacy preservation na adversarially robust incentive allocation kwa pamoja ndani ya blockchain-federated framework moja katika credit-risk setting ni chache.
Michango mitano mikuu ya BCFL-DAI-PUB iliyoelezwa kwenye chanzo ni hii:
- Global preprocessing inayoratibiwa na smart contract.
- Global feature selection inayotegemea SHAP na inayoweza kuthibitishwa kwa blockchain.
- Privacy-preserving generative model inayotegemea TabDDPM na kuanzishwa kwa Self-Supervised Learning.
- Utaratibu wa Dynamic Adaptive Incentive unaotumia pamoja utility na privacy contribution.
- Tathmini ya utility, privacy, recovery na system overhead chini ya honest, malicious na free-rider clients.
Mkusanyiko wa data na uwiano wa madarasa
| Kipengele | Thamani ya chanzo |
|---|---|
| Idadi ya rekodi za awali | 307.511 |
| TARGET=1 — loan defaulter | 24.825 |
| TARGET=0 — successful repayment | 282.686 |
| Numerical attribute | 106 |
| Categorical attribute | 16 |
| Jumla ya raw feature | 122 |
| Rekodi baada ya oversampling | 565.372 |
| TARGET=1 baada ya oversampling | 282.686 |
| TARGET=0 baada ya oversampling | 282.686 |
Chanzo kinasema kuwa oversampling ilitumika kwa minority class lakini hakitaji kwa undani algoritimu ya oversampling iliyotumika. Pia hakiripoti utaratibu wa kina wa kudhibiti data leakage kuhusu iwapo oversampling ilifanywa kando ndani ya cross-validation folds au baada ya balanced dataset yote kutengenezwa. Verianla haijazi pengo hili kwa kuongeza SMOTE ya kudhaniwa au mbinu nyingine ya sampling.
Mlinganyo 1–3: Tatizo la msingi la uboreshaji katika Federated Learning
Kila mteja \(C_i\) huhifadhi mkusanyiko wake wa data wa ndani:
\[ D_i=\{(x_j,y_j)\}_{j=1}^{n_i}. \tag{1} \]
Unahesabu nini? Mlinganyo 1 ni ufafanuzi wa kihisabati wa mkusanyiko wa data wa ndani wa mteja \(i\) zaidi kuliko fomula ya hesabu. \(x_j\) ni vekta ya vipengele, \(y_j\) ni darasa lengwa na \(n_i\) ni idadi ya sampuli za ndani za mteja.
Lengo la global:
\[ \min_{w\in\mathbb{R}^{d}} F(w), \tag{2} \]
na:
\[ F(w)= \sum_{i=1}^{N} \frac{n_i}{n}F_i(w), \qquad n=\sum_{i=1}^{N}n_i. \]
Local loss function ya kila mteja:
\[ F_i(w)= \frac{1}{n_i} \sum_{(x_j,y_j)\in D_i} \ell(w;x_j,y_j). \tag{3} \]
Jukumu la kihisabati: Milinganyo 2–3 hufafanua classical weighted federated objective. Mteja mwenye mkusanyiko mkubwa wa data hutoa mchango mkubwa zaidi kwa global objective kupitia uzito wa \(n_i/n\).
Kizio: \(w\) ni vekta ya vigezo vya modeli. \(F\) na \(\ell\) hazina kizio cha kimwili; ni thamani za objective za nambari zinazotegemea loss function ya modeli.
Kwa nini Blockchain inaongezwa?
Tabaka la BCFL hubadilisha shughuli za model update na evaluation kuwa transaction zinazoweza kuthibitishwa kwenye blockchain katika usanifu wa chanzo. Validator node huthibitisha transaction kupitia Practical Byzantine Fault Tolerance (PBFT) consensus. Smart contract husimamia vigezo vya global preprocessing, marejeo ya feature-selection, reputation, contribution score na maamuzi ya incentive.
Katika Figure 1 ya chanzo pia kuna Task Publisher inayoonyeshwa kama jukumu la kuanzisha linalounda global model na kuisambaza kwa wateja. Kwa hiyo kauli “fully decentralized” iliyotumiwa kwenye chanzo haipaswi kupanuliwa kumaanisha kwamba mfumo hauna jukumu lolote la kuanzisha; dai kuu la decentralization ni kwamba uratibu wa model-update, uthibitishaji na aggregation hautegemei aggregator ya kati inayoaminika.
Faragha Tofauti Inalinda Nini Katika Utafiti Huu?
Katika BCFL-DAI-PUB, faragha tofauti inalenga kufanya urejeshaji wa rekodi binafsi za mafunzo kupitia gradient inversion na membership inference kuwa mgumu kwa kupotosha taarifa ya gradient katika kiwango cha optimizer kwa clipping na Gaussian noise, tofauti na kusimba kwa siri njia ya mawasiliano ya model-update.
Mlinganyo 4–5: Utaratibu wa Gaussian wa faragha tofauti
Chanzo kinatoa utaratibu wa jumla wa Gaussian kama:
\[ M(D)=f(D)+\mathcal{N}(0,\sigma^2 I) \tag{4} \]
katika muundo huu.
Kiwango cha kelele:
\[ \sigma \ge \frac{ \Delta_2f\sqrt{2\ln(1.25/\delta)} }{ \epsilon }. \tag{5} \]
\(D\) mkusanyiko binafsi wa data, \(f(D)\) hesabu itakayochapishwa, \(\Delta_2f\) thamani ya L2 sensitivity, \(\epsilon\) privacy budget, \(\delta\) kigezo cha privacy-failure chenye uwezekano mdogo na \(\sigma\) kiwango cha Gaussian noise.
Katika mantiki ya DAI ya chanzo, utility ikiwa juu lakini privacy contribution ikiwa chini, privacy budget hupunguzwa ili kuimarisha faragha. Katika Table 7, privacy-budget adjustment:
\[ \Delta\epsilon=0.10 \]
imetolewa.
Mlinganyo 6: Objective ya Gradient Inversion Attack
\[ \mathcal{L}(\hat{x}) = \left\| \nabla_{\theta} \mathcal{L}(f_{\theta}(\hat{x});y) - g_i \right\|_2^2 + \lambda_{TV}TV(\hat{x}) + \lambda_{range} \sum_j \left[ \max(0,\hat{x}_j-u_j)^2 + \max(0,l_j-\hat{x}_j)^2 \right]. \tag{6} \]
Kipengele cha kwanza hupunguza tofauti kati ya gradient iliyotengenezwa na sampuli sintetiki ya mshambuliaji na gradient iliyozingatiwa. \(TV(\hat{x})\) ni kipengele cha regularization. \(l_j\) na \(u_j\) hujaribu kuhifadhi mipaka halali ya chini/juu ya tabular features.
Chanzo kinasema kuwa katika honest-but-curious attacker model mshambuliaji anaweza kufikia public model parameters, lakini huona aggregated update badala ya individual client gradient.
Mlinganyo 7–8: Ubora wa uundaji upya wa GIA
\[ MAE= \frac{1}{d} \sum_{j=1}^{d} |\hat{x}_j-x_j|. \tag{7} \]
MAE ikiwa ndogo, reconstruction iko karibu zaidi na sampuli ya awali; kwa mtazamo wa ulinzi wa faragha mshambuliaji amefanikiwa zaidi. Kwa hiyo katika jedwali la GIA MAE kubwa zaidi ni bora kwa upande wa ulinzi.
Inference indicator katika kiwango cha sampuli moja kwa protected categorical attribute:
\[ AIA= \mathbf{1}\{\hat{a}=a^*\}. \tag{8} \]
Hapa \(\hat a\) ni attribute iliyokadiriwa na mshambuliaji na \(a^*\) ni thamani halisi ya attribute. Gender Inference Accuracy katika Table 11 ni kipimo cha jumla cha usahihi wa matokeo sahihi/isiyo sahihi katika kiwango cha sampuli moja.
Mlinganyo 9–11: Membership Inference Attack
Loss ya sampuli kwenye modeli:
\[ \ell(x^*,y^*) = \mathcal{L}(f_{\theta}(x^*),y^*). \tag{9} \]
Membership threshold:
\[ T_{MIA} = \operatorname{median} \{\ell(x_i,y_i)\}. \tag{10} \]
Kwenye chanzo, ikiwa loss:
\[ \ell(x^*,y^*) < T_{MIA} \]
basi sampuli huainishwa kama training member.
MIA Advantage:
\[ Adv_{MIA} = TPR-FPR. \tag{11} \]
Kwa tafsiri ya chanzo \(Adv_{MIA}\le0.05\) ni negligible risk; thamani zilizo juu ya 0,10 zimechukuliwa kuwa privacy leakage muhimu.
Chanzo pia hufafanua bila namba:
\[ R_{MIA}=1-Adv_{MIA} \]
na resistance score. Kwa hiyo \(Adv_{MIA}\) ya chini na \(R_{MIA}\) ya juu huashiria faragha yenye nguvu zaidi.
Mlinganyo 12–13: Label-flipping poisoning
Lebo ya binary class hubadilishwa na mteja malicious kama:
\[ y_i^{mal}=1-y_i \tag{12} \]
na kugeuzwa kinyume.
Malicious gradient inayotokana nayo:
\[ \widetilde{g}_i = \nabla_{\theta} \mathcal{L} (f_{\theta}(x_i),y_i^{mal}). \tag{13} \]
Update hizi hujaribu kuathiri global model kuelekea darasa la kinyume. Katika utafiti, label-flipping attack ilianzishwa katika communication round 14 na kusimamishwa katika round 18.
Vipimo vya poisoning recovery
Chanzo kinafafanua uchanganuzi wa recovery katika Table 3 kwa vipimo vifuatavyo:
\[ AUC_{before} = \frac{1}{t_s-1} \sum_{t=1}^{t_s-1} AUC_t \]
\[ AUC_{attack} = \frac{1}{t_e-t_s+1} \sum_{t=t_s}^{t_e} AUC_t \]
\[ AUC_{min} = \min_{t_s\le t\le t_e} AUC_t \]
\[ t_r = \min_{t>t_e} \left\{ t\mid AUC_t\ge AUC_{before}-\varepsilon \right\} \]
\[ NR_{start}=t_r-t_s, \qquad NR_{end}=t_r-t_e \]
\[ AUC_{after} = \frac{1}{T-t_r} \sum_{t=t_r+1}^{T} AUC_t \]
\[ \Delta_{drop}=AUC_{before}-AUC_{min} \]
\[ \Delta_{recover}=AUC_{after}-AUC_{min} \]
\[ RecoveryRatio = \frac{\Delta_{recover}}{\Delta_{drop}}. \]
\(NR_{start}\) ni jumla ya idadi ya raundi tangu shambulio lianze hadi pre-attack performance irejee. \(NR_{end}\) hupima muda wa ziada wa recovery unaohitajika baada ya shambulio kusimama.
Global preprocessing inayodhibitiwa na smart-contract
BCFL-DAI-PUB inalenga kusawazisha global preprocessing schema kupitia smart contract ili kuzuia tofauti za feature encoding na normalization kati ya taasisi zinazoshiriki.
Mlinganyo 14: Global numerical mean
\[ \mu_{global} = \frac{1}{N} \sum_{i=1}^{N}\mu_i. \tag{14} \]
Kila mteja hutuma local mean yake kwa numerical feature na smart contract huhesabu wastani rahisi wa kihesabu wa local means.
Dokezo muhimu la kihisabati: Eq. 14 si pooled sample mean iliyowekwa uzito kwa ukubwa wa data ya mteja \(n_i\). Ukubwa wa wateja ukitofautiana:
\[ \frac{1}{N}\sum_i\mu_i \]
kwa ujumla si sawa na wastani unaohesabiwa kwa kuweka rekodi zote katika dimbwi moja. Kwa kuwa chanzo kimefafanua fomula hivi, Verianla haibadilishi kimya kimya na fomula iliyowekwa uzito.
Mlinganyo 15: Global categorical vocabulary
\[ C_{global} = \bigcup_{i=1}^{N}C_i. \tag{15} \]
Unique values zinazoonekana na kila mteja katika categorical features zake huunganishwa katika global dictionary moja kwa operesheni ya union. Hivyo, lengo ni kwamba vipimo vya One-Hot Encoding viwe sawa kwa wateja wote.
Global mean, thamani za min–max na \(C_{global}\) huhifadhiwa kwenye IPFS kama JSON schema iliyosanifishwa; schema hash husajiliwa kwenye blockchain.
Baada ya one-hot encoding, raw attribute 122:
245 preprocessed feature
zimepatikana.
Mlinganyo 16–17: Global feature selection kwa SHAP
Katika mteja \(i\), thamani ya SHAP importance ya feature \(f\) ni:
\[ I_i(f) = \frac{1}{n_{samples}} \sum_{j=1}^{n_{samples}} |\phi_j(f)|. \tag{16} \]
\(\phi_j(f)\) kwa sampuli \(j\) ni thamani ya SHAP contribution ya feature \(f\).
Global feature importance:
\[ I_{global}(f) = \frac{1}{N} \sum_{i=1}^{N} I_i(f). \tag{17} \]
Hapa pia wateja hupewa uzito sawa katika wastani; weighting kwa local dataset size haijatumika.
Features hupangwa kwa mpangilio wa kushuka kulingana na \(I_{global}(f)\), na huchaguliwa hadi jumla ya cumulative importance ifikie %75. Matokeo yake, kati ya 245 feature 184 featurezimechaguliwa.
Algorithm 1 inafanya nini?
Mtiririko wa kisayansi wa Algorithm 1:
- Kila mteja hutoa local mean, min–max na categorical vocabulary.
- Smart contract hubadilisha thamani hizi kuwa global preprocessing schema.
- Schema hupakiwa IPFS na hash yake kuchapishwa kwenye blockchain.
- Wateja hutumia schema hiyo hiyo kufanya missing-value imputation, normalization na One-Hot Encoding.
- Kila mteja hufundisha LightGBM na kuhesabu SHAP importance kwa TreeExplainer.
- Thamani za global SHAP importance huwekwa wastani.
- Feature huchaguliwa hadi cumulative importance ifikie %75.
- Global feature set yenye 184 feature hufanyiwa finalize na smart contract.
Global model initialization
Model initialization ina hatua mbili. Katika hatua ya kwanza, deep tabular transformer hufanyiwa pretrain kwa self-supervised contrastive learning isiyohitaji label. Backbone iliyojifunza huhifadhiwa frozen katika diffusion training round kumi za kwanza na kisha hufunguliwa kwa fine-tuning.
Katika hatua ya pili, latent representation hii hutumika kama input ya mwanzo ya modeli ya TabDDPM.
Mlinganyo 18: Numerical forward diffusion
\[ x_t = \sqrt{\bar{\alpha}_t}x_0 + \sqrt{1-\bar{\alpha}_t}\epsilon, \qquad \epsilon\sim\mathcal{N}(0,I). \tag{18} \]
Hapa:
\[ \alpha_t=1-\beta_t, \qquad \bar{\alpha}_t=\prod_{i=1}^{t}\alpha_i. \]
\(\beta_t\) ni timestep noise schedule, \(x_0\) ni clean latent representation na \(x_t\) ni noise-corrupted numerical representation katika wakati t.
Mlinganyo 19: Categorical forward diffusion
\[ q(c_t\mid c_{t-1}) = (1-\beta_t)v(c_{t-1}) + \frac{\beta_t}{K}. \tag{19} \]
\(K\) ni idadi ya categorical state na \(v(c_{t-1})\) ni one-hot representation ya categorical state iliyotangulia. Hivyo continuous na categorical features huchakatwa ndani ya diffusion model moja kwa kanuni tofauti za noising.
Mlinganyo 20–22: Reverse denoising loss
Jumla ya loss:
\[ L_{total} = L_{mse}+L_{vlb}. \tag{20} \]
Numerical noise-prediction loss:
\[ L_{mse} = \mathbb{E}_{x_0,\epsilon,t} \left[ \| \epsilon-\epsilon_{\theta}(x_t,t) \|_2^2 \right]. \tag{21} \]
Kipengele cha Categorical Variational Lower Bound:
\[ L_{vlb} = \mathbb{E}_{q} \left[ \sum_{t=1}^{T} D_{KL} \left( q(c_{t-1}\mid c_t,c_0) \| p_{\theta}(c_{t-1}\mid c_t) \right) \right]. \tag{22} \]
\(D_{KL}\) ni Kullback–Leibler divergence kati ya reverse posterior halisi na reverse distribution iliyojifunza.
Mlinganyo 23: Gradient ya DP optimizer
\[ \widetilde{g} = \frac{1}{N} \sum_{i=1}^{N} \operatorname{clip}(g_i,C) + \mathcal{N} (0,\sigma^2C^2I). \tag{23} \]
\(C\) ni gradient clipping norm, \(\sigma\) ni noise multiplier na \(N\) ni batch size. Clipping hupunguza athari ya gradient ya sampuli moja; Gaussian noise huvuruga maelezo nyeti ya uhusiano wa gradient-data.
Dokezo la uwakilishi wa chanzo: Ingawa Eq. 23 inaonyesha wastani wa per-sample clipped gradients, katika pseudocode ya Algorithm 2 clipping imeandikwa kwenye alama moja ya \(g\) kama:
\[ \widetilde g = \frac{g}{\max(1,\|g\|_2/C)} + \mathcal{N}(0,\sigma^2C^2I) \]
Kauli hizi mbili zinawakilisha wazo lilelile la DP-SGD, lakini chanzo hakielezi tofauti ya granularidadi kando.
Algorithm 2 inafanya nini?
- Tabular Transformer hufundishwa kwa self-supervised contrastive pretraining.
- Uzito wa backbone huhifadhiwa frozen mwanzoni.
- Latent numerical \(x_0\) na categorical \(c_0\) representations hutengenezwa.
- TabDDPM denoising network huundwa.
- Katika kila iteration, timestep huchaguliwa.
- Numerical na categorical forward noise hutumika.
- Modeli hutabiri noise na category probability.
- MSE + VLB loss huhesabiwa.
- Gradient clipping na Gaussian noise hutumika.
- Katika stabilization round ya 10, backbone hufanywa unfrozen na kuhamia privacy-aware fine-tuning.
Mlinganyo 24: Local client model update
\[ w_{i,t+1} = w_{i,t} - \eta\nabla L_i(w_{i,t}). \tag{24} \]
\(\eta\) ni learning rate, \(L_i\) ni local loss na \(w_{i,t}\) ni vigezo vya modeli ya client \(i\) katika round \(t\).
Chanzo kinatoa mlinganyo huu lakini hakiripoti thamani ya nambari ya training learning rate ya jumla katika implementation table.
Mlinganyo 25: AUC kwa predictive utility
\[ AUC = \sum_{k=1}^{n} (FPR_{k+1}-FPR_k) \left( \frac{TPR_k+TPR_{k+1}}{2} \right). \tag{25} \]
Trapezoidal integration hii huhesabu eneo chini ya ROC curve. Kadiri AUC inavyoongezeka, class-ranking performance huimarika.
Mlinganyo 26: Privacy metric
\[ Adv_{MIA} = TPR-FPR. \tag{26} \]
Eq. 26 ni matumizi tena ya MIA Advantage iliyofafanuliwa awali kama Eq. 11 katika sehemu ya threat-model, katika hatua ya client self-assessment.
Mlinganyo 27–28: Peer evaluation vectors
Utility vector:
\[ ut_i = [ut_{i,1},ut_{i,2},\ldots,ut_{i,N}]. \tag{27} \]
Privacy vector:
\[ pt_i = [pt_{i,1},pt_{i,2},\ldots,pt_{i,N}]. \tag{28} \]
Evaluator \(E_i\) hutathmini modeli zote za client kwa kutumia data yake private. \(ut_{i,j}\) ni tathmini ya utility ya modeli ya client \(j\) inayotegemea AUC; \(pt_{i,j}\) ni tathmini ya privacy-vulnerability inayotegemea MIA Advantage.
Vectors hizi hutumwa kwenye blockchain kama signed transaction na kufanyiwa finalize kwa PBFT.
Utaratibu wa Dynamic Adaptive Incentive (DAI) Unafanyaje Kazi?
Katika kila communication round, utaratibu wa DAI huhesabu reputation kutoka peer-evaluated utility na thamani za privacy zinazotegemea MIA, huunganisha reputation na tabia ya zamani kupitia exponential moving average, huzingatia pia sehemu ya data ya client ili kutengeneza Utility Contribution na Privacy Contribution scores, na kutokana na scores hizo mbili huamua reward ya kifedha, kupunguza privacy-budget, SCAFFOLD correction au kutotoa incentive.
Mlinganyo 29: Wastani wa peer evaluation kwa kila client
\[ U_{i'}^{t} = \frac{1}{N} \sum_{i=1}^{N} ut_i^{t}[i'], \qquad P_{i'}^{t} = \frac{1}{N} \sum_{i=1}^{N} pt_i^{t}[i']. \tag{29} \]
\(U_{i'}^t\) ni score ya wastani ya utility ya client \(i'\) iliyotolewa na evaluators wengine. \(P_{i'}^t\) ni score ya wastani ya privacy-vulnerability inayotegemea MIA Advantage.
Mlinganyo 30: Reference utility na privacy kwa round
\[ U^t = \frac{1}{N} \sum_{i=1}^{N}U_i^t, \qquad P^t = \frac{1}{N} \sum_{i=1}^{N}P_i^t. \tag{30} \]
Thamani hizi hutumika kama round-wise reference katika hesabu ya reputation.
Mlinganyo 31: Normalize reputation
\[ Rep_{Ui}^{t} = 2\sigma \left( \gamma(U_i^t-U^t) \right)-1, \]
\[ Rep_{Pi}^{t} = 2\sigma \left( \gamma(P^t-P_i^t) \right)-1. \tag{31} \]
\(\sigma(\cdot)\) ni sigmoid function na \(\gamma\) ni parameter ya reputation sensitivity. Katika Table 7:
\[ \gamma=4.0 \]
imetolewa.
Katika utility reputation, utility ya client kuwa juu ya wastani wa global huunda reputation chanya. Kwa upande wa privacy ishara imegeuzwa: kwa kuwa \(P_i^t\) ni MIA vulnerability, privacy leakage iliyo chini kuliko wastani hutoa privacy reputation ya juu zaidi.
Mlinganyo 32: Historical reputation
\[ FR_{Ui}^{t} = (1-\lambda) FR_{Ui}^{t-1} + \lambda Rep_{Ui}^{t}, \]
\[ FR_{Pi}^{t} = (1-\lambda) FR_{Pi}^{t-1} + \lambda Rep_{Pi}^{t}. \tag{32} \]
Exponential moving average hii hupunguza uwezekano wa mabadiliko ya round moja kuamua reputation ghafla. Kwenye chanzo:
\[ \lambda=0.30. \]
Mlinganyo 33: Total reputation
\[ TR_i^t = FR_{Ui}^{t} + FR_{Pi}^{t}. \tag{33} \]
Kwa kuwa kila historical reputation component iko katika \([-1,1]\), \(TR_i^t\) kinadharia inaweza kufikia masafa ya \([-2,2]\).
Mlinganyo 34: Kuhamisha sehemu ya data kwenye kipimo cha contribution
\[ \pi_i = 2\frac{|D_i|}{|D|} - 1. \tag{34} \]
\(|D_i|/|D|\) ni sehemu ya client \(i\) katika data yote. Ubadilishaji wa mstari huhamisha thamani hii kwenye kipimo cha \([-1,1]\).
Mlinganyo 35: Utility na Privacy Contribution
\[ UC_i(t) = \alpha_c\pi_i + (1-\alpha_c)FR_{Ui}^{t}, \]
\[ PC_i(t) = \alpha_c\pi_i + (1-\alpha_c)FR_{Pi}^{t}. \tag{35} \]
Kwenye chanzo:
\[ \alpha_c=0.50. \]
Kwa hiyo nusu ya contribution score hutoka mapped data share na nusu hutoka historical reputation.
Mlinganyo 36: Uainishaji wa model-status
Chanzo kinafafanua kizingiti cha uamuzi kuwa:
\[ T_{DAI}=0.70 \]
na:
\[ \Psi(PC_i,UC_i) = \begin{cases} Balanced, & PC_i \gt T_{DAI} \land UC_i \gt T_{DAI} \\ Privacy\ Heavy, & PC_i \gt T_{DAI} \land 0\le UC_i\le T_{DAI} \\ Utility\ Heavy, & 0\le PC_i\le T_{DAI} \land UC_i\gt T_{DAI} \\ Low\ Contribution, & 0\le PC_i\le T_{DAI} \land 0\le UC_i\le T_{DAI} \\ No\ Contribution, & PC_i\lt0 \land UC_i\lt0 \end{cases} \tag{36} \]
Pengo la uamuzi ndani ya chanzo: Ufafanuzi huu wa piecewise hauelezi ni darasa gani linatumika ikiwa score moja ni hasi na nyingine ni sifuri au chanya. Kwa mfano, \(PC_i<0\) na \(UC_i>0\), au kinyume chake, haviingii katika tawi lolote la Eq. 36. Katika maelezo ya implementation, chanzo huhamisha baadhi ya malicious clients kwenye hali ya “No Contribution”; hata hivyo, jinsi mixed-sign cases zinavyoshughulikiwa katika implementation haijaainishwa wazi kwa fomula.
Mlinganyo 37: Incentive update rule
\[ I_i= \begin{cases} M\leftarrow M+monetary\_benefit, & \Psi=Balanced \\ S\leftarrow global\_correction\_error, & \Psi=Privacy\ Heavy \\ DP\leftarrow DP-0.1, & \Psi=Utility\ Heavy \\ S\leftarrow global\_correction\_error, & \Psi=Low\ Contribution \\ No\ Incentive, & \Psi=No\ Contribution \end{cases} \tag{37} \]
Balanced: Utility na privacy contribution zikiwa juu ya kizingiti, monetary benefit hutolewa.
Utility Heavy: Utility ikiwa juu lakini privacy contribution haitoshi, privacy budget hupunguzwa kwa 0,10 na DP huimarishwa.
Privacy Heavy: Privacy ikiwa juu lakini utility haitoshi, global correction error inayotegemea SCAFFOLD hutumika.
Low Contribution: Scores zote mbili zikiwa chanya lakini chini ya kizingiti, SCAFFOLD correction hutumika tena.
No Contribution: Katika Eq. 36 ya chanzo, ikiwa scores zote mbili ni hasi, incentive haitolewi.
Kikomo cha reproducibility: Chanzo hakiripoti kiasi cha fedha/kitengo cha token cha monetary benefit wala global_correction_error kama exact SCAFFOLD update formula katika sehemu hii. Thamani hizi hazijabuniwa na Verianla.
Vigezo vya DAI na DP katika Table 7
| Kigezo | Thamani ya chanzo |
|---|---|
| Reputation sensitivity \(\gamma\) | 4,0 |
| Historical reputation weight \(\lambda\) | 0,30 |
| Contribution weight \(\alpha_c\) | 0,50 |
| DAI threshold \(T_{DAI}\) | 0,70 |
| DP-Boost adjustment \(\Delta\epsilon\) | 0,10 |
| Gradient clipping norm \(C\) | 1,0 |
| Gaussian noise multiplier \(\sigma\) | 0,50 |
| Privacy parameter \(\delta\) | \(1\times10^{-5}\) |
| Initial privacy budget \(\epsilon_0\) | 1,20 |
| Privacy-budget range | 0,40–2,50 |
| Backbone unfreeze round | 10 |
| Feature-selection threshold | 0,75 cumulative importance |
| Cross-validation folds | 10 |
| Random seed | 42 |
Dokezo la privacy-budget ndani ya chanzo: Table 7 inatoa global initial privacy budget kama \(\epsilon_0=1,20\), huku maelezo ya malicious C2 na free-rider C5 yakisema kuwa \(\epsilon=2,0\) ilitumika katika hatua za mapema. Chanzo hakielezi kando njia kamili ya initialization/adaptation kutoka thamani ya mwanzo 1,20 hadi thamani hizi client-specific.
Mlinganyo 38: Reputation-weighted global aggregation
\[ w^{(t)} = \frac{ \sum_{i=1}^{N} TR_i\,w_i^{(t)} }{ \sum_{i=1}^{N} TR_i }. \tag{38} \]
Lengo la chanzo ni kupunguza uzito wa malicious au free-riding client updates zenye reputation ya chini kwenye global model, na kuhifadhi athari ya honest clients zenye reputation ya juu.
Kikomo cha tafsiri ya kihisabati: Kulingana na Eq. 33, \(TR_i\) ni jumla ya historical reputation mbili katika \([-1,1]\) na kinadharia inaweza kuwa hasi. Eq. 38 hutumia \(TR_i\) moja kwa moja kama uzito. Chanzo:
- hakielezi kama \(TR_i\) hasi hukatwa hadi sifuri,
- kama uzito hurekebishwa tena kwenye masafa chanya,
- au nini hufanyika ikiwa \(\sum_i TR_i=0\),
kwa uwazi. Kwa hiyo Verianla huhifadhi Eq. 38 kama ilivyo kwenye chanzo na haibuni sheria ya ziada ya normalization.
Mbinu na Matokeo ya Utafiti
Je, Matokeo Haya Yalipatikana Katika Matumizi Halisi ya Uwanjani Kati ya Benki?
Hapana. Utafiti haukutumia hifadhidata tofauti za taasisi halisi za fedha wala miundombinu ya production blockchain; mkusanyiko mmoja wa Home Credit Default Risk uligawanywa baada ya oversampling kwa federated clients watano walioigwa, na tabia honest, label-flipping malicious na free-riding ziliundwa katika hali za majaribio zinazodhibitiwa.
Near-IID client simulation
| Client | Sehemu | Rekodi | Class 0 | Class 1 | Jukumu |
|---|---|---|---|---|---|
| C1 | %40 | 226.149 | %49,50 | %50,50 | Honest |
| C2 | %25 | 141.343 | %49,00 | %51,00 | Malicious |
| C3 | %15 | 84.806 | %50,00 | %50,00 | Honest |
| C4 | %12 | 67.844 | %53,08 | %46,92 | Honest |
| C5 | %8 | 45.230 | %51,00 | %49,00 | Free-rider |
Non-IID client simulation
| Client | Sehemu | Rekodi | Class 0 | Class 1 | Jukumu |
|---|---|---|---|---|---|
| C1 | %35 | 197.880 | %70,00 | %30,00 | Honest |
| C2 | %30 | 169.612 | %25,00 | %75,00 | Malicious |
| C3 | %20 | 113.074 | %60,00 | %40,00 | Honest |
| C4 | %8 | 45.230 | %55,00 | %45,00 | Honest |
| C5 | %7 | 39.576 | %22,86 | %77,14 | Free-rider |
Chanzo hutumia \(\alpha_D=10,0\) kama heterogeneity ya chini/near-IID na \(\alpha_D=0,5\) kama hali ya non-IID yenye class skew yenye nguvu zaidi. Majaribio mengine makuu yalifanywa katika hali ya \(\alpha_D=0,5\), ambayo ilionekana kuwa ya uhalisia zaidi.
Near-IID na non-IID overhead
| Hali | Training time (s) | Consensus time (s) | Aggregation time (s) | Evaluation time (s) | Cumulative communication time (s) | Cumulative memory (MB) |
|---|---|---|---|---|---|---|
| \(\alpha_D=10,0\) | 12,56 | 21,07 | 1,15 | 10,25 | 45,03 | 39,42 |
| \(\alpha_D=0,5\) | 13,20 | 21,58 | 2,05 | 11,01 | 47,84 | 40,8 |
Chanzo kinaripoti kuwa katika hali ya non-IID total communication overhead iliongezeka kwa %6,24 na total memory usage kwa %3,50.
Near-IID na non-IID predictive performance
| Hali | AUC | Precision | Recall | F1 |
|---|---|---|---|---|
| \(\alpha_D=10,0\) | 0,92520 ± 0,00003 | 0,84992 ± 0,00003 | 0,75169 ± 0,00008 | 0,79779 ± 0,00003 |
| \(\alpha_D=0,5\) | 0,91501 ± 0,00007 | 0,83732 ± 0,00116 | 0,74946 ± 0,00018 | 0,79096 ± 0,00008 |
Katika mabadiliko kutoka near-IID hadi non-IID, chanzo kilihesabu kupungua kwa %1,10 katika AUC; %1,48 katika Precision; %0,30 katika Recall na %0,86 katika F1.
Thamani za “±” katika majedwali hutolewa pamoja na matokeo ya cross-validation na chanzo huzitafsiri kama fold variation ndogo; katika caption za Table 9 na Table 13 haijawekwa wazi kwa lebo ya safu ikiwa “±” ni standard deviation au standard error. Kwa hiyo Verianla haizibadilishi kiotomatiki kuwa aina fulani ya uncertainty.
Tabia ya DAI ya honest clients
Kwa C1, C3 na C4, chanzo kinaripoti kuwa interventions za DAI zilipeleka utility na privacy contribution kwenye hali ya balanced juu ya kizingiti cha takriban 0,70, na honest clients wote watatu walikaribia hali ya balanced karibu na communication round 30.
Utility ikiwa juu lakini privacy chini, \(\epsilon\) hupunguzwa; privacy ikiwa juu na utility chini, SCAFFOLD correction hutumika. Scores zote mbili zikizidi kizingiti, monetary incentive hutolewa.
Malicious Client C2
C2 ina %30 ya data yote katika hali ya non-IID. Kwa mujibu wa chanzo, utility ni karibu 0,85 hadi raundi ya 14. Label-flipping attack inapoanza katika raundi ya 14, utility score hushuka kutoka karibu 0,78 hadi −0,25, na chanzo kinasema C2 inawekwa katika hali ya “No Contribution” kuanzia raundi ya 15 na incentives zake kuondolewa.
Dokezo la mantiki ya uamuzi: Eq. 36 inahitaji \(PC_i<0\) na \(UC_i<0\) zote mbili kwa “No Contribution”. Ingawa grafu na maandishi ya chanzo yanaonyesha wazi utility kuwa hasi baada ya shambulio, hayafafanui kando kwamba privacy score pia ni hasi wakati wote. Kwa hiyo uhusiano wa implementation kati ya source narrative na piecewise Eq. 36 haujaandikwa kikamilifu.
Free-rider Client C5
Kwa mujibu wa chanzo, C5 ni free-rider anayesambaza outdated update bila kufanya local training yenye maana. Katika Fig. 8, final contribution score inaripotiwa kuwa karibu 0,35, na chanzo kinasema client huyu hapati incentive na athari yake kwenye global model imeondolewa.
Hata hivyo, kwa mujibu wa Table 4, ikiwa scores zote mbili za utility na privacy contribution ziko kati ya 0 na 0,70, hali ni “Low Contribution” na primary action ni “Scaffold Incentive”. Chanzo hakielezi kikamilifu ikiwa uamuzi wa “no incentive” kwa C5 unatokana na scores tofauti za utility na privacy au sheria nyingine ya implementation.
Contribution scores baada ya raundi 50
| Client | Jukumu | Contribution score |
|---|---|---|
| C1 | Honest | 0,72 |
| C2 | Malicious | −0,20 |
| C3 | Honest | 0,76 |
| C4 | Honest | 0,75 |
| C5 | Free-rider | 0,35 |
Honest clients pekee
Katika hali ambayo clients wote ni honest, final AUC ya BCFL-DAI-PUB hufikia:
\[ 0.93 \]
huku BCFL-PS-HER ikibaki katika:
\[ 0.88 \]
.
Hali ya honest + malicious + free-rider
Katika hali mchanganyiko, BCFL-DAI-PUB iliongezeka kutoka initial AUC ya karibu 0,70 hadi final AUC ya 0,91. Baseline iliongezeka kutoka karibu 0,60 hadi 0,86.
Recovery baada ya label-flipping attack
| Metriki | BCFL-DAI-PUB | BCFL-PS-HER |
|---|---|---|
| Attack start \(t_s\) | 14 | 14 |
| Attack end \(t_e\) | 18 | 18 |
| Pre-attack AUC | ≈0,81 | ≈0,70 |
| Recovery round \(t_r\) | 25 | 34 |
| Attack-onset recovery | raundi 11 | raundi 20 |
| Post-attack recovery delay | raundi 7 | raundi 16 |
| Utendaji wa mwisho | ≈0,91 | ≈0,86 |
Uwiano wa 20/11:
\[ \frac{20}{11}\approx1.82 \]
hivyo muda wa attack-onset recovery wa baseline ni takriban mara 1,82 wa ule wa mbinu iliyopendekezwa.
Mpangilio wa jaribio la Gradient Inversion Attack
GIA:
- katika communication round ya 50,
- kwa batch size = 1,
- kwenye clients watano,
- kwa kutumia vipengele vya iGIA na DiffGIA, analytical gradient matching, total-variation/range regularization na randomized diffusion timesteps
ilitekelezwa.
Kila shambulio lilirudiwa mara tano kwa kila client na Table 11 iliripotiwa kama mean ± standard deviation.
| Metriki | BCFL-PS-HER | BCFL-DAI-PUB | Tafsiri |
|---|---|---|---|
| MAE — feature zote 122 | 4.821 ± 387 | 42.105 ± 2.310 | Kwa Proposed, reconstruction error ya mshambuliaji ni 8,7× juu zaidi |
| MAE — Income | 12.104 ± 1.208 | 91.332 ± 9.104 | Kwa Proposed, 7,6× juu zaidi |
| Gender Inference Accuracy | 0,93 ± 0,04 | 0,52 ± 0,06 | −0,41 absolute |
| Reconstructed-data TARGET AUC | 0,823 ± 0,009 | 0,569 ± 0,014 | −0,254 |
Katika jedwali hili, kuongezeka kwa reconstruction MAE hakumaanishi modeli ya utabiri wa mikopo ya BCFL-DAI-PUB imekuwa mbaya; kunaonyesha kuwa private sample reconstruction ya mshambuliaji imekuwa mbaya zaidi.
Sehemu ya conclusion ya chanzo inasema gradient inversion “success rate” imepungua mara 7,6. Hata hivyo, katika Table 11 kipimo kilichopimwa moja kwa moja kama 7,6× ni ongezeko la Income MAE. Kwa hiyo Verianla haitaji tena 7,6× kama attack-success probability.
Matokeo ya Membership Inference Attack
| Mbinu | AdvMIA ya mwanzo | AdvMIA katika raundi ya 50 | Final \(R_{MIA}=1-Adv_{MIA}\) |
|---|---|---|---|
| BCFL-PS-HER | ≈0,50 | ≈0,22 | %78 |
| BCFL-DAI-PUB | ≈0,40 | ≈0,05 | %95 |
Chanzo:
\[ \frac{0.95}{0.78}\approx1.22 \]
kwa uwiano huu kinaripoti kuwa mbinu iliyopendekezwa hutoa MIA resistance takriban 1,22× juu zaidi.
Dokezo la lebo ya Figure: Caption ya Source Figure 16 inasema kwa usahihi “MIA Advantage”, lakini kichwa cha juu cha grafu kinatumia “Membership Inference Attack Resistance” na kinaandika “Lower is Better”. Metriki inayopaswa kuwa chini si resistance bali \(Adv_{MIA}\). Verianla hutenganisha MIA Advantage na MIA Resistance.
Ulinganisho wa system overhead
| Metriki | BCFL-PS-HER | BCFL-DAI-PUB |
|---|---|---|
| Training time | 14,01 s | 13,20 s |
| Consensus time | 22,04 s | 21,58 s |
| Aggregation time | 4,12 s | 2,05 s |
| Evaluation time | 12,00 s | 11,01 s |
| Cumulative communication time | 52,17 s | 47,84 s |
| Consensus size | 5,21 MB | 5,01 MB |
| Chain size | 2,12 MB | 1,78 MB |
| Model update size | 39,27 MB | 34,01 MB |
| Cumulative memory | 46,60 MB | 40,8 MB |
Chanzo kinaripoti cumulative communication overhead ya BCFL-DAI-PUB kuwa %8,29 chini ya baseline na cumulative storage/memory overhead kuwa %12,45 chini.
Kikomo cha istilahi: Thamani 52,17 na 47,84 ambazo chanzo kinaita “communication overhead” ziko katika sekunde; si kiasi cha network-byte. Kwa hiyo zinapaswa kutafsiriwa kama communication-cycle time / cumulative communication time.
Throughput
Katika usanidi huohuo wa clients watano:
| Mbinu | Throughput |
|---|---|
| BCFL-PS-HER | 10.837,20 records/s |
| BCFL-DAI-PUB | 11.817,56 records/s |
Chanzo kinahesabu ongezeko kuwa %9,05.
Thamani hii si blockchain transaction per second. Kipimo ni record/s zinazochakatwa katika jaribio la clients watano.
Ulinganisho wa 10-fold baseline
| Mbinu | AUC | Precision | Recall | F1 |
|---|---|---|---|---|
| BCFL-PS-HER | 0,86071 ± 0,00123 | 0,81916 ± 0,00131 | 0,72159 ± 0,0021 | 0,76727 ± 0,00102 |
| BCFL-DAI-PUB | 0,91501 ± 0,00007 | 0,83732 ± 0,00116 | 0,74946 ± 0,00018 | 0,79096 ± 0,00008 |
Chanzo kinahesabu maboresho ya uwiano kuwa:
- AUC: %6,31
- Precision: %2,22
- Recall: %3,86
- F1: %3,09
.
Ablation study
| Usanidi | Udhibiti wa free-rider | Udhibiti wa malicious | Recovery | Ulinzi wa GIA | Ulinzi wa MIA | Ulinzi wa single point of failure | Utendaji wa modeli |
|---|---|---|---|---|---|---|---|
| BC + FL + IM + DP — BCFL-DAI-PUB kamili | Ndiyo | Ndiyo | Ndiyo | Ndiyo | Ndiyo | Ndiyo | 0,91 |
| DP imeondolewa: BC + FL + IM | Ndiyo | Ndiyo | Ndiyo | Hapana | Hapana | Ndiyo | 0,87 |
| DP + IM zimeondolewa: BC + FL | Hapana | Hapana | Hapana | Hapana | Hapana | Ndiyo | 0,80 |
| Hali ya FL-only — kulingana na safu ya model katika chanzo | Hapana | Hapana | Hapana | Hapana | Hapana | Hapana | 0,76 |
Dokezo la ndani ya chanzo kuhusu Table 15: Lebo ya “Architectural Components” katika mstari wa mwisho inaonekana kusema DP, FL, IM na BC zimeondolewa, lakini katika safu ya “Models” ya mstari huo kuna FL. Majadiliano yanayofuata pia yanaeleza kwamba blockchain na incentive zikiondolewa hubaki federated learning pekee. Kwa hiyo Verianla hueleza mstari wa mwisho kama “FL-only” lakini haifichi mgongano wa lebo kwenye chanzo.
Matokeo yanayoungwa mkono na utafiti
- BCFL-DAI-PUB iliripoti predictive AUC ya juu kuliko BCFL-PS-HER katika simulation ya clients watano ya utafiti.
- Katika mgawanyo wa data wa non-IID, utendaji ulipungua kidogo ukilinganishwa na hali ya near-IID lakini ulibaki thabiti katika vipimo vya chanzo.
- Utaratibu wa DAI ulitofautisha tabia za honest, malicious na free-rider katika simulation ya chanzo.
- Attack-onset recovery baada ya label-flipping attack ilipimwa kuwa raundi 11 kwa mbinu iliyopendekezwa na raundi 20 kwa baseline.
- Optimizer-level DP iliongeza GIA reconstruction MAE; ikapunguza gender inference na reconstructed-data predictive utility.
- Final MIA Advantage ya BCFL-DAI-PUB ni chini kuliko baseline.
- Mbinu iliyopendekezwa iliripoti cumulative communication time na memory overhead ya chini pamoja na records/s throughput ya juu katika usanidi huohuo wa clients watano.
- Jedwali la ablation linaonyesha katika jaribio la chanzo kwamba DP hutoa mchango muhimu kwa ulinzi wa inference-attack na incentive mechanism kwa udhibiti wa malicious/free-rider.
Madai ya jumla yasiyoungwa mkono na utafiti
- Haijathibitishwa kuwa BCFL-DAI-PUB itatoa AUC, privacy au recovery values zilezile katika mifumo halisi ya benki.
- Simulated clients watano si uthibitisho wa uwanjani unaowakilisha tabia za kiutendaji za taasisi tano halisi za fedha.
- Thamani 11.817,56 records/s si public blockchain transaction throughput.
- 0,91 AUC si kizingiti cha kutosha cha udhibiti, kliniki au uchumi kwa uamuzi wa mkopo.
- %95 MIA resistance si dhamana ya ulinzi wa jumla dhidi ya aina zote za membership-inference attacks; utafiti ulitathmini kwa Yeom-style loss-threshold attack.
- Matokeo ya GIA hayathibitishi kuwa algoritimu zote za gradient reconstruction zitashindwa; chanzo kilitumia attack pipeline maalum inayotegemea iGIA/DiffGIA.
- Kutumia PBFT hakufanyi tabaka la blockchain kuwa salama dhidi ya mashambulizi yote.
- Sehemu ya monetary incentive ya DAI haijajaribiwa kwa majaribio jinsi itakavyofanya kazi katika mifumo halisi ya motisha za kiuchumi.
- Chanzo hakikupima hasara ya kifedha, fairness au matokeo ya udhibiti ya maamuzi halisi ya utoaji mikopo.
Reproducibility na maelezo yaliyoachwa wazi kwenye chanzo
Mbinu ya oversampling: Minority-class oversampling ilitumika; jina la sampling algorithm na utaratibu wa fold-level isolation haukutolewa kwa kina.
Blockchain implementation: Smart contract, blockchain, PBFT na IPFS zimefafanuliwa; lakini blockchain platform/chain implementation halisi iliyotumika haikutajwa kwa kina.
Hardware: CPU, GPU, RAM na mazingira ya kimwili ya majaribio hayakutolewa kwenye reproducibility table ya kina katika chanzo.
Mipangilio ya training: Ingawa vigezo vya DAI/DP vimetolewa wazi, idadi ya local epoch, general model learning rate na main training batch size, miongoni mwa vigezo vyote vya mafunzo, havijaripotiwa kikamilifu. Kwa jaribio la GIA batch size=1 imetolewa wazi.
Cross-validation: 10 fold na random seed 42 zimeripotiwa; maelezo yote ya mpangilio kamili wa oversampling, federated partitioning na model training kufanywa upya ndani ya kila fold hayajatolewa.
SCAFFOLD correction: Hutumia global_correction_error kama DAI action; exact SCAFFOLD control-variate equation na correction magnitude hazijatolewa kwa kina katika sehemu ya DAI ya makala hii.
Monetary incentive: “monetary_benefit” imetolewa kama action ya ishara; kiasi halisi cha fedha/token, bajeti na uchumi wa malipo havijaelezwa.
Hali za DAI mixed-sign: Katika Eq. 36, maeneo ambayo contribution moja ni hasi na nyingine ni nonnegative hayajaainishwa wazi.
Reputation aggregation: Katika Eq. 38, tabia ya implementation wakati total reputation ni hasi au sifuri haijaelezwa.
Mwanzo wa privacy-budget: Table 7 ina \(\epsilon_0=1,20\), huku baadhi ya maelezo ya client yakionyesha \(\epsilon=2,0\); njia ya client-specific initialization haiko wazi.
Istilahi ya MIA figure: Figure 16 caption/y-axis hupima \(Adv_{MIA}\), lakini kichwa cha grafu kinatumia “resistance”. Quantity inayopaswa kuwa chini ni \(Adv_{MIA}\).
Kauli ya GIA 7,6×: Table 11 hupima moja kwa moja ongezeko la 7,6× la Income MAE; kwa hiyo metrika mpya ya “attack success probability ilipungua 7,6×” haipaswi kuundwa.
Maana ya matumizi ya mbinu
Utafiti wa chanzo unaunganisha wazo la kufundisha modeli ya pamoja ya hatari ya mikopo bila kuhamisha rekodi ghafi za borrower kwenye hifadhi ya kati, pamoja na blockchain auditability, optimizer-level privacy na contribution-sensitive governance. Kimuundo, moja ya ubunifu muhimu si kulinda model update pekee bali pia kupima privacy na utility contribution za washiriki na kujaribu kurekebisha kwa nguvu athari na incentive zao kwenye global model.
Hata hivyo, katika mpito kwenda production finance system, data halisi za taasisi, mahitaji ya udhibiti, fairness, usimamizi wa model-risk, gharama ya blockchain deployment, usalama wa smart-contract, mabadiliko ya mgawanyo wa data, tabia halisi za washambuliaji na uchumi wa incentive wa muda mrefu lazima zithibitishwe kando.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: BCFL-DAI-PUB: Blockchain-integrated federated learning with dynamic adaptive incentives for privacy-utility balanced credit risk modelling
Waandishi: Padmaja Ramachandra; Santhi Vaithiyanathan.
Mpangilio wa waandishi: Mpangilio uliotolewa kwenye chanzo umehifadhiwa kama ulivyo.
Mchango sawa: Padmaja Ramachandra na Santhi Vaithiyanathan wamewekewa alama kwenye chanzo kama waandishi waliotoa mchango sawa.
Corresponding author: Santhi Vaithiyanathan.
Taasisi 1: Vellore Institute of Technology, School of Computer Science and Engineering, Vellore, Tamil Nadu, India.
Taasisi 2: Vellore Institute of Technology, School of Computer Science and Engineering, Chennai, Tamil Nadu, India.
Jarida: PLOS ONE.
Mchapishaji: PLOS.
Juzuu / toleo / namba ya makala: 21(10): e0361223.
DOI: 10.1371/journal.pone.0361223.
Rekodi rasmi: Ukurasa wa makala wa PLOS ONE unapatikana kupitia DOI 10.1371/journal.pone.0361223 kama rekodi rasmi.
Tarehe ya kupokelewa: 28 Januari 2026.
Tarehe ya kukubaliwa: 7 Oktoba 2026.
Tarehe ya kuchapishwa: 29 Oktoba 2026.
Aina ya chanzo:Research article iliyopitiwa na wahakiki.
Hali ya mapitio ya wahakiki: Ndiyo; Version of Record iliyopitiwa na wahakiki na kuchapishwa katika PLOS ONE.
Leseni: Creative Commons Attribution License (CC BY). Chanzo kinaripoti leseni ya ufikiaji wazi inayoruhusu matumizi, usambazaji na uzalishaji upya mradi mwandishi na chanzo asilia vitajwe.
Upatikanaji wa data: Data za Home Credit Default Risk zimeripotiwa kupatikana kwenye Kaggle; makala inaelekeza hasa faili ya HC_application_train.csv.
Ufadhili: Waandishi wameripoti kuwa hakuna ufadhili maalum uliopokelewa kwa utafiti.
Mgongano wa maslahi: Waandishi wametangaza kuwa hakuna competing interest.
Upatikanaji wa msimbo: Hakuna kiungo tofauti cha public source-code repository kilichoripotiwa kwenye makala.
Michango ya waandishi: Conceptualization: Padmaja Ramachandra. Data curation: Padmaja Ramachandra. Formal analysis: Padmaja Ramachandra na Santhi Vaithiyanathan. Investigation: Santhi Vaithiyanathan. Methodology: Padmaja Ramachandra. Resources: Santhi Vaithiyanathan. Supervision: Santhi Vaithiyanathan. Validation: Padmaja Ramachandra. Visualization: Padmaja Ramachandra. Writing – original draft: Padmaja Ramachandra. Writing – review & editing: Santhi Vaithiyanathan.
Aina kuu ya kisayansi ya utafiti: Jaribio la kompyuta la blockchain-federated learning kwenye mkusanyiko wa data ya hatari ya mikopo wa umma, ambapo data imegawanywa kwa federated clients walioigwa na tabia malicious na free-rider zimeingizwa kwa kudhibitiwa.
Data preprocessing: Rekodi 307.511 za awali zimeongezwa hadi rekodi 565.372 zilizosawazishwa baada ya minority oversampling. Raw feature 122 zimebadilika kuwa 245 feature baada ya global One-Hot Encoding na 184 feature zikachaguliwa kwa SHAP cumulative importance %75 threshold.
Federated heterogeneity: Dirichlet \(\alpha_D=10,0\) ilitumika kwa near-IID na \(\alpha_D=0,5\) kwa non-IID. Majaribio makuu yaliyofuata yalifanywa katika mazingira ya non-IID.
Tabia za client: Honest client watatu, label-flipping malicious client mmoja na free-rider client mmoja.
Consensus: Imeripotiwa kuwa PBFT hutumika kuthibitisha client update na peer-evaluation transactions.
Mgawanyo wa off-chain / on-chain: Imeripotiwa kuwa hesabu za numerical model/SHAP hufanyika off-chain, global schema huhifadhiwa IPFS na cryptographic reference/hash huandikwa kwenye blockchain.
Mbinu ya privacy: Optimizer-level differential privacy inayotumia gradient clipping + Gaussian noise; initial privacy budget \(\epsilon_0=1,20\), range 0,40–2,50, \(\delta=10^{-5}\), \(C=1,0\), \(\sigma=0,50\).
DAI: \(T_{DAI}=0,70\); \(\gamma=4,0\); \(\lambda=0,30\); \(\alpha_c=0,50\); \(\Delta\epsilon=0,10\).
Mashambulizi ya faragha: Gradient Inversion Attack na Yeom-style black-box Membership Inference Attack.
Poisoning: Label-flipping attack ilitumika kati ya communication round 14–18.
Takwimu: Matokeo ya GIA Table 11 yanaripotiwa kama mean ± standard deviation kutoka marudio kwenye clients watano. 10-fold cross-validation hutumika kwa predictive performance. Chanzo hakitoi inferential significance test inayotegemea p-value, confidence interval au effect-size.
Baseline: BCFL-PS-HER; inachukuliwa kama blockchain-federated baseline inayotumia homomorphic encryption na static reputation.
Kikomo kikuu cha tafsiri: Majaribio ya utafiti hayakufanywa kwenye hifadhidata huru za taasisi halisi za fedha au mtandao halisi wa production blockchain. Uhamishaji wa matokeo kwenda matumizi halisi ya benki lazima uthibitishwe kando.
Utata wa kimethodolojia ndani ya chanzo: Aina kamili ya oversampling algorithm na fold isolation, blockchain implementation/platform halisi, hardware/software stack, kiasi cha monetary incentive, exact SCAFFOLD correction equation, mixed-sign cases za Eq. 36, tabia ya negative/zero reputation-weight ya Eq. 38 na client-specific privacy-budget initialization hazijaripotiwa kikamilifu kando.
Madokezo ya kuripoti ndani ya chanzo: Mstari wa mwisho wa ablation katika Table 15 una kutolingana kati ya lebo na safu ya “Models=FL”; ingawa kichwa cha grafu cha Figure 16 kinasema MIA “resistance”, quantity iliyochorwa ni MIA Advantage; kauli ya 7,6× GIA katika conclusion inalingana moja kwa moja na ongezeko la 7,6× la Income reconstruction MAE kwenye jedwali.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *