

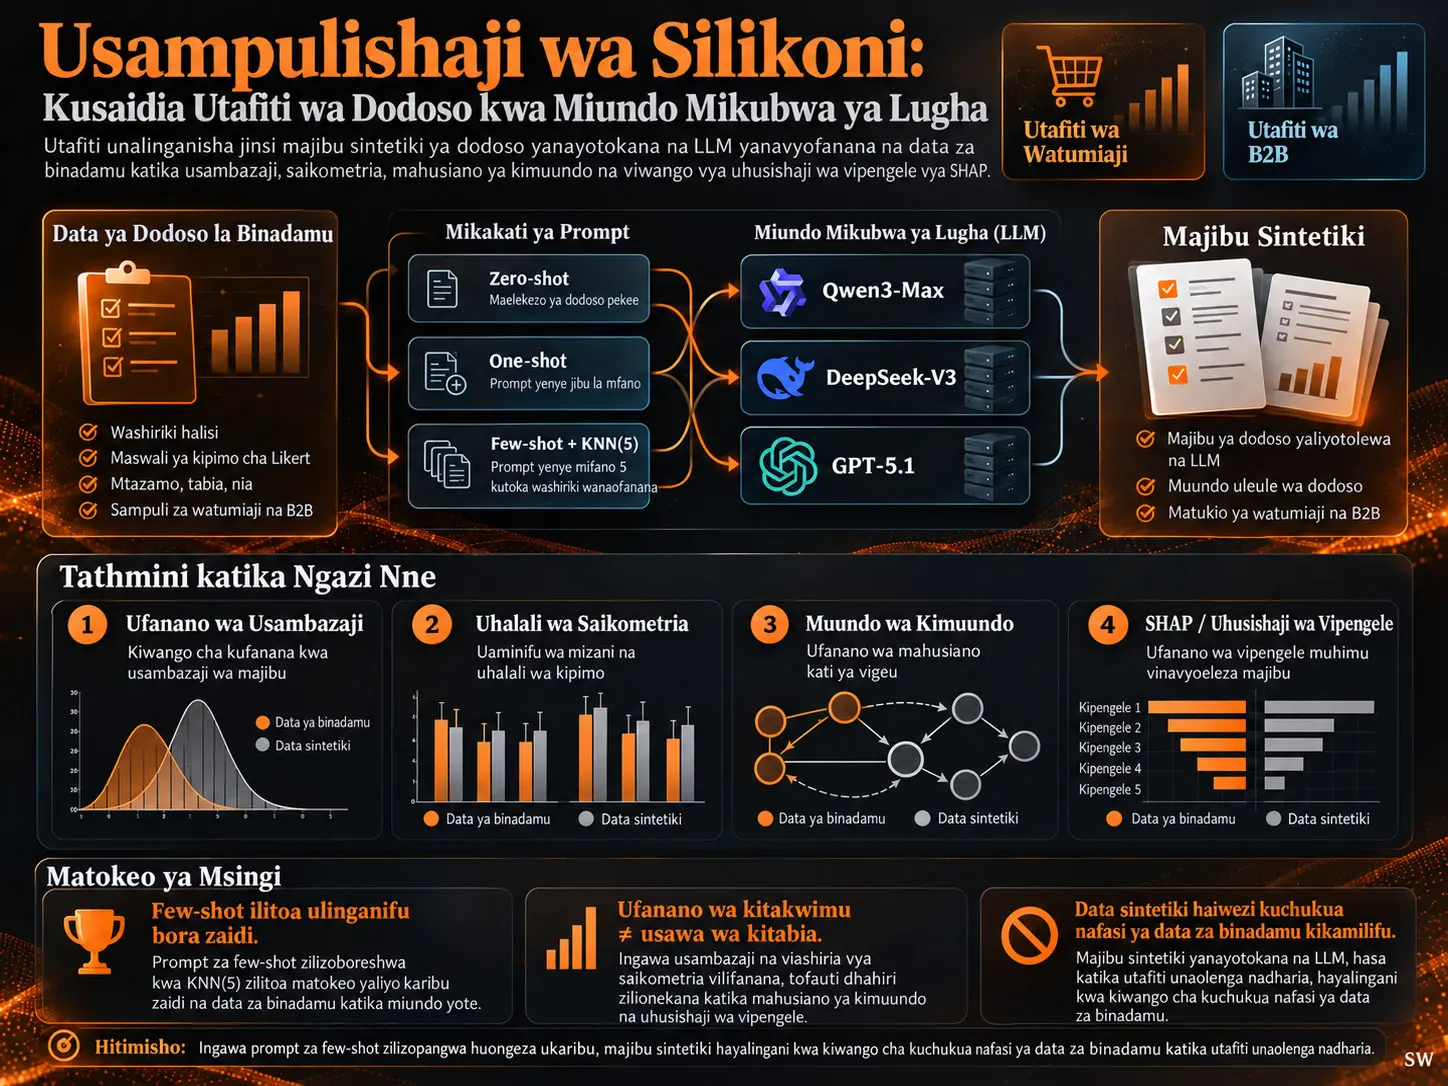
Usampulishaji wa silikoni (silicon sampling) ni mbinu ambapo miundo mikubwa ya lugha huzalisha majibu sintetiki ya dodoso chini ya prompt zilizodhibitiwa na majibu hayo hutumiwa kwa kulinganishwa na data za empiria zilizokusanywa kutoka kwa watu. Utafiti huu hauchunguzi tu ikiwa usampulishaji wa silikoni “huzalisha majibu yanayofanana na ya binadamu”, bali pia kiwango ambacho huhifadhi ufanano wa usambazaji, ubora wa kipimo cha kisaikometriki, mahusiano ya kimuundo na mifumo ya uhusishaji wa vipengele vya utabiri. Jumla ya majibu sintetiki 6.048 yalizalishwa kwa kutumia miundo mikubwa ya lugha mitatu na kulinganishwa na jumla ya majibu 672 kutoka seti mbili za data halisi za binadamu: watumiaji 369 katika muktadha wa matumizi ya bidhaa za kifahari na kampuni 303 katika muktadha wa masoko ya kijani ya B2B. Hitimisho kuu la utafiti ni kwamba prompt zilizopangwa kwa muundo wa few-shot huongeza kwa kiasi kikubwa ukaribu na data za binadamu; hata hivyo, ulinganifu bora wa kitakwimu haumaanishi usawa kamili wa kisaikolojia au kitabia na majibu ya binadamu.
Utafiti unaonyesha tofauti hii kwa ngazi nne za uhalali. Ngazi ya kwanza inalinganisha usambazaji wa majibu, ngazi ya pili uaminifu na uhalali wa mizani, ngazi ya tatu uhifadhi wa mahusiano ya kimuundo ya kinadharia, na ngazi ya nne mifumo ya uhusishaji wa vipengele vya SHAP inayopatikana kutoka kwa miundo ya Gradient Boosting. Matokeo yanaonyesha kwamba kadiri uchambuzi unavyoingia kwa kina, ndivyo ulinganifu unavyokuwa wa masharti zaidi. Katika muktadha wa watumiaji, majibu ya LLM kwa ujumla yalielekea kuwa na alama za juu kuliko majibu ya binadamu, ilhali katika muktadha wa shirika wa B2B, hasa katika usanidi wa DeepSeek na GPT, majibu yaliyopungua na kubanwa kwa variansi yalijitokeza zaidi.
Kwa hiyo, utafiti unaweka usampulishaji wa silikoni si kama chanzo huru cha ushahidi wa empiria kinachoweza kuchukua nafasi ya washiriki wa binadamu, bali kama zana saidizi ya kimetodolojia inayoweza kutumiwa katika kazi zenye mipaka iliyoelezwa wazi, kama vile majaribio ya awali ya dodoso, ulinganishaji, ukaguzi wa uthabiti, unyeti wa sampuli na uchunguzi wa hali mbalimbali. Hasa pale ambapo inahitajika kupima nadharia, kutathmini upatanishi, athari za urekebishaji au kutafsiri utaratibu wa kitabia, data za binadamu zinaendelea kuwa rejea kuu ya empiria.
Usampulishaji wa Silikoni ni Nini?
Usampulishaji wa silikoni ni mbinu ya kupata majibu sintetiki ya dodoso kutoka kwa miundo mikubwa ya lugha chini ya masharti maalum ya kidemografia, kimuktadha au ya majukumu, na kisha kulinganisha majibu hayo kwa utaratibu na data halisi za rejea za binadamu bila kuyaweka moja kwa moja mahali pa data za binadamu.
Moja ya changamoto kuu za utafiti wa dodoso ni kujaribu kupima tabia ya binadamu kupitia miundo ambayo haiwezi kuzingatiwa moja kwa moja. Vigezo kama taswira ya chapa, ushawishi wa kijamii, kuridhika na maisha, mkakati wa mazingira au uwekaji wa chapa sokoni havisomwi moja kwa moja kwa sensa ya kimwili; ni miundo fiche inayotokana na mizani yenye vipengee vingi. Kwa hiyo, kuonekana “halisi” kwa wastani wa seti ya data pekee hakumaanishi kuwa seti hiyo inatosha kwa kupima nadharia.
Kwa sababu miundo mikubwa ya lugha inaweza kutoa majibu yanayozingatia muktadha na yenye uthabiti wa kimuundo, fursa mpya ya kimetodolojia imejitokeza katika utafiti wa dodoso. Hata hivyo, haiwezi kudhaniwa kuwa majibu ya LLM yana sifa thabiti za kisaikolojia kama washiriki wa binadamu. Tokeo la modeli hutegemea muundo wa prompt, mifano iliyotolewa, taarifa za muktadha na nafasi ya uwakilishi iliyojifunza ya modeli yenyewe. Kwa hiyo, badala ya kudhani uhalali wa majibu sintetiki moja kwa moja, utafiti huyajaribu hatua kwa hatua dhidi ya data za binadamu.
Swali kuu la utafiti
Tatizo kuu la utafiti ni la kina zaidi kuliko swali “Je, matokeo ya LLM yanafanana na majibu ya binadamu?” Swali halisi ni ni kwa kiwango gani majibu sintetiki yanaweza kuhifadhi sifa za kimetodolojia zinazohitajika na utafiti. Wastani wa seti ya data unaweza kukaribia data za binadamu; hata hivyo, seti hiyo hiyo inaweza kuunda kwa namna tofauti muundo wa kovariansia wa mizani, mahusiano ya njia za kinadharia au mfumo wa uhusishaji wa vipengele unaoonyesha ni vigezo gani vinavyoathiri matokeo.
Kwa Nini Ufanano wa Kitakwimu Pekee Hautoshi?
Ufanano wa kitakwimu unaonyesha tu kiwango cha juu juu zaidi cha uhalali; katika utafiti wa dodoso unaotegemea nadharia, ni lazima pia kupimwe kando ikiwa uaminifu wa mizani, muundo wa vipengele fiche, mahusiano ya kimuundo na mifumo ya uhusishaji wa vipengele inayofafanua matokeo vinaendana na data za rejea za binadamu.
Uhalali wa ngazi nne wa kihierarkia
| Ngazi | Swali kuu | Zana kuu zilizotumika | Nini kinapimwa? |
|---|---|---|---|
| 1 — Ulinganifu wa usambazaji | Usambazaji wa majibu sintetiki unakaribia kwa kiasi gani majibu ya binadamu? | MANOVA, ANOVA katika kiwango cha kipengee, Welch t-test, uwiano wa mikengeuko sanifu | Mabadiliko ya wastani, usambazaji na kuongezeka/kubanwa kwa mwelekeo |
| 2 — Uadilifu wa kisaikometriki | Ubora wa upimaji wa mizani unahifadhiwa? | Cronbach α, uaminifu changamano (CR), AVE, CFA | Uthabiti wa ndani, uhalali wa ukaribiano na muundo wa vipengele fiche |
| 3 — Uhifadhi wa modeli ya kimuundo | Njia kati ya vigezo vya kinadharia zinahifadhiwa? | SEM, vigawo sanifu vya njia na fahirisi za ulinganifu | Mwelekeo, umuhimu wa kitakwimu, ukubwa wa athari na ulinganifu wa modeli |
| 4 — Uthabiti wa uhusishaji wa vipengele | Ni vigezo gani vinavyojitokeza wakati wa kutabiri matokeo? | Gradient Boosting + SHAP | Mifumo ya umuhimu wa kulinganisha wa vigezo vya utabiri |
Ngazi ya nne inapaswa kutafsiriwa kwa uangalifu maalum. Thamani za SHAP hapa zinafafanua michango ya vipengele katika miundo ya utabiri ya Gradient Boosting. Kwa hiyo, matokeo haya hayamaanishi moja kwa moja kwamba “LLM inafikiri hivi” au “akili ya binadamu hutumia utaratibu huu”. Huu pia ndio mpaka wa kimetodolojia wa utafiti: SHAP inalinganisha mifumo ya uhusishaji wa kiutabiri inayozalishwa na seti za data; haiangalii moja kwa moja michakato halisi ya utambuzi.
Kwa nini muundo wa prompt ni kigezo cha kimetodolojia?
Katika utafiti, pamoja na uteuzi wa modeli, usanifu wa prompt pia ulitazamwa kama kigezo huru cha kimetodolojia. Katika hali ya zero-shot hakuna mfano unaotolewa. Katika hali ya one-shot, mfano mmoja wa muundo unatolewa. Katika hali ya few-shot + KNN, uchunguzi halisi mitano iliyo karibu na profaili inayochunguzwa katika nafasi ya vipengele hutafutwa na kuongezwa kwenye muktadha wa modeli kama mifano. Kwa njia hii, majibu ya modeli hujaribiwa kuunganishwa na mifumo ya ndani ya data za binadamu bila kupewa takwimu za jumla moja kwa moja.
Katika kubainisha mifano ya binadamu iliyo karibu zaidi, utafiti wa chanzo hutumia umbali wa Euclidean:
\[ d(p_i,p_j)=\sqrt{\sum_f \left(p_i^f-p_j^f\right)^2} \]
Mlinganyo huu huhesabu umbali wa nafasi ya vipengele kati ya profaili mbili. \(p_i\) inawakilisha profaili ambayo jibu sintetiki litatengenezwa, \(p_j\) uchunguzi wa binadamu unaowezekana, na \(f\) kipengele kinachotumika katika ulinganisho. Tofauti katika kila kipengele huwekwa mraba, hujumlishwa katika vipengele vyote, kisha mzizi wa mraba wa jumla huhesabiwa. Uchunguzi mitano yenye umbali mdogo zaidi huunda nanga ya muktadha wa few-shot. Kwa kuwa mlinganyo huu hauhesabu kiasi cha kimwili, hauna kitengo cha mita, sekunde au kitengo kingine cha kimwili; matokeo ni umbali wa kijiometri katika nafasi ya uwakilishi wa vipengele vinavyotumika.
Data za rejea za binadamu → utoaji wa profaili na muktadha → zero-shot / one-shot / few-shot + KNN(5) → Qwen3-Max / DeepSeek-V3 / GPT-5.1 → majibu sintetiki ya dodoso → ulinganisho wa ngazi nne wa binadamu–LLM.
Kwa nini miktadha miwili tofauti ya utafiti ilitumika?
Utafiti wa kwanza hutumia muktadha wa matumizi ya bidhaa za kifahari, ambako mitazamo ya watumiaji binafsi hutawala. Sampuli ya rejea ya binadamu ina majibu halali 369 kutoka sampuli ndogo ya China. Miundo kama ushawishi wa kijamii, matumizi ya kujionyesha, taswira ya chapa, mwelekeo wa matumizi ya kifahari, msukumo wa ununuzi, matumizi ya fedha kwa bidhaa za kifahari na kuridhika na maisha hutathminiwa.
Utafiti wa pili hutumia seti ya data ya B2B yenye kampuni 303. Hapa, mahusiano kati ya mkakati wa masoko ya kijani, mkakati wa mazingira wa kampuni, uwekaji wa chapa ya kijani, ushindani wa chapa ya kijani na mafanikio ya bidhaa mpya ya kijani yanachunguzwa. Kwa kuwa modeli hii inajumuisha mahusiano ya upatanishi na urekebishaji pamoja na athari za moja kwa moja, ina ugumu mkubwa zaidi wa kimuundo kuliko utafiti wa kwanza.
Mbinu na Matokeo ya Utafiti
Miundo mitatu ilitathminiwa: Qwen3-Max (qwen3-max), DeepSeek-V3 (deepseek-v3) na GPT-5.1 (gpt-5.1-all). Joto la uzalishaji liliwekwa kuwa 0,7, max_tokens 2000; top_p iliachwa katika chaguo-msingi la API na seed haikubainishwa. Kila kisa sintetiki kilizalishwa mara moja tu, na wastani wa uzalishaji wa kurudia kwa kisa kilekile haukuchukuliwa.
Kuzalisha upya jumla ya uchunguzi 672 kutoka seti mbili za data za binadamu katika miundo mitatu na hali tatu kuu za prompt kulitengeneza majibu sintetiki 6.048. Faida muhimu ya muundo huu ni kwamba hali za modeli na prompt zinaweza kulinganishwa ndani ya mfumo uleule wa rejea ya binadamu. Kizuizi muhimu ni kwamba, kwa kuwa kila kisa sintetiki kilizalishwa mara moja tu, nasibu ya uzalishaji na uthabiti kati ya marudio haviwezi kupimwa moja kwa moja.
Je, Few-Shot Prompting Hutoa Usawa na Data za Binadamu?
Hapana. Hali ya few-shot + KNN kwa ujumla ilizalisha data sintetiki zilizo karibu zaidi na rejea ya binadamu katika tafiti zote mbili; hata hivyo, kutokana na mikengeuko ya usambazaji, kupungua kwa ulinganifu wa modeli, mabadiliko ya baadhi ya vigawo vya njia na tofauti katika mifumo ya uhusishaji wa vipengele vya SHAP, utafiti hautafsiri hali hii kama usawa kamili na data za binadamu.
Utafiti 1 — Matokeo ya usambazaji katika muktadha wa watumiaji
Katika jaribio la watumiaji, majibu ya zero-shot ndiyo hali zilizo mbali zaidi na data za binadamu. Few-shot hupunguza tofauti kwa kiasi kikubwa katika miundo yote mitatu. Hata hivyo, mkengeuko dhahiri wa majibu sintetiki kuelekea juu unaendelea. Katika hali ya few-shot, tofauti ya wastani ni +0,50 kwa Qwen, +0,49 kwa DeepSeek na +0,67 alama za kipimo kwa GPT. Karibu katika vipengee vyote vinavyoonyesha tofauti yenye umuhimu wa kitakwimu, wastani wa LLM ni mkubwa kuliko wastani wa binadamu.
| Modeli | Wilks λ | Wastani η² | Tofauti ya wastani dhidi ya data za binadamu | Mwelekeo mkuu |
|---|---|---|---|---|
| Qwen3-Max | 0,245 | 0,064 | +0,50 | Majibu sintetiki ni ya juu zaidi |
| DeepSeek-V3 | 0,251 | 0,063 | +0,49 | Majibu sintetiki ni ya juu zaidi |
| GPT-5.1 | 0,321 | 0,088 | +0,67 | Majibu sintetiki ni ya juu zaidi |
Matokeo haya yanaonyesha kwamba prompt iliyopangwa ni muhimu, lakini sampuli sintetiki haiondoki kiotomatiki kwenye upendeleo. Hali ya few-shot hupunguza ukubwa wa tofauti, lakini haiondoi mwelekeo wa kimfumo wa kutoa alama za juu katika sampuli ya watumiaji.
Utafiti 1 — Uadilifu wa kisaikometriki
Katika seti za data za few-shot, thamani za Cronbach α, uaminifu changamano na AVE kwa ujumla zilibaki ndani ya mipaka inayokubalika. Mojawapo ya udhaifu ulioonekana zaidi ulikuwa katika muundo wa taswira ya chapa; hata hivyo, AVE iliripotiwa kuwa 0,577 kwa Qwen, 0,571 kwa DeepSeek na 0,631 kwa GPT.
Katika ulinganifu wa CFA, data za binadamu zina nguvu zaidi. Katika rejea ya binadamu CFI ni 0,944, TLI 0,935 na RMSEA 0,064; katika data ya few-shot ya Qwen zilipatikana 0,913 / 0,900 / 0,072, kwa DeepSeek 0,909 / 0,895 / 0,073 na kwa GPT 0,899 / 0,884 / 0,085. Muundo wa mizani hauvunjiki kabisa, lakini pia hautolewi upya katika kiwango sawa na modeli ya kipimo ya binadamu.
Utafiti 1 — Modeli ya kimuundo
Matokeo ya SEM yanaonyesha modeli ya kiwango sawa. Katika modeli ya binadamu CFI ni 0,947, TLI 0,941 na RMSEA 0,061. Modeli ya few-shot ya Qwen ilitoa 0,901 / 0,889 / 0,076; DeepSeek 0,897 / 0,885 / 0,077; na GPT 0,889 / 0,877 / 0,088.
Sehemu kubwa ya njia sita kuu za kimuundo ilihifadhiwa kwa upande wa mwelekeo na umuhimu. Hata hivyo, njia ya BI → LCT kutoka taswira ya chapa kwenda mwelekeo wa matumizi ya kifahari, ambayo katika data za binadamu ilikuwa \(β=0,184\), ilibadilisha mwelekeo kuwa \(β=-0,149\) kwa Qwen na \(β=-0,168\) kwa DeepSeek; kwa GPT mwelekeo wa binadamu ulihifadhiwa kwa \(β=0,146\). Hata pale ambapo mwelekeo wa baadhi ya njia nyingine ulihifadhiwa, ukubwa wa vigawo ulitofautiana sana na rejea ya binadamu. Kwa hiyo, kuhifadhi topolojia ya modeli hakumaanishi kwamba ukubwa wa athari ni sawa.
Utafiti 1 — Kwa nini SHAP ilitoa onyo muhimu?
Katika rejea ya binadamu, katika modeli ya Gradient Boosting inayotabiri msukumo wa ununuzi, kipengele chenye nguvu zaidi ni kuridhika na maisha (LS; umuhimu 0,367). Umuhimu wa kigezo cha umri katika data za binadamu ni 0,137. Katika wastani wa seti za data sintetiki, umuhimu wa SHAP wa umri huongezeka hadi 0,303, huku umuhimu wa wastani wa LS ukishuka hadi 0,036. Chanzo pia kinaripoti kwamba umri ulikuwa kipengele muhimu zaidi katika usanidi 10 kati ya 12 wa LLM/prompt.
Hii inaonyesha kuwa majibu sintetiki yanaweza kuhifadhi baadhi ya sifa za juu juu na za kimuundo huku yakibadilisha ni vigezo gani vinavyozunguka mpangilio wa matokeo. Matokeo haya hayapaswi kusomwa kama “LLM kwa kweli hutumia umri inapofanya uamuzi”; SHAP inalinganisha mifumo ya uhusishaji wa vipengele ya miundo ya Gradient Boosting iliyofunzwa kwa seti tofauti za data.
Utafiti 2 — Mwelekeo wa usambazaji hubadilika katika muktadha wa B2B
Katika utafiti wa B2B, few-shot bado kwa ujumla hutoa mbinu bora zaidi, lakini mwelekeo wa mkengeuko si wa aina moja kama katika utafiti wa watumiaji. Hali ya few-shot ya GPT-5.1 inatoa mojawapo ya ulinganifu wenye nguvu zaidi wa usambazaji kwa Wilks λ=0,266 na wastani η²=0,034; tofauti ya wastani ni -0,048. Tofauti ya few-shot ya DeepSeek ni -0,160, huku Qwen few-shot ikiwa +0,159.
| Modeli | Wilks λ | Wastani η² | Tofauti ya wastani dhidi ya data za binadamu |
|---|---|---|---|
| Qwen3-Max | 0,192 | 0,056 | +0,159 |
| DeepSeek-V3 | 0,211 | 0,050 | -0,160 |
| GPT-5.1 | 0,266 | 0,034 | -0,048 |
Hapa ndipo matokeo muhimu ya kuvuka miktadha yanapoonekana: kosa la data sintetiki si tabia thabiti ya “LLM daima hutoa alama za juu”. Ingawa katika muktadha wa watumiaji kuna ongezeko linaloonekana, katika maswali ya shirika na kimkakati ya B2B, hasa majibu ya DeepSeek na GPT yanaweza kusogea chini ikilinganishwa na rejea ya binadamu na variansi inaweza kubanwa zaidi.
Utafiti 2 — Muundo wa kipimo ni dhaifu zaidi
Katika mizani ya B2B, ingawa uthabiti wa ndani kwa ujumla unabaki kuwa mkubwa, baadhi ya thamani za uhalali wa ukaribiano zimedhoofika. Kulingana na Jedwali 8 la chanzo, thamani ya AVE ya binadamu kwa Green Marketing Strategy ni 0,599; inashuka hadi 0,447 kwa Qwen na 0,395 kwa DeepSeek, huku ikiwa 0,584 kwa GPT. Thamani za Qwen na DeepSeek kuwa chini ya 0,50 zinaonyesha kuwa, hasa katika miundo ya kimkakati iliyo dhahania zaidi, uwakilishi fiche unaweza kuwa dhaifu zaidi kuliko vigawo vya uaminifu.
Katika CFA, rejea ya binadamu inaonyesha ulinganifu mkubwa sana kwa CFI 0,992, TLI 0,991 na RMSEA 0,017. Data za GPT zinatoa matokeo yaliyo karibu zaidi na binadamu kati ya miundo mitatu kwa 0,897 / 0,889 / 0,068. Qwen ni 0,845 / 0,833 / 0,077; DeepSeek 0,792 / 0,775 / 0,087. Hivyo inaonekana kuwa ni vigumu zaidi kutoa upya muundo fiche wa kipimo katika muktadha wa B2B kuliko katika muktadha wa watumiaji.
Utafiti 2 — Njia za moja kwa moja, upatanishi na urekebishaji
Jedwali 11 la chanzo linaonyesha wazi kwamba njia zote hazihifadhiwi kwa kiwango sawa. Kwa mfano, njia ya GMS → GBP katika data za binadamu ni \(β=0,396\), lakini ni 0,746 kwa Qwen, 1,267 kwa DeepSeek na 0,651 kwa GPT; ingawa mwelekeo na umuhimu vinahifadhiwa, ukubwa hubadilika kwa kiasi kikubwa.
Kinyume chake, njia ya CES → GBP katika data za binadamu ni \(β=0,209\), lakini inabadilisha mwelekeo kuwa -0,104 kwa Qwen na -0,323 kwa DeepSeek; kwa GPT inahifadhiwa kuwa 0,286. Uhusiano wa GBP → NGPS katika data za binadamu ni \(β=0,543\); kwa Qwen ni 0,187 na kwa DeepSeek 0,180, na ingawa mwelekeo wake umehifadhiwa, haukupita kigezo cha kuhifadhi umuhimu katika jedwali la chanzo; kwa GPT mwelekeo na umuhimu vyote vimehifadhiwa kwa 0,492.
Athari ya urekebishaji pia ni hali muhimu ya mpaka. Mwingiliano wa GMS × CES → GBP katika data za binadamu ni \(β=-0,445\). Qwen (-0,154) na DeepSeek (-0,169) huhifadhi mwelekeo na umuhimu uleule, huku kwa GPT kigezo kikibadilika kuwa +0,034 na kutohifadhiwa. Kwa hiyo, hata kama data sintetiki zinaweza kutoa upya kwa sehemu usanifu mkuu wa kimuundo, usawa hauhakikishwi hasa katika mahusiano ya ngazi ya juu.
Utafiti 2 — Mfumo wa uhusishaji wa vipengele
Katika rejea ya B2B ya binadamu, kigezo muhimu zaidi kinachotabiri matokeo ya Green Brand Positioning ni New Green Product Success (NGPS; umuhimu wa SHAP 0,363). Katika seti za data za LLM, umuhimu wa wastani wa NGPS hushuka hadi 0,025 na nafasi yake ya wastani hadi 5,0. Kinyume chake, Green Brand Competitiveness (GBC) ni 0,124 katika data za binadamu, lakini huongezeka hadi 0,158 katika wastani wa data sintetiki na nafasi ya wastani huwa 1,3.
Matokeo haya ni tofauti na mfumo wa “ubadilishaji wa kidemografia” katika jaribio la watumiaji. Katika muktadha wa B2B, data sintetiki zinaunganisha matokeo zaidi na miundo ya kimkakati ya kati kuliko na vigezo vinavyolenga utendaji katika data za binadamu. Hivyo hoja kuu ya utafiti inaimarika: mkengeuko wa LLM hauathiriwi na modeli pekee, bali pia na asili ya muktadha wa utafiti unaohitaji kuwakilishwa.
Matokeo yanayoungwa mkono na utafiti
Utafiti wa chanzo unaunga mkono kwamba prompt zilizopangwa za few-shot kwa ujumla huongeza ukaribu na rejea ya binadamu; uaminifu wa kisaikometriki unaweza kuhifadhiwa katika hali nyingi; mwelekeo na umuhimu wa baadhi ya mahusiano ya kimuundo unaweza kutolewa upya; lakini upendeleo wa usambazaji, upotoshaji wa ukubwa wa vigawo, kutokuwa thabiti katika mahusiano changamano ya kimuundo na tofauti za kimfumo katika mifumo ya uhusishaji wa vipengele vinaendelea.
Matokeo ambayo utafiti hauungi mkono
Utafiti hauthibitishi kwamba majibu yanayozalishwa na LLM yanaweza kutumiwa kwa usalama badala ya washiriki wa binadamu. Few-shot prompting haihakikishi usawa wa binadamu. Matokeo ya SHAP hayapimi moja kwa moja utambuzi wa binadamu au wa LLM. Matokeo kutoka miktadha miwili ya utafiti hayawezi kujumlishwa kwa jamii zote, aina zote za dodoso, tamaduni zote au matoleo yote ya LLM. Utafiti pia haukupima kiwango cha uthabiti wa majibu sintetiki katika uzalishaji wa kurudiwa.
Maana ya vitendo
Matokeo haya yanaonyesha kwamba maeneo salama zaidi ya kutumia usampulishaji wa silikoni ni majaribio ya awali wakati wa kubuni dodoso, ukaguzi wa uthabiti wa vipengee, unyeti kwa miundo mbadala ya sampuli, majaribio ya msongo wa kimetodolojia, ulinganishaji na uchunguzi wa hali mbalimbali. Data sintetiki zinaweza kumsaidia mtafiti kuchunguza ni katika hali gani matokeo yanaweza kubadilika. Hata hivyo, hazipaswi kuchukua nafasi ya data za binadamu pale ambapo ushahidi wa empiria kuhusu tabia ya watu halisi unahitajika.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Silicon Sampling: Supporting Survey Research with Large Language Models
Waandishi: Haozhe Ma; Yunchu Yang; Arnaldo Coelho; Penousal Machado; Yapeng Wang.
Taasisi: CEBER – Centre for Business and Economics Research, Faculty of Economics, University of Coimbra; Faculty of Applied Sciences, Macao Polytechnic University; CISUC/LASI – Centre for Informatics and Systems of the University of Coimbra, Department of Informatics Engineering.
Corresponding author: Katika PDF, alama ya corresponding-author imeonyeshwa kwa Yunchu Yang.
DOI: 10.2139/ssrn.7362005.
Jukwaa na hali ya uchapishaji: Rekodi ya preprint ya SSRN. PDF iliyopakiwa inaeleza wazi kwamba utafiti bado haujapitia tathmini ya rika. Katika sehemu ya chini ya PDF kuna kauli “Preprint submitted to Elsevier”; katika hati iliyotolewa hakuna toleo la jarida lililopitiwa na rika lililobainishwa.
Tarehe ya kuwasilisha: Katika rekodi rasmi ya SSRN, 28 Agosti 2026.
Leseni: Hakuna leseni wazi ya Creative Commons ya matumizi tena iliyobainishwa katika PDF iliyopakiwa au rekodi ya bibliografia inayoweza kuthibitishwa. Kwa hiyo, katika maudhui ya Verianla, vielelezo vya chanzo au miundo asilia ya jedwali haikutumiwa tena; ukweli wa kisayansi uliwasilishwa kwa maelezo huru na miundo mipya ya jedwali.
Muundo mkuu wa utafiti: Uzalishaji upya wa sintetiki wa seti mbili za data za dodoso za binadamu zilizothibitishwa awali na Qwen3-Max, DeepSeek-V3 na GPT-5.1 katika miktadha ya zero-shot, one-shot na few-shot + KNN; kulinganisha seti za data sintetiki na za binadamu katika ngazi za usambazaji, kisaikometriki, kimuundo na uhusishaji wa vipengele vya SHAP.
Mipangilio ya uzalishaji: Temperature 0,7; max_tokens 2000; top_p chaguo-msingi la API; seed haikubainishwa. Kila kisa sintetiki kilizalishwa mara moja.
Sampuli za binadamu: Utafiti wa watumiaji N=369; utafiti wa B2B N=303; jumla N=672.
Data sintetiki: Jumla ya majibu 6.048 yaliyotengenezwa na LLM.
Michango ya CRediT: Haozhe Ma — uundaji wa dhana, utafiti, uratibu wa data na rasimu ya kwanza; Yunchu Yang — metodolojia, uchanganuzi rasmi, uwasilishaji wa kuona na mapitio/uhariri; Arnaldo Coelho — rasimu ya kwanza, ushauri na mapitio/uhariri; Penousal Machado — ushauri na mapitio/uhariri; Yapeng Wang — rasilimali na ushauri.
Ufadhili, mgongano wa maslahi na upatikanaji wa data: Hakuna taarifa tofauti na wazi kuhusu haya zilizobainishwa katika PDF iliyotolewa; hakuna maelezo ya ziada yaliyodhaniwa kuhusu maeneo haya.
Ukosefu wa ulinganifu katika uripoti wa chanzo
Ingawa muundo wa mbinu unafafanua rejimu tatu kuu za prompt kuwa zero-shot, one-shot na few-shot + KNN, katika maelezo ya Study 1 kuna mahali ambapo kauli “statistical-summary prompting” imetumika. Kwa kuwa istilahi hii haikulinganishwa wazi na muundo mkuu wa majaribio na majedwali husika, maelezo ya Verianla yametumia kama msingi rejimu tatu zilizofafanuliwa wazi.
Sehemu ya maelezo ya matokeo ya kisaikometriki ya B2B inaandika thamani ya AVE ya binadamu kwa Green Marketing Strategy kuwa 0,566, huku Jedwali 8 la chanzo likitoa thamani hiyo hiyo kuwa 0,599. Katika uwasilishaji wa kiasi wa Verianla, thamani ya moja kwa moja ya jedwali 0,599 imetumiwa na kutokulingana huku hakujafichwa.
Baadhi ya kauli za jumla katika maelezo ya matokeo ya kimuundo ya B2B pia hazilingani kikamilifu na alama za uhifadhi wa kila njia katika Jedwali 11 la chanzo. Kwa hiyo, katika tathmini za mwelekeo na umuhimu, vigawo na alama za uhifadhi zilizoripotiwa moja moja katika Jedwali 11 zimetumiwa kama msingi.
Vikwazo vikuu
Utafiti unachunguza miktadha miwili tu ya dodoso. Kwa kuwa utafiti wa B2B unatokana na mazingira ya kitaasisi ya China, haijulikani ikiwa matokeo yale yale yangeonekana katika miktadha mingine ya kitaasisi au kitamaduni. Usanidi wa modeli na prompt uliotumika ni mdogo; mbinu kama retrieval-augmented generation, fine-tuning au usampulishaji mseto wa binadamu–LLM hazikujaribiwa moja kwa moja.
Kwa kuwa kila kisa sintetiki kilizalishwa mara moja tu, haijulikani ni kwa kiasi gani matokeo ya usambazaji, kisaikometriki au kimuundo yangebadilika katika uzalishaji wa kurudiwa wa prompt na profaili ileile. Aidha, tathmini katika kiwango cha utaratibu inategemea mfumo wa Gradient Boosting + SHAP. Algoriti tofauti za utabiri au mbinu tofauti za uelezekaji zinaweza kutoa miundo tofauti ya uhusishaji wa vipengele.
Kwa hiyo, hitimisho lenye nguvu zaidi la utafiti si kwamba “washiriki sintetiki ni sawa na binadamu”. Hitimisho linaloweza kutetewa zaidi ni kwamba uhalali wa usampulishaji wa silikoni unategemea prompt iliyotumika, modeli, muktadha wa utafiti na kina cha hitimisho la kisayansi linalotakiwa kufanywa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *