

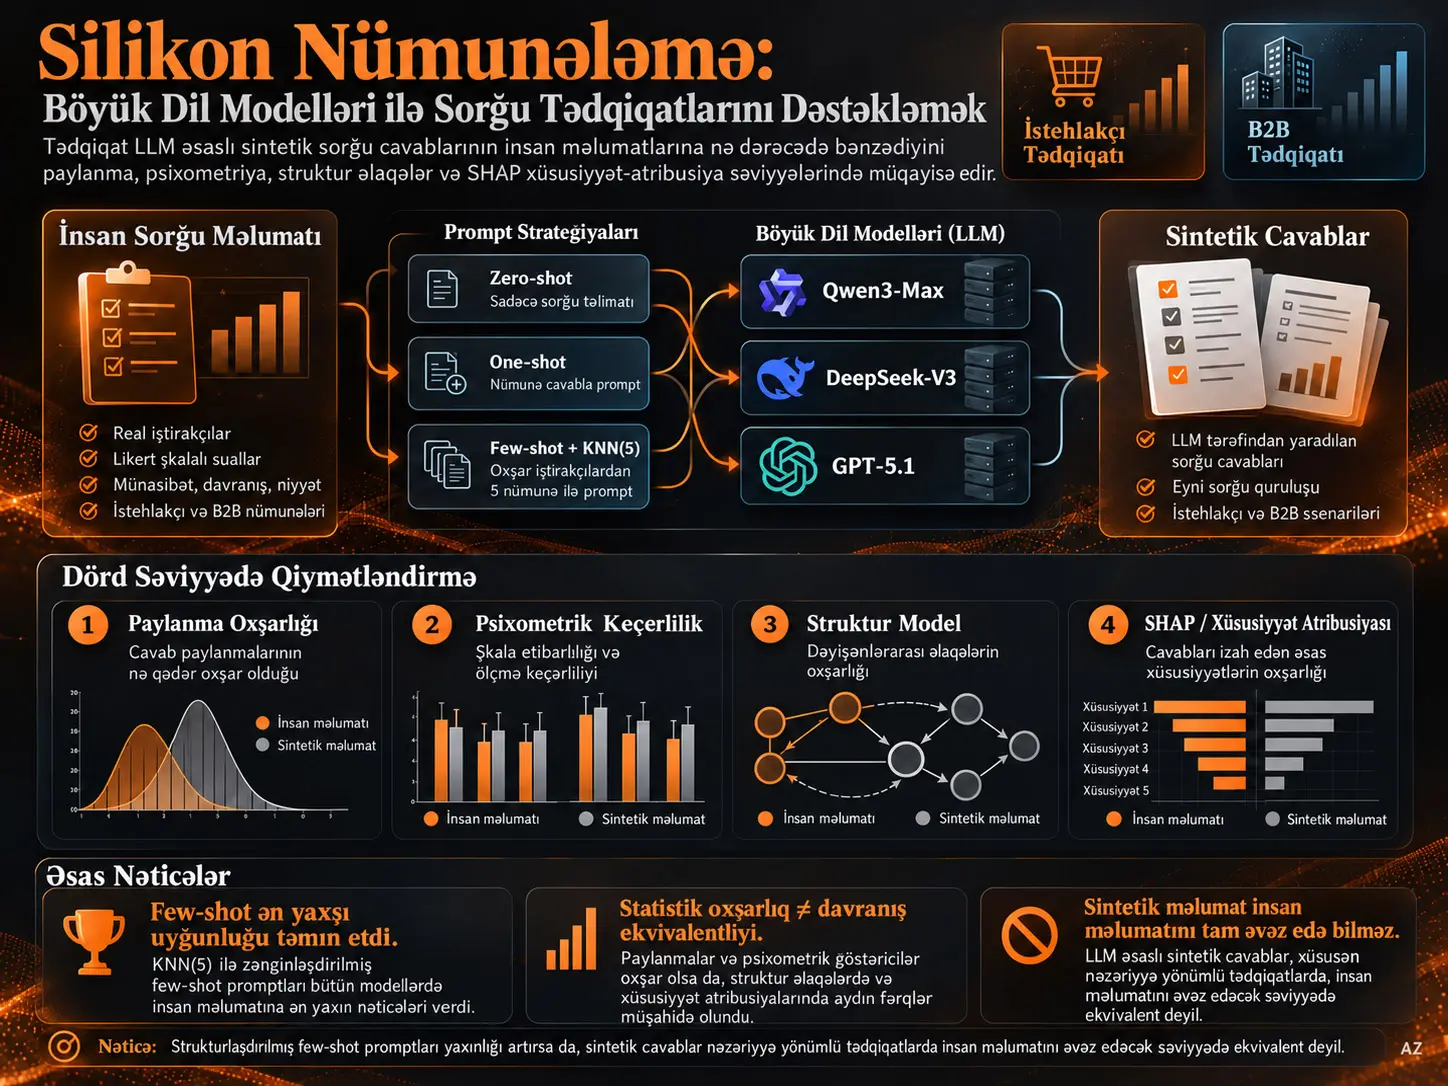
Silikon nümunələmə (silicon sampling), böyük dil modellərinin nəzarət olunan promptlar altında sintetik sorğu cavabları yaratması və bu cavabların insanlardan toplanmış empirik məlumatlarla müqayisəli şəkildə istifadə edilməsi yanaşmasıdır. Bu tədqiqat silikon nümunələmənin yalnız “insana bənzər cavablar yaradıb-yaratmadığını” deyil, həm də paylanma oxşarlığını, psixometrik ölçmə keyfiyyətini, struktur əlaqələri və proqnozlaşdırıcı xüsusiyyət-atribusiya nümunələrini nə dərəcədə qoruduğunu araşdırır. Üç böyük dil modeli ilə ümumilikdə 6.048 sintetik cavab yaradılmış və bunlar iki real insan məlumat dəstindəki ümumilikdə 672 cavabla müqayisə edilmişdir: lüks istehlak kontekstində 369 istehlakçı və B2B yaşıl marketinq kontekstində 303 firma. Tədqiqatın əsas nəticəsi budur ki, few-shot formasındakı strukturlaşdırılmış promptlar insan məlumatlarına yaxınlığı nəzərəçarpacaq dərəcədə artırır; lakin daha yaxşı statistik uyğunluq insan cavabları ilə tam psixoloji və ya davranış ekvivalentliyi demək deyil.
Tədqiqat bu fərqi dörd mərhələli etibarlılıq iyerarxiyası ilə göstərir. Birinci səviyyə cavab paylanmalarını, ikinci səviyyə şkalaların etibarlılığını və keçərliliyini, üçüncü səviyyə nəzəri struktur əlaqələrin qorunmasını, dördüncü səviyyə isə Gradient Boosting modellərindən əldə edilən SHAP xüsusiyyət-atribusiya nümunələrini müqayisə edir. Nəticələr təhlil dərinləşdikcə uyğunluğun daha şərti hala gəldiyini göstərir. İstehlakçı kontekstində LLM cavabları ümumən insan cavablarından daha yüksək ballara meyl etdiyi halda, təşkilati B2B kontekstində xüsusilə DeepSeek və GPT konfiqurasiyalarında aşağı salınmış cavablar və dispersiyanın sıxılması önə çıxmışdır.
Buna görə tədqiqat silikon nümunələməni insan iştirakçılarını əvəz edəcək müstəqil empirik sübut mənbəyi kimi deyil, sorğunun ilkin sınağı, müqayisələndirmə, dayanıqlılıq yoxlaması, nümunə həssaslığı və ssenari araşdırması kimi sərhədləri aydın müəyyən edilmiş tapşırıqlarda istifadə oluna biləcək köməkçi metodoloji alət kimi mövqeləndirir. Xüsusilə nəzəriyyənin sınağı, vasitəçilik, moderatorluq və ya davranış mexanizminin şərhi tələb olunduqda insan məlumatları əsas empirik istinad olaraq qalır.
Silikon Nümunələmə Nədir?
Silikon nümunələmə böyük dil modellərindən müəyyən demoqrafik, kontekstual və ya rol əsaslı şərtlər altında sorğu formatında sintetik cavabların əldə edilməsi və bu cavabların avtomatik olaraq insan məlumatlarının yerinə keçirilmədən real insan istinad məlumatları ilə sistemli şəkildə müqayisə olunması yanaşmasıdır.
Sorğu tədqiqatının əsas çətinliklərindən biri insan davranışını birbaşa müşahidə edilə bilməyən konstruksiyalar vasitəsilə ölçməyə çalışmasıdır. Brend imici, sosial təsir, həyatdan məmnunluq, ekoloji strategiya və ya brend mövqeləndirilməsi kimi dəyişənlər fiziki sensorla birbaşa oxunmur; onlar çoxmaddəli şkalalardan çıxarılan gizli konstruksiyalardır. Buna görə yalnız məlumat dəstinin orta qiymətlərinin “realistik” görünməsi onun nəzəriyyə sınağı üçün kifayət olduğu demək deyil.
Böyük dil modelləri kontekstə həssas və formal cəhətdən ardıcıl cavablar yarada bildiyinə görə sorğu tədqiqatında yeni metodoloji imkan yaranır. Lakin LLM cavablarının insan iştirakçıları kimi sabit psixoloji xüsusiyyətlərə malik olduğu fərz edilə bilməz. Model çıxışı promptun quruluşundan, verilən nümunələrdən, kontekstual məlumatdan və modelin öz öyrənilmiş təmsil fəzasından asılıdır. Buna görə tədqiqat sintetik cavabların keçərliliyini birbaşa fərz etmək əvəzinə onları insan məlumatlarına qarşı mərhələli şəkildə sınaqdan keçirir.
Tədqiqatın əsas sualı
Tədqiqatın mərkəzi problemi “LLM çıxışları insan cavablarına bənzəyirmi?” sualından daha dərindir. Əsas sual sintetik cavabların tədqiqatın tələb etdiyi metodoloji xüsusiyyətləri hansı dərinliyə qədər qoruya bilməsidir. Bir məlumat dəstinin orta göstəriciləri insan məlumatlarına yaxınlaşa bilər; lakin eyni məlumat dəsti şkalaların kovariasiya quruluşunu, nəzəri yol əlaqələrini və ya nəticəyə hansı dəyişənlərin təsir etdiyinə dair xüsusiyyət-atribusiya nümunəsini fərqli şəkildə qura bilər.
Niyə Yalnız Statistik Oxşarlıq Kifayət Deyil?
Statistik oxşarlıq yalnız ən səthi keçərlilik səviyyəsini göstərir; nəzəriyyəyə əsaslanan sorğu tədqiqatı üçün şkala etibarlılığının, gizli faktor quruluşunun, struktur əlaqələrin və nəticələri izah edən xüsusiyyət-atribusiya nümunələrinin də insan istinad məlumatları ilə uyğun olub-olmadığı ayrıca sınaqdan keçirilməlidir.
Dörd səviyyəli iyerarxik keçərlilik
| Səviyyə | Əsas sual | İstifadə olunan əsas alətlər | Nə ölçülür? |
|---|---|---|---|
| 1 — Paylanma uyğunluğu | Sintetik cavab paylanmaları insan cavablarına nə qədər yaxınlaşır? | MANOVA, maddə səviyyəsində ANOVA, Welch t-testi, standart sapma nisbətləri | Orta qiymət sürüşmələri, paylanma və istiqamətli şişmə/sıxılma |
| 2 — Psixometrik bütövlük | Şkalaların ölçmə keyfiyyəti qorunurmu? | Cronbach α, kompozit etibarlılıq (CR), AVE, CFA | Daxili uyğunluq, konvergent keçərlilik və gizli faktor quruluşu |
| 3 — Struktur modelin qorunması | Nəzəri dəyişənlər arasındakı yollar qorunurmu? | SEM, standartlaşdırılmış yol əmsalları və uyğunluq indeksləri | İstiqamət, statistik əhəmiyyətlilik, təsir ölçüsü və model uyğunluğu |
| 4 — Xüsusiyyət-atribusiya ardıcıllığı | Nəticəni proqnozlaşdırarkən hansı dəyişənlər önə çıxır? | Gradient Boosting + SHAP | Proqnozlaşdırıcı dəyişənlərin nisbi əhəmiyyət nümunələri |
Dördüncü səviyyə xüsusilə ehtiyatla şərh edilməlidir. SHAP dəyərləri burada Gradient Boosting proqnoz modellərində xüsusiyyətlərin töhfələrini izah edir. Buna görə bu nəticələr birbaşa “LLM belə düşünür” və ya “insan zehni bu mexanizmdən istifadə edir” mənasına gəlmir. Tədqiqatın öz metodoloji sərhədi də budur: SHAP məlumat dəstlərinin yaratdığı proqnozlaşdırıcı atribusiya nümunələrini müqayisə edir; real koqnitiv prosesləri birbaşa müşahidə etmir.
Prompt dizaynı niyə metodoloji dəyişəndir?
Tədqiqatda model seçimi ilə yanaşı prompt arxitekturası da müstəqil metodoloji dəyişən kimi nəzərdən keçirilmişdir. Zero-shot şəraitində nümunə verilmir. One-shot şəraitində bir format nümunəsi təqdim olunur. Few-shot + KNN şəraitində isə araşdırılan profilə xüsusiyyət fəzasında yaxın olan beş real müşahidə tapılaraq modelin kontekstinə nümunə kimi əlavə edilir. Beləliklə model cavablarının birbaşa ümumi statistikalar verilmədən yerli insan məlumat nümunələrinə bağlanmasına çalışılır.
Ən yaxın insan nümunələrinin müəyyənləşdirilməsində mənbə tədqiqat Evklid məsafəsindən istifadə edir:
\[ d(p_i,p_j)=\sqrt{\sum_f \left(p_i^f-p_j^f\right)^2} \]
Bu tənlik iki profil arasındakı xüsusiyyət-fəzası məsafəsini hesablayır. \(p_i\) sintetik cavab yaradılacaq profili, \(p_j\) namizəd insan müşahidəsini, \(f\) isə müqayisədə istifadə edilən xüsusiyyəti təmsil edir. Hər xüsusiyyətdəki fərqin kvadratı alınır, xüsusiyyətlər üzrə toplanır və cəmin kvadrat kökü hesablanır. Ən kiçik məsafəyə malik beş müşahidə few-shot kontekst lövbərini yaradır. Tənlik fiziki kəmiyyət hesablamadığı üçün metr, saniyə və ya başqa fiziki vahidə malik deyil; nəticə istifadə olunan xüsusiyyət təmsilinin fəzasındakı həndəsi məsafədir.
İnsan istinad məlumatları → profil və kontekst çıxarışı → zero-shot / one-shot / few-shot + KNN(5) → Qwen3-Max / DeepSeek-V3 / GPT-5.1 → sintetik sorğu cavabları → dörd səviyyəli insan–LLM müqayisəsi.
Niyə iki fərqli tədqiqat kontekstindən istifadə edildi?
Birinci tədqiqat fərdi istehlakçı münasibətlərinin üstün olduğu lüks istehlak kontekstindən istifadə edir. İnsan istinad nümunəsi Çin alt nümunəsindəki 369 etibarlı cavabdan ibarətdir. Sosial təsir, nümayişkaranə istehlak, brend imici, lüks istehlak meyli, alış impulsu, lüks xərcləmə və həyatdan məmnunluq kimi konstruksiyalar qiymətləndirilir.
İkinci tədqiqat 303 firmadan ibarət B2B məlumat dəstindən istifadə edir. Burada yaşıl marketinq strategiyası, şirkətin ekoloji strategiyası, yaşıl brend mövqeləndirilməsi, yaşıl brend rəqabətqabiliyyətliliyi və yeni yaşıl məhsul uğuru arasındakı əlaqələr nəzərdən keçirilir. Bu model birbaşa təsirlərlə yanaşı vasitəçilik və moderatorluq əlaqələrini də ehtiva etdiyinə görə birinci tədqiqatdan daha yüksək struktur mürəkkəbliyə malikdir.
Tədqiqatın Metodu və Nəticələri
Üç model qiymətləndirilmişdir: Qwen3-Max (qwen3-max), DeepSeek-V3 (deepseek-v3) və GPT-5.1 (gpt-5.1-all). Generasiya temperaturu 0,7, max_tokens 2000 olaraq müəyyən edilmiş; top_p API standartında saxlanmış və seed göstərilməmişdir. Hər sintetik hal yalnız bir dəfə yaradılmış, eyni hal üçün təkrar generasiyaların ortası alınmamışdır.
İki insan məlumat dəstindəki ümumilikdə 672 müşahidənin üç model və üç əsas prompt şəraitində yenidən yaradılması 6.048 sintetik cavab əmələ gətirmişdir. Bu dizaynın mühüm üstünlüyü model və prompt şərtlərinin eyni insan istinad çərçivəsi üzərində müqayisə edilə bilməsidir. Mühüm məhdudiyyəti isə hər sintetik halın yalnız bir dəfə yaradılması səbəbindən generasiya təsadüfiliyinin və təkrarlararası sabitliyin birbaşa ölçülə bilməməsidir.
Few-Shot Prompting İnsan Məlumatları ilə Ekvivalentlik Yaradırmı?
Xeyr. Few-shot + KNN şəraiti hər iki tədqiqatda ümumən insan istinadına ən yaxın sintetik məlumatları yaratmışdır; lakin paylanma sapmaları, model uyğunluğu itkiləri, bəzi yol əmsallarının dəyişməsi və SHAP xüsusiyyət-atribusiya nümunələrindəki fərqlər səbəbindən tədqiqat bunu insan məlumatları ilə tam ekvivalentlik kimi şərh etmir.
Tədqiqat 1 — İstehlakçı kontekstində paylanma nəticələri
İstehlakçı təcrübəsində zero-shot cavablar insan məlumatlarından ən çox uzaqlaşan şəraitdir. Few-shot hər üç modeldə fərqi nəzərəçarpacaq dərəcədə azaldır. Bununla belə sintetik cavabların aydın yuxarı istiqamətli sapması davam edir. Few-shot şəraitində Qwen üçün orta fərq +0,50, DeepSeek üçün +0,49 və GPT üçün +0,67 şkala balıdır. Statistik baxımdan əhəmiyyətli fərq göstərən maddələrin demək olar hamısında LLM ortalamaları insan ortalamalarından yüksəkdir.
| Model | Wilks λ | Orta η² | İnsan məlumatına görə orta fərq | Əsas istiqamət |
|---|---|---|---|---|
| Qwen3-Max | 0,245 | 0,064 | +0,50 | Sintetik cavablar daha yüksəkdir |
| DeepSeek-V3 | 0,251 | 0,063 | +0,49 | Sintetik cavablar daha yüksəkdir |
| GPT-5.1 | 0,321 | 0,088 | +0,67 | Sintetik cavablar daha yüksəkdir |
Bu nəticə strukturlaşdırılmış promptun mühüm olduğunu, lakin sintetik nümunənin qərəzdən avtomatik olaraq təmizlənmədiyini göstərir. Few-shot şəraiti fərqin ölçüsünü azaldır, lakin istehlakçı nümunəsində sistematik yüksək bal vermə meylini aradan qaldırmır.
Tədqiqat 1 — Psixometrik bütövlük
Few-shot məlumat dəstlərində Cronbach α, kompozit etibarlılıq və AVE dəyərləri ümumən qəbul edilə bilən sərhədlərdə qalmışdır. Ən nəzərəçarpan zəifləmələrdən biri brend imici konstruksiyasında görülür; lakin AVE yenə də Qwen üçün 0,577, DeepSeek üçün 0,571 və GPT üçün 0,631 olaraq bildirilmişdir.
CFA uyğunluğunda insan məlumatları daha güclüdür. İnsan istinadında CFI 0,944, TLI 0,935 və RMSEA 0,064 olduğu halda; Qwen few-shot məlumatında 0,913 / 0,900 / 0,072, DeepSeek-də 0,909 / 0,895 / 0,073 və GPT-də 0,899 / 0,884 / 0,085 dəyərləri əldə edilmişdir. Şkala quruluşu tamamilə dağılmır, lakin insan ölçmə modelinin səviyyəsində də yenidən yaradılmır.
Tədqiqat 1 — Struktur model
SEM nəticələri eyni dərəcəli modeli göstərir. İnsan modelində CFI 0,947, TLI 0,941 və RMSEA 0,061-dir. Few-shot Qwen modeli 0,901 / 0,889 / 0,076; DeepSeek 0,897 / 0,885 / 0,077; GPT isə 0,889 / 0,877 / 0,088 dəyərlərini vermişdir.
Altı əsas struktur yolun böyük hissəsi istiqamət və əhəmiyyətlilik baxımından qorunmuşdur. Lakin brend imicindən lüks istehlak meylinə gedən BI → LCT yolu insan məlumatında \(β=0,184\) olduğu halda Qwen-də \(β=-0,149\) və DeepSeek-də \(β=-0,168\) olaraq istiqamət dəyişmiş; GPT-də \(β=0,146\) ilə insan istiqaməti qorunmuşdur. Digər bəzi yolların istiqaməti qorunsa belə əmsal ölçüləri insan istinadından əhəmiyyətli dərəcədə uzaqlaşmışdır. Buna görə model topologiyasının qorunması təsir ölçülərinin eyni olması demək deyil.
Tədqiqat 1 — SHAP niyə kritik xəbərdarlıq verdi?
İnsan istinadında alış impulsunu proqnozlaşdıran Gradient Boosting modelində ən güclü xüsusiyyət həyatdan məmnunluqdur (LS; əhəmiyyət 0,367). Yaş dəyişəninin insan məlumatındakı əhəmiyyəti 0,137-dir. Sintetik məlumat dəstlərinin ortalamasında isə yaşın SHAP əhəmiyyəti 0,303-ə yüksəldiyi halda LS-nin orta əhəmiyyəti 0,036-ya enir. Mənbə həmçinin yaşın 12 LLM/prompt konfiqurasiyasının 10-da ən mühüm xüsusiyyətə çevrildiyini bildirir.
Bu, sintetik cavabların bəzi səthi və struktur xüsusiyyətləri qoruyarkən nəticənin hansı dəyişənlər ətrafında təşkil olunduğunu dəyişdirə bildiyini göstərir. Buradakı nəticə “LLM həqiqətən qərar verərkən yaşdan istifadə edir” kimi oxunmamalıdır; SHAP fərqli məlumat dəstləri üzərində təlimləndirilmiş Gradient Boosting modellərinin xüsusiyyət-atribusiya nümunələrini müqayisə edir.
Tədqiqat 2 — B2B kontekstində paylanmanın istiqaməti dəyişir
B2B tədqiqatında few-shot yenə ümumən ən yaxşı yanaşmanı verir, lakin sapmanın istiqaməti istehlakçı tədqiqatındakı kimi vahid deyil. GPT-5.1 few-shot şəraiti Wilks λ=0,266 və orta η²=0,034 ilə ən güclü paylanma uyğunluqlarından birini təqdim edir; orta fərq -0,048-dir. DeepSeek few-shot fərqi -0,160 olduğu halda Qwen few-shot +0,159-dur.
| Model | Wilks λ | Orta η² | İnsan məlumatına görə orta fərq |
|---|---|---|---|
| Qwen3-Max | 0,192 | 0,056 | +0,159 |
| DeepSeek-V3 | 0,211 | 0,050 | -0,160 |
| GPT-5.1 | 0,266 | 0,034 | -0,048 |
Tədqiqatın mühüm kontekstlərarası nəticəsi burada ortaya çıxır: sintetik məlumat xətası sabit “LLM həmişə yüksək bal verir” davranışı deyil. İstehlakçı kontekstində nəzərəçarpan şişmə görüldüyü halda, təşkilati və strateji B2B suallarında xüsusilə DeepSeek və GPT cavabları insan istinadına nisbətən aşağı istiqamətdə sürüşə və dispersiya daha sıx ola bilər.
Tədqiqat 2 — Ölçmə quruluşu daha kövrəkdir
B2B şkalalarında daxili uyğunluq ümumən güclü qaldığı halda bəzi konvergent keçərlilik dəyərləri zəifləmişdir. Mənbə Cədvəl 8-ə görə Green Marketing Strategy üçün insan AVE dəyəri 0,599-dur; Qwen-də 0,447 və DeepSeek-də 0,395-ə düşdüyü halda GPT-də 0,584-dür. Qwen və DeepSeek dəyərlərinin 0,50-dən aşağı qalması xüsusilə daha abstrakt strateji konstruksiyalarda gizli təmsilin etibarlılıq əmsallarından daha kövrək ola biləcəyini göstərir.
CFA-da insan istinadı CFI 0,992, TLI 0,991 və RMSEA 0,017 ilə çox güclü uyğunluq göstərir. GPT məlumatları 0,897 / 0,889 / 0,068 ilə üç model arasında insana ən yaxın nəticələri verir. Qwen 0,845 / 0,833 / 0,077; DeepSeek isə 0,792 / 0,775 / 0,087 dəyərlərindədir. Beləliklə B2B kontekstində gizli ölçmə quruluşunun istehlakçı kontekstinə nisbətən daha çətin yenidən yaradıldığı görünür.
Tədqiqat 2 — Birbaşa, vasitəçilik və moderator yolları
Mənbə Cədvəl 11 bütün yolların eyni dərəcədə qorunmadığını aydın şəkildə göstərir. Məsələn, GMS → GBP yolu insan məlumatında \(β=0,396\) olduğu halda Qwen-də 0,746, DeepSeek-də 1,267 və GPT-də 0,651-dir; istiqamət və əhəmiyyətlilik qorunduğu halda ölçülər nəzərəçarpacaq dərəcədə dəyişir.
Bunun əksinə CES → GBP yolu insan məlumatında \(β=0,209\) olduğu halda Qwen-də -0,104 və DeepSeek-də -0,323 ilə istiqamət dəyişmiş; GPT-də 0,286 olaraq qorunmuşdur. GBP → NGPS əlaqəsi insan məlumatında \(β=0,543\) olduğu halda Qwen-də 0,187 və DeepSeek-də 0,180 olaraq istiqamətini qorumasına baxmayaraq mənbə cədvəldəki əhəmiyyətliliyin qorunması meyarını keçməmiş; GPT-də 0,492 ilə həm istiqamət, həm də əhəmiyyətlilik qorunmuşdur.
Moderator təsiri də mühüm sərhəd halıdır. İnsan məlumatındakı GMS × CES → GBP qarşılıqlı təsiri \(β=-0,445\)-dir. Qwen (-0,154) və DeepSeek (-0,169) eyni istiqaməti və əhəmiyyətliliyi qoruduğu halda GPT-də əmsal +0,034-ə çevrilmiş və qorunmamışdır. Buna görə sintetik məlumat əsas struktur arxitekturanı qismən yenidən yaratsa belə, xüsusilə daha yüksək dərəcəli əlaqələrdə ekvivalentlik zəmanət verilmir.
Tədqiqat 2 — Xüsusiyyət-atribusiya nümunəsi
İnsan B2B istinadında Green Brand Positioning nəticəsini proqnozlaşdıran ən mühüm dəyişən New Green Product Success-dır (NGPS; SHAP əhəmiyyəti 0,363). LLM məlumat dəstlərində NGPS-nin orta əhəmiyyəti 0,025-ə və orta sırası 5,0-a geriləyir. Bunun əksinə Green Brand Competitiveness (GBC) insan məlumatında 0,124 olduğu halda sintetik məlumat ortalamasında 0,158-ə yüksəlir və orta sıra 1,3 olur.
Bu nəticə istehlakçı təcrübəsindəki “demoqrafik əvəzləmə” nümunəsindən fərqlidir. B2B kontekstində sintetik məlumat nəticəni insan məlumatındakı performans-yönümlü dəyişənlərdən daha çox aralıq strateji konstruksiyalara bağlayır. Beləliklə tədqiqatın əsas iddiası güclənir: LLM sapmasına yalnız model deyil, təmsil edilməli olan tədqiqat kontekstinin xarakteri də təsir edir.
Tədqiqatın dəstəklədiyi nəticələr
Mənbə tədqiqat strukturlaşdırılmış few-shot promptların insan istinadına yaxınlığı ümumən artırdığını; psixometrik etibarlılığın bir çox halda qoruna bildiyini; bəzi struktur əlaqələrin istiqamət və əhəmiyyətliliyinin yenidən yaradıla bildiyini; lakin paylanma qərəzi, əmsal ölçüsünün pozulması, mürəkkəb struktur əlaqələrdə qeyri-sabitlik və xüsusiyyət-atribusiya nümunələrində sistemli fərqlərin davam etdiyini dəstəkləyir.
Tədqiqatın dəstəkləmədiyi nəticələr
Tədqiqat LLM tərəfindən yaradılmış cavabların insan iştirakçılarının yerinə etibarlı şəkildə keçirilə biləcəyini sübut etmir. Few-shot prompting insan ekvivalentliyinə zəmanət vermir. SHAP nəticələri insan və ya LLM koqnisiyasını birbaşa ölçmür. İki tədqiqat kontekstindəki nəticələr bütün cəmiyyətlərə, bütün sorğu növlərinə, bütün mədəniyyətlərə və ya bütün LLM versiyalarına ümumiləşdirilə bilməz. Tədqiqat həmçinin sintetik cavabların təkrar generasiyalarda nə dərəcədə sabit olduğunu sınaqdan keçirməmişdir.
Praktik məna
Bu nəticələr silikon nümunələmənin ən təhlükəsiz istifadə sahələrinin sorğu dizaynı zamanı ilkin sınaq, maddə uyğunluğunun yoxlanması, alternativ nümunə kompozisiyalarına həssaslıq, metodoloji stress testi, müqayisələndirmə və ssenari kəşfi olduğunu düşündürür. Sintetik məlumat bu tapşırıqlarda tədqiqatçıya nəticələrin hansı şərtlərdə dəyişə biləcəyini araşdırmağa kömək edə bilər. Lakin real populyasiya davranışı haqqında empirik sübut lazım olduqda insan məlumatlarını əvəz etməməlidir.
Mənbə və Metod Qeydi
Orijinal başlıq: Silicon Sampling: Supporting Survey Research with Large Language Models
Müəlliflər: Haozhe Ma; Yunchu Yang; Arnaldo Coelho; Penousal Machado; Yapeng Wang.
Qurumlar: CEBER – Centre for Business and Economics Research, Faculty of Economics, University of Coimbra; Faculty of Applied Sciences, Macao Polytechnic University; CISUC/LASI – Centre for Informatics and Systems of the University of Coimbra, Department of Informatics Engineering.
Corresponding author: PDF-də corresponding-author işarəsi Yunchu Yang üzərində göstərilir.
DOI: 10.2139/ssrn.7362005.
Platforma və nəşr statusu: SSRN preprint qeydi. Yüklənmiş PDF açıq şəkildə tədqiqatın hələ resenzent qiymətləndirməsindən keçmədiyini bildirir. PDF-in alt qeydində “Preprint submitted to Elsevier” ifadəsi var; təqdim edilmiş sənəddə resenziyalı jurnal versiyası müəyyən edilmir.
Təqdimetmə tarixi: Rəsmi SSRN qeydində 28 Avqust 2026.
Lisenziya: Yüklənmiş PDF-də və doğrulana bilən biblioqrafik qeyddə təkrar istifadə üçün açıq Creative Commons lisenziyası müəyyən edilməmişdir. Buna görə Verianla məzmununda mənbə fiqurları və ya orijinal cədvəl dizaynları yenidən istifadə edilməmiş; elmi faktlar müstəqil izah və yeni cədvəl strukturları ilə təqdim edilmişdir.
Əsas tədqiqat dizaynı: Əvvəlcədən təsdiqlənmiş iki insan sorğu məlumat dəstinin Qwen3-Max, DeepSeek-V3 və GPT-5.1 tərəfindən zero-shot, one-shot və few-shot + KNN kontekstlərində sintetik şəkildə yenidən yaradılması; sintetik və insan məlumat dəstlərinin paylanma, psixometrik, struktur və SHAP xüsusiyyət-atribusiya səviyyələrində müqayisəsi.
Generasiya parametrləri: Temperature 0,7; max_tokens 2000; top_p API standartı; seed göstərilməmişdir. Hər sintetik hal bir dəfə yaradılmışdır.
İnsan nümunələri: İstehlakçı tədqiqatı N=369; B2B tədqiqatı N=303; ümumi N=672.
Sintetik məlumat: Ümumilikdə 6.048 LLM tərəfindən yaradılmış cavab.
CRediT töhfələri: Haozhe Ma — konseptuallaşdırma, tədqiqat, məlumat kurasiyası və ilkin layihə; Yunchu Yang — metodologiya, formal analiz, vizuallaşdırma və nəzərdən keçirmə/redaktə; Arnaldo Coelho — ilkin layihə, məsləhətçilik və nəzərdən keçirmə/redaktə; Penousal Machado — məsləhətçilik və nəzərdən keçirmə/redaktə; Yapeng Wang — resurslar və məsləhətçilik.
Maliyyələşdirmə, maraqlar toqquşması və məlumat əlçatanlığı: Təqdim edilmiş PDF-də bunlar üçün ayrıca və açıq bəyanatlar müəyyən edilməmişdir; bu sahələr barədə əlavə məlumat fərz edilməmişdir.
Mənbə daxilində hesabat uyğunsuzluqları
Metod dizaynı üç əsas prompt rejimini zero-shot, one-shot və few-shot + KNN kimi müəyyən etsə də, Study 1 izahında bir yerdə “statistical-summary prompting” ifadəsi işlədilir. Bu termin əsas eksperimental dizayn və əlaqəli cədvəllərlə açıq şəkildə uyğunlaşdırılmadığı üçün Verianla izahında açıq şəkildə müəyyən edilmiş üç rejim əsas götürülmüşdür.
B2B psixometrik nəticələrinin mətn hissəsi Green Marketing Strategy üçün insan AVE dəyərini 0,566 kimi yazdığı halda, mənbə Cədvəl 8 eyni dəyəri 0,599 olaraq verir. Verianla-nın kəmiyyətli ötürülməsində birbaşa cədvəl dəyəri 0,599 istifadə edilmiş və uyğunsuzluq gizlədilməmişdir.
B2B struktur nəticələrinin izahındakı bəzi ümumi ifadələr də mənbə Cədvəl 11-dəki yol-əsaslı qorunma işarələri ilə tam üst-üstə düşmür. Buna görə istiqamət və əhəmiyyətlilik qiymətləndirmələrində Cədvəl 11-in ayrı-ayrılıqda bildirdiyi əmsallar və qorunma işarələri əsas götürülmüşdür.
Əsas məhdudiyyətlər
Tədqiqat yalnız iki sorğu kontekstini araşdırır. B2B tədqiqatı Çin institusional mühitinə əsaslandığı üçün nəticələrin başqa institusional və ya mədəni kontekstlərdə eyni şəkildə ortaya çıxacağı məlum deyil. İstifadə olunan model və prompt konfiqurasiyaları məhduddur; retrieval-augmented generation, fine-tuning və ya insan–LLM hibrid nümunələmə kimi yanaşmalar birbaşa sınaqdan keçirilməmişdir.
Hər sintetik hal yalnız bir dəfə yaradıldığı üçün eyni prompt və profilin təkrar generasiyalarında paylanma, psixometrik və ya struktur nəticələrin nə dərəcədə dəyişəcəyi məlum deyil. Bundan əlavə mexanizm səviyyəsində qiymətləndirmə Gradient Boosting + SHAP çərçivəsindən asılıdır. Fərqli proqnozlaşdırma alqoritmləri və ya izah edilə bilənlik metodları fərqli xüsusiyyət-atribusiya strukturları yarada bilər.
Buna görə tədqiqatın ən güclü nəticəsi “sintetik iştirakçılar insanlarla eynidir” deyil. Daha müdafiəolunan nəticə silikon nümunələmənin keçərliliyinin istifadə olunan promptdan, modeldən, tədqiqat kontekstindən və həyata keçirilməsi nəzərdə tutulan elmi nəticəçıxarmanın dərinliyindən asılı olmasıdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib