

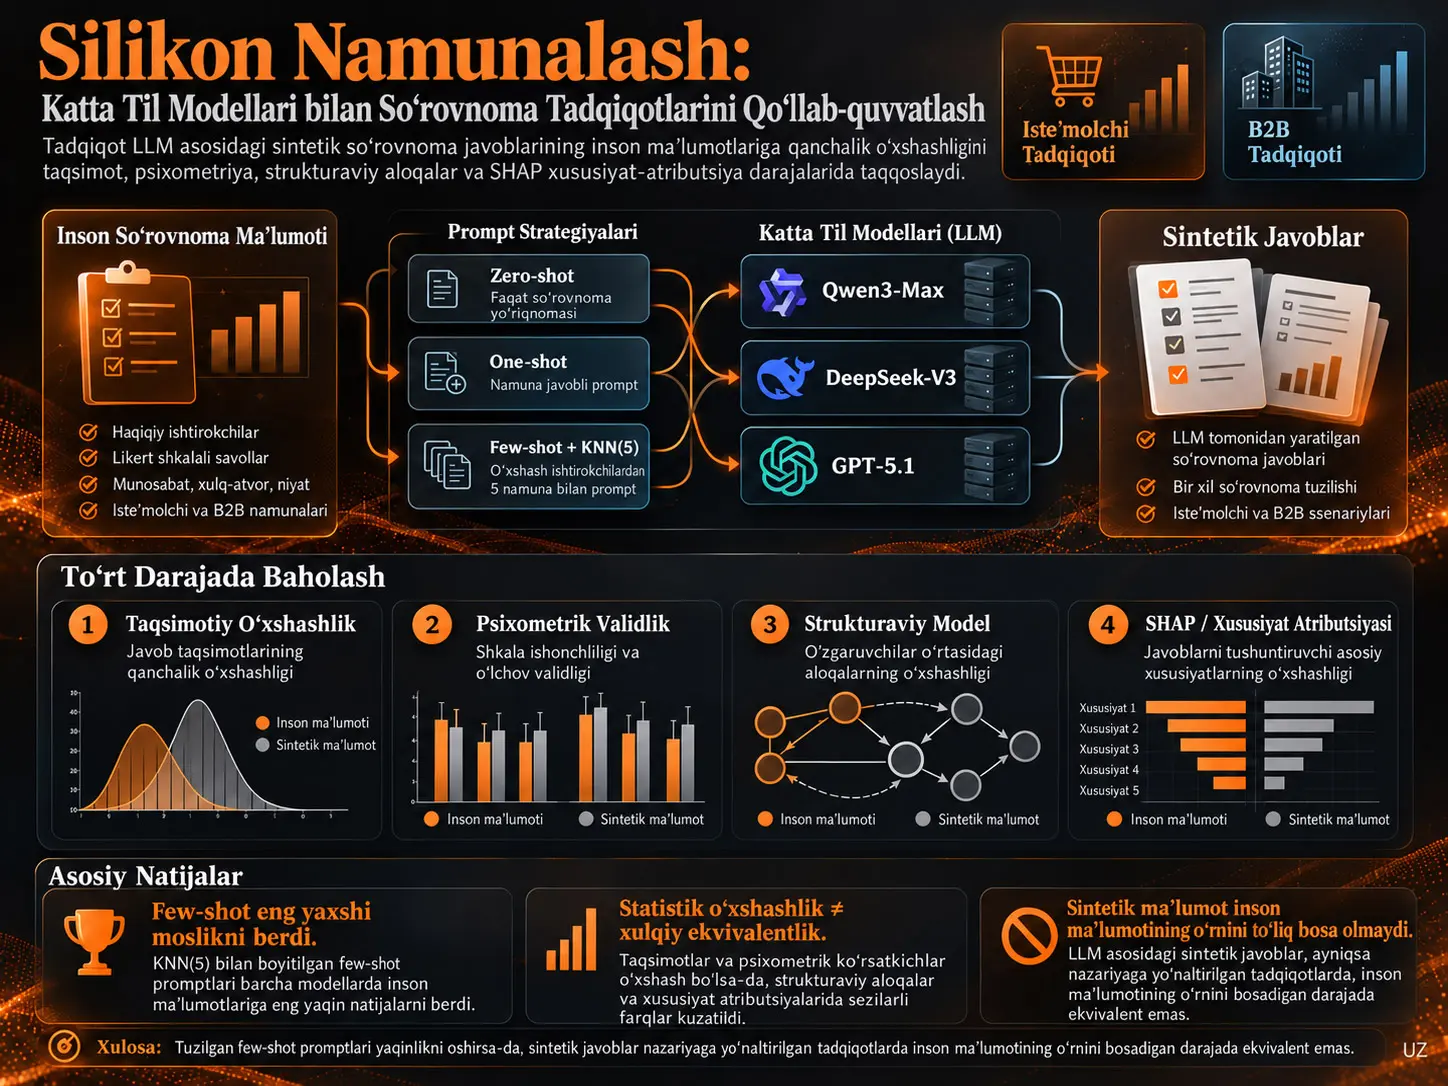
Silikon namunalash (silicon sampling) — katta til modellarining nazorat qilinadigan promptlar ostida sintetik so‘rovnoma javoblarini yaratishi va bu javoblarning odamlardan to‘plangan empirik ma’lumotlar bilan qiyosiy ravishda qo‘llanishi yondashuvidir. Ushbu tadqiqot silikon namunalash faqat “insonga o‘xshash javoblar yarata oladimi” degan savolni emas, balki taqsimotiy o‘xshashlikni, psixometrik o‘lchash sifatini, strukturaviy aloqalarni va bashoratlovchi xususiyat-atributsiya naqshlarini qay darajada saqlab qolishini ham o‘rganadi. Uchta katta til modeli yordamida jami 6.048 ta sintetik javob yaratilib, ular ikkita haqiqiy inson ma’lumotlar to‘plamidagi jami 672 ta javob bilan solishtirilgan: hashamatli iste’mol kontekstida 369 iste’molchi va B2B yashil marketing kontekstida 303 firma. Tadqiqotning asosiy xulosasi shundan iboratki, few-shot shaklidagi tuzilgan promptlar inson ma’lumotlariga yaqinlikni sezilarli darajada oshiradi; biroq yaxshiroq statistik moslik inson javoblari bilan to‘liq psixologik yoki xulqiy ekvivalentlikni anglatmaydi.
Tadqiqot bu farqni to‘rt bosqichli validlik iyerarxiyasi orqali ko‘rsatadi. Birinchi daraja javoblar taqsimotlarini, ikkinchi daraja shkalalarning ishonchliligi va validligini, uchinchi daraja nazariy strukturaviy aloqalarning saqlanishini, to‘rtinchi daraja esa Gradient Boosting modellaridan olingan SHAP xususiyat-atributsiya naqshlarini taqqoslaydi. Natijalar tahlil chuqurlashgani sari moslik ko‘proq shartli tus olishini ko‘rsatadi. Iste’molchi kontekstida LLM javoblari umuman olganda inson javoblariga qaraganda yuqoriroq ballarga moyil bo‘lsa, tashkiliy B2B kontekstida, ayniqsa DeepSeek va GPT konfiguratsiyalarida pasaytirilgan javoblar va dispersiyaning siqilishi ajralib turgan.
Shu sababli tadqiqot silikon namunalashni inson ishtirokchilarining o‘rnini bosadigan mustaqil empirik dalil manbai sifatida emas, balki so‘rovnomani dastlabki sinovdan o‘tkazish, taqqoslash, barqarorlik tekshiruvi, namuna sezgirligi va ssenariy tahlili kabi chegaralari aniq belgilangan vazifalarda qo‘llanishi mumkin bo‘lgan yordamchi metodologik vosita sifatida joylashtiradi. Ayniqsa nazariyani sinash, vositachilik, moderatorlik yoki xulq-atvor mexanizmini talqin qilish talab etilganda inson ma’lumotlari asosiy empirik tayanch bo‘lib qoladi.
Silikon Namunalash Nima?
Silikon namunalash — katta til modellaridan muayyan demografik, kontekstual yoki rolga asoslangan sharoitlarda so‘rovnoma shaklida sintetik javoblar olish va bu javoblarni inson ma’lumotlari o‘rniga avtomatik ravishda qo‘ymasdan, haqiqiy inson tayanch ma’lumotlari bilan tizimli ravishda taqqoslash yondashuvidir.
So‘rovnoma tadqiqotining asosiy qiyinchiliklaridan biri inson xulq-atvorini bevosita kuzatib bo‘lmaydigan konstruktlar orqali o‘lchashga urinishdir. Brend imiji, ijtimoiy ta’sir, hayotdan qoniqish, ekologik strategiya yoki brendni pozitsiyalash kabi o‘zgaruvchilarni jismoniy sensor bilan bevosita o‘qib bo‘lmaydi; ular ko‘p bandli shkalalardan chiqariladigan latent konstruktlardir. Shu sababli ma’lumotlar to‘plamining faqat o‘rtacha qiymatlari “realistik” ko‘rinishi uning nazariyani sinash uchun yetarli ekanini anglatmaydi.
Katta til modellari kontekstga sezgir va shaklan izchil javoblar yarata olgani uchun so‘rovnoma tadqiqotida yangi metodologik imkoniyat paydo bo‘lmoqda. Biroq LLM javoblari inson ishtirokchilari kabi barqaror psixologik xususiyatlarga ega deb taxmin qilib bo‘lmaydi. Model chiqishi prompt tuzilishiga, berilgan misollarga, kontekstual ma’lumotga va modelning o‘rganilgan reprezentatsiya makoniga bog‘liq. Shu sababli tadqiqot sintetik javoblarning validligini bevosita taxmin qilish o‘rniga ularni inson ma’lumotlariga nisbatan bosqichma-bosqich sinaydi.
Tadqiqotning asosiy savoli
Tadqiqotning markaziy muammosi “LLM chiqishlari inson javoblariga o‘xshaydimi?” degan savoldan chuqurroqdir. Asosiy savol sintetik javoblar tadqiqot talab qiladigan metodologik xususiyatlarni qanchalik chuqur darajagacha saqlab qola olishidir. Ma’lumotlar to‘plamining o‘rtacha qiymatlari inson ma’lumotlariga yaqinlashishi mumkin; biroq ayni ma’lumotlar to‘plami shkalalarning kovariatsiya tuzilishini, nazariy yo‘l munosabatlarini yoki natijaga qaysi o‘zgaruvchilar ta’sir qilishi haqidagi xususiyat-atributsiya naqshini boshqacha shakllantirishi mumkin.
Nega Faqat Statistik O‘xshashlik Yetarli Emas?
Statistik o‘xshashlik validlikning faqat eng yuzaki darajasini ko‘rsatadi; nazariyaga asoslangan so‘rovnoma tadqiqoti uchun shkala ishonchliligi, latent faktor tuzilishi, strukturaviy aloqalar va natijalarni tushuntiruvchi xususiyat-atributsiya naqshlarining ham inson tayanch ma’lumotlariga mos kelishi yoki kelmasligi alohida sinovdan o‘tkazilishi kerak.
To‘rt darajali iyerarxik validlik
| Daraja | Asosiy savol | Qo‘llanilgan asosiy vositalar | Nima o‘lchanadi? |
|---|---|---|---|
| 1 — Taqsimotiy moslik | Sintetik javoblar taqsimotlari inson javoblariga qanchalik yaqinlashadi? | MANOVA, band darajasidagi ANOVA, Welch t-testi, standart og‘ish nisbatlari | O‘rtacha qiymat siljishlari, taqsimot va yo‘nalgan oshish/siqilish |
| 2 — Psixometrik yaxlitlik | Shkalalarning o‘lchash sifati saqlanadimi? | Cronbach α, kompozit ishonchlilik (CR), AVE, CFA | Ichki izchillik, konvergent validlik va latent faktor tuzilishi |
| 3 — Strukturaviy modelning saqlanishi | Nazariy o‘zgaruvchilar o‘rtasidagi yo‘llar saqlanadimi? | SEM, standartlashtirilgan yo‘l koeffitsiyentlari va moslik indekslari | Yo‘nalish, statistik ahamiyatlilik, ta’sir kattaligi va model mosligi |
| 4 — Xususiyat-atributsiya izchilligi | Natijani bashorat qilishda qaysi o‘zgaruvchilar ajralib turadi? | Gradient Boosting + SHAP | Bashoratlovchi o‘zgaruvchilarning nisbiy ahamiyat naqshlari |
To‘rtinchi daraja ayniqsa ehtiyotkorlik bilan talqin qilinishi kerak. Bu yerda SHAP qiymatlari Gradient Boosting bashorat modellaridagi xususiyatlar hissasini izohlaydi. Shuning uchun bu natijalar bevosita “LLM shunday o‘ylaydi” yoki “inson ongi mana shu mexanizmdan foydalanadi” degani emas. Tadqiqotning o‘z metodologik chegarasi ham shudir: SHAP ma’lumotlar to‘plamlari hosil qilgan bashoratlovchi atributsiya naqshlarini solishtiradi; haqiqiy kognitiv jarayonlarni bevosita kuzatmaydi.
Prompt dizayni nega metodologik o‘zgaruvchidir?
Tadqiqotda model tanlash bilan bir qatorda prompt arxitekturasi ham mustaqil metodologik o‘zgaruvchi sifatida ko‘rib chiqilgan. Zero-shot sharoitida misol berilmaydi. One-shot sharoitida bitta format misoli taqdim etiladi. Few-shot + KNN sharoitida esa o‘rganilayotgan profilga xususiyatlar makonida yaqin bo‘lgan beshta haqiqiy kuzatuv topilib, model kontekstiga misol sifatida qo‘shiladi. Shu tariqa model javoblarini bevosita umumlashtirilgan statistikalarni bermasdan mahalliy inson ma’lumotlari naqshlariga bog‘lashga harakat qilinadi.
Eng yaqin inson misollarini aniqlashda manba tadqiqot Evklid masofasidan foydalanadi:
\[ d(p_i,p_j)=\sqrt{\sum_f \left(p_i^f-p_j^f\right)^2} \]
Bu tenglama ikki profil orasidagi xususiyatlar-makoni masofasini hisoblaydi. \(p_i\) sintetik javob yaratiladigan profilni, \(p_j\) nomzod inson kuzatuvini, \(f\) esa taqqoslashda ishlatiladigan xususiyatni ifodalaydi. Har bir xususiyatdagi farq kvadratga ko‘tariladi, xususiyatlar bo‘yicha yig‘iladi va yig‘indining kvadrat ildizi olinadi. Eng kichik masofaga ega beshta kuzatuv few-shot kontekst langarini tashkil qiladi. Tenglama fizik kattalikni hisoblamagani sababli metr, soniya yoki boshqa fizik birlikka ega emas; natija qo‘llanilgan xususiyatlar reprezentatsiyasi makonidagi geometrik masofadir.
Inson tayanch ma’lumotlari → profil va kontekstni ajratish → zero-shot / one-shot / few-shot + KNN(5) → Qwen3-Max / DeepSeek-V3 / GPT-5.1 → sintetik so‘rovnoma javoblari → to‘rt darajali inson–LLM taqqoslash.
Nega ikki xil tadqiqot kontekstidan foydalanildi?
Birinchi tadqiqot individual iste’molchi munosabatlari ustun bo‘lgan hashamatli iste’mol kontekstidan foydalanadi. Inson tayanch namunasi Xitoy quyi namunasidagi 369 ta haqiqiy javobdan iborat. Ijtimoiy ta’sir, namoyishkorona iste’mol, brend imiji, hashamatli iste’molga moyillik, xarid impulsi, hashamatga sarf-xarajat va hayotdan qoniqish kabi konstruktlar baholanadi.
Ikkinchi tadqiqot 303 firmadan iborat B2B ma’lumotlar to‘plamidan foydalanadi. Bu yerda yashil marketing strategiyasi, kompaniyaning ekologik strategiyasi, yashil brendni pozitsiyalash, yashil brend raqobatbardoshligi va yangi yashil mahsulot muvaffaqiyati o‘rtasidagi aloqalar ko‘rib chiqiladi. Ushbu model bevosita ta’sirlar bilan bir qatorda vositachilik va moderatorlik aloqalarini ham o‘z ichiga olgani uchun birinchi tadqiqotga qaraganda yuqoriroq strukturaviy murakkablikka ega.
Tadqiqot Usuli va Natijalari
Uchta model baholangan: Qwen3-Max (qwen3-max), DeepSeek-V3 (deepseek-v3) va GPT-5.1 (gpt-5.1-all). Generatsiya harorati 0,7, max_tokens 2000 deb belgilangan; top_p API standart holatida qoldirilgan va seed ko‘rsatilmagan. Har bir sintetik holat faqat bir marta yaratilgan, ayni holat uchun takroriy generatsiyalar o‘rtachasi olinmagan.
Ikki inson ma’lumotlar to‘plamidagi jami 672 kuzatuvni uchta model va uchta asosiy prompt sharoitida qayta yaratish 6.048 ta sintetik javobni hosil qilgan. Bu dizaynning muhim afzalligi model va prompt sharoitlarini bir xil inson tayanch doirasida taqqoslash imkoniyatidir. Muhim cheklovi esa har bir sintetik holat faqat bir marta yaratilgani sababli generatsiya tasodifiyligi va takrorlararo barqarorlikni bevosita o‘lchab bo‘lmasligidir.
Few-Shot Prompting Inson Ma’lumotlari bilan Ekvivalentlikni Ta’minlaydimi?
Yo‘q. Few-shot + KNN sharoiti ikkala tadqiqotda ham umuman olganda inson tayanchiga eng yaqin sintetik ma’lumotlarni yaratgan; biroq taqsimotiy og‘ishlar, model mosligi yo‘qotishlari, ayrim yo‘l koeffitsiyentlarining o‘zgarishi va SHAP xususiyat-atributsiya naqshlaridagi farqlar sababli tadqiqot buni inson ma’lumotlari bilan to‘liq ekvivalentlik sifatida talqin qilmaydi.
Tadqiqot 1 — Iste’molchi kontekstida taqsimotiy natijalar
Iste’molchi tajribasida zero-shot javoblar inson ma’lumotlaridan eng ko‘p uzoqlashgan sharoitlardir. Few-shot uchala modelda ham farqni sezilarli darajada kamaytiradi. Shunga qaramay, sintetik javoblarning aniq yuqoriga yo‘nalgan og‘ishi saqlanib qoladi. Few-shot sharoitida Qwen uchun o‘rtacha farq +0,50, DeepSeek uchun +0,49 va GPT uchun +0,67 shkala ballidir. Statistik jihatdan ahamiyatli farq ko‘rsatgan bandlarning deyarli barchasida LLM o‘rtachalari inson o‘rtachalaridan yuqori.
| Model | Wilks λ | O‘rtacha η² | Inson ma’lumotiga nisbatan o‘rtacha farq | Asosiy yo‘nalish |
|---|---|---|---|---|
| Qwen3-Max | 0,245 | 0,064 | +0,50 | Sintetik javoblar yuqoriroq |
| DeepSeek-V3 | 0,251 | 0,063 | +0,49 | Sintetik javoblar yuqoriroq |
| GPT-5.1 | 0,321 | 0,088 | +0,67 | Sintetik javoblar yuqoriroq |
Bu natija tuzilgan prompt muhim ekanini, biroq sintetik namuna avtomatik ravishda tarafkashlikdan xalos bo‘lmasligini ko‘rsatadi. Few-shot sharoiti farq kattaligini kamaytiradi, lekin iste’molchi namunasidagi tizimli yuqori ball berish moyilligini bartaraf etmaydi.
Tadqiqot 1 — Psixometrik yaxlitlik
Few-shot ma’lumotlar to‘plamlarida Cronbach α, kompozit ishonchlilik va AVE qiymatlari umuman olganda qabul qilinadigan chegaralarda qolgan. Eng sezilarli zaiflashuvlardan biri brend imiji konstruktida kuzatiladi; biroq AVE Qwen uchun 0,577, DeepSeek uchun 0,571 va GPT uchun 0,631 deb qayd etilgan.
CFA mosligida inson ma’lumotlari kuchliroq. Inson tayanchida CFI 0,944, TLI 0,935 va RMSEA 0,064 bo‘lsa; Qwen few-shot ma’lumotida 0,913 / 0,900 / 0,072, DeepSeek’da 0,909 / 0,895 / 0,073 va GPT’da 0,899 / 0,884 / 0,085 qiymatlari olingan. Shkala tuzilishi butunlay yemirilmaydi, lekin inson o‘lchash modeli darajasida ham qayta yaratilmaydi.
Tadqiqot 1 — Strukturaviy model
SEM natijalari bir xil tartibli modelni ko‘rsatadi. Inson modelida CFI 0,947, TLI 0,941 va RMSEA 0,061. Few-shot Qwen modeli 0,901 / 0,889 / 0,076; DeepSeek 0,897 / 0,885 / 0,077; GPT esa 0,889 / 0,877 / 0,088 qiymatlarini bergan.
Oltita asosiy strukturaviy yo‘lning katta qismi yo‘nalish va ahamiyatlilik jihatidan saqlangan. Biroq brend imijidan hashamatli iste’molga moyillikka boruvchi BI → LCT yo‘li inson ma’lumotida \(β=0,184\) bo‘lsa, Qwen’da \(β=-0,149\) va DeepSeek’da \(β=-0,168\) bo‘lib yo‘nalishni o‘zgartirgan; GPT’da \(β=0,146\) bilan inson yo‘nalishi saqlangan. Boshqa ayrim yo‘llarda yo‘nalish saqlansa ham koeffitsiyent kattaliklari inson tayanchidan sezilarli darajada uzoqlashgan. Shu sababli model topologiyasining saqlanishi ta’sir kattaliklari bir xil degani emas.
Tadqiqot 1 — Nega SHAP muhim ogohlantirish berdi?
Inson tayanchida xarid impulsini bashorat qiluvchi Gradient Boosting modelida eng kuchli xususiyat hayotdan qoniqishdir (LS; ahamiyati 0,367). Yosh o‘zgaruvchisining inson ma’lumotidagi ahamiyati 0,137. Sintetik ma’lumotlar to‘plamlarining o‘rtachasida esa yoshning SHAP ahamiyati 0,303 gacha ko‘tariladi, LSning o‘rtacha ahamiyati esa 0,036 gacha tushadi. Manba shuningdek, yosh 12 ta LLM/prompt konfiguratsiyasining 10 tasida eng muhim xususiyatga aylanganini bildiradi.
Bu sintetik javoblar ayrim yuzaki va strukturaviy xususiyatlarni saqlagan holda natija qaysi o‘zgaruvchilar atrofida tashkil etilishini o‘zgartira olishini ko‘rsatadi. Bu yerdagi natija “LLM haqiqatan qaror qabul qilayotganda yoshdan foydalanadi” deb o‘qilmasligi kerak; SHAP turli ma’lumotlar to‘plamlarida o‘qitilgan Gradient Boosting modellarining xususiyat-atributsiya naqshlarini taqqoslaydi.
Tadqiqot 2 — B2B kontekstida taqsimot yo‘nalishi o‘zgaradi
B2B tadqiqotida few-shot yana umuman eng yaxshi yondashuvni beradi, biroq og‘ish yo‘nalishi iste’molchi tadqiqotidagidek bir xil emas. GPT-5.1 few-shot sharoiti Wilks λ=0,266 va o‘rtacha η²=0,034 bilan eng kuchli taqsimotiy mosliklardan birini taqdim etadi; o‘rtacha farq -0,048. DeepSeek few-shot farqi -0,160 bo‘lsa, Qwen few-shot +0,159.
| Model | Wilks λ | O‘rtacha η² | Inson ma’lumotiga nisbatan o‘rtacha farq |
|---|---|---|---|
| Qwen3-Max | 0,192 | 0,056 | +0,159 |
| DeepSeek-V3 | 0,211 | 0,050 | -0,160 |
| GPT-5.1 | 0,266 | 0,034 | -0,048 |
Tadqiqotning muhim kontekstlararo topilmasi shu yerda namoyon bo‘ladi: sintetik ma’lumot xatosi doimiy “LLM har doim yuqori ball beradi” xulqi emas. Iste’molchi kontekstida aniq oshish kuzatilgan bo‘lsa, tashkiliy va strategik B2B savollarida, ayniqsa DeepSeek va GPT javoblari inson tayanchiga nisbatan pastga siljishi va dispersiya yanada siqilgan bo‘lishi mumkin.
Tadqiqot 2 — O‘lchash tuzilishi yanada mo‘rt
B2B shkalalarida ichki izchillik umuman kuchli qolsa-da, ayrim konvergent validlik qiymatlari zaiflashgan. Manba 8-jadvaliga ko‘ra Green Marketing Strategy uchun inson AVE qiymati 0,599; Qwen’da 0,447 va DeepSeek’da 0,395 gacha pasaygan, GPT’da esa 0,584. Qwen va DeepSeek qiymatlarining 0,50 dan past bo‘lishi, ayniqsa mavhumroq strategik konstruktlarda latent reprezentatsiya ishonchlilik koeffitsiyentlariga qaraganda mo‘rtroq bo‘lishi mumkinligini ko‘rsatadi.
CFAda inson tayanchi CFI 0,992, TLI 0,991 va RMSEA 0,017 bilan juda kuchli moslik ko‘rsatadi. GPT ma’lumotlari 0,897 / 0,889 / 0,068 bilan uch model orasida insonga eng yaqin natijalarni beradi. Qwen 0,845 / 0,833 / 0,077; DeepSeek esa 0,792 / 0,775 / 0,087. Shunday qilib B2B kontekstidagi latent o‘lchash tuzilishini iste’molchi kontekstiga qaraganda qayta yaratish qiyinroq ekani ko‘rinadi.
Tadqiqot 2 — Bevosita, vositachi va moderator yo‘llar
Manba 11-jadval barcha yo‘llar bir xil darajada saqlanmasligini aniq ko‘rsatadi. Masalan, GMS → GBP yo‘li inson ma’lumotida \(β=0,396\) bo‘lsa, Qwen’da 0,746, DeepSeek’da 1,267 va GPT’da 0,651; yo‘nalish va ahamiyatlilik saqlansa ham kattaliklar sezilarli darajada o‘zgaradi.
Buning aksiga CES → GBP yo‘li inson ma’lumotida \(β=0,209\) bo‘lsa, Qwen’da -0,104 va DeepSeek’da -0,323 bilan yo‘nalishni o‘zgartirgan; GPT’da 0,286 sifatida saqlangan. GBP → NGPS munosabati inson ma’lumotida \(β=0,543\) bo‘lsa, Qwen’da 0,187 va DeepSeek’da 0,180 bo‘lib yo‘nalishini saqlashiga qaramay, manba jadvalidagi ahamiyatlilikni saqlash mezonidan o‘tmagan; GPT’da 0,492 bilan ham yo‘nalish, ham ahamiyatlilik saqlangan.
Moderator ta’sir ham muhim chegara holatidir. Inson ma’lumotidagi GMS × CES → GBP o‘zaro ta’siri \(β=-0,445\). Qwen (-0,154) va DeepSeek (-0,169) bir xil yo‘nalish va ahamiyatlilikni saqlagan, GPT’da esa koeffitsiyent +0,034 ga aylangan va saqlanmagan. Demak, sintetik ma’lumot asosiy strukturaviy arxitekturani qisman qayta yaratsa ham, ayniqsa yuqori tartibli munosabatlarda ekvivalentlik kafolatlanmaydi.
Tadqiqot 2 — Xususiyat-atributsiya naqshi
Inson B2B tayanchida Green Brand Positioning natijasini bashorat qiluvchi eng muhim o‘zgaruvchi New Green Product Success (NGPS; SHAP ahamiyati 0,363). LLM ma’lumotlar to‘plamlarida NGPSning o‘rtacha ahamiyati 0,025 gacha va o‘rtacha o‘rni 5,0 gacha pasayadi. Aksincha, Green Brand Competitiveness (GBC) inson ma’lumotida 0,124 bo‘lsa, sintetik ma’lumotlar o‘rtachasida 0,158 gacha ko‘tariladi va o‘rtacha o‘rin 1,3 bo‘ladi.
Bu natija iste’molchi tajribasidagi “demografik almashtirish” naqshidan farq qiladi. B2B kontekstida sintetik ma’lumot natijani inson ma’lumotidagi samaradorlikka yo‘naltirilgan o‘zgaruvchilardan ko‘ra oraliq strategik konstruktlarga ko‘proq bog‘laydi. Shu tariqa tadqiqotning asosiy da’vosi kuchayadi: LLM og‘ishi faqat modelga emas, balki reprezentatsiya qilinishi lozim bo‘lgan tadqiqot kontekstining tabiatiga ham bog‘liq.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
Manba tadqiqot tuzilgan few-shot promptlar inson tayanchiga yaqinlikni umuman oshirishini; psixometrik ishonchlilik ko‘p hollarda saqlanishi mumkinligini; ayrim strukturaviy aloqalarning yo‘nalish va ahamiyatliligi qayta yaratilishi mumkinligini; biroq taqsimotiy tarafkashlik, koeffitsiyent kattaligi buzilishi, murakkab strukturaviy aloqalardagi beqarorlik va xususiyat-atributsiya naqshlaridagi tizimli farqlar davom etishini qo‘llab-quvvatlaydi.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
Tadqiqot LLM yaratgan javoblarni inson ishtirokchilarining o‘rniga ishonch bilan qo‘llash mumkinligini isbotlamaydi. Few-shot prompting inson ekvivalentligini kafolatlamaydi. SHAP natijalari inson yoki LLM kognitsiyasini bevosita o‘lchamaydi. Ikki tadqiqot kontekstidagi natijalarni barcha jamiyatlarga, barcha so‘rovnoma turlariga, barcha madaniyatlarga yoki barcha LLM versiyalariga umumlashtirib bo‘lmaydi. Tadqiqot shuningdek sintetik javoblar takroriy generatsiyalarda qanchalik barqaror ekanini sinamagan.
Amaliy ma’no
Bu natijalar silikon namunalashning eng xavfsiz qo‘llanish sohalari so‘rovnoma dizayni paytida dastlabki sinov, bandlar izchilligini tekshirish, muqobil namuna kompozitsiyalariga sezgirlik, metodologik stress-testi, taqqoslash va ssenariylarni o‘rganish ekanini ko‘rsatadi. Sintetik ma’lumot bu vazifalarda tadqiqotchiga natijalar qaysi sharoitlarda o‘zgarishi mumkinligini tekshirishga yordam beradi. Biroq real populyatsiya xulq-atvori haqida empirik dalil zarur bo‘lganda inson ma’lumotlarining o‘rnini bosmasligi kerak.
Manba va Usul Haqida Izoh
Asl sarlavha: Silicon Sampling: Supporting Survey Research with Large Language Models
Mualliflar: Haozhe Ma; Yunchu Yang; Arnaldo Coelho; Penousal Machado; Yapeng Wang.
Muassasalar: CEBER – Centre for Business and Economics Research, Faculty of Economics, University of Coimbra; Faculty of Applied Sciences, Macao Polytechnic University; CISUC/LASI – Centre for Informatics and Systems of the University of Coimbra, Department of Informatics Engineering.
Corresponding author: PDFda corresponding-author belgisi Yunchu Yang nomida ko‘rsatilgan.
DOI: 10.2139/ssrn.7362005.
Platforma va nashr holati: SSRN preprint yozuvi. Yuklangan PDF ish hali taqrizdan o‘tmaganini ochiq ko‘rsatadi. PDF pastki qismida “Preprint submitted to Elsevier” iborasi mavjud; taqdim etilgan hujjatda taqrizdan o‘tgan jurnal versiyasi aniqlanmagan.
Yuborilgan sana: Rasmiy SSRN yozuvida 28 Avgust 2026.
Litsenziya: Yuklangan PDF va tekshirish mumkin bo‘lgan bibliografik yozuvda qayta foydalanish uchun ochiq Creative Commons litsenziyasi aniqlanmagan. Shu sababli Verianla mazmunida manba figuralari yoki original jadval dizaynlari qayta ishlatilmagan; ilmiy faktlar mustaqil bayon va yangi jadval tuzilmalari orqali taqdim etilgan.
Asosiy tadqiqot dizayni: Oldindan tasdiqlangan ikki inson so‘rovnoma ma’lumotlar to‘plamining Qwen3-Max, DeepSeek-V3 va GPT-5.1 tomonidan zero-shot, one-shot va few-shot + KNN kontekstlarida sintetik tarzda qayta yaratilishi; sintetik va inson ma’lumotlar to‘plamlarining taqsimotiy, psixometrik, strukturaviy va SHAP xususiyat-atributsiya darajalarida taqqoslanishi.
Generatsiya sozlamalari: Temperature 0,7; max_tokens 2000; top_p API standart qiymati; seed ko‘rsatilmagan. Har bir sintetik holat bir marta yaratilgan.
Inson namunalari: Iste’molchi tadqiqoti N=369; B2B tadqiqoti N=303; jami N=672.
Sintetik ma’lumot: Jami 6.048 ta LLM yaratgan javob.
CRediT hissalari: Haozhe Ma — konseptuallashtirish, tadqiqot, ma’lumotlarni kuratsiya qilish va dastlabki qoralama; Yunchu Yang — metodologiya, formal tahlil, vizualizatsiya va ko‘rib chiqish/tahrirlash; Arnaldo Coelho — dastlabki qoralama, maslahat va ko‘rib chiqish/tahrirlash; Penousal Machado — maslahat va ko‘rib chiqish/tahrirlash; Yapeng Wang — resurslar va maslahat.
Moliyalashtirish, manfaatlar to‘qnashuvi va ma’lumotlar mavjudligi: Taqdim etilgan PDFda bular bo‘yicha alohida va aniq bayonotlar aniqlanmagan; bu sohalar haqida qo‘shimcha ma’lumot taxmin qilinmagan.
Manba ichidagi hisobot nomuvofiqliklari
Metod dizayni uchta asosiy prompt rejimini zero-shot, one-shot va few-shot + KNN deb belgilashiga qaramay, Study 1 bayonida bir joyda “statistical-summary prompting” iborasi uchraydi. Bu atama asosiy eksperimental dizayn va tegishli jadvallar bilan aniq moslashtirilmagani sababli Verianla bayonida aniq belgilangan uchta rejim asos qilib olingan.
B2B psixometrik natijalarining bayon qismi Green Marketing Strategy uchun inson AVE qiymatini 0,566 deb yozadi, manba 8-jadval esa ayni qiymatni 0,599 deb beradi. Verianlaning miqdoriy bayonida to‘g‘ridan-to‘g‘ri jadval qiymati 0,599 ishlatilgan va nomuvofiqlik yashirilmagan.
B2B strukturaviy natijalar bayonidagi ayrim umumiy iboralar ham manba 11-jadvaldagi yo‘l-asosli saqlanish belgilariga to‘liq mos kelmaydi. Shu sababli yo‘nalish va ahamiyatlilikni baholashda 11-jadval alohida hisobot bergan koeffitsiyentlar va saqlanish belgilari asos qilib olingan.
Asosiy cheklovlar
Tadqiqot faqat ikkita so‘rovnoma kontekstini o‘rganadi. B2B tadqiqoti Xitoy institutsional muhitiga asoslangani sababli natijalar boshqa institutsional yoki madaniy kontekstlarda ayni tarzda yuzaga kelishi noma’lum. Qo‘llanilgan model va prompt konfiguratsiyalari cheklangan; retrieval-augmented generation, fine-tuning yoki inson–LLM gibrid namunalash kabi yondashuvlar bevosita sinovdan o‘tkazilmagan.
Har bir sintetik holat faqat bir marta yaratilgani sababli ayni prompt va profilning takroriy generatsiyalarida taqsimotiy, psixometrik yoki strukturaviy natijalar qay darajada o‘zgarishi noma’lum. Bundan tashqari mexanizm darajasidagi baholash Gradient Boosting + SHAP doirasiga bog‘liq. Turli bashorat algoritmlari yoki tushuntiriluvchanlik usullari turli xususiyat-atributsiya tuzilmalarini yaratishi mumkin.
Shu sababli tadqiqotning eng kuchli xulosasi “sintetik ishtirokchilar insonlar bilan bir xil” degani emas. Himoya qilish mumkin bo‘lgan xulosa shuki, silikon namunalashning validligi qo‘llanilgan prompt, model, tadqiqot konteksti va amalga oshirilmoqchi bo‘lgan ilmiy xulosaning chuqurligiga bog‘liq.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan