

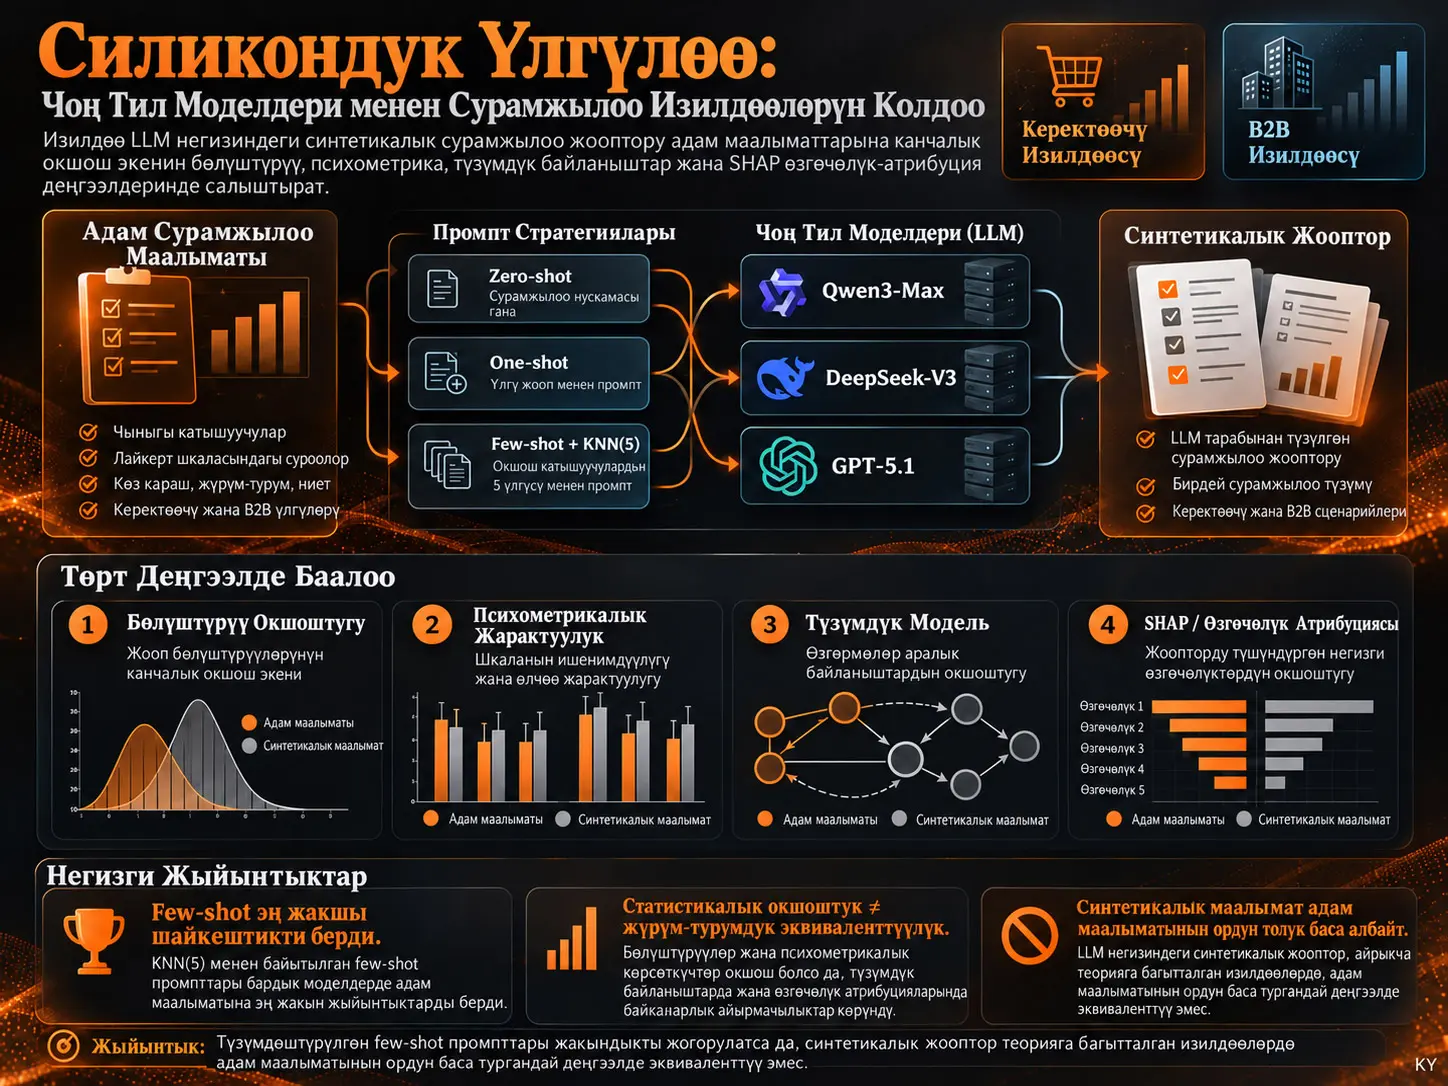
Силикондук үлгүлөө (silicon sampling) — чоң тил моделдеринин көзөмөлдөнгөн prompt шарттарында синтетикалык сурамжылоо жоопторун түзүшү жана бул жооптордун адамдардан чогултулган эмпирикалык маалыматтар менен салыштырма түрдө колдонулушу ыкмасы. Бул изилдөө силикондук үлгүлөө жөн гана “адамга окшош жоопторду чыгара алабы” деген суроону эмес, бөлүштүрүү окшоштугун, психометрикалык өлчөө сапатын, түзүмдүк байланыштарды жана божомолдоочу өзгөчөлүк-атрибуция үлгүлөрүн канчалык деңгээлде сактай аларын да изилдейт. Үч чоң тил модели менен жалпысынан 6.048 синтетикалык жооп түзүлүп, алар эки чыныгы адам маалымат топтомундагы жалпысынан 672 жооп менен салыштырылган: люкс керектөө контекстинде 369 керектөөчү жана B2B жашыл маркетинг контекстинде 303 фирма. Изилдөөнүн негизги жыйынтыгы — few-shot форматындагы түзүмдөштүрүлгөн promptтар адам маалыматтарына жакындыкты байкаларлык жогорулатат, бирок жакшыраак статистикалык дал келүү адам жооптору менен толук психологиялык же жүрүм-турумдук эквиваленттүүлүктү билдирбейт.
Изилдөө бул айырманы төрт баскычтуу жарактуулук иерархиясы аркылуу көрсөтөт. Биринчи деңгээл жооптордун бөлүштүрүлүшүн, экинчи деңгээл шкалалардын ишенимдүүлүгүн жана жарактуулугун, үчүнчү деңгээл теориялык түзүмдүк байланыштардын сакталуусун, төртүнчү деңгээл болсо Gradient Boosting моделдеринен алынган SHAP өзгөчөлүк-атрибуция үлгүлөрүн салыштырат. Натыйжалар талдоо тереңдеген сайын дал келүү көбүрөөк шарттуу болуп каларын көрсөтөт. Керектөөчү контекстинде LLM жооптору жалпысынан адам жоопторуна караганда жогору баллдарга ыктаган, ал эми уюмдук B2B контекстинде өзгөчө DeepSeek жана GPT конфигурацияларында төмөндөтүлгөн жооптор жана дисперсиянын кысылышы өзгөчөлөнгөн.
Ошондуктан изилдөө силикондук үлгүлөөнү адам катышуучуларын алмаштыра турган өз алдынча эмпирикалык далил булагы катары эмес, сурамжылоону алдын ала тестирлөө, салыштыруу, туруктуулукту текшерүү, үлгү сезимталдыгы жана сценарийди изилдөө сыяктуу чектери так белгиленген милдеттерде колдонууга боло турган көмөкчү методологиялык курал катары жайгаштырат. Айрыкча теорияны текшерүү, медиатордук байланыш, модерация же жүрүм-турум механизмин чечмелөө талап кылынганда адам маалыматтары негизги эмпирикалык таяныч бойдон калат.
Силикондук Үлгүлөө Деген Эмне?
Силикондук үлгүлөө — чоң тил моделдеринен белгилүү демографиялык, контексттик же ролго негизделген шарттарда сурамжылоо форматындагы синтетикалык жоопторду алуу жана бул жоопторду адам маалыматтарынын ордуна автоматтык түрдө койбостон, чыныгы адамдык таяныч маалыматтар менен системалуу салыштыруу ыкмасы.
Сурамжылоо изилдөөсүнүн негизги кыйынчылыктарынын бири — адамдын жүрүм-турумун түздөн-түз байкоого мүмкүн болбогон конструкциялар аркылуу өлчөөгө аракет кылуу. Бренд имиджи, социалдык таасир, жашоого канааттануу, экологиялык стратегия же брендди позициялоо сыяктуу өзгөрмөлөр физикалык сенсор менен түз окулбайт; алар көп пункттуу шкалалардан чыгарылган жашыруун конструкциялар. Ошондуктан маалымат топтомунун орточо маанилери гана “реалдуу” көрүнүшү анын теорияны текшерүү үчүн жетиштүү экенин билдирбейт.
Чоң тил моделдери контекстке сезимтал жана формалык жактан ырааттуу жоопторду түзө алгандыктан, сурамжылоо изилдөөлөрүндө жаңы методологиялык мүмкүнчүлүк жаралат. Бирок LLM жооптору адам катышуучуларындай туруктуу психологиялык касиеттерге ээ деп кабыл алууга болбойт. Моделдин чыгышы promptтун түзүлүшүнө, берилген мисалдарга, контексттик маалыматка жана моделдин өзүнүн үйрөнүлгөн өкүлчүлүк мейкиндигине көз каранды. Ошондуктан изилдөө синтетикалык жооптордун жарактуулугун түздөн-түз болжолдоонун ордуна аларды адам маалыматтарына каршы баскыч-баскыч текшерет.
Изилдөөнүн негизги суроосу
Изилдөөнүн борбордук маселеси “LLM чыгыштары адам жоопторуна окшошпу?” деген суроодон тереңирээк. Негизги суроо — синтетикалык жооптор изилдөө талап кылган методологиялык касиеттерди кандай тереңдикке чейин сактай алат. Маалымат топтомунун орточо көрсөткүчтөрү адам маалыматтарына жакындашы мүмкүн; бирок ошол эле маалымат топтому шкалалардын ковариация түзүлүшүн, теориялык жол байланыштарын же натыйжага кайсы өзгөрмөлөр таасир этерин көрсөткөн өзгөчөлүк-атрибуция үлгүсүн башкача түзүшү мүмкүн.
Эмне Үчүн Жалгыз Статистикалык Окшоштук Жетишсиз?
Статистикалык окшоштук жарактуулуктун эң үстүртөн деңгээлин гана көрсөтөт; теорияга негизделген сурамжылоо изилдөөсү үчүн шкаланын ишенимдүүлүгү, жашыруун фактор түзүлүшү, түзүмдүк байланыштар жана натыйжаларды түшүндүргөн өзгөчөлүк-атрибуция үлгүлөрү да адамдык таяныч маалыматтарга шайкеш келер-келбеси өзүнчө текшерилиши керек.
Төрт деңгээлдүү иерархиялык жарактуулук
| Деңгээл | Негизги суроо | Колдонулган негизги куралдар | Эмне өлчөнөт? |
|---|---|---|---|
| 1 — Бөлүштүрүү шайкештиги | Синтетикалык жооптордун бөлүштүрүлүшү адам жоопторуна канчалык жакын? | MANOVA, пункт деңгээлиндеги ANOVA, Welch t-тести, стандарттык четтөөлөрдүн катыштары | Орточо маанилердин жылышы, бөлүштүрүү жана багыттуу көбөйүү/кысылуу |
| 2 — Психометрикалык бүтүндүк | Шкалалардын өлчөө сапаты сакталабы? | Cronbach α, курама ишенимдүүлүк (CR), AVE, CFA | Ички ырааттуулук, конвергенттик жарактуулук жана жашыруун фактор түзүлүшү |
| 3 — Түзүмдүк моделдин сакталуусу | Теориялык өзгөрмөлөрдүн ортосундагы жолдор сакталабы? | SEM, стандартташтырылган жол коэффициенттери жана дал келүү индекстери | Багыт, статистикалык маанилүүлүк, эффект өлчөмү жана моделдин дал келүүсү |
| 4 — Өзгөчөлүк-атрибуция ырааттуулугу | Натыйжаны божомолдоодо кайсы өзгөрмөлөр алдыга чыгат? | Gradient Boosting + SHAP | Божомолдоочу өзгөрмөлөрдүн салыштырмалуу маанилүүлүк үлгүлөрү |
Төртүнчү деңгээлди өзгөчө этият чечмелөө керек. Бул жерде SHAP маанилери Gradient Boosting божомолдоо моделдериндеги өзгөчөлүктөрдүн салымын түшүндүрөт. Демек, бул жыйынтыктар түздөн-түз “LLM ушундай ойлонот” же “адамдын аң-сезими ушул механизмди колдонот” дегенди билдирбейт. Изилдөөнүн өз методологиялык чеги да ушунда: SHAP маалымат топтомдору жараткан божомолдоочу атрибуция үлгүлөрүн салыштырат; чыныгы когнитивдик процесстерди түз байкабайт.
Prompt дизайны эмне үчүн методологиялык өзгөрмө?
Изилдөөдө моделди тандоо менен катар prompt архитектурасы да көз карандысыз методологиялык өзгөрмө катары каралган. Zero-shot шартында мисал берилбейт. One-shot шартында бир форматтык мисал берилет. Few-shot + KNN шартында болсо изилденип жаткан профилге өзгөчөлүктөр мейкиндигинде жакын болгон беш чыныгы байкоо табылып, моделдин контекстине мисал катары кошулат. Ошентип, жалпы статистикаларды түз бербестен, моделдин жоопторун жергиликтүү адам маалымат үлгүлөрүнө байлоого аракет кылынат.
Эң жакын адам мисалдарын аныктоодо булак изилдөө Евклид аралыкты колдонот:
\[ d(p_i,p_j)=\sqrt{\sum_f \left(p_i^f-p_j^f\right)^2} \]
Бул теңдеме эки профилдин ортосундагы өзгөчөлүктөр-мейкиндиги аралыгын эсептейт. \(p_i\) синтетикалык жооп түзүлө турган профилди, \(p_j\) талапкер адам байкоосун, \(f\) болсо салыштырууда колдонулган өзгөчөлүктү билдирет. Ар бир өзгөчөлүктөгү айырманын квадраты алынат, өзгөчөлүктөр боюнча кошулат жана сумманын квадраттык түбү эсептелет. Эң аз аралыкка ээ беш байкоо few-shot контексттик таянычын түзөт. Теңдеме физикалык чоңдукту эсептебегендиктен метр, секунд же башка физикалык бирдикке ээ эмес; натыйжа колдонулган өзгөчөлүк өкүлчүлүгүнүн мейкиндигиндеги геометриялык аралык.
Адамдык таяныч маалыматтар → профиль жана контекстти чыгаруу → zero-shot / one-shot / few-shot + KNN(5) → Qwen3-Max / DeepSeek-V3 / GPT-5.1 → синтетикалык сурамжылоо жооптору → төрт деңгээлдүү адам–LLM салыштыруусу.
Эмне үчүн эки башка изилдөө контексти колдонулду?
Биринчи изилдөө жеке керектөөчүлүк мамилелер үстөм болгон люкс керектөө контекстин колдонот. Адамдык таяныч үлгү Кытайдын ички үлгүсүндөгү 369 жарактуу жооптон турат. Социалдык таасир, көрсөтмөлүү керектөө, бренд имиджи, люкс керектөөгө ыктоо, сатып алуу импульсу, люкска чыгымдоо жана жашоого канааттануу сыяктуу конструкциялар бааланат.
Экинчи изилдөө 303 фирмадан турган B2B маалымат топтомун колдонот. Бул жерде жашыл маркетинг стратегиясы, компаниянын экологиялык стратегиясы, жашыл брендди позициялоо, жашыл бренддин атаандаштыкка жөндөмдүүлүгү жана жаңы жашыл продуктунун ийгилиги ортосундагы байланыштар каралат. Бул модель түз таасирлерден тышкары медиатордук жана модерациялык байланыштарды да камтыгандыктан, биринчи изилдөөгө караганда жогорку түзүмдүк татаалдыкка ээ.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Үч модель бааланган: Qwen3-Max (qwen3-max), DeepSeek-V3 (deepseek-v3) жана GPT-5.1 (gpt-5.1-all). Генерация температурасы 0,7, max_tokens 2000 деп белгиленген; top_p API демейки маанисинде калтырылган жана seed көрсөтүлгөн эмес. Ар бир синтетикалык учур бир гана жолу түзүлгөн, ошол эле учур үчүн кайталанган генерациялардын орточосу алынган эмес.
Эки адам маалымат топтомундагы жалпысынан 672 байкоону үч модель жана үч негизги prompt шартында кайра түзүү 6.048 синтетикалык жоопту жараткан. Бул дизайндагы маанилүү артыкчылык — модель жана prompt шарттарын бир эле адамдык таяныч алкагында салыштырууга мүмкүнчүлүк бериши. Маанилүү чектөөсү болсо ар бир синтетикалык учур бир гана жолу түзүлгөндүктөн, генерациянын кокустугун жана кайталоолор аралык туруктуулукту түз өлчөөгө мүмкүн эместиги.
Few-Shot Prompting Адам Маалыматтары менен Эквиваленттүүлүктү Камсыздайбы?
Жок. Few-shot + KNN шарты эки изилдөөдө тең жалпысынан адамдык таянычка эң жакын синтетикалык маалыматтарды түзгөн; бирок бөлүштүрүү четтөөлөрү, моделдин дал келүү жоготуулары, айрым жол коэффициенттеринин өзгөрүшү жана SHAP өзгөчөлүк-атрибуция үлгүлөрүндөгү айырмачылыктардан улам изилдөө муну адам маалыматтары менен толук эквиваленттүүлүк катары чечмелебейт.
Изилдөө 1 — Керектөөчү контекстиндеги бөлүштүрүү жыйынтыктары
Керектөөчү экспериментинде zero-shot жооптор адам маалыматтарынан эң көп алыстаган шарт болуп саналат. Few-shot үч моделде тең айырманы олуттуу азайтат. Ошого карабастан синтетикалык жооптордун жогору багытталган айкын четтөөсү сакталат. Few-shot шартында Qwen үчүн орточо айырма +0,50, DeepSeek үчүн +0,49 жана GPT үчүн +0,67 шкала баллы. Статистикалык жактан маанилүү айырма көрсөткөн пункттардын дээрлик баарында LLM орточолору адам орточолорунан жогору.
| Модель | Wilks λ | Орточо η² | Адам маалыматтарына салыштырмалуу орточо айырма | Негизги багыт |
|---|---|---|---|---|
| Qwen3-Max | 0,245 | 0,064 | +0,50 | Синтетикалык жооптор жогору |
| DeepSeek-V3 | 0,251 | 0,063 | +0,49 | Синтетикалык жооптор жогору |
| GPT-5.1 | 0,321 | 0,088 | +0,67 | Синтетикалык жооптор жогору |
Бул натыйжа түзүмдөштүрүлгөн prompt маанилүү экенин, бирок синтетикалык үлгү автоматтык түрдө бир жактуулуктан арылбай турганын көрсөтөт. Few-shot шарты айырманын өлчөмүн азайтат, бирок керектөөчү үлгүсүндөгү системалуу жогорку балл берүү тенденциясын жок кылбайт.
Изилдөө 1 — Психометрикалык бүтүндүк
Few-shot маалымат топтомдорунда Cronbach α, курама ишенимдүүлүк жана AVE маанилери жалпысынан кабыл алынуучу чектерде калган. Эң айкын начарлоолордун бири бренд имиджи конструкциясында көрүнөт; бирок AVE Qwen үчүн 0,577, DeepSeek үчүн 0,571 жана GPT үчүн 0,631 деп билдирилген.
CFA дал келүүсүндө адам маалыматтары күчтүүрөөк. Адамдык таянычта CFI 0,944, TLI 0,935 жана RMSEA 0,064 болсо; Qwen few-shot маалыматында 0,913 / 0,900 / 0,072, DeepSeekте 0,909 / 0,895 / 0,073 жана GPTде 0,899 / 0,884 / 0,085 маанилери алынган. Шкаланын түзүлүшү толук кыйрабайт, бирок адам өлчөө модели деңгээлинде да кайра түзүлбөйт.
Изилдөө 1 — Түзүмдүк модель
SEM жыйынтыктары ошол эле даражадагы моделди көрсөтөт. Адам моделинде CFI 0,947, TLI 0,941 жана RMSEA 0,061. Few-shot Qwen модели 0,901 / 0,889 / 0,076; DeepSeek 0,897 / 0,885 / 0,077; GPT болсо 0,889 / 0,877 / 0,088 маанилерин берген.
Алты негизги түзүмдүк жолдун көпчүлүгү багыт жана маанилүүлүк жагынан сакталган. Бирок бренд имиджинен люкс керектөөгө ыктоого кеткен BI → LCT жолу адам маалыматында \(β=0,184\) болсо, Qwenде \(β=-0,149\) жана DeepSeekте \(β=-0,168\) болуп багытын өзгөрткөн; GPTде \(β=0,146\) менен адам багыты сакталган. Башка айрым жолдордун багыты сакталса да коэффициенттердин өлчөмү адамдык таянычтан олуттуу алыстаган. Ошондуктан моделдин топологиясынын сакталуусу эффект өлчөмдөрү бирдей дегенди билдирбейт.
Изилдөө 1 — SHAP эмне үчүн олуттуу эскертүү берди?
Адамдык таянычта сатып алуу импульсун божомолдогон Gradient Boosting моделинде эң күчтүү өзгөчөлүк — жашоого канааттануу (LS; маанилүүлүк 0,367). Жаш өзгөрмөсүнүн адам маалыматындагы маанилүүлүгү 0,137. Синтетикалык маалымат топтомдорунун орточосунда болсо жаштын SHAP маанилүүлүгү 0,303кө көтөрүлүп, LSтин орточо маанилүүлүгү 0,036га төмөндөйт. Булак ошондой эле жаш 12 LLM/prompt конфигурациясынын 10унда эң маанилүү өзгөчөлүк болуп калганын билдирет.
Бул синтетикалык жооптор айрым үстүртөн жана түзүмдүк касиеттерди сактап туруп, натыйжа кайсы өзгөрмөлөрдүн айланасында уюшуларын өзгөртө аларын көрсөтөт. Бул жердеги жыйынтык “LLM чечим кабыл алганда чындап жашты колдонот” деп окулбашы керек; SHAP ар башка маалымат топтомдорунда үйрөтүлгөн Gradient Boosting моделдеринин өзгөчөлүк-атрибуция үлгүлөрүн салыштырат.
Изилдөө 2 — B2B контекстинде бөлүштүрүүнүн багыты өзгөрөт
B2B изилдөөсүндө few-shot дагы эле жалпысынан эң жакшы ыкманы берет, бирок четтөөнүн багыты керектөөчү изилдөөсүндөгүдөй бир тектүү эмес. GPT-5.1 few-shot шарты Wilks λ=0,266 жана орточо η²=0,034 менен эң күчтүү бөлүштүрүү дал келүүлөрүнүн бирин берет; орточо айырма -0,048. DeepSeek few-shot айырмасы -0,160 болсо, Qwen few-shot +0,159.
| Модель | Wilks λ | Орточо η² | Адам маалыматтарына салыштырмалуу орточо айырма |
|---|---|---|---|
| Qwen3-Max | 0,192 | 0,056 | +0,159 |
| DeepSeek-V3 | 0,211 | 0,050 | -0,160 |
| GPT-5.1 | 0,266 | 0,034 | -0,048 |
Изилдөөнүн маанилүү контексттер аралык табылгасы ушул жерден көрүнөт: синтетикалык маалымат катасы туруктуу “LLM дайыма жогорку балл берет” жүрүм-туруму эмес. Керектөөчү контекстинде айкын көбөйүү байкалса, уюмдук жана стратегиялык B2B суроолорунда өзгөчө DeepSeek жана GPT жооптору адамдык таянычка салыштырмалуу төмөн карай жылышы жана дисперсия көбүрөөк кысылышы мүмкүн.
Изилдөө 2 — Өлчөө түзүлүшү көбүрөөк морт
B2B шкалаларында ички ырааттуулук жалпысынан күчтүү бойдон калса да, айрым конвергенттик жарактуулук маанилери начарлаган. Булак Таблица 8ге ылайык Green Marketing Strategy үчүн адам AVE мааниси 0,599; Qwenде 0,447 жана DeepSeekте 0,395ке түшөт, GPTде болсо 0,584. Qwen жана DeepSeek маанилеринин 0,50ден төмөн болушу, өзгөчө абстракттуу стратегиялык конструкцияларда жашыруун өкүлчүлүк ишенимдүүлүк коэффициенттерине караганда морт болушу мүмкүн экенин көрсөтөт.
CFAда адамдык таяныч CFI 0,992, TLI 0,991 жана RMSEA 0,017 менен абдан күчтүү дал келүүнү көрсөтөт. GPT маалыматтары 0,897 / 0,889 / 0,068 менен үч моделдин ичинен адамга эң жакын жыйынтыктарды берет. Qwen 0,845 / 0,833 / 0,077; DeepSeek болсо 0,792 / 0,775 / 0,087. Ошентип B2B контекстиндеги жашыруун өлчөө түзүлүшүн керектөөчү контекстине караганда кайра түзүү кыйыныраак экени көрүнөт.
Изилдөө 2 — Түз, медиатордук жана модерациялык жолдор
Булак Таблица 11 бардык жолдор бирдей деңгээлде сакталбаганын ачык көрсөтөт. Мисалы, GMS → GBP жолу адам маалыматында \(β=0,396\) болсо, Qwenде 0,746, DeepSeekте 1,267 жана GPTде 0,651; багыт жана маанилүүлүк сакталганы менен өлчөмдөр кыйла өзгөрөт.
Ал эми CES → GBP жолу адам маалыматында \(β=0,209\) болсо, Qwenде -0,104 жана DeepSeekте -0,323 болуп багытын өзгөрткөн; GPTде 0,286 болуп сакталган. GBP → NGPS байланышы адам маалыматында \(β=0,543\) болсо, Qwenде 0,187 жана DeepSeekте 0,180 болуп багытын сактаганына карабай, булак таблицадагы маанилүүлүктү сактоо критерийинен өткөн эмес; GPTде 0,492 менен багыт да, маанилүүлүк да сакталган.
Модерациялык эффект да маанилүү чектик учур. Адам маалыматындагы GMS × CES → GBP өз ара таасири \(β=-0,445\). Qwen (-0,154) жана DeepSeek (-0,169) ошол эле багытты жана маанилүүлүктү сактаган, ал эми GPTде коэффициент +0,034кө айланып, сакталган эмес. Демек, синтетикалык маалымат негизги түзүмдүк архитектураны жарым-жартылай кайра түзсө да, өзгөчө жогорку даражадагы байланыштарда эквиваленттүүлүк кепилденбейт.
Изилдөө 2 — Өзгөчөлүк-атрибуция үлгүсү
Адамдык B2B таянычында Green Brand Positioning натыйжасын божомолдогон эң маанилүү өзгөрмө New Green Product Success (NGPS; SHAP маанилүүлүгү 0,363). LLM маалымат топтомдорунда NGPSтин орточо маанилүүлүгү 0,025ке жана орточо орду 5,0ге түшөт. Ал эми Green Brand Competitiveness (GBC) адам маалыматында 0,124 болсо, синтетикалык маалымат орточосунда 0,158ге көтөрүлөт жана орточо орун 1,3 болот.
Бул жыйынтык керектөөчү экспериментиндеги “демографиялык алмаштыруу” үлгүсүнөн айырмаланат. B2B контекстинде синтетикалык маалымат натыйжаны адам маалыматындагы натыйжалуулукка багытталган өзгөрмөлөрдөн көрө аралык стратегиялык конструкцияларга көбүрөөк байланыштырат. Ошентип изилдөөнүн негизги дооматы күчөйт: LLM четтөөсүнө модель гана эмес, көрсөтүлүүгө тийиш болгон изилдөө контекстинин табияты да таасир этет.
Изилдөө колдогон жыйынтыктар
Булак изилдөө түзүмдөштүрүлгөн few-shot promptтар адамдык таянычка жакындыкты жалпысынан арттырарын; психометрикалык ишенимдүүлүк көп учурда сакталышы мүмкүн экенин; айрым түзүмдүк байланыштардын багыты жана маанилүүлүгү кайра түзүлүшү мүмкүн экенин; бирок бөлүштүрүү бир жактуулугу, коэффициент өлчөмүнүн бузулушу, татаал түзүмдүк байланыштардагы туруксуздук жана өзгөчөлүк-атрибуция үлгүлөрүндөгү системалуу айырмачылыктар улана берерин колдойт.
Изилдөө колдобогон жыйынтыктар
Изилдөө LLM тарабынан түзүлгөн жооптор адам катышуучуларынын ордуна ишенимдүү коюла аларын далилдебейт. Few-shot prompting адам эквиваленттүүлүгүн кепилдебейт. SHAP жыйынтыктары адам же LLM когнициясын түз өлчөбөйт. Эки изилдөө контекстиндеги жыйынтыктарды бардык коомдорго, бардык сурамжылоо түрлөрүнө, бардык маданияттарга же бардык LLM версияларына жалпылоого болбойт. Изилдөө ошондой эле синтетикалык жооптордун кайталанган генерацияларда канчалык туруктуу экенин текшерген эмес.
Практикалык мааниси
Бул жыйынтыктар силикондук үлгүлөөнүн эң коопсуз колдонуу тармактары сурамжылоо дизайнында алдын ала тестирлөө, пункттардын ырааттуулугун текшерүү, альтернативдүү үлгү курамдарына сезимталдык, методологиялык стресс-тест, салыштыруу жана сценарийлерди изилдөө экенин көрсөтөт. Синтетикалык маалымат бул милдеттерде изилдөөчүгө жыйынтыктар кайсы шарттарда өзгөрүшү мүмкүн экенин текшерүүгө жардам берет. Бирок чыныгы популяциянын жүрүм-туруму тууралуу эмпирикалык далил талап кылынганда адам маалыматтарын алмаштырбашы керек.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: Silicon Sampling: Supporting Survey Research with Large Language Models
Авторлор: Haozhe Ma; Yunchu Yang; Arnaldo Coelho; Penousal Machado; Yapeng Wang.
Мекемелер: CEBER – Centre for Business and Economics Research, Faculty of Economics, University of Coimbra; Faculty of Applied Sciences, Macao Polytechnic University; CISUC/LASI – Centre for Informatics and Systems of the University of Coimbra, Department of Informatics Engineering.
Corresponding author: PDFде corresponding-author белгиси Yunchu Yang үстүндө көрсөтүлгөн.
DOI: 10.2139/ssrn.7362005.
Платформа жана жарыялоо статусу: SSRN preprint жазуусу. Жүктөлгөн PDF изилдөө али рецензиядан өтпөгөнүн ачык көрсөтөт. PDFдин төмөнкү колонтитулунда “Preprint submitted to Elsevier” деген сөз бар; берилген документте рецензияланган журнал версиясы аныкталган эмес.
Тапшыруу датасы: Расмий SSRN жазуусунда 28 Август 2026.
Лицензия: Жүктөлгөн PDFде жана текшерүүгө мүмкүн болгон библиографиялык жазууда кайра колдонууга ачык Creative Commons лицензиясы көрсөтүлгөн эмес. Ошондуктан Verianla мазмунунда булак фигуралары же түпнуска таблица дизайндары кайра колдонулган эмес; илимий фактылар өз алдынча баяндоо жана жаңы таблица түзүлүштөрү менен берилген.
Негизги изилдөө дизайны: Алдын ала текшерилген эки адам сурамжылоо маалымат топтомун Qwen3-Max, DeepSeek-V3 жана GPT-5.1 тарабынан zero-shot, one-shot жана few-shot + KNN контексттеринде синтетикалык түрдө кайра түзүү; синтетикалык жана адам маалымат топтомдорун бөлүштүрүү, психометрикалык, түзүмдүк жана SHAP өзгөчөлүк-атрибуция деңгээлдеринде салыштыруу.
Генерация жөндөөлөрү: Temperature 0,7; max_tokens 2000; top_p API демейки мааниси; seed көрсөтүлгөн эмес. Ар бир синтетикалык учур бир жолу түзүлгөн.
Адам үлгүлөрү: Керектөөчү изилдөөсү N=369; B2B изилдөөсү N=303; жалпы N=672.
Синтетикалык маалымат: Жалпысынан 6.048 LLM тарабынан түзүлгөн жооп.
CRediT салымдары: Haozhe Ma — концептуалдаштыруу, изилдөө, маалыматтарды курациялоо жана алгачкы долбоор; Yunchu Yang — методология, формалдык анализ, визуалдаштыруу жана карап чыгуу/редакциялоо; Arnaldo Coelho — алгачкы долбоор, кеңеш берүү жана карап чыгуу/редакциялоо; Penousal Machado — кеңеш берүү жана карап чыгуу/редакциялоо; Yapeng Wang — ресурстар жана кеңеш берүү.
Каржылоо, кызыкчылыктардын кагылышы жана маалыматтардын жеткиликтүүлүгү: Берилген PDFде булар боюнча өзүнчө жана ачык билдирүүлөр табылган эмес; бул талаалар тууралуу кошумча маалымат болжолдонгон эмес.
Булактагы отчет берүү карама-каршылыктары
Метод дизайны үч негизги prompt режимин zero-shot, one-shot жана few-shot + KNN катары аныктаганына карабастан, Study 1 баянында бир жерде “statistical-summary prompting” деген сөз колдонулат. Бул термин негизги эксперименттик дизайн жана тиешелүү таблицалар менен ачык дал келтирилбегендиктен, Verianla баянында так аныкталган үч режим негиз катары алынган.
B2B психометрикалык жыйынтыктарынын баяндама бөлүгү Green Marketing Strategy үчүн адам AVE маанисин 0,566 деп жазат, ал эми булак Таблица 8 ошол эле маанини 0,599 деп берет. Verianlaнын сандык берүүсүндө түздөн-түз таблицадагы 0,599 мааниси колдонулган жана карама-каршылык жашырылган эмес.
B2B түзүмдүк жыйынтыктарынын баянында айрым жалпы билдирүүлөр да булак Таблица 11деги жол боюнча сакталуу белгилери менен толук дал келбейт. Ошондуктан багыт жана маанилүүлүктү баалоодо Таблица 11 ар бир жол үчүн өзүнчө берген коэффициенттер жана сакталуу белгилери негиз катары алынган.
Негизги чектөөлөр
Изилдөө болгону эки сурамжылоо контекстин карайт. B2B изилдөөсү Кытайдын институционалдык чөйрөсүнө негизделгендиктен, жыйынтыктар башка институционалдык же маданий контексттерде дал ушундай чыгары белгисиз. Колдонулган модель жана prompt конфигурациялары чектелүү; retrieval-augmented generation, fine-tuning же адам–LLM гибриддик үлгүлөө сыяктуу ыкмалар түздөн-түз текшерилген эмес.
Ар бир синтетикалык учур бир гана жолу түзүлгөндүктөн, ошол эле prompt жана профилдин кайталанган генерацияларында бөлүштүрүү, психометрикалык же түзүмдүк жыйынтыктар канчалык өзгөрөрү белгисиз. Мындан тышкары механизм деңгээлиндеги баалоо Gradient Boosting + SHAP алкагына көз каранды. Ар башка божомолдоо алгоритмдери же түшүндүрмөлүүлүк ыкмалары ар башка өзгөчөлүк-атрибуция түзүлүштөрүн жаратышы мүмкүн.
Ошондуктан изилдөөнүн эң күчтүү жыйынтыгы “синтетикалык катышуучулар адамдар менен бирдей” деген эмес. Коргоого боло турган жыйынтык — силикондук үлгүлөөнүн жарактуулугу колдонулган promptка, моделге, изилдөө контекстине жана жасала турган илимий тыянактын тереңдигине көз каранды.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген