

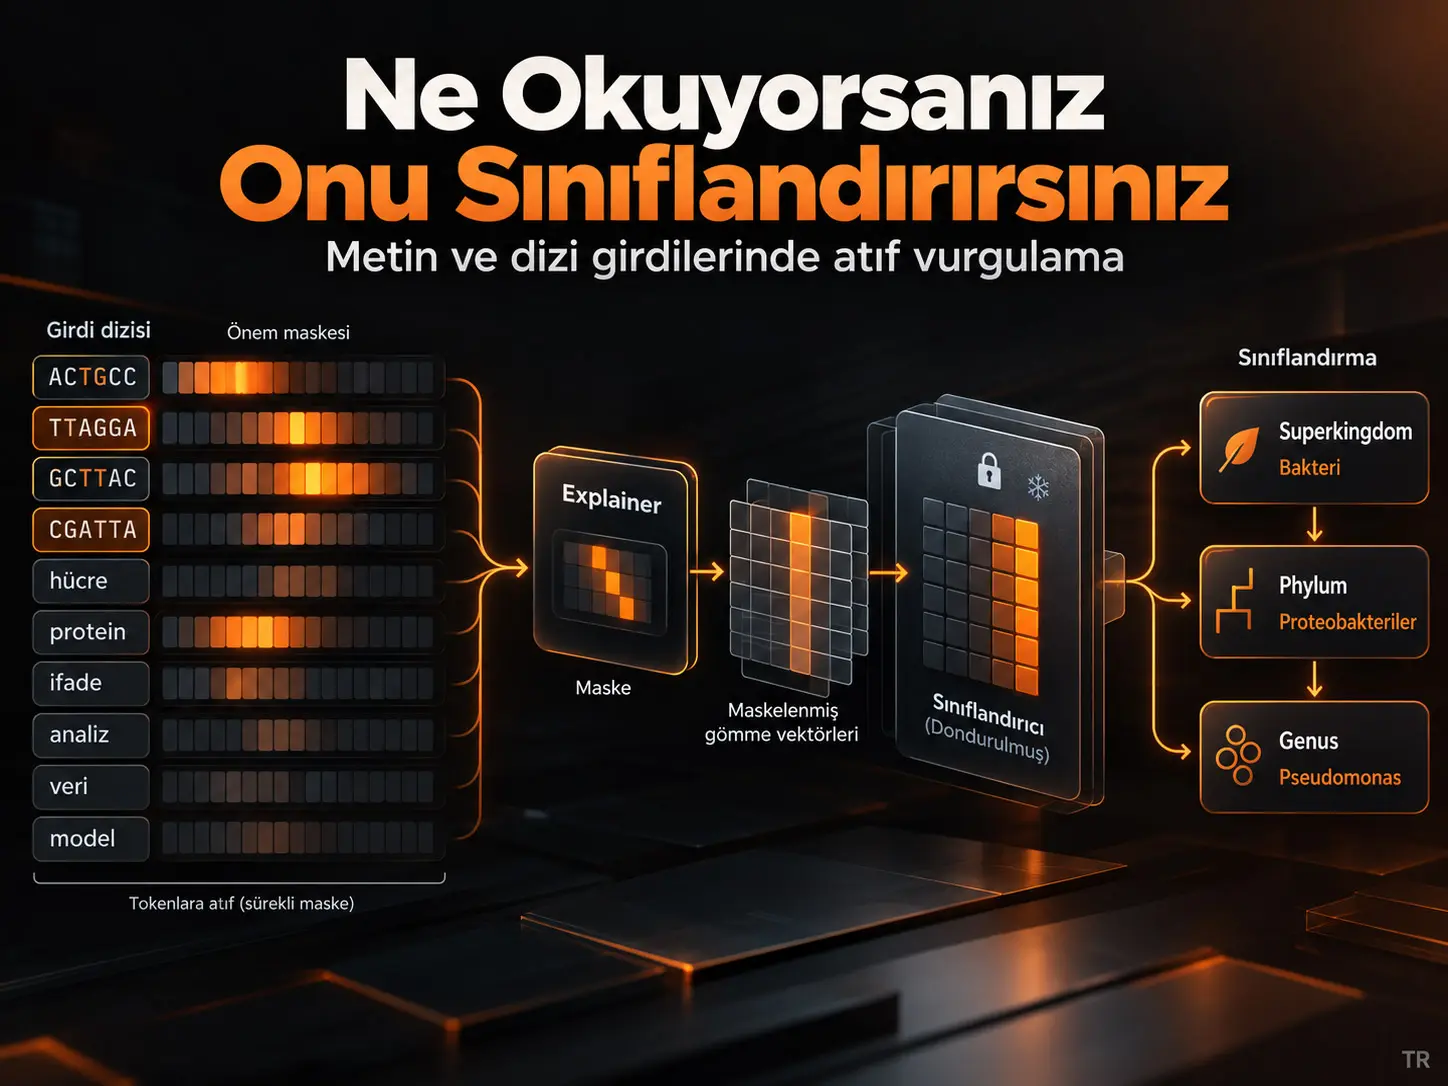
Bu çalışmada geliştirilen Explainer–Explanandum tabanlı açıklanabilir yapay zekâ yöntemi, token dizilerini sınıflandıran bir yapay zekâ modelinin kararında hangi ardışık token bölgelerinin önemli olduğunu sürekli değerli maskelerle belirlemeyi amaçlayan bir XAI yaklaşımıdır. Yöntem, maskeyi ayrık token kimliklerine doğrudan uygulamak yerine tokenların sürekli embedding vektörlerine Hadamard çarpımıyla uygular; böylece embedding vektörünün yönü korunurken büyüklüğü azaltılır. Araştırmacılar yöntemi 50 milyon parametreli Nucleotide Transformer modeli NT50m ile DNA dizilerinin superkingdom, phylum ve genus düzeylerinde taksonomik sınıflandırılması üzerinde sınamıştır. Sonuçlar, önemli kabul edilen bölgeler açık bırakıldığında sınıflandırma başarımının büyük ölçüde korunduğunu, aynı bölgeler gizlendiğinde ise başarımın ciddi biçimde düştüğünü göstermektedir. Bununla birlikte deney doğal dil metni üzerinde değil genomik token dizileri üzerinde gerçekleştirilmiştir; bu nedenle doğal dil için genellenebilirlik çalışmanın deneysel olarak doğrulanmış sonucu değildir.
Temel sınıflandırıcı olan Explanandum'un dengeli doğruluğu superkingdom, phylum ve genus için Tablo 1'de sırasıyla %99,05, %97,39 ve %71,67 olarak raporlanmıştır. Explainer tarafından oluşturulan sürekli maskeler uygulanırken bu değerler %98,39, %95,51 ve %69,88 olarak korunmuştur. Maskelerin ters çevrilmesi, yani Explainer'ın önemli olarak gördüğü bölgelerin gizlenip önemsiz bölgelerin açık bırakılması durumunda dengeli doğruluk sırasıyla %46,70, %28,21 ve %5,71'e düşmüştür. Bu karşıtlık, maskelerin sınıflandırmaya gerçekten katkı sağlayan bilgi bölgelerini ayırabildiğine ilişkin çalışmanın başlıca deneysel kanıtıdır.
Yöntemin amacı tek tek ve birbirinden kopuk token önem skorları üretmek yerine daha sürekli açıklama bölgeleri oluşturmaktır. Yuvarlanmış maskelerden elde edilen açık bölgelerde ortalama parça sayısı 3,35'tir; dizilerin yaklaşık %90'ında dört veya daha az açık parça bulunmaktadır. Ortalama açık bölüm uzunluğu 51,39 token olup 250 tokenlık tipik girişin yaklaşık beşte birine karşılık gelir. Böylece açıklama, bütün diziyi önemli ilan etmek yerine orta uzunlukta birkaç ardışık bölgeye yoğunlaşmaktadır.
Çalışma ayrıca çalışma zamanı bakımından LIME ile pratik bir karşılaştırma sunar. Kaynakta LIME'ın her dizi ve her taksonomik seviye için ortalama 26 saniye aldığı bildirilirken Explainer'ın eğitimi 15 saat 40 dakika sürmüş ve eğitilmiş Explainer test kümesinin maskelerini yaklaşık 20 dakikada üretmiştir. Buradaki temel mimari fark, LIME gibi perturbation tabanlı yöntemlerin hesaplama yükünü büyük ölçüde açıklama üretimi sırasında taşırken bu yöntemin maliyetinin önemli bölümünü Explainer eğitimi sırasında önden ödemesidir.
Token Tabanlı Açıklanabilir Yapay Zekâdaki Temel Sorun Nedir?
Token tabanlı açıklanabilir yapay zekâdaki temel sorun, metin veya biyolojik dizi gibi ayrık girdilerde bir tokenın kısmen maskelenememesi ve güçlü transformer sınıflandırıcılarının kararlarının hem yerel hem de uzak token etkileşimlerine dayanabilmesidir; bu nedenle görüntülerde doğal biçimde çalışan sürekli piksel maskeleri tokenlara doğrudan aktarılamaz.
Görüntü sınıflandırmasında bir pikselin yoğunluğu sürekli bir sayıdır. Örneğin bir görüntü bölgesini 0,25 ile çarpmak o bölgenin görsel etkisini azaltır ve işlem diferansiyellenebilir kalır. Buna karşılık token kimliği kategoriktir. Bir kelimeyi veya DNA 6-mer'ını “0,25 token” haline getirmek geçerli bir tokenizasyon işlemi değildir.
Metin açıklamalarında yaygın kullanılan SHAP ve Local Interpretable Model-Agnostic Explanations (LIME) gibi perturbation tabanlı yöntemler, giriş özelliklerini değiştirerek çıktı üzerindeki etkilerini değerlendirir. Kaynak yazarlarına göre tokenları çoğunlukla tek tek ele alan bu yaklaşım, uzun dizilerde önemli bölgeleri birbirinden kopuk tokenlar halinde gösterebilir ve bütüncül olarak okunması zor bir önem haritası oluşturabilir.
Rationalization yöntemleri ise sınıflandırma kararını açıklamak için girdinin ilgili bölümlerini seçebilir veya açıklayıcı metin oluşturabilir. Ancak kaynak, bazı generatif rationalization yaklaşımlarında açıklamanın girdiye sadık kalmaması veya hallucination üretmesi riskine; bazı denetimli seçme yaklaşımlarında ise eğitim karmaşıklığına dikkat çekmektedir.
Explainer ve Explanandum rolleri
Yöntem iki model rolünü ayırır. Explanandum, açıklanmak istenen ve ağırlıkları dondurulan mevcut sınıflandırıcıdır. Explainer ise her giriş tokenı ve her sınıf için 0 ile 1 arasında maske değeri üretmek üzere eğitilen ikinci sinir ağıdır.
Bir sınıf için üretilen maske \(s_c\) ile gösterilir. Gerçek hedefe ait sınıfların maskeleri element-wise maksimum işlemiyle birleştirilerek hedef maske \(m\) oluşturulur. Hedef olmayan sınıfların maskelerinden de non-target maske \(n\) oluşturulur. Hedef maskenin tersi:
\[ \widetilde{m}=1-m \]
şeklindedir. Bu tamamlayıcı maske özellikle “önemli kabul edilen bilgiyi kaldırırsak sınıflandırıcının güveni gerçekten bozuluyor mu?” sorusunun sınanmasında kullanılır.
Kaynak Şekil 1 neyi gösteriyor?
Kaynağın Şekil 1A paneli, görüntüler için kullanılan özgün “what-you-see” yaklaşımında Explainer'ın doğrudan görüntü boyutunda maskeler üretmesini gösterir. Şekil 1B ise makalenin temel katkısını sunar: token dizisi önce Explainer'a giderken açıklanan Explanandum token işleme ve embedding bölümü ile sonraki gizli/sınıflandırma katmanlarına ayrılır. Maskeler tokenların kendisi üzerinde değil, sürekli embedding temsillerinin üzerinde etkili olur.
Bu Çalışmada Maske Tokenlara Nasıl Uygulanıyor?
Maske token kimliğini değiştirmek yerine her tokenın embedding vektörüne uygulanır; uzunluğu \(d\) olan maske vektörü embedding boyutu \(h\) boyunca tekrarlanarak \(d\times h\) boyutuna genişletilir ve embedding matrisiyle Hadamard, yani element-wise çarpım yapılır.
Bir tokenın embedding vektörü \(e\) ve o tokenın maske değeri \(m_i\) ise işlem kavramsal olarak:
\[ e_{\text{masked}}=m_i e \]
şeklinde düşünülebilir. Aynı skaler değer embedding'in bütün bileşenlerine uygulandığı için \(0<m_i<1\) olduğunda vektörün büyüklüğü azalır fakat embedding uzayındaki yönü değişmez. Kaynağın Şekil 2'sinde 0,25 maske değeriyle “apple” embedding vektörünün aynı yönde fakat daha kısa hale gelmesi bu mekanizmayı görselleştirir.
Bu seçim iki problemi aynı anda çözer. Birincisi, ayrık tokenlara kesirli maske uygulama zorunluluğunu ortadan kaldırır. İkincisi, sürekli çarpım işlemi sayesinde Explainer'dan Explanandum üzerinden kayıp fonksiyonuna kadar olan yol diferansiyellenebilir kalır; böylece Explanandum dondurulurken yalnız Explainer ağırlıkları eğitilebilir.
Mean pooling kullanıldığında neden ikinci maskeleme gerekiyor?
Yazarlar yöntemin uygulanması için önemli bir koşul belirlemektedir: boş bir dizinin veya tamamen maskelenmiş dizinin sınıflandırıcı softmax çıktısının yaklaşık uniform olması beklenir. Ancak NT50m'de bütün token gizli durumları üzerinde mean pooling kullanıldığında tamamen maskelenmiş giriş bunu otomatik olarak sağlamamıştır.
Bu nedenle NT50m deneyinde maske yalnız embedding katmanından sonra değil, transformer gizli katmanlarının çıktısına da mean pooling öncesinde yeniden uygulanmıştır. Kaynağın Şekil 3'ü CLS token çıktısı kullanan sınıflandırıcı ile mean-pooling sınıflandırıcı arasındaki bu farkı gösterir. Yazarlar, sınıflandırma yalnız CLS çıktısına dayanıyorsa ikinci maskelemenin gerekli olmadığını belirtmektedir.
Kayıp fonksiyonunun genel yapısı
Görüntüler için kullanılan iki boyutlu maske kaybı token dizileri için tek boyuta indirgenmiştir. Toplam Explainer kaybı kaynakta Denklem (1) olarak:
\[ L_E(x,Y,S,m,n) = L_c(x,Y,m) + \lambda_e L_e(x,\widetilde m) + \lambda_a L_a(m,n,S) + \lambda_{tv}L_{tv}(m,n) \]
şeklinde verilir. Deneylerde:
\[ \lambda_e=\lambda_a=\lambda_{tv}=1 \]
kullanılmıştır. Bu katsayılar ayrıca hiperparametre aramasıyla optimize edilmemiş, kaynak alınan Stalder ve arkadaşlarının çalışmasındaki değerlere dayanılarak seçilmiştir.
Açıklayıcı Ağın Kayıp Fonksiyonu Neyi Dengeliyor?
Toplam kayıp, hedef sınıflandırma bilgisini açık tutmak, önemli bilgi gizlendiğinde sınıflandırıcıyı belirsiz hale getirmek, maskenin ne her şeyi ne de hiçbir şeyi göstermesini önlemek ve önemli tokenların birbirinden kopuk noktalar yerine yerel olarak daha sürekli bölgeler oluşturmasını teşvik etmek üzere dört bileşeni birlikte dengeler.
1. Sınıflandırma kaybı \(L_c\)
Kaynak çok sınıflı sınıflandırma için standart cross-entropy temelli terimi:
\[ L_c(x,Y,m) = -\frac{1}{C} \sum_{c=1}^{C} \left[ \llbracket c\in Y\rrbracket\log p[c] + \llbracket c\notin Y\rrbracket\log(1-p[c]) \right] \]
olarak verir. Burada \(C\) sınıf sayısını, \(p[c]\) sınıf \(c\) için tahmin olasılığını ve Iverson parantezi \(\llbracket\cdot\rrbracket\) koşul doğruysa 1, yanlışsa 0 değerini temsil eder. Bu terim hedef maskenin sınıflandırma için gerekli bilgiyi açık bırakmasını teşvik eder.
2. Tamamlayıcı maske entropisi \(L_e\)
Kaynak Denklem (3)'te:
\[ L_e = \frac{1}{C} \sum_{c=1}^{C} F(x\odot\widetilde m)[c] \log F(x\odot\widetilde m)[c] \]
ifadesini kullanır. \(F(\cdot)\) Explanandum'un sınıf olasılıklarını üretir. Tamamlayıcı maske uygulandığında yalnız düşük önem verilen bilgiler açık kalır. Bu durumda çıktı olasılıklarının mümkün olduğunca uniform hale gelmesi, önemli bilgi kaldırıldığında modelin anlamlı sınıflandırma yapamamasını teşvik eder.
3. Maske alan kaybı \(L_a\)
Yalnız sınıflandırma ve entropi terimleri kullanılırsa bir terim maskeyi her şeyi göstermeye, diğeri ise fazla gizlemeye itebilir. Alan kaybı bu iki uç arasında denge kurar:
\[ L_a(m,n,S) = A(m)+A(n) + \frac{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket B(s_c) }{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket }. \]
\(A(m)\), hedef maskenin ortalama değerini; \(A(n)\), hedef olmayan maskenin ortalama değerini ifade eder. Kaynak, görünür maske alanı için \(0<a<b<1\) olacak biçimde minimum \(a\) ve maksimum \(b\) kesirleri tanımlar.
Sıralanmış maske değerleri için sınır cezası Denklem (5)'te:
\[ B(s) = \frac{1}{Z} \sum_i \max(q_{\min}[i]-q_{\text{mask}}[i],0) + \frac{1}{Z} \sum_i \max(q_{\text{mask}}[i]-q_{\max}[i],0) \]
şeklinde tanımlanır. \(Z\) dizi uzunluğudur. Maske alanı \(a\)'dan küçük veya \(b\)'den büyük olduğunda ceza oluşur; böylece açıklamanın aşırı küçük veya aşırı geniş olması engellenmeye çalışılır.
4. Toplam varyasyon kaybı \(L_{tv}\)
Yerel sürekliliği teşvik eden Denklem (6):
\[ L_{tv} = \frac{1}{Z} \sum_i |m[i]-m[i+1]| + \frac{1}{Z} \sum_i |n[i]-n[i+1]|. \]
Komşu tokenların maske değerleri büyük sıçramalar yaptığında bu terim büyür. Dolayısıyla Explainer, yalnız tek tek dağınık tokenları işaretlemek yerine komşu tokenların birlikte önemli olduğu daha sürekli bölgeler oluşturmaya yönlendirilir. Bu süreklilik, çalışmanın “insan tarafından okunabilir açıklama” hedefinin temel tasarım öğelerinden biridir.
Explainer mimarisi
Explainer'ın girişi, NT50m ile aynı 4107 öğelik sözlüğü kullanan ve boyutu 100 olan bir embedding katmanıdır. Bunun ardından iki katmanlı çift yönlü Long Short-Term Memory (LSTM) ağı gelir. Kaynak her yönde kullanılan yapı için 40 node seçildiğini ve ileri/geri memory-cell durumlarının birleştirilmesiyle token başına 160 boyutlu temsil elde edildiğini belirtmektedir.
LSTM çıkışını Batch Normalization ve sigmoid aktivasyonlu dense katman izler. Sınıf sayısı \(c\), dizi uzunluğu \(d\) olduğunda Explainer'ın nihai çıktısı:
\[ d\times c \]
boyutlu bir maske matrisidir ve her token-sınıf çifti için 0–1 arasında önem değeri üretir. Explainer mimarisi için hiperparametre araması yapılmamıştır. Yazarlar 40 LSTM node'unu kaynak gereksinimleriyle denge kurmak amacıyla seçtiklerini belirtmektedir.
Çalışmanın Yöntemi ve Bulguları
Deneysel görev: genomik taksonomik sınıflandırma
Açıklanan Explanandum modeli, daha önce taksonomik DNA sınıflandırması için fine-tune edilmiş Nucleotide Transformer 50 million parameter model, yani NT50m'dir. Sınıflandırma üç hiyerarşik seviyede gerçekleştirilir:
- superkingdom: 4 sınıf,
- phylum: 55 sınıf,
- genus: 1878 olası sınıf.
NT50m'nin transformer gizli boyutu 512'dir. Token düzeyindeki gizli durumlar mean pooling ile sabit uzunlukta 512 boyutlu temsile dönüştürülür ve üç ayrı doğrusal sınıflandırma başlığı superkingdom, phylum ve genus logitlerini üretir. Explanandum kaybı üç taksonomik seviyenin cross-entropy kayıplarının toplamıdır.
Veri seti
İşleme sonrasında kaynak toplam 5.181.880 DNA dizisi raporlamaktadır.
| Superkingdom | Dizi sayısı |
|---|---|
| Eukaryota | 2.601.890 |
| Bacteria | 1.828.018 |
| Archaea | 524.276 |
| Viruses | 227.696 |
| Toplam | 5.181.880 |
Her dizi 1500 base-pair uzunluğundadır. NT50m'nin 6-mer tokenizasyonu nedeniyle her giriş yaklaşık 250 tokendan oluşur; bu uzunluk modelin 1000 tokenlık maksimum giriş uzunluğunun altındadır.
Kaynak içi terminoloji notu: Yöntem bölümünde 6-mer açıklaması bir noktada “six amino acids grouped together” biçiminde yazılmıştır; ancak çalışma DNA dizileriyle ilgilidir, örnek `ACTGCC` nükleotid karakterlerinden oluşur ve Şekil 5 açıklaması her altı base-pair grubunu bir token olarak tanımlar. Verianla bu ifadeyi sessizce kaynak metninin düzeltilmiş haliymiş gibi sunmamaktadır.
Kaynak ayrıca 1573 “unique taxonomy IDs”, 55 phyla ve 1878 genera bildirmektedir. 1573 taxonomy ID ile 1878 genus sayısının nasıl bağdaştırılması gerektiği metinde açıklanmadığından bu sayıların ilişkisi hakkında ek varsayım yapılmamıştır.
Eğitim, doğrulama ve test ayrımı
Scikit-learn `train_test_split` işlemi seed 42 ile uygulanmıştır. Kaynak tam veri setinin %2'sini, yani 103.648 diziyi, bütün deneysel çalıştırmalar için kullanılacak hold-out test kümesi olarak ayırmaktadır. Tam verinin ayrıca %10'u eğitim süresince validation loss'u izlemek için ayrılmıştır.
Explanandum kalan veriler üzerinde eğitilirken Explainer için bütün eğitim verisi kullanılmamıştır. Explainer, eğitim kümesinden rastgele seçilen 239.391 örnek üzerinde eğitilmiş; kaynak bunun eğitim kümesinin yaklaşık %4,7'sine karşılık geldiğini ve tam veriyle eğitime gerek bırakmayacak sonuçlar verdiğini belirtmiştir.
Eğitim donanımı ve hiperparametreler
| Öğe | Değer |
|---|---|
| GPU | NVIDIA H100, 80 GB VRAM |
| Python | 3.11.6 |
| PyTorch | 2.5.1 |
| Learning rate | 0,0002 |
| Learning-rate scheduler | Cosine |
| Explanandum epoch | 5 |
| Explanandum batch size | 128 |
| Explainer planlanan epoch | 50 |
| Explainer gerçekleşen epoch | 38; early stopping |
| Explainer batch size | 48 |
| Precision | FP32 |
| Weight decay | 0 |
| Warm-up | Yok |
| Random seed | 42 |
| LIME uygulaması | Captum 0.7.0 |
| Scikit-learn | 1.6.1 |
Maskelerin Gerçekten Önemli Token Bölgelerini Koruduğu Nasıl Test Edildi?
Çalışma maskelerin doğruluğunu, önemli kabul edilen tokenları açık bırakan maskeli girişlerle bunun tersini yapan inverted-mask girişlerinin sınıflandırma başarımını karşılaştırarak test etti; maskeli girişlerde başarı büyük ölçüde korunurken önemli bölgeler gizlendiğinde üç taksonomik seviyede de dengeli doğruluk keskin biçimde düştü.
| Koşul | Superkingdom | Phylum | Genus |
|---|---|---|---|
| Explanandum, maskesiz | %99,05 | %97,39 | %71,67 |
| Sürekli maskeler | %98,39 | %95,51 | %69,88 |
| Ters maskeler | %46,70 | %28,21 | %5,71 |
| Yuvarlanmış maskeler | %76,42 | %52,60 | %40,86 |
| Ters yuvarlanmış maskeler | %44,85 | %26,20 | %4,92 |
| Ortalama ilgili parça | %69,98 | %49,92 | %36,32 |
| Ortalama ilgisiz parça | %47,13 | %31,68 | %9,58 |
Bu tablo iki ayrı kanıt sunmaktadır. Birincisi, sürekli maskeler uygulandığında maskesiz Explanandum'a kıyasla sınıflandırma başarısı yalnız sınırlı ölçüde düşmektedir. İkincisi, maskelerin ters çevrilmesiyle Explainer'ın önemli gördüğü bölümler ortadan kaldırıldığında performans özellikle genus seviyesinde %69,88'den %5,71'e kadar inmektedir.
Kaynak içi sayı notu: Tablo 1 maskesiz genus doğruluğunu %71,67 verirken hemen önceki ve sonraki anlatım metni %71,65 değerini kullanmaktadır. Tablo burada kaynaktaki biçimiyle %71,67 olarak aktarılmış, fark ayrıca görünür bırakılmıştır.
Yuvarlanmış maskeler neden ayrıca test edildi?
Sürekli maskeler 0 ile 1 arasında değişir. Araştırmacılar açıklamayı daha keskin hale getirmek için değerleri 0 veya 1'e yuvarlayarak ikili maskeler de test etmiştir. Yuvarlama bilgi kaybına neden olduğu için doğruluk sürekli maskelere göre düşse de ters yuvarlanmış maskelere kıyasla belirgin biçimde yüksek kalmaktadır. Yazarlar bunu, önemli bölgelerin kaba ikili maskeleme altında bile anlamlı sınıflandırma bilgisi taşıdığı yönünde yorumlamaktadır.
İlgili ve ilgisiz parçaların ayrı sınıflandırılması
Maskelenmiş boşlukların model üzerinde istemeden sınıflandırma ipucu yaratıp yaratmadığını sınamak için yuvarlanmış maskeler ardışık açık ve kapalı parçalara bölünmüştür. Her parça tek başına Explanandum'a verilmiştir. İlgili parçalar superkingdom, phylum ve genus için sırasıyla %69,98, %49,92 ve %36,32 dengeli doğruluk üretirken ilgisiz parçalar %47,13, %31,68 ve %9,58 vermiştir.
Bu sonuç, sınıflandırmanın yalnız maskelenmiş dizideki boşlukların geometrisinden kaynaklanmadığı ve Explainer'ın açık bıraktığı gerçek dizi parçalarının daha fazla taksonomik bilgi taşıdığı yönündeki yorumu desteklemektedir.
Maskeler dizinin ne kadarını açık bırakıyor?
Test kümesi genelinde maske değerlerinin ortalaması 0,73 olarak verilmiştir ve bütün token maske değerlerinin %67,28'i 0,5'in üzerindedir. Şekil 6A bu dağılımı histogram olarak, Şekil 6B ise token konumuna göre ortalama maske değerini göstermektedir. Kaynak, dizinin başında ve ortasında tekrar eden yüksek-önem bölgelerinin gözlendiğini, fakat minimum ve maksimum değerlerin örnekler arasında geniş değişim gösterdiğini belirtmektedir.
Yuvarlanmış maskelerde açık bölgelerin sayısı ortalama 3,35 parçadır. Dizilerin yaklaşık %90'ında dört veya daha az açık parça vardır. Kaynak ayrıca yalnız %0,4'lük bölümde hiç maskelenmiş token bulunmadığını bildirir.
Ortalama açık bölüm uzunluğu 51,39 token olarak raporlanmıştır; bazı açık bölümler 200 tokenı aşmaktadır. 250 tokenlık tipik dizi uzunluğuyla karşılaştırıldığında yazarlar bunun yaklaşık %20'lik bir bölüm olduğunu belirtmektedir. Böylece açıklama bütün diziyi işaretlemek yerine orta uzunlukta birkaç devamlı bölge oluşturmaktadır.
LIME ile çalışma zamanı ve yorumlanabilirlik karşılaştırması
Kaynak, NT50m'nin Evolutionary Scale Modeling tabanlı yapısının serializasyon özellikleri nedeniyle LIME, transformer-interpret ve SHAP Python paketlerini uygulamanın zor olduğunu belirtir. Tam uygulanan karşılaştırmalı yöntem LIME'dır.
LIME'ın ortalama çalışma süresi kaynakta her dizi ve her taksonomik seviye için yaklaşık 26 saniye olarak verilmiştir. Yazarlar bu sürenin bütün test kümesine seri uygulanması durumunda aylar gerektirebileceğini belirtmektedir.
Önerilen Explainer'ın eğitimi 15 saat 40 dakika sürmüş; eğitilmiş Explainer'ın test kümesi için maskeleri üretmesi yaklaşık 20 dakika almıştır. Bu karşılaştırmada iki yöntem aynı maliyet yapısına sahip değildir: Explainer bir kez eğitilerek sonraki girdilerde doğrudan maske üretirken LIME açıklama üretiminde her örnek için tekrar perturbation işlemleri yapmaktadır.
Kaynak içi sayı notu: veri bölümü test kümesini 103.648 dizi olarak verirken LIME çalışma zamanı bölümünde 103.638 dizi yazılmıştır. Verianla bu on dizilik farkı kaynağın hangi sayıyı kastettiğini tahmin ederek düzeltmemiştir.
Şekil 8'de LIME'ın tek örnek üzerindeki pozitif ve negatif önem değerleri, dizinin farklı bölgelerine yayılmış çok sayıda renkli token olarak görünmektedir. Yazarlar, yalnız pozitif veya 0,5'in üzerindeki pozitif katkılar gösterildiğinde bile işaretlerin birbirinden uzak kalmasını yorumlanabilirlik açısından sorun olarak değerlendirir. Buna karşılık Explainer maskeleri daha sürekli bölgeler oluşturacak şekilde tasarlanmıştır.
Bu Yöntem Doğal Dil Metni Üzerinde Doğrudan Doğrulandı mı?
Hayır. Çalışma yöntemi token tabanlı girdilere ve metne genellenebilecek bir XAI yaklaşımı olarak formüle etmektedir, ancak yayımlanan deneysel doğrulama NT50m ile DNA/nükleotid dizilerinin taksonomik sınıflandırılması üzerinde yapılmıştır; doğal dil sınıflandırması çalışmanın gelecek araştırma alanlarından biridir.
Bu ayrım önemlidir. DNA 6-mer'ları ve doğal dil tokenları ikisi de ayrık token dizileri olsa da semantik yapıları, sözlükleri, bağlam ilişkileri, model eğitim hedefleri ve insanın açıklamayı değerlendirme biçimi aynı değildir. Kaynak, bu farkları karşılaştıran doğal dil deneyleri sunmamaktadır.
Benzer biçimde çalışma, üretilen maskelerin “human-readable” olmasını mimarinin süreklilik özelliği ve örnek görseller üzerinden savunmaktadır; ancak açıklamaların insanlar tarafından daha doğru, daha hızlı veya daha güvenilir anlaşıldığını ölçen kontrollü kullanıcı deneyi yapılmamıştır. Bu nedenle “insanlar için daha yorumlanabilir olduğu klinik veya psikometrik olarak kanıtlandı” biçiminde bir sonuç çıkarılamaz.
Çalışmanın desteklediği sonuçlar
Çalışma, embedding düzeyinde sürekli maskeler öğrenen Explainer'ın NT50m genomik sınıflandırıcısı için sınıflandırma bilgisini koruyan devamlı token bölgeleri üretebildiğini desteklemektedir. Maskeli dizilerde yüksek doğruluğun korunması ve ters maskelerde doğruluğun keskin biçimde düşmesi, maskelerin sınıflandırma açısından bilgi taşıyan bölgelerle ilişkili olduğunu göstermektedir.
Çalışma ayrıca hesaplama maliyetinin açıklama anından Explainer eğitimi aşamasına taşınmasının, çok büyük test kümeleri üzerinde tekrar tekrar açıklama üretirken avantaj sağlayabileceğini gösteren uygulamalı bir örnek sunmaktadır.
Çalışmanın desteklemediği sonuçlar
Çalışma, yöntemin bütün doğal dil görevlerinde SHAP veya LIME'dan daha doğru açıklama ürettiğini göstermez. Doğal dil veri seti üzerinde nicel değerlendirme yapılmamıştır ve LIME dışındaki başlıca XAI yöntemleriyle eksiksiz ölçekli benchmark sunulmamıştır.
Yöntemin bütün transformer, recurrent veya başka token sınıflandırıcı mimarilerinde aynı performansı vereceği deneysel olarak kanıtlanmamıştır. Yazarlar mimari olarak genel uygulanabilirlik ileri sürse de yayımlanan deney NT50m üzerinde yoğunlaşmaktadır ve mean-pooling mimarisinin özel olarak ikinci maskeleme gerektirdiği gösterilmiştir.
Ayrıca maskeler sınıflandırıcı için önemli özellik bölgelerini işaretlemektedir; bunların biyolojik olarak nedensel motifler, fonksiyonel genomik bölgeler veya gerçek biyolojik mekanizmalar olduğu bu deneyden çıkarılamaz. Model atfı ile biyolojik nedensellik birbirinden ayrılmalıdır.
Kaynak ve Yöntem Notu
Özgün çalışma: What You Read Is What You Classify: Highlighting Attributions to Text and Text-like Inputs
Yazarlar: Daniel S. Berman; Brian Merritt; Stanley Ta; Dana Udwin; Amanda Ernlund; Jeremy Ratcliff; Vijay Narayan.
Sorumlu yazar: Vijay Narayan.
Kurumlar: Johns Hopkins Applied Physics Laboratory, Laurel, Maryland, ABD; Google DeepMind, Londra, Birleşik Krallık.
Dergi: AI.
Yayınevi: MDPI.
Kaynak türü: Özgün araştırma makalesi; açıklanabilir yapay zekâ ve makine öğrenmesi yöntem geliştirme/hesaplamalı deney çalışması.
Yayın bilgisi: AI 2026, cilt 7, sayı 5, makale 168.
DOI: 10.3390/ai7050168
Gönderim: 25 Mart 2026.
Revizyon: 20 Nisan 2026.
Kabul: 23 Nisan 2026.
Yayın: 13 Mayıs 2026.
Preprint: arXiv:2602.24149. Bu kayıt yayımlanmış çalışmanın önceki sürümüdür; ayrı bağımsız araştırma olarak değerlendirilmemiştir.
Hakemlik: Hakemli bilimsel dergide yayımlanmış makale.
Lisans: Creative Commons Attribution (CC BY), açık erişim.
Finansman: Çalışma, U.S. Centers for Disease Control and Prevention, Office of Readiness and Response tarafından Contract #75D30124C20202 kapsamında desteklenmiştir.
Kurumsal etik kurul: Uygulanabilir değil.
Bilgilendirilmiş onam: Uygulanabilir değil.
Veri erişilebilirliği: Çalışmada kullanılan temel veri, Mock ve arkadaşlarının açık erişimli çalışmasının ek materyalinde bulunmaktadır. Yazarlar ayrıca veri bölme, Explainer ve Explanandum eğitimi ve inference için kullanılan kodun açık bir GitHub deposunda yayımlandığını belirtmektedir.
Teşekkür: Yazarlar Molly Gallagher'a çalışmanın tamamlanması sırasında yaptığı katkılar ve programatik engellerin aşılmasına yardımı için teşekkür etmektedir.
Çıkar çatışması: Jeremy Ratcliff çalışmaya katkı verdiği sırada Johns Hopkins Applied Physics Laboratory çalışanıydı. Diğer yazarlar potansiyel ticari veya finansal çıkar çatışması oluşturabilecek ilişki bulunmadığını bildirmiştir.
Yazar katkıları: Kavramsallaştırma Daniel S. Berman, Dana Udwin ve Amanda Ernlund; metodoloji Daniel S. Berman ve Amanda Ernlund; yazılım Daniel S. Berman ve Vijay Narayan; doğrulama, formal analiz ve araştırma Daniel S. Berman; kaynaklar Brian Merritt; veri kürasyonu Brian Merritt, Stanley Ta ve Daniel S. Berman; ilk taslak Daniel S. Berman, Brian Merritt, Stanley Ta ve Vijay Narayan; gözden geçirme ve düzenleme Daniel S. Berman, Brian Merritt, Stanley Ta, Dana Udwin, Amanda Ernlund ve Vijay Narayan; görselleştirme Daniel S. Berman; denetim, proje yönetimi ve finansman edinimi Jeremy Ratcliff ve Vijay Narayan tarafından yürütülmüştür.
Temel yöntemsel sınırlar: Deneysel doğrulama genomik token dizileriyle sınırlıdır; doğal dil metni doğrudan test edilmemiştir. Explainer mimarisi için hiperparametre araması yapılmamıştır. Deney tek ana Explanandum mimarisi NT50m üzerinde yoğunlaşmaktadır. İnsan katılımcılarla yorumlanabilirlik çalışması yapılmamıştır. LIME karşılaştırması çalışma süresi ve örnek görseller bakımından sunulmuş olsa da bütün çağdaş XAI yöntemlerinin ortak ölçütlerle karşılaştırıldığı kapsamlı benchmark değildir.
Kaynak içi tutarsızlık notu: Kaynakta 6-mer için “six amino acids” ifadesi DNA bağlamıyla uyuşmamaktadır; genus maskesiz dengeli doğruluğu metinde %71,65 ve Tablo 1'de %71,67 olarak geçmektedir; test seti veri bölümünde 103.648, LIME çalışma süresi bölümünde 103.638 olarak yazılmıştır; ayrıca 1573 unique taxonomy ID ve 1878 genus sayıları arasındaki ilişki açıklanmamıştır. Bu noktalar Verianla tarafından sessizce düzeltilmemiştir.
Verianla yöntem notu: Bu içerik kaynak makalenin satır satır çevirisi değildir. Araştırma problemi, Explainer–Explanandum yapısı, embedding düzeyinde Hadamard maskelemesi, kayıp fonksiyonları, NT50m mimarisi, veri seti, eğitim koşulları, Tablo 1 sonuçları ve Şekil 1–8'in bilimsel mesajları korunarak bağımsız ve öğretici bir Türkçe yapı oluşturulmuştur. Kaynakta bulunmayan deney sonucu veya performans değeri eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir