

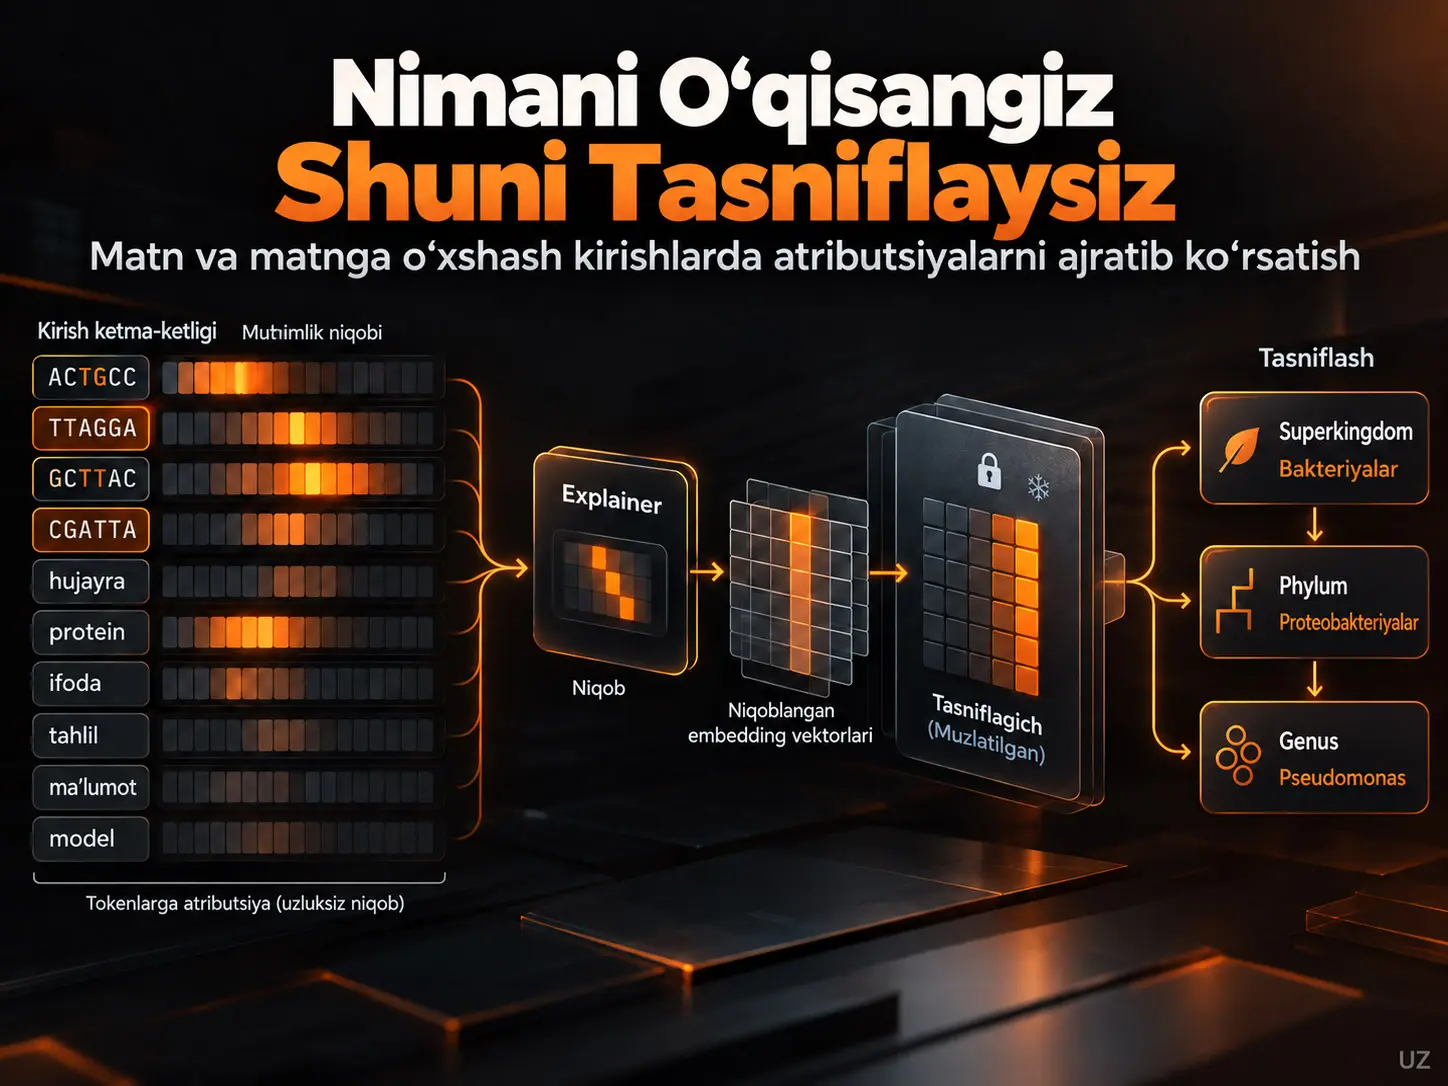
Ushbu tadqiqotda ishlab chiqilgan Explainer–Explanandum asosidagi tushuntiriladigan sun’iy intellekt usuli, token ketma-ketliklarini tasniflaydigan sun’iy intellekt modelining qarorida qaysi ketma-ket token hududlari muhim ekanini uzluksiz qiymatli niqoblar bilan aniqlashni maqsad qiluvchi XAI yondashuvidir. Usul niqobni diskret token identifikatorlariga toʻgʻridan-toʻgʻri qoʻllash oʻrniga tokenlarning uzluksiz embedding vektorlariga Hadamard koʻpaytmasi orqali qoʻllaydi; shu tariqa embedding vektorining yoʻnalishi saqlanib, kattaligi kamaytiriladi. Tadqiqotchilar usulni 50 million parametrli Nucleotide Transformer modeli NT50m yordamida DNA ketma-ketliklarini superkingdom, phylum va genus darajalarida taksonomik tasniflashda sinab koʻrgan. Natijalar muhim deb topilgan hududlar ochiq qoldirilganda tasniflash samaradorligi katta darajada saqlanishini, ayni hududlar yashirilganda esa samaradorlik jiddiy pasayishini koʻrsatadi. Biroq tajriba tabiiy til matni ustida emas, genomik token ketma-ketliklari ustida oʻtkazilgan; shu sabab tabiiy tilga umumlashtirish ushbu tadqiqotning tajribaviy tasdiqlangan natijasi emas.
Asosiy tasniflagich boʻlgan Explanandumning muvozanatlangan aniqligi superkingdom, phylum va genus uchun 1-jadvalda mos ravishda %99,05, %97,39 va %71,67 deb hisobot qilingan. Explainer hosil qilgan uzluksiz niqoblar qoʻllanganda bu qiymatlar %98,39, %95,51 va %69,88 darajasida saqlangan. Niqoblar teskarilanganda, ya’ni Explainer muhim deb topgan hududlar yashirilib, muhim boʻlmagan hududlar ochiq qoldirilganda muvozanatlangan aniqlik mos ravishda %46,70, %28,21 va %5,71 gacha tushgan. Bu qarama-qarshilik niqoblar tasniflashga haqiqatan hissa qoʻshadigan axborot hududlarini ajrata olishiga oid tadqiqotning asosiy tajribaviy dalilidir.
Usulning maqsadi alohida-alohida va bir-biridan uzilgan token muhimlik ballarini ishlab chiqarish oʻrniga yanada uzluksiz tushuntirish hududlarini hosil qilishdir. Yaxlitlangan niqoblardan olingan ochiq hududlarda boʻlaklarning oʻrtacha soni 3,35 ni tashkil etadi; ketma-ketliklarning qariyb %90 ida toʻrtta yoki undan kam ochiq boʻlak mavjud. Ochiq boʻlakning oʻrtacha uzunligi 51,39 token boʻlib, 250 tokenlik odatiy kirishning taxminan beshdan biriga teng. Shunday qilib, tushuntirish butun ketma-ketlikni muhim deb belgilash oʻrniga oʻrtacha uzunlikdagi bir nechta ketma-ket hududga jamlanadi.
Tadqiqot ish vaqti nuqtai nazaridan LIME bilan amaliy taqqoslashni ham taqdim etadi. Manbada LIME har bir ketma-ketlik va har bir taksonomik daraja uchun oʻrtacha 26 soniya olishi bildirilgan, Explainerning oʻqitilishi esa 15 soat 40 daqiqa davom etgan va oʻqitilgan Explainer test toʻplamining niqoblarini taxminan 20 daqiqada yaratgan. Bu yerda asosiy arxitektura farqi shundaki, LIME kabi perturbation asosidagi usullar hisoblash yukining katta qismini tushuntirish yaratish paytida koʻtaradi, ushbu usul esa xarajatning muhim qismini Explainer oʻqitilishi vaqtida oldindan toʻlaydi.
Token Asosidagi Tushuntiriladigan Sun’iy Intellektdagi Asosiy Muammo Nima?
Token asosidagi tushuntiriladigan sun’iy intellektdagi asosiy muammo — matn yoki biologik ketma-ketlik kabi diskret kirishlarda tokenni qisman niqoblab boʻlmasligi va kuchli transformer tasniflagichlarining qarorlari ham mahalliy, ham uzoq token oʻzaro ta’sirlariga tayanishi mumkinligidir; shu sabab tasvirlarda tabiiy ishlaydigan uzluksiz piksel niqoblarini tokenlarga toʻgʻridan-toʻgʻri koʻchirib boʻlmaydi.
Tasvir tasnifida piksel intensivligi uzluksiz son hisoblanadi. Masalan, tasvirning bir hududini 0,25 ga koʻpaytirish oʻsha hududning vizual ta’sirini kamaytiradi va amal differensiallanuvchi boʻlib qoladi. Bunga qarshi ravishda token identifikatori kategorikdir. Bir soʻz yoki DNA 6-merini “0,25 token”ga aylantirish haqiqiy tokenizatsiya amali emas.
Matn tushuntirishlarida keng qoʻllaniladigan SHAP va Local Interpretable Model-Agnostic Explanations (LIME) kabi perturbation asosidagi usullar kirish xususiyatlarini oʻzgartirib, ularning chiqishga ta’sirini baholaydi. Manba mualliflariga koʻra, tokenlarni koʻpincha bittalab koʻrib chiqadigan bu yondashuv uzun ketma-ketliklarda muhim hududlarni bir-biridan uzilgan tokenlar koʻrinishida koʻrsatishi va yaxlit holda oʻqish qiyin boʻlgan muhimlik xaritasini yaratishi mumkin.
Rationalization usullari esa tasniflash qarorini tushuntirish uchun kirishning tegishli qismlarini tanlashi yoki tushuntiruvchi matn yaratishi mumkin. Biroq manba ayrim generativ rationalization yondashuvlarida tushuntirishning kirishga sodiq qolmasligi yoki hallucination hosil qilishi xavfiga, ayrim nazoratli tanlash yondashuvlarida esa oʻqitish murakkabligiga e’tibor qaratadi.
Explainer va Explanandum rollari
Usul ikki model rolini ajratadi. Explanandum — tushuntirilishi kerak boʻlgan va vaznlari muzlatilgan mavjud tasniflagich. Explainer esa har bir kirish tokeni va har bir sinf uchun 0 dan 1 gacha niqob qiymatini hosil qilishga oʻrgatiladigan ikkinchi neyron tarmoqdir.
Bir sinf uchun hosil qilingan niqob \(s_c\) bilan belgilanadi. Haqiqiy nishonga tegishli sinflarning niqoblari element-wise maksimum amali bilan birlashtirilib, nishon niqobi \(m\) hosil qilinadi. Nishon boʻlmagan sinflarning niqoblaridan ham non-target niqob \(n\) tuziladi. Nishon niqobining teskarisi:
\[ \widetilde{m}=1-m \]
koʻrinishidadir. Ushbu toʻldiruvchi niqob, ayniqsa, “muhim deb topilgan axborotni olib tashlasak, tasniflagichning ishonchi haqiqatan ham buziladimi?” savolini tekshirishda qoʻllanadi.
Manba 1-rasm nimani koʻrsatadi?
Manbaning 1A-rasm paneli tasvirlar uchun qoʻllanilgan dastlabki “what-you-see” yondashuvida Explainer bevosita tasvir oʻlchamida niqoblar hosil qilishini koʻrsatadi. 1B-rasm esa maqolaning asosiy hissasini taqdim etadi: token ketma-ketligi avval Explainerga uzatiladi, izohlanayotgan Explanandum esa tokenlarni qayta ishlash va embedding qismiga hamda undan keyingi yashirin/tasniflash qatlamlariga ajratiladi. Niqoblar tokenlarning oʻziga emas, uzluksiz embedding tasvirlariga ta’sir qiladi.
Ushbu Tadqiqotda Niqob Tokenlarga Qanday Qoʻllanadi?
Niqob token identifikatorini oʻzgartirish oʻrniga har bir tokenning embedding vektoriga qoʻllanadi; uzunligi \(d\) boʻlgan niqob vektori embedding oʻlchami \(h\) boʻylab takrorlanib, \(d\times h\) oʻlchamiga kengaytiriladi va embedding matritsasi bilan Hadamard, ya’ni element-wise koʻpaytma bajariladi.
Agar tokenning embedding vektori \(e\), uning niqob qiymati esa \(m_i\) boʻlsa, amalni konseptual ravishda:
\[ e_{\text{masked}}=m_i e \]
koʻrinishida tasavvur qilish mumkin. Bir xil skalyar qiymat embeddingning barcha tarkibiy qismlariga qoʻllanilgani uchun \(0<m_i<1\) boʻlganda vektorning kattaligi kamayadi, biroq embedding fazosidagi yoʻnalishi oʻzgarmaydi. Manbaning 2-rasmida 0,25 niqob qiymati bilan “apple” embedding vektorining bir xil yoʻnalishda, ammo qisqaroq boʻlishi ushbu mexanizmni tasvirlaydi.
Bu tanlov ikki muammoni bir vaqtning oʻzida hal qiladi. Birinchidan, diskret tokenlarga kasr niqob qoʻllash zaruratini bartaraf etadi. Ikkinchidan, uzluksiz koʻpaytirish amali tufayli Explainerdan Explanandum orqali yoʻqotish funksiyasigacha boʻlgan yoʻl differensiallanuvchi boʻlib qoladi; shunday qilib Explanandum muzlatilgan holda faqat Explainer vaznlarini oʻqitish mumkin.
Mean pooling ishlatilganda nega ikkinchi niqoblash kerak?
Mualliflar usulni qoʻllash uchun muhim shartni belgilaydi: boʻsh ketma-ketlik yoki toʻliq niqoblangan ketma-ketlikning tasniflagich softmax chiqishi taxminan uniform boʻlishi kutiladi. Biroq NT50mda barcha token yashirin holatlari ustida mean pooling ishlatilganda toʻliq niqoblangan kirish buni avtomatik ta’minlamagan.
Shu sabab NT50m tajribasida niqob faqat embedding qatlamidan keyin emas, transformer yashirin qatlamlarining chiqishiga ham mean poolingdan oldin qayta qoʻllangan. Manbaning 3-rasmi CLS token chiqishidan foydalanadigan tasniflagich bilan mean-pooling tasniflagichi oʻrtasidagi ushbu farqni koʻrsatadi. Mualliflar tasniflash faqat CLS chiqishiga tayansa, ikkinchi niqoblash zarur emasligini aytadi.
Yoʻqotish funksiyasining umumiy tuzilishi
Tasvirlar uchun qoʻllaniladigan ikki oʻlchamli niqob yoʻqotishi token ketma-ketliklari uchun bir oʻlchamga tushirilgan. Umumiy Explainer yoʻqotishi manbada Tenglama (1) sifatida:
\[ L_E(x,Y,S,m,n) = L_c(x,Y,m) + \lambda_e L_e(x,\widetilde m) + \lambda_a L_a(m,n,S) + \lambda_{tv}L_{tv}(m,n) \]
koʻrinishida beriladi. Tajribalarda:
\[ \lambda_e=\lambda_a=\lambda_{tv}=1 \]
ishlatilgan. Ushbu koeffitsiyentlar alohida giperparametr qidiruvi bilan optimallashtirilmagan, manba sifatida olingan Stalder va hamkasblari tadqiqotidagi qiymatlarga asoslanib tanlangan.
Tushuntiruvchi Tarmoqning Yoʻqotish Funksiyasi Nimani Muvozanatlashtiradi?
Umumiy yoʻqotish nishon tasniflash axborotini ochiq saqlash, muhim axborot yashirilganda tasniflagichni noaniq holga keltirish, niqobning na hamma narsani, na hech narsani koʻrsatishiga yoʻl qoʻymaslik va muhim tokenlarning bir-biridan uzilgan nuqtalar oʻrniga mahalliy ravishda yanada uzluksiz hududlar hosil qilishini ragʻbatlantirish uchun toʻrtta komponentni birgalikda muvozanatlashtiradi.
1. Tasniflash yoʻqotishi \(L_c\)
Manba koʻp sinfli tasniflash uchun standart cross-entropy asosidagi hadni:
\[ L_c(x,Y,m) = -\frac{1}{C} \sum_{c=1}^{C} \left[ \llbracket c\in Y\rrbracket\log p[c] + \llbracket c\notin Y\rrbracket\log(1-p[c]) \right] \]
koʻrinishida beradi. Bu yerda \(C\) sinflar sonini, \(p[c]\) sinf \(c\) uchun bashorat ehtimolini, Iverson qavsi \(\llbracket\cdot\rrbracket\) esa shart rost boʻlsa 1, aks holda 0 qiymatini ifodalaydi. Ushbu had nishon niqobining tasniflash uchun zarur axborotni ochiq qoldirishini ragʻbatlantiradi.
2. Toʻldiruvchi niqob entropiyasi \(L_e\)
Manba Tenglama (3) da:
\[ L_e = \frac{1}{C} \sum_{c=1}^{C} F(x\odot\widetilde m)[c] \log F(x\odot\widetilde m)[c] \]
ifodasidan foydalanadi. \(F(\cdot)\) Explanandumning sinf ehtimollarini hosil qiladi. Toʻldiruvchi niqob qoʻllanganda faqat kam muhim deb baholangan axborot ochiq qoladi. Bu holatda chiqish ehtimollarining imkon qadar uniform boʻlishi, muhim axborot olib tashlanganda modelning mazmunli tasniflay olmasligini ragʻbatlantiradi.
3. Niqob maydoni yoʻqotishi \(L_a\)
Faqat tasniflash va entropiya hadlari ishlatilsa, bir had niqobni hamma narsani koʻrsatishga, boshqasi esa haddan tashqari yashirishga undashi mumkin. Maydon yoʻqotishi ushbu ikki chekka holat oʻrtasida muvozanat oʻrnatadi:
\[ L_a(m,n,S) = A(m)+A(n) + \frac{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket B(s_c) }{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket }. \]
\(A(m)\) nishon niqobining oʻrtacha qiymatini, \(A(n)\) esa nishon boʻlmagan niqobning oʻrtacha qiymatini anglatadi. Manba koʻrinadigan niqob maydoni uchun \(0<a<b<1\) boʻladigan tarzda minimal \(a\) va maksimal \(b\) ulushlarni belgilaydi.
Tartiblangan niqob qiymatlari uchun chegara jazosi Tenglama (5) da:
\[ B(s) = \frac{1}{Z} \sum_i \max(q_{\min}[i]-q_{\text{mask}}[i],0) + \frac{1}{Z} \sum_i \max(q_{\text{mask}}[i]-q_{\max}[i],0) \]
koʻrinishida ta’riflanadi. \(Z\) ketma-ketlik uzunligidir. Niqob maydoni \(a\) dan kichik yoki \(b\) dan katta boʻlganda jazo yuzaga keladi; shu tariqa tushuntirishning haddan tashqari kichik yoki haddan tashqari keng boʻlishiga yoʻl qoʻymaslikka harakat qilinadi.
4. Umumiy variatsiya yoʻqotishi \(L_{tv}\)
Mahalliy uzluksizlikni ragʻbatlantiruvchi Tenglama (6):
\[ L_{tv} = \frac{1}{Z} \sum_i |m[i]-m[i+1]| + \frac{1}{Z} \sum_i |n[i]-n[i+1]|. \]
Qoʻshni tokenlarning niqob qiymatlari katta sakrashlar qilganda ushbu had kattalashadi. Natijada Explainer faqat alohida tarqoq tokenlarni belgilash oʻrniga qoʻshni tokenlar birgalikda muhim boʻlgan yanada uzluksiz hududlarni hosil qilishga yoʻnaltiriladi. Ushbu uzluksizlik tadqiqotning “inson tomonidan oʻqiladigan tushuntirish” maqsadining asosiy dizayn elementlaridan biridir.
Explainer arxitekturasi
Explainer kirishi NT50m bilan bir xil 4107 elementli lugʻatdan foydalanadigan va oʻlchami 100 boʻlgan embedding qatlamidir. Undan keyin ikki qatlamli ikki yoʻnalishli Long Short-Term Memory (LSTM) tarmogʻi keladi. Manba har bir yoʻnalishda ishlatiladigan tuzilma uchun 40 node tanlanganini va oldinga/orqaga memory-cell holatlarini birlashtirish orqali har bir token uchun 160 oʻlchamli tasvir hosil qilinishini bildiradi.
LSTM chiqishidan keyin Batch Normalization va sigmoid aktivatsiyali dense qatlam keladi. Sinflar soni \(c\), ketma-ketlik uzunligi \(d\) boʻlganda Explainerning yakuniy chiqishi:
\[ d\times c \]
oʻlchamli niqob matritsasidir va har bir token-sinf juftligi uchun 0–1 oraligʻida muhimlik qiymati hosil qiladi. Explainer arxitekturasi uchun giperparametr qidiruvi oʻtkazilmagan. Mualliflar 40 LSTM node ni resurs talablarini muvozanatlashtirish maqsadida tanlaganini bildiradi.
Tadqiqot Usuli va Natijalari
Tajribaviy vazifa: genomik taksonomik tasniflash
Tushuntirilayotgan Explanandum modeli avval taksonomik DNA tasnifi uchun fine-tune qilingan Nucleotide Transformer 50 million parameter model, ya’ni NT50mdir. Tasniflash uch ierarxik darajada amalga oshiriladi:
- superkingdom: 4 sinf,
- phylum: 55 sinf,
- genus: 1878 mumkin boʻlgan sinf.
NT50mning transformer yashirin oʻlchami 512 dir. Token darajasidagi yashirin holatlar mean pooling orqali sobit uzunlikdagi 512 oʻlchamli tasvirga aylantiriladi va uchta alohida chiziqli tasniflash boshi superkingdom, phylum va genus logitlarini hosil qiladi. Explanandum yoʻqotishi uch taksonomik darajadagi cross-entropy yoʻqotishlarining yigʻindisidir.
Ma’lumotlar toʻplami
Qayta ishlashdan soʻng manba jami 5.181.880 DNA ketma-ketligini hisobot qiladi.
| Superkingdom | Ketma-ketliklar soni |
|---|---|
| Eukaryota | 2.601.890 |
| Bacteria | 1.828.018 |
| Archaea | 524.276 |
| Viruses | 227.696 |
| Jami | 5.181.880 |
Har bir ketma-ketlik 1500 base-pair uzunlikka ega. NT50mning 6-mer tokenizatsiyasi sabab har bir kirish taxminan 250 tokendan iborat; bu uzunlik modelning maksimal 1000 tokenlik kirish uzunligidan past.
Manba ichidagi terminologiya qaydi: Usul boʻlimida 6-mer izohi bir joyda “six amino acids grouped together” shaklida yozilgan; biroq tadqiqot DNA ketma-ketliklariga tegishli, `ACTGCC` namunasi nukleotid belgilaridan iborat va 5-rasm izohi har olti base-pair guruhini bitta token sifatida belgilaydi. Verianla ushbu iborani manba matnining jim tarzda tuzatilgan koʻrinishi sifatida taqdim etmaydi.
Manba shuningdek 1573 “unique taxonomy IDs”, 55 phyla va 1878 genera haqida xabar beradi. 1573 taxonomy ID bilan 1878 genus sonini qanday muvofiqlashtirish kerakligi matnda izohlanmagani sabab bu sonlar oʻrtasidagi munosabat haqida qoʻshimcha taxmin qilinmagan.
Oʻqitish, validatsiya va testga ajratish
Scikit-learn `train_test_split` amali seed 42 bilan qoʻllangan. Manba toʻliq ma’lumotlar toʻplamining %2 ini, ya’ni 103.648 ketma-ketlikni, barcha tajribaviy ishga tushirishlar uchun ishlatiladigan hold-out test toʻplami sifatida ajratadi. Toʻliq ma’lumotlarning yana %10 i oʻqitish davomida validation loss ni kuzatish uchun ajratilgan.
Explanandum qolgan ma’lumotlarda oʻqitilgan boʻlsa-da, Explainer uchun barcha oʻqitish ma’lumotlari ishlatilmagan. Explainer oʻqitish toʻplamidan tasodifiy tanlangan 239.391 misolda oʻqitilgan; manba bu oʻqitish toʻplamining taxminan %4,7 iga tengligini va toʻliq ma’lumot bilan oʻqitishni talab qilmaydigan natijalar berganini bildiradi.
Oʻqitish apparati va giperparametrlar
| Element | Qiymat |
|---|---|
| GPU | NVIDIA H100, 80 GB VRAM |
| Python | 3.11.6 |
| PyTorch | 2.5.1 |
| Learning rate | 0,0002 |
| Learning-rate scheduler | Cosine |
| Explanandum epoch | 5 |
| Explanandum batch size | 128 |
| Explainer rejalashtirilgan epoch | 50 |
| Explainer amaldagi epoch | 38; early stopping |
| Explainer batch size | 48 |
| Precision | FP32 |
| Weight decay | 0 |
| Warm-up | Yoʻq |
| Random seed | 42 |
| LIME qoʻllanmasi | Captum 0.7.0 |
| Scikit-learn | 1.6.1 |
Niqoblar Haqiqatan Muhim Token Hududlarini Saqlashi Qanday Tekshirildi?
Tadqiqot niqoblarning toʻgʻriligini muhim deb topilgan tokenlarni ochiq qoldiradigan niqoblangan kirishlar bilan buning aksini qiluvchi inverted-mask kirishlarining tasniflash samaradorligini taqqoslash orqali tekshirdi; niqoblangan kirishlarda samaradorlik katta darajada saqlanib qolgan boʻlsa, muhim hududlar yashirilganda uchala taksonomik darajada ham muvozanatlangan aniqlik keskin pasaydi.
| Shart | Superkingdom | Phylum | Genus |
|---|---|---|---|
| Explanandum, niqobsiz | %99,05 | %97,39 | %71,67 |
| Uzluksiz niqoblar | %98,39 | %95,51 | %69,88 |
| Teskari niqoblar | %46,70 | %28,21 | %5,71 |
| Yaxlitlangan niqoblar | %76,42 | %52,60 | %40,86 |
| Teskari yaxlitlangan niqoblar | %44,85 | %26,20 | %4,92 |
| Oʻrtacha tegishli boʻlak | %69,98 | %49,92 | %36,32 |
| Oʻrtacha tegishsiz boʻlak | %47,13 | %31,68 | %9,58 |
Ushbu jadval ikki alohida dalilni taqdim etadi. Birinchidan, uzluksiz niqoblar qoʻllanganda niqobsiz Explanandumga nisbatan tasniflash samaradorligi faqat cheklangan darajada pasayadi. Ikkinchidan, niqoblar teskarilanganda Explainer muhim deb topgan qismlar olib tashlanib, samaradorlik ayniqsa genus darajasida %69,88 dan %5,71 gacha tushadi.
Manba ichidagi raqam qaydi: 1-jadval niqobsiz genus aniqligini %71,67 deb koʻrsatsa-da, undan bevosita oldingi va keyingi bayon matni %71,65 qiymatidan foydalanadi. Jadval bu yerda manbadagi koʻrinishida %71,67 sifatida berilgan va farq alohida koʻrinadigan qilib qoldirilgan.
Yaxlitlangan niqoblar nega alohida sinovdan oʻtkazildi?
Uzluksiz niqoblar 0 bilan 1 oraligʻida oʻzgaradi. Tadqiqotchilar tushuntirishni keskinroq qilish uchun qiymatlarni 0 yoki 1 ga yaxlitlab, ikkilik niqoblarni ham sinovdan oʻtkazgan. Yaxlitlash axborot yoʻqotilishiga sabab boʻlgani uchun aniqlik uzluksiz niqoblarga nisbatan pasaysa-da, teskari yaxlitlangan niqoblarga nisbatan sezilarli darajada yuqori boʻlib qoladi. Mualliflar buni muhim hududlar qoʻpol ikkilik niqoblash sharoitida ham mazmunli tasniflash axborotini olib yurishi sifatida talqin qiladi.
Tegishli va tegishsiz boʻlaklarni alohida tasniflash
Niqoblangan boʻshliqlar modelda bilmasdan tasniflash ishorasini hosil qiladimi-yoʻqmi, tekshirish uchun yaxlitlangan niqoblar ketma-ket ochiq va yopiq boʻlaklarga ajratilgan. Har bir boʻlak alohida Explanandumga berilgan. Tegishli boʻlaklar superkingdom, phylum va genus uchun mos ravishda %69,98, %49,92 va %36,32 muvozanatlangan aniqlik hosil qilgan, tegishsiz boʻlaklar esa %47,13, %31,68 va %9,58 ni bergan.
Bu natija tasniflash faqat niqoblangan ketma-ketlikdagi boʻshliqlar geometriyasidan kelib chiqmasligi va Explainer ochiq qoldirgan haqiqiy ketma-ketlik boʻlaklari koʻproq taksonomik axborot olib yurishi haqidagi talqinni qoʻllab-quvvatlaydi.
Niqoblar ketma-ketlikning qancha qismini ochiq qoldiradi?
Test toʻplami boʻyicha niqob qiymatlarining oʻrtachasi 0,73 deb berilgan va barcha token niqob qiymatlarining %67,28 i 0,5 dan yuqori. 6A-rasm bu taqsimotni gistogramma tarzida, 6B-rasm esa token oʻrniga qarab oʻrtacha niqob qiymatini koʻrsatadi. Manba ketma-ketlikning boshida va oʻrtasida takrorlanuvchi yuqori muhimlikdagi hududlar kuzatilganini, biroq minimal va maksimal qiymatlar namunalar oʻrtasida keng oʻzgarishini bildiradi.
Yaxlitlangan niqoblarda ochiq hududlar soni oʻrtacha 3,35 boʻlakni tashkil etadi. Ketma-ketliklarning qariyb %90 ida toʻrtta yoki undan kam ochiq boʻlak mavjud. Manba shuningdek faqat %0,4 qismda umuman niqoblangan token boʻlmaganini bildiradi.
Ochiq boʻlakning oʻrtacha uzunligi 51,39 token deb hisobot qilingan; ayrim ochiq boʻlaklar 200 tokendan oshadi. 250 tokenlik odatiy ketma-ketlik uzunligi bilan taqqoslaganda, mualliflar bu taxminan %20 lik qismga tengligini bildiradi. Shunday qilib, tushuntirish butun ketma-ketlikni belgilash oʻrniga oʻrtacha uzunlikdagi bir nechta uzluksiz hududni hosil qiladi.
LIME bilan ish vaqti va tushuntiriluvchanlik taqqoslanishi
Manba NT50mning Evolutionary Scale Modeling asosidagi tuzilmasining serializatsiya xususiyatlari sabab LIME, transformer-interpret va SHAP Python paketlarini qoʻllash qiyinligini bildiradi. Toʻliq qoʻllanilgan taqqoslama usul LIME dir.
LIMEning oʻrtacha ish vaqti manbada har bir ketma-ketlik va har bir taksonomik daraja uchun taxminan 26 soniya deb berilgan. Mualliflar bu vaqt butun test toʻplamiga ketma-ket qoʻllansa, oylar talab qilishi mumkinligini bildiradi.
Taklif qilingan Explainerning oʻqitilishi 15 soat 40 daqiqa davom etgan; oʻqitilgan Explainer test toʻplami uchun niqoblarni yaratishi taxminan 20 daqiqa olgan. Ushbu taqqoslashda ikki usulning xarajat tuzilishi bir xil emas: Explainer bir marta oʻqitilib, keyingi kirishlar uchun toʻgʻridan-toʻgʻri niqob hosil qiladi, LIME esa tushuntirish yaratish paytida har bir namuna uchun perturbation amallarini takrorlaydi.
Manba ichidagi raqam qaydi: ma’lumotlar boʻlimida test toʻplami 103.648 ketma-ketlik deb berilgan, LIME ish vaqti boʻlimida esa 103.638 ketma-ketlik deb yozilgan. Verianla ushbu oʻn ketma-ketlik farqini manba qaysi sonni nazarda tutganini taxmin qilib tuzatmagan.
8-rasmda LIMEning bitta namuna boʻyicha musbat va manfiy muhimlik qiymatlari ketma-ketlikning turli hududlariga tarqalgan koʻp sonli rangli tokenlar sifatida koʻrinadi. Mualliflar faqat musbat yoki 0,5 dan yuqori musbat hissalar koʻrsatilganda ham belgilar bir-biridan uzoqda qolishini tushuntiriluvchanlik nuqtai nazaridan muammo deb baholaydi. Bunga qarshi ravishda Explainer niqoblari yanada uzluksiz hududlar hosil qilish uchun yaratilgan.
Ushbu Usul Tabiiy Til Matnida Bevosita Tasdiqlanganmi?
Yoʻq. Tadqiqot usulni token asosidagi kirishlarga va matnga umumlashtirilishi mumkin boʻlgan XAI yondashuvi sifatida shakllantiradi, biroq chop etilgan tajribaviy tasdiq NT50m bilan DNA/nukleotid ketma-ketliklarining taksonomik tasnifi ustida amalga oshirilgan; tabiiy til tasnifi tadqiqotning kelajakdagi tadqiqot yoʻnalishlaridan biridir.
Bu farq muhim. DNA 6-merlari va tabiiy til tokenlari ikkalasi ham diskret token ketma-ketliklari boʻlsa-da, ularning semantik tuzilmalari, lugʻatlari, kontekst aloqalari, model oʻqitish maqsadlari va insonning tushuntirishni baholash usuli bir xil emas. Manba bu farqlarni taqqoslaydigan tabiiy til tajribalarini taqdim etmaydi.
Xuddi shuningdek, tadqiqot yaratilgan niqoblarning “human-readable” boʻlishini arxitekturaning uzluksizlik xususiyati va namuna vizuallari orqali asoslaydi; biroq tushuntirishlar odamlar tomonidan aniqroq, tezroq yoki ishonchliroq tushunilishini oʻlchaydigan nazoratli foydalanuvchi tajribasi oʻtkazilmagan. Shu sabab “odamlar uchun koʻproq tushuntiriladigan ekani klinik yoki psixometrik jihatdan isbotlangan” degan xulosaga kelib boʻlmaydi.
Tadqiqot qoʻllab-quvvatlaydigan natijalar
Tadqiqot embedding darajasida uzluksiz niqoblarni oʻrganadigan Explainer NT50m genomik tasniflagichi uchun tasniflash axborotini saqlaydigan uzluksiz token hududlarini hosil qila olishini qoʻllab-quvvatlaydi. Niqoblangan ketma-ketliklarda yuqori aniqlik saqlanishi va teskari niqoblarda aniqlikning keskin pasayishi niqoblar tasniflash nuqtai nazaridan axborot tashuvchi hududlar bilan bogʻliqligini koʻrsatadi.
Tadqiqot shuningdek hisoblash xarajatini tushuntirish paytidan Explainer oʻqitish bosqichiga koʻchirish juda katta test toʻplamlarida takror-takror tushuntirish yaratishda afzallik berishi mumkinligini koʻrsatadigan amaliy misolni taqdim etadi.
Tadqiqot qoʻllab-quvvatlamaydigan natijalar
Tadqiqot usul barcha tabiiy til vazifalarida SHAP yoki LIMEdan aniqroq tushuntirishlar hosil qilishini koʻrsatmaydi. Tabiiy til ma’lumotlar toʻplamida miqdoriy baholash oʻtkazilmagan va LIMEdan tashqari asosiy XAI usullari bilan toʻliq miqyosli benchmark taqdim etilmagan.
Usul barcha transformer, recurrent yoki boshqa token tasniflagich arxitekturalarida bir xil samaradorlik berishi tajribaviy ravishda isbotlanmagan. Mualliflar arxitektura jihatidan umumiy qoʻllanish imkonini ilgari sursa-da, chop etilgan tajriba NT50mga qaratilgan va mean-pooling arxitekturasi aynan ikkinchi niqoblashni talab qilishi koʻrsatilgan.
Bundan tashqari, niqoblar tasniflagich uchun muhim xususiyat hududlarini belgilaydi; ularning biologik jihatdan sababiy motivlar, funksional genomik hududlar yoki haqiqiy biologik mexanizmlar ekani ushbu tajribadan chiqarib boʻlmaydi. Model atributsiyasi bilan biologik sababiylik bir-biridan ajratilishi kerak.
Manba va Usul Haqida Izoh
Asl tadqiqot: What You Read Is What You Classify: Highlighting Attributions to Text and Text-like Inputs
Mualliflar: Daniel S. Berman; Brian Merritt; Stanley Ta; Dana Udwin; Amanda Ernlund; Jeremy Ratcliff; Vijay Narayan.
Mas’ul muallif: Vijay Narayan.
Muassasalar: Johns Hopkins Applied Physics Laboratory, Laurel, Maryland, AQSh; Google DeepMind, London, Birlashgan Qirollik.
Jurnal: AI.
Nashriyot: MDPI.
Manba turi: Asl tadqiqot maqolasi; tushuntiriladigan sun’iy intellekt va mashinaviy oʻrganish usulini ishlab chiqish/hisoblash tajribasi tadqiqoti.
Nashr ma’lumoti: AI 2026, jild 7, son 5, maqola 168.
DOI: 10.3390/ai7050168
Yuborilgan: 25 Mart 2026.
Qayta koʻrib chiqish: 20 Aprel 2026.
Qabul: 23 Aprel 2026.
Nashr: 13 May 2026.
Preprint: arXiv:2602.24149. Bu yozuv chop etilgan tadqiqotning oldingi versiyasidir; alohida mustaqil tadqiqot sifatida baholanmagan.
Taqriz: Taqrizdan oʻtgan ilmiy jurnalda chop etilgan maqola.
Litsenziya: Creative Commons Attribution (CC BY), ochiq kirish.
Moliyalashtirish: Tadqiqot U.S. Centers for Disease Control and Prevention, Office of Readiness and Response tomonidan Contract #75D30124C20202 doirasida qoʻllab-quvvatlangan.
Institutsional etika kengashi: Qoʻllanilmaydi.
Axborotli rozilik: Qoʻllanilmaydi.
Ma’lumotlarning mavjudligi: Tadqiqotda ishlatilgan asosiy ma’lumotlar Mock va hamkasblarining ochiq kirishli tadqiqoti qoʻshimcha materialida mavjud. Mualliflar, shuningdek, ma’lumotlarni ajratish, Explainer va Explanandumni oʻqitish hamda inference uchun ishlatilgan kod ochiq GitHub repozitoriyasida e’lon qilinganini bildiradi.
Tashakkur: Mualliflar Molly Gallagherga tadqiqotni yakunlash jarayonidagi hissasi va dasturiy toʻsiqlarni bartaraf etishga koʻrsatgan yordami uchun minnatdorlik bildiradi.
Manfaatlar toʻqnashuvi: Jeremy Ratcliff tadqiqotga hissa qoʻshgan paytda Johns Hopkins Applied Physics Laboratory xodimi boʻlgan. Boshqa mualliflar potensial tijoriy yoki moliyaviy manfaatlar toʻqnashuvini keltirib chiqarishi mumkin boʻlgan aloqalari yoʻqligini bildirgan.
Mualliflar hissasi: Konseptuallashtirish Daniel S. Berman, Dana Udwin va Amanda Ernlund; metodologiya Daniel S. Berman va Amanda Ernlund; dasturiy ta’minot Daniel S. Berman va Vijay Narayan; validatsiya, formal tahlil va tadqiqot Daniel S. Berman; resurslar Brian Merritt; ma’lumotlar kuratsiyasi Brian Merritt, Stanley Ta va Daniel S. Berman; dastlabki qoralama Daniel S. Berman, Brian Merritt, Stanley Ta va Vijay Narayan; koʻrib chiqish va tahrirlash Daniel S. Berman, Brian Merritt, Stanley Ta, Dana Udwin, Amanda Ernlund va Vijay Narayan; vizuallashtirish Daniel S. Berman; nazorat, loyiha boshqaruvi va moliyalashtirishni jalb qilish Jeremy Ratcliff va Vijay Narayan tomonidan bajarilgan.
Asosiy metodologik cheklovlar: Tajribaviy tasdiq genomik token ketma-ketliklari bilan cheklangan; tabiiy til matni bevosita sinovdan oʻtkazilmagan. Explainer arxitekturasi uchun giperparametr qidiruvi oʻtkazilmagan. Tajriba bitta asosiy Explanandum arxitekturasi — NT50mga qaratilgan. Inson ishtirokchilari bilan tushuntiriluvchanlik tadqiqoti oʻtkazilmagan. LIME taqqoslanishi ish vaqti va namuna vizuallari boʻyicha taqdim etilgan boʻlsa-da, barcha zamonaviy XAI usullari umumiy mezonlar bilan taqqoslangan keng qamrovli benchmark emas.
Manba ichidagi nomuvofiqlik qaydi: Manbada 6-mer uchun “six amino acids” iborasi DNA kontekstiga mos kelmaydi; genusning niqobsiz muvozanatlangan aniqligi matnda %71,65 va 1-jadvalda %71,67 sifatida berilgan; test toʻplami ma’lumotlar boʻlimida 103.648, LIME ish vaqti boʻlimida 103.638 deb yozilgan; shuningdek, 1573 unique taxonomy ID va 1878 genus soni oʻrtasidagi munosabat izohlanmagan. Bu nuqtalar Verianla tomonidan jim tarzda tuzatilmagan.
Verianla usul izohi: Ushbu mazmun manba maqolaning satrma-satr tarjimasi emas. Tadqiqot muammosi, Explainer–Explanandum tuzilmasi, embedding darajasidagi Hadamard niqoblash, yoʻqotish funksiyalari, NT50m arxitekturasi, ma’lumotlar toʻplami, oʻqitish sharoitlari, 1-jadval natijalari va 1–8-rasmlarning ilmiy mazmuni saqlangan holda mustaqil va oʻrgatuvchi Oʻzbekcha tuzilma yaratildi. Manbada boʻlmagan tajriba natijasi yoki samaradorlik qiymati qoʻshilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan