

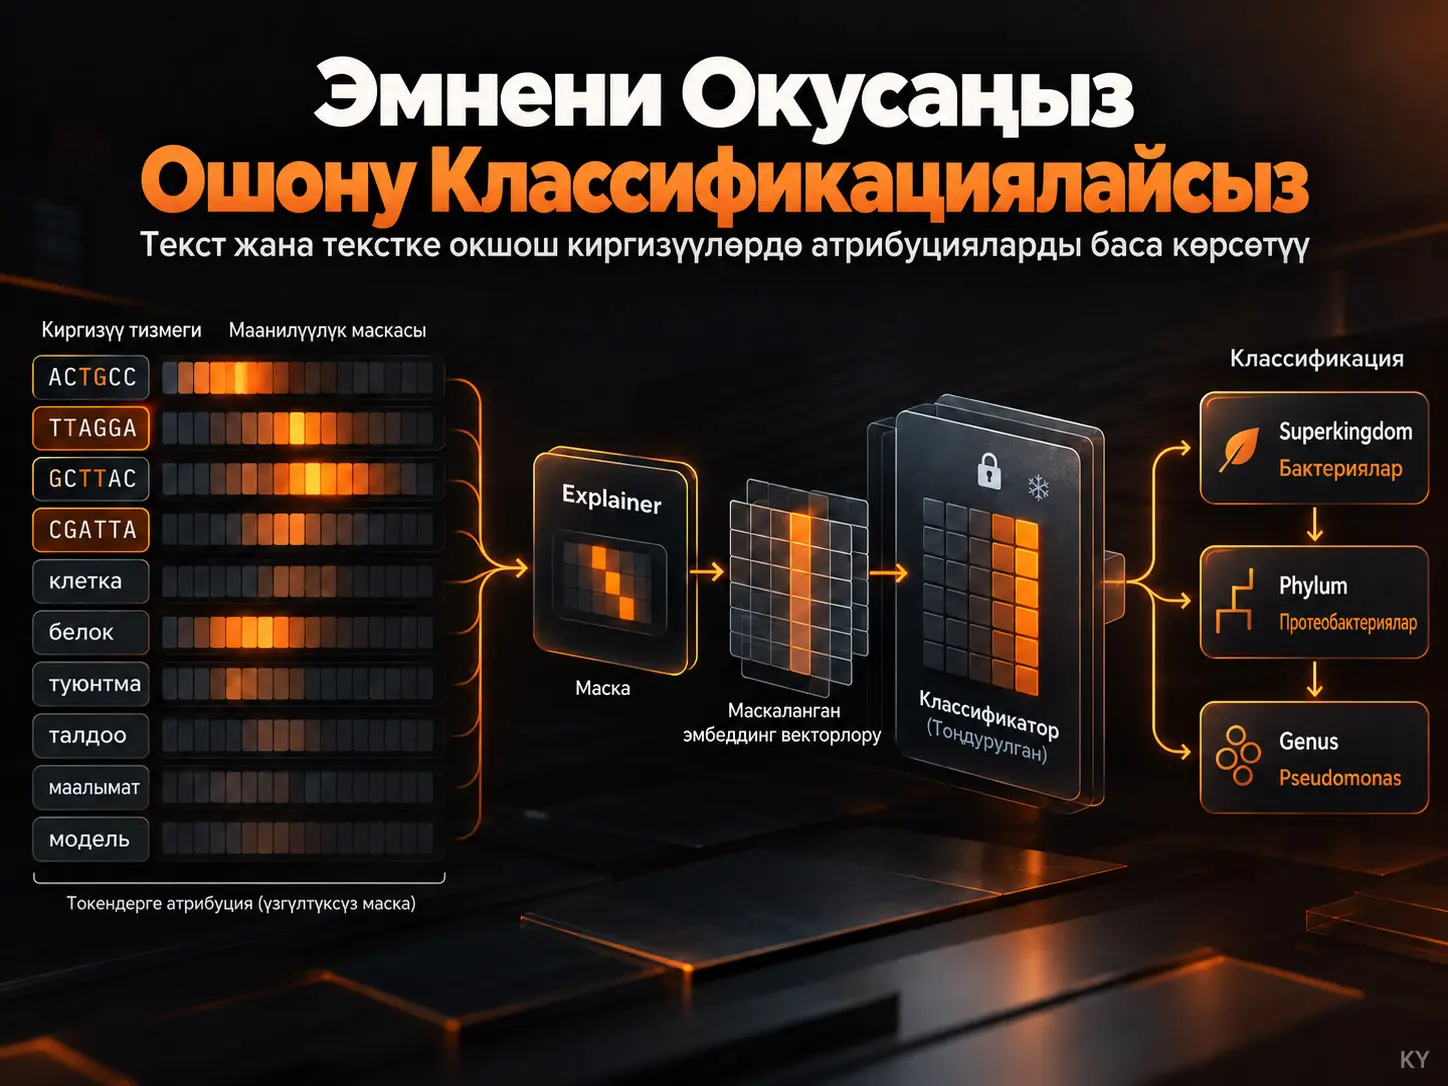
Бул изилдөөдө иштелип чыккан Explainer–Explanandum негизиндеги түшүндүрүлүүчү жасалма интеллект ыкмасы — токен тизмектерин классификациялаган жасалма интеллект моделинин чечиминде кайсы ырааттуу токен аймактары маанилүү экенин үзгүлтүксүз маанилүү маскалар аркылуу аныктоону көздөгөн XAI ыкмасы. Ыкма масканы дискреттүү токен идентификаторлоруна түздөн-түз колдонбой, токендердин үзгүлтүксүз embedding векторлоруна Hadamard көбөйтүүсү аркылуу колдонот; мунун натыйжасында embedding векторунун багыты сакталат, ал эми чоңдугу азаят. Изилдөөчүлөр ыкманы 50 миллион параметрлүү Nucleotide Transformer модели NT50m менен DNA тизмектерин superkingdom, phylum жана genus деңгээлдеринде таксономиялык классификациялоо боюнча сынашкан. Натыйжалар маанилүү деп эсептелген аймактар ачык калтырылганда классификациянын көрсөткүчү негизинен сакталарын, ошол эле аймактар жашырылганда көрсөткүч олуттуу төмөндөөрүн көрсөтөт. Бирок эксперимент табигый тилдеги текстте эмес, геномдук токен тизмектеринде жүргүзүлгөн; ошондуктан табигый тилге жалпылоо бул изилдөөнүн эксперименталдык түрдө ырасталган натыйжасы эмес.
Негизги классификатор болгон Explanandumдун тең салмакталган тактыгы superkingdom, phylum жана genus үчүн 1-таблицада тиешелүүлүгүнө жараша %99,05, %97,39 жана %71,67 деп билдирилген. Explainer түзгөн үзгүлтүксүз маскалар колдонулганда бул көрсөткүчтөр %98,39, %95,51 жана %69,88 деңгээлинде сакталган. Маскалар тескерисине айлантылганда, башкача айтканда Explainer маанилүү деп эсептеген аймактар жашырылып, маанилүү эмес аймактар ачык калтырылганда тең салмакталган тактык тиешелүүлүгүнө жараша %46,70, %28,21 жана %5,71ге чейин төмөндөгөн. Бул карама-каршылык маскалар классификацияга чындап салым кошкон маалымат аймактарын бөлүп көрсөтө аларына байланыштуу изилдөөнүн негизги эксперименталдык далили болуп саналат.
Ыкманын максаты өз-өзүнчө жана бири-биринен үзүлгөн токен маанилүүлүк упайларын чыгаруунун ордуна көбүрөөк үзгүлтүксүз түшүндүрмө аймактарын түзүү. Тегеректелген маскалардан алынган ачык аймактардагы бөлүктөрдүн орточо саны 3,35; тизмектердин болжол менен %90ында төрт же андан аз ачык бөлүк бар. Ачык бөлүктүн орточо узундугу 51,39 токен болуп, 250 токенден турган типтүү киргизүүнүн болжол менен бештен бир бөлүгүнө туура келет. Ошентип, түшүндүрмө бүт тизмекти маанилүү деп жарыялоонун ордуна орточо узундуктагы бир нече ырааттуу аймакка топтолот.
Изилдөө иштөө убактысы жагынан LIME менен практикалык салыштырууну да берет. Булакта LIME ар бир тизмек жана ар бир таксономиялык деңгээл үчүн орточо 26 секунд талап кылары айтылат, ал эми Explainerди үйрөтүү 15 саат 40 мүнөткө созулуп, үйрөтүлгөн Explainer тест топтомунун маскаларын болжол менен 20 мүнөттө жараткан. Бул жердеги негизги архитектуралык айырма — LIME сыяктуу perturbation негизиндеги ыкмалар эсептөө жүгүнүн чоң бөлүгүн түшүндүрмө жаратуу учурунда көтөрсө, бул ыкма чыгымдын маанилүү бөлүгүн Explainerди үйрөтүү учурунда алдын ала төлөйт.
Токен Негизиндеги Түшүндүрүлүүчү Жасалма Интеллекттеги Негизги Маселе Эмне?
Токен негизиндеги түшүндүрүлүүчү жасалма интеллекттеги негизги маселе — текст же биологиялык тизмек сыяктуу дискреттүү киргизүүлөрдө токенди жарым-жартылай маскалоо мүмкүн эместиги жана күчтүү transformer классификаторлорунун чечимдери жергиликтүү да, алыскы да токен өз ара аракеттенүүлөрүнө таянышы мүмкүн экени; ошондуктан сүрөттөрдө табигый иштеген үзгүлтүксүз пикселдик маскаларды токендерге түздөн-түз көчүрүү мүмкүн эмес.
Сүрөт классификациясында пикселдин интенсивдүүлүгү үзгүлтүксүз сан болуп саналат. Мисалы, сүрөттүн бир аймагын 0,25ке көбөйтүү ошол аймактын көрүү таасирин азайтат жана операция дифференциалдануучу бойдон калат. Ал эми токен идентификатору категориялык. Сөздү же DNA 6-merин “0,25 токенге” айлантуу жарактуу токендештирүү операциясы эмес.
Текст түшүндүрмөлөрүндө кеңири колдонулган SHAP жана Local Interpretable Model-Agnostic Explanations (LIME) сыяктуу perturbation негизиндеги ыкмалар киргизүү өзгөчөлүктөрүн өзгөртүп, алардын чыгышка тийгизген таасирин баалайт. Булак авторлорунун пикири боюнча, токендерди көбүнчө өз-өзүнчө караган мындай ыкма узун тизмектерде маанилүү аймактарды бири-биринен үзүлгөн токендер түрүндө көрсөтүп, бүтүндөй окууга кыйын маанилүүлүк картасын түзүшү мүмкүн.
Rationalization ыкмалары болсо классификация чечимин түшүндүрүү үчүн киргизүүнүн тиешелүү бөлүктөрүн тандай же түшүндүрүүчү текст жарата алат. Бирок булак айрым генеративдүү rationalization ыкмаларында түшүндүрмөнүн киргизүүгө берилген бойдон калбоо же hallucination жаратуу коркунучуна, айрым көзөмөлдөнгөн тандоо ыкмаларында болсо үйрөтүүнүн татаалдыгына көңүл бурат.
Explainer жана Explanandum ролдору
Ыкма эки моделдин ролун бөлүп көрсөтөт. Explanandum — түшүндүрүлө турган жана салмактары тоңдурулган учурдагы классификатор. Explainer болсо ар бир киргизүү токени жана ар бир класс үчүн 0 менен 1дин ортосунда маска маанисин жаратуу үчүн үйрөтүлгөн экинчи нейрондук тармак.
Бир класс үчүн түзүлгөн маска \(s_c\) менен белгиленет. Чыныгы максатка тиешелүү класстардын маскалары element-wise максимум операциясы менен бириктирилип, максат маскасы \(m\) түзүлөт. Максат эмес класстардын маскаларынан non-target маска \(n\) түзүлөт. Максат маскасынын тескериси:
\[ \widetilde{m}=1-m \]
түрүндө болот. Бул толуктоочу маска өзгөчө “маанилүү деп эсептелген маалыматты алып салсак, классификатордун ишеними чындап бузулобу?” деген суроону текшерүүдө колдонулат.
Булактагы 1-сүрөт эмнени көрсөтөт?
Булактагы 1A-сүрөт панели сүрөттөр үчүн колдонулган баштапкы “what-you-see” ыкмасында Explainer түздөн-түз сүрөт өлчөмүндө маскаларды түзөрүн көрсөтөт. 1B-сүрөт болсо макаланын негизги салымын берет: токен тизмеги алгач Explainerге барат, ал эми түшүндүрүлүп жаткан Explanandum токен иштетүү жана embedding бөлүгүнө, андан кийинки жашыруун/классификация катмарларына бөлүнөт. Маскалар токендердин өзүнө эмес, үзгүлтүксүз embedding өкүлчүлүктөрүнө таасир этет.
Бул Изилдөөдө Маска Токендерге Кантип Колдонулат?
Маска токен идентификаторун өзгөртүүнүн ордуна ар бир токендин embedding векторуна колдонулат; узундугу \(d\) болгон маска вектору embedding өлчөмү \(h\) боюнча кайталанып, \(d\times h\) өлчөмүнө кеңейтилет жана embedding матрицасы менен Hadamard, башкача айтканда element-wise көбөйтүү аткарылат.
Эгер токендин embedding вектору \(e\), ал токендин маска мааниси \(m_i\) болсо, операцияны концептуалдык түрдө:
\[ e_{\text{masked}}=m_i e \]
деп түшүнүүгө болот. Бир эле скалярдык мааниси embeddingдин бардык компоненттерине колдонулгандыктан, \(0<m_i<1\) болгондо вектордун чоңдугу азаят, бирок embedding мейкиндигиндеги багыты өзгөрбөйт. Булактын 2-сүрөтүндө 0,25 маска мааниси менен “apple” embedding векторунун ошол эле багытта, бирок кыскараак болуп калышы бул механизмди көрсөтөт.
Бул тандоо эки маселени бир учурда чечет. Биринчиден, дискреттүү токендерге бөлчөк маска колдонуу зарылдыгын жоёт. Экинчиден, үзгүлтүксүз көбөйтүү операциясынын аркасында Explainerден Explanandum аркылуу жоготуу функциясына чейинки жол дифференциалдануучу бойдон калат; ошентип Explanandum тоңдурулганда Explainerдин салмактары гана үйрөтүлөт.
Mean pooling колдонулганда эмне үчүн экинчи маскалоо керек?
Авторлор ыкманы колдонуу үчүн маанилүү шартты белгилешет: бош тизмектин же толугу менен маскаланган тизмектин классификатор softmax чыгышы болжол менен uniform болушу күтүлөт. Бирок NT50mде бардык токендин жашыруун абалдары боюнча mean pooling колдонулганда толугу менен маскаланган киргизүү муну автоматтык түрдө камсыз кылган эмес.
Ошондуктан NT50m экспериментинде маска embedding катмарынан кийин гана эмес, transformer жашыруун катмарларынын чыгышына да mean poolingге чейин кайра колдонулган. Булактын 3-сүрөтү CLS токен чыгышын колдонгон классификатор менен mean-pooling классификаторунун ортосундагы бул айырманы көрсөтөт. Авторлор классификация CLS чыгышына гана таянса, экинчи маскалоо зарыл эмес экенин белгилешет.
Жоготуу функциясынын жалпы түзүлүшү
Сүрөттөр үчүн колдонулган эки өлчөмдүү маска жоготуусу токен тизмектери үчүн бир өлчөмгө түшүрүлгөн. Жалпы Explainer жоготуусу булакта Теңдеме (1) катары:
\[ L_E(x,Y,S,m,n) = L_c(x,Y,m) + \lambda_e L_e(x,\widetilde m) + \lambda_a L_a(m,n,S) + \lambda_{tv}L_{tv}(m,n) \]
түрүндө берилет. Эксперименттерде:
\[ \lambda_e=\lambda_a=\lambda_{tv}=1 \]
колдонулган. Бул коэффициенттер кошумча гиперпараметр издөө аркылуу оптималдаштырылган эмес, булак катары алынган Stalder жана кесиптештеринин изилдөөсүндөгү маанилерге таянып тандалган.
Түшүндүрүүчү Тармактын Жоготуу Функциясы Эмнени Тең Салмактайт?
Жалпы жоготуу максаттуу классификация маалыматын ачык кармоо, маанилүү маалымат жашырылганда классификаторду белгисиз кылуу, масканын баарын да, эч нерсени да көрсөтүп калуусуна жол бербөө жана маанилүү токендерди бири-биринен үзүлгөн чекиттердин ордуна жергиликтүү түрдө көбүрөөк үзгүлтүксүз аймактарды түзүүгө түрткү берүү үчүн төрт компонентти бирге тең салмактайт.
1. Классификация жоготуусу \(L_c\)
Булак көп класстуу классификация үчүн стандарттык cross-entropy негизиндеги мүчөнү:
\[ L_c(x,Y,m) = -\frac{1}{C} \sum_{c=1}^{C} \left[ \llbracket c\in Y\rrbracket\log p[c] + \llbracket c\notin Y\rrbracket\log(1-p[c]) \right] \]
түрүндө берет. Бул жерде \(C\) класстардын санын, \(p[c]\) класс \(c\) үчүн божомол ыктымалдыгын, ал эми Iverson кашаасы \(\llbracket\cdot\rrbracket\) шарт туура болсо 1, туура эмес болсо 0 маанисин билдирет. Бул мүчө максат маскасынын классификация үчүн зарыл маалыматты ачык калтырышына түрткү берет.
2. Толуктоочу маска энтропиясы \(L_e\)
Булак Теңдеме (3)тө:
\[ L_e = \frac{1}{C} \sum_{c=1}^{C} F(x\odot\widetilde m)[c] \log F(x\odot\widetilde m)[c] \]
туюнтмасын колдонот. \(F(\cdot)\) Explanandumдун класс ыктымалдыктарын чыгарат. Толуктоочу маска колдонулганда маанилүүлүгү төмөн деп бааланган маалымат гана ачык калат. Бул учурда чыгыш ыктымалдыктарынын мүмкүн болушунча uniform болушу маанилүү маалымат алынганда моделдин маанилүү классификация жасай албашына түрткү берет.
3. Маска аянтынын жоготуусу \(L_a\)
Классификация жана энтропия мүчөлөрү гана колдонулса, бир мүчө масканы баарын көрсөтүүгө, экинчиси өтө көп жашырууга түртүшү мүмкүн. Аянт жоготуусу ушул эки четтин ортосунда тең салмак түзөт:
\[ L_a(m,n,S) = A(m)+A(n) + \frac{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket B(s_c) }{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket }. \]
\(A(m)\) максат маскасынын орточо маанисин, \(A(n)\) максат эмес масканын орточо маанисин билдирет. Булак көрүнүп турган маска аянты үчүн \(0<a<b<1\) боло тургандай минималдуу \(a\) жана максималдуу \(b\) үлүштөрүн аныктайт.
Иреттелген маска маанилери үчүн чек ара жазасы Теңдеме (5)те:
\[ B(s) = \frac{1}{Z} \sum_i \max(q_{\min}[i]-q_{\text{mask}}[i],0) + \frac{1}{Z} \sum_i \max(q_{\text{mask}}[i]-q_{\max}[i],0) \]
түрүндө аныкталат. \(Z\) — тизмектин узундугу. Маска аянты \(a\)дан кичине же \(b\)дан чоң болгондо жаза пайда болот; ошентип түшүндүрмөнүн өтө кичине же өтө кең болушун алдын алууга аракет жасалат.
4. Жалпы вариация жоготуусу \(L_{tv}\)
Жергиликтүү үзгүлтүксүздүктү колдогон Теңдеме (6):
\[ L_{tv} = \frac{1}{Z} \sum_i |m[i]-m[i+1]| + \frac{1}{Z} \sum_i |n[i]-n[i+1]|. \]
Коңшу токендердин маска маанилери чоң секирик жасаганда бул мүчө чоңоёт. Ошондуктан Explainer өзүнчө чачыранды токендерди белгилөөнүн ордуна коңшу токендер чогуу маанилүү болгон көбүрөөк үзгүлтүксүз аймактарды түзүүгө багытталат. Бул үзгүлтүксүздүк изилдөөнүн “адам окуй ала турган түшүндүрмө” максатынын негизги дизайн элементтеринин бири.
Explainer архитектурасы
Explainerдин киргизүүсү NT50m менен бирдей 4107 элементтүү сөздүктү колдонгон жана өлчөмү 100 болгон embedding катмары. Андан кийин эки катмарлуу эки багыттуу Long Short-Term Memory (LSTM) тармагы келет. Булак ар бир багытта колдонулган түзүлүш үчүн 40 node тандалганын жана алдыга/артка memory-cell абалдарын бириктирүү аркылуу ар бир токен үчүн 160 өлчөмдүү өкүлчүлүк алынарын билдирет.
LSTM чыгышынан кийин Batch Normalization жана sigmoid активдешүүсү бар dense катмар келет. Класстардын саны \(c\), тизмектин узундугу \(d\) болгондо Explainerдин акыркы чыгышы:
\[ d\times c \]
өлчөмдүү маска матрицасы болуп, ар бир токен-класс жуп үчүн 0–1 аралыгында маанилүүлүк маанисин чыгарат. Explainer архитектурасы үчүн гиперпараметр издөө жүргүзүлгөн эмес. Авторлор 40 LSTM node ресурстук талаптар менен тең салмак түзүү үчүн тандалганын билдиришет.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Эксперименталдык тапшырма: геномдук таксономиялык классификация
Түшүндүрүлүп жаткан Explanandum модели — мурда таксономиялык DNA классификациясы үчүн fine-tune кылынган Nucleotide Transformer 50 million parameter model, башкача айтканда NT50m. Классификация үч иерархиялык деңгээлде жүргүзүлөт:
- superkingdom: 4 класс,
- phylum: 55 класс,
- genus: 1878 мүмкүн болгон класс.
NT50mдин transformer жашыруун өлчөмү 512. Токен деңгээлиндеги жашыруун абалдар mean pooling аркылуу туруктуу узундуктагы 512 өлчөмдүү өкүлчүлүккө айландырылып, үч өзүнчө сызыктуу классификация башы superkingdom, phylum жана genus логиттерин чыгарат. Explanandum жоготуусу үч таксономиялык деңгээлдин cross-entropy жоготууларынын суммасы.
Маалымат топтому
Иштетүүдөн кийин булак жалпысынан 5.181.880 DNA тизмегин билдирет.
| Superkingdom | Тизмектердин саны |
|---|---|
| Eukaryota | 2.601.890 |
| Bacteria | 1.828.018 |
| Archaea | 524.276 |
| Viruses | 227.696 |
| Жалпы | 5.181.880 |
Ар бир тизмектин узундугу 1500 base-pair. NT50mдин 6-mer токендештирүүсүнө байланыштуу ар бир киргизүү болжол менен 250 токенден турат; бул узундук моделдин максималдуу 1000 токендик киргизүү узундугунан төмөн.
Булактагы терминологиялык эскертүү: Ыкма бөлүмүндө 6-mer түшүндүрмөсү бир жерде “six amino acids grouped together” деп жазылган; бирок изилдөө DNA тизмектери жөнүндө, `ACTGCC` мисалы нуклеотид белгилеринен турат жана 5-сүрөттүн түшүндүрмөсү ар бир алты base-pair тобун бир токен катары аныктайт. Verianla бул билдирүүнү булак текстинин унчукпай оңдолгон формасы катары бербейт.
Булак мындан тышкары 1573 “unique taxonomy IDs”, 55 phyla жана 1878 genera деп билдирет. 1573 taxonomy ID менен 1878 genus санынын кантип шайкеш келиши керек экени текстте түшүндүрүлбөгөндүктөн, бул сандардын байланышы тууралуу кошумча божомол жасалган эмес.
Үйрөтүү, валидация жана тестке бөлүү
Scikit-learn `train_test_split` операциясы seed 42 менен колдонулган. Булак толук маалымат топтомунун %2син, башкача айтканда 103.648 тизмекти, бардык эксперименталдык иштетүүлөрдө колдонулуучу hold-out тест топтому катары бөлүп алган. Толук маалыматтын дагы %10у үйрөтүү учурунда validation lossту көзөмөлдөө үчүн бөлүнгөн.
Explanandum калган маалыматтарда үйрөтүлгөнү менен Explainer үчүн бардык үйрөтүү маалыматтары колдонулган эмес. Explainer үйрөтүү топтомунан туш келди тандалган 239.391 мисалда үйрөтүлгөн; булак мунун үйрөтүү топтомунун болжол менен %4,7сине туура келерин жана толук маалымат менен үйрөтүүнү талап кылбаган натыйжаларды бергенин билдирет.
Үйрөтүү жабдыгы жана гиперпараметрлер
| Элемент | Маани |
|---|---|
| GPU | NVIDIA H100, 80 GB VRAM |
| Python | 3.11.6 |
| PyTorch | 2.5.1 |
| Learning rate | 0,0002 |
| Learning-rate scheduler | Cosine |
| Explanandum epoch | 5 |
| Explanandum batch size | 128 |
| Explainer пландалган epoch | 50 |
| Explainer ишке ашкан epoch | 38; early stopping |
| Explainer batch size | 48 |
| Precision | FP32 |
| Weight decay | 0 |
| Warm-up | Жок |
| Random seed | 42 |
| LIME колдонмосу | Captum 0.7.0 |
| Scikit-learn | 1.6.1 |
Маскалар Чындап Маанилүү Токен Аймактарын Сактай Турганы Кантип Текшерилди?
Изилдөө маскалардын тууралыгын маанилүү деп эсептелген токендерди ачык калтырган маскаланган киргизүүлөр менен анын тескерисин жасаган inverted-mask киргизүүлөрүнүн классификация көрсөткүчтөрүн салыштыруу аркылуу текшерген; маскаланган киргизүүлөрдө көрсөткүч негизинен сакталып, маанилүү аймактар жашырылганда үч таксономиялык деңгээлдин баарында тең салмакталган тактык кескин төмөндөгөн.
| Шарт | Superkingdom | Phylum | Genus |
|---|---|---|---|
| Explanandum, маскасыз | %99,05 | %97,39 | %71,67 |
| Үзгүлтүксүз маскалар | %98,39 | %95,51 | %69,88 |
| Тескери маскалар | %46,70 | %28,21 | %5,71 |
| Тегеректелген маскалар | %76,42 | %52,60 | %40,86 |
| Тескери тегеректелген маскалар | %44,85 | %26,20 | %4,92 |
| Орточо тиешелүү бөлүк | %69,98 | %49,92 | %36,32 |
| Орточо тиешеси жок бөлүк | %47,13 | %31,68 | %9,58 |
Бул таблица эки өзүнчө далилди берет. Биринчиден, үзгүлтүксүз маскалар колдонулганда маскасыз Explanandumга салыштырмалуу классификация көрсөткүчү аз гана төмөндөйт. Экинчиден, маскалар тескерисине айлантылып, Explainer маанилүү деп эсептеген бөлүктөр алынып салынганда көрсөткүч өзгөчө genus деңгээлинде %69,88ден %5,71ге чейин төмөндөйт.
Булактагы сандык эскертүү: 1-таблица маскасыз genus тактыгын %71,67 деп берсе, анын дароо алдындагы жана кийинки баяндама текстинде %71,65 мааниси колдонулат. Таблица бул жерде булактагыдай %71,67 түрүндө берилди жана айырма өзүнчө көрүнүктүү калтырылды.
Тегеректелген маскалар эмне үчүн өзүнчө текшерилди?
Үзгүлтүксүз маскалар 0 менен 1дин ортосунда өзгөрөт. Изилдөөчүлөр түшүндүрмөнү такыраак кылуу үчүн маанилерди 0 же 1ге тегеректеп, бинардык маскаларды да текшеришкен. Тегеректөө маалымат жоготуусуна алып келгендиктен тактык үзгүлтүксүз маскаларга салыштырмалуу төмөндөсө да, тескери тегеректелген маскаларга салыштырмалуу кыйла жогору бойдон калат. Авторлор муну маанилүү аймактар орой бинардык маскалоо шартында да маанилүү классификация маалыматын алып жүрөт деп чечмелешет.
Тиешелүү жана тиешеси жок бөлүктөрдү өзүнчө классификациялоо
Маскаланган боштуктар моделде кокустан классификация белгисин жаратып-жаратпаганын текшерүү үчүн тегеректелген маскалар ырааттуу ачык жана жабык бөлүктөргө бөлүнгөн. Ар бир бөлүк өзүнчө Explanandumга берилген. Тиешелүү бөлүктөр superkingdom, phylum жана genus үчүн тиешелүүлүгүнө жараша %69,98, %49,92 жана %36,32 тең салмакталган тактык берсе, тиешеси жок бөлүктөр %47,13, %31,68 жана %9,58 көрсөткөн.
Бул жыйынтык классификация маскаланган тизмектеги боштуктардын геометриясынан гана келип чыкпайт жана Explainer ачык калтырган чыныгы тизмек бөлүктөрү көбүрөөк таксономиялык маалымат алып жүрөт деген чечмелөөнү колдойт.
Маскалар тизмектин канча бөлүгүн ачык калтырат?
Тест топтому боюнча маска маанилеринин орточосу 0,73 деп берилген жана бардык токен маска маанилеринин %67,28и 0,5тен жогору. 6A-сүрөт бул бөлүштүрүүнү гистограмма катары, 6B-сүрөт болсо токендин ордуна жараша орточо маска маанисин көрсөтөт. Булак тизмектин башында жана ортосунда кайталанган жогорку маанилүүлүктөгү аймактар байкалганын, бирок минималдуу жана максималдуу маанилер мисалдар арасында кеңири өзгөрөрүн билдирет.
Тегеректелген маскаларда ачык аймактардын саны орточо 3,35 бөлүк. Тизмектердин болжол менен %90ында төрт же андан аз ачык бөлүк бар. Булак ошондой эле болгону %0,4 бөлүгүндө эч бир маскаланган токен болбогонун билдирет.
Ачык бөлүктүн орточо узундугу 51,39 токен деп билдирилген; айрым ачык бөлүктөр 200 токенден ашат. 250 токендик типтүү тизмек узундугу менен салыштырганда авторлор бул болжол менен %20 бөлүккө туура келерин айтышат. Ошентип, түшүндүрмө бүт тизмекти белгилөөнүн ордуна орточо узундуктагы бир нече үзгүлтүксүз аймак түзөт.
LIME менен иштөө убактысын жана түшүндүрүлмөлүүлүктү салыштыруу
Булак NT50mдин Evolutionary Scale Modeling негизиндеги түзүлүшүнүн сериализация өзгөчөлүктөрүнөн улам LIME, transformer-interpret жана SHAP Python пакеттерин колдонуу кыйын экенин билдирет. Толук колдонулган салыштырма ыкма — LIME.
LIMEдин орточо иштөө убактысы булакта ар бир тизмек жана ар бир таксономиялык деңгээл үчүн болжол менен 26 секунд деп берилген. Авторлор бул убакыт бүт тест топтомуна кезектешип колдонулса, айлар талап кылынышы мүмкүн экенин билдиришет.
Сунушталган Explainerди үйрөтүү 15 саат 40 мүнөткө созулган; үйрөтүлгөн Explainer тест топтому үчүн маскаларды болжол менен 20 мүнөттө жараткан. Бул салыштырууда эки ыкманын чыгым түзүлүшү бирдей эмес: Explainer бир жолу үйрөтүлүп, кийинки киргизүүлөр үчүн түздөн-түз маска жаратат, ал эми LIME түшүндүрмө жаратууда ар бир мисал үчүн perturbation операцияларын кайра аткарат.
Булактагы сандык эскертүү: маалымат бөлүмүндө тест топтому 103.648 тизмек деп берилсе, LIME иштөө убактысы бөлүмүндө 103.638 тизмек деп жазылган. Verianla бул он тизмек айырмасын булак кайсы санды көздөгөнүн божомолдоп оңдогон эмес.
8-сүрөттө LIMEдин бир мисалдагы оң жана терс маанилүүлүк маанилери тизмектин ар башка аймактарына жайылган көптөгөн түстүү токендер катары көрүнөт. Авторлор оң салымдар гана же 0,5тен жогору оң салымдар гана көрсөтүлгөндө да белгилердин бири-биринен алыс калышын түшүндүрүлмөлүүлүк жагынан көйгөй деп эсептешет. Ал эми Explainer маскалары көбүрөөк үзгүлтүксүз аймактарды түзүүгө ылайыкталган.
Бул Ыкма Табигый Тил Текстинде Түздөн-Түз Ырасталдыбы?
Жок. Изилдөө ыкманы токен негизиндеги киргизүүлөргө жана текстке жалпылоого боло турган XAI ыкмасы катары формулировкалайт, бирок жарыяланган эксперименталдык ырастоо NT50m менен DNA/нуклеотид тизмектерин таксономиялык классификациялоо боюнча жүргүзүлгөн; табигый тил классификациясы изилдөөнүн келечектеги багыттарынын бири.
Бул айырма маанилүү. DNA 6-merлери жана табигый тил токендери экөө тең дискреттүү токен тизмектери болгону менен, алардын семантикалык түзүлүштөрү, сөздүктөрү, контексттик байланыштары, моделди үйрөтүү максаттары жана адамдын түшүндүрмөнү баалоо ыкмасы бирдей эмес. Булак бул айырмачылыктарды салыштырган табигый тил эксперименттерин бербейт.
Ошондой эле изилдөө түзүлгөн маскалардын “human-readable” болушун архитектуранын үзгүлтүксүздүк касиети жана мисал визуалдар аркылуу негиздейт; бирок түшүндүрмөлөрдү адамдар такыраак, тезирээк же ишенимдүүрөөк түшүнөрүн өлчөгөн көзөмөлдөнгөн колдонуучу эксперименти жүргүзүлгөн эмес. Ошондуктан “адамдар үчүн көбүрөөк түшүндүрүлмөлүү экени клиникалык же психометрикалык түрдө далилденди” деген жыйынтык чыгарууга болбойт.
Изилдөө колдогон жыйынтыктар
Изилдөө embedding деңгээлинде үзгүлтүксүз маскаларды үйрөнгөн Explainer NT50m геномдук классификатору үчүн классификация маалыматын сактаган үзгүлтүксүз токен аймактарын түзө аларын колдойт. Маскаланган тизмектерде жогорку тактыктын сакталышы жана тескери маскаларда тактыктын кескин төмөндөшү маскалар классификация жагынан маалымат алып жүргөн аймактар менен байланыштуу экенин көрсөтөт.
Изилдөө ошондой эле эсептөө чыгымын түшүндүрмө түзүү учурунан Explainerди үйрөтүү баскычына жылдыруу өтө чоң тест топтомдорунда кайра-кайра түшүндүрмө жаратууда артыкчылык бере аларын көрсөткөн практикалык мисал берет.
Изилдөө колдобогон жыйынтыктар
Изилдөө бул ыкма бардык табигый тил тапшырмаларында SHAP же LIMEге караганда такыраак түшүндүрмө чыгарарын көрсөтпөйт. Табигый тил маалымат топтомунда сандык баалоо жүргүзүлгөн эмес жана LIMEден башка негизги XAI ыкмалары менен толук масштабдуу benchmark берилген эмес.
Ыкма бардык transformer, recurrent же башка токен классификатор архитектураларында бирдей көрсөткүч берет деп эксперименталдык түрдө далилденген эмес. Авторлор архитектуралык жактан жалпы колдонулушун сунуштаса да, жарыяланган эксперимент NT50mге багытталган жана mean-pooling архитектурасы өзгөчө экинчи маскалоону талап кылары көрсөтүлгөн.
Мындан тышкары, маскалар классификатор үчүн маанилүү өзгөчөлүк аймактарын белгилейт; алардын биологиялык жактан себептик мотивдер, функционалдык геномдук аймактар же чыныгы биологиялык механизмдер экени бул эксперименттен чыгарылбайт. Моделдик атрибуция менен биологиялык себептүүлүк айырмаланышы керек.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска изилдөө: What You Read Is What You Classify: Highlighting Attributions to Text and Text-like Inputs
Авторлор: Daniel S. Berman; Brian Merritt; Stanley Ta; Dana Udwin; Amanda Ernlund; Jeremy Ratcliff; Vijay Narayan.
Жооптуу автор: Vijay Narayan.
Мекемелер: Johns Hopkins Applied Physics Laboratory, Laurel, Maryland, АКШ; Google DeepMind, Лондон, Бириккен Падышалык.
Журнал: AI.
Басмакана: MDPI.
Булактын түрү: Түпнуска изилдөө макаласы; түшүндүрүлүүчү жасалма интеллект жана машиналык үйрөнүү ыкмасын иштеп чыгуу/эсептөөчү эксперименттик изилдөө.
Жарыя маалыматы: AI 2026, том 7, сан 5, макала 168.
DOI: 10.3390/ai7050168
Жөнөтүлгөн: 25 Март 2026.
Ревизия: 20 Апрель 2026.
Кабыл алынган: 23 Апрель 2026.
Жарыяланган: 13 Май 2026.
Preprint: arXiv:2602.24149. Бул жазуу жарыяланган изилдөөнүн мурунку версиясы; өзүнчө көз карандысыз изилдөө катары бааланган эмес.
Рецензиялоо: Рецензияланган илимий журналда жарыяланган макала.
Лицензия: Creative Commons Attribution (CC BY), ачык жеткиликтүүлүк.
Каржылоо: Изилдөө U.S. Centers for Disease Control and Prevention, Office of Readiness and Response тарабынан Contract #75D30124C20202 алкагында колдоого алынган.
Институционалдык этика кеңеши: Колдонулбайт.
Маалымдалган макулдук: Колдонулбайт.
Маалыматтардын жеткиликтүүлүгү: Изилдөөдө колдонулган негизги маалымат Mock жана кесиптештеринин ачык жеткиликтүү изилдөөсүнүн кошумча материалында бар. Авторлор ошондой эле маалыматтарды бөлүү, Explainer жана Explanandum үйрөтүү жана inference үчүн колдонулган код ачык GitHub репозиторийинде жарыяланганын билдиришет.
Ыраазычылык: Авторлор Molly Gallagherге изилдөөнү аяктоодогу салымы жана программалык тоскоолдуктарды жоюуга көрсөткөн жардамы үчүн ыраазычылык билдиришет.
Кызыкчылыктардын кагылышы: Jeremy Ratcliff изилдөөгө салым кошкон учурда Johns Hopkins Applied Physics Laboratory кызматкери болгон. Башка авторлор потенциалдуу коммерциялык же каржылык кызыкчылыктардын кагылышын жаратышы мүмкүн болгон байланыштары жок экенин билдиришкен.
Авторлордун салымы: Концептуалдаштыруу Daniel S. Berman, Dana Udwin жана Amanda Ernlund; методология Daniel S. Berman жана Amanda Ernlund; программалык камсыздоо Daniel S. Berman жана Vijay Narayan; валидация, формалдык талдоо жана изилдөө Daniel S. Berman; ресурстар Brian Merritt; маалыматтарды курациялоо Brian Merritt, Stanley Ta жана Daniel S. Berman; алгачкы долбоор Daniel S. Berman, Brian Merritt, Stanley Ta жана Vijay Narayan; карап чыгуу жана редакциялоо Daniel S. Berman, Brian Merritt, Stanley Ta, Dana Udwin, Amanda Ernlund жана Vijay Narayan; визуалдаштыруу Daniel S. Berman; көзөмөл, долбоорду башкаруу жана каржылоону алуу Jeremy Ratcliff жана Vijay Narayan тарабынан аткарылган.
Негизги методологиялык чектөөлөр: Эксперименталдык ырастоо геномдук токен тизмектери менен чектелген; табигый тил тексти түздөн-түз текшерилген эмес. Explainer архитектурасы үчүн гиперпараметр издөө жүргүзүлгөн эмес. Эксперимент бир негизги Explanandum архитектурасы NT50mге багытталган. Адам катышуучулары менен түшүндүрүлмөлүүлүк изилдөөсү жүргүзүлгөн эмес. LIME салыштыруусу иштөө убактысы жана мисал визуалдар боюнча берилгени менен, бардык заманбап XAI ыкмалары жалпы өлчөмдөр менен салыштырылган кеңири benchmark эмес.
Булактагы дал келбестик жөнүндө эскертүү: Булактагы 6-mer үчүн “six amino acids” деген билдирүү DNA контекстине туура келбейт; genus үчүн маскасыз тең салмакталган тактык текстте %71,65, ал эми 1-таблицада %71,67 деп берилген; тест топтому маалымат бөлүмүндө 103.648, LIME иштөө убактысы бөлүмүндө 103.638 деп жазылган; мындан тышкары 1573 unique taxonomy ID менен 1878 genus санынын ортосундагы байланыш түшүндүрүлгөн эмес. Бул учурлар Verianla тарабынан унчукпай оңдолгон эмес.
Verianla ыкма эскертүүсү: Бул мазмун булак макаланын сап-сап котормосу эмес. Изилдөө маселеси, Explainer–Explanandum түзүлүшү, embedding деңгээлиндеги Hadamard маскалоосу, жоготуу функциялары, NT50m архитектурасы, маалымат топтому, үйрөтүү шарттары, 1-таблицанын жыйынтыктары жана 1–8-сүрөттөрдүн илимий билдирүүлөрү сакталып, өз алдынча жана үйрөтүүчү Кыргызча түзүлүш түзүлгөн. Булакта жок эксперимент жыйынтыгы же көрсөткүч кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген