

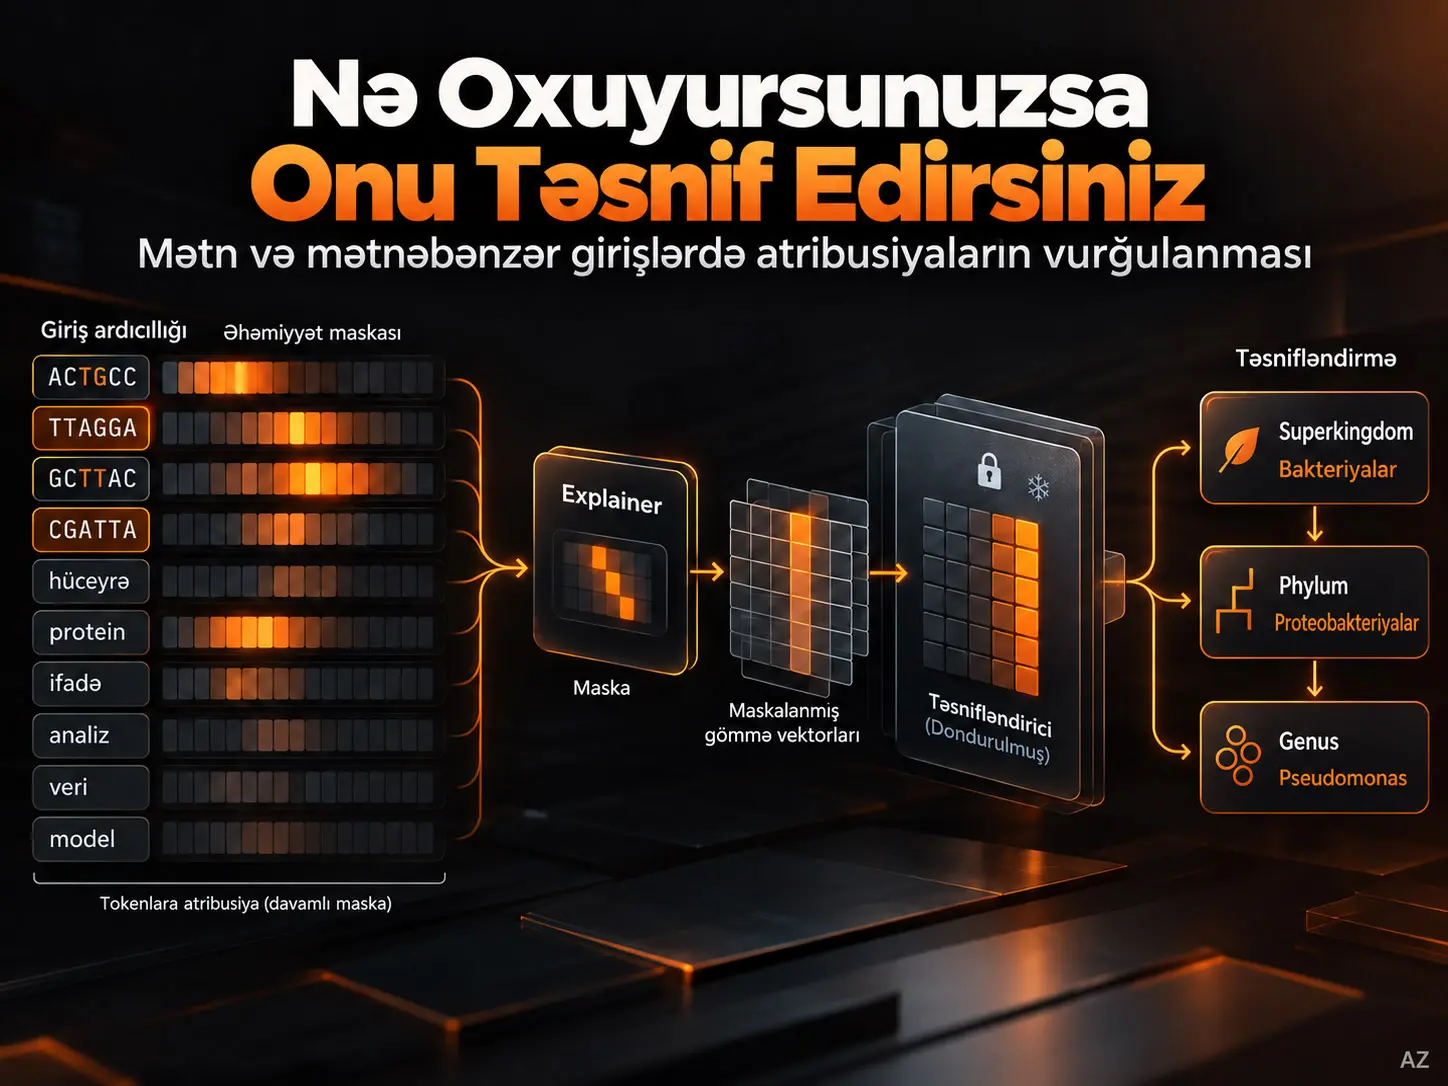
Bu tədqiqatda hazırlanmış Explainer–Explanandum əsaslı izah edilə bilən süni intellekt metodu, token ardıcıllıqlarını təsnif edən süni intellekt modelinin qərarında hansı ardıcıl token bölgələrinin mühüm olduğunu davamlı qiymətli maskalarla müəyyənləşdirməyi hədəfləyən XAI yanaşmasıdır. Metod maskanı diskret token identifikatorlarına birbaşa tətbiq etmək əvəzinə, tokenların davamlı embedding vektorlarına Hadamard hasili ilə tətbiq edir; beləliklə embedding vektorunun istiqaməti qorunarkən böyüklüyü azaldılır. Tədqiqatçılar metodu 50 milyon parametrli Nucleotide Transformer modeli NT50m ilə DNA ardıcıllıqlarının superkingdom, phylum və genus səviyyələrində taksonomik təsnifatı üzərində sınaqdan keçirmişlər. Nəticələr mühüm hesab edilən bölgələr açıq saxlanıldıqda təsnifat performansının böyük ölçüdə qorunduğunu, eyni bölgələr gizlədildikdə isə performansın ciddi şəkildə azaldığını göstərir. Bununla belə, təcrübə təbii dil mətni üzərində deyil, genomik token ardıcıllıqları üzərində aparılmışdır; buna görə təbii dil üçün ümumiləşdirilə bilmə tədqiqatın eksperimental olaraq təsdiqlənmiş nəticəsi deyil.
Əsas təsnifatçı olan Explanandum-un balanslaşdırılmış dəqiqliyi superkingdom, phylum və genus üçün Cədvəl 1-də müvafiq olaraq %99,05, %97,39 və %71,67 kimi bildirilib. Explainer tərəfindən yaradılan davamlı maskalar tətbiq edilərkən bu göstəricilər %98,39, %95,51 və %69,88 səviyyəsində qorunub. Maskalar tərsinə çevrildikdə, yəni Explainer-ın mühüm hesab etdiyi bölgələr gizlədilib mühüm hesab etmədiyi bölgələr açıq saxlanıldıqda balanslaşdırılmış dəqiqlik müvafiq olaraq %46,70, %28,21 və %5,71-ə düşüb. Bu ziddiyyət maskaların təsnifata həqiqətən töhfə verən informasiya bölgələrini ayıra bildiyinə dair tədqiqatın əsas eksperimental sübutudur.
Metodun məqsədi ayrı-ayrı və bir-birindən qopuq token əhəmiyyət balları yaratmaq əvəzinə daha davamlı izah bölgələri formalaşdırmaqdır. Yuvarlaqlaşdırılmış maskalardan alınan açıq bölgələrdə orta fraqment sayı 3,35-dir; ardıcıllıqların təxminən %90-da dörd və ya daha az açıq fraqment mövcuddur. Açıq hissənin orta uzunluğu 51,39 token olub, 250 tokenlik tipik girişin təxminən beşdə birinə uyğundur. Beləliklə, izah bütün ardıcıllığı mühüm elan etmək əvəzinə orta uzunluqlu bir neçə ardıcıl bölgədə cəmləşir.
Tədqiqat həmçinin işləmə vaxtı baxımından LIME ilə praktik müqayisə təqdim edir. Mənbədə LIME-ın hər ardıcıllıq və hər taksonomik səviyyə üçün orta hesabla 26 saniyə tələb etdiyi bildirilir; Explainer-ın təlimi isə 15 saat 40 dəqiqə çəkib və təlim keçmiş Explainer test dəstinin maskalarını təxminən 20 dəqiqədə yaradıb. Buradakı əsas arxitektura fərqi ondan ibarətdir ki, LIME kimi perturbation əsaslı metodlar hesablama yükünün böyük hissəsini izahın yaradılması zamanı daşıdığı halda, bu metod xərcin mühüm hissəsini əvvəlcədən Explainer-ın təlimi zamanı ödəyir.
Token Əsaslı İzah Edilə Bilən Süni İntellektdə Əsas Problem Nədir?
Token əsaslı izah edilə bilən süni intellektdə əsas problem mətn və ya bioloji ardıcıllıq kimi diskret girişlərdə bir tokenın qismən maskalana bilməməsi və güclü transformer təsnifatçılarının qərarlarının həm yerli, həm də uzaq token qarşılıqlı təsirlərinə əsaslana bilməsidir; buna görə görüntülərdə təbii şəkildə işləyən davamlı piksel maskalarını tokenlara birbaşa köçürmək mümkün deyil.
Görüntü təsnifatında pikselin intensivliyi davamlı ədəddir. Məsələn, görüntünün bir bölgəsini 0,25 ilə vurmaq həmin bölgənin vizual təsirini azaldır və əməliyyat diferensiallana bilən olaraq qalır. Buna qarşı token identifikatoru kateqorikdir. Bir sözü və ya DNA 6-mer-ini “0,25 token” halına gətirmək etibarlı tokenizasiya əməliyyatı deyil.
Mətn izahlarında geniş istifadə olunan SHAP və Local Interpretable Model-Agnostic Explanations (LIME) kimi perturbation əsaslı metodlar giriş xüsusiyyətlərini dəyişdirərək onların çıxışa təsirini qiymətləndirir. Mənbə müəlliflərinə görə tokenları əsasən ayrı-ayrılıqda nəzərdən keçirən bu yanaşma uzun ardıcıllıqlarda mühüm bölgələri bir-birindən qopuq tokenlar şəklində göstərə və bütöv şəkildə oxunması çətin olan əhəmiyyət xəritəsi yarada bilər.
Rationalization metodları isə təsnifat qərarını izah etmək üçün girişin müvafiq hissələrini seçə və ya izahlı mətn yarada bilər. Lakin mənbə bəzi generativ rationalization yanaşmalarında izahın girişə sadiq qalmaması və ya hallucination yaratması riskinə, bəzi nəzarətli seçim yanaşmalarında isə təlim mürəkkəbliyinə diqqət çəkir.
Explainer və Explanandum rolları
Metod iki model rolunu ayırır. Explanandum izah edilməsi nəzərdə tutulan və çəkiləri dondurulmuş mövcud təsnifatçıdır. Explainer isə hər giriş tokenı və hər sinif üçün 0 ilə 1 arasında maska qiyməti yaratmaq məqsədilə öyrədilən ikinci neyron şəbəkədir.
Bir sinif üçün yaradılan maska \(s_c\) ilə göstərilir. Həqiqi hədəfə aid siniflərin maskaları element-wise maksimum əməliyyatı ilə birləşdirilərək hədəf maska \(m\) yaradılır. Hədəf olmayan siniflərin maskalarından da non-target maska \(n\) yaradılır. Hədəf maskanın tərsi:
\[ \widetilde{m}=1-m \]
şəklindədir. Bu tamamlayıcı maska xüsusilə “mühüm hesab edilən informasiyanı çıxarsaq, təsnifatçının etibarı həqiqətən pozulurmu?” sualının sınanmasında istifadə olunur.
Mənbə Şəkil 1 nəyi göstərir?
Mənbənin Şəkil 1A paneli görüntülər üçün istifadə edilən ilkin “what-you-see” yanaşmasında Explainer-ın birbaşa görüntü ölçüsündə maskalar yaratdığını göstərir. Şəkil 1B isə məqalənin əsas töhfəsini təqdim edir: token ardıcıllığı əvvəlcə Explainer-a gedərkən izah edilən Explanandum token emalı və embedding hissəsinə, daha sonra gizli/təsnifat qatlarına ayrılır. Maskalar tokenların özlərinə deyil, davamlı embedding təmsillərinə təsir edir.
Bu Tədqiqatda Maska Tokenlara Necə Tətbiq Edilir?
Maska token identifikatorunu dəyişdirmək əvəzinə hər tokenın embedding vektoruna tətbiq edilir; uzunluğu \(d\) olan maska vektoru embedding ölçüsü \(h\) boyunca təkrarlanaraq \(d\times h\) ölçüsünə genişləndirilir və embedding matrisi ilə Hadamard, yəni element-wise hasil həyata keçirilir.
Bir tokenın embedding vektoru \(e\), həmin tokenın maska qiyməti isə \(m_i\) olduqda əməliyyatı konseptual olaraq:
\[ e_{\text{masked}}=m_i e \]
şəklində düşünmək olar. Eyni skalyar qiymət embedding-in bütün komponentlərinə tətbiq edildiyinə görə \(0<m_i<1\) olduqda vektorun böyüklüyü azalır, lakin embedding fəzasındakı istiqaməti dəyişmir. Mənbənin Şəkil 2-sində 0,25 maska qiyməti ilə “apple” embedding vektorunun eyni istiqamətdə, lakin daha qısa hala gəlməsi bu mexanizmi vizuallaşdırır.
Bu seçim iki problemi eyni anda həll edir. Birincisi, diskret tokenlara kəsrli maska tətbiq etmək zərurətini aradan qaldırır. İkincisi, davamlı vurma əməliyyatı sayəsində Explainer-dan Explanandum üzərindən itki funksiyasına qədər olan yol diferensiallana bilən qalır; beləliklə Explanandum dondurulmuş halda yalnız Explainer çəkiləri öyrədilə bilir.
Mean pooling istifadə edildikdə ikinci maskalama niyə lazımdır?
Müəlliflər metodun tətbiqi üçün mühüm şərt müəyyənləşdirirlər: boş ardıcıllığın və ya tam maskalanmış ardıcıllığın təsnifatçı softmax çıxışının təxminən uniform olması gözlənilir. Lakin NT50m-də bütün token gizli vəziyyətləri üzərində mean pooling istifadə edildikdə tam maskalanmış giriş bunu avtomatik təmin etməyib.
Buna görə NT50m təcrübəsində maska yalnız embedding qatından sonra deyil, transformer gizli qatlarının çıxışına da mean pooling-dən əvvəl yenidən tətbiq edilib. Mənbənin Şəkil 3-ü CLS token çıxışından istifadə edən təsnifatçı ilə mean-pooling təsnifatçısı arasındakı bu fərqi göstərir. Müəlliflər təsnifat yalnız CLS çıxışına əsaslanırsa ikinci maskalamanın lazım olmadığını bildirirlər.
İtki funksiyasının ümumi quruluşu
Görüntülər üçün istifadə olunan ikiölçülü maska itkisi token ardıcıllıqları üçün bir ölçüyə endirilib. Ümumi Explainer itkisi mənbədə Tənlik (1) kimi:
\[ L_E(x,Y,S,m,n) = L_c(x,Y,m) + \lambda_e L_e(x,\widetilde m) + \lambda_a L_a(m,n,S) + \lambda_{tv}L_{tv}(m,n) \]
şəklində verilir. Təcrübələrdə:
\[ \lambda_e=\lambda_a=\lambda_{tv}=1 \]
istifadə edilib. Bu əmsallar əlavə hiperparametr axtarışı ilə optimallaşdırılmayıb, istinad edilən Stalder və həmkarlarının tədqiqatındakı qiymətlərə əsasən seçilib.
İzahlayıcı Şəbəkənin İtki Funksiyası Nələri Tarazlaşdırır?
Ümumi itki hədəf təsnifat informasiyasını açıq saxlamaq, mühüm informasiya gizlədildikdə təsnifatçını qeyri-müəyyən hala gətirmək, maskanın nə hər şeyi, nə də heç nəyi göstərməsinin qarşısını almaq və mühüm tokenların bir-birindən qopuq nöqtələr əvəzinə lokal olaraq daha davamlı bölgələr yaratmasını təşviq etmək üçün dörd komponenti birlikdə tarazlaşdırır.
1. Təsnifat itkisi \(L_c\)
Mənbə çoxsinifli təsnifat üçün standart cross-entropy əsaslı termini:
\[ L_c(x,Y,m) = -\frac{1}{C} \sum_{c=1}^{C} \left[ \llbracket c\in Y\rrbracket\log p[c] + \llbracket c\notin Y\rrbracket\log(1-p[c]) \right] \]
şəklində verir. Burada \(C\) siniflərin sayını, \(p[c]\) sinif \(c\) üçün proqnoz ehtimalını, Iverson mötərizəsi \(\llbracket\cdot\rrbracket\) isə şərt doğrudursa 1, yanlışdırsa 0 qiymətini təmsil edir. Bu termin hədəf maskanın təsnifat üçün zəruri informasiyanı açıq saxlamasını təşviq edir.
2. Tamamlayıcı maska entropiyası \(L_e\)
Mənbə Tənlik (3)-də:
\[ L_e = \frac{1}{C} \sum_{c=1}^{C} F(x\odot\widetilde m)[c] \log F(x\odot\widetilde m)[c] \]
ifadəsindən istifadə edir. \(F(\cdot)\) Explanandum-un sinif ehtimallarını yaradır. Tamamlayıcı maska tətbiq edildikdə yalnız aşağı əhəmiyyət verilmiş informasiya açıq qalır. Bu halda çıxış ehtimallarının mümkün qədər uniform hala gəlməsi mühüm informasiya çıxarıldıqda modelin mənalı təsnifat edə bilməməsini təşviq edir.
3. Maska sahəsi itkisi \(L_a\)
Yalnız təsnifat və entropiya terminləri istifadə edilərsə, bir termin maskanı hər şeyi göstərməyə, digəri isə həddən artıq gizlətməyə sövq edə bilər. Sahə itkisi bu iki ifrat arasında tarazlıq yaradır:
\[ L_a(m,n,S) = A(m)+A(n) + \frac{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket B(s_c) }{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket }. \]
\(A(m)\) hədəf maskanın orta qiymətini, \(A(n)\) isə hədəf olmayan maskanın orta qiymətini ifadə edir. Mənbə görünən maska sahəsi üçün \(0<a<b<1\) olmaqla minimum \(a\) və maksimum \(b\) fraksiyalarını müəyyən edir.
Sıralanmış maska qiymətləri üçün sərhəd cəzası Tənlik (5)-də:
\[ B(s) = \frac{1}{Z} \sum_i \max(q_{\min}[i]-q_{\text{mask}}[i],0) + \frac{1}{Z} \sum_i \max(q_{\text{mask}}[i]-q_{\max}[i],0) \]
şəklində müəyyənləşdirilir. \(Z\) ardıcıllığın uzunluğudur. Maska sahəsi \(a\)-dan kiçik və ya \(b\)-dən böyük olduqda cəza yaranır; beləliklə izahın həddindən artıq kiçik və ya həddindən artıq geniş olmasının qarşısı alınmağa çalışılır.
4. Ümumi variasiya itkisi \(L_{tv}\)
Lokal davamlılığı təşviq edən Tənlik (6):
\[ L_{tv} = \frac{1}{Z} \sum_i |m[i]-m[i+1]| + \frac{1}{Z} \sum_i |n[i]-n[i+1]|. \]
Qonşu tokenların maska qiymətləri böyük sıçrayışlar etdikdə bu termin böyüyür. Buna görə Explainer yalnız ayrı-ayrı səpələnmiş tokenları işarələmək əvəzinə qonşu tokenların birlikdə mühüm olduğu daha davamlı bölgələr yaratmağa yönəldilir. Bu davamlılıq tədqiqatın “insan tərəfindən oxuna bilən izah” hədəfinin əsas dizayn elementlərindən biridir.
Explainer arxitekturası
Explainer-ın girişi NT50m ilə eyni 4107 elementlik lüğətdən istifadə edən və ölçüsü 100 olan embedding qatıdır. Bundan sonra ikiqatlı, ikiistiqamətli Long Short-Term Memory (LSTM) şəbəkəsi gəlir. Mənbə hər istiqamət üçün istifadə edilən strukturda 40 node seçildiyini və irəli/geri memory-cell vəziyyətlərinin birləşdirilməsi ilə hər token üçün 160 ölçülü təmsil əldə edildiyini bildirir.
LSTM çıxışını Batch Normalization və sigmoid aktivləşdirməli dense qat izləyir. Sinif sayı \(c\), ardıcıllıq uzunluğu \(d\) olduqda Explainer-ın yekun çıxışı:
\[ d\times c \]
ölçülü maska matrisidir və hər token-sinif cütü üçün 0–1 arasında əhəmiyyət qiyməti yaradır. Explainer arxitekturası üçün hiperparametr axtarışı aparılmayıb. Müəlliflər 40 LSTM node-unu resurs tələbləri ilə balans yaratmaq üçün seçdiklərini bildirirlər.
Tədqiqatın Metodu və Nəticələri
Eksperimental tapşırıq: genomik taksonomik təsnifat
İzah edilən Explanandum modeli əvvəlcə taksonomik DNA təsnifatı üçün fine-tune edilmiş Nucleotide Transformer 50 million parameter model, yəni NT50m-dir. Təsnifat üç iyerarxik səviyyədə həyata keçirilir:
- superkingdom: 4 sinif,
- phylum: 55 sinif,
- genus: 1878 mümkün sinif.
NT50m-nin transformer gizli ölçüsü 512-dir. Token səviyyəsində gizli vəziyyətlər mean pooling ilə sabit uzunluqlu 512 ölçülü təmsilə çevrilir və üç ayrı xətti təsnifat başlığı superkingdom, phylum və genus logitlərini yaradır. Explanandum itkisi üç taksonomik səviyyənin cross-entropy itkilərinin cəmidir.
Verilənlər dəsti
Emaldan sonra mənbə cəmi 5.181.880 DNA ardıcıllığı bildirir.
| Superkingdom | Ardıcıllıq sayı |
|---|---|
| Eukaryota | 2.601.890 |
| Bacteria | 1.828.018 |
| Archaea | 524.276 |
| Viruses | 227.696 |
| Cəmi | 5.181.880 |
Hər ardıcıllığın uzunluğu 1500 base-pair-dir. NT50m-nin 6-mer tokenizasiyasına görə hər giriş təxminən 250 tokendən ibarətdir; bu uzunluq modelin maksimum 1000 tokenlik giriş uzunluğundan aşağıdır.
Mənbədaxili terminologiya qeydi: Metod bölməsində 6-mer izahı bir yerdə “six amino acids grouped together” formasında yazılıb; lakin tədqiqat DNA ardıcıllıqları ilə bağlıdır, nümunə `ACTGCC` nukleotid simvollarından ibarətdir və Şəkil 5-in izahı hər altı base-pair qrupunu bir token kimi müəyyən edir. Verianla bu ifadəni səssiz şəkildə mənbə mətninin düzəldilmiş forması kimi təqdim etmir.
Mənbə həmçinin 1573 “unique taxonomy IDs”, 55 phyla və 1878 genera bildirir. 1573 taxonomy ID ilə 1878 genus sayının necə uzlaşdırılmalı olduğu mətndə izah edilmədiyinə görə bu rəqəmlərin əlaqəsi haqqında əlavə fərziyyə irəli sürülməyib.
Təlim, doğrulama və test bölgüsü
Scikit-learn `train_test_split` əməliyyatı seed 42 ilə tətbiq edilib. Mənbə tam verilənlər dəstinin %2-sini, yəni 103.648 ardıcıllığı, bütün eksperimental işə salmalarda istifadə ediləcək hold-out test dəsti kimi ayırır. Tam verilənlərin əlavə %10-u təlim zamanı validation loss-u izləmək üçün ayrılıb.
Explanandum qalan verilənlər üzərində öyrədilərkən Explainer üçün bütün təlim verilənləri istifadə edilməyib. Explainer təlim dəstindən təsadüfi seçilmiş 239.391 nümunə üzərində öyrədilib; mənbə bunun təlim dəstinin təxminən %4,7-nə uyğun olduğunu və tam verilənlərlə təlimə ehtiyac qoymayan nəticələr verdiyini bildirir.
Təlim avadanlığı və hiperparametrlər
| Element | Qiymət |
|---|---|
| GPU | NVIDIA H100, 80 GB VRAM |
| Python | 3.11.6 |
| PyTorch | 2.5.1 |
| Learning rate | 0,0002 |
| Learning-rate scheduler | Cosine |
| Explanandum epoch | 5 |
| Explanandum batch size | 128 |
| Explainer planlaşdırılan epoch | 50 |
| Explainer faktiki epoch | 38; early stopping |
| Explainer batch size | 48 |
| Precision | FP32 |
| Weight decay | 0 |
| Warm-up | Yox |
| Random seed | 42 |
| LIME tətbiqi | Captum 0.7.0 |
| Scikit-learn | 1.6.1 |
Maskaların Həqiqətən Mühüm Token Bölgələrini Qoruduğu Necə Sınaqdan Keçirildi?
Tədqiqat maskaların doğruluğunu mühüm hesab edilən tokenları açıq saxlayan maskalanmış girişlərlə bunun əksini edən inverted-mask girişlərinin təsnifat performansını müqayisə etməklə sınaqdan keçirib; maskalanmış girişlərdə performans böyük ölçüdə qorunarkən, mühüm bölgələr gizlədildikdə hər üç taksonomik səviyyədə balanslaşdırılmış dəqiqlik kəskin şəkildə azalıb.
| Şərt | Superkingdom | Phylum | Genus |
|---|---|---|---|
| Explanandum, maskasız | %99,05 | %97,39 | %71,67 |
| Davamlı maskalar | %98,39 | %95,51 | %69,88 |
| Tərs maskalar | %46,70 | %28,21 | %5,71 |
| Yuvarlaqlaşdırılmış maskalar | %76,42 | %52,60 | %40,86 |
| Tərs yuvarlaqlaşdırılmış maskalar | %44,85 | %26,20 | %4,92 |
| Orta əlaqəli fraqment | %69,98 | %49,92 | %36,32 |
| Orta əlaqəsiz fraqment | %47,13 | %31,68 | %9,58 |
Bu cədvəl iki ayrı sübut təqdim edir. Birincisi, davamlı maskalar tətbiq edildikdə maskasız Explanandum ilə müqayisədə təsnifat performansı yalnız məhdud dərəcədə azalır. İkincisi, maskalar tərsinə çevrilərək Explainer-ın mühüm gördüyü hissələr aradan qaldırıldıqda performans xüsusilə genus səviyyəsində %69,88-dən %5,71-ə qədər enir.
Mənbədaxili rəqəm qeydi: Cədvəl 1 maskasız genus dəqiqliyini %71,67 kimi göstərdiyi halda, ondan dərhal əvvəlki və sonrakı izah mətni %71,65 qiymətindən istifadə edir. Cədvəl burada mənbədəki forması ilə %71,67 olaraq verilib və fərq ayrıca görünən saxlanılıb.
Yuvarlaqlaşdırılmış maskalar niyə ayrıca sınaqdan keçirildi?
Davamlı maskalar 0 ilə 1 arasında dəyişir. Tədqiqatçılar izahı daha kəskin etmək üçün qiymətləri 0 və ya 1-ə yuvarlaqlaşdıraraq ikili maskaları da sınaqdan keçiriblər. Yuvarlaqlaşdırma informasiya itkisinə səbəb olduğundan dəqiqlik davamlı maskalarla müqayisədə azalsa da, tərs yuvarlaqlaşdırılmış maskalarla müqayisədə nəzərəçarpacaq dərəcədə yüksək qalır. Müəlliflər bunu mühüm bölgələrin kobud ikili maskalama şəraitində belə mənalı təsnifat informasiyası daşıması kimi şərh edirlər.
Əlaqəli və əlaqəsiz fraqmentlərin ayrıca təsnifatı
Maskalanmış boşluqların model üzərində istəmədən təsnifat ipucu yaradıb-yaratmadığını sınamaq üçün yuvarlaqlaşdırılmış maskalar ardıcıl açıq və qapalı fraqmentlərə bölünüb. Hər fraqment təkbaşına Explanandum-a verilib. Əlaqəli fraqmentlər superkingdom, phylum və genus üçün müvafiq olaraq %69,98, %49,92 və %36,32 balanslaşdırılmış dəqiqlik verdiyi halda, əlaqəsiz fraqmentlər %47,13, %31,68 və %9,58 verib.
Bu nəticə təsnifatın yalnız maskalanmış ardıcıllıqdakı boşluqların həndəsəsindən qaynaqlanmadığı və Explainer-ın açıq saxladığı real ardıcıllıq fraqmentlərinin daha çox taksonomik informasiya daşıdığı şərhini dəstəkləyir.
Maskalar ardıcıllığın nə qədərini açıq saxlayır?
Test dəsti üzrə maska qiymətlərinin ortalaması 0,73 kimi verilib və bütün token maska qiymətlərinin %67,28-i 0,5-dən yuxarıdır. Şəkil 6A bu paylanmanı histoqram kimi, Şəkil 6B isə token mövqeyinə görə orta maska qiymətini göstərir. Mənbə ardıcıllığın əvvəlində və ortasında təkrarlanan yüksək-əhəmiyyətli bölgələrin müşahidə edildiyini, lakin minimum və maksimum qiymətlərin nümunələr arasında geniş dəyişdiyini bildirir.
Yuvarlaqlaşdırılmış maskalarda açıq bölgələrin sayı orta hesabla 3,35 fraqmentdir. Ardıcıllıqların təxminən %90-da dörd və ya daha az açıq fraqment var. Mənbə həmçinin yalnız %0,4-lük hissədə heç bir maskalanmış token olmadığını bildirir.
Açıq hissənin orta uzunluğu 51,39 token kimi bildirilib; bəzi açıq hissələr 200 tokeni keçir. 250 tokenlik tipik ardıcıllıq uzunluğu ilə müqayisədə müəlliflər bunun təxminən %20-lik hissəyə uyğun olduğunu bildirirlər. Beləliklə, izah bütün ardıcıllığı işarələmək əvəzinə orta uzunluqlu bir neçə davamlı bölgə yaradır.
LIME ilə işləmə vaxtı və şərh edilə bilmə müqayisəsi
Mənbə NT50m-nin Evolutionary Scale Modeling əsaslı quruluşunun serializasiya xüsusiyyətlərinə görə LIME, transformer-interpret və SHAP Python paketlərini tətbiq etməyin çətin olduğunu bildirir. Tam tətbiq edilmiş müqayisəli metod LIME-dır.
LIME-ın orta işləmə vaxtı mənbədə hər ardıcıllıq və hər taksonomik səviyyə üçün təxminən 26 saniyə kimi verilib. Müəlliflər bu vaxtın bütün test dəstinə ardıcıl tətbiq edildiyi halda aylar tələb edə biləcəyini bildirirlər.
Təklif edilən Explainer-ın təlimi 15 saat 40 dəqiqə çəkib; təlim keçmiş Explainer-ın test dəsti üçün maskaları yaratması təxminən 20 dəqiqə tələb edib. Bu müqayisədə iki metod eyni xərc quruluşuna malik deyil: Explainer bir dəfə öyrədilərək sonrakı girişlər üçün birbaşa maska yaradır, LIME isə izahın yaradılması zamanı hər nümunə üçün perturbation əməliyyatlarını təkrar edir.
Mənbədaxili rəqəm qeydi: verilənlər bölməsi test dəstini 103.648 ardıcıllıq kimi göstərdiyi halda, LIME işləmə vaxtı bölməsində 103.638 ardıcıllıq yazılıb. Verianla bu on ardıcıllıq fərqini mənbənin hansı rəqəmi nəzərdə tutduğunu təxmin etməklə düzəltməyib.
Şəkil 8-də LIME-ın bir nümunə üzrə müsbət və mənfi əhəmiyyət qiymətləri ardıcıllığın müxtəlif bölgələrinə yayılmış çoxsaylı rəngli tokenlar kimi görünür. Müəlliflər yalnız müsbət və ya 0,5-dən yuxarı müsbət töhfələr göstərildikdə belə işarələrin bir-birindən uzaq qalmasını şərh edilə bilmə baxımından problem hesab edirlər. Buna qarşı Explainer maskaları daha davamlı bölgələr yaratmaq üçün dizayn edilib.
Bu Metod Təbii Dil Mətni Üzərində Birbaşa Təsdiqlənibmi?
Xeyr. Tədqiqat metodu token əsaslı girişlərə və mətnə ümumiləşdirilə bilən XAI yanaşması kimi formalaşdırır, lakin dərc olunmuş eksperimental təsdiq NT50m ilə DNA/nukleotid ardıcıllıqlarının taksonomik təsnifatı üzərində aparılıb; təbii dil təsnifatı tədqiqatın gələcək araşdırma istiqamətlərindən biridir.
Bu fərq mühümdür. DNA 6-mer-ləri və təbii dil tokenları hər ikisi diskret token ardıcıllığı olsa da, onların semantik strukturları, lüğətləri, kontekst əlaqələri, model təlim hədəfləri və insanın izahı qiymətləndirmə üsulu eyni deyil. Mənbə bu fərqləri müqayisə edən təbii dil təcrübələri təqdim etmir.
Eyni şəkildə tədqiqat yaradılmış maskaların “human-readable” olmasını arxitekturanın davamlılıq xüsusiyyəti və nümunə vizuallar üzərindən müdafiə edir; lakin izahların insanlar tərəfindən daha düzgün, daha sürətli və ya daha etibarlı başa düşüldüyünü ölçən nəzarətli istifadəçi təcrübəsi aparılmayıb. Buna görə “insanlar üçün daha şərh edilə bilən olduğu klinik və ya psixometrik olaraq sübut edilib” formasında nəticə çıxarmaq olmaz.
Tədqiqatın dəstəklədiyi nəticələr
Tədqiqat embedding səviyyəsində davamlı maskalar öyrənən Explainer-ın NT50m genomik təsnifatçısı üçün təsnifat informasiyasını qoruyan davamlı token bölgələri yarada bildiyini dəstəkləyir. Maskalanmış ardıcıllıqlarda yüksək dəqiqliyin qorunması və tərs maskalarda dəqiqliyin kəskin azalması maskaların təsnifat baxımından informasiya daşıyan bölgələrlə əlaqəli olduğunu göstərir.
Tədqiqat həmçinin hesablama xərcinin izah anından Explainer-ın təlim mərhələsinə keçirilməsinin çox böyük test dəstləri üzərində təkrar-təkrar izah yaradılarkən üstünlük verə biləcəyini göstərən tətbiqi nümunə təqdim edir.
Tədqiqatın dəstəkləmədiyi nəticələr
Tədqiqat metodun bütün təbii dil tapşırıqlarında SHAP və ya LIME-dan daha düzgün izahlar yaratdığını göstərmir. Təbii dil verilənlər dəsti üzərində kəmiyyət qiymətləndirməsi aparılmayıb və LIME-dan başqa əsas XAI metodları ilə tam miqyaslı benchmark təqdim edilməyib.
Metodun bütün transformer, recurrent və ya başqa token təsnifatçı arxitekturalarında eyni performansı verəcəyi eksperimental olaraq sübut edilməyib. Müəlliflər arxitektura baxımından ümumi tətbiq edilə bilmə irəli sürsələr də, dərc edilmiş təcrübə NT50m üzərində cəmləşir və mean-pooling arxitekturasının xüsusi olaraq ikinci maskalama tələb etdiyi göstərilib.
Həmçinin maskalar təsnifatçı üçün mühüm xüsusiyyət bölgələrini işarələyir; bunların bioloji baxımdan səbəbkar motivlər, funksional genomik bölgələr və ya real bioloji mexanizmlər olduğu bu təcrübədən çıxarıla bilməz. Model atribusiyası ilə bioloji səbəbiyyət bir-birindən ayrılmalıdır.
Mənbə və Metod Qeydi
Orijinal tədqiqat: What You Read Is What You Classify: Highlighting Attributions to Text and Text-like Inputs
Müəlliflər: Daniel S. Berman; Brian Merritt; Stanley Ta; Dana Udwin; Amanda Ernlund; Jeremy Ratcliff; Vijay Narayan.
Məsul müəllif: Vijay Narayan.
Qurumlar: Johns Hopkins Applied Physics Laboratory, Laurel, Maryland, ABŞ; Google DeepMind, London, Birləşmiş Krallıq.
Jurnal: AI.
Nəşriyyat: MDPI.
Mənbə növü: Orijinal tədqiqat məqaləsi; izah edilə bilən süni intellekt və maşın öyrənməsi üzrə metod hazırlama/hesablamalı eksperiment tədqiqatı.
Nəşr məlumatı: AI 2026, cild 7, say 5, məqalə 168.
DOI: 10.3390/ai7050168
Təqdim: 25 Mart 2026.
Reviziya: 20 Aprel 2026.
Qəbul: 23 Aprel 2026.
Nəşr: 13 May 2026.
Preprint: arXiv:2602.24149. Bu qeyd dərc olunmuş tədqiqatın əvvəlki versiyasıdır; ayrıca müstəqil tədqiqat kimi qiymətləndirilməyib.
Rəyçilik: Rəyli elmi jurnalda dərc olunmuş məqalə.
Lisenziya: Creative Commons Attribution (CC BY), açıq giriş.
Maliyyələşdirmə: Tədqiqat U.S. Centers for Disease Control and Prevention, Office of Readiness and Response tərəfindən Contract #75D30124C20202 çərçivəsində dəstəklənib.
İnstitusional etika şurası: Tətbiq edilmir.
Məlumatlandırılmış razılıq: Tətbiq edilmir.
Verilənlərin əlçatanlığı: Tədqiqatda istifadə olunan əsas verilənlər Mock və həmkarlarının açıq girişli tədqiqatının əlavə materialındadır. Müəlliflər həmçinin verilənlərin bölünməsi, Explainer və Explanandum təlimi və inference üçün istifadə olunan kodun açıq GitHub deposunda dərc edildiyini bildirirlər.
Təşəkkür: Müəlliflər tədqiqatın tamamlanması zamanı verdiyi töhfələrə və proqramlaşdırma maneələrinin aradan qaldırılmasına köməyinə görə Molly Gallagher-a təşəkkür edirlər.
Maraqların toqquşması: Jeremy Ratcliff tədqiqata töhfə verdiyi zaman Johns Hopkins Applied Physics Laboratory əməkdaşı idi. Digər müəlliflər potensial kommersiya və ya maliyyə maraqlarının toqquşması yarada biləcək əlaqələrinin olmadığını bildiriblər.
Müəllif töhfələri: Konseptuallaşdırma Daniel S. Berman, Dana Udwin və Amanda Ernlund; metodologiya Daniel S. Berman və Amanda Ernlund; proqram təminatı Daniel S. Berman və Vijay Narayan; doğrulama, formal analiz və araşdırma Daniel S. Berman; resurslar Brian Merritt; verilənlərin kurasiyası Brian Merritt, Stanley Ta və Daniel S. Berman; ilkin qaralama Daniel S. Berman, Brian Merritt, Stanley Ta və Vijay Narayan; nəzərdən keçirmə və redaktə Daniel S. Berman, Brian Merritt, Stanley Ta, Dana Udwin, Amanda Ernlund və Vijay Narayan; vizuallaşdırma Daniel S. Berman; nəzarət, layihənin idarə edilməsi və maliyyənin əldə edilməsi Jeremy Ratcliff və Vijay Narayan tərəfindən həyata keçirilib.
Əsas metodoloji məhdudiyyətlər: Eksperimental təsdiq genomik token ardıcıllıqları ilə məhdudlaşır; təbii dil mətni birbaşa sınaqdan keçirilməyib. Explainer arxitekturası üçün hiperparametr axtarışı aparılmayıb. Təcrübə bir əsas Explanandum arxitekturası olan NT50m üzərində cəmləşir. İnsan iştirakçılarla şərh edilə bilmə tədqiqatı aparılmayıb. LIME müqayisəsi işləmə vaxtı və nümunə vizuallar baxımından təqdim edilsə də, bütün müasir XAI metodlarının ortaq meyarlarla müqayisə edildiyi əhatəli benchmark deyil.
Mənbədaxili uyğunsuzluq qeydi: Mənbədə 6-mer üçün “six amino acids” ifadəsi DNA konteksti ilə uyğun gəlmir; genus üçün maskasız balanslaşdırılmış dəqiqlik mətndə %71,65, Cədvəl 1-də isə %71,67 kimi verilir; test dəsti verilənlər bölməsində 103.648, LIME işləmə vaxtı bölməsində 103.638 kimi yazılıb; həmçinin 1573 unique taxonomy ID ilə 1878 genus sayları arasındakı əlaqə izah edilməyib. Bu məqamlar Verianla tərəfindən səssiz şəkildə düzəldilməyib.
Verianla metod qeydi: Bu məzmun mənbə məqalənin sətir-sətir tərcüməsi deyil. Tədqiqat problemi, Explainer–Explanandum quruluşu, embedding səviyyəsində Hadamard maskalaması, itki funksiyaları, NT50m arxitekturası, verilənlər dəsti, təlim şərtləri, Cədvəl 1 nəticələri və Şəkil 1–8-in elmi mesajları qorunaraq müstəqil və öyrədici Azərbaycan dilində quruluş yaradılıb. Mənbədə olmayan eksperimental nəticə və ya performans göstəricisi əlavə edilməyib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib