

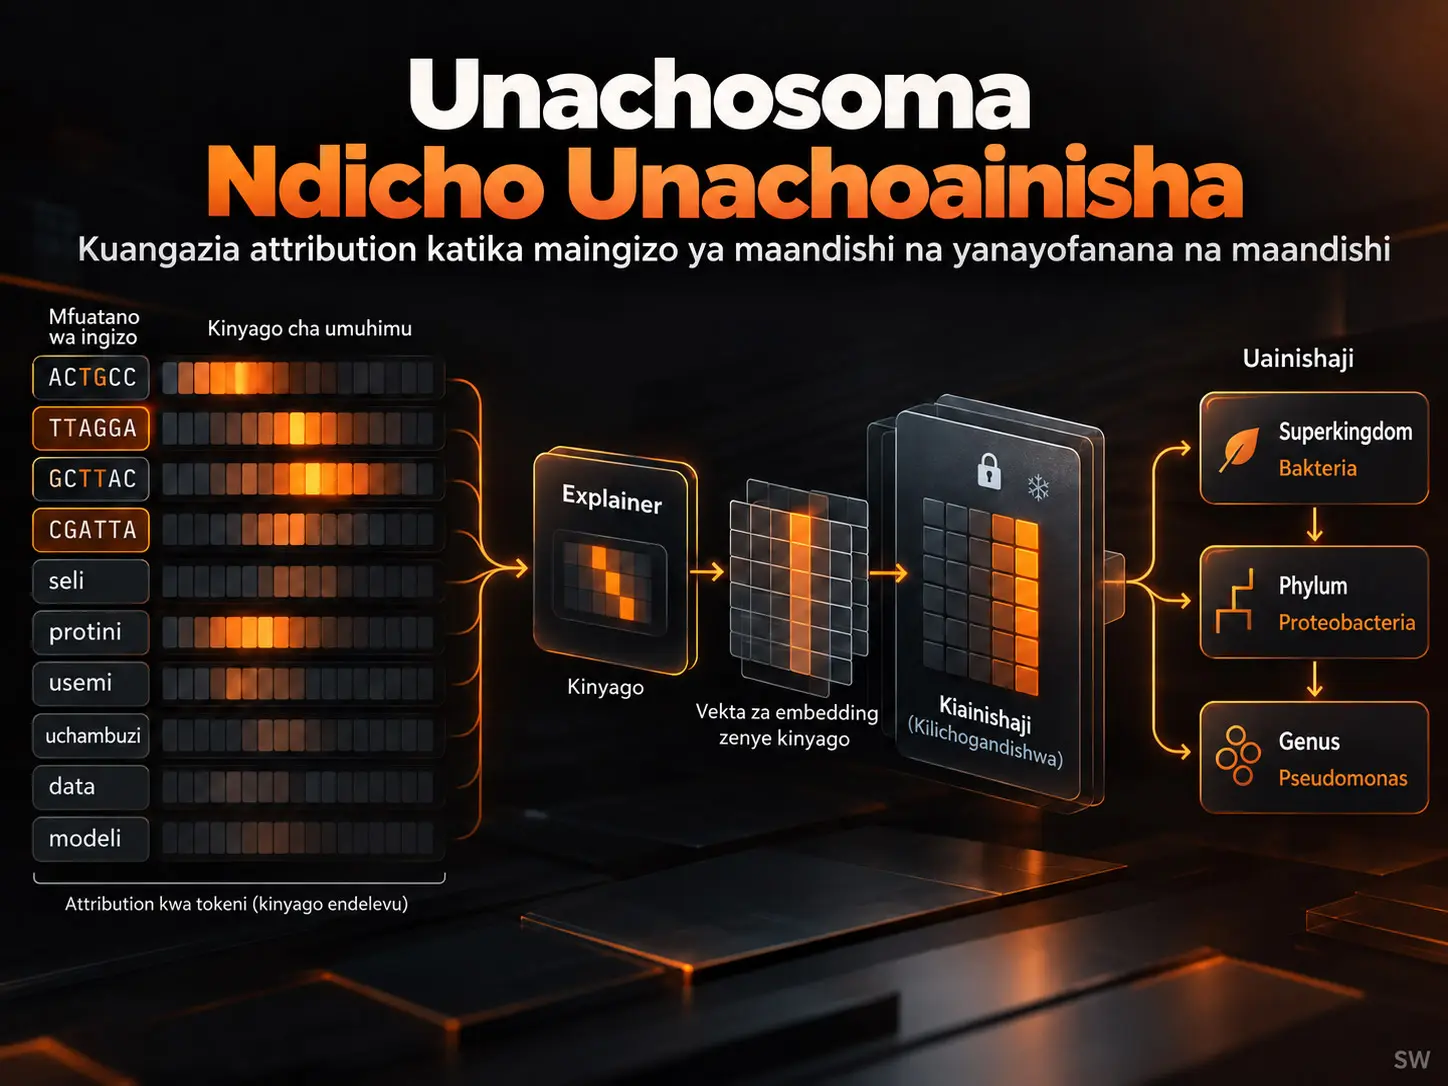
Mbinu ya akili bandia inayoelezeka yenye msingi wa Explainer–Explanandum iliyotengenezwa katika utafiti huu ni mkabala wa XAI unaolenga kubainisha, kwa kutumia vinyago vyenye thamani endelevu, ni maeneo gani yanayofuatana ya token ni muhimu katika uamuzi wa modeli ya akili bandia inayotabiri makundi ya mifuatano ya token. Badala ya kutumia kinyago moja kwa moja kwenye vitambulisho bainifu vya token, mbinu hutumia kinyago kwenye vekta endelevu za embedding za token kwa zao la Hadamard; kwa njia hiyo mwelekeo wa vekta ya embedding huhifadhiwa huku ukubwa wake ukipunguzwa. Watafiti waliijaribu mbinu kwa kutumia modeli ya Nucleotide Transformer yenye vigezo milioni 50, NT50m, katika uainishaji wa kitaksonomia wa mifuatano ya DNA katika viwango vya superkingdom, phylum na genus. Matokeo yanaonyesha kuwa utendaji wa uainishaji huhifadhiwa kwa kiwango kikubwa maeneo yanayochukuliwa kuwa muhimu yanapoachwa wazi, huku utendaji ukishuka sana maeneo hayo hayo yanapofichwa. Hata hivyo, jaribio halikufanywa kwenye maandishi ya lugha asilia bali kwenye mifuatano ya token za kijenomu; kwa hiyo uwezo wa kujumlisha kwa lugha asilia si matokeo yaliyothibitishwa kwa majaribio katika utafiti huu.
Usahihi uliosawazishwa wa Explanandum, ambaye ndiye mmainishaji mkuu, uliripotiwa katika Jedwali 1 kuwa %99,05, %97,39 na %71,67 kwa superkingdom, phylum na genus mtawalia. Vinyago endelevu vilivyotengenezwa na Explainer vilipotumika, thamani hizi zilihifadhiwa katika %98,39, %95,51 na %69,88. Vinyago vilipogeuzwa, yaani maeneo ambayo Explainer iliona kuwa muhimu yakafichwa huku yale yasiyo muhimu yakiachwa wazi, usahihi uliosawazishwa ulishuka hadi %46,70, %28,21 na %5,71 mtawalia. Tofauti hii ndiyo ushahidi mkuu wa kimajaribio wa utafiti kwamba vinyago vinaweza kutenganisha maeneo ya taarifa yanayochangia kwa kweli katika uainishaji.
Lengo la mbinu ni kuunda maeneo ya maelezo yaliyo endelevu zaidi badala ya kutoa alama za umuhimu wa token moja moja na zisizoungana. Katika maeneo yaliyo wazi yaliyopatikana kutoka kwa vinyago vilivyokadiriwa, wastani wa idadi ya vipande ni 3,35; takribani %90 ya mifuatano ina vipande vinne au vichache vilivyo wazi. Urefu wa wastani wa sehemu iliyo wazi ni token 51,39, sawa na takribani moja ya tano ya ingizo la kawaida lenye token 250. Kwa hiyo, maelezo huzingatia maeneo machache yanayofuatana ya urefu wa kati badala ya kutangaza mfuatano mzima kuwa muhimu.
Utafiti pia unatoa ulinganisho wa vitendo na LIME kwa upande wa muda wa utekelezaji. Chanzo kinaripoti kuwa LIME huchukua wastani wa sekunde 26 kwa kila mfuatano na kila kiwango cha taksonomia, ilhali mafunzo ya Explainer yalichukua saa 15 dakika 40 na Explainer iliyofunzwa ilizalisha vinyago vya mkusanyo wa majaribio kwa takribani dakika 20. Tofauti kuu ya usanifu hapa ni kwamba mbinu zinazotegemea perturbation kama LIME hubeba sehemu kubwa ya mzigo wa ukokotozi wakati wa kutengeneza maelezo, wakati mbinu hii hulipia mapema sehemu muhimu ya gharama wakati wa mafunzo ya Explainer.
Tatizo Kuu katika Akili Bandia Inayoelezeka Inayotegemea Token ni Lipi?
Tatizo kuu katika akili bandia inayoelezeka inayotegemea token ni kwamba token haiwezi kufichwa kwa sehemu katika maingizo bainifu kama maandishi au mfuatano wa kibayolojia, na maamuzi ya viainishaji vyenye nguvu vya transformer yanaweza kutegemea mwingiliano wa token wa karibu na wa mbali; kwa hiyo vinyago endelevu vya pikseli vinavyofanya kazi kwa kawaida kwenye picha haviwezi kuhamishwa moja kwa moja kwenda kwenye token.
Katika uainishaji wa picha, ukali wa pikseli ni namba endelevu. Kwa mfano, kuzidisha eneo la picha kwa 0,25 hupunguza athari yake ya kuona na operesheni hubaki kuwa differentiable. Kwa upande mwingine, kitambulisho cha token ni cha kikategoria. Kubadilisha neno au DNA 6-mer kuwa “token 0,25” si operesheni halali ya tokenization.
Mbinu zinazotegemea perturbation kama SHAP na Local Interpretable Model-Agnostic Explanations (LIME), zinazotumiwa sana katika maelezo ya maandishi, hutathmini athari za vipengele vya ingizo kwenye matokeo kwa kuvibadilisha. Kwa mujibu wa waandishi wa chanzo, mkabala huu ambao kwa kawaida hushughulikia token moja moja unaweza kuonyesha maeneo muhimu katika mifuatano mirefu kama token zilizotengana na hivyo kutengeneza ramani ya umuhimu ambayo ni ngumu kusoma kwa ujumla.
Mbinu za Rationalization zinaweza kuchagua sehemu husika za ingizo au kutengeneza maandishi ya maelezo ili kufafanua uamuzi wa uainishaji. Hata hivyo, chanzo kinaelekeza kwenye hatari ya maelezo kutokuwa mwaminifu kwa ingizo au kuzalisha hallucination katika baadhi ya mikabala ya generative rationalization, na pia kwenye ugumu wa mafunzo katika baadhi ya mikabala ya uteuzi unaosimamiwa.
Majukumu ya Explainer na Explanandum
Mbinu hutenganisha majukumu mawili ya modeli. Explanandum ni mmainishaji uliopo unaotakiwa kuelezwa na ambao uzani wake umefungwa. Explainer ni mtandao wa pili wa neva unaofunzwa kutengeneza thamani ya kinyago kati ya 0 na 1 kwa kila token ya ingizo na kila darasa.
Kinyago kinachotengenezwa kwa darasa moja huonyeshwa kwa \(s_c\). Vinyago vya madarasa yanayohusiana na lengo halisi huunganishwa kwa operesheni ya element-wise maximum ili kuunda kinyago lengwa \(m\). Kutoka kwenye vinyago vya madarasa yasiyo lengwa pia hutengenezwa kinyago cha non-target \(n\). Kinyume cha kinyago lengwa ni:
\[ \widetilde{m}=1-m \]
Kinyago hiki cha nyongeza hutumiwa hasa kujaribu swali: “tukiondoa taarifa inayochukuliwa kuwa muhimu, je, uhakika wa mmainishaji unaharibika kweli?”
Kielelezo 1 cha chanzo kinaonyesha nini?
Paneli ya Kielelezo 1A cha chanzo inaonyesha kuwa katika mkabala wa awali wa “what-you-see” uliotumiwa kwa picha, Explainer hutengeneza vinyago moja kwa moja katika vipimo vya picha. Kielelezo 1B kinaonyesha mchango mkuu wa makala: mfuatano wa token huenda kwanza kwa Explainer, huku Explanandum inayofafanuliwa ikigawanywa katika sehemu ya usindikaji wa token na embedding, kisha katika tabaka za siri/uainishaji zinazofuata. Vinyago havifanyi kazi kwenye token zenyewe bali kwenye uwakilishi endelevu wa embedding.
Katika Utafiti Huu Kinyago Kinatumika kwa Token Jinsi Gani?
Badala ya kubadilisha kitambulisho cha token, kinyago hutumika kwenye vekta ya embedding ya kila token; vekta ya kinyago yenye urefu \(d\) hurudiwa katika kipimo cha embedding \(h\), kupanuliwa hadi ukubwa wa \(d\times h\), kisha kuzidishwa na matriki ya embedding kwa Hadamard, yaani element-wise multiplication.
Ikiwa vekta ya embedding ya token ni \(e\) na thamani ya kinyago ya token hiyo ni \(m_i\), operesheni inaweza kufikiriwa kimawazo kama:
\[ e_{\text{masked}}=m_i e \]
Kwa sababu thamani ileile ya scalar hutumika kwenye vipengele vyote vya embedding, wakati \(0<m_i<1\) ukubwa wa vekta hupungua lakini mwelekeo wake katika nafasi ya embedding haubadiliki. Katika Kielelezo 2 cha chanzo, vekta ya embedding ya “apple” yenye thamani ya kinyago 0,25 kuwa katika mwelekeo uleule lakini fupi zaidi inaonyesha kwa picha utaratibu huu.
Uteuzi huu hutatua matatizo mawili kwa wakati mmoja. Kwanza, unaondoa ulazima wa kutumia kinyago cha sehemu kwenye token bainifu. Pili, kwa sababu operesheni ya kuzidisha endelevu ni differentiable, njia kutoka Explainer kupitia Explanandum hadi kwenye loss function hubaki differentiable; hivyo, Explanandum inapofungwa, ni uzani wa Explainer pekee unaoweza kufunzwa.
Kwa nini ni lazima kuficha mara ya pili wakati mean pooling inatumiwa?
Waandishi wanaweka sharti muhimu kwa matumizi ya mbinu: matokeo ya softmax ya mmainishaji kwa mfuatano tupu au mfuatano uliofichwa kabisa yanatarajiwa kuwa takribani uniform. Hata hivyo, katika NT50m, mean pooling ilipotumiwa juu ya hali zote zilizofichika za token, ingizo lililofichwa kabisa halikutoa hali hii kiotomatiki.
Kwa hiyo, katika jaribio la NT50m, kinyago hakikutumika tu baada ya tabaka la embedding bali pia kilitumika tena kwenye matokeo ya tabaka zilizofichika za transformer kabla ya mean pooling. Kielelezo 3 cha chanzo kinaonyesha tofauti hii kati ya mmainishaji unaotumia matokeo ya CLS token na mmainishaji wa mean-pooling. Waandishi wanasema kuwa ikiwa uainishaji unategemea matokeo ya CLS pekee, kuficha mara ya pili hakuhitajiki.
Muundo wa jumla wa loss function
Hasara ya kinyago ya vipimo viwili inayotumiwa kwa picha imepunguzwa hadi kipimo kimoja kwa mifuatano ya token. Hasara ya jumla ya Explainer imetolewa katika chanzo kama Mlinganyo (1):
\[ L_E(x,Y,S,m,n) = L_c(x,Y,m) + \lambda_e L_e(x,\widetilde m) + \lambda_a L_a(m,n,S) + \lambda_{tv}L_{tv}(m,n) \]
Katika majaribio:
\[ \lambda_e=\lambda_a=\lambda_{tv}=1 \]
ilitumika. Vigezo hivi havikuboreshwa kwa utafutaji wa ziada wa hyperparameter; vilichaguliwa kwa kutegemea thamani katika utafiti wa Stalder na wenzake uliotumiwa kama chanzo.
Loss Function ya Mtandao wa Kueleza Inasawazisha Nini?
Hasara ya jumla husawazisha vipengele vinne pamoja: kuweka wazi taarifa ya uainishaji lengwa, kufanya mmainishaji kutokuwa na uhakika taarifa muhimu inapofichwa, kuzuia kinyago kuonyesha kila kitu au kutokuonyesha chochote, na kuhimiza token muhimu kuunda maeneo ya karibu yaliyo endelevu zaidi badala ya alama zilizotengana.
1. Hasara ya uainishaji \(L_c\)
Chanzo kinatoa kipengele cha kawaida kinachotegemea cross-entropy kwa uainishaji wa madarasa mengi kama:
\[ L_c(x,Y,m) = -\frac{1}{C} \sum_{c=1}^{C} \left[ \llbracket c\in Y\rrbracket\log p[c] + \llbracket c\notin Y\rrbracket\log(1-p[c]) \right] \]
Hapa \(C\) ni idadi ya madarasa, \(p[c]\) ni uwezekano wa utabiri kwa darasa \(c\), na mabano ya Iverson \(\llbracket\cdot\rrbracket\) yana thamani 1 ikiwa sharti ni kweli na 0 ikiwa ni uongo. Kipengele hiki huhimiza kinyago lengwa kuacha wazi taarifa inayohitajika kwa uainishaji.
2. Entropia ya kinyago cha nyongeza \(L_e\)
Katika Mlinganyo (3), chanzo kinatumia:
\[ L_e = \frac{1}{C} \sum_{c=1}^{C} F(x\odot\widetilde m)[c] \log F(x\odot\widetilde m)[c] \]
Hapa \(F(\cdot)\) hutengeneza uwezekano wa madarasa wa Explanandum. Kinyago cha nyongeza kinapotumika, ni taarifa zilizopewa umuhimu mdogo pekee zinazobaki wazi. Katika hali hii, kufanya uwezekano wa matokeo uwe uniform kadiri iwezekanavyo huhimiza modeli ishindwe kufanya uainishaji wenye maana taarifa muhimu inapoondolewa.
3. Hasara ya eneo la kinyago \(L_a\)
Ikiwa vipengele vya uainishaji na entropia pekee vinatumika, kimoja kinaweza kusukuma kinyago kuonyesha kila kitu, na kingine kukisukuma kuficha mengi kupita kiasi. Hasara ya eneo huleta usawaziko kati ya hali hizi mbili:
\[ L_a(m,n,S) = A(m)+A(n) + \frac{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket B(s_c) }{ \sum_{c=1}^{C} \llbracket c\in Y\rrbracket }. \]
\(A(m)\) inaonyesha thamani ya wastani ya kinyago lengwa, na \(A(n)\) thamani ya wastani ya kinyago kisicho lengwa. Chanzo kinafafanua eneo la kinyago kinachoonekana kwa namna ambayo \(0<a<b<1\), kwa sehemu ya chini \(a\) na ya juu \(b\).
Kwa thamani za kinyago zilizopangwa, adhabu ya mipaka katika Mlinganyo (5) imefafanuliwa kama:
\[ B(s) = \frac{1}{Z} \sum_i \max(q_{\min}[i]-q_{\text{mask}}[i],0) + \frac{1}{Z} \sum_i \max(q_{\text{mask}}[i]-q_{\max}[i],0) \]
\(Z\) ni urefu wa mfuatano. Adhabu hutokea eneo la kinyago linapokuwa chini ya \(a\) au juu ya \(b\); kwa njia hii, mfumo hujaribu kuzuia maelezo kuwa madogo kupita kiasi au mapana kupita kiasi.
4. Hasara ya total variation \(L_{tv}\)
Mlinganyo (6) unaohimiza mwendelezo wa karibu ni:
\[ L_{tv} = \frac{1}{Z} \sum_i |m[i]-m[i+1]| + \frac{1}{Z} \sum_i |n[i]-n[i+1]|. \]
Kipengele hiki huongezeka wakati thamani za kinyago za token jirani zina miruko mikubwa. Kwa hiyo, Explainer huelekezwa kuunda maeneo yaliyo endelevu zaidi ambapo token jirani ni muhimu pamoja, badala ya kuashiria token zilizotawanyika moja moja. Mwendelezo huu ni mojawapo ya vipengele vya msingi vya muundo wa lengo la utafiti la “maelezo yanayosomeka na binadamu”.
Usanifu wa Explainer
Ingizo la Explainer ni tabaka la embedding lenye ukubwa 100 linalotumia msamiati uleule wa vipengele 4107 kama NT50m. Hili linafuatwa na mtandao wa Long Short-Term Memory (LSTM) wa tabaka mbili na mielekeo miwili. Chanzo kinaeleza kuwa node 40 zilichaguliwa kwa muundo wa kila mwelekeo na, kwa kuunganisha hali za memory-cell za mbele/nyuma, uwakilishi wa vipimo 160 hupatikana kwa kila token.
Matokeo ya LSTM hufuatiwa na Batch Normalization na tabaka la dense lenye sigmoid activation. Ikiwa idadi ya madarasa ni \(c\) na urefu wa mfuatano ni \(d\), matokeo ya mwisho ya Explainer ni:
\[ d\times c \]
matriki ya kinyago ya ukubwa huo, inayotengeneza thamani ya umuhimu kati ya 0–1 kwa kila jozi ya token-darasa. Hakuna utafutaji wa hyperparameter uliofanywa kwa usanifu wa Explainer. Waandishi wanasema walichagua node 40 za LSTM ili kusawazisha mahitaji ya rasilimali.
Mbinu na Matokeo ya Utafiti
Kazi ya majaribio: uainishaji wa kitaksonomia wa kijenomu
Modeli ya Explanandum inayofafanuliwa ni Nucleotide Transformer 50 million parameter model, yaani NT50m, ambayo tayari ilikuwa imefanyiwa fine-tune kwa uainishaji wa kitaksonomia wa DNA. Uainishaji unafanywa katika viwango vitatu vya kihierarkia:
- superkingdom: madarasa 4,
- phylum: madarasa 55,
- genus: madarasa 1878 yanayowezekana.
Kipimo kilichofichika cha transformer cha NT50m ni 512. Hali zilizofichika katika kiwango cha token hubadilishwa kupitia mean pooling kuwa uwakilishi wa ukubwa usiobadilika wa vipimo 512, na vichwa vitatu tofauti vya uainishaji vya mstari huzalisha logit za superkingdom, phylum na genus. Hasara ya Explanandum ni jumla ya hasara za cross-entropy za viwango vitatu vya taksonomia.
Mkusanyo wa data
Baada ya uchakataji, chanzo kinaripoti jumla ya mifuatano 5.181.880 ya DNA.
| Superkingdom | Idadi ya mifuatano |
|---|---|
| Eukaryota | 2.601.890 |
| Bacteria | 1.828.018 |
| Archaea | 524.276 |
| Viruses | 227.696 |
| Jumla | 5.181.880 |
Kila mfuatano una urefu wa 1500 base-pair. Kutokana na tokenization ya 6-mer ya NT50m, kila ingizo lina takribani token 250; urefu huu uko chini ya urefu wa juu wa ingizo wa token 1000 wa modeli.
Dokezo la istilahi ndani ya chanzo: Katika sehemu ya mbinu, maelezo ya 6-mer yameandikwa mahali fulani kama “six amino acids grouped together”; hata hivyo, utafiti unahusu mifuatano ya DNA, mfano `ACTGCC` umeundwa na herufi za nukleotidi, na maelezo ya Kielelezo 5 yanafafanua kila kundi la base-pair sita kama token moja. Verianla haiwasilishi kauli hii kana kwamba imerekebishwa kimya kimya kutoka kwenye maandishi ya chanzo.
Chanzo pia kinaripoti 1573 “unique taxonomy IDs”, 55 phyla na 1878 genera. Kwa kuwa maandishi hayaelezi jinsi 1573 taxonomy ID zinavyopaswa kuhusishwa na genera 1878, hakuna dhana ya ziada iliyofanywa kuhusu uhusiano wa namba hizi.
Mgawanyo wa mafunzo, uthibitishaji na majaribio
Operesheni ya Scikit-learn `train_test_split` ilitumika kwa seed 42. Chanzo kinatenga %2 ya mkusanyo mzima wa data, yaani mifuatano 103.648, kama mkusanyo wa hold-out test utakaotumiwa kwa majaribio yote. Aidha, %10 ya data nzima ilitengwa kwa kufuatilia validation loss wakati wa mafunzo.
Ingawa Explanandum ilifunzwa kwenye data iliyobaki, si data yote ya mafunzo iliyotumiwa kwa Explainer. Explainer ilifunzwa kwenye mifano 239.391 iliyochaguliwa kwa nasibu kutoka kwenye mkusanyo wa mafunzo; chanzo kinasema hii ni takribani %4,7 ya mkusanyo wa mafunzo na ilitoa matokeo yasiyohitaji mafunzo kwa data yote.
Vifaa vya mafunzo na hyperparameter
| Kipengele | Thamani |
|---|---|
| GPU | NVIDIA H100, 80 GB VRAM |
| Python | 3.11.6 |
| PyTorch | 2.5.1 |
| Learning rate | 0,0002 |
| Learning-rate scheduler | Cosine |
| Explanandum epoch | 5 |
| Explanandum batch size | 128 |
| Explainer epoch iliyopangwa | 50 |
| Explainer epoch iliyotekelezwa | 38; early stopping |
| Explainer batch size | 48 |
| Precision | FP32 |
| Weight decay | 0 |
| Warm-up | Hakuna |
| Random seed | 42 |
| Utekelezaji wa LIME | Captum 0.7.0 |
| Scikit-learn | 1.6.1 |
Ilijaribiwaje Kwamba Vinyago Vinahifadhi Kweli Maeneo Muhimu ya Token?
Utafiti ulijaribu usahihi wa vinyago kwa kulinganisha utendaji wa uainishaji wa maingizo yaliyofichwa ambayo yanaacha token muhimu wazi na maingizo ya inverted-mask yanayofanya kinyume; utendaji ulidumishwa kwa kiasi kikubwa kwenye maingizo yaliyofichwa, lakini usahihi uliosawazishwa ulianguka kwa kasi katika viwango vyote vitatu vya taksonomia maeneo muhimu yalipofichwa.
| Hali | Superkingdom | Phylum | Genus |
|---|---|---|---|
| Explanandum, bila kinyago | %99,05 | %97,39 | %71,67 |
| Vinyago endelevu | %98,39 | %95,51 | %69,88 |
| Vinyago vilivyogeuzwa | %46,70 | %28,21 | %5,71 |
| Vinyago vilivyokadiriwa | %76,42 | %52,60 | %40,86 |
| Vinyago vilivyokadiriwa na kugeuzwa | %44,85 | %26,20 | %4,92 |
| Kipande husika cha wastani | %69,98 | %49,92 | %36,32 |
| Kipande kisichohusika cha wastani | %47,13 | %31,68 | %9,58 |
Jedwali hili linatoa ushahidi mbili tofauti. Kwanza, vinyago endelevu vinapotumika, utendaji wa uainishaji hupungua kwa kiwango kidogo tu ikilinganishwa na Explanandum isiyo na kinyago. Pili, vinyago vinapogeuzwa na sehemu ambazo Explainer iliona kuwa muhimu kuondolewa, utendaji hushuka hasa katika kiwango cha genus kutoka %69,88 hadi %5,71.
Dokezo la namba ndani ya chanzo: Jedwali 1 linatoa usahihi wa genus bila kinyago kuwa %71,67, wakati maandishi ya maelezo kabla na baada yake yanatumia thamani %71,65. Jedwali hapa limewasilishwa kwa umbo la chanzo kama %71,67 na tofauti imeachwa ionekane wazi.
Kwa nini vinyago vilivyokadiriwa vilijaribiwa pia?
Vinyago endelevu hubadilika kati ya 0 na 1. Watafiti walijaribu pia vinyago vya binary kwa kukadiria thamani hadi 0 au 1 ili kufanya maelezo yawe makali zaidi. Kwa sababu kukadiria husababisha upotevu wa taarifa, usahihi hushuka ikilinganishwa na vinyago endelevu, lakini hubaki juu kwa kiwango kinachoonekana ikilinganishwa na vinyago vilivyokadiriwa na kugeuzwa. Waandishi wanafasiri hili kuwa maeneo muhimu yanaendelea kubeba taarifa yenye maana ya uainishaji hata chini ya ufichaji mkali wa binary.
Uainishaji tofauti wa vipande husika na visivyohusika
Ili kujaribu kama nafasi zilizofichwa zinatengeneza bila kukusudia kidokezo cha uainishaji kwa modeli, vinyago vilivyokadiriwa viligawanywa katika vipande vinavyofuatana vilivyo wazi na vilivyofungwa. Kila kipande kilipelekwa peke yake kwa Explanandum. Vipande husika vilitoa usahihi uliosawazishwa wa %69,98, %49,92 na %36,32 kwa superkingdom, phylum na genus mtawalia, huku vipande visivyohusika vikitoa %47,13, %31,68 na %9,58.
Matokeo haya yanaunga mkono tafsiri kwamba uainishaji hautokani tu na jiometri ya nafasi katika mfuatano uliofichwa, na kwamba vipande halisi vya mfuatano ambavyo Explainer huacha wazi hubeba taarifa zaidi ya kitaksonomia.
Vinyago huacha sehemu gani ya mfuatano ikiwa wazi?
Katika mkusanyo mzima wa majaribio, wastani wa thamani za kinyago umetolewa kuwa 0,73 na %67,28 ya thamani zote za vinyago vya token ziko juu ya 0,5. Kielelezo 6A kinaonyesha mgawanyo huu kama histogram, na Kielelezo 6B kinaonyesha wastani wa thamani ya kinyago kulingana na nafasi ya token. Chanzo kinasema maeneo ya umuhimu wa juu yanayojirudia yalionekana mwanzoni na katikati ya mfuatano, lakini thamani za chini na za juu zilitofautiana sana kati ya mifano.
Katika vinyago vilivyokadiriwa, idadi ya maeneo yaliyo wazi ni wastani wa vipande 3,35. Takribani %90 ya mifuatano ina vipande vinne au vichache vilivyo wazi. Chanzo pia kinaripoti kuwa ni %0,4 pekee ya sehemu ambayo haikuwa na token yoyote iliyofichwa.
Urefu wa wastani wa sehemu iliyo wazi uliripotiwa kuwa token 51,39; baadhi ya sehemu zilizo wazi huzidi token 200. Ikilinganishwa na urefu wa kawaida wa mfuatano wa token 250, waandishi wanasema hii ni takribani sehemu ya %20. Kwa hiyo, maelezo huunda maeneo machache endelevu ya urefu wa kati badala ya kuashiria mfuatano mzima.
Ulinganisho wa muda wa utekelezaji na uelezekaji dhidi ya LIME
Chanzo kinaeleza kuwa sifa za serialization za muundo wa NT50m unaotegemea Evolutionary Scale Modeling zilifanya iwe vigumu kutumia vifurushi vya Python vya LIME, transformer-interpret na SHAP. Mbinu linganishi iliyotekelezwa kikamilifu ni LIME.
Muda wa wastani wa utekelezaji wa LIME umetolewa katika chanzo kuwa takribani sekunde 26 kwa kila mfuatano na kila kiwango cha taksonomia. Waandishi wanasema muda huu unaweza kuhitaji miezi ikiwa utatumika mfululizo kwa mkusanyo mzima wa majaribio.
Mafunzo ya Explainer iliyopendekezwa yalichukua saa 15 dakika 40; Explainer iliyofunzwa ilitengeneza vinyago kwa mkusanyo wa majaribio kwa takribani dakika 20. Katika ulinganisho huu mbinu hizo mbili hazina muundo sawa wa gharama: Explainer hufunzwa mara moja na kisha hutengeneza vinyago moja kwa moja kwa maingizo yanayofuata, wakati LIME hurudia operesheni za perturbation kwa kila mfano wakati wa kutengeneza maelezo.
Dokezo la namba ndani ya chanzo: sehemu ya data inatoa mkusanyo wa majaribio kuwa mifuatano 103.648, wakati sehemu ya muda wa utekelezaji wa LIME inaandika mifuatano 103.638. Verianla haijarekebisha tofauti hii ya mifuatano kumi kwa kukisia namba ipi chanzo kilikusudia.
Katika Kielelezo 8, thamani chanya na hasi za umuhimu za LIME kwa mfano mmoja zinaonekana kama token nyingi za rangi zilizotawanyika katika maeneo tofauti ya mfuatano. Waandishi wanaona kubaki mbali kwa alama hizo kuwa tatizo la uelezekaji hata wakati ni michango chanya pekee au michango chanya iliyo juu ya 0,5 inayoonyeshwa. Kinyume chake, vinyago vya Explainer vimeundwa kuunda maeneo yaliyo endelevu zaidi.
Je, Mbinu Hii Ilithibitishwa Moja kwa Moja Kwenye Maandishi ya Lugha Asilia?
Hapana. Utafiti unaformulisha mbinu kama mkabala wa XAI unaoweza kujumlishwa kwa maingizo yanayotegemea token na maandishi, lakini uthibitisho wa kimajaribio uliochapishwa ulifanywa kwa NT50m katika uainishaji wa kitaksonomia wa mifuatano ya DNA/nukleotidi; uainishaji wa lugha asilia ni mojawapo ya maeneo ya utafiti ya baadaye.
Tofauti hii ni muhimu. Ingawa DNA 6-mer na token za lugha asilia zote ni mifuatano bainifu ya token, miundo yao ya kisemantiki, misamiati, mahusiano ya muktadha, malengo ya mafunzo ya modeli na namna binadamu wanavyotathmini maelezo si sawa. Chanzo hakitoi majaribio ya lugha asilia yanayolinganisha tofauti hizi.
Vivyo hivyo, utafiti unatetea kuwa vinyago vinavyotengenezwa ni “human-readable” kwa kutegemea sifa ya mwendelezo wa usanifu na vielelezo vya mfano; hata hivyo, hakuna jaribio la watumiaji lililodhibitiwa lililofanywa kupima kama maelezo yanaeleweka kwa usahihi zaidi, haraka zaidi au kwa kutegemewa zaidi na binadamu. Kwa hiyo haiwezekani kufikia hitimisho kwamba “imeonekana kimatibabu au kisaikometriki kuwa inaelezeka zaidi kwa binadamu”.
Matokeo yanayoungwa mkono na utafiti
Utafiti unaunga mkono kwamba Explainer inayojifunza vinyago endelevu katika kiwango cha embedding inaweza kutengeneza maeneo endelevu ya token yanayohifadhi taarifa ya uainishaji kwa mmainishaji wa kijenomu wa NT50m. Kuhifadhiwa kwa usahihi wa juu katika mifuatano iliyofichwa na kushuka kwa kasi kwa usahihi katika vinyago vilivyogeuzwa kunaonyesha kuwa vinyago vinahusiana na maeneo yanayobeba taarifa kwa uainishaji.
Utafiti pia unatoa mfano wa vitendo unaoonyesha kuwa kuhamisha gharama ya ukokotozi kutoka wakati wa kutengeneza maelezo kwenda hatua ya mafunzo ya Explainer kunaweza kutoa faida wakati wa kuzalisha maelezo mara kwa mara kwenye mikusanyo mikubwa sana ya majaribio.
Matokeo yasiyoungwa mkono na utafiti
Utafiti hauonyeshi kuwa mbinu hutoa maelezo sahihi zaidi kuliko SHAP au LIME katika kazi zote za lugha asilia. Hakuna tathmini ya kiasi iliyofanywa kwenye mkusanyo wa data wa lugha asilia, na hakuna benchmark kamili iliyotolewa dhidi ya mbinu kuu za XAI zaidi ya LIME.
Haijathibitishwa kwa majaribio kuwa mbinu itatoa utendaji uleule katika usanifu wote wa transformer, recurrent au viainishaji vingine vya token. Ingawa waandishi wanadai uwezo wa matumizi ya jumla wa usanifu, jaribio lililochapishwa linalenga NT50m, na imeonyeshwa kuwa usanifu wa mean-pooling unahitaji hasa kuficha mara ya pili.
Zaidi ya hayo, vinyago huashiria maeneo ya vipengele muhimu kwa mmainishaji; haiwezi kuhitimishwa kutokana na jaribio hili kwamba maeneo hayo ni motifs za kibayolojia za kisababishi, maeneo ya kijenomu yenye kazi au taratibu halisi za kibayolojia. Attribution ya modeli na usababishi wa kibayolojia lazima vitenganishwe.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: What You Read Is What You Classify: Highlighting Attributions to Text and Text-like Inputs
Waandishi: Daniel S. Berman; Brian Merritt; Stanley Ta; Dana Udwin; Amanda Ernlund; Jeremy Ratcliff; Vijay Narayan.
Mwandishi wa mawasiliano: Vijay Narayan.
Taasisi: Johns Hopkins Applied Physics Laboratory, Laurel, Maryland, Marekani; Google DeepMind, London, Uingereza.
Jarida: AI.
Mchapishaji: MDPI.
Aina ya chanzo: Makala asilia ya utafiti; utafiti wa ukuzaji wa mbinu/majaribio ya kimahesabu katika akili bandia inayoelezeka na ujifunzaji wa mashine.
Taarifa ya uchapishaji: AI 2026, juzuu 7, toleo 5, makala 168.
DOI: 10.3390/ai7050168
Iliwasilishwa: 25 Machi 2026.
Marekebisho: 20 Aprili 2026.
Ilikubaliwa: 23 Aprili 2026.
Ilichapishwa: 13 Mei 2026.
Preprint: arXiv:2602.24149. Rekodi hii ni toleo la awali la utafiti uliochapishwa; haijazingatiwa kama utafiti huru tofauti.
Mapitio ya kitaalamu: Makala imechapishwa katika jarida la kisayansi lililopitiwa na wataalamu.
Leseni: Creative Commons Attribution (CC BY), ufikiaji wazi.
Ufadhili: Utafiti uliungwa mkono na U.S. Centers for Disease Control and Prevention, Office of Readiness and Response chini ya Contract #75D30124C20202.
Bodi ya maadili ya taasisi: Haitumiki.
Ridhaa iliyoarifiwa: Haitumiki.
Upatikanaji wa data: Data msingi iliyotumika katika utafiti inapatikana katika nyenzo za ziada za utafiti wa ufikiaji wazi wa Mock na wenzake. Waandishi pia wanasema kuwa msimbo uliotumiwa kwa mgawanyo wa data, mafunzo ya Explainer na Explanandum na inference umechapishwa katika hazina ya wazi ya GitHub.
Shukrani: Waandishi wanamshukuru Molly Gallagher kwa michango yake wakati wa kukamilisha utafiti na kwa msaada wake katika kushinda vikwazo vya programu.
Mgongano wa maslahi: Jeremy Ratcliff alikuwa mfanyakazi wa Johns Hopkins Applied Physics Laboratory wakati alipotoa mchango katika utafiti. Waandishi wengine waliripoti kutokuwa na uhusiano ambao ungeweza kuunda mgongano wa maslahi ya kibiashara au kifedha.
Michango ya waandishi: Uundaji wa dhana Daniel S. Berman, Dana Udwin na Amanda Ernlund; metodolojia Daniel S. Berman na Amanda Ernlund; programu Daniel S. Berman na Vijay Narayan; uthibitishaji, uchanganuzi rasmi na utafiti Daniel S. Berman; rasilimali Brian Merritt; usimamizi wa data Brian Merritt, Stanley Ta na Daniel S. Berman; rasimu ya kwanza Daniel S. Berman, Brian Merritt, Stanley Ta na Vijay Narayan; mapitio na uhariri Daniel S. Berman, Brian Merritt, Stanley Ta, Dana Udwin, Amanda Ernlund na Vijay Narayan; uonyeshaji Daniel S. Berman; usimamizi, usimamizi wa mradi na upatikanaji wa ufadhili Jeremy Ratcliff na Vijay Narayan.
Vikwazo vikuu vya kimetodolojia: Uthibitisho wa kimajaribio umewekewa mipaka katika mifuatano ya token za kijenomu; maandishi ya lugha asilia hayakujaribiwa moja kwa moja. Hakuna utafutaji wa hyperparameter uliofanywa kwa usanifu wa Explainer. Jaribio linalenga usanifu mmoja mkuu wa Explanandum, NT50m. Hakuna utafiti wa uelezekaji uliofanywa na washiriki binadamu. Ingawa ulinganisho wa LIME umetolewa kwa upande wa muda wa utekelezaji na vielelezo vya mfano, si benchmark pana inayolinganisha mbinu zote za kisasa za XAI kwa vipimo vya pamoja.
Dokezo la kutokulingana ndani ya chanzo: Katika chanzo, kauli “six amino acids” kwa 6-mer haiendani na muktadha wa DNA; usahihi uliosawazishwa wa genus bila kinyago umetolewa kama %71,65 katika maandishi na %71,67 katika Jedwali 1; mkusanyo wa majaribio umeandikwa kuwa 103.648 katika sehemu ya data na 103.638 katika sehemu ya muda wa utekelezaji wa LIME; aidha, uhusiano kati ya 1573 unique taxonomy ID na 1878 genus haujaelezwa. Vipengele hivi havikurekebishwa kimya kimya na Verianla.
Dokezo la mbinu la Verianla: Maudhui haya si tafsiri ya mstari kwa mstari ya makala ya chanzo. Tatizo la utafiti, muundo wa Explainer–Explanandum, kuficha kwa Hadamard katika kiwango cha embedding, loss functions, usanifu wa NT50m, mkusanyo wa data, hali za mafunzo, matokeo ya Jedwali 1 na ujumbe wa kisayansi wa Vielelezo 1–8 vimehifadhiwa huku muundo huru na wa kielimu wa Kiswahili ukiundwa. Hakuna matokeo ya majaribio au thamani ya utendaji isiyokuwepo kwenye chanzo iliyoongezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *