


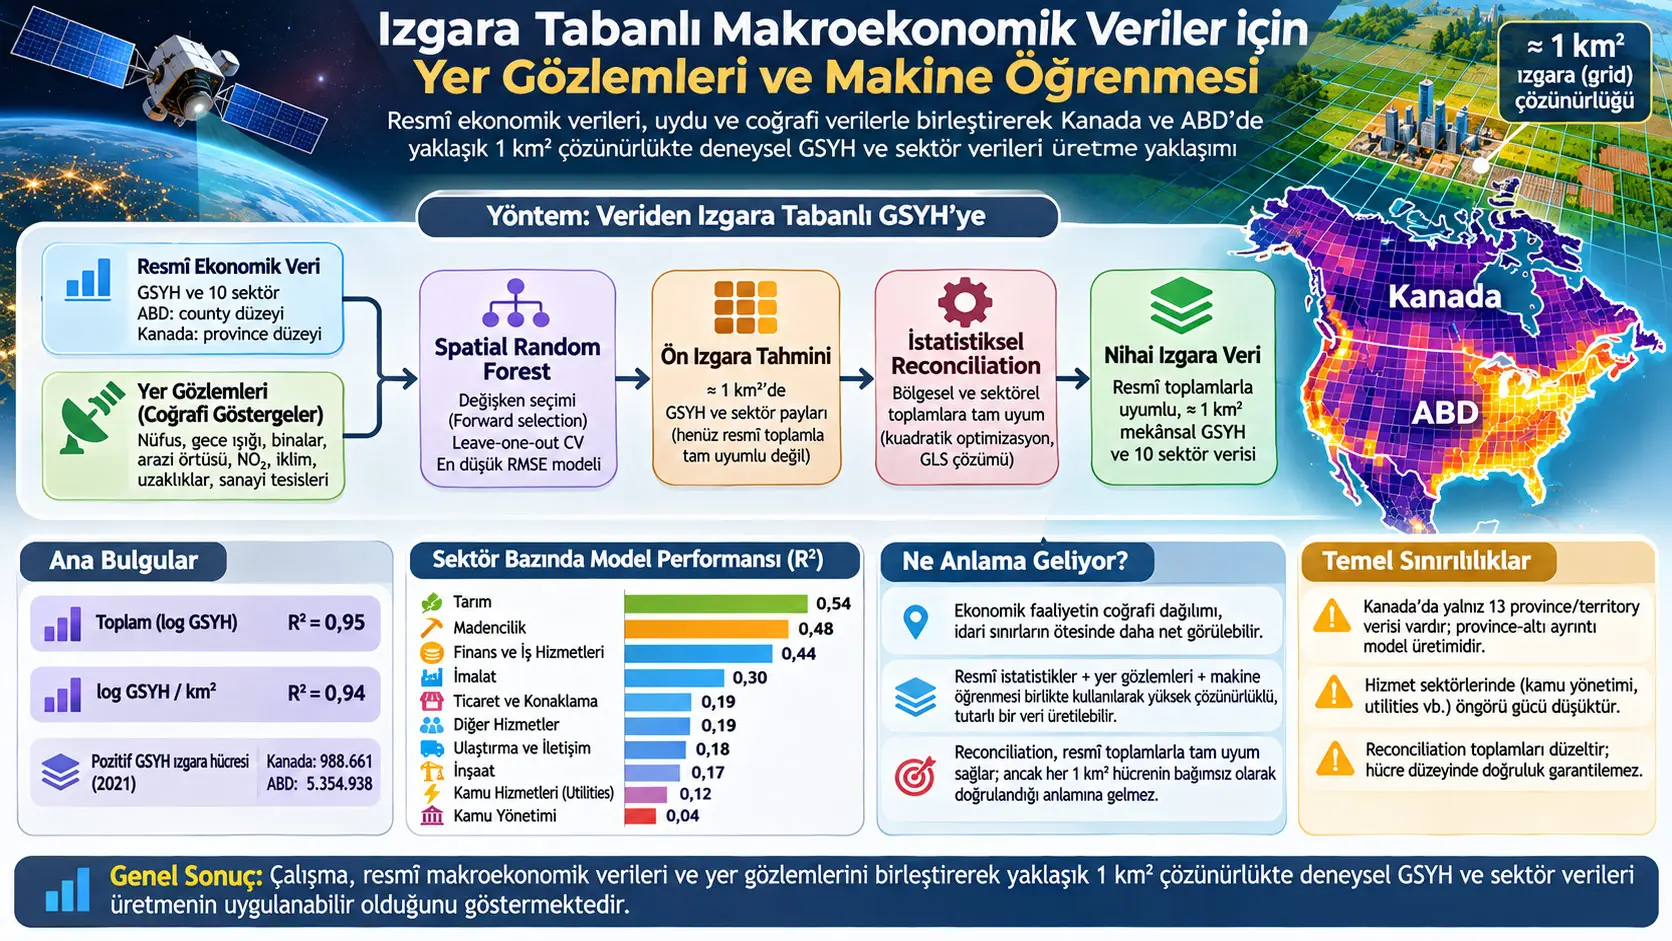
Izgara tabanlı GSYH (gridded GDP), ekonomik üretimin yalnız ülke, eyalet veya il gibi idari bölgeler için değil, düzenli coğrafi hücreler üzerinde tahmin edilmesini sağlayan mekânsal bir makroekonomik veri gösterimidir. Marco Marini, Jim Tebrake ve Andinet Woldemichael'ın çalışması; resmî ulusal ve alt-ulusal GSYH verilerini nüfus, gece ışıkları, yapılaşmış alan, arazi örtüsü ve diğer yüksek çözünürlüklü yer gözlemi değişkenleriyle birleştirerek Kanada ve Amerika Birleşik Devletleri için yaklaşık 1 km² grid hücrelerinde deneysel GSYH ve 10 sektör payı üretmeye yönelik iki aşamalı bir yöntem geliştirmektedir.
Birinci aşamada araştırmacılar, resmî GSYH ve sektör verisinin bulunduğu en ayrıntılı idari düzeyde spatial random forest modelleri eğitmektedir. ABD'de eğitim verisi county düzeyine kadar inerken Kanada'da yalnız province/territory düzeyindedir. Model girdileri arasında nüfus, gece ışığı, azot dioksit, yapı yoğunluğu ve alanı, karayoluna ve yapılaşmış yüzeye uzaklık, tarım alanına uzaklık, sıcaklık, yağış, arazi örtüsü ve ağır sanayi tesislerinin yakınlığı bulunmaktadır.
İkinci aşamada makine öğrenmesiyle üretilen grid tahminleri doğrudan nihai veri olarak kabul edilmemektedir. Araştırmacılar statistical reconciliation adı verilen kuadratik bir optimizasyon yöntemiyle grid ve sektör tahminlerini resmî bölgesel hesaplarla yeniden uzlaştırmaktadır. Böylece hücre düzeyindeki tahminlerin toplamı ilgili resmî bölge GSYH'sine ve sektör toplamlarına tam olarak eşit hale getirilirken, makine öğrenmesinin önerdiği mekânsal dağılım mümkün olduğunca korunmaktadır.
Toplam ekonomik faaliyet için model performansı yüksektir: log GSYH modelinde \(R^2=0{,}95\), log GSYH/km² modelinde \(R^2=0{,}94\) raporlanmaktadır. Ancak sektör düzeyinde performans büyük ölçüde değişmektedir. Tarım için \(R^2=0{,}54\), madencilik için 0,48, finans ve iş hizmetleri için 0,44 ve imalat için 0,30 iken kamu yönetiminde 0,04 ve kamu hizmetlerinde 0,12'dir.
Bu fark önemlidir; çünkü gece ışıkları, yapılaşma ve arazi örtüsü gibi fiziksel göstergeler tarım, madencilik veya yoğun kentsel ekonomik faaliyetleri belirli ölçüde yakalayabilirken kamu hizmetleri ve bazı hizmet sektörlerinde değer yaratılan yer ile gözlenebilir fiziksel altyapının bulunduğu yer aynı olmayabilir.
Reconciliation öncesindeki ön tahminlerde tarım ve utilities sektörleri resmî sektör toplamlarından yaklaşık dört-beş kat sapabilmektedir. Reconciliation bu toplam tutarsızlığını muhasebesel olarak düzeltmektedir; ancak bu düzeltme her 1 km² hücre tahmininin bağımsız biçimde doğrulandığı anlamına gelmez.
Çalışmanın en önemli yorum sınırlarından biri Kanada'dır. ABD modellemesi 3.082 county düzeyindeki resmî sonuçlardan yararlanabilirken Kanada için yalnız 13 province ve territory gözlemi bulunmaktadır. Bu nedenle Kanada'nın province-altı bütün mekânsal ayrıntısı model tarafından üretilmiş deneysel bir tahsistir; bağımsız olarak gözlenmiş resmî 1 km² GSYH değildir.
Araştırmanın temel problemi nedir?
Makroekonomik istatistikler çoğunlukla ülke veya büyük alt-ulusal bölgeler için yayımlanır. Bu yaklaşım toplam ekonomik büyüklükleri ölçmek açısından güçlüdür; ancak ekonomik faaliyetin aynı ülke içinde hangi coğrafi noktalarda yoğunlaştığını ayrıntılı biçimde göstermez.
Bu eksiklik özellikle aşağıdaki tür analizlerde önem kazanır:
- sel, kasırga, yangın veya başka fiziksel risklerin yerel ekonomik etkilerinin değerlendirilmesi,
- altyapı açıklarının belirlenmesi,
- bölgesel ekonomik eşitsizliklerin incelenmesi,
- ulaştırma ve ticaret bağlantılarının mekânsal analizi,
- yerel üretim ve sektör yoğunlaşmalarının modellenmesi.
Örneğin aynı eyalet veya province içerisinde büyük bir metropol, tarım bölgesi, madencilik alanı ve düşük nüfuslu kırsal bölge aynı idari ortalamanın içinde kaybolabilir. Çalışma bu nedenle resmî toplamları bozmadan ekonomik faaliyeti daha küçük coğrafi hücrelere dağıtmayı amaçlamaktadır.
Izgara Tabanlı GSYH Nedir?
Izgara tabanlı GSYH, resmî ekonomik üretim toplamının düzenli coğrafi hücrelere mekânsal olarak dağıtılmış bir gösterimidir; bu çalışmada hedef çözünürlük yaklaşık 1 km² olup hücre değerleri doğrudan resmî ölçüm değil, resmî hesaplar ve yüksek çözünürlüklü mekânsal göstergelerden türetilmiş model tahminleridir.
Gross Cell Product kavramı
Literatürde grid hücresindeki üretim bazen Gross Cell Product (GCP) olarak adlandırılmaktadır. GCP'nin kavramsal anlamı GSYH'ye benzer; fark, ölçüm alanının ülke veya idari bölge yerine belirli büyüklükteki bir grid hücresi olmasıdır.
Çalışmanın hedefi resmî GSYH'nin yerine yeni bir ulusal hesap sistemi kurmak değildir. Tam tersine, resmî hesapları üst düzey “anchor” veya sabit toplam olarak koruyarak mekânsal ayrıntı eklemektir.
Downscaling ne demektir?
Downscaling, daha büyük coğrafi birimlerde bulunan bir değişkeni, ilişkili yüksek çözünürlüklü bilgiler kullanarak daha küçük mekânsal birimlere dağıtma işlemidir.
Bu çalışmada süreç kabaca:
\[ \text{Resmî bölgesel GSYH} \rightarrow \text{Yer gözlemi ilişkileri} \rightarrow \text{1 km}^2 \text{ grid tahminleri} \rightarrow \text{Resmî toplamlarla reconciliation} \]
şeklinde ilerlemektedir.
Bu denklem bir araştırma tahmin denklemi değil, yöntemin öğretici akış gösterimidir.
Yer gözlemi neden ekonomik faaliyet hakkında bilgi taşıyor?
Çalışmada kullanılan mekânsal değişkenlerin hiçbiri tek başına “GSYH” değildir. Bunlar ekonomik faaliyetin coğrafi dağılımıyla ilişkili olabilecek göstergelerdir.
Nüfus: emek arzı ve tüketici yoğunluğu hakkında bilgi taşır.
Gece ışıkları: aydınlatılmış yerleşim ve üretim alanlarının yoğunluğu üzerinden ekonomik faaliyet için vekil değişken olarak kullanılabilir.
NO₂: yakıt kullanan taşıtlar ve makineler gibi yanma kaynaklarının yoğun olduğu yerlerde yerel ekonomik faaliyete ilişkin bilgi taşıyabilir.
Yapı ayak izi: bina sayısı, yoğunluğu ve kapladığı alan üzerinden fiziksel sermaye ve yerleşim yoğunluğuyla ilişkilidir.
Arazi örtüsü: tarım alanı, ağaçlık alan, yapılaşmış alan, su, kar/buz ve diğer yüzey sınıflarının sektörel mekânsal dağılımla ilişkisini yakalamaya yardımcı olabilir.
Uzaklık değişkenleri: karayoluna, yapılaşmış yüzeye ve ekili araziye uzaklık, farklı faaliyet türlerinin kent merkezleri ve altyapıyla ilişkisini temsil eder.
Ağır sanayi tesisleri: demir-çelik gibi belirli üretim faaliyetlerinin coğrafi varlığı hakkında doğrudan yer bilgisi sağlar.
Nüfus ve gece ışığı sonuçları nasıl okunmalı?
Kanada ve ABD birlikte değerlendirildiğinde kaynak, alt-ulusal GSYH ile nüfus arasında yaklaşık \(R^2=0{,}95\), gece ışığı ile GSYH arasında yaklaşık \(R^2=0{,}94\) raporlamaktadır.
Bu yüksek değerler nüfusun veya gece ışığının GSYH'yi “yarattığını” göstermez. Bunlar güçlü mekânsal öngörü ilişkileridir. Model bu değişkenleri ekonomik faaliyetin coğrafi dağılımını tahmin etmek amacıyla kullanmaktadır.
Veri kaynakları ve çözünürlükleri
| Değişken | Çözünürlük / idari düzey | Zaman kapsamı | Kaynak |
|---|---|---|---|
| ABD alt-ulusal GSYH | County, admin 2 | 2001–2023 | BEA |
| Kanada alt-ulusal GSYH | Province, admin 1 | 1997–2021 | Statistics Canada |
| ABD 10 sektör verisi | County, admin 2 | 2001–2023 | BEA |
| Kanada 10 sektör verisi | Province, admin 1 | 1997–2021 | Statistics Canada |
| Nüfus | 3 arcsecond, yaklaşık 100 m | Kaynak tabloda tek dönem aralığı belirtilmemiş | WorldPop |
| Gece ışığı | 3 arcsecond, yaklaşık 100 m | 2015–2023 | WorldPop |
| Yapılaşmış yüzeye uzaklık | 3 arcsecond, yaklaşık 100 m | 2015–2030 | WorldPop |
| Karayoluna uzaklık | 3 arcsecond, yaklaşık 100 m | 2023 | WorldPop |
| Yıllık ortalama yağış | 3 arcsecond, yaklaşık 100 m | 2015–2023 | WorldPop |
| Ortalama sıcaklık | 3 arcsecond, yaklaşık 100 m | 2015–2023 | WorldPop |
| Ekili araziye uzaklık | 3 arcsecond, yaklaşık 100 m | 2015–2023 | WorldPop |
| Bina sayısı | 3 arcsecond, yaklaşık 100 m | 2023 | WorldPop |
| Bina yoğunluğu | 3 arcsecond, yaklaşık 100 m | 2023 | WorldPop |
| Bina alanı | 3 arcsecond, yaklaşık 100 m | 2023 | WorldPop |
| Arazi örtüsü sınıflaması | 3 arcsecond, yaklaşık 100 m | 2015–2023 | ESA |
| Yıllık ortalama yüzey NO₂ | 1 km | 1990–2020 | NASA |
| 50 km içindeki demir-çelik tesisi sayısı | 50 km yarıçap içinde sayı | Tarihsel–2025 | Global Energy Monitor |
10 sektör sınıflaması
Resmî ülke ve alt-ulusal sektör verileri Groningen Growth and Development Centre 10-Sector Database sınıflamasıyla uyumlaştırılmıştır. Sınıflama ISIC Rev. 3.1'e dayanır.
| Kısaltma | Sektör |
|---|---|
| AGR | Tarım, avcılık, ormancılık ve balıkçılık |
| MIN | Madencilik ve taş ocakçılığı |
| MAN | İmalat |
| PUB | Elektrik, gaz ve su hizmetleri |
| CON | İnşaat |
| TRAD | Toptan/perakende ticaret, otel ve restoranlar |
| TRAN | Ulaştırma, depolama ve iletişim |
| FIN | Finans, sigorta, gayrimenkul ve iş hizmetleri |
| GOV | Kamu hizmetleri / kamu yönetimi |
| OTH | Toplumsal, sosyal ve kişisel diğer hizmetler |
Kaynak yöntem denklemindeki hedef değişken listesinin sonunda ayrıca SER sembolü görünmektedir. Appendix A'daki 10 sektör tablosunda ayrı bir SER kategorisi tanımlanmadığı için bu sembole Verianla tarafından kaynakta bulunmayan yeni bir anlam verilmemiştir.
Spatial Random Forest Bu Çalışmada Ne Yapıyor?
Spatial random forest, resmî alt-ulusal ekonomik sonuçlarla yüksek çözünürlüklü coğrafi göstergeler arasındaki doğrusal olmayan öngörü ilişkilerini öğrenerek bu ilişkileri grid hücrelerine taşıyan ağaç-topluluğu tabanlı bir makine öğrenmesi yaklaşımıdır; çalışmada amaç nedensel katsayı üretmek değil, mekânsal tahmin yapmaktır.
Temel model denklemi
Kaynak, her hedef değişken için modeli şu genel biçimde tanımlar:
\[ y_i^k=f(X_i^k)+\varepsilon_i^k. \]
Burada:
- \(i\), resmî verinin gözlendiği alt-ulusal idari birimi temsil eder.
- \(k\), log GSYH, GSYH/km² veya belirli sektör payı gibi hedef değişkeni temsil eder.
- \(y_i^k\), idari birimde gözlenen hedef değişkendir.
- \(X_i^k\), nüfus, gece ışığı, yapılaşma, iklim ve diğer coğrafi açıklayıcı değişkenlerden oluşan vektördür.
- \(f(\cdot)\), spatial random forest tarafından öğrenilen bilinmeyen doğrusal olmayan eşlemedir.
- \(\varepsilon_i^k\), modelin açıklayamadığı ek hata terimidir.
Denklemin önemli tarafı, araştırmacıların \(f(\cdot)\) için önceden doğrusal bir fonksiyon biçimi dayatmamasıdır. Random forest, birçok karar ağacının birlikte kullanılmasına dayanan esnek bir öngörü yaklaşımıdır.
Random forest mantığı
Genel random forest mantığında çok sayıda karar ağacı farklı gözlem ve değişken kombinasyonları üzerinde oluşturulur. Her ağaç hedef değişken için bir tahmin üretir ve ağaç topluluğunun tahminleri birleştirilir.
Bu çalışmadaki uygulama spatial olarak tanımlanmaktadır; çünkü model eğitimi ve değerlendirmesi coğrafi bağımlılığı hesaba katacak biçimde spatial machine learning literatürünü izlemektedir.
Kaynak, uygulamada R içindeki CAST Version 1.04 kütüphanesini kullandığını bildirmektedir.
Değişken seçimi nasıl yapılıyor?
Kaynak forward feature selection kullanmaktadır.
Forward feature selection, başlangıçta sınırlı bir değişken setinden başlayıp tahmin performansını iyileştiren açıklayıcı değişkenleri aşamalı biçimde modele ekleyen özellik seçimi yaklaşımıdır.
Amaç her mevcut coğrafi değişkeni otomatik olarak modele doldurmak değil, hedef değişken için öngörü performansını iyileştiren kombinasyonu seçmektir.
Cross-validation nasıl yapılıyor?
Model performansı için kaynak, k-fold cross-validation çerçevesi içinde leave-one-out yaklaşımını kullandığını bildirmektedir.
Leave-one-out mantığında belirli bir gözlem veya mekânsal birim eğitimden çıkarılır, model kalan verilerle eğitilir ve dışarıda bırakılan birim üzerinde tahmin performansı kontrol edilir. İşlem farklı gözlemler için tekrarlanarak modelin yalnız eğitim verisini ezberleyip ezberlemediği değerlendirilir.
Kaynak model varyantları arasında en düşük Root Mean Square Error (RMSE) değerine sahip spesifikasyonu seçmektedir.
RMSE, MAE ve R² neyi anlatıyor?
RMSE, tahmin hatalarının karelerini daha fazla cezalandıran ortalama hata ölçüsüdür. Daha düşük RMSE daha iyi tahmin performansıyla uyumludur.
MAE, tahmin ile gözlem arasındaki mutlak farkların ortalama büyüklüğünü ölçer. Daha düşük değer daha küçük ortalama hata anlamına gelir.
\(R^2\), hedef değişkendeki varyasyonun ne kadarının model tahminleriyle uyumlu olduğunu gösteren ölçüdür. Değerin 1'e yaklaşması daha yüksek uyum anlamına gelir; ancak yüksek \(R^2\) nedensellik veya her grid hücresinin doğru tahmin edildiği anlamına gelmez.
Kaynak hangi hiperparametreleri bildirmiyor?
Kaynak spatial random forest yaklaşımını, CAST 1.04 kütüphanesini, feature-selection ve cross-validation yapısını açıklamaktadır. Bununla birlikte PDF'de random forest için:
- nihai ağaç sayısı,
mtrybenzeri düğüm başına değişken sayısı,- minimum düğüm büyüklüğü,
- maksimum ağaç derinliği,
- nihai rastgele tohum
gibi tüm düşük düzey hiperparametreler açık biçimde raporlanmamaktadır. Bu değerler Verianla tarafından tahmin edilmemiştir.
İdari düzeyden 1 km² grid hücresine geçişteki varsayım
Model ilişkileri önce resmî ekonomik sonuçların bulunduğu idari birimlerde öğrenilir. Ardından aynı ilişki yüksek çözünürlüklü grid hücrelerine uygulanır.
Bu nedenle kaynak açık bir varsayım taşır: idari birim düzeyinde öğrenilen coğrafi değişken–ekonomik faaliyet ilişkisinin hücre ölçeğinde de kullanılabilir olduğu kabul edilir.
Bu varsayım özellikle Kanada için önemlidir; çünkü province içinde resmî alt-province GSYH eğitim gözlemi bulunmamaktadır.
İstatistiksel Reconciliation Neden Gerekli?
İstatistiksel reconciliation, makine öğrenmesinin ayrıntılı fakat toplamları resmî hesaplardan sapabilen grid tahminlerini, mekânsal ve sektörel örüntüyü mümkün olduğunca koruyarak resmî bölgesel ve sektör toplamlarına tam olarak bağlayan kuadratik optimizasyon aşamasıdır.
Neden makine öğrenmesi tahmini tek başına yeterli değil?
Random forest bir hücrenin veya bölgenin ekonomik yapısını coğrafi göstergelerden tahmin edebilir. Fakat bütün hücreler toplandığında elde edilen sektör toplamının resmî ulusal hesaplarla aynı olmasını otomatik olarak garanti etmez.
Bu fark özellikle çalışmanın ön sonuçlarında açıkça görülmektedir. Tarım ve utilities gibi bazı sektörlerde reconciliation öncesi grid toplamları resmî değerlerden birkaç kat sapabilmektedir.
Makale bu nedenle makine öğrenmesini resmî istatistiğin yerine koymak yerine, resmî istatistik tarafından sınırlandırılan bir mekânsal dağıtım motoru olarak kullanır.
Reconciliation notasyonu
Appendix B'de:
- \(g=1,\ldots,G\): grid hücrelerini,
- \(i=1,\ldots,I\): sektörleri,
- \(r=1,\ldots,R\): alt-ulusal bölgeleri
gösterir.
\(p_{g,i}\), grid \(g\) ve sektör \(i\) için makine öğrenmesinin reconciliation öncesi tahminidir.
\(x_{g,i}\), aynı hücre ve sektör için reconciliation sonrasındaki nihai değerdir.
Mekânsal aggregation matrisi
Kaynak:
\[ S_{rg}= \begin{cases} 1, & \text{grid } g \in r,\\ 0, & \text{aksi halde} \end{cases} \]
matrisini tanımlar.
\(S_{rg}=1\) ise grid hücresi \(g\), bölge \(r\)'nin içindedir. \(S_{rg}=0\) ise değildir.
Bu basit ikili matris milyonlarca grid hücresinin hangi resmî idari bölgeye ait olduğunu cebirsel olarak tanımlamayı sağlar.
Birinci kısıt: bölge ve sektör toplamı
Her bölge \(r\) ve sektör \(i\) için:
\[ \sum_{g\in r}x_{g,i} = y_{r,i}^{\mathrm{off}}. \]
Burada \(y_{r,i}^{\mathrm{off}}\), ilgili bölge ve sektör için resmî ekonomik toplamdır.
Bu kısıtın anlamı şudur: örneğin belirli bir province içindeki bütün imalat grid hücreleri toplandığında sonuç resmî province imalat değerine eşit olmalıdır.
İkinci kısıt: bölgenin bütün sektörleri
Kaynak ikinci olarak:
\[ \sum_{i=1}^{I} \sum_{g\in r} x_{g,i} = y_r^{\mathrm{off}} \]
koşulunu uygular.
Bu denklem bütün sektörler ve bütün grid hücreleri toplandığında ilgili bölgenin resmî toplam GSYH'sine ulaşılmasını zorunlu kılar.
Kronecker product neden kullanılıyor?
Kaynak aynı kısıtları matris biçiminde yazarken \(\otimes\) sembolüyle Kronecker product kullanmaktadır.
Kronecker product, mekânsal aggregation matrisi ile sektör boyutunu tek büyük blok matris yapısı içinde birleştirmeyi sağlar.
Sektör kimlik matrisi \(I_I\) kullanıldığında her sektörün bölgesel toplam kısıtı ayrı korunabilir. Birlerden oluşan \(1_I'\) vektörü kullanıldığında ise sektörler birlikte toplanabilir.
Bütün kısıtların kompakt biçimi
Kaynak bütün resmî muhasebe kısıtlarını:
\[ Hx=y_a \]
şeklinde tek sistemde toplar.
\(H\), bölge-sektör muhasebe yapısını kodlayan seyrek bir matristir. \(x\), reconciled grid-sektör değerlerinin büyük vektörüdür. \(y_a\), uygulanması gereken resmî aggregate değerleri temsil eder.
Kuadratik kayıp fonksiyonu
Makine öğrenmesi tahminini resmî toplamlarla uyumlu hale getirirken hücrelerin ilk mekânsal yapısını gereksiz yere bozmak istenmez.
Bu nedenle kaynak:
\[ \min_x \sum_{g,i} \left( \frac{x_{g,i}-p_{g,i}} {p_{g,i}} \right)^2 \]
kriterini kullanır.
Bu ifade mutlak değişimi değil, göreli değişimi cezalandırmaktadır.
Örneğin aynı 10 birimlik değişiklik başlangıç tahmini 1.000 olan büyük bir hücre için küçük göreli düzeltme, başlangıç tahmini 20 olan küçük bir hücre için ise çok büyük göreli düzeltme anlamına gelir.
Ağırlık matrisi
Matris biçiminde:
\[ \min_x (x-p)'W(x-p) \]
ve:
\[ W= \operatorname{diag} \left( \frac{1}{p_{g,i}^2} \right). \]
\(W\) ağırlık matrisi, hata cezasının göreli ölçekte uygulanmasını sağlar.
Kısıtlı optimizasyon problemi
Tam problem:
\[ \min_x (x-p)'W(x-p) \]
koşuluyla:
\[ Hx=y_a. \]
Başka bir ifadeyle sistem iki şeyi aynı anda yapmalıdır:
- resmî muhasebe toplamlarına tam olarak uymak,
- makine öğrenmesiyle elde edilen ilk mekânsal-sektörel dağılımdan mümkün olan en az göreli uzaklaşmayı yapmak.
GLS reconciliation estimator
Birinci derece koşulları kaynakta şu çözümü üretir:
\[ x = p - W^{-1}H' \left( HW^{-1}H' \right)^{-1} \left( Hp-y_a \right). \]
Bu denklem çalışmanın en önemli matematiksel yapılarından biridir.
\(p\): ilk makine öğrenmesi tahminleridir.
\(Hp\): bu ilk tahminlerin resmî aggregation yapısı altında oluşturduğu toplamdır.
\(Hp-y_a\): makine öğrenmesi toplamı ile resmî toplam arasındaki uyumsuzluktur.
\(W^{-1}H'(HW^{-1}H')^{-1}\): bu uyumsuzluğun grid ve sektör hücrelerine hangi ağırlıklarla geri dağıtılacağını belirleyen düzeltme yapısıdır.
\(x\): bütün resmî kısıtları sağlayan reconciled sonuçtur.
Neden bu sistem hesaplanabilir?
\(H\) matrisi son derece seyrektir; çünkü bir grid hücresi yalnız ait olduğu bölge ve ilgili sektör bloklarıyla bağlantılıdır.
Kaynak bu seyrek yapının:
- sparse Cholesky,
- multifrontal factorization
gibi yöntemlerle büyük grid sistemlerinde verimli biçimde çözülebileceğini belirtmektedir.
Sıfır tahminler için 0,01 neden ekleniyor?
\[ W= \operatorname{diag}(1/p_{g,i}^2) \]
olduğu için \(p_{g,i}=0\) olduğunda ağırlık tanımsız hale gelir.
Kaynak bu teknik problemi çözmek için sıfır tahminli hücrelere reconciliation öncesinde 0,01 büyüklüğünde küçük bir notional değer atar.
Reconciliation tamamlandıktan sonra bu 0,01 tekrar kaldırılır ve hücre tam sıfıra döndürülür.
Bu 0,01 ekonomik aktivite ölçümü değildir; sayısal optimizasyonun ağırlık matrisini tanımlı tutmak için kullanılan teknik yardımcı değerdir.
Reconciliation negatif değer üretebilir mi?
Kaynağın kullandığı GLS çözümü işaret açısından kısıtsızdır. Bu nedenle teorik olarak büyük bir düzeltme gerektiğinde bazı reconciled hücre değerleri negatif olabilir.
Ancak kaynak, Kanada–ABD uygulamasında reconciliation sonrasında negatif değer oluşmadığını açıkça belirtmektedir.
Çalışmanın Yöntemi ve Bulguları
İki aşamalı yöntem
Araştırmanın yöntem zinciri iki ana aşamadır:
- Makine öğrenmesi aşaması: resmî idari GSYH ve sektör sonuçları ile yüksek çözünürlüklü coğrafi değişkenler arasındaki ilişkiler öğrenilir ve grid hücrelerine uygulanır.
- Reconciliation aşaması: grid tahminleri resmî bölge ve sektör toplamlarına tam uyacak biçimde kuadratik optimizasyonla düzeltilir.
Grid düzeyinde uygulanan iki ek kısıt
Kaynak ayrıca:
- 10 sektör için tahmin edilen sektör paylarının toplamının ilgili idari birimde 1 olmasını,
- GSYH'nin sıfır tahmin edildiği büyük sürekli su alanları, yerleşimsiz çöller ve kalıcı kar alanları gibi yerlerde sektör paylarının da sıfır olmasını
zorunlu tutmaktadır.
Model performansı
| Hedef | RMSE | R² | MAE |
|---|---|---|---|
| log GSYH | 0,39 | 0,95 | 0,29 |
| log GSYH / km² | 0,44 | 0,94 | 0,32 |
| Tarım | 0,06 | 0,54 | 0,04 |
| İnşaat | 0,03 | 0,17 | 0,02 |
| Finans ve iş hizmetleri | 0,10 | 0,44 | 0,07 |
| Kamu yönetimi | 0,08 | 0,04 | 0,06 |
| İmalat | 0,11 | 0,30 | 0,08 |
| Madencilik | 0,10 | 0,48 | 0,06 |
| Diğer hizmetler | 0,01 | 0,19 | 0,08 |
| Utilities | 0,09 | 0,12 | 0,05 |
| Ticaret ve konaklama | 0,05 | 0,19 | 0,04 |
| Ulaştırma ve iletişim | 0,04 | 0,18 | 0,02 |
Kaynak metinde ayrıca log kişi başına GSYH ve log kişi başına GSYH/km² modelleri için \(R^2\) değerlerini sırasıyla yaklaşık 0,50 ve 0,56 olarak raporlamaktadır. Bu iki varyantta nüfus açıklayıcı değişkenler setinden çıkarılmıştır.
Sektör performansları neden farklı?
Tarım ve madencilik gibi sektörlerin fiziksel coğrafyayla daha güçlü bir mekânsal izi vardır. Tarım arazi örtüsüyle, madencilik belirli coğrafi ve tesis konumlarıyla ilişkilendirilebilir.
Hizmetler, kamu yönetimi ve utilities gibi sektörlerde ise gözlenebilir fiziksel konum ile değer yaratımının ulusal hesaplarda kaydedildiği yer aynı olmayabilir.
Kaynak bu nedenle sektör düzeyinde değişken öngörü gücünün önemli ölçüde farklı olduğunu vurgular.
Değişken önem sıralaması nedensellik midir?
Hayır. Kaynak Figure 5'teki variable-selection sıralamalarının yalnız tahmine katkıyı gösterdiğini açıkça belirtmektedir.
Örneğin built-up area, population ve nighttime light toplam GSYH için üst sıralarda yer alırken cropland tarım modelinde güçlü bir değişkendir.
Bu durum “gece ışığındaki artış GSYH'yi şu kadar artırır” biçiminde bir nedensel sonuç vermez.
Reconciliation öncesi en büyük sapmalar
Kaynak ön grid tahminlerini resmî sektör GSYH'siyle karşılaştırdığında tarım ve utilities için en büyük sapmaları gözlemlemektedir.
Her iki sektörde de reconciliation öncesindeki grid toplamları resmî verilerin yaklaşık dört-beş katına ulaşabilmektedir.
Tarım için bu sonuç özellikle öğreticidir; çünkü tarım modelinin \(R^2\) değeri sektörler arasında görece yüksek olan 0,54'tür.
Bu durum iyi bir idari düzey tahmin uyumunun grid toplamlarında otomatik muhasebe tutarlılığı anlamına gelmediğini gösterir.
Kaynak bunu kısmen tarım arazisinin ekonomik katma değerine kıyasla çok geniş fiziksel alan kaplamasıyla açıklar.
Kent ağırlıklı sektörlerde ön tahmin daha yakın
Finans ve iş hizmetleri, ticaret ve konaklama, imalat ile ulaştırma ve iletişim sektörlerinde reconciliation öncesi tahminlerin resmî toplamlarla oranı Kanada ve ABD'de genel olarak yaklaşık %75–90 bandındadır.
Bu sonuç kentsel ve ticari faaliyetlerin gece ışığı, yapılaşma ve diğer fiziksel göstergelerle daha görünür olabilmesiyle uyumludur.
Reconciliation bu sorunu nasıl çözüyor?
Reconciliation bütün sektörlerin grid toplamlarını resmî ulusal ve alt-ulusal hesaplarla aynı seviyeye ölçekleyip yeniden dağıtır.
Fakat burada çok önemli bir ayrım vardır:
Aggregate tutarlılık elde etmek, hücre düzeyinde bağımsız doğrulama elde etmek değildir.
Reconciliation sonrasında bölge toplamının resmî GSYH'ye eşit olması matematiksel olarak garanti edilir. Buna karşılık aynı toplam içindeki ekonomik faaliyetin tam olarak hangi 1 km² hücreye ne oranda ait olduğu halen makine öğrenmesi modelinin mekânsal tahsis yapısına dayanır.
2021 grid kapsamı
Post-benchmarking veride pozitif GSYH tahmin edilen hücreler açısından:
| Ülke | Pozitif GSYH hücre sayısı | Yaklaşık hücre büyüklüğü |
|---|---|---|
| Kanada | 988.661 | Yaklaşık 1 km² |
| Amerika Birleşik Devletleri | 5.354.938 | Yaklaşık 1 km² |
Kaynak yalnız pozitif GSYH tahmin edilen hücreleri bu kapsam sayılarına dahil etmektedir.
Kaynak GSYH birimindeki tutarsızlık
Ana Tablo 1, 2021 GSYH sütununu “USD PPP bn” olarak etiketlemekte ve veri bölümünde alt-ulusal GSYH'nin IMF WEO PPP international dollars benchmark'ıyla ayarlandığını açıklamaktadır.
Buna karşılık Appendix C'deki aynı kapsam tablosunun notunda “GDP figures in current USD billions” ifadesi bulunmaktadır.
Kaynak içindeki bu birim tutarsızlığı Verianla tarafından sessizce düzeltilmemiştir. Bu nedenle bu makale toplam 2021 para değerlerini yeni hesaplamalarda kullanmamaktadır.
Kanada ve ABD sonuçları neden aynı güvenle okunamaz?
ABD için resmî eğitim sonuçları county düzeyine kadar bulunmaktadır. Bu nedenle modelin ABD içindeki ince mekânsal örüntüsü en azından county ölçeğine kadar gerçek alt-ulusal GSYH farklılıklarından öğrenmektedir.
Kanada için resmî eğitim sonucu yalnız 13 province/territory düzeyindedir.
Bu nedenle Kanada'nın province içindeki dağılımı tamamen geocovariate ilişkileri üzerinden model tarafından üretilmektedir.
Kaynağın kendi ifadesiyle Kanada sonuçları experimental model-based spatial allocations olarak değerlendirilmelidir; bağımsız olarak doğrulanmış subprovincial GDP değildir.
Toplam ekonomik faaliyetin mekânsal örüntüsü
Post-reconciliation 2021 sonuçlarında ekonomik faaliyetin en yüksek olduğu grid hücreleri büyük metropol koridorlarında yoğunlaşmaktadır.
ABD'nin doğu yarısında daha sürekli orta düzey ekonomik faaliyet görülürken kurak iç batı bölgelerinde daha seyrek düşük değerli hücreler bulunmaktadır.
Kanada'daki ekonomik faaliyet ağırlıklı olarak ABD sınırına yakın daha dar bir kuşakta yoğunlaşmakta ve yüksek enlemlerde belirgin biçimde seyrekleşmektedir.
Bu örüntüler model çıktısıdır ve özellikle Kanada'da province-altı gerçek resmî gözlemler olarak yorumlanmamalıdır.
Location Quotient nedir?
Çalışma bir grid hücresinde hangi sektörün ulusal yapıya göre daha uzmanlaşmış olduğunu göstermek için Location Quotient (LQ) kullanmaktadır.
Kaynak dipnotundaki tanım matematiksel olarak:
\[ LQ_{g,i} = \frac{\text{grid }g\text{'de sektör }i\text{ payı}} {\text{ülke genelinde sektör }i\text{ payı}} \]
şeklinde ifade edilebilir.
\(LQ=1\), sektörün grid hücresindeki ağırlığının ülke ortalamasıyla aynı olduğu anlamına gelir.
\(LQ=1{,}5\), grid hücresindeki sektör payının ulusal paydan %50 daha yüksek olduğu anlamına gelir.
Kaynak dominant sektör haritasında 1,5 üzerindeki değerleri belirgin yerel uzmanlaşma olarak yorumlamaktadır.
Sektörel mekânsal örüntüler
Model sonuçlarında tarım Kanada ve ABD'nin iç ovalarında geniş ve sınırları aşan bir koridor oluşturur.
Madencilik, petrol ve gaz faaliyetleri ABD'nin intermountain west bölgeleri, Appalachian kuşağı ve kuzey Kanada'daki bazı bölgelerde yoğunlaşır.
İmalat, Büyük Göller'in güneyindeki tarihsel sanayi kuşağını ve ABD'nin güneydoğusuna uzanan bölgeleri izler.
Finans ve iş hizmetleri büyük kuzeydoğu metropollerinde yoğunlaşırken, kamu yönetimi Washington D.C. çevresinde güçlü uzmanlaşma gösterir.
Bu sonuçların önemli mesajlarından biri sektör coğrafyasının idari sınırları takip etmek zorunda olmamasıdır. Tarım, madencilik ve imalat kuşakları eyalet veya ülke sınırlarının ötesine kesintisiz devam edebilir.
Finans sektörü haritası neyi göstermiyor?
Kaynak özel bir uyarı yapmaktadır: “Finance and Business Services” grid katmanı finansal risklerin, kredilerin veya teminatların fiziksel konum haritası olarak okunmamalıdır.
Finans, sigorta, gayrimenkul ve iş hizmetlerinde katma değer çoğu zaman şirket merkezinde kaydedilebilir; buna karşılık gerçek ekonomik veya finansal exposure başka coğrafi bölgelerde bulunabilir.
Hizmet sektörleri neden daha zor?
Bir fabrikanın, tarım alanının veya madenin fiziksel konumu uzaktan algılama verilerinde nispeten belirgin olabilir.
Buna karşılık:
- finansal aracılık,
- telekomünikasyon,
- elektrik iletimi,
- kamu yönetimi,
- eğitim ve sağlık gibi hizmetler
için değerin üretildiği yer ile fiziksel tesisin bulunduğu yer arasında doğrudan bire bir ilişki olmayabilir.
Kaynak, hizmet ağırlıklı ekonomik bölgelerin spatial allocation için daha zor olduğunu ve gelecekte bankalar, kamu kurumları, okullar, hastaneler ve perakende merkezleri gibi sektör-özel mekânsal göstergelerin eklenebileceğini belirtmektedir.
Kırsal ve uzak bölgelerdeki sınırlılık
Gece ışığı veya yapılaşma gibi göstergeler düşük nüfuslu kırsal ve uzak bölgelerde ekonomik üretimi daha zayıf temsil edebilir.
Kaynak gelecekte:
- yol ağı yoğunluğu,
- tarımsal üretkenlik endeksleri,
- pazarlara uzaklık
gibi ek değişkenlerin kullanılabileceğini önermektedir.
Nüfusla ek tutarlılık kontrolü
Yazarlar gelecekte post-benchmarking GSYH'nin nüfusun neredeyse sıfır olduğu grid hücrelerine ekonomik olarak mantıksız biçimde tahsis edilmesini önlemek için nüfusun ayrıca consistency check olarak kullanılmasını önermektedir.
Bu kontrol mevcut çalışmanın tamamlanmış bir parçası değildir; gelecekte yapılabilecek geliştirme olarak sunulmaktadır.
GeoPulse bağlantısı
Çalışmada geliştirilen gridded GDP tahminlerinin IMF'de geliştirilmekte olan GeoPulse adlı jeo-uzamsal analiz platformuna çekirdek girdi olması planlanmaktadır.
Kaynağın hedeflediği kullanım; yüksek çözünürlüklü ekonomik üretim tahminlerini doğal afet maruziyeti, finansal stres ve demografik değişim gibi başka mekânsal risk göstergeleriyle birleştirmektir.
GeoPulse'a gelecekte entegrasyon niyetidir; bu makale GeoPulse'ın tamamlanmış performans değerlendirmesini sunmamaktadır.
Çalışmanın desteklediği sonuçlar
- Resmî makroekonomik toplamlar, yüksek çözünürlüklü yer gözlemleri ve spatial random forest birlikte kullanılarak yaklaşık 1 km² düzeyinde deneysel GSYH dağılımları üretilebilir.
- Toplam log GSYH için kullanılan yer gözlemi değişkenleri yüksek öngörü performansı göstermektedir.
- Sektör düzeyindeki öngörü performansı sektörler arasında önemli ölçüde farklıdır.
- Nüfus, yapılaşmış alan ve gece ışığı toplam GSYH tahmininde güçlü öngörü değişkenleri arasındadır.
- Cropland gibi arazi örtüsü göstergeleri tarımın mekânsal dağılımı için daha güçlü bilgi taşıyabilir.
- Makine öğrenmesi tahminleri resmî sektör ve bölge toplamlarıyla otomatik olarak tutarlı değildir.
- Kuadratik reconciliation, grid ve sektör tahminlerini resmî muhasebe toplamlarıyla tam uyumlu hale getirebilir.
- İdari sınırların gizlediği sektör uzmanlaşmaları grid biçiminde daha görünür hale gelebilir.
- Kanada ve ABD uygulaması yöntem için proof-of-concept niteliğindedir.
Çalışmanın desteklemediği sonuçlar
Çalışma 1 km² hücrelerin her birinde doğrudan ölçülmüş resmî GSYH bulunduğunu göstermemektedir.
Çalışma özellikle Kanada'nın province-altı grid değerlerini bağımsız doğrulanmış resmî veri olarak sunmamaktadır.
Reconciliation sonrasında resmî toplamların tam tutması, her hücrenin gerçek ekonomik değerinin doğru tahmin edildiğini kanıtlamaz.
Yüksek \(R^2\), kullanılan uydu veya coğrafi göstergenin GSYH üzerinde nedensel etkisi bulunduğunu göstermez.
Variable importance sıralaması, değişkenlerin ekonomik büyüklük üzerindeki işaretini veya nedensel katsayısını göstermez.
Çalışma bütün ülkeler için aynı performansı kanıtlamamaktadır. Kanada ve ABD, güçlü resmî istatistik sistemlerine sahip veri-zengin pilot ekonomilerdir.
Çalışma Latin Amerika, Sahra Altı Afrika, Güney Asya veya Güneydoğu Asya'da yöntemin aynı doğrulukla çalıştığını henüz göstermemektedir; bu bölgeler gelecek genişleme alanları olarak önerilmektedir.
Çalışma henüz gridded capital stock veri seti üretmemektedir. Sermaye stoku, yöntemin gelecekte genişletilebileceği alanlardan biri olarak belirtilmektedir.
Çalışma finans ve iş hizmetleri gridini gerçek finansal exposure veya collateral haritası olarak yorumlamayı desteklememektedir.
Temel sınırlılıklar
- Kanada eğitim desteği: yalnız 13 province/territory resmî gözlemi vardır; province-altı ayrıntı model üretimidir.
- Ölçek aktarımı varsayımı: idari birimde öğrenilen ilişki grid hücresi ölçeğine uygulanmaktadır.
- Sektör heterojenliği: model performansı sektörler arasında büyük farklılık gösterir.
- Hizmet sektörü görünürlüğü: fiziksel uzaktan algılama göstergeleri bazı hizmetleri zayıf temsil eder.
- Reconciliation: resmî toplamlarla tutarlılığı sağlar fakat bağımsız hücre doğrulaması sağlamaz.
- Hiperparametre raporlaması: random forest'ın bütün düşük düzey ayarları PDF'de ayrıntılı verilmemektedir.
- Resmî birim tutarsızlığı: ana Tablo 1 ile Appendix C'nin GSYH para birimi notları birbiriyle tam uyumlu değildir.
Genel bilimsel anlam
Çalışmanın güçlü yanı resmî makroekonomik istatistiği makine öğrenmesiyle değiştirmeye çalışmamasıdır.
Yöntem iki bilgi türünün güçlü taraflarını birleştirir:
Resmî ulusal hesaplar, ekonomik büyüklüğün güvenilir toplamını sağlar.
Yer gözlemi ve spatial machine learning, toplamın coğrafya içinde nerelerde yoğunlaşabileceğine ilişkin yüksek çözünürlüklü mekânsal bilgi sağlar.
Statistical reconciliation, bu iki katmanı birbiriyle muhasebesel olarak tutarlı hale getirir.
Bu yaklaşımın bilimsel değeri, “uydu görüntüsünden gerçek GSYH'yi doğrudan görüyoruz” iddiasında değil; resmî makroekonomik toplamların mekânsal dağılımını, gözlenebilir coğrafi göstergelerden öğrenilen örüntülerle sistematik ve tekrar uygulanabilir biçimde tahsis edebilmesindedir.
Kaynak ve Yöntem Notu
Özgün başlık: Earth Observations and Machine Learning for Gridded Macroeconomic Data
Türkçe yayın başlığı: Izgara Tabanlı Makroekonomik Veriler için Yer Gözlemleri ve Makine Öğrenmesi
Yazarlar: Marco Marini, Jim Tebrake, Andinet Woldemichael.
Yazar sırası: Kaynaktaki sıra korunmuştur.
Kurum: International Monetary Fund.
Departman: Statistics Department.
Corresponding ve lead author: Andinet Woldemichael.
Eşit katkı / eş birinci yazarlık: Kaynakta böyle bir beyan bulunmamaktadır.
Çalışma numarası: WP/26/213.
Seri: IMF Working Papers.
Yayıncı: International Monetary Fund.
PDF iç tarih: September 2026.
Resmî IMF eLibrary yayın tarihi: 2 Ekim 2026.
Issue-level DOI: 10.5089/9798229062961.001.
Article-level DOI: 10.5089/9798229062961.001.A001.
Resmî yayın kaydı: IMF eLibrary, Working Paper Volume 2026, Issue 213.
SSRN: Kaynak PDF elektronik kopyanın SSRN abstract 7611151 altında bulunduğunu belirtmektedir.
Kaynak türü: IMF Working Paper; yöntem geliştirme ve deneysel veri üretimi çalışması.
Hakemlik durumu: Hakemli akademik dergi makalesi gibi sunulmamalıdır. IMF, Working Paper'ları devam eden araştırmayı tartışmaya açan yayınlar olarak tanımlar.
Telif / lisans: © 2026 International Monetary Fund. PDF “Not for Redistribution” ibaresi taşımaktadır. Creative Commons açık lisansı belirtilmemiştir.
JEL kodları: C55, O47, R12.
Kaynak anahtar kelimeleri: Earth observations; gridded GDP; spatial machine learning.
Ana araştırma amacı: Resmî ulusal ve alt-ulusal GSYH ile sektör verilerini yüksek çözünürlüklü jeo-uzamsal göstergeler kullanarak yaklaşık 1 km² grid hücrelerine downscale etmek ve sonuçları resmî muhasebe toplamlarıyla tam uyumlu hale getirmek.
Pilot ülkeler: Kanada ve Amerika Birleşik Devletleri.
Referans uygulama yılı: Ana grid sonuçlarında 2021.
ABD resmî veri desteği: County düzeyi, admin 2; 3.082 county gözlemi model eğitiminde kullanılabilmektedir.
Kanada resmî veri desteği: 13 province/territory düzeyi gözlem; province-altı bütün mekânsal ayrıntı model üretimidir.
Grid hedef çözünürlüğü: Yaklaşık 1 km².
Yüksek çözünürlüklü geocovariate çözünürlüğü: Çoğu WorldPop değişkeni yaklaşık 3 arcsecond, yani yaklaşık 100 m.
Ana yöntem: Spatial random forest + forward feature selection + leave-one-out cross-validation + kuadratik statistical reconciliation.
Yazılım: R içinde CAST Version 1.04 kütüphanesi.
Model seçimi: Farklı pooled ve split coğrafi örneklerde model varyantları eğitilmekte; değişken seçimi uygulanmakta ve en düşük RMSE'ye sahip spesifikasyon korunmaktadır.
Makine öğrenmesi temel denklemi: \(y_i^k=f(X_i^k)+\varepsilon_i^k\).
Reconciliation temel problemi: İlk ML tahminleri \(p\), resmî muhasebe kısıtı \(Hx=y_a\) altında göreli kuadratik sapmayı minimize edecek biçimde reconciled değerler \(x\)'e dönüştürülmektedir.
GLS reconciliation çözümü: \(x=p-W^{-1}H'(HW^{-1}H')^{-1}(Hp-y_a)\).
Reconciliation teknik ayrıntısı: Sıfır tahminli hücrelere ağırlık matrisini tanımlı tutmak için geçici 0,01 değeri verilir ve işlem sonrasında tekrar sıfırlanır.
Negatif değer durumu: GLS çözümü teorik olarak negatif hücre üretebilir; kaynak Kanada–ABD uygulamasında negatif reconciled değer oluşmadığını bildirir.
Toplam GSYH performansı: log GSYH için RMSE 0,39, \(R^2=0{,}95\), MAE 0,29; log GSYH/km² için RMSE 0,44, \(R^2=0{,}94\), MAE 0,32.
Sektör performansı: Tarım ve madencilik görece güçlü; kamu yönetimi, utilities, ticaret/konaklama ve ulaşım/iletişim daha düşük \(R^2\) değerlerine sahiptir.
Reconciliation öncesi önemli sapma: Tarım ve utilities sektörlerinde gridded toplamlar resmî GSYH'nin yaklaşık dört-beş katına çıkabilmektedir.
2021 pozitif GSYH grid kapsamı: Kanada 988.661 hücre; ABD 5.354.938 hücre.
Para birimi kaynak-içi tutarsızlığı: Ana Tablo 1 GSYH değerlerini “USD PPP bn” olarak etiketler ve yöntem bölümü WEO PPP benchmark'ını tanımlar; Appendix C tablo notu ise aynı seriyi “current USD billions” olarak tanımlar. Verianla bu tutarsızlığı sessizce düzeltmemiştir.
Hedef değişken sembolü kaynak-içi belirsizliği: Yöntem bölümündeki hedef kümesinde SER sembolü yer almakta, ancak Appendix A'daki 10 sektör sınıflamasında ayrı bir SER kategorisi tanımlanmamaktadır. Kaynakta bulunmayan açıklama eklenmemiştir.
Veri erişilebilirliği: Kaynak BEA, Statistics Canada, WorldPop, ESA, NASA ve Global Energy Monitor dahil kullanılan veri kaynaklarını ayrıntılı listeler; PDF'de tek bir açık replikasyon paketi veya ayrı standart Data Availability Statement verilmemektedir.
Model hiperparametre erişilebilirliği: CAST 1.04, spatial random forest, feature selection ve cross-validation yapısı raporlanmaktadır; bütün düşük düzey random forest hiperparametreleri PDF'de açık değildir.
Finansman bildirimi: Kaynakta ayrı standart araştırma finansmanı beyanı bulunmamaktadır.
Çıkar çatışması: Kaynakta ayrı standart çıkar çatışması beyanı bulunmamaktadır.
CRediT / yazar katkıları: Kaynakta standart CRediT katkı tablosu bulunmamaktadır.
Teşekkür: Kaynak Javier Uruñuela López'e yorum ve önerileri; Alessandra Sozzi ile Zhaosheng Li'ye gridded GDP verisinin geliştirilmesindeki destekleri için teşekkür etmektedir.
Temel yöntemsel sınırlılık: Grid düzeyindeki değerler resmî doğrudan gözlem değildir. Reconciliation aggregate tutarlılık sağlar fakat hücre doğruluğunu bağımsız biçimde doğrulamaz. Kanada'da province-altı mekânsal dağılım tamamen model tarafından üretilmektedir.
Gelecek çalışma: Kırsal/uzak alanlar için yeni covariate'ler, hizmet sektörüne özgü altyapı noktaları, nüfus tabanlı tutarlılık kontrolü, başka coğrafyalara genişletme ve gridded capital stock üretimi önerilmektedir.
Kurumsal görüş uyarısı: Kaynaktaki görüşler yazarlara aittir; IMF, IMF Executive Board veya IMF management görüşlerini zorunlu olarak temsil etmez.
Yayın notu: Bu Türkçe anlatım kaynak Working Paper'ın veri yapısını, spatial random forest yöntemini, grid downscaling mantığını, cross-validation ve feature-selection adımlarını, statistical reconciliation denklemlerini, performans sonuçlarını, mekânsal sektör bulgularını ve sınırlılıklarını öğretici biçimde aktarmaktadır. Kaynakta bulunmayan grid değeri, model sonucu, istatistik, hiperparametre veya ülke genellemesi üretilmemiştir. Bilimsel atıflarda özgün IMF Working Paper ve resmî DOI esas alınmalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir