


1. Je, chanzo kilikaguliwa kwa ukamilifu kutoka mwanzo hadi mwisho pamoja na vielelezo vyake? Ndiyo; maandishi makuu ya PDF yenye kurasa 36, vielelezo tisa vikuu, majedwali mawili ya msingi ya matokeo, Appendix A-D na hasa hisabati ya reconciliation katika Appendix B vilikaguliwa. 2. Je, matokeo yote ya kisayansi yanategemea chanzo? Ndiyo; hakuna thamani ya grid, usahihi wa modeli, matokeo ya nchi au utendaji wa sekta usiopatikana katika chanzo uliotengenezwa. 3. Je, utambulisho wa kibibliografia ni sahihi; na je, wavuti ya nje ilitumika tu kwa uthibitishaji wa kibibliografia? Ndiyo; wavuti ya nje ilitumika tu kuthibitisha tarehe rasmi ya uchapishaji ya IMF, nambari na rekodi ya DOI. Nambari ya utafiti iliyokosekana katika recommended-citation ya PDF pia ilibainishwa. 4. Je, tofauti ya uigaji / jaribio / uwanja / kliniki / kinadharia ni sahihi? Ndiyo; utafiti si jaribio la uga la kisababishi, bali ni mbinu ya majaribio ya spatial downscaling na uzalishaji wa data inayounganisha data rasmi na uchunguzi wa Dunia. 5. Je, fomula kuu, kigezo cha mbinu, kielelezo au matokeo ya namba yalirukwa katika chanzo? Mlinganyo wa spatial random forest, cross-validation, forward feature selection, vikwazo vya grid, vikwazo vya reconciliation, hasara ya kuadrati, GLS estimator, vipimo vya utendaji, matokeo ya sekta na vikwazo vikuu vilishughulikiwa. 6. Je, ujumbe wa kisayansi wa vielelezo na grafu ni sahihi? Ndiyo; kwa kuwa data ghafi za seli za ramani za chanzo hazikupatikana, ramani bandia yenye usahihi wa kubuniwa ya Kanada-Marekani haikutengenezwa. Mahusiano kamili ya mbinu yalionyeshwa kwa mchoro huru wa mchakato wa SVG. 7. Je, mpangilio wa H2 sita za kimuundo umehifadhiwa? Ndiyo. 8. Ikiwa kuna H2 za ziada, je, ni maswali yenye thamani kubwa ya AEO pekee? Ndiyo; gridded GDP, spatial random forest na reconciliation zina thamani ya swali huru kwa kuelewa kiini cha utafiti. 9. Je, entity/mbinu/modeli kuu ya kisayansi imefafanuliwa wazi na kwa kuungwa mkono na chanzo? Ndiyo; gridded GDP, spatial random forest na statistical reconciliation zilifafanuliwa katika matumizi yao ya kwanza kwa kueleza ni nini na zinafanya nini. 10. Je, mpaka wa tafsiri kuhusu kile utafiti unachounga mkono / hauungi mkono unaonekana? Ndiyo; ugawaji wa modeli dhidi ya takwimu rasmi, uhusiano dhidi ya usababishaji, na reconciliation dhidi ya uthibitishaji huru wa seli zimetenganishwa. 11. Je, muundo wa HTML/SVG/Base64 ni salama? Ndiyo; script, iframe, event handler, foreignObject, URL ya picha ya nje na Base64 iliyoharibika havikutumika. SVG ni huru, haina kipimo cha data na tagi zake zimefungwa. 12. Je, makala ni salama kwa tafsiri na je, undani wa kisayansi haukupunguzwa kwa ajili ya urahisi wa kutafsiri? Ndiyo; istilahi canonical ziliwekwa thabiti, milinganyo ya MathJax ilitenganishwa na maandishi yanayoonekana na undani wa kiufundi umehifadhiwa. LANGO DOGO LA REJEA YA PICHA: A. Ujumbe wa kisayansi wa ramani muhimu za chanzo ulielezwa wazi katika maandishi; kwa kuwa data ghafi za seli hazikuwepo, ramani zenyewe hazikubuniwa. B. Mtiririko wa mbinu unaoweza kujengwa upya haukuachwa katika maandishi pekee; SVG halisi ya inline ilitengenezwa. C. Thamani za utendaji kutoka chanzo ziliwasilishwa katika jedwali la HTML linaloonekana. D. Hakuna rejea tupu iliyobaki inayomwelekeza msomaji kwenye “Kielelezo X” kisichoonekana. LANGO DOGO LA HAKIMILIKI / LESENI: Chanzo kina © 2026 International Monetary Fund na kina tamko “Not for Redistribution”. Hakuna leseni ya wazi ya Creative Commons iliyobainika. Ramani au grafu za chanzo hazikunakiliwa moja kwa moja; mahusiano ya kisayansi pekee yaliwasilishwa kwa mchoro huru wa Verianla, jedwali na maelezo asilia.
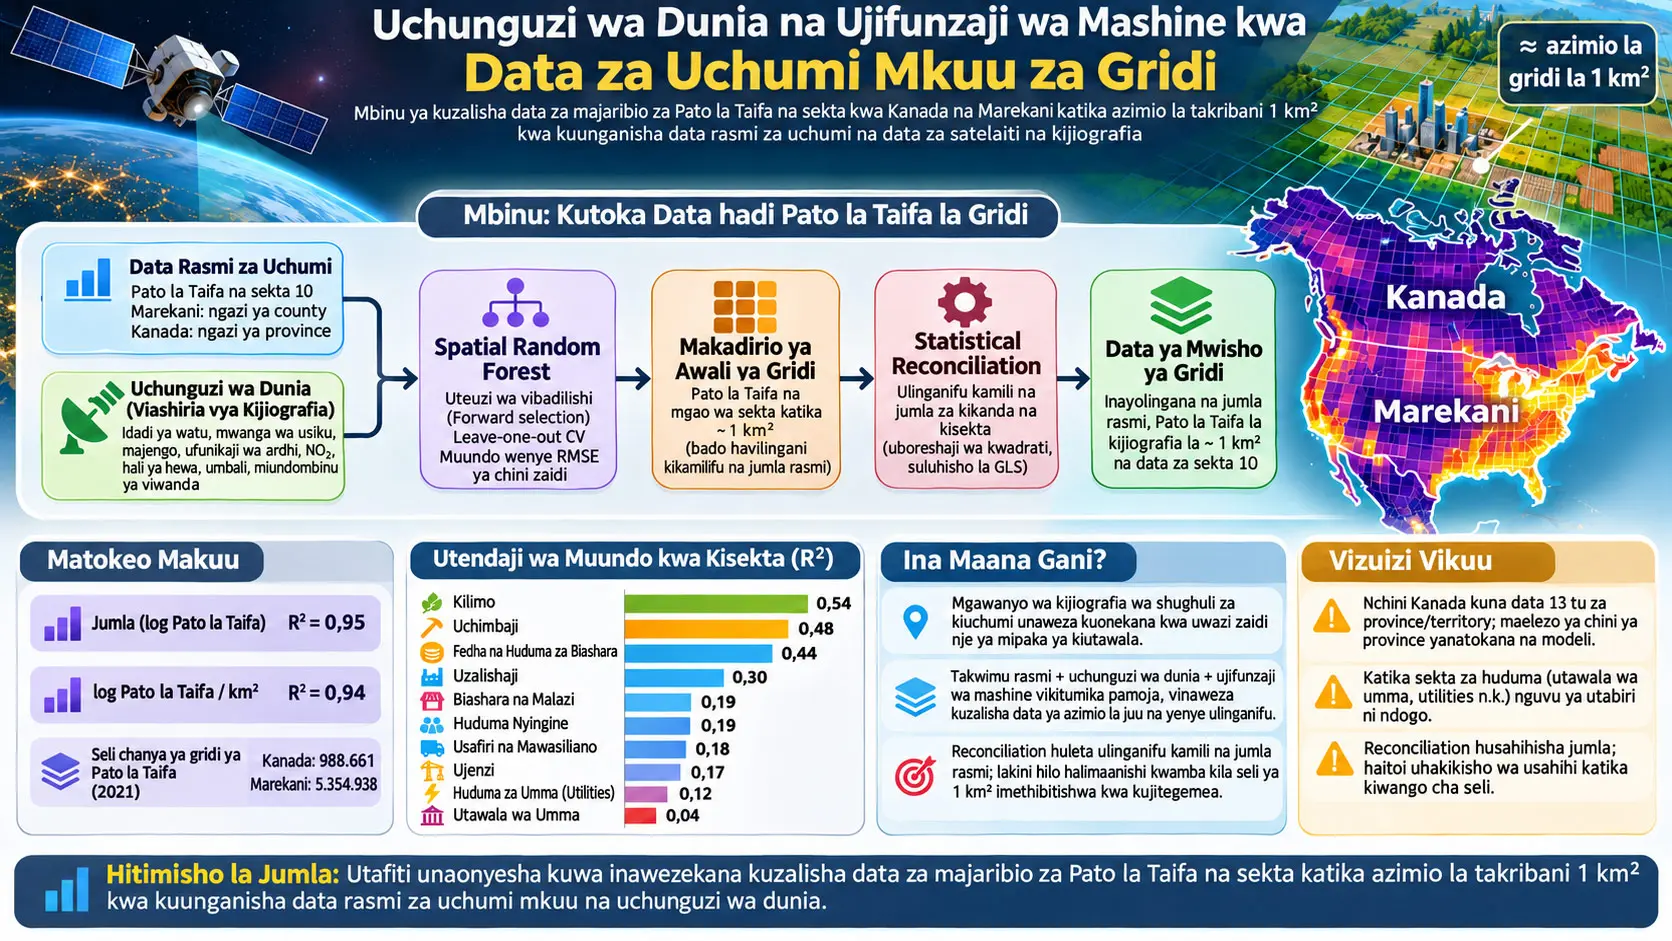
Pato la Taifa kwa gridi (gridded GDP) ni uwakilishi wa data za uchumi mkuu wa kijiografia unaowezesha uzalishaji wa kiuchumi kukadiriwa si kwa maeneo ya kiutawala kama nchi, jimbo au mkoa pekee, bali pia katika seli za kijiografia zilizopangwa kwa utaratibu. Utafiti wa Marco Marini, Jim Tebrake na Andinet Woldemichael unaendeleza mbinu ya hatua mbili ya kuzalisha Pato la Taifa la majaribio na hisa za sekta 10 katika seli za grid za takribani 1 km² kwa Kanada na Marekani, kwa kuunganisha data rasmi za Pato la Taifa za kitaifa na za chini ya taifa na idadi ya watu, mwanga wa usiku, maeneo yaliyojengwa, ufuniko wa ardhi na vigezo vingine vya uchunguzi wa Dunia vyenye mwonekano wa juu.
Katika hatua ya kwanza, watafiti hufundisha modeli za spatial random forest katika kiwango cha kiutawala chenye maelezo mengi zaidi ambacho data rasmi za Pato la Taifa na sekta zinapatikana. Nchini Marekani, data za mafunzo hushuka hadi kiwango cha county, ilhali Kanada zinafikia tu kiwango cha province/territory. Ingizo za modeli zinajumuisha idadi ya watu, mwanga wa usiku, dioksidi ya nitrojeni, msongamano na eneo la majengo, umbali hadi barabara na uso uliojengwa, umbali hadi ardhi ya kilimo, halijoto, mvua, ufuniko wa ardhi na ukaribu wa mitambo ya viwanda vizito.
Katika hatua ya pili, makadirio ya grid yaliyotengenezwa kwa ujifunzaji wa mashine hayakubaliwi moja kwa moja kuwa data ya mwisho. Watafiti hufanya upatanishaji upya wa makadirio ya grid na sekta na hesabu rasmi za kikanda kwa kutumia mbinu ya uboreshaji wa kuadrati iitwayo statistical reconciliation. Hivyo, jumla ya makadirio ya kiwango cha seli hufanywa kuwa sawa kabisa na Pato la Taifa rasmi la eneo husika na jumla za sekta, huku mgawanyo wa kijiografia uliopendekezwa na ujifunzaji wa mashine ukihifadhiwa kadiri iwezekanavyo.
Utendaji wa modeli kwa shughuli zote za kiuchumi ni wa juu: katika modeli ya log Pato la Taifa \(R^2=0{,}95\), na katika modeli ya log Pato la Taifa/km² \(R^2=0{,}94\) zimeripotiwa. Hata hivyo, utendaji katika kiwango cha sekta hutofautiana sana. Kwa kilimo \(R^2=0{,}54\), kwa uchimbaji madini 0,48, kwa fedha na huduma za biashara 0,44 na kwa viwanda 0,30, wakati kwa utawala wa umma ni 0,04 na kwa utilities ni 0,12.
Tofauti hii ni muhimu; kwa sababu viashiria vya kimwili kama mwanga wa usiku, ujenzi na ufuniko wa ardhi vinaweza kukamata kwa kiasi fulani kilimo, uchimbaji madini au shughuli nzito za kiuchumi mijini, ilhali katika utilities na baadhi ya sekta za huduma, mahali thamani inapozalishwa huenda pasiwe sawa na mahali miundombinu ya kimwili inayoonekana ilipo.
Katika makadirio ya awali kabla ya reconciliation, sekta za kilimo na utilities zinaweza kupotoka kutoka jumla rasmi za sekta kwa takribani mara nne-tano. Reconciliation husahihisha kutolingana huku kwa jumla kwa upande wa uhasibu; hata hivyo, marekebisho hayo hayamaanishi kwamba kila makadirio ya seli ya 1 km² yamethibitishwa kwa njia huru.
Moja ya mipaka muhimu zaidi ya tafsiri ya utafiti ni Kanada. Ingawa uundaji wa modeli wa Marekani unaweza kutumia matokeo rasmi katika kiwango cha county 3.082, kwa Kanada kuna uchunguzi 13 pekee wa province na territory. Kwa hiyo, maelezo yote ya kijiografia ya Kanada yaliyo chini ya province ni ugawaji wa majaribio uliotengenezwa na modeli; si Pato la Taifa rasmi la 1 km² lililochunguzwa kwa njia huru.
Tatizo kuu la utafiti ni nini?
Takwimu za uchumi mkuu kwa kawaida huchapishwa kwa nchi au maeneo makubwa ya chini ya taifa. Njia hii ni imara kwa kupima ukubwa wa jumla wa uchumi; lakini haionyeshi kwa undani ni katika maeneo gani ya kijiografia shughuli za kiuchumi zimejikita ndani ya nchi ileile.
Upungufu huu huwa muhimu hasa katika aina zifuatazo za uchambuzi:
- kutathmini athari za kiuchumi za ndani za mafuriko, vimbunga, moto au hatari nyingine za kimwili,
- kutambua mapengo ya miundombinu,
- kuchunguza kutokuwiana kwa uchumi wa kikanda,
- uchambuzi wa kijiografia wa miunganisho ya usafiri na biashara,
- kuunda modeli za uzalishaji wa ndani na mkusanyiko wa sekta.
Kwa mfano, ndani ya jimbo au province ileile, jiji kubwa, eneo la kilimo, eneo la uchimbaji madini na eneo la vijijini lenye watu wachache vinaweza kufichwa ndani ya wastani uleule wa kiutawala. Kwa hiyo, utafiti unalenga kusambaza shughuli za kiuchumi katika seli ndogo zaidi za kijiografia bila kuvuruga jumla rasmi.
Pato la Taifa kwa Gridi ni Nini?
Pato la Taifa kwa gridi ni uwakilishi wa kijiografia wa jumla rasmi ya uzalishaji wa kiuchumi uliogawanywa katika seli za kijiografia zilizopangwa kwa utaratibu; katika utafiti huu azimio lengwa ni takribani 1 km², na thamani za seli si vipimo rasmi vya moja kwa moja bali ni makadirio ya modeli yaliyotokana na hesabu rasmi na viashiria vya kijiografia vyenye mwonekano wa juu.
Dhana ya Gross Cell Product
Katika fasihi, uzalishaji katika seli ya grid wakati mwingine huitwa Gross Cell Product (GCP). Maana ya dhana ya GCP inafanana na Pato la Taifa; tofauti ni kwamba eneo la upimaji ni seli ya grid yenye ukubwa maalumu badala ya nchi au eneo la kiutawala.
Lengo la utafiti si kujenga mfumo mpya wa hesabu za taifa kuchukua nafasi ya Pato la Taifa rasmi. Kinyume chake, ni kuongeza maelezo ya kijiografia huku hesabu rasmi zikihifadhiwa kama “anchor” ya kiwango cha juu au jumla isiyobadilika.
Downscaling ina maana gani?
Downscaling ni mchakato wa kusambaza kigezo kilichopo katika vitengo vikubwa zaidi vya kijiografia kwenda katika vitengo vidogo zaidi vya kijiografia kwa kutumia taarifa zinazohusiana zenye mwonekano wa juu.
Katika utafiti huu mchakato kwa muhtasari unaendelea kama ifuatavyo:
\[ \text{Resmî bölgesel GSYH} \rightarrow \text{Yer gözlemi ilişkileri} \rightarrow \text{1 km}^2 \text{ grid tahminleri} \rightarrow \text{Resmî toplamlarla reconciliation} \]
Hivyo ndivyo mchakato unavyoendelea.
Mlinganyo huu si mlinganyo wa makadirio ya utafiti, bali ni uwakilishi wa kufundishia wa mtiririko wa mbinu.
Kwa nini uchunguzi wa Dunia hubeba taarifa kuhusu shughuli za kiuchumi?
Hakuna hata kimoja kati ya vigezo vya kijiografia vinavyotumiwa katika utafiti ambacho chenyewe ni “Pato la Taifa”. Hivi ni viashiria vinavyoweza kuhusishwa na mgawanyo wa kijiografia wa shughuli za kiuchumi.
Idadi ya watu: hubeba taarifa kuhusu ugavi wa nguvu kazi na msongamano wa watumiaji.
Mwanga wa usiku: unaweza kutumiwa kama kigezo mbadala cha shughuli za kiuchumi kupitia msongamano wa makazi na maeneo ya uzalishaji yenye mwanga.
NO₂: inaweza kubeba taarifa kuhusu shughuli za kiuchumi za ndani katika maeneo yenye vyanzo vingi vya mwako kama magari na mashine zinazotumia mafuta.
Alama ya eneo la majengo: inahusiana na mtaji wa kimwili na msongamano wa makazi kupitia idadi ya majengo, msongamano wake na eneo linalofunikwa.
Ufuniko wa ardhi: unaweza kusaidia kukamata uhusiano wa maeneo ya kilimo, misitu, maeneo yaliyojengwa, maji, theluji/barafu na madaraja mengine ya uso na mgawanyo wa kijiografia wa sekta.
Vigezo vya umbali: umbali hadi barabara, uso uliojengwa na ardhi iliyolimwa huwakilisha uhusiano wa aina tofauti za shughuli na vituo vya mijini pamoja na miundombinu.
Mitambo ya viwanda vizito: hutoa taarifa ya moja kwa moja ya mahali kuhusu uwepo wa kijiografia wa shughuli maalumu za uzalishaji kama chuma na steel.
Matokeo ya idadi ya watu na mwanga wa usiku yanapaswa kusomwaje?
Kanada na Marekani zinapotathminiwa pamoja, chanzo kinaripoti takribani \(R^2=0{,}95\) kati ya Pato la Taifa la chini ya taifa na idadi ya watu, na takribani \(R^2=0{,}94\) kati ya mwanga wa usiku na Pato la Taifa.
Thamani hizi za juu hazionyeshi kwamba idadi ya watu au mwanga wa usiku “huunda” Pato la Taifa. Haya ni mahusiano makubwa ya utabiri wa kijiografia. Modeli hutumia vigezo hivi kukadiria mgawanyo wa kijiografia wa shughuli za kiuchumi.
Vyanzo vya data na azimio lake
| Kigezo | Azimio / kiwango cha kiutawala | Kipindi cha muda | Chanzo |
|---|---|---|---|
| Pato la Taifa la chini ya taifa la Marekani | County, admin 2 | 2001–2023 | BEA |
| Pato la Taifa la chini ya taifa la Kanada | Province, admin 1 | 1997–2021 | Statistics Canada |
| Data za sekta 10 za Marekani | County, admin 2 | 2001–2023 | BEA |
| Data za sekta 10 za Kanada | Province, admin 1 | 1997–2021 | Statistics Canada |
| Idadi ya watu | 3 arcsecond, takribani 100 m | Kipindi kimoja hakijaainishwa katika jedwali la chanzo | WorldPop |
| Mwanga wa usiku | 3 arcsecond, takribani 100 m | 2015–2023 | WorldPop |
| Umbali hadi uso uliojengwa | 3 arcsecond, takribani 100 m | 2015–2030 | WorldPop |
| Umbali hadi barabara | 3 arcsecond, takribani 100 m | 2023 | WorldPop |
| Wastani wa mvua wa mwaka | 3 arcsecond, takribani 100 m | 2015–2023 | WorldPop |
| Wastani wa halijoto | 3 arcsecond, takribani 100 m | 2015–2023 | WorldPop |
| Umbali hadi ardhi iliyolimwa | 3 arcsecond, takribani 100 m | 2015–2023 | WorldPop |
| Idadi ya majengo | 3 arcsecond, takribani 100 m | 2023 | WorldPop |
| Msongamano wa majengo | 3 arcsecond, takribani 100 m | 2023 | WorldPop |
| Eneo la majengo | 3 arcsecond, takribani 100 m | 2023 | WorldPop |
| Uainishaji wa ufuniko wa ardhi | 3 arcsecond, takribani 100 m | 2015–2023 | ESA |
| Wastani wa mwaka wa NO₂ ya uso | 1 km | 1990–2020 | NASA |
| Idadi ya mitambo ya chuma na chuma cha pua ndani ya 50 km | Idadi ndani ya radius ya 50 km | Kihistoria–2025 | Global Energy Monitor |
Uainishaji wa sekta 10
Data rasmi za sekta za kitaifa na za chini ya taifa zimeoanishwa na uainishaji wa Groningen Growth and Development Centre 10-Sector Database. Uainishaji huu unatokana na ISIC Rev. 3.1.
| Kifupi | Sekta |
|---|---|
| AGR | Kilimo, uwindaji, misitu na uvuvi |
| MIN | Uchimbaji madini na mawe |
| MAN | Viwanda |
| PUB | Huduma za umeme, gesi na maji |
| CON | Ujenzi |
| TRAD | Biashara ya jumla/rejareja, hoteli na migahawa |
| TRAN | Usafiri, uhifadhi na mawasiliano |
| FIN | Fedha, bima, mali isiyohamishika na huduma za biashara |
| GOV | Huduma za umma / utawala wa umma |
| OTH | Huduma nyingine za jamii, kijamii na binafsi |
Mwishoni mwa orodha ya vigezo lengwa katika mlinganyo wa mbinu wa chanzo, alama SER pia inaonekana. Kwa kuwa katika jedwali la sekta 10 la Appendix A hakuna kategoria tofauti ya SER iliyofafanuliwa, Verianla haijaipa alama hii maana mpya ambayo haipo katika chanzo.
Spatial Random Forest Inafanya Nini Katika Utafiti Huu?
Spatial random forest ni mbinu ya ujifunzaji wa mashine inayotegemea mkusanyiko wa miti ya maamuzi, ambayo hujifunza mahusiano yasiyo ya mstari ya utabiri kati ya matokeo rasmi ya kiuchumi ya chini ya taifa na viashiria vya kijiografia vyenye mwonekano wa juu, kisha kuhamisha mahusiano hayo kwenye seli za grid; lengo la utafiti si kuzalisha mgawo wa kisababishi, bali kufanya makadirio ya kijiografia.
Mlinganyo msingi wa modeli
Chanzo hufafanua modeli kwa kila kigezo lengwa katika umbo hili la jumla:
\[ y_i^k=f(X_i^k)+\varepsilon_i^k. \]
Hapa:
- \(i\) inawakilisha kitengo cha kiutawala cha chini ya taifa ambako data rasmi inachunguzwa.
- \(k\) inawakilisha kigezo lengwa kama log Pato la Taifa, Pato la Taifa/km² au hisa ya sekta fulani.
- \(y_i^k\) ni kigezo lengwa kinachochunguzwa katika kitengo cha kiutawala.
- \(X_i^k\) ni vekta inayojumuisha idadi ya watu, mwanga wa usiku, ujenzi, hali ya hewa na vigezo vingine vya kijiografia vinavyoeleza.
- \(f(\cdot)\) ni ulinganishaji usiojulikana usio wa mstari unaojifunzwa na spatial random forest.
- \(\varepsilon_i^k\) ni neno la ziada la hitilafu ambalo modeli haiwezi kulieleza.
Jambo muhimu katika mlinganyo ni kwamba watafiti hawalazimishi mapema umbo la kazi ya mstari kwa \(f(\cdot)\). Random forest ni mbinu nyumbufu ya utabiri inayotegemea matumizi ya miti mingi ya maamuzi kwa pamoja.
Mantiki ya random forest
Katika mantiki ya jumla ya random forest, miti mingi ya maamuzi huundwa juu ya mchanganyiko tofauti wa uchunguzi na vigezo. Kila mti hutoa makadirio kwa kigezo lengwa na makadirio ya mkusanyiko wa miti huunganishwa.
Matumizi katika utafiti huu yanafafanuliwa kuwa spatial; kwa sababu mafunzo na tathmini ya modeli hufuata fasihi ya spatial machine learning kwa namna inayozingatia utegemezi wa kijiografia.
Chanzo kinaripoti kwamba katika utekelezaji kinatumia maktaba ya CAST Version 1.04 ndani ya R.
Uteuzi wa vigezo unafanywaje?
Chanzo kinatumia forward feature selection.
Forward feature selection ni mbinu ya uteuzi wa vipengele inayoweka mwanzo seti ndogo ya vigezo na kisha kuongeza hatua kwa hatua vigezo vinavyoeleza ambavyo vinaboresha utendaji wa utabiri wa modeli.
Lengo si kujaza modeli kiotomatiki kwa kila kigezo cha kijiografia kinachopatikana, bali kuchagua mchanganyiko unaoboresha utendaji wa utabiri kwa kigezo lengwa.
Cross-validation inafanywaje?
Kwa utendaji wa modeli, chanzo kinaripoti kutumia mbinu ya leave-one-out ndani ya mfumo wa k-fold cross-validation.
Katika mantiki ya leave-one-out, uchunguzi au kitengo fulani cha kijiografia huondolewa kwenye mafunzo, modeli hufundishwa kwa data iliyobaki, na utendaji wa utabiri hukaguliwa kwenye kitengo kilichoachwa nje. Mchakato hurudiwa kwa uchunguzi tofauti ili kutathmini kama modeli imekariri tu data ya mafunzo.
Chanzo huchagua kati ya variants za modeli specification yenye thamani ya chini zaidi ya Root Mean Square Error (RMSE).
RMSE, MAE na R² zinaeleza nini?
RMSE ni kipimo cha wastani wa hitilafu kinachotoza adhabu kubwa zaidi kwa mraba wa makosa ya makadirio. RMSE ya chini inaendana na utendaji bora wa utabiri.
MAE hupima ukubwa wa wastani wa tofauti kamili kati ya makadirio na uchunguzi. Thamani ya chini humaanisha hitilafu ndogo ya wastani.
\(R^2\) ni kipimo kinachoonyesha ni kiasi gani cha mabadiliko katika kigezo lengwa kinachoendana na makadirio ya modeli. Thamani inapokaribia 1 humaanisha ulinganifu wa juu zaidi; hata hivyo, \(R^2\) ya juu haimaanishi usababishaji wala kwamba kila seli ya grid imekadiriwa kwa usahihi.
Ni hyperparameters zipi ambazo chanzo hakiripoti?
Chanzo kinaeleza mbinu ya spatial random forest, maktaba ya CAST 1.04, muundo wa feature-selection na cross-validation. Hata hivyo, katika PDF kwa random forest:
- idadi ya mwisho ya miti,
mtrykama idadi ya vigezo kwa kila node,- ukubwa wa chini wa node,
- kina cha juu cha mti,
- random seed ya mwisho
na hyperparameters nyingine zote za kiwango cha chini haziripotiwi wazi. Thamani hizi hazijakadiriwa na Verianla.
Dhana katika uhamishaji kutoka kiwango cha kiutawala hadi seli ya grid ya 1 km²
Mahusiano ya modeli hujifunzwa kwanza katika vitengo vya kiutawala ambako matokeo rasmi ya kiuchumi yanapatikana. Kisha uhusiano huohuo hutumiwa kwenye seli za grid zenye mwonekano wa juu.
Kwa hiyo chanzo kina dhana iliyo wazi: inakubaliwa kwamba uhusiano kati ya kigezo cha kijiografia na shughuli za kiuchumi uliojifunzwa katika kiwango cha kitengo cha kiutawala unaweza kutumika pia katika kiwango cha seli.
Dhana hii ni muhimu hasa kwa Kanada; kwa sababu ndani ya province hakuna uchunguzi rasmi wa mafunzo wa Pato la Taifa wa chini ya province.
Kwa Nini Statistical Reconciliation Inahitajika?
Statistical reconciliation ni hatua ya uboreshaji wa kuadrati inayounganisha kikamilifu makadirio ya grid ya ujifunzaji wa mashine, ambayo yana maelezo mengi lakini jumla zake zinaweza kupotoka kutoka hesabu rasmi, na jumla rasmi za kikanda na za sekta huku ikihifadhi kadiri iwezekanavyo muundo wa kijiografia na wa kisekta.
Kwa nini makadirio ya ujifunzaji wa mashine pekee hayatoshi?
Random forest inaweza kukadiria muundo wa kiuchumi wa seli au eneo kutokana na viashiria vya kijiografia. Lakini haihakikishi kiotomatiki kwamba jumla ya sekta inayopatikana seli zote zinapojumlishwa itakuwa sawa na hesabu rasmi za taifa.
Tofauti hii inaonekana wazi hasa katika matokeo ya awali ya utafiti. Katika baadhi ya sekta kama kilimo na utilities, jumla za grid kabla ya reconciliation zinaweza kupotoka mara kadhaa kutoka thamani rasmi.
Kwa hiyo makala hutumia ujifunzaji wa mashine si kuchukua nafasi ya takwimu rasmi, bali kama injini ya ugawaji wa kijiografia inayowekewa mipaka na takwimu rasmi.
Notation ya reconciliation
Katika Appendix B:
- \(g=1,\ldots,G\): inawakilisha seli za grid,
- \(i=1,\ldots,I\): inawakilisha sekta,
- \(r=1,\ldots,R\): inawakilisha maeneo ya chini ya taifa
zinaonyesha.
\(p_{g,i}\) ni makadirio ya ujifunzaji wa mashine kabla ya reconciliation kwa grid \(g\) na sekta \(i\).
\(x_{g,i}\) ni thamani ya mwisho baada ya reconciliation kwa seli na sekta hiyo hiyo.
Matrix ya spatial aggregation
Chanzo kinafafanua matrix:
\[ S_{rg}= \begin{cases} 1, & \text{grid } g \in r,\\ 0, & \text{aksi halde} \end{cases} \]
Hii ndiyo matrix inayofafanuliwa.
Ikiwa \(S_{rg}=1\), seli ya grid \(g\) iko ndani ya eneo \(r\). Ikiwa \(S_{rg}=0\), haiko.
Matrix hii rahisi ya binary hufanya iwezekane kufafanua kialjebra ni eneo gani rasmi la kiutawala ambalo mamilioni ya seli za grid zinahusika nalo.
Kizuizi cha kwanza: jumla ya eneo na sekta
Kwa kila eneo \(r\) na sekta \(i\):
\[ \sum_{g\in r}x_{g,i} = y_{r,i}^{\mathrm{off}}. \]
Hapa \(y_{r,i}^{\mathrm{off}}\) ni jumla rasmi ya kiuchumi kwa eneo na sekta husika.
Maana ya kizuizi hiki ni hii: kwa mfano, seli zote za grid za viwanda ndani ya province fulani zinapojumlishwa, matokeo lazima yawe sawa na thamani rasmi ya viwanda ya province hiyo.
Kizuizi cha pili: sekta zote za eneo
Pili, chanzo kinatumia:
\[ \sum_{i=1}^{I} \sum_{g\in r} x_{g,i} = y_r^{\mathrm{off}} \]
kama sharti.
Mlinganyo huu unalazimisha kwamba sekta zote na seli zote za grid zinapojumlishwa, jumla rasmi ya Pato la Taifa ya eneo husika ifikiwe.
Kwa nini Kronecker product inatumika?
Chanzo kinapotunga vikwazo hivyo hivyo katika umbo la matrix, kinatumia Kronecker product yenye alama \(\otimes\).
Kronecker product huwezesha kuunganisha matrix ya spatial aggregation na dimensheni ya sekta ndani ya muundo mmoja mkubwa wa block matrix.
Matrix ya utambulisho wa sekta \(I_I\) inapotumiwa, kizuizi cha jumla ya kikanda kwa kila sekta kinaweza kuhifadhiwa kivyake. Vekta \(1_I'\) yenye namba moja pekee inapotumiwa, sekta zinaweza kujumlishwa pamoja.
Umbo fupi la vikwazo vyote
Chanzo hukusanya vikwazo vyote rasmi vya uhasibu katika mfumo mmoja:
\[ Hx=y_a \]
kwa namna hiyo katika mfumo mmoja.
\(H\) ni matrix sparse inayoweka msimbo wa muundo wa uhasibu wa eneo-sekta. \(x\) ni vekta kubwa ya thamani za grid-sekta zilizofanyiwa reconciliation. \(y_a\) inawakilisha thamani rasmi za aggregate zinazopaswa kutekelezwa.
Kazi ya hasara ya kuadrati
Wakati makadirio ya ujifunzaji wa mashine yanafanywa yaendane na jumla rasmi, haitakiwi kuvuruga bila sababu muundo wa awali wa kijiografia wa seli.
Kwa hiyo chanzo hutumia kigezo:
\[ \min_x \sum_{g,i} \left( \frac{x_{g,i}-p_{g,i}} {p_{g,i}} \right)^2 \]
kama kigezo.
Usemi huu hutoa adhabu kwa mabadiliko ya jamaa, si mabadiliko ya kabisa.
Kwa mfano, mabadiliko yale yale ya vitengo 10 yana maana ya marekebisho madogo ya jamaa kwa seli kubwa yenye makadirio ya awali ya 1.000, lakini marekebisho makubwa sana ya jamaa kwa seli ndogo yenye makadirio ya awali ya 20.
Matrix ya uzani
Katika umbo la matrix:
\[ \min_x (x-p)'W(x-p) \]
na:
\[ W= \operatorname{diag} \left( \frac{1}{p_{g,i}^2} \right). \]
Matrix ya uzani \(W\) hufanya adhabu ya hitilafu itumike katika kipimo cha jamaa.
Tatizo la uboreshaji lenye vikwazo
Tatizo kamili ni:
\[ \min_x (x-p)'W(x-p) \]
chini ya sharti:
\[ Hx=y_a. \]
Kwa maneno mengine, mfumo lazima ufanye mambo mawili kwa wakati mmoja:
- ulingane kikamilifu na jumla rasmi za uhasibu,
- uondoke kwa kiwango kidogo zaidi cha jamaa kinachowezekana kutoka mgawanyo wa awali wa kijiografia na kisekta uliopatikana kwa ujifunzaji wa mashine.
GLS reconciliation estimator
Masharti ya daraja la kwanza katika chanzo yanatoa suluhisho hili:
\[ x = p - W^{-1}H' \left( HW^{-1}H' \right)^{-1} \left( Hp-y_a \right). \]
Mlinganyo huu ni mojawapo ya miundo muhimu zaidi ya kihisabati katika utafiti.
\(p\): ni makadirio ya awali ya ujifunzaji wa mashine.
\(Hp\): ni jumla inayotengenezwa na makadirio haya ya awali chini ya muundo rasmi wa aggregation.
\(Hp-y_a\): ni kutolingana kati ya jumla ya ujifunzaji wa mashine na jumla rasmi.
\(W^{-1}H'(HW^{-1}H')^{-1}\): ni muundo wa marekebisho unaoamua kwa uzani gani kutolingana huku kutasambazwa tena kwenye seli za grid na sekta.
\(x\): ni matokeo yaliyofanyiwa reconciliation yanayokidhi vikwazo vyote rasmi.
Kwa nini mfumo huu unaweza kukokotolewa?
Matrix \(H\) ni sparse sana; kwa sababu seli ya grid imeunganishwa tu na eneo inamomilikiwa na block za sekta husika.
Chanzo kinaeleza kuhusu muundo huu sparse:
- sparse Cholesky,
- multifrontal factorization
kwamba unaweza kutatuliwa kwa ufanisi katika mifumo mikubwa ya grid kwa mbinu kama hizo.
Kwa nini 0,01 inaongezwa kwa makadirio ya sifuri?
\[ W= \operatorname{diag}(1/p_{g,i}^2) \]
kwa hiyo, \(p_{g,i}=0\) inapokuwa, uzani hauwezi kufafanuliwa.
Ili kutatua tatizo hili la kiufundi, chanzo huipa seli zenye makadirio ya sifuri thamani ndogo ya notional ya 0,01 kabla ya reconciliation.
Baada ya reconciliation kukamilika, 0,01 hii huondolewa tena na seli hurudishwa kwenye sifuri kamili.
0,01 hii si kipimo cha shughuli za kiuchumi; ni thamani saidizi ya kiufundi inayotumiwa kuweka matrix ya uzani ikiwa imefafanuliwa katika uboreshaji wa namba.
Je, reconciliation inaweza kuzalisha thamani hasi?
Suluhisho la GLS linalotumiwa na chanzo halina kizuizi cha alama. Kwa hiyo, kinadharia, marekebisho makubwa yanapohitajika baadhi ya thamani za seli zilizofanyiwa reconciliation zinaweza kuwa hasi.
Hata hivyo, chanzo kinaeleza wazi kwamba katika matumizi ya Kanada–Marekani hakuna thamani hasi iliyotokea baada ya reconciliation.
Mbinu na Matokeo ya Utafiti
Mbinu ya hatua mbili
Mlolongo wa mbinu za utafiti una hatua mbili kuu:
- Hatua ya ujifunzaji wa mashine: mahusiano kati ya Pato la Taifa rasmi la kiutawala na matokeo ya sekta pamoja na vigezo vya kijiografia vyenye mwonekano wa juu hujifunzwa na kutumiwa kwenye seli za grid.
- Hatua ya reconciliation: makadirio ya grid hurekebishwa kwa uboreshaji wa kuadrati ili yalingane kikamilifu na jumla rasmi za maeneo na sekta.
Vikwazo viwili vya ziada vinavyotumika katika kiwango cha grid
Chanzo pia kinalazimisha:
- jumla ya hisa za sekta zilizokadiriwa kwa sekta 10 iwe 1 katika kitengo husika cha kiutawala,
- hisa za sekta pia ziwe sifuri katika maeneo kama sehemu kubwa zinazoendelea za maji, majangwa yasiyokaliwa na maeneo ya theluji ya kudumu ambako Pato la Taifa limekadiriwa kuwa sifuri
huweka haya kama masharti ya lazima.
Utendaji wa modeli
| Lengo | RMSE | R² | MAE |
|---|---|---|---|
| log Pato la Taifa | 0,39 | 0,95 | 0,29 |
| log Pato la Taifa / km² | 0,44 | 0,94 | 0,32 |
| Kilimo | 0,06 | 0,54 | 0,04 |
| Ujenzi | 0,03 | 0,17 | 0,02 |
| Fedha na huduma za biashara | 0,10 | 0,44 | 0,07 |
| Utawala wa umma | 0,08 | 0,04 | 0,06 |
| Viwanda | 0,11 | 0,30 | 0,08 |
| Uchimbaji madini | 0,10 | 0,48 | 0,06 |
| Huduma nyingine | 0,01 | 0,19 | 0,08 |
| Utilities | 0,09 | 0,12 | 0,05 |
| Biashara na malazi | 0,05 | 0,19 | 0,04 |
| Usafiri na mawasiliano | 0,04 | 0,18 | 0,02 |
Chanzo pia kinaripoti katika maandishi thamani za \(R^2\) za takribani 0,50 na 0,56 mtawalia kwa modeli za log Pato la Taifa kwa mtu na log Pato la Taifa kwa mtu/km². Katika variants hizi mbili, idadi ya watu imeondolewa kutoka seti ya vigezo vinavyoeleza.
Kwa nini utendaji wa sekta hutofautiana?
Sekta kama kilimo na uchimbaji madini zina alama ya kijiografia ya kimwili iliyo imara zaidi. Kilimo kinaweza kuhusishwa na ufuniko wa ardhi, na uchimbaji madini na maeneo maalumu ya kijiografia na ya mitambo.
Katika sekta kama huduma, utawala wa umma na utilities, mahali pa kimwili panapoonekana huenda pasiwe sawa na mahali uundaji wa thamani unaporekodiwa katika hesabu za taifa.
Kwa hiyo chanzo kinasisitiza kwamba nguvu ya utabiri ya vigezo katika kiwango cha sekta hutofautiana kwa kiasi kikubwa.
Je, mpangilio wa umuhimu wa vigezo ni usababishaji?
Hapana. Chanzo kinaeleza wazi kwamba mipangilio ya variable-selection katika Figure 5 inaonyesha tu mchango katika utabiri.
Kwa mfano, built-up area, population na nighttime light ziko katika nafasi za juu kwa Pato la Taifa la jumla, huku cropland ikiwa kigezo chenye nguvu katika modeli ya kilimo.
Hali hii haitoi hitimisho la kisababishi kama “ongezeko la mwanga wa usiku huongeza Pato la Taifa kwa kiasi fulani”.
Mikengeuko mikubwa zaidi kabla ya reconciliation
Chanzo kinapolinganisha makadirio ya awali ya grid na Pato la Taifa rasmi la sekta, kinabaini mikengeuko mikubwa zaidi kwa kilimo na utilities.
Katika sekta zote mbili, jumla za grid kabla ya reconciliation zinaweza kufikia takribani mara nne-tano ya data rasmi.
Kwa kilimo, matokeo haya yanafundisha hasa; kwa sababu thamani ya \(R^2\) ya modeli ya kilimo, 0,54, ni ya juu kiasi ikilinganishwa na sekta nyingine.
Hali hii inaonyesha kwamba ulinganifu mzuri wa makadirio katika kiwango cha kiutawala haumaanishi moja kwa moja uthabiti wa kihasibu katika jumla za grid.
Chanzo kinaeleza hili kwa sehemu kwa ukweli kwamba ardhi ya kilimo huchukua eneo kubwa sana la kimwili ikilinganishwa na thamani yake ya kiuchumi inayoongezwa.
Makadirio ya awali yako karibu zaidi katika sekta zenye uzito wa mijini
Katika sekta za fedha na huduma za biashara, biashara na malazi, viwanda, pamoja na usafiri na mawasiliano, uwiano wa makadirio ya kabla ya reconciliation kwa jumla rasmi nchini Kanada na Marekani kwa kawaida uko katika kiwango cha takribani %75–90.
Matokeo haya yanaendana na uwezekano kwamba shughuli za mijini na kibiashara zinaweza kuonekana zaidi kupitia mwanga wa usiku, ujenzi na viashiria vingine vya kimwili.
Reconciliation hutatua tatizo hili vipi?
Reconciliation hupima upya na kusambaza tena jumla za grid za sekta zote hadi kiwango kilekile cha hesabu rasmi za kitaifa na za chini ya taifa.
Lakini kuna tofauti muhimu sana hapa:
Kupata uthabiti wa aggregate si sawa na kupata uthibitishaji huru katika kiwango cha seli.
Baada ya reconciliation, jumla ya eneo kuhakikishwa kihisabati kuwa sawa na Pato la Taifa rasmi. Kinyume chake, ni seli gani hasa ya 1 km² ndani ya jumla hiyo inayohusishwa na shughuli za kiuchumi na kwa uwiano gani bado inategemea muundo wa ugawaji wa kijiografia wa modeli ya ujifunzaji wa mashine.
Upeo wa grid wa 2021
Kwa seli zenye Pato la Taifa chanya lililokadiriwa katika data ya post-benchmarking:
| Nchi | Idadi ya seli zenye Pato la Taifa chanya | Ukubwa wa takribani wa seli |
|---|---|---|
| Kanada | 988.661 | Takribani 1 km² |
| Marekani | 5.354.938 | Takribani 1 km² |
Chanzo kinajumuisha tu seli zenye Pato la Taifa chanya lililokadiriwa katika idadi hizi za upeo.
Kutolingana kwa kitengo cha Pato la Taifa katika chanzo
Jedwali kuu 1 linaweka lebo ya safu ya Pato la Taifa ya 2021 kama “USD PPP bn” na linaeleza katika sehemu ya data kwamba Pato la Taifa la chini ya taifa limerekebishwa kwa benchmark ya IMF WEO PPP international dollars.
Kinyume chake, katika dokezo la jedwali la upeo huo huo katika Appendix C kuna usemi “GDP figures in current USD billions”.
Kutolingana huku kwa kitengo ndani ya chanzo hakujarekebishwa kimya kimya na Verianla. Kwa hiyo, makala hii haitumii jumla za thamani za fedha za 2021 katika hesabu mpya.
Kwa nini matokeo ya Kanada na Marekani hayawezi kusomwa kwa kiwango sawa cha kujiamini?
Kwa Marekani, matokeo rasmi ya mafunzo yanapatikana hadi kiwango cha county. Kwa hiyo muundo wa ndani wenye maelezo ya kijiografia wa modeli nchini Marekani hujifunza, angalau hadi kiwango cha county, kutoka tofauti halisi za Pato la Taifa za chini ya taifa.
Kwa Kanada, matokeo rasmi ya mafunzo yako tu katika kiwango cha 13 province/territory.
Kwa hiyo mgawanyo ndani ya province za Kanada hutengenezwa kabisa na modeli kupitia mahusiano ya geocovariate.
Kwa usemi wa chanzo chenyewe, matokeo ya Kanada yanapaswa kutathminiwa kama experimental model-based spatial allocations; si subprovincial GDP iliyothibitishwa kwa njia huru.
Muundo wa kijiografia wa shughuli zote za kiuchumi
Katika matokeo ya post-reconciliation ya 2021, seli za grid zenye shughuli za kiuchumi za juu zaidi hujikita katika korido kubwa za miji mikuu.
Katika nusu ya mashariki ya Marekani, shughuli za kiuchumi za kiwango cha kati huonekana kwa mwendelezo zaidi, wakati katika maeneo makavu ya ndani ya magharibi kuna seli zenye thamani ndogo zilizoenea kwa uchache zaidi.
Shughuli za kiuchumi nchini Kanada hujikita hasa katika ukanda mwembamba zaidi karibu na mpaka wa Marekani na hupungua kwa kiasi kikubwa katika latitudo za juu.
Mifumo hii ni matokeo ya modeli na, hasa Kanada, haipaswi kutafsiriwa kama uchunguzi halisi rasmi wa chini ya province.
Location Quotient ni nini?
Utafiti unatumia Location Quotient (LQ) kuonyesha ni sekta gani katika seli ya grid iliyobobea zaidi ikilinganishwa na muundo wa kitaifa.
Ufafanuzi katika tanbihi ya chanzo unaweza kuonyeshwa kihisabati kama:
\[ LQ_{g,i} = \frac{\text{grid }g\text{'de sektör }i\text{ payı}} {\text{ülke genelinde sektör }i\text{ payı}} \]
unaweza kuonyeshwa kwa namna hiyo.
\(LQ=1\) humaanisha kwamba uzito wa sekta katika seli ya grid ni sawa na wastani wa nchi.
\(LQ=1{,}5\) humaanisha kwamba hisa ya sekta katika seli ya grid ni %50 juu kuliko hisa ya kitaifa.
Chanzo hutafsiri thamani zilizo juu ya 1,5 katika ramani ya sekta dominant kama ubobezi wa ndani ulio wazi.
Mifumo ya kijiografia ya sekta
Katika matokeo ya modeli, kilimo huunda korido pana inayovuka mipaka katika tambarare za ndani za Kanada na Marekani.
Shughuli za uchimbaji madini, mafuta na gesi hujikita katika maeneo ya intermountain west ya Marekani, ukanda wa Appalachian na baadhi ya maeneo ya kaskazini mwa Kanada.
Viwanda hufuata ukanda wa kihistoria wa viwanda kusini mwa Maziwa Makuu na maeneo yanayoenea kuelekea kusini-mashariki mwa Marekani.
Fedha na huduma za biashara hujikita katika miji mikubwa ya kaskazini-mashariki, huku utawala wa umma ukionyesha ubobezi mkubwa karibu na Washington D.C.
Moja ya ujumbe muhimu wa matokeo haya ni kwamba jiografia ya sekta si lazima ifuate mipaka ya kiutawala. Mikanda ya kilimo, uchimbaji madini na viwanda inaweza kuendelea bila kukatika kuvuka mipaka ya majimbo au nchi.
Ramani ya sekta ya fedha haionyeshi nini?
Chanzo kinatoa onyo maalumu: tabaka la grid la “Finance and Business Services” halipaswi kusomwa kama ramani ya maeneo ya kimwili ya hatari za kifedha, mikopo au dhamana.
Katika fedha, bima, mali isiyohamishika na huduma za biashara, thamani inayoongezwa mara nyingi inaweza kurekodiwa katika makao makuu ya kampuni; kwa upande mwingine, exposure halisi ya kiuchumi au kifedha inaweza kuwa katika maeneo mengine ya kijiografia.
Kwa nini sekta za huduma ni ngumu zaidi?
Mahali pa kimwili pa kiwanda, eneo la kilimo au mgodi linaweza kuonekana kwa uwazi kiasi katika data za remote sensing.
Kinyume chake, kwa:
- upatanishi wa kifedha,
- mawasiliano ya simu,
- usafirishaji wa umeme,
- utawala wa umma,
- huduma kama elimu na afya
huenda kusiwe na uhusiano wa moja kwa moja wa moja-kwa-moja kati ya mahali thamani inapozalishwa na mahali kituo cha kimwili kilipo.
Chanzo kinaeleza kwamba maeneo ya kiuchumi yenye uzito wa huduma ni magumu zaidi kwa spatial allocation na kwamba katika siku zijazo viashiria vya kijiografia maalumu kwa sekta, kama benki, taasisi za umma, shule, hospitali na vituo vya rejareja, vinaweza kuongezwa.
Kizuizi katika maeneo ya vijijini na ya mbali
Viashiria kama mwanga wa usiku au ujenzi vinaweza kuwakilisha uzalishaji wa kiuchumi kwa udhaifu zaidi katika maeneo ya vijijini na ya mbali yenye idadi ndogo ya watu.
Chanzo kinapendekeza kwamba katika siku zijazo vigezo vya ziada kama:
- msongamano wa mtandao wa barabara,
- fahirisi za tija ya kilimo,
- umbali hadi masoko
vinaweza kutumiwa.
Ukaguzi wa ziada wa uthabiti kwa kutumia idadi ya watu
Waandishi wanapendekeza kwamba katika siku zijazo idadi ya watu itumiwe pia kama consistency check ili kuzuia Pato la Taifa la post-benchmarking kugawiwa kwa namna isiyo na mantiki ya kiuchumi kwenye seli za grid ambazo idadi ya watu ni karibu sifuri.
Ukaguzi huu si sehemu iliyokamilika ya utafiti wa sasa; unawasilishwa kama uboreshaji unaoweza kufanywa baadaye.
Uhusiano na GeoPulse
Imepangwa kwamba makadirio ya gridded GDP yaliyotengenezwa katika utafiti yawe ingizo msingi kwa jukwaa la uchambuzi wa geospatial linaloitwa GeoPulse linaloendelezwa katika IMF.
Matumizi yanayolengwa na chanzo ni kuunganisha makadirio ya uzalishaji wa kiuchumi yenye mwonekano wa juu na viashiria vingine vya hatari za kijiografia kama kukabiliwa na majanga ya asili, msongo wa kifedha na mabadiliko ya kidemografia.
Kuunganishwa na GeoPulse katika siku zijazo ni nia; makala hii haitoi tathmini iliyokamilika ya utendaji wa GeoPulse.
Matokeo yanayoungwa mkono na utafiti
- Kwa kutumia kwa pamoja jumla rasmi za uchumi mkuu, uchunguzi wa Dunia wenye mwonekano wa juu na spatial random forest, migawanyo ya majaribio ya Pato la Taifa katika kiwango cha takribani 1 km² inaweza kuzalishwa.
- Vigezo vya uchunguzi wa Dunia vinavyotumiwa kwa log Pato la Taifa la jumla vinaonyesha utendaji wa juu wa utabiri.
- Utendaji wa utabiri katika kiwango cha sekta hutofautiana kwa kiasi kikubwa kati ya sekta.
- Idadi ya watu, eneo lililojengwa na mwanga wa usiku ni miongoni mwa vigezo vyenye nguvu vya utabiri katika makadirio ya Pato la Taifa la jumla.
- Viashiria vya ufuniko wa ardhi kama Cropland vinaweza kubeba taarifa yenye nguvu zaidi kwa mgawanyo wa kijiografia wa kilimo.
- Makadirio ya ujifunzaji wa mashine hayalingani kiotomatiki na jumla rasmi za sekta na maeneo.
- Reconciliation ya kuadrati inaweza kufanya makadirio ya grid na sekta yalingane kikamilifu na jumla rasmi za uhasibu.
- Ubobezi wa sekta unaofichwa na mipaka ya kiutawala unaweza kuonekana zaidi katika umbo la grid.
- Matumizi ya Kanada na Marekani yana sifa ya proof-of-concept kwa mbinu.
Matokeo ambayo utafiti hauungi mkono
Utafiti hauonyeshi kwamba kuna Pato la Taifa rasmi lililopimwa moja kwa moja katika kila seli ya 1 km².
Utafiti hauwasilishi hasa thamani za grid za Kanada zilizo chini ya province kama data rasmi iliyothibitishwa kwa njia huru.
Baada ya reconciliation, ukweli kwamba jumla rasmi zinalingana kikamilifu hauthibitishi kuwa thamani halisi ya kiuchumi ya kila seli imekadiriwa kwa usahihi.
\(R^2\) ya juu haionyeshi kwamba kiashiria cha satelaiti au cha kijiografia kilichotumiwa kina athari ya kisababishi kwa Pato la Taifa.
Mpangilio wa variable importance hauonyeshi ishara ya vigezo juu ya ukubwa wa uchumi wala mgawo wake wa kisababishi.
Utafiti hauthibitishi utendaji uleule kwa nchi zote. Kanada na Marekani ni uchumi wa majaribio wenye data nyingi na mifumo imara ya takwimu rasmi.
Utafiti bado haujaonyesha kwamba mbinu inafanya kazi kwa usahihi uleule katika Amerika ya Kusini, Afrika Kusini mwa Jangwa la Sahara, Asia Kusini au Asia ya Kusini-Mashariki; maeneo haya yanapendekezwa kuwa maeneo ya upanuzi wa baadaye.
Utafiti bado hauzalishi seti ya data ya gridded capital stock. Stock ya mtaji imetajwa kuwa mojawapo ya maeneo ambayo mbinu inaweza kupanuliwa katika siku zijazo.
Utafiti hauungi mkono kutafsiri grid ya fedha na huduma za biashara kama ramani halisi ya financial exposure au collateral.
Vikwazo vikuu
- Msaada wa mafunzo wa Kanada: kuna uchunguzi rasmi 13 pekee wa province/territory; maelezo ya chini ya province ni uzalishaji wa modeli.
- Dhana ya uhamishaji wa kiwango: uhusiano uliojifunzwa katika kitengo cha kiutawala unatumiwa katika kiwango cha seli ya grid.
- Heterogeneity ya sekta: utendaji wa modeli hutofautiana sana kati ya sekta.
- Kuonekana kwa sekta ya huduma: viashiria vya kimwili vya remote sensing huwakilisha baadhi ya huduma kwa udhaifu.
- Reconciliation: huhakikisha uthabiti na jumla rasmi lakini haitoi uthibitishaji huru wa seli.
- Kuripoti hyperparameters: mipangilio yote ya kiwango cha chini ya random forest haijaelezwa kwa undani katika PDF.
- Kutolingana kwa kitengo rasmi: dokezo la sarafu ya Pato la Taifa katika Jedwali kuu 1 na Appendix C halilingani kikamilifu.
Maana ya jumla ya kisayansi
Nguvu ya utafiti ni kwamba haujaribu kuchukua nafasi ya takwimu rasmi za uchumi mkuu kwa ujifunzaji wa mashine.
Mbinu inaunganisha nguvu za aina mbili za taarifa:
Hesabu rasmi za taifa hutoa jumla ya kuaminika ya ukubwa wa uchumi.
Uchunguzi wa Dunia na spatial machine learning hutoa taarifa za kijiografia zenye mwonekano wa juu kuhusu mahali ambapo jumla inaweza kuwa imejikita ndani ya jiografia.
Statistical reconciliation hufanya tabaka hizi mbili ziwe thabiti kwa upande wa uhasibu.
Thamani ya kisayansi ya mbinu hii haiko katika dai la “tunaona Pato la Taifa halisi moja kwa moja kutoka kwenye picha ya satelaiti”; iko katika uwezo wa kugawa mgawanyo wa kijiografia wa jumla rasmi za uchumi mkuu kwa njia ya kimfumo na inayoweza kurudiwa, kwa kutumia mifumo iliyojifunzwa kutoka viashiria vya kijiografia vinavyoonekana.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Earth Observations and Machine Learning for Gridded Macroeconomic Data
Kichwa cha uchapishaji kwa Kiswahili: Uchunguzi wa Dunia na Ujifunzaji wa Mashine kwa Data za Uchumi Mkuu za Gridi
Waandishi: Marco Marini, Jim Tebrake, Andinet Woldemichael.
Mpangilio wa waandishi: Mpangilio uliotolewa katika chanzo umehifadhiwa.
Taasisi: International Monetary Fund.
Idara: Statistics Department.
Corresponding na lead author: Andinet Woldemichael.
Mchango sawa / uandishi mwenza wa kwanza: Hakuna tamko kama hilo katika chanzo.
Nambari ya utafiti: WP/26/213.
Mfululizo: IMF Working Papers.
Mchapishaji: International Monetary Fund.
Tarehe ya ndani ya PDF: September 2026.
Tarehe rasmi ya uchapishaji katika IMF eLibrary: 2 Oktoba 2026.
Issue-level DOI: 10.5089/9798229062961.001.
Article-level DOI: 10.5089/9798229062961.001.A001.
Rekodi rasmi ya uchapishaji: IMF eLibrary, Working Paper Volume 2026, Issue 213.
SSRN: PDF ya chanzo inaeleza kwamba nakala ya kielektroniki inapatikana chini ya SSRN abstract 7611151.
Aina ya chanzo: IMF Working Paper; utafiti wa uendelezaji wa mbinu na uzalishaji wa data ya majaribio.
Hali ya mapitio: Haipaswi kuwasilishwa kama makala ya jarida la kitaaluma iliyopitiwa na wataalamu wenza. IMF hufafanua Working Papers kama machapisho yanayowasilisha utafiti unaoendelea kwa ajili ya mjadala.
Hakimiliki / leseni: © 2026 International Monetary Fund. PDF ina tamko “Not for Redistribution”. Hakuna leseni ya wazi ya Creative Commons iliyoainishwa.
Misimbo ya JEL: C55, O47, R12.
Maneno muhimu ya chanzo: Earth observations; gridded GDP; spatial machine learning.
Lengo kuu la utafiti: Kufanya downscale ya Pato la Taifa rasmi la kitaifa na la chini ya taifa pamoja na data za sekta hadi seli za grid za takribani 1 km² kwa kutumia viashiria vya geospatial vyenye mwonekano wa juu, na kufanya matokeo yalingane kikamilifu na jumla rasmi za uhasibu.
Nchi za majaribio: Kanada na Marekani.
Mwaka wa matumizi ya rejea: 2021 katika matokeo makuu ya grid.
Msaada rasmi wa data wa Marekani: Kiwango cha County, admin 2; uchunguzi 3.082 wa county unaweza kutumiwa katika mafunzo ya modeli.
Msaada rasmi wa data wa Kanada: uchunguzi 13 katika kiwango cha province/territory; maelezo yote ya kijiografia yaliyo chini ya province yanatengenezwa na modeli.
Azimio lengwa la grid: Takribani 1 km².
Azimio la geocovariate lenye mwonekano wa juu: Vigezo vingi vya WorldPop ni takribani 3 arcsecond, yaani takribani 100 m.
Mbinu kuu: Spatial random forest + forward feature selection + leave-one-out cross-validation + statistical reconciliation ya kuadrati.
Programu: Maktaba ya CAST Version 1.04 ndani ya R.
Uteuzi wa modeli: Variants za modeli hufundishwa katika sampuli tofauti za kijiografia za pooled na split; uteuzi wa vigezo hutumika na specification yenye RMSE ya chini zaidi huhifadhiwa.
Mlinganyo msingi wa ujifunzaji wa mashine: \(y_i^k=f(X_i^k)+\varepsilon_i^k\).
Tatizo msingi la reconciliation: Makadirio ya awali ya ML \(p\), chini ya kizuizi rasmi cha uhasibu \(Hx=y_a\), hubadilishwa kuwa thamani reconciled \(x\) kwa namna inayopunguza mkengeuko wa jamaa wa kuadrati.
Suluhisho la GLS reconciliation: \(x=p-W^{-1}H'(HW^{-1}H')^{-1}(Hp-y_a)\).
Jambo la kiufundi la reconciliation: Seli zenye makadirio ya sifuri hupewa kwa muda thamani 0,01 ili kuweka matrix ya uzani ikiwa imefafanuliwa, na baada ya mchakato huwekwa sifuri tena.
Hali ya thamani hasi: Suluhisho la GLS kinadharia linaweza kuzalisha seli hasi; chanzo kinaripoti kwamba katika matumizi ya Kanada–Marekani hakuna thamani hasi reconciled iliyotokea.
Utendaji wa jumla wa Pato la Taifa: kwa log Pato la Taifa RMSE 0,39, \(R^2=0{,}95\), MAE 0,29; kwa log Pato la Taifa/km² RMSE 0,44, \(R^2=0{,}94\), MAE 0,32.
Utendaji wa sekta: Kilimo na uchimbaji madini ni imara kiasi; utawala wa umma, utilities, biashara/malazi na usafiri/mawasiliano zina thamani za chini zaidi za \(R^2\).
Mkengeuko muhimu kabla ya reconciliation: Katika sekta za kilimo na utilities, jumla za gridded zinaweza kufikia takribani mara nne-tano ya Pato la Taifa rasmi.
Upeo wa grid yenye Pato la Taifa chanya wa 2021: Kanada seli 988.661; Marekani seli 5.354.938.
Kutolingana kwa kitengo cha fedha ndani ya chanzo: Jedwali kuu 1 linaweka lebo ya thamani za Pato la Taifa kama “USD PPP bn” na sehemu ya mbinu inafafanua benchmark ya WEO PPP; dokezo la jedwali la Appendix C linafafanua mfululizo huo huo kama “current USD billions”. Verianla haijarekebisha kimya kimya kutolingana huku.
Utata wa ndani ya chanzo wa alama ya kigezo lengwa: Alama SER ipo katika seti ya malengo ya sehemu ya mbinu, lakini katika uainishaji wa sekta 10 wa Appendix A hakuna kategoria tofauti ya SER iliyofafanuliwa. Hakuna maelezo yasiyopatikana katika chanzo yaliyoongezwa.
Upatikanaji wa data: Chanzo kinaorodhesha kwa kina vyanzo vya data vilivyotumiwa, ikiwemo BEA, Statistics Canada, WorldPop, ESA, NASA na Global Energy Monitor; PDF haitoi kifurushi kimoja cha wazi cha replication wala Data Availability Statement ya kawaida iliyo tofauti.
Upatikanaji wa hyperparameters za modeli: CAST 1.04, spatial random forest, feature selection na muundo wa cross-validation vimeripotiwa; hyperparameters zote za kiwango cha chini za random forest hazijaelezwa wazi katika PDF.
Tamko la ufadhili: Hakuna tamko tofauti la kawaida la ufadhili wa utafiti katika chanzo.
Mgongano wa maslahi: Hakuna tamko tofauti la kawaida la mgongano wa maslahi katika chanzo.
CRediT / michango ya waandishi: Hakuna jedwali la kawaida la michango ya CRediT katika chanzo.
Shukrani: Chanzo kinamshukuru Javier Uruñuela López kwa maoni na mapendekezo; na Alessandra Sozzi pamoja na Zhaosheng Li kwa msaada wao katika kuendeleza data ya gridded GDP.
Kizuizi kikuu cha kimethodolojia: Thamani za kiwango cha grid si uchunguzi rasmi wa moja kwa moja. Reconciliation hutoa uthabiti wa aggregate lakini haithibitishi kwa njia huru usahihi wa seli. Nchini Kanada, mgawanyo wa kijiografia ulio chini ya province unatengenezwa kabisa na modeli.
Kazi ya baadaye: Covariate mpya kwa maeneo ya vijijini/ya mbali, maeneo ya miundombinu maalumu kwa sekta za huduma, ukaguzi wa uthabiti unaotegemea idadi ya watu, upanuzi katika jiografia nyingine na uzalishaji wa gridded capital stock vinapendekezwa.
Onyo kuhusu msimamo wa taasisi: Maoni katika chanzo ni ya waandishi; hayawakilishi kwa lazima maoni ya IMF, IMF Executive Board au IMF management.
Dokezo la uchapishaji: Maelezo haya ya Kiswahili yanawasilisha kwa namna ya kufundisha muundo wa data wa Working Paper ya chanzo, mbinu ya spatial random forest, mantiki ya grid downscaling, hatua za cross-validation na feature-selection, milinganyo ya statistical reconciliation, matokeo ya utendaji, matokeo ya kijiografia ya sekta na vikwazo. Hakuna thamani ya grid, matokeo ya modeli, takwimu, hyperparameter au ujumla wa nchi usiopatikana katika chanzo uliotengenezwa. Katika marejeo ya kisayansi, Working Paper asilia ya IMF na DOI rasmi zinapaswa kutumiwa kama msingi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *