

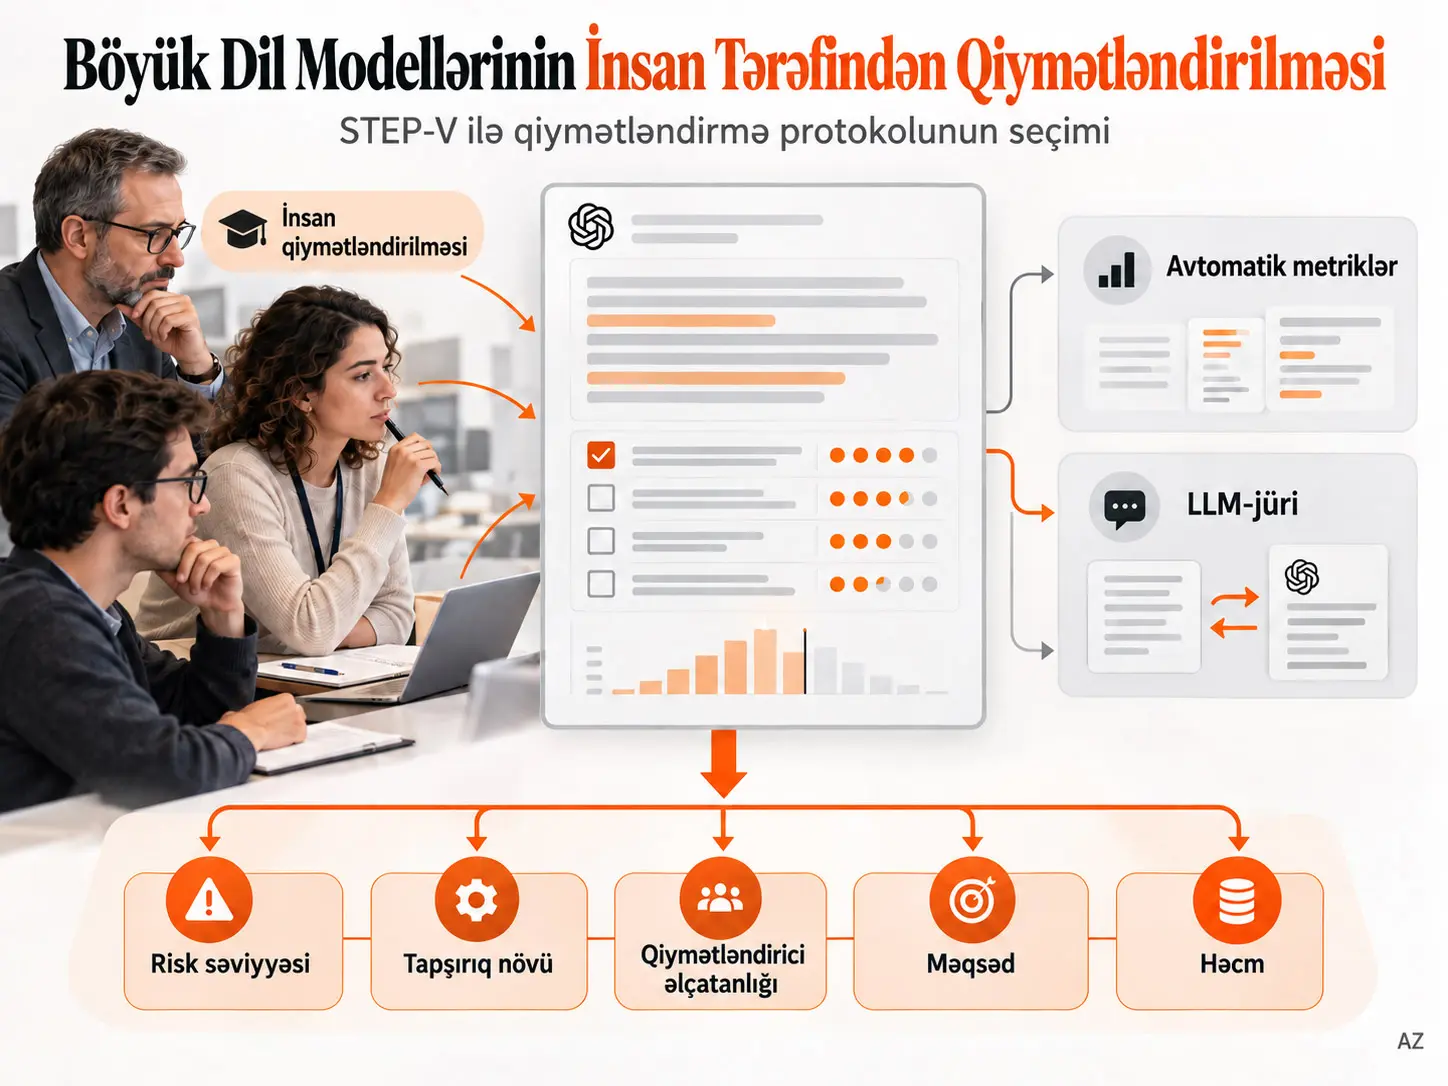
İnsan mərkəzli LLM qiymətləndirilməsi, böyük dil modeli çıxışlarının yalnız avtomatik metriklərlə deyil, müəyyən tapşırığı, keyfiyyət meyarını və istifadə kontekstini qiymətləndirməyə uyğun insan mühakimələri ilə ölçülməsini təmin edən qiymətləndirmə yanaşmasıdır. Bu icmal insan qiymətləndirilməsini qüsursuz “düzgün cavab mənbəyi” kimi deyil, öz etibarlılığı, keçərliliyi, qərəzləri, koqnitiv məhdudiyyətləri və qeyri-müəyyənliyi olan ölçmə infrastrukturu kimi nəzərdən keçirir. Məqalə yeni bir LLM təcrübəsinin nəticələrini təqdim etmir; qiymətləndirmə metodologiyası, psixometriya, koqnitiv elm, insan amilləri və sahəyə xas LLM tətbiqlərindəki tədqiqatları sintez edərək qiymətləndirmə protokolunun necə seçilməli olduğuna dair konseptual çərçivə hazırlayır.
Müəllif dörd əsas problemə diqqət çəkir: insan etiketlərinin qüsursuz qızıl standart kimi qəbul edilməsi, qiymətləndirici yorğunluğu və həddindən artıq koqnitiv yük, insanlarla LLM əsaslı hakim modellərində görülən ortaq və ya fərqli qərəz strukturları, həmçinin qiymətləndirmə nəticələrində qeyri-müəyyənlik və paylanma məlumatlarının çox vaxt nəzərə alınmaması. Bu problemləri sistemli şəkildə həll etmək üçün STEP-V çərçivəsi təklif olunur. STEP-V; Stakes, Task-type, Evaluator availability, Purpose və Volume ölçülərindən ibarətdir və real istifadə şəraitində insan, avtomatik metrik və LLM-as-judge kombinasiyalarının necə seçilə biləcəyinə dair qərar dəstəyi verir.
Məqalənin ikinci orijinal töhfəsi insan qiymətləndiriciləri ilə LLM-as-judge sistemlərini eyni xəta çərçivəsində araşdıran ortaq xəta rejimi taksonomiyasıdır. Sıra effektləri, uzun cavaba üstünlük, avtoritet effekti, həddindən artıq özünəinam, yorğunluq, subyektivlik, bilik çatışmazlığı, mədəni qərəz və yanlış məlumata etibar kimi problemlərin bəziləri həm insanlarda, həm də LLM qiymətləndiricilərində müxtəlif formalarda görünə bilər. Buna görə insan və süni qiymətləndiriciləri birləşdirən hibrid sistemlərin öz-özünə daha etibarlı olduğu fərz edilə bilməz; hər iki tərəf eyni növ xətaya meyllidirsə, xəta azalmaq əvəzinə güclənə bilər.
Tədqiqatın əsas şərh məhdudiyyəti budur: STEP-V və ortaq xəta rejimi taksonomiyası hələ prospektiv təcrübələrlə təsdiqlənmiş kəmiyyət performans modelləri deyil. Müəllif bunları qiymətləndirmə dizaynını strukturlaşdırmaq üçün konseptual çərçivələr kimi təqdim edir və real qiymətləndirmə keyfiyyətini artırıb-artırmadıqlarının gələcəkdə empirik şəkildə sınaqdan keçirilməli olduğunu açıq bildirir.
LLM Qiymətləndirilməsində İnsan Mühakiməsi Niyə Hələ də Lazımdır?
İnsan mühakiməsi xüsusilə açıq uclu, kontekstdən asılı, ekspertiza tələb edən və ya sosial və normativ meyarları ehtiva edən tapşırıqlarda lazımdır; çünki söz oxşarlığı və ya avtomatik ballar bir cavabın klinik baxımdan təhlükəsiz, hüquqi baxımdan müdafiə oluna bilən, pedaqoji baxımdan faydalı, sosial baxımdan uyğun və ya real istifadəçi üçün yararlı olub-olmadığını təkbaşına etibarlı şəkildə ölçə bilməz.
Erkən təbii dil emalı sistemlərində tapşırıqlar daha dar, düzgün çıxış məkanı daha məhdud və istinad cavabları ilə müqayisə daha tətbiqolunan idi. Müasir LLM-lər isə tibbi məsləhətdən hüquqi təhlilə, tədrisdən planlaşdırmaya və yaradıcı yazıya qədər çox açıq uclu çıxışlar yaradır. Belə hallarda eyni suala birdən çox yaxşı cavab ola bilər və səthi olaraq oxşar iki cavab təhlükəsizlik və ya düzgünlük baxımından tamamilə fərqli ola bilər.
Buna görə məqalə qiymətləndirməni yalnız “model düzgün cavab verdi?” sualına endirmir. Əsas ölçmə problemi bunları birlikdə əhatə edir: nəyin ölçüldüyü, kimin qiymətləndirdiyi, hansı protokolun istifadə edildiyi, qiymətləndirmə şkalasının necə müəyyənləşdirildiyi, qiymətləndiricinin nə dərəcədə ekspert olduğu, nə qədər yorulduğu və nəticələrin hansı statistik fərziyyələrlə birləşdirildiyi.
İnsan qiymətləndirilməsi özü də bir ölçmə sistemidir
İnsan qiymətləndirilməsi keçərli və ya keçərsiz; etibarlı və ya etibarsız; yaxşı kalibrlənmiş və ya zəif kalibrlənmiş ola bilər. Buna görə insan etiketini avtomatik olaraq “ground truth” qəbul etmək metodoloji baxımdan qeyri-kafidir.
Məqalənin psixometrik yanaşması burada əhəmiyyət qazanır. Ölçmənin etibarlılığı, müxtəlif qiymətləndiricilər, maddələr və ya zamanlar arasında nə dərəcədə ardıcıl olduğunu; keçərliliyi isə həqiqətən ölçmək istədiyi konstruksiyanı ölçüb-ölçmədiyini ifadə edir. Qiymətləndirmə yüksək ardıcıllığa malik olub yenə də yanlış şeyi ölçə bilər.
Məsələn, qiymətləndiricilərin sistemli şəkildə daha uzun cavablara üstünlük verməsi çox ardıcıl nəticə yarada bilər; lakin hədəf meyar düzgünlükdürsə, cavab uzunluğu həqiqi keyfiyyət göstəricisi olmaya bilər. Eyni şəkildə son istifadəçi məmnunluğu “qavranılan faydalılıq” üçün keçərli meyar ola bildiyi halda faktoloji düzgünlüyün keçərli ölçüsü olmaq məcburiyyətində deyil.
Üçqatlı LLM qiymətləndirmə taksonomiyası
| Səviyyə | Qiymətləndirici / alət | Əsas üstünlük | Əsas məhdudiyyət |
|---|---|---|---|
| Səviyyə 1 | Avtomatik istinadlı və ya istinadsız metriklər | Aşağı xərc, yüksək təkrarlana bilmə və sürətli iterasiya | Açıq uclu tapşırıqlarda düzgünlük, mühakimə keyfiyyəti, faydalılıq və ya etik uyğunluq kimi konstruksiyaları natamam ölçə bilər |
| Səviyyə 2 | LLM-as-judge sistemləri | İnsanlarla müqayisədə daha yüksək miqyaslana bilmə və klassik metriklərdən daha çox kontekstual həssaslıq | Keçərlilik tapşırıqdan, dildən, ölçülən xüsusiyyətdən və hədəf insan qrupundan asılıdır; standart olaraq keçərli sayıla bilməz |
| Səviyyə 3 | Birbaşa insan qiymətləndirilməsi | Konteksti, ekspertizanı, sosial uyğunluğu, təhlükəsizliyi və bir neçə keçərli cavabı qiymətləndirə bilmə | Xərc, miqyaslana bilmə, yorğunluq, heterogenlik və koqnitiv qərəzlər |
Səviyyə 1: Avtomatik metriklər
BLEU, ROUGE və METEOR kimi klassik metriklər yaradılan mətni istinad cavabları ilə səthi və ya struktur oxşarlığı baxımından müqayisə edir. BERTScore kimi daha yeni semantik metriklər embedding məkanında semantik oxşarlığı qiymətləndirməyə çalışır. Perplexity və ya bəzi retrieval-augmented generation kontekstlərindəki faithfulness metrikləri kimi istinadsız alətlər də tək bir qızıl cavab tələb etmədən keyfiyyət siqnalı yaratmağı hədəfləyir.
Bu alətlərin əhəmiyyəti kiçildilməməlidir; onlar sürətli, ucuz və təkrar istehsal oluna bilən qiymətləndirmə təmin edir. Lakin məqalənin vurğusu budur ki, bunlar yalnız ölçə bildikləri konstruksiya qədər mənalıdır. Mətn istinad cavabına bənzədiyi halda real dünya baxımından yanlış və ya təhlükəli ola bilər; başqa mətn isə istinada az bənzədiyi halda düzgün və faydalı ola bilər.
Səviyyə 2: LLM-as-judge
LLM-as-judge, bir dil modelinin başqa model çıxışını ballamaq, sıralamaq və ya iki cavab arasında seçim etmək üçün qiymətləndirici kimi istifadə edilməsidir. Məqalə bu yanaşmanın xüsusilə aydın meyarlı, rubrik əsaslı və ya ikili müqayisə tapşırıqlarında yararlı ola biləcəyini; lakin performansın tapşırıq növünə, ölçülən xüsusiyyətə, dilə və müqayisə edilən insan qiymətləndiricilərinin ekspertiza səviyyəsinə görə əhəmiyyətli dərəcədə dəyişə bildiyini vurğulayır.
Buradan çıxarılan əsas nəticə odur ki, LLM-as-judge sistemi plug-and-play formasında universal qiymətləndirici deyil. Hakim modelinin keçərliliyi lokaldır: hədəf tapşırığa, hədəf konstruksiyaya və hədəf insan qiymətləndirici icmasına qarşı kalibrlənməli və sınaqdan keçirilməlidir.
Səviyyə 3: Birbaşa insan qiymətləndirilməsi
Birbaşa insan qiymətləndirilməsi inandırıcılıq, uyğunluq, pedaqoji dəyər, potensial zərər, sahəyə xas səriştə və kontekstual uyğunluq kimi formallaşdırılması çətin xüsusiyyətlərdə yüksək çeviklik verir.
Lakin “insan qiymətləndirilməsi” vahid bir metod deyil. Həkimin klinik cavabı qiymətləndirməsi, hüquq mütəxəssisinin hüquqi təhlili araşdırması, son istifadəçinin məmnunluq bildirməsi və crowdworker-in iki chatbot cavabını müqayisə etməsi fərqli ölçmə aktlarıdır. Bunları ekvivalent saymaq qiymətləndirmənin keçərliliyini zəiflədə bilər.
LLM Çıxışını Kimin Qiymətləndirməli Olduğuna Necə Qərar Verilir?
Qiymətləndirici seçimi ölçüləcək konstruksiyanın nə qədər ekspert bilik, yaşanmış təcrübə və ya kontekstual tanışlıq tələb etdiyinə görə aparılmalıdır. Yüksək riskli və ekspertiza tələb edən tapşırıqlarda sahə mütəxəssisləri daha güclü konstrukt keçərliliyi təmin edə bildiyi halda, istifadəçi məmnunluğu və ya gündəlik istifadəyə yararlılıq kimi konstruksiyalar üçün real son istifadəçilər daha keçərli qiymətləndiricilər ola bilər.
| Qiymətləndirici | Ekspert tapşırıqlarda keçərlilik | Etibarlılıq | Xərc | Miqyaslana bilmə | Ən uyğun istifadə |
|---|---|---|---|---|---|
| Sahə mütəxəssisləri | Çox yüksək | Orta | Çox yüksək | Aşağı | Tibb, hüquq, hərbi sahə, maliyyə kimi yüksək riskli və ekspertiza tələb edən tapşırıqlar |
| Təlim keçmiş annotatorlar | Orta | Orta | Orta | Orta | Rubrik və kalibrləmə ilə ümumi təyinatlı keyfiyyət qiymətləndirilməsi |
| Crowdworker-lər | Aşağı–orta | Aşağı–orta | Aşağı | Çox yüksək | Axıcılıq, uyğunluq, əsas başadüşülənlik və aşağı riskli genişmiqyaslı annotasiya |
| Son istifadəçilər | Yüksək ekoloji keçərlilik | Aşağı | Aşağı | Orta | Məmnunluq, istifadəyə yararlılıq və real istifadə kontekstində faydalılıq |
Məqalə xüsusilə ekspertlər arasında fikir ayrılığının ola biləcəyini xatırladır. Ekspertlərin eyni nəticəyə gəlməməsi avtomatik olaraq qiymətləndirmənin uğursuzluğu deyil; mürəkkəb klinik, hüquqi və ya sosial konstruksiyanın həqiqətən qeyri-müəyyən olmasının əlaməti ola bilər.
Nə qiymətləndirilir?
Qiymətləndirmənin ilk dizayn addımlarından biri hədəf konstruksiyanın aydın şəkildə müəyyənləşdirilməsidir. “Keyfiyyət” kimi tək və qeyri-müəyyən söz əvəzinə düzgünlük, faydalılıq, üstünlük, etibar, oxunaqlılıq, təhlükəsizlik, kontekstual uyğunluq və ya başqa ölçülə bilən konstruksiya müəyyən edilməlidir.
Faktoloji düzgünlük, sitat düzgünlüyü və format qaydalarına uyğunluq çox vaxt xaricdən yoxlana bilər. Yaradıcılıq, nəzakət və ya qarşılıqlı əlaqənin cəlbediciliyi isə insan şərhinə və sosial normalara daha çox bağlıdır. Klinik uyğunluq, hüquqi möhkəmlik və ya tənzimləyici uyğunluq kimi meyarlarda ümumi qiymətləndiricilər kifayət qədər ekspertizaya malik olmaya bilər.
Qiymətləndirmə hansı protokolla aparıla bilər?
- Likert tipli ballama: Cavaba, məsələn, 1–5 arasında bal verilir. İncə dərəcələndirmə təmin edir, lakin şkalanın şərhinə və anchoring effektlərinə həssasdır.
- İkili qərar: Məqbul / qeyri-məqbul və ya düzgün / yanlış kimi iki sinifdən biri seçilir. Kəskin fərqlərdə razılaşmanı artıra bilər, lakin nüansı itirə bilər.
- İkili müqayisə: İki çıxış yanaşı qiymətləndirilir və müəyyən meyara görə hansının daha yaxşı olduğu seçilir. Mütləq bal verməkdə çətinlik çəkən qiymətləndiricilər üçün yararlı ola bilər.
- Rubrik əsaslı qiymətləndirmə: Çıxış bir neçə aydın alt ölçüdə, əvvəlcədən müəyyən edilmiş meyarlar və ya anchor nümunələri ilə ballanır. Qeyri-müəyyən bütöv mühakiməni daha müşahidəolunan hissələrə ayıra bilər.
Protokol yalnız bal formatını müəyyənləşdirmir; yaranacaq məlumatın statistik strukturunu, koqnitiv yükü və mümkün xəta mənbələrini də müəyyən edir. Həddindən artıq çox eyni vaxtlı meyar, uzun qiymətləndirmə sessiyaları və ya kifayət qədər müəyyənləşdirilməmiş şkala etiketləri etibarlılığı azalda bilər.
İnsanlar Arasında Fikir Ayrılığı Həmişə Xətadırmı?
Xeyr. Açıq uclu, subyektiv və ya mədəni baxımdan dəyişkən tapşırıqlarda fikir ayrılığı real və mənalı perspektiv fərqlərini təmsil edə bilər; bunun əksinə, dərman əks-göstərişi və ya yanlış hüquqi istinad kimi xaricdən yoxlana bilən yüksək riskli məsələlərdə yüksək fikir ayrılığı daha sərt ekspert baxışı tələb edən xəbərdarlıq siqnalı kimi qiymətləndirilməlidir.
Etibarlılığın ölçülməsi
Məqalə Cohen's kappa, Krippendorff's alpha və intraclass correlation coefficient kimi qiymətləndiricilərarası etibarlılıq ölçülərinin mövcud olduğunu; lakin LLM qiymətləndirmə tədqiqatlarında bunların kifayət qədər bildirilmədiyini və ya kontekstsiz verildiyini qeyd edir.
Tək bir orta bal yüksək fikir ayrılığını gizlədə bilər. Buna görə aşağı razılaşma birbaşa “annotator səs-küyü” kimi kənara atılmamalıdır; qeyri-müəyyən meyar, qarışıq konstruksiya və ya qiymətləndirici üzərində həddindən artıq koqnitiv yük olduğuna işarə edə bilər.
Paylanma əsaslı qiymətləndirmə
Subyektiv tapşırıqlarda yalnız orta rəyə baxmaq əvəzinə qiymətləndirmə paylanmalarını qorumaq mümkündür. Məqalə Kullback–Leibler divergence və Earth Mover's Distance kimi paylanma məsafəsi ölçülərinin model mühakimələrinin yalnız insan ortalamasına deyil, insan rəylərinin yayılmasına nə qədər bənzədiyini araşdırmaq üçün istifadə oluna biləcəyini müzakirə edir.
Buradakı məqsəd bütün fikir ayrılıqlarını aradan qaldırmaq deyil. Müxtəlif insan qruplarının fərqli, lakin keçərli perspektivləri ola bilər. Bununla belə, böyük alt qrup ayrışmaları və ya yüksək riskli maddələrdə qeyri-müəyyənlik hədəflənmiş nəzarətə və ekspert adjudication ehtiyacına işarə edə bilər.
Qüsurlu qızıl standart problemi
İnsan etiketi bir çox LLM qiymətləndirməsində son və mübahisəsiz istinad kimi qəbul edilir. Məqalə psixometriya və diaqnostik statistika ədəbiyyatına əsaslanaraq bunun həmişə keçərli olmadığını vurğulayır. İnsan qiymətləndiricilər də səhv edə, fərqli sərtliklə bal verə və ya konstruksiyanı fərqli şərh edə bilər.
Buna görə sadə bal ortalamalarından kənara çıxmaq üçün many-facet Rasch modelləri, iyerarxik ordinal modellər, Bradley–Terry tipli ikili müqayisə modelləri və lazım gəldikdə qüsurlu-qızıl-standart və ya latent-class modelləri kimi ölçmə yanaşmaları müzakirə olunur. Məqalə bu modelləri öz məlumatlarına tətbiq etmir; onları daha müdafiəolunan LLM qiymətləndirmə dizaynı üçün metodoloji seçimlər kimi təqdim edir.
Tədqiqatın Metodu və Nəticələri
İcmalın elmi yanaşması
Tədqiqat yeni bir LLM məlumat dəsti üzərində təcrübə aparan empirik araşdırma deyil. Müəllif LLM qiymətləndirmə metodologiyası, insan qiymətləndirilməsi, psixometriya, koqnitiv elm, annotasiya araşdırmaları, LLM-as-judge tədqiqatları və səhiyyə, hüquq, maliyyə, hərbi sahə, təhsil və təhlükəsizlik kimi tətbiq sahələrindəki ədəbiyyatı bir araya gətirərək ortaq qiymətləndirmə dizayn məntiqi formalaşdırır.
Mənbə sistematik axtarış sorğusu, PRISMA seçim axını, meta-analiz və ya kəmiyyət tədqiqat-keyfiyyət ballaması bildirmir. Buna görə əldə edilən “nəticələr” yeni eksperimental effektlərdən daha çox ədəbiyyat sintezi ilə hazırlanmış konseptual nəticələr, metod təklifləri və dizayn prinsipləridir.
İnsan və LLM qiymətləndiricilərinin ortaq xəta rejimi taksonomiyası
| Xəta rejimi | İnsandakı görünüşü | LLM-as-judge görünüşü | Təklif olunan dizayn qarşılığı |
|---|---|---|---|
| Sıra effektləri | İlk/son elementə ağırlıq vermə, anchoring | Mövqe qərəzi | Sıralamanı təsadüfiləşdir və təqdimatı korlaşdır |
| Uzunluq qərəzi | Daha uzun cavabı daha yaxşı hesab etmə | Məzmun əvəzinə uzunluğa üstünlük vermə | Uzunluğu nəzarətdə saxla və ya yığcamlığı ayrıca qiymətləndir |
| Avtoritet qərəzi | Prestijli mənbəyə və ya tona həddindən artıq etibar etmə | Avtoritetli görünən çıxışa üstünlük vermə | Mümkündürsə mənbə/kimlik ipuclarını aradan qaldır |
| Sosial uyğunlaşma | Əvvəlki qiymətləndiricilərə doğru sürüklənmə | Əvvəlcədən verilmiş siqnalları gücləndirmə | Qiymətləndiriciləri müstəqil saxla və bal sızmasının qarşısını al |
| Həddindən artıq özünəinam | Ballarda həddindən artıq yüksək əminlik | Qərarda həddindən artıq yüksək əminlik | Əsaslandırma və ya əminlik səviyyəsinin bildirilməsini tələb et |
| Yorğunluq və həddindən artıq yük | Sessiya daxilində və sessiyalar arasında diqqətin azalması | Uzun kontekst, mürəkkəb tapşırıq və ya təkrarlanan çıxarım altında performansın azalması | Sessiya müddətini məhdudlaşdır və sıra boyunca drift nəzarəti apar |
| Subyektivlik uğursuzluğu | Yaradıcı və ya mədəni mühakimələrdə qiymətləndiricilərarası aşağı razılaşma | Subyektiv tapşırıqlarda insanlarla zəif uyğunluq | Birdən çox qiymətləndirici istifadə et, fikir ayrılığını qoru və səs-küydəki siqnalı araşdır |
| Bilik boşluqları | Ekspertiza tələb edən xətanı fərq edə bilməmə | Zəif sahəyə xas mühakimə | Qiymətləndirici ekspertizasını tapşırığa uyğunlaşdır |
| Mədəni qərəz | Demoqrafik və ya mədəni fonun bala təsir etməsi | Təlim məlumatlarından daşınan qərəzlər | Qiymətləndirici hovuzunu şaxələndir və alt qrup effektlərini sına |
| Hallüsinasiyaya etibar | Özünəinamlı yanlış məlumatı aşkar edə bilməmə | Uydurulmuş məzmunu keçərli kimi ballama | Faktoloji ölçülərdə xarici yoxlamadan istifadə et |
Bu cədvəl məqalənin vacib mesajlarından birini aydınlaşdırır: insan və LLM xətaları müstəqil olmaq məcburiyyətində deyil. Hər iki tərəf eyni istiqamətdə uzunluq, avtoritet və ya mədəni qərəz göstərirsə, onları birləşdirmək “iki fərqli nəzarət qatı” yaratmaq əvəzinə eyni sapmanı gücləndirə bilər.
STEP-V Çərçivəsi Qiymətləndirmə Protokolunu Necə Seçir?
STEP-V qiymətləndirmə dizaynını beş kontekstual dəyişənə görə strukturlaşdırır: yanlış qiymətləndirmənin nəticələrinin ciddiliyi, tapşırığın qapalı/açıq uclu quruluşu, uyğun qiymətləndiricilərin əlçatanlığı, qiymətləndirmənin məqsədi və qiymətləndiriləcək çıxış həcmi. Çərçivə vahid universal protokol təklif etmir; kontekst dəyişdikcə insan, LLM və avtomatik metodların rollarının da dəyişməli olduğunu müdafiə edir.
| Ölçü | Mənası | Dizayn üzərində əsas təsiri |
|---|---|---|
| S — Stakes | Yanlış qiymətləndirmənin real dünyadakı nəticələrinin ciddiliyi | Risk artdıqca ekspertiza, konservativ hədlər və qeyri-müəyyənliyin idarə edilməsi əhəmiyyət qazanır |
| T — Task-type | Tapşırığın qapalı və yoxlanıla bilən, yoxsa açıq uclu və subyektiv olması | Yoxlanıla bilən tapşırıqlar avtomatlaşdırmaya daha uyğun ola bilər; açıq uclu tapşırıqlar daha çox insan mühakiməsi tələb edir |
| E — Evaluator availability | Ekspert, annotator, crowdworker, son istifadəçi və ya LLM qiymətləndiricilərinin əlçatanlığı | Məhdud ekspert vaxtı nümunə götürmə və escalation strategiyasını dəyişdirir |
| P — Purpose | Erkən inkişaf, yerləşdirmədən əvvəl doğrulama və ya istehsaldan sonra davamlı monitorinq | Eyni sistem həyat dövrünün müxtəlif mərhələlərində fərqli qiymətləndirmə protokolları tələb edə bilər |
| V — Volume | Qiymətləndiriləcək çıxışların sayı və tezliyi | Həcm artdıqca avtomatlaşdırma, statistik nümunə götürmə və seçici insan baxışı tələb olunur |
Stakes: xəta nə qədər ciddidir?
Aşağı riskli tətbiqlər, yanlış qiymətləndirmənin böyük real dünya zərərinə səbəb olmasının gözlənilmədiyi yaradıcı yazı, marketinq şüarı və ya chatbot tonunun tənzimlənməsi kimi tapşırıqları əhatə edir. Bu kontekstlərdə avtomatik metriklər, üstünlük testləri və ya daha yüngül insan qiymətləndirmələri kifayət edə bilər.
Orta riskli tətbiqlər, xəta səbəbilə əhəmiyyətli, lakin adətən kritik olmayan nəticələrin yarana biləcəyi şirkətdaxili sənəd xülasəsi, ümumi təhsil izahları və ya insan tərəfindən nəzərdən keçirilən proqram kodu təklifləri kimi tapşırıqlardır. Hibrid qiymətləndirmə daha mənalı olur.
Yüksək riskli tətbiqlər, tibbi məsləhət, klinik qərar dəstəyi, hüquqi təhlil, maliyyə tövsiyəsi və ya hərbi planlaşdırma kimi yanlış qiymətləndirmənin zərər, hüquqi məsuliyyət və ya təhlükəsizlik riski yarada biləcəyi sahələrdir. Məqalə bu kontekstlərdə sahə mütəxəssislərini, çoxölçülü rubrikləri, konservativ qərar hədlərini və qeyri-müəyyənlik/fikir ayrılığının idarə edilməsini prioritetləşdirir; avtomatik metodları dəstəkləyici rola yerləşdirir.
Task-type: tapşırıq yoxlanıla bilirmi?
Qapalı uclu tapşırıqlarda aydın düzgün cavab və ya xarici yoxlama qaydası ola bilər. Strukturlaşdırılmış məlumat çıxarılması, məlum etiketli təsnifat və ya vahid testlərdən keçməli olan kod kimi tapşırıqlarda avtomatik nəzarət güclü rol oynaya bilər.
Açıq uclu tapşırıqlarda isə birdən çox ağlabatan cavab ola bilər. Mürəkkəb sənəd xülasəsi, tibbi məsləhət dili, hüquqi mühakimə və ya strateji tövsiyə kimi tapşırıqlarda faydalılıq, aydınlıq və kontekstual uyğunluq kimi konstruksiyalar tam şəkildə xaricdən müşahidə olunmaya bilər.
Evaluator availability: düzgün qiymətləndirici həqiqətən əlçatandırmı?
Tibb, hüquq və ya hərbi planlaşdırma kimi sahələrdə ən uyğun ekspertlər bahalı və zaman baxımından məhdud ola bilər. Buna görə qiymətləndirmə dizaynı yalnız ideal qiymətləndiricinin kim olduğunu deyil, həqiqətən nə qədər ekspert vaxtının mövcud olduğunu da nəzərə almalıdır.
Məqalə ekspertlərin məhdud olduğu hallarda sabit annotasiya kvotası əvəzinə hədəflənən qeyri-müəyyənliyə görə nümunə ölçüsünün planlaşdırılmasını; ekspert əməyinin riskli, sərhəd və ya yüksək fikir ayrılığı olan maddələrə yönəldilməsini təklif edir.
Purpose: qiymətləndirmə həyat dövrünün hansı mərhələsindədir?
Erkən inkişaf sürətli model müqayisəsinə və aşkar xəta rejimlərinin tapılmasına fokuslanır. Avtomatik metriklər, kiçik insan üstünlük testləri və ya LLM-as-judge sistemləri sürətli istiqamətləndirici siqnal verə bilər.
Yerləşdirmədən əvvəl doğrulama daha yüksək sübut həddi tələb edir. Sistemin hədəflənən performans, təhlükəsizlik və etibarlılıq sərhədlərinə cavab verib-vermədiyi sualına strukturlaşdırılmış insan qiymətləndirməsi, sahə meyarları və etibarlılıq hesabatı ilə cavab verilməlidir.
İstehsal monitorinqi sistem istifadəyə verildikdən sonra performans sürüşməsini, yeni xəta rejimlərini və istifadəçi qarşılıqlı təsirlərindəki dəyişiklikləri izləyir. Yüksək həcmdə avtomatik monitorinq və anomaliya aşkarlanması aparıla bilər; seçilmiş yüksək riskli və ya şübhəli nümunələr insan baxışına yönləndirilə bilər.
Volume: milyonlarla çıxış necə qiymətləndirilir?
Aşağı həcmli ekspert test dəstində hər çıxış ətraflı rubriklərlə bir neçə ekspert tərəfindən araşdırıla bilər. Orta həcmdə nümunə götürmə ilə qismən avtomatlaşdırma birləşdirilə bilər. Milyonlarla chatbot qarşılıqlı təsirinin olduğu yüksək həcmli istehsal mühitində isə hər çıxışı birbaşa insanla qiymətləndirmək mümkün deyil; avtomatik skan və statistik nümunə götürmə ilə yalnız riskli və ya qeyri-adi nümunələr insana yönləndirilməlidir.
Mənbə Şəkil 1-in elmi mesajı
Məqalənin 10-cu səhifəsindəki STEP-V şəkli aşağı, orta və yüksək riskli istifadə səviyyələrini üç ayrı qərar panelində göstərir. Hər panel “əsas hədəf”, “kim qiymətləndirməlidir?”, “məqbul metodlar” və “nə zaman ekspert baxışına yüksəldilməlidir?” suallarını inkişaf, yerləşdirmə doğrulaması və monitorinq kontekstində birlikdə nəzərdən keçirir.
Şəklin əsas mesajı risk artdıqca insan ekspertizasının qiymətləndirmə zəncirinin mərkəzinə keçirilməsidir. Aşağı riskli və yüksək həcmli işlərdə avtomatlaşdırma daha çox istifadə edilə bildiyi halda, yüksək riskli sahələrdə avtomatik qiymətləndirmə insan ekspertini əvəz etmək əvəzinə ilkin süzgəc və ya dəstək rolunda qalmalıdır.
Yüksək Riskli Tətbiqlərdə LLM-as-Judge İnsan Ekspertini Əvəz Edə Bilərmi?
Məqalənin tövsiyəsinə görə ümumi halda xeyr. Yüksək riskli tətbiqlərdə LLM-as-judge sistemləri yalnız hədəf tapşırıqda ixtisaslı ekspertlərlə müqayisədə fövqəladə güclü və tapşırığa xas sübut təqdim edə bilirsə daha geniş rol ala bilər; standart yanaşma eksperti əsas hakim, LLM-i isə ilkin skan, alt meyar yoxlaması və ya baxış prioritetləşdirmə aləti kimi istifadə etməkdir.
Expert-Guided Auto-Evaluation
Ekspert azlığı ilə yüksək qiymətləndirmə həcmi arasındakı boşluğu azaltmaq üçün məqalə Expert-Guided Auto-Evaluation yanaşmasını müzakirə edir. Burada ekspertin rolu hər çıxışı tək-tək etiketləməkdən qismən uzaqlaşaraq ölçmə alətini dizayn etməyə keçir.
Ekspert tapşırığa xas rubrikləri, kritik alt meyarları və qiymətləndirmə/tənqid promptlarını yaradır. LLM əsaslı hakim sistemi bu strukturlaşdırılmış ölçməni daha geniş çıxış həcminə tətbiq edir. Lakin LLM qiymətləndirilməsi ekspert standartları ilə kalibrlənməlidir.
50–100 ekspert etiketi tövsiyəsi nə deməkdir?
Məqalə tam ekspert nəzarətinin xərc səbəbilə mümkün olmadığı bəzi yüksək riskli hallarda təxminən 50–100 ekspert tərəfindən doğrulanmış nümunənin daha böyük və daha ucuz crowd-sourced və ya LLM-hakim məlumat dəstini kalibrləmək üçün istifadə oluna biləcəyini nümunə strategiya kimi müzakirə edir.
Bu say universal nümunə ölçüsü qaydası deyil. Mətnin davamı nümunə planının sabit kvota əvəzinə qərar üçün məqbul qeyri-müəyyənlik səviyyəsindən başlanmalı olduğunu açıq şəkildə bildirir.
Üç tətbiq nümunəsi
| Tətbiq | Risk / tapşırıq strukturu | Təklif olunan qiymətləndirmə yanaşması |
|---|---|---|
| Tibbi məsləhət köməkçisi | Yüksək risk, əsasən açıq uclu, ekspert çatışmazlığı | Ekspert rəhbərliyində rubrik qiymətləndirməsi; avtomatik alətlər ilkin skan/triage üçün; qeyri-müəyyən və ya riskli halları ekspertə yüksəltmə |
| İstehlakçı yazı köməkçisi | Aşağı–orta risk, açıq uclu, yüksək qiymətləndirici əlçatanlığı | İkili üstünlük, istifadəçi balları və LLM-as-judge; təhlükəsizlik/siyasət ölçülərində periodik ekspert nəzarəti |
| Korporativ retrieval əsaslı siyasət/uyğunluq aləti | Orta–yüksək risk, qismən yoxlanıla bilən, yüksək həcm | Faktoloji uyğunluq və citation düzgünlüyü üçün avtomatik yoxlamalar + insana kalibrlənmiş LLM-as-judge + nümunələnmiş insan nəzarəti |
STEP-V hansı hallarda uğursuz ola bilər?
Müəllif STEP-V-ni qiymətləndirmə xətasına qarşı zəmanət kimi təqdim etmir. Çərçivənin xüsusilə dörd halda problemi həll edə bilməyəcəyi bildirilir: ölçüləcək konstruksiya zəif müəyyənləşdirilibsə, mövcud qiymətləndiricilərin hamısı eyni sistemli qərəzi daşıyırsa, yüksək riskli tapşırıqda minimal ekspert nəzarəti yoxdursa və ya mənalı qiymətləndirici fikir ayrılığı yanlış şəkildə tək konsensus balına endirilirsə.
Bu halda problem protokol seçimindən kənardadır. STEP-V qərar sahəsini nizamlaya bilər, lakin keçərsiz konstruksiya tərifini, qeyri-kafi qiymətləndirici hovuzunu və ya qeyri-müəyyənliyi gizlədən ölçmə sistemini öz-özünə düzəldə bilməz.
Metodoloji tövsiyələr
Məqalə insan mərkəzli LLM qiymətləndirilməsi üçün hədəf meyarların aydın əməliyyat tərifləri ilə başlamasını tövsiyə edir. Təriflər, təmsilçi nümunələr və sərhəd halların necə idarə ediləcəyi əvvəlcədən müəyyən edilməlidir.
Qiymətləndirici seçimi hədəf konstruksiya ilə əsaslandırılmalıdır. Sıra effekti və digər məlum qərəzləri azaltmaq üçün korlaşdırma, randomizasiya, kalibrləmə və iş yükünün idarə edilməsi istifadə olunmalıdır. Tədqiqatlar yalnız orta balı deyil, etibarlılıq statistikasını və qeyri-müəyyənlik məlumatını da bildirməlidir.
Avtomatik metriklər və LLM əsaslı hakim modelləri hədəf tapşırıq üzərində insan mühakimələri ilə kalibrlənmədən standart olaraq keçərli qəbul edilməməlidir. Risk səviyyəsi yüksəldikcə LLM-as-judge sistemindən istifadə etmək üçün tələb olunan sübut standartı da yüksəlməlidir.
Psixometrik model seçimi
| Məlumat / protokol | Təklif olunan model ailəsi | Məqsəd |
|---|---|---|
| Likert və ya ordinal rubrik balları | İyerarxik ordinal modellər | Latent keyfiyyəti qiymətləndirici sərtliyi, maddə çətinliyi və qeyri-müəyyənliklə birlikdə modelləşdirmək |
| Çoxqiymətləndiricili strukturlaşdırılmış qiymətləndirmə | Many-facet Rasch modelləri | Model performansını qiymətləndirici sərtliyi və maddə çətinliyindən ayırmaq |
| İkili müqayisə | Bradley–Terry və ya əlaqəli Thurstone modelləri | Nisbi keyfiyyəti ikili üstünlük məlumatlarından təxmin etmək |
| Heç bir qiymətləndiricinin səhvsiz qəbul edilə bilmədiyi mühit | Latent-class / imperfect-gold-standard modelləri | Sadə çoxluq səsverməsi əvəzinə qiymətləndirici xətasını açıq şəkildə modelləşdirmək |
Minimum hesabat standartı
Müəllif qiymətləndirmə tədqiqatlarında ən azı qiymətləndiricilərin işə qəbulu, təlimi, tapşırıq təlimatları, şkala formatı, qiymətləndirmə sessiyasının müddəti, adjudication qaydaları, etibarlılıq statistikaları və qeyri-müəyyənlik hesabatının görünən olmalı olduğunu müdafiə edir.
Nümunə rubriklərin, kalibrləmə promptlarının, audit checklist-lərinin və analiz şablonlarının paylaşılması da təkrarlana bilməni gücləndirə bilər. Mənbənin Supplementary Materials paketində bu məqsədlər üçün hazırlanmış beş əlavə fayl mövcuddur.
Tədqiqatın dəstəklədiyi və dəstəkləmədiyi nəticələr
| Tədqiqatın dəstəklədiyi | Tədqiqatın dəstəkləmədiyi |
|---|---|
| İnsan qiymətləndirilməsinin öz etibarlılıq, keçərlilik və qərəz problemləri olan ölçmə sistemi kimi dizayn edilməli olduğu. | İnsan qiymətləndirilməsinin hər vəziyyətdə LLM-as-judge-dan daha düzgün olduğunun eksperimental olaraq sübut edildiyi. |
| LLM-as-judge keçərliliyinin tapşırıqdan, konstruksiyadan və qiymətləndirici icmasından asılı olduğu. | Müəyyən hakim modelinin bütün tapşırıqlarda istifadə edilməli olduğu. |
| İnsan–LLM hibrid qiymətləndirilməsinin bəzi hallarda miqyası və kontekstual keyfiyyəti birləşdirə bildiyi. | Hibrid sistemlərin avtomatik olaraq qərəzi azaltdığı. |
| Fikir ayrılığının subyektiv və ya mədəni tapşırıqlarda mənalı perspektiv fərqi daşıya bildiyi. | Bütün fikir ayrılıqlarının qəbul edilməli olduğu; təhlükəsizlik-kritik maddələrdə adjudication-un lazımsız olduğu. |
| STEP-V-nin qiymətləndirmə metodu seçimini sistemləşdirən dizayn dəstəyi olduğu. | STEP-V-nin eksperimental olaraq təsdiqlənmiş, xəta dərəcəsi məlum olan və ya yeganə düzgün protokolu avtomatik hesablayan model olduğu. |
| Yüksək riskdə ekspert nəzarəti və qeyri-müəyyənliyin idarə edilməsinin prioritetləşdirilməli olduğu. | Kalibrlənməmiş LLM-as-judge sistemlərinin tibb, hüquq, maliyyə və ya hərbi istifadədə ekspertləri əvəz edə biləcəyi. |
Məhdudiyyətlər və gələcək tədqiqat
Məqalənin ən mühüm məhdudiyyəti həm STEP-V-nin, həm də ortaq xəta rejimi taksonomiyasının konseptual olmasıdır. Müəllif bu strukturların real qiymətləndirmə dizaynını yaxşılaşdırıb-yaxşılaşdırmadığının, qərəz və fikir ayrılığını nə dərəcədə proqnozlaşdırdığının və hibrid sistem performansına dair fərziyyələrin prospektiv tədqiqatlarla sınaqdan keçirilməli olduğunu bildirir.
LLM qiymətləndirmə sahəsinin çox sürətli dəyişməsi icmalların qısa müddətdə köhnəlmə riskini də artırır. Gələcək tədqiqatların qiymətləndiricilərin zamanla LLM-lərə alışması, mədəniyyətlərarası ölçmə dəyişməzliyi, qiymətləndirici effektlərinin psixometrik modelləşdirilməsi, fikir ayrılığı-aware pipeline-lar, nümunə və güc planlaşdırması və məhdud ekspert vaxtının qeyri-müəyyənliyə görə bölüşdürülməsi üzərində cəmlənməsi tövsiyə olunur.
Məqalə həmçinin STEP-V-nin gələcəkdə yarıkəmiyyət qərar alətinə çevrilə biləcəyini müzakirə edir. Beş ölçüyə ordinal səviyyələr verilməsi və bunların keçərlilik riski, qiymətləndiricilərarası etibarlılıq riski, ortaq qərəzin güclənməsi, xərc və escalation yükü kimi çıxışlarla əlaqələndirilməsi mümkündür. Lakin mənbə bu kəmiyyət uyğunlaşdırmasını hələ həyata keçirmir; mövcud STEP-V-nin kəmiyyət performans proqnozlaşdırıcısı kimi istifadəsi tədqiqat tərəfindən dəstəklənmir.
Mənbə və Metod Qeydi
| Orijinal başlıq | Human Evaluation of Large Language Models: A Review and Protocol Selection Framework |
|---|---|
| Müəllif | Tad T. Brunyé |
| Qurum 1 | Center for Applied Brain and Cognitive Sciences, Tufts University, Medford, Massachusetts, USA |
| Qurum 2 | U.S. Army DEVCOM Soldier Center, Natick, Massachusetts, USA |
| DOI | 10.3390/ai7050174 |
| Jurnal | AI |
| Nəşriyyat | MDPI, Basel, Switzerland |
| ISSN | 2673-2688 |
| Cild / nömrə | 7 / 5 |
| Məqalə nömrəsi | 174 |
| Mənbə növü | Review |
| Qəbul tarixi | 7 aprel 2026 |
| Reviziya | 30 aprel 2026 |
| Qəbul | 14 may 2026 |
| Nəşr | 19 may 2026 |
| Rəyçilik | Rəyli jurnal nəşri |
| Lisenziya | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Maliyyələşdirmə | U.S. Army DEVCOM Soldier Center, Augmented Decisions via Intelligent Systems Recommendations (ADVISR) proqramı, BC1/3D |
| Institutional Review Board | Tətbiq olunmur |
| Məlumatlandırılmış razılıq | Tətbiq olunmur |
| Məlumatların əlçatanlığı | Tətbiq olunmur |
| Maraq toqquşması | Müəllif maraq toqquşmasının olmadığını bildirmişdir. |
| Supplementary Materials | File S1–S5 mövcuddur |
Supplementary Materials məzmunu: File S1 Illustrative Scoring Rubrics; File S2 Example Calibration Prompts; File S3 Example Reporting Template; File S4 Example Audit Checklist; File S5 STEP-V Illustrative Configurations.
Maliyyələşdirmə və institusional mövqe məhdudiyyəti: Tədqiqat U.S. Army DEVCOM Soldier Center nəzdindəki ADVISR proqramı tərəfindən dəstəklənmişdir. Məqalədə fikir və iddiaların müəllifin şəxsi fikirləri olduğu və United States Army və ya əlaqəli dövlət qurumlarının rəsmi siyasətini və ya mövqeyini təmsil etmədiyi açıq şəkildə bildirilir.
Müəllif töhfələri: Mənbə tək müəlliflidir və ayrıca CRediT töhfə cədvəli bildirmir. Mənbədə olmayan töhfə rolları Verianla tərəfindən törədilməmişdir.
İcmal metodunun məhdudiyyəti: Məqalə geniş ədəbiyyat sintezi aparır, lakin sistematik axtarış sətri, PRISMA axını, tədqiqat seçimi sayları və ya meta-analitik sintez bildirmir. Buna görə “sistematik icmal” kimi təsnif edilməmişdir.
STEP-V doğrulama məhdudiyyəti: STEP-V və xəta rejimi taksonomiyası konseptual çərçivələrdir. Mənbə onların gələcəkdə prospektiv şəkildə sınaqdan keçirilməli olduğunu bildirir; çərçivələrə aid düzgünlük dərəcəsi, həssaslıq, spesifiklik, etibar intervalı və ya eksperimental uğur balı bildirilmir.
Vizual mənbə qeydi: 10-cu səhifədəki orijinal STEP-V şəkli aşağı, orta və yüksək riskli tətbiqlərdə qiymətləndirici seçimini, inkişaf/doğrulama/monitorinq metodlarını və escalation məntiqini göstərən qərar dəstəkçisidir. Verianla üçün yenidən çəkiləcəksə piksel surəti əvəzinə eyni elmi əlaqələri qoruyan orijinal qərar axını istifadə edilməlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib