

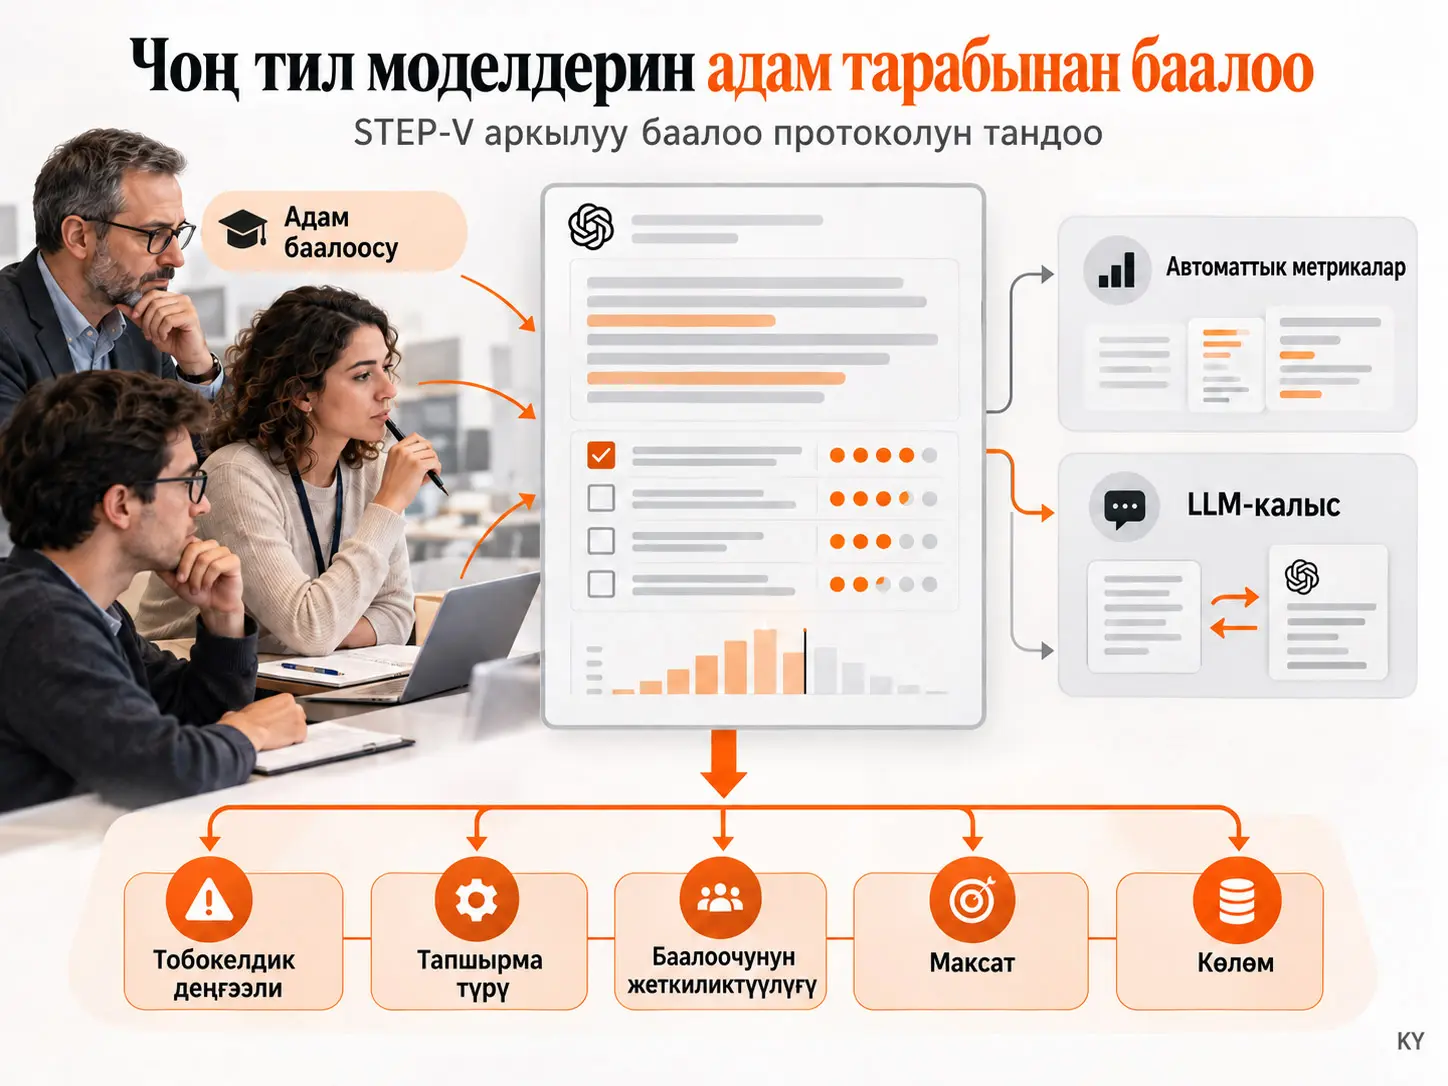
Адамга багытталган LLM баалоосу, чоң тил моделинин чыгыштарын автоматтык метрикалар менен гана эмес, белгилүү бир тапшырманы, сапат критерийин жана колдонуу контекстин баалоого ылайыктуу адамдык баа берүү аркылуу өлчөөгө мүмкүндүк берген баалоо ыкмасы. Бул сереп адамдык баалоону кемчиликсиз “туура жооптун булагы” катары эмес, өзүнүн ишенимдүүлүгү, валиддүүлүгү, бейтарапсыздыктары, когнитивдик чектөөлөрү жана белгисиздиги бар өлчөө инфраструктурасы катары карайт. Макала жаңы LLM экспериментинин жыйынтыктарын бербейт; баалоо методологиясы, психометрия, когнитивдик илим, адам факторлору жана тармакка мүнөздүү LLM колдонмолорундагы изилдөөлөрдү синтездеп, баалоо протоколун кантип тандоо керектиги боюнча концептуалдык алкак түзөт.
Автор төрт негизги көйгөйгө көңүл бурат: адам берген энбелгилерди кемчиликсиз алтын стандарт катары кабыл алуу, баалоочулардын чарчоосу жана ашыкча когнитивдик жүк, адамдар менен LLM негизиндеги калыстар моделдеринде кездешкен жалпы же айырмалуу бир тараптуулук түзүмдөрү, ошондой эле баалоо жыйынтыктарындагы белгисиздик менен бөлүштүрүү маалыматынын көп учурда эске алынбай калышы. Бул көйгөйлөрдү системалуу түрдө чечүү үчүн STEP-V алкагы сунушталат. STEP-V; Stakes, Task-type, Evaluator availability, Purpose жана Volume өлчөмдөрүнөн турат жана чыныгы колдонуу шарттарында адам, автоматтык метрика жана LLM-as-judge айкалыштарын кантип тандоого болору боюнча чечим кабыл алууга колдоо көрсөтөт.
Макаланын экинчи өзгөчө салымы — адам баалоочулары менен LLM-as-judge системаларын бир эле ката алкагында талдаган жалпы ката режимдеринин таксономиясы. Ирет таасири, узун жоопко артыкчылык берүү, авторитет таасири, ашыкча ишеним, чарчоо, субъективдүүлүк, билимдин жетишсиздиги, маданий бир тараптуулук жана туура эмес маалыматка ишенүү сыяктуу көйгөйлөрдүн айрымдары адамдарда да, LLM баалоочуларында да ар башка формада кездешиши мүмкүн. Ошондуктан адам жана жасалма баалоочуларды бириктирген гибрид системалар өзүнөн-өзү ишенимдүүрөөк деп божомолдоого болбойт; эки тарап тең бир эле түрдөгү катага жакын болсо, ката азайбастан күчөшү мүмкүн.
Изилдөөнүн негизги чечмелөө чеги мындай: STEP-V жана жалпы ката режимдеринин таксономиясы азырынча проспективдүү эксперименттер менен ырасталган сандык натыйжалуулук моделдери эмес. Автор аларды баалоо дизайнын түзүмдөштүрүүчү концептуалдык алкактар катары сунуштайт жана чыныгы баалоо сапатын жакшыртабы же жокпу, келечекте эмпирикалык түрдө текшерилиши керектигин ачык белгилейт.
LLM Баалоосунда Адамдын Пикири Эмне Үчүн Дагы эле Керек?
Адамдын пикири айрыкча ачык жооптуу, контекстке көз каранды, адистикти талап кылган же социалдык жана нормативдик критерийлерди камтыган тапшырмаларда керек; анткени сөздөрдүн окшоштугу же автоматтык упайлар жооптун клиникалык жактан коопсуз, укуктук жактан корголуучу, педагогикалык жактан пайдалуу, коомдук жактан ылайыктуу же чыныгы колдонуучу үчүн пайдалуу экенин өз алдынча ишенимдүү өлчөй албайт.
Алгачкы табигый тилди иштетүү системаларында тапшырмалар тарыраак, туура чыгыштар мейкиндиги чектелүү жана эталон жооптор менен салыштыруу иш жүзүндө жеңилирээк болчу. Азыркы LLMдер болсо медициналык кеңештен укуктук талдоого, окутуудан пландаштырууга жана чыгармачыл жазууга чейин өтө ачык жооптуу чыгыштарды түзөт. Мындай учурларда бир эле суроого бир нече жакшы жооп болушу мүмкүн жана сыртынан окшош эки жооп коопсуздук же тууралык жагынан таптакыр айырмаланышы мүмкүн.
Ошондуктан макала баалоону “модель туура жооп бердиби?” деген суроого гана кыскартпайт. Негизги өлчөө маселеси төмөнкүлөрдү бирге камтыйт: эмне өлчөнүп жатканы, ким баалап жатканы, кайсы протокол колдонулганы, баалоо шкаласы кантип аныкталганы, баалоочунун адистиги канчалык экендиги, канчалык чарчаганы жана жыйынтыктар кайсы статистикалык божомолдор менен бириктирилгени.
Адамдык баалоонун өзү да өлчөө системасы
Адамдык баалоо валиддүү же валиддүү эмес; ишенимдүү же ишенимсиз; жакшы калибрленген же начар калибрленген болушу мүмкүн. Ошондуктан адам энбелгисин автоматтык түрдө “ground truth” деп кабыл алуу методологиялык жактан жетишсиз.
Макаланын психометриялык мамилеси ушул жерде маанилүү болот. Өлчөөнүн ишенимдүүлүгүар башка баалоочулар, пункттар же убакыттар арасында канчалык ырааттуу экенин; валиддүүлүгү болсо чындап өлчөгүсү келген түзүлүштү өлчөп жатабы же жокпу дегенди билдирет. Баалоо өтө ырааттуу болуп туруп эле туура эмес нерсени өлчөшү мүмкүн.
Мисалы, баалоочулардын системалуу түрдө узунураак жоопторго артыкчылык бериши өтө ырааттуу жыйынтыкка алып келиши мүмкүн; бирок максаттуу критерий тууралык болсо, жооптун узундугу чыныгы сапат көрсөткүчү болбошу мүмкүн. Ошондой эле акыркы колдонуучунун канааттануусу “кабыл алынган пайдалуулук” үчүн валиддүү критерий болушу мүмкүн, бирок фактылык тууралыктын валиддүү өлчөмү болууга милдеттүү эмес.
Үч катмарлуу LLM баалоо таксономиясы
| Катмар | Баалоочу / курал | Негизги артыкчылык | Негизги чектөө |
|---|---|---|---|
| Катмар 1 | Автоматтык эталондуу же эталонсуз метрикалар | Төмөн чыгым, жогорку кайталануучулук жана тез итерация | Ачык жооптуу тапшырмаларда тууралык, ой жүгүртүүнүн сапаты, пайдалуулук же этикалык ылайыктуулук сыяктуу түзүлүштөрдү толук эмес өлчөшү мүмкүн |
| Катмар 2 | LLM-as-judge системалары | Адамдарга караганда жогору масштабдалуучулук жана классикалык метрикаларга караганда көбүрөөк контексттик сезимталдык | Валиддүүлүк тапшырмага, тилге, өлчөнүп жаткан касиетке жана максаттуу адам тобуна жараша болот; демейки түрдө валиддүү деп кабыл алынбайт |
| Катмар 3 | Түздөн-түз адамдык баалоо | Контекстти, адистикти, социалдык ылайыктуулукту, коопсуздукту жана бир нече валиддүү жоопту баалай алуу | Чыгым, масштабдалуучулук, чарчоо, гетерогендүүлүк жана когнитивдик бир тараптуулуктар |
Катмар 1: Автоматтык метрикалар
BLEU, ROUGE жана METEOR сыяктуу классикалык метрикалар түзүлгөн текстти эталон жооптор менен үстүртөн же түзүмдүк окшоштук боюнча салыштырат. BERTScore сыяктуу жаңыраак семантикалык метрикалар embedding мейкиндигинде семантикалык окшоштукту баалоого аракет кылат. Perplexity же айрым retrieval-augmented generation контексттериндеги faithfulness метрикалары сыяктуу эталонсуз куралдар да бир гана алтын жоопту талап кылбастан сапат сигналынын алынышын көздөйт.
Бул куралдардын маанисин төмөндөтүүгө болбойт; алар тез, арзан жана кайра өндүрүлө турган баалоону камсыз кылат. Бирок макаланын басымы — алардын мааниси өлчөй алган түзүлүшү менен гана чектелет. Текст эталон жоопко окшош болгону менен реалдуу дүйнөдө туура эмес же кооптуу болушу мүмкүн; башка текст эталонго азыраак окшош болсо да туура жана пайдалуу болушу мүмкүн.
Катмар 2: LLM-as-judge
LLM-as-judge— бир тил моделин башка моделдин чыгышын упайлоо, иреттөө же эки жооптун арасынан тандоо үчүн баалоочу катары колдонуу. Макала бул ыкма айкын критерийлүү, рубрика негизиндеги же жуптук салыштыруу тапшырмаларында өзгөчө пайдалуу болушу мүмкүн экенин; бирок натыйжалуулук тапшырманын түрүнө, өлчөнгөн касиетке, тилге жана салыштырылган адам баалоочуларынын адистик деңгээлине жараша олуттуу өзгөрүшү мүмкүн экенин баса белгилейт.
Мындан чыккан негизги жыйынтык — LLM-as-judge системасы plug-and-play түрүндөгү универсалдуу баалоочу эмес. Калыс моделинин валиддүүлүгү жергиликтүү: ал максаттуу тапшырмага, максаттуу түзүлүшкө жана максаттуу адам баалоочулар коомчулугуна карата калибрленип, текшерилиши керек.
Катмар 3: Түздөн-түз адамдык баалоо
Түздөн-түз адамдык баалоо ынанымдуулук, ылайыктуулук, педагогикалык баалуулук, потенциалдуу зыян, тармакка мүнөздүү компетенттүүлүк жана контексттик шайкештик сыяктуу формалдаштыруу кыйын болгон касиеттерде жогорку ийкемдүүлүк берет.
Бирок “адамдык баалоо” бир эле ыкма эмес. Дарыгердин клиникалык жоопту баалоосу, укук адисинин укуктук талдоону карап чыгышы, акыркы колдонуучунун канааттануусун билдириши жана crowdworkerдин эки chatbot жообун салыштырышы — ар башка өлчөө аракеттери. Буларды тең деп кабыл алуу баалоонун валиддүүлүгүн начарлатышы мүмкүн.
LLM Чыгышын Ким Баалашы Керектигин Кантип Чечүү Керек?
Баалоочуну тандоо өлчөнө турган түзүлүш канчалык деңгээлде адистик билимди, турмуштук тажрыйбаны же контексттик тааныштыкты талап кылганына жараша жүргүзүлүшү керек. Жогорку тобокелдиктүү жана адистикти талап кылган тапшырмаларда тармактык адистер түзүлүштүн валиддүүлүгүн күчтүүрөөк камсыз кыла алса, колдонуучунун канааттануусу же күнүмдүк колдонууга ыңгайлуулук сыяктуу түзүлүштөр үчүн чыныгы акыркы колдонуучулар валиддүүрөөк баалоочулар болушу мүмкүн.
| Баалоочу | Адистик тапшырмалардагы валиддүүлүк | Ишенимдүүлүк | Чыгым | Масштабдалуучулук | Эң ылайыктуу колдонуу |
|---|---|---|---|---|---|
| Тармактык адистер | Өтө жогору | Орточо | Өтө жогору | Төмөн | Медицина, укук, аскердик тармак, финансы сыяктуу жогорку тобокелдиктүү жана адистикти талап кылган тапшырмалар |
| Үйрөтүлгөн аннотациялоочулар | Орточо | Орточо | Орточо | Орточо | Рубрика жана калибрлөө менен жалпы максаттагы сапат баалоо |
| Crowdworkerлер | Төмөн–орточо | Төмөн–орточо | Төмөн | Өтө жогору | Агымдуулук, тиешелүүлүк, негизги түшүнүктүүлүк жана төмөн тобокелдиктүү ири масштабдагы аннотация |
| Акыркы колдонуучулар | Жогорку экологиялык валиддүүлүк | Төмөн | Төмөн | Орточо | Канааттануу, колдонууга ыңгайлуулук жана реалдуу колдонуу контекстиндеги пайдалуулук |
Макала адистер арасында пикир келишпестик болушу мүмкүн экенин өзгөчө эске салат. Адистердин бирдей жыйынтыкка келбеши автоматтык түрдө баалоонун ийгиликсиздиги эмес; бул татаал клиникалык, укуктук же социалдык түзүлүштүн чындап эле белгисиз экенинин белгиси болушу мүмкүн.
Эмне бааланып жатат?
Баалоо дизайнынын алгачкы кадамдарынын бири — максаттуу түзүлүштү так аныктоо. “Сапат” сыяктуу бир гана бүдөмүк сөздүн ордуна тууралык, пайдалуулук, артыкчылык, ишеним, окулушу, коопсуздук, контексттик ылайыктуулук же башка өлчөнүүчү түзүлүш белгилениши керек.
Фактылык тууралык, цитатанын тууралыгы жана формат эрежелерине шайкештик көп учурда сырттан текшерилиши мүмкүн. Чыгармачылык, сылыктык же өз ара аракеттенүүнүн жагымдуулугу болсо адамдык чечмелөөгө жана социалдык нормаларга көбүрөөк көз каранды. Клиникалык ылайыктуулук, укуктук негиздүүлүк же жөнгө салуучу талаптарга шайкештик сыяктуу критерийлерде жалпы баалоочулардын жетиштүү адистиги болбошу мүмкүн.
Баалоо кайсы протокол менен жүргүзүлүшү мүмкүн?
- Likert тибиндеги упайлоо: Жоопко, мисалы, 1–5 аралыгында упай берилет. Майда деңгээлдөө берет, бирок шкаланы чечмелөөгө жана anchoring таасирлерине сезимтал.
- Экилик чечим: Кабыл алынуучу / кабыл алынгыс же туура / туура эмес сыяктуу эки класстын бири тандалат. Так айырмаларда макулдашууну көбөйтүшү мүмкүн, бирок нюансты жоготушу мүмкүн.
- Жуптук салыштыруу: Эки чыгыш катар бааланып, белгилүү критерий боюнча кайсынысы жакшы экени тандалат. Абсолюттук упай берүүдө кыйналган баалоочулар үчүн пайдалуу болушу мүмкүн.
- Рубрика негизиндеги баалоо: Чыгыш алдын ала аныкталган критерийлер же anchor мисалдары менен бир нече ачык ички өлчөм боюнча упайланат. Бүдөмүк бүтүн бааны көбүрөөк байкоого боло турган бөлүктөргө ажырата алат.
Протокол упай форматын гана аныктабайт; ал пайда боло турган маалыматтын статистикалык түзүлүшүн, когнитивдик жүктү жана мүмкүн болгон ката булактарын да аныктайт. Бир убакта өтө көп критерий, узак баалоо сессиялары же жетишсиз аныкталган шкала энбелгилери ишенимдүүлүктү төмөндөтүшү мүмкүн.
Адамдардын Пикир Келишпестиги Ар Дайым Ката Болобу?
Жок. Ачык жооптуу, субъективдүү же маданий жактан өзгөрмө тапшырмаларда пикир келишпестик чыныгы жана маанилүү көз караш айырмачылыктарын көрсөтүшү мүмкүн; тескерисинче, дарынын каршы көрсөтмөсү же туура эмес укуктук шилтеме сыяктуу сырттан текшериле турган жогорку тобокелдиктүү маселелерде чоң келишпестик катуураак эксперттик кароону талап кылган эскертүү сигналы катары бааланышы керек.
Ишенимдүүлүктү өлчөө
Макала Cohen's kappa, Krippendorff's alpha жана intraclass correlation coefficient сыяктуу баалоочулар аралык ишенимдүүлүк өлчөмдөрү бар экенин; бирок LLM баалоо изилдөөлөрүндө алар жетиштүү деңгээлде билдирилбегенин же контекстсиз берилгенин белгилейт.
Бир гана орточо упай чоң пикир келишпестикти жашырып коюшу мүмкүн. Ошондуктан төмөн макулдашуу дароо “аннотациялоочу ызы-чуусу” катары четке кагылбашы керек; ал бүдөмүк критерийди, аралаш түзүлүштү же баалоочудагы ашыкча когнитивдик жүктү көрсөтүшү мүмкүн.
Бөлүштүрмөлүү баалоо
Субъективдүү тапшырмаларда орточо пикирге гана кароонун ордуна баалоо бөлүштүрмөлөрүн сактоого болот. Макала Kullback–Leibler divergence жана Earth Mover's Distance сыяктуу бөлүштүрмө аралык өлчөмдөрүн модель баалары адамдын орточо пикирине гана эмес, адам пикирлеринин жайылышына канчалык окшош экенин талдоо үчүн колдонууга болорун талкуулайт.
Бул жердеги максат бардык келишпестиктерди жок кылуу эмес. Ар башка адам топторунун айырмалуу, бирок валиддүү көз караштары болушу мүмкүн. Ошол эле учурда чоң ички топ ажырымдары же жогорку тобокелдиктүү пункттардагы белгисиздик максаттуу көзөмөл жана эксперттик adjudication зарылдыгын көрсөтүшү мүмкүн.
Кемчиликтүү алтын стандарт көйгөйү
Адам энбелгиси көптөгөн LLM баалоолорунда акыркы жана талашсыз эталон катары кабыл алынат. Макала психометрия жана диагностикалык статистика адабиятына таянып, бул ар дайым валиддүү эмес экенин баса белгилейт. Адам баалоочулар да ката кетириши, ар башка катаалдыкта упай бериши же түзүлүштү ар башкача чечмелеши мүмкүн.
Ошондуктан жөнөкөй упай орточолорунан тышкары чыгуу үчүн many-facet Rasch моделдери, иерархиялык ordinal моделдер, Bradley–Terry тибиндеги жуптук салыштыруу моделдери жана зарыл учурда imperfect-gold-standard же latent-class моделдери сыяктуу өлчөө ыкмалары талкууланат. Макала бул моделдерди өз маалыматтарына колдонбойт; аларды негиздүү LLM баалоо дизайны үчүн методологиялык варианттар катары сунуштайт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Серептин илимий мамилеси
Изилдөө жаңы LLM маалымат топтомунда эксперимент жүргүзгөн эмпирикалык изилдөө эмес. Автор LLM баалоо методологиясы, адамдык баалоо, психометрия, когнитивдик илим, аннотация боюнча изилдөөлөр, LLM-as-judge иштери жана саламаттык сактоо, укук, финансы, аскердик тармак, билим берүү жана коопсуздук сыяктуу колдонуу чөйрөлөрүндөгү адабияттарды бириктирип, жалпы баалоо дизайнынын логикасын түзөт.
Булак системалуу издөө суроосун, PRISMA тандоо агымын, мета-анализди же сандык изилдөө-сапат упайлоосун билдирбейт. Ошондуктан алынган “жыйынтыктар” жаңы эксперименттик эффекттерден көбүрөөк адабият синтези аркылуу иштелип чыккан концептуалдык жыйынтыктар, ыкма сунуштары жана дизайн принциптери болуп саналат.
Адам жана LLM баалоочуларынын жалпы ката режимдеринин таксономиясы
| Ката режими | Адамдагы көрүнүшү | LLM-as-judge көрүнүшү | Сунушталган дизайн жооп чарасы |
|---|---|---|---|
| Ирет таасирлери | Биринчи/акыркы элементке ашыкча салмак берүү, anchoring | Позициялык бир тараптуулук | Иретти кокусташтыр жана көрсөтүүнү сокурла |
| Узундукка бир тараптуулук | Узунураак жоопту жакшыраак деп көрүү | Мазмундун ордуна узундукка артыкчылык берүү | Узундукту көзөмөлдө же кыскалыкты өзүнчө баала |
| Авторитетке бир тараптуулук | Кадыр-барктуу булакка же тонго ашыкча ишенүү | Авторитеттүү көрүнгөн чыгышты жактыруу | Мүмкүн болсо булак/идентификация белгилерин алып сал |
| Социалдык ыңгайлашуу | Мурунку баалоочуларга карай ооп кетүү | Алдын ала берилген сигналдарды күчөтүү | Баалоочуларды көз карандысыз карма жана упайдын агып кетишине жол бербе |
| Ашыкча ишеним | Упайларда негизсиз жогорку аныктык | Чечимде негизсиз жогорку аныктык | Негиздеме же ишеним деңгээлин билдирүүнү талап кыл |
| Чарчоо жана ашыкча жүк | Сессия ичинде жана сессиялар арасында көңүлдүн төмөндөшү | Узак контекст, татаал тапшырма же кайталанма чыгарым шартында натыйжалуулуктун төмөндөшү | Сессиянын узактыгын чекте жана ирет боюнча drift көзөмөлүн жүргүз |
| Субъективдүүлүк боюнча ийгиликсиздик | Чыгармачыл же маданий бааларда баалоочулар аралык төмөн макулдашуу | Субъективдүү тапшырмаларда адамдар менен начар шайкештик | Бир нече баалоочуну колдон, келишпестикти сакта жана ызы-чуунун ичиндеги сигналды изилде |
| Билим боштуктары | Адистикти талап кылган катаны байкай албоо | Тармакка мүнөздүү начар ой жүгүртүү | Баалоочунун адистигин тапшырмага дал келтир |
| Маданий бир тараптуулук | Демографиялык же маданий фон упайга таасир этет | Окутуу маалыматтарынан өткөн бир тараптуулуктар | Баалоочулар пулун ар түрдүү кыл жана ички топ таасирлерин текшер |
| Галлюцинацияга ишенүү | Ишенимдүү айтылган туура эмес маалыматты таба албоо | Ойдон чыгарылган мазмунду валиддүү деп упайлоо | Фактылык өлчөмдөрдө тышкы текшерүүнү колдон |
Бул таблица макаланын маанилүү билдирүүлөрүнүн бирин ачык көрсөтөт: адам жана LLM каталары көз карандысыз болууга милдеттүү эмес. Эгер эки тарап тең бир багытта узундук, авторитет же маданий бир тараптуулук көрсөтсө, аларды бириктирүү “эки башка көзөмөл катмарын” түзүүнүн ордуна ошол эле четтөөнү күчөтүшү мүмкүн.
STEP-V Алкагы Баалоо Протоколун Кантип Тандайт?
STEP-V баалоо дизайнын беш контексттик өзгөрмөгө жараша түзүмдөштүрөт: туура эмес баалоонун кесепеттеринин олуттуулугу, тапшырманын жабык/ачык жооптуу түзүлүшү, ылайыктуу баалоочулардын жеткиликтүүлүгү, баалоонун максаты жана баалана турган чыгыштардын көлөмү. Алкак бир универсалдуу протоколду сунуштабайт; контекст өзгөргөн сайын адам, LLM жана автоматтык ыкмалардын ролдору да өзгөрүшү керек деп эсептейт.
| Өлчөм | Мааниси | Дизайнга негизги таасири |
|---|---|---|
| S — Stakes | Туура эмес баалоонун реалдуу дүйнөдөгү кесепеттеринин олуттуулугу | Тобокелдик жогорулаган сайын адистик, консервативдүү чектер жана белгисиздикти башкаруу маанилүү болот |
| T — Task-type | Тапшырма жабык жана текшериле турганбы же ачык жооптуу жана субъективдүүбү | Текшериле турган тапшырмалар автоматташтырууга көбүрөөк ылайыктуу болушу мүмкүн; ачык жооптуу тапшырмалар көбүрөөк адамдык пикирди талап кылат |
| E — Evaluator availability | Адис, аннотациялоочу, crowdworker, акыркы колдонуучу же LLM баалоочуларынын жеткиликтүүлүгү | Чектелген эксперт убактысы үлгү алуу жана escalation стратегиясын өзгөртөт |
| P — Purpose | Эрте иштеп чыгуу, жайылтуудан мурунку валидация же өндүрүштөн кийинки үзгүлтүксүз мониторинг | Бир эле система жашоо циклинин ар башка баскычтарында ар башка баалоо протоколдорун талап кылышы мүмкүн |
| V — Volume | Баалана турган чыгыштардын саны жана жыштыгы | Көлөм өскөн сайын автоматташтыруу, статистикалык үлгү алуу жана тандалма адам кароосу керек |
Stakes: ката канчалык олуттуу?
Төмөн тобокелдиктүү колдонмолор, туура эмес баалоо реалдуу дүйнөдө чоң зыян алып келиши күтүлбөгөн чыгармачыл жазуу, маркетинг урааны же chatbot тонун жөндөө сыяктуу тапшырмаларды камтыйт. Бул контексттерде автоматтык метрикалар, артыкчылык тесттери же жеңилирээк адамдык баалоолор жетиштүү болушу мүмкүн.
Орточо тобокелдиктүү колдонмолор, ката маанилүү, бирок адатта критикалык эмес кесепеттерди жаратышы мүмкүн болгон уюм ичиндеги документти кыскача мазмундоо, жалпы билим берүү түшүндүрмөлөрү же адам карап чыгуучу программалык код сунуштары сыяктуу тапшырмалар. Гибрид баалоо бул жерде маанилүүрөөк болот.
Жогорку тобокелдиктүү колдонмолор, медициналык кеңеш, клиникалык чечимди колдоо, укуктук талдоо, финансылык сунуш же аскердик пландаштыруу сыяктуу туура эмес баалоо зыянга, укуктук жоопкерчиликке же коопсуздук тобокелдигине алып келиши мүмкүн болгон тармактар. Макала бул контексттерде тармактык адистерди, көп өлчөмдүү рубрикаларды, консервативдүү чечим чектерин жана белгисиздик/келишпестикти башкарууну артыкчылыкка коёт; автоматтык ыкмаларды колдоочу ролго жайгаштырат.
Task-type: тапшырманы текшерүүгө болобу?
Жабык жооптуу тапшырмаларда ачык туура жооп же тышкы текшерүү эрежеси болушу мүмкүн. Түзүмдөлгөн маалымат чыгаруу, белгилүү энбелгиси бар классификация же unit тесттерден өтүшү керек болгон код сыяктуу тапшырмаларда автоматтык көзөмөл күчтүү роль ойной алат.
Ачык жооптуу тапшырмаларда болсо бир нече негиздүү жооп болушу мүмкүн. Татаал документтин кыскача мазмуну, медициналык кеңештин тили, укуктук ой жүгүртүү же стратегиялык сунуш сыяктуу тапшырмаларда пайдалуулук, ачыктык жана контексттик ылайыктуулук сыяктуу түзүлүштөр сырттан толук байкалбашы мүмкүн.
Evaluator availability: туура баалоочу чындап жеткиликтүүбү?
Медицина, укук же аскердик пландаштыруу сыяктуу тармактарда эң ылайыктуу адистер кымбат жана убакыт жагынан тартыш болушу мүмкүн. Ошондуктан баалоо дизайны идеалдуу баалоочу ким экенин гана эмес, чындыгында канча эксперт убактысы бар экенин да эске алышы керек.
Макала адистер чектелүү болгон учурларда туруктуу аннотация квотасынын ордуна максатталган белгисиздикке жараша үлгү көлөмүн пландаштырууну; эксперт эмгегин тобокелдүү, чек аралык же жогорку келишпестиктүү пункттарга багыттоону сунуштайт.
Purpose: баалоо жашоо циклинин кайсы баскычында?
Эрте иштеп чыгуу тез модель салыштырууга жана ачык ката режимдерин табууга багытталат. Автоматтык метрикалар, чакан адам артыкчылык тесттери же LLM-as-judge системалары тез багыттоочу сигнал бере алат.
Жайылтуудан мурунку валидация жогорураак далил чегин талап кылат. Система максатталган натыйжалуулук, коопсуздук жана ишенимдүүлүк чектерин аткарабы деген суроого түзүмдөлгөн адамдык баалоо, тармактык критерийлер жана ишенимдүүлүк жөнүндө отчет берүү менен жооп берилиши керек.
Өндүрүш мониторинги система колдонууга киргенден кийин натыйжалуулуктун жылышын, жаңы ката режимдерин жана колдонуучу өз ара аракеттенүүлөрүндөгү өзгөрүүлөрдү көзөмөлдөйт. Жогорку көлөмдө автоматтык мониторинг жана аномалияны аныктоо жүргүзүлүшү мүмкүн; тандалган жогорку тобокелдиктүү же шектүү үлгүлөр адам кароосуна жөнөтүлөт.
Volume: миллиондогон чыгыштар кантип бааланат?
Төмөн көлөмдүү эксперттик тест топтомунда ар бир чыгыш деталдуу рубрикалар менен бир нече адис тарабынан каралышы мүмкүн. Орточо көлөмдө үлгү алуу менен жарым-жартылай автоматташтыруу бириктирилиши мүмкүн. Миллиондогон chatbot өз ара аракеттенүүсү бар жогорку көлөмдүү өндүрүш чөйрөсүндө ар бир чыгышты түздөн-түз адам менен баалоо мүмкүн эмес; автоматтык скрининг жана статистикалык үлгү алуу аркылуу тобокелдүү же адаттан тыш үлгүлөр гана адамга жөнөтүлүшү керек.
Булактагы 1-сүрөттүн илимий билдирүүсү
Макаланын 10-бетиндеги STEP-V сүрөтү төмөн, орточо жана жогорку тобокелдиктүү колдонуу деңгээлдерин үч өзүнчө чечим панелинде көрсөтөт. Ар бир панель “негизги максат”, “ким баалашы керек?”, “кабыл алынуучу ыкмалар” жана “качан эксперттик кароого көтөрүү керек?” деген суроолорду иштеп чыгуу, жайылтуу валидациясы жана мониторинг контекстинде бирге карайт.
Сүрөттүн негизги билдирүүсү — тобокелдик өскөн сайын адам адистиги баалоо чынжырынын борборуна жылат. Төмөн тобокелдиктүү жана жогорку көлөмдүү иштерде автоматташтыруу көбүрөөк колдонулса, жогорку тобокелдиктүү тармактарда автоматтык баалоо адам адисинин ордун баспастан алдын ала иргөө же колдоо милдетинде калышы керек.
Жогорку Тобокелдиктүү Колдонмолордо LLM-as-Judge Адам Адисинин Ордун Баса Алабы?
Макаланын сунушу боюнча, жалпы учурда жок. Жогорку тобокелдиктүү колдонмолордо LLM-as-judge системалары максаттуу тапшырмада квалификациялуу адистерге салыштырмалуу өтө күчтүү жана тапшырмага мүнөздүү далил бере алганда гана кеңири роль ала алат; демейки мамиле адисти негизги калыс, LLMди болсо алдын ала скрининг, ички критерийлерди текшерүү же кароону артыкчылыкка коюу куралы катары колдонуу.
Expert-Guided Auto-Evaluation
Адистердин тартыштыгы менен баалоонун чоң көлөмүнүн ортосундагы боштукту азайтуу үчүн макала Expert-Guided Auto-Evaluation ыкмасын талкуулайт. Бул жерде эксперттин ролу ар бир чыгышка өзүнчө энбелги коюудан жарым-жартылай алыстап, өлчөө куралын долбоорлоого өтөт.
Адис тапшырмага мүнөздүү рубрикаларды, критикалык ички критерийлерди жана баалоо/сын promptтарын түзөт. LLM негизиндеги калыстар системасы бул түзүмдөлгөн өлчөөнү чыгыштардын чоң көлөмүнө колдонот. Бирок LLM баалоосу эксперттик стандарттар менен калибрлениши керек.
50–100 эксперттик энбелги сунушу эмнени билдирет?
Макала толук эксперттик көзөмөл чыгымга байланыштуу мүмкүн болбогон айрым жогорку тобокелдиктүү учурларда болжол менен 50–100 эксперт тарабынан ырасталган үлгүнү чоңураак жана арзаныраак crowd-sourced же LLM-калыс маалымат топтомун калибрлөө үчүн колдонсо болорун мисал стратегия катары талкуулайт.
Бул сан универсалдуу үлгү көлөмү эрежеси эмес. Тексттин уландысы үлгү планын туруктуу квотадан эмес, чечим үчүн кабыл алынуучу белгисиздик деңгээлинен баштоо керектигин ачык көрсөтөт.
Үч колдонуу мисалы
| Колдонмо | Тобокелдик / тапшырма түзүлүшү | Сунушталган баалоо ыкмасы |
|---|---|---|
| Медициналык кеңешчи жардамчы | Жогорку тобокелдик, негизинен ачык жооптуу, адис тартыштыгы | Эксперт жетекчилигиндеги рубрика баалоосу; автоматтык куралдар алдын ала скрининг/triage үчүн; белгисиз же тобокелдүү учурларды экспертке көтөрүү |
| Керектөөчүгө арналган жазуу жардамчысы | Төмөн–орточо тобокелдик, ачык жооптуу, баалоочулар жогорку деңгээлде жеткиликтүү | Жуптук артыкчылык, колдонуучу упайлары жана LLM-as-judge; коопсуздук/саясат өлчөмдөрүндө мезгил-мезгили менен эксперттик көзөмөл |
| Корпоративдик retrieval негизиндеги саясат/шайкештик куралы | Орточо–жогорку тобокелдик, жарым-жартылай текшериле турган, жогорку көлөм | Фактылык шайкештик жана citation тууралыгы үчүн автоматтык текшерүүлөр + адамга калибрленген LLM-as-judge + үлгүлөнгөн адамдык көзөмөл |
STEP-V кайсы учурларда иштебей калышы мүмкүн?
Автор STEP-Vни баалоо катасына каршы кепилдик катары сунуштабайт. Алкак айрыкча төрт учурда көйгөйдү чече албай турганы айтылат: өлчөнө турган түзүлүш начар аныкталса, жеткиликтүү баалоочулардын баары бир эле системалуу бир тараптуулукка ээ болсо, жогорку тобокелдиктүү тапшырмада минималдуу эксперттик көзөмөл жок болсо же маанилүү баалоочу келишпестиги туура эмес түрдө бир консенсус упайына кыскартылса.
Мындай учурда көйгөй протокол тандоодон да кеңири. STEP-V чечим мейкиндигин иреттей алат, бирок валиддүү эмес түзүлүш аныктамасын, жетишсиз баалоочулар пулун же белгисиздикти жашырган өлчөө системасын өзүнөн-өзү оңдой албайт.
Методологиялык сунуштар
Макала адамга багытталган LLM баалоосу үчүн максаттуу критерийлерди так операциялык аныктамалардан баштоону сунуштайт. Аныктамалар, өкүлчүлүктүү мисалдар жана чек аралык учурлар кандай каралары алдын ала көрсөтүлүшү керек.
Баалоочуну тандоо максаттуу түзүлүш менен негизделиши керек. Ирет таасирин жана башка белгилүү бир тараптуулуктарды азайтуу үчүн сокурлоо, рандомизация, калибрлөө жана иш жүгүн башкаруу колдонулушу керек. Изилдөөлөр орточо упайды гана эмес, ишенимдүүлүк статистикасын жана белгисиздик маалыматын да билдириши керек.
Автоматтык метрикалар жана LLM негизиндеги калыстар моделдери максаттуу тапшырмада адамдык пикирлер менен калибрленбей туруп демейки түрдө валиддүү деп кабыл алынбашы керек. Тобокелдик деңгээли жогорулаган сайын LLM-as-judge системасын колдонуу үчүн талап кылынган далил стандарты да жогорулашы керек.
Психометриялык модель тандоо
| Маалымат / протокол | Сунушталган модель үй-бүлөсү | Максат |
|---|---|---|
| Likert же ordinal рубрика упайлары | Иерархиялык ordinal моделдер | Латенттик сапатты баалоочунун катаалдыгы, пункттун татаалдыгы жана белгисиздик менен бирге моделдөө |
| Көп баалоочулуу түзүмдөлгөн баалоо | Many-facet Rasch моделдери | Моделдин натыйжалуулугун баалоочунун катаалдыгынан жана пункттун татаалдыгынан ажыратуу |
| Жуптук салыштыруу | Bradley–Terry же ага байланышкан Thurstone моделдери | Салыштырмалуу сапатты жуптук артыкчылык маалыматтарынан баалоо |
| Эч бир баалоочу катасыз деп кабыл алынбаган чөйрө | Latent-class / imperfect-gold-standard моделдери | Жөнөкөй көпчүлүк добушунун ордуна баалоочунун катасын ачык моделдөө |
Минималдуу отчеттуулук стандарты
Автор баалоо изилдөөлөрүндө жок дегенде баалоочуларды жалдоо, окутуу, тапшырма көрсөтмөлөрү, шкаланын форматы, баалоо сессиясынын узактыгы, adjudication эрежелери, ишенимдүүлүк статистикасы жана белгисиздик жөнүндө отчет көрүнүктүү болушу керек деп эсептейт.
Мисал рубрикаларды, калибрлөө promptтарын, аудит checklistтерин жана талдоо шаблондорун бөлүшүү да кайталануучулукту күчөтүшү мүмкүн. Булактын Supplementary Materials пакетинде ушул максаттар үчүн даярдалган беш кошумча файл бар.
Изилдөө колдогон жана колдобогон жыйынтыктар
| Изилдөө колдогон | Изилдөө колдобогон |
|---|---|
| Адамдык баалоо өзүнүн ишенимдүүлүк, валиддүүлүк жана бир тараптуулук көйгөйлөрү бар өлчөө системасы катары долбоорлонушу керек. | Адамдык баалоо бардык учурда LLM-as-judgeдан туурараак экени эксперименттик түрдө далилденген. |
| LLM-as-judge валиддүүлүгү тапшырмага, түзүлүшкө жана баалоочулар коомчулугуна жараша болот. | Белгилүү бир калыс модели бардык тапшырмаларда колдонулушу керек. |
| Адам–LLM гибрид баалоосу айрым учурларда масштаб менен контексттик сапатты бириктире алат. | Гибрид системалар автоматтык түрдө бир тараптуулукту азайтат. |
| Келишпестик субъективдүү же маданий тапшырмаларда маанилүү көз караш айырмасын көрсөтүшү мүмкүн. | Бардык келишпестиктер кабыл алынышы керек; коопсуздук-критикалык пункттарда adjudication керексиз. |
| STEP-V баалоо ыкмасын тандоону системалаштырган дизайн колдоосу болуп саналат. | STEP-V эксперименттик түрдө ырасталган, ката деңгээли белгилүү же жалгыз туура протоколду автоматтык эсептеген модель болуп саналат. |
| Жогорку тобокелдикте эксперттик көзөмөл жана белгисиздикти башкаруу артыкчылыкка коюлушу керек. | Калибрленбеген LLM-as-judge системалары медицина, укук, финансы же аскердик колдонууда адистердин ордун баса алат. |
Чектөөлөр жана келечектеги изилдөө
Макаланын эң маанилүү чектөөсү — STEP-V да, жалпы ката режимдеринин таксономиясы да концептуалдык болуп саналат. Автор бул түзүмдөр реалдуу баалоо дизайнын жакшыртабы же жокпу, бир тараптуулукту жана келишпестикти канчалык алдын ала айта алары жана гибрид системанын натыйжалуулугу тууралуу божомолдор проспективдүү изилдөөлөр менен текшерилиши керектигин белгилейт.
LLM баалоо тармагынын өтө тез өзгөрүшү серептердин кыска убакытта эскирип калуу тобокелдигин да жогорулатат. Келечектеги изилдөөлөр баалоочулардын убакыт өтүшү менен LLMдерге көнүшүнө, маданияттар аралык өлчөө инварианттуулугуна, баалоочу таасирлерин психометриялык моделдөөгө, келишпестик-aware pipelineдарга, үлгү жана күч пландаштырууга, ошондой эле чектелген эксперт убактысын белгисиздикке жараша бөлүштүрүүгө багытталышы сунушталат.
Макала ошондой эле STEP-V келечекте жарым сандык чечим куралына айландырылышы мүмкүн экенин талкуулайт. Беш өлчөмгө ordinal деңгээлдерди ыйгаруу жана аларды валиддүүлүк тобокелдиги, баалоочулар аралык ишенимдүүлүк тобокелдиги, жалпы бир тараптуулуктун күчөшү, чыгым жана escalation жүгү сыяктуу чыгыштар менен байланыштыруу мүмкүн. Бирок булак бул сандык дал келтирүүнү азырынча ишке ашырбайт; учурдагы STEP-Vни сандык натыйжалуулук божомолдоочусу катары колдонуу изилдөө тарабынан колдоого алынбайт.
Булак жана Ыкма Жөнүндө Эскертүү
| Түпнуска аталыш | Human Evaluation of Large Language Models: A Review and Protocol Selection Framework |
|---|---|
| Автор | Tad T. Brunyé |
| Мекеме 1 | Center for Applied Brain and Cognitive Sciences, Tufts University, Medford, Massachusetts, USA |
| Мекеме 2 | U.S. Army DEVCOM Soldier Center, Natick, Massachusetts, USA |
| DOI | 10.3390/ai7050174 |
| Журнал | AI |
| Басмакана | MDPI, Basel, Switzerland |
| ISSN | 2673-2688 |
| Том / саны | 7 / 5 |
| Макаланын номери | 174 |
| Булактын түрү | Review |
| Келип түшкөн датасы | 7 апрель 2026 |
| Ревизия | 30 апрель 2026 |
| Кабыл алуу | 14 май 2026 |
| Жарыялоо | 19 май 2026 |
| Рецензиялоо | Рецензияланган журналдык жарыя |
| Лицензия | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Каржылоо | U.S. Army DEVCOM Soldier Center, Augmented Decisions via Intelligent Systems Recommendations (ADVISR) программасы, BC1/3D |
| Institutional Review Board | Колдонулбайт |
| Маалымдалган макулдук | Колдонулбайт |
| Маалыматтын жеткиликтүүлүгү | Колдонулбайт |
| Кызыкчылыктардын кагылышы | Автор кызыкчылыктардын кагылышы жок экенин билдирген. |
| Supplementary Materials | File S1–S5 бар |
Supplementary Materials мазмуну: File S1 Illustrative Scoring Rubrics; File S2 Example Calibration Prompts; File S3 Example Reporting Template; File S4 Example Audit Checklist; File S5 STEP-V Illustrative Configurations.
Каржылоо жана мекемелик позициянын чеги: Изилдөө U.S. Army DEVCOM Soldier Center курамындагы ADVISR программасы тарабынан колдоого алынган. Макалада пикирлер жана дооматтар автордун жеке көз караштары экени жана United States Army же тиешелүү мамлекеттик мекемелердин расмий саясатын же көз карашын билдирбей турганы ачык көрсөтүлгөн.
Автордун салымдары: Булак бир авторлуу жана өзүнчө CRediT салым таблицасын билдирбейт. Булакта жок салым ролдору Verianla тарабынан чыгарылган эмес.
Сереп ыкмасынын чеги: Макала кеңири адабият синтезин жүргүзөт, бирок системалуу издөө сабын, PRISMA агымын, изилдөө тандоо сандарын же мета-аналитикалык синтезди билдирбейт. Ошондуктан “системалуу сереп” катары классификацияланган эмес.
STEP-V валидациясынын чеги: STEP-V жана ката режимдеринин таксономиясы концептуалдык алкактар. Булак алар келечекте проспективдүү түрдө текшерилиши керектигин билдирет; алкактарга тиешелүү тууралык деңгээли, сезимталдык, өзгөчөлүк, ишеним аралыгы же эксперименттик ийгилик упайы билдирилген эмес.
Визуалдык булак эскертүүсү: 10-беттеги түпнуска STEP-V сүрөтү төмөн, орточо жана жогорку тобокелдиктүү колдонмолордо баалоочу тандоону, иштеп чыгуу/валидация/мониторинг ыкмаларын жана escalation логикасын көрсөткөн чечим жардамчысы. Verianla үчүн кайра чийилсе, пикселдик көчүрмөнүн ордуна ошол эле илимий байланыштарды сактаган өз алдынча чечим агымы колдонулушу керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген