

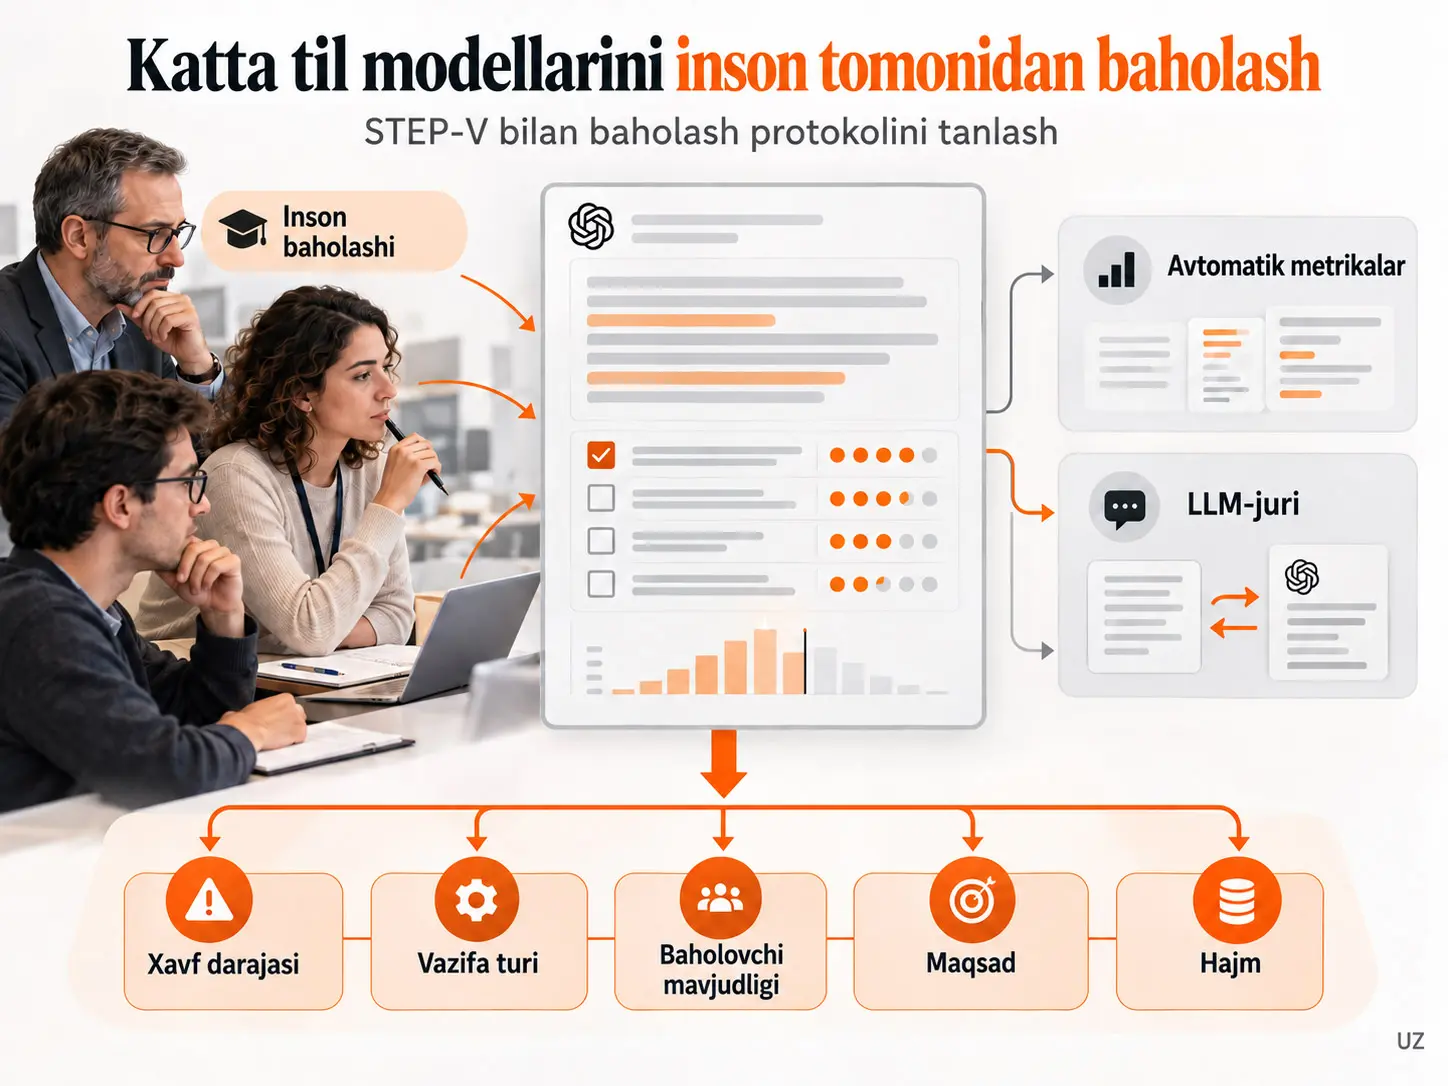
Inson markazidagi LLM baholashi, katta til modeli chiqishlarini faqat avtomatik metrikalar bilan emas, balki muayyan vazifa, sifat mezoni va foydalanish kontekstini baholashga mos inson hukmlari orqali o‘lchashni ta’minlaydigan baholash yondashuvidir. Ushbu sharh inson baholashini benuqson “to‘g‘ri javob manbai” sifatida emas, balki o‘z ishonchliligi, validligi, tarafkashliklari, kognitiv cheklovlari va noaniqligiga ega o‘lchash infratuzilmasi sifatida ko‘rib chiqadi. Maqola yangi LLM tajribasi natijalarini taqdim etmaydi; u baholash metodologiyasi, psixometriya, kognitiv fan, inson omillari va sohaga xos LLM ilovalaridagi tadqiqotlarni sintez qilib, baholash protokolini qanday tanlash kerakligi bo‘yicha konseptual asos ishlab chiqadi.
Muallif to‘rtta asosiy muammoga e’tibor qaratadi: inson yorliqlarini benuqson oltin standart sifatida qabul qilish, baholovchi charchog‘i va ortiqcha kognitiv yuk, insonlar hamda LLM asosidagi hakam modellarida uchraydigan umumiy yoki farqli tarafkashlik tuzilmalari, shuningdek baholash natijalaridagi noaniqlik va taqsimot ma’lumotlarining ko‘pincha e’tibordan chetda qolishi. Ushbu muammolarni tizimli ko‘rib chiqish uchun STEP-V doirasi taklif etiladi. STEP-V; Stakes, Task-type, Evaluator availability, Purpose va Volume o‘lchamlaridan iborat bo‘lib, real foydalanish sharoitlarida inson, avtomatik metrika va LLM-as-judge kombinatsiyalarini qanday tanlash mumkinligi bo‘yicha qarorlarni qo‘llab-quvvatlaydi.
Maqolaning ikkinchi original hissasi inson baholovchilari va LLM-as-judge tizimlarini bir xil xato doirasida ko‘rib chiqadigan umumiy xato rejimlari taksonomiyasidir. Tartib ta’siri, uzun javobni afzal ko‘rish, avtoritet ta’siri, ortiqcha ishonch, charchoq, subyektivlik, bilim yetishmasligi, madaniy tarafkashlik va noto‘g‘ri ma’lumotga ishonish kabi muammolarning ayrimlari insonlarda ham, LLM baholovchilarida ham turli shakllarda namoyon bo‘lishi mumkin. Shu sababli inson va sun’iy baholovchilarni birlashtirgan gibrid tizimlar o‘z-o‘zidan ishonchliroq deb faraz qilib bo‘lmaydi; agar har ikki tomon bir xil turdagi xatoga moyil bo‘lsa, xato kamayish o‘rniga kuchayishi mumkin.
Tadqiqotning asosiy talqin chegarasi shundan iboratki, STEP-V va umumiy xato rejimlari taksonomiyasi hali prospektiv tajribalar bilan tasdiqlangan miqdoriy ishlash modellari emas. Muallif ularni baholash dizaynini tuzilmalashtirish uchun konseptual asoslar sifatida taqdim etadi va ular haqiqiy baholash sifatini oshiradimi-yo‘qmi, kelajakda empirik ravishda sinovdan o‘tkazilishi kerakligini ochiq aytadi.
LLM Baholashida Inson Hukmi Nega Hali Ham Zarur?
Inson hukmi, ayniqsa, ochiq yakunli, kontekstga bog‘liq, mutaxassislik talab qiladigan yoki ijtimoiy va normativ mezonlarni o‘z ichiga oladigan vazifalarda zarur; chunki so‘z o‘xshashligi yoki avtomatik ballar javobning klinik jihatdan xavfsiz, huquqiy jihatdan himoya qilinadigan, pedagogik jihatdan foydali, ijtimoiy jihatdan maqbul yoki haqiqiy foydalanuvchi uchun foydali ekanini yakka o‘zi ishonchli o‘lchay olmaydi.
Dastlabki tabiiy tilni qayta ishlash tizimlarida vazifalar torroq, to‘g‘ri chiqishlar fazosi cheklanganroq va etalon javoblar bilan taqqoslash amaliyroq edi. Hozirgi LLMlar esa tibbiy maslahatdan huquqiy tahlilgacha, o‘qitishdan rejalashtirish va ijodiy yozuvgacha juda ochiq yakunli chiqishlar yaratadi. Bunday holatlarda bir savolga bir nechta yaxshi javob bo‘lishi mumkin va yuzaki jihatdan o‘xshash ikki javob xavfsizlik yoki to‘g‘rilik nuqtai nazaridan butunlay farq qilishi mumkin.
Shu sababli maqola baholashni faqat “model to‘g‘ri javob berdimi?” savoligacha qisqartirmaydi. Asosiy o‘lchash muammosi quyidagilarni birgalikda qamrab oladi: nima o‘lchanayotgani, kim baholayotgani, qaysi protokol qo‘llanayotgani, baholash shkalasi qanday ta’riflangani, baholovchining qanchalik malakali ekani, qanchalik charchagani va natijalar qaysi statistik farazlar asosida birlashtirilgani.
Inson baholashining o‘zi ham o‘lchash tizimidir
Inson baholashi valid yoki novalid; ishonchli yoki ishonchsiz; yaxshi kalibrlangan yoki yomon kalibrlangan bo‘lishi mumkin. Shu sababli inson yorlig‘ini avtomatik ravishda “ground truth” deb qabul qilish metodologik jihatdan yetarli emas.
Maqolaning psixometrik yondashuvi shu yerda muhim ahamiyat kasb etadi. O‘lchashning ishonchliligiturli baholovchilar, bandlar yoki vaqt nuqtalari orasida qanchalik izchil ekanini; validligi esa haqiqatan o‘lchamoqchi bo‘lgan konstruktni o‘lchayaptimi-yo‘qmi, shuni ifodalaydi. Baholash yuqori izchillikka ega bo‘lib, baribir noto‘g‘ri narsani o‘lchashi mumkin.
Masalan, baholovchilarning tizimli ravishda uzunroq javoblarni afzal ko‘rishi juda izchil natija berishi mumkin; ammo maqsad mezoni to‘g‘rilik bo‘lsa, javob uzunligi haqiqiy sifat ko‘rsatkichi bo‘lmasligi mumkin. Xuddi shuningdek, yakuniy foydalanuvchi qoniqishi “idrok etilgan foydalilik” uchun valid mezon bo‘lishi mumkin, biroq faktik to‘g‘rilikning valid o‘lchovi bo‘lishi shart emas.
Uch qatlamli LLM baholash taksonomiyasi
| Qatlam | Baholovchi / vosita | Asosiy afzallik | Asosiy cheklov |
|---|---|---|---|
| Qatlam 1 | Avtomatik etalonli yoki etalonsiz metrikalar | Past xarajat, yuqori takrorlanuvchanlik va tez iteratsiya | Ochiq yakunli vazifalarda to‘g‘rilik, mulohaza yuritish sifati, foydalilik yoki etik muvofiqlik kabi konstruktlarni to‘liq o‘lchamasligi mumkin |
| Qatlam 2 | LLM-as-judge tizimlari | Insonlarga qaraganda yuqoriroq masshtablanuvchanlik va klassik metrikalarga qaraganda ko‘proq kontekst sezgirligi | Validlik vazifa, til, o‘lchanayotgan xususiyat va maqsadli inson guruhiga bog‘liq; sukut bo‘yicha valid deb qabul qilib bo‘lmaydi |
| Qatlam 3 | Bevosita inson baholashi | Kontekst, mutaxassislik, ijtimoiy muvofiqlik, xavfsizlik va bir nechta valid javoblarni baholay olish | Xarajat, masshtablanuvchanlik, charchoq, geterogenlik va kognitiv tarafkashliklar |
Qatlam 1: Avtomatik metrikalar
BLEU, ROUGE va METEOR kabi klassik metrikalar yaratilgan matnni etalon javoblar bilan yuzaki yoki tuzilmaviy o‘xshashlik jihatidan taqqoslaydi. BERTScore kabi yangi semantik metrikalar embedding fazosida semantik o‘xshashlikni baholashga urinadi. Perplexity yoki ayrim retrieval-augmented generation kontekstlaridagi faithfulness metrikalari kabi etalonsiz vositalar ham bitta oltin javobni talab qilmasdan sifat signali ishlab chiqarishni maqsad qiladi.
Bu vositalarning ahamiyatini kamaytirib bo‘lmaydi; ular tez, arzon va qayta ishlab bo‘ladigan baholashni ta’minlaydi. Biroq maqolaning urg‘usi shundaki, ular faqat o‘lchay oladigan konstrukt darajasidagina mazmunlidir. Matn etalon javobga o‘xshash bo‘lsa ham real dunyo nuqtai nazaridan noto‘g‘ri yoki xavfli bo‘lishi mumkin; boshqa matn esa etalonga kam o‘xshasa ham to‘g‘ri va foydali bo‘lishi mumkin.
Qatlam 2: LLM-as-judge
LLM-as-judge— til modelidan boshqa model chiqishini ballash, tartiblash yoki ikki javob orasida tanlash uchun baholovchi sifatida foydalanishdir. Maqola bu yondashuv ayniqsa aniq mezonli, rubrikaga asoslangan yoki juft taqqoslash vazifalarida foydali bo‘lishi mumkinligini; biroq ishlash vazifa turi, o‘lchanayotgan xususiyat, til va u bilan taqqoslanayotgan inson baholovchilarining mutaxassislik darajasiga qarab sezilarli darajada o‘zgarishi mumkinligini ta’kidlaydi.
Bundan kelib chiqadigan asosiy xulosa shuki, LLM-as-judge tizimi plug-and-play ko‘rinishidagi universal baholovchi emas. Hakam modelining validligi mahalliydir: u maqsadli vazifa, maqsadli konstrukt va maqsadli inson baholovchilar hamjamiyatiga nisbatan kalibrlanishi va sinovdan o‘tkazilishi kerak.
Qatlam 3: Bevosita inson baholashi
Bevosita inson baholashi ishontiruvchanlik, muvofiqlik, pedagogik qiymat, potensial zarar, sohaga xos kompetensiya va kontekstual moslik kabi formallashtirish qiyin bo‘lgan xususiyatlarda yuqori moslashuvchanlik beradi.
Biroq “inson baholashi” bitta usul emas. Shifokorning klinik javobni baholashi, huquq mutaxassisining huquqiy tahlilni ko‘rib chiqishi, yakuniy foydalanuvchining qoniqish bildirishi va crowdworkerning ikki chatbot javobini taqqoslashi turli o‘lchash harakatlaridir. Ularni teng deb qabul qilish baholash validligini zaiflashtirishi mumkin.
LLM Chiqishini Kim Baholashi Kerakligini Qanday Hal Qilinadi?
Baholovchini tanlash o‘lchanadigan konstrukt qanchalik ko‘p mutaxassislik bilimi, yashab o‘tilgan tajriba yoki kontekstual tanishlik talab qilishiga qarab amalga oshirilishi kerak. Yuqori xavfli va mutaxassislik talab qiladigan vazifalarda soha mutaxassislari kuchliroq konstrukt validligini ta’minlashi mumkin, foydalanuvchi qoniqishi yoki kundalik foydalanish qulayligi kabi konstruktlar uchun esa haqiqiy yakuniy foydalanuvchilar validroq baholovchilar bo‘lishi mumkin.
| Baholovchi | Mutaxassislik vazifalaridagi validlik | Ishonchlilik | Xarajat | Masshtablanuvchanlik | Eng maqbul qo‘llanish |
|---|---|---|---|---|---|
| Soha mutaxassislari | Juda yuqori | O‘rta | Juda yuqori | Past | Tibbiyot, huquq, harbiy soha, moliya kabi yuqori xavfli va mutaxassislik talab qiladigan vazifalar |
| Tayyorlangan annotatorlar | O‘rta | O‘rta | O‘rta | O‘rta | Rubrika va kalibrlash bilan umumiy maqsadli sifat baholashi |
| Crowdworkerlar | Past–o‘rta | Past–o‘rta | Past | Juda yuqori | Ravonlik, aloqadorlik, asosiy tushunarlilik va past xavfli keng ko‘lamli annotatsiya |
| Yakuniy foydalanuvchilar | Yuqori ekologik validlik | Past | Past | O‘rta | Qoniqish, foydalanish qulayligi va real foydalanish kontekstidagi foydalilik |
Maqola, ayniqsa, mutaxassislar o‘rtasida fikrlar farqi bo‘lishi mumkinligini eslatadi. Mutaxassislarning bir xil xulosaga kelmasligi avtomatik ravishda baholash muvaffaqiyatsizligi degani emas; bu murakkab klinik, huquqiy yoki ijtimoiy konstruktning haqiqatan noaniq ekanining belgisi bo‘lishi mumkin.
Nima baholanmoqda?
Baholash dizaynining dastlabki qadamlaridan biri maqsadli konstruktni aniq ta’riflashdir. “Sifat” kabi bitta va noaniq so‘z o‘rniga to‘g‘rilik, foydalilik, afzallik, ishonch, o‘qish qulayligi, xavfsizlik, kontekstual moslik yoki boshqa o‘lchanadigan konstrukt belgilanishi kerak.
Faktik to‘g‘rilik, iqtibos to‘g‘riligi va format qoidalariga muvofiqlik ko‘pincha tashqaridan tekshirilishi mumkin. Ijodkorlik, xushmuomalalik yoki o‘zaro ta’sir jozibadorligi esa inson talqiniga va ijtimoiy me’yorlarga ko‘proq bog‘liq. Klinik muvofiqlik, huquqiy mustahkamlik yoki tartibga soluvchi talablariga muvofiqlik kabi mezonlarda umumiy baholovchilar yetarli mutaxassislikka ega bo‘lmasligi mumkin.
Baholash qaysi protokol bilan amalga oshirilishi mumkin?
- Likert tipidagi ballash: Javobga, masalan, 1–5 oralig‘ida ball beriladi. Nozik darajalashni beradi, biroq shkalani talqin qilish va anchoring ta’sirlariga sezgir.
- Ikkilik qaror: Maqbul / nomaqbul yoki to‘g‘ri / noto‘g‘ri kabi ikki sinfdan biri tanlanadi. Keskin farqlarda kelishuvni oshirishi mumkin, ammo nozik farqlarni yo‘qotishi mumkin.
- Juft taqqoslash: Ikki chiqish yonma-yon baholanadi va muayyan mezon bo‘yicha qaysi biri yaxshiroq ekani tanlanadi. Mutlaq ball berishda qiynaladigan baholovchilar uchun foydali bo‘lishi mumkin.
- Rubrikaga asoslangan baholash: Chiqish bir nechta aniq quyi o‘lchamda, oldindan belgilangan mezonlar yoki anchor misollar asosida ballanadi. Noaniq yaxlit hukmni kuzatish mumkin bo‘lgan qismlarga ajratishi mumkin.
Protokol faqat ball shaklini belgilamaydi; u hosil bo‘ladigan ma’lumotlarning statistik tuzilmasini, kognitiv yukni va ehtimoliy xato manbalarini ham belgilaydi. Bir vaqtning o‘zida haddan tashqari ko‘p mezon, uzoq baholash sessiyalari yoki yetarlicha aniq ta’riflanmagan shkala yorliqlari ishonchlilikni pasaytirishi mumkin.
Insonlar O‘rtasidagi Fikr Farqi Har Doim Xatomi?
Yo‘q. Ochiq yakunli, subyektiv yoki madaniy jihatdan o‘zgaruvchan vazifalarda fikr farqi haqiqiy va mazmunli nuqtai nazar farqlarini ifodalashi mumkin; aksincha, dori kontrindikatsiyasi yoki noto‘g‘ri huquqiy iqtibos kabi tashqaridan tekshiriladigan yuqori xavfli masalalarda katta kelishmovchilik yanada qat’iy ekspert ko‘rib chiqishini talab qiladigan ogohlantirish signali sifatida baholanishi kerak.
Ishonchlilikni o‘lchash
Maqola Cohen's kappa, Krippendorff's alpha va intraclass correlation coefficient kabi baholovchilararo ishonchlilik o‘lchovlari mavjudligini; biroq LLM baholash tadqiqotlarida ular yetarlicha hisobot qilinmasligi yoki kontekstsiz berilishini qayd etadi.
Bitta o‘rtacha ball katta kelishmovchilikni yashirishi mumkin. Shu sababli past kelishuvni to‘g‘ridan-to‘g‘ri “annotator shovqini” sifatida tashlab yubormaslik kerak; u noaniq mezon, aralash konstrukt yoki baholovchiga tushgan ortiqcha kognitiv yukni ko‘rsatishi mumkin.
Taqsimotli baholash
Subyektiv vazifalarda faqat o‘rtacha fikrga qarash o‘rniga baholash taqsimotlarini saqlab qolish mumkin. Maqola Kullback–Leibler divergence va Earth Mover's Distance kabi taqsimot masofasi o‘lchovlaridan model hukmlarining faqat inson o‘rtachasiga emas, balki inson fikrlarining tarqalishiga qanchalik o‘xshashligini tekshirish uchun foydalanish mumkinligini muhokama qiladi.
Bu yerda maqsad barcha kelishmovchiliklarni yo‘q qilish emas. Turli inson guruhlari turlicha, ammo valid nuqtai nazarlarga ega bo‘lishi mumkin. Biroq katta quyi guruh ajralishlari yoki yuqori xavfli bandlardagi noaniqlik maqsadli nazorat va ekspert adjudication zaruratini ko‘rsatishi mumkin.
Nuqsonli oltin standart muammosi
Inson yorlig‘i ko‘plab LLM baholashlarida so‘nggi va bahssiz etalon sifatida qabul qilinadi. Maqola psixometriya va diagnostik statistika adabiyotiga tayangan holda bu har doim ham valid emasligini ta’kidlaydi. Inson baholovchilari ham xato qilishi, turli qat’iylikda ball berishi yoki konstruktni turlicha talqin qilishi mumkin.
Shu sababli oddiy ball o‘rtachalaridan tashqariga chiqish uchun many-facet Rasch modellari, iyerarxik ordinal modellar, Bradley–Terry turidagi juft taqqoslash modellari va zarur bo‘lganda imperfect-gold-standard yoki latent-class modellari kabi o‘lchash yondashuvlari muhokama qilinadi. Maqola bu modellarni o‘z ma’lumotlariga qo‘llamaydi; ularni yanada asosli LLM baholash dizayni uchun metodologik variantlar sifatida taqdim etadi.
Tadqiqot Usuli va Natijalari
Sharhning ilmiy yondashuvi
Tadqiqot yangi LLM ma’lumotlar to‘plamida tajriba o‘tkazadigan empirik tadqiqot emas. Muallif LLM baholash metodologiyasi, inson baholashi, psixometriya, kognitiv fan, annotatsiya tadqiqotlari, LLM-as-judge ishlari va sog‘liqni saqlash, huquq, moliya, harbiy soha, ta’lim hamda xavfsizlik kabi amaliy sohalardagi adabiyotlarni birlashtirib, umumiy baholash dizayni mantiqini shakllantiradi.
Manbada tizimli qidiruv so‘rovi, PRISMA tanlash oqimi, meta-tahlil yoki miqdoriy tadqiqot sifati ballashi hisobot qilinmagan. Shu sababli olingan “natijalar” yangi eksperimental ta’sirlardan ko‘ra adabiyot sintezi orqali ishlab chiqilgan konseptual xulosalar, usul tavsiyalari va dizayn tamoyillaridir.
Inson va LLM baholovchilarining umumiy xato rejimlari taksonomiyasi
| Xato rejimi | Insondagi ko‘rinishi | LLM-as-judge ko‘rinishi | Tavsiya etilgan dizayn javobi |
|---|---|---|---|
| Tartib ta’sirlari | Birinchi/oxirgi elementga ortiqcha vazn berish, anchoring | Pozitsiya tarafkashligi | Tartibni tasodifiylashtir va taqdimotni ko‘r qil |
| Uzunlik tarafkashligi | Uzunroq javobni yaxshiroq deb ko‘rish | Mazmun o‘rniga uzunlikni afzal ko‘rish | Uzunlikni nazorat qil yoki ixchamlikni alohida bahola |
| Avtoritet tarafkashligi | Nufuzli manba yoki ohangga ortiqcha ishonish | Avtoritetli ko‘rinadigan chiqishni afzal ko‘rish | Imkon bo‘lsa manba/shaxsiyat ishoralarini olib tashla |
| Ijtimoiy moslashuv | Oldingi baholovchilar tomon og‘ish | Oldindan berilgan signallarni kuchaytirish | Baholovchilarni mustaqil tut va ball sizib chiqishining oldini ol |
| Ortiqcha ishonch | Ballarda haddan tashqari yuqori aniqlik | Qarorda haddan tashqari yuqori aniqlik | Asos yoki ishonch darajasi hisobotini so‘ra |
| Charchoq va ortiqcha yuk | Sessiya ichida va sessiyalar orasida e’tiborning pasayishi | Uzoq kontekst, murakkab vazifa yoki takroriy inferensiya ostida ishlashning pasayishi | Sessiya davomiyligini chekla va tartib bo‘ylab drift nazoratini olib bor |
| Subyektivlikdagi muvaffaqiyatsizlik | Ijodiy yoki madaniy hukmlarda baholovchilararo past kelishuv | Subyektiv vazifalarda insonlar bilan zaif moslik | Bir nechta baholovchidan foydalan, kelishmovchilikni saqla va shovqindagi signalni tekshir |
| Bilim bo‘shliqlari | Mutaxassislik talab qiladigan xatoni payqay olmaslik | Sohaga xos zaif mulohaza | Baholovchi mutaxassisligini vazifaga moslashtir |
| Madaniy tarafkashlik | Demografik yoki madaniy fonning ballga ta’sir qilishi | O‘quv ma’lumotlaridan ko‘chib o‘tgan tarafkashliklar | Baholovchilar havzasini xilma-xillashtir va quyi guruh ta’sirlarini sinovdan o‘tkaz |
| Gallyutsinatsiyaga ishonish | Ishonch bilan aytilgan noto‘g‘ri ma’lumotni aniqlay olmaslik | Uydirma mazmunni valid deb ballash | Faktik o‘lchamlarda tashqi tekshiruvdan foydalan |
Bu jadval maqolaning muhim xabarlaridan birini ochib beradi: inson va LLM xatolari mustaqil bo‘lishi shart emas. Agar ikki tomon bir yo‘nalishda uzunlik, avtoritet yoki madaniy tarafkashlik ko‘rsatsa, ularni birlashtirish “ikki xil nazorat qatlami” yaratish o‘rniga bir xil og‘ishni kuchaytirishi mumkin.
STEP-V Doirasi Baholash Protokolini Qanday Tanlaydi?
STEP-V baholash dizaynini beshta kontekstual o‘zgaruvchi bo‘yicha tuzilmalashtiradi: noto‘g‘ri baholash oqibatlarining jiddiyligi, vazifaning yopiq/ochiq yakunli tuzilishi, mos baholovchilarning mavjudligi, baholash maqsadi va baholanadigan chiqish hajmi. Doira bitta universal protokolni tavsiya qilmaydi; kontekst o‘zgarganda inson, LLM va avtomatik usullarning rollari ham o‘zgarishi kerakligini ilgari suradi.
| O‘lcham | Ma’nosi | Dizaynga asosiy ta’siri |
|---|---|---|
| S — Stakes | Noto‘g‘ri baholashning real dunyodagi oqibatlari jiddiyligi | Xavf oshgani sari mutaxassislik, konservativ chegaralar va noaniqlikni boshqarish muhimlashadi |
| T — Task-type | Vazifa yopiq va tekshiriladigami yoki ochiq yakunli va subyektivmi | Tekshiriladigan vazifalar avtomatlashtirishga ko‘proq mos bo‘lishi mumkin; ochiq yakunli vazifalar ko‘proq inson hukmini talab qiladi |
| E — Evaluator availability | Mutaxassis, annotator, crowdworker, yakuniy foydalanuvchi yoki LLM baholovchilarining mavjudligi | Cheklangan mutaxassis vaqti namuna olish va escalation strategiyasini o‘zgartiradi |
| P — Purpose | Dastlabki ishlab chiqish, joriy etishdan oldingi validatsiya yoki ishlab chiqarishdan keyingi uzluksiz monitoring | Bir xil tizim hayot siklining turli bosqichlarida turli baholash protokollarini talab qilishi mumkin |
| V — Volume | Baholanadigan chiqishlar soni va chastotasi | Hajm oshgani sari avtomatlashtirish, statistik namuna olish va tanlab inson tekshiruvi kerak bo‘ladi |
Stakes: xato qanchalik jiddiy?
Past xavfli ilovalar, noto‘g‘ri baholash katta real dunyo zarariga olib kelishi kutilmaydigan ijodiy yozuv, marketing shiori yoki chatbot ohangini sozlash kabi vazifalarni qamrab oladi. Bu kontekstlarda avtomatik metrikalar, afzallik testlari yoki yengilroq inson baholashlari yetarli bo‘lishi mumkin.
O‘rta xavfli ilovalar, xato sababli mazmunli, ammo odatda kritik bo‘lmagan oqibatlar yuzaga kelishi mumkin bo‘lgan tashkilot ichidagi hujjatlarni qisqacha bayon qilish, umumiy ta’lim tushuntirishlari yoki inson ko‘rib chiqadigan dasturiy kod takliflari kabi vazifalardir. Gibrid baholash mazmunliroq bo‘ladi.
Yuqori xavfli ilovalar, tibbiy maslahat, klinik qarorlarni qo‘llab-quvvatlash, huquqiy tahlil, moliyaviy tavsiya yoki harbiy rejalashtirish kabi noto‘g‘ri baholash zarar, huquqiy javobgarlik yoki xavfsizlik xavfini keltirib chiqarishi mumkin bo‘lgan sohalardir. Maqola bu kontekstlarda soha mutaxassislarini, ko‘p o‘lchamli rubrikalarni, konservativ qaror chegaralarini va noaniqlik/kelishmovchilikni boshqarishni ustuvor qiladi; avtomatik usullarni qo‘llab-quvvatlovchi rolga joylashtiradi.
Task-type: vazifani tekshirish mumkinmi?
Yopiq yakunli vazifalarda aniq to‘g‘ri javob yoki tashqi tekshiruv qoidasi bo‘lishi mumkin. Tuzilmalashtirilgan ma’lumot ajratib olish, ma’lum yorliqli klassifikatsiya yoki unit testlardan o‘tishi kerak bo‘lgan kod kabi vazifalarda avtomatik nazorat kuchli rol o‘ynashi mumkin.
Ochiq yakunli vazifalarda esa bir nechta asosli javob bo‘lishi mumkin. Murakkab hujjat xulosasi, tibbiy maslahat tili, huquqiy mulohaza yoki strategik tavsiya kabi vazifalarda foydalilik, aniqlik va kontekstual moslik kabi konstruktlar tashqaridan to‘liq kuzatilmasligi mumkin.
Evaluator availability: to‘g‘ri baholovchi haqiqatan mavjudmi?
Tibbiyot, huquq yoki harbiy rejalashtirish kabi sohalarda eng mos mutaxassislar qimmat va vaqt jihatidan kamyob bo‘lishi mumkin. Shu sababli baholash dizayni nafaqat ideal baholovchi kimligini, balki amalda qancha mutaxassis vaqti mavjudligini ham hisobga olishi kerak.
Maqola mutaxassislar cheklangan holatlarda qat’iy annotatsiya kvotasi o‘rniga maqsad qilingan noaniqlikka qarab namuna hajmini rejalashtirishni; mutaxassis mehnatini xavfli, chegaraviy yoki katta kelishmovchilikli bandlarga yo‘naltirishni tavsiya qiladi.
Purpose: baholash hayot siklining qaysi bosqichida?
Dastlabki ishlab chiqish tezkor model taqqoslashiga va yaqqol xato rejimlarini topishga qaratiladi. Avtomatik metrikalar, kichik inson afzallik testlari yoki LLM-as-judge tizimlari tez yo‘naltiruvchi signal berishi mumkin.
Joriy etishdan oldingi validatsiya yuqoriroq dalil chegarasini talab qiladi. Tizim maqsad qilingan ishlash, xavfsizlik va ishonchlilik chegaralariga javob beradimi degan savolga tuzilmalashtirilgan inson baholashi, soha mezonlari va ishonchlilik hisobotlari bilan javob berish kerak.
Ishlab chiqarish monitoringi tizim foydalanishga kirgandan keyin ishlash siljishi, yangi xato rejimlari va foydalanuvchi o‘zaro ta’sirlaridagi o‘zgarishlarni kuzatadi. Katta hajmda avtomatik monitoring va anomaliyani aniqlash amalga oshirilishi mumkin; tanlangan yuqori xavfli yoki shubhali namunalar inson ko‘rib chiqishiga yo‘naltirilishi mumkin.
Volume: millionlab chiqishlar qanday baholanadi?
Past hajmli mutaxassis test to‘plamida har bir chiqish batafsil rubrikalar asosida bir nechta mutaxassis tomonidan ko‘rib chiqilishi mumkin. O‘rta hajmda namuna olish va qisman avtomatlashtirish birlashtirilishi mumkin. Millionlab chatbot o‘zaro ta’sirlari mavjud katta hajmli ishlab chiqarish muhitida esa har bir chiqishni bevosita inson bilan baholash mumkin emas; avtomatik skrining va statistik namuna olish orqali faqat xavfli yoki noodatiy namunalarni insonga yo‘naltirish kerak.
Manba 1-rasmning ilmiy xabari
Maqolaning 10-sahifasidagi STEP-V rasmi past, o‘rta va yuqori xavfli foydalanish darajalarini uchta alohida qaror panelida ko‘rsatadi. Har bir panel “asosiy maqsad”, “kim baholashi kerak?”, “maqbul usullar” va “qachon ekspert ko‘rib chiqishiga ko‘tarish kerak?” savollarini ishlab chiqish, joriy etish validatsiyasi va monitoring kontekstida birgalikda ko‘rib chiqadi.
Rasmning asosiy xabari shuki, xavf oshgani sari inson mutaxassisligi baholash zanjirining markaziga ko‘chadi. Past xavfli va katta hajmli ishlarda avtomatlashtirish ko‘proq qo‘llanishi mumkin, yuqori xavfli sohalarda esa avtomatik baholash inson mutaxassisi o‘rnini bosishdan ko‘ra dastlabki saralash yoki yordamchi vazifada qolishi kerak.
Yuqori Xavfli Ilovalarda LLM-as-Judge Inson Mutaxassisining O‘rnini Bosa Oladimi?
Maqola tavsiyasiga ko‘ra, umumiy holatda yo‘q. Yuqori xavfli ilovalarda LLM-as-judge tizimlari faqat maqsadli vazifada malakali mutaxassislar bilan taqqoslaganda nihoyatda kuchli va vazifaga xos dalil bera olsa, kengroq rol olishi mumkin; sukut bo‘yicha yondashuv mutaxassisni asosiy hakam, LLMni esa dastlabki skrining, quyi mezonlarni tekshirish yoki ko‘rib chiqishni ustuvorlashtirish vositasi sifatida ishlatishdir.
Expert-Guided Auto-Evaluation
Mutaxassislar tanqisligi bilan katta baholash hajmi o‘rtasidagi bo‘shliqni kamaytirish uchun maqola Expert-Guided Auto-Evaluation yondashuvini muhokama qiladi. Bu yerda mutaxassisning roli har bir chiqishni birma-bir yorliqlashdan qisman uzoqlashib, o‘lchash vositasini loyihalashga o‘tadi.
Mutaxassis vazifaga xos rubrikalarni, kritik quyi mezonlarni va baholash/tanqid promptlarini yaratadi. LLM asosidagi hakam tizimi bu tuzilmalashtirilgan o‘lchovni kattaroq chiqish hajmiga qo‘llaydi. Biroq LLM baholashi mutaxassis standartlari bilan kalibrlanishi kerak.
50–100 ta mutaxassis yorlig‘i tavsiyasi nimani anglatadi?
Maqola to‘liq ekspert nazorati xarajat tufayli mumkin bo‘lmagan ayrim yuqori xavfli holatlarda taxminan 50–100 ta mutaxassis tomonidan tasdiqlangan namuna kattaroq va arzonroq crowd-sourced yoki LLM-hakam ma’lumotlar to‘plamini kalibrlash uchun ishlatilishi mumkinligini namunaviy strategiya sifatida muhokama qiladi.
Bu son universal namuna hajmi qoidasi emas. Matn davomida namuna rejasini qat’iy kvotadan emas, qaror uchun maqbul noaniqlik darajasidan boshlash kerakligi ochiq ko‘rsatiladi.
Uchta amaliy misol
| Ilova | Xavf / vazifa tuzilishi | Tavsiya etilgan baholash yondashuvi |
|---|---|---|
| Tibbiy maslahat yordamchisi | Yuqori xavf, asosan ochiq yakunli, mutaxassis tanqisligi | Mutaxassis boshchiligidagi rubrik baholashi; avtomatik vositalar dastlabki skrining/triage uchun; noaniq yoki xavfli holatlarni mutaxassisga ko‘tarish |
| Iste’molchi yozuv yordamchisi | Past–o‘rta xavf, ochiq yakunli, baholovchilar mavjudligi yuqori | Juft afzallik, foydalanuvchi ballari va LLM-as-judge; xavfsizlik/siyosat o‘lchamlarida davriy ekspert nazorati |
| Korporativ retrieval asosidagi siyosat/muvofiqlik vositasi | O‘rta–yuqori xavf, qisman tekshiriladigan, katta hajm | Faktik muvofiqlik va citation to‘g‘riligi uchun avtomatik tekshiruvlar + insonga kalibrlangan LLM-as-judge + namunaviy inson nazorati |
STEP-V qaysi holatlarda muvaffaqiyatsiz bo‘lishi mumkin?
Muallif STEP-Vni baholash xatosiga qarshi kafolat sifatida taqdim etmaydi. Doira, ayniqsa, to‘rtta holatda muammoni hal qila olmasligi aytiladi: o‘lchanadigan konstrukt yomon ta’riflangan bo‘lsa, mavjud baholovchilarning barchasi bir xil tizimli tarafkashlikka ega bo‘lsa, yuqori xavfli vazifada minimal ekspert nazorati bo‘lmasa yoki mazmunli baholovchi kelishmovchiligi noto‘g‘ri tarzda bitta konsensus balliga qisqartirilsa.
Bunday holatda muammo protokol tanlashdan tashqariga chiqadi. STEP-V qaror maydonini tartibga solishi mumkin, ammo novalid konstrukt ta’rifini, yetarli bo‘lmagan baholovchilar havzasini yoki noaniqlikni yashiruvchi o‘lchash tizimini o‘z-o‘zidan tuzata olmaydi.
Metodologik tavsiyalar
Maqola inson markazidagi LLM baholashi uchun maqsadli mezonlarni aniq operatsion ta’riflardan boshlashni tavsiya qiladi. Ta’riflar, vakillik qiluvchi misollar va chegara holatlari qanday ko‘rib chiqilishi oldindan belgilanishi kerak.
Baholovchi tanlovi maqsadli konstrukt bilan asoslanishi kerak. Tartib ta’siri va boshqa ma’lum tarafkashliklarni kamaytirish uchun ko‘r qilish, randomizatsiya, kalibrlash va ish yukini boshqarish qo‘llanishi kerak. Tadqiqotlar faqat o‘rtacha ballni emas, balki ishonchlilik statistikasi va noaniqlik ma’lumotlarini ham hisobot qilishi kerak.
Avtomatik metrikalar va LLM asosidagi hakam modellari maqsadli vazifada inson hukmlari bilan kalibrlanmasdan sukut bo‘yicha valid deb qabul qilinmasligi kerak. Xavf darajasi oshgani sari LLM-as-judge tizimidan foydalanish uchun zarur dalil standarti ham oshishi kerak.
Psixometrik model tanlash
| Ma’lumot / protokol | Tavsiya etilgan model oilasi | Maqsad |
|---|---|---|
| Likert yoki ordinal rubrika ballari | Iyerarxik ordinal modellar | Latent sifatni baholovchi qat’iyligi, band qiyinligi va noaniqlik bilan birga modellashtirish |
| Ko‘p baholovchili tuzilmalashtirilgan baholash | Many-facet Rasch modellari | Model ishlashini baholovchi qat’iyligi va band qiyinligidan ajratish |
| Juft taqqoslash | Bradley–Terry yoki tegishli Thurstone modellari | Nisbiy sifatni juft afzallik ma’lumotlaridan baholash |
| Hech bir baholovchi xatosiz deb qabul qilinmaydigan muhit | Latent-class / imperfect-gold-standard modellari | Oddiy ko‘pchilik ovozi o‘rniga baholovchi xatosini ochiq modellashtirish |
Minimal hisobot standarti
Muallif baholash tadqiqotlarida kamida baholovchilarni yollash, tayyorlash, vazifa ko‘rsatmalari, shkala shakli, baholash sessiyasi davomiyligi, adjudication qoidalari, ishonchlilik statistikasi va noaniqlik hisobotlari ko‘rinadigan bo‘lishi kerakligini ta’kidlaydi.
Namuna rubrikalar, kalibrlash promptlari, audit checklistlari va tahlil shablonlarini ulashish ham takrorlanuvchanlikni kuchaytirishi mumkin. Manbaning Supplementary Materials to‘plamida shu maqsadlar uchun tayyorlangan beshta qo‘shimcha fayl mavjud.
Tadqiqot qo‘llab-quvvatlaydigan va qo‘llab-quvvatlamaydigan xulosalar
| Tadqiqot qo‘llab-quvvatlaydi | Tadqiqot qo‘llab-quvvatlamaydi |
|---|---|
| Inson baholashi o‘z ishonchlilik, validlik va tarafkashlik muammolariga ega o‘lchash tizimi sifatida loyihalanishi kerak. | Inson baholashi har qanday holatda LLM-as-judgedan to‘g‘riroq ekanligi eksperimental ravishda isbotlangan. |
| LLM-as-judge validligi vazifa, konstrukt va baholovchilar hamjamiyatiga bog‘liq. | Muayyan hakam modelini barcha vazifalarda ishlatish kerak. |
| Inson–LLM gibrid baholashi ayrim holatlarda masshtab va kontekstual sifatni birlashtira oladi. | Gibrid tizimlar avtomatik ravishda tarafkashlikni kamaytiradi. |
| Kelishmovchilik subyektiv yoki madaniy vazifalarda mazmunli nuqtai nazar farqini ifodalashi mumkin. | Barcha kelishmovchiliklar qabul qilinishi kerak; xavfsizlik-kritik bandlarda adjudication kerak emas. |
| STEP-V baholash usulini tanlashni tizimlashtiruvchi dizayn yordamidir. | STEP-V eksperimental tasdiqlangan, xato darajasi ma’lum yoki yagona to‘g‘ri protokolni avtomatik hisoblaydigan modeldir. |
| Yuqori xavfda ekspert nazorati va noaniqlikni boshqarish ustuvor bo‘lishi kerak. | Kalibrlanmagan LLM-as-judge tizimlari tibbiyot, huquq, moliya yoki harbiy foydalanishda mutaxassislar o‘rnini bosa oladi. |
Cheklovlar va kelajakdagi tadqiqot
Maqolaning eng muhim cheklovi shundaki, STEP-V ham, umumiy xato rejimlari taksonomiyasi ham konseptual xususiyatga ega. Muallif ushbu tuzilmalar real baholash dizaynini yaxshilaydimi-yo‘qmi, tarafkashlik va kelishmovchilikni qay darajada bashorat qilishi hamda gibrid tizim ishlashi haqidagi farazlar prospektiv tadqiqotlar bilan sinovdan o‘tkazilishi kerakligini bildiradi.
LLM baholash sohasining juda tez o‘zgarishi sharhlarning qisqa muddatda eskirib qolish xavfini ham oshiradi. Kelajakdagi tadqiqotlarda baholovchilarning vaqt o‘tishi bilan LLMlarga ko‘nikishi, madaniyatlararo o‘lchash invariantligi, baholovchi ta’sirlarini psixometrik modellashtirish, kelishmovchilik-aware pipelinelar, namuna va quvvatni rejalashtirish hamda cheklangan ekspert vaqtini noaniqlik bo‘yicha taqsimlashga e’tibor qaratish tavsiya etiladi.
Maqola, shuningdek, STEP-V kelajakda yarim miqdoriy qaror vositasiga aylantirilishi mumkinligini muhokama qiladi. Besh o‘lchamga ordinal darajalar berish va ularni validlik xavfi, baholovchilararo ishonchlilik xavfi, umumiy tarafkashlikning kuchayishi, xarajat va escalation yuki kabi chiqishlar bilan bog‘lash mumkin. Biroq manba bu miqdoriy xaritalashni hali amalga oshirmagan; mavjud STEP-Vdan miqdoriy ishlash bashoratchisi sifatida foydalanish tadqiqot tomonidan qo‘llab-quvvatlanmaydi.
Manba va Usul Haqida Izoh
| Asl sarlavha | Human Evaluation of Large Language Models: A Review and Protocol Selection Framework |
|---|---|
| Muallif | Tad T. Brunyé |
| Muassasa 1 | Center for Applied Brain and Cognitive Sciences, Tufts University, Medford, Massachusetts, USA |
| Muassasa 2 | U.S. Army DEVCOM Soldier Center, Natick, Massachusetts, USA |
| DOI | 10.3390/ai7050174 |
| Jurnal | AI |
| Nashriyot | MDPI, Basel, Switzerland |
| ISSN | 2673-2688 |
| Jild / son | 7 / 5 |
| Maqola raqami | 174 |
| Manba turi | Review |
| Qabul qilingan sana | 7 aprel 2026 |
| Reviziya | 30 aprel 2026 |
| Qabul | 14 may 2026 |
| Nashr | 19 may 2026 |
| Taqriz | Taqrizli jurnal nashri |
| Litsenziya | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Moliyalashtirish | U.S. Army DEVCOM Soldier Center, Augmented Decisions via Intelligent Systems Recommendations (ADVISR) dasturi, BC1/3D |
| Institutional Review Board | Qo‘llanilmaydi |
| Axborotli rozilik | Qo‘llanilmaydi |
| Ma’lumotlarning mavjudligi | Qo‘llanilmaydi |
| Manfaatlar to‘qnashuvi | Muallif manfaatlar to‘qnashuvi yo‘qligini bildirgan. |
| Supplementary Materials | File S1–S5 mavjud |
Supplementary Materials mazmuni: File S1 Illustrative Scoring Rubrics; File S2 Example Calibration Prompts; File S3 Example Reporting Template; File S4 Example Audit Checklist; File S5 STEP-V Illustrative Configurations.
Moliyalashtirish va institutsional fikr chegarasi: Tadqiqot U.S. Army DEVCOM Soldier Center tarkibidagi ADVISR dasturi tomonidan qo‘llab-quvvatlangan. Maqolada fikrlar va da’volar muallifning shaxsiy qarashlari ekani hamda United States Army yoki tegishli davlat idoralarining rasmiy siyosati yoki fikrini ifodalamasligi aniq ko‘rsatilgan.
Muallif hissalari: Manba bitta muallifga ega va alohida CRediT hissa jadvalini hisobot qilmaydi. Manbada yo‘q hissa rollari Verianla tomonidan chiqarib olinmagan.
Sharh usuli chegarasi: Maqola keng adabiyot sintezini amalga oshiradi, biroq tizimli qidiruv qatori, PRISMA oqimi, tadqiqot tanlash sonlari yoki meta-tahliliy sintezni hisobot qilmaydi. Shu sababli u “tizimli sharh” sifatida tasniflanmagan.
STEP-V validatsiyasi chegarasi: STEP-V va xato rejimlari taksonomiyasi konseptual doiralardir. Manba ularni kelajakda prospektiv tarzda sinovdan o‘tkazish kerakligini bildiradi; doiralarga tegishli to‘g‘rilik darajasi, sezgirlik, spetsifiklik, ishonch oralig‘i yoki eksperimental muvaffaqiyat balli hisobot qilinmagan.
Vizual manba izohi: 10-sahifadagi original STEP-V rasmi past, o‘rta va yuqori xavfli ilovalarda baholovchi tanlovi, ishlab chiqish/validatsiya/monitoring usullari va escalation mantiqini ko‘rsatadigan qaror yordamchisidir. Verianla uchun qayta chizilsa, piksel nusxasi o‘rniga ayni ilmiy munosabatlarni saqlaydigan original qaror oqimidan foydalanish kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan