

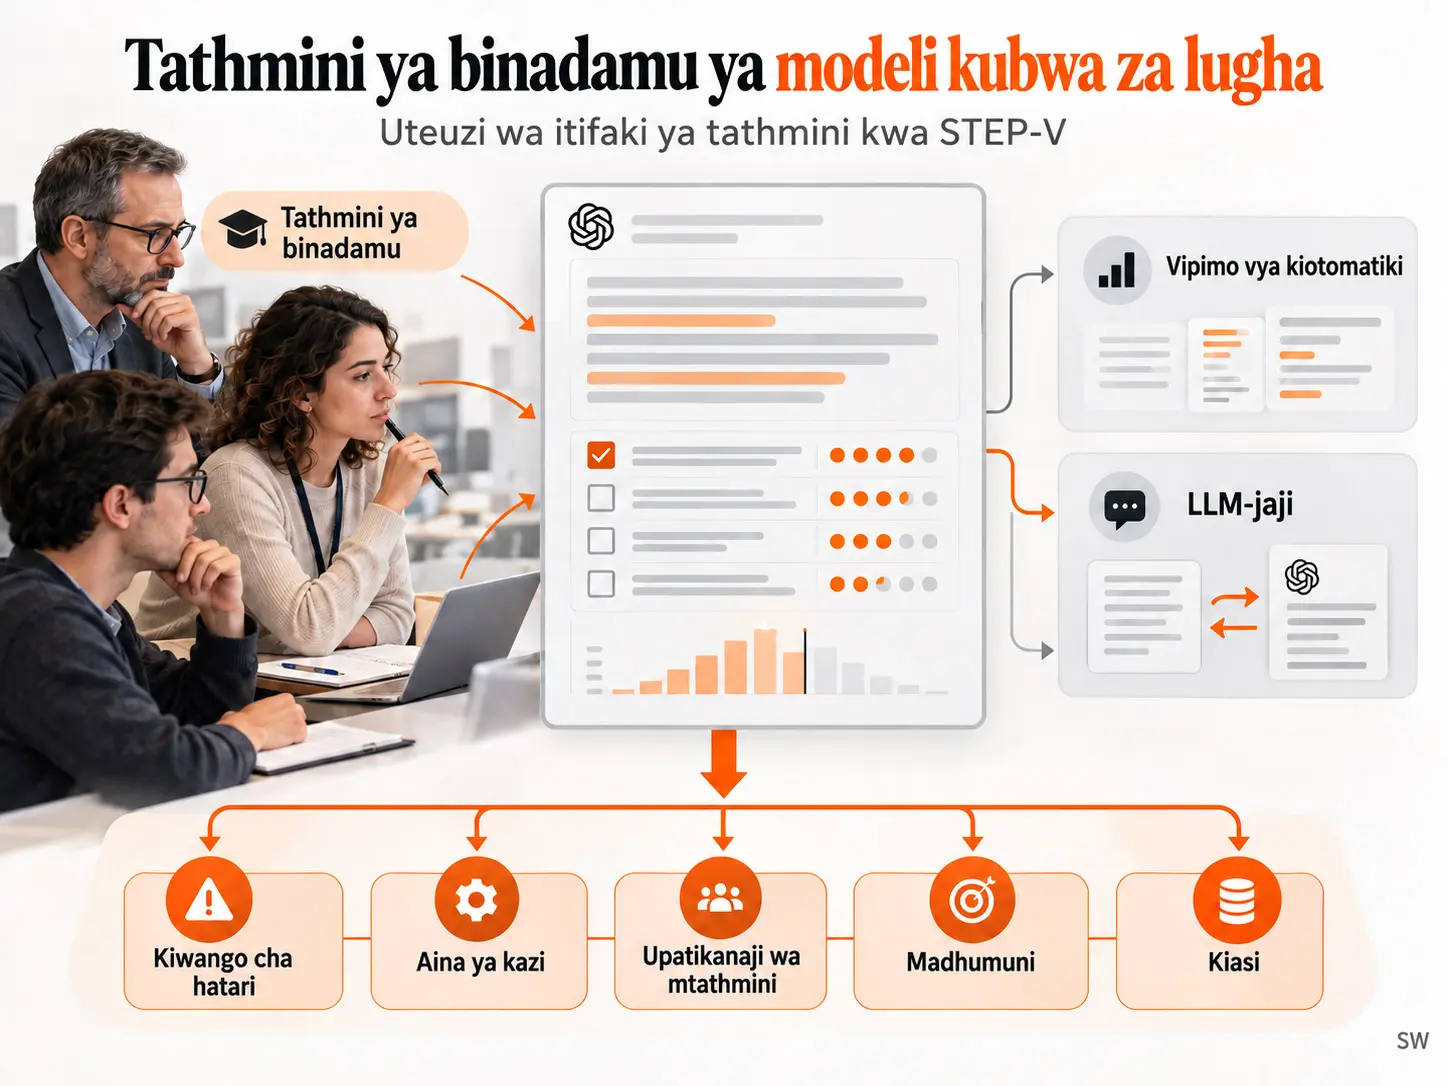
Tathmini ya LLM Inayomweka Binadamu Katikati, ni mkabala wa tathmini unaowezesha matokeo ya modeli kubwa za lugha kupimwa si kwa vipimo otomatiki pekee, bali pia kwa hukumu za binadamu zinazofaa kutathmini kazi mahususi, kigezo cha ubora na muktadha wa matumizi. Mapitio haya hayaichukulii tathmini ya binadamu kama “chanzo cha jibu sahihi” kisicho na dosari, bali kama miundombinu ya upimaji yenye uaminifu, uhalali, upendeleo, mipaka ya kiutambuzi na kutokuwa na uhakika kwake yenyewe. Makala haiwasilishi matokeo ya jaribio jipya la LLM; inaunganisha tafiti katika mbinu za tathmini, saikometria, sayansi ya utambuzi, mambo ya kibinadamu na matumizi mahususi ya LLM kwa nyanja tofauti ili kuunda mfumo wa kimawazo kuhusu jinsi itifaki ya tathmini inavyopaswa kuchaguliwa.
Mwandishi anaelekeza umakini kwenye matatizo manne ya msingi: kuchukulia lebo za binadamu kama kiwango cha dhahabu kisicho na dosari, uchovu wa mtathmini na mzigo mkubwa kupita kiasi wa kiutambuzi, miundo ya upendeleo inayofanana au kutofautiana kati ya binadamu na modeli za majaji zinazotumia LLM, pamoja na kupuuzwa mara nyingi kwa kutokuwa na uhakika na taarifa za usambazaji katika matokeo ya tathmini. Ili kushughulikia matatizo haya kwa utaratibu, mfumo wa STEP-V unapendekezwa. STEP-V unajumuisha vipimo vya Stakes, Task-type, Evaluator availability, Purpose na Volume na hutoa msaada wa uamuzi kuhusu jinsi mchanganyiko wa binadamu, vipimo otomatiki na LLM-as-judge unavyoweza kuchaguliwa katika hali halisi za matumizi.
Mchango wa pili wa kipekee wa makala ni taksonomia ya pamoja ya aina za makosa inayochunguza watathmini wa binadamu na mifumo ya LLM-as-judge ndani ya mfumo mmoja wa makosa. Baadhi ya matatizo kama athari za mpangilio, upendeleo kwa majibu marefu, athari ya mamlaka, kujiamini kupita kiasi, uchovu, hali ya kutegemea maoni binafsi, upungufu wa maarifa, upendeleo wa kitamaduni na kuamini taarifa potofu yanaweza kuonekana kwa namna tofauti kwa binadamu na kwa watathmini wa LLM. Kwa hiyo, haiwezi kudhaniwa moja kwa moja kwamba mifumo mseto inayounganisha watathmini wa binadamu na wa kiakili-bandia ni ya kuaminika zaidi; ikiwa pande zote mbili zinaelekea kufanya aina ileile ya kosa, kosa linaweza kuimarika badala ya kupungua.
Kikomo kikuu cha ufasiri wa utafiti ni hiki: STEP-V na taksonomia ya pamoja ya aina za makosa bado si modeli za kiasi za utendaji zilizothibitishwa kwa majaribio tarajiwa. Mwandishi anaziwasilisha kama mifumo ya kimawazo ya kupanga muundo wa tathmini na anaeleza wazi kwamba iwapo zinaongeza ubora halisi wa tathmini au la, jambo hilo linahitaji kujaribiwa kwa njia ya kiempiria katika siku zijazo.
Kwa Nini Hukumu ya Binadamu Bado Inahitajika katika Tathmini ya LLM?
Hukumu ya binadamu inahitajika hasa katika kazi zilizo wazi, zinazotegemea muktadha, zinazohitaji utaalamu au zinazojumuisha vigezo vya kijamii na kikanuni; kwa sababu ufanano wa maneno au alama otomatiki peke yake hauwezi kupima kwa kuaminika ikiwa jibu ni salama kitabibu, linaweza kutetewa kisheria, linafaa kielimu, linafaa kijamii au lina manufaa kwa mtumiaji halisi.
Katika mifumo ya awali ya uchakataji wa lugha asilia, kazi zilikuwa finyu zaidi, nafasi ya matokeo sahihi ilikuwa na mipaka zaidi na ulinganisho na majibu rejea ulikuwa rahisi zaidi kutekeleza. LLM za sasa, kwa upande mwingine, huzalisha matokeo yaliyo wazi sana kuanzia ushauri wa kitabibu hadi uchanganuzi wa kisheria, kutoka ufundishaji hadi upangaji na uandishi bunifu. Katika hali kama hizi, kunaweza kuwa na zaidi ya jibu moja zuri kwa swali lilelile, na majibu mawili yanayofanana kijuujuu yanaweza kutofautiana kabisa kwa usalama au usahihi.
Kwa hiyo, makala haipunguzi tathmini kuwa swali la “je, modeli ilitoa jibu sahihi?” pekee. Tatizo kuu la upimaji linajumuisha kwa pamoja: nini kinachopimwa, nani anayepima, itifaki gani inayotumika, skeli ya tathmini imefafanuliwaje, mtathmini ana utaalamu kiasi gani, amechoka kiasi gani na matokeo yanaunganishwaje chini ya dhana zipi za kitakwimu.
Tathmini ya binadamu yenyewe pia ni mfumo wa upimaji
Tathmini ya binadamu inaweza kuwa halali au batili; ya kuaminika au isiyoaminika; iliyokalibishwa vizuri au iliyokalibishwa vibaya. Kwa hiyo, kukubali lebo ya binadamu moja kwa moja kama “ground truth” haitoshi kimetodolojia.
Mkabala wa kisaikometria wa makala unakuwa muhimu hapa. uaminifuwa kipimo unaeleza jinsi kinavyokuwa thabiti kati ya watathmini tofauti, vipengee au nyakati; uhalali wake unaeleza iwapo kweli kinapima dhana iliyokusudiwa kupimwa. Tathmini inaweza kuwa na uthabiti wa juu lakini bado ikawa inapima kitu kisicho sahihi.
Kwa mfano, watathmini wakipendelea majibu marefu kwa utaratibu wanaweza kutoa matokeo thabiti sana; lakini ikiwa kigezo lengwa ni usahihi, urefu wa jibu huenda usiwe kiashiria halisi cha ubora. Vilevile, kuridhika kwa mtumiaji wa mwisho kunaweza kuwa kigezo halali cha “manufaa yanayotambuliwa” bila kuwa lazima kipimo halali cha usahihi wa ukweli.
Taksonomia ya tathmini ya LLM yenye tabaka tatu
| Tabaka | Mtathmini / chombo | Faida kuu | Kikomo kikuu |
|---|---|---|---|
| Tabaka 1 | Vipimo otomatiki vyenye rejea au visivyo na rejea | Gharama ya chini, urudiwaji wa juu na marudio ya haraka | Katika kazi zilizo wazi vinaweza kupima kwa upungufu dhana kama usahihi, ubora wa hoja, manufaa au ufaafu wa kimaadili |
| Tabaka 2 | Mifumo ya LLM-as-judge | Uwezo mkubwa zaidi wa kupanuliwa kuliko binadamu na unyeti mkubwa zaidi kwa muktadha kuliko vipimo vya kawaida | Uhalali hutegemea kazi, lugha, sifa inayopimwa na kundi lengwa la binadamu; hauwezi kudhaniwa kuwa halali kwa chaguomsingi |
| Tabaka 3 | Tathmini ya moja kwa moja ya binadamu | Uwezo wa kutathmini muktadha, utaalamu, ufaafu wa kijamii, usalama na majibu mengi halali | Gharama, uwezo wa kupanuliwa, uchovu, utofauti na upendeleo wa kiutambuzi |
Tabaka 1: Vipimo otomatiki
Vipimo vya kawaida kama BLEU, ROUGE na METEOR hulinganisha maandishi yaliyotolewa na majibu rejea kwa ufanano wa kijuujuu au wa kimuundo. Vipimo vipya zaidi vya kisemantiki kama BERTScore hujaribu kutathmini ufanano wa maana katika nafasi ya embedding. Zana zisizo na rejea kama Perplexity au vipimo vya faithfulness katika baadhi ya miktadha ya retrieval-augmented generation pia hulenga kutoa ishara ya ubora bila kuhitaji jibu moja la dhahabu.
Umuhimu wa zana hizi haupaswi kupuuzwa; zinatoa tathmini ya haraka, ya bei nafuu na inayoweza kuzalishwa tena. Hata hivyo, msisitizo wa makala ni kwamba zina maana kwa kiwango cha dhana inayoweza kupimwa nazo tu. Maandishi yanaweza kufanana na jibu rejea lakini yakawa si sahihi au si salama katika ulimwengu halisi; maandishi mengine yanaweza kutofanana sana na rejea lakini yakawa sahihi na yenye manufaa.
Tabaka 2: LLM-as-judge
LLM-as-judgeni matumizi ya modeli ya lugha kama mtathmini wa kuipa alama, kuipanga au kuchagua kati ya majibu mawili ya modeli nyingine. Makala inasisitiza kwamba mkabala huu unaweza kuwa muhimu hasa katika kazi zenye vigezo vilivyo wazi, zinazotegemea rubriki au kulinganisha kwa jozi; lakini utendaji unaweza kubadilika kwa kiasi kikubwa kulingana na aina ya kazi, sifa inayopimwa, lugha na kiwango cha utaalamu cha watathmini wa binadamu wanaotumika kwa ulinganisho.
Hitimisho kuu linalotokana na hili ni kwamba mfumo wa LLM-as-judge si mtathmini wa ulimwengu wote wa aina ya plug-and-play. Uhalali wa modeli ya jaji ni wa eneo husika: lazima ukalibishwe na ujaribiwe dhidi ya kazi lengwa, dhana lengwa na jamii lengwa ya watathmini wa binadamu.
Tabaka 3: Tathmini ya moja kwa moja ya binadamu
Tathmini ya moja kwa moja ya binadamu hutoa unyumbufu mkubwa katika sifa ambazo ni vigumu kurasimisha, kama uwezo wa kushawishi, ufaafu, thamani ya kielimu, madhara yanayoweza kutokea, umahiri mahususi wa nyanja na ulinganifu wa kimuktadha.
Hata hivyo, “tathmini ya binadamu” si mbinu moja. Daktari kutathmini jibu la kliniki, mtaalamu wa sheria kukagua uchanganuzi wa kisheria, mtumiaji wa mwisho kuripoti kuridhika na crowdworker kulinganisha majibu mawili ya chatbot ni vitendo tofauti vya upimaji. Kuvichukulia kuwa sawa kunaweza kudhoofisha uhalali wa tathmini.
Inaamuliwaje Ni Nani Anayepaswa Kutathmini Matokeo ya LLM?
Uchaguzi wa mtathmini unapaswa kufanywa kulingana na kiwango ambacho dhana inayopimwa inahitaji maarifa ya kitaalamu, uzoefu wa kuishi au uzoefu wa muktadha. Katika kazi zenye hatari kubwa na zinazohitaji utaalamu, wataalamu wa nyanja wanaweza kutoa uhalali imara zaidi wa dhana, wakati kwa dhana kama kuridhika kwa mtumiaji au urahisi wa matumizi ya kila siku, watumiaji halisi wa mwisho wanaweza kuwa watathmini halali zaidi.
| Mtathmini | Uhalali katika kazi za kitaalamu | Uaminifu | Gharama | Uwezo wa kupanuliwa | Matumizi yanayofaa zaidi |
|---|---|---|---|---|---|
| Wataalamu wa nyanja | Juu sana | Wastani | Juu sana | Chini | Kazi zenye hatari kubwa na zinazohitaji utaalamu kama tiba, sheria, nyanja za kijeshi na fedha |
| Wawekaji alama waliofunzwa | Wastani | Wastani | Wastani | Wastani | Tathmini ya ubora wa jumla kwa rubriki na kalibresheni |
| Crowdworker | Chini–wastani | Chini–wastani | Chini | Juu sana | Ufasaha, umuhimu, uelewekaji wa msingi na uwekaji alama wa kiwango kikubwa wenye hatari ndogo |
| Watumiaji wa mwisho | Uhalali wa kiikolojia wa juu | Chini | Chini | Wastani | Kuridhika, urahisi wa matumizi na manufaa katika muktadha halisi wa matumizi |
Makala hasa inakumbusha kwamba wataalamu wanaweza kutofautiana kwa maoni. Kutofikia hitimisho moja kwa wataalamu si kushindwa kwa tathmini moja kwa moja; kunaweza kuwa ishara kwamba dhana changamano ya kliniki, kisheria au kijamii kwa kweli ina kutokuwa na uhakika.
Nini kinatathminiwa?
Moja ya hatua za kwanza za kubuni tathmini ni kufafanua kwa uwazi dhana lengwa. Badala ya neno moja lisiloeleweka kama “ubora”, inapaswa kubainishwa dhana inayoweza kupimwa kama usahihi, manufaa, upendeleo, uaminifu, usomekaji, usalama, ufaafu wa kimuktadha au dhana nyingine.
Usahihi wa ukweli, usahihi wa nukuu na ufuataji wa kanuni za muundo mara nyingi vinaweza kuthibitishwa kutoka nje. Ubunifu, adabu au mvuto wa mwingiliano hutegemea zaidi tafsiri ya binadamu na kanuni za kijamii. Kwa vigezo kama ufaafu wa kliniki, uthabiti wa kisheria au ufuataji wa kanuni, watathmini wa jumla huenda wasiwe na utaalamu wa kutosha.
Tathmini inaweza kufanywa kwa itifaki gani?
- Upimaji wa aina ya Likert: Jibu hupewa, kwa mfano, alama kati ya 1–5. Hutoa upangaji wa kina lakini ni nyeti kwa tafsiri ya skeli na athari za anchoring.
- Uamuzi wa jozi mbili: Huchaguliwa moja ya madaraja mawili kama inakubalika / haikubaliki au sahihi / si sahihi. Inaweza kuongeza makubaliano katika tofauti zilizo wazi lakini inaweza kupoteza nuances.
- Ulinganisho wa jozi: Matokeo mawili hutathminiwa sambamba na huchaguliwa lipi ni bora kulingana na kigezo maalum. Inaweza kuwa muhimu kwa watathmini wanaopata ugumu kutoa alama kamili.
- Tathmini inayotegemea rubriki: Matokeo hupewa alama katika vipimo vidogo kadhaa vilivyo wazi, kwa kutumia vigezo vilivyofafanuliwa awali au mifano ya anchor. Inaweza kugawa hukumu jumla isiyo wazi kuwa sehemu zinazoweza kuonekana zaidi.
Itifaki haibainishi tu aina ya alama; pia hubainisha muundo wa kitakwimu wa data itakayopatikana, mzigo wa kiutambuzi na vyanzo vinavyowezekana vya makosa. Vigezo vingi sana kwa wakati mmoja, vipindi virefu vya tathmini au lebo za skeli ambazo hazijafafanuliwa vizuri zinaweza kupunguza uaminifu.
Je, Kutokubaliana kwa Maoni Kati ya Binadamu Daima ni Kosa?
Hapana. Katika kazi zilizo wazi, za kimtazamo au zinazobadilika kitamaduni, kutokubaliana kwa maoni kunaweza kuwakilisha tofauti halisi na zenye maana za mitazamo; kwa upande mwingine, katika masuala yenye hatari kubwa yanayoweza kuthibitishwa kutoka nje kama contraindication ya dawa au nukuu ya kisheria isiyo sahihi, kutokubaliana kwa kiwango kikubwa kunapaswa kutathminiwa kama ishara ya onyo inayohitaji ukaguzi mkali zaidi wa kitaalamu.
Upimaji wa uaminifu
Makala inaeleza kwamba kuna vipimo vya uaminifu kati ya watathmini kama Cohen's kappa, Krippendorff's alpha na intraclass correlation coefficient; lakini katika tafiti za tathmini ya LLM mara nyingi haviripotiwi vya kutosha au hutolewa bila muktadha.
Alama moja ya wastani inaweza kuficha kutokubaliana kwa kiwango kikubwa. Kwa hiyo, makubaliano ya chini hayapaswi kutupiliwa mbali moja kwa moja kama “kelele ya annotator”; yanaweza kuashiria kigezo kisicho wazi, dhana iliyochanganyika au mzigo mkubwa kupita kiasi wa kiutambuzi kwa mtathmini.
Tathmini ya usambazaji
Katika kazi za kimtazamo, inawezekana kuhifadhi usambazaji wa tathmini badala ya kuangalia maoni ya wastani pekee. Makala inajadili kwamba vipimo vya umbali wa usambazaji kama Kullback–Leibler divergence na Earth Mover's Distance vinaweza kutumiwa kuchunguza jinsi hukumu za modeli zinavyofanana si tu na wastani wa binadamu bali pia na mtawanyiko wa maoni ya binadamu.
Lengo hapa si kuondoa kutokubaliana kote. Makundi tofauti ya watu yanaweza kuwa na mitazamo tofauti lakini halali. Hata hivyo, mgawanyiko mkubwa wa vikundi vidogo au kutokuwa na uhakika katika vipengee vya hatari kubwa kunaweza kuonyesha hitaji la uangalizi lengwa na adjudication ya mtaalamu.
Tatizo la kiwango cha dhahabu kisicho kamili
Lebo ya binadamu huchukuliwa katika tathmini nyingi za LLM kama rejea ya mwisho isiyopingika. Makala, ikitegemea fasihi ya saikometria na takwimu za uchunguzi, inasisitiza kwamba hii si halali kila wakati. Watathmini wa binadamu pia wanaweza kufanya makosa, kutoa alama kwa ukali tofauti au kutafsiri dhana kwa namna tofauti.
Kwa hiyo, ili kwenda zaidi ya wastani rahisi wa alama, mikabala ya upimaji kama modeli za many-facet Rasch, modeli za ordinal za kihierarkia, modeli za ulinganisho wa jozi aina ya Bradley–Terry na, inapohitajika, modeli za imperfect-gold-standard au latent-class zinajadiliwa. Makala haitumii modeli hizi kwenye data yake yenyewe; inaziwasilisha kama chaguo za kimetodolojia kwa muundo wa tathmini ya LLM unaoweza kutetewa zaidi.
Mbinu na Matokeo ya Utafiti
Mkabala wa kisayansi wa mapitio
Utafiti huu si utafiti wa kiempiria unaofanya jaribio kwenye seti mpya ya data ya LLM. Mwandishi anaunganisha fasihi kuhusu mbinu za tathmini ya LLM, tathmini ya binadamu, saikometria, sayansi ya utambuzi, tafiti za uwekaji alama, tafiti za LLM-as-judge na nyanja za matumizi kama afya, sheria, fedha, kijeshi, elimu na usalama ili kuunda mantiki ya pamoja ya kubuni tathmini.
Chanzo hakiripoti hoja ya utafutaji wa kimfumo, mtiririko wa uteuzi wa PRISMA, meta-uchanganuzi au upimaji wa kiasi wa ubora wa tafiti. Kwa hiyo, “matokeo” yaliyopatikana ni zaidi ya hitimisho za kimawazo, mapendekezo ya mbinu na kanuni za muundo zilizotengenezwa kupitia usanisi wa fasihi kuliko athari mpya za majaribio.
Taksonomia ya pamoja ya aina za makosa ya watathmini wa binadamu na LLM
| Aina ya kosa | Jinsi linavyoonekana kwa binadamu | Jinsi linavyoonekana kwa LLM-as-judge | Mwitikio wa muundo unaopendekezwa |
|---|---|---|---|
| Athari za mpangilio | Kupa uzito kipengee cha kwanza/mwisho, anchoring | Upendeleo wa nafasi | Badilisha mpangilio kwa nasibu na fanya uwasilishaji usifichue utambulisho |
| Upendeleo wa urefu | Kuona jibu refu zaidi kuwa bora | Kupendelea urefu badala ya maudhui | Dhibiti urefu au tathmini ufupi kando |
| Upendeleo wa mamlaka | Kuamini kupita kiasi chanzo chenye hadhi au toni | Kupendelea matokeo yanayoonekana kuwa na mamlaka | Ikiwezekana, ondoa vidokezo vya chanzo/utambulisho |
| Ulinganifu wa kijamii | Kuelekea kwa watathmini waliotangulia | Kuimarisha ishara zilizotolewa awali | Waweke watathmini huru na zuia kuvuja kwa alama |
| Kujiamini kupita kiasi | Uhakika mkubwa kupita kiasi katika alama | Uhakika mkubwa kupita kiasi katika uamuzi | Omba taarifa ya sababu au kiwango cha kujiamini |
| Uchovu na mzigo kupita kiasi | Kupungua kwa umakini ndani ya kipindi na kati ya vipindi | Kushuka kwa utendaji chini ya muktadha mrefu, kazi changamano au inferensi inayorudiwa | Punguza muda wa kipindi na fanya udhibiti wa drift katika mlolongo |
| Kushindwa kwa tathmini ya kimtazamo | Makubaliano ya chini kati ya watathmini katika hukumu za ubunifu au kitamaduni | Ulinganifu dhaifu na binadamu katika kazi za kimtazamo | Tumia watathmini wengi, hifadhi kutokubaliana na chunguza ishara ndani ya kelele |
| Mapengo ya maarifa | Kushindwa kutambua kosa linalohitaji utaalamu | Hoja dhaifu mahususi kwa nyanja | Linganisha utaalamu wa mtathmini na kazi |
| Upendeleo wa kitamaduni | Asili ya kidemografia au kitamaduni kuathiri alama | Upendeleo uliobebwa kutoka data ya mafunzo | Panua utofauti wa kundi la watathmini na jaribu athari za vikundi vidogo |
| Kuamini halusinesheni | Kushindwa kutambua taarifa potofu iliyotolewa kwa kujiamini | Kutoa alama halali kwa maudhui yaliyobuniwa | Tumia uthibitishaji wa nje katika vipimo vya ukweli |
Jedwali hili linaweka wazi mojawapo ya ujumbe muhimu wa makala: makosa ya binadamu na ya LLM si lazima yawe huru. Ikiwa pande zote mbili zinaonyesha upendeleo wa urefu, mamlaka au utamaduni katika mwelekeo mmoja, kuyachanganya kunaweza kuimarisha upotovu uleule badala ya kuunda “tabaka mbili tofauti za udhibiti”.
Mfumo wa STEP-V Unachaguaje Itifaki ya Tathmini?
STEP-V hupanga muundo wa tathmini kulingana na vigezo vitano vya kimuktadha: uzito wa matokeo ya tathmini isiyo sahihi, muundo wa kazi uliofungwa/wazi, upatikanaji wa watathmini wanaofaa, madhumuni ya tathmini na kiasi cha matokeo yatakayotathminiwa. Mfumo haupendekezi itifaki moja ya ulimwengu wote; unasema kwamba kadiri muktadha unavyobadilika, majukumu ya binadamu, LLM na mbinu otomatiki yanapaswa pia kubadilika.
| Kipimo | Maana | Athari kuu kwa muundo |
|---|---|---|
| S — Stakes | Uzito wa matokeo ya tathmini isiyo sahihi katika ulimwengu halisi | Kadiri hatari inavyoongezeka, utaalamu, vizingiti vya tahadhari na usimamizi wa kutokuwa na uhakika vinakuwa muhimu zaidi |
| T — Task-type | Iwapo kazi imefungwa na inaweza kuthibitishwa, au iko wazi na ni ya kimtazamo | Kazi zinazoweza kuthibitishwa zinaweza kufaa zaidi kwa otomatiki; kazi zilizo wazi zinahitaji hukumu zaidi ya binadamu |
| E — Evaluator availability | Upatikanaji wa mtaalamu, annotator, crowdworker, mtumiaji wa mwisho au mtathmini wa LLM | Uhaba wa muda wa mtaalamu hubadilisha mkakati wa sampuli na escalation |
| P — Purpose | Maendeleo ya awali, uthibitishaji kabla ya kupelekwa au ufuatiliaji endelevu baada ya uzalishaji | Mfumo uleule unaweza kuhitaji itifaki tofauti za tathmini katika hatua tofauti za mzunguko wa maisha |
| V — Volume | Idadi na marudio ya matokeo yatakayotathminiwa | Kadiri kiasi kinavyoongezeka, otomatiki, sampuli za kitakwimu na ukaguzi teule wa binadamu vinahitajika |
Stakes: kosa ni kubwa kiasi gani?
Matumizi yenye hatari ndogo, yanajumuisha kazi kama uandishi bunifu, kauli mbiu ya masoko au kurekebisha toni ya chatbot, ambako tathmini isiyo sahihi haitarajiwi kusababisha madhara makubwa katika ulimwengu halisi. Katika miktadha hii, vipimo otomatiki, majaribio ya mapendeleo au tathmini nyepesi za binadamu zinaweza kutosha.
Matumizi yenye hatari ya kati, ni kazi kama kufupisha hati za ndani za biashara, maelezo ya jumla ya elimu au mapendekezo ya msimbo wa programu yanayopitiwa na binadamu, ambako kosa linaweza kusababisha matokeo yenye maana lakini kwa kawaida yasiyo makubwa sana. Tathmini mseto huwa na maana zaidi.
Matumizi yenye hatari kubwa, ni maeneo kama ushauri wa kitabibu, usaidizi wa maamuzi ya kliniki, uchanganuzi wa kisheria, pendekezo la kifedha au upangaji wa kijeshi, ambako tathmini isiyo sahihi inaweza kusababisha madhara, dhima ya kisheria au hatari ya usalama. Makala inaweka mbele wataalamu wa nyanja, rubriki zenye vipimo vingi, vizingiti vya uamuzi vya tahadhari na usimamizi wa kutokuwa na uhakika/kutokubaliana; mbinu otomatiki zinawekwa katika nafasi ya kusaidia.
Task-type: je, kazi inaweza kuthibitishwa?
Katika kazi zilizofungwa, kunaweza kuwa na jibu sahihi lililo wazi au kanuni ya uthibitishaji wa nje. Udhibiti otomatiki unaweza kuwa na nafasi kubwa katika kazi kama uchimbaji wa taarifa uliopangwa, uainishaji wenye lebo inayojulikana au msimbo unaopaswa kupita unit test.
Katika kazi zilizo wazi, kunaweza kuwa na majibu mengi yenye msingi. Katika kazi kama muhtasari wa hati changamano, lugha ya ushauri wa kitabibu, hoja za kisheria au mapendekezo ya kimkakati, dhana kama manufaa, uwazi na ufaafu wa kimuktadha huenda zisionekane kikamilifu kutoka nje.
Evaluator availability: je, mtathmini sahihi anapatikana kweli?
Katika nyanja kama tiba, sheria au upangaji wa kijeshi, wataalamu wanaofaa zaidi wanaweza kuwa ghali na adimu kwa upande wa muda. Kwa hiyo, muundo wa tathmini unapaswa kuzingatia si tu mtathmini bora ni nani, bali pia ni kiasi gani cha muda wa mtaalamu kinapatikana kwa kweli.
Makala inapendekeza kwamba pale wataalamu walipo wachache, ukubwa wa sampuli upangwe kulingana na kiwango lengwa cha kutokuwa na uhakika badala ya mgao usiobadilika wa uwekaji alama; kazi ya mtaalamu ielekezwe kwenye vipengee hatarishi, vya mpakani au vyenye kutokubaliana kwa kiwango kikubwa.
Purpose: tathmini iko katika hatua gani ya mzunguko wa maisha?
Maendeleo ya awali hulenga ulinganisho wa haraka wa modeli na kutambua aina za makosa zilizo dhahiri. Vipimo otomatiki, majaribio madogo ya mapendeleo ya binadamu au mifumo ya LLM-as-judge inaweza kutoa ishara ya haraka ya mwelekeo.
Uthibitishaji kabla ya kupelekwa unahitaji kizingiti cha juu zaidi cha ushahidi. Swali la iwapo mfumo unatimiza mipaka lengwa ya utendaji, usalama na uaminifu linahitaji kujibiwa kwa tathmini ya binadamu iliyopangwa, vigezo vya nyanja na taarifa ya uaminifu.
Ufuatiliaji wa uzalishaji hufuatilia mabadiliko ya utendaji, aina mpya za makosa na mabadiliko katika mwingiliano wa watumiaji baada ya mfumo kuanza kutumiwa. Kwa kiasi kikubwa, ufuatiliaji otomatiki na ugunduzi wa hali zisizo za kawaida unaweza kufanywa; sampuli teule zenye hatari kubwa au zinazotia shaka zinaweza kuelekezwa kwa ukaguzi wa binadamu.
Volume: matokeo milioni nyingi yanatathminiwaje?
Katika seti ndogo ya majaribio ya kitaalamu, kila tokeo linaweza kukaguliwa na wataalamu wengi kwa rubriki za kina. Kwa kiasi cha kati, sampuli inaweza kuunganishwa na otomatiki ya sehemu. Katika mazingira ya uzalishaji yenye kiasi kikubwa na mamilioni ya mwingiliano wa chatbot, haiwezekani kutathmini kila tokeo moja kwa moja kwa binadamu; ni sampuli hatarishi au zisizo za kawaida pekee zinazopaswa kuelekezwa kwa binadamu kupitia uchunguzi otomatiki na sampuli za kitakwimu.
Ujumbe wa kisayansi wa Kielelezo 1 cha chanzo
Kielelezo cha STEP-V kwenye ukurasa wa 10 wa makala kinaonyesha viwango vya matumizi ya hatari ndogo, ya kati na kubwa katika paneli tatu tofauti za maamuzi. Kila paneli inashughulikia kwa pamoja maswali ya “lengo kuu”, “nani anapaswa kutathmini?”, “mbinu zinazokubalika” na “ni lini ipandishwe kwa ukaguzi wa mtaalamu?” katika muktadha wa maendeleo, uthibitishaji wa kupelekwa na ufuatiliaji.
Ujumbe mkuu wa kielelezo ni kwamba kadiri hatari inavyoongezeka, utaalamu wa binadamu unasogezwa katikati ya mnyororo wa tathmini. Ingawa otomatiki inaweza kutumiwa zaidi katika kazi zenye hatari ndogo na kiasi kikubwa, katika maeneo yenye hatari kubwa tathmini otomatiki inapaswa kubaki katika jukumu la uchujaji wa awali au usaidizi badala ya kuchukua nafasi ya mtaalamu wa binadamu.
Je, LLM-as-Judge Inaweza Kuchukua Nafasi ya Mtaalamu wa Binadamu katika Matumizi yenye Hatari Kubwa?
Kwa mujibu wa pendekezo la makala, kwa ujumla hapana. Katika matumizi yenye hatari kubwa, mifumo ya LLM-as-judge inaweza kuchukua jukumu pana zaidi tu ikiwa, ikilinganishwa na wataalamu wenye sifa katika kazi lengwa, inaweza kutoa ushahidi wenye nguvu ya kipekee na mahususi kwa kazi; mkabala wa chaguomsingi ni kutumia mtaalamu kama mwamuzi mkuu na LLM kama chombo cha uchunguzi wa awali, ukaguzi wa vigezo vidogo au upangaji wa vipaumbele vya ukaguzi.
Expert-Guided Auto-Evaluation
Ili kupunguza pengo kati ya uhaba wa wataalamu na kiasi kikubwa cha tathmini, makala inajadili mkabala wa Expert-Guided Auto-Evaluation . Hapa, jukumu la mtaalamu huhama kwa sehemu kutoka kuweka lebo kwa kila tokeo moja baada ya jingine hadi kubuni chombo cha upimaji.
Mtaalamu huunda rubriki mahususi za kazi, vigezo vidogo muhimu na prompt za tathmini/ukosoaji. Mfumo wa jaji unaotegemea LLM hutumia kipimo hiki kilichopangwa katika kiasi kikubwa zaidi cha matokeo. Hata hivyo, tathmini ya LLM lazima ikalibishwe kwa viwango vya wataalamu.
Pendekezo la lebo 50–100 za wataalamu linamaanisha nini?
Makala inajadili kama mkakati wa mfano kwamba katika baadhi ya hali za hatari kubwa ambapo usimamizi kamili wa wataalamu hauwezekani kwa sababu ya gharama, takriban sampuli 50–100 zilizothibitishwa na wataalamu zinaweza kutumiwa kukalibisha seti kubwa na nafuu zaidi ya data ya crowd-sourced au jaji wa LLM.
Nambari hii si kanuni ya jumla ya ukubwa wa sampuli. Maandishi yanayofuata yanaeleza wazi kwamba mpango wa sampuli unapaswa kuanzia kiwango cha kutokuwa na uhakika kinachokubalika kwa uamuzi badala ya mgao usiobadilika.
Mifano mitatu ya matumizi
| Matumizi | Hatari / muundo wa kazi | Mkabala wa tathmini unaopendekezwa |
|---|---|---|
| Msaidizi wa ushauri wa kitabibu | Hatari kubwa, kwa kiasi kikubwa kazi wazi, uhaba wa wataalamu | Tathmini ya rubriki inayoongozwa na mtaalamu; zana otomatiki kwa uchunguzi wa awali/triage; kupandisha hali zisizo na uhakika au hatarishi kwa mtaalamu |
| Msaidizi wa uandishi wa watumiaji | Hatari ndogo–ya kati, kazi wazi, upatikanaji mkubwa wa watathmini | Mapendeleo ya jozi, alama za watumiaji na LLM-as-judge; usimamizi wa mara kwa mara wa mtaalamu katika vipimo vya usalama/sera |
| Chombo cha sera/uzingatiaji wa shirika kinachotegemea retrieval | Hatari ya kati–kubwa, kinaweza kuthibitishwa kwa sehemu, kiasi kikubwa | Ukaguzi otomatiki wa ulinganifu wa ukweli na usahihi wa citation + LLM-as-judge iliyokalibishwa kwa binadamu + usimamizi wa binadamu kwa sampuli |
STEP-V inaweza kushindwa katika hali zipi?
Mwandishi hawasilishi STEP-V kama dhamana dhidi ya kosa la tathmini. Inaelezwa kwamba mfumo unaweza kushindwa kutatua tatizo hasa katika hali nne: ikiwa dhana inayopimwa imefafanuliwa vibaya, ikiwa watathmini wote wanaopatikana wana upendeleo uleule wa kimfumo, ikiwa hakuna kiwango cha chini cha usimamizi wa mtaalamu katika kazi yenye hatari kubwa, au ikiwa kutokubaliana kwa maana kwa watathmini kunapunguzwa kimakosa kuwa alama moja ya makubaliano.
Katika hali hii, tatizo linazidi uchaguzi wa itifaki. STEP-V inaweza kupanga nafasi ya maamuzi, lakini haiwezi kujisahihisha yenyewe ufafanuzi batili wa dhana, kundi lisilotosha la watathmini au mfumo wa upimaji unaoficha kutokuwa na uhakika.
Mapendekezo ya kimetodolojia
Makala inapendekeza kwamba vigezo lengwa vya tathmini ya LLM inayomweka binadamu katikati vianze na ufafanuzi wazi wa kiutendaji. Ufafanuzi, mifano wakilishi na namna ya kushughulikia visa vya mpakani inapaswa kubainishwa mapema.
Uchaguzi wa mtathmini unapaswa kuhalalishwa kwa kuzingatia dhana lengwa. Ili kupunguza athari za mpangilio na upendeleo mwingine unaojulikana, ufichaji, upangaji nasibu, kalibresheni na usimamizi wa mzigo wa kazi vinapaswa kutumiwa. Tafiti zinapaswa kuripoti si alama ya wastani tu, bali pia takwimu za uaminifu na taarifa za kutokuwa na uhakika.
Vipimo otomatiki na modeli za majaji zinazotegemea LLM hazipaswi kudhaniwa kuwa halali kwa chaguomsingi bila kukalibishwa dhidi ya hukumu za binadamu katika kazi lengwa. Kadiri kiwango cha hatari kinavyoongezeka, kiwango cha ushahidi kinachohitajika kutumia mfumo wa LLM-as-judge kinapaswa pia kuongezeka.
Uchaguzi wa modeli ya saikometria
| Data / itifaki | Familia ya modeli inayopendekezwa | Lengo |
|---|---|---|
| Alama za rubriki za Likert au ordinal | Modeli za ordinal za kihierarkia | Kumodeli ubora fiche pamoja na ukali wa mtathmini, ugumu wa kipengee na kutokuwa na uhakika |
| Tathmini iliyopangwa yenye watathmini wengi | Modeli za Many-facet Rasch | Kutenganisha utendaji wa modeli na ukali wa mtathmini pamoja na ugumu wa kipengee |
| Ulinganisho wa jozi | Modeli za Bradley–Terry au Thurstone zinazohusiana | Kukadiria ubora linganishi kutoka data ya mapendeleo ya jozi |
| Mazingira ambayo hakuna mtathmini anayeweza kuchukuliwa kuwa hana makosa | Modeli za Latent-class / imperfect-gold-standard | Kumodeli kosa la mtathmini kwa uwazi badala ya kutumia kura rahisi ya wengi |
Kiwango cha chini cha kuripoti
Mwandishi anasisitiza kwamba katika tafiti za tathmini, angalau uajiri wa watathmini, mafunzo, maelekezo ya kazi, muundo wa skeli, muda wa kipindi cha tathmini, kanuni za adjudication, takwimu za uaminifu na kuripoti kutokuwa na uhakika vinapaswa kuonekana wazi.
Kushiriki rubriki za mfano, prompt za kalibresheni, audit checklist na violezo vya uchanganuzi kunaweza pia kuimarisha urudiwaji. Kifurushi cha Supplementary Materials cha chanzo kina mafaili matano ya ziada yaliyotayarishwa kwa madhumuni haya.
Hitimisho zinazoungwa mkono na zisizoungwa mkono na utafiti
| Utafiti unaunga mkono | Utafiti hauungi mkono |
|---|---|
| Tathmini ya binadamu inapaswa kubuniwa kama mfumo wa upimaji wenye matatizo yake ya uaminifu, uhalali na upendeleo. | Kwamba imethibitishwa kwa majaribio kuwa tathmini ya binadamu ni sahihi zaidi kuliko LLM-as-judge katika kila hali. |
| Uhalali wa LLM-as-judge hutegemea kazi, dhana na jamii ya watathmini. | Kwamba modeli fulani ya jaji inapaswa kutumiwa katika kazi zote. |
| Tathmini mseto ya binadamu–LLM inaweza katika baadhi ya hali kuunganisha kiwango na ubora wa kimuktadha. | Kwamba mifumo mseto hupunguza upendeleo moja kwa moja. |
| Kutokubaliana kunaweza kubeba tofauti yenye maana ya mitazamo katika kazi za kimtazamo au kitamaduni. | Kwamba kutokubaliana kote kunapaswa kukubaliwa; adjudication haihitajiki katika vipengee muhimu kwa usalama. |
| STEP-V ni msaada wa muundo unaoratibu uchaguzi wa mbinu ya tathmini. | Kwamba STEP-V ni modeli iliyothibitishwa kwa majaribio, yenye kiwango cha kosa kinachojulikana au inayokokotoa moja kwa moja itifaki moja sahihi. |
| Katika hatari kubwa, usimamizi wa mtaalamu na udhibiti wa kutokuwa na uhakika vinapaswa kupewa kipaumbele. | Kwamba mifumo ya LLM-as-judge isiyokalibishwa inaweza kuchukua nafasi ya wataalamu katika matumizi ya tiba, sheria, fedha au kijeshi. |
Mapungufu na utafiti wa baadaye
Kizuizi muhimu zaidi cha makala ni kwamba STEP-V pamoja na taksonomia ya pamoja ya aina za makosa ni ya kimawazo . Mwandishi anaeleza kwamba ikiwa miundo hii inaboresha muundo halisi wa tathmini, jinsi inavyoweza kutabiri upendeleo na kutokubaliana, na dhana kuhusu utendaji wa mifumo mseto zinahitaji kujaribiwa kwa tafiti tarajiwa.
Mabadiliko ya haraka sana katika eneo la tathmini ya LLM pia huongeza hatari ya mapitio kupitwa na wakati kwa muda mfupi. Tafiti zijazo zinapendekezwa kuzingatia jinsi watathmini wanavyozoea LLM kadiri muda unavyopita, invariance ya upimaji kati ya tamaduni, umodelishaji wa kisaikometria wa athari za watathmini, pipeline zinazotambua kutokubaliana, upangaji wa sampuli na nguvu, pamoja na ugawaji wa muda mdogo wa wataalamu kulingana na kutokuwa na uhakika.
Makala pia inajadili kwamba STEP-V inaweza baadaye kubadilishwa kuwa chombo cha uamuzi cha nusu-kiasi. Inawezekana kuzipa vipimo vitano viwango vya ordinal na kuvihusianisha na matokeo kama hatari ya uhalali, hatari ya uaminifu kati ya watathmini, ukuzaji wa upendeleo wa pamoja, gharama na mzigo wa escalation. Hata hivyo, chanzo bado hakijatekeleza ramani hii ya kiasi; kutumia STEP-V ya sasa kama kitabiri cha kiasi cha utendaji hakuungwi mkono na utafiti.
Maelezo ya Chanzo na Mbinu
| Kichwa asili | Human Evaluation of Large Language Models: A Review and Protocol Selection Framework |
|---|---|
| Mwandishi | Tad T. Brunyé |
| Taasisi 1 | Center for Applied Brain and Cognitive Sciences, Tufts University, Medford, Massachusetts, USA |
| Taasisi 2 | U.S. Army DEVCOM Soldier Center, Natick, Massachusetts, USA |
| DOI | 10.3390/ai7050174 |
| Jarida | AI |
| Mchapishaji | MDPI, Basel, Switzerland |
| ISSN | 2673-2688 |
| Juzuu / toleo | 7 / 5 |
| Nambari ya makala | 174 |
| Aina ya chanzo | Review |
| Tarehe ya kupokelewa | 7 Aprili 2026 |
| Marekebisho | 30 Aprili 2026 |
| Kukubaliwa | 14 Mei 2026 |
| Kuchapishwa | 19 Mei 2026 |
| Mapitio ya rika | Chapisho la jarida lililopitiwa na rika |
| Leseni | Creative Commons Attribution 4.0 International (CC BY 4.0) |
| Ufadhili | Programu ya U.S. Army DEVCOM Soldier Center, Augmented Decisions via Intelligent Systems Recommendations (ADVISR), BC1/3D |
| Institutional Review Board | Haitumiki |
| Ridhaa yenye taarifa | Haitumiki |
| Upatikanaji wa data | Haitumiki |
| Mgongano wa maslahi | Mwandishi ameripoti kuwa hakuna mgongano wa maslahi. |
| Supplementary Materials | File S1–S5 zinapatikana |
Yaliyomo katika Supplementary Materials: File S1 Illustrative Scoring Rubrics; File S2 Example Calibration Prompts; File S3 Example Reporting Template; File S4 Example Audit Checklist; File S5 STEP-V Illustrative Configurations.
Kikomo cha ufadhili na msimamo wa taasisi: Utafiti uliungwa mkono na programu ya ADVISR ndani ya U.S. Army DEVCOM Soldier Center. Makala inaeleza wazi kwamba maoni na madai ni maoni binafsi ya mwandishi na hayawakilishi sera rasmi au maoni ya United States Army au taasisi husika za serikali.
Michango ya mwandishi: Chanzo kina mwandishi mmoja na hakiripoti jedwali tofauti la michango la CRediT. Majukumu ya mchango ambayo hayapo katika chanzo hayajatolewa na Verianla.
Kikomo cha mbinu ya mapitio: Makala inafanya usanisi mpana wa fasihi lakini hairipoti mfuatano wa utafutaji wa kimfumo, mtiririko wa PRISMA, idadi za uteuzi wa tafiti au usanisi wa meta-uchanganuzi. Kwa hiyo, haijaainishwa kama “mapitio ya kimfumo”.
Kikomo cha uthibitishaji wa STEP-V: STEP-V na taksonomia ya aina za makosa ni mifumo ya kimawazo. Chanzo kinaeleza kwamba zinapaswa kujaribiwa kwa njia tarajiwa katika siku zijazo; hakuna kiwango cha usahihi, unyeti, umahususi, muda wa kujiamini au alama ya mafanikio ya majaribio iliyoripotiwa kwa mifumo hiyo.
Maelezo ya chanzo cha taswira: Kielelezo asili cha STEP-V kwenye ukurasa wa 10 ni msaada wa uamuzi unaoonyesha uchaguzi wa mtathmini, mbinu za maendeleo/uthibitishaji/ufuatiliaji na mantiki ya escalation katika matumizi yenye hatari ndogo, ya kati na kubwa. Ikiwa kitachorwa upya kwa Verianla, mtiririko asilia wa maamuzi unaohifadhi mahusiano yale yale ya kisayansi unapaswa kutumiwa badala ya nakala ya pikseli.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *