


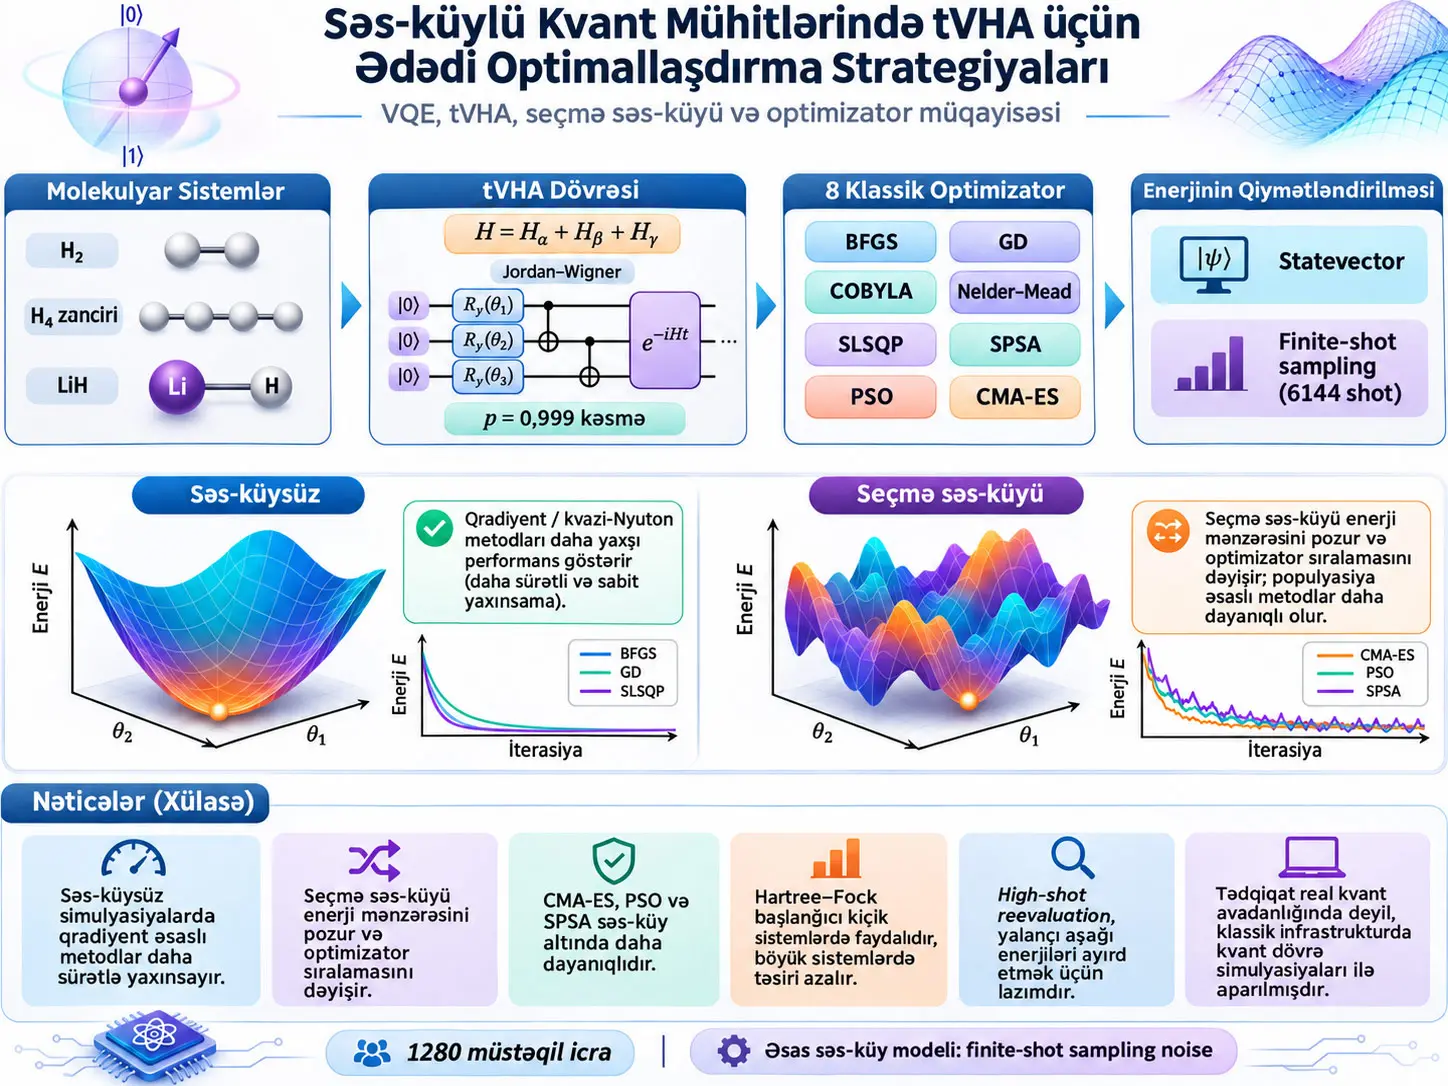
Truncated Variational Hamiltonian Ansatz (tVHA) molekulyar elektron Hamiltonianının fiziki quruluşundan törədilən, parametrli kvant dövrəsini daha idarəolunan etmək üçün xüsusilə non-Coulomb iki-cisim terminlərini nəzarətli şəkildə budayan, kimyəvi baxımdan strukturlaşdırılmış variasion kvant ansatzıdır. Bu tədqiqat tVHA əsaslı Variational Quantum Eigensolver (VQE) hesablamalarında səkkiz klassik optimallaşdırma alqoritminin davranışını H2, xətti H4 zənciri və LiH-nin full-space və active-space təsvirləri üzərində müqayisə edir. Tədqiqat real kvant avadanlığı üzərində aparılmamış; quantum circuits klassik yüksək məhsuldarlıqlı hesablama infrastrukturu üzərində Qiskit ilə simulyasiya edilmişdir. Buna görə burada ölçülən “səs-küyə davamlılıq” ilk növbədə finite-shot sampling noise-a qarşı simulyasiya performansıdır.
Müqayisə olunan səkkiz optimizer BFGS, Covariance Matrix Adaptation Evolution Strategy (CMA-ES), COBYLA, Gradient Descent (GD), Nelder–Mead, Particle Swarm Optimization (PSO), Sequential Least Squares Programming (SLSQP) və Simultaneous Perturbation Stochastic Approximation (SPSA)-dır. Hər molecule–optimizer cütü dörd ssenaridə sınaqdan keçirilmişdir: Hartree–Fock başlanğıcı + statevector, Hartree–Fock başlanğıcı + finite-shot sampling, random başlanğıc + statevector və random başlanğıc + finite-shot sampling. Hər ssenari üçün 10 müstəqil işə salma həyata keçirilmiş və ümumilikdə:
\[ 4\ \text{moleküler temsil} \times 8\ \text{optimizer} \times 4\ \text{senaryo} \times 10\ \text{koşu} = 1280 \]
müstəqil simulation yaradılmışdır.
Əsas noisy benchmark-da hər function evaluation üçün 6144 shot istifadə edilmişdir. Exact reference üçün Qiskit StatevectorEstimator, finite-shot hesablamalar üçün Qiskit Aer Estimator istifadə olunmuşdur. Aer Estimator Born qaydasına əsasən nümunələmə apardığı üçün measured expectation values finite sample variance daşıyır. Tədqiqatın əsas nəticəsi budur ki, sampling noise nəticələrə sadəcə kiçik xəta əlavə etmir; cost landscape-in formasını, görünən minimumları, gradient directions-u və buna görə optimizer sıralamasını dəyişdirir.
Səs-küysüz statevector şəraitində xüsusilə kiçik H2 sistemi üçün BFGS və digər deterministik üsullar son dərəcə sürətli və dəqiq yaxınlaşdığı halda, finite-shot sampling noise altında bu üstünlük böyük ölçüdə itir. Molekulyar və parametr fəzası mürəkkəbləşdikcə CMA-ES, PSO və SPSA kimi population-based və ya stochastic üsullar daha ardıcıl olur. Full-space LiH noisy benchmark-da high-shot reevaluation-dan sonra CMA-ES təxminən \(8\times10^{-3}\) Ha xəta ilə mənbədə ən yaxşı nəticəni verərkən, active-space LiH-də CMA-ES \(2.6\times10^{-4}\) Ha, SPSA \(3.9\times10^{-4}\) Ha və PSO \(4.2\times10^{-4}\) Ha səviyyələrinə çatmışdır.
Tədqiqatın ən kritik fiziki şərh sərhədi variational principle ilə bağlıdır. Exact expectation value üçün:
\[ E(\boldsymbol{\theta})\ge E_0 \]
qüvvədə qalır. Finite-shot hesablamada bunun altında görünə bilən dəyər:
\[ \hat E(\boldsymbol{\theta})
şəklindəki statistik enerji təxminidir. Bu, real fiziki quantum state-in əsas vəziyyət enerjisindən daha aşağı enerjiyə malik olduğu demək deyil. Sampling fluctuation ölçülən estimator-u müvəqqəti olaraq aşağı çəkə bilər.
Tədqiqatın nəticələri real quantum hardware performansının birbaşa təsdiqi deyil. Benchmark coherent gate errors, stochastic gate errors, amplitude damping, thermal relaxation və ya readout-assignment bias ehtiva etmir. Müəlliflər də future work çərçivəsində bu realistik hardware noise channels-ın ayrıca sınaqdan keçirilməli olduğunu bildirirlər.
tVHA Nədir və VQE Daxilində Nə Edir?
Truncated Variational Hamiltonian Ansatz molekulyar Hamiltonianın bir-elektron, Coulomb iki-elektron və non-Coulomb iki-elektron komponentlərini birbaşa parametrli quantum evolution bloklarına çevirən və daha aşağı dövrə mürəkkəbliyi üçün non-Coulomb töhfələrin bir hissəsini əhəmiyyət sırasına görə kəsən, kimyəvi baxımdan strukturlaşdırılmış ansatzdır; VQE daxilində vəzifəsi əsas vəziyyət enerjisini axtaran classical optimizer-in tənzimləyəcəyi quantum state ailəsini müəyyən etməkdir.
VQE niyə həm kvant, həm də klassik alqoritmdir?
Variational Quantum Eigensolver hybrid quantum–classical üsuldur. Quantum tərəfi parametrli bir vəziyyət:
\[ |\psi(\boldsymbol{\theta})\rangle \]
hazırlayır və Hamiltonian expectation value-nu ölçür:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle. \]
Classical optimizer isə \(\boldsymbol{\theta}\) parametrlərini dəyişdirərək bu enerjini azaltmağa çalışır.
Deməli, optimizer-in gördüyü objective function kvant dövrəsinin yaratdığı enerji təxminidir. Bu təxmin səs-küylü olduqda optimizer yanlış gradient, yanlış curvature və ya müvəqqəti false minimum görə bilər.
Ansatz nədir?
Ansatz VQE-nin axtarış aparacağı parametrli quantum-state ailəsidir. Yaxşı ansatz iki zidd tələbi tarazlamalıdır:
- Real molekulyar ground state-ə kifayət qədər yaxınlaşa biləcək qədər expressive olmalıdır.
- NISQ şəraitində işlədilə biləcək qədər az parametrli və aşağı dövrə dərinliyinə malik olmalıdır.
Çox zəif ansatz ground state-ə çata bilməz. Həddindən artıq mürəkkəb ansatz isə dövrə dərinliyini, ölçmə xərcini və optimallaşdırma çətinliyini artıra bilər.
Molekulyar Hamiltonian necə parçalanır?
Mənbə tVHA quruluşunu əvvəlcə:
\[ H=H_{\alpha}+H_{\beta}+H_{\gamma} \tag{1} \]
şəklində müəyyən edir.
Burada:
- \(H_{\alpha}\): one-body terminlərini,
- \(H_{\beta}\): Coulomb two-body terminlərini,
- \(H_{\gamma}\): non-Coulomb two-body terminlərini
təmsil edir.
Mənbə Tənlik (2)-ni aşağıdakı formada verir:
\[ H= \sum_{ij} h_{ij}a_i^{\dagger}a_j + \frac{1}{2} \sum_{ij} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ja_i + \frac{1}{2} \sum_{\substack{ijk\ell\\i\neq k\\j\neq\ell}} g_{ijk\ell} a_i^{\dagger}a_j^{\dagger}a_ka_{\ell}. \tag{2} \]
\(a_i^\dagger\) fermionic creation operator, \(a_j\) annihilation operator-dur. \(h_{ij}\) one-electron integrals-ın, \(g_{ijk\ell}\) isə two-electron interaction coefficients-in simvolik göstərimidir.
Mənbə notasiyası xəbərdarlığı: Tənlik (2)-nin Coulomb terminində cəm işarəsi yalnız \(i,j\) üzərində yazıldığı halda coefficient \(g_{ijk\ell}\) formasında dörd indeks daşıyır. Mənbə bu nöqtədə \(k,\ell\) indekslərini ayrıca izah etmir. Buna görə Verianla tənliyi daha adi indeks quruluşuna səssizcə çevirməmiş, mənbədəki göstərimi qorumuşdur.
tVHA-dakı truncation threshold nəyi ifadə edir?
Non-Coulomb two-body terms əhəmiyyət böyüklüyünə görə sıralandıqdan sonra mənbə Tənlik (3)-də cumulative truncation fraction-u:
\[ p= \frac{1} {\sum_s |g_s^{\gamma}|} \sum_{s=1}^{s_{\mathrm{cut}}} |g_s^{\gamma}| \tag{3} \]
kimi müəyyən edir.
Burada:
- \(g_s^\gamma\): non-Coulomb two-body coefficient,
- \(s\): dörd fermionic index-in bir sıralı indeks altında toplanmış forması,
- \(s_{\mathrm{cut}}\): qorunan terms üçün cutoff,
- \(p\): qorunan cumulative interaction weight fraction-dır.
Bu benchmark-da:
\[ p=0.999 \]
istifadə edilmişdir.
Yəni mənbənin tərifinə görə non-Coulomb two-body interaction strength-in kumulyativ böyüklüyünün %99,9-unu təşkil edən terms qorunmağa çalışılmış, daha kiçik töhfələr dövrə mürəkkəbliyini azaltmaq üçün budanmışdır.
Bu truncation pulsuz deyil. Daha az operator daha dayaz circuit yaratmağa kömək edə bilər; lakin ansatz-ın çata bildiyi state space-i daraldaraq reachability deficit yarada bilər. Belə halda optimizer qüsursuz işləsə belə ansatz real full-configuration-interaction ground state-ə tam çata bilməyə bilər.
Fermionic Hamiltonian niyə qubit operatorlarına çevrilir?
Elektronlar fermion olduqları üçün electronic Hamiltonian creation/annihilation operators ilə yazılır. Gate-model quantum circuit isə qubit və Pauli operators ilə işləyir. Tədqiqatda fermionic Hamiltonian:
\[ H_{\alpha} = \sum_{\alpha}c_{\alpha}P_{\alpha}, \qquad H_{\beta} = \sum_{\beta}c_{\beta}P_{\beta}, \qquad H_{\gamma} = \sum_{\gamma}c_{\gamma}P_{\gamma} \]
şəklindəki Pauli-term strukturlarına Jordan–Wigner transformation ilə çevrilir.
Mənbə Bravyi–Kitaev transformation-ın da prinsipcə mümkün olduğunu, lakin Jordan–Wigner mapping-in hər qubit state-i spin-orbital occupation number kimi daha birbaşa şərh etməyə imkan verdiyini bildirir.
Commuting Pauli groups niyə istifadə olunur?
Bir-biri ilə commute edən Pauli terms eyni measurement context daxilində birlikdə nəzərdən keçirilə bilər. Mənbə Pauli terms-i graph coloring ilə commuting groups-a ayırır və bununla ölçmə yükünü azaltmağı hədəfləyir.
Üç Hamiltonian fragment üçün commuting-set families:
\[ \mathcal{G}^{\alpha}, \qquad \mathcal{G}^{\beta}, \qquad \mathcal{G}^{\gamma} \]
kimi göstərilir.
tVHA unitary çevrilməsi necə qurulur?
Mənbə Tənlik (4):
\[ U(\boldsymbol{\alpha},\boldsymbol{\beta},\boldsymbol{\gamma}) = \prod_{d=1}^{D} \left[ \prod_{G\in\mathcal{G}^{\alpha}} e^{i\alpha_d c_{\alpha,G}P_{\alpha}} \right] \left[ \prod_{G\in\mathcal{G}^{\beta}} e^{i\beta_d c_{\beta,G}P_{\beta}} \right] \left[ \prod_{G\in\mathcal{G}^{\gamma}} e^{i\gamma_d c_{\gamma,G}P_{\gamma}} \right]. \tag{4} \]
Burada:
- \(D\): discretization/Trotter-step sayı və buna görə circuit depth ilə əlaqəli parametr,
- \(\alpha_d,\beta_d,\gamma_d\): classical optimizer tərəfindən dəyişdirilən variational parameters,
- \(c_{\alpha,G},c_{\beta,G},c_{\gamma,G}\): Pauli-group coefficients,
- \(P\): müvafiq Pauli operator,
- \(\mathcal G\): commuting groups-dur.
Non-commuting Hamiltonian hissələrinin exponential evolution-u birinci dərəcəli Suzuki–Trotter, digər adı ilə Lie–Trotter expansion vasitəsilə təxmini şəkildə həyata keçirilir.
Mənbə H2 üçün necə quantum circuit nümunəsi verir?
Mənbə Figure 1-də H2 ground-state problemi üçün tam decomposed, 4-qubit və 3 trainable-parameter tVHA circuit nümunəsini göstərir.
| Gate | Say |
|---|---|
| CX | 48 |
| H | 32 |
| \(\sqrt{X}\) | 16 |
| RZ | 16 |
| \(\sqrt{X}^{\dagger}\) | 16 |
| RZZ | 6 |
| U3 | 2 |
Bu gate count yalnız mənbədə göstərilən H2 circuit nümunəsinə aiddir; digər molekullar üçün eyni gate saylarını fərz etmək düzgün deyil.
Hartree–Fock initialization necə yaradılır?
Mənbə adiabatic state preparation ideyasına əsaslanan başlanğıcı:
\[ U_{\mathrm{ad}} = \prod_{d=1}^{D} e^{-i\frac{\tau}{D}H_0} e^{-i\frac{\tau}{D}\frac{d}{D}V} \tag{5} \]
şəklində verir.
Burada:
- \(H_0\): non-interacting Hamiltonian component,
- \(V\): interacting component,
- \(\tau\): effective adiabatic-evolution parameter,
- \(d/D\): addım irəlilədikcə interaction-ın artan fractional weight-i,
- \(D\): discretization step sayıdır.
Mənbə \(H_{\beta}\) və \(H_{\gamma}\) üçün başlanğıc parametrlərini:
\[ \beta_d^{(0)} = \gamma_d^{(0)} = \frac{\tau}{D} \langle V\rangle_{\mathrm{HF}} \frac{d}{D} \]
şəklində verir.
\(H_{\alpha}\) başlanğıc parametrinə dair mənbə cümləsində \(\alpha_d^{(0)}\), \(\tau/D\) və \(\langle H_\alpha\rangle_{\mathrm{HF}}\) birlikdə yazılır; lakin yayımlanmış PDF mətnində bu hissədə açıq bərabərlik işarəsi görünmür. Buna görə çatışmayan kimi görünən simvolik əlaqə Verianla tərəfindən təxmin edilərək tamamlanmamışdır.
Random initialization isə:
\[ \theta_i^{(0)} \sim \mathcal U(0,1) \]
uniform distribution ilə aparılmışdır.
Finite-Shot Sampling Noise Enerji Mənzərəsini Niyə Pozur?
Finite-shot sampling noise expectation value-nun sonsuz ölçmə ortalaması əvəzinə məhdud sayda quantum measurement outcome-dan təxmin edilməsi səbəbilə enerji təxmininə təsadüfi xəta əlavə edir; real gradient kiçik olduqda bu xəta gradient-i ört-basdır edə, əks istiqamətdə göstərə, hamar vadiləri süni şəkildə nahamar edə və optimizer-ə həqiqətdə olmayan minimumlar göstərə bilər.
Statevector ilə shot-based simulation arasındakı fərq
StatevectorEstimator quantum state amplitudes üzərindən expectation value-nu deterministik şəkildə hesablayır. Finite-shot sampling variance yoxdur.
Aer Estimator isə measurement outcomes-u Born qaydasına əsasən nümunələyir. Shot sayı sonlu olduqda eyni parameter point yenidən ölçülərsə, eyni estimated energy alınmaq məcburiyyətində deyil.
Mənbə əsas benchmark üçün:
\[ N_{\mathrm{shots}}=6144 \]
istifadə etmişdir.
Sampling variance ümumiyyətlə:
\[ \sigma^2\propto\frac{1}{N_{\mathrm{shots}}} \]
miqyasında azalır.
Buna görə standard deviation təxminən:
\[ \sigma\propto\frac{1}{\sqrt{N_{\mathrm{shots}}}} \]
davranışı göstərir. Shot sayını dörd dəfə artırmaq, digər şərtlər eyni olduqda, standard deviation-ı təxminən yarıya endirən square-root scaling ilə uyğundur.
Energy-landscape slicing necə aparıldı?
Müəlliflər əvvəlcə yüksək dəqiqlikli sampling ilə:
\[ N_{\mathrm{shots}}\ge10^6 \]
şərtində reference parameter set:
\[ \boldsymbol{\theta}^{\ast} \]
əldə etmişdir.
Daha sonra seçilmiş iki parameter direction üçün:
\[ \delta_i,\delta_j\in[-\Delta,\Delta] \]
grid-i boyunca enerji yenidən hesablanmış, digər parameters optimal reference values-da sabit saxlanmışdır.
Beləliklə eyni əsas energy surface-in müxtəlif shot counts altında optimizer tərəfindən necə “görüldüyü” müqayisə edilmişdir.
Mənbədə müşahidə olunan üç əsas landscape təhrifı
Mənbə Figure 2-nin əsas mesajını üç mexanizm altında xülasə etmək olar:
- False minima: finite-shot fluctuations səbəbilə real səthdə olmayan yerli aşağı bölgələr yarana bilər.
- Gradient reversal: noisy slope real slope-un əks istiqamətini göstərə bilər.
- Noise-induced ruggedness: xüsusilə quasi-degenerate və ya flat valley diblərində kiçik real gradient sampling fluctuations tərəfindən basdırılır.
Bu şəraitdə optimizer deterministic descent əvəzinə parameter space daxilində stochastic drift və ya random-walk tipli hərəkət göstərə bilər.
Barren plateau nədir?
Barren plateau parameterized quantum circuit-in cost-function gradient-lərinin sistem böyüdükcə son dərəcə kiçildiyi və optimizer-in mənalı descent direction tapmasının çətinləşdiyi hamar optimization landscape rejimidir.
Mənbə nəzəri konteksti:
\[ \ell_{\theta} = \langle\rho(\theta),O\rangle, \qquad \rho(\theta)\in\mathcal B(\mathcal H) \tag{6} \]
və:
\[ \operatorname{Var}_{\theta}(\ell_{\theta}) \in \mathcal O\left(\frac{1}{4^n}\right) \tag{7} \]
ifadələri ilə izah edir.
Burada:
- \(\rho(\theta)\): parameterized quantum state/operator representation,
- \(O\): observable,
- \(\ell_\theta\): observable expectation-dan törədilən loss,
- \(n\): qubit sayıdır.
Hilbert-space dimension:
\[ \dim\mathcal H=2^n \]
və operator-space dimension:
\[ \dim\mathcal B(\mathcal H)=4^n \]
kimi böyüyür.
Mənbə 12-qubit LiH nümunəsi üçün:
\[ 4^{12}=16\,777\,216\approx1.6\times10^7 \]
operator-space dimension böyüklüyünü vurğulayır.
Tənlik (6)–(7) bu benchmark-da ölçülmüş yeni empirical scaling nəticəsi deyil, sampling noise ilə barren-plateau probleminin birlikdə niyə ciddi ola biləcəyini izah edən nəzəri çərçivədir.
Variasion Prinsip Finite-Shot Ölçmədə Həqiqətən Pozulurmu?
Exact quantum expectation value variasion aşağı sərhədi pozmur; \(E(\theta)\ge E_0\) qüvvədə qalır, lakin finite-shot measurement-dan hesablanan təsadüfi estimator \(\hat E\) real expectation ətrafında paylandığı üçün bəzi nümunələrdə \(E_0\)-dan aşağı görünə bilər və mənbə “variational-bound violation” ifadəsini bu görünən statistik pozuntu üçün istifadə edir.
Exact enerji ilə estimated enerji eyni şey deyil
Variasion prinsip:
\[ E(\boldsymbol{\theta}) = \langle\psi(\boldsymbol{\theta})| H |\psi(\boldsymbol{\theta})\rangle \ge E_0 \]
deyir.
\(E_0\) exact ground-state energy-dir.
Finite-shot ölçmədə optimizer-in gördüyü isə:
\[ \hat E = E+\text{sampling fluctuation} \]
şəklində stochastic estimator-dur.
Əgər real variational energy artıq ground state-ə çox yaxındırsa, mənfi sampling fluctuation qalan energy gap-dən böyük ola bilər. O zaman:
\[ \hat E
görünə bilər.
Bu, “daha aşağı fiziki ground state kəşf edildi” demək deyil.
Sampling noise riyazi olaraq necə modelləşdirilir?
Mənbə Tənlik (8):
\[ \bar C(\boldsymbol{\theta}) = C(\boldsymbol{\theta}) + \epsilon_{\mathrm{sampling}} \tag{8} \]
şəklindədir.
Burada:
- \(C(\theta)\): real expectation-based objective,
- \(\bar C(\theta)\): finite-shot noisy estimate,
- \(\epsilon_{\mathrm{sampling}}\): mean-i sıfır qəbul edilən sampling error-dur.
Mənbə:
\[ \operatorname{Var} (\epsilon_{\mathrm{sampling}}) = \frac{\operatorname{Var}[C(\theta)]} {N_{\mathrm{shots}}} \]
əlaqəsindən istifadə edir.
Hamiltonian variance necə hesablanır?
\[ \hat H = \sum_k c_kP_k \]
üçün mənbə Tənlik (9):
\[ \operatorname{Var}[C(\theta)] = \langle\hat H^2\rangle - \langle\hat H\rangle^2. \tag{9} \]
Bu, observable-ın ikinci momenti ilə expectation value-nun kvadratı arasındakı fərqdir.
Mənbə həmçinin Pauli-term shot noise-a əlavə olaraq eyni commuting measurement groups daxilindəki covariance contributions-ın estimator variance-a töhfə verdiyini bildirir.
Sampling noise floor necə müəyyən edilir?
Mənbə optimization trajectory boyunca effective noise floor-u:
\[ \sigma_{\mathrm{noise}} \approx \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \frac{ \operatorname{Var}[C(\theta_i)] }{ N_{\mathrm{shots}} } } \tag{10} \]
kimi qiymətləndirir.
Burada \(N\), trajectory boyunca qiymətləndirilən nöqtələrin sayıdır.
Noise floor-a yaxınlaşdıqda optimizer-in daha aşağı observed energy tapması artıq mütləq daha yaxşı parameters tapması demək deyil; measured differences noise magnitude ilə eyni miqyasa düşmüş ola bilər.
Figure 3-də shot sayı ilə noise floor necə dəyişir?
| Shot sayı | Noise floor (Ha) | Məlumat statusu |
|---|---|---|
| 8 | ±6,7 × 10⁻² | Mənbə Figure 3 etiketi |
| 16 | ±4,2 × 10⁻² | Mənbə Figure 3 etiketi |
| 32 | ±2,5 × 10⁻² | Mənbə Figure 3 etiketi |
| 64 | ±1,7 × 10⁻² | Mənbə Figure 3 etiketi |
| 512 | ±6,0 × 10⁻³ | Mənbə Figure 3 etiketi |
| 1024 | ±4,0 × 10⁻³ | Mənbə Figure 3 etiketi |
| 6144 | ±1,6 × 10⁻³ | Mənbə Figure 3 etiketi |
| 12.000 | ±1,2 × 10⁻³ | Mənbə Figure 3 etiketi |
| 30.000 | ±7,3 × 10⁻⁴ | Mənbə Figure 3 etiketi |
Shot sayı artdıqca noise floor azalır; lakin \(1/\sqrt{N_{\mathrm{shots}}}\) xarakterli scaling səbəbilə eyni mütləq yaxşılaşmanı əldə etmək getdikcə daha çox shot tələb edir. Müəlliflərin “təxminən 1000 shot-dan sonra diminishing returns” qiymətləndirməsi yaxşılaşmanın tam dayandığı demək deyil, əlavə hər shot üçün əldə olunan marjinal dəqiqlik qazancının kiçildiyinə işarə edir.
Population Mean Niyə Tək “Ən Yaxşı” Namizəddən Daha Etibarlı Ola Bilər?
Sampling noise təxminən simmetrik olduqda population daxilində bir çox namizədin ortalaması müsbət və mənfi measurement fluctuations-ı qarşılıqlı söndürə bilər; əvəzində yalnız ən aşağı ölçülmüş namizədi seçmək böyük population daxilində təsadüfən həddən artıq aşağı ölçülmüş “good outlier” seçmək ehtimalını artıraraq optimizer-in noise-u real irəliləyiş hesab etməsinə səbəb ola bilər.
Population böyüdükdə iki əks təsir eyni anda yarana bilər
Bu tədqiqatın mühüm nüanslarından biri budur:
- Best-value selection: population böyüdükcə çox aşağı lucky noise sample tapmaq ehtimalı arta bilər.
- Population mean: population böyüdükcə müstəqil/məhdud korrelyasiyalı fluctuations orta hesabla bir-birini daha yaxşı kompensasiya edə bilər.
Mənbə population-average estimation error üçün:
\[ \mathrm{Error} \propto \frac{\sigma_{\mathrm{noise}}}{\sqrt{\lambda}} \]
miqyaslanmasından istifadə edir.
Burada \(\lambda\), population size-dır.
Bu ifadə “sampling noise-un fiziki fundamental sərhədi qırıldı” kimi şərh edilməməlidir. Daha çox population member üzərindən statistik məlumat birləşdirildiyi üçün mean estimate tək noisy evaluation ilə müqayisədə daha dəqiq olur.
Mənbənin müqayisə etdiyi üç noise-floor strategiyası
- Shot escalation: hər evaluation üçün shot sayını artırmaq.
- Selective high-shot reevaluation: görünən ən yaxşı candidates-ı daha yüksək shot ilə yenidən ölçmək.
- Population averaging: CMA-ES steady-state population statistics-dən istifadə etmək.
Shot escalation variance-ı birbaşa azaldır, lakin xərci artırır. Selective reevaluation seçilmiş namizəd artıq lucky outlier-dırsa selection bias riski daşıyır. Population mean isə sampling fluctuations-ın simmetriyasından istifadə edərək tək minimum müşahidəsinin bias-ını azaltmağı hədəfləyir.
Müəlliflər CMA-ES-in noise floor tərəfindən müəyyən edilən steady-state distribution-a yaxınlaşa bilməsindən istifadə edirlər; lakin bunun global ground-state optimum-a çatmağı təmin etmədiyini də açıq şəkildə qeyd edirlər.
Population size üzrə əlavə analiz nə göstərdi?
Appendix C:
\[ \lambda=7,\ 25,\ 50,\ 100 \]
population sizes üçün əlavə analiz təqdim edir.
\(\lambda=7\) şəraitində belə iteration mean tək best-value selection-la müqayisədə daha aşağı xəta meyli göstərir.
\(\lambda=25\) və xüsusilə \(\lambda=50\) şəraitində population mean theoretical/empirical noise floor-a olduqca yaxın davranır.
\(\lambda=100\) üçün 30.000-shot rejimində mənbə təxminən iteration 5 ətrafında sürətlə zero-error yaxınlığına gəldiyini, təxminən iteration 20-yə qədər bu bölgədə qaldığını və daha sonra noise-induced divergence/overfitting əlamətlərinin ortaya çıxdığını bildirir.
Buna görə tədqiqat “population nə qədər böyükdürsə həmişə bir o qədər yaxşıdır” nəticəsinə gəlmir. Müəlliflər optimal population-size window ola biləcəyini irəli sürür, lakin bütün problemlər üçün keçərli vahid optimal \(\lambda\) dəyəri müəyyən etmirlər.
Tədqiqatın Metodu və Nəticələri
Benchmark klassik high-performance computing infrastrukturu üzərində simulyasiya edilən tVHA circuits-də səkkiz classical optimizer-in exact statevector və finite-shot sampling şəraitində davranışını Hartree–Fock və random initialization seçimləri ilə müqayisə edir.
Molekulyar sistemlər
| Xüsusiyyət | H2 | LiH Active Space | LiH Full Space | H4 Zənciri |
|---|---|---|---|---|
| Bond length / distances (Å) | 0,74279 | 1,596 | 1,596 | 0,7; 0,7; 0,768 |
| Charge | 0 | 0 | 0 | 0 |
| Multiplicity | 1 | 1 | 1 | 1 |
| Basis set | STO-3G | STO-3G | STO-3G | STO-3G |
| Active space | Full | (2,2), 3 orbital | Full | Full |
Mənbənin footnote-u LiH active-space üçün orbitals [1,2,3] və 2 alpha + 2 beta electrons ifadəsindən istifadə edir. Bu göstərim mənbədə verildiyi kimi qorunmuşdur.
STO-3G basis set nə deməkdir?
STO-3G molekulyar orbital calculations-da istifadə olunan minimal Gaussian basis family-dir. Mənbə bunu bütün sistemlərdə eyni basis kimi istifadə edərək optimizer müqayisəsini eyni əsas electronic-structure approximation üzərində aparır.
Active-space reduction niyə vacibdir?
Active-space yanaşması bütün molecular orbitals əvəzinə electron correlation baxımından mühüm seçilmiş orbitals üzərində hesab aparır. Beləliklə:
- qubit/circuit tələbi,
- parameter-space ölçüsü,
- optimizer-in araşdırmalı olduğu effective landscape
azaldıla bilər.
Lakin active-space nəticəsi full molecular Hilbert-space həlli ilə eyni problem deyil. Mənbə LiH active-space-in noise robustness-ı artırdığını göstərsə də bunu “full LiH problemi tam və daha düzgün həll edildi” kimi şərh etmək doğru deyil.
Müqayisə olunan optimizer-lər
| Optimizer | Mənbə təsnifatı | Əsas iş prinsipi |
|---|---|---|
| BFGS | Gradient-based | Inverse-Hessian approximation ilə quasi-Newton yeniləməsi |
| CMA-ES | Metaheuristic / evolutionary | Candidate population və adaptive multivariate Gaussian covariance |
| COBYLA | Gradient-free | Objective və constraints üçün local linear approximations və trust-region yanaşması |
| GD | Gradient-based | Negative gradient direction boyunca parameter update |
| Nelder–Mead | Gradient-free | Simplex reflection, expansion, contraction və shrink əməliyyatları |
| PSO | Metaheuristic / swarm | Particles-ın individual-best və global-best məlumatına görə hərəkət etməsi |
| SLSQP | Gradient-based | Sequential quadratic programming və constrained local approximation |
| SPSA | Mənbə Table 3-də gradient-free | Bütün parameters-ı eyni anda perturb edərək iki function evaluation ilə stochastic gradient estimate |
SLSQP təsnifat qeydi: Mənbənin Introduction bölməsində COBYLA ilə SLSQP “derivative-free techniques” ifadəsi altında birlikdə qeyd edilir. Bunun əksinə, Appendix A və Table 3 SLSQP-ni gradient-based method kimi təsnif edir və sequential quadratic programming quruluşunu izah edir. Verianla əsas cədvəldə daha ətraflı Appendix A/Table 3 təsnifatından istifadə etmiş, Introduction-dakı fərqli ifadəni gizlətməmişdir.
Neçə müstəqil simulation işə salındı?
Hər optimizer–molecule cütü üçün dörd configuration və hər configuration üçün 10 run vardır:
| Ssenari | Initialization | Energy evaluation |
|---|---|---|
| 1 | Hartree–Fock | Statevector |
| 2 | Hartree–Fock | 6144-shot sampling |
| 3 | Random | Statevector |
| 4 | Random | 6144-shot sampling |
Cəmi:
\[ 1280 \]
müstəqil run həyata keçirilmişdir.
Pseudo-random seeds sabitlənməmişdir. Mənbəyə görə beləliklə starting points, optimizer-in stochastic steps-i və shot sampling hər trial-da müstəqil stochastic draw kimi baş vermişdir.
Bu seçim ensemble-level robustness-ı qiymətləndirmək baxımından məntiqlidir; lakin tək run-ın bit-bit yenidən istehsalını sabit seed istifadəsi ilə müqayisədə çətinləşdirir.
Optimizer hyperparameters necə seçildi?
Mənbə optimizer hyperparameters-ın molecule əsasında ayrı-ayrılıqda tune edilmədiyini; müvafiq implementations-ın geniş istifadə olunan defaults dəyərlərinin seçildiyini bildirir. Məqsəd üsullar arasında case-by-case tuning bias-ını azaltmaqdır.
Bunun əvəzində Appendix E stopping/convergence criteria üçün açıq tolerantlıqlar verir.
Convergence criteria
| Optimizer | Mənbə parametri | Mənbə criterion |
|---|---|---|
| BFGS | \(ftol=10^{-10}\) | \(\frac{f_k-f_{k+1}}{\max(|f_k|,|f_{k+1}|,1)}\le ftol\) |
| COBYLA | \(tol=10^{-7}\) | \(\Delta f_k=|f_{k+1}-f_k|\le tol\) |
| GD | \(tol=5\times10^{-4}\) | \(\|\theta_{k+1}-\theta_k\|\le tol\) |
| CMA-ES | \(tolx=10^{-12}\), \(tolfun=10^{-12}\) | \(\max_i\sigma_i\le tolx\) və population objective range \(\le tolfun\) |
| Nelder–Mead | \(xatol=10^{-6}\) | \(\|x_{k+1}-x_k\|\le xatol\) |
| PSO | velocity threshold \(10^{-5}\), cluster threshold 1 | Unclustered-particle count və maximum velocity birlikdə sərhəddən aşağı düşdükdə |
| SLSQP | \(ftol=10^{-10}\) | BFGS ilə eyni normalized function-change forması |
| SPSA | \(N=100\), \(allowed\_increase=10^{-3}\) | Son 100 objective value üçün fitted trend slope müsbət olduqda stagnation/termination yoxlaması |
Appendix E-də SPSA slope meyarı
Mənbə Tənlik (18):
\[ \mathrm{slope} = \frac{1}{N} \frac{df_k}{dk} > 0 \tag{18} \]
göstərimindən istifadə edir.
Slope son \(N=100\) objective values üzərində linear regression ilə müəyyən edilir.
Reproducibility boşluğu: Mənbə bütün optimizers üçün maximum function-evaluation limitinin eyni olduğunu bildirir; lakin yüklənmiş manuscript mətnində bu ümumi maximum-un sayısal dəyəri görünən şəkildə raportlanmayıb. Səhifə 11-də də “running up to optimization iterations” ifadəsində iteration sayı çatışmır. Bu dəyər Verianla tərəfindən təxmin edilməmişdir.
Proqram təminatı stack-i
| Python library | Versiya |
|---|---|
| qiskit | 1.0.2 |
| qiskit_algorithms | 0.3.1 |
| qiskit_nature | 0.7.2 |
| qiskit_aer | 0.14.2 |
| pyscf | 2.6.0 |
| scipy | 1.15.2 |
| cma | 3.3.0 |
Hesablama infrastrukturu
Simulyasiyalar IT4Innovations Barbora supercomputer üzərində aparılmışdır. Mənbə sistemi:
- 192 standard node: hər node üçün 2 × 18-core Intel Xeon və 192 GB RAM,
- 8 GPU node: 2 × 12-core Intel Xeon + 4 × NVIDIA V100,
- 1 fat node: 8 × 16-core Intel Xeon + 6 TB RAM,
- 200 Gb/s Infiniband HDR,
- 310 TB SCRATCH storage və 28 GB/s throughput
kimi təsvir edir.
Runs job-level embarrassingly parallel şəklində Slurm jobs kimi paylanmışdır. LiH və H4 üçün 5–10 concurrent run qrupları istifadə edilmişdir.
Mənbə ümumi computational consumption-ı təxminən:
\[ 4500\ \text{node-hour} \]
kimi raportlayır.
High-shot reevaluation niyə aparılmışdır?
Noisy optimizer bəzən lucky sampling fluctuation səbəbilə əslində olduğundan çox yaxşı görünən candidate parameters seçə bilər. Figure 4–7 captions optimization zamanı tapılan candidate parameters-ın:
\[ 10^5\ \text{shot} \]
ilə yenidən qiymətləndirildiyini göstərir.
High-shot reevaluation optimizer-i yenidən işə salmaq deyil. Məqsəd eyni parameter point-in enerjisini daha aşağı sampling variance ilə yenidən ölçərək görünən uğurun real parameter quality-dən, yoxsa low-shot fluctuation-dan qaynaqlandığını ayırd etməkdir.
H2 nəticələri
Səs-küysüz statevector şəraitində H2 ən asan benchmark-dır.
Mənbə:
- BFGS, CMA-ES, COBYLA, Nelder–Mead və PSO üçün təxminən \(10^{-13}\)–\(10^{-14}\) Ha-dan aşağı errors,
- GD + HF üçün təxminən \(10^{-6}\) Ha,
- SPSA üçün təxminən \(3\times10^{-5}\) Ha
raportlayır.
Bu rejimdə üsullar arasındakı əsas fərq final accuracy-dən daha çox convergence speed-dir.
Sampling noise altında high-shot corrected values üçün mənbə:
| Optimizer / şərt | Raportlanan xəta (Ha) |
|---|---|
| GD + HF | 6,6 × 10⁻⁴ |
| SPSA + HF | 4,1 × 10⁻⁴ |
| CMA-ES | 4,5 × 10⁻⁴ |
| COBYLA | 2,4 × 10⁻³ |
| Nelder–Mead + HF | 3,9 × 10⁻³ |
| BFGS | təxminən 4 × 10⁻³ |
| PSO random | 6,5 × 10⁻⁴ |
| PSO HF | 1,0 × 10⁻³ |
SLSQP sampling-noise şəraitində H2-də belə etibarlı şəkildə converge etməmişdir.
Mənbədaxili sıralama xəbərdarlığı: Mənbə mətni “lowest corrected mean errors come from GD ... followed by SPSA ... and CMA-ES” şəklində yazır. Lakin verilən rəqəmlər müqayisə edildikdə:
\[ 4.1\times10^{-4} < 4.5\times10^{-4} < 6.6\times10^{-4}. \]
Buna görə sayısal böyüklük sırası SPSA, CMA-ES, GD şəklindədir. Verianla mənbə cümləsini öz qərarı ilə yenidən sıralayıb “mənbə belə dedi” kimi təqdim etmir; həm mətn ifadəsi, həm də sayısal dəyərlər görünən saxlanılır.
H4 nəticələri
H4 chain daha mürəkkəb Hamiltonian və optimization landscape yaradır.
Statevector şəraitində mənbə:
- BFGS, COBYLA və SLSQP üçün təxminən \(7\times10^{-3}\) Ha,
- GD üçün təxminən \(2,5\times10^{-2}\) Ha
xəta səviyyələri bildirir.
Sampling-noise high-shot reevaluation-dan sonra:
| Optimizer | Raportlanan corrected mean error (Ha) |
|---|---|
| CMA-ES + HF | 2,25 × 10⁻² |
| PSO | 2,7 × 10⁻² |
| GD | 3,01 × 10⁻² |
| SPSA | təxminən 3,5–3,8 × 10⁻² intervalında |
| COBYLA | təxminən 3,5–3,8 × 10⁻² intervalında |
| BFGS | >4,5 × 10⁻² |
| Nelder–Mead | >4,5 × 10⁻² |
Mənbədaxili sıralama xəbərdarlığı: Mətn CMA-ES-dən sonra “GD və PSO” formasında sıralama qurur; lakin verilən rəqəmlərdə PSO-nun \(2,7\times10^{-2}\) Ha dəyəri GD-nin \(3,01\times10^{-2}\) Ha dəyərindən kiçikdir.
LiH full-space nəticələri
Mənbə statevector şəraitində BFGS, CMA-ES, COBYLA, Nelder–Mead və SPSA-nın təxminən:
\[ 4\times10^{-3}\ \mathrm{Ha} \]
ətrafına çatdığını, GD-nin təxminən \(2\times10^{-2}\) Ha və PSO-nun təxminən \(9\times10^{-3}\) Ha səviyyəsində qaldığını bildirir.
Mənbə eyni cümlədə ilk qrup üçün “sub-millihartree precision” ifadəsini istifadə edir.
Lakin:
\[ 4\times10^{-3}\ \mathrm{Ha} = 4\ \mathrm{mHa}. \]
“Sub-millihartree” riyazi olaraq 1 mHa-dan kiçik, yəni \(10^{-3}\) Ha-dan aşağı deməkdir. Buna görə mənbədə istifadə olunan təsvir ilə eyni cümlədə verilən təxminən \(4\times10^{-3}\) Ha rəqəmi bir-biri ilə uyğun gəlmir. Verianla rəqəmi əsas götürərək bunu gizlətmir.
Sampling noise + high-shot reevaluation:
| Optimizer / şərt | Raportlanan xəta |
|---|---|
| CMA-ES + HF | ~8,0 mHa |
| CMA-ES random | ~10,5 mHa |
| PSO + HF | ~13,2 mHa |
| PSO random | ~13,6 mHa |
| SPSA + HF | ~16 mHa |
| GD | ~19 mHa |
| BFGS + HF | ~19,7 mHa |
| BFGS random | ~22,2 mHa |
| COBYLA / Nelder–Mead | təxminən 20 mHa səviyyəsi |
Full-space LiH larger parameter-space şəraitində population-based CMA-ES-in sampling noise altında ən ardıcıl nəticə verdiyi sistemlərdən biridir.
LiH active-space nəticələri
Active-space reduction optimization problemini nəzərəçarpacaq dərəcədə asanlaşdırır.
Statevector şəraitində CMA-ES, PSO, Nelder–Mead və SPSA:
\[ <2\times10^{-4}\ \mathrm{Ha} \]
səviyyəsinə çatır.
BFGS və COBYLA da təxminən \(2\times10^{-4}\) Ha ətrafındadır.
Sampling-noise high-shot reevaluation:
| Optimizer / şərt | Raportlanan xəta |
|---|---|
| CMA-ES + HF | 2,6 × 10⁻⁴ Ha |
| SPSA | 3,9 × 10⁻⁴ Ha |
| PSO | 4,2 × 10⁻⁴ Ha |
| Nelder–Mead + HF | 5,3 × 10⁻⁴ Ha |
| COBYLA / BFGS | ~8 × 10⁻⁴–1,1 × 10⁻³ Ha |
| GD | bir neçə mHa |
| SLSQP | >3 × 10⁻¹ Ha |
Mənbə sonrakı literature-comparison paraqrafında SPSA + HF üçün \(6,5\times10^{-4}\) Ha və 486 function evaluation da raportlayır. Section 6-nın high-shot nəticə paraqrafında isə \(3,9\times10^{-4}\) Ha yazılır. Mənbə bu iki rəqəmin fərqli evaluation stage, aggregation və ya reporting choice-dan qaynaqlandığını açıq şəkildə izah etmir. Buna görə iki dəyər zorla birləşdirilməmişdir.
Full LiH ilə active-space LiH arasındakı əsas fərq
Mənbə active-space reduction-ın optimizer demand və noise sensitivity-ni təxminən bir order of magnitude azaltdığını bildirir.
Discussion bölməsində COBYLA sampling üçün active-space truncation-dan sonra:
\[ 95.2\% \]
error reduction raportlanır.
Bu faiz müəyyən LiH/COBYLA comparison-a aiddir; bütün optimizers, molekullar və ya real quantum hardware üçün ümumi %95,2 yaxşılaşma kimi şərh edilməməlidir.
Figure 8 nəyi göstərir?
Mənbə Figure 8 dörd sistemin bütün optimizers üçün final errors dəyərlərini altı evaluation category şəklində müqayisə edir:
- Random Init Statevector,
- HF Init Statevector,
- Random Init Sampling Noise,
- HF Init Sampling Noise,
- Random-Sampling High-Shot Reevaluation,
- HF-Sampling High-Shot Reevaluation.
Bars mean final error-u, error bars isə mənbə caption-a görə %95 confidence interval dəyərlərini təmsil edir.
Mənbə Figure 8-in bütün bar heights dəyərlərini ayrıca numeric table kimi raportlamır. Buna görə Verianla qrafikdən piksel oxuyaraq saxta dəqiqlikli yeni rəqəmlər yaratmamışdır.
Mənbənin əsas optimizer nəticəsi necə xülasə edilməlidir?
| Şərt | Mənbədə önə çıxan davranış | Şərh sərhədi |
|---|---|---|
| Kiçik sistem + statevector | BFGS və deterministic/gradient methods sürətli və yüksək dəqiqlikli | Noise yoxdur; hardware davranışı deyil |
| Finite-shot sampling | Gradient/curvature information pozulur | Yalnız sampling noise sınaqdan keçirilib |
| Daha böyük parameter space | CMA-ES, PSO, SPSA daha sabit olur | Hər system üçün vahid universal sıralama yoxdur |
| Active-space LiH | Optimization asanlaşır və noise sensitivity azalır | Problem full-space LiH ilə eyni state space deyil |
| Population mean | Best-value selection-la müqayisədə symmetric sampling noise-u daha yaxşı zəiflədə bilər | Global optimum zəmanəti deyil |
Tədqiqatın dəstəklədiyi nəticələr
- Optimizer ranking sampling noise-un mövcudluğundan güclü şəkildə asılıdır.
- Səs-küysüz kiçik sistemlərdə gradient/quasi-Newton üsulları çox effektiv ola bilər.
- Finite-shot sampling gradient və curvature estimates-ı poza bilər.
- SLSQP tested sampling-noise şəraitində ciddi divergence göstərmişdir.
- BFGS noiseless şəraitdəki güclü üstünlüyünü sampling noise altında böyük ölçüdə itirmişdir.
- CMA-ES, PSO və SPSA larger/noisy benchmark-larda daha ardıcıl olmuşdur.
- Hartree–Fock initialization kiçik sistemlərdə əsasən faydalıdır, lakin üstünlüyü complexity artdıqca azalır.
- Random initialization bəzi population-based methods üçün HF ilə bərabər və ya daha yaxşı ola bilər.
- Active-space reduction LiH-də optimization və noise robustness-ı əhəmiyyətli dərəcədə yaxşılaşdırmışdır.
- Finite-shot energy estimates exact ground-state lower bound-dan aşağı görünə bilər.
- High-shot reevaluation low-shot “yaxşı” nəticələrin bir hissəsinin sampling artifact olduğunu göstərmişdir.
- Population mean single best candidate selection-la müqayisədə noise-overfitting riskini azalda bilər.
Tədqiqatın dəstəkləmədiyi nəticələr
- Tədqiqat real quantum computer üzərində səkkiz optimizer-i benchmark etməmişdir.
- CMA-ES-in bütün VQE problemlərində qəti şəkildə ən yaxşı optimizer olduğu göstərilməmişdir.
- Sampling noise-un fiziki olaraq ground-state energy-dən daha aşağı real quantum states yaratdığı göstərilməmişdir.
- Variational principle exact expectation dəyərləri üçün təkzib edilməmişdir.
- Gate infidelity, coherent error, depolarizing noise, amplitude damping, thermal relaxation və ya readout error benchmark edilməmişdir.
- Optimizer sıralamasının real hardware noise altında eyni qalacağı sübut edilməmişdir.
- Quantum computational speedup və ya quantum advantage göstərilməmişdir.
- STO-3G və araşdırılan kiçik molecular systems nəticələri böyük kimyəvi sistemlərə avtomatik ümumiləşdirilə bilməz.
- Population size artdıqca performansın sərhədsiz yaxşılaşacağı göstərilməmişdir.
- Source Table 2-dəki “hardware üçün uyğun” kimi optimizer tövsiyələri birbaşa hardware benchmark nəticəsi deyil.
Tədqiqatın əsas məhdudiyyətləri
Mənbə və metod birlikdə qiymətləndirildikdə əsas məhdudiyyətlər bunlardır:
- Quantum circuits klassik kompüter/HPC üzərində simulyasiya edilmişdir.
- Əsas noisy condition yalnız finite-shot sampling noise-dur.
- Real-device gate/readout/calibration noise daxil deyil.
- STO-3G minimal basis istifadə edilmişdir.
- Araşdırılan molecular systems H2, H4 və LiH ilə məhduddur.
- Random seeds sabit deyil.
- Bütün optimizer hyperparameters molecule-specific tuning-ə məruz qalmamışdır.
- Common maximum function-evaluation sayının numeric dəyəri manuscript mətnində görünən şəkildə raportlanmır.
- Figure 8-in bütün bar values dəyərləri numeric table kimi verilməyib.
- tVHA truncation circuit depth-i azaldarkən reachability deficit yarada bilər.
- CMA-ES steady-state stability global optimum zəmanəti deyil.
Gələcək tədqiqat istiqamətləri
Müəlliflər gələcəkdə:
- fast gradient search ilə population methods arasında noise-adaptive switching,
- measured noise floor-a görə dynamic shot allocation,
- noise-aware stopping rules,
- thermal relaxation,
- amplitude damping,
- readout assignment errors,
- hardware-backed calibration
kimi daha realistik noise conditions və hybrid optimization strategies araşdırılmasını təklif edirlər.
Mənbə və Metod Qeydi
Özgün başlıq: Numerical Optimization Strategies for the Variational Hamiltonian Ansatz in Noisy Quantum Environments
Müəlliflər: Silvie Illésová; Vojtěch Novák; Tomáš Bezděk; Clemens Possel; Martin Beseda.
Müəllif sırası: Mənbədəki sıra qorunmuşdur.
Bərabər töhfə: Yüklənmiş v4 PDF-də açıq equal-contribution/equal-first-author bəyanı görünmür.
Corresponding author: Martin Beseda.
Corresponding-author e-poçt: martin.beseda@univaq.it
Qurum 1: Gran Sasso Science Institute, L’Aquila, Italy.
Qurum 2: Department of Applied Mathematics, Faculty of Electrical Engineering and Computer Science, VSB-Technical University of Ostrava, Ostrava, Czech Republic.
Qurum 3: IT4Innovations National Supercomputing Center, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Qurum 4: Department of Computer Science, Faculty of Electrical Engineering and Computer Science, VSB–Technical University of Ostrava, Ostrava, Czech Republic.
Qurum 5: Department of Mathematics, TUM School of Computation, Information and Technology, Technical University of Munich, Garching bei München, Germany.
Qurum 6: Fraunhofer Institute for Chemical Technology ICT, Pfinztal, Germany.
Qurum 7: Department of Physics, Saarland University, Saarbrücken, Germany.
Qurum 8: Department of Information Engineering, Computer Science and Mathematics, University of L’Aquila, L’Aquila, Italy.
Platforma: arXiv.
arXiv: arXiv:2505.22398v4 [quant-ph].
İlk arXiv göndərişi: 28 May 2025.
Yüklənmiş versiya: v4, 22 Yanvar 2026.
DOI: 10.48550/arXiv.2505.22398.
Rəsmi keçid: https://arxiv.org/abs/2505.22398
Mənbə növü: Nəzəri/hesablamalı quantum-chemistry və numerical-optimization preprint/manuscript.
Hakemlik statusu: Yüklənmiş mənbə arXiv preprint versiyasıdır. PDF IOP Publishing manuscript template-dən istifadə edir; lakin Journal Name, volume/year/article-number və received/revised dates placeholder vəziyyətindədir. Bu araşdırmada exact title üçün təsdiqlənmiş son hakemli journal publication qeydi müəyyən edilmədiyinə görə məqalə hakemli final nəşr kimi təqdim edilməmişdir.
IOP şablon qeydi: PDF üzərində “Journal vv (yyyy) aaaaaa”, “Journal Name”, “dd Month yyyy” kimi placeholders var. Bunlar real biblioqrafik journal metadata kimi istifadə edilməmişdir.
Fayl kimliyi qeydi: Yüklənmiş faylın adı Research Square DOI formatında bir ifadə daşısa da PDF-in öz daxili kimliyi arXiv:2505.22398v4, PDF metadata DOI-si isə 10.48550/arXiv.2505.22398-dir. Research Square qeydi bu araşdırmada etibarlı rəsmi səhifədən ayrıca doğrulanmadığı üçün əsas DOI kimi istifadə edilməmişdir.
Lisenziya: PDF metadata-sı Creative Commons Attribution 4.0 International (CC BY 4.0) lisenziyasını göstərir.
Açar sözlər: Variational Quantum Eigensolver; Noisy optimization; CMA-ES; Truncated Variational Hamiltonian Ansatz; Quantum chemistry.
Tədqiqat növü: Classical HPC üzərində quantum-circuit simulation və optimizer benchmarking.
Real quantum hardware: İstifadə edilməmişdir.
Əsas noise modeli: Finite-shot sampling noise.
Daxil edilməyən noise növləri: coherent/stochastic gate errors, thermal relaxation, amplitude damping və readout bias əsas benchmark-a daxil deyil.
Molekulyar sistemlər: H₂, linear H₄ chain, LiH full space, LiH active space.
Basis: STO-3G.
Hamiltonian mapping: Jordan–Wigner.
tVHA truncation: \(p=0.999\), yəni mənbənin şərhinə görə non-Coulomb two-body interaction strength-in cumulative %99,9-u qorunur.
Əsas sampling budget: 6144 shot / function evaluation.
Landscape reference sampling: \(N_{\mathrm{shots}}\ge10^6\).
High-shot reevaluation: Figure 4–7-də \(10^5\) shot.
Müstəqil run sayı: 1280.
Random seeds: Sabitlənməmişdir.
Optimizer tuning: Mənbə case-by-case hyperparameter optimization əvəzinə geniş istifadə olunan implementation defaults dəyərlərinin tətbiq edildiyini bildirir; ayrıca stopping tolerances Appendix E-də hesabatlandırılmışdır.
Hesablama infrastrukturu: Barbora supercomputer, Bull Sequana X cluster; cəmi təxminən 4500 node-hour.
Proqram təminatı: Qiskit 1.0.2; qiskit_algorithms 0.3.1; qiskit_nature 0.7.2; qiskit_aer 0.14.2; PySCF 2.6.0; SciPy 1.15.2; cma 3.3.0.
Data Availability: Hesablanmış nəticələr və onları yaradan scripts Zenodo-da public olaraq paylaşılmışdır.
Zenodo DOI: 10.5281/zenodo.15526170.
Conflict of Interest: Müəlliflər məlum competing financial interests və ya personal relationships olmadığını bəyan edirlər.
Ethical Statement: Human participants, human data və ya animal experimentation olmadığı üçün ethical approval tələb olunmamışdır.
Funding / dəstək: Clemens Possel, Baden-Württemberg Ministry of Economic Affairs, Labour and Tourism tərəfindən QC-4-BW, QC-4-BW II və KQCBW24 layihələri vasitəsilə dəstəklənmişdir. Tomáš Bezděk SGS No. SP2025/049, Vojtěch Novák SGS No. SP2025/072 dəstəklərini almışdır. Tədqiqat həmçinin Czech Ministry of Education, Youth and Sports tərəfindən e-INFRA CZ ID:90254 vasitəsilə dəstəklənmişdir.
Müəllif töhfələri: Mənbədə ayrıca CRediT author-contribution breakdown yoxdur.
Statistika: Hər configuration üçün 10 independent run həyata keçirilmişdir. Figure 8 mean final errors və %95 confidence intervals göstərir. Mənbədə optimizer cütləri üçün əhatəli formal p-value significance-testing cədvəli hesabatlandırılmamışdır.
Equation (2) notasiya qeydi: Coulomb term-də cəm \(\sum_{ij}\) formasında olduğu halda coefficient \(g_{ijk\ell}\) kimi dörd indeks daşıyır. Mənbə bu göstərimi ayrıca izah etmir; Verianla tənlik indekslərini fərziyyə ilə dəyişdirməmişdir.
H₂ nəticələrinin sırası qeydi: Mənbə GD + HF \(6,6\times10^{-4}\) Ha-nı “lowest” kimi əvvəl yazdığı halda SPSA + HF \(4,1\times10^{-4}\) Ha və CMA-ES \(4,5\times10^{-4}\) Ha olaraq daha kiçik numeric values bildirir.
H₄ sıra qeydi: Mətn CMA-ES-dən sonra GD və PSO sırasını işlədir, halbuki verilən PSO dəyəri \(2,7\times10^{-2}\) Ha, GD dəyəri \(3,01\times10^{-2}\) Ha-dır.
LiH unit-language qeydi: Full-space statevector paraqrafı təxminən \(4\times10^{-3}\) Ha dəyərlərini “sub-millihartree” kimi xarakterizə edir; \(4\times10^{-3}\) Ha = 4 mHa olduğuna görə rəqəmlə xarakteristika uyğun gəlmir.
SLSQP təsnifat qeydi: Introduction-da derivative-free methods kontekstində qeyd olunduğu halda Appendix A və Table 3-də gradient-based constrained optimizer kimi təsvir edilir.
SPSA active-space qeydi: Main result paragraph \(3,9\times10^{-4}\) Ha high-shot result verdiyi halda sonrakı literature-comparison paragraph \(6,5\times10^{-4}\) Ha və 486 function evaluations dəyəri verir. Mənbə fərqi ətraflı izah etmir.
Maximum function-evaluation qeydi: Bütün optimizers üçün eyni maximum limit istifadə edildiyi bildirilir, lakin yüklənmiş manuscript text-də ümumi ədədi maksimum açıq şəkildə görünmür.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib