

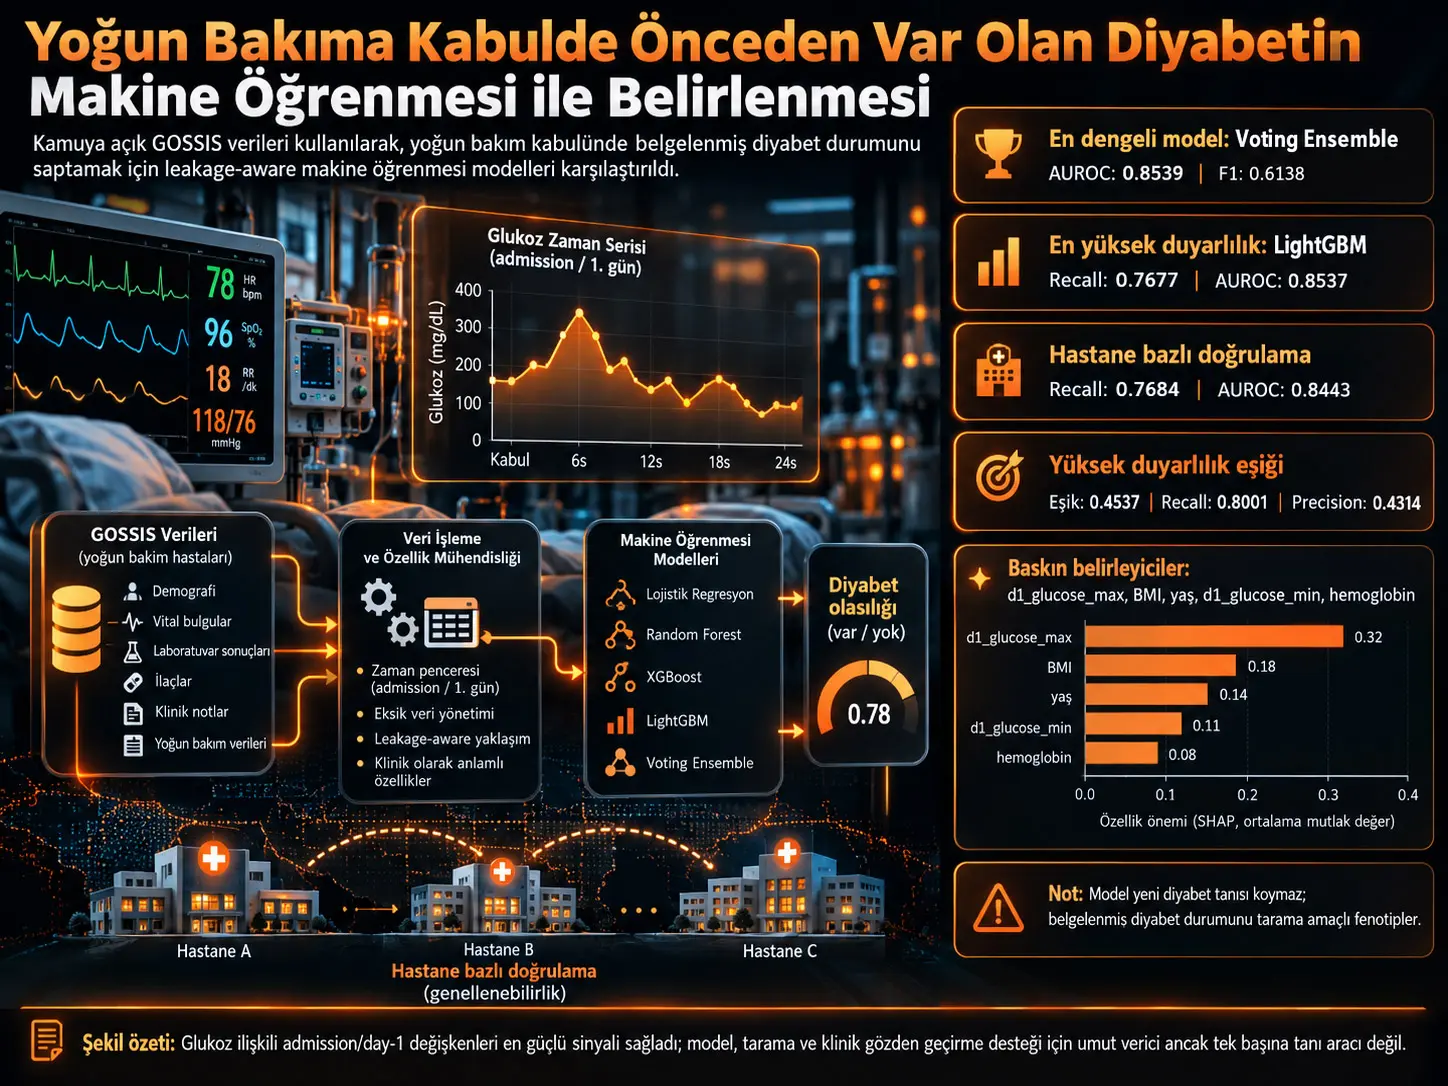
Hesaplanabilir diyabet fenotipleme (computable diabetes phenotyping), elektronik sağlık kayıtlarındaki yapılandırılmış değişkenlerden yararlanarak kişinin kaynak kayıtlarda belirli bir klinik fenotipe sahip olma olasılığını algoritmik biçimde belirlemeye çalışan bir sınıflandırma yaklaşımıdır. Bu çalışma, kamuya açık WiDS Datathon 2021/GOSSIS kritik bakım verilerini kullanarak yoğun bakıma kabul sırasında kayıtlarda önceden belgelenmiş diyabet durumunu belirlemek için leakage-aware makine öğrenmesi modellerini karşılaştırmıştır. Ana analizde 125.139 yaş ≥16 ICU kaydı kullanılmış; CatBoost, Random Forest, XGBoost, LightGBM, Histogram-based Gradient Boosting ve üç boosting modelini birleştiren soft-voting ensemble değerlendirilmiştir. Leakage-mitigated random doğrulamada voting ensemble AUROC 0,8539, precision 0,5671, recall 0,6690 ve F1 0,6138 ile en dengeli genel profili verirken tuned LightGBM recall 0,7677 ile en yüksek duyarlılık yönelimli model olmuştur.
Çalışmanın en kritik bulgusu, model başarısının açık site veya APACHE değişkenlerinden çok erken glukoz sinyaline bağlı olmasıdır. APACHE değişkenleri çıkarıldığında performans yalnız sınırlı ölçüde azalırken, glukoz-benzeri değişkenlerin de çıkarıldığı strict reduced senaryoda LightGBM AUROC 0,7432'ye ve voting ensemble AUROC 0,7448'e düşmüştür. SHAP analizi de d1_glucose_max ve d1_glucose_min değişkenlerinin baskınlığını göstermiştir. Bununla birlikte yoğun bakımın ilk günündeki glukoz ölçümleri yalnız kronik diyabeti değil akut stres fizyolojisini, ilaç veya tedavi etkilerini, beslenme desteğini ve ölçüm yoğunluğunu da yansıtabilir.
Hastanelerin eğitim ve doğrulama arasında tamamen ayrıldığı grouped-site doğrulamada LightGBM recall 0,7684 ile korunmuş, ancak AUROC 0,8443'e ve precision 0,4546'ya düşmüştür. 0,4537 eşik değerinde recall 0,8001'e çıkarılabilmiş ancak precision 0,4314 olmuştur. Kalibrasyon sonuçları da tahmin edilen olasılıkların klinik mutlak risk olarak kullanılabilecek kadar güvenilir olmadığını göstermiştir. Bu nedenle sistem, bağımsız diyabet tanısı koyan bir araç değil; chart review, medication reconciliation, cohort enrichment veya araştırma sınıflaması için yüksek duyarlılıklı bir fenotipleme/tarama yardımcısı olarak yorumlanmalıdır.
Araştırma problemi
Yoğun bakıma kabul sırasında hastanın diyabet geçmişinin doğru bilinmesi, erken hipergliseminin nasıl yorumlanacağını etkileyebilir. Bununla birlikte diyabet bilgisi problem listesi, tanı kodları, eski başvurular, ilaç kayıtları, laboratuvar arşivleri veya kurumlar arası transfer belgeleri gibi farklı elektronik sağlık kaydı kaynaklarına dağılmış olabilir. Bu kayıtların bir bölümü kabul anında erişilebilir olmayabilir.
Bu problem özellikle yoğun bakımda önemlidir çünkü aynı yüksek glukoz değeri farklı nedenlerle ortaya çıkabilir. Önceden bilinen diyabet, daha önce tanınmamış kronik disglisemi, akut stres hiperglisemisi, glukokortikoid veya diğer ilaç etkileri, enteral/parenteral beslenme, dekstroz içeren sıvılar ve erken tedavi uygulamaları birbirine benzeyen glisemik görünümler oluşturabilir.
Çalışmanın araştırma sorusu bu nedenle “hasta gerçekten diyabetik midir?” biçiminde yeni klinik tanı koymak değildir. Soru, yoğun bakım kabulüne yakın zamanda mevcut yapılandırılmış veriler kullanılarak kaynak veri tabanında önceden belgelenmiş diyabet durumunun ne kadar güvenilir biçimde fenotiplenebileceğidir.
Bu Model Gerçekte Diyabet Tanısı mı Koyuyor?
Hayır. Çalışmanın hedef etiketi kaynak kayıtlarda yoğun bakıma kabulden önce veya kabul sırasında zaten belgelenmiş diyabet durumudur; model yeni diyabet tanısı koymak, stres hiperglisemisini saptamak veya gelecekte ortaya çıkacak diyabeti tahmin etmek üzere eğitilmemiştir ve kaynak yazar sistemi bağımsız tanı aracı değil, fenotipleme ve tarama yardımcısı olarak sınırlandırmaktadır.
Computable phenotyping yaklaşımının rolü
Computable phenotyping, klinik bir durumu yapılandırılmış EHR değişkenleri üzerinden yeniden tanımlayan algoritmik bir yaklaşım olarak düşünülebilir. Bu tür sistemlerde performans yalnız AUROC ile değerlendirilmemelidir. Aynı derecede önemli sorular; kullanılan değişkenlerin etikete sızıp sızmadığı, preprocessing'in yalnız training verisinden öğrenilip öğrenilmediği, farklı hastanelerde performansın korunup korunmadığı, sınıf dengesizliğinin nasıl ele alındığı ve tahmin olasılıklarının kalibre olup olmadığıdır.
Veri kaynağı
| Bileşen | Kayıt | Özellik | Çalışmadaki kullanımı |
|---|---|---|---|
| Etiketli WiDS 2021 dosyası | 130.157 ICU stay | 181 | Model geliştirme ve doğrulama kaynağı |
| Yaş ≥16 analitik kohort | 125.139 ICU stay | Ön işlemeden sonra senaryoya bağlı | Asıl modelleme kohortu |
| Etiketsiz challenge dosyası | 10.234 kayıt | 180 | Validation metriği, preprocessing öğrenimi veya eşik seçimi için kullanılmadı |
Dört özellik senaryosu
| Senaryo | Temel kural |
|---|---|
| Full feature set | Rutin temizleme uygulanır; grouping identifier'lar model matrisinden çıkarılır. |
| Leakage-mitigated original | Etikete doğrudan veya dolaylı olarak çok yakın olabilecek APACHE diagnosis alanları ve seçilmiş kronik komorbidite göstergeleri çıkarılır; diğer klinik admission/day-1 değişkenleri korunur. |
| Exclude all APACHE | Leakage-mitigated çıkarımlara ek olarak bütün APACHE ilişkili değişkenler kaldırılır. |
| Strict reduced model | APACHE, site identifier ve glukoz-benzeri değişkenler de çıkarılır. |
Split-aware preprocessing neden önemliydi?
Çalışmada veri ön işleme kuralları doğrulama verisinden bilgi sızdırmayacak şekilde yalnız training split üzerinde öğrenilmiştir. Etiketsiz challenge dosyası da imputer, kategorik düzey, engineered feature veya correlation-pruning kararı üretmekte kullanılmamıştır.
Birincil random split:
\[ (X_{\mathrm{train}},X_{\mathrm{val}},y_{\mathrm{train}},y_{\mathrm{val}}) = \mathrm{StratifiedSplit}(X,y;\mathrm{test\_size}=0.20,\mathrm{stratify}=y,\mathrm{seed}=40) \]
Bu denklem bütün yetişkin kayıtlarını diabetes_mellitus etiket dağılımını koruyarak %80 eğitim ve %20 doğrulama olarak ayırır. Ardından preprocessing parametreleri yalnız eğitim bölümünden hesaplanır:
\[ \Theta=\mathrm{fit}_{\mathrm{train}}(\mathrm{preprocessing}), \qquad X_{\mathrm{val}}^{*}=\mathrm{transform}_{\Theta}(X_{\mathrm{val}}) \]
Bu sıra, doğrulama verisindeki dağılım özelliklerinin eğitim sırasında modele dolaylı biçimde taşınmasını azaltmayı amaçlar.
Satır ve şema düzeyindeki temizlik
- Yaş <16 kayıtları çıkarıldı.
- hospital_admit_source ve icu_admit_source kategorileri harmonize edildi.
- Bir _min değişkeni karşılık gelen _max değerinden büyükse iki değer yer değiştirildi.
- Eksik d1_pao2fio2ratio_max için uygun olduğunda pao2_apache/fio2_apache oranı hesaplandı.
- Bütün h1_ değişkenleri çıkarıldı.
- Day-1 eşdeğeri bulunan bazı near-duplicate APACHE alanları kaldırıldı.
- encounter_id, readmission_status ve indeks sütunu modelden çıkarıldı.
- hospital_id ve icu_id yalnız grouped validation için ayrı tutuldu; hiçbir feature senaryosunda model girdisi yapılmadı.
Eksik değerlerin ele alınması
Sürekli değişkenler training-set ortalamasıyla, kategorik değişkenler training-set modu ile dolduruldu. Boy, kilo ve BMI için önce cinsiyete özgü training-set ortalaması kullanıldı; bu değer yoksa genel training ortalamasına dönüldü. Kategorik değişkenler yalnız training bölümünde gözlenen kategoriler kullanılarak one-hot encode edildi.
Training design matrix üzerinde mutlak Pearson korelasyonu 0,80'i aşan üst üçgensel feature çiftlerinde ikinci feature çıkarıldı:
\[ C_{\mathrm{drop}} = \{b:\exists a<b,\ |r_{ab}|>0.80\} \]
Aynı sütun çıkarımları validation ve challenge matrislerine de aynen uygulandı.
Karşılaştırılan modeller
| Model | Rol | Kaynakta verilen ana yapılandırma |
|---|---|---|
| CatBoost | Boosting baseline | 100 boosting iteration; random seed 40 |
| Random Forest | Bagging baseline | 100 ağaç; random_state=40; paralel işlem |
| Tuned XGBoost | Tuned gradient boosting | 200 estimator; max_depth=8; learning_rate=0,05; subsample=0,8; min_child_weight=10; colsample_bytree=0,8 |
| Tuned LightGBM | Duyarlılık yönelimli boosting | learning_rate=0,007; colsample_bytree=0,2; reg_alpha=3; reg_lambda=1; scale_pos_weight=4; n_estimators=10.000; random_state=100 |
| HistGradientBoosting | Ek boosting karşılaştırıcısı | scikit-learn histogram-based gradient boosting; random_state=40 |
| Soft-voting ensemble | Birleşik probability modeli | XGBoost : LightGBM : HGB = 1 : 3 : 1 |
Sınıf dengesizliği nasıl ele alındı?
Çalışma sentetik minority örnekleri üretmek için SMOTE kullanmak yerine model-içi sınıf ağırlıklandırmasını tercih etmiştir. LightGBM'de diabetes-positive sınıf için scale_pos_weight=4 kullanılmıştır. Bu seçim gerçek veri dağılımını değiştirmeden pozitif vakaların yanlış sınıflandırılmasının training loss içindeki maliyetini yükseltmektedir.
Kavramsal ağırlıklı kayıp:
\[ L=\sum_{i=1}^{n}w_{y_i}\ell(y_i,p_i)+\Omega(F) \]
Burada \(w_{y_i}\) sınıf-ağırlığını, \(\ell(y_i,p_i)\) ikili sınıflandırma kaybını ve \(\Omega(F)\) model karmaşıklığına uygulanan regularization terimini temsil eder.
Soft-voting ensemble nasıl oluşturuldu?
XGBoost, LightGBM ve HGB probability tahminleri LightGBM'ye üç kat ağırlık verilecek biçimde birleştirildi:
\[ p_i^{(\mathrm{ens})} = \frac{ p_i^{(\mathrm{XGB})} + 3p_i^{(\mathrm{LGBM})} + p_i^{(\mathrm{HGB})} }{5} \]
Amaç LightGBM'nin yüksek duyarlılık avantajını korurken XGBoost ve HGB'nin daha muhafazakâr olasılık tahminleriyle false-positive yükünü dengelemektir.
Sınıflandırma eşiği
Her model önce diyabet pozitif sınıfı için olasılık tahmini üretmiştir:
\[ p_i^{(m)} = \Pr(y_i=1\mid x_i^{*},M_m) \]
Birincil karşılaştırmada varsayılan eşik \(t=0,50\) kullanılmıştır:
\[ \hat{y}_i^{(m)}(t) = I\left(p_i^{(m)}\geq t\right) \]
Precision–recall analizinde ise eşik değiştirilerek farklı recall–precision dengeleri ayrıca incelenmiştir.
Performans metriklerinin rolü
Accuracy genel doğru sınıflandırma oranını, precision pozitif tahmin edilen vakaların ne kadarının gerçekten pozitif olduğunu, recall kaynak etiketinde pozitif olan vakaların ne kadarının yakalandığını ve F1 precision ile recall'un harmonik ortalamasını ölçmektedir.
Brier skoru probability doğruluğunu ölçen ve düşük olması istenen metriktir:
\[ \mathrm{Brier} = \frac{1}{n_V} \sum_{i\in V} (p_i-y_i)^2 \]
AUROC ise sabit bir eşikten bağımsız sıralama ayrıştırmasını temsil eder. Bir model yüksek AUROC'ya sahip olup yine de kötü kalibre olabileceği için kaynak AUROC ile calibration/Brier'ı ayrı değerlendirmiştir.
Hastane Bazlı Gruplu Doğrulama Neden Önemlidir?
Grouped-site validation, aynı hastaneye ait hiçbir kaydın hem eğitim hem doğrulama bölümünde bulunmasına izin vermediği için modelin belirli kurumlara özgü kodlama, laboratuvar isteme, hasta profili veya dokümantasyon örüntülerini ezberlemesinden doğabilecek iyimser performans tahminini azaltır; ancak bu tasarım hâlâ aynı WiDS/GOSSIS veri sürümü içinde yapılan internal validation'dır ve bağımsız external validation değildir.
Matematiksel ayrım:
\[ G_{\mathrm{train}}\cap G_{\mathrm{val}}=\varnothing \]
| Doğrulama | Eğitim kaydı | Doğrulama kaydı | Hastane yapısı |
|---|---|---|---|
| Random stratified | 100.111 | 25.028 | Aynı hastaneler iki bölümde de bulunabilir |
| Grouped site | 95.233 | 29.906 | 163 training ve 41 validation hastanesi; örtüşme yok |
Çalışmanın Yöntemi ve Bulguları
Birincil model karşılaştırması
| Model | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Voting Ensemble | 0,8151 | 0,5671 | 0,6690 | 0,6138 | 0,8539 | 0,1300 |
| LightGBM (Tuned) | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| XGBoost (Tuned) | 0,8288 | 0,6557 | 0,4642 | 0,5436 | 0,8505 | 0,1197 |
| HistGradientBoosting | 0,8251 | 0,6445 | 0,4543 | 0,5330 | 0,8458 | 0,1214 |
| CatBoost | 0,8227 | 0,6317 | 0,4629 | 0,5343 | 0,8403 | 0,1236 |
| Random Forest | 0,8154 | 0,6645 | 0,3225 | 0,4342 | 0,8252 | 0,1286 |
Bu tablo tek bir “en iyi model” yerine farklı kullanım amaçları için farklı işletim profilleri bulunduğunu göstermektedir. Voting ensemble F1 ve AUROC açısından en dengeli sonuçları vermiştir. LightGBM pozitif vakaları en fazla yakalayan modeldir; fakat daha çok false positive üretmiştir. XGBoost ise daha düşük recall karşılığında en düşük Brier skorunu üretmiştir.
Figure 1–6: Confusion matrix ve feature importance
Kaynakta Figure 1–6 her bir ana model için confusion matrix ile top-15 feature importance grafiğini eşleştirmektedir. CatBoost 18.046 true negative, 1.484 false positive, 2.953 false negative ve 2.545 true positive üretmiştir. Random Forest false positive sayısını yalnız 895'e düşürmüş, ancak 3.725 diyabet-pozitif vakayı kaçırmıştır.
Tuned XGBoost 2.552 true positive ve 1.340 false positive üretirken LightGBM 4.221 true positiveye ulaşmış; buna karşılık 4.192 false positive oluşturmuştur. HGB 2.498 true positive, 1.378 false positive üretmiştir. Voting ensemble 3.678 true positive ve 2.808 false positive ile LightGBM ile daha muhafazakâr modeller arasında orta bir işletim profili oluşturmuştur.
Bütün model ailelerinde d1_glucose_max güçlü veya baskın feature olarak öne çıkmıştır. d1_glucose_min, BMI, yaş, kreatinin, pre-ICU length of stay, hemoglobin ve diğer fizyolojik/laboratuvar özetleri farklı modellerde tekrar eden yüksek öneme sahip değişkenlerdir.
Glukoz Benzeri Değişkenler Çıkarıldığında Performans Ne Oldu?
Glukoz-benzeri değişkenler APACHE ve leakage-prone alanlarla birlikte çıkarıldığında model ayrıştırması belirgin biçimde çökmüştür: LightGBM AUROC 0,8537'den 0,7432'ye, voting ensemble AUROC 0,8539'dan 0,7448'e düşmüştür; buna karşılık yalnız leakage-prone veya bütün APACHE değişkenlerini çıkarmak çok daha küçük kayıplar oluşturmuştur, dolayısıyla admission/day-1 glisemik değişkenleri modelin ana predictive sinyalidir.
| Senaryo | LightGBM AUROC | LightGBM Recall | LightGBM Brier | Ensemble AUROC | Ensemble F1 |
|---|---|---|---|---|---|
| Full feature set | 0,8565 | 0,7672 | 0,1491 | 0,8566 | 0,6159 |
| Leakage-mitigated original | 0,8537 | 0,7677 | 0,1508 | 0,8539 | 0,6138 |
| Exclude all APACHE | 0,8508 | 0,7634 | 0,1529 | 0,8514 | 0,6077 |
| Strict reduced model | 0,7432 | 0,6641 | 0,1986 | 0,7448 | 0,4493 |
Bu ablasyon, glukoz değişkenlerinin “kronik diyabeti saf biçimde ölçtüğünü” kanıtlamaz. Tam tersine, modelin güçlü sinyalinin önemli bölümünün erken glisemik ölçümlere dayandığını gösterdiği için klinik yorumda daha fazla dikkat gerektirir.
Hastane bazlı doğrulama sonuçları
| Doğrulama | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Random stratified | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| Grouped site | 0,7727 | 0,4546 | 0,7684 | 0,5712 | 0,8443 | 0,1596 |
Grouped-site confusion matrix 18.581 true negative, 5.432 false positive, 1.365 false negative ve 4.528 true positive içermektedir. Recall'ın neredeyse değişmeden kalması modelin farklı hastanelerde pozitif kayıtları yakalamaya devam ettiğini; precision ve Brier'daki bozulma ise bunun daha büyük yanlış-pozitif ve probability reliability maliyetiyle gerçekleştiğini göstermektedir.
Precision–recall ve yüksek duyarlılık eşiği
Class imbalance nedeniyle ROC analizine ek olarak precision–recall eğrileri kullanılmıştır. Random validation average precision 0,622, grouped-site average precision 0,551'dir.
Kaynak yüksek duyarlılık hedefini:
\[ t_r= \max\{t:\mathrm{Recall}(t)\geq0.80\} \]
olarak tanımlamıştır. Grouped-site verisinde bu koşulu karşılayan raporlanmış eşik 0,4537'dir; bu noktada recall 0,8001 ve precision 0,4314'tür.
Bu sonuç, “daha yüksek recall ücretsiz değildir” ilkesini doğrudan gösterir. Kaçırılan pozitifleri azaltmak için eşik düşürüldüğünde, pozitif olarak işaretlenen fakat kaynak etiketi negatif olan hasta sayısı artmaktadır.
Modelin Yüksek AUROC Değeri Olasılıkların İyi Kalibre Olduğu Anlamına Geliyor mu?
Hayır. LightGBM AUROC bakımından güçlü ayrıştırma sağlasa da random ve grouped-site kalibrasyon eğrileri tahmin olasılıklarının özellikle orta-yüksek risk aralıklarında gözlenen diyabet sıklığını aşma eğiliminde olduğunu, Brier skorlarının da grouped validation altında kötüleştiğini göstermiştir; bu nedenle ham model olasılıkları yeniden kalibrasyon yapılmadan klinik mutlak risk olasılığı olarak yorumlanmamalıdır.
Kalibrasyon mantığı
Mükemmel kalibre edilmiş bir model için tahmin olasılığı \(p\) olan hasta grubunda gerçek pozitiflik oranının da \(p\) olması beklenir:
\[ E[y_i\mid p_i=p]=p \]
Kaynak kalibrasyon eğrisini 10 eşit olasılık aralığıyla oluşturmuş ve post hoc recalibration uygulamamıştır. Figure 10'da iki validation tasarımındaki eğri ideal diyagonalin önemli kısmında altında kalmıştır; bu, probability overestimation ile uyumludur.
| Validation | Brier | Kalibrasyon yorumu |
|---|---|---|
| Random stratified | 0,1508 | Probability overestimation gözleniyor |
| Grouped site | 0,1596 | Probability reliability biraz daha kötü |
SHAP neden grouped-site modelde hesaplandı?
SHAP analizinin grouped-site LightGBM üzerinde yapılması, açıklamanın aynı hastanelerin iki fold'da bulunduğu daha kolay random split yerine daha katı hastane-ayrımlı model davranışına bağlanmasını sağlamıştır. Grouped validation örneklem sayısı 3.000'i aşarsa SHAP hesaplaması tekrar üretilebilirlik için sabit seed ile en fazla 3.000 kayda örneklenmiştir.
SHAP'nin additive açıklama biçimi:
\[ F_G(x_i^{*}) = \phi_0+\sum_{j=1}^{p}\phi_{ij} \]
Burada \(\phi_0\) modelin başlangıç/baseline çıktısını, \(\phi_{ij}\) ise hasta \(i\) için feature \(j\)'nin model çıktısını yukarı veya aşağı iten katkısını temsil eder.
Global SHAP bulguları
| Değişken | Kaynakta gözlenen temel davranış |
|---|---|
| d1_glucose_max | Açık ara en yüksek mean absolute SHAP; yüksek değerler genellikle diabetes-positive yönde katkı |
| BMI | Yüksek değerler genellikle pozitif katkı; high-20s civarında negatiften pozitife geçiş ve üst uçta kısmi plato |
| Age | Genç yaşlarda negatif; orta ve ileri yaşlarda daha pozitif; en ileri yaşlarda plato/hafif gerileme |
| d1_glucose_min | Ters ve doğrusal olmayan örüntü; düşük minima pozitif yönde katkı gösterebilir |
| d1_hemoglobin_max | Düşük-orta değerlerde pozitif katkı, yüksek değerlerde giderek negatif yön |
| urineoutput_apache | Daha küçük ve dağınık SHAP büyüklükleri; ikincil bağlamsal feature |
d1_glucose_max dependence grafiği
Figure 12'ye göre d1_glucose_max'ın SHAP katkısı yaklaşık 100–250 mg/dL arasında belirgin biçimde yükselmiş ve çok yüksek değerlerde plato yapmıştır. Bu örüntü model davranışının sınırsız doğrusal artıştan çok non-linear saturation içerdiğini göstermektedir.
Yerel SHAP waterfall açıklamaları
Figure 14–15 true positive, false positive, true negative ve false negative gruplarından seçilmiş temsilî vakaları açıklamaktadır. Pozitif skor alan örneklerde yüksek d1_glucose_max çoğunlukla en büyük yukarı yönlü katkıdır; negatif skorlu örneklerde daha düşük veya daha az uç maksimum glukoz değeri güçlü aşağı yönlü katkı sağlayabilir.
Bununla birlikte bireysel tahminler tek feature'dan oluşmamaktadır. BMI, yaş, hemoglobin, renal bağlam, d1_glucose_min ve pre-ICU özellikleri güçlü glisemik sinyali artırabilir veya azaltabilir.
Çalışmanın desteklediği sonuçlar
- Public WiDS/GOSSIS structured EHR verisi, kayıtlarda belgelenmiş diyabet durumunun admission-time fenotiplenmesinde kullanılabilir.
- Gradient-boosted ve ensemble tree modelleri kaynak doğrulama tasarımlarında güçlü ayrıştırma göstermiştir.
- Voting ensemble en dengeli F1/AUROC profilini üretmiştir.
- LightGBM en yüksek recall yönelimli tek modeldir.
- Reasonable leakage mitigation ve bütün APACHE değişkenlerinin çıkarılması performansı yalnız sınırlı ölçüde azaltmıştır.
- Glukoz-benzeri feature'ların çıkarılması ayrıştırmayı belirgin biçimde düşürmüştür.
- Grouped-site validation'da recall korunurken precision ve calibration kötüleşmiştir.
- SHAP analizleri dominant glycemic signal ile daha küçük bağlamsal klinik katkıları göstermektedir.
Çalışmanın desteklemediği sonuçlar
- Model yeni diyabet tanısı koyduğunu kanıtlamaz.
- Model kronik diyabet ile stress hyperglycemia'yı kesin olarak ayırmaz.
- 0,8539 AUROC klinik deployment için tek başına yeterli değildir.
- Grouped-site validation bağımsız dış veri üzerindeki external validation değildir.
- 0,4537 eşiği bütün klinik iş akışları için evrensel optimal eşik değildir.
- SHAP katkıları biyolojik nedensellik anlamına gelmez.
- Model olasılıkları recalibration olmadan klinik mutlak risk olasılığı olarak kullanılmamalıdır.
- Çalışma otomatik tedavi kararı, insülin dozu veya klinik alarm sistemi doğrulamamıştır.
Başlıca sınırlılıklar
Birinci sınırlılık referans etiketidir. “Diabetes mellitus” etiketi kaynak veri tabanındaki belgelenmiş diyabet bilgisidir; HbA1c, longitudinal outpatient records, ilaç geçmişi ve manuel chart review ile yeniden adjudike edilmiş gold-standard kronik diyabet etiketi değildir.
İkinci sınırlılık validation kapsamıdır. Hastane-bazlı ayırma random split'e göre daha katı olsa da training ve validation kayıtları aynı kamu veri ekosisteminin parçasıdır. Bağımsız ICU veri setlerinde external validation yapılmamıştır.
Üçüncü sınırlılık glisemik sinyalin özgüllüğüdür. Early ICU glucose değerleri hem kronik metabolik hastalığı hem akut stres, tedavi ve izlem sürecini yansıtabilir.
Dördüncü sınırlılık calibration'dır. Kaynak model tahminlerini yeniden kalibre etmemiştir; calibration analizi yalnız problemi teşhis etmiştir.
Gelecek çalışma yönleri
Kaynak bağımsız ICU veri tabanlarında external validation, farklı hastane ve zaman dönemlerinde prospektif değerlendirme, kullanım amacına özel eşik seçimi ve gerektiğinde post hoc recalibration önermektedir.
Daha güçlü referans etiketleri için longitudinal EHR, HbA1c, outpatient ilaç geçmişi, problem listeleri, tanı kodları ve uygun olduğunda manuel adjudication birlikte değerlendirilebilir. Böylece önceden bilinen kronik diyabet; daha önce tanınmamış diyabet, stress hyperglycemia, medication-related hyperglycemia, nutrition-associated dysglycemia ve treatment-related glucose değişimlerinden daha açık biçimde ayrılabilir.
Kaynak ayrıca aynı validation, calibration, ablation ve interpretability çerçevesi altında TabNet, TabTransformer, FT-Transformer veya diğer deep tabular/Transformer tabanlı modellerin gelecekte karşılaştırılabileceğini belirtmektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: Identifying Pre-Existing Diabetes at ICU Admission with Machine Learning on Public GOSSIS Data
Yazar: Lily Popova Zhuhadar.
Yazar sayısı: 1; kaynak makale sole-author çalışmasıdır.
Kurum: Department of Analytics & Information Systems, Center for Applied Data Analytics, Western Kentucky University, Bowling Green, Kentucky, USA.
Sorumlu yazar: Lily Popova Zhuhadar.
Dergi: Diabetology.
Yayınevi: MDPI, Basel, Switzerland.
Cilt / sayı / makale: 7(5), 100.
DOI: 10.3390/diabetology7050100.
Received: 26 Mart 2026.
Revised: 19 Mayıs 2026.
Accepted: 19 Mayıs 2026.
Published: 21 Mayıs 2026.
Academic Editor: Peter Clifton.
Kaynak türü: Hakemli Original Article; retrospektif makine öğrenmesi benchmark/fenotipleme çalışması.
Lisans: Creative Commons Attribution (CC BY).
Veri kaynağı: WiDS Datathon 2021 tabular release; GOSSIS initiative ve eICU Collaborative Research Database türevi.
Başlangıç etiketli veri: 130.157 ICU stay, 181 feature.
Etiketsiz challenge dosyası: 10.234 kayıt, 180 feature; preprocessing öğrenimi, eşik seçimi ve validation performansı için kullanılmadı.
Nihai yaş ≥16 analitik kohort: 125.139 ICU stay.
Birincil random split: 100.111 training / 25.028 validation; stratified 80/20; random seed 40.
Grouped-site split: 95.233 training / 29.906 validation; 163 training hastanesi / 41 validation hastanesi; hastane örtüşmesi yok.
Hedef etiket: Kaynak kayıtlarda admission öncesinde veya sırasında belgelenmiş pre-existing diabetes mellitus.
Modeller: CatBoost, Random Forest, tuned XGBoost, tuned LightGBM, HistGradientBoosting ve soft-voting ensemble.
Class imbalance yaklaşımı: Model-intrinsic class weighting ve threshold-aware evaluation; sentetik oversampling kullanılmadı.
Soft-voting ağırlıkları: XGBoost : LightGBM : HGB = 1 : 3 : 1.
Değerlendirme metrikleri: Accuracy, precision, recall, F1-score, AUROC, Brier score ve average precision.
Calibration: 10 uniform probability bin; post hoc recalibration uygulanmadı.
Interpretability: SHAP / TreeExplainer; grouped-site LightGBM; gerekirse en fazla 3.000 grouped-validation kaydı.
Ablasyon: Full feature set, leakage-mitigated original, exclude all APACHE ve strict reduced model.
Ana sonuç: Voting ensemble leakage-mitigated random splitte AUROC 0,8539 ve F1 0,6138 ile en dengeli genel profil; tuned LightGBM recall 0,7677 ile en duyarlı tek model.
Grouped-site ana sonuç: LightGBM recall 0,7684, AUROC 0,8443, precision 0,4546 ve Brier 0,1596.
Yüksek-duyarlılık grouped eşik: t=0,4537; recall 0,8001; precision 0,4314.
Dominant model sinyali: d1_glucose_max ve diğer glukoz ilişkili day-1 değişkenleri.
Finansman: Dış finansman yok.
Etik kurul: Not applicable; de-identified public ICU data kullanıldı.
Bilgilendirilmiş onam: Not applicable.
Veri erişilebilirliği: WiDS Datathon 2021 tabular dataset Kaggle üzerinden kamuya açık olarak bildirilmiştir.
Kod/analitik materyal: Yazar sonuçları yeniden üretmeye yönelik Google Colab kaynağı bildirmiştir; kaynakta erişim tarihi 12 Mart 2026'dır.
Çıkar çatışması: Yazar çıkar çatışması bildirmemiştir.
Temel klinik sınır: Model kayıtlarda belgelenmiş diyabet fenotipini sınıflandırmaktadır; adjudike kronik diyabet tanısı, stress hyperglycemia ayrımı veya tedavi kararı üretmemektedir.
Temel deployment sınırı: External validation, recalibration, workflow-specific thresholding ve confirmatory clinical review yapılmadan bağımsız tanı veya tedavi karar aracı olarak kullanılmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir