

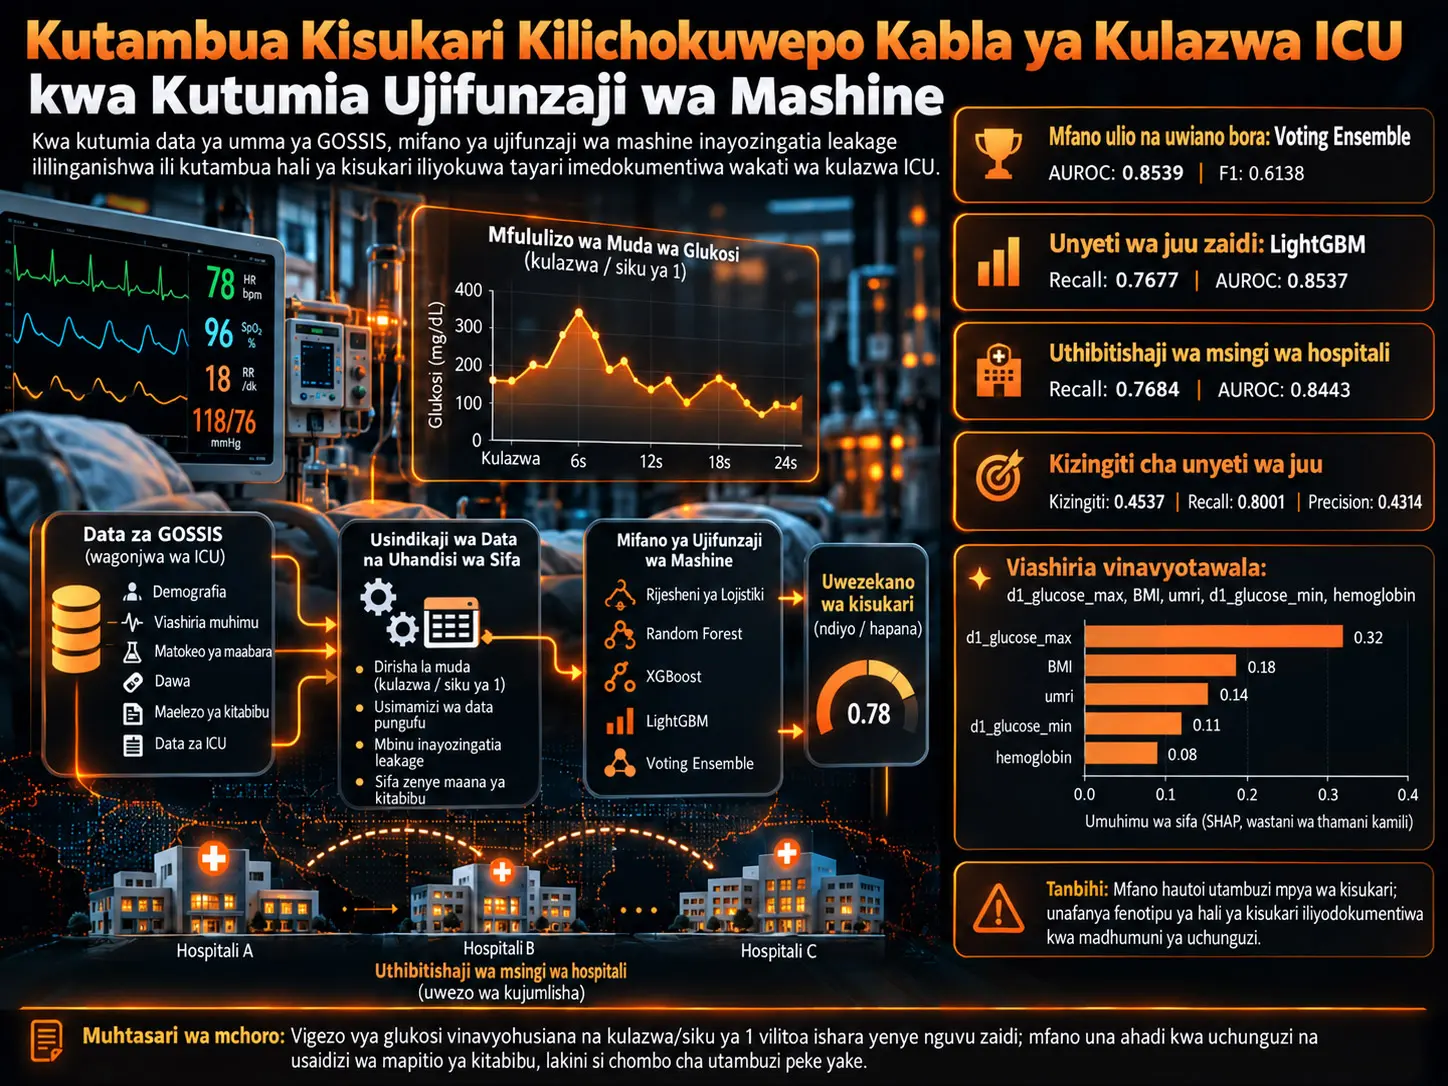
Uainishaji wa fenotipu ya kisukari unaokokotolewa (computable diabetes phenotyping) ni mbinu ya uainishaji inayotumia vigezo vilivyopangwa katika rekodi za afya za kielektroniki ili kubaini kwa njia ya algoriti uwezekano wa mtu kuwa na fenotipu fulani ya kliniki katika rekodi chanzo. Utafiti huu ulilinganisha modeli za leakage-aware za ujifunzaji wa mashine ili kutambua hali ya kisukari iliyokuwa tayari imeandikwa katika rekodi wakati wa kulazwa ICU, kwa kutumia data ya huduma mahututi ya WiDS Datathon 2021/GOSSIS iliyo wazi kwa umma. Katika uchanganuzi mkuu, rekodi 125.139 za ICU za umri ≥16 zilitumika; CatBoost, Random Forest, XGBoost, LightGBM, Histogram-based Gradient Boosting na soft-voting ensemble inayounganisha modeli tatu za boosting zilitathminiwa. Katika leakage-mitigated random validation, voting ensemble ilitoa wasifu wa jumla ulio na uwiano bora zaidi kwa AUROC 0,8539, precision 0,5671, recall 0,6690 na F1 0,6138, huku tuned LightGBM ikiwa modeli yenye mwelekeo mkubwa zaidi wa sensitivity kwa recall 0,7677.
Ugunduzi muhimu zaidi wa utafiti ni kwamba mafanikio ya modeli yalitegemea zaidi ishara ya mapema ya glukosi kuliko vigezo vya wazi vya site au APACHE. Baada ya kuondoa vigezo vya APACHE, utendaji ulipungua kwa kiwango kidogo tu, lakini katika hali ya strict reduced ambapo vigezo vinavyofanana na glukosi pia viliondolewa, LightGBM AUROC ilishuka hadi 0,7432 na voting ensemble AUROC hadi 0,7448. Uchambuzi wa SHAP pia ulionyesha kutawala kwa vigezo d1_glucose_max na d1_glucose_min. Hata hivyo, vipimo vya glukosi katika siku ya kwanza ya ICU vinaweza kuakisi si kisukari sugu pekee, bali pia fiziolojia ya stress ya papo hapo, athari za dawa au matibabu, usaidizi wa lishe na kiwango cha upimaji.
Katika grouped-site validation ambako hospitali zilitenganishwa kabisa kati ya training na validation, LightGBM recall ilidumishwa katika 0,7684, lakini AUROC ilishuka hadi 0,8443 na precision hadi 0,4546. Kwa threshold ya 0,4537, recall iliweza kuongezwa hadi 0,8001 lakini precision ilikuwa 0,4314. Matokeo ya calibration pia yalionyesha kuwa probability zilizotabiriwa hazikuwa za kuaminika vya kutosha kutumiwa kama absolute clinical risk. Kwa hiyo, mfumo huu si zana huru ya kutambua kisukari; unapaswa kutafsiriwa kama msaidizi wa phenotyping/uchunguzi wenye sensitivity ya juu kwa chart review, medication reconciliation, cohort enrichment au uainishaji wa utafiti.
Tatizo la utafiti
Kujua kwa usahihi historia ya kisukari ya mgonjwa wakati wa kulazwa ICU kunaweza kuathiri namna hyperglycemia ya mapema inavyotafsiriwa. Hata hivyo, taarifa za kisukari zinaweza kuwa zimetawanyika katika vyanzo mbalimbali vya rekodi za afya za kielektroniki, kama orodha ya matatizo, misimbo ya utambuzi, kulazwa kwa awali, rekodi za dawa, kumbukumbu za maabara au nyaraka za uhamisho kati ya taasisi. Baadhi ya rekodi hizi zinaweza kutopatikana wakati wa kulazwa.
Tatizo hili ni muhimu hasa katika ICU kwa sababu thamani ileile ya juu ya glukosi inaweza kutokea kwa sababu tofauti. Kisukari kilichojulikana awali, dysglycemia sugu ambayo haikutambuliwa hapo awali, stress hyperglycemia ya papo hapo, athari za glucocorticoid au dawa nyingine, lishe ya enteral/parenteral, vimiminika vyenye dextrose na matibabu ya mapema vinaweza kuunda mifumo ya glycemic inayofanana.
Kwa hiyo, swali la utafiti si kuweka utambuzi mpya wa kliniki kwa namna ya “je, mgonjwa ana kisukari kweli?”. Swali ni kiwango ambacho hali ya kisukari iliyokuwa tayari imeandikwa katika hifadhidata chanzo inaweza kufanyiwa phenotyping kwa kutegemewa kwa kutumia data iliyopangwa inayopatikana karibu na muda wa kulazwa ICU.
Je, Modeli Hii Kweli Inatambua Kisukari?
Hapana. Lebo lengwa ya utafiti ni hali ya kisukari ambayo tayari ilikuwa imeandikwa katika rekodi chanzo kabla ya au wakati wa kulazwa ICU; modeli haikufunzwa kuweka utambuzi mpya wa kisukari, kutambua stress hyperglycemia au kutabiri kisukari kitakachotokea baadaye, na mwandishi wa chanzo anaweka mipaka ya mfumo kuwa msaidizi wa phenotyping na uchunguzi, si zana huru ya utambuzi.
Jukumu la mbinu ya computable phenotyping
Computable phenotyping inaweza kufikiriwa kama mbinu ya algoriti inayofafanua upya hali ya kliniki kupitia vigezo vya EHR vilivyopangwa. Katika mifumo ya aina hii, utendaji haupaswi kutathminiwa kwa AUROC pekee. Maswali muhimu sawa ni kama vigezo vinavyotumiwa vinavuja taarifa kuelekea lebo, kama preprocessing imejifunza kutoka data ya training pekee, kama utendaji unadumishwa katika hospitali tofauti, jinsi class imbalance inavyoshughulikiwa na kama probability za utabiri zimecalibrate.
Chanzo cha data
| Kipengele | Rekodi | Sifa | Matumizi katika utafiti |
|---|---|---|---|
| Faili ya WiDS 2021 yenye lebo | 130.157 ICU stay | 181 | Chanzo cha uundaji na validation ya modeli |
| Kohorti ya uchanganuzi ya umri ≥16 | 125.139 ICU stay | Hutegemea scenario baada ya preprocessing | Kohorti kuu ya modeling |
| Faili ya challenge isiyo na lebo | 10.234 rekodi | 180 | Haikutumika kwa metric ya validation, kujifunza preprocessing au kuchagua threshold |
Scenario nne za feature
| Scenario | Kanuni kuu |
|---|---|
| Full feature set | Usafishaji wa kawaida unatumika; grouping identifier zinaondolewa kwenye matrix ya modeli. |
| Leakage-mitigated original | Sehemu za APACHE diagnosis na viashiria teule vya chronic comorbidity ambavyo vinaweza kuwa karibu sana na lebo moja kwa moja au kwa njia isiyo ya moja kwa moja vinaondolewa; vigezo vingine vya kliniki vya admission/day-1 vinahifadhiwa. |
| Exclude all APACHE | Mbali na uondoaji wa leakage-mitigated, vigezo vyote vinavyohusiana na APACHE vinaondolewa. |
| Strict reduced model | APACHE, site identifier na vigezo vinavyofanana na glukosi pia vinaondolewa. |
Kwa nini split-aware preprocessing ilikuwa muhimu?
Katika utafiti, kanuni za preprocessing zilijifunzwa kwenye training split pekee ili taarifa kutoka data ya validation zisivuje. Faili ya challenge isiyo na lebo pia haikutumika kutengeneza imputer, kiwango cha kategoria, engineered feature au uamuzi wa correlation-pruning.
Random split ya msingi:
\[ (X_{\mathrm{train}},X_{\mathrm{val}},y_{\mathrm{train}},y_{\mathrm{val}}) = \mathrm{StratifiedSplit}(X,y;\mathrm{test\_size}=0.20,\mathrm{stratify}=y,\mathrm{seed}=40) \]
Mlinganyo huu hugawanya rekodi zote za watu wazima kuwa %80 training na %20 validation huku ukihifadhi mgawanyo wa lebo ya diabetes_mellitus. Kisha parameters za preprocessing huhesabiwa kutoka sehemu ya training pekee:
\[ \Theta=\mathrm{fit}_{\mathrm{train}}(\mathrm{preprocessing}), \qquad X_{\mathrm{val}}^{*}=\mathrm{transform}_{\Theta}(X_{\mathrm{val}}) \]
Mlolongo huu unalenga kupunguza uhamishaji usio wa moja kwa moja wa sifa za mgawanyo katika data ya validation kwenda kwenye modeli wakati wa training.
Usafishaji katika kiwango cha safu na schema
- Rekodi za umri <16 ziliondolewa.
- Kategoria za hospital_admit_source na icu_admit_source zilioanishwa.
- Ikiwa variable ya _min ilikuwa kubwa kuliko thamani inayolingana ya _max, thamani hizo mbili zilibadilishana nafasi.
- Kwa d1_pao2fio2ratio_max iliyokosekana, ratio ya pao2_apache/fio2_apache ilihesabiwa pale ilipofaa.
- Variables zote za h1_ ziliondolewa.
- Baadhi ya sehemu za near-duplicate APACHE zenye Day-1 equivalent ziliondolewa.
- encounter_id, readmission_status na column ya index ziliondolewa kwenye modeli.
- hospital_id na icu_id zilitengwa kwa grouped validation pekee; hazikutumiwa kama model input katika scenario yoyote ya feature.
Utunzaji wa thamani zinazokosekana
Vigezo endelevu vilijazwa kwa wastani wa training-set, na vigezo vya kategoria kwa mode ya training-set. Kwa urefu, uzito na BMI, wastani wa training-set maalum kwa jinsia ulitumika kwanza; ikiwa haukuwepo, wastani wa jumla wa training ulitumika. Vigezo vya kategoria vilifanyiwa one-hot encode kwa kutumia kategoria zilizozingatiwa katika sehemu ya training pekee.
Kwenye training design matrix, kwa jozi za feature za upper triangle ambazo absolute Pearson correlation ilizidi 0,80, feature ya pili iliondolewa:
\[ C_{\mathrm{drop}} = \{b:\exists a<b,\ |r_{ab}|>0.80\} \]
Uondoaji huohuo wa columns ulitumika bila mabadiliko kwenye matrix za validation na challenge.
Modeli zilizolinganishwa
| Modeli | Jukumu | Usanidi mkuu uliotolewa katika chanzo |
|---|---|---|
| CatBoost | Boosting baseline | 100 boosting iteration; random seed 40 |
| Random Forest | Bagging baseline | 100 miti; random_state=40; uchakataji sambamba |
| Tuned XGBoost | Tuned gradient boosting | 200 estimator; max_depth=8; learning_rate=0,05; subsample=0,8; min_child_weight=10; colsample_bytree=0,8 |
| Tuned LightGBM | Boosting yenye mwelekeo wa sensitivity | learning_rate=0,007; colsample_bytree=0,2; reg_alpha=3; reg_lambda=1; scale_pos_weight=4; n_estimators=10.000; random_state=100 |
| HistGradientBoosting | Kilinganishi cha ziada cha boosting | scikit-learn histogram-based gradient boosting; random_state=40 |
| Soft-voting ensemble | Modeli iliyounganishwa ya probability | XGBoost : LightGBM : HGB = 1 : 3 : 1 |
Class imbalance ilishughulikiwaje?
Badala ya kutumia SMOTE kutengeneza synthetic minority samples, utafiti ulichagua class weighting ndani ya modeli. Katika LightGBM, scale_pos_weight=4 ilitumika kwa darasa la diabetes-positive. Chaguo hili linaongeza gharama ndani ya training loss ya kuainisha vibaya visa positive bila kubadilisha mgawanyo halisi wa data.
Conceptual weighted loss:
\[ L=\sum_{i=1}^{n}w_{y_i}\ell(y_i,p_i)+\Omega(F) \]
Hapa \(w_{y_i}\) inawakilisha class weight, \(\ell(y_i,p_i)\) binary classification loss, na \(\Omega(F)\) regularization term inayotumika kwa ugumu wa modeli.
Soft-voting ensemble iliundwaje?
Probability predictions za XGBoost, LightGBM na HGB ziliunganishwa kwa kuipa LightGBM uzito mara tatu:
\[ p_i^{(\mathrm{ens})} = \frac{ p_i^{(\mathrm{XGB})} + 3p_i^{(\mathrm{LGBM})} + p_i^{(\mathrm{HGB})} }{5} \]
Lengo lilikuwa kuhifadhi faida ya sensitivity ya juu ya LightGBM huku ikisawazisha mzigo wa false-positive kwa probability predictions zilizo makini zaidi za XGBoost na HGB.
Threshold ya uainishaji
Kila modeli kwanza ilitoa probability prediction kwa darasa la diabetes-positive:
\[ p_i^{(m)} = \Pr(y_i=1\mid x_i^{*},M_m) \]
Katika ulinganisho mkuu, threshold chaguomsingi \(t=0,50\) ilitumika:
\[ \hat{y}_i^{(m)}(t) = I\left(p_i^{(m)}\geq t\right) \]
Katika uchanganuzi wa precision–recall, threshold ilibadilishwa na mizani tofauti ya recall–precision ikachunguzwa kando.
Jukumu la metrics za utendaji
Accuracy hupima uwiano wa jumla wa uainishaji sahihi, precision hupima ni sehemu gani ya visa vilivyotabiriwa kuwa positive ambayo kwa kweli ni positive, recall hupima ni sehemu gani ya visa positive katika lebo chanzo iliyopatikana, na F1 hupima harmonic mean ya precision na recall.
Brier score ni metric inayopima usahihi wa probability na thamani ya chini ndiyo inayotamaniwa:
\[ \mathrm{Brier} = \frac{1}{n_V} \sum_{i\in V} (p_i-y_i)^2 \]
AUROC inawakilisha uwezo wa kutenganisha mpangilio bila kutegemea threshold maalum. Kwa sababu modeli inaweza kuwa na AUROC ya juu lakini bado ikawa imecalibrate vibaya, chanzo kilitathmini AUROC na calibration/Brier kando.
Kwa Nini Grouped Validation kwa Msingi wa Hospitali ni Muhimu?
Grouped-site validation hairuhusu rekodi yoyote ya hospitali moja kuwa katika sehemu zote mbili za training na validation, hivyo inapunguza makadirio ya utendaji yaliyo na matumaini kupita kiasi yanayoweza kutokana na modeli kukariri coding, maagizo ya maabara, wasifu wa wagonjwa au mifumo ya documentation maalum kwa taasisi fulani; hata hivyo, muundo huu bado ni internal validation ndani ya toleo lilelile la data ya WiDS/GOSSIS na si external validation huru.
Mgawanyo wa kihisabati:
\[ G_{\mathrm{train}}\cap G_{\mathrm{val}}=\varnothing \]
| Validation | Rekodi za training | Rekodi za validation | Muundo wa hospitali |
|---|---|---|---|
| Random stratified | 100.111 | 25.028 | Hospitali zilezile zinaweza kuwa katika sehemu zote mbili |
| Grouped site | 95.233 | 29.906 | Hospitali 163 za training na 41 za validation; hakuna overlap |
Mbinu na Matokeo ya Utafiti
Ulinganisho mkuu wa modeli
| Modeli | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Voting Ensemble | 0,8151 | 0,5671 | 0,6690 | 0,6138 | 0,8539 | 0,1300 |
| LightGBM (Tuned) | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| XGBoost (Tuned) | 0,8288 | 0,6557 | 0,4642 | 0,5436 | 0,8505 | 0,1197 |
| HistGradientBoosting | 0,8251 | 0,6445 | 0,4543 | 0,5330 | 0,8458 | 0,1214 |
| CatBoost | 0,8227 | 0,6317 | 0,4629 | 0,5343 | 0,8403 | 0,1236 |
| Random Forest | 0,8154 | 0,6645 | 0,3225 | 0,4342 | 0,8252 | 0,1286 |
Jedwali hili linaonyesha kuwa badala ya “modeli bora” moja, kuna wasifu tofauti wa uendeshaji kwa madhumuni tofauti ya matumizi. Voting ensemble ilitoa matokeo yenye uwiano bora zaidi kwa F1 na AUROC. LightGBM ndiyo modeli iliyokamata visa positive vingi zaidi; hata hivyo, ilizalisha false positive nyingi zaidi. XGBoost ilitoa Brier score ya chini zaidi kwa gharama ya recall ya chini.
Figure 1–6: Confusion matrix na feature importance
Katika chanzo, Figure 1–6 huoanisha confusion matrix na grafu ya top-15 feature importance kwa kila modeli kuu. CatBoost ilizalisha 18.046 true negative, 1.484 false positive, 2.953 false negative na 2.545 true positive. Random Forest ilipunguza idadi ya false positive hadi 895 tu, lakini ilikosa visa 3.725 vya diabetes-positive.
Tuned XGBoost ilizalisha 2.552 true positive na 1.340 false positive, huku LightGBM ikifikia 4.221 true positive; kwa upande mwingine ilizalisha 4.192 false positive. HGB ilizalisha 2.498 true positive na 1.378 false positive. Voting ensemble iliunda wasifu wa kati wa uendeshaji kati ya LightGBM na modeli zilizo makini zaidi kwa 3.678 true positive na 2.808 false positive.
Katika familia zote za modeli, d1_glucose_max ilijitokeza kama feature yenye nguvu au inayotawala. d1_glucose_min, BMI, umri, creatinine, pre-ICU length of stay, hemoglobin na muhtasari mwingine wa kifiziolojia/maabara vilikuwa vigezo vya umuhimu mkubwa vinavyojirudia katika modeli tofauti.
Utendaji Ulikuwaje Baada ya Kuondoa Vigezo Vinavyofanana na Glukosi?
Vigezo vinavyofanana na glukosi vilipoondolewa pamoja na sehemu za APACHE na leakage-prone, uwezo wa modeli wa kutenganisha uliporomoka kwa kiwango kikubwa: LightGBM AUROC ilishuka kutoka 0,8537 hadi 0,7432, na voting ensemble AUROC kutoka 0,8539 hadi 0,7448; kwa upande mwingine, kuondoa leakage-prone pekee au vigezo vyote vya APACHE kulisababisha hasara ndogo zaidi, kwa hiyo vigezo vya glycemic vya admission/day-1 ndiyo predictive signal kuu ya modeli.
| Scenario | LightGBM AUROC | LightGBM Recall | LightGBM Brier | Ensemble AUROC | Ensemble F1 |
|---|---|---|---|---|---|
| Full feature set | 0,8565 | 0,7672 | 0,1491 | 0,8566 | 0,6159 |
| Leakage-mitigated original | 0,8537 | 0,7677 | 0,1508 | 0,8539 | 0,6138 |
| Exclude all APACHE | 0,8508 | 0,7634 | 0,1529 | 0,8514 | 0,6077 |
| Strict reduced model | 0,7432 | 0,6641 | 0,1986 | 0,7448 | 0,4493 |
Ablation hii haithibitishi kwamba vigezo vya glukosi “vinapima kisukari sugu kwa usafi”. Kinyume chake, kwa sababu inaonyesha kuwa sehemu muhimu ya signal yenye nguvu ya modeli inategemea vipimo vya mapema vya glycemic, inahitaji tahadhari zaidi katika tafsiri ya kliniki.
Matokeo ya validation kwa msingi wa hospitali
| Validation | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Random stratified | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| Grouped site | 0,7727 | 0,4546 | 0,7684 | 0,5712 | 0,8443 | 0,1596 |
Grouped-site confusion matrix ina 18.581 true negative, 5.432 false positive, 1.365 false negative na 4.528 true positive. Kubaki kwa recall karibu bila kubadilika kunaonyesha kwamba modeli iliendelea kukamata rekodi positive katika hospitali tofauti; kuzorota kwa precision na Brier kunaonyesha kuwa hili lilitokea kwa gharama kubwa zaidi ya false-positive na probability reliability.
Precision–recall na threshold ya sensitivity ya juu
Kwa sababu ya class imbalance, precision–recall curves zilitumika pamoja na uchanganuzi wa ROC. Random validation average precision ni 0,622, grouped-site average precision ni 0,551.
Chanzo kilifafanua lengo la sensitivity ya juu kama:
\[ t_r= \max\{t:\mathrm{Recall}(t)\geq0.80\} \]
Katika data ya grouped-site, threshold iliyoripotiwa inayotimiza sharti hili ni 0,4537; katika hatua hii recall ni 0,8001 na precision ni 0,4314.
Matokeo haya yanaonyesha moja kwa moja kanuni kwamba “recall ya juu zaidi si bure”. Threshold inaposhushwa ili kupunguza visa positive vinavyokosekana, idadi ya wagonjwa wanaowekwa alama kuwa positive lakini lebo chanzo ni negative huongezeka.
Je, AUROC ya Juu ya Modeli Inamaanisha Probability Zimecalibrate Vizuri?
Hapana. Ingawa LightGBM hutoa utengano wenye nguvu kwa AUROC, calibration curves za random na grouped-site zilionyesha kwamba probability zilizotabiriwa zinaelekea kuzidi frequency ya kisukari iliyozingatiwa, hasa katika viwango vya hatari vya kati hadi juu, na Brier scores pia zilizorota chini ya grouped validation; kwa hiyo probability ghafi za modeli hazipaswi kutafsiriwa kama absolute clinical risk probability bila recalibration.
Mantiki ya calibration
Kwa modeli iliyocalibrate kikamilifu, katika kundi la wagonjwa lenye probability ya utabiri \(p\), kiwango halisi cha positive kinatarajiwa pia kuwa \(p\):
\[ E[y_i\mid p_i=p]=p \]
Chanzo kiliunda calibration curve kwa intervals 10 sawa za probability na hakikutumia post hoc recalibration. Katika Figure 10, curve katika miundo yote miwili ya validation ilibaki chini ya ideal diagonal katika sehemu kubwa; hali hii inaendana na probability overestimation.
| Validation | Brier | Tafsiri ya calibration |
|---|---|---|
| Random stratified | 0,1508 | Probability overestimation inaonekana |
| Grouped site | 0,1596 | Probability reliability ni mbaya kidogo zaidi |
Kwa nini SHAP ilihesabiwa kwenye modeli ya grouped-site?
Kufanya uchanganuzi wa SHAP kwenye grouped-site LightGBM kulifanya maelezo yahusishwe na tabia ya modeli yenye mgawanyo mkali zaidi wa hospitali, badala ya random split rahisi zaidi ambako hospitali zilezile zipo katika fold zote mbili. Ikiwa idadi ya sampuli za grouped validation ilizidi 3.000, hesabu ya SHAP ilichukua sampuli ya hadi rekodi 3.000 kwa seed thabiti ili kuhakikisha reproducibility.
Muundo wa maelezo wa additive wa SHAP:
\[ F_G(x_i^{*}) = \phi_0+\sum_{j=1}^{p}\phi_{ij} \]
Hapa \(\phi_0\) inawakilisha matokeo ya mwanzo/baseline ya modeli, na \(\phi_{ij}\) inawakilisha kwa mgonjwa \(i\), mchango wa feature \(j\) unaosukuma matokeo ya modeli juu au chini.
Matokeo ya global SHAP
| Kigezo | Tabia kuu iliyoonekana katika chanzo |
|---|---|
| d1_glucose_max | Kwa tofauti kubwa mean absolute SHAP ya juu zaidi; thamani za juu kwa kawaida huchangia kuelekea diabetes-positive |
| BMI | Thamani za juu kwa kawaida hutoa mchango positive; karibu na high-20s kuna mpito kutoka negative kwenda positive na partial plateau katika mwisho wa juu |
| Age | Negative katika umri mdogo; positive zaidi katika umri wa kati na mkubwa; plateau/kupungua kidogo katika umri mkubwa sana |
| d1_glucose_min | Muundo wa kinyume na non-linear; minima ya chini inaweza kuchangia kuelekea positive |
| d1_hemoglobin_max | Mchango positive katika thamani za chini-kati, kisha mwelekeo unaozidi kuwa negative katika thamani za juu |
| urineoutput_apache | Ukubwa mdogo na uliotawanyika wa SHAP; feature ya pili ya kimuktadha |
Grafu ya dependence ya d1_glucose_max
Kulingana na Figure 12, mchango wa SHAP wa d1_glucose_max uliongezeka kwa wazi kati ya takriban 100–250 mg/dL na kufikia plateau katika thamani za juu sana. Muundo huu unaonyesha kwamba tabia ya modeli ina non-linear saturation zaidi kuliko ongezeko la mstari lisilo na kikomo.
Maelezo ya local SHAP waterfall
Figure 14–15 inaeleza visa wakilishi vilivyochaguliwa kutoka makundi ya true positive, false positive, true negative na false negative. Katika mifano yenye score positive, d1_glucose_max ya juu mara nyingi ndiyo mchango mkubwa zaidi wa kuelekea juu; katika mifano yenye score negative, thamani ya juu kabisa ya glukosi iliyo chini au isiyo kali sana inaweza kutoa mchango mkubwa wa kuelekea chini.
Hata hivyo, utabiri binafsi hautokani na feature moja. BMI, umri, hemoglobin, muktadha wa renal, d1_glucose_min na sifa za pre-ICU zinaweza kuongeza au kupunguza ishara yenye nguvu ya glycemic.
Hitimisho zinazoungwa mkono na utafiti
- Data ya Public WiDS/GOSSIS structured EHR inaweza kutumiwa katika admission-time phenotyping ya hali ya kisukari iliyoandikwa katika rekodi.
- Modeli za Gradient-boosted na ensemble tree zilionyesha uwezo mkubwa wa kutenganisha katika miundo ya validation ya chanzo.
- Voting ensemble ilitoa wasifu wenye uwiano bora zaidi wa F1/AUROC.
- LightGBM ndiyo modeli moja yenye mwelekeo wa recall ya juu zaidi.
- Reasonable leakage mitigation na kuondolewa kwa vigezo vyote vya APACHE kulipunguza utendaji kwa kiwango kidogo tu.
- Kuondolewa kwa feature zinazofanana na glukosi kulipunguza uwezo wa kutenganisha kwa kiwango kikubwa.
- Katika grouped-site validation, recall ilidumishwa huku precision na calibration zikizorota.
- Uchambuzi wa SHAP unaonyesha dominant glycemic signal pamoja na michango midogo ya kliniki ya kimuktadha.
Hitimisho ambazo utafiti hauungi mkono
- Modeli haithibitishi kwamba inaweka utambuzi mpya wa kisukari.
- Modeli haitenganishi kwa uhakika kisukari sugu na stress hyperglycemia.
- 0,8539 AUROC pekee haitoshi kwa clinical deployment.
- Grouped-site validation si external validation kwenye data huru ya nje.
- Threshold ya 0,4537 si threshold bora ya ulimwengu wote kwa workflows zote za kliniki.
- Michango ya SHAP haimaanishi biological causality.
- Probability za modeli hazipaswi kutumiwa kama absolute clinical risk probability bila recalibration.
- Utafiti haujathibitisha uamuzi wa matibabu wa kiotomatiki, dozi ya insulini au mfumo wa tahadhari ya kliniki.
Mapungufu makuu
Kizuizi cha kwanza ni lebo rejea. Lebo ya “Diabetes mellitus” ni taarifa ya kisukari iliyoandikwa katika hifadhidata chanzo; si lebo ya gold-standard ya kisukari sugu iliyofanyiwa adjudication upya kwa HbA1c, longitudinal outpatient records, historia ya dawa na manual chart review.
Kizuizi cha pili ni upeo wa validation. Ingawa mgawanyo wa hospitali ni mkali zaidi kuliko random split, rekodi za training na validation ni sehemu ya mfumo uleule wa data ya umma. External validation haikufanywa kwenye seti huru za data za ICU.
Kizuizi cha tatu ni specificity ya ishara ya glycemic. Thamani za Early ICU glucose zinaweza kuakisi ugonjwa sugu wa metabolic pamoja na stress ya papo hapo, matibabu na mchakato wa monitoring.
Kizuizi cha nne ni calibration. Chanzo hakikufanya recalibration ya utabiri wa modeli; uchanganuzi wa calibration ulitambua tatizo pekee.
Mwelekeo wa tafiti za baadaye
Chanzo kinapendekeza external validation katika hifadhidata huru za ICU, tathmini ya prospective katika hospitali na vipindi tofauti, uchaguzi wa threshold kulingana na madhumuni ya matumizi na, inapohitajika, post hoc recalibration.
Kwa lebo rejea zenye nguvu zaidi, longitudinal EHR, HbA1c, historia ya dawa za outpatient, orodha za matatizo, misimbo ya utambuzi na manual adjudication pale inapofaa vinaweza kutathminiwa kwa pamoja. Hivyo, kisukari sugu kilichojulikana awali kinaweza kutenganishwa kwa uwazi zaidi na kisukari ambacho hakikutambuliwa hapo awali, stress hyperglycemia, medication-related hyperglycemia, nutrition-associated dysglycemia na treatment-related glucose changes.
Chanzo pia kinasema kwamba TabNet, TabTransformer, FT-Transformer au modeli nyingine za deep tabular/Transformer zinaweza kulinganishwa baadaye chini ya mfumo uleule wa validation, calibration, ablation na interpretability.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Identifying Pre-Existing Diabetes at ICU Admission with Machine Learning on Public GOSSIS Data
Mwandishi: Lily Popova Zhuhadar.
Idadi ya waandishi: 1; makala chanzo ni utafiti wa sole-author.
Taasisi: Department of Analytics & Information Systems, Center for Applied Data Analytics, Western Kentucky University, Bowling Green, Kentucky, USA.
Mwandishi anayewajibika: Lily Popova Zhuhadar.
Jarida: Diabetology.
Mchapishaji: MDPI, Basel, Switzerland.
Juzuu / toleo / makala: 7(5), 100.
DOI: 10.3390/diabetology7050100.
Received: 26 Machi 2026.
Revised: 19 Mei 2026.
Accepted: 19 Mei 2026.
Published: 21 Mei 2026.
Academic Editor: Peter Clifton.
Aina ya chanzo: Original Article iliyopitiwa na wenzao; utafiti retrospective wa benchmark/phenotyping wa ujifunzaji wa mashine.
Leseni: Creative Commons Attribution (CC BY).
Chanzo cha data: WiDS Datathon 2021 tabular release; derivative ya GOSSIS initiative na eICU Collaborative Research Database.
Data ya awali yenye lebo: 130.157 ICU stay, 181 feature.
Faili ya challenge isiyo na lebo: 10.234 rekodi, 180 feature; haikutumika kwa kujifunza preprocessing, kuchagua threshold au utendaji wa validation.
Kohorti ya mwisho ya uchanganuzi ya umri ≥16: 125.139 ICU stay.
Random split ya msingi: 100.111 training / 25.028 validation; stratified 80/20; random seed 40.
Grouped-site split: 95.233 training / 29.906 validation; hospitali 163 za training / hospitali 41 za validation; hakuna overlap ya hospitali.
Lebo lengwa: pre-existing diabetes mellitus iliyoandikwa katika rekodi chanzo kabla ya au wakati wa admission.
Modeli: CatBoost, Random Forest, tuned XGBoost, tuned LightGBM, HistGradientBoosting na soft-voting ensemble.
Mbinu ya class imbalance: Model-intrinsic class weighting na threshold-aware evaluation; synthetic oversampling haikutumika.
Uzito wa soft-voting: XGBoost : LightGBM : HGB = 1 : 3 : 1.
Metrics za tathmini: Accuracy, precision, recall, F1-score, AUROC, Brier score na average precision.
Calibration: 10 uniform probability bin; post hoc recalibration haikutumika.
Interpretability: SHAP / TreeExplainer; grouped-site LightGBM; inapohitajika rekodi zisizozidi 3.000 za grouped-validation.
Ablation: Full feature set, leakage-mitigated original, exclude all APACHE na strict reduced model.
Matokeo makuu: Voting ensemble katika leakage-mitigated random split ilitoa wasifu wa jumla wenye uwiano bora zaidi kwa AUROC 0,8539 na F1 0,6138; tuned LightGBM ilikuwa modeli moja yenye sensitivity ya juu zaidi kwa recall 0,7677.
Matokeo makuu ya grouped-site: LightGBM recall 0,7684, AUROC 0,8443, precision 0,4546 na Brier 0,1596.
Grouped threshold ya sensitivity ya juu: t=0,4537; recall 0,8001; precision 0,4314.
Dominant model signal: d1_glucose_max na vigezo vingine vya day-1 vinavyohusiana na glukosi.
Ufadhili: Hakuna ufadhili wa nje.
Bodi ya maadili: Not applicable; de-identified public ICU data ilitumika.
Ridhaa yenye taarifa: Not applicable.
Upatikanaji wa data: WiDS Datathon 2021 tabular dataset iliripotiwa kuwa inapatikana kwa umma kupitia Kaggle.
Kodi/nyenzo za uchanganuzi: Mwandishi aliripoti chanzo cha Google Colab cha kuzalisha tena matokeo; tarehe ya kufikia katika chanzo ni 12 Machi 2026.
Mgongano wa maslahi: Mwandishi hakuripoti mgongano wa maslahi.
Kikomo kikuu cha kliniki: Modeli inaainisha fenotipu ya kisukari iliyoandikwa katika rekodi; haitoi utambuzi wa kisukari sugu uliofanyiwa adjudication, utenganishaji wa stress hyperglycemia au uamuzi wa matibabu.
Kikomo kikuu cha deployment: Haitakiwi kutumiwa kama zana huru ya utambuzi au uamuzi wa matibabu bila external validation, recalibration, workflow-specific thresholding na confirmatory clinical review.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *