

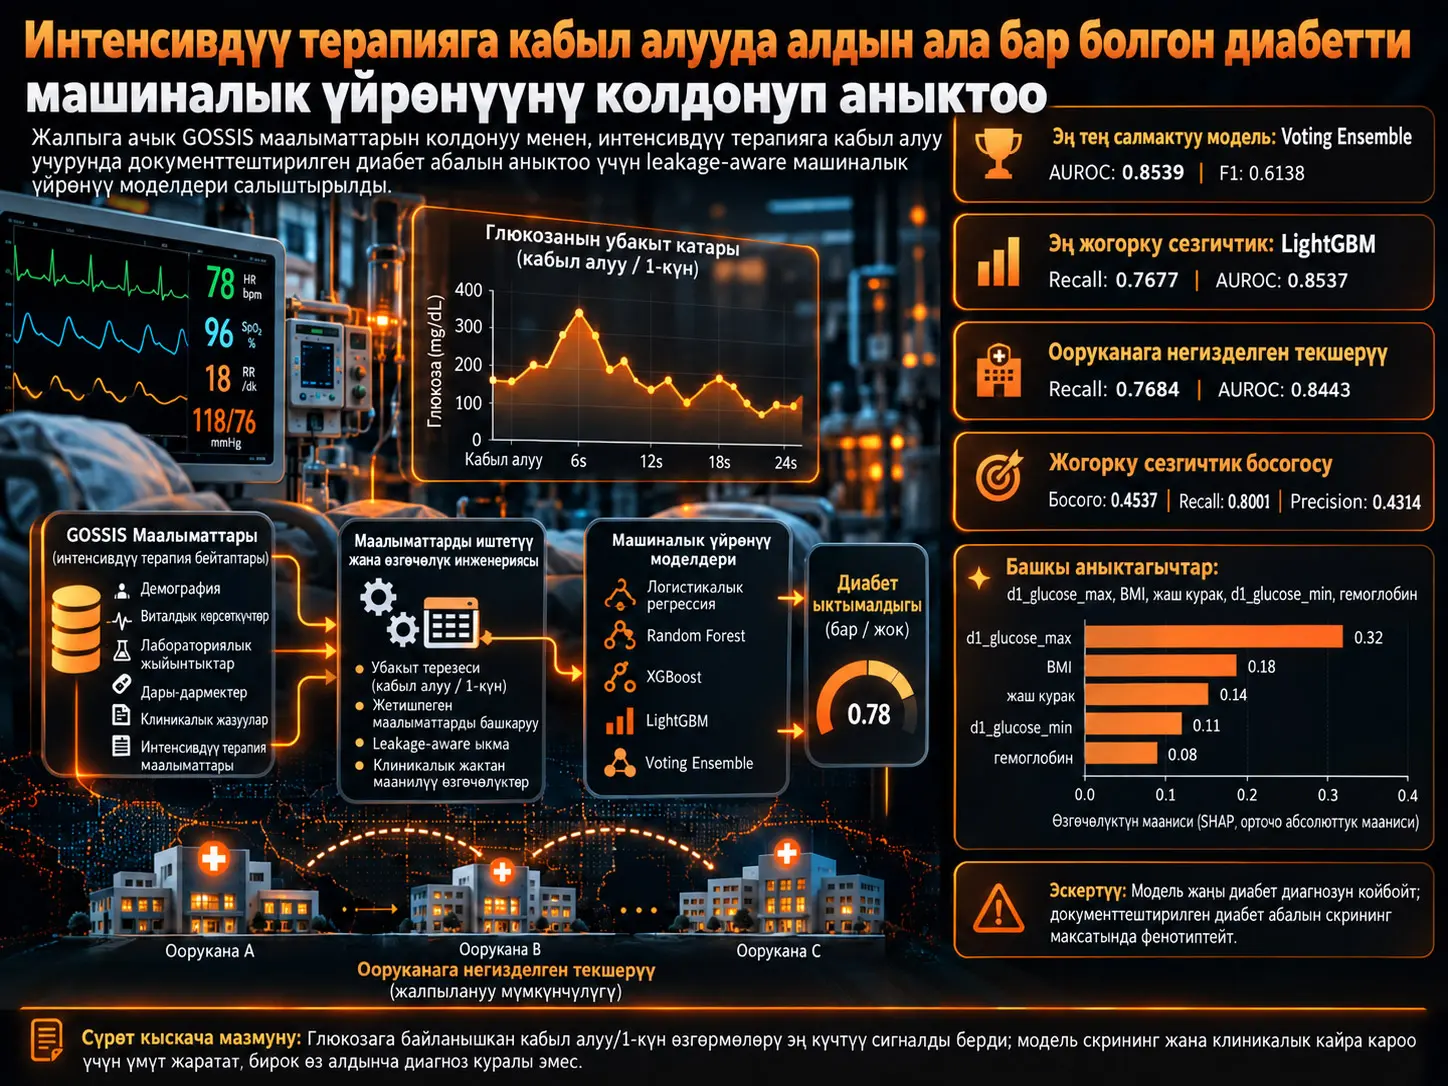
Эсептелүүчү диабет фенотиптөөсү (computable diabetes phenotyping) электрондук медициналык жазуулардагы түзүмдөлгөн өзгөрмөлөрдү колдонуп, адамдын булак жазууларында белгилүү бир клиникалык фенотипке ээ болуу ыктымалдыгын алгоритмдик түрдө аныктоого багытталган классификациялык ыкма. Бул изилдөө жалпыга ачык WiDS Datathon 2021/GOSSIS критикалык жардам маалыматтарын колдонуп, интенсивдүү терапияга кабыл алуу учурунда жазууларда мурда документтештирилген диабет абалын аныктоо үчүн leakage-aware машиналык үйрөнүү моделдерин салыштырган. Негизги талдоодо 125.139 жашы ≥16 ICU жазуусу колдонулган; CatBoost, Random Forest, XGBoost, LightGBM, Histogram-based Gradient Boosting жана үч boosting моделин бириктирген soft-voting ensemble бааланган. Leakage-mitigated random validation учурунда voting ensemble AUROC 0,8539, precision 0,5671, recall 0,6690 жана F1 0,6138 менен эң тең салмактуу жалпы профилди көрсөткөн, ал эми tuned LightGBM recall 0,7677 менен сезгичтикке эң көп багытталган модель болгон.
Изилдөөнүн эң маанилүү табылгасы — моделдин ийгилиги ачык site же APACHE өзгөрмөлөрүнө караганда эрте глюкоза сигналына көбүрөөк көз каранды болушу. APACHE өзгөрмөлөрү чыгарылганда көрсөткүчтөр чектелүү гана төмөндөгөн, ал эми глюкозага окшош өзгөрмөлөр да чыгарылган strict reduced сценарийинде LightGBM AUROC 0,7432 деңгээлине жана voting ensemble AUROC 0,7448 деңгээлине түшкөн. SHAP талдоосу да d1_glucose_max жана d1_glucose_min өзгөрмөлөрүнүн үстөмдүгүн көрсөткөн. Бирок интенсивдүү терапиянын биринчи күнүндөгү глюкоза өлчөөлөрү өнөкөт диабетти гана эмес, курч стресс физиологиясын, дары же дарылоо таасирлерин, тамактандыруу колдоосун жана өлчөө интенсивдүүлүгүн да чагылдырышы мүмкүн.
Ооруканалар training менен validation ортосунда толук бөлүнгөн grouped-site validationда LightGBM recall 0,7684 деңгээлинде сакталган, бирок AUROC 0,8443 деңгээлине жана precision 0,4546 деңгээлине төмөндөгөн. 0,4537 threshold маанисинде recall 0,8001 деңгээлине чейин көтөрүлгөн, бирок precision 0,4314 болгон. Калибрлөө натыйжалары да болжолдонгон ыктымалдыктар клиникалык абсолюттук коркунуч катары колдонууга жетиштүү ишенимдүү эмес экенин көрсөткөн. Ошондуктан система өз алдынча диабет диагнозун коюучу курал эмес; chart review, medication reconciliation, cohort enrichment же изилдөө классификациясы үчүн жогорку сезгичтиктеги фенотиптөө/скрининг жардамчысы катары чечмелениши керек.
Изилдөө маселеси
Интенсивдүү терапияга кабыл алуу учурунда бейтаптын диабет тарыхын туура билүү эрте гипергликемияны кандай чечмелөөгө таасир этиши мүмкүн. Бирок диабет тууралуу маалымат көйгөйлөр тизмеси, диагноз коддору, мурдагы кайрылуулар, дары жазуулары, лабораториялык архивдер же мекемелер аралык которуу документтери сыяктуу ар түрдүү электрондук медициналык жазуу булактарына чачырап кетиши мүмкүн. Бул жазуулардын бир бөлүгү кабыл алуу маалында жеткиликтүү болбошу мүмкүн.
Бул маселе өзгөчө интенсивдүү терапияда маанилүү, анткени бир эле жогорку глюкоза мааниси ар башка себептерден пайда болушу мүмкүн. Мурда белгилүү болгон диабет, мурда таанылбаган өнөкөт дисгликемия, курч стресс гипергликемиясы, глюкокортикоид же башка дары таасирлери, энтералдык/парентералдык тамактандыруу, декстроза камтыган суюктуктар жана эрте дарылоо чаралары бири-бирине окшош гликемиялык көрүнүштөрдү жаратышы мүмкүн.
Ошондуктан изилдөөнүн суроосу “бейтап чындап диабетикпи?” деген түрдө жаңы клиникалык диагноз коюу эмес. Суроо — интенсивдүү терапияга кабыл алууга жакын учурда жеткиликтүү түзүмдөлгөн маалыматтарды колдонуп, булак маалымат базасындагы мурда документтештирилген диабет абалын канчалык ишенимдүү фенотиптөөгө болору.
Бул Модель Чынында Диабет Диагнозун Коябу?
Жок. Изилдөөнүн максаттуу энбелгиси — булак жазууларында интенсивдүү терапияга кабыл алуудан мурда же кабыл алуу маалында эле документтештирилген диабет абалы; модель жаңы диабет диагнозун коюуга, стресс гипергликемиясын аныктоого же келечекте пайда боло турган диабетти болжолдоого үйрөтүлгөн эмес жана булак автор системаны өз алдынча диагноз коюучу курал эмес, фенотиптөө жана скрининг жардамчысы катары чектейт.
Computable phenotyping ыкмасынын ролу
Computable phenotyping клиникалык абалды түзүмдөлгөн EHR өзгөрмөлөрү аркылуу кайра аныктаган алгоритмдик ыкма катары каралышы мүмкүн. Мындай системаларда көрсөткүчтөр AUROC менен гана бааланбашы керек. Ошончолук маанилүү суроолор: колдонулган өзгөрмөлөр энбелгиге маалымат агызабы, preprocessing training маалыматынан гана үйрөнүлдүбү, ар башка ооруканаларда көрсөткүчтөр сакталабы, класс теңсиздиги кандай башкарылды жана болжол ыктымалдыктары калибрлендиби.
Маалымат булагы
| Компонент | Жазуу | Өзгөчөлүк | Изилдөөдө колдонулушу |
|---|---|---|---|
| Энбелгиленген WiDS 2021 файлы | 130.157 ICU stay | 181 | Моделди иштеп чыгуу жана validation булагы |
| Жашы ≥16 аналитикалык когорта | 125.139 ICU stay | Preprocessingден кийин сценарийге жараша | Негизги моделдөө когортасы |
| Энбелгисиз challenge файлы | 10.234 жазуу | 180 | Validation метрикасы, preprocessing үйрөнүү же threshold тандоо үчүн колдонулган эмес |
Төрт өзгөчөлүк сценарийи
| Сценарий | Негизги эреже |
|---|---|
| Full feature set | Кадимки тазалоо колдонулат; grouping identifierлер модель матрицасынан чыгарылат. |
| Leakage-mitigated original | Энбелгиге түз же кыйыр түрдө өтө жакын болушу мүмкүн болгон APACHE diagnosis талаалары жана тандалган өнөкөт коморбиддүүлүк көрсөткүчтөрү чыгарылат; башка клиникалык admission/day-1 өзгөрмөлөрү сакталат. |
| Exclude all APACHE | Leakage-mitigated чыгарууларга кошумча бардык APACHE менен байланышкан өзгөрмөлөр алынып салынат. |
| Strict reduced model | APACHE, site identifier жана глюкозага окшош өзгөрмөлөр да чыгарылат. |
Split-aware preprocessing эмне үчүн маанилүү болгон?
Изилдөөдө маалыматтарды preprocessing эрежелери validation маалыматынан маалымат агып кетпегидей кылып training split үстүндө гана үйрөнүлгөн. Энбелгисиз challenge файлы да imputer, категориялык деңгээл, engineered feature же correlation-pruning чечимин түзүүдө колдонулган эмес.
Негизги random split:
\[ (X_{\mathrm{train}},X_{\mathrm{val}},y_{\mathrm{train}},y_{\mathrm{val}}) = \mathrm{StratifiedSplit}(X,y;\mathrm{test\_size}=0.20,\mathrm{stratify}=y,\mathrm{seed}=40) \]
Бул теңдеме бардык чоңдордун жазууларын diabetes_mellitus энбелгисинин бөлүштүрүлүшүн сактоо менен %80 training жана %20 validation болуп бөлөт. Андан соң preprocessing параметрлери training бөлүгүнөн гана эсептелет:
\[ \Theta=\mathrm{fit}_{\mathrm{train}}(\mathrm{preprocessing}), \qquad X_{\mathrm{val}}^{*}=\mathrm{transform}_{\Theta}(X_{\mathrm{val}}) \]
Бул ырааттуулук validation маалыматындагы бөлүштүрүү касиеттеринин training учурунда модельге кыйыр өтүп кетишин азайтууга багытталган.
Сап жана схема деңгээлиндеги тазалоо
- Жашы <16 болгон жазуулар чыгарылды.
- hospital_admit_source жана icu_admit_source категориялары шайкештештирилди.
- Эгер бир _min өзгөрмөсү тиешелүү _max маанисинен чоң болсо, эки маанинин орду алмаштырылды.
- Жетишпеген d1_pao2fio2ratio_max үчүн ылайыктуу учурда pao2_apache/fio2_apache катышы эсептелди.
- Бардык h1_ өзгөрмөлөрү чыгарылды.
- Day-1 эквиваленти бар айрым near-duplicate APACHE талаалары алынып салынды.
- encounter_id, readmission_status жана индекс тилкеси моделден чыгарылды.
- hospital_id жана icu_id grouped validation үчүн гана өзүнчө сакталды; эч бир feature сценарийинде модель киргизүүсү катары колдонулган жок.
Жетишпеген маанилерди иштетүү
Үзгүлтүксүз өзгөрмөлөр training-set орточосу, категориялык өзгөрмөлөр training-set модасы менен толтурулду. Бою, салмагы жана BMI үчүн адегенде жыныска мүнөздүү training-set орточосу колдонулду; ал мааниси жок болсо, жалпы training орточосуна кайтарылды. Категориялык өзгөрмөлөр training бөлүгүндө байкалган категориялар менен гана one-hot encode кылынды.
Training design matrix үстүндө абсолюттук Pearson корреляциясы 0,80 чегинен ашкан жогорку үч бурчтук feature жуптарында экинчи feature чыгарылды:
\[ C_{\mathrm{drop}} = \{b:\exists a<b,\ |r_{ab}|>0.80\} \]
Ошол эле тилке чыгаруулар validation жана challenge матрицаларына да өзгөртүүсүз колдонулду.
Салыштырылган моделдер
| Модель | Ролу | Булакта берилген негизги конфигурация |
|---|---|---|
| CatBoost | Boosting baseline | 100 boosting iteration; random seed 40 |
| Random Forest | Bagging baseline | 100 дарак; random_state=40; параллелдүү иштетүү |
| Tuned XGBoost | Tuned gradient boosting | 200 estimator; max_depth=8; learning_rate=0,05; subsample=0,8; min_child_weight=10; colsample_bytree=0,8 |
| Tuned LightGBM | Сезгичтикке багытталган boosting | learning_rate=0,007; colsample_bytree=0,2; reg_alpha=3; reg_lambda=1; scale_pos_weight=4; n_estimators=10.000; random_state=100 |
| HistGradientBoosting | Кошумча boosting салыштыргычы | scikit-learn histogram-based gradient boosting; random_state=40 |
| Soft-voting ensemble | Бириктирилген probability модели | XGBoost : LightGBM : HGB = 1 : 3 : 1 |
Класс теңсиздиги кандай башкарылды?
Изилдөө синтетикалык minority үлгүлөрүн түзүү үчүн SMOTE колдонгондун ордуна модель ичиндеги класс салмактоону тандаган. LightGBMде diabetes-positive классы үчүн scale_pos_weight=4 колдонулган. Бул тандоо чыныгы маалымат бөлүштүрүлүшүн өзгөртпөстөн позитивдүү учурларды туура эмес классификациялоонун training loss ичиндеги баасын жогорулатат.
Концептуалдык салмакталган жоготуу:
\[ L=\sum_{i=1}^{n}w_{y_i}\ell(y_i,p_i)+\Omega(F) \]
Бул жерде \(w_{y_i}\) класс салмагын, \(\ell(y_i,p_i)\) бинардык классификация жоготуусун, ал эми \(\Omega(F)\) моделдин татаалдыгына колдонулган regularization мүчөсүн билдирет.
Soft-voting ensemble кантип түзүлгөн?
XGBoost, LightGBM жана HGB probability болжолдору LightGBMге үч эсе салмак берилген түрдө бириктирилген:
\[ p_i^{(\mathrm{ens})} = \frac{ p_i^{(\mathrm{XGB})} + 3p_i^{(\mathrm{LGBM})} + p_i^{(\mathrm{HGB})} }{5} \]
Максат LightGBMдин жогорку сезгичтик артыкчылыгын сактоо менен XGBoost жана HGBнин этиятраак ыктымалдык болжолдору аркылуу false-positive жүгүн тең салмактоо болгон.
Классификация thresholdу
Ар бир модель адегенде диабет-positive классы үчүн ыктымалдык болжолун чыгарган:
\[ p_i^{(m)} = \Pr(y_i=1\mid x_i^{*},M_m) \]
Негизги салыштырууда демейки threshold \(t=0,50\) колдонулган:
\[ \hat{y}_i^{(m)}(t) = I\left(p_i^{(m)}\geq t\right) \]
Precision–recall талдоосунда болсо threshold өзгөртүлүп, ар түрдүү recall–precision тең салмактары өзүнчө каралган.
Иштөө метрикаларынын ролу
Accuracy жалпы туура классификациялоо үлүшүн, precision позитивдүү деп болжолдонгон учурлардын канчасы чындап позитивдүү экенин, recall булак энбелгисинде позитивдүү болгон учурлардын канчасы табылганын, ал эми F1 precision менен recallдун гармониялык орточосун өлчөйт.
Brier скору probability тактыгын өлчөгөн жана төмөн болушу каалаган метрика:
\[ \mathrm{Brier} = \frac{1}{n_V} \sum_{i\in V} (p_i-y_i)^2 \]
AUROC туруктуу thresholdдон көз каранды эмес ранжирлөө боюнча ажыратууну билдирет. Модель жогорку AUROCко ээ болуп туруп начар калибрлениши мүмкүн болгондуктан, булак AUROC менен calibration/Brierди өзүнчө баалаган.
Оорукана Боюнча Топтоштурулган Validation Эмне Үчүн Маанилүү?
Grouped-site validation бир эле ооруканага тиешелүү эч бир жазуунун training менен validation бөлүктөрүнүн экөөндө тең болушуна жол бербегендиктен, моделдин белгилүү мекемелерге мүнөздүү коддоо, лабораториялык тапшырык, бейтап профили же документтештирүү үлгүлөрүн жаттап алуусунан келип чыга турган ашыкча оптимисттик көрсөткүч баасын азайтат; бирок бул дизайн дагы эле ошол эле WiDS/GOSSIS маалымат версиясынын ичинде жүргүзүлгөн internal validation болуп саналат жана көз карандысыз external validation эмес.
Математикалык бөлүнүү:
\[ G_{\mathrm{train}}\cap G_{\mathrm{val}}=\varnothing \]
| Validation | Training жазуусу | Validation жазуусу | Оорукана түзүмү |
|---|---|---|---|
| Random stratified | 100.111 | 25.028 | Бир эле ооруканалар эки бөлүктө тең болушу мүмкүн |
| Grouped site | 95.233 | 29.906 | 163 training жана 41 validation ооруканасы; кайчылашуу жок |
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Негизги модель салыштыруусу
| Модель | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Voting Ensemble | 0,8151 | 0,5671 | 0,6690 | 0,6138 | 0,8539 | 0,1300 |
| LightGBM (Tuned) | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| XGBoost (Tuned) | 0,8288 | 0,6557 | 0,4642 | 0,5436 | 0,8505 | 0,1197 |
| HistGradientBoosting | 0,8251 | 0,6445 | 0,4543 | 0,5330 | 0,8458 | 0,1214 |
| CatBoost | 0,8227 | 0,6317 | 0,4629 | 0,5343 | 0,8403 | 0,1236 |
| Random Forest | 0,8154 | 0,6645 | 0,3225 | 0,4342 | 0,8252 | 0,1286 |
Бул таблица бир эле “эң жакшы модель” эмес, ар кандай колдонуу максаттары үчүн ар башка иштөө профилдери бар экенин көрсөтөт. Voting ensemble F1 жана AUROC боюнча эң тең салмактуу жыйынтыктарды берген. LightGBM позитивдүү учурларды эң көп кармаган модель; бирок көбүрөөк false positive жараткан. XGBoost болсо төмөнүрөөк recall эсебинен эң төмөн Brier скорун берген.
Figure 1–6: Confusion matrix жана feature importance
Булакта Figure 1–6 ар бир негизги модель үчүн confusion matrix менен top-15 feature importance графигин жупташтырат. CatBoost 18.046 true negative, 1.484 false positive, 2.953 false negative жана 2.545 true positive чыгарган. Random Forest false positive санын болгону 895 санына чейин азайткан, бирок 3.725 диабет-positive учурду өткөрүп жиберген.
Tuned XGBoost 2.552 true positive жана 1.340 false positive чыгарганда LightGBM 4.221 true positiveге жеткен; анын ордуна 4.192 false positive жараткан. HGB 2.498 true positive, 1.378 false positive чыгарган. Voting ensemble 3.678 true positive жана 2.808 false positive менен LightGBM жана этиятраак моделдердин ортосунда орточо иштөө профилин түзгөн.
Бардык модель үй-бүлөлөрүндө d1_glucose_max күчтүү же үстөм feature катары айырмаланган. d1_glucose_min, BMI, жаш, креатинин, pre-ICU length of stay, гемоглобин жана башка физиологиялык/лабораториялык жыйынтыктар ар түрдүү моделдерде кайра-кайра жогорку мааниге ээ өзгөрмөлөр болгон.
Глюкозага Окшош Өзгөрмөлөр Чыгарылганда Көрсөткүчтөр Кандай Болду?
Глюкозага окшош өзгөрмөлөр APACHE жана leakage-prone талаалар менен кошо чыгарылганда моделдин ажыратуу жөндөмү олуттуу төмөндөгөн: LightGBM AUROC 0,8537 маанисинен 0,7432 маанисине, voting ensemble AUROC 0,8539 маанисинен 0,7448 маанисине түшкөн; ал эми leakage-prone же бардык APACHE өзгөрмөлөрүн гана чыгаруу кыйла азыраак жоготууларды жараткан, демек admission/day-1 гликемиялык өзгөрмөлөрү моделдин негизги predictive сигналы болуп саналат.
| Сценарий | LightGBM AUROC | LightGBM Recall | LightGBM Brier | Ensemble AUROC | Ensemble F1 |
|---|---|---|---|---|---|
| Full feature set | 0,8565 | 0,7672 | 0,1491 | 0,8566 | 0,6159 |
| Leakage-mitigated original | 0,8537 | 0,7677 | 0,1508 | 0,8539 | 0,6138 |
| Exclude all APACHE | 0,8508 | 0,7634 | 0,1529 | 0,8514 | 0,6077 |
| Strict reduced model | 0,7432 | 0,6641 | 0,1986 | 0,7448 | 0,4493 |
Бул ablation глюкоза өзгөрмөлөрү “өнөкөт диабетти таза түрдө өлчөйт” деп далилдебейт. Тескерисинче, моделдин күчтүү сигналынын маанилүү бөлүгү эрте гликемиялык өлчөөлөргө таянарын көрсөткөндүктөн, клиникалык чечмелөөдө көбүрөөк этияттык талап кылат.
Оорукана боюнча validation жыйынтыктары
| Validation | Accuracy | Precision | Recall | F1 | AUROC | Brier |
|---|---|---|---|---|---|---|
| Random stratified | 0,7815 | 0,5017 | 0,7677 | 0,6069 | 0,8537 | 0,1508 |
| Grouped site | 0,7727 | 0,4546 | 0,7684 | 0,5712 | 0,8443 | 0,1596 |
Grouped-site confusion matrix 18.581 true negative, 5.432 false positive, 1.365 false negative жана 4.528 true positive камтыйт. Recall дээрлик өзгөрбөй калышы модель ар башка ооруканаларда позитивдүү жазууларды кармоону улантканын; precision жана Brierдин начарлашы болсо мунун көбүрөөк жалган-позитивдүү жана probability reliability чыгымы менен болгонун көрсөтөт.
Precision–recall жана жогорку сезгичтик thresholdу
Class imbalance болгондуктан ROC талдоосуна кошумча precision–recall ийри сызыктары колдонулган. Random validation average precision 0,622, grouped-site average precision 0,551 түзөт.
Булак жогорку сезгичтик максатын:
\[ t_r= \max\{t:\mathrm{Recall}(t)\geq0.80\} \]
деп аныктаган. Grouped-site маалыматында бул шартка жооп берген билдирилген threshold 0,4537; бул чекитте recall 0,8001 жана precision 0,4314 түзөт.
Бул жыйынтык “жогорку recall бекер эмес” деген принципти түз көрсөтөт. Өткөрүп жиберилген позитивдерди азайтуу үчүн threshold төмөндөтүлгөндө, позитивдүү деп белгиленип, бирок булак энбелгиси негативдүү болгон бейтаптардын саны көбөйөт.
Моделдин Жогорку AUROC Мааниси Ыктымалдыктар Жакшы Калибрленгенин Билдиреби?
Жок. LightGBM AUROC боюнча күчтүү ажыратууну камсыз кылганы менен, random жана grouped-site калибрлөө ийри сызыктары болжол ыктымалдыктары өзгөчө орто-жогорку коркунуч аралыктарында байкалган диабет жыштыгынан жогору болууга ыктаарын, Brier скорлору grouped validation шартында да начарлаганын көрсөткөн; ошондуктан чийки модель ыктымалдыктары кайра калибрлөөсүз клиникалык абсолюттук коркунуч ыктымалдыгы катары чечмеленбеши керек.
Калибрлөөнүн логикасы
Мыкты калибрленген модель үчүн болжол ыктымалдыгы \(p\) болгон бейтаптар тобунда чыныгы позитивдүүлүк үлүшү да \(p\) болушу күтүлөт:
\[ E[y_i\mid p_i=p]=p \]
Булак калибрлөө ийри сызыгын 10 тең ыктымалдык аралыгы менен түзүп, post hoc recalibration колдонгон эмес. Figure 10 ичинде эки validation дизайнындагы ийри сызык идеалдуу диагоналдын маанилүү бөлүгүндө төмөн калган; бул probability overestimation менен шайкеш келет.
| Validation | Brier | Калибрлөө чечмелөөсү |
|---|---|---|
| Random stratified | 0,1508 | Probability overestimation байкалат |
| Grouped site | 0,1596 | Probability reliability бир аз начарыраак |
SHAP эмне үчүн grouped-site моделинде эсептелген?
SHAP талдоосунун grouped-site LightGBM үстүндө жүргүзүлүшү түшүндүрмөнү бир эле ооруканалар эки foldда кездешкен жеңилирээк random splitке эмес, катуураак оорукана-бөлүнгөн модель жүрүм-турумуна байланыштырууга мүмкүндүк берген. Grouped validation үлгүлөрүнүн саны 3.000 жазуудан ашса, SHAP эсептөөсү кайра өндүрүлүшү үчүн туруктуу seed менен эң көп 3.000 жазууга чейин үлгүлөнгөн.
SHAPтын additive түшүндүрүү формасы:
\[ F_G(x_i^{*}) = \phi_0+\sum_{j=1}^{p}\phi_{ij} \]
Бул жерде \(\phi_0\) моделдин баштапкы/baseline чыгышын, ал эми \(\phi_{ij}\) бейтап \(i\) үчүн feature \(j\)нин модель чыгышын өйдө же ылдый түрткөн салымын билдирет.
Глобалдык SHAP табылгалары
| Өзгөрмө | Булакта байкалган негизги жүрүм-турум |
|---|---|
| d1_glucose_max | Айкын түрдө эң жогорку mean absolute SHAP; жогорку маанилер адатта diabetes-positive багытына салым кошот |
| BMI | Жогорку маанилер адатта позитивдүү салым; high-20s чамасында негативдүүдөн позитивдүүгө өтүү жана жогорку четинде жарым-жартылай плато |
| Age | Жаш куракта негативдүү; орто жана улуу куракта көбүрөөк позитивдүү; эң улуу куракта плато/жеңил төмөндөө |
| d1_glucose_min | Тескери жана сызыктуу эмес үлгү; төмөн minima позитивдүү багытта салым кошушу мүмкүн |
| d1_hemoglobin_max | Төмөн-орто маанилерде позитивдүү салым, жогорку маанилерде бара-бара негативдүү багыт |
| urineoutput_apache | Кичирээк жана чачыранды SHAP чоңдуктары; экинчи даражадагы контексттик feature |
d1_glucose_max dependence графиги
Figure 12 боюнча d1_glucose_maxтын SHAP салымы болжол менен 100–250 mg/dL аралыгында айкын жогорулап, өтө жогорку маанилерде платого чыккан. Бул үлгү моделдин жүрүм-туруму чексиз сызыктуу өсүштөн көрө non-linear saturation камтарын көрсөтөт.
Жергиликтүү SHAP waterfall түшүндүрмөлөрү
Figure 14–15 true positive, false positive, true negative жана false negative топторунан тандалган өкүлчүлүктүү учурларды түшүндүрөт. Позитивдүү скор алган мисалдарда жогорку d1_glucose_max көбүнчө эң чоң өйдө багытталган салым; негативдүү скор алган мисалдарда төмөнүрөөк же азыраак экстремалдуу максималдуу глюкоза мааниси күчтүү ылдый багытталган салым бере алат.
Ошентсе да жеке болжолдор бир гана featureдан турбайт. BMI, жаш, гемоглобин, renal контекст, d1_glucose_min жана pre-ICU өзгөчөлүктөрү күчтүү гликемиялык сигналды күчөтүшү же азайтышы мүмкүн.
Изилдөө колдогон жыйынтыктар
- Public WiDS/GOSSIS structured EHR маалыматы жазууларда документтештирилген диабет абалын admission-time фенотиптөөдө колдонулушу мүмкүн.
- Gradient-boosted жана ensemble tree моделдери булак validation дизайндарында күчтүү ажыратууну көрсөткөн.
- Voting ensemble эң тең салмактуу F1/AUROC профилин түзгөн.
- LightGBM эң жогорку recallга багытталган жалгыз модель.
- Reasonable leakage mitigation жана бардык APACHE өзгөрмөлөрүн чыгаруу көрсөткүчтөрдү чектелүү гана төмөндөткөн.
- Глюкозага окшош featureларды чыгаруу ажыратууну айкын төмөндөткөн.
- Grouped-site validationда recall сакталганда precision жана calibration начарлаган.
- SHAP талдоолору dominant glycemic signal менен кичирээк контексттик клиникалык салымдарды көрсөтөт.
Изилдөө колдобогон жыйынтыктар
- Модель жаңы диабет диагнозун коёрун далилдебейт.
- Модель өнөкөт диабет менен stress hyperglycemiaны так ажыратпайт.
- 0,8539 AUROC клиникалык deployment үчүн өз алдынча жетиштүү эмес.
- Grouped-site validation көз карандысыз тышкы маалыматтагы external validation эмес.
- 0,4537 threshold бардык клиникалык иш агымдары үчүн универсалдуу оптималдуу threshold эмес.
- SHAP салымдары биологиялык себептүүлүктү билдирбейт.
- Модель ыктымалдыктары recalibrationсыз клиникалык абсолюттук коркунуч ыктымалдыгы катары колдонулбашы керек.
- Изилдөө автоматтык дарылоо чечимин, инсулин дозасын же клиникалык сигнализация системасын валидациялаган эмес.
Негизги чектөөлөр
Биринчи чектөө — маалымдама энбелгиси. “Diabetes mellitus” энбелгиси булак маалымат базасындагы документтештирилген диабет маалыматы; HbA1c, longitudinal outpatient records, дары тарыхы жана manual chart review аркылуу кайра adjudike кылынган gold-standard өнөкөт диабет энбелгиси эмес.
Экинчи чектөө — validation камтуусу. Оорукана боюнча бөлүү random splitке караганда катуураак болгону менен training жана validation жазуулары бир эле коомдук маалымат экосистемасынын бөлүгү. Көз карандысыз ICU маалымат топтомдорунда external validation жүргүзүлгөн эмес.
Үчүнчү чектөө — гликемиялык сигналдын өзгөчөлүгү. Early ICU glucose маанилери өнөкөт метаболикалык ооруну да, курч стрессти, дарылоону жана көзөмөл процессин да чагылдырышы мүмкүн.
Төртүнчү чектөө — calibration. Булак модель болжолдорун кайра калибрлеген эмес; calibration талдоосу көйгөйдү гана аныктаган.
Келечектеги изилдөө багыттары
Булак көз карандысыз ICU маалымат базаларында external validation, ар түрдүү оорукана жана убакыт мезгилдеринде проспективдүү баалоо, колдонуу максатына жараша threshold тандоо жана зарыл болсо post hoc recalibration сунуштайт.
Күчтүүрөөк маалымдама энбелгилери үчүн longitudinal EHR, HbA1c, outpatient дары тарыхы, көйгөйлөр тизмелери, диагноз коддору жана ылайыктуу болсо manual adjudication бирге бааланышы мүмкүн. Ошентип мурда белгилүү өнөкөт диабетти мурда таанылбаган диабеттен, stress hyperglycemiaдан, medication-related hyperglycemiaдан, nutrition-associated dysglycemiaдан жана treatment-related glucose өзгөрүүлөрүнөн айкынраак ажыратууга болот.
Булак ошондой эле ошол эле validation, calibration, ablation жана interpretability алкагында TabNet, TabTransformer, FT-Transformer же башка deep tabular/Transformer негизиндеги моделдер келечекте салыштырылышы мүмкүн экенин белгилейт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска изилдөө: Identifying Pre-Existing Diabetes at ICU Admission with Machine Learning on Public GOSSIS Data
Автор: Lily Popova Zhuhadar.
Авторлордун саны: 1; булак макала sole-author изилдөөсү.
Мекеме: Department of Analytics & Information Systems, Center for Applied Data Analytics, Western Kentucky University, Bowling Green, Kentucky, USA.
Жооптуу автор: Lily Popova Zhuhadar.
Журнал: Diabetology.
Басма: MDPI, Basel, Switzerland.
Том / сан / макала: 7(5), 100.
DOI: 10.3390/diabetology7050100.
Received: 26 Март 2026.
Revised: 19 Май 2026.
Accepted: 19 Май 2026.
Published: 21 Май 2026.
Academic Editor: Peter Clifton.
Булак түрү: Рецензияланган Original Article; ретроспективдүү машиналык үйрөнүү benchmark/фенотиптөө изилдөөсү.
Лицензия: Creative Commons Attribution (CC BY).
Маалымат булагы: WiDS Datathon 2021 tabular release; GOSSIS initiative жана eICU Collaborative Research Database туундусу.
Баштапкы энбелгиленген маалымат: 130.157 ICU stay, 181 feature.
Энбелгисиз challenge файлы: 10.234 жазуу, 180 feature; preprocessing үйрөнүү, threshold тандоо жана validation көрсөткүчтөрү үчүн колдонулган эмес.
Акыркы жашы ≥16 аналитикалык когорта: 125.139 ICU stay.
Негизги random split: 100.111 training / 25.028 validation; stratified 80/20; random seed 40.
Grouped-site split: 95.233 training / 29.906 validation; 163 training ооруканасы / 41 validation ооруканасы; оорукана кайчылашуусу жок.
Максаттуу энбелги: Булак жазууларында admissionга чейин же анын учурунда документтештирилген pre-existing diabetes mellitus.
Моделдер: CatBoost, Random Forest, tuned XGBoost, tuned LightGBM, HistGradientBoosting жана soft-voting ensemble.
Class imbalance ыкмасы: Model-intrinsic class weighting жана threshold-aware evaluation; синтетикалык oversampling колдонулган эмес.
Soft-voting салмактары: XGBoost : LightGBM : HGB = 1 : 3 : 1.
Баалоо метрикалары: Accuracy, precision, recall, F1-score, AUROC, Brier score жана average precision.
Calibration: 10 uniform probability bin; post hoc recalibration колдонулган эмес.
Interpretability: SHAP / TreeExplainer; grouped-site LightGBM; керек болсо эң көп 3.000 grouped-validation жазуусу.
Ablation: Full feature set, leakage-mitigated original, exclude all APACHE жана strict reduced model.
Негизги жыйынтык: Voting ensemble leakage-mitigated random splitте AUROC 0,8539 жана F1 0,6138 менен эң тең салмактуу жалпы профиль; tuned LightGBM recall 0,7677 менен эң сезгич жалгыз модель.
Grouped-site негизги жыйынтык: LightGBM recall 0,7684, AUROC 0,8443, precision 0,4546 жана Brier 0,1596.
Жогорку сезгичтиктеги grouped threshold: t=0,4537; recall 0,8001; precision 0,4314.
Dominant модель сигналы: d1_glucose_max жана глюкоза менен байланышкан башка day-1 өзгөрмөлөрү.
Каржылоо: Тышкы каржылоо жок.
Этика кеңеши: Not applicable; de-identified public ICU data колдонулган.
Маалымдалган макулдук: Not applicable.
Маалыматтын жеткиликтүүлүгү: WiDS Datathon 2021 tabular dataset Kaggle аркылуу жалпыга ачык экени билдирилген.
Код/аналитикалык материал: Автор жыйынтыктарды кайра өндүрүүгө арналган Google Colab булагын көрсөткөн; булакта кирүү датасы 12 Март 2026-жыл.
Кызыкчылыктардын кагылышы: Автор кызыкчылыктардын кагылышын билдирген эмес.
Негизги клиникалык чек: Модель жазууларда документтештирилген диабет фенотибин классификациялайт; adjudike өнөкөт диабет диагнозун, stress hyperglycemia айырмалоосун же дарылоо чечимин чыгарбайт.
Негизги deployment чеги: External validation, recalibration, workflow-specific thresholding жана confirmatory clinical review жүргүзүлмөйүнчө өз алдынча диагноз же дарылоо чечим куралы катары колдонулбашы керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген